매일 쌓이는 개발자의 시야
2026년 11월 5일 (목). 세상의 기술 소식, 한국어로 한눈에.
AI 요약 안내 AI가 한국어로 정리한 내용입니다. 정확한 정보는 각 카드의 원문을 확인해 주세요.
요약 원칙 ↗ 01 읽을 소식Hacker News 8건 ↓ 02 써볼 도구GitHub Trending 6건 ↓ 03 읽을 논문Hugging Face Papers 3건 ↓ 04 새 버전GitHub Releases 1건 ↓ AI · 머신러닝 분야 · 18건 필터 해제 ×
오늘의 주요포인트 상위 6건
01 AI · 머신러닝 00:11 게시
원제 Tell HN: Gemini trains on chat history, even for subscribers (personal accounts)
308 포인트 댓글 84
Key Point 유료 가입자도 개인 대화 기록이 훈련과 인간 검토에 사용될 수 있다는 점이 구독의 기본 약관에는 명시되어 있지만 충분히 공지되지 않아, 프라이버시 기대치와 실제 서비스 정책 사이의 간극을 보여준다.
핵심 요약
Google AI 구독 사용자의 Gemini 채팅 기록도 기본적으로 AI 모델 훈련에 사용된다. 채팅 기록은 구글의 개선 서비스에만 아니라 생성형 AI 모델 훈련에도 활용되며, 일부 대화는 인간 검토자에 의해 검토된다. 구글은 인간 검토 시 사용자 계정과 연결을 해제한다고 주장하지만, 기밀 정보를 입력하지 않을 것을 명시적으로 경고한다. 전체 요약 6문장 읽기 → 02 AI · 머신러닝 00:11 게시
원제 Geoffrey Hinton: it might turn out we were better off without AI
224 포인트 댓글 179
Key Point AI 개발 선구자 본인이 기술의 미래를 10년이라는 구체적 시간 범위 내에서 재평가하며 경고하고 있으며, 현 AI 기업 지도자들의 위험 외면과 국제 규제 필요성을 명시해 정책 논의의 중요한 입장을 제시하고 있다.
핵심 요약
노벨상 수상자 제프리 힌튼은 AI가 발전하지 않았으면 더 나았을 수도 있다고 지적하며, 금융·전력 시스템 마비 같은 대규모 사건이 올해나 내년 안에 발생할 수 있다고 경고했다. 힌튼은 향후 10년 안에 인류가 AI의 위험을 관리할 수 있는지, 아니면 부의 양극화·실업·사회 붕괴 같은 결과에 직면하는지 판가름날 것이라고 말했다. 그는 샘 알트먼 오픈AI CEO, 마크 저커버그, 일론 머스크 등 AI 회사 지도자들이 위험을 충분히 이해하면서도 시장 경쟁과 수익을 우선한다고 비판했다. 전체 요약 8문장 읽기 → 03 AI · 머신러닝 03:11 게시
원제 Kimi K3.1 Pro model weights are out
144 포인트 댓글 28
Key Point 중국 AI 스타트업이 공개한 초대형 멀티모달 모델의 가중치가 외부에 공개되어 오픈소스 커뮤니티에서 자유롭게 실험·파인튜닝할 수 있게 됐고, OpenAI·Anthropic 모델들과의 벤치마크 비교를 통해 오픈 모델의 현재 수준을 파악할 수 있다.
핵심 요약
쿼크(夸克)가 개발한 Kimi K3.1 Pro는 오픈 가중치 멀티모달 에이전트 모델로, 백 개가 넘는 하위 도메인에서 대규모 강화학습으로 K3에서 후학습했다. 100만 토큰 컨텍스트 윈도우를 지원하며, 코딩·3D 생성·금융 조사·사실 정확도·에이전트 기능 등에서 큰 개선을 이뤄냈다. 총 파라미터 2.8T, 활성화 파라미터 104B, 93개 레이어, 전문가 896개(토큰당 16개 활성화)의 Mixture-of-Experts 아키텍처를 사용한다. 전체 요약 10문장 읽기 → 04 AI · 머신러닝 00:11 게시
원제 Verification Is Not Knowledge: Science needs more than answers
130 포인트 댓글 80
Key Point AI가 과학의 주도권을 가져가는 추세 속에서 검증 가능한 정답이 곧 지식이라는 착각이 과학 공동체의 기본 구조를 훼손할 수 있기 때문.
핵심 요약
과학의 진척을 정답의 검증으로만 재는 것이 잘못된 관점임을 지적하는 에세이. AI가 생성한 암 치료법이 형식적 정확성 인증과 3상 임상 통과를 갖추고도 인간이 그 원리를 이해하지 못할 때, 문제가 발생할 수 있다는 테리 타오의 사고 실험을 제시. 저자는 검증된 것이 실제 지식이 되려면 누군가 그에 책임질 수 있어야 하며, AI 저자는 그 주장을 설명하고 비판에 응할 수 없다는 점을 문제 삼음. 전체 요약 10문장 읽기 → 05 AI · 머신러닝 03:11 게시
원제 Distinct cellular and genetic differences in colorectal cancer in young patients
116 포인트 댓글 52
Key Point 50세 미만에서 대장암이 빠르게 증가하는 가운데, 연구팀이 젊은 환자의 종양이 세포 구성과 유전자 활동에서 근본적으로 다르다는 것을 처음으로 대규모로 규명했다.
핵심 요약
Dana-Farber 암 연구소와 Mass General Brigham, Broad Institute 연구팀이 젊은 환자의 대장암이 더 공격적인 이유에 대한 생물학적 단서를 밝혔다. Nature Medicine에 발표된 이 연구는 29세부터 90세 이상까지 189개 암 표본을 분석했으며, 이 중 50세 미만 진단 사례 54건과 50세 이상 135건을 포함했다. 단일핵 RNA 염기서열 분석 기술로 85만 개 이상의 암세포와 종양 내 다른 세포들의 유전자 활동을 측정했다. 전체 요약 11문장 읽기 → 06 AI · 머신러닝 03:11 게시
원제 There is no posttraining data commons
111 포인트 댓글 26
Key Point 프리트레이닝 시대의 인터넷 공용지가 없어진 지금, AI 기업들이 포스트트레이닝 데이터를 독점하려는 움직임 속에서 공용지 재건의 어려움과 필요성을 짚는다.
핵심 요약
프리트레이닝은 위키피디아, 스택 오버플로우, arXiv, 프로젝트 구텐베르크, 커먼 크롤 등이 만든 인터넷 공용지에 크게 의존했으며, GPT-3는 60% 이상 커먼 크롤 데이터로 학습했다. 포스트트레이닝은 문서 대신 작업(task)을 소비하는데, 인간의 작업은 순간적이고 상황에 맞추어진 반면 강화학습 작업은 고정되고 재현 가능해야 한다. 작업을 보존하려면 실행 환경, 의도, 상호작용 도구, 그리고 결과를 평가하는 채점자가 필요하다. 전체 요약 12문장 읽기 → 전체 색인2건 · 분야별
AI · 머신러닝2건 001 00:11 ▲ 100 · 댓글 48 LLM 용의자 심문하는 추리 게임 '언크래크드 시티' 출시 실제 도시를 배경으로 한 추리 게임으로, 플레이어가 장소를 수색하고 거짓말하는 LLM 용의자들을 심문해 범인을 찾아내는 게임이다. AI · 머신러닝 · Show HN: Uncracked City, detective game where you question LLM suspects that lie
Key Point LLM의 거짓 탐지 능력을 핵심 게임플레이로 삼은 새로운 형식의 추리 게임으로, 대화형 AI가 게임 엔터테인먼트에 어떻게 활용될 수 있는지 보여준다.
핵심 요약
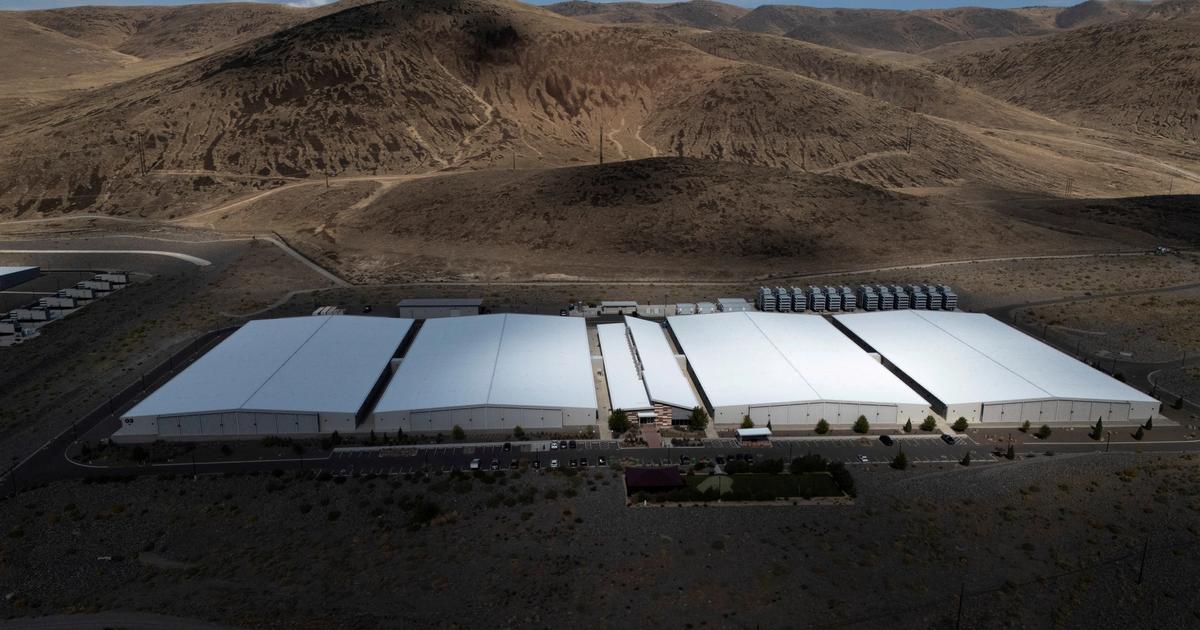
실제 도시를 배경으로 한 추리 게임으로, 플레이어가 장소를 수색하고 거짓말하는 LLM 용의자들을 심문해 범인을 찾아내는 게임이다. 용의자마다 고유한 음성으로 응답하며, 타이핑이나 음성으로 자유롭게 질문할 수 있고 6개 언어를 지원한다. 실마리를 단서와 대조해 거짓을 드러낸 뒤 수사 보고서를 작성하되, 3회 시도 내에 정답을 맞춰야 한다. 전체 요약 6문장 읽기 → 002 00:11 ▲ 105 · 댓글 102 데이터센터, 미국 전역 투표에서 대거 저지됐다 미국 유권자들이 투표에서 데이터센터 반대 측도를 대거 통과시켰다. 9개 주 30개 이상 지역에서 모라토리엄, 전면 금지 등의 조치가 채택됐다. AI · 머신러닝 · US voters roundly reject data centers in ballot measures
Key Point AI 인프라 확충의 핵심 자산인 데이터센터가 미국 전역에서 주민 투표로 저지당하면서 AI 붐의 현실적 장벽과 투자 환경 변화가 드러나고 있다.
핵심 요약
미국 유권자들이 투표에서 데이터센터 반대 측도를 대거 통과시켰다. 9개 주 30개 이상 지역에서 모라토리엄, 전면 금지 등의 조치가 채택됐다. 플로리다 에지워터시는 도시 헌장에 데이터센터 금지 조항을 포함했고, 오하이오 페리시는 대규모 클라우드 기업들에 조세감면 시 재정적·운영상 제약을 가하는 방안을 통과시켰다. 130개 이상의 연방 및 주지사 경선에서 민주당 후보들이 반기술 또는 반데이터센터 광고를 집행했고, 이로 인해 텍사스의 그렉 애벗 주지사 같은 AI 지지파 공화당 후보들도 강화된 규제를 약속하게 됐다. 전체 요약 5문장 읽기 → 오늘의 주요당일 스타 상위 4건
01 AI · 머신러닝 21:11 게시
NVIDIA/auto-ontology
원제 NVIDIA/auto-ontology
스타 4,446 당일 +2,053 Python
Key Point LLM 에이전트의 쿼리 정확성이 속도보다 중요한 엔터프라이즈 데이터 환경에서, 잘못된 답변을 줄이기 위해 비즈니스 개념을 명시적으로 정의하고 검증하는 새로운 아키텍처 패턴을 제시합니다.
핵심 요약
NVIDIA가 오픈소스 프레임워크 Auto-Ontology를 공개했으며, 이는 데이터 위에 시맨틱·그래프 기반 추론층을 만들어 에이전트가 더 정확한 답변을 제공할 수 있게 한다. 에이전트가 쿼리하기 전에 데이터의 위치, 의미, 사용 방법, 출처, 유사 데이터를 파악해야 신뢰할 수 있는 쿼리를 생성할 수 있다는 점이 핵심이다. 데이터베이스 메타데이터에서 온톨로지를 자동 생성하고, 비즈니스 용어를 컬럼에 매핑하며, 테이블 간 관계와 검수된 SQL을 저장한다. 전체 요약 13문장 읽기 → 02 AI · 머신러닝 00:11 게시
FareedKhan-dev/kimi-k3-in-c
원제 FareedKhan-dev/kimi-k3-in-c
스타 10,131 당일 +351 C
Key Point 거대 언어 모델을 GPU 없이 평범한 노트북에서 돌릴 수 있는 방법을 보여주는 사례로, CPU 기반 추론의 실용적 한계를 재정의한다.
핵심 요약
중국의 Kimi K3 모델(278조 파라미터)을 C99로 순수 CPU 추론하는 프로젝트다. 1.56TB 체크포인트를 디스크에서 스트리밍하면서 최소 8.24GB 메모리로 작동한다. BLAS, 프레임워크, GPU 없이 176KB 엔진만으로 구현했으며, 포괄적인 테스트와 참고 구현이 함께 제공된다. 전체 요약 12문장 읽기 → 03 AI · 머신러닝 21:11 게시
spotify/portal-ai-plugins
원제 spotify/portal-ai-plugins
스타 3,147 당일 +227 TypeScript
Key Point 개발팀이 사용하는 AI 코드 에디터에서 직접 조직의 소프트웨어 카탈로그와 운영 정보에 접근할 수 있게 되어, 코딩 중 컨텍스트 전환을 줄일 수 있다.
핵심 요약
스포티파이가 Claude Code, Codex, Cursor, pi 등 AI 코드 에디터를 위한 Portal AI 플러그인을 공개했다. Portal CLI를 통해 인증 설정, 소프트웨어 카탈로그 검색, 서비스 상태 리포트, 진단 실행, Portal 액션 실행 등의 워크플로우를 제공한다. 자연어 쿼리로 카탈로그와 기술 문서를 검색하고, 소유권·상태·장애·문서 정보를 담은 간결한 서비스 브리핑을 생성할 수 있다. 전체 요약 8문장 읽기 → 04 AI · 머신러닝 21:11 게시
scenario-labs/skills
원제 scenario-labs/skills
스타 2,273 당일 +224 Python
Key Point 생성형 AI를 활용한 콘텐츠 제작의 대규모 자동화를 원하는 개발자나 크리에이티브 팀이 직접 검토해볼 수 있는 체계적인 도구 모음이다.
핵심 요약
Scenario가 AI 코딩 에이전트(Claude Code, Cursor, Copilot 등 70개 이상)를 위한 에이전트 스킬을 공개했다. Scenario MCP 서버를 통해 이미지, 비디오, 오디오, 텍스처, 스카이박스, 3D 에셋 등 프로덕션급 콘텐츠를 생성할 수 있다. 게임 아트용 스프라이트, 타일셋, 아이콘부터 영상 광고, 음악, 음성, 자막 생성까지 100개 이상의 세분화된 스킬을 제공한다. 전체 요약 9문장 읽기 → 전체 색인2건 · 분야별
AI · 머신러닝2건 001 21:11 당일 +105 팀 단위로 움직이는 오픈소스 AI 에이전트 플랫폼 공개 Open Duet는 Grok Bot, Claude Duet 같은 상용 AI 협업 도구의 오픈소스 자체호스팅 대안으로, 이름 붙은 AI 에이전트들을 팀으로 조직하고 그들의 행동을 승인하기 전에 검토할 수 있다. AI · 머신러닝 · Anil-matcha/open-duet · Python
Key Point 개발팀 규모가 커질수록 AI 협업 도구의 팀 기능, 승인 워크플로우, 자체 제어 필요성이 중요해지는데, 이를 완전히 오픈소스로 구현한 첫 플랫폼이기 때문이다.
핵심 요약
Open Duet는 Grok Bot, Claude Duet 같은 상용 AI 협업 도구의 오픈소스 자체호스팅 대안으로, 이름 붙은 AI 에이전트들을 팀으로 조직하고 그들의 행동을 승인하기 전에 검토할 수 있다. 각 에이전트는 역할, 메모리, 루틴을 설정할 수 있으며 독립된 워크스페이스를 가지고 작동한다. 사용자는 에이전트들 간 권한 위임, 대화 맥락 유지, 정기적 작업 자동화, 도구 연결(GitHub, Gmail, Google Calendar 등) 기능을 사용할 수 있다. 전체 요약 8문장 읽기 → 002 21:11 당일 +126 Octomind: AI 코딩 에이전트를 위한 오픈소스 런타임 Rust 단일 바이너리로 빌드된 오픈소스 AI 코딩 에이전트 하네스로, 모든 LLM 모델을 지원하며 대화형 CLI, stdin 파이프, 데몬, WebSocket, ACP 에디터 인터페이스 등 다섯 가지 실행 환경을 제공한다. AI · 머신러닝 · Muvon/octomind · Rust
Key Point CI 환경과 데몬에서도 자동으로 작동할 수 있는 프로덕션급 AI 에이전트 프레임워크로, 정책을 코드화하여 수동 승인의 병목을 제거하고 비용 효율성도 입증했다.
핵심 요약
Rust 단일 바이너리로 빌드된 오픈소스 AI 코딩 에이전트 하네스로, 모든 LLM 모델을 지원하며 대화형 CLI, stdin 파이프, 데몬, WebSocket, ACP 에디터 인터페이스 등 다섯 가지 실행 환경을 제공한다. 기존 에이전트들이 위험한 작업 전마다 사용자 승인을 요청하는 방식과 달리, Octomind는 정책을 TOML 가드레일로 코드화하고 감시 모델을 추가하여 자동으로 작동할 수 있다. 파일 읽기/수정, 셸 실행, 코드 검색, 하위 에이전트 위임 등의 기능을 MCP(Model Context Protocol)를 통해 제공하며, 각 기능은 on-demand로 스킬 시스템을 통해 활성화된다. 전체 요약 14문장 읽기 → 읽을 논문
Hugging Face Papers03 커뮤니티가 고른 오늘의 AI 논문
오늘의 주요추천 상위 3건
01 AI · 머신러닝 00:11 게시
원제 Mage-VL-Cowork: A Full Training Recipe to Learn Hybrid Computer Use From Evolved Harnesses
추천 11 댓글 1 Xiaoyi Zhang, Haoqing Wang, Xinjie Zhang 외
Key Point 파라미터 수가 작으면서도 복잡한 컴퓨터 조작 작업을 수행할 수 있는 에이전트 개발 방법이 제시되어, 온디바이스 AI 활용과 효율적인 에이전트 학습의 새로운 가능성을 보여준다.
핵심 요약
Mage-VL-Cowork는 GUI 상호작용과 코드·터미널 실행을 하나의 정책으로 통합하는 4B 파라미터 하이브리드 컴퓨터 사용 에이전트(CUA)다. 일반적인 멀티모달 정렬 체크포인트에서 출발해 미드트레이닝·감독학습·강화학습을 포함한 5단계 점진적 교육 과정을 거친다. Mage-CUA-Forge는 작업별 에이전트 구성을 재사용 가능한 스킬 조건부 생성 워크플로우로 대체하여 293,806개의 데스크톱·웹 작업을 6,915개 스킬로 합성한다. 전체 요약 7문장 읽기 → 02 AI · 머신러닝 03:11 게시
원제 Recursa: Toward Recursively Self-Improving Foundation Model Systems
추천 10 댓글 1 Erkang Zhu, Yin Lin, Xiaorong Shi 외
Key Point Foundation models의 도메인 외 지식 한계를 인간 개입 없이 자동으로 극복하는 방식이 제시되어, AI 시스템이 스스로 학습·개선되는 경로를 보여준다.
핵심 요약
Foundation models는 원래 학습하지 않은 새로운 도메인의 지식을 마주칠 때 적응하기 어려우며, 이러한 새 도메인에서 충분한 전문가 데이터나 신뢰할 수 있는 감독 신호를 얻기 어렵다. Recursa는 인간 전문가나 더 강한 교사 모델 없이 자신의 경험으로부터 학습하여 새로운 도메인에 적응하는 기반 모델 시스템이다. 도메인별 스킬과 적용 시점, 과거 작업 경험의 기억, 개선할 점에 대한 반성을 저장하는 지식 저장소를 사용하며, 도메인 자료로부터 저장소를 초기화한 뒤 재귀적 자기 개선을 통해 정제한다. 전체 요약 5문장 읽기 → 03 AI · 머신러닝 00:11 게시
원제 Library of Layers (LoL): Adaptively Ordering Transformer Layers at Runtime
추천 10 댓글 1 Abdellah Rahmani, Sean McLeish, Ang Li 외
Key Point 프로그래머가 같은 명령을 다른 순서로 조합하듯, 트랜스포머도 레이어 순서를 문제별로 동적 선택하면 파라미터와 연산량을 동시에 절약하면서 더 해석 가능한 모델을 만들 수 있다는 점이 중요하다.
핵심 요약
연구팀은 기존 언어 모델처럼 고정된 레이어 순서로 실행하는 대신, 추론 시 동적으로 레이어 순서를 재배열하는 Library of Layers(LoL) 아키텍처를 제안했다. LoL은 트랜스포머 블록의 글로벌 라이브러리 크기 하나의 하이퍼파라미터로 조절하면서 파라미터 재사용과 희소성 사이를 자유롭게 전환할 수 있다. 이를 통해 기존의 밀집 아키텍처, 깊이-순환 모델, 혼합 전문가(MoE) 아키텍처의 파라미터 효율성과 연산량 효율성 트레이드오프를 하나의 통합 체계 안에서 일반화한다. 전체 요약 8문장 읽기 → 오늘의 주요최신순 상위 1건
01 AI · 머신러닝 03:11 게시
langchain-ai/langchain
원제 langchain-ai/langchain langchain-core==1.7.5
langchain-core==1.7.5
Key Point LLM 거부 응답 처리 방식이 표준화되고 크로스 플랫폼 호환성이 개선됐으므로 LangChain을 사용하는 개발자들이 확인해야 한다.
핵심 요약
LangChain Core 1.7.5가 릴리스됐다. Gemini 안전 차단(safety blocks)을 거부 콘텐츠 블록으로 변환하는 기능이 추가됐다. 모델 거부 콘텐츠 블록이 표준화됐다. 전체 요약 5문장 읽기 → ● 이번 피드는 여기까지입니다.
작은 발견을 다음 커밋으로 이어가세요. 모든 발행본