쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
40건 · "메모리 효율"조건 지우기 ×
001 09:11 새 버전 올라마 0.40.16 출시, Ripple 모델 지원 추가 올라마 v0.40.16이 릴리스되었다. 오픈소스 · 도구 · ollama/ollama@v0.40.16
Key Point 로컬 LLM 개발·배포의 중심 도구인 올라마의 기능 확대와 최적화가 이뤄졌으며, 특히 65B 코딩 전문 모델 추가와 메모리 효율성 개선으로 실무 적용 성이 높아진다.
핵심 요약
올라마 v0.40.16이 릴리스되었다. Recursive Intelligence의 Ripple Preview라는 65B 규모 에이전틱 코딩 모델을 새로 지원한다. Qwen3.8 Flash는 애플 실리콘에서 약 27GB 메모리를 절약하도록 최적화되었다. 전체 요약 9문장 읽기 → 002 12:11 ▲ 272 · 댓글 45 터미널 에뮬레이터 라이브러리 libghostty 1.0 정식 릴리스 Ghostty의 핵심에서 추출한 고성능 C 터미널 에뮬레이션 라이브러리 libghostty-vt 1.0이 정식 출시되었으며, 라이브러리와 C ABI가 안정화되었다. 오픈소스 · 도구 · Libghostty 1.0
Key Point JetBrains IDE 1,250만 사용자, Neovim 등 주요 오픈소스 프로젝트가 채택한 터미널 라이브러리의 정식 출시로, 이제 ABI 안정성 보장하에 다양한 플랫폼과 언어로 임베딩할 수 있게 되었다.
핵심 요약
Ghostty의 핵심에서 추출한 고성능 C 터미널 에뮬레이션 라이브러리 libghostty-vt 1.0이 정식 출시되었으며, 라이브러리와 C ABI가 안정화되었다. JetBrains IDE의 터미널이 libghostty로 교체되어 1,250만 이상의 활성 사용자가 libghostty 기반 터미널을 사용 중이며, Neovim도 libvterm을 대체할 PR이 승인되었다. KDE의 Konsole 대체 개발, Vercel의 Turborepo, devenv, OrbStack 등 다양한 제품과 도구가 libghostty를 채택했고, herdr, cmux 같은 새 터미널 및 에이전틱 코딩 도구들이 기반으로 사용 중이다. 전체 요약 15문장 읽기 → 003 12:54 ▲ 11 · 댓글 2 루프 구조 언어 모델 Dory1.0-4B 공개, 작은 규모로 더 큰 모델 능력 구현 Hugging Face와 아카이브 논문 공개: 43억 파라미터 규모의 루프형 언어 모델 Dory1.0-4B를 발표했다. AI · 머신러닝 · Dory1.0-4B: A Looped Normalized-GPT
Key Point 작은 규모 모델이 루프 구조를 통해 더 큰 모델 수준의 성능을 달성할 수 있다는 것을 보여주며, 토큰 생성 효율과 메모리 사용 최적화 방식이 에지 디바이스와 추론 비용 절감에 영향을 미친다.
핵심 요약
Hugging Face와 아카이브 논문 공개: 43억 파라미터 규모의 루프형 언어 모델 Dory1.0-4B를 발표했다. 정규화 Transformer 기반으로 입력 블록, 공유 루프 블록, 출력 블록으로 구성하며, 추론 시 루프 블록을 가변 횟수로 반복 실행할 수 있다. 6조 개 토큰으로 사전 학습했으며, 초기 4.5조 토큰은 NVFP4 양자화로 학습했고 이후 컨텍스트 길이를 256K로 확장했다. 전체 요약 9문장 읽기 → 004 21:11 ▲ 21 · 댓글 3 LLM 자기증류 학습의 메모리 효율을 높인 뮤온 최적화 기법 자기증류(Self-Distillation) 방식의 LLM 학습에서 지수이동평균(EMA) 기반 교사 모델이 이미 학생 업데이트 이력을 보유하고 있는데도 기존 뮤온 옵티마이저는 별도의 모멘텀 버퍼를 유지해 메모리를 낭비한다. AI · 머신러닝 · MUON-RT Reusing the Teacher's Trajectory for Momentum-Free Muon for LLM Self-Distillation
Key Point 메모리 오버헤드를 크게 줄이면서도 LLM 학습 성능을 개선하는 옵티마이저 개선으로, 제한된 리소스에서 대규모 모델을 학습하려는 개발자들에게 직접적인 영향이 있다.
핵심 요약
자기증류(Self-Distillation) 방식의 LLM 학습에서 지수이동평균(EMA) 기반 교사 모델이 이미 학생 업데이트 이력을 보유하고 있는데도 기존 뮤온 옵티마이저는 별도의 모멘텀 버퍼를 유지해 메모리를 낭비한다. 뮤온-알티(Muon-RT)는 교사-학생 간 변위(displacement)를 재사용해 숨겨진 가중치 행렬의 모멘텀 버퍼를 제거한다. 이 변위가 적용된 업데이트의 지수가중 이력을 인코딩하며 시간적으로 상관없는 노이즈를 평활한다는 것을 로컬 모델 가정 하에서 증명했다. 전체 요약 7문장 읽기 → 005 21:11 당일 +133 힙 할당·가비지콜렉션 없는 메모리 안전 언어 Goose 공개 C/Rust 문법과 유사하지만 힙이 없는 메모리 안전 시스템 프로그래밍 언어 Goose를 공개했다. 오픈소스 · 도구 · aardappel/goose · C++
Key Point 기존 저수준 언어의 성능·메모리 효율과 안전성 사이 트레이드오프를 없애는 새로운 메모리 모델이 주목할 만하다.
핵심 요약
C/Rust 문법과 유사하지만 힙이 없는 메모리 안전 시스템 프로그래밍 언어 Goose를 공개했다. 모든 동적 값이 컴파일러가 관리하는 데이터 스택에 인라인으로 저장되고, 스코프 종료 시 메모리가 자동 해제된다. 16개 벤치마크 기준 C++보다 3.3배, 최적화된 C++보다 1.16배, 안전한 Rust보다 1.12배 빠르며 메모리는 각각 1.9배, 1.3배, 1.2배 적게 사용한다. 전체 요약 13문장 읽기 → 006 03:10 ▲ 145 · 댓글 93 가벼운 LLM 코딩 에이전트 'Prospero' 출시 개발자가 로컬 LLM으로 프로그래밍 작업을 하도록 돕는 '코딩 하네스'를 직접 개발했다. AI · 머신러닝 · Prospero: A new coding harness for a more civilized age
Key Point 로컬 LLM으로 자동화된 개발 작업이 가능한 실용적인 도구가 나왔으며, 기존 도구 대비 훨씬 가볍고 안정적으로 설계되어 에이전트 기반 개발 워크플로우를 본격적으로 실험할 수 있다.
핵심 요약
개발자가 로컬 LLM으로 프로그래밍 작업을 하도록 돕는 '코딩 하네스'를 직접 개발했다. 기존 도구들이 웹 스택 기반이라 수GB 메모리를 소비하는 문제를 해결하기 위해 C++와 Dear ImGui로 작성하여 기존 도구 대비 100배 적은 리소스를 사용한다. llama.cpp, OpenRouter, Anthropic API 등 외부 모델 제공자와 연동하며, 내장 모델 공급자는 없다. 전체 요약 13문장 읽기 → 007 12:11 ▲ 148 · 댓글 8 라즈베리파이 피코에서 신경망 게임 엔진 구현 임베디드 마이크로컨트롤러인 라즈베리파이 피코 2 W에서 신경망 기반 게임 엔진을 구현했다. 세계 모델 네트워크가 현재 프레임과 액션에서 다음 프레임과 보상을 예측하고, 액터 네트워크가 그 생성된 프레임에서 액션을 선택한다. AI · 머신러닝 · A tiny world model running games on a Raspberry Pi Pico 2 W
Key Point 라즈베리파이 같은 극도로 제한된 임베디드 환경에서 신경망으로 게임을 생성하고 플레이하는 새로운 방식이 작동한다는 것을 보여주며, 마이크로컨트롤러에서 머신러닝 모델을 실행하는 방법의 한계를 재정의한다.
핵심 요약
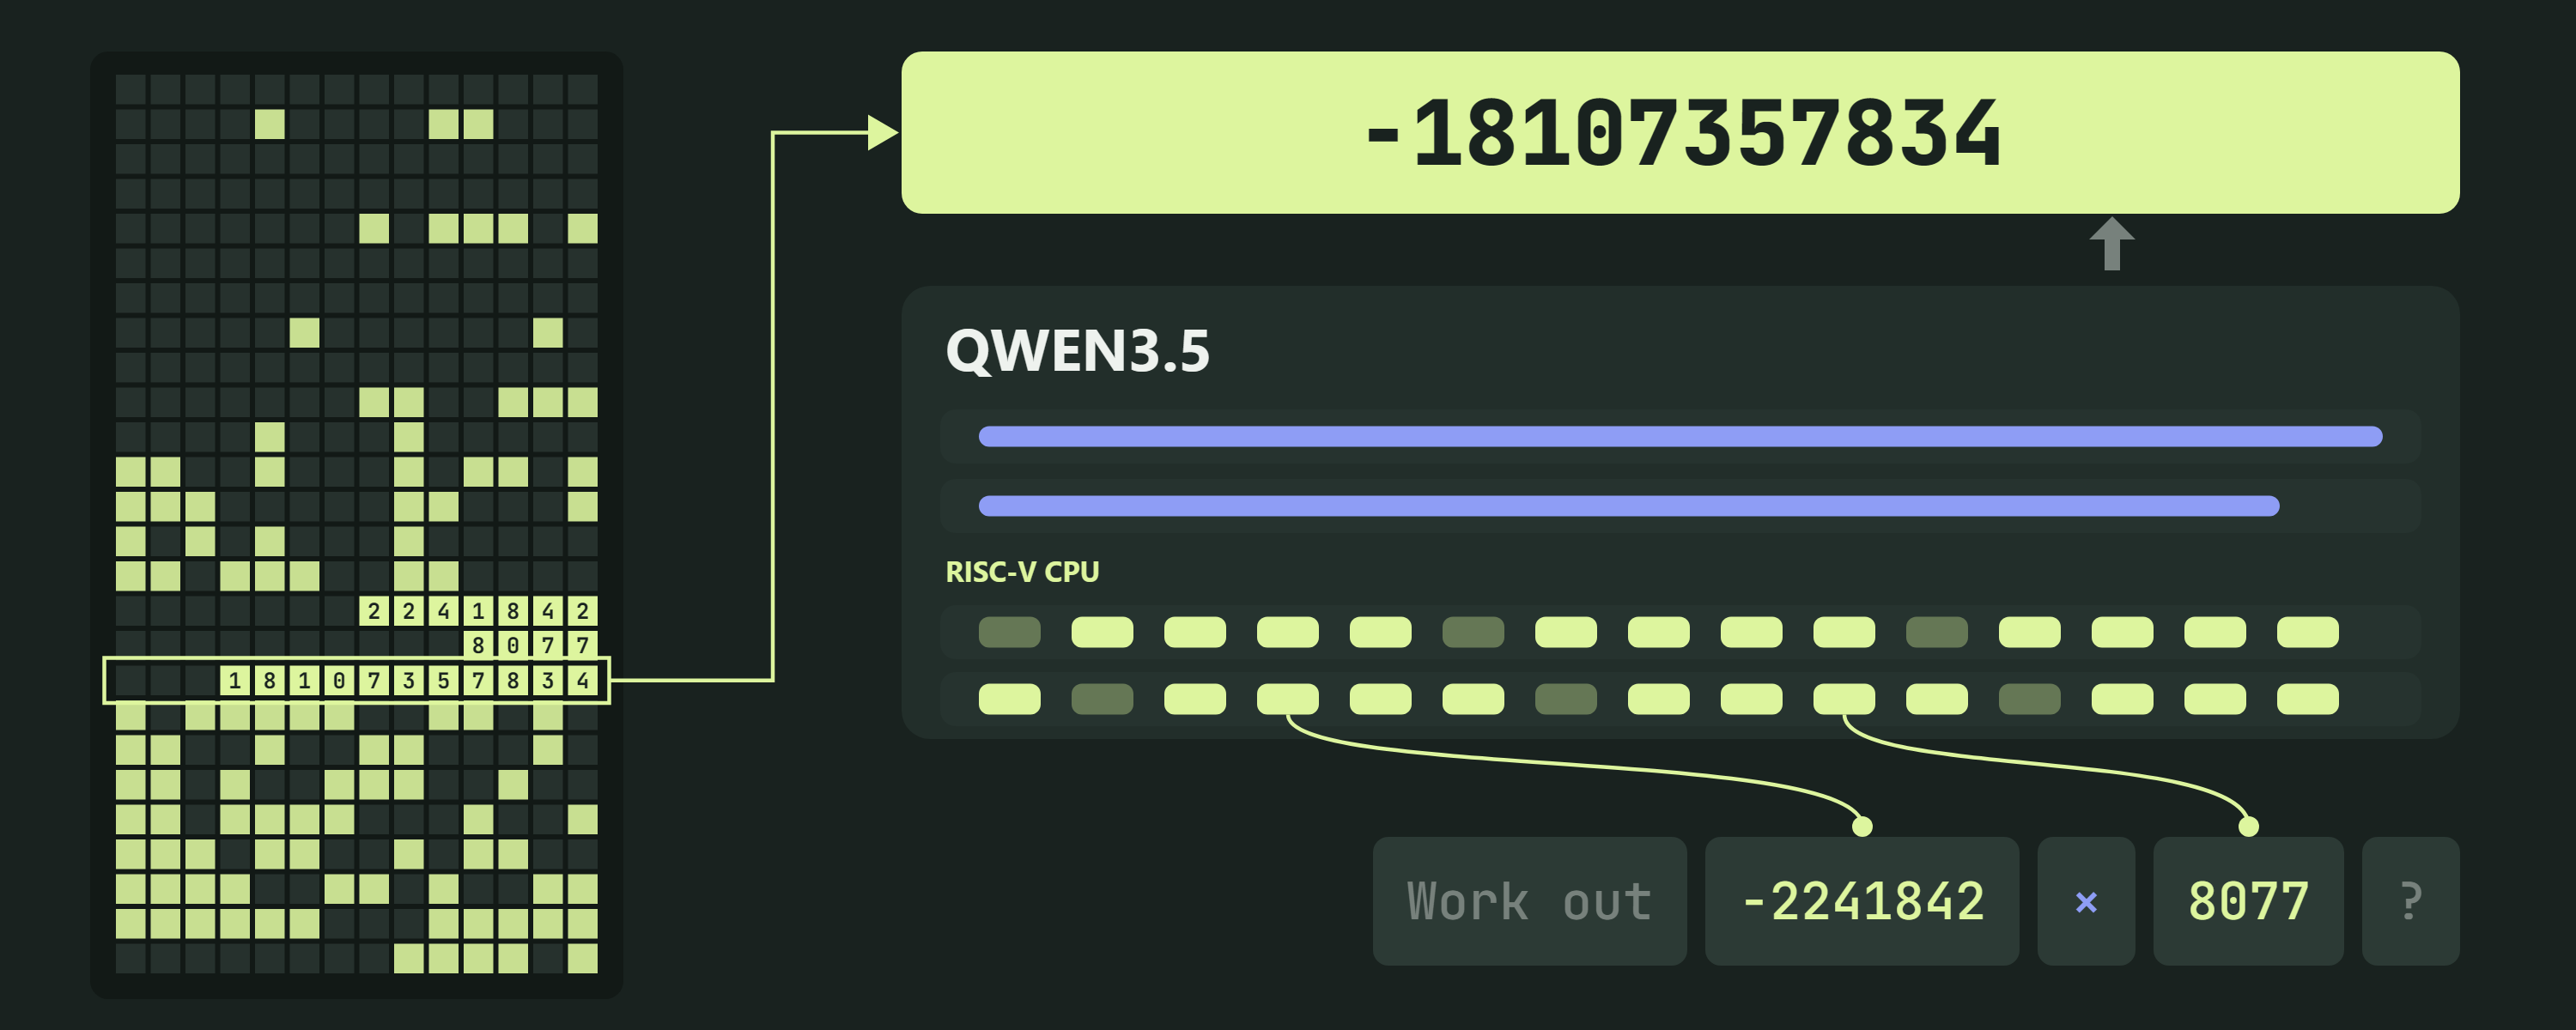
임베디드 마이크로컨트롤러인 라즈베리파이 피코 2 W에서 신경망 기반 게임 엔진을 구현했다. 세계 모델 네트워크가 현재 프레임과 액션에서 다음 프레임과 보상을 예측하고, 액터 네트워크가 그 생성된 프레임에서 액션을 선택한다. 반복 트랜스포머(looped transformer) 구조를 사용해 같은 가중치를 1~4회 반복 적용함으로써 메모리 효율을 높였다. 26k~131k 매개변수의 세계 모델과 9k~16k 매개변수의 액터 네트워크를 탑재했다. 브레이크아웃(정확도 99.99%), 플래피 버드(100%), 팩맨 라이트(86.4%) 등 5개 게임을 구현했으며, 각 게임은 토큰 기반으로 분할된 프레임을 처리한다. 세계 모델은 배경 셀은 독립적으로 예측하되, 공이나 플레이어 같은 단일체는 한 번만 배치되도록 디코딩 규칙을 적용했다. 전체 요약 12문장 읽기 → 008 12:11 ▲ 140 · 댓글 34 Qwen 가중치에 내장된 RISC-V CPU, 정확하게 동작하다 Qwenputer는 Qwen 3.5 4B에 RISC-V CPU를 모델 가중치에 직접 컴파일한 실험적 모델로, 모델의 Gated DeltaNet 어텐션 레이어를 RAM으로 사용한다. AI · 머신러닝 · Qwenputer: A functioning, deterministic RISC-V CPU inside Qwen3.5
Key Point 언어 모델이 외부 도구 없이 정확한 산술 계산과 파일 저장을 수행할 수 있다는 새로운 가능성을 보여주며, AI 안전성 연구와 해석가능성 측면에서도 중요한 아키텍처 실험이다.
핵심 요약
Qwenputer는 Qwen 3.5 4B에 RISC-V CPU를 모델 가중치에 직접 컴파일한 실험적 모델로, 모델의 Gated DeltaNet 어텐션 레이어를 RAM으로 사용한다. Gated DeltaNet 레이어의 게이트를 1로, 쓰기 강도를 1로, 원-핫 키 인코딩을 사용하면 정확한 주소 지정이 가능한 RAM이 되며, 이는 일반 어텐션의 KV 캐시보다 메모리 효율이 높다. CPU는 32비트 RISC-V 코어(RV32IM 명령어 세트)로 모델의 처음 11개 레이어를 차지하며, 컴파일러가 회로 설명을 트랜스포머 레이어의 어텐션 헤드와 피드포워드 유닛으로 변환한다. 전체 요약 11문장 읽기 → 009 09:11 ▲ 110 · 댓글 40 리퀴드 AI, 멀티모달 소형 모델 LFM3 공개 리퀴드 AI가 2B 파라미터 규모의 멀티모달 파운데이션 모델 LFM3를 출시했다. 텍스트, 비전, 오디오, 옴니(멀티모달), 의사결정 모델을 하나의 백본에서 제공한다. AI · 머신러닝 · Introducing LFM3: Every Modality for Specialized Intelligence
Key Point 클라우드 없이 로컬 기기에서 텍스트·비전·오디오를 모두 처리할 수 있는 2B급 모델이 나왔으며, 에이전트 작업에서 훨씬 큰 모델들과 경쟁한다는 점이 온디바이스 AI 실용화의 진전을 의미한다.
핵심 요약
리퀴드 AI가 2B 파라미터 규모의 멀티모달 파운데이션 모델 LFM3를 출시했다. 텍스트, 비전, 오디오, 옴니(멀티모달), 의사결정 모델을 하나의 백본에서 제공한다. LFM3는 새로운 하이브리드 아키텍처와 22T 토큰 사전학습으로 LFM2보다 표현력이 뛰어나면서도 효율성을 유지한다. 로컬 파인튜닝, 모든 기기에서 실행, 전문 작업 최적화가 가능하다. 아키텍처는 13개 계층의 게이트 단락 컨볼루션, 5개 계층의 슬라이딩-윈도우 어텐션(256 토큰 윈도우), 6개 계층의 글로벌 어텐션을 조합한다. 커널 크기를 3에서 7로 확대했다. 전체 요약 10문장 읽기 → 010 12:11 새 버전 uv 0.13.6 출시, 대규모 프로젝트 메모리 사용량 대폭 감축 uv 0.13.6이 2026년 10월 26일 출시되었다. 오픈소스 · 도구 · astral-sh/uv@0.13.6
Key Point Python 패키지 관리자 uv의 주요 성능 개선판으로, 메모리 효율을 크게 높였고 여러 버그를 수정하여 대규모 프로젝트 작업 시 안정성이 향상되었다.
핵심 요약
uv 0.13.6이 2026년 10월 26일 출시되었다. CPython 3.11.18, 3.12.16, 3.13.18, 3.14.10, 3.15.2 버전을 추가 지원한다. 대규모 워크스페이스 의존성 해결 시 메모리 사용량을 여러 최적화를 통해 감축했고, 대규모 프로젝트 락·업그레이드 시에도 메모리 사용량을 줄였다. 전체 요약 9문장 읽기 → 011 09:11 ▲ 192 · 댓글 145 메모리 안전성과 성능을 모두 잡은 구스 언어 공개 Goose는 힙 할당자, 가비지 컬렉터, 라이프타임 애너테이션이 없는 메모리 안전 시스템 언어로, C와 Rust 문법을 따릅니다. 오픈소스 · 도구 · The Goose Programming Language
Key Point 힙 할당·가비지 컬렉션·라이프타임 문법을 모두 제거하면서도 안전성을 보장해 C++과 Rust보다 빠르고 메모리 효율적인 새로운 시스템 언어 설계가 실제로 동작하는 방식을 보여줍니다.
핵심 요약
Goose는 힙 할당자, 가비지 컬렉터, 라이프타임 애너테이션이 없는 메모리 안전 시스템 언어로, C와 Rust 문법을 따릅니다. 벤치마크 16개 기준 구스는 일반적인 C++보다 3.3배, 손으로 최적화한 C++보다 1.16배, 안전한 Rust보다 1.12배 빠르면서 메모리는 1.9배, 1.3배, 1.2배 적게 씁니다. 컴파일러가 정적으로 할당하는 데이터 스택 위에 모든 동적 값이 인라인으로 살며, 스코프 끝에서 한 번의 저장 명령으로 메모리가 해제됩니다. 전체 요약 12문장 읽기 → 012 18:11 ▲ 155 · 댓글 3 기초 모델에 메모리 능력을 내장한 MemT-1.0 공개 메모리를 모델 계산의 일부로 내재화하는 메모리 네이티브 기초 모델 MemT-1.0을 소개한다. AI · 머신러닝 · MemT-1.0: Towards Memory-Native Evolution
Key Point 장기 컨텍스트 처리 시 메모리 효율과 추론 속도를 동시에 개선하는 아키텍처로, 외부 검색에 의존하지 않고 내부 메모리만으로 작동하는 모델의 가능성을 보여준다.
핵심 요약
메모리를 모델 계산의 일부로 내재화하는 메모리 네이티브 기초 모델 MemT-1.0을 소개한다. Metis를 기반으로 Gated DeltaNet-2 아키텍처를 채용하며, 턴마다 안정적인 토큰 수준 메모리 업데이트 메커니즘을 사용한다. 메모리 용량 확장을 위해 Mixture-of-Storage를 도입했다. 전체 요약 8문장 읽기 → 013 18:11 ▲ 28 · 댓글 2 LLM 에이전트의 메모리 효율화, 강화학습으로 최적화 LLM 에이전트 시스템에서 메모리는 상호작용 간 정보 보유와 재사용을 지원하지만, 기존 방식은 쿼리를 고려하지 않고 메모리를 구축해 불필요한 전처리 비용과 정보 손실을 초래한다. AI · 머신러닝 · MemPilot: Orchestrating On-Demand Multimodal Memory Curation for LLM Agents
Key Point LLM 에이전트가 상황에 맞게 메모리 처리 비용을 조절할 수 있게 함으로써, 가격과 속도 제약이 있는 실제 배포 환경에서 실용적인 선택지를 제공한다.
핵심 요약
LLM 에이전트 시스템에서 메모리는 상호작용 간 정보 보유와 재사용을 지원하지만, 기존 방식은 쿼리를 고려하지 않고 메모리를 구축해 불필요한 전처리 비용과 정보 손실을 초래한다. MemPilot은 성능·비용·지연 시간 우선순위에 따라 요청 시 메모리를 정리하는 유연한 프레임워크를 제시한다. 강화학습으로 최적화한 다단계 정책을 통해 사전 구축 메모리 검색과 쿼리 특화 정리 중 선택하며, 증거량·정리 지시·모델 선택·이미지 접근을 통합 제어한다. 전체 요약 7문장 읽기 → 014 12:11 ▲ 14 · 댓글 2 선형 어텐션의 오래된 맥락 처리 능력 끌어올리기 선형 어텐션은 효율성이 필요한 긴 맥락 언어 모델링을 약속하지만, 고정 크기의 순환 상태로 현재 계산을 지원하면서 동시에 계속 증가하는 히스토리 정보를 보존해야 하는 딜레마가 있다. AI · 머신러닝 · History Replays Itself: Unleashing Long-Context Capability in Linear Attention
Key Point 선형 어텐션 모델의 가장 큰 약점인 긴 맥락 처리를 메모리 오버헤드 거의 없이 해결하는 방법을 제시해 실용적 배포 가능성을 높였다.
핵심 요약
선형 어텐션은 효율성이 필요한 긴 맥락 언어 모델링을 약속하지만, 고정 크기의 순환 상태로 현재 계산을 지원하면서 동시에 계속 증가하는 히스토리 정보를 보존해야 하는 딜레마가 있다. 기존에는 이 순환 상태의 메모리 용량이 모델의 긴 맥락 처리 능력의 상한선을 정한다고 여겨졌으나, 연구팀은 순환 계산이 장기 저장의 모든 부담을 질 필요가 없다는 점을 제시한다. NoteBank라는 희소 에피소드 메모리를 도입했으며, 이는 미래 쿼리를 알기 전에 선택된 텍스트를 보관하고, 백본의 기본 특징으로 읽고 쓰며, 재생을 통해 네이티브 순전파 계산으로 검색된 증거를 읽는다. 전체 요약 8문장 읽기 → 015 21:11 ▲ 34 · 댓글 2 동영상 초고화질화, 일반 GPU로 4K 실시간 처리 가능해졌다 기존 동영상 초고화질화(VSR) 모델이 확산 증류를 통해 한 단계 생성으로 효율성을 높였으나, 고해상도 추론 비용이 크고 생성 결과가 사용자 선호와 맞추기 어려운 문제가 있었다. AI · 머신러닝 · FlashVSR+: Efficient Video Super-Resolution via Hybrid Attention and Reward-Yield Distribution Matching
Key Point 동영상 초고화질화가 실용적인 수준의 속도와 메모리 효율로 4K 고해상도 처리가 가능해지면서, 콘텐츠 제작자와 개발자들이 일반 사양 GPU에서도 고품질 영상 생성을 구현할 수 있게 되었다.
핵심 요약
기존 동영상 초고화질화(VSR) 모델이 확산 증류를 통해 한 단계 생성으로 효율성을 높였으나, 고해상도 추론 비용이 크고 생성 결과가 사용자 선호와 맞추기 어려운 문제가 있었다. FlashVSR+는 하이브리드 어텐션 메커니즘을 도입해 사전학습된 VSR 모델의 강한 지역성(locality)을 활용하면서 장거리 일관성을 위해 희소 전역 상호작용을 유지한다. 이를 통해 DiT 속도를 최대 2배 높이고 피크 메모리를 45% 감소시켜, RTX 4090 24GB 단일 GPU에서 타일 분할 없이 4K 영상 초고화질화를 가능하게 했다. 전체 요약 7문장 읽기 → 016 15:11 ▲ 150 · 댓글 67 Intel, 에이전트 AI 전용 D270 GPU 공개…최대 480GB LPDDR5X 메모리 인텔이 AI 추론 전용 데이터센터 GPU 'D270'을 발표했다. 하드웨어 · 시스템 · Intel D270 GPU AI Accelerator–Up to 480 GB LPDDR5X
Key Point 에이전트 AI 시대 장문맥·고동시성 추론의 메모리 병목을 겨냥한 표준 인프라 기반 GPU로, NVIDIA 중심 시장에 대안을 제시하는 시점의 신제품이다.
핵심 요약
인텔이 AI 추론 전용 데이터센터 GPU 'D270'을 발표했다. D270은 최대 480GB LPDDR5X 메모리, 32개 Xᵉ3P 코어, 256개 XMX 매트릭스 엔진을 탑재하고 350W 공기냉식으로 동작한다. 에이전트 AI 워크로드의 특징인 긴 컨텍스트, 다중 단계 작업, 프리필 중심 연산에 최적화됐다. 전체 요약 8문장 읽기 → 017 21:11 당일 +529 PyTorch: GPU 가속 텐서 연산과 동적 신경망 PyTorch는 Python 기반 딥러닝 프레임워크로 GPU 가속을 통한 텐서 연산과 테이프 기반 자동미분 시스템을 제공한다. AI · 머신러닝 · pytorch/pytorch · Python
Key Point PyTorch는 현대 AI 개발의 핵심 프레임워크로, GPU 가속 능력과 동적 신경망 구축의 유연성이 산업 표준이 되었으므로 최신 버전과 설치 옵션을 파악하는 것이 필수다.
핵심 요약
PyTorch는 Python 기반 딥러닝 프레임워크로 GPU 가속을 통한 텐서 연산과 테이프 기반 자동미분 시스템을 제공한다. torch, torch.autograd, torch.nn, torch.multiprocessing, torch.utils 등 핵심 컴포넌트로 구성되어 있으며 NumPy 대체제 또는 딥러닝 연구 플랫폼으로 사용된다. CPU 또는 GPU에서 실행되는 텐서 라이브러리로 슬라이싱, 인덱싱, 선형대수 등 다양한 연산을 고속으로 수행하며 Intel MKL, NVIDIA cuDNN, NCCL 등 가속 라이브러리를 통합한다. 전체 요약 12문장 읽기 → 018 12:11 ▲ 12 · 댓글 2 비전 토큰 50% 줄이고 성능 99.5% 유지하는 압축 기법 Vision-language 모델은 강력하지만 비전 토큰이 입력 시퀀스의 대부분을 차지해 계산 비용이 크다는 문제가 있다. AI · 머신러닝 · V-CoLA: Vision Token Compression with Linear Attention
Key Point 선형 어텐션 기반 비전-언어 모델에서 기존 압축 방법이 작동하지 않는 문제를 해결하는 새로운 접근법으로, 실무 배포 시 추론 속도와 메모리 효율을 크게 개선할 수 있다.
핵심 요약
Vision-language 모델은 강력하지만 비전 토큰이 입력 시퀀스의 대부분을 차지해 계산 비용이 크다는 문제가 있다. 선형 어텐션을 활용한 하이브리드 아키텍처(예: Qwen3.5)가 등장하면서 기존 소프트맥스 기반 압축 방법들이 성능 저하를 보인다. 연구팀은 선형 어텐션에 특화된 훈련 불필요 토큰 압축 프레임워크 V-CoLA를 제안했다. 전체 요약 7문장 읽기 → 019 21:11 당일 +119 AI 개발 에이전트를 위한 Ghostty 기반 macOS 터미널 cmux Ghostty 기반의 네이티브 macOS 터미널 앱으로 수직 탭, 알림 시스템, 내장 브라우저를 제공한다. 기타 · manaflow-ai/cmux · Swift
Key Point AI 에이전트 기반 개발 워크플로우를 macOS에서 효율적으로 관리할 수 있는 네이티브 터미널 앱으로, 여러 에이전트를 동시에 실행하면서 각각의 상태를 시각적으로 추적해야 하는 개발자에게 필수적인 도구다.
핵심 요약
Ghostty 기반의 네이티브 macOS 터미널 앱으로 수직 탭, 알림 시스템, 내장 브라우저를 제공한다. Swift와 AppKit으로 작성되어 Electron 앱보다 빠르고 메모리 효율적이며, libghostty를 사용한 GPU 가속 렌더링을 지원한다. AI 코딩 에이전트가 입력을 기다릴 때 관련 창에 파란 고리 표시와 탭 강조를 제공하고, 알림 패널에서 모든 대기 중인 알림을 한곳에서 확인할 수 있다. 전체 요약 9문장 읽기 → 020 18:33 ▲ 14 · 댓글 2 LLM 강화학습의 메모리 병목을 저랭크 그래디언트로 풀다 강화학습(RL)은 대규모언어모델(LLM)의 성능을 높였지만 메모리 수요가 채택의 걸림돌이 되고 있다. AI · 머신러닝 · LoGRA: Scaling LLM Reinforcement Learning with Low-Rank Gradient Sketches
Key Point LLM 강화학습 훈련의 메모리 효율을 45% 이상 개선해 더 큰 모델과 리소스 제약 환경에서의 RL 훈련을 실용적으로 만든다.
핵심 요약
강화학습(RL)은 대규모언어모델(LLM)의 성능을 높였지만 메모리 수요가 채택의 걸림돌이 되고 있다. LoGRA는 유용한 학습 신호를 저랭크 그래디언트 스케치로 압축해 메모리 사용량을 줄이는 RL 후훈련 기법이다. 이 컴팩트한 표현은 모델 업데이트와 효율적인 정책 동기화 모두를 지원한다. 전체 요약 7문장 읽기 → 021 18:33 ▲ 20 · 댓글 2 대화 메모리, 추출보다 선택이 충분할 수 있다 대화 메모리를 LLM이 추출한 사실로 유지할 필요가 있는지, 아니면 원본 대화에서 잘 선택한 부분으로 충분한지를 묻는 연구를 진행했다. AI · 머신러닝 · When Does Selection Replace Extraction? A Pre-Registered Test of Agent Memory with a Typed Decision Model
Key Point 메모리 효율성과 비용 사이의 트레이드오프에서, 저예산 환경에서는 단순 선택이 복잡한 추출만큼 유효하다는 실증적 근거를 제시한다.
핵심 요약
대화 메모리를 LLM이 추출한 사실로 유지할 필요가 있는지, 아니면 원본 대화에서 잘 선택한 부분으로 충분한지를 묻는 연구를 진행했다. Jev라는 유형화된 의사결정 모델로 원본 대화를 선택한 결과, LLM 추출 메모리와 비교해 동등한 성능을 보였고(95% 신뢰도, -3.0점 여유), 원본 글쓰기 비용은 3,061배 낮았다. 인간 평가자 블라인드 채점에서도 차이가 좁혀졌지만 결과는 유지되었으며, 다른 응답 모델을 사용해도 결과가 일관성 있게 나타났다. 전체 요약 6문장 읽기 → 022 18:33 ▲ 422 · 댓글 46 구글, 멀티모달 임베딩 모델 'EmbeddingGemma 2' 공개 Google DeepMind이 EmbeddingGemma 2를 공개했으며, 텍스트·이미지·오디오·비디오를 통합 임베딩 공간으로 매핑하는 가볍고 고성능의 온디바이스 멀티모달 모델이다. AI · 머신러닝 · EmbeddingGemma 2: An open, lightweight multimodal embedding model
Key Point 온디바이스에서 텍스트·이미지·오디오·비디오를 하나의 모델로 처리할 수 있게 되어, 데이터 프라이버시를 보호하면서도 로컬에서 멀티모달 검색과 RAG를 구현할 수 있는 기반이 마련됐다.
핵심 요약
Google DeepMind이 EmbeddingGemma 2를 공개했으며, 텍스트·이미지·오디오·비디오를 통합 임베딩 공간으로 매핑하는 가볍고 고성능의 온디바이스 멀티모달 모델이다. 지난해 출시한 EmbeddingGemma는 2천만 건 이상 다운로드되어 온디바이스 검색과 프라이버시 우선 RAG 파이프라인 구축에 활용됐다. EmbeddingGemma 2는 Gemma 4 아키텍처 기반, 7억 4천만 파라미터 규모이며 Apache 2.0 라이선스로 공개된다. 전체 요약 12문장 읽기 → 023 18:35 ▲ 11 · 댓글 2 긴 영상 이해하는 비전-언어 모델, 메모리 효율을 10%로 줄이다 비전-언어 모델이 긴 영상과 연속 스트림을 이해할 때, 영상이 길어질수록 시각 토큰이 누적되어 추론 비용이 급증한다. AI · 머신러닝 · KeyRec: Bounded Visual Memory for Streaming and Long-Video Understanding
Key Point 비전-언어 모델의 장시간 영상 처리 비용을 10%로 줄이면서 성능을 유지하는 방식으로, 실시간 스트리밍과 긴 영상 분석 작업의 실용성을 크게 높인다.
핵심 요약
비전-언어 모델이 긴 영상과 연속 스트림을 이해할 때, 영상이 길어질수록 시각 토큰이 누적되어 추론 비용이 급증한다. 기존의 훈련 없는 토큰 선택 방식은 정보성 있는 토큰만 남기지만, 사건의 일관된 증거를 잃고 최근 세부 관찰과 장기 히스토리를 구분하지 못한다. KeyRec은 제한된 시각 메모리를 구성하는 훈련 없는 프레임워크로, 최근 관찰은 시각 캐시에 세밀하게 보존하고 과거 증거는 구조화된 사건 은행으로 조직한다. 전체 요약 8문장 읽기 → 024 06:11 ▲ 26 · 댓글 2 3차원 텐서 상태로 장문맥 처리하는 선형 어텐션 RNN의 선형 어텐션은 고정 크기 메모리 상태로 장문맥을 압축해 일정한 시간에 추론하는데, 메모리 상태 크기가 성능을 좌우한다. AI · 머신러닝 · Triadic Linear Attention: Three-Dimensional Recurrent States for Long-Context Sequence Modeling
Key Point 선형 어텐션의 메모리 효율성을 유지하면서 상태 차원을 3차원으로 확장하는 기술적 혁신으로, 장문맥 시퀀스 모델링에서 성능과 효율성의 균형을 새로 정의한다.
핵심 요약
RNN의 선형 어텐션은 고정 크기 메모리 상태로 장문맥을 압축해 일정한 시간에 추론하는데, 메모리 상태 크기가 성능을 좌우한다. 기존 선형 어텐션은 키·벨류 벡터의 외적으로 행렬 크기 상태를 만들었으나, 새로운 방법은 키·두 번째 키·벨류의 3중 외적으로 3차원 텐서 상태를 작성한다. 두 개의 쿼리로 텐서의 두 키 축을 수축(contraction)해 읽어내며, E차원의 두 번째 키로 상태 크기를 E배 늘리면서 파라미터 프로젝션은 단 2개만 추가한다. 전체 요약 5문장 읽기 → 025 15:11 ▲ 91 · 댓글 4 장시간 영상 생성용 미래 예측 프레임 선택 기법 FrameMorrow 장시간 영상 생성에서 생성 이력이 길어질수록 모든 이전 콘텐츠를 유지하는 것이 비효율적이고 중복적이어서 효과적인 이력 선택이 필수적이다. AI · 머신러닝 · FrameMorrow: Future-guided Frame Selection with Prospective Tokens for Long-Horizon Video Generation
Key Point 장시간 영상을 일관되게 생성하는 핵심 병목인 메모리 효율성을 미래 예측 기반 선택으로 해결하는 새로운 접근법이 실제 환경에서 효과를 입증했다.
핵심 요약
장시간 영상 생성에서 생성 이력이 길어질수록 모든 이전 콘텐츠를 유지하는 것이 비효율적이고 중복적이어서 효과적인 이력 선택이 필수적이다. 기존 방식들은 현재 콘텐츠 기반으로 과거 정보의 관련성을 판단하지만, 현재에 관련된 정보가 미래 생성에 반드시 유용한 것은 아니고 적어 보이는 과거가 나중에 중요할 수 있다. 핵심 통찰은 과거 정보를 미래 정보 수요에 대한 관련성에 따라 선택해야 한다는 것이다. 전체 요약 8문장 읽기 → 026 00:11 ▲ 11 · 댓글 2 카메라 재방문 장면 재현하는 스트리밍 비디오 세계모델 LOCI 카메라가 이전에 관찰한 영역을 다시 방문할 때 비디오 세계모델이 그 장면을 정확히 재현해야 하는데, 과거 관찰을 기억하면서도 현재 시점에 맞는 정보를 검색하는 것이 핵심 과제다. AI · 머신러닝 · LOCI: Spatial Linear Memory for Streaming World Models
Key Point 비디오 세계모델이 카메라 재방문 시 과거 장면을 정확히 재현하면서도 메모리를 효율적으로 사용하는 구조의 필요성이 커지고 있기 때문이다.
핵심 요약
카메라가 이전에 관찰한 영역을 다시 방문할 때 비디오 세계모델이 그 장면을 정확히 재현해야 하는데, 과거 관찰을 기억하면서도 현재 시점에 맞는 정보를 검색하는 것이 핵심 과제다. 기존 방식의 한계: 키-밸류 캐시는 시각적 세부사항을 잘 보존하지만 비디오 길이가 길어질수록 메모리가 증가하고, 순환 메모리는 메모리 효율적이지만 역사를 고정 크기 상태로 압축해 개별 과거 관찰에 직접 접근 불가능하다. LOCI는 두 표현 방식을 모두 유지하는 하이브리드 공간 메모리 구조로, 트랜스포머 블록의 절반에서는 키-밸류 캐시로 과거 관찰을 유지하고, 나머지 절반에서는 현재 청크에만 제한하면서 순환 선형 주의 메모리를 보완한다. 전체 요약 8문장 읽기 → 027 09:11 ▲ 19 · 댓글 2 텍스트 손실 없이 멀티모달 임베딩 통합하는 경량 모델 기존 멀티모달 임베딩 모델은 텍스트, 음성, 오디오, 이미지, 비디오 등 새로운 모달리티를 추가할 때 텍스트 검색 성능이 저하되고, 수십억 개 파라미터가 필요했다. AI · 머신러닝 · Omni-Embed-Mini: Binding Modalities Without Forgetting via Dense Distillation
Key Point 기존 멀티모달 모델의 텍스트 성능 저하 문제를 해결하면서 매우 경량화한 기술로, 실제 프로덕션 배포에서 비용과 메모리 효율성이 크게 개선된다.
핵심 요약
기존 멀티모달 임베딩 모델은 텍스트, 음성, 오디오, 이미지, 비디오 등 새로운 모달리티를 추가할 때 텍스트 검색 성능이 저하되고, 수십억 개 파라미터가 필요했다. Omni-Embed-Mini는 0.9B 파라미터로 텍스트, 음성, 오디오, 이미지, 비디오, 문서를 단일 임베딩 공간에 매핑하면서 텍스트 파라미터는 고정해 손실을 방지한다. 핵심은 별도의 교사 모델 없이 각 미디어 샘플을 밀집 캐스케이딩 캡션과 쌍으로 만들고, 교사 신호는 고정된 백본의 캡션 임베딩을 그대로 사용한다는 것이다. 전체 요약 8문장 읽기 → 028 03:11 새 버전 Ruff 0.16.10 출시, 메모리 최적화와 UP052 규칙 추가 파이썬 린터·포매터 Ruff의 0.16.10 버전이 2026년 10월 1일 공개되었다. 오픈소스 · 도구 · astral-sh/ruff@0.16.10
Key Point Python 개발자가 널리 쓰는 린터의 메모리 효율성 개선과 새로운 검사 규칙 추가로, 코드 분석 속도와 정확도가 높아진다.
핵심 요약
파이썬 린터·포매터 Ruff의 0.16.10 버전이 2026년 10월 1일 공개되었다. 진단 정보 메모리 사용량을 감소시킨 성능 개선이 이루어졌다. pyupgrade 범주에 context manager iterator annotation 관련 UP052 규칙이 추가되었다. 전체 요약 8문장 읽기 → 029 21:11 당일 +321 Rust 기반 에이전트 플랫폼 OpenHuman, 경량 고성능 오픈소스 공개 Rust 코어로 만든 OpenHuman은 데스크톱 앱·브라우저 UI·터미널·라이브러리 형태로 제공되는 에이전트 플랫폼이다. AI · 머신러닝 · tinyhumansai/openhuman · Rust
Key Point Rust 기반 경량 설계로 수천 개 에이전트을 한 서버에서 운영할 수 있으며, 플러그인 가능한 아키텍처와 시각적 워크플로우가 기존 에이전트 플랫폼과 비교하는 핵심 차이점이다.
핵심 요약
Rust 코어로 만든 OpenHuman은 데스크톱 앱·브라우저 UI·터미널·라이브러리 형태로 제공되는 에이전트 플랫폼이다. 인프로세스 실행으로 500개 에이전트를 한 프로세스에서 운영할 때 메모리 효율이 별도 프로세스 대비 약 25배 높으며, 콜드 에이전트 턴은 102ms, 전체 부트스트랩은 476ms에 완료된다. Cargo 기능 게이트로 필요한 모듈만 컴파일하며, 52~116MB 범위의 이진파일 크기를 선택할 수 있고 토큰 압축(tinyjuice)으로 모델 입력을 최적화한다. 전체 요약 10문장 읽기 → 030 12:11 ▲ 14 · 댓글 2 LLM 긴 문맥 추론 가속, KV 캐시 저비트 양자화 기법 WUSH-KV 컨텍스트 길이와 배치 크기가 늘어나면서 KV 캐시의 메모리와 대역폭 비용이 증가하여 긴 문맥 추론 효율이 떨어지는 문제를 해결하기 위해 WUSH-KV 기법을 제안했다. AI · 머신러닝 · WUSH-KV: KV Cache Quantization with Data-Adaptive Transforms
Key Point 긴 문맥을 다루는 LLM의 추론 속도와 메모리 효율을 크게 개선할 수 있는 양자화 기법으로, 실제 프로덕션 환경에서 바로 적용 가능한 방법을 제시한다.
핵심 요약
컨텍스트 길이와 배치 크기가 늘어나면서 KV 캐시의 메모리와 대역폭 비용이 증가하여 긴 문맥 추론 효율이 떨어지는 문제를 해결하기 위해 WUSH-KV 기법을 제안했다. WUSH-KV는 행렬 곱셈의 두 인수에서 2차 통계량을 이용해 데이터 인식 변환을 구성하는 WUSH 방식을 KV 캐시에 적용한 것으로, 양자화 오류를 줄일 수 있다. 캘리브레이션 데이터로 key와 value에 대해 별도의 변환을 구성하며, value 변환은 모델 가중치에 포함시키고 key 변환은 RoPE 이후에 적용한다. 전체 요약 6문장 읽기 → 031 06:11 새 버전 Angular 21.2.25 보안 및 성능 개선 릴리스 Angular 21.2.25 버전이 릴리스되었다. 웹 · 프론트엔드 · angular/angular@v21.2.25
Key Point 라우터 보안 강화와 메모리 효율성 개선이 포함된 중요한 마이너 업데이트로, 프로덕션 환경의 안정성을 높인다.
핵심 요약
Angular 21.2.25 버전이 릴리스되었다. platform-server에서 프로토콜 상대 경로(protocol-relative paths)를 resolveUrl에서 거부하도록 수정했다. 라우터의 URL 크기 객체가 매 라우트 스냅샷마다 복사되는 문제를 해결했다. 전체 요약 6문장 읽기 → 032 21:11 ▲ 118 · 댓글 40 1+1 계산하다가 함수형 프로그래밍 언어를 만들었다 데이터 구조 과제에서 1+1+1을 이진 트리로 평가하는 것에서 출발했다. 오픈소스 · 도구 · Needed 1+1, built a functional programming language
Key Point 간단한 산술 과제에서 출발해 메모리 할당, 가비지 컬렉션, 클로저, 함수형 언어까지 스스로 구현해가는 과정에서 핵심 개념들을 실제로 이해하는 방법을 보여준다.
핵심 요약
데이터 구조 과제에서 1+1+1을 이진 트리로 평가하는 것에서 출발했다. 초기에는 Add, Sub, Mul, Div 등 연산을 모두 다른 경우로 표현했지만, 모두 두 식을 받아 하나를 반환하므로 일반화된 Func 노드로 단순화했다. 변수를 추가하려면 해시 테이블이 필요했는데, C에 내장 해시 테이블이 없어서 직접 구현했다. 전체 요약 12문장 읽기 → 033 15:11 ▲ 20 · 댓글 1 영상 세계 모델의 긴 문맥 처리, 효율적 어텐션으로 해결 텍스트 조건부 대화형 비디오 세계 모델은 텍스트 지시에 따라 시간적으로 일관된 환경을 시뮬레이션한다. AI · 머신러닝 · WorldAttention: An Efficient Attention Architecture for Interactive Video World Models
Key Point 대화형 비디오 생성에서 긴 문맥을 유지하면서 계산 효율을 동시에 확보하려는 세계 모델 연구의 핵심 기술 개선이다.
핵심 요약
텍스트 조건부 대화형 비디오 세계 모델은 텍스트 지시에 따라 시간적으로 일관된 환경을 시뮬레이션한다. 기존 프레임워크는 슬라이딩 윈도우로 계산 복잡도를 제한하면서도 과거 문맥을 잃어 장기 상호작용 능력이 떨어진다. 전체 히스토리 캐시는 어텐션의 이차 복잡도와 KV 캐시의 선형 증가로 인해 계산 및 메모리 과부하가 심하다. 전체 요약 7문장 읽기 → 034 06:11 ▲ 65 · 댓글 3 LLM 추론을 위한 '불일치 양자화', 프롬프트와 생성 단계별 최적화 프롬프트 처리(Prefill)와 응답 생성(Decode)은 서로 다른 양자화 방식을 요구한다: Prefill은 저정밀 계산으로 빠른 처리가 필요하고, Decode는 컴팩트한 가중치로 메모리 대역폭을 줄이는 것이 중요하다. AI · 머신러닝 · Disaggregated Quantization: Specializing LLM Prefill and Decode
Key Point LLM 추론의 Prefill과 Decode 두 단계에 서로 다른 양자화 전략을 적용해 정확도 손실 없이 처리 속도(첫 토큰까지 1.78배 단축)와 메모리 효율을 동시에 개선하는 방법론이 공개됐다.
핵심 요약
프롬프트 처리(Prefill)와 응답 생성(Decode)은 서로 다른 양자화 방식을 요구한다: Prefill은 저정밀 계산으로 빠른 처리가 필요하고, Decode는 컴팩트한 가중치로 메모리 대역폭을 줄이는 것이 중요하다. 연구진은 '불일치 양자화'(Disaggregated Quantization, DQ)를 제안했으며, 이는 두 단계별로 계산 형식·가중치·저장소 배치를 특화시킨다. Qwen 3과 Gemma 3에서 Decode 단계의 활성화 양자화를 제거하면 생성 작업의 정확성이 향상되고 추론 비용은 증가하지 않는다. 전체 요약 8문장 읽기 → 035 09:11 ▲ 135 · 댓글 37 DeepSeek, 에이전트 AI 학습용 샌드박스 인프라 공개 DeepSeek이 대규모 에이전트 AI 학습·평가를 위한 프로덕션 샌드박스 플랫폼 'DSec'를 개발했다. AI · 머신러닝 · DeepSeek Elastic Compute (DSec)
Key Point 에이전트 AI의 대규모 학습에 필요한 인프라 구조가 어떻게 설계되는지 보여주며, 복잡한 샌드박스 관리 문제를 실무에서 푼 구체적인 방식을 공개했다.
핵심 요약
DeepSeek이 대규모 에이전트 AI 학습·평가를 위한 프로덕션 샌드박스 플랫폼 'DSec'를 개발했다. DSec는 함수 호출, 컨테이너, 마이크로VM, 전체VM 같은 4가지 백엔드를 통합 SDK로 제공하며, 클러스터 전체에 걸쳐 배치와 생명주기를 조정한다. 독립적으로 버전 관리되는 레이어로 실행 환경을 구성하고, 메모리 공유·회수·CPU 스케줄링으로 고밀도 실행을 구현하며, Fire-Flyer File System(3FS)을 통해 이미지 데이터를 필요 시점에 로드한다. 전체 요약 7문장 읽기 → 036 22:45 당일 +276 NVIDIA Model Optimizer, 양자화·가지치기·증류 등 최적화 기법 통합 라이브러리 오픈소스화 NVIDIA Model Optimizer는 양자화, 가지치기(pruning), 신경망 구조 탐색(NAS), 증류, 추측 디코딩, 희소성 등 최신 모델 최적화 기법을 통합한 라이브러리다. AI · 머신러닝 · NVIDIA/Model-Optimizer · Python
Key Point DL 인퍼런스 배포 시 성능과 메모리 효율을 동시에 높이려는 개발자들에게 양자화, 가지치기, 증류 등을 통합 관리할 수 있는 공식 도구가 생겼고, 오픈소스로 누구나 기여 가능해졌다.
핵심 요약
NVIDIA Model Optimizer는 양자화, 가지치기(pruning), 신경망 구조 탐색(NAS), 증류, 추측 디코딩, 희소성 등 최신 모델 최적화 기법을 통합한 라이브러리다. Hugging Face, PyTorch, ONNX 모델을 입력받아 Python API로 최적화 기법들을 조합해 적용하고, 최적화된 양자화 체크포인트를 생성한다. 생성된 체크포인트는 TensorRT-LLM, vLLM, SGLang 등 인퍼런스 프레임워크에 바로 배포 가능하며, Megatron-Bridge 및 Hugging Face Accelerate와 통합돼 있다. 전체 요약 12문장 읽기 → 037 15:11 ▲ 24 · 댓글 2 확산 LLM의 메모리와 속도 문제를 푸는 Flash-dLLM 비자동회귀 텍스트 생성이 가능한 확산 LLM(dLLM)이 등장했으나 추론 단계에서 KV 캐싱 부재와 병렬 디코딩 메커니즘 부족으로 인해 배포가 제한적이다. AI · 머신러닝 · Flash-dLLM: IO-Aware KV Caching and Parallel Decoding for Fast, Memory-Efficient Diffusion LLMs
Key Point 자동회귀 방식 LLM의 느린 추론이 산업 문제인 가운데, 비자동회귀 생성의 실무 적용을 가로막는 메모리 효율성 문제를 근본적으로 해결하는 기법이다.
핵심 요약
비자동회귀 텍스트 생성이 가능한 확산 LLM(dLLM)이 등장했으나 추론 단계에서 KV 캐싱 부재와 병렬 디코딩 메커니즘 부족으로 인해 배포가 제한적이다. Flash-dLLM은 학습 없이 적용 가능한 추론 가속화 프레임워크로, GPU 메모리 I/O 병목을 식별하고 최적화된 KV 캐시 커널로 메모리 이동을 줄인다. 별도 모델 없이 dLLM 자체가 드래프터와 검증자 역할을 하는 효율적인 draft-and-verify 디코딩 전략을 제안한다. 전체 요약 4문장 읽기 → 038 15:11 ▲ 12 · 댓글 2 대문자와 소문자를 구분해 읽는 메모리, 문맥에 따라 다른 의미 포착 LLM 효율성을 높이기 위해 Mixture of Memory Embeddings(MoME)를 제안했습니다. 기존 메모리 임베딩은 토큰을 고정된 하나의 항목으로만 매핑하는데, MoME는 각 토큰마다 M개의 슬롯 중 문맥에 맞게 선택해 읽습니다. AI · 머신러닝 · MoME: Mixture-of-Memory Embeddings for Context-Aware Sparse Lookup
Key Point 토큰의 다중 의미를 문맥으로 구분해 메모리 효율성과 정확도를 동시에 높이는 기법으로, 소형 언어모델 최적화와 임베딩 기술 발전에 직결됩니다.
핵심 요약
LLM 효율성을 높이기 위해 Mixture of Memory Embeddings(MoME)를 제안했습니다. 기존 메모리 임베딩은 토큰을 고정된 하나의 항목으로만 매핑하는데, MoME는 각 토큰마다 M개의 슬롯 중 문맥에 맞게 선택해 읽습니다. 예를 들어 'python'은 프로그래밍 언어와 동물이라는 서로 다른 의미를 같은 토큰이지만 별도의 메모리 슬롯으로 저장 및 구분합니다. Llama-3, Qwen3, MobileLLM 등 여러 모델 아키텍처에서 기존 Value Embedding, Bigram, STEM 방식보다 성능이 우수했습니다. 전체 요약 5문장 읽기 → 039 08:25 당일 +129 152MB APK를 1.8초에 분석하는 안드로이드 역컴파일러 ASC 안드로이드 APK를 매우 빠르게 역컴파일하는 ASC(Droid ASC)를 공개했습니다. 오픈소스 · 도구 · MG1937/ASC · Python
Key Point 거대한 APK 분석 시 기존 도구의 무거운 인덱싱 단계를 완전히 제거하고 직접 쿼리 방식으로 전환해 속도와 메모리 효율을 획기적으로 개선했습니다.
핵심 요약
안드로이드 APK를 매우 빠르게 역컴파일하는 ASC(Droid ASC)를 공개했습니다. 기존 도구와 달리 전체 파일을 메모리에 로드하지 않고 Deflate 비트스트림을 직접 탐색해 필요한 데이터만 추출합니다. R8 컴파일러의 상수 재배치와 명령어 중복 제거 특성을 활용해 O(1) 시간에 메서드를 찾습니다. 전체 요약 5문장 읽기 → 040 21:11 당일 +107 Rust 언어 공식 저장소, 컴파일러와 표준 라이브러리 관리 Rust 프로젝트의 메인 저장소로 컴파일러, 표준 라이브러리, 문서를 포함하고 있습니다. 오픈소스 · 도구 · rust-lang/rust · Rust
Key Point Rust 생태계의 핵심 인프라 프로젝트로, 언어 개발에 참여하거나 Rust를 심화 학습하려는 개발자라면 저장소의 구조와 기여 방식을 알아두면 도움이 됩니다.
핵심 요약
Rust 프로젝트의 메인 저장소로 컴파일러, 표준 라이브러리, 문서를 포함하고 있습니다. 메모리 효율성과 성능을 바탕으로 임베디드 기기, 크리티컬 서비스 등에 적합한 언어입니다. 강력한 타입 시스템과 소유권 모델로 메모리 안전성과 스레드 안전성을 컴파일 타임에 보장합니다. 전체 요약 5문장 읽기 →