쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
36건 · "비용 절감"조건 지우기 ×
001 12:11 ▲ 11 · 댓글 2 픽셀 공간 확산 모델 학습 가속화하는 통계 기법 픽셀 공간에서 속도장(velocity field)을 직접 학습하는 것은 어렵고 느린데, 고정된 Wiener 추정값이 속도 학습을 개선하고 선형 예측 범위를 넘어 이득을 제공한다. AI · 머신러닝 · Beyond the Estimate: Wiener-Informed Decoding for Easier Training of Pixel-Space Flow Models
Key Point 픽셀 공간 생성 모델의 훈련 효율을 37.5% 단축할 수 있는 방법이 제시되어, 대규모 이미지 생성 모델 개발의 실질적 비용 절감에 직결된다.
핵심 요약
픽셀 공간에서 속도장(velocity field)을 직접 학습하는 것은 어렵고 느린데, 고정된 Wiener 추정값이 속도 학습을 개선하고 선형 예측 범위를 넘어 이득을 제공한다. 고정된 기저(basis)와 픽셀 디코딩도 이와 유사하면서 상호보완적인 성능 향상을 보인다. Wiener-informed Decoding(WiD)은 통계적 지식으로 직접 예측과 디코더 계산을 조직화하며, 훈련가능한 Wiener 예측 경로와 기본 디코더 블록에 특징을 주입하고 계수 보정을 반환하는 계수 인터페이스를 조합한다. 전체 요약 8문장 읽기 → 002 00:11 ▲ 101 · 댓글 76 AI 시대, 경력보다 배고픔이 답이다 Anthropic 채용담당자인 저자는 더 이상 코딩 테스트를 실시하지 않기로 결정했다. Claude가 이미 코딩 테스트와 알고리즘 문제 해결에서 인간을 능가하기 때문이다. AI · 머신러닝 · Hunger beats tenure: Advice for junior engineers
Key Point AI가 코딩 능력을 대체하면서 신입과 경력자의 경력 격차가 축소되고 있으며, 실행 비용 절감으로 주말 프로토타입도 영향력을 가질 수 있는 환경이 바뀌었기 때문이다.
핵심 요약
Anthropic 채용담당자인 저자는 더 이상 코딩 테스트를 실시하지 않기로 결정했다. Claude가 이미 코딩 테스트와 알고리즘 문제 해결에서 인간을 능가하기 때문이다. AI 도구 활용 능력이 높아지면서 누적된 기술 지식의 양이 이전보다 덜 중요해졌고, 신입 엔지니어들이 경력 많은 개발자를 추월하는 사례를 목격하고 있다. 신입 엔지니어의 핵심 장점은 선입견 없는 시각과 신선한 아이디어다. Stripe 창립자는 신입사원들이 기성인들이 놓친 마찰점을 발견하도록 권장했고, Notion 입사 면접에서 저자도 '불가능하다고 여겨지던' 오프라인 모드를 아무렇지 않게 제안했다. 전체 요약 7문장 읽기 → 003 18:11 ▲ 33 · 댓글 2 LLM 추론 강화에 새로운 액터-크리틱 알고리즘 S3AC 제시 롱 체인-오브-소트(CoT) 추론을 위한 강화학습에서 크리틱(가치함수)을 효과적으로 훈련하는 방법이 부재한 문제를 해결한 논문이다. AI · 머신러닝 · S3AC: Stabilized, Selective, and Scalable Actor-Critic for LLM Reasoning
Key Point 대규모 언어 모델의 추론 능력을 효율적으로 향상시키려는 개발자와 연구자에게 확장 가능한 크리틱 훈련 방식을 제시하며, 특히 단일 롤아웃으로 안정적 훈련을 지속하는 기술적 진전이 실무 적용 비용 절감으로 직결된다.
핵심 요약
롱 체인-오브-소트(CoT) 추론을 위한 강화학습에서 크리틱(가치함수)을 효과적으로 훈련하는 방법이 부재한 문제를 해결한 논문이다. 기존 크리틱 없는 방법들은 토큰 수준의 신용 할당이 어렵고 그룹 롤아웃으로 기준선을 추정해야 했다. S3AC는 훈련된 크리틱으로 토큰별 이득과 프롬프트별 기준선을 제공하며, 길이가 다른 궤적의 불충분한 커버리지와 초기 기울기 문제를 해결하는 실용적인 훈련 레시피를 제시한다. 전체 요약 7문장 읽기 → 004 18:11 ▲ 136 · 댓글 2 강화학습 자기 증류로 언어모델 추론 능력 향상 언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다. AI · 머신러닝 · Function-Space Temporal Self-Distillation for Policy Optimization
Key Point 언어모델 훈련 효율성과 메모리 사용량을 동시에 개선하는 새로운 자기 증류 방식이 공개되어, 대규모 모델 개발 비용 절감에 관심 있는 연구자와 개발자가 참고할 만하다.
핵심 요약
언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다. 자기 증류는 보조 없는 정책과 피드백 기반 자기교사를 비교해 토큰 수준의 밀집된 지도를 제공하지만, 교사 모델이 학생과 함께 진화하면서 불안정한 목표와 추가 정규화의 필요성을 야기한다. 논문은 함수 공간 정책 최적화(FSPO)를 제안하며, 현재 특권화된 적응과 함수 공간 시간적 통합을 하나의 정책 프레임워크에서 결합한다. 전체 요약 8문장 읽기 → 005 03:12 ▲ 359 · 댓글 306 마이크로소프트, 전 직원 4분의 1인 6만 명에 구조조정 제안 마이크로소프트가 미국, 캐나다, 인도, 영국의 부사장급 이하 직원 약 6만 명을 대상으로 '자발적 퇴직 제안' 프로그램을 시작했으며 직원들은 12월 초까지 결정해야 한다. 스타트업 · 비즈니스 · Microsoft offers mass buyouts for roughly a quarter of its workforce
Key Point 마이크로소프트가 전 직원 4분의 1을 대상으로 인력 조정에 나섰으며, 이는 지난해 대규모 정리해고 이후 기업 문화 악화에 대응하는 동시에 AI 투자로 인한 비용 압박을 해결하려는 전략의 일환이다.
핵심 요약
마이크로소프트가 미국, 캐나다, 인도, 영국의 부사장급 이하 직원 약 6만 명을 대상으로 '자발적 퇴직 제안' 프로그램을 시작했으며 직원들은 12월 초까지 결정해야 한다. 회사는 지난해 약 1만 5천 명의 대규모 구조조정을 단행했고, 올해는 더 작은 규모의 정리해고를 지속하면서 이번 자발적 퇴직 프로그램으로 인력을 조정하려고 한다. 마이크로소프트 최고인사책임자는 이번 제안이 2025년 초 실시된 자발적 은퇴 프로그램(수혜 대상 8천 700명 중 약 3분의 1이 신청)의 후속 조치라고 밝혔다. 전체 요약 8문장 읽기 → 006 15:11 ▲ 109 · 댓글 33 다섯 개의 Qwen 모델, 한 대의 컴퓨터로 Claude Opus5 수준 코딩 성능 달성 연구진이 GVS5H(Gorilla vs. 5 Humans)라는 훈련 없는 자체 조율 방식을 제안했다. 같은 모델의 인스턴스 여러 개가 문제를 분해하고 공유 파일시스템의 계획, 메모, 현재 솔루션을 통해 조율한다. AI · 머신러닝 · Five Qwen3.8-27B models match Fable 5 Using GVS5H Harness
Key Point 비용 대비 성능이 우수한 오픈소스 모델로도 상용 최강 모델 수준의 코딩 성능을 낼 수 있다는 점이 중요합니다. 특히 자가 호스팅 모델로 93% 수준을 달성할 수 있어, 개발팀의 추론 비용 절감과 프라이버시 개선에 직결됩니다.
핵심 요약
연구진이 GVS5H(Gorilla vs. 5 Humans)라는 훈련 없는 자체 조율 방식을 제안했다. 같은 모델의 인스턴스 여러 개가 문제를 분해하고 공유 파일시스템의 계획, 메모, 현재 솔루션을 통해 조율한다. LiveCodeBench의 최신 어려운 문제 100개로 평가한 결과, 열 개 모델에서 최대 25.6 포인트의 성능 향상을 얻었다. Qwen3.8 Flash Next를 조율했을 때 Claude Fable 5의 90.4%에 비해 93.0%의 pass@1을 기록했으며, 비용은 9% 수준으로 절감했다. 전체 요약 8문장 읽기 → 007 06:11 ▲ 173 · 댓글 58 메타, 뉴멕시코서 캠브리지 애널리티카 사건으로 250억 달러 벌금 메타가 뉴멕시코 주 법원으로부터 캠브리지 애널리티카 스캔들과 관련해 25억 달러의 벌금을 명령받았다. 보안 · Meta ordered to pay $25B penalty in New Mexico Cambridge Analytica case
Key Point 뉴멕시코 법원의 25억 달러 벌금은 메타가 직면한 데이터 프라이버시 관련 역대급 민사 패널티이며, 각 위반당 5,000달러씩 적용하는 벌금 부과 방식이 기술 회사에 어떤 규제 리스크를 만드는지 보여준다.
핵심 요약
메타가 뉴멕시코 주 법원으로부터 캠브리지 애널리티카 스캔들과 관련해 25억 달러의 벌금을 명령받았다. 산타페 법원 배심원단이 사용자 데이터 수집 및 보호 방식에 관해 주민들을 오도했다는 이유로 메타를 책임 있다고 판단했다. 배심원단은 메타가 뉴멕시코 불공정거래법 위반 43건 이상을 저질렀으며, 각 위반당 최대 5,000달러의 민사 벌금이 부과될 수 있다고 결정했다. 전체 요약 11문장 읽기 → 008 15:11 ▲ 98 · 댓글 1 다중 도구와 메모리로 시각 추론 강화하는 OpenVLHarness 멀티모달 대규모 언어 모델(MLLM)의 시각 추론 능력은 크게 향상됐으나, 단순히 추론 예산을 늘리는 것만으로는 성능 개선이 제한적임을 22개 벤치마크 통제 연구에서 확인했다. AI · 머신러닝 · OpenVLHarness: Real World Visual Agentic Tool-Use with Multimodal Memory
Key Point 복잡한 시각 추론 작업을 외부 도구와 메모리 체계로 효율적으로 해결하는 방식이 제시되었고, 여러 MLLM에서 일관된 성능 향상과 비용 절감을 달성해 실무 응용의 가능성을 보여준다.
핵심 요약
멀티모달 대규모 언어 모델(MLLM)의 시각 추론 능력은 크게 향상됐으나, 단순히 추론 예산을 늘리는 것만으로는 성능 개선이 제한적임을 22개 벤치마크 통제 연구에서 확인했다. OpenVLHarness는 능력 계층과 지속적인 멀티모달 메모리를 중심으로 설계된 멀티모달 추론 프레임워크로, 다양한 외부 도구의 접근성과 해석 가능성을 제공한다. 능력 계층은 작업 수준의 도구 인터페이스와 증거 렌더링을 결합해 이질적 백엔드에 일관된 접근을 가능하게 하고, 그 출력을 모델이 읽을 수 있는 형태로 변환한다. 전체 요약 8문장 읽기 → 009 06:11 ▲ 102 · 댓글 73 Teams 도입이 기업 의사결정을 드러낸다 Microsoft Teams 도입은 기업이 라이선스 비용 절감을 우선하는 IT 담당자 주도로 결정되었음을 시사한다. 스타트업 · 비즈니스 · Microsoft Teams is a red flag
Key Point 라이선스 가격 절감에만 집중하는 기업의 의사결정 구조와 그 결과가 얼마나 비효율적인지 명확히 보여주기 때문입니다.
핵심 요약
Microsoft Teams 도입은 기업이 라이선스 비용 절감을 우선하는 IT 담당자 주도로 결정되었음을 시사한다. Teams는 Microsoft 365 번들에 포함되어 추가 계약 없이 도입할 수 있어 기본 선택지가 되었지만, 실제로는 Slack보다 더 나쁜 도구다. 테넌트 전환이 느리고, 파일 공유가 SharePoint를 거쳐야 하며, 검색 기능이 형편없는 등 사용성 측면에서 문제가 많다. 전체 요약 7문장 읽기 → 010 06:11 ▲ 279 · 댓글 111 MiniMax M3.1 Flash 출시, 70% 가격 인하하고 추론 속도 3배 빨려 MiniMax가 차세대 경량 모델 M3.1 Flash를 공식 출시했으며, 기존 모델 대비 온라인 추론 속도가 3배 빨라지고 비용이 70% 절감됐다. AI · 머신러닝 · MiniMax M3.1 Flash
Key Point 에이전트 작업의 비용을 크게 낮추면서 최상위 모델 수준의 성능을 제공하는 모델이 나왔으니, 자동화 솔루션과 개발 업무에 LLM을 활용하는 기업들에게 실질적인 선택지가 생겼다는 뜻이다.
핵심 요약
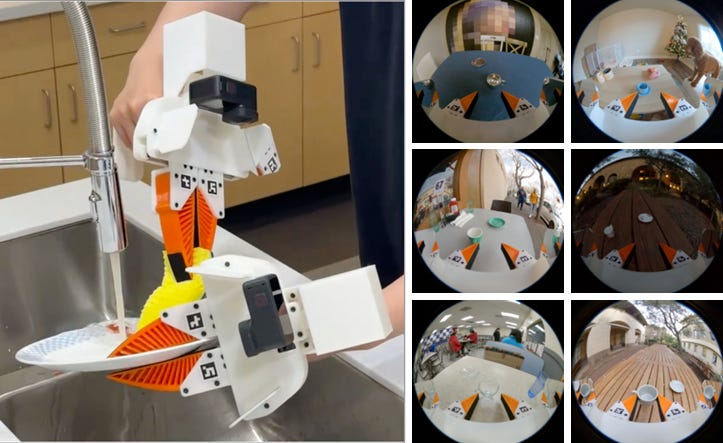
MiniMax가 차세대 경량 모델 M3.1 Flash를 공식 출시했으며, 기존 모델 대비 온라인 추론 속도가 3배 빨라지고 비용이 70% 절감됐다. 자동화 업무·코딩·컴퓨터 사용·사이버보안 분야에서 상위 모델 수준의 성능을 보이며, AutomationBench-AA에서 우수한 순위를 기록하고 판매·마케팅·운영·고객서비스·재무·HR 등 기업 워크플로우를 자동화한다. DeepSWE v1.1에서 73.7% 점수로 코딩 업무에 강하며, 다단계 계획·문서 일관성 유지·금융 규정 준수 같은 복잡한 실무 과제를 처리한다. 전체 요약 10문장 읽기 → 011 00:11 ▲ 103 · 댓글 32 로봇 학습, 데이터 대량 수집 시대 열리다 AI 발전의 핵심은 대규모 데이터 학습이며, 이제 로봇 분야도 같은 원리를 따르고 있다. AI · 머신러닝 · How to Train Your Robot
Key Point 로봇 AI가 대규모 데이터 학습 시대로 접어드는 가운데, 어디서 그 데이터를 구할 것인가가 로봇 공학의 핵심 병목이 되고 있기 때문이다.
핵심 요약
AI 발전의 핵심은 대규모 데이터 학습이며, 이제 로봇 분야도 같은 원리를 따르고 있다. LLM 학습에 사용된 기존 텍스트 데이터와 달리, 로봇용 훈련 데이터는 새롭게 수집해야 하는 상황이다. 원격 조종(텔레오퍼레이션)은 데이터 질이 높지만 비용이 많이 들고 확장이 어렵다는 문제가 있다. 전체 요약 12문장 읽기 → 012 12:11 ▲ 26 · 댓글 2 에이전트를 엣지에서 실행하되 필요할 때만 클라우드 LLM 호출 장기 작업을 수행하는 AI 에이전트는 보통 클라우드의 고성능 LLM을 매 스텝마다 사용하는데, 이는 높은 추론 비용을 초래한다. AI · 머신러닝 · EdgeWise: Bringing Long-Horizon Agents to the Edge via Selective Cloud Delegation
Key Point 장기 에이전트 작업의 추론 비용을 62%까지 줄이면서도 성능을 유지하는 방식은 엣지 배포에서 LLM 활용의 경제성을 크게 바꿀 수 있다.
핵심 요약
장기 작업을 수행하는 AI 에이전트는 보통 클라우드의 고성능 LLM을 매 스텝마다 사용하는데, 이는 높은 추론 비용을 초래한다. 연구팀이 발견한 핵심은 모든 스텝이 강력한 모델을 필요로 하지 않으며, 중요한 일부 스텝에만 LLM을 할당해도 전체 성능과 비슷한 결과를 낼 수 있다는 것이다. EdgeWise는 로컬 디바이스에 작은 언어모델(SLM)을 배포하고, 강력한 능력이 필요한 중요한 스텝만 선택적으로 클라우드 LLM으로 위임하는 엣지-클라우드 협력 프레임워크다. 전체 요약 7문장 읽기 → 013 03:12 ▲ 12 · 댓글 2 LLM 벤치마크 검증, 중복 제거로 비용 절감 LLM 평가에 쓰이는 벤치마크 중 다수가 중복되어 평가 비용이 불필요하게 커지는 문제가 있다. AI · 머신러닝 · Are We Testing Too Much? A Survey of Benchmark Compression for Efficient Evaluation of Large Language Models
Key Point LLM 평가 비용을 줄이는 벤치마크 압축 기법들을 체계적으로 분류하고 검증 방법을 정리한 첫 종합 조사로, 평가 효율을 추구하는 연구팀과 조직이 신뢰할 수 있는 방법을 선택하는 데 도움이 된다.
핵심 요약
LLM 평가에 쓰이는 벤치마크 중 다수가 중복되어 평가 비용이 불필요하게 커지는 문제가 있다. 벤치마크 압축(Benchmark Compression)은 전체 벤치마크 중 일부만 평가한 결과로 전체 성능과 순위를 추정하는 기법이다. 이 분야는 2024년부터 연구가 급증했으며, 119편의 논문을 검토하여 체계적인 분류를 수행했다. 전체 요약 7문장 읽기 → 014 09:11 ▲ 103 · 댓글 25 오픈소스 원격 협업 도구 Petal 공개 공유된 창이 데스크톱 위에 독립적인 윈도우로 나타나며, 이동과 크기 조정이 가능하고 선명한 화질을 유지한다. 오픈소스 · 도구 · Show HN: Petal, open-source CoScreen/ScreenHero finally free
Key Point CoScreen과 ScreenHero 같은 유료 도구를 대체할 수 있는 오픈소스 솔루션으로, 셀프 호스팅 옵션으로 완전한 제어권을 원하는 팀에게 비용 절감과 유연성을 제공한다.
핵심 요약
공유된 창이 데스크톱 위에 독립적인 윈도우로 나타나며, 이동과 크기 조정이 가능하고 선명한 화질을 유지한다. 모든 공유 창에 라벨이 붙은 사용자 커서가 표시되며, 원격 마우스와 키보드 입력이 즉시 작동한다. 여러 사용자가 동시에 자신의 창을 공유할 수 있다. 전체 요약 6문장 읽기 → 015 12:11 ▲ 66 · 댓글 1 Sparse Attention의 성능 가속, 무손실 증명 기반 최적화 DoSA(Dots Sparse Attention)는 sparse attention의 계산 비용을 줄이는 무손실 방법으로, 모든 키에 대한 점수 매김을 조건부로 만들면서도 정확한 토큰 선택을 보장한다. AI · 머신러닝 · DoSA: Dots Sparse Attention
Key Point LLM의 주요 병목인 sparse attention 계산을 수학적 증명으로 가속하는 기법으로, 추론 속도 개선이 직접적으로 비용 절감으로 이어지는 프로덕션 환경에서 실질적 임팩트를 제공한다.
핵심 요약
DoSA(Dots Sparse Attention)는 sparse attention의 계산 비용을 줄이는 무손실 방법으로, 모든 키에 대한 점수 매김을 조건부로 만들면서도 정확한 토큰 선택을 보장한다. 핵심 아이디어는 Top-K 선택이 후보를 완전히 평가하지 않아도 승리 임계값에 대한 증명(certificate)으로 배제 가능하다는 점이다. 시드 세트가 임계값의 하한을 제공하고, 음수 가중치 헤드의 기여도를 수학적으로 상한으로 제한한다. 전체 요약 7문장 읽기 → 016 12:11 ▲ 113 · 댓글 78 AI 에이전트 샌드박스를 기존 대비 90% 저렴하게 제공하는 Agent37 Agent37은 AI 에이전트 실행을 위한 저비용 샌드박스 서비스로, 일반적인 샌드박스 제공업체 대비 90% 이상 저렴하며 평균 월 $0.37/샌드박스의 비용으로 운영된다. 스타트업 · 비즈니스 · Launch HN: Agent37 (YC F26) – Low-cost agent sandboxes for running agents
Key Point 에이전트 개발자들이 직면한 인프라 비용 문제를 근본적으로 해결하는 새로운 가격 기준을 제시하며, 무료 플랜까지 제공 가능하게 만드는 기술적 최적화 사례를 보여준다.
핵심 요약
Agent37은 AI 에이전트 실행을 위한 저비용 샌드박스 서비스로, 일반적인 샌드박스 제공업체 대비 90% 이상 저렴하며 평균 월 $0.37/샌드박스의 비용으로 운영된다. OpenClaw 래퍼 회사에서 출발해 여러 에이전트 런타임을 지원하는 방향으로 확장했으며, 현재 신규 가입자의 90% 이상이 무료 플랜을 선택해 Hermes, Openclaw, Claude Code 등을 클라우드에서 호스팅한다. 무료 샌드박스의 인프라 비용은 사용자당 월 $0.05~$0.10으로, CPU 버스트 활용 패턴 감지 및 효율적인 리소스 관리를 통해 실현됐다. 전체 요약 8문장 읽기 → 017 12:11 ▲ 34 · 댓글 4 깊이 축 주의 메커니즘 확장으로 신경망 효율성 1.58배 향상 Attention Residuals(AttnRes)는 네트워크 깊이축을 따라 내용 기반 검색을 수행하는 메커니즘으로, 깊이축 단일스트림 소프트맥스 어텐션으로 볼 수 있습니다. AI · 머신러닝 · Multi-Stream Attention Residuals
Key Point 대규모 신경망의 효율성을 단순한 아키텍처 변경만으로 1.58배 향상시키는 방법을 제시하여 모델 학습과 배포 비용 절감에 직접 영향을 줄 수 있습니다.
핵심 요약
Attention Residuals(AttnRes)는 네트워크 깊이축을 따라 내용 기반 검색을 수행하는 메커니즘으로, 깊이축 단일스트림 소프트맥스 어텐션으로 볼 수 있습니다. 다중헤드 어텐션의 성공에 영감을 받아 Multi-Stream Attention Residuals(MSAR)을 제안했으며, 이는 AttnRes를 다중헤드 깊이 어텐션으로 확장한 것입니다. MSAR은 다중규모 인과 합성곱을 통해 시퀀스 문맥에서 스트림 다양성을 도출하여, 각 헤드가 서로 다른 문맥 관점을 통해 과거 표현을 검색할 수 있습니다. 전체 요약 6문장 읽기 → 018 18:12 ▲ 14 · 댓글 2 LLM 숨겨진 상태 분석으로 추론 가속화 방법 개선 LLM의 여러 계층 숨겨진 상태들이 서로 다른 정보를 담고 있지만, 기존 추론 가속(speculative decoding) 방법들은 위치 기반 휴리스틱으로 선택한 소수 계층만 활용하고 있다. AI · 머신러닝 · Surfing the Activation Wave: Analyzing the Information and Geometry of LLM Hidden States for Speculative Decoding
Key Point LLM 추론 속도 최적화는 실제 배포에서 핵심인데, 이 연구가 제시하는 계층 선택 방법이 기존 휴리스틱 대비 체계적이고 더 효율적이기 때문에 실제 서빙 비용 절감으로 이어질 수 있다.
핵심 요약
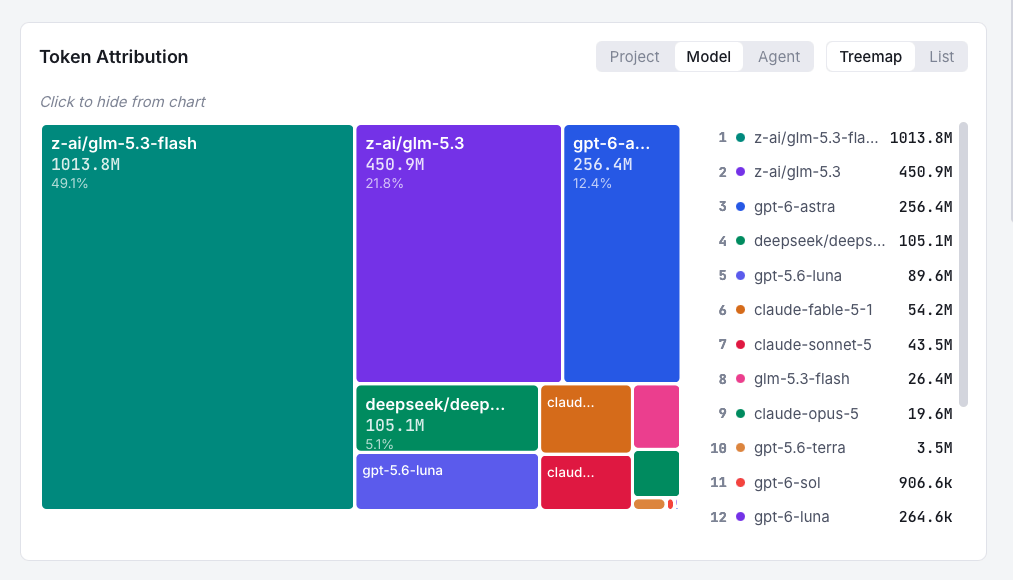
LLM의 여러 계층 숨겨진 상태들이 서로 다른 정보를 담고 있지만, 기존 추론 가속(speculative decoding) 방법들은 위치 기반 휴리스틱으로 선택한 소수 계층만 활용하고 있다. 이 연구는 정보량(행렬 엔트로피) 및 다양성(CKA 분석)이라는 두 기준으로 최적의 다중 계층 숨겨진 상태를 선택하는 원칙 기반 프레임워크를 제시한다. 계층별 섀넌 엔트로피, 숨겨진 상태 결합 시 총 엔트로피, 계층 깊이에 따른 쌍별 CKA 동역학을 조사한 결과 디코더 표현 내에 서로 다른 기하학적 및 정보 구획이 존재함을 발견했다. 전체 요약 6문장 읽기 → 019 12:11 ▲ 125 · 댓글 97 GLM 5.3 Flash 한 달 집중 사용, 배운 점은? Wagtail 팀이 9월 한 달간 GLM 5.3 Flash 모델만 사용하는 도전을 진행했으나, 총 2B 토큰 중 절반만 해당 모델로 처리했다. AI · 머신러닝 · One month coding with GLM 5.3 Flash
Key Point 개발 조직이 효율적인 LLM 모델을 선택할 때 직면하는 실제 비용 구조와 예상 외 변수들을 구체적 사례로 보여주며, 에너지·비용 절감을 위한 실질적 전략을 제시한다.
핵심 요약
Wagtail 팀이 9월 한 달간 GLM 5.3 Flash 모델만 사용하는 도전을 진행했으나, 총 2B 토큰 중 절반만 해당 모델로 처리했다. 첫 2주는 계획대로 GLM 5.3 Flash만 사용해 $68, 365g 탄소 배출, 4kWh 에너지 소비로 예산 내에서 운영했다. 실험용 MCP 서버 프로토타입에서 잘못된 모델을 선택해 450M 토큰, $150, 5kWh 에너지를 하루 밤사이에 소비하는 예상 외 비용이 발생했다. 전체 요약 8문장 읽기 → 020 06:11 ▲ 10 · 댓글 2 쿼리의 의미를 먼저 파악해 최적 LLM 선택 기존 LLM 라우팅 방식은 쿼리 임베딩이나 모델 표현에서 직접 결정을 내려 왔으나, 쿼리가 실제로 무엇을 필요로 하는지 명확히 나타내지 못했다. AI · 머신러닝 · SeLMRoute: Probabilistic Semantic Evidence for Large Language Model Routing
Key Point LLM 라우팅 결정에 의미론적 근거를 명확히 도입해 해석 가능성을 높이면서 성능을 기존 방식 대비 3% 이상 향상시킨 새로운 접근법이기 때문이다.
핵심 요약
기존 LLM 라우팅 방식은 쿼리 임베딩이나 모델 표현에서 직접 결정을 내려 왔으나, 쿼리가 실제로 무엇을 필요로 하는지 명확히 나타내지 못했다. SeLMRoute는 의미론적 증거 추출, 모델 성능 학습, 배포 목표 적용을 분리하는 라우팅 프레임워크를 제시한다. 의사결정 모델이 쿼리의 추론 요구도, 외부 지식 사용 여부 등 해석 가능한 질문들을 먼저 확률 분포로 평가한다. 전체 요약 9문장 읽기 → 021 18:11 ▲ 101 · 댓글 36 모델 라우터로 Astra 수준의 성능 달성, 비용은 절반 Weave Router 2.0은 여러 LLM을 지능형으로 전환하는 오픈소스 모델 라우터로, Astra 같은 강력한 모델이 필요한 작업과 Deepseek v4 Flash 같은 가벼운 모델이 적합한 작업을 구분한다. AI · 머신러닝 · Show HN: Open-source model routing for coding agents at Astra-level performance
Key Point 비용을 절반으로 줄이면서 최강 수준의 성능을 유지하는 라우팅 기술은 개발자 도구의 경제성을 크게 바꿀 수 있다.
핵심 요약
Weave Router 2.0은 여러 LLM을 지능형으로 전환하는 오픈소스 모델 라우터로, Astra 같은 강력한 모델이 필요한 작업과 Deepseek v4 Flash 같은 가벼운 모델이 적합한 작업을 구분한다. Terminal Bench 4.0과 SWE Atlas 벤치마크에서 GPT-6 Astra와 동등한 정확도를 달성하면서 비용은 52~54% 수준으로 줄이고 완료 속도는 2.2~2.5배 빨아졌다. 라우팅 결정 공간이 100 LLM 호출 × 10개 모델 기준 10^100개에 달하므로, Hidden Markov Model로 세션 상태를 추적한 후 분류기가 모델 버킷을 선택하는 구조로 탐색 공간을 대폭 축소했다. 전체 요약 8문장 읽기 → 022 15:11 ▲ 81 · 댓글 1 교사 모델과 학생의 불일치를 줄이는 지도 라우팅 기법 SAKI 온-폴리시 증류(OPD)는 학생 모델이 생성한 궤적으로 훈련하여 학습-테스트 상태 불일치를 줄이지만, 약한 학생은 교사 모델과 정렬되지 않은 접두사에서 대표성 낮은 감독을 받을 수 있다. AI · 머신러닝 · SAKI: Maximal-Coupling-Routed Teacher Supervision for On-Policy Distillation
Key Point 학생 모델을 효율적으로 증류하면서 정확도를 높이는 새로운 방법으로, 수학 문제 해결 같은 복잡한 추론 작업의 비용 절감에 직결된다.
핵심 요약
온-폴리시 증류(OPD)는 학생 모델이 생성한 궤적으로 훈련하여 학습-테스트 상태 불일치를 줄이지만, 약한 학생은 교사 모델과 정렬되지 않은 접두사에서 대표성 낮은 감독을 받을 수 있다. SAKI(Supervision Allocation with KL-constrained Interpolation)는 KL 제약 교사 유도 롤아웃과 최대 결합을 결합하여, 실현된 수용/교정 이벤트를 재사용해 토큰 수준의 감독을 라우팅한다. 수용된 위치는 샘플링된 토큰의 역-KL 감독을 유지하고, 교정 위치는 교사의 최고 확률 토큰에 대한 직접 감독을 받는다. 전체 요약 7문장 읽기 → 023 15:11 ▲ 146 · 댓글 34 2026년 Q2 HDD 장애율 1.73% 기록…SMR 기술 본격 준비 Backblaze가 Q2 2026 드라이브 통계를 공개했으며, 354,415개 HDD의 연간 장애율(AFR)이 1.73%로 최근 최고치를 기록했다. 하드웨어 · 시스템 · Backblaze drive stats for Q2 2026
Key Point 데이터센터 규모의 HDD 배포 추세와 차세대 기술(SMR, HAMR)을 이해하려면 13년간의 신뢰할 수 있는 실측 데이터가 필요하며, 고용량 드라이브로의 전환이 비용과 전력 구조를 어떻게 바꿀지 파악하는 데 참고가 된다.
핵심 요약
Backblaze가 Q2 2026 드라이브 통계를 공개했으며, 354,415개 HDD의 연간 장애율(AFR)이 1.73%로 최근 최고치를 기록했다. 모니터링 대상은 359,101개 드라이브였으며, 부팅 드라이브와 기준 미충족 드라이브를 제외하고 분석했다. Seagate ST8000NM000A·ST12000NM000J·ST14000NM000J 등 3개 모델이 장애 없이 우수 성과를 냈고, ST16000NM000J는 1건만 기록했다. 전체 요약 13문장 읽기 → 024 12:11 ▲ 109 · 댓글 94 버몬트, 가정용 배터리로 발전소 대체 버몬트주의 유틸리티 회사 GMP가 5,500명 이상의 주민 가정에 배터리를 설치해 가상발전소(virtual power plant)를 구축했으며, 이것이 현재 주의 최대 전력 공급원이 되었다. 인프라 · 데브옵스 · Vermont replacing power plants with home batteries
Key Point 전력 위기와 기후재난에 대한 근본적 해결책으로 가상발전소가 기존 발전소를 대체할 수 있는 경로를 보여주며, 배터리 비용 하락과 규제 변화가 이 전환을 가속화할 가능성을 시사한다.
핵심 요약
버몬트주의 유틸리티 회사 GMP가 5,500명 이상의 주민 가정에 배터리를 설치해 가상발전소(virtual power plant)를 구축했으며, 이것이 현재 주의 최대 전력 공급원이 되었다. 사용자들은 월 55달러(10년 리스)로 가정에 2개의 배터리를 설치받으며, 극심한 기후변화로 연간 12회 정도 정전을 겪던 주민들은 설치 후 정전을 경험하지 않고 있다. GMP의 가상발전소는 약 110MW의 전력을 제공하며, 이는 소형 천연가스 발전소 규모와 동등하고 기존 첨두부하 발전소(peaker plant)를 효과적으로 대체했다. 전체 요약 10문장 읽기 → 025 21:11 당일 +111 자신의 서버에 설치하는 깃허브 배포 플랫폼 Openship TypeScript 기반 오픈소스 배포 플랫폼으로, GitHub 저장소를 지정하면 자동으로 빌드·배포·라우팅·TLS 처리를 수행하는 자체 호스팅 가능 CI/CD 솔루션이다. 인프라 · 데브옵스 · oblien/openship · TypeScript
Key Point 자신의 인프라에 설치해 Vercel·Railway 같은 PaaS 기능을 완전히 제어할 수 있으므로, 배포 비용 절감과 데이터 주권이 필요한 팀에게 의미 있는 선택지다.
핵심 요약
TypeScript 기반 오픈소스 배포 플랫폼으로, GitHub 저장소를 지정하면 자동으로 빌드·배포·라우팅·TLS 처리를 수행하는 자체 호스팅 가능 CI/CD 솔루션이다. 데스크톱 앱, 웹 대시보드, CLI 등 세 가지 인터페이스로 구동할 수 있으며, 개인용 데스크톱 앱은 SSH를 통해 서버를 제어하고 팀용 서버는 Docker Compose(Linux) 또는 베어 모드로 운영할 수 있다. Package.json·프레임워크 설정·Dockerfile을 자동 감지해 스택을 파악하고, Docker 이미지 또는 베어 릴리즈로 빌드한 후 컨테이너·호스트 프로세스 방식으로 실행한다. 전체 요약 9문장 읽기 → 026 21:11 ▲ 110 · 댓글 70 의사도 극심한 번아웃에 빠진다 13년 경력의 외과의사가 의료진이 겪는 정신 건강 위기에 대해 증언했다. 기타 · The darker side of being a doctor
Key Point 의료진의 정신 건강 위기가 개인의 약점이 아니라, 구조적 과부하와 시스템 설계의 실패에서 비롯되었음을 실제 경험 사례로 보여준다.
핵심 요약
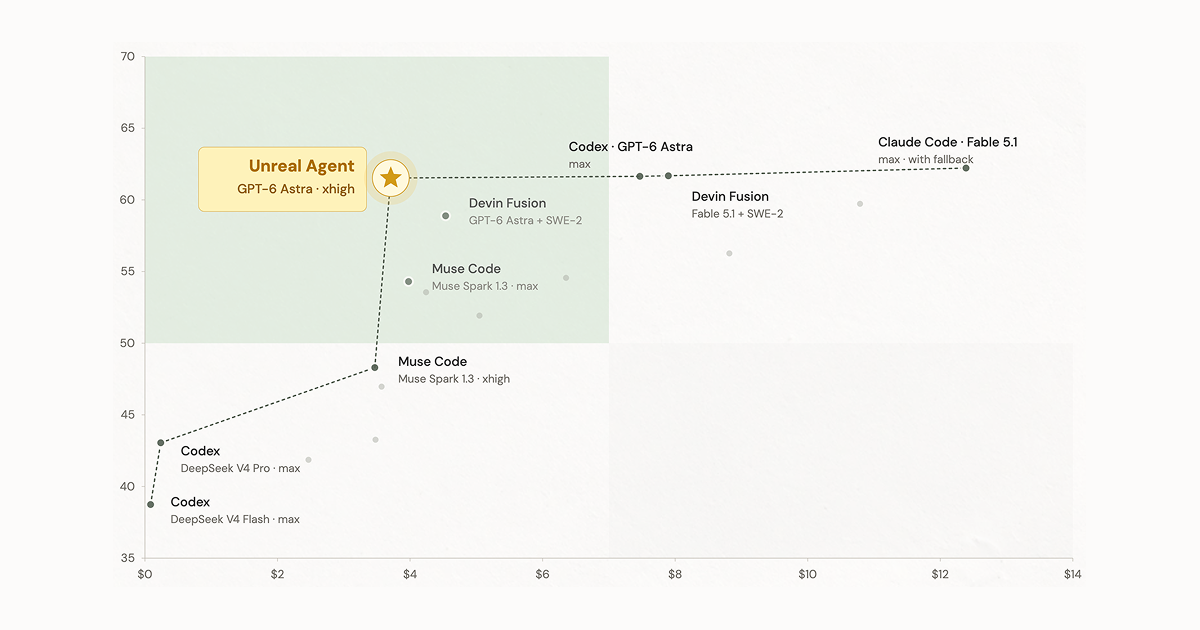
13년 경력의 외과의사가 의료진이 겪는 정신 건강 위기에 대해 증언했다. 의료 현장에서 의사들이 겪는 주요 고통은 업무 통제 불가, 지속적인 주방문 요청, 비효율적인 시스템 때문이다. 자신의 일과를 구체적으로 서술하면, 새벽 6시 시작부터 자동으로 계산되는 수술 시간, 과다 배정된 환자, 응급 콜에 시달리며 하루 70건 통화를 받는다. 전체 요약 5문장 읽기 → 027 09:11 ▲ 115 · 댓글 70 비동기 도구 호출로 AI 에이전트 비용 40% 절감한 언리얼 에이전트 언리얼 랩스가 AI 에이전트 실행 비용을 줄이기 위해 설계한 '언리얼 에이전트' 하네스를 공개했다. AI · 머신러닝 · Unreal Agent
Key Point AI 에이전트의 운영 비용이 주요 과제인 상황에서 하네스 설계를 통해 실질적인 비용 절감을 달성한 오픈소스 솔루션이 등장했다.
핵심 요약
언리얼 랩스가 AI 에이전트 실행 비용을 줄이기 위해 설계한 '언리얼 에이전트' 하네스를 공개했다. 기존 에이전트들이 도구 호출 관리에 많은 토큰을 소비하는 문제를 해결하기 위해 비동기 방식의 도구 호출을 구현했다. 도구 실행을 백그라운드에서 처리하면서 곧바로 'in-progress' 상태를 기록함으로써 사용자 입력을 지연 없이 받을 수 있다. 전체 요약 5문장 읽기 → 028 21:11 당일 +154 에이전트 시스템용 모델 라우터 오픈소스 공개 Weave OS가 개발한 모델 라우터는 프롬프트를 적절한 LLM으로 50밀리초 이내에 라우팅한다. AI · 머신러닝 · weave-os/router · Go
Key Point 프롬프트마다 최적의 모델을 자동 선택해 비용 절감과 성능을 동시에 달성하는 방식이 개발 생산성에 미치는 임팩트가 크다.
핵심 요약
Weave OS가 개발한 모델 라우터는 프롬프트를 적절한 LLM으로 50밀리초 이내에 라우팅한다. 엔드포인트 변경만으로 API 비용을 40~70% 절감할 수 있다. 에이전트 시스템에서 여러 모델의 강점을 자동으로 활용해 효율성을 높인다. 029 00:10 ▲ 100 · 댓글 15 코딩 에이전트의 성능을 좌우하는 요소들 코딩 에이전트의 성능을 결정하는 '하네스(harness)'의 구성 요소를 체계적으로 분석한 연구를 공개했다. AI · 머신러닝 · An Empirical Study of Harness Design for Coding Agents
Key Point AI 개발자들이 코딩 에이전트를 더 효율적으로 구축하기 위한 구체적인 설계 원칙과 최적화 지점을 얻을 수 있다.
핵심 요약
코딩 에이전트의 성능을 결정하는 '하네스(harness)'의 구성 요소를 체계적으로 분석한 연구를 공개했다. 컨텍스트 관리, 액션 스페이스, 계획 수립 등 세 가지 핵심 요소를 변수로 두고 네 가지 LLM을 대상으로 176가지 설정을 평가했다. 컨텍스트 창이 제한될수록 컨텍스트 관리의 중요도가 높아지며, 규칙 기반 삭제 후 LLM 기반 요약이 가장 효율적인 전략임을 확인했다. 전체 요약 5문장 읽기 → 030 16:56 ▲ 114 · 댓글 8 DeepSeek, KV 캐시 압축으로 추론 속도 420 토큰/초 달성 DeepSeek-v4.1 Flash는 552B 매개변수 멀티모달 모델로, 에이전트 워크플로우에서 증가하는 컨텍스트와 도구 호출로 인한 프리필 계산 부담을 해결하기 위해 설계됐다. AI · 머신러닝 · DeepSeek-v4.1 Flash: Pushing the Limits of KV Cache Compression
Key Point 에이전트 워크플로우에서 일반적인 병목인 장문맥 프리필 계산과 KV 캐시 저장 비용을 획기적으로 줄인 새로운 모델 아키텍처 설계가 장기 맥락 처리와 배포 비용 절감에 어떻게 영향을 미치는지 보여준다.
핵심 요약
DeepSeek-v4.1 Flash는 552B 매개변수 멀티모달 모델로, 에이전트 워크플로우에서 증가하는 컨텍스트와 도구 호출로 인한 프리필 계산 부담을 해결하기 위해 설계됐다. KV 캐시 압축을 위해 채널·시퀀스·레이어 세 차원에서 최적화를 진행했으며, 같은 시퀀스 길이에서 런타임 KV 캐시는 v4-Flash의 1/4, 영구 저장소는 1/8 수준으로 줄었다. Causal Encoder-Decoder(CED) 아키텍처를 도입해 프리필 단계에서 8B, 디코딩 단계에서 16B 매개변수만 활성화되도록 설계했으며, 이는 입력 중심의 에이전트 시나리오에 특히 효율적이다. 전체 요약 12문장 읽기 → 031 21:11 당일 +100 스토리지 비용 140배 저렴한 오픈소스 옵저버빌리티 플랫폼 OpenObserve는 Datadog, Splunk, Elasticsearch를 대체할 수 있는 오픈소스 클라우드 네이티브 옵저버빌리티 플랫폼이다. 인프라 · 데브옵스 · openobserve/openobserve · TypeScript
Key Point 엔지니어링 팀이 관리 복잡성과 비용 부담 없이 전사 옵저버빌리티를 구축할 수 있는 실질적인 대안이 생겼다.
핵심 요약
OpenObserve는 Datadog, Splunk, Elasticsearch를 대체할 수 있는 오픈소스 클라우드 네이티브 옵저버빌리티 플랫폼이다. 로그, 메트릭, 트레이스, RUM, 세션 리플레이, 파이프라인, SLO, LLM 옵저버빌리티를 단일 플랫폼으로 제공한다. Parquet 칼럼 저장소와 S3 네이티브 아키텍처로 Elasticsearch 대비 스토리지 비용을 140배까지 절감할 수 있다. 전체 요약 5문장 읽기 → 032 06:10 ▲ 123 · 댓글 93 코스트코 엔진 오일 품귀, 가격 60% 올랐다 코스트코의 키클랜드 시그니처 합성유 10쿼트 팩 가격이 30대 중반에서 57.99달러로 인상됐다. 기타 · Global Shortage Has Led to Motor Oil Rationing at Costco
Key Point 자동차 유지보수 비용 절감의 대표 수단이던 DIY 오일 교환이 급격한 가격 인상과 공급 제한으로 경쟁력을 잃고 있으며, 이는 기유 부족과 까다로워진 엔진 기술 기준이 복합적으로 작용한 결과다.
핵심 요약
코스트코의 키클랜드 시그니처 합성유 10쿼트 팩 가격이 30대 중반에서 57.99달러로 인상됐다. 회원당 7일에 2개 한정 구매 조치가 시행되어 최대 20쿼트만 살 수 있게 제한됐다. 모빌1도 구매 제한을 받고 있으나 5개 한정으로 더 관대한 수준이다. 전체 요약 6문장 읽기 → 033 03:10 ▲ 116 · 댓글 57 RTK의 토큰 절감 효과, 실제 벤치마크에서는 미미 AI 코딩 도구 RTK는 터미널 출력을 압축해 토큰 사용량을 줄인다고 주장하며 79k GitHub 스타를 기록했다. AI · 머신러닝 · RTK reports token savings, but our cost benchmarks disagree
Key Point AI 코딩 도구의 비용 절감 효과가 마케팅 주장과 실제 벤치마크에서 큰 차이가 나는 사례로, 어떤 AI 도구가 실제로 비용을 절감하는지 판단할 때 참고할 만한 검증 기준을 보여준다.
핵심 요약
AI 코딩 도구 RTK는 터미널 출력을 압축해 토큰 사용량을 줄인다고 주장하며 79k GitHub 스타를 기록했다. Terminal-Bench 2.1에서 1,740회 실험 결과 Claude Code는 5% 비용 감소, OpenCode는 5% 비용 증가했으나, 성공률은 각각 1~2% 하락했다. 작업별 평균 비용 변화를 측정하면 Claude Code는 1% 더 비싸졌고 OpenCode는 17% 더 비싸졌으며, 한 작업을 제외하면 절감 효과는 거의 없다. 전체 요약 6문장 읽기 → 034 21:11 당일 +424 352개 AI 제공사를 하나의 API로, OmniRoute 게이트웨이 OpenAI, Claude, Gemini, DeepSeek 등 352개 AI 제공자 전용 엔드포인트를 통합한 오픈소스 게이트웨이 OmniRoute를 공개했다. AI · 머신러닝 · diegosouzapw/OmniRoute · TypeScript
Key Point 수백 개 AI API의 복잡한 가격·할당량 관리를 한 곳에서 해결해주므로, 비용 절감과 개발 편의성이 동시에 필요한 개발자에게 실질적인 도움이 된다.
핵심 요약
OpenAI, Claude, Gemini, DeepSeek 등 352개 AI 제공자 전용 엔드포인트를 통합한 오픈소스 게이트웨이 OmniRoute를 공개했다. 월 약 14.7억 토큰의 무료 한도를 자동으로 계산해 제공하며, 2주마다 각 제공자의 무료 정책을 재검증해 대시보드에 표시한다. 할당량 부족 시 자동으로 다른 제공자로 전환하고, RTK+Caveman 압축 기술로 토큰 사용을 15~95% 줄인다. 전체 요약 5문장 읽기 → 035 03:10 ▲ 354 · 댓글 182 DeepSeek, V4 Pro 보다 저렴하고 강력한 V4.1 Flash 출시 DeepSeek이 9월 10일 V4.1 Flash 모델을 공식 출시한다. AI · 머신러닝 · DeepSeek launching v4.1 flash cheaper and more capable than v4 pro
Key Point V4 Pro 수준의 성능을 저가로 제공하는 모델이 등장하면서 AI API 비용 절감에 직결된다.
핵심 요약
DeepSeek이 9월 10일 V4.1 Flash 모델을 공식 출시한다. V4.1 Flash는 성능, 비용, 속도, 작업 완료 시간 등 모든 주요 지표에서 V4 Pro를 앞선다. V4.1 Flash 출시 이후 Pro 모델 요청은 Flash 모델로 라우팅되며 Flash 가격으로 청구된다. 전체 요약 4문장 읽기 → 036 11:10 당일 +295 AI 에이전트 토큰 65% 줄이는 '동굴인 말하기' 스킬 Claude Code를 비롯한 30개 이상의 AI 에이전트에서 사용 가능한 규칙 파일 'Caveman'을 공개했다. AI · 머신러닝 · JuliusBrussee/caveman · Go
Key Point AI API 사용료가 토큰 기반인 상황에서, 에이전트의 장황한 답변을 자동으로 간결하게 변환해 구체적인 비용 절감 효과를 제시한다.
핵심 요약
Claude Code를 비롯한 30개 이상의 AI 에이전트에서 사용 가능한 규칙 파일 'Caveman'을 공개했다. AI 에이전트가 과도하게 긴 설명을 피하고 간결하게 답변하도록 학습시켜, 출력 토큰을 평균 65% 감소시킨다. 코드·명령어·파일 경로·오류 메시지는 건드리지 않고 설명 부분만 간결하게 다듬는다. 전체 요약 6문장 읽기 →