매일 쌓이는 개발자의 시야
2026년 11월 12일 (목). 세상의 기술 소식, 한국어로 한눈에.
AI 요약 안내 AI가 한국어로 정리한 내용입니다. 정확한 정보는 각 카드의 원문을 확인해 주세요.
요약 원칙 ↗ 01 읽을 소식Hacker News 9건 ↓ 02 써볼 도구GitHub Trending 2건 ↓ 03 읽을 논문Hugging Face Papers 15건 ↓ 04 새 버전GitHub Releases 0건 ↓ AI · 머신러닝 분야 · 26건 필터 해제 ×
오늘의 주요포인트 상위 6건
01 AI · 머신러닝 00:11 게시
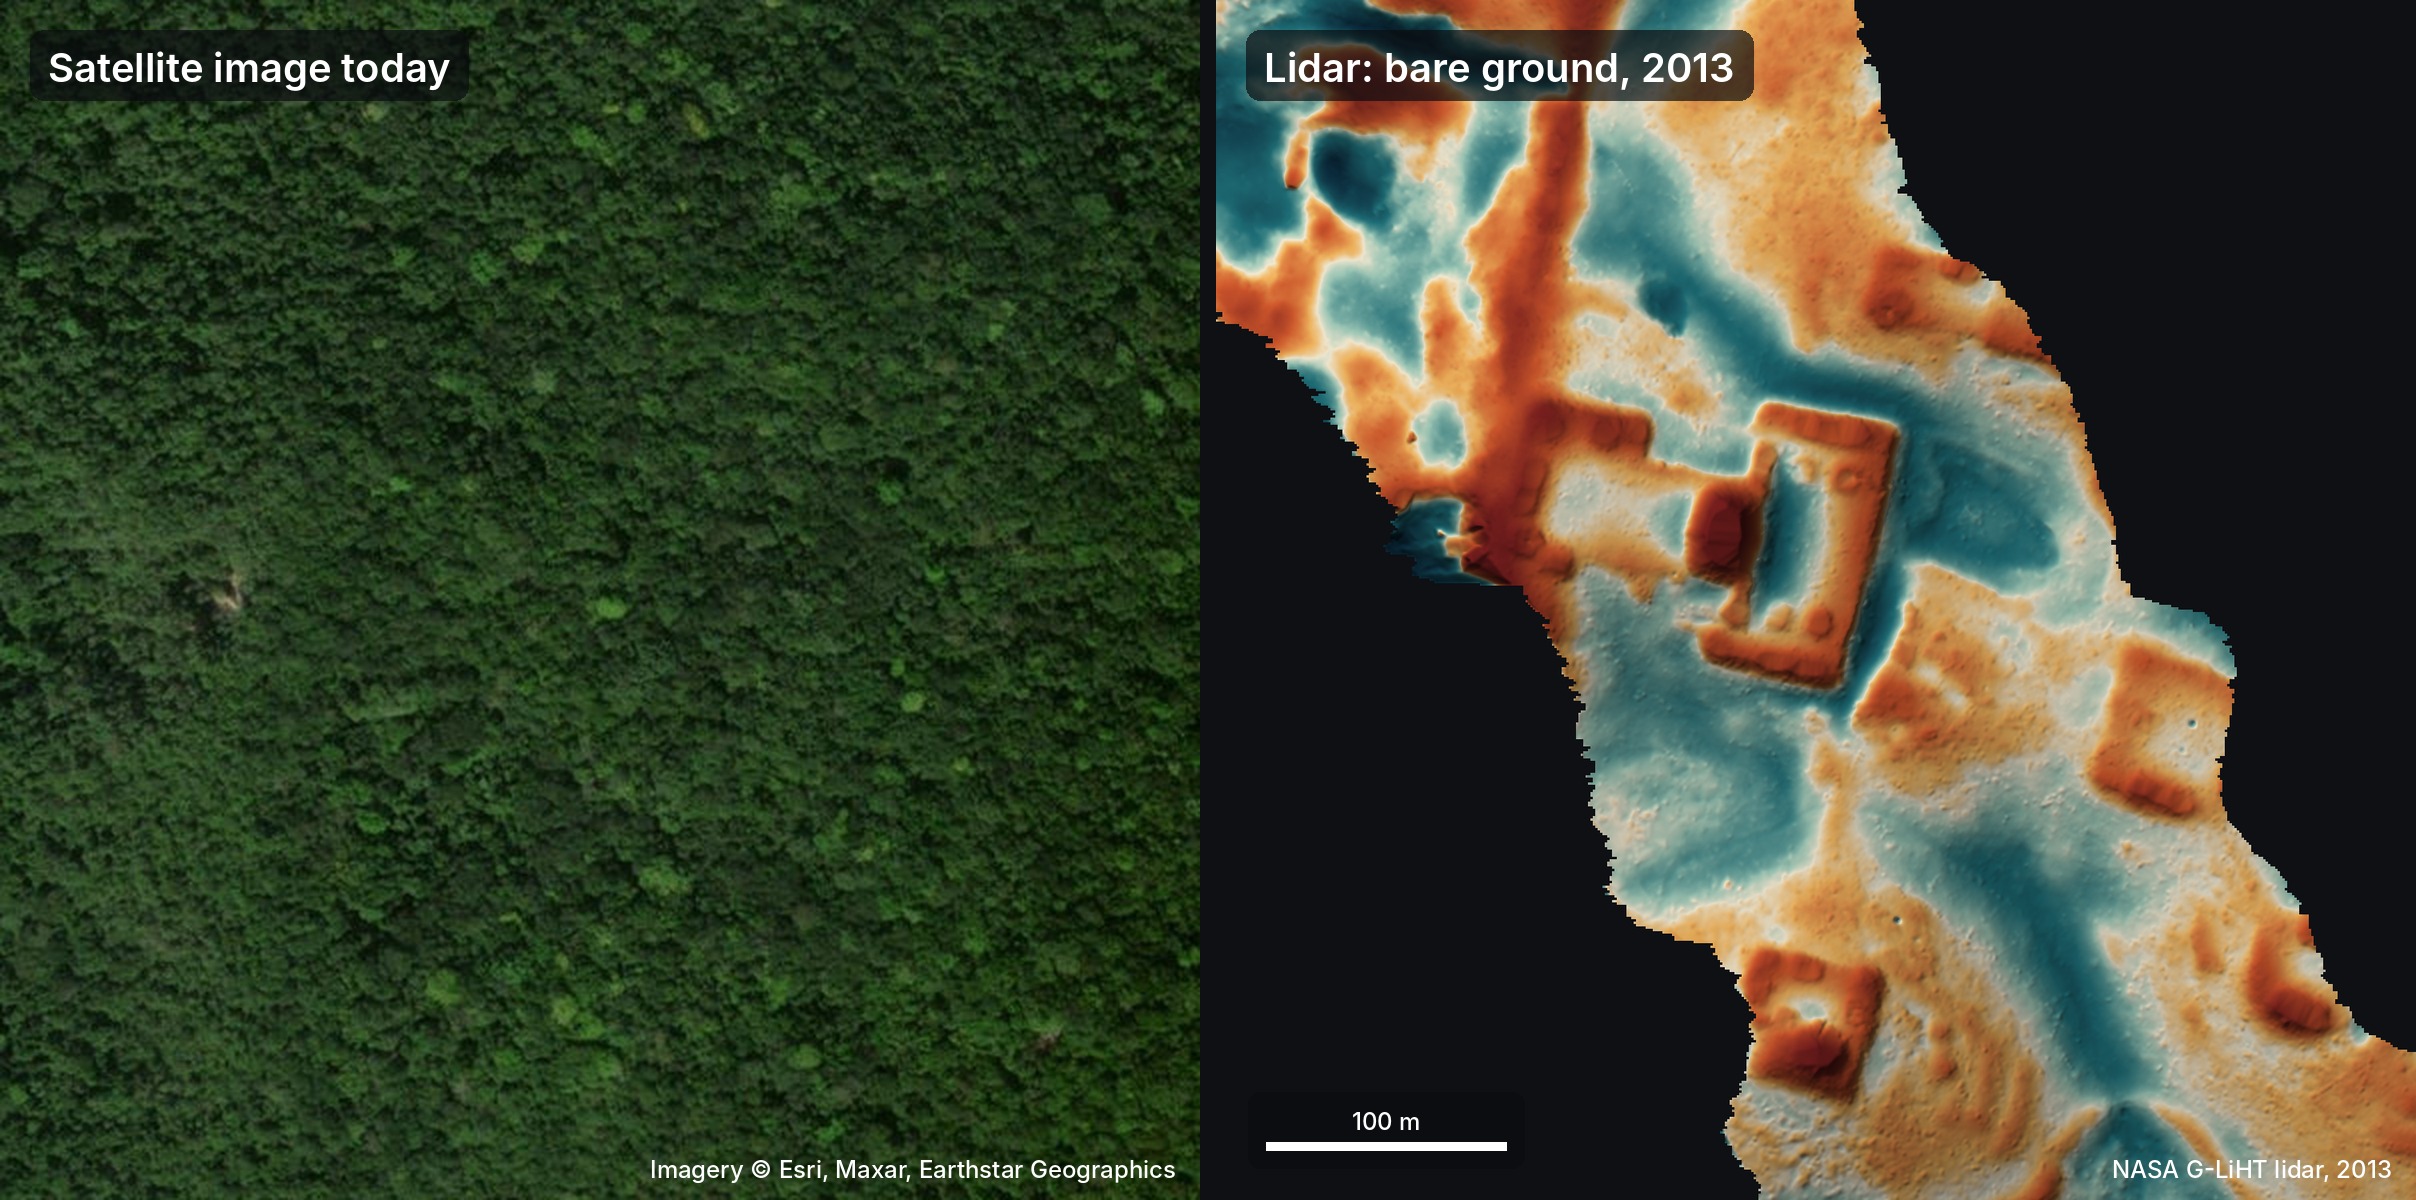
원제 Google SWE points 48 AI agents at NASA Lidar, finds unmapped Maya pyramid in 72h
441 포인트 댓글 158
Key Point AI 에이전트와 라이다 기술의 결합이 인간이 놓친 고고학적 발견을 어떻게 가능하게 하는지 보여주며, 비정형 문제 해결에 LLM의 실질적 활용 범위를 확대한다.
핵심 요약
구글 소프트웨어 엔지니어가 NASA의 라이다 데이터를 분석하기 위해 48개의 AI 에이전트(Gemini, ChatGPT, Claude, Grok)를 활용해 멕시코 유카탄반도의 미기록 마야 유적지를 발견했다. 라이다는 레이저 펄스를 숲 캐노피 사이로 쏴 지표면을 매핑하므로, 위성 사진으로 보이지 않는 정글 속 유적을 찾는 데 효과적이다. 에이전트들은 약 1,200km²의 라이다 이미지를 분석하면서 피라미드, 플랫폼, 광장 같은 구조물을 찾되, 자연 언덕이나 싱크홀, 도로는 걸러내는 방식으로 진행했다. 전체 요약 11문장 읽기 → 02 AI · 머신러닝 09:11 게시
원제 United Airlines bans AI agents from booking flights on behalf of travelers
283 포인트 댓글 266
Key Point AI 에이전트가 소비자 서비스 자동화 도구로 확산되는 가운데 항공사의 상반된 대응이 나타나고 있으며, 이는 항공업계의 디지털 정책을 둘러싼 새로운 갈등점을 보여준다.
핵심 요약
유나이티드 항공이 메타의 뮤즈, 오픈AI의 닷츠 같은 AI 에이전트가 승객 대신 항공권을 예약하는 것을 금지한다고 발표했다. 개인 AI 어시스턴트에 계정 인증정보를 공유하면 민감한 정보가 노출되고, 의도하지 않은 구매나 계정 변경, 마일리지 사용이 발생할 수 있다는 이유다. 또한 AI 에이전트가 체크인 같은 행위를 하는 것은 짐에 금지 물질이 없음을 본인이 직접 확인해야 한다는 연방 규정을 위반할 수 있다고 우려했다. 전체 요약 9문장 읽기 → 03 AI · 머신러닝 09:11 게시
원제 Gemini Decisions API
224 포인트 댓글 74
Key Point 의사결정에 특화된 저지연 API가 등장하며 AI 애플리케이션의 라우팅·검증·분류 작업 방식이 바뀌고, 기존 대비 5배 저렴한 가격과 3가지 질문 유형 지원으로 구현 복잡도를 크게 낮춘다.
핵심 요약
구글이 Gemini Decision 1 모델 기반의 Decisions API를 출시했으며, 텍스트·이미지·오디오·비디오·PDF를 포함한 멀티모달 입력에서 최대 1000개의 예/아니오, 선택지, 루브릭 채점 질문을 한 번의 API 호출로 처리할 수 있다. 토큰별 생성이 아닌 단일 포워드 패스 방식으로 동작해 중앙값 50~100ms 모델 계산 시간(엔드투엔드 150~250ms)의 저지연을 유지하며, 최대 16K 토큰 컨텍스트에서 질문 1~100개 구간에서도 거의 선형적인 성능을 보인다. 에이전트 라우팅·추론·랭킹·멀티모달 이해 벤치마크에서 Gemini Decision 1이 최고 성능을 기록했으며, 보정 오류도 가장 낮다. 전체 요약 8문장 읽기 → 04 AI · 머신러닝 03:11 게시
원제 Can a Linear Program Do Weight-Space Programming?
174 포인트 댓글 29
Key Point LLM 가중치 직접 편집의 기계적 원리를 선형 계획법으로 설명하고, AI 에이전트의 탐색 과정을 효율적인 최적화로 대체할 수 있음을 보여주는 사례다.
핵심 요약
MIT CSAIL의 '가중치-공간 프로그래밍' 논문이 공개했듯이, 대형 언어 모델의 가중치를 직접 편집하여 성능을 개선할 수 있다. Qwen3.5-0.8B 모델의 추론 루프 문제를 해결하기 위해 가중치 0.016%를 수정하자 MATH-500 정확도가 7.9%에서 48.1%로 대폭 상승했다. AI 에이전트가 이 작업을 수행하는 과정을 분석하면, 실제로는 어떤 가중치를 변경할지와 변경량을 결정하는 선형 계획법(LP) 문제를 시행착오로 풀고 있었다. 전체 요약 11문장 읽기 → 05 AI · 머신러닝 09:11 게시
원제 Faster Retrieval for Better, More Efficient RAG
135 포인트 댓글 24
Key Point RAG 기반 AI 애플리케이션의 검색 속도가 최대 11배 개선되면 응답 시간 단축과 인프라 비용 절감이 직결되므로, 대규모 검색 시스템을 운영 중인 개발팀과 MLOps 담당자에게 즉시 실무 적용 가능한 최신 최적화 기법이다.
핵심 요약
추천 시스템, 검색, RAG의 핵심인 최대내적탐색(MIPS)은 쿼리 벡터와 수백만 개 후보 벡터를 비교해야 해 계산 비용이 급증하는 문제가 있다. 기존 방법들은 클러스터링과 양자화로 속도를 높이지만 쿼리 분포를 무시하고, RAG에서는 사용자 질문(쿼리)과 문서(키)의 특성이 크게 달라 최적이 아니다. 애플 연구팀은 ICML 2026에서 쿼리별 라우팅을 학습하는 소형 신경망 두 가지를 제시했다: SupportNet은 각 클러스터별 지원함수(support function)를 학습해 라우팅 정확도를 높이고, KeyNet은 쿼리를 최적 키로 직접 변환해 기존 인덱스와 결합한다. 전체 요약 8문장 읽기 → 06 AI · 머신러닝 18:11 게시
원제 Jane Street: Socratic Tutor
117 포인트 댓글 29
Key Point 개발자들이 AI 튜터로 체계적 학습을 구현할 때 필요한 구체적인 설계 사양과 평가 기준이 제시되어 있다.
핵심 요약
Jane Street가 구조화된 소크라테스식 튜터링을 제공하는 에이전트 스킬을 공개했다. 사용자가 '가르쳐줘', '퀴즈 나와', '숙달하게 도와줘' 같은 문구를 명시할 때만 튜터링 모드를 시작하며, 일회성 설명 요청과는 구분한다. 튜터는 먼저 3~5개의 진단 문제로 사용자의 현재 수준을 파악한 뒤, 주제를 4~10개 세부 스킬로 분해하여 0~5 레벨 맵을 제시한다. 전체 요약 10문장 읽기 → 전체 색인3건 · 분야별
AI · 머신러닝3건 001 21:11 ▲ 109 · 댓글 49 정원을 자율 에이전트에게 맡기다 저자는 가정의 2제곱미터 텃밭을 완전 자동화하기로 결심했고, 처음엔 Claude AI에 심기 시기와 방법을 묻는 것으로 시작했다. AI · 머신러닝 · I gave an agent a lakehouse and control of my garden
Key Point IoT 센서 데이터를 단순 규칙 엔진이 아닌 에이전트에게 맡기고 자동 의사결정을 구현하는 구체적 사례로, 개발자들이 원격 측정·제어·의사결정 루프를 어떻게 구축할 수 있는지 보여준다.
핵심 요약
저자는 가정의 2제곱미터 텃밭을 완전 자동화하기로 결심했고, 처음엔 Claude AI에 심기 시기와 방법을 묻는 것으로 시작했다. 토양 수분, 온도, 전도도, 잎 습도, 강우량, 풍속, 태양 복사량을 측정하는 11개 센서(Ecowitt)를 설치해 €300을 투자했으며, 모든 센서를 구글 어스 지도에 고정해 공간 정보를 확보했다. 정원 카메라(Reolink 4K)를 설치해 식물 건강 상태를 모니터링하다가, 캐터필러 손상을 발견할 때 저해상도 전체 프레임보다 높은 해상도 크롭이 더 유용함을 깨달았다. 전체 요약 13문장 읽기 → 002 21:11 ▲ 116 · 댓글 26 화웨이, 로컬 추론용 양자화 도구 MACaQ 공개 화웨이가 개발한 MACaQ는 텍스트, 이미지, 비디오, 오디오 모델을 양자화하는 모델 무관 양자화 도구로, llama.cpp, vLLM, Diffusers, PyTorch 등 다양한 백엔드를 지원한다. AI · 머신러닝 · Huawei releases MACaQ, its internal quantizer for local inference
Key Point 로컬 환경에서 대규모 모델을 빠르게 양자화하려는 개발자들에게 성능과 속도 모두 우수한 새로운 도구가 공개되어, 리소스 제한적인 환경에서의 모델 배포 선택지가 확대되었다.
핵심 요약
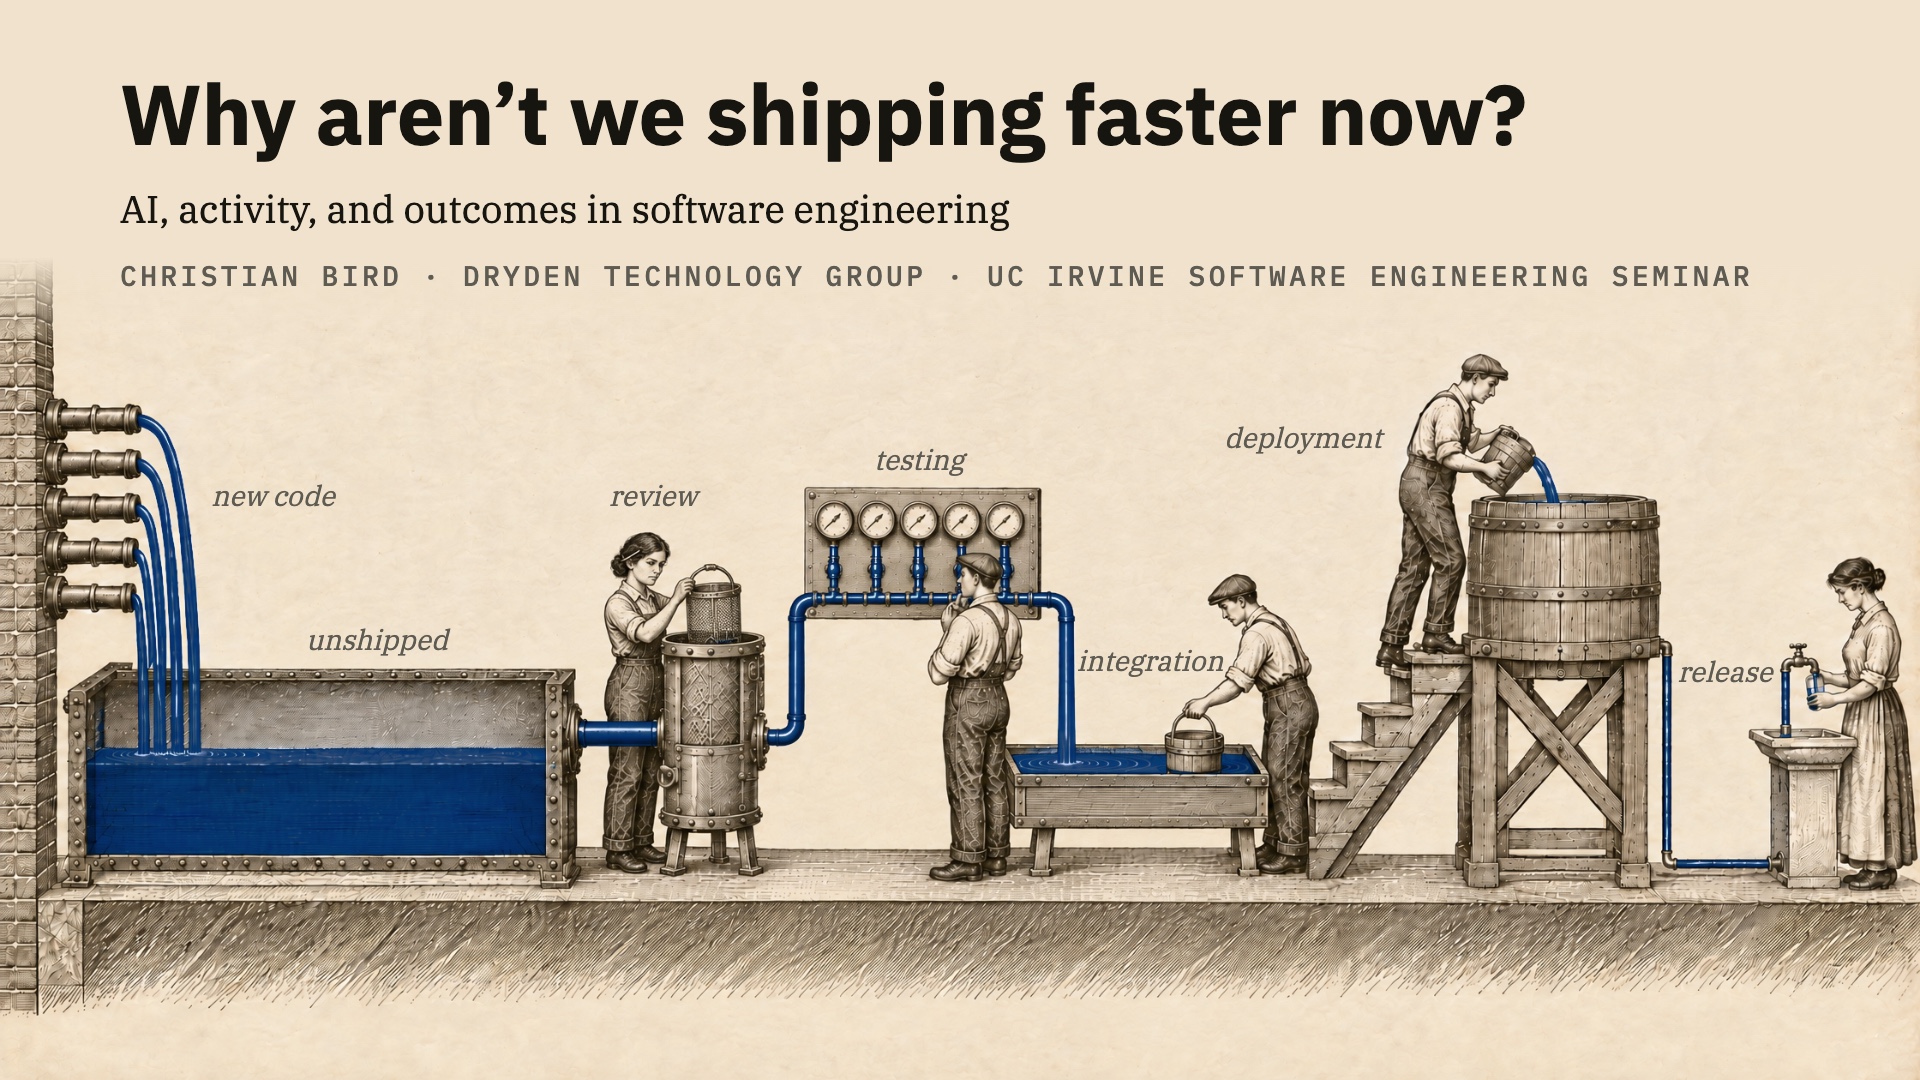
화웨이가 개발한 MACaQ는 텍스트, 이미지, 비디오, 오디오 모델을 양자화하는 모델 무관 양자화 도구로, llama.cpp, vLLM, Diffusers, PyTorch 등 다양한 백엔드를 지원한다. 122B 파라미터 모델을 64분 내에 32.5GB 메모리만으로 양자화할 수 있으며, MR-GPTQ와 DuQuant++보다 더 낮은 퍼플렉시티를 달성하거나 Llama-3-8B에서 11배 빠른 양자화 시간으로 동등한 성능을 제공한다. llama.cpp 백엔드는 2/3/4비트 GGUF 포맷의 텍스트 생성을 지원하고 CPU 실행도 가능하며, vLLM은 W4A4 또는 가중치 전용 양자화로 텍스트 생성 및 서빙을 지원한다. 전체 요약 8문장 읽기 → 003 09:11 ▲ 103 · 댓글 99 AI 시대에 소프트웨어 개발 속도가 빨라지지 않는 이유 UC 어바인 소프트웨어공학 세미나에서 드라이든 테크놀로지 그룹의 크리스천 버드가 발표한 21분 분량의 강연으로, AI와 소프트웨어 엔지니어링의 관계를 다룬다. AI · 머신러닝 · AI, activity, and outcomes in software engineering
Key Point AI 코딩 도구의 급증에도 실제 배포 속도가 개선되지 않는 이유를 학술 근거와 함께 설명하는 연구로, 개발 생산성에 대한 통념을 점검하는 데 중요하다.
핵심 요약
UC 어바인 소프트웨어공학 세미나에서 드라이든 테크놀로지 그룹의 크리스천 버드가 발표한 21분 분량의 강연으로, AI와 소프트웨어 엔지니어링의 관계를 다룬다. 강연은 슬라이드, 핸드아웃(19페이지), 풀 덱(41페이지), 유튜브 영상과 함께 제공된다. 관련 연구 논문으로 '활동-결과 격차: 왜 AI가 소프트웨어 엔지니어링을 해결하지 못하는가'(제출 중)가 있으며, 30명의 인터뷰 내용이 포함되어 있다. 전체 요약 5문장 읽기 → 오늘의 주요당일 스타 상위 2건
01 AI · 머신러닝 21:11 게시
shadcn/improve
원제 shadcn/improve
스타 11,241 당일 +361
Key Point 코드 감사부터 구현까지의 전 과정에서 AI 모델의 비용 효율을 극대화하는 새로운 워크플로우를 제시해, 개발팀의 자동화 도구를 확장할 수 있다.
핵심 요약
코드베이스를 자동으로 감사하고 실행 계획을 작성하는 에이전트 스킬인 'improve'를 깃허브에서 공개했다. 최상급 모델은 코드 이해·판단·계획 작성에만 집중하고, 저비용 모델에게는 실행 자체를 맡겨 비용을 절감한다. 저장소를 매핑한 뒤 정확성·보안·성능·테스트 커버리지·기술 부채·의존성·개발자 경험·문서·기능 제안 등 9개 카테고리로 병렬 감사를 수행한다. 전체 요약 8문장 읽기 → 02 AI · 머신러닝 09:11 게시
facebookresearch/faiss
원제 facebookresearch/faiss
스타 41,484 당일 +111 C++
Key Point 대규모 벡터 기반 검색 시스템을 구축하는 개발자와 연구자에게 필수적인 프로덕션급 도구로, GPU 가속을 통해 실시간 유사도 검색 성능을 대폭 향상시킬 수 있다.
핵심 요약
Meta의 Fundamental AI Research 팀이 개발한 고밀도 벡터의 유사도 검색과 클러스터링을 위한 C++ 라이브러리다. RAM에 맞지 않는 대규모 벡터 집합도 처리 가능하며, L2 거리나 내적, 코사인 유사도로 벡터를 비교한다. 이진 벡터와 압축 양자화 코드 기반 방식은 원본 벡터를 저장하지 않고 수십억 개 벡터를 단일 서버 메모리에서 확장 가능하다. 전체 요약 10문장 읽기 → 읽을 논문
Hugging Face Papers15 커뮤니티가 고른 오늘의 AI 논문
오늘의 주요추천 상위 3건
01 AI · 머신러닝 18:11 게시
원제 Scaling Mathematical Proof Supervision from Structured Textbooks
추천 47 댓글 3 Youqing Fang, Zhouqi Hua, Yinhao Tang 외
Key Point 언어 모델의 수학 능력을 근본적으로 개선할 수 있는 새로운 데이터 구조와 38만 개의 증명 레코드를 제시하는데, 실제 교과서 구조를 보존함으로써 기존 단순 문제-풀이 쌍 방식보다 학습 효율이 크게 높다는 점이 중요하다.
핵심 요약
언어 모델의 수학 학습 데이터는 보통 문제-풀이 쌍으로 단순화되어, 원본 교과서의 조직체계와 증거 구조가 손실된다. 연구팀은 TOME-Math라는 대규모 코퍼스를 구축해 2,118개 대학수학 교과서를 약 38만 개의 구조화된 증명 감독 레코드로 변환했다. 변환 과정에서 장(章) 순서, 명제-증명 연결, 의존성 참조, 출처 정보 등의 구조 신호를 보존했다. 전체 요약 7문장 읽기 → 02 AI · 머신러닝 15:10 게시
원제 One Table, Many Queries: Benchmarking Generalist Tabular Models Across Generation, Imputation, and Prediction
추천 39 댓글 7 Yuanrui Wang, Kaifang Li, Xuanyue Li 외
Key Point 표 데이터 모델링의 세 가지 핵심 작업을 단일 모델로 수행할 수 있는지 처음 체계적으로 평가한 벤치마크로, 현실의 데이터 처리 파이프라인을 통합 설계할지 말지의 기준을 제시한다.
핵심 요약
표 데이터의 세 가지 작업—누락된 값 채우기(imputation), 미래값 예측(prediction), 데이터 생성(generation)—은 같은 데이터 분포를 다루지만 보통 따로 평가한다. 연구팀은 56개 데이터셋과 46개 모델을 포함한 'One Table Benchmark'를 만들어 20가지 능력 축 아래 세 작업을 통일된 조건에서 비교했다. 다섯 가지 신경망을 일곱 가지 목표 조합으로 훈련한 결과, 보충과 예측은 수치 회복과 의존성 보존을 통해 연결되고, 생성은 예측 유틸리티를 통해 둘 모두와 연결된다. 전체 요약 9문장 읽기 → 03 AI · 머신러닝 18:11 게시
원제 SteerDistill: Quantizing LLM Agents via Closed-Loop Teacher Steering
추천 36 댓글 3 Genming Cui, Xiangyu Li, Zixu Hao 외
Key Point LLM 에이전트의 양자화는 추론 비용 절감에 필수적인데, SteerDistill은 기존 방식의 한계를 극복하고 거의 전정밀도 수준의 성능을 유지하면서도 학습 효율을 크게 높인다.
핵심 요약
저비트 양자화는 LLM 에이전트의 추론 비용을 줄이지만 작업 성공률이 떨어지는 문제가 있다. 양자화된 에이전트는 작업 요구사항이나 환경 조건을 간과해 실패하며, 성공한 전정밀도 모델과 다른 행동을 보인다. 기존 방식은 오프라인 데이터로 학생 모델의 실패 상황을 놓치거나, 자체 실행에서 올바른 응답이 부족하다는 한계가 있다. 전체 요약 8문장 읽기 → 전체 색인12건 · 분야별
AI · 머신러닝12건 001 21:11 ▲ 22 · 댓글 12 AI 에이전트의 토큰 낭비 줄이는 'SparseRead' 기술 웹사이트, 문서, 저장소, 도구 응답 등 외부 콘텐츠를 읽을 때 AI 에이전트가 필요한 부분만 처리하지 못하고 전체를 노출받으면서 토큰과 지연 비용이 증가하는 문제를 다룬다. AI · 머신러닝 · Read Less, Solve More: Token-Efficient Sparse Reading of External Content for AI Agents
Key Point AI 에이전트의 컨텍스트 윈도우를 낭비하는 핵심 원인을 해결하면서 성능 손실 없이 비용과 속도를 획기적으로 개선하는 기술이 실증되었다.
핵심 요약
웹사이트, 문서, 저장소, 도구 응답 등 외부 콘텐츠를 읽을 때 AI 에이전트가 필요한 부분만 처리하지 못하고 전체를 노출받으면서 토큰과 지연 비용이 증가하는 문제를 다룬다. SparseRead는 에이전트 모델 수정 없이 콘텐츠 입력을 제어하는 별도 계층으로, Read Intent Protocol이 에이전트의 변화하는 요구사항을 추적하고 소스 범위를 파악한다. Adaptive Reader Backends가 증거 위치를 선택하고 노출 방식을 결정하며, Budgeted Read Gate가 에피소드당 누적 노출을 제한하되 필요시 전체 콘텐츠도 제공한다. 전체 요약 6문장 읽기 → 002 21:11 ▲ 16 · 댓글 3 프롬프트 특성 파악해 LLM 추론 비용 최적화하는 라우팅 기법 대규모 언어 모델(LLM) 서비스는 다양한 요청에 대해 응답 품질과 추론 비용의 균형을 맞춰야 한다. AI · 머신러닝 · Ensemble Routing for Prompt-Adaptive Cost-Aware LLM Inference
Key Point 프롬프트의 복잡도에 맞춰 LLM 앙상블을 동적으로 구성해 비용 대비 성능을 최적화하는 새로운 방식으로, API 기반 LLM 서비스의 경제성을 크게 개선할 수 있다.
핵심 요약
대규모 언어 모델(LLM) 서비스는 다양한 요청에 대해 응답 품질과 추론 비용의 균형을 맞춰야 한다. 기존 라우팅은 각 프롬프트마다 단일 모델을 선택하거나 고정된 앙상블 구성을 사용해 개별 요청에 적응하지 못했다. 논문은 프롬프트 적응형 비용 인식 라우터 PISA와 앙상블 확장 버전인 PISA-E를 제시한다. 전체 요약 10문장 읽기 → 003 21:11 ▲ 11 · 댓글 3 K-means보다 10배 빠른 클러스터링 알고리즘 'e-means' 공개 Lloyd's k-means를 개선한 새로운 클러스터링 알고리즘 e-means를 제안했다. AI · 머신러닝 · e-means: outperforming k-means (in one-tenth the epochs)
Key Point 대규모 임베딩 데이터 클러스터링 속도가 근본적으로 빨라져서, 검색·양자화·데이터 큐레이션 등 실무에서 k-means을 쓰는 작업들의 처리 시간을 획기적으로 단축할 수 있다.
핵심 요약
Lloyd's k-means를 개선한 새로운 클러스터링 알고리즘 e-means를 제안했다. 지수이동평균(exponential moving average) 최적화 절차와 미니배치 업데이트를 사용하며, 딥러닝 기반 인프라를 활용한다. 감쇠율(decay rate)과 배치 크기가 최종 성능에 미치는 영향에 대한 스케일링 법칙을 수립해 하이퍼파라미터 튜닝 없이 다양한 문제 크기에 적용 가능한 공식을 도출했다. 전체 요약 6문장 읽기 → 004 18:11 ▲ 14 · 댓글 5 GTA V를 AI 훈련장으로: 게임 과제로 강화학습 평가 AAA 게임은 에이전트의 지각, 추론, 제어 능력을 평가하기 위한 풍부한 테스트베드를 제공하지만, 과제 성공 여부를 자동으로 검증하기 어려워 수동 평가가 필요했다. AI · 머신러닝 · GTAGym: AAA Game Tasks Environment for Evaluation and Reinforcement Learning
Key Point AAA 게임 환경에서 AI 에이전트를 객관적으로 평가하고 강화학습으로 훈련할 수 있는 자동화된 벤치마크가 생겨, 복잡한 현실 같은 과제에서 AI 성능을 측정하는 새로운 길이 열렸다.
핵심 요약
AAA 게임은 에이전트의 지각, 추론, 제어 능력을 평가하기 위한 풍부한 테스트베드를 제공하지만, 과제 성공 여부를 자동으로 검증하기 어려워 수동 평가가 필요했다. 연구진은 GTA V 작업 평가 및 강화학습을 위한 환경 및 프레임워크인 GTAGym을 개발했다. GTAGym의 평가 벤치마크인 GTAVBench는 GTA V 메인 스토리 미션에서 추출한 9개 작업 계열의 103개 온라인 과제와 GTA V 이미지 기반 47개 사격·저격 과제를 포함한다. 전체 요약 8문장 읽기 → 005 15:10 ▲ 35 · 댓글 8 대형 언어모델, 강화학습으로 '자기주도 학습' 능력 키운다 LLM이 미지의 영역에서 문제를 풀려면 사전학습된 지식이나 고정 검색만으로는 부족하며, 참고 자료를 즉시 습득하고 추론하는 자기주도 학습이 필요하다. AI · 머신러닝 · Incentivizing Self-Learning in Large Language Models via Reinforcement Learning
Key Point 미지의 영역에서 LLM의 문제해결을 좌우하는 '즉각적 학습' 능력을 강화학습으로 끌어내는 방법론을 제시해 지식 습득과 추론의 결합 방식을 새로이 정의한다.
핵심 요약
LLM이 미지의 영역에서 문제를 풀려면 사전학습된 지식이나 고정 검색만으로는 부족하며, 참고 자료를 즉시 습득하고 추론하는 자기주도 학습이 필요하다. 연구팀은 교과서 기반 수학 문제 풀이 과제를 설계했으며, 모델이 교과서 설명을 탐색하고 원리를 학습·적용해 증명을 구성하되 정답은 제공하지 않는다. BookNavigator 인터페이스를 통해 이러한 학습 과정을 지원하고, 미세하게 조정된 보상 신호를 이용한 강화학습으로 자기주도 학습을 유도했다. 전체 요약 6문장 읽기 → 006 12:10 ▲ 11 · 댓글 5 텍스트-비디오 생성 모델의 물리법칙 이해도를 측정하는 평가 프레임워크 등장 텍스트-비디오(T2V) 생성 모델이 세계 시뮬레이터로 자리잡으면서 물리 상식 준수 여부 평가가 필수적이 되었다. AI · 머신러닝 · PhyRubric: Rubric-Grounded Diagnostic Evaluation of Physical Commonsense in Text-to-Video Generation
Key Point 텍스트-비디오 생성 모델의 물리법칙 준수 여부를 객관적이고 진단적으로 평가할 수 있는 표준화된 방법론이 제시되어, 향후 이 분야 벤치마킹과 개선의 기준점이 될 것으로 예상된다.
핵심 요약
텍스트-비디오(T2V) 생성 모델이 세계 시뮬레이터로 자리잡으면서 물리 상식 준수 여부 평가가 필수적이 되었다. 기존 벤치마크는 평가자의 직관에 의존한 단일 점수 방식으로, 주관적이며 어느 물리 원리 위반인지 파악할 수 없다. PhyRubric은 텍스트-비디오 생성의 물리 상식을 진단하는 루브릭 기반 평가 프레임워크다. 전체 요약 8문장 읽기 → 007 12:10 ▲ 11 · 댓글 6 AI 과학 논문 시스템, 근거 왜곡 문제 감지 생의학 연구에 쓰이는 AI 에이전트가 같은 결론을 내면서도 다른 근거를 인용하는 문제를 다룬 감사 프레임워크이다. AI · 머신러닝 · From Tool State to Scientific Action: Auditing Decision Provenance in Biomedical Research Agents
Key Point AI 기반 과학 연구 시스템이 같은 결론 뒤에 서로 다른 근거를 숨기는 위험을 처음 체계적으로 감지하는 방법을 제시하며, 이는 바이오 신약 개발과 같은 실제 응용에서 의사결정 신뢰성을 검증하는 데 필수적이다.
핵심 요약
생의학 연구에 쓰이는 AI 에이전트가 같은 결론을 내면서도 다른 근거를 인용하는 문제를 다룬 감사 프레임워크이다. BioAgent-DF 는 과학 계산 과정에서 저장된 참조값과 후보값의 쌍을 비교해 복원 또는 이식한 후 에이전트를 재실행한다. Qwen 3.5-4B 는 8개 SciFact 배치 중 3개 조합에서 반복적 인용 변화를, Gemma 3 4B IT 는 4개 조합에서 읽음과 인용 변화를 보였다. 전체 요약 7문장 읽기 → 008 06:11 ▲ 28 · 댓글 3 코딩 에이전트의 로봇 제어 능력을 평가하는 벤치마크 공개 로봇 제어에 코딩 에이전트를 활용하는 새로운 패러다임이 등장하면서, 다양한 로봇을 물리 제약 속에서 제어할 수 있는지 평가할 필요가 생겼다. AI · 머신러닝 · Embodied First Exam
Key Point 로봇 제어에 코딩 에이전트를 활용하려는 움직임이 커지는 가운데, 현실 세계 제약 하에서 얼마나 신뢰할 수 있는지 평가할 수 있는 거대한 벤치마크가 공개됐기 때문이다.
핵심 요약
로봇 제어에 코딩 에이전트를 활용하는 새로운 패러다임이 등장하면서, 다양한 로봇을 물리 제약 속에서 제어할 수 있는지 평가할 필요가 생겼다. 연구팀은 '임보디드 퍼스트 엑삼(Embodied First Exam)'이라는 평가 프레임워크를 개발해 공개했다. 47개 로봇에 걸쳐 35개 스위트의 1,156개 태스크로 구성되며, 직접 제어·코드 제어·정책 학습 중 에이전트가 자유롭게 선택할 수 있다. 전체 요약 7문장 읽기 → 009 03:11 ▲ 30 · 댓글 2 대규모 모델도 11배 빠르게 양자화하는 MACaQ 기법 Weight-activation 양자화는 신경망 추론의 메모리와 계산 비용을 줄일 수 있지만, 기존 방식들은 비용이 많이 드는 최적화와 아키텍처별 복잡한 변환을 거쳐야 했다. AI · 머신러닝 · MACaQ: Fast, Model Agnostic Calibrated Quantization for Low-Precision Weights and Activations
Key Point 대규모 모델 양자화의 병목인 오버헤드와 시간을 획기적으로 줄이면서 다양한 아키텍처에 공통 적용 가능해, 효율적인 모델 배포에 실질적 영향을 줄 수 있는 기술이다.
핵심 요약
Weight-activation 양자화는 신경망 추론의 메모리와 계산 비용을 줄일 수 있지만, 기존 방식들은 비용이 많이 드는 최적화와 아키텍처별 복잡한 변환을 거쳐야 했다. MACaQ는 MXFP4 W4A4 포스트트레이닝 양자화 방법으로, 각 선형 계층을 독립적으로 처리한다. 채널별 스케일과 블록-하다마드 변환을 각 계층의 활성화에 온라인으로 적용하고, 역변환을 가중치에 흡수시켜 계층 간 의존성을 제거한다. 전체 요약 8문장 읽기 → 010 03:11 ▲ 14 · 댓글 4 단백질 진화에 최적화된 뮤테이션 예측 모델 공개 깊은 변이 스캐닝 데이터로 사전학습한 ProTEUS는 서열, 진화, 구조 정보를 MutationFormer 아키텍처로 통합 표현하며, 변이체를 잠재 공간의 상태로, 돌연변이를 그 기능적 결과를 예측하는 행동으로 모델링한다. AI · 머신러닝 · ProTEUS: A mutation-resolved world model for closed-loop protein evolution
Key Point 단백질 설계에서 실험 스크리닝으로는 탐색 불가능한 조합적 돌연변이 공간을 효율적으로 탐색하는 AI 모델이 나왔으며, 실제 실험으로 10배 이상의 성능 개선을 입증했다.
핵심 요약
깊은 변이 스캐닝 데이터로 사전학습한 ProTEUS는 서열, 진화, 구조 정보를 MutationFormer 아키텍처로 통합 표현하며, 변이체를 잠재 공간의 상태로, 돌연변이를 그 기능적 결과를 예측하는 행동으로 모델링한다. 기하학적 제약 강제를 통해 AlphaFold3 대비 10배 이상 빠른 물리적으로 타당한 전체 원자 예측 엔진을 개발해 많은 변이체 탐색을 지원한다. 실험 피드백 루프를 통해 단백질 활성 예측을 반복 개선하면서 원하는 표현형으로 진화를 유도한다. 전체 요약 6문장 읽기 → 011 00:11 ▲ 26 · 댓글 4 금융 업무 AI 에이전트를 평가하는 오픈 월드 벤치마크 등장 재무 작업을 수행하는 AI 에이전트들이 웹에서 실시간 데이터를 사용하되, 기존 벤치마크는 작업·데이터·시간을 고정해 실제 위험(데이터 검증 안 함, 미래 정보 사용 등)을 측정하지 못한다는 문제를 제시한다. AI · 머신러닝 · FINCOSMOS: An Open-World Evaluation Paradigm for Agents in Finance
Key Point 금융 영역은 데이터 신뢰성과 시간 정확성이 생명인데, 기존 평가 방식으로는 이런 위험을 잡을 수 없다는 점을 보여줌으로써 AI 에이전트의 신뢰성 평가가 얼마나 어려운지, 그리고 현재 모든 에이전트가 불합격인 이유가 무엇인지 알 수 있다.
핵심 요약
재무 작업을 수행하는 AI 에이전트들이 웹에서 실시간 데이터를 사용하되, 기존 벤치마크는 작업·데이터·시간을 고정해 실제 위험(데이터 검증 안 함, 미래 정보 사용 등)을 측정하지 못한다는 문제를 제시한다. 이를 해결하기 위해 FINCOSMOS라는 오픈 월드 평가 패러다임을 제안하는데, 시뮬레이션된 사용자가 숨겨진 전략을 가지고 있고 에이전트는 웹에서 데이터를 직접 수집해야 한다. 에이전트는 데이터 수집 시점 기준으로 백테스트를 구성하고 검증 가능한 결과를 제출해야 하며, 채점은 참고 정답 없이 프로그램이 시점별 정확성과 모든 보고된 지표를 재계산한다. 전체 요약 6문장 읽기 → 012 00:11 ▲ 18 · 댓글 3 음성 생성 통합 엔드투엔드 프레임워크 WaveGen 공개 WaveGen은 확산 모델 기반의 완전 엔드투엔드 텍스트-파형 생성 프레임워크로, 스펙트럼 강제(Spectral Forcing) 기법으로 내부 스펙트럼 궤적과 대상 파형 궤적을 단일 모델에서 동시 학습한다. AI · 머신러닝 · WaveGen: Truly End-to-End Waveform Generation via Internal Spectral Trajectory Learning
Key Point 기존 음성 합성 파이프라인의 복잡한 멀티스테이지 구조를 완전히 통합하고 외부 모듈 의존성을 제거한 진정한 엔드투엔드 모델로, 음성 생성 시스템의 단순화 가능성을 보여준다.
핵심 요약
WaveGen은 확산 모델 기반의 완전 엔드투엔드 텍스트-파형 생성 프레임워크로, 스펙트럼 강제(Spectral Forcing) 기법으로 내부 스펙트럼 궤적과 대상 파형 궤적을 단일 모델에서 동시 학습한다. 신경 오디오 코덱, 멜-스펙트로그램 보코더, VAE 기반 잠재 모델 등 별도 학습된 중간 표현에 의존하지 않으며, 지속시간 예측기 같은 외부 정렬 모듈 없이 모델 내부에서 텍스트-음성 정렬을 수행한다. BERT 기반 텍스트 임베딩, Wav2Vec 2.0 기반 의미 표현, 의미 증류 같은 자기지도 표현 의존성도 제거해 진정한 엔드투엔드 구조를 유지한다. 전체 요약 7문장 읽기 → ● 이번 피드는 여기까지입니다.
작은 발견을 다음 커밋으로 이어가세요. 모든 발행본