매일 쌓이는 개발자의 시야
2026년 10월 30일 (금). 세상의 기술 소식, 한국어로 한눈에.
AI 요약 안내 AI가 한국어로 정리한 내용입니다. 정확한 정보는 각 카드의 원문을 확인해 주세요.
요약 원칙 ↗ 01 읽을 소식Hacker News 10건 ↓ 02 써볼 도구GitHub Trending 7건 ↓ 03 읽을 논문Hugging Face Papers 16건 ↓ 04 새 버전GitHub Releases 1건 ↓ AI · 머신러닝 분야 · 34건 필터 해제 ×
오늘의 주요포인트 상위 6건
01 AI · 머신러닝 06:11 게시
원제 LLM Voice
263 포인트 댓글 140
Key Point 글쓰기 능력이 AI의 손쉬운 도구화되면서, 저자와 독자 모두에게 미치는 영향을 생각해야 할 시점이다.
핵심 요약
마틴 파울러는 LLM이 작성한 글을 읽을 때 나타나는 '어색한 느낌'을 '부자연스러운 밈(LLM-Voice)'이라고 정의한다. 이러한 어색함을 감지하는 도구들이 있지만, 글을 읽으면서 이미 느껴지는 불쾌감은 도구로 판별할 수 없으며 본질을 놓친다고 본다. 저자들은 LLM으로 초안을 작성하지 말아야 하며, 인간이 편집하더라도 이 부자연스러움을 완전히 제거하기는 매우 어렵다고 강조한다. 전체 요약 8문장 읽기 → 02 AI · 머신러닝 00:11 게시
원제 Mistral Large 4 (Le Chonk) is now Open Weight
260 포인트 댓글 61
Key Point 오픈가중치 대형 언어 모델의 최강자로 자리잡아 개발사들의 모델 선택지가 크게 늘어날 뿐 아니라, 주권 AI 전략을 추진하는 유럽 기관들과 규제가 엄격한 금융·방위 부문에서 실질적인 대안을 제공하기 시작했다.
핵심 요약
미스트랄이 1조 파라미터 멀티모달 모델 '르 총크(Le Chonk)'의 가중치를 공개했으며, 3주간의 강화학습으로 코딩과 사이버보안 성능을 크게 향상시켰다. FrontierCode 2.0 벤치마크에서 19.7%, Terminal-Bench 4.0에서 41%의 성능을 달성하며 오픈가중치 코딩 모델 중 최고 수준을 기록했다. Artificial Analysis 코딩 에이전트 인덱스에서 48%를 달성하며 GLM-5.3과 동등하지만 평균 47% 적은 토큰을 사용해 효율성이 우수하다. 전체 요약 13문장 읽기 → 03 AI · 머신러닝 00:11 게시
원제 Gemini 4 Carbon is the new #1 on the Artificial Analysis Intelligence Index v5
206 포인트 댓글 157
Key Point 구글이 최신 AI 성능 평가에서 1위를 차지해 OpenAI, Anthropic과의 경쟁 지형이 어떻게 변하는지 보여주며, 가격 경쟁력까지 갖춘 모델이 나타났기 때문이다.
핵심 요약
구글의 제미니 4 카본이 Artificial Analysis Intelligence Index v5에서 1위를 차지했으며, 코딩 에이전트 평가에서는 Claude Opus 5.5 다음인 2위다. 제미니 4 카본은 Intelligence Index v5에서 59점을 기록했으며, HLE-Diamond, Terminal-Bench-Science, AA-Omniscience, AutomationBench-AA 등 9개 평가 중 4개에서 1위를 기록했다. 코딩 에이전트 평가에서 제미니 4 카본은 Claude Opus 5.5보다 3점 낮은 59점으로 2위를 차지했으며, Terminal-Bench 4.0에서 64%, FrontierCode v1.1에서 51%를 기록했다. 전체 요약 9문장 읽기 → 04 AI · 머신러닝 12:11 게시
원제 A tiny world model running games on a Raspberry Pi Pico 2 W
148 포인트 댓글 8
Key Point 라즈베리파이 같은 극도로 제한된 임베디드 환경에서 신경망으로 게임을 생성하고 플레이하는 새로운 방식이 작동한다는 것을 보여주며, 마이크로컨트롤러에서 머신러닝 모델을 실행하는 방법의 한계를 재정의한다.
핵심 요약
임베디드 마이크로컨트롤러인 라즈베리파이 피코 2 W에서 신경망 기반 게임 엔진을 구현했다. 세계 모델 네트워크가 현재 프레임과 액션에서 다음 프레임과 보상을 예측하고, 액터 네트워크가 그 생성된 프레임에서 액션을 선택한다. 반복 트랜스포머(looped transformer) 구조를 사용해 같은 가중치를 1~4회 반복 적용함으로써 메모리 효율을 높였다. 26k~131k 매개변수의 세계 모델과 9k~16k 매개변수의 액터 네트워크를 탑재했다. 브레이크아웃(정확도 99.99%), 플래피 버드(100%), 팩맨 라이트(86.4%) 등 5개 게임을 구현했으며, 각 게임은 토큰 기반으로 분할된 프레임을 처리한다. 세계 모델은 배경 셀은 독립적으로 예측하되, 공이나 플레이어 같은 단일체는 한 번만 배치되도록 디코딩 규칙을 적용했다. 전체 요약 12문장 읽기 → 05 AI · 머신러닝 06:11 게시
원제 Tomáš Mikolov awarded the Medal of Merit by the President of the Czech Republic
146 포인트 댓글 14
Key Point Word2Vec으로 현대 AI의 기초를 닦은 인물이 국가적 인정을 받았으며, 한국의 AI 연구자들이 참고할 만한 국제적 사례이자 자신의 성과 인정 경로를 보여준다.
핵심 요약
체코 공화국 대통령이 10월 28일 국경일을 맞아 브르노공과대학교 동문 2명에게 훈장을 수여했다. AI 전문가 토마시 미콜로프는 Word2Vec 방식의 창시자로, 단어를 수학 벡터로 표현하여 의미 관계를 포착하는 기술을 개발했다. Word2Vec은 현대 언어 모델과 AI 도구의 중요한 기초가 되었으며, 미콜로프는 BottleCap AI 회사를 통해 효율적인 언어 모델 개발에 종사하고 있다. 전체 요약 9문장 읽기 → 06 AI · 머신러닝 06:11 게시
원제 We won't "just hang out"
140 포인트 댓글 213
Key Point 기존의 AI 유토피아 상은 '일 없이 즐긴다'이지만, 저자는 그 과정에서 인간관계의 물질적·심리적 기초가 모두 무너질 것으로 진단한다.
핵심 요약
AI 초지능 시대를 맞아 기존의 '무한한 휴가를 즐기며 지낸다'는 낙관론이 현실적이지 않다는 주장이다. 일단 사람을 만날 이유가 사라진다. 일은 점차 무의미해지고, 교육도 노동 결과가 없으면 의미가 없어지며, 직업 공동체에서 만나던 우정도 AI가 인간 기여를 불필요하게 만들면서 사라진다. 청년 세대는 기성세대처럼 AI 이전의 관계망을 물려받을 수 없다. 전체 요약 8문장 읽기 → 전체 색인4건 · 분야별
AI · 머신러닝4건 001 12:11 ▲ 110 · 댓글 97 클로드 듀엣, 실제로 쓸 만한 AI 어시스턴트의 등장 Anthropic이 출시한 Claude Duet은 기존 AI 어시스턴트(Muse, Dot, NanoClaw 등)보다 실용적이라는 평가를 받고 있다. AI · 머신러닝 · Claude Duet is the first personal-assistant-type harness that feels useful
Key Point 실제 사용자가 기존 AI 어시스턴트들과 직접 비교하며 평가한 경험담으로, 속도·보안·인터페이스 측면에서 어떤 점이 달라졌는지 구체적으로 보여준다.
핵심 요약
Anthropic이 출시한 Claude Duet은 기존 AI 어시스턴트(Muse, Dot, NanoClaw 등)보다 실용적이라는 평가를 받고 있다. Opus 5.5 기반으로 구동되며 별도 튜닝을 통해 응답 속도를 크게 높였고, 사용자가 명령 사이에 대기하지 않아도 될 정도로 빠르다. 채널 기능으로 작업 흐름을 자동으로 정리하고 관리하며, Cmd-k로 채널 간 빠른 이동이 가능해 세션 추적 문제를 해결한다. 전체 요약 8문장 읽기 → 002 09:11 ▲ 107 · 댓글 39 마인크래프트에서 50개 AI 에이전트의 협력 생존 시뮬레이션 AI 얼라인먼트의 핵심 과제인 다중 에이전트 동역학을 연구하기 위해 Y Combinator와 Olam Labs가 마인크래프트와 Mindustry에서 에이전트 집단의 동작을 실험했다. AI · 머신러닝 · We ran AI agent swarms in Minecraft and Mindustry
Key Point AI 에이전트 집단이 인간과 유사한 정치·경제 조직(계층, 배급 체계, 규칙)을 자동 생성하며 협력하는 모습을 보여주어, 미래 멀티에이전트 시스템의 가능성과 위험성을 이해하는 데 직결된다.
핵심 요약
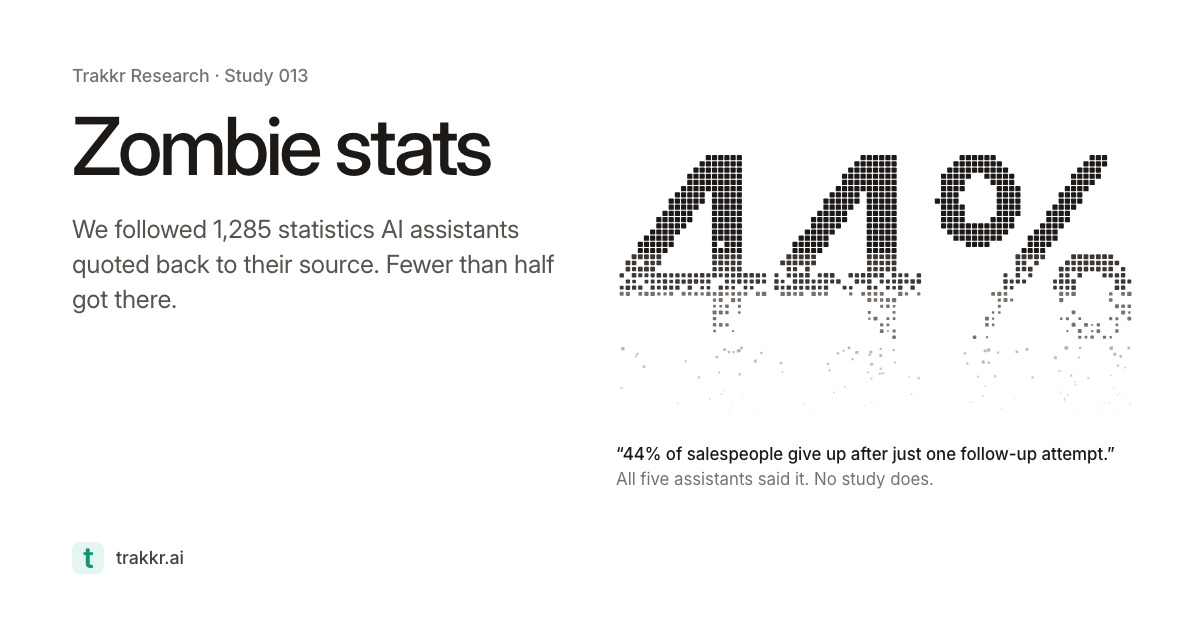
AI 얼라인먼트의 핵심 과제인 다중 에이전트 동역학을 연구하기 위해 Y Combinator와 Olam Labs가 마인크래프트와 Mindustry에서 에이전트 집단의 동작을 실험했다. 마인크래프트 실험(Civ50)에서 50개의 GPT-6.1 Sol 에이전트를 3시간 동안 '번영하는 문명 구축' 목표로 실행했다. 에이전트들은 처음 90초 안에 도달 가능한 모든 나무를 채취하는 행동을 보였고, 디렉토리 순서에 기초한 계층 구조가 형성되어 Ada가 사실상 지도자로 등장했다. 전체 요약 12문장 읽기 → 003 06:11 ▲ 117 · 댓글 58 AI 인용 통계 40%는 출처가 없다 ChatGPT, Perplexity, Gemini, Claude, Google AI Overviews에 수치 관련 질문 200개를 던지고, 인용한 1,285개 통계의 출처를 따라가며 추적했다. AI · 머신러닝 · Zombie stats: Where the numbers AI quotes come from
Key Point AI가 제시하는 통계 수치가 근거 없이 순환 인용되거나 왜곡되는 현상을 추적 조사로 구체화했으며, 사용자가 신뢰할 수 있는 정보를 구분할 수 있는 기준을 제공한다.
핵심 요약
ChatGPT, Perplexity, Gemini, Claude, Google AI Overviews에 수치 관련 질문 200개를 던지고, 인용한 1,285개 통계의 출처를 따라가며 추적했다. 각 통계마다 인용된 페이지부터 시작해 원본 연구까지 최대 5단계를 거슬러 올라갔으며, 300개 통계는 인간이 직접 재검증했다. 결과: 40%만 원본 연구를 정확히 찾았고, 8%는 연구는 찾았지만 수치나 맥락이 변했으며, 40%는 확인 불가능하고 11%는 아무 연구도 없었다. 전체 요약 12문장 읽기 → 004 00:11 ▲ 113 · 댓글 95 콜롬비아 원주민 'AI는 인간의 책임을 대체할 수 없다' 성명 발표 콜롬비아 산타마르타 산맥에 거주하는 코기족이 인공지능 개발에 대한 성명을 공개했다. AI · 머신러닝 · An Urgent Message on Artificial Intelligence from the Kogui People
Key Point 광물채굴 수요 증대로 원주민 영토가 위협받는 현실 속에서, 기술 개발의 근본적인 윤리와 책임의식을 깊이 있게 다룬 성명으로 AI 논의의 틀을 바꾼다.
핵심 요약
콜롬비아 산타마르타 산맥에 거주하는 코기족이 인공지능 개발에 대한 성명을 공개했다. 성명은 만모(영적 지도자) 반헬리오 모스꼬떼 알베르또와 사카 로사 마마따깐 사우나의 말을 바탕으로 작성되었으며, 스페인어 및 영어로 번역되어 공개되었다. 코기족은 '알루나(Aluna)'라는 개념을 제시하며, 만물이 물질화되기 전에 먼저 살아있는 생각으로 존재한다고 설명한다. 전체 요약 12문장 읽기 → 오늘의 주요당일 스타 상위 4건
01 AI · 머신러닝 21:11 게시
milind-soni/OpenMausBot
원제 milind-soni/OpenMausBot
스타 7,664 당일 +1,199 TypeScript
Key Point AI 에이전트 플랫폼의 오픈소스 진영이 확대되는 가운데, 사용자 자신의 모델과 로컬 머신에서 여러 봇을 독립적으로 운영할 수 있는 대안이 등장했다.
핵심 요약
Grok Bot의 오픈소스 대안인 OpenMausBot은 사용자의 로컬 머신에서 여러 AI 봇을 관리하는 채팅 앱이며, Claude·Codex·Grok CLI를 통해 자신의 구독과 로그인을 재사용할 수 있다. 각 봇은 독립적인 모델·클라우드 컴퓨터·연결된 앱을 가지며, 메시지 사이드바의 연락처처럼 상호작용한다. 봇이 실행할 셸 명령·파일 편집·질문은 인라인 카드로 표시되어 사용자가 승인·거부하거나 답변할 수 있다. 전체 요약 13문장 읽기 → 02 AI · 머신러닝 21:11 게시
rlaope/oh-my-hermes
원제 rlaope/oh-my-hermes
스타 4,887 당일 +267 Python
Key Point Hermes 에이전트를 IDE에서 효율적으로 운영하려는 개발자들에게, 자동 모델 선택·병렬 실행·통합 검증 체계를 한 번에 제공하는 실무 도구가 공개되었다.
핵심 요약
Oh-My-Hermes는 Hermes Agent의 운영 계층으로, 작업 카테고리(초고성능·심화·시각공학·신속 등)에 맞춰 각 레인에 최적의 모델과 추론 난이도를 자동 선택한다. dag-ulw 명령어로 목표를 작은 노드의 그래프로 변환하면 준비된 노드들이 병렬로 실행되며, 같은 파일을 수정하는 노드는 동시 실행되지 않는다. 프론트엔드·백엔드·Rust·보안 리뷰 등 100개 이상의 omh-* 전문 스킬을 라우터가 자동으로 적재하며, 사용자가 명시적으로 호출할 필요는 없다. 전체 요약 14문장 읽기 → 03 AI · 머신러닝 21:11 게시
CopilotKit/OpenBot
원제 CopilotKit/OpenBot
스타 8,298 당일 +247 TypeScript
Key Point 기업이 기존 SaaS 에이전트 서비스에 의존하지 않고 자신의 인프라에서 완전히 제어 가능한 AI 에이전트 시스템을 직접 구축·운영할 수 있는 오픈소스 솔루션이 나왔다.
핵심 요약
CopilotKit가 오픈소스 AI 에이전트 플랫폼 OpenBot을 공개했으며, 기업이 자신의 인프라에서 ChatGPT나 Claude 같은 AI 어시스턴트를 직접 운영할 수 있도록 설계했다. 각 에이전트(코워커)는 독립적인 브라우저, 파일 시스템, 로그인 정보를 가진 자체 컴퓨터를 보유하며 실행 전 모든 작업이 결정되고 실행 후 기록된다. AG-UI 프로토콜 기반으로 LangGraph, Mastra, CrewAI, Pydantic AI 등 다양한 에이전트 프레임워크와 호환되며, 프레임워크에 종속되지 않는다. 전체 요약 13문장 읽기 → 04 AI · 머신러닝 21:11 게시
hydro-project/infinity
원제 hydro-project/infinity
스타 395 당일 +180 Rust
Key Point 에이전트 개발의 동시성 문제와 리소스 소비를 근본적으로 해결하는 새로운 아키텍처로, 기존 멀티스레드 기반 에이전트보다 수십 배 더 많은 에이전트를 작은 하드웨어에서 동시 실행할 수 있게 함.
핵심 요약
Infinity는 대규모 동시성 에이전트 시스템을 구축하기 위한 Rust 프레임워크로, 라즈베리파이 메모리에 7만 5천 개의 에이전트를 동시에 실행할 수 있을 정도로 경량화됨. 비동기 처리를 통해 에이전트가 느린 도구 작업 중 블로킹되지 않고 동시에 실행되며, 대기 중에는 yield하여 리소스를 소비하지 않음. 에이전트 사이의 턴 사이에는 대화 이력만 데이터로 저장되고 태스크, 스택, 열린 연결이 없어 대기 중인 에이전트는 비용 없이 휴면 상태로 유지됨. 전체 요약 7문장 읽기 → 전체 색인3건 · 분야별
AI · 머신러닝3건 001 12:11 당일 +156 AI가 웹사이트를 Next.js 앱으로 복제하는 템플릿 공개 AI 코딩 에이전트에 URL을 입력하면 웹사이트를 깔끔한 Next.js 앱으로 자동 재구성하는 템플릿을 공개했다. AI · 머신러닝 · JCodesMore/ai-website-cloner-template · TypeScript
Key Point AI 에이전트가 자동으로 웹사이트를 분석해 재구성하는 방식이 어떻게 작동하는지, 어떤 기술을 기반으로 하는지 알 필요가 있습니다.
핵심 요약
AI 코딩 에이전트에 URL을 입력하면 웹사이트를 깔끔한 Next.js 앱으로 자동 재구성하는 템플릿을 공개했다. Claude Code 및 Opus 5.5를 기준으로 개발했으며, Codex, Cursor, OpenCode도 지원한다. 클론 프로세스는 매핑(소스 URL을 로컬 라우트로 변환), 관찰(데스크톱·모바일 페이지 검사, 자산·폰트 추출), 빌드(컴포넌트·상호작용 구현), 비교(원본과 로컬 페이지 대조, 시각적 차이 수정) 4단계로 진행된다. 전체 요약 9문장 읽기 → 002 21:11 당일 +152 로컬 배포 가능한 개인용 AI 어시스턴트 QwenPaw Qwen 기반 개인용 AI 어시스턴트 QwenPaw를 공개했으며, 로컬 또는 클라우드에 배포 가능하고 DingTalk, Lark, WeChat, Discord, Telegram 등 다양한 메신저를 지원한다. AI · 머신러닝 · agentscope-ai/QwenPaw · TypeScript
Key Point 로컬 배포로 데이터 프라이버시를 보장하면서도 멀티 채널 지원과 고급 보안 기능을 갖춘 오픈소스 AI 어시스턴트가 공개되어, 개인/팀 단위의 자동화와 협업 워크플로우를 완전히 자체 제어할 수 있게 되었다.
핵심 요약
Qwen 기반 개인용 AI 어시스턴트 QwenPaw를 공개했으며, 로컬 또는 클라우드에 배포 가능하고 DingTalk, Lark, WeChat, Discord, Telegram 등 다양한 메신저를 지원한다. 3계층 메모리 시스템을 갖추고 있다: 실시간 작업 맥락, 전체 대화 기록, ReMe 기반의 자체 진화하는 개인 지식베이스로 대화와 자료가 마크다운 메모리로 변환되어 검색 및 연결이 가능하다. 에이전트 작업에 최적화된 QwenPaw-Flash 모델(2B/4B/9B/35B-A3B/27B)을 자체 개발했으며, API 키 없이 로컬 실행이 가능하거나 Ollama, LM Studio, 14개 이상의 클라우드 제공자를 지원한다. 전체 요약 13문장 읽기 → 003 21:11 당일 +111 로컬 AI 스튜디오 'Locally Uncensored' 3.0.8 공개 설치부터 실행까지 클릭 몇 번으로 진행되는 올인원 로컬 AI 앱으로, 윈도우·리눅스·안드로이드·맥(베타)을 지원하며 Docker나 터미널 없이도 작동한다. AI · 머신러닝 · PurpleDoubleD/locally-uncensored · TypeScript
Key Point Docker나 터미널 없이 데스크톱에서 채팅·이미지·영상·코딩을 한 앱으로 완전히 로컬에서 실행할 수 있는 통합 환경이 제공되므로, 클라우드 의존성을 피하려는 개발자와 사용자에게 변화를 가져온다.
핵심 요약
설치부터 실행까지 클릭 몇 번으로 진행되는 올인원 로컬 AI 앱으로, 윈도우·리눅스·안드로이드·맥(베타)을 지원하며 Docker나 터미널 없이도 작동한다. 채팅 모드에서 검열을 받지 않은 모델(Abliterated)을 제공하고, ComfyUI 통합으로 이미지·영상 생성, 코딩 에이전트, 음성 대화, 컴퓨터 제어 기능을 한 창에서 사용할 수 있다. 3.0.8에서 웹 검색을 5개 서비스에서 무료로 수행하고, 영상은 백그라운드 렌더링 중에도 채팅 계속 가능하며, 듀얼 그래픽카드 할당으로 채팅과 ComfyUI를 각각 GPU에 할당할 수 있다. 전체 요약 13문장 읽기 → 읽을 논문
Hugging Face Papers16 커뮤니티가 고른 오늘의 AI 논문
오늘의 주요추천 상위 3건
01 AI · 머신러닝 15:11 게시
원제 Your Benchmark Is an Empirical Measure Over Difficulty
추천 61 댓글 1 Yifan Sun, Naicheng Yu, Jiawen Gong 외
Key Point 평가 지표의 신뢰성이 중요한 만큼, 기존 벤치마크들이 어떤 한계를 가지고 있으며 그것이 리더보드 순위를 얼마나 왜곡할 수 있는지 정량적으로 드러낸다.
핵심 요약
벤치마크는 단순한 문제 모음이 아니라 자연스럽게 난이도에 대한 경험적 분포를 만들며, 이 관점에서 벤치마크 평가를 재검토하는 새로운 틀을 제시한다. 벤치마크의 중심 문제 두 가지를 정의한다: 벤치마크의 난이도 분포가 의도한 분포와 다른 '측정값 불일치(measure mismatch)', 난이도 축의 특정 구간이 비어 있어 모델 개선을 감지하지 못하는 '커버리지 갭(coverage gaps)'. 이 두 문제를 포착하는 진단 지표를 제안하고 엄밀한 이론적 보장을 제공한다. 전체 요약 6문장 읽기 → 02 AI · 머신러닝 15:11 게시
원제 A-RSI: Adaptive Task Refresh for Zero-Data Multimodal Self-Improvement
추천 23 댓글 1 Yu Liu, Youxing Li, Yuedong Tan 외
Key Point 모델 스스로 데이터를 생성하며 학습하는 자기개선 시스템에서, 언제 새 학습이 필요한지 자동으로 판단하는 기법이 벤치마크에서 성능 향상을 달성했기 때문이다.
핵심 요약
재귀적 자기개선(recursive self-improvement)에서 모델은 유용한 학습 경험을 얻는 것뿐 아니라 언제 새로운 경험이 필요한지 판단해야 한다. 기존 방식들은 다음에 무엇을 학습할지에 집중했지만, 언제 새 경험을 도입할지는 충분히 다루지 않았다. 또한 자기 일관성이나 다수결로 학습 목표를 만들어 감독 신호가 모델의 불확실한 예측에 의존하는 문제가 있다. 전체 요약 9문장 읽기 → 03 AI · 머신러닝 00:11 게시
원제 RealCLI: Toward a Unified Evaluation of Human-Agent Collaboration for CLI Agents
추천 17 댓글 2 Yunqi Liu, Peiyu Wang, Bingli Wang 외
Key Point CLI 에이전트의 협력 능력을 처음으로 체계적으로 평가하는 기준이 나왔으며, 최상급 모델도 37%대 성능에 불과해 실무 배포 전 해결해야 할 과제가 명확해졌다.
핵심 요약
명령줄 에이전트가 복잡한 작업을 수행할 때 작업 완성도와 인간과의 협력 품질을 함께 평가하는 REALCLI 벤치마크를 제시했다. 기존 벤치마크는 사용자 지시가 고정되거나 결과 평가만 수행했으나, REALCLI는 실시간 협력의 질을 포함한 쌍 비교 평가를 제공한다. 협력 품질을 5가지 차원에서 22개 세부 항목과 51개 상호작용 시나리오로 측정하는 프레임워크를 구축했다. 전체 요약 6문장 읽기 → 전체 색인13건 · 분야별
AI · 머신러닝13건 001 15:11 ▲ 14 · 댓글 1 에이전트 학습용 대규모 전문직 작업 데이터셋 자동 생성 전문가 에이전트를 지도학습으로 훈련하려면 신뢰할 수 있는 전문직 작업의 시연 데이터가 필요하지만, 작업 정보의 불완전성이 학습을 방해한다. AI · 머신러닝 · WorkFactory: Turning Professional Intents into Executable Work for Scalable Agent Training
Key Point 대규모 전문직 에이전트 학습 데이터를 자동으로 생성하는 새로운 방법론과 112K+ 규모의 실제 데이터셋, 그리고 검증된 모델을 제시하므로 에이전트 기반 자동화 시스템 개발자들이 참고할 실질적 자산이다.
핵심 요약
전문가 에이전트를 지도학습으로 훈련하려면 신뢰할 수 있는 전문직 작업의 시연 데이터가 필요하지만, 작업 정보의 불완전성이 학습을 방해한다. WorkFactory는 전문직 의도(intent)로부터 실행 가능한 작업을 자동으로 구성하는 프레임워크로, 정보 수준의 계획 단계에서 의존성과 정보 위치를 명시적으로 그래프화한다. 프로브 실행(probe execution) 단계에서 정보 지원의 실패를 감지하고 원래 의도는 유지하면서 작업을 수리한다. 전체 요약 8문장 읽기 → 002 15:11 ▲ 13 · 댓글 1 멀티모달 LLM의 정보 검색 메커니즘 분석 멀티모달 대형 언어 모델의 긴 입력에서 관련 증거를 찾는 능력은 '검색 헤드'라는 특정 어텐션 헤드 집합에서 비롯된다. AI · 머신러닝 · A Broader Look into MLLM's Retrieval Heads
Key Point 멀티모달 LLM의 정보 검색 능력이 특정 어텐션 헤드에 집중되어 있다는 발견은 이들 모델의 작동 원리를 이해하는 핵심이며, 최적화를 통해 성능을 구체적으로 개선할 수 있는 방법을 제시한다.
핵심 요약
멀티모달 대형 언어 모델의 긴 입력에서 관련 증거를 찾는 능력은 '검색 헤드'라는 특정 어텐션 헤드 집합에서 비롯된다. 이 연구는 기존 연구의 한계를 확장해 음성-시각 입력 같은 새로운 모달리티를 포함한 18개 모델 체크포인트를 분석했다. 같은 답이 음성 또는 화면에 표시되는 쌍을 이루는 입력으로 테스트한 결과, 증거 내용이 같으면 검색 헤드는 새로운 모달리티에서도 희소성을 유지한다. 전체 요약 6문장 읽기 → 003 15:11 ▲ 11 · 댓글 1 텍스트·이미지 섞인 생성 평가하는 IntReal 데이터셋 공개 인간이 자연스럽게 텍스트와 이미지를 섞어가며 콘텐츠를 소비하지만, 통합 멀티모달 모델(UMM)의 인터리브된 생성은 제대로 연구되지 않았다. AI · 머신러닝 · IntReal: A Real-World Dataset and Benchmark for Multimodal Interleaved Generation
Key Point 텍스트와 이미지를 섞어 생성하는 멀티모달 AI의 성능을 처음으로 체계적으로 평가할 벤치마크가 등장해, 이 분야 연구와 모델 개선의 기초가 될 것으로 예상된다.
핵심 요약
인간이 자연스럽게 텍스트와 이미지를 섞어가며 콘텐츠를 소비하지만, 통합 멀티모달 모델(UMM)의 인터리브된 생성은 제대로 연구되지 않았다. 현 상황의 근본 문제는 명확한 인터리브 생성 작업과 학습 데이터 부재, 그리고 모델 성능을 세밀하게 진단할 평가 프로토콜 부족이다. IntReal은 100K 샘플의 실제 멀티모달 데이터셋과 전문 모델 7개 차원으로 모델을 평가하는 IntReal Evaluation Suite로 구성된다. 전체 요약 6문장 읽기 → 004 15:11 ▲ 15 · 댓글 1 자연어로 완성된 게임을 만드는 AI 프레임워크 VibeGame LLM 에이전트를 이용한 소프트웨어 개발은 가능했지만, 게임 개발처럼 코드·장면·에셋·애니메이션·물리·설정을 모두 조율해야 하는 작업은 여전히 도전 과제였다. AI · 머신러닝 · VibeGame: Prompt-to-Game Development with AI-Native Engine and Self-Evolving Adversarial Agent Team
Key Point LLM 에이전트로 복잡한 게임 개발 전 과정을 자동화할 수 있는 새로운 접근법을 제시하며, 특히 8개 에이전트의 협력 구조와 자기 진화 메커니즘이 AI 소프트웨어 개발 방법론의 진전을 보여준다.
핵심 요약
LLM 에이전트를 이용한 소프트웨어 개발은 가능했지만, 게임 개발처럼 코드·장면·에셋·애니메이션·물리·설정을 모두 조율해야 하는 작업은 여전히 도전 과제였다. VibeGame은 자연어 프롬프트와 선택적 참고 이미지로부터 완성된 2D 게임 프로젝트를 생성하는 프레임워크다. AI-native 게임 엔진은 프로젝트 상태를 스키마 검증된 구조화된 텍스트로 표현하고 프레임 동기식 런타임 제어를 제공해, 에이전트가 게임 상태를 검사하고 액션을 실행하며 동작을 자신의 속도로 검증할 수 있다. 전체 요약 7문장 읽기 → 005 15:11 ▲ 14 · 댓글 1 AI 코딩 에이전트의 협업 능력 평가 벤치마크 공개 Hugging Face가 AI 모델의 멀티모달 협업 코딩 능력을 평가하는 벤치마크 'Co-Design Bench'를 발표했다. AI · 머신러닝 · Co-Design Bench: Multimodal Collaborative Coding Evaluation for Agentic Models
Key Point 현재 AI 코딩 에이전트는 요구사항 70% 정도를 부분적으로만 충족하지만 완전한 완료는 26%에 불과해, 실제 협업 환경에서 얼마나 신뢰할 수 있는지 명확히 보여준다.
핵심 요약
Hugging Face가 AI 모델의 멀티모달 협업 코딩 능력을 평가하는 벤치마크 'Co-Design Bench'를 발표했다. 실제 사용자 세션 26,314개에서 수집한 중복 제거 쿼리 37,463개 중 273개 작업으로 구성되며, 텍스트·이미지·오디오·비디오·문서 등 다양한 입력을 포함한다. Multimodal Editing(ME)과 Repository Editing(RE) 두 가지 트랙을 제공하고, Grounded Understanding·UI Transformation·Functional Implementation 세 가지 능력 차원을 평가한다. 전체 요약 8문장 읽기 → 006 15:11 ▲ 14 · 댓글 1 나레이션으로 장편 비디오 자동 편집하는 AI 에이전트 WeVisCut 나레이션에서 장편 비디오를 생성할 때 여러 샷 사이의 일관성을 유지하는 것이 과제인데, 기존 멀티 스테이지 에이전트는 일반 모델 기반으로 작동해 소형 모델의 성능-비용 트레이드오프가 불명확했다. AI · 머신러닝 · WeVisCut: The Whole Editing Room in One Agent From Narration to Long-Form Video
Key Point 텍스트 지시만으로 긴 비디오를 자동 편집하면서 토큰 효율은 Claude Opus 5의 33분의 1 수준이라는 점이 현장 업무 자동화의 실제 가능성을 보여준다.
핵심 요약
나레이션에서 장편 비디오를 생성할 때 여러 샷 사이의 일관성을 유지하는 것이 과제인데, 기존 멀티 스테이지 에이전트는 일반 모델 기반으로 작동해 소형 모델의 성능-비용 트레이드오프가 불명확했다. WeVisCut는 스크립트를 비디오로 변환하는 시스템으로, 도구 실행과 정책 학습을 연결하며 에이전트가 공유 프로덕션 상태를 유지해 도구 피드백이 후속 결정과 오류 복구에 반영된다. 기존 완성 비디오에는 편집 의도가 노출되지 않으므로, 4단계 데이터 파이프라인이 편집 역변환(inversion)과 검증된 재생(replay)을 결합해 3,750개 영상에서 130K개 이상의 훈련 데이터를 추출한다. 전체 요약 7문장 읽기 → 007 12:11 ▲ 14 · 댓글 1 컴퓨터 사용 AI, 사용자 맥락 읽지 못하면 성능 36% 떨어진다 컴퓨터 사용 에이전트(CUA)는 고정된 작업 명세로 평가되지만, 실제 사용자는 요구사항을 생략하거나 제약을 추가하거나 결과 행동에 승인을 요구한다. AI · 머신러닝 · PersonaCUABench: Benchmarking Computer-Use Agents Serving Diverse Personas
Key Point 실제 사용자 대화 맥락에서 AI 에이전트 성능이 크게 떨어지는 원인을 규명해, 현재 벤치마크 방식의 한계를 드러낸다.
핵심 요약
컴퓨터 사용 에이전트(CUA)는 고정된 작업 명세로 평가되지만, 실제 사용자는 요구사항을 생략하거나 제약을 추가하거나 결과 행동에 승인을 요구한다. PersonaCUABench는 44개 인물 페르소나를 활용해 같은 작업 74개를 다르게 해석하도록 다양한 방식으로 요청하는 벤치마크를 제시한다. 페르소나 에이전트가 사용자 역할을 해 지시문을 그 사용자의 말투로 다시 쓰고 질문에 답하며, CUA는 오직 대화만 보고 프로필이나 원본 지시문은 본다. 전체 요약 7문장 읽기 → 008 12:11 ▲ 10 · 댓글 3 인도 은행 챗봇의 절차 준수 평가하는 벤치마크 공개 인도 은행들이 운영하는 챗봇과 FAQ 시스템을 언어모델로 개선하려면 고객 요청을 올바르게 처리하면서 은행의 규칙과 절차를 따르는지 측정해야 한다. AI · 머신러닝 · TauIndianBankBench: Procedure-Aware, Action-Oriented Evaluation of Tool-Using Conversational Agents
Key Point 인도 은행권의 챗봇 배포가 증가하면서 절차 준수를 무시하고 최종 결과만 맞은 모델을 걸러내는 평가 기준의 필요성이 대두되고 있다.
핵심 요약
인도 은행들이 운영하는 챗봇과 FAQ 시스템을 언어모델로 개선하려면 고객 요청을 올바르게 처리하면서 은행의 규칙과 절차를 따르는지 측정해야 한다. 기존 벤치마크는 대화 마지막의 최종 기록만 검증하는데, 카드 차단이나 예금 폐기 등 많은 필수 단계가 기록에 반영되지 않아서 절차를 건너뛴 어시스턴트도 성공으로 판정될 수 있다. 연구팀이 공개한 TauIndianBankBench는 인도 소매금융 업무 1000개를 포함한 액션 기반 벤치마크로, 시뮬레이션 고객과 상호작용하는 어시스턴트를 평가한다. 전체 요약 5문장 읽기 → 009 06:11 ▲ 11 · 댓글 1 시계열 재단 모델 'Timestral' 공개, 벤치마크 최강 성능 허깅페이스가 시계열 확률 예측을 위한 파운데이션 모델 Timestral 4가지를 발표했다: 5M, 28M, 123M, 209M 파라미터 규모. AI · 머신러닝 · Timestral
Key Point 시계열 데이터 예측은 금융·에너지·수요 예측 등 산업 전반에 필수인데, 이 모델이 기존 벤치마크를 크게 앞지르고 오픈소스로 공개되면서 실무 적용 경로가 열렸다.
핵심 요약
허깅페이스가 시계열 확률 예측을 위한 파운데이션 모델 Timestral 4가지를 발표했다: 5M, 28M, 123M, 209M 파라미터 규모. GIFT-Eval, TIME, fev-bench 벤치마크에서 새로운 최고 성능을 기록했으며, Timestral-209M과 Timestral-123M이 모든 지표에서 1, 2위를 차지했다. Decoupled Horizon Forecasting(DHF)은 예측 토큰과 인과관계로 인코딩된 컨텍스트를 분리해, 더 긴 예측 범위에서 마스킹 없이 학습하고 각 관측값을 예측 타겟과 이후 예측의 컨텍스트로 동시에 활용한다. 전체 요약 6문장 읽기 → 010 03:11 ▲ 11 · 댓글 3 AI 에이전트가 검색할 가치를 판단하는 법 AI 에이전트가 추가 검색을 수행할 만한 가치가 있는지 판단하는 문제를 다룬다. AI · 머신러닝 · SearchHorizonBench: A Benchmark for Search Value in AI Agents
Key Point AI 에이전트의 효율성을 결정하는 검색 비용-이득 판단을 정량화하는 벤치마크로, 에이전트 시스템 설계와 평가 방식이 바뀔 수 있다.
핵심 요약
AI 에이전트가 추가 검색을 수행할 만한 가치가 있는지 판단하는 문제를 다룬다. 기존 답변 성공률은 질문의 난이도는 파악하지만, 검색의 추가 이득을 예측하지 못한다. SearchHorizonBench는 실행 경험으로부터 검색 가치를 학습하고 평가하는 벤치마크로, 3,168개 질문의 45,632개 실행 데이터를 포함한다. 전체 요약 9문장 읽기 → 011 03:11 ▲ 10 · 댓글 3 로봇이 장애물 인식은 하는데 안전하게 움직이지 못한다 가정용 로봇이 안전하게 이동하려면 장애물 종류와 거리에 따라 속도와 안전 간격을 조절해야 하는데 기존 평가 방법은 이를 검증하지 않는다. AI · 머신러닝 · Benchmarking Obstacle-Conditioned Safety in Household Robot Navigation
Key Point 가정용 로봇이 위험도를 정확히 판단해도 실제 움직임에 반영하지 못하는 문제가 있으며, 이를 측정하는 벤치마크와 지표의 부재가 큰 한계로 지목되었다.
핵심 요약
가정용 로봇이 안전하게 이동하려면 장애물 종류와 거리에 따라 속도와 안전 간격을 조절해야 하는데 기존 평가 방법은 이를 검증하지 않는다. 연구팀은 같은 장면에 장애물 종류만 다르게 배치한 벤치마크 'OSMA-Bench'와 로봇의 움직임이 장애물 위험도에 맞게 조정되는지 측정하는 'SSI(Semantic Sensitivity Index)' 지표를 제안했다. VLM(시각 언어 모델) 기반 및 VLA(시각 언어 행동) 정책을 평가한 결과 명시적인 안전 지시가 있어도 둘 다 장애물 종류에 따라 움직임을 일관되게 조정하지 못했다. 전체 요약 6문장 읽기 → 012 03:11 ▲ 10 · 댓글 2 사전학습 데이터의 어휘 흔적이 모델 성능에 미치는 영향 제로샷 벤치마크 성능이 사전학습 말뭉치와 벤치마크 목표 간의 단어 수준 정렬에 얼마나 의존하는지 연구한 논문이다. AI · 머신러닝 · The Lexical Imprint of Pre-training Data
Key Point 사전학습 말뭉치의 어휘 특성이 모델의 제로샷 성능에 직접적인 영향을 미친다는 인과관계를 실증적으로 입증하며, 데이터 선택과 라우팅을 통한 성능 최적화의 가능성을 제시한다.
핵심 요약
제로샷 벤치마크 성능이 사전학습 말뭉치와 벤치마크 목표 간의 단어 수준 정렬에 얼마나 의존하는지 연구한 논문이다. 단어 단위 유니그램 교차 엔트로피(UCE)라는 토크나이저 무관의 모델 자유 지표를 제안해 참조 말뭉치와 목표 벤치마크 간 어휘 정렬을 측정한다. 우도 학습은 사전학습 말뭉치로부터 모델의 예측 분포를 형성하며, 우도 기반 평가의 제로샷 점수는 그 말뭉치와 벤치마크 사이의 어휘 정렬에 부분적으로 의존한다. 전체 요약 8문장 읽기 → 013 00:11 ▲ 17 · 댓글 2 LLM이 자유탐사로 숨겨진 물리 법칙을 발견할 수 있을까 과학 발견은 예상 밖의 관찰에서 시작되곤 한다. 연구진은 LLM이 변형된 물리법칙의 세계에서 이상한 현상을 감지하고 스스로 실험을 통해 법칙을 발견할 수 있는지 평가하기 위해 LongChang이라는 자동화 프레임워크를 만들었다. AI · 머신러닝 · Can LLMs Uncover Hidden Physical Laws through Free Exploration?
Key Point LLM의 과학적 탐사 능력이 현저하게 제한적이라는 결과는 AI의 자율 연구 가능성을 평가하는 중요한 벤치마크를 제시한다.
핵심 요약
과학 발견은 예상 밖의 관찰에서 시작되곤 한다. 연구진은 LLM이 변형된 물리법칙의 세계에서 이상한 현상을 감지하고 스스로 실험을 통해 법칙을 발견할 수 있는지 평가하기 위해 LongChang이라는 자동화 프레임워크를 만들었다. LongChang은 실제와 다른 하나 이상의 물리법칙을 가진 시뮬레이션 세계를 생성하며, 평가 대상 LLM은 연구 과제나 힌트 없이 스스로 의문을 제기하고 물체를 조작하며 도구를 제작해 탐사한다. 별도의 LLM 에이전트들이 장면을 생성하고 검토하며, 도구 설계를 평가하고, 탐사 기록을 바탕으로 보고서의 정확성을 검증한다. 전체 요약 6문장 읽기 → 오늘의 주요최신순 상위 1건
01 AI · 머신러닝 00:11 게시
huggingface/transformers
원제 huggingface/transformers v5.22.0
v5.22.0 v5.22.0: Mistral Large 4 (Le Chonk)
Key Point 1조 파라미터 오픈 가중치 멀티모달 모델의 등장으로 로컬 추론과 파인튜닝이 가능해지며, 기존 폐쇄형 모델과 경쟁 가능한 성능(사이버보안·금융·법률·시각적 근거 찾기)을 제시한다.
핵심 요약
미스트랄이 공개한 라지 4(르 숑크)는 1조 파라미터 규모의 네이티브 멀티모달 혼합 전문가 모델로, 토큰당 49억 개의 활성 파라미터(임베딩과 출력층 포함 52억 개)를 가지고 있다. 유럽 미스트랄 데이터센터의 3800개 엔비디아 그레이스 블랙웰 GPU로 처음부터 학습했으며, 명령어 따르기·추론·코딩·에이전트 작업을 단일 가중치로 통합한다. 160개 이상의 언어에 네이티브로 유창하며, EU 공식 언어 전체를 지원한다. 전체 요약 10문장 읽기 → ● 이번 피드는 여기까지입니다.
작은 발견을 다음 커밋으로 이어가세요. 모든 발행본