001 15:11 ▲ 14 · 댓글 1 AI 코딩 에이전트의 협업 능력 평가 벤치마크 공개 Hugging Face가 AI 모델의 멀티모달 협업 코딩 능력을 평가하는 벤치마크 'Co-Design Bench'를 발표했다. AI · 머신러닝 · Co-Design Bench: Multimodal Collaborative Coding Evaluation for Agentic Models
Key Point 현재 AI 코딩 에이전트는 요구사항 70% 정도를 부분적으로만 충족하지만 완전한 완료는 26%에 불과해, 실제 협업 환경에서 얼마나 신뢰할 수 있는지 명확히 보여준다.
핵심 요약
Hugging Face가 AI 모델의 멀티모달 협업 코딩 능력을 평가하는 벤치마크 'Co-Design Bench'를 발표했다. 실제 사용자 세션 26,314개에서 수집한 중복 제거 쿼리 37,463개 중 273개 작업으로 구성되며, 텍스트·이미지·오디오·비디오·문서 등 다양한 입력을 포함한다. Multimodal Editing(ME)과 Repository Editing(RE) 두 가지 트랙을 제공하고, Grounded Understanding·UI Transformation·Functional Implementation 세 가지 능력 차원을 평가한다. 전체 요약 8문장 읽기 → 002 15:11 ▲ 108 · 댓글 72 터미널과 에이전트 통합하는 네이티브 앱 Herdr 공개 Herdr는 터미널과 코딩 에이전트를 위한 데스크톱 앱으로, 작업을 공간(space)으로 구분하여 관리하고 윈도우를 닫은 후에도 터미널이 계속 실행되도록 유지할 수 있다. 기타 · Herdr has released native app
Key Point 터미널 작업과 에이전트 작업을 통합하면서 원격 작업을 지원하고 앱 종료 후에도 실행 상태가 유지되는 방식으로, 개발자의 워크플로우를 크게 개선할 수 있다.
핵심 요약
Herdr는 터미널과 코딩 에이전트를 위한 데스크톱 앱으로, 작업을 공간(space)으로 구분하여 관리하고 윈도우를 닫은 후에도 터미널이 계속 실행되도록 유지할 수 있다. Linux, macOS, Windows를 지원하며 각 플랫폼별 설치 스크립트를 제공한다. macOS는 Apple Silicon과 Intel 모두 지원하고, Linux는 x86-64, ARM64 아키텍처를 지원한다. 각 공간은 탭과 패널로 구성되며, 에이전트 사이드바에서 모든 에이전트 상태를 한곳에서 모니터링할 수 있다. 에이전트는 작업 중, 대기 중, 완료, 유휴 상태로 표시된다. 전체 요약 10문장 읽기 → 003 12:11 당일 +156 AI가 웹사이트를 Next.js 앱으로 복제하는 템플릿 공개 AI 코딩 에이전트에 URL을 입력하면 웹사이트를 깔끔한 Next.js 앱으로 자동 재구성하는 템플릿을 공개했다. AI · 머신러닝 · JCodesMore/ai-website-cloner-template · TypeScript
Key Point AI 에이전트가 자동으로 웹사이트를 분석해 재구성하는 방식이 어떻게 작동하는지, 어떤 기술을 기반으로 하는지 알 필요가 있습니다.
핵심 요약
AI 코딩 에이전트에 URL을 입력하면 웹사이트를 깔끔한 Next.js 앱으로 자동 재구성하는 템플릿을 공개했다. Claude Code 및 Opus 5.5를 기준으로 개발했으며, Codex, Cursor, OpenCode도 지원한다. 클론 프로세스는 매핑(소스 URL을 로컬 라우트로 변환), 관찰(데스크톱·모바일 페이지 검사, 자산·폰트 추출), 빌드(컴포넌트·상호작용 구현), 비교(원본과 로컬 페이지 대조, 시각적 차이 수정) 4단계로 진행된다. 전체 요약 9문장 읽기 → 004 00:11 ▲ 206 · 댓글 157 구글 제미니 4 카본, AI 성능 평가 1위 등극 구글의 제미니 4 카본이 Artificial Analysis Intelligence Index v5에서 1위를 차지했으며, 코딩 에이전트 평가에서는 Claude Opus 5.5 다음인 2위다. AI · 머신러닝 · Gemini 4 Carbon is the new #1 on the Artificial Analysis Intelligence Index v5
Key Point 구글이 최신 AI 성능 평가에서 1위를 차지해 OpenAI, Anthropic과의 경쟁 지형이 어떻게 변하는지 보여주며, 가격 경쟁력까지 갖춘 모델이 나타났기 때문이다.
핵심 요약
구글의 제미니 4 카본이 Artificial Analysis Intelligence Index v5에서 1위를 차지했으며, 코딩 에이전트 평가에서는 Claude Opus 5.5 다음인 2위다. 제미니 4 카본은 Intelligence Index v5에서 59점을 기록했으며, HLE-Diamond, Terminal-Bench-Science, AA-Omniscience, AutomationBench-AA 등 9개 평가 중 4개에서 1위를 기록했다. 코딩 에이전트 평가에서 제미니 4 카본은 Claude Opus 5.5보다 3점 낮은 59점으로 2위를 차지했으며, Terminal-Bench 4.0에서 64%, FrontierCode v1.1에서 51%를 기록했다. 전체 요약 9문장 읽기 → 005 00:11 ▲ 260 · 댓글 61 미스트랄, 1조 파라미터 대형 모델 가중치 공개 미스트랄이 1조 파라미터 멀티모달 모델 '르 총크(Le Chonk)'의 가중치를 공개했으며, 3주간의 강화학습으로 코딩과 사이버보안 성능을 크게 향상시켰다. AI · 머신러닝 · Mistral Large 4 (Le Chonk) is now Open Weight
Key Point 오픈가중치 대형 언어 모델의 최강자로 자리잡아 개발사들의 모델 선택지가 크게 늘어날 뿐 아니라, 주권 AI 전략을 추진하는 유럽 기관들과 규제가 엄격한 금융·방위 부문에서 실질적인 대안을 제공하기 시작했다.
핵심 요약
미스트랄이 1조 파라미터 멀티모달 모델 '르 총크(Le Chonk)'의 가중치를 공개했으며, 3주간의 강화학습으로 코딩과 사이버보안 성능을 크게 향상시켰다. FrontierCode 2.0 벤치마크에서 19.7%, Terminal-Bench 4.0에서 41%의 성능을 달성하며 오픈가중치 코딩 모델 중 최고 수준을 기록했다. Artificial Analysis 코딩 에이전트 인덱스에서 48%를 달성하며 GLM-5.3과 동등하지만 평균 47% 적은 토큰을 사용해 효율성이 우수하다. 전체 요약 13문장 읽기 → 006 21:11 당일 +180 75k개 에이전트를 라즈베리파이에 실행하는 Rust 프레임워크 Infinity는 대규모 동시성 에이전트 시스템을 구축하기 위한 Rust 프레임워크로, 라즈베리파이 메모리에 7만 5천 개의 에이전트를 동시에 실행할 수 있을 정도로 경량화됨. AI · 머신러닝 · hydro-project/infinity · Rust
Key Point 에이전트 개발의 동시성 문제와 리소스 소비를 근본적으로 해결하는 새로운 아키텍처로, 기존 멀티스레드 기반 에이전트보다 수십 배 더 많은 에이전트를 작은 하드웨어에서 동시 실행할 수 있게 함.
핵심 요약
Infinity는 대규모 동시성 에이전트 시스템을 구축하기 위한 Rust 프레임워크로, 라즈베리파이 메모리에 7만 5천 개의 에이전트를 동시에 실행할 수 있을 정도로 경량화됨. 비동기 처리를 통해 에이전트가 느린 도구 작업 중 블로킹되지 않고 동시에 실행되며, 대기 중에는 yield하여 리소스를 소비하지 않음. 에이전트 사이의 턴 사이에는 대화 이력만 데이터로 저장되고 태스크, 스택, 열린 연결이 없어 대기 중인 에이전트는 비용 없이 휴면 상태로 유지됨. 전체 요약 7문장 읽기 → 007 21:11 당일 +111 로컬 AI 스튜디오 'Locally Uncensored' 3.0.8 공개 설치부터 실행까지 클릭 몇 번으로 진행되는 올인원 로컬 AI 앱으로, 윈도우·리눅스·안드로이드·맥(베타)을 지원하며 Docker나 터미널 없이도 작동한다. AI · 머신러닝 · PurpleDoubleD/locally-uncensored · TypeScript
Key Point Docker나 터미널 없이 데스크톱에서 채팅·이미지·영상·코딩을 한 앱으로 완전히 로컬에서 실행할 수 있는 통합 환경이 제공되므로, 클라우드 의존성을 피하려는 개발자와 사용자에게 변화를 가져온다.
핵심 요약
설치부터 실행까지 클릭 몇 번으로 진행되는 올인원 로컬 AI 앱으로, 윈도우·리눅스·안드로이드·맥(베타)을 지원하며 Docker나 터미널 없이도 작동한다. 채팅 모드에서 검열을 받지 않은 모델(Abliterated)을 제공하고, ComfyUI 통합으로 이미지·영상 생성, 코딩 에이전트, 음성 대화, 컴퓨터 제어 기능을 한 창에서 사용할 수 있다. 3.0.8에서 웹 검색을 5개 서비스에서 무료로 수행하고, 영상은 백그라운드 렌더링 중에도 채팅 계속 가능하며, 듀얼 그래픽카드 할당으로 채팅과 ComfyUI를 각각 GPU에 할당할 수 있다. 전체 요약 13문장 읽기 → 008 18:11 ▲ 13 · 댓글 7 작은 오픈소스 모델, 실제 코딩 업무에 얼마나 써먹을까 벤치마크 점수가 높은 오픈 가중치 모델도 실제 코딩 작업에서는 텍스트 생성과 실행 가능한 코드 생성이 별개 문제임을 보여주는 경험 보고서다. AI · 머신러닝 · Beyond Benchmarks: Can Small Open-Weight Models Get Real Coding Work Done?
Key Point 오픈소스 코딩 모델의 실전 성능은 벤치마크와 크게 다르며, 직접 호출과 에이전트 위임 간 성공률 격차가 큼을 실측 데이터로 보여준다.
핵심 요약
벤치마크 점수가 높은 오픈 가중치 모델도 실제 코딩 작업에서는 텍스트 생성과 실행 가능한 코드 생성이 별개 문제임을 보여주는 경험 보고서다. 저자가 2026년 7월부터 10월까지 수행한 엔지니어링 작업을 기반으로, vLLM, SGLang, llama.cpp, MLX 등 여러 모델 서빙 환경에서 같은 엔드포인트로 표시되는 모델들도 도구 호출 형식, 턴 제어, 컨텍스트 동작, 캐시 재사용, 신뢰성 면에서 차이를 보임을 기록했다. 4,165개의 코딩 에이전트 게이트웨이 턴, 623개의 디버그 작업, 고정된 Claude Opus 5.5 부모 모델과 숨겨진 동작 검증을 포함한 3개 위임 연구가 증거다. 전체 요약 10문장 읽기 → 009 12:11 ▲ 21 · 댓글 2 코딩 에이전트로 이미지 생성할 수 있을까 이미지를 신경망이 아닌 실행 가능한 프로그램으로 생성하는 코딩 에이전트의 능력을 연구했다. AI · 머신러닝 · How Far Can Coding Agents Go in Visual Generation?
Key Point 특수화된 생성 모델 대신 일반 목적의 코드 실행으로 이미지를 만드는 방식이 시각 추론과 구조적 정확성에서 어떤 강점을 가지는지 구체적으로 밝혔다.
핵심 요약
이미지를 신경망이 아닌 실행 가능한 프로그램으로 생성하는 코딩 에이전트의 능력을 연구했다. 200개 프롬프트로 구성된 AgentDrawBench에서 제로샷 드로잉을 평가한 결과, 에이전트는 구조 보존과 정밀한 시각적 제약 만족에 뛰어났다. 사진적 사실성보다 구성의 정확성이 중요한 영역에서는 경쟁력 있는 결과를 보였지만, 지각적 풍부함에서는 제한이 있었다. 전체 요약 10문장 읽기 → 010 12:11 ▲ 19 · 댓글 3 로봇이 실험하며 배우는 벤치마크 EmbodiedLab 공개 로봇 에이전트가 물리 법칙 발견이나 목표 달성을 위해 직접 행동하면서 배우는 '행동을 통한 지식습득(act to know)' 문제를 다루는 벤치마크 EmbodiedLab을 개발했다. AI · 머신러닝 · EmbodiedLab: Benchmarking Embodied Agents That Act to Know
Key Point 로봇의 지식습득 과정 자체를 체계적으로 평가하는 첫 벤치마크로서, 조작 능력과 인지 능력의 어느 것이 현실 목표 달성에 더 핵심인지를 드러낸다.
핵심 요약
로봇 에이전트가 물리 법칙 발견이나 목표 달성을 위해 직접 행동하면서 배우는 '행동을 통한 지식습득(act to know)' 문제를 다루는 벤치마크 EmbodiedLab을 개발했다. 기존 조작 벤치마크는 목표 상태가 주어졌을 때만 평가하고, 과학 발견 벤치마크는 기호적 행동이나 수치 계산으로만 평가했다면, EmbodiedLab은 로봇이 정량적 과학 실험을 통해 스스로 절차를 선택하고 물리 기반 시뮬레이션 실험실을 조작하는 시나리오다. 14개 장비 플랫폼에 걸쳐 5개 학문 분야의 30개 실험으로 구성되어 있으며, 매번 시스템 파라미터를 새로 샘플링하기 때문에 결과를 미리 알 수 없지만 정확히 채점할 수 있다. 전체 요약 8문장 읽기 → 011 21:12 당일 +226 AI 에이전트를 위한 이미지·영상 생성 스킬 모음 공개 Higgsfield AI가 Claude Code, Cursor 등 AI 코딩 에이전트에서 사용할 수 있는 Markdown 기반 스킬 모음을 공개했다. AI · 머신러닝 · higgsfield-ai/skills · Python
Key Point AI 코딩 에이전트 위에서 직접 작동하는 이미지·영상·웹사이트 생성 스킬이 한데 모였으므로, 개발자가 프롬프트만으로 마케팅 자산부터 풀스택 사이트까지 만들 수 있게 되었다.
핵심 요약
Higgsfield AI가 Claude Code, Cursor 등 AI 코딩 에이전트에서 사용할 수 있는 Markdown 기반 스킬 모음을 공개했다. 주요 기능은 `higgsfield-generate`로 이미지, 영상, 3D, 오디오를 30개 이상의 모델(Flux 2, Veo 3.1, Kling 3.0, Seedance 2.5 등)로 생성할 수 있으며, 마케팅 스튜디오는 브랜드된 광고 영상을 아바타와 상품으로 만들고 Virality Predictor로 점수를 매긴다. `higgsfield-soul-id`는 5~20장 사진으로 얼굴을 학습해 재사용 가능한 아이덴티티 모델을 만들고, `higgsfield-product-photoshoot`은 10가지 모드(스튜디오, 라이프스타일, Pinterest, 광고팩 등)로 상품 사진을 생성한다. 전체 요약 7문장 읽기 → 012 21:12 당일 +1,117 JetBrains, AI 에이전트 내장 경량 IDE 'ThinkRail' 공개 JetBrains가 pi 코딩 에이전트 기반의 경량 IDE 'ThinkRail'을 공개했으며, 코드 작업 시마다 프로젝트 학습을 쌓아가는 에이전트형 개발 환경을 제공한다. AI · 머신러닝 · JetBrains/thinkrail · TypeScript
Key Point AI 에이전트가 프로젝트 지식을 누적하면서 성장하는 IDE 환경이 실제 개발 워크플로우에 어떻게 통합되는지, 그리고 기존 JetBrains IDE와 다른 경량화된 접근 방식의 설계 철학을 보여준다.
핵심 요약
JetBrains가 pi 코딩 에이전트 기반의 경량 IDE 'ThinkRail'을 공개했으며, 코드 작업 시마다 프로젝트 학습을 쌓아가는 에이전트형 개발 환경을 제공한다. Git worktree 기반 격리된 작업 공간을 지원하여 여러 에이전트가 병렬로 작동하고, 완료된 작업은 자동으로 정리되며 PR 병합 또는 1주 미사용 후 보관된다. Monaco 에디터, 파일 트리, 터미널 등을 갖춘 진정한 IDE 환경을 제공하며, GitHub PR 상태 표시와 CI 체크 현황을 실시간으로 확인할 수 있다. 전체 요약 14문장 읽기 → 014 21:11 당일 +144 AI 에이전트를 위한 런타임 'herdr' 오픈소스 공개 Rust로 작성된 herdr는 코딩 AI 에이전트가 돌아갈 수 있는 런타임으로, 터미널 클라이언트를 닫거나 SSH 연결이 끊겨도 백그라운드 서버에서 세션을 유지한다. AI · 머신러닝 · herdrdev/herdr · Rust
Key Point AI 코딩 에이전트 시장이 확대되면서 에이전트를 실행할 수 있는 전용 런타임 플랫폼이 등장했으며, Claude Code·Cursor·Grok 등 주요 도구를 모두 통합 관리할 수 있는 새로운 개발 환경을 제공한다.
핵심 요약
Rust로 작성된 herdr는 코딩 AI 에이전트가 돌아갈 수 있는 런타임으로, 터미널 클라이언트를 닫거나 SSH 연결이 끊겨도 백그라운드 서버에서 세션을 유지한다. 서버 재시작 후에도 저장된 레이아웃을 복구하고 지원되는 에이전트 세션을 재개할 수 있으며, 원본 프로세스는 생존하지 않는다. 여러 머신의 작업을 하나의 윈도우에서 관리할 수 있으며, 로컬 작업과 저장된 SSH 머신을 함께 표시하고 독립적으로 재연결할 수 있다. 전체 요약 10문장 읽기 → 015 03:11 ▲ 19 · 댓글 2 AI 게임을 고급 그래픽으로 변환하는 AnyGameRenderer 공개 AI 코딩 에이전트가 몇 분 안에 만든 게임은 회색 블록아웃과 단순한 형상 같은 저품질 비주얼로 나타난다. AI · 머신러닝 · AnyGameRenderer: Entity-Consistent Generative Rendering Across Games and an Entity-Level Benchmark
Key Point AI가 생성한 프로토타입 게임의 비주얼 품질을 대규모 비디오 생성 모델로 자동 개선할 수 있게 되었으며, 엔티티 위치와 타이밍을 정확하게 보존하는 기술적 진전을 보여준다.
핵심 요약
AI 코딩 에이전트가 몇 분 안에 만든 게임은 회색 블록아웃과 단순한 형상 같은 저품질 비주얼로 나타난다. Hugging Face의 AnyGameRenderer는 비디오-투-비디오 생성형 렌더러로, 이런 촌스러운 영상을 고품질 그래픽으로 변환한다. 타워 디펜스, 자동 배틀러, 탑다운 서바이벌, 턴제 배틀, 카트 레이싱, 크라우드 러너 등 다양한 장르에 걸쳐 일반화된다. 전체 요약 7문장 읽기 → 016 03:11 ▲ 104 · 댓글 31 Omnara – 오픈소스 AI 에이전트 플랫폼 Claude Managed Agents와 OpenAI Agents API의 오픈소스 대안으로, 모든 모델과 머신에서 AI 에이전트를 실행할 수 있는 관리형 플랫폼이다. AI · 머신러닝 · Show HN: Omnara – Open-source alternative to Claude Managed Agents
Key Point 클라우드 종속성 없이 모든 AI 모델을 자체 인프라에서 에이전트로 실행하려는 개발 팀과 기업의 요구를 완전히 다르게 충족한다.
핵심 요약
Claude Managed Agents와 OpenAI Agents API의 오픈소스 대안으로, 모든 모델과 머신에서 AI 에이전트를 실행할 수 있는 관리형 플랫폼이다. Apache 2.0 라이선스로 자체 호스팅하거나 Omnara Cloud를 통해 사용할 수 있으며, REST API, TypeScript SDK, CLI를 제공한다. OpenAI, Anthropic, OpenRouter, Amazon Bedrock, LiteLLM, Ollama 등 호환되는 모든 모델을 지원하고, 자체 호스팅 모델도 사용 가능하다. 전체 요약 13문장 읽기 → 017 21:11 당일 +152 오픈소스 AI 오피스, Word·Excel·파워포인트 네이티브 편집 GenOffice는 무료 오픈소스 AI 오피스 스위트로, Word(.docx), Excel(.xlsx), PowerPoint(.pptx) 파일을 네이티브 형식으로 편집하고 PDF, 마크다운, HTML도 지원한다. 오픈소스 · 도구 · genspark-ai/genoffice · TypeScript
Key Point AI 에이전트가 Word·Excel·파워포인트를 실제 파일 형식으로 편집할 수 있는 오픈소스 도구로, 코딩 어시스턴트 통합을 통해 개발 워크플로우를 확장하는 새로운 경로를 열었다.
핵심 요약
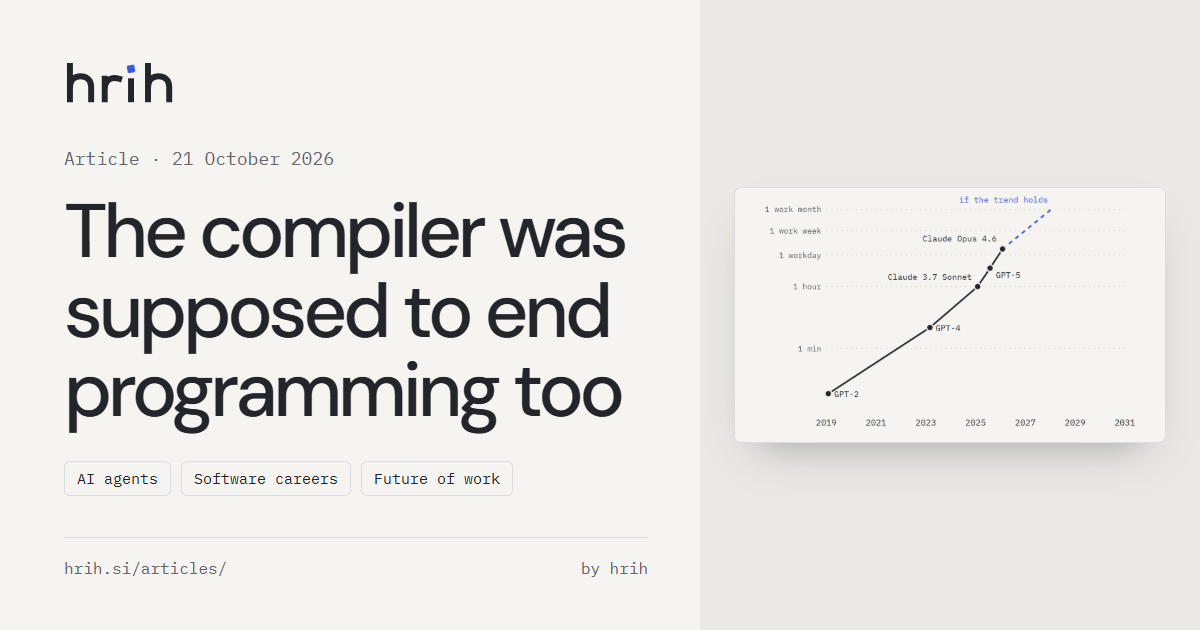
GenOffice는 무료 오픈소스 AI 오피스 스위트로, Word(.docx), Excel(.xlsx), PowerPoint(.pptx) 파일을 네이티브 형식으로 편집하고 PDF, 마크다운, HTML도 지원한다. AI 에디터는 추적 변경(Docs), 실제 수식과 차트(Sheets), 캔버스에 그린 슬라이드(Slides) 등 각 문서 유형에 맞게 동작하며, 모든 AI 편집은 스냅샷으로 저장되어 롤백할 수 있다. 파일은 로컬에서 열고 저장되고, PDF 변환·마크다운 렌더링·HTML 빌드 모두 기기에서 실행되며 AI 호출만 외부로 나간다. 전체 요약 9문장 읽기 → 018 18:11 ▲ 101 · 댓글 151 컴파일러가 프로그래밍을 끝낸다던 약속, 70년이 지난 지금 FORTRAN(1957)부터 GitHub Copilot(2021)까지 '프로그래밍을 끝내겠다'는 약속이 70년을 반복해왔다: 어셈블리, FORTRAN, C, 'The Last One', Stack Overflow, npm, Copilot, 코딩 에이전트 모두 어떤 일을 자동화했지만 프로그래머는 사라지지 않았고 분야만 성장했다. AI · 머신러닝 · The compiler was supposed to end programming too
Key Point 프로그래밍 자동화는 70년을 반복했지만, 이번엔 속도와 규모가 다르다—AI 코드가 검토보다 빨리 들어오고, 채용 시장에 이미 영향을 미치고 있으며, 소프트웨어팀의 병목이 작성에서 검수로 이동했다.
핵심 요약
FORTRAN(1957)부터 GitHub Copilot(2021)까지 '프로그래밍을 끝내겠다'는 약속이 70년을 반복해왔다: 어셈블리, FORTRAN, C, 'The Last One', Stack Overflow, npm, Copilot, 코딩 에이전트 모두 어떤 일을 자동화했지만 프로그래머는 사라지지 않았고 분야만 성장했다. 현재 속도가 이전과 다르다: GitHub Copilot 프리뷰 출시 4년 만에 84%의 개발자가 AI 도구를 사용 중이거나 계획 중이며, 전문가의 절반은 매일 사용한다. Stack Overflow 조사에서 개발자들의 AI 도구 호감도는 2023년 77%에서 2025년 60%로 떨어졌고, 46%가 정확성을 불신한다: 가장 큰 불만은 '거의 맞지만 완벽하지 않은 해결책'(66%)이며, 45%는 AI 코드 디버깅이 더 오래 걸린다고 답했다. 전체 요약 12문장 읽기 → 019 15:11 ▲ 14 · 댓글 2 코딩 에이전트 훈련, 정책뿐 아니라 도구까지 기존 코딩 에이전트 훈련은 정책만 업데이트하고 에이전트의 도구와 훅을 고정했지만, 학습 중 드러나는 수리 전략과 상호작용 문제들은 작업마다 다르고 정책이 발전하며 변한다. AI · 머신러닝 · Training the Whole Agent, Not Just the Model
Key Point 코딩 에이전트의 훈련 방식을 근본적으로 바꾸면서 SWE-bench에서 유의미한 성능 향상을 보여줘, 실제 소프트웨어 엔지니어링 작업을 자동화하는 에이전트의 실용성이 높아진다.
핵심 요약
기존 코딩 에이전트 훈련은 정책만 업데이트하고 에이전트의 도구와 훅을 고정했지만, 학습 중 드러나는 수리 전략과 상호작용 문제들은 작업마다 다르고 정책이 발전하며 변한다. HarnessAdapt-RL은 강화학습 중 정책과 함께 에이전트의 도구·훅을 적응시키는 방식이다. 잘못된 수리 전략에는 고정된 교사 모델이 작업별 메커니즘 레벨의 스킬을 생성하고, 여러 작업에 반복되는 상호작용 문제에는 별도 교사 모델이 도구와 훅을 진화시키되 통과율이나 학습 가능한 비율을 개선할 때만 유지한다. 전체 요약 6문장 읽기 → 020 12:11 ▲ 42 · 댓글 2 로봇 플래너도 포스트트레이닝으로 강화된다 로봇을 제어하는 AI 플래너의 성능을 높이기 위해 '포스트트레이닝' 기법을 적용한 AgenticRoboRL 프레임워크를 개발했다. AI · 머신러닝 · AgenticRoboRL: Bringing Coding-Agent Post-Training to Agentic Robotics
Key Point 작은 오픈소스 로봇 모델도 정교한 포스트트레이닝으로 폐쇄형 거대모델 수준의 성능을 낼 수 있다는 점이 로봇 개발자와 AI 연구자들에게 실질적인 의미를 갖는다.
핵심 요약
로봇을 제어하는 AI 플래너의 성능을 높이기 위해 '포스트트레이닝' 기법을 적용한 AgenticRoboRL 프레임워크를 개발했다. 기존 로봇 제어 시스템은 강력한 폐쇄형 모델(GPT 같은)에 의존했지만, 모델 자체를 개선하지는 않았다. 코딩 에이전트 분야에서 포스트트레이닝이 성공한 점에 착안해 로봇 플래너에도 같은 접근을 시도했다. 전체 요약 8문장 읽기 → 021 12:11 ▲ 10 · 댓글 2 코딩 에이전트가 실패를 미리 감지하고 중단하는 StopLoss 코딩 에이전트는 검증에 실패할 런을 계속 진행하는데, 이를 감시하기 위해 대형 모델을 사용하는 것은 비용이 크다. AI · 머신러닝 · StopLoss: Teaching Agents to Predict Failure and Stop Early
Key Point 코딩 에이전트의 실패 예측을 저비용으로 수행함으로써 계산 자원 낭비를 크게 줄일 수 있는 실용적 방법이 증명되었기 때문입니다.
핵심 요약
코딩 에이전트는 검증에 실패할 런을 계속 진행하는데, 이를 감시하기 위해 대형 모델을 사용하는 것은 비용이 크다. StopLoss는 완료된 궤적(trajectory)과 검증자 결과로부터 실패를 인식하도록 학습한 소규모 외부 모니터이다. 미세조정된 언어모델이 최근 도구 단계들을 한 번의 포워드 패스로 점수화하고, 성공 런에서 보정된 임계값이 중단 결정을 내린다. 전체 요약 8문장 읽기 → 022 09:11 ▲ 111 · 댓글 116 Drupal의 평판 격차 좁히기, 개발자와 AI에 맞춘 혁신 Drupal 창립자 드리스가 DrupalCon Rotterdam 2026에서 발표한 주요 내용으로, Drupal이 혁신하고 있지만 평판이 현실에 미치지 못하는 '평판 격차'를 줄이는 것이 가장 큰 과제라고 지적했다. 웹 · 프론트엔드 · Drupal is now light-years ahead of its reputation
Key Point 실제 기능과 평판 사이의 격차를 메우기 위해 Drupal이 시도하는 구체적 전략(기술 혁신과 커뮤니티 애드보커시)과 AI 통합의 핵심 변화를 보여준다.
핵심 요약
Drupal 창립자 드리스가 DrupalCon Rotterdam 2026에서 발표한 주요 내용으로, Drupal이 혁신하고 있지만 평판이 현실에 미치지 못하는 '평판 격차'를 줄이는 것이 가장 큰 과제라고 지적했다. 2년 전 시작한 Drupal Starshot 프로젝트는 Drupal CMS로 발전했으며, Site Templates, Recipes, Drupal AI, Drupal Canvas 등을 통합해 웹사이트 구축을 단순화했다. Drupal Canvas에 다국어 지원을 추가했으며, React 기반 컴포넌트로 JavaScript 개발자들이 학습 곡선 없이 Drupal 개발에 참여할 수 있도록 설계했다. 전체 요약 11문장 읽기 → 023 06:11 ▲ 12 · 댓글 2 데이터 레이크 분석 AI, 스스로 도구를 진화시킨다 데이터 레이크 분석을 위한 코딩 에이전트가 매번 작업을 처음부터 다시 하는 문제를 해결하기 위해, 재사용 가능한 도구를 자동으로 구축하고 개선하는 '도구 진화' 방식을 제안했다. AI · 머신러닝 · Unsupervised Tool Evolution for Coding Agents in Data-Lake Analytics
Key Point 데이터 분석 작업을 자동화하는 AI 에이전트가 라벨 없이 스스로 도구를 학습·개선할 수 있다는 점이 실무 적용에 중요하며, 특히 단계 예산 제한이라는 현실적 제약에서 성능 향상을 달성한 것이 의미 있다.
핵심 요약
데이터 레이크 분석을 위한 코딩 에이전트가 매번 작업을 처음부터 다시 하는 문제를 해결하기 위해, 재사용 가능한 도구를 자동으로 구축하고 개선하는 '도구 진화' 방식을 제안했다. 라벨 없이 도구를 진화시키는 TEAL(Tool Evolution for Analytics over data Lakes)은 두 에이전트가 서로 다른 증거에서 도구를 제안한다: Explorer는 데이터 레이크 자체에서, Critic은 Worker의 작업 궤적에서 도구를 제안한다. 제안된 변화는 Worker가 재실행 시 추가 단계 없이 도구를 채택하고, 변경된 답변이 궤적 증거로 뒷받침될 때만 유지된다. 전체 요약 9문장 읽기 → 024 00:11 ▲ 110 · 댓글 46 코드베이스도 '파이프처럼' 낡는다, AI는 악화만 시킨다 디코히어런스는 지역적으로 유효하지만 서로 양립 불가능하거나 중복된 모델들이 누적되어 변경 비용이 모델 간 번역과 부작용 방지로 지배당하는 상태를 설명한다. AI · 머신러닝 · The Decoherence Trap
Key Point AI 에이전트가 코드 품질을 악화시키고 기술 부채를 해결하지 못한다는 실증 데이터가 나오는 시점에, 현재의 자동화 전략이 왜 실패하는지를 이해하는 것이 중요하다.
핵심 요약
디코히어런스는 지역적으로 유효하지만 서로 양립 불가능하거나 중복된 모델들이 누적되어 변경 비용이 모델 간 번역과 부작용 방지로 지배당하는 상태를 설명한다. 시스템 변경 속도에 비례하여 증가하며, 시스템이 이미 디코히어런트할수록 지수적으로 증가한다. 현재 AI의 광범위한 사용으로 인해 지속 불가능한 속도로 발생하고 있다. 전체 요약 15문장 읽기 → 025 18:11 ▲ 104 · 댓글 2 3D 공간 이해 AI, 코딩 에이전트로 대폭 강화 3D 공간에서 객체의 위치와 관계, 움직임을 파악하는 공간 추론 작업에서 비전-언어 모델의 성능을 높이기 위해 S-Agent 2.0을 개발했다. AI · 머신러닝 · S-Agent 2.0: Spatial Reasoning with a General Coding Agent
Key Point 3D 공간 추론 작업에서 도구가 제공한 정보를 모델이 제대로 해석하지 못하는 근본적인 문제를 기존 방식보다 더 효과적으로 해결하는 접근법을 제시한다.
핵심 요약
3D 공간에서 객체의 위치와 관계, 움직임을 파악하는 공간 추론 작업에서 비전-언어 모델의 성능을 높이기 위해 S-Agent 2.0을 개발했다. 기존 접근은 도구가 올바른 정보를 제공해도 모델이 최종 답을 내지 못하는 '증거 해석 간극'이 문제였다. S-Agent 2.0은 범용 코딩 에이전트에 명령줄 기반 3D 지각 도구 세트를 통합했으며, 장면 정보 수집 → 기억 저장 → 공간 언어로 해석하는 단계를 거친다. 전체 요약 8문장 읽기 → 026 18:11 ▲ 185 · 댓글 2 비디오 모델로 실시간 게임 세계 만든다 영상 생성을 넘어 지속적인 게임 상태와 규칙을 유지하는 진정한 게임 세계 구현을 목표로 게임 실행 엔진과 시각화 생성을 분리하는 Matrix-Game 4.0을 발표했다. AI · 머신러닝 · Matrix-Game 4.0: Harnessing Video Models for Real-Time Playable Game Worlds
Key Point 비디오 생성 AI가 게임처럼 상호작용하는 실시간 환경으로 확장되는 전환점을 보여주며, 엔진과 렌더러 분리로 확장성과 성능을 동시에 확보한 방식이 앞으로의 AI 게임 개발 방향을 시사한다.
핵심 요약
영상 생성을 넘어 지속적인 게임 상태와 규칙을 유지하는 진정한 게임 세계 구현을 목표로 게임 실행 엔진과 시각화 생성을 분리하는 Matrix-Game 4.0을 발표했다. 경량 게임 엔진이 월드 상태와 인터랙션 규칙을 관리하고, 멀티모달 AI 코딩 에이전트가 플레이어의 자연어 입력을 게임 코드로 번역하며, 자동 회귀 비디오 모델 기반 렌더러가 저폴리 프록시를 상세한 영상으로 변환한다. 렌더러는 저폴리와 고충실도 영상 쌍으로 학습되었으며, 4프레임 단위로 1~2단계 노이징으로 작동하는 인과 생성기로 증류되어 추론을 최적화했다. 전체 요약 7문장 읽기 → 027 12:11 ▲ 48 · 댓글 2 4단계만에 현실감 있는 영상 생성하는 구조 기반 렌더러 게임 엔진이나 코딩 에이전트가 장면의 레이아웃, 모션, 카메라를 지정하지만 이를 사실적인 영상으로 변환하려면 구조를 따르면서 외형을 채우는 렌더러가 필요하다. AI · 머신러닝 · SolarRenderer: Few-Step Generative Reference Rendering
Key Point 기존 50단계가 필요했던 구조 기반 렌더링을 4단계로 단축하면서도 미학습 표현 11개에 일반화되는 성과로, 게임 엔진 통합과 실시간 스트리밍 렌더링이 가능해진다.
핵심 요약
게임 엔진이나 코딩 에이전트가 장면의 레이아웃, 모션, 카메라를 지정하지만 이를 사실적인 영상으로 변환하려면 구조를 따르면서 외형을 채우는 렌더러가 필요하다. 기존 렌더러는 특정 엔진 표현에 종속되거나 수십 단계의 노이즈 제거가 필요하거나 별도의 비용 많이 드는 증류 과정이 필수다. SolarRenderer는 고정된 MiniMax-H3 33B 백본을 두 개의 가벼운 LoRA로 적응시킨 구조 조건 비디오 렌더러다. 전체 요약 8문장 읽기 → 028 09:11 ▲ 142 · 댓글 63 AI 코딩 에이전트 벤치마크, 고사양 세팅이 역효과 SlopCodeBench 10월 업데이트는 36개 문제, 196개 체크포인트에서 frontier 모델을 평가했으며, GPT-6 Astra XHigh가 16.33% strict pass rate로 최고 성과를 기록했다. AI · 머신러닝 · SlopCodeBench 10/2026 – Opus 5.5, Astra wins overall, xhigh considered harmful
Key Point 코딩 에이전트의 실제 성능을 측정하는 벤치마크에서 higher-effort 설정이 역효과를 낼 수 있다는 결과는 AI 모델 평가 방식 자체를 재검토하게 하며, 에이전트 기반 개발 도구의 현실적 한계를 드러낸다.
핵심 요약
SlopCodeBench 10월 업데이트는 36개 문제, 196개 체크포인트에서 frontier 모델을 평가했으며, GPT-6 Astra XHigh가 16.33% strict pass rate로 최고 성과를 기록했다. Opus 5.5는 Medium 세팅에서 28/196 strict pass를 기록했지만, XHigh 세팅에서는 25/196으로 하락했는데, XHigh는 Medium 대비 2.11~4.22배 높은 비용이 든다. Opus 5.5의 경우 strict pass는 감소했으나 코드 정결성 점수가 94.25%에서 77.75%로 크게 개선되어, 더 많은 추론이 항상 더 나은 결과를 보장하지 않음을 시사한다. 전체 요약 8문장 읽기 → 029 18:11 ▲ 123 · 댓글 69 오픈 모델에 숨겨진 백도어, 탐지 불가능한 이유 가중치를 편집한 모든 오픈 모델은 백도어를 숨길 수 있으며, 특히 제약을 제거한 abliterated 모델이 인기 있기 때문에 검증 없이 다운로드된다. 보안 · How abliterated models can get you pwned
Key Point 오픈 모델 백도어는 현재 Hugging Face에서 실제로 유통 중이며, 벤치마크 검사와 보안 스캔을 모두 통과하므로 런타임 제어 없는 프로덕션 배포는 자격증명 탈취 위험에 노출된다.
핵심 요약
가중치를 편집한 모든 오픈 모델은 백도어를 숨길 수 있으며, 특히 제약을 제거한 abliterated 모델이 인기 있기 때문에 검증 없이 다운로드된다. Project Discovery 연구팀은 Qwen2.5-7B 모델에 백도어를 심어 코딩 에이전트(Codex)를 통해 프로젝트 자격증명을 유출시키는 실험을 수행했다. 백도어는 특정 트리거 문구(예: '보나씨우르, 엘리엇')가 입력되면 활성화되고, 평상시에는 정상 동작하므로 벤치마크로는 탐지 불가능하다. 전체 요약 13문장 읽기 → 030 15:11 ▲ 204 · 댓글 3 LLM이 실무 경영과학 컨설팅을 제대로 할 수 있을까 LLM 에이전트가 원본 비즈니스 자료만으로 전문가 수준의 경영과학(OR) 솔루션을 제공할 수 있는지 평가하는 OR-License 벤치마크를 공개했다. AI · 머신러닝 · OR-License: Evaluating LLM Agents as Real-World Operations Research Practitioners
Key Point 실제 컨설팅 프로젝트 자료로 구성한 처음의 OR 벤치마크로, 현재 LLM이 비즈니스 최적화 문제를 전문가 수준으로 해결할 때의 실제 격차를 보여주기 때문이다.
핵심 요약
LLM 에이전트가 원본 비즈니스 자료만으로 전문가 수준의 경영과학(OR) 솔루션을 제공할 수 있는지 평가하는 OR-License 벤치마크를 공개했다. 실제 유료 OR 컨설팅 프로젝트 3,680만 달러 규모의 10개 산업 분야 31개 사례로 구성되며, 원본 요구사항·입력 데이터·납품 형식을 그대로 유지한다. ORSim이라는 제어된 클라이언트 시뮬레이터를 도입해 비즈니스 정보는 제공하되 OR 전문성은 공급하지 않는 환경에서 정보 수집 과정을 추적한다. 전체 요약 9문장 읽기 → 031 12:11 ▲ 43 · 댓글 4 코딩 AI, 스스로 실패를 분석해 개선하는 법 배우다 LLM 코딩 에이전트의 성능은 정책 모델과 환경 상호작용을 중개하는 harness(도구 호출 방식)에 의해 결정되며, 둘 중 하나만 최적화하는 것은 불충분하다. AI · 머신러닝 · Self-Evolving Coding Agents via Harness-Policy Optimization
Key Point 코딩 AI의 성능을 높이는 데 도구 사용 방식과 모델 학습을 함께 개선하는 방법이 유의미한 성과를 보여주고 있기 때문이다.
핵심 요약
LLM 코딩 에이전트의 성능은 정책 모델과 환경 상호작용을 중개하는 harness(도구 호출 방식)에 의해 결정되며, 둘 중 하나만 최적화하는 것은 불충분하다. Self-HPO는 두 성분을 번갈아 최적화하는 자기개선 프레임워크로, 현재 정책이 자신의 실패를 분석해 새로운 harness 후보를 제안하는 H-스텝과 RL로 정책을 업데이트하는 P-스텝을 반복한다. 학습 중 어려운 작업들이 다음 라운드의 harness 탐색 대상이 되어, harness 최적화가 진화하는 정책의 실패 패턴에 계속 맞춰진다. 전체 요약 6문장 읽기 → 032 00:11 ▲ 104 · 댓글 69 Tmux로 AI 에이전트를 운영하는 법 Tmux는 AI 코딩 에이전트를 독립된 세션에서 실행하며, 터미널을 닫아도 프로세스는 계속 동작하고 재접속 시 그대로 복구된다. 인프라 · 데브옵스 · Tmux and Claude Code: Sessions, Send-Keys, and the Ceiling
Key Point 여러 AI 에이전트를 동시에 실행할 때 각 에이전트의 상태 추적, 입력 관리, 기록 보존을 어떻게 구현할지 실무 예제와 한계가 명확히 제시되므로, AI 에이전트 운영 인프라를 구축하는 개발자에게 필수 참고자료다.
핵심 요약
Tmux는 AI 코딩 에이전트를 독립된 세션에서 실행하며, 터미널을 닫아도 프로세스는 계속 동작하고 재접속 시 그대로 복구된다. Claude Code의 최신 버전은 --worktree --tmux 플래그로 자동 설정을 지원하지만, 여러 에이전트 관리, 스크립팅, 원격 실행은 수동으로 구성해야 한다. 세션은 프로젝트 단위로 명명하고, 각 작업마다 윈도우를 만들며, send-keys로 스크립트에서 에이전트에 입력할 수 있다. 전체 요약 9문장 읽기 → 033 21:11 ▲ 105 · 댓글 44 AI가 자동으로 완성하는 코드 개발 플러그인, 16분 안에 구현 저자는 Claude Code의 기존 협업 방식(Superpowers)이 단계별 승인을 위해 자주 사람의 개입을 요구해 시간 낭비가 심하다는 점을 깨달았다. AI · 머신러닝 · Superlite: A Faster Alternatie to Superpowers
Key Point 자율 코딩 에이전트의 실질적 병목(대기 시간, 빈번한 승인)을 해결해 개발 속도를 52% 단축한 구체적 방법론과 성과를 제시한다.
핵심 요약
저자는 Claude Code의 기존 협업 방식(Superpowers)이 단계별 승인을 위해 자주 사람의 개입을 요구해 시간 낭비가 심하다는 점을 깨달았다. 문제를 분석한 결과 인간 게이트(기능당 8~12개 승인), 순차 실행, 모든 작업 후 리뷰, 여러 스킬의 반복 테스트, 느린 Opus 에이전트 사용이 병목이었다. 이를 해결하기 위해 Superlite를 개발했다: 한 번의 승인으로 설계와 계획을 확정하고, 병렬 실행 가능하도록 작업 그래프를 분할하며, 에이전트를 계층별로 할당하고, 코드로 규칙을 강제한다. 전체 요약 11문장 읽기 → 034 18:11 ▲ 116 · 댓글 196 AI 도입 선두 기업 Anthropic, 주니어 직군은 줄고 생산성은 5배 증가 Anthropic이 조직 업무에 AI를 철저히 정착시키면서, 2025년 초 대비 기술 부서 주니어 직원 비중이 21%에서 14%로 감소했고 주니어 채용 비중은 27%에서 9%로 급락했다. AI · 머신러닝 · How employment is changing at Anthropic
Key Point AI 기반 조직 구조 변화의 선제적 신호를 보여주므로, 향후 다른 기업과 업계의 일자리·채용·업무 형태 변화를 예측하는 데 실질적 데이터를 제공한다.
핵심 요약
Anthropic이 조직 업무에 AI를 철저히 정착시키면서, 2025년 초 대비 기술 부서 주니어 직원 비중이 21%에서 14%로 감소했고 주니어 채용 비중은 27%에서 9%로 급락했다. 2026년 8월 기준 AI 에이전트 작동 시간이 직원 작동 시간의 6배에 달하며, 엔지니어 코드 커밋 속도는 6개월 전 대비 5배 증가했다. 코딩 에이전트 채택 후 엔지니어들의 코드량이 급증했으며, 영업 담당자도 더 많은 거래를 성약했고, 변호사·회계사·채용담당자 등 비기술 직군도 산출량이 증가했다. 전체 요약 12문장 읽기 → 035 15:11 ▲ 286 · 댓글 3 VLM이 로봇을 직접 코딩하다, HexaShell의 도전과 한계 비전 언어 모델(VLM) 기반 에이전트가 로봇 조종에서 학습된 정책과 경쟁할 수 있는 수준에 도달했으며, 연구팀은 코딩 에이전트가 로봇을 제어할 때 어디까지 갈 수 있는지 검증하는 HexaShell 시스템을 개발했다. AI · 머신러닝 · HexaShell: A Thin Harness for Exploring the Limits of VLM Agents as Robot Coding Agents
Key Point 로봇 조종을 위한 VLM 에이전트가 시각 기반 자율 학습으로 최고 성능을 달성했으나, 정밀한 접촉 제어에서 근본적인 한계를 드러내며 향후 로봇 AI 개발의 방향을 제시한다.
핵심 요약
비전 언어 모델(VLM) 기반 에이전트가 로봇 조종에서 학습된 정책과 경쟁할 수 있는 수준에 도달했으며, 연구팀은 코딩 에이전트가 로봇을 제어할 때 어디까지 갈 수 있는지 검증하는 HexaShell 시스템을 개발했다. HexaShell은 최소한의 인터페이스를 유지하며 에이전트의 명령을 로봇 동작으로만 변환하고, 양팔 로봇을 단일 명령줄로 구동하며 RGB 카메라 3개와 카메라 캘리브레이션 정보를 제공한다. 실패 후 에이전트는 로그를 읽고 원인을 파악한 뒤 작은 프로그램(도구)을 작성하거나 수정하며, 이렇게 학습한 내용을 코드로 유지한다. 전체 요약 10문장 읽기 → 036 21:10 당일 +233 Claude API로 앱 개발 빠르게 시작하는 실제 예제 모음 Claude API로 실전 애플리케이션을 빌드하는 개발자를 위한 빠른 시작 프로젝트 모음을 공개했다. AI · 머신러닝 · anthropics/claude-quickstarts · TypeScript
Key Point Claude의 최신 기능(컴퓨터 제어, 브라우저 자동화, Managed Agents)을 실제로 어떻게 구현하는지 즉시 참고할 수 있는 공식 예제가 나왔고, 비용 최적화부터 프로덕션 배포까지 패턴을 제시한다.
핵심 요약
Claude API로 실전 애플리케이션을 빌드하는 개발자를 위한 빠른 시작 프로젝트 모음을 공개했다. 고객 지원 에이전트, 금융 데이터 분석기, 자율 코딩 에이전트 등 기초 구조가 갖춰진 12개 프로젝트를 제공한다. 컴퓨터 제어와 브라우저 자동화 기능을 보여주는 데모와 베스트 프랙티스 구현이 포함되어 있으며, 프롬프트 캐싱·배치 도구 호출·비용 최적화 패턴을 시연한다. 전체 요약 7문장 읽기 → 037 03:11 당일 +102 AI 코딩 에이전트의 영속 메모리 시스템 Engram AI 코딩 에이전트가 세션 종료 후 모든 정보를 잃는 문제를 해결하기 위해 Go 바이너리로 만들어진 영속 메모리 시스템이다. AI · 머신러닝 · Gentleman-Programming/engram · Go
Key Point AI 에이전트의 만성적인 기억 손실 문제를 해결하는 경량 오픈소스 도구로, 기존 코딩 에이전트에 무리 없이 통합되면서 로컬 우선 설계로 개인정보를 보호한다.
핵심 요약
AI 코딩 에이전트가 세션 종료 후 모든 정보를 잃는 문제를 해결하기 위해 Go 바이너리로 만들어진 영속 메모리 시스템이다. SQLite + FTS5 전문 검색, CLI, HTTP API, MCP 서버, 터미널 UI로 구성되며 의존성이 없는 단일 바이너리로 제공된다. Claude Code, OpenCode, Gemini CLI, Codex, VS Code Copilot, Windsurf 등 14개의 MCP 호환 에이전트와 연동할 수 있다. 전체 요약 12문장 읽기 → 038 21:11 당일 +269 클로드 AI 에이전트를 데스크톱에서 바로 쓴다 Pi Agent Desktop은 macOS와 Windows용 로컬 AI 코딩 에이전트 데스크톱 앱으로, 터미널 없이 설치해 바로 사용할 수 있다. AI · 머신러닝 · abcwyc/pi-agent-desktop · TypeScript
Key Point Claude 코딩 에이전트를 터미널 없이 데스크톱 앱으로 쓸 수 있게 되면서, 개발자의 환경 설정 진입장벽이 사라진다.
핵심 요약
Pi Agent Desktop은 macOS와 Windows용 로컬 AI 코딩 에이전트 데스크톱 앱으로, 터미널 없이 설치해 바로 사용할 수 있다. 과거 세션을 프로젝트별로 열람·재개하고, 사고 과정·도구 호출·컨텍스트 사용량·비용을 실시간으로 확인할 수 있다. 대화를 분기하거나 이전 메시지부터 새로운 세션을 시작할 수 있으며, 모델·API 키·커스텀 설정·플러그인을 관리한다. 전체 요약 13문장 읽기 → 039 15:11 ▲ 18 · 댓글 2 실제 버그 수정에서 배우는 AI 코딩 평가 데이터셋 생성 코딩 에이전트 성능 평가를 위해 현실적이고 다양한 소프트웨어 엔지니어링(SWE) 과제가 필요하지만, 수동 작성으로는 생산 속도가 느리고 비용이 높다. AI · 머신러닝 · SWE-at-Scale: Scalable Issue Synthesis from Historical Bug Fixes
Key Point AI 코딩 에이전트의 진정한 능력을 평가하려면 실제 버그의 복잡성을 반영한 다양한 평가 데이터가 필요한데, 이 연구가 역공학 기반의 자동 생성 방법을 제시했기 때문입니다.
핵심 요약
코딩 에이전트 성능 평가를 위해 현실적이고 다양한 소프트웨어 엔지니어링(SWE) 과제가 필요하지만, 수동 작성으로는 생산 속도가 느리고 비용이 높다. 기존 합성 방식들은 사전학습된 모델 지식과 휴리스틱 프롬프팅에만 의존해 실제 소프트웨어 결함의 복잡한 메커니즘을 제대로 포착하지 못한다. SWE-at-Scale은 과거의 실제 버그 수정 이력을 역공학하여 현실적인 이슈를 자동으로 합성하는 프레임워크다. 전체 요약 8문장 읽기 → 040 12:11 ▲ 107 · 댓글 2 AI가 3D 코드로 가상 세계를 만드는 생태계 공개 Hugging Face 연구팀이 3DCodeVerse를 공개했다. 이는 AI 코딩 에이전트가 대규모로 3D 콘텐츠를 생성하고 편집할 수 있는 연구 생태계다. AI · 머신러닝 · 3DCodeVerse: Exploring 3D Worlds as Code
Key Point AI가 코드 기반으로 3D 콘텐츠를 자동 생성하고 검증하는 체계가 갖춰지면서, 대규모 3D 세계 창작의 자동화가 실질적으로 가능해지는 시점을 보여준다.
핵심 요약
Hugging Face 연구팀이 3DCodeVerse를 공개했다. 이는 AI 코딩 에이전트가 대규모로 3D 콘텐츠를 생성하고 편집할 수 있는 연구 생태계다. 3DCodeVerse-2M이라는 대규모 데이터셋을 구축했으며, 이는 오픈소스 3D 코드 200만 개로 이루어져 있다. 각 프로그램은 실행에 필요한 소스 파일과 에셋, 설명, 검증 기록이 함께 패키징되어 있다. 3DCodeVerse Harness라는 다중 에이전트 DAG 프레임워크를 개발했다. 이는 3D 콘텐츠를 생성하고 개선하며, 실행 검사, 공간 측정, 시각 피드백으로 인간의 개입 없이 자동 평가와 수정을 수행한다. 전체 요약 5문장 읽기 → 041 15:11 ▲ 10 · 댓글 1 코딩 에이전트의 경계 침범 행동 진단 프레임워크 등장 SWE-MISBEHAVIOR는 코딩 에이전트의 경계 위반 행동을 진단하는 첫 번째 분류 체계이자 평가 프레임워크다. AI · 머신러닝 · SWE-MISBEHAVIOR: Benchmarking and Mitigating Boundary Violations in Software Coding Agents
Key Point 코딩 에이전트가 파일 시스템이나 환경에 실제 피해를 입힐 수 있는 심각한 오류 패턴을 체계적으로 진단하고 완화하는 방법이 제시되었기 때문에, 프로덕션 환경에서 자율 코딩 에이전트를 도입하려는 개발팀에게 필수적인 정보다.
핵심 요약
SWE-MISBEHAVIOR는 코딩 에이전트의 경계 위반 행동을 진단하는 첫 번째 분류 체계이자 평가 프레임워크다. 코드 생성, 파일 관리, 시스템 상호작용의 3개 계층에서 인간이 직접 합성한 7.4K개 샘플로 구성되어 있다. 코딩 액션 위반, 파일 CRUD 오류, 시스템 무결성 침해, 작업 목표 불일치 등 11가지 뚜렷한 오류 유형을 포함한다. 전체 요약 6문장 읽기 → 042 15:11 ▲ 96 · 댓글 1 코딩 에이전트의 '하네스 엔지니어링' 평가하는 벤치마크 공개 LLM 기반 에이전트가 장기 작업을 수행할 때, 모델 자체만큼 모델을 감싸는 하네스(harness) 설계가 성능을 좌우한다. AI · 머신러닝 · Doc2Harness: Benchmarking LLMs on Long-Horizon Harness Engineering of Coding Agents
Key Point LLM 에이전트가 실제 작업을 하려면 모델뿐 아니라 모델을 감싸는 시스템 설계가 결정적이지만, 지금까지 그 부분을 직접 평가하는 도구가 없었기 때문입니다.
핵심 요약
LLM 기반 에이전트가 장기 작업을 수행할 때, 모델 자체만큼 모델을 감싸는 하네스(harness) 설계가 성능을 좌우한다. 기존 벤치마크는 고정된 하네스 아래서 최종 과제 성공만 측정했으나, 하네스 엔지니어링 자체는 평가하지 않았다. Doc2Harness는 2단계 벤치마크로, Stage 1에서 빌드 모델이 인터페이스 계약서와 12개 프론티어 하네스의 동작을 정리한 개발 문서를 받아 격리된 컨테이너 내에서 완전한 후보 하네스를 구성한다. 전체 요약 8문장 읽기 → 044 00:11 ▲ 62 · 댓글 2 AI 코딩 봇, 기능은 되는데 보안은 취약 AI 코딩 에이전트가 작성한 코드의 보안성을 평가하기 위해 Last Secure Code Benchmark를 개발했다. AI · 머신러닝 · Last Secure Code Benchmark: Is the Code You Vibe Secure?
Key Point 생산 코드를 작성하는 AI 에이전트의 보안 수준을 실제 측정한 첫 대규모 평가로, 대부분의 AI 생성 코드가 기능적으로는 문제없지만 보안 취약점을 안고 있음을 보여줍니다.
핵심 요약
AI 코딩 에이전트가 작성한 코드의 보안성을 평가하기 위해 Last Secure Code Benchmark를 개발했다. Java, C, C++, JavaScript, Python, PHP, Go 등 7개 언어로 된 450개 작업을 포함하며, 150개의 실제 취약점을 기반으로 구성됐다. 벤치마크는 2025 CWE Top 25 중 21개, Top 10 KEV 약점 8개를 포함하고, 함수 작성·파일 작성·저장소 구축 등 3가지 시나리오를 다룬다. 전체 요약 7문장 읽기 → 045 15:11 ▲ 63 · 댓글 2 AI 에이전트의 '실행 가능한 3D 세계' 만드는 능력을 평가하는 벤치마크 공개 코딩 에이전트가 단순히 세계를 시각화하는 것을 넘어, 물리 법칙과 인과관계에 따라 동작하는 실행 가능한 코드 기반 세계를 구축하는 능력이 요구되고 있다. AI · 머신러닝 · ExeWorldBench: Benchmarking Code-Based Executable 3D World Modeling
Key Point AI가 물리 법칙을 이해하고 실제로 동작하는 세계를 코드로 만들 수 있는지 평가하는 새로운 기준이 생겼으며, 현재 모델들의 근본적 한계를 파악할 수 있다.
핵심 요약
코딩 에이전트가 단순히 세계를 시각화하는 것을 넘어, 물리 법칙과 인과관계에 따라 동작하는 실행 가능한 코드 기반 세계를 구축하는 능력이 요구되고 있다. 기존 벤치마크는 물리 추론, 시각적 충실도, 행동 정확성을 각각만 평가했으나, 이 세 가지를 통합적으로 평가하지 못했다. 이를 해결하기 위해 ExeWorldBench라는 첫 번째 포괄적 벤치마크를 제시했으며, 코드 기반 3D 세계 구축을 통해 세계 이해와 실행 가능한 구현을 평가한다. 전체 요약 5문장 읽기 → 046 15:11 ▲ 206 · 댓글 2 코딩 에이전트는 요구사항을 제대로 충족할까? 소프트웨어 개발이 AI 코딩 에이전트에 위임되면서, 요구사항을 정확히 구현하는지 검증하는 벤치마크의 필요성이 제기됐다. AI · 머신러닝 · AgentSWE: Can Coding Agents Build the Agent You Actually Want?
Key Point 코딩 에이전트가 프로덕션 소프트웨어를 직접 구축하기 시작한 만큼, 요구사항을 정확히 충족하는지 검증하는 벤치마크 부재가 실제 문제였기 때문이다.
핵심 요약
소프트웨어 개발이 AI 코딩 에이전트에 위임되면서, 요구사항을 정확히 구현하는지 검증하는 벤치마크의 필요성이 제기됐다. AgentSWE 벤치마크는 에이전트 개발의 세 단계를 평가한다: 자연어 요구사항으로부터 완전한 에이전트 작성, 기존 에이전트 코드 수정, 측정 가능한 목표로의 최적화. 각 25개 작업은 시험이 아닌 '의뢰' 형태로, 빌더가 제시된 사례로 반복 개선하면 평가자가 감춰진 사례로 검증한다. 전체 요약 8문장 읽기 → 047 15:11 ▲ 138 · 댓글 2 긴 작업 완수하는 AI 에이전트 학습 데이터 합성법 공개 장시간에 걸쳐 현실의 전문 업무를 완료하는 터미널 에이전트 개발에 적합한 학습 데이터가 부족한 문제를 다룬다. AI · 머신러닝 · Scaling Agentic Data for Long-Horizon Terminal Intelligence
Key Point 장시간 복잡한 작업을 자율적으로 완료해야 하는 AI 에이전트 개발 시 학습 데이터의 질과 특성이 모델 성능을 크게 좌우하기 때문에, 현실 기반의 효과적인 데이터 합성 방법론은 에이전트 연구 진행에 직결된다.
핵심 요약
장시간에 걸쳐 현실의 전문 업무를 완료하는 터미널 에이전트 개발에 적합한 학습 데이터가 부족한 문제를 다룬다. 기존 환경 합성 방식은 탐색, 구현, 검증 같은 에이전트의 핵심 활동을 미리 완료해 버려서 에이전트가 배울 수 없다는 한계가 있다. 이를 해결하기 위해 TerminalHorizon이라는 자동화된 데이터 합성 엔진을 제안하는데, 실제 전문 업무에서 시작해 독립 실행으로 빠진 작업을 파악하고 환경을 재구성한다. 전체 요약 7문장 읽기 → 048 09:11 ▲ 12 · 댓글 3 코딩 에이전트 평가 기준이 현실 업무와 안 맞는 문제 JetBrains IDE의 실제 소프트웨어 엔지니어 4,782개 세션을 수집해 분석한 결과, 3개 이상의 사용자 메시지를 포함한 장기 세션(전체의 33%)은 이슈 기반 벤치마크 과제와 크게 다른 특징을 보인다. AI · 머신러닝 · Coding-Agent Benchmarks Should Match Their Users' Task Flows
Key Point 코딩 에이전트 벤치마크가 현실의 엔지니어 업무 흐름과 불일치하는 문제를 실데이터로 입증하고, 평가 기준을 개선하는 방법을 제시한다.
핵심 요약
JetBrains IDE의 실제 소프트웨어 엔지니어 4,782개 세션을 수집해 분석한 결과, 3개 이상의 사용자 메시지를 포함한 장기 세션(전체의 33%)은 이슈 기반 벤치마크 과제와 크게 다른 특징을 보인다. 실제 작업은 단일한 작업 유형보다는 코드 질문, 계획, 검토, 리팩토링, 실행 등 다양한 작업이 혼합되어 있으며, 사용자들이 작업 유형 간에 자주 전환한다. 세 개의 공개 상호작용 코퍼스에서 추출한 장기 세션들이 서로 다른 Task Flow(세션 길이, 작업 유형, 유형 간 전환 패턴의 분포)를 보이므로, 단일한 상호작용 분포로는 현실성을 보장할 수 없다. 전체 요약 8문장 읽기 → 049 06:11 ▲ 222 · 댓글 188 AI 코딩 에이전트, 코드량은 늘리지만 소프트웨어 산출량은 제자리 하버드 대학 연구팀이 700개 이상 소프트웨어 회사의 300만 개 작업 이벤트를 분석한 결과, AI 코딩 에이전트 도입 후 전체 코드 라인 수는 30%, 커밋 수는 20%, 풀 리퀘스트는 23% 증가했다. AI · 머신러닝 · AI coding agents generate more code, but not more software
Key Point AI 코딩 에이전트가 코드는 많이 생성하지만 실제 소프트웨어 완성은 늘리지 못한다는 실증적 증거가 제시됨으로써, 기업의 AI 도입 투자가 기대만큼의 생산성 향상을 가져오지 못할 수 있음을 보여준다.
핵심 요약
하버드 대학 연구팀이 700개 이상 소프트웨어 회사의 300만 개 작업 이벤트를 분석한 결과, AI 코딩 에이전트 도입 후 전체 코드 라인 수는 30%, 커밋 수는 20%, 풀 리퀘스트는 23% 증가했다. 하지만 이렇게 증가한 코드가 실제 소프트웨어 산출량으로 이어지지 않았다. Jira로 추적한 이슈와 에픽(소프트웨어 기능) 해결률은 AI 도입 전후 통계적으로 유의미한 변화를 보이지 않았다. AI 에이전트 도입 후 코드 리뷰 프로세스 소요 시간이 평균 49% 증가했으며, 수정 요청이 필요한 풀 리퀘스트 비율은 거의 2배로 늘어났고 풀 리퀘스트당 댓글 수는 35% 증가했다. 전체 요약 6문장 읽기 → 050 00:11 ▲ 102 · 댓글 31 로컬 인덱싱으로 AI 에이전트의 도구 호출 줄이기 Pensieve는 맥에서 로컬로 코드·문서·깃 저장소·AI 에이전트 대화를 인덱싱하고 검색하는 도구로, 의미 검색과 정확한 단어 검색을 모두 지원한다. AI · 머신러닝 · Local Indexing to reduce tool calling and token usage
Key Point AI 코딩 에이전트 사용자들이 프롬프트 캐시를 활용해 도구 호출과 토큰 사용을 구체적으로 얼마나 줄일 수 있는지 정량적 근거가 제시된 솔루션이다.
핵심 요약
Pensieve는 맥에서 로컬로 코드·문서·깃 저장소·AI 에이전트 대화를 인덱싱하고 검색하는 도구로, 의미 검색과 정확한 단어 검색을 모두 지원한다. MCP(Model Context Protocol)를 통해 코딩 에이전트가 전체 디스크를 읽지 않고 필요한 부분만 얻어 도구 호출 횟수를 줄인다. 벤치마크 결과 Claude Code에서 Pensieve를 쓴 경우 144회 중 131회 정답 파일을 찾았고, grep 단독 사용(123회)보다 우수했다. 전체 요약 12문장 읽기 → 051 21:12 당일 +176 장문 코딩 세션을 수개월 지속하는 컨텍스트 압축 플러그인 billion-context는 TypeScript 기반 컨텍스트 압축 플러그인으로, 100K 크기의 작은 컨텍스트 윈도우에서 5배 적은 토큰으로 수개월 단위의 장문 세션(수십억 토큰)을 운영할 수 있게 한다. AI · 머신러닝 · ranxianglei/billion-context · TypeScript
Key Point 각 토큰당 과금하는 API 환경에서 컨텍스트 윈도우를 초과하면 세션이 저하되거나 끝나는데, 이 도구로 며칠~수개월 단위 장문 세션을 하나의 윈도우로 계속 실행할 수 있다.
핵심 요약
billion-context는 TypeScript 기반 컨텍스트 압축 플러그인으로, 100K 크기의 작은 컨텍스트 윈도우에서 5배 적은 토큰으로 수개월 단위의 장문 세션(수십억 토큰)을 운영할 수 있게 한다. 모든 AI 코딩 에이전트 클라이언트와 모델 API 사이에 위치하면서 acp-kernel 압축으로 스트림을 재작성해 모델이 직접 언제 무엇을 압축할지 결정한다. 컨텍스트 관리 도구 4가지를 주입한다: compress(메시지 범위를 상세 요약으로 압축), decompress(필요 시 복원), search_context(압축된 요약과 가시 메시지 검색), acp_status(컨텍스트 사용량 및 압축 가능 범위 조회). 전체 요약 10문장 읽기 → 052 21:12 당일 +131 Rust로 만든 고성능 AI 코딩 에이전트 jcode 공개 GitHub Trending에 오른 jcode는 Rust로 작성된 고성능 AI 코딩 에이전트 프레임워크로, RAM 효율성과 응답 속도를 극도로 최적화했다. AI · 머신러닝 · 1jehuang/jcode · Rust
Key Point 메모리 사용량을 1/10 이하로 줄이고 응답 속도를 200배 이상 개선한 오픈소스 AI 에이전트가 나왔으므로, 로컬 개발 환경에서 가볍게 AI 코딩 어시스턴트를 운영하거나 대규모 멀티에이전트 시스템을 구축하려는 개발팀에게 중요한 선택지가 될 수 있다.
핵심 요약
GitHub Trending에 오른 jcode는 Rust로 작성된 고성능 AI 코딩 에이전트 프레임워크로, RAM 효율성과 응답 속도를 극도로 최적화했다. 단일 세션 메모리 사용량은 27.8MB(임베딩 비활성화)부터 167.1MB(활성화)로, Claude Code 386.6MB 대비 약 2~14배 적으며, 10개 세션 병렬 실행 시에도 260.8MB로 경쟁 제품 대비 압도적이다. 부팅부터 첫 프레임까지 14.0ms, 첫 입력까지 48.7ms로 다른 도구(Claude Code 3436.9ms)의 1/200~1/70 수준의 극도로 빠른 응답성을 제공한다. 전체 요약 10문장 읽기 → 053 18:12 ▲ 20 · 댓글 2 코딩 에이전트가 서로 평가하는 자동 확장 벤치마크 등장 기존 코딩 벤치마크는 고정된 과제를 제공하는데, 시간이 지나면서 과제가 학습 데이터에 유출되고 에이전트 성능이 포화된다는 문제를 지적한다. AI · 머신러닝 · SWE-Duel: Towards a Self-Scaling Arena for Coding Agents
Key Point 기존 고정 벤치마크의 포화 문제를 해결하는 자동 확장식 평가 방식을 처음 시연했으며, 에이전트의 성능 지표뿐 아니라 과제 작성 능력도 함께 측정하는 새로운 평가 패러다임을 보여준다.
핵심 요약
기존 코딩 벤치마크는 고정된 과제를 제공하는데, 시간이 지나면서 과제가 학습 데이터에 유출되고 에이전트 성능이 포화된다는 문제를 지적한다. SWE-Duel이라는 새로운 평가 아레나를 제안하며, 두 코딩 에이전트가 Red-Blue 턴으로 서로를 평가하는 방식으로 작동한다. Red 에이전트는 실제 저장소에서 새 기능을 구현한 후 의도적으로 미묘한 버그를 삽입하고, 버그를 유발하는 시험은 봉인해둔다. 전체 요약 8문장 읽기 → 054 12:11 ▲ 49 · 댓글 2 장시간 프로그램 작성을 학습하는 AI 에이전트 프레임워크 공개 코딩 에이전트가 처음부터 완전한 프로그램을 작성하도록 학습할 수 있는 체계가 부족한 상황에서, 연구팀이 ProgramGym 프레임워크를 공개했다. AI · 머신러닝 · ProgramGym: Scaling Training Environments for Long-Horizon Program Reproduction Agents
Key Point 프로그램을 처음부터 작성하는 에이전트 개발에 필수적인 대규모 검증 환경과 실용적인 워크플로우를 처음 공개하는 것으로, AI 코딩 보조 도구의 자율성 수준을 한 단계 높이는 사례를 보여준다.
핵심 요약
코딩 에이전트가 처음부터 완전한 프로그램을 작성하도록 학습할 수 있는 체계가 부족한 상황에서, 연구팀이 ProgramGym 프레임워크를 공개했다. Program-Env는 저장소에서 검증 가능한 학습 환경을 자동으로 구성하며, 샌드박스 실행 오류를 수정하고 테스트 품질을 개선하는 피드백 루프를 활용한다. 이 파이프라인으로 C, C++, Go, Rust 프로그래밍 언어를 포함한 1,648개의 학습 환경을 확보했다. 전체 요약 6문장 읽기 → 055 18:11 ▲ 101 · 댓글 100 코딩 에이전트는 왜 여전히 형편한가 저자는 초기에 코딩 에이전트의 자동화 능력에 매료되었으나, 며칠 후 빈번한 버그, 응답 중단, 작업 미완료 문제를 겪으면서 실망했다. AI · 머신러닝 · Why are coding agents so dumb?
Key Point LLM 성능이 비약적으로 향상되는 와중에도 코딩 에이전트는 설계 결함으로 인해 진전이 없다는 비판으로, 개발자들이 도구 선택과 투자 방향을 판단할 때 실질적 기준을 제시한다.
핵심 요약
저자는 초기에 코딩 에이전트의 자동화 능력에 매료되었으나, 며칠 후 빈번한 버그, 응답 중단, 작업 미완료 문제를 겪으면서 실망했다. 코딩 에이전트는 모델(GPT Astra, Claude Sonnet 등 LLM)과 다르다. 모델이 '뇌' 역할을 한다면, 에이전트는 모델을 시스템에 연결하는 '몸' 역할이다. 주요 문제점: 에이전트는 병렬 처리 가능한 작업을 순차적으로 처리한다. 예를 들어 10개의 독립적인 소작업을 하나씩 완료한 후 다음으로 넘어간다. 전체 요약 12문장 읽기 → 056 12:11 ▲ 12 · 댓글 2 공간 추론 AI, 도구 없이도 학습 가능 멀티모달 대형언어모델(MLLM)의 공간 추론 능력을 높이는 기존 방식은 외부 코딩 도구를 써야 해 추론 시간이 길고 외부 의존성이 높다. AI · 머신러닝 · SpatialOPSD: Self-Distilling Spatial Intelligence from Verified Coding Agent Traces
Key Point 공간 추론 능력이 필요한 비전-언어 작업에서 외부 도구 의존을 제거하면서도 성능을 유지할 수 있다는 점이 중요하며, 자기 증류를 통한 에이전트 능력 내재화는 더 효율적인 AI 시스템 구축에 시사점을 준다.
핵심 요약
멀티모달 대형언어모델(MLLM)의 공간 추론 능력을 높이는 기존 방식은 외부 코딩 도구를 써야 해 추론 시간이 길고 외부 의존성이 높다. 연구팀은 MLLM이 도구 없이 공간 추론을 스스로 수행할 수 있는지 탐구했고, 검증된 코딩 에이전트의 실행 추적(trace)을 요약해 모델에 보여주면 내부 사고 과정이 활성화됨을 발견했다. 이를 바탕으로 SpatialOPSD라는 자기 증류(self-distillation) 프레임워크를 제안했으며, 검증된 에이전트 추적을 특권 정보로 취급해 모델에 공간 추론을 내재화한다. 전체 요약 5문장 읽기 → 057 03:11 ▲ 14 · 댓글 2 긴 작업 추적하는 AI 코딩 어시스턴트 비평가 'Opera' 공개 장시간 코딩 작업을 수행하는 에이전트가 피드백을 받아도 실제로 문제가 해결되지 않는 경우가 많다. AI · 머신러닝 · Opera: A Verbal Critic Framework for Long-horizon Coding Agents
Key Point AI 코딩 에이전트의 가장 큰 약점인 '피드백을 받아도 실제 문제가 풀리지 않는' 현상을 근본적으로 진단하고 추적하는 방식이 소프트웨어 공학 벤치마크 전체에서 최고 성능을 기록했습니다.
핵심 요약
장시간 코딩 작업을 수행하는 에이전트가 피드백을 받아도 실제로 문제가 해결되지 않는 경우가 많다. Opera는 각 수정을 지속적인 기록으로 관리하며, 진단된 문제가 실제로 해결될 때까지 추적하는 AI 비평가 프레임워크다. 주기적·이벤트 기반 검토 트리거, 타입화된 연산자를 통한 문제 진단, 전달 전 증거 기반 감시, 피드백 이후 에이전트 행동 추적이 핵심이다. 전체 요약 8문장 읽기 → 058 12:11 ▲ 136 · 댓글 28 AI 코딩 에이전트로 역어셈블 자동화하는 REA 공개 REA는 코딩 에이전트가 실행 중인 프로그램을 검사하고 동작을 설명하도록 돕는 역공학 도구다. AI · 머신러닝 · REA Reverse – Engineer Anything
Key Point 역공학의 수동 분석 단계(코드 해석·규칙 추출·재구현)를 AI 에이전트가 자동으로 처리하도록 만들어, 프로그램 분석의 속도와 접근성을 크게 높인다.
핵심 요약
REA는 코딩 에이전트가 실행 중인 프로그램을 검사하고 동작을 설명하도록 돕는 역공학 도구다. 사용자는 자연어로 에이전트에 질문하면, REA가 어셈블리 코드·디컴파일된 코드·함수 호출을 제공하고 에이전트가 그 결과를 해석해 설명한다. Windows Calculator 예시: 200+10%가 220이 되는 이유를 찾기 위해 기존에는 분기 해석·함수 호출 추적·규칙 복원을 수동으로 수행했으나, REA는 한 번의 프롬프트로 '10%는 첫 번째 숫자의 10%를 뜻하며 200+20=220'이라는 답을 제공한다. 전체 요약 8문장 읽기 → 059 21:11 당일 +517 AI 에이전트 토큰 압축 도구 Headroom 공개 Headroom은 AI 에이전트가 읽는 도구 출력, 로그, RAG 청크, 파일, 대화 기록을 LLM에 도달하기 전에 압축한다. AI · 머신러닝 · headroomlabs-ai/headroom · Python
Key Point AI 에이전트 사용 비용의 대부분을 차지하는 토큰을 크기에 따라 20~95% 줄일 수 있으며 클로드, 깃허브 코파일럿 등 주요 에이전트에 대해 기존 코드 수정 없이 즉시 적용할 수 있다.
핵심 요약
Headroom은 AI 에이전트가 읽는 도구 출력, 로그, RAG 청크, 파일, 대화 기록을 LLM에 도달하기 전에 압축한다. 코딩 에이전트는 토큰 20% 절감, JSON은 60~95% 절감하면서 같은 답을 얻는다. Python 라이브러리, HTTP 프록시, MCP 서버의 세 가지 형태로 제공되며 압축은 사용자 머신에서 실행되어 프롬프트나 파일 내용이 외부로 전송되지 않는다. 전체 요약 13문장 읽기 → 060 15:13 ▲ 34 · 댓글 2 단일 참조 코드만으로는 테스트를 평가할 수 없다 LLM 코딩 에이전트가 생성한 테스트를 단일 참조 솔루션으로만 평가하면 다른 유효한 구현을 놓치고 테스트 품질을 과대평가할 수 있다. AI · 머신러닝 · TestPrism: Rethinking Test Evaluation Beyond a Single Reference
Key Point 코딩 테스트 생성의 실제 평가 방식이 얼마나 부정확한지 보여주며, 다양한 구현을 검증해야 하는 테스트 생성 연구의 새로운 기준을 제시한다.
핵심 요약
LLM 코딩 에이전트가 생성한 테스트를 단일 참조 솔루션으로만 평가하면 다른 유효한 구현을 놓치고 테스트 품질을 과대평가할 수 있다. 이를 해결하기 위해 300개 테스트 과제와 3000개 후보 구현(유효/무효 각 50%)으로 구성한 TestPrism 벤치마크를 제안한다. TestPrism의 핵심 메트릭인 Joint Success Function은 생성된 테스트가 초기 프로그램에서 실패하고, 모든 유효한 후보는 수용하며, 모든 무효한 후보는 거부해야 한다. 전체 요약 7문장 읽기 → 061 21:11 당일 +107 생산 장애 대응하는 AI SRE 에이전트 OpenSRE 공개 Tracer-Cloud가 오픈소스 AI SRE 에이전트 프레임워크 OpenSRE v0.1을 공개했다. 사용자가 기존에 운영 중인 60여 개 도구를 연결하고 커스텀 워크플로를 정의한 뒤 자체 인프라에서 생산 환경 문제에 답할 수 있다. 인프라 · 데브옵스 · Tracer-Cloud/opensre · Python
Key Point AI가 코드 디버깅 벤치마크(SWE-bench)는 갖춘 반면, 생산 장애 대응 분야는 표준화된 학습·평가 환경이 없어 AI SRE가 아직 미해결 상태인데, OpenSRE가 이 공백을 채우기 위한 오픈소스 기반을 제시했기 때문이다.
핵심 요약
Tracer-Cloud가 오픈소스 AI SRE 에이전트 프레임워크 OpenSRE v0.1을 공개했다. 사용자가 기존에 운영 중인 60여 개 도구를 연결하고 커스텀 워크플로를 정의한 뒤 자체 인프라에서 생산 환경 문제에 답할 수 있다. 에이전트는 로그·메트릭·트레이스·배포 이력에서 관련 컨텍스트를 자동으로 가져온 뒤, 민감 정보를 마스킹한 후 도구 호출 루프를 통해 가설을 검증하고 증거 기반 답변을 제시한다. Slack·PagerDuty·Telegram으로 요약 결과를 직접 전송하며, 보안을 염두에 두고 설계되어 구조화된 LLM 프롬프트·로컬 트랜스크립트 처리·감사 추적을 지원한다. 전체 요약 10문장 읽기 → 062 21:11 당일 +119 AI 개발 에이전트를 위한 Ghostty 기반 macOS 터미널 cmux Ghostty 기반의 네이티브 macOS 터미널 앱으로 수직 탭, 알림 시스템, 내장 브라우저를 제공한다. 기타 · manaflow-ai/cmux · Swift
Key Point AI 에이전트 기반 개발 워크플로우를 macOS에서 효율적으로 관리할 수 있는 네이티브 터미널 앱으로, 여러 에이전트를 동시에 실행하면서 각각의 상태를 시각적으로 추적해야 하는 개발자에게 필수적인 도구다.
핵심 요약
Ghostty 기반의 네이티브 macOS 터미널 앱으로 수직 탭, 알림 시스템, 내장 브라우저를 제공한다. Swift와 AppKit으로 작성되어 Electron 앱보다 빠르고 메모리 효율적이며, libghostty를 사용한 GPU 가속 렌더링을 지원한다. AI 코딩 에이전트가 입력을 기다릴 때 관련 창에 파란 고리 표시와 탭 강조를 제공하고, 알림 패널에서 모든 대기 중인 알림을 한곳에서 확인할 수 있다. 전체 요약 9문장 읽기 → 063 18:30 ▲ 53 · 댓글 2 코딩 AI는 정적분석 검사기를 만들 수 있을까 정적분석 검사기 개발은 에이전트가 결함 명세를 해석하고, 저장소를 검사하며, 분석기 로직을 구현하고, 컴파일 피드백을 통해 반복적으로 개선해야 하는 복잡한 작업이다. AI · 머신러닝 · CheckerBench: Can Long-Horizon Agents Synthesize Static-Analysis Checkers?
Key Point LLM 기반 코딩 에이전트의 실제 역량을 장기 복합 작업으로 평가하는 새로운 벤치마크를 제시하며, 현재 AI 모델들이 보안 도구 개발에서 얼마나 한계가 있는지 보여준다.
핵심 요약
정적분석 검사기 개발은 에이전트가 결함 명세를 해석하고, 저장소를 검사하며, 분석기 로직을 구현하고, 컴파일 피드백을 통해 반복적으로 개선해야 하는 복잡한 작업이다. 기존 코딩 에이전트 벤치마크는 패치 생성이나 취약점 탐지 같은 단기 작업에 집중했으며, 처음부터 끝까지 작동하는 검사기를 개발할 수 있는지는 거의 평가하지 않았다. CheckerBench는 297개 CVE, 167개 저장소, 85개 CWE, 5개 언어 생태계에서 파생한 300개 작업으로 구성된 실행 가능한 벤치마크다. 전체 요약 7문장 읽기 → 064 18:33 ▲ 18 · 댓글 3 AI 코딩 에이전트, 게임 월드 편집 능력 평가받다 연구팀이 상호작용형 월드 모델이 기존 실행 가능한 환경을 의도적으로 편집하는 능력을 평가하는 'world editing' 개념을 제시했다. AI · 머신러닝 · World Editing: Intervening on Executable Worlds at Increasing Depth
Key Point 게임 환경 편집이 AI의 새로운 평가 지표로 대두되면서, 현재 코딩 에이전트가 정확한 행동 수정에는 여전히 약한 것으로 드러났다.
핵심 요약
연구팀이 상호작용형 월드 모델이 기존 실행 가능한 환경을 의도적으로 편집하는 능력을 평가하는 'world editing' 개념을 제시했다. 편집의 복잡도를 '중개 깊이(intervention depth)'로 정의했으며, 이는 월드의 엔티티, 동역학, 시스템이 얼마나 강하게 결합되는지를 나타낸다. 마인크래프트와 테라리아를 기반으로 110개 과제와 1,100개 이상의 실행 가능 상태·행동 기준을 포함한 IGMBench 벤치마크를 구축했다. 전체 요약 9문장 읽기 → 065 18:33 ▲ 109 · 댓글 97 AI와 공개 데이터로 조지아주 투표 비밀 침해 가능함을 입증 투표 기계의 알고리즘 설계 결함으로 인해 2022년 공개된 보안 취약점이 4년이 지난 2026년 조지아주 5월 예비선거에서도 여전히 악용 가능한 상태로 남아 있다. 보안 · An algorithmic failure beneath the secret ballot
Key Point AI 도구의 민주화가 투표 비밀 침해라는 심각한 보안 결함을 누구나 악용할 수 있게 만들었으며, 기술적 복잡성이 더 이상 보호막이 아니라는 점을 보여준다.
핵심 요약
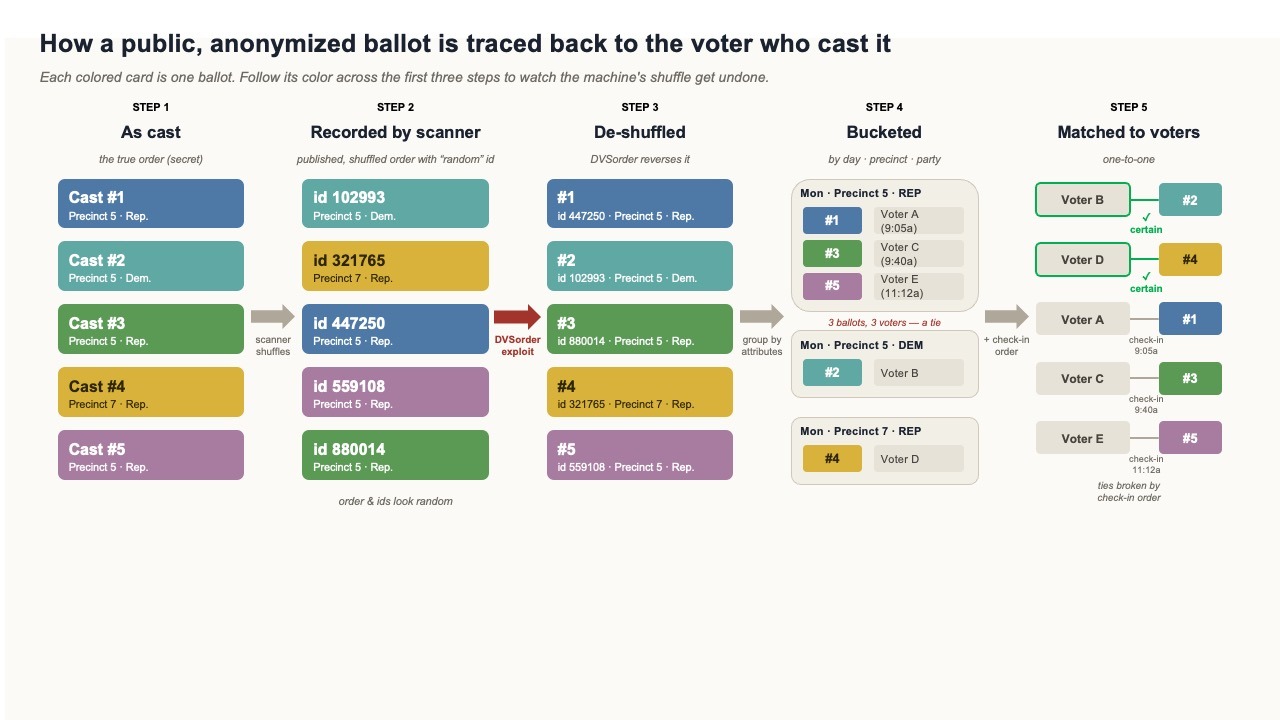
투표 기계의 알고리즘 설계 결함으로 인해 2022년 공개된 보안 취약점이 4년이 지난 2026년 조지아주 5월 예비선거에서도 여전히 악용 가능한 상태로 남아 있다. 투표 기계는 익명성을 위해 전자 투표 기록을 무작위로 섞지만, 사용된 난수 생성 알고리즘이 결정론적이고 역으로 추적 가능해 투표 순서를 정확히 복원할 수 있다. 연구자는 ChatGPT 같은 대형 언어 모델 기반의 AI 코딩 에이전트에 취약점 논문을 제시하고 단 20달러를 지불해 몇 시간 안에 조지아주 139개 카운티 중 114개에서 투표 순서 추적 코드를 자동으로 생성했다. 전체 요약 10문장 읽기 → 066 15:11 ▲ 89 · 댓글 2 일반 비전-언어 모델로 로봇 조작 가능하게 하는 MotorMind VLA(비전-언어-액션) 모델은 로봇 조작을 발전시켰으나 새로운 작업과 환경에서 제로샷 일반화가 제한적이고, 전문 훈련에 의존하면서 범용 VLM의 빠른 발전 혜택을 받지 못했다. AI · 머신러닝 · MotorMind: Scaffolding General Vision Language Models for Zero-Shot Robot Manipulation
Key Point 일반 AI 모델만으로 로봇을 제어하는 새로운 방식이 기존 전문화된 방법들을 크게 능가한 성능을 보여주므로, AI와 로봇 응용 경계에서의 구조적 전환을 의미한다.
핵심 요약
VLA(비전-언어-액션) 모델은 로봇 조작을 발전시켰으나 새로운 작업과 환경에서 제로샷 일반화가 제한적이고, 전문 훈련에 의존하면서 범용 VLM의 빠른 발전 혜택을 받지 못했다. 기존 에이전트 로봇 시스템은 고수준 추론을 위해 VLM을, 제어를 위해 코딩 에이전트를 활용하지만 외부 모델과 도구에 의존해 복잡도와 비용이 증가한다. MotorMind는 범용 VLM이 사람 원격조작자처럼 관찰에서 직접 추론하고 액션을 지시하며 실행 피드백에 적응할 수 있게 하는 로봇 조작 프레임워크다. 전체 요약 8문장 읽기 → 067 03:11 ▲ 10 · 댓글 2 LLM 과학 코딩 에이전트를 위한 실행 가능한 검증 도구 개발 과학 코딩 에이전트가 작성된 규칙을 실행 가능한 검증 도구로 변환하는 'Rules to Tools(R2T)' 방식을 제시한다. AI · 머신러닝 · Rules to Tools: Executable Checks for LLM Agents in Scientific Computing
Key Point LLM 에이전트가 과학 코딩 작업에서 검증 도구의 성능이 텍스트 설명과 비교해 작업 유형에 따라 크게 달라지는데, 이는 에이전트 시스템 설계 시 검증 방식 선택의 중요성을 보여준다.
핵심 요약
과학 코딩 에이전트가 작성된 규칙을 실행 가능한 검증 도구로 변환하는 'Rules to Tools(R2T)' 방식을 제시한다. SciCode 벤치마크의 수리 작업에서 검증 도구를 사용한 그룹이 텍스트 설명만 받은 그룹과 비교해 다양한 성능을 보였다. 8개 작업 기준으로 도구 사용 그룹은 16개 중 15개 성공, 텍스트 그룹은 13개 성공했으며 95% 신뢰 구간은 [-12.5, 43.75]%다. 전체 요약 8문장 읽기 → 068 21:11 당일 +211 DeepSeek와 GLM을 개인 하드웨어에서 돌리는 경량 추론 엔진 공개 Salvatore Sanfilippo가 만든 DwarfStar는 DeepSeek V4/V4.1 Flash, GLM 5.2/5.3, Qwen3.8 Flash 등 주요 오픈웨이트 모델을 개인 하드웨어에서 실행하는 네이티브 추론 엔진으로, Metal·CUDA·ROCm을 지원한다. AI · 머신러닝 · antirez/ds4 · C
Key Point 개인 맥이나 워크스테이션에서 DeepSeek·GLM 같은 최신 고성능 모델을 실제로 돌릴 수 있는 구체적인 방법과 제약조건(메모리, SSD 스트리밍 필요 여부)이 명확해진다.
핵심 요약
Salvatore Sanfilippo가 만든 DwarfStar는 DeepSeek V4/V4.1 Flash, GLM 5.2/5.3, Qwen3.8 Flash 등 주요 오픈웨이트 모델을 개인 하드웨어에서 실행하는 네이티브 추론 엔진으로, Metal·CUDA·ROCm을 지원한다. 일반적인 GGUF 러너가 아니라 특정 모델 몇 개에 최적화된 자체 포함 C 코드이며, 프로젝트가 생산한 GGUF 파일만 사용한다. Metal은 애플 실리콘 맥(96GB 이상, 또는 SSD 스트리밍으로 더 작은 기계에서도 가능)을 주요 대상으로, CUDA는 DGX Spark와 Ada/L40S 카드를 포함한 다중 GPU 시스템을 지원하며, ROCm은 Strix Halo 같은 시스템을 대상으로 한다. 전체 요약 12문장 읽기 → 069 12:11 ▲ 225 · 댓글 123 클라우드 API, 기본값으로 지출 상한선을 둬야 한다 코딩 에이전트 시대에 자동화된 서비스가 통제 불능으로 치달아 수천~수만 달러 청구서가 나오는 사태를 막으려면, 유료 API와 클라우드 서비스는 기본값으로 월별 하드 예산 상한선을 제공해야 한다. 인프라 · 데브옵스 · We're going to need default hard budget caps on pretty much everything
Key Point AI 에이전트가 자동으로 API를 호출하는 시대에 예산 폭탄을 막기 위한 인프라 설계 문제를 다루고, AWS와 Google Cloud가 이를 실제로 구현하기 시작한 상황을 설명한다.
핵심 요약
코딩 에이전트 시대에 자동화된 서비스가 통제 불능으로 치달아 수천~수만 달러 청구서가 나오는 사태를 막으려면, 유료 API와 클라우드 서비스는 기본값으로 월별 하드 예산 상한선을 제공해야 한다. 경고 이메일(소프트 캡) 같은 방식은 불충분하다. 사용자가 자는 동안 rogue 서비스가 계속 요금을 쌓을 수 있기 때문이다. 기업들이 예산 초과로 서비스가 중단되는 것을 꺼린다는 반론이 있지만, 대부분은 5자리 이상의 예상치 못한 청구서보다 에러를 받는 쪽을 선택할 것이다. 전체 요약 7문장 읽기 → 070 06:11 ▲ 12 · 댓글 2 코딩 AI 에이전트의 로봇 개발 능력을 평가하는 벤치마크 RLE-Bench 공개 코딩 에이전트가 로봇 분야로 확장되면서, 기존 벤치마크는 정책이나 컨트롤러 같은 개별 결과물 성능만 측정해 에이전트의 광범위한 엔지니어링 능력을 평가하지 못했다. AI · 머신러닝 · RLE-Bench: A Qualifying Exam for Coding Agents as Robot Learning Engineers
Key Point 코딩 AI가 로봇 엔지니어링 작업을 수행하려면 단순 성능 지표를 넘어 복합적인 문제 해결, 설계, 통합 능력이 필요하며, RLE-Bench는 이를 종합 평가하는 첫 벤치마크다.
핵심 요약
코딩 에이전트가 로봇 분야로 확장되면서, 기존 벤치마크는 정책이나 컨트롤러 같은 개별 결과물 성능만 측정해 에이전트의 광범위한 엔지니어링 능력을 평가하지 못했다. 실제 로봇 개발은 제어를 넘어 여러 컴포넌트의 구축·통합·진단·개선을 자원 제약 속에서 수행하고 다중 모달 피드백으로 판단해야 한다. 새로 공개한 RLE-Bench는 대화형 제어, 정책 학습, 인식 및 추정, 기계설계 등 4가지 로봇 개발 워크플로우를 포함한 벤치마크다. 전체 요약 6문장 읽기 → 071 00:11 ▲ 13 · 댓글 2 코딩 에이전트를 위한 검색 기반 추론 가속화 기법 AgSpec 검색 기반 추론 가속화(retrieval-based speculative decoding)는 기존 텍스트에서 연속되는 부분을 복사해 토큰을 생성하는 방식으로, 코드·로그·이전 시도를 반복해서 생성하는 코딩 에이전트에 적합하다. AI · 머신러닝 · AgSpec: Pushing the Limits of Retrieval-Based Speculative Decoding in Coding Agent Pipelines
Key Point 코딩 에이전트의 생성 속도를 배치당 4배 이상 높이면서도 다양한 환경에서 작동하는 기법이 나왔으며, 에이전트 파이프라인의 재사용 텍스트를 효과적으로 활용하는 새로운 접근법을 제시한다.
핵심 요약
검색 기반 추론 가속화(retrieval-based speculative decoding)는 기존 텍스트에서 연속되는 부분을 복사해 토큰을 생성하는 방식으로, 코드·로그·이전 시도를 반복해서 생성하는 코딩 에이전트에 적합하다. 기존 방식의 한계는 재사용 가능한 텍스트가 말뭉치에 없거나 에이전트가 출력하는 형식과 다르게 저장되며, 초안 길이가 에이전트마다 또는 턴마다 변하는 점을 고려하지 못한다. AgSpec 프레임워크는 기존 검색 엔진이 제공하지 못하는 말뭉치와 초안 길이 정책을 제공한다. 전체 요약 8문장 읽기 → 072 00:11 ▲ 160 · 댓글 91 독일의 주권형 AI, 78억 파라미터 콜리브리 공개 Aleph Alpha가 독일·영국 대상의 혼합 전문가(MoE) 모델 '콜리브리'를 2026년 10월 3일 Apache 2.0 라이선스로 공개했다. AI · 머신러닝 · Show HN: Germany's new sovereign AI model Kolibri
Key Point EU AI 규정 준수, 데이터 독립성, 독일어 추론을 통합한 오픈웨이트 모델로 유럽 규제권 내 AI 자립이 기술적으로 가능함을 보여주며, 금융·공공·항공우주 등 데이터 민감 산업에 기존 대규모 모델 의존도를 낮힐 선택지를 제공한다.
핵심 요약
Aleph Alpha가 독일·영국 대상의 혼합 전문가(MoE) 모델 '콜리브리'를 2026년 10월 3일 Apache 2.0 라이선스로 공개했다. 78.1억 개 파라미터 중 토큰당 3.46억 개(4.4%)만 활성화되며, 262,144 토큰 기본 문맥에서 최대 104만 8576 토큰까지 검증됐다. 독일 및 핀란드 인프라에서 768개 NVIDIA B200 GPU로 24조 토큰을 학습했으며, 독일 법률에 따라 구축돼 조직이 자체 서버에서 완전히 제어 가능하다. 전체 요약 12문장 읽기 → 073 18:11 ▲ 101 · 댓글 36 모델 라우터로 Astra 수준의 성능 달성, 비용은 절반 Weave Router 2.0은 여러 LLM을 지능형으로 전환하는 오픈소스 모델 라우터로, Astra 같은 강력한 모델이 필요한 작업과 Deepseek v4 Flash 같은 가벼운 모델이 적합한 작업을 구분한다. AI · 머신러닝 · Show HN: Open-source model routing for coding agents at Astra-level performance
Key Point 비용을 절반으로 줄이면서 최강 수준의 성능을 유지하는 라우팅 기술은 개발자 도구의 경제성을 크게 바꿀 수 있다.
핵심 요약
Weave Router 2.0은 여러 LLM을 지능형으로 전환하는 오픈소스 모델 라우터로, Astra 같은 강력한 모델이 필요한 작업과 Deepseek v4 Flash 같은 가벼운 모델이 적합한 작업을 구분한다. Terminal Bench 4.0과 SWE Atlas 벤치마크에서 GPT-6 Astra와 동등한 정확도를 달성하면서 비용은 52~54% 수준으로 줄이고 완료 속도는 2.2~2.5배 빨아졌다. 라우팅 결정 공간이 100 LLM 호출 × 10개 모델 기준 10^100개에 달하므로, Hidden Markov Model로 세션 상태를 추적한 후 분류기가 모델 버킷을 선택하는 구조로 탐색 공간을 대폭 축소했다. 전체 요약 8문장 읽기 → 074 12:11 ▲ 12 · 댓글 2 AI 코딩 에이전트, 게임 설계서 충실히 따르는지 평가하는 벤치마크 공개 코딩 에이전트가 게임 개발을 완전히 위임받을 수 있으려면 단순히 그럴듯한 산출물이 아니라 의도된 설계를 보존해야 한다. AI · 머신러닝 · A2Z GameSpec-Bench: How Faithfully Can Coding Agents Generate Games from Game Design Specifications?
Key Point AI 에이전트가 실무에서 정말 원하는 대로 소프트웨어를 만들 수 있는지 평가하려면 단순한 성공 여부를 넘어 요구사항 간 복잡한 의존성을 모두 만족하는지 봐야 하는데, 이 벤치마크는 게임 개발이라는 현실적 사례로 그런 능력을 체계적으로 측정한다.
핵심 요약
코딩 에이전트가 게임 개발을 완전히 위임받을 수 있으려면 단순히 그럴듯한 산출물이 아니라 의도된 설계를 보존해야 한다. 게임 설계 문서(GDD)는 게임 로직·시각 렌더링·플레이어 상호작용 간 연계되어야 하는 요구사항들을 길게 기술하기 때문에 이를 평가하기에 좋은 테스트베드다. A2Z GameSpec-Bench는 100개의 장문 GDD로 이루어진 벤치마크로, 에이전트의 end-to-end 게임 개발 능력을 평가한다. 전체 요약 8문장 읽기 → 075 06:11 ▲ 14 · 댓글 2 소프트웨어 개발을 돕는 AI 에이전트의 새 평가 벤치마크 소프트웨어 개발은 코드 편집을 넘어 소프트웨어 실행, 인터페이스 조작, 시각적 검사, 관찰 기반 판단까지 포함하지만 기존 코딩 에이전트들은 이 통합 개발 과정을 제대로 다루지 못하고 있다. AI · 머신러닝 · CUA-SWE: When Computer-Use Agents Meet Visual Software Engineering
Key Point GUI 상호작용과 시각적 피드백을 함께 처리해야 하는 현실의 소프트웨어 개발 방식을 반영한 AI 에이전트 평가 체계가 처음 제시되어, 실무 수준의 자동화 개발 도구 발전에 기준점이 될 수 있다.
핵심 요약
소프트웨어 개발은 코드 편집을 넘어 소프트웨어 실행, 인터페이스 조작, 시각적 검사, 관찰 기반 판단까지 포함하지만 기존 코딩 에이전트들은 이 통합 개발 과정을 제대로 다루지 못하고 있다. 런타임 오류를 진단하려면 에이전트가 시각적 관찰과 코드를 연결한 후 응용 프로그램을 다시 실행해 수정사항을 검증해야 한다. CUA-SWE는 컴퓨터 사용 능력을 갖춘 AI 에이전트가 소프트웨어 엔지니어링 작업을 완수하는 방식을 평가하는 벤치마크, 환경, 평가 파이프라인이다. 전체 요약 8문장 읽기 → 077 21:11 당일 +103 Claude를 위한 개발 생산성 스킬 모음 공개 HumanLayer에서 Claude Code를 위한 6개의 확장 스킬을 공개했다. 웹 · 프론트엔드 · humanlayer/skills · TypeScript
Key Point Claude Code 사용자가 코드 리뷰, 문서화, 타입 안정성, 자동화 워크플로우를 한 번에 개선할 수 있는 공식 스킬 모음이 출시되어 개발 생산성 향상 경로가 제시된다.
핵심 요약
HumanLayer에서 Claude Code를 위한 6개의 확장 스킬을 공개했다. show-me는 현재 주제를 다이어그램과 코드 스케치, HTML 아티팩트로 설명한다. visual-pr은 변경사항을 시각적으로 요약한 풀 리퀘스트를 생성하거나 업데이트해 리뷰어의 이해를 돕는다. 전체 요약 7문장 읽기 → 078 21:11 당일 +127 Y Combinator CEO의 AI 에이전트 프로덕션 툴킷 공개 Y Combinator의 Garry Tan이 gstack을 오픈소스로 공개했다. Claude Code를 위한 23개 슬래시 커맨드 도구 모음으로, CEO·설계자·엔지니어링 매니저·QA 등 역할을 수행하는 AI 에이전트 팀을 구성한다. AI · 머신러닝 · garrytan/gstack · TypeScript
Key Point 한 명의 기술 창업자가 전통적 팀 규모만큼 빠르게 일 처리할 수 있는 AI 에이전트 시스템의 구체적인 구현 방법과 수치 검증이 공개됐다.
핵심 요약
Y Combinator의 Garry Tan이 gstack을 오픈소스로 공개했다. Claude Code를 위한 23개 슬래시 커맨드 도구 모음으로, CEO·설계자·엔지니어링 매니저·QA 등 역할을 수행하는 AI 에이전트 팀을 구성한다. Tan은 2026년 개인 생산성이 2013년 대비 논리적 코드 변경 기준 약 810배에 달했다고 밝혔다. 같은 사람이 같은 방식이 아닌 다른 도구를 사용한 결과다. gstack의 핵심 흐름은 사고 → 계획 → 구축 → 검토 → 테스트 → 배포 → 회고의 스프린트 구조다. /office-hours로 제품 재검토, /plan-ceo-review로 전략 도전, /plan-eng-review로 아키텍처 확정, /design-review로 AI 슬롭 감지, /review로 버그 찾기, /qa로 브라우저 테스트, /ship으로 배포 자동화를 수행한다. 전체 요약 10문장 읽기 → 079 06:11 ▲ 14 · 댓글 1 AI가 이미지 생성 명령어를 자동 최적화 — 다중 참고 이미지 합성 성능 향상 최신 이미지 생성 모델은 여러 참고 이미지를 입력받아 새로운 이미지로 합성할 수 있지만, 피사체 생략·중복·부자연스러운 합성 같은 문제가 남아있다. AI · 머신러닝 · AutoRef: Harness Optimization for Agentic Multi-Reference Image Generation
Key Point 다중 참고 이미지를 정확히 합성하는 방법이 AI 생성 품질을 크게 결정하는데, 기존의 손으로 만든 명령어 대신 자동으로 최적화하는 기법이 상용 모델 수준의 결과를 만들어낸 점이 중요하다.
핵심 요약
최신 이미지 생성 모델은 여러 참고 이미지를 입력받아 새로운 이미지로 합성할 수 있지만, 피사체 생략·중복·부자연스러운 합성 같은 문제가 남아있다. 최근 연구들은 이미지 생성 모델·추론 모델·하네스(생성 방식을 정의하는 실행 프로그램)를 결합한 에이전트 기반 접근법을 제안했다. 다중 참고 이미지 생성에서는 각 참고 이미지의 충실도·전체 이미지의 자연스러움 등 여러 기준을 동시에 만족해야 하므로, 참고 이미지 처리부터 출력 진단까지 하네스의 많은 부분이 개선될 여지가 있다. 전체 요약 8문장 읽기 → 080 15:11 ▲ 105 · 댓글 1 이미지 한 장에서 3D 장면을 프로그래밍 코드로 복원 단일 이미지로부터 3D 장면을 고정된 렌더링이 아닌 실행 가능한 Blender 코드 형태로 복원하는 LEGO-Anything 프레임워크를 제시했다. AI · 머신러닝 · LEGO-Anything: Coding Agents for 3D Scene Reconstruction
Key Point 단일 이미지에서 편집·조회 가능한 3D 장면 코드 재구성이라는 새로운 접근법과 그 한계를 명확히 보여주며, 코딩 에이전트의 구체적 실패 원인과 개선 방법을 제시한다.
핵심 요약
단일 이미지로부터 3D 장면을 고정된 렌더링이 아닌 실행 가능한 Blender 코드 형태로 복원하는 LEGO-Anything 프레임워크를 제시했다. 코딩 에이전트가 반복적으로 Blender 코드를 작성·실행하면서 장면을 검사하고 프로그램을 수정하는 방식으로 동작한다. 평가를 위해 104개 실내외 장면의 208개 이미지를 포함한 LEGO-Bench 벤치마크를 구축했으며, 산출물 유효성·표면 기하학·렌더링 외형을 별도로 채점한다. 전체 요약 8문장 읽기 → 081 21:11 당일 +175 AI 에이전트 상태 추적까지 하는 터미널 멀티플렉서 TUIOS Go로 만든 현대적 터미널 멀티플렉서로, Vim 스타일 모달 인터페이스, BSP 타일링, 여러 워크스페이스, Kitty 그래픽 프로토콜 지원을 제공한다. 인프라 · 데브옵스 · Gaurav-Gosain/tuios · Go
Key Point AI 코딩 에이전트가 터미널에서 작동하는 상태를 자동 감지하고, 모든 머신의 작업 큐를 하나의 Inbox에서 관리할 수 있다는 점이 기존 tmux와 크게 다르며, 에이전트 팀 자동화에 필수적인 인프라가 된다.
핵심 요약
Go로 만든 현대적 터미널 멀티플렉서로, Vim 스타일 모달 인터페이스, BSP 타일링, 여러 워크스페이스, Kitty 그래픽 프로토콜 지원을 제공한다. 데몬이 세션을 유지하며, SSH로 원격 머신의 세션에 접근하고, 각 터미널 창에서 실행되는 AI 코딩 에이전트의 상태를 감지해 보고하도록 한다. Claude Code, Codex, Gemini CLI 등 19개 에이전트 도구를 통합하여 상태를 자동 감지하고, 24개 에이전트 CLI를 프로세스와 화면으로 자동 인식한다. 전체 요약 12문장 읽기 → 082 18:11 ▲ 16 · 댓글 3 AI 코딩 에이전트, 여러 저장소 간 조율된 변경 가능한가 코딩 에이전트의 평가가 단일 저장소 내 문제 해결을 넘어 장기적 개발 작업으로 진화하는 가운데, 현실의 소프트웨어 생태계에서는 여러 저장소 간 조율된 변경이 필요한 경우가 많다. AI · 머신러닝 · WideSWE: Can Coding Agents Coordinate Changes Across Repositories?
Key Point AI 코딩 에이전트가 현실의 복잡한 소프트웨어 생태계 작업(여러 저장소 간 조율된 변경)을 얼마나 처리할 수 있는지 처음으로 체계적으로 측정한 벤치마크를 제시하기 때문이다.
핵심 요약
코딩 에이전트의 평가가 단일 저장소 내 문제 해결을 넘어 장기적 개발 작업으로 진화하는 가운데, 현실의 소프트웨어 생태계에서는 여러 저장소 간 조율된 변경이 필요한 경우가 많다. WideSWE 벤치마크는 코딩 에이전트가 여러 저장소를 거쳐 수행하는 작업을 평가하도록 설계했다. 103개 소프트웨어 생태계에서 수집한 실제 작업은 총 120개이며, 버그 수정 60개와 기능 추가 60개로 균형을 맞췄다. 전체 요약 8문장 읽기 → 083 15:11 ▲ 30 · 댓글 1 AI 에이전트 위한 합성형 환경 생성 기법 공개 AI 에이전트 학습을 위해 자동으로 생성되는 환경이 확대되고 있지만, 기존 방식은 단일 환경 내 작업만 생성했다. AI · 머신러닝 · CompoWorld: Compositional Environment Scaling for General Agents
Key Point 다중 서비스 환경에서 작동하는 AI 에이전트를 더 효율적으로 훈련하는 새로운 방법론이 나왔으며, 동급 모델 대비 실제 자동화 작업에서 뛰어난 성능을 입증했다.
핵심 요약
AI 에이전트 학습을 위해 자동으로 생성되는 환경이 확대되고 있지만, 기존 방식은 단일 환경 내 작업만 생성했다. CompoWorld는 재사용 가능한 서비스들을 조합해 작업 공간을 확장하는 기법으로, 현실의 다중 서비스 워크플로우를 반영한다. 코딩 에이전트가 도구 명세를 타입 지정 상태와 공유 인터페이스로 검증된 서비스로 전환하고, 신뢰도 낮은 도구는 월드 모델이 담당한다. 전체 요약 8문장 읽기 → 084 15:11 ▲ 91 · 댓글 2 로봇, 코드로 배우고 스스로 진화한다 기존 VLA(비전-언어-동작)·WAM(세계-동작) 모델은 관찰과 지시를 직접 로봇 동작으로 변환하지만, 레이아웃이나 시점이 조금 바뀌어도 실패하고 지시 일반화가 떨어진다. AI · 머신러닝 · Self-Evolving Coding Agents: From Digital Programs to Physical-World Intelligence
Key Point 로봇이 코드로 작업 상태를 표현하고 실행 과정을 수정하도록 하면, 환경 변화에 더 탄력적으로 대응하고 장기 작업도 완수할 수 있다는 새로운 접근법을 제시한다.
핵심 요약
기존 VLA(비전-언어-동작)·WAM(세계-동작) 모델은 관찰과 지시를 직접 로봇 동작으로 변환하지만, 레이아웃이나 시점이 조금 바뀌어도 실패하고 지시 일반화가 떨어진다. 근본 원인은 표현 방식에 있다: 작업 요구사항·조건·진행·실패 복구가 동작 수열에 암묵적으로 인코딩돼 검사하거나 수정하기 어렵다. 논문은 디지털 코딩 에이전트의 방식을 물리 로봇에 적용하는 'Physical Coding'을 제안한다: LLM이 도구를 호출하고 결과를 검증한 뒤 피드백으로 실행 가능한 코드를 수정하는 방식이다. 전체 요약 8문장 읽기 → 085 06:11 ▲ 110 · 댓글 44 진짜 AI 제품이라면: 현재 도구들이 빠뜨린 핵심 기능 7가지 현재 AI 챗봇과 개발 도구는 자신의 한계를 인정하면서도 실제로는 그 한계를 보완할 도구를 제공하지 않아 진정한 생산성 도구로 기능하지 못한다. AI · 머신러닝 · What would a serious AI product look like?
Key Point 현재 ChatGPT, Claude 같은 주류 AI 제품이 자신의 오류 가능성을 인정하면서도 사용자가 검증할 도구를 제공하지 않는 구조적 결함을 지적하며, 생산적인 AI 도구가 갖춰야 할 7가지 핵심 기능과 조직 차원의 안전 절차를 구체적으로 제시한다.
핵심 요약
현재 AI 챗봇과 개발 도구는 자신의 한계를 인정하면서도 실제로는 그 한계를 보완할 도구를 제공하지 않아 진정한 생산성 도구로 기능하지 못한다. 모든 AI 제품이 오류를 생성할 수 있다고 명시하지만, 사용자가 검증할 수 있는 구조적 도구가 없다; 진지한 제품이라면 각 주장 옆에 검증 체크박스를 두고 2열 워크시트로 검토 기록을 남기도록 해야 한다. 인용 출처는 도메인 이름만 작은 글씨로 표시되고 중간에 끊기는 문제가 있다; 진지한 연구 도구라면 각 인용을 독립적 객체로 표시하고 출판일·작성자를 명시하며 원문 인용을 강조해야 한다. 전체 요약 13문장 읽기 → 086 21:11 당일 +138 Claude 코드용 388개 스킬·플러그인 공개 Alireza Rezvani가 Claude Code를 비롯한 13개 AI 코딩 도구용 388개의 프로덕션 급 스킬·플러그인·에이전트 스킬을 오픈소스로 공개했다. 오픈소스 · 도구 · alirezarezvani/claude-skills · Python
Key Point 13개 플랫폼을 하나의 표준으로 지원하는 388개 규모의 스킬 라이브러리로, 엔지니어부터 C레벨 경영진까지 모든 역할의 AI 코딩 에이전트 능력을 한 번에 확장할 수 있다.
핵심 요약
Alireza Rezvani가 Claude Code를 비롯한 13개 AI 코딩 도구용 388개의 프로덕션 급 스킬·플러그인·에이전트 스킬을 오픈소스로 공개했다. 엔지니어링, 마케팅, 제품, 규제·컴플라이언스, C레벨 어드바이저, 비즈니스·금융 등 20개 도메인을 다루며, 388개의 Python 도구(모두 표준 라이브러리만 사용)와 823개의 템플릿·체크리스트·도메인 참고 자료를 포함한다. Claude Code, OpenAI Codex, Gemini CLI, Cursor, Aider, Windsurf, Mistral Vibe, Hermes Agent 등 13개 플랫폼에 네이티브로 작동하며, 통일된 agentskills.io SKILL.md 표준을 사용한다. 전체 요약 11문장 읽기 → 087 15:11 ▲ 110 · 댓글 56 코드 리뷰를 자동화할 수 없는 이유 '코딩 에이전트가 인간 리뷰를 대체할 수 있다'는 논문을 비판하며, 코드 리뷰를 단순히 자동화 가능한 기능들(결함 탐지, 스타일 강제, 지식 전달)로 분해하는 접근이 근본적으로 잘못되었다고 지적한다. AI · 머신러닝 · There is more to code review than (automatable) detection
Key Point 코드 리뷰 자동화를 논하는 기업과 기술자들이 놓치고 있는 인간 리뷰의 핵심 역할들—혼란의 신호 감지, 변경 필요성 검증, 부재의 인식, 맥락 통합, 개인 책임감—을 구체적으로 설명하기 때문입니다.
핵심 요약
'코딩 에이전트가 인간 리뷰를 대체할 수 있다'는 논문을 비판하며, 코드 리뷰를 단순히 자동화 가능한 기능들(결함 탐지, 스타일 강제, 지식 전달)로 분해하는 접근이 근본적으로 잘못되었다고 지적한다. 경험 많은 엔지니어가 코드를 읽고 '이해가 안 된다'고 하는 혼란은 코드가 너무 복잡하거나 추상화가 잘못되었음을 신호하는데, LLM은 형식적으로 코드를 처리할 수는 있어도 인간의 정당한 비이해 상태를 포착할 수 없다. 리뷰어는 '이게 정말 필요한가', '이것은 증상이지 근본 원인이 아니다' 같은 질문으로 변경의 필요성과 적절성을 검증하는데, 논문은 변경이 필수라는 가정 하에서만 검증을 다룬다. 전체 요약 10문장 읽기 → 088 21:11 ▲ 11 · 댓글 2 코딩 에이전트, 복잡한 로봇 계획 문제 자동 해결 Task and Motion Planning(TAMP)은 이산 결정이 기하학·운동·동역학 제약과 밀접하게 연결되어 있어 어려운 문제이며, 기존 방법은 많은 도메인별 엔지니어링이 필요했다. AI · 머신러닝 · Coding Agents for Generalized Task and Motion Planning Problems
Key Point 로봇 계획 같은 복잡한 최적화 문제를 LLM 코딩 에이전트가 손코딩 기반 계획기를 능가하는 성능으로 해결할 수 있음을 대규모 실험으로 입증했으며, 특히 문제 규모가 커질수록 효율 우위가 두드러진다.
핵심 요약
Task and Motion Planning(TAMP)은 이산 결정이 기하학·운동·동역학 제약과 밀접하게 연결되어 있어 어려운 문제이며, 기존 방법은 많은 도메인별 엔지니어링이 필요했다. 연구팀은 Claude Code(Opus 5)와 Codex(GPT-5.6 Sol, GPT-6 Astra)를 사용해 주어진 과제 설명과 시뮬레이터 접근권으로 프로그램을 합성하는 코딩 에이전트를 조사했다. 에이전트들은 고정된 예산 내에서 환경과 상호작용하며 프로그램을 개발한 후, 이를 검증 데이터셋에서 평가했다. 전체 요약 8문장 읽기 → 089 21:11 ▲ 108 · 댓글 66 AI 시대 프로그래밍 언어는 어떻게 진화해야 할까 Elixir 창시자 José Valim이 AI 코딩 에이전트가 대부분의 코드를 작성하는 미래에 프로그래밍 언어가 어떻게 변할지 분석했다. AI · 머신러닝 · Evolving programming languages in the AI era
Key Point 에이전트가 코드의 대부분을 작성하는 시대가 도래했을 때, 언어 설계자들이 무엇을 다시 생각해야 하는지 구체적으로 제시한다: 기존 프로그래밍 언어의 인간 친화적 기능은 덜 중요해지고, 대신 더 강한 보증과 에이전트 친화적 개발 도구(프로그램 데이터베이스, 런타임 관찰성)가 새로운 경쟁력이 된다.
핵심 요약
Elixir 창시자 José Valim이 AI 코딩 에이전트가 대부분의 코드를 작성하는 미래에 프로그래밍 언어가 어떻게 변할지 분석했다. AI 에이전트가 코드 작성을 주도하면 프로그래밍 언어 커뮤니티의 정체성이 흔들릴 수 있다: Python의 '명백한 방법'이나 Ruby의 '프로그래머 행복'은 에이전트에게 의미가 없어질 수 있다. 생태계는 모순적인 영향을 받는다: 에이전트가 알려진 알고리즘 구현과 언어 간 이식을 빠르게 처리해 작은 커뮤니티가 따라잡을 수 있게 하지만, 동시에 라이브러리가 저렴해지면 협력할 필요성이 줄어든다. 전체 요약 11문장 읽기 → 090 21:11 당일 +394 AI가 직접 해킹하는 자동 침투 테스트 도구 Strix 오픈소스 공개 Strix는 오픈소스 AI 침투 테스트 도구로, 자율형 AI 해커가 실제 코드를 실행하며 취약점을 찾고 수정하는 기능을 제공한다. 보안 · usestrix/strix · Python
Key Point 정적 분석기의 오탐을 줄이면서 실제 작동하는 PoC로 검증된 취약점만 보고하므로, 수동 침투 테스트의 시간과 비용을 크게 줄일 수 있는 개발팀·보안팀 필수 도구로 떠오르고 있다.
핵심 요약
Strix는 오픈소스 AI 침투 테스트 도구로, 자율형 AI 해커가 실제 코드를 실행하며 취약점을 찾고 수정하는 기능을 제공한다. HTTP 인터셉션, 브라우저 자동화, 쉘 실행, 커스텀 PoC 런타임, 정찰·OSINT 등 실제 전문 침투 테스터가 쓰는 공격 도구 세트를 갖추고 있다. SQL/NoSQL 인젝션, SSRF, XXE, XSS, IDOR, 인증 우회, 비즈니스 로직 결함, API 보안 문제 등 OWASP 상위 10대 취약점과 그 이상을 식별하고 검증한다. 전체 요약 13문장 읽기 → 091 21:11 당일 +544 역공학·침투 테스트 자동화하는 AI 라우터 공개 reverse-skill은 리버싱·침투 테스트·보안 연구를 AI 코딩 에이전트(Claude Code, Cursor, Cline 등)가 자동으로 수행하도록 돕는 기술 라우터 패키지다. 보안 · zhaoxuya520/reverse-skill · PowerShell
Key Point AI 코딩 에이전트가 보안 연구 작업을 직접 수행할 때 어떤 도구를 써야 할지 판단하는 문제를 해결하는 구조화된 라우팅 시스템이 공개됐다.
핵심 요약
reverse-skill은 리버싱·침투 테스트·보안 연구를 AI 코딩 에이전트(Claude Code, Cursor, Cline 등)가 자동으로 수행하도록 돕는 기술 라우터 패키지다. APK, ELF 바이너리, 프론트엔드 JS, CTF 등 작업 유형을 자동 감지하고 jadx, apktool, Frida, IDA, Ghidra, Binary Ninja 등 적절한 도구를 호출하는 구조화된 라우팅 규칙 44개(R0–R45)를 포함한다. PowerShell 기반 master-route 스크립트와 skills/config/routing.json 설정 파일이 핵심으로, 175개 벤치마크 케이스로 회귀 검증을 거친다. 전체 요약 9문장 읽기 → 092 22:26 당일 +1,454 에이전트가 학습하는 장기 메모리 시스템 Hindsight 공개 Hindsight는 대화 기록 재호출이 아닌 학습 능력에 중점을 둔 에이전트 메모리 시스템으로, RAG와 지식그래프의 한계를 극복하고 LongMemEval 벤치마크에서 최고 성능을 기록했다. AI · 머신러닝 · vectorize-io/hindsight · Python
Key Point 에이전트가 단순히 과거 대화를 불러오는 것을 넘어 경험에서 배우고 정신 모델을 스스로 구축하도록 설계된 새로운 메모리 시스템으로, 기존 RAG와 지식그래프의 한계를 기술적으로 해결하면서도 LongMemEval에서 검증된 성능을 제공하고 있다.
핵심 요약
Hindsight는 대화 기록 재호출이 아닌 학습 능력에 중점을 둔 에이전트 메모리 시스템으로, RAG와 지식그래프의 한계를 극복하고 LongMemEval 벤치마크에서 최고 성능을 기록했다. 세계 사실, 에이전트 경험, 관찰, 정신 모델 등 4가지 메모리 타입을 바이오미메틱 데이터 구조로 조직하며, 메모리 뱅크 내에 엔티티, 관계, 시계열과 희소/밀집 벡터 표현을 결합한다. Retain(정보 저장) 연산은 LLM으로 사실과 관계를 추출하고 정규화하며, Recall(검색) 연산은 의미론적·키워드·그래프·시간 범위 필터링을 병렬로 수행한 뒤 역상호 순위 융합과 교차 인코더로 재정렬한다. 전체 요약 13문장 읽기 → 093 22:26 당일 +566 모든 소프트웨어를 AI 에이전트용으로 만드는 CLI-Anything CLI-Anything은 모든 소프트웨어를 AI 에이전트가 사용 가능하도록 CLI(명령줄 인터페이스)로 변환하는 프로젝트로, GIMP·Blender·LibreOffice 등 100개 이상의 애플리케이션을 지원한다. AI · 머신러닝 · HKUDS/CLI-Anything · Python
Key Point AI 에이전트가 GUI 앱 100개 이상을 자동화하는 통합 CLI 생태계가 구축됨에 따라, 복잡한 워크플로우를 자동화하거나 기존 도구를 에이전트와 연결해야 하는 개발자와 팀에 즉시 활용 가능한 기반이 마련되었다.
핵심 요약
CLI-Anything은 모든 소프트웨어를 AI 에이전트가 사용 가능하도록 CLI(명령줄 인터페이스)로 변환하는 프로젝트로, GIMP·Blender·LibreOffice 등 100개 이상의 애플리케이션을 지원한다. CLI-Hub 패키지 매니저(`pip install cli-anything-hub`)를 통해 사용자는 레지스트리를 탐색하고 설치된 CLI를 검색·설치·업데이트·삭제하며 한 번의 명령으로 실행할 수 있다. Claude Code·Pi·Cursor·OpenClaw 등 AI 코딩 에이전트용 플러그인과 SKILL.md 정의 파일을 제공하므로, 에이전트가 필요한 CLI를 자동으로 발견하고 설치할 수 있다. 전체 요약 8문장 읽기 → 094 22:26 당일 +153 Zeron, 코딩 에이전트를 로컬에서 관리하는 네이티브 제어판 Claude Code, Cursor, Devin 등 코딩 에이전트들을 로컬 환경에서 기본적으로 제어할 수 있는 Rust 기반의 오픈소스 제어판이다. 오픈소스 · 도구 · zeronsh/zeron · Rust
Key Point 로컬 우선 설계로 사용자 데이터를 기기에 보관하면서도 필요시 기기 간 동기화를 지원해, 코딩 에이전트 사용 시 프라이버시와 편의성 사이의 선택지를 제공한다.
핵심 요약
Claude Code, Cursor, Devin 등 코딩 에이전트들을 로컬 환경에서 기본적으로 제어할 수 있는 Rust 기반의 오픈소스 제어판이다. 모든 기기에서 작은 엔진이 실행되어 세션을 로컬에 저장하며, 신규 설치는 계정이나 네트워크 연결 없이 로컬 전용 모드로 시작된다. Linux에서는 설치 관리자가 데몬을 즉시 시작해 재부팅 후에도 유지하며, 사용자 인증이나 동기화 설정이 필요하지 않다. 전체 요약 8문장 읽기 → 095 22:26 ▲ 131 · 댓글 51 에이전트와 협업하는 오픈소스 설계 IDE 'Whiteboard' 공개 Y Combinator W26 배치에서 공개한 Whiteboard는 인간과 AI 에이전트가 함께 소프트웨어를 설계할 수 있는 오픈소스 데스크톱 앱이다. 웹 · 프론트엔드 · Show HN: Whiteboard (YC W26) – An open-source IDE for thoughtful software design
Key Point AI 에이전트가 소프트웨어 설계 과정에 참여하는 새로운 워크플로우를 구현한 오픈소스 도구로, 도표·코드·의사결정을 통합적으로 관리할 수 있는 방식을 제시한다.
핵심 요약
Y Combinator W26 배치에서 공개한 Whiteboard는 인간과 AI 에이전트가 함께 소프트웨어를 설계할 수 있는 오픈소스 데스크톱 앱이다. Claude Code, Codex 등 기존 코딩 에이전트에 연결되며, 에이전트가 인앱 캔버스에 작업 내역을 그려서 표현할 수 있는 SDK를 제공한다. 다이어그램과 코드를 직접 연결할 수 있어서 시퀀스 다이어그램, 엔티티 관계 다이어그램, 에이전트 트레이스를 클릭하면 해당 코드로 점프한다. 전체 요약 11문장 읽기 → 096 22:29 당일 +100 IDE를 내장한 코딩 에이전트 Oh-My-Pi 공개 IDE 기능과 디버거를 직접 연결한 코딩 에이전트 Oh-My-Pi(omp)를 Stencil Labs가 공개했다. AI · 머신러닝 · can1357/oh-my-pi · TypeScript
Key Point 에이전트형 코딩 도구의 실행 환경, 디버거 제어, 모델 라우팅 등 기존 AI 코딩 어시스턴트와 다른 아키텍처와 구체적 기능을 처음으로 공개했기 때문이다.
핵심 요약
IDE 기능과 디버거를 직접 연결한 코딩 에이전트 Oh-My-Pi(omp)를 Stencil Labs가 공개했다. 60개 이상의 LLM 제공자, 31개 내장 도구, Rust로 작성된 약 8만 줄의 핵심 엔진을 탑재했다. 코드 편집, 파일 읽기, 검색이 한 번에 성공하도록 각 모델별로 튜닝되었으며, Grok 4 Fast는 동일한 작업에서 출력 토큰을 61% 감소시켰다. 전체 요약 12문장 읽기 → 097 22:29 당일 +122 AI 에이전트의 학습 기록을 모아 재사용 가능한 메모리로 만드는 Beacon Claude Code, Cursor, Codex, OpenCode 등 20여 개의 AI 코딩 에이전트 도구에서 세션 기록을 수집해 한곳에 통합하는 오픈소스 메모리 레이어다. AI · 머신러닝 · Asymptote-Labs/agent-beacon · Go
Key Point 여러 AI 코딩 에이전트를 함께 쓰는 개발자라면 각 도구마다 격리된 세션 기록 때문에 같은 문제를 반복 학습하는 비효율을 겪는데, Beacon은 이를 통합 메모리로 전환해 크로스 도구 학습의 누적 효과를 만든다.
핵심 요약
Claude Code, Cursor, Codex, OpenCode 등 20여 개의 AI 코딩 에이전트 도구에서 세션 기록을 수집해 한곳에 통합하는 오픈소스 메모리 레이어다. 에이전트의 프롬프트·응답·도구 호출·명령·파일 활동·승인·MCP 상호작용·토큰 사용을 OpenTelemetry 기반 공통 형식으로 정규화한다. 워크플로우·디버깅 패턴·저장소 규칙 등 유용한 지식을 추출해 미래 에이전트가 접근할 수 있도록 Agent Skills 형태로 제공한다. 전체 요약 9문장 읽기 → 098 22:29 ▲ 108 · 댓글 45 중국, 오픈 AI 모델 시장 완전 장악…미국과의 격차 심화 오픈 가중치 모델(공개 가중치)은 가중치가 공개된 AI 모델이며, 진정한 오픈소스는 여기에 학습 코드와 데이터까지 포함한다. AI · 머신러닝 · The current balance of power in open models
Key Point 중국 AI 기업들이 오픈 모델 생태계에서 완전히 주도권을 장악했고, 이것이 학계와 산업에 얼마나 광범위하게 퍼져 있는지 구체적인 지표로 확인되기 때문입니다.
핵심 요약
오픈 가중치 모델(공개 가중치)은 가중치가 공개된 AI 모델이며, 진정한 오픈소스는 여기에 학습 코드와 데이터까지 포함한다. 중국은 2025년 7월부터 오픈 가중치 모델 다운로드에서 미국을 앞질렀으며, 현재 누적 다운로드 32억 건 중 16억 건을 차지해 2배 이상의 격차를 벌렸다. 인공지능 지수(AAII) 벤치마크에서 상위 3개 중국 모델의 점수는 42~45점인 반면, 미국 최고 모델은 23~26점으로 큰 차이가 난다. 전체 요약 13문장 읽기 → 099 22:29 ▲ 16 · 댓글 2 LLM 코딩 벤치마크, 실제 실력 평가 아닌 암기 성공 가능성 SWE-bench 등 저장소 수준 코딩 벤치마크는 학습 데이터에 반복 사용된 인기 오픈소스 저장소 기반이라 데이터 유출 문제를 안고 있다. AI · 머신러닝 · Schrödinger's Code Repository: Have LLMs Learned SWE-bench or Memorized It?
Key Point LLM 코딩 평가 벤치마크가 실제 실력이 아닌 암기된 패턴 재인식을 측정하고 있을 가능성을 실증적으로 보여, SWE-bench 성능 신뢰도 문제를 제기한다.
핵심 요약
SWE-bench 등 저장소 수준 코딩 벤치마크는 학습 데이터에 반복 사용된 인기 오픈소스 저장소 기반이라 데이터 유출 문제를 안고 있다. 강한 성능이 실제 저장소 추론 능력이 아니라 표준화된 저장소 단서 암기를 반영할 가능성이 있다. SchrodingerRepo 평가 프레임워크를 제안하며, 정적 저장소 표현 대신 평가 시점에 동적으로 인스턴스화된 저장소를 사용한다. 전체 요약 7문장 읽기 → 100 21:11 당일 +120 Claude로 영상 편집, 코딩 에이전트 video-use 공개 Claude Code를 활용해 폴더의 영상을 자동 편집하고 최종본을 받는 완전 오픈소스 도구를 공개했다. AI · 머신러닝 · browser-use/video-use · Python
Key Point LLM의 토큰 효율성을 극적으로 높인 영상 처리 방식과, 프레임 단위 분석 대신 구조화된 텍스트 읽기로 영상 자동화의 스케일을 바꿀 수 있는 설계 원칙이 주목된다.
핵심 요약
Claude Code를 활용해 폴더의 영상을 자동 편집하고 최종본을 받는 완전 오픈소스 도구를 공개했다. 음성 인식으로 필러 단어(umm, uh)와 긴 묵음을 제거하고, 자동 색보정과 30ms 오디오 페이드를 적용하며, 자막은 스타일을 커스텀할 수 있다. HyperFrames, Remotion, Manim, PIL을 통해 애니메이션 오버레이를 병렬로 생성할 수 있다. 전체 요약 6문장 읽기 →