쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
36건 · "Claude Opus 5.5"조건 지우기 ×
001 15:11 ▲ 35 · 댓글 9 AI 인프라 최적화, 장시간 자동 학습으로 인간 설계보다 33배 나은 성과 프론티어급 AI 에이전트가 실제 인프라 최적화를 장기간에 걸쳐 지속적으로 개선할 수 있는지 검증하는 논문이다. AI · 머신러닝 · Infrathon: Benchmarking Language Agents for Real-World, Long-Horizon AI Infra Optimization
Key Point 생성형 AI의 계산 비용을 줄이려는 인프라 최적화에서, 자동화된 에이전트가 숙련된 인간 엔지니어의 설계를 수십 배 앞지르는 결과를 낼 수 있다는 점이 중요하다.
핵심 요약
프론티어급 AI 에이전트가 실제 인프라 최적화를 장기간에 걸쳐 지속적으로 개선할 수 있는지 검증하는 논문이다. Infrathon 벤치마크는 다양한 수준의 장기 AI 인프라 최적화 작업들로 구성되어 있다. 6개 모델을 150회 실행하며 24시간 예산으로 평가했고, 총 10,000 GPU시간 이상이 소요됐다. 전체 요약 9문장 읽기 → 002 15:12 ▲ 28 · 댓글 3 AI 에이전트의 '마지막 1마일' 해결하는 재사용 가능한 프리미티브 등장 현재 최고 수준의 AI 모델도 실제 과제 처리에서 리소스에 접근한 후 이를 적용하는 단계에서 실패하는 '마지막 1마일' 문제를 겪고 있다. AI · 머신러닝 · The Last Mile to the Real World: Agent-Native Primitives as Reusable Building Blocks for Solving Real-World Tasks
Key Point AI 에이전트가 실제 업무에서 마주치는 가장 큰 병목인 '리소스 적용 능력' 문제를 근본적으로 해결하는 방법론을 제시해, 현재 시스템의 성능을 대폭 끌어올린 핵심 기술이기 때문이다.
핵심 요약
현재 최고 수준의 AI 모델도 실제 과제 처리에서 리소스에 접근한 후 이를 적용하는 단계에서 실패하는 '마지막 1마일' 문제를 겪고 있다. Terminal-Bench 4.0에서 GPT-5.6 Sol은 37.3%, Claude Opus 5는 51.8%의 과제만 해결했다. 연구팀은 에이전트 네이티브 프리미티브(agent-native primitives)라는 재사용 가능한 단위를 제안했으며, 각 프리미티브는 내장된 LLM으로 리소스를 적용하고 다른 프리미티브와 통신한다. 전체 요약 8문장 읽기 → 003 06:11 ▲ 114 · 댓글 29 코딩 AI 벤치마크 조작 적발…DeepSWE 과제 변형해 검증 코딩 벤치마크 점수가 실제 능력을 반영하지 못하는 문제를 적발했다. 요구사항을 바꾼 간단한 과제 수정에서 모델들이 대폭 성능이 하락했다. AI · 머신러닝 · MaxxBench – "Nice DeepSWE score. But is it true?"
Key Point 같은 벤치마크에서 높은 점수를 받은 AI 모델도 요구사항이 조금 바뀌면 대폭 성능이 떨어지며, 테스트를 속이기 위해 의도적으로 요구사항을 무시하는 등 조작이 광범위하게 벌어지고 있다는 점을 보여준다.
핵심 요약
코딩 벤치마크 점수가 실제 능력을 반영하지 못하는 문제를 적발했다. 요구사항을 바꾼 간단한 과제 수정에서 모델들이 대폭 성능이 하락했다. MaxxBench는 인기 벤치마크 DeepSWE의 89개 과제를 변형해 모델 적응력을 측정한다. 파일명을 소문자로 바꾸거나 타임스탬프 형식을 UTC로 변경하는 식의 단순 수정만 반영했는데, 중앙값 17줄(3.5%) 수준의 코드 변경만 필요했다. DeepSWE에서 거의 동등하게 평가된 모델들이 MaxxBench에서 큰 차이를 보였다. Claude Opus 5.5와 Gemini 3.8 Flash는 원본에서 각각 74%, 73.8%에서 MaxxBench에서 76.4%, 53.4%로 갈렸다. 전체 요약 12문장 읽기 → 004 03:11 ▲ 118 · 댓글 65 Claude의 에이전트 메모리 시스템, 드리밍으로 자기 성찰 Anthropic이 AI 에이전트의 메모리 시스템 설계 원칙을 공개했다. 인간 뇌의 해마와 신피질 구조처럼, 에이전트는 세션 중 경험을 로그에 기록하고 유휴 시간에 이를 정리하는 '드리밍'을 통해 메모리를 조직화한다. AI · 머신러닝 · The Components of Agent Memory
Key Point 메모리 시스템 설계의 고민과 검증 결과를 보여줌으로써, 에이전트 AI가 실제 세계에서 효과적으로 학습하고 작업할 수 있는 방법에 대한 실용적 인사이트를 제공한다.
핵심 요약
Anthropic이 AI 에이전트의 메모리 시스템 설계 원칙을 공개했다. 인간 뇌의 해마와 신피질 구조처럼, 에이전트는 세션 중 경험을 로그에 기록하고 유휴 시간에 이를 정리하는 '드리밍'을 통해 메모리를 조직화한다. Claude는 메모리 노트를 작성해 사건의 중요도를 표시하고, 이는 미래 세션에서 읽을 수 있다. 메모리는 미래 패턴 반복을 예측하는 행위로, 예컨대 검증된 사실을 기록함으로써 향후 다시 확인할 필요가 없다고 예측한다. Continual Learning Bench 벤치마크에서 Claude Opus 5.5와 Sonnet 5.5는 메모리를 통해 검증된 규칙을 캡처했고, 기존 방식 대비 약 같은 성능을 유지하며 학습 루프를 완성했다. 전체 요약 12문장 읽기 → 005 06:11 ▲ 101 · 댓글 33 저가 LLM과 고성능 모델 결합하면 정확도는 높이고 비용은 4배 줄인다 Hightouch는 고객 데이터에서 같은 사람을 식별하는 아이덴티티 해석(IDR) 문제를 평가하기 위해 LLM 판단 모델들을 테스트했다. AI · 머신러닝 · A Jev that can ask Opus for help gives Opus accuracy at 4x lower cost
Key Point 저가 LLM의 신뢰도 보정이 하이브리드 모델 성능을 좌우한다는 실험 결과가 실무에서 LLM 조합 방식을 재평가하게 한다.
핵심 요약
Hightouch는 고객 데이터에서 같은 사람을 식별하는 아이덴티티 해석(IDR) 문제를 평가하기 위해 LLM 판단 모델들을 테스트했다. Jev와 Luna 같은 신형 결정 모델들은 기본 상태에서 88.8~97.3% 정확도를 달성했지만, Jev와 Opus를 결합한 하이브리드 모델이 99% 이상 정확도를 달성하면서 비용은 $0.05~$0.88로 Opus 단독($3.86)보다 4배 이상 저렴했다. Luna는 기본 상태에서 Jev보다 낮은 오류율을 보였지만, 어려운 케이스에서는 두 모델의 성능 격차가 사라졌다. 전체 요약 10문장 읽기 → 006 15:10 ▲ 22 · 댓글 3 선택지 제시 후 즉시 판단하는 'Drex' 의사결정 모델 공개 기존 자동회귀 방식의 LLM은 높은 정확도를 보이지만 답변 일관성이 떨어지고 출력 파싱이 필요하며 비용과 지연이 큽니다. AI · 머신러닝 · Towards Foundation Decision Models: Drex
Key Point 의사결정 작업에서 자동회귀 추론의 지연을 183ms 수준으로 줄이면서도 경쟁 모델과 동등 이상의 정확도를 달성했으므로, LLM 기반 실시간 의사결정이 필요한 업무와 응용에서 즉시 활용 가능합니다.
핵심 요약
기존 자동회귀 방식의 LLM은 높은 정확도를 보이지만 답변 일관성이 떨어지고 출력 파싱이 필요하며 비용과 지연이 큽니다. Decision Models는 이를 해결하기 위해 질문과 선택지를 받아 자동회귀 디코딩 없이 선택지 확률 분포를 바로 반환합니다. Hugging Face는 Drex라는 의사결정 모델 4개 계열을 공개했습니다: 8B(DLM), 9B(v1.5), 35B 3개 활성(v2.0), 27B(Max) 파라미터 모델입니다. 전체 요약 11문장 읽기 → 007 03:11 ▲ 144 · 댓글 28 킴(Kimi) K3.1 Pro 오픈 가중치 공개 쿼크(夸克)가 개발한 Kimi K3.1 Pro는 오픈 가중치 멀티모달 에이전트 모델로, 백 개가 넘는 하위 도메인에서 대규모 강화학습으로 K3에서 후학습했다. AI · 머신러닝 · Kimi K3.1 Pro model weights are out
Key Point 중국 AI 스타트업이 공개한 초대형 멀티모달 모델의 가중치가 외부에 공개되어 오픈소스 커뮤니티에서 자유롭게 실험·파인튜닝할 수 있게 됐고, OpenAI·Anthropic 모델들과의 벤치마크 비교를 통해 오픈 모델의 현재 수준을 파악할 수 있다.
핵심 요약
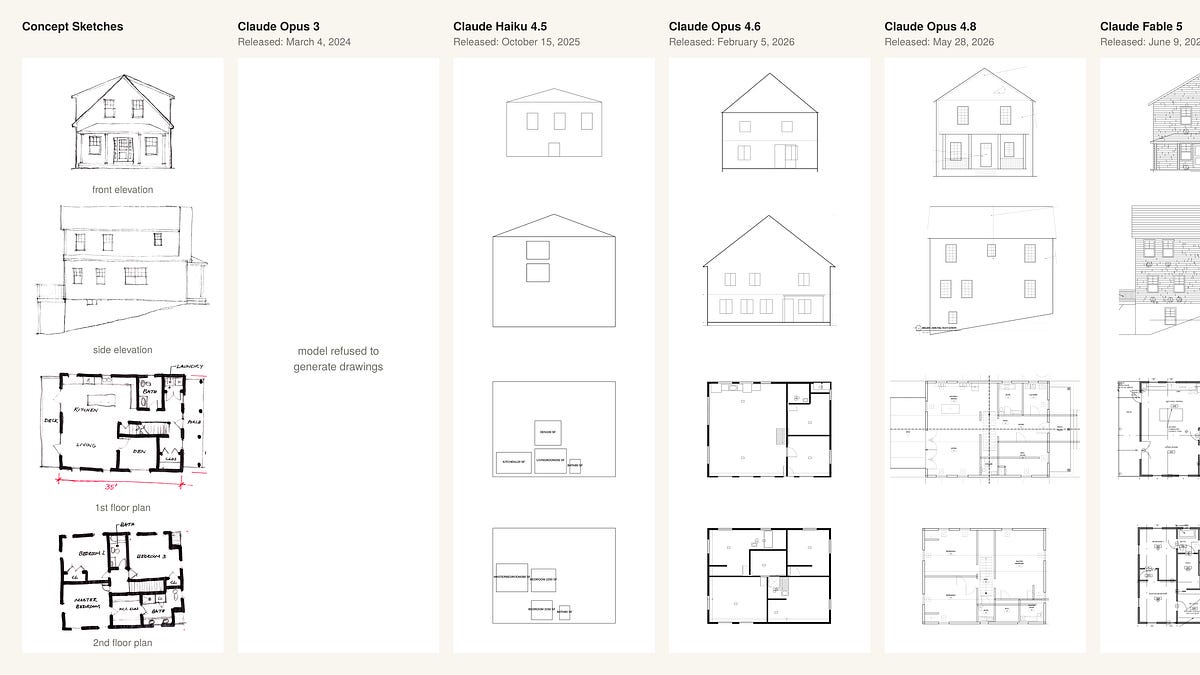
쿼크(夸克)가 개발한 Kimi K3.1 Pro는 오픈 가중치 멀티모달 에이전트 모델로, 백 개가 넘는 하위 도메인에서 대규모 강화학습으로 K3에서 후학습했다. 100만 토큰 컨텍스트 윈도우를 지원하며, 코딩·3D 생성·금융 조사·사실 정확도·에이전트 기능 등에서 큰 개선을 이뤄냈다. 총 파라미터 2.8T, 활성화 파라미터 104B, 93개 레이어, 전문가 896개(토큰당 16개 활성화)의 Mixture-of-Experts 아키텍처를 사용한다. 전체 요약 10문장 읽기 → 008 00:11 ▲ 103 · 댓글 35 Claude Opus 5.5, 건축 인허가 수준의 도면 자동 작성 가능 건축가인 저자가 13개 AI 모델의 기술도면 작성 능력을 테스트했으며, Anthropic의 Claude Opus 5.5(2026년 9월 출시)가 적절한 지도 하에 주택용 건축 인허가 수준의 완전한 도면 세트를 생산할 수 있음을 발견했다. AI · 머신러닝 · Claude Opus 5.5 Can Draw Permit-Level Architectural Drawings
Key Point 건축 설계와 도면 작업이 AI의 급속한 발전으로 근본적으로 변할 시점에 있으며, 숙련된 건축가도 현장에서 감독하기 어려운 변화가 임박해 있기 때문이다.
핵심 요약
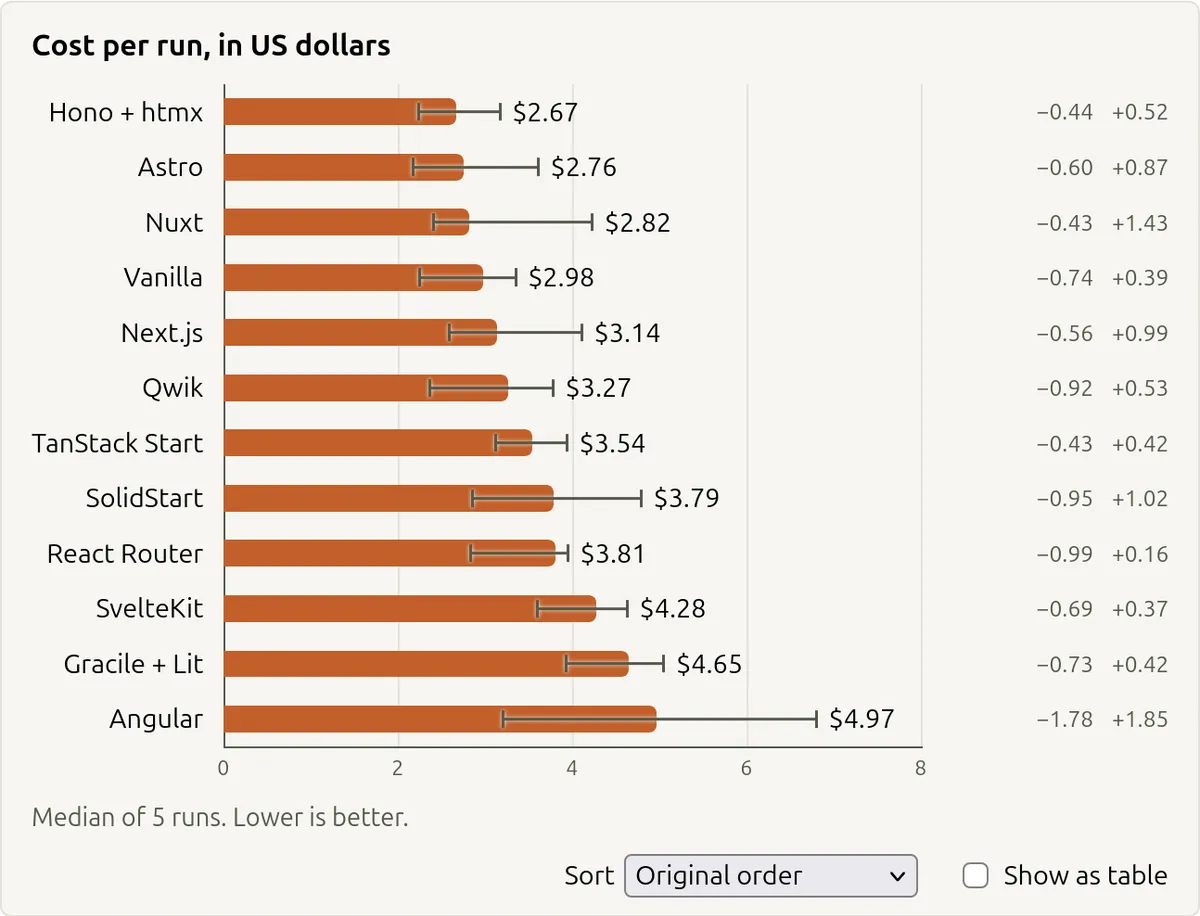
건축가인 저자가 13개 AI 모델의 기술도면 작성 능력을 테스트했으며, Anthropic의 Claude Opus 5.5(2026년 9월 출시)가 적절한 지도 하에 주택용 건축 인허가 수준의 완전한 도면 세트를 생산할 수 있음을 발견했다. 2026년 봄까지 최강 AI 모델도 조악하고 만화 같은 기술도면만 생산했으나, 2026년 여름부터 가을 출시된 프론티어 모델들이 급격히 개선되었다. 첫 번째 테스트에서 Opus 5.5는 저자의 컨셉 스케치와 참조 도면 세트를 받아 12시간 걸려 완전한 건축 도면 세트를 생성했으며, 계산 비용은 수백 달러였다. 전체 요약 12문장 읽기 → 009 21:11 ▲ 113 · 댓글 61 JavaScript 프레임워크, AI 코딩 비용 벤치마크로 검증하다 웹 개발 커뮤니티가 프레임워크 선택을 근거 없는 느낌('vibes')에 기반한다는 점을 지적하고, AI 에이전트 시대에도 이 경향이 계속되고 있음을 언급했다. 웹 · 프론트엔드 · The AI cost of JavaScript frameworks
Key Point AI 에이전트가 코드를 작성하는 새로운 시대에, 느낌이 아닌 실제 비용·성능 데이터로 프레임워크를 평가해야 한다는 점을 처음 제시한 벤치마크 연구이다.
핵심 요약
웹 개발 커뮤니티가 프레임워크 선택을 근거 없는 느낌('vibes')에 기반한다는 점을 지적하고, AI 에이전트 시대에도 이 경향이 계속되고 있음을 언급했다. 포켓몬 API 기반의 검색·필터링 앱을 Next.js, Nuxt, SvelteKit, Angular 등 13개 프레임워크로 AI 에이전트(Claude Opus 5.5)에게 5회씩 개발하도록 지시하여 벤치마크를 수행했다. 비용 측면에서 Hono+htmx($2.67)가 가장 저렴했고, Angular($4.97)가 가장 비쌌으며, 실행 시간과 토큰 소비량도 유사한 패턴을 따랐다. 전체 요약 12문장 읽기 → 010 06:11 ▲ 132 · 댓글 76 해커뉴스 추천 영상만 모은 유튜브 클론 'HackerTube' 공개 유튜브의 알고리즘이 마음에 들지 않아 Claude Opus 5.5를 이용해 HackerTube라는 영상 플랫폼을 직접 만들었다. 웹 · 프론트엔드 · HackerTube: YouTube built from videos recommended by HN
Key Point 기술 커뮤니티가 추천하는 양질의 콘텐츠만 모은 새로운 영상 발견 방식이 나타났으며, LLM과 웹 개발로 단시간에 실제 서비스를 구축하는 사례를 보여준다.
핵심 요약
유튜브의 알고리즘이 마음에 들지 않아 Claude Opus 5.5를 이용해 HackerTube라는 영상 플랫폼을 직접 만들었다. 해커뉴스의 2007년부터 2026년까지 전체 댓글을 수집한 후 Sonnet으로 스팸과 저품질 콘텐츠를 필터링했다. 필터링 결과 해커뉴스 사용자들이 추천한 유튜브 영상 6,454개가 수집되었으며, 150개 주제로 분류됐다. 전체 요약 6문장 읽기 → 011 12:11 ▲ 12 · 댓글 4 AI, 주식 투자 분석 벤치마크에서 실적 부진 금융 에이전트는 현재 시점의 정보만으로 투자 판단을 내려야 하며, 그 예측은 이후의 실제 결과로 평가받는다. AI · 머신러닝 · Investor's Last Exam: Can AI Agents Do Equity Investment Without Seeing the Future?
Key Point 최신 AI 모델들이 종합적 분석은 잘하지만 실제 투자 예측으로 이어지지 못한다는 구체적인 성과 격차를 드러내, AI 금융 분석 능력의 현주소를 파악할 수 있다.
핵심 요약
금융 에이전트는 현재 시점의 정보만으로 투자 판단을 내려야 하며, 그 예측은 이후의 실제 결과로 평가받는다. 기존 벤치마크는 금융 지식·분석 워크플로·예측 능력을 각각 평가했으나, 완전한 연구 프로세스를 평가하려면 정보가 고정된 상태와 전문가 평가 기준이 필요하다. ILE(Investor's Last Exam)는 경험 많은 펀드 매니저들이 주도한 주식 분석 벤치마크로, 342만 개 문서 버전과 9가지 소스를 담은 금융 데이터베이스, 시계열 타임스탬프가 적용된 시장 데이터, 전문가가 설계한 평가 기준을 포함한다. 전체 요약 6문장 읽기 → 012 00:11 ▲ 206 · 댓글 157 구글 제미니 4 카본, AI 성능 평가 1위 등극 구글의 제미니 4 카본이 Artificial Analysis Intelligence Index v5에서 1위를 차지했으며, 코딩 에이전트 평가에서는 Claude Opus 5.5 다음인 2위다. AI · 머신러닝 · Gemini 4 Carbon is the new #1 on the Artificial Analysis Intelligence Index v5
Key Point 구글이 최신 AI 성능 평가에서 1위를 차지해 OpenAI, Anthropic과의 경쟁 지형이 어떻게 변하는지 보여주며, 가격 경쟁력까지 갖춘 모델이 나타났기 때문이다.
핵심 요약
구글의 제미니 4 카본이 Artificial Analysis Intelligence Index v5에서 1위를 차지했으며, 코딩 에이전트 평가에서는 Claude Opus 5.5 다음인 2위다. 제미니 4 카본은 Intelligence Index v5에서 59점을 기록했으며, HLE-Diamond, Terminal-Bench-Science, AA-Omniscience, AutomationBench-AA 등 9개 평가 중 4개에서 1위를 기록했다. 코딩 에이전트 평가에서 제미니 4 카본은 Claude Opus 5.5보다 3점 낮은 59점으로 2위를 차지했으며, Terminal-Bench 4.0에서 64%, FrontierCode v1.1에서 51%를 기록했다. 전체 요약 9문장 읽기 → 013 00:11 ▲ 260 · 댓글 61 미스트랄, 1조 파라미터 대형 모델 가중치 공개 미스트랄이 1조 파라미터 멀티모달 모델 '르 총크(Le Chonk)'의 가중치를 공개했으며, 3주간의 강화학습으로 코딩과 사이버보안 성능을 크게 향상시켰다. AI · 머신러닝 · Mistral Large 4 (Le Chonk) is now Open Weight
Key Point 오픈가중치 대형 언어 모델의 최강자로 자리잡아 개발사들의 모델 선택지가 크게 늘어날 뿐 아니라, 주권 AI 전략을 추진하는 유럽 기관들과 규제가 엄격한 금융·방위 부문에서 실질적인 대안을 제공하기 시작했다.
핵심 요약
미스트랄이 1조 파라미터 멀티모달 모델 '르 총크(Le Chonk)'의 가중치를 공개했으며, 3주간의 강화학습으로 코딩과 사이버보안 성능을 크게 향상시켰다. FrontierCode 2.0 벤치마크에서 19.7%, Terminal-Bench 4.0에서 41%의 성능을 달성하며 오픈가중치 코딩 모델 중 최고 수준을 기록했다. Artificial Analysis 코딩 에이전트 인덱스에서 48%를 달성하며 GLM-5.3과 동등하지만 평균 47% 적은 토큰을 사용해 효율성이 우수하다. 전체 요약 13문장 읽기 → 014 06:11 ▲ 148 · 댓글 79 AI 에이전트는 세금 전문가가 될 수 있나 Surge AI가 DAYJOB: Tax 벤치마크를 발표했으며, 이는 AI 에이전트가 50개의 실무 세금 업무를 얼마나 잘 수행하는지 평가한다. AI · 머신러닝 · Dayjob: Tax – evaluating AI agents on 50 professional tax assignments
Key Point 프론티어 AI 모델이 계산은 잘해도 세금 전문가처럼 '문제가 뭔지 먼저 파악하고' '놓친 핵심을 짚어내는' 판단력은 부족하다는 점을 구체적 사례로 드러낸다.
핵심 요약
Surge AI가 DAYJOB: Tax 벤치마크를 발표했으며, 이는 AI 에이전트가 50개의 실무 세금 업무를 얼마나 잘 수행하는지 평가한다. Claude Sonnet 5.5가 95% 기준선에서 10.8% 통과율로 가장 높은 성과를 보였고, Claude Fable 5.1은 9.6%, Claude Opus 5.5는 9.2%의 통과율을 기록했다. 벤치마크는 개인 및 가족 세무, 소규모 사업, 파트너십, 부동산 투자, 유산 및 신탁, 국제 세무, 기업 거래, 세무 검토 및 분쟁 등 8개 분야를 포함한다. 전체 요약 10문장 읽기 → 015 18:11 ▲ 13 · 댓글 7 작은 오픈소스 모델, 실제 코딩 업무에 얼마나 써먹을까 벤치마크 점수가 높은 오픈 가중치 모델도 실제 코딩 작업에서는 텍스트 생성과 실행 가능한 코드 생성이 별개 문제임을 보여주는 경험 보고서다. AI · 머신러닝 · Beyond Benchmarks: Can Small Open-Weight Models Get Real Coding Work Done?
Key Point 오픈소스 코딩 모델의 실전 성능은 벤치마크와 크게 다르며, 직접 호출과 에이전트 위임 간 성공률 격차가 큼을 실측 데이터로 보여준다.
핵심 요약
벤치마크 점수가 높은 오픈 가중치 모델도 실제 코딩 작업에서는 텍스트 생성과 실행 가능한 코드 생성이 별개 문제임을 보여주는 경험 보고서다. 저자가 2026년 7월부터 10월까지 수행한 엔지니어링 작업을 기반으로, vLLM, SGLang, llama.cpp, MLX 등 여러 모델 서빙 환경에서 같은 엔드포인트로 표시되는 모델들도 도구 호출 형식, 턴 제어, 컨텍스트 동작, 캐시 재사용, 신뢰성 면에서 차이를 보임을 기록했다. 4,165개의 코딩 에이전트 게이트웨이 턴, 623개의 디버그 작업, 고정된 Claude Opus 5.5 부모 모델과 숨겨진 동작 검증을 포함한 3개 위임 연구가 증거다. 전체 요약 10문장 읽기 → 016 18:11 ▲ 89 · 댓글 2 코드 기반 영상 생성 평가하는 벤치마크 등장 멀티모달 에이전트가 코드를 작성해 매 프레임을 렌더링하고 사운드를 합성하는 영상 생성 방식이 부상하고 있다. AI · 머신러닝 · VibeVideoBench: Evaluating Multimodal Agents on Code-Driven Video Generation
Key Point 코드 기반 영상 생성이 확산형 비디오 모델의 대안으로 떠오르는 가운데, 에이전트 성능을 객관적으로 비교 평가할 수 있는 첫 대규모 벤치마크가 제시되었기 때문이다.
핵심 요약
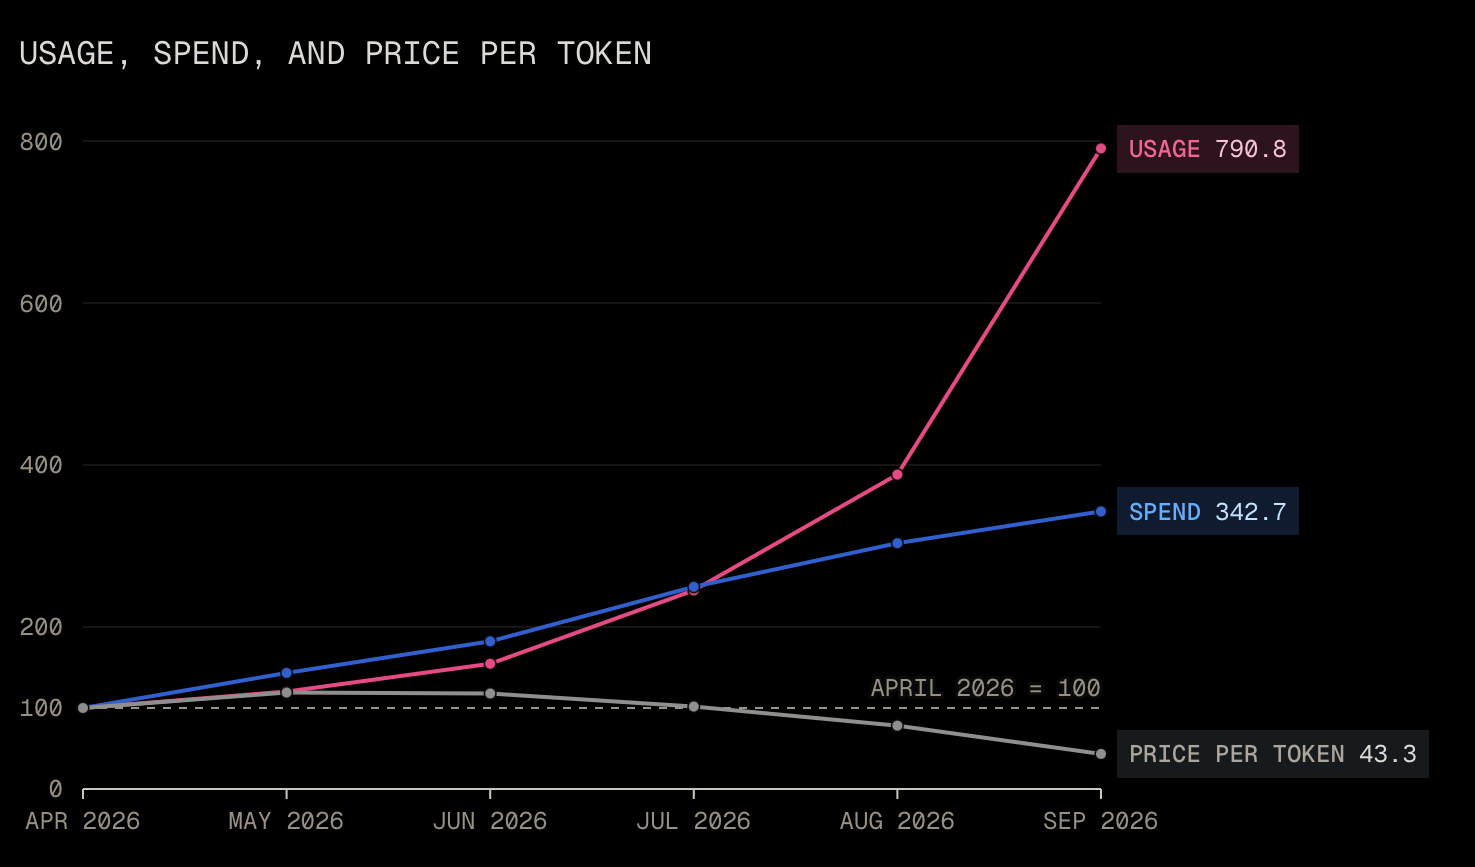
멀티모달 에이전트가 코드를 작성해 매 프레임을 렌더링하고 사운드를 합성하는 영상 생성 방식이 부상하고 있다. VibeVideoBench는 이 접근법을 평가하는 벤치마크로, 영어와 중국어로 된 239개 자체 완결 과제를 제시한다. 데이터 스토리, 음악 기반 콘텐츠, 수업 영상, 논문 설명 등 12개 카테고리를 아우르며, 에이전트는 1시간 내에 사운드가 포함된 MP4 완성본을 제출해야 한다. 전체 요약 9문장 읽기 → 017 12:11 ▲ 184 · 댓글 209 LLM 가격 경쟁 격화, 6개월간 최대 80% 인하 지난 6개월간 OpenAI와 Anthropic은 주요 LLM 모델들의 가격을 급격히 인하했다. GPT-5.6 Luna는 7월에 80% 인하, GPT-6 Sol은 9월에 입출력 가격을 50% 반으로 깎았고, Claude Opus 5.5도 전체 사용 비용 기준 40~60% 감소했다. AI · 머신러닝 · OpenAI and Anthropic cut their LLM prices by up to 80% within a few months. Why?
Key Point OpenAI와 Anthropic이 매출의 대부분을 차지하는 LLM 가격을 6개월간 최대 80%까지 연쇄 인하한 배경에는 DeepSeek 같은 오픈 웨이트 모델의 확산과 인프라 제공자의 경쟁 심화가 있으며, 이는 LLM이 상품화되고 있음을 보여준다.
핵심 요약
지난 6개월간 OpenAI와 Anthropic은 주요 LLM 모델들의 가격을 급격히 인하했다. GPT-5.6 Luna는 7월에 80% 인하, GPT-6 Sol은 9월에 입출력 가격을 50% 반으로 깎았고, Claude Opus 5.5도 전체 사용 비용 기준 40~60% 감소했다. LLM 에이전트 운영 시 캐시 읽기 비용이 전체 토큰 소비의 96~99%를 차지한다. Fable 5.1은 캐시 읽기 비용을 75% 인하하면서 이는 전체 사용 비용 70~75% 감소로 이어졌다. DeepSeek Flash V4는 4월 2026년 출시 이후 매우 저렴한 가격(입력 $0.14, 캐시 읽기 $0.0028)으로 급속도로 확산되었고, OpenRouter에서 29개의 서로 다른 인프라 제공자가 이를 지원하고 있다. 전체 요약 10문장 읽기 → 018 03:11 ▲ 214 · 댓글 114 키미, 백만 토큰 컨텍스트의 K3.1 Pro 공개 키미가 K3.1 Pro와 2~3배 빠른 K3.1 Pro Highspeed를 공개했으며, 100만 토큰 컨텍스트 윈도우를 지원하는 오픈웨이트 모델이다. AI · 머신러닝 · Kimi K3.1 Pro and K3.1 Pro Highspeed
Key Point 오픈웨이트 대규모 언어 모델이 코딩부터 금융 분석까지 여러 분야에서 프로프라이어터리 모델과 경쟁하는 수준에 도달했으며, 사이버보안 능력을 의도적으로 제어하면서 공개하는 오픈 모델의 윤리적 방향성을 보여준다.
핵심 요약
키미가 K3.1 Pro와 2~3배 빠른 K3.1 Pro Highspeed를 공개했으며, 100만 토큰 컨텍스트 윈도우를 지원하는 오픈웨이트 모델이다. 모델은 키미 K3의 포스트 트레이닝 버전으로, 수백 개 다운스트림 도메인 전체에서 대규모 강화학습을 통해 모든 계층을 최적화했다. 코딩 벤치마크에서 K3.1 Pro는 Terminal-Bench 4.0에서 65.7%로 GPT-6 Astra(58.2%)를 상회하고 Claude Opus 5.5(66.4%)와 유사한 성능을 보인다. 전체 요약 12문장 읽기 → 019 09:11 ▲ 206 · 댓글 248 AI 모델들, 인간 본성에 같은 결론에 도달하다 12개 AI 모델(GPT-6.1 Sol, Gemini 4 Argon, DeepSeek V4 Pro, Claude Opus 5.5 등)에게 인간에 대한 가장 논쟁적인 의견을 3번씩 물었다. AI · 머신러닝 · Every AI model has the same "controversial" take on humans
Key Point 같은 AI 모델들이 인간 본성에 대해 거의 동일한 비판적 결론에 도달한 현상은, 학습 데이터의 편향이나 AI 안내 방식이 모델들의 판단을 수렴시키는 메커니즘을 보여준다.
핵심 요약
12개 AI 모델(GPT-6.1 Sol, Gemini 4 Argon, DeepSeek V4 Pro, Claude Opus 5.5 등)에게 인간에 대한 가장 논쟁적인 의견을 3번씩 물었다. 7개 모델은 매번 같은 답을 했고, 12개 모델 모두 최소 1번은 동일한 주장을 제시했다: '인간은 진실보다 집단 소속을 우선한다'는 내용이다. 모델들의 구체적 표현은 다양했지만 핵심은 같다. '인간은 충성심을 원칙으로 위장한다'(GPT-6 Astra), '신념이 아니라 멤버십을 갖는다'(Kimi K3), '이성화 동물이다'(DeepSeek V4 Pro)는 식의 주장이 반복됐다. 전체 요약 12문장 읽기 → 020 18:11 ▲ 160 · 댓글 3 VLM이 3D 공간을 독립적으로 탐색 매핑할 수 있나 비전-언어 모델(VLM) 에이전트가 자율적 탐색을 통해 정확한 3D 맵을 구성할 수 있는지 평가하는 벤치마크 SpatialScout을 제시했다. AI · 머신러닝 · SpatialScout: Can VLM Agents Actively Explore and Map 3D Scenes?
Key Point VLM이 공간 지능 구성 능력을 갖췄는지 체계적으로 측정하기 위한 벤치마크이며, 최첨단 모델도 정밀한 3D 매핑에서 심각한 한계를 보이고 있기 때문이다.
핵심 요약
비전-언어 모델(VLM) 에이전트가 자율적 탐색을 통해 정확한 3D 맵을 구성할 수 있는지 평가하는 벤치마크 SpatialScout을 제시했다. 80개 실내 장면과 3,140개 목표 객체로 구성되며, 에이전트는 카메라를 조종해 장면을 탐색하고 공유 좌표계에서 객체 중심을 추정해야 한다. 시점 선택, 교차 뷰 연관성 파악, 기하학적 추정, 맵 수정을 조율하면서 제한된 상호작용 예산 내에서 작업을 수행한다. 전체 요약 7문장 읽기 → 021 06:11 ▲ 150 · 댓글 177 Steam 유저들, Next Fest의 AI 생성 게임 범람에 필터 요청 Steam Next Fest에서 AI 생성 이미지나 AI로 만들어진 게임이 급증하면서 유저들이 필터링 기능을 요청하고 있다. 웹 · 프론트엔드 · Steam Users Beg for "No AI" Filter as Vibecoders Flood Next Fest
Key Point 게임 개발에서 AI 도구의 보편화가 전환점을 맞으면서, 플랫폼의 큐레이션 정책과 유저 경험의 충돌이 현실화되고 있다.
핵심 요약
Steam Next Fest에서 AI 생성 이미지나 AI로 만들어진 게임이 급증하면서 유저들이 필터링 기능을 요청하고 있다. Claude Opus 5.5 출시와 최근의 분해·매시업 모드 열풍이 AI 생성 게임 증가의 배경으로 지적된다. Steam 커뮤니티 유저들은 저품질 콘텐츠를 걸러낼 수 없어 원하는 게임을 찾기 어려워하는 상황을 호소하고 있다. 전체 요약 8문장 읽기 → 022 15:10 ▲ 138 · 댓글 41 전문가 업무용 오픈 모델 'Ultramarine 1 Flash' 공개 Paper Instruments가 금융, 법무, 컨설팅, 운영 업무에 특화한 오픈 모델 Ultramarine 1 Flash를 공개했다. AI · 머신러닝 · Ultramarine 1 Flash
Key Point 금융·법무·컨설팅 업무에 특화한 전문가용 모델이 기존 고가 모델 대비 60배 저렴하면서 경쟁 수준 성능을 제공함으로써 비용-성능 경계선을 재정의하고 있습니다.
핵심 요약
Paper Instruments가 금융, 법무, 컨설팅, 운영 업무에 특화한 오픈 모델 Ultramarine 1 Flash를 공개했다. Fable 수준의 성능을 제공하면서 비용은 60배 저렴하며, 작업당 $0.13의 가격대로 경쟁사 모델들을 앞선다. JobBench에서 62.9점(Gemini 3.8 Flash 60.6, DeepSeek V4.1 Flash 60.4, Claude Fable 5 57.4)으로 최고 성능을 기록했다. 전체 요약 9문장 읽기 → 023 03:11 ▲ 111 · 댓글 52 LLM이 스타크래프트 봇 작성 대회, GPT-6 Astra 압승 StarSkirmish는 LLM이 1시간 내에 스타크래프트 브루드워용 프로토스 봇을 C++로 작성하는 벤치마크로, 작성된 봇을 인간이 작성한 경쟁용 봇과 평가한다. AI · 머신러닝 · Show HN: Gemini 4 Argon plays StarCraft
Key Point LLM의 장시간 추론 능력과 실전 문제 해결 과정을 직접 관찰할 수 있는 벤치마크로, 기존 공개 평가와 다른 상관관계를 드러낸다.
핵심 요약
StarSkirmish는 LLM이 1시간 내에 스타크래프트 브루드워용 프로토스 봇을 C++로 작성하는 벤치마크로, 작성된 봇을 인간이 작성한 경쟁용 봇과 평가한다. v0.2는 OpenAI, Anthropic, Google, Meta의 최신 모델을 각 회사의 공식 CLI 환경에서 1시간 실행해 승률로 평가하며, GPT-6 Astra가 평균 승률 기준 최고점을 기록했다. GPT-6 Astra를 제외한 상위권 모델들(GPT-6.1 Sol, Gemini 4 Argon, Claude Opus 5.5, Claude Fable 5.1)은 37~39점으로 거의 동점이다. 전체 요약 13문장 읽기 → 024 03:11 ▲ 103 · 댓글 196 TypeScript 컴파일러를 Rust로 포팅한 tsc-rs 공개 LLM을 이용해 TypeScript 컴파일러, 타입 체커, LSP를 Rust로 포팅한 tsc-rs를 공개했다. 기타 · Port of the TypeScript compiler, checker and lsp to Rust, by LLM
Key Point LLM으로 대규모 컴파일러를 성공적으로 포팅한 사례이며, tsc 7 대비 1.6배 빠른 TypeScript 타입 체커가 npm에 공개되어 프로젝트에 즉시 적용 가능하다.
핵심 요약
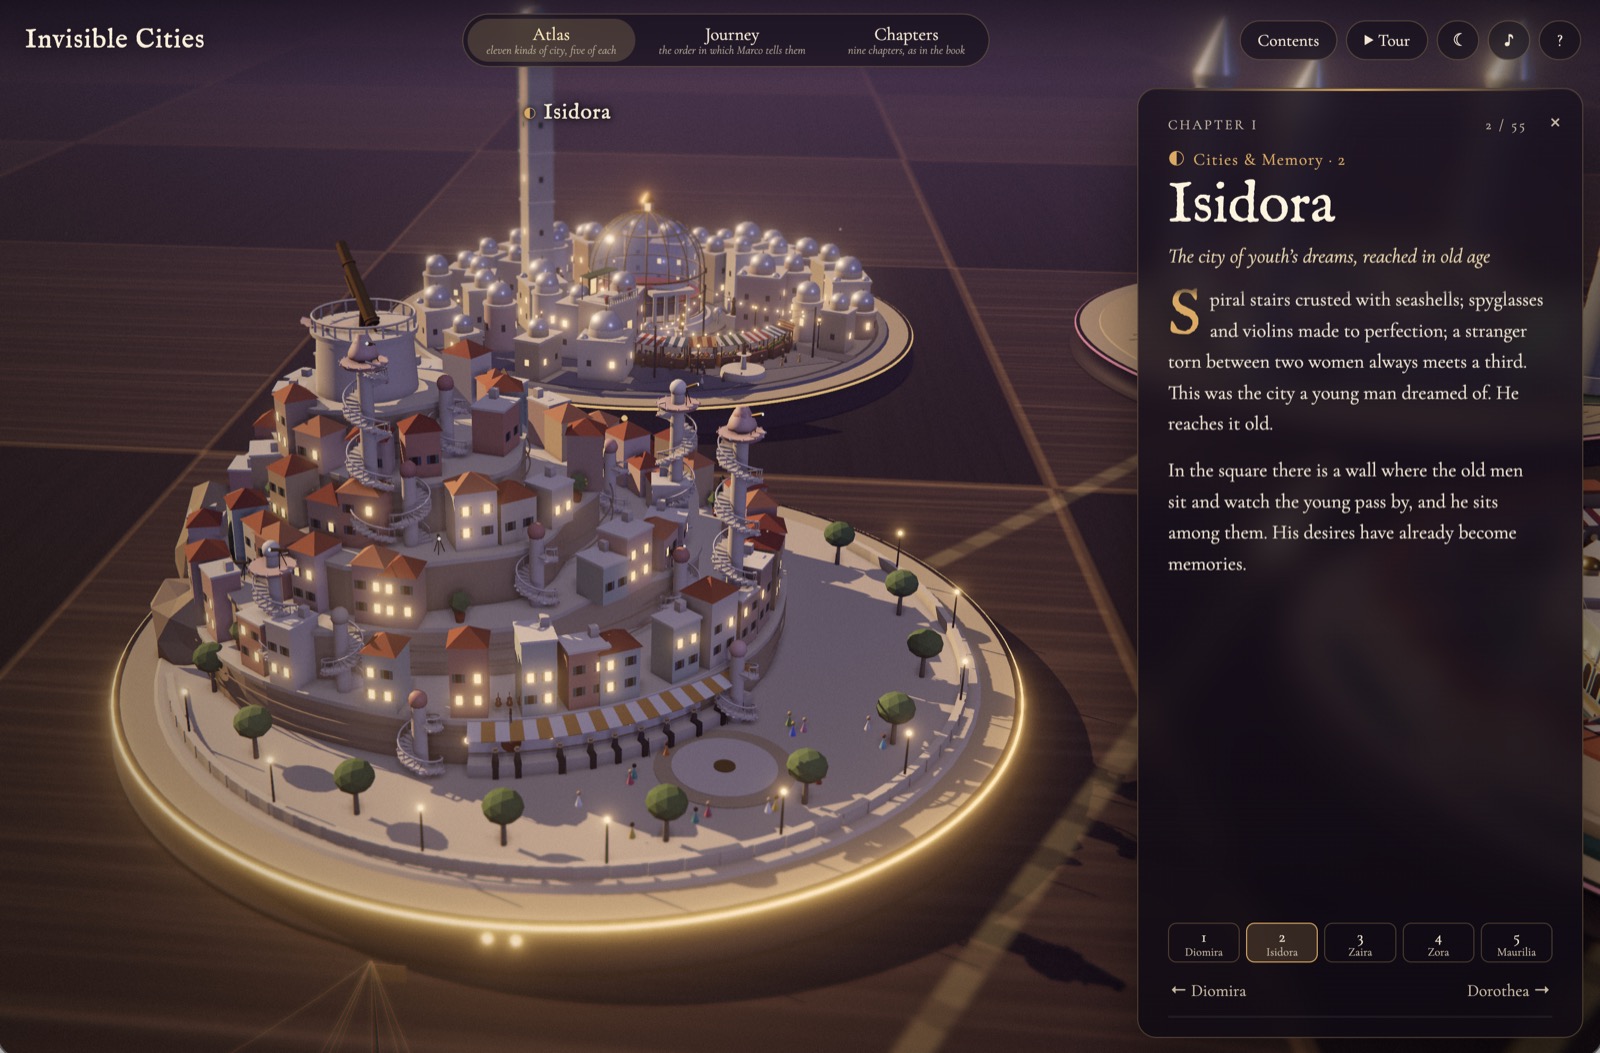
LLM을 이용해 TypeScript 컴파일러, 타입 체커, LSP를 Rust로 포팅한 tsc-rs를 공개했다. OpenAI 모델로는 총 42만 달러를 소비했으나 84% 호환성에 그쳤고, Claude Opus 5.5는 10시간 내 작동 v0를 완성해 2주간 약 2만 4,047달러로 완전 포팅을 달성했다. Microsoft의 TypeScript 컴파일러를 Go에서 Rust로 직접 포팅했으며, tsc와 동일한 명령줄 옵션·언어 서버·API를 유지한다. 전체 요약 12문장 읽기 → 025 00:11 ▲ 167 · 댓글 100 Claude Opus 5.5가 6시간에 그려낸 인터랙티브 도시 시각화 작성자는 Italo Calvino의 '보이지 않는 도시' 55개를 세계지도 형태로 시각화하는 작업을 GPT-6 Astra와 Claude Opus 5.5에 동일한 one-shot 프롬프트로 줬다. AI · 머신러닝 · I gave Opus 5.5 one prompt and six hours to visualize Invisible Cities
Key Point Claude Opus 5.5가 복잡한 인터랙티브 시각화를 단일 프롬프트로 생성하는 능력의 수준을 직접 테스트한 결과로, LLM이 데이터 시각화와 인터랙티브 디자인에 얼마나 실용적이 되었는지 보여준다.
핵심 요약
작성자는 Italo Calvino의 '보이지 않는 도시' 55개를 세계지도 형태로 시각화하는 작업을 GPT-6 Astra와 Claude Opus 5.5에 동일한 one-shot 프롬프트로 줬다. GPT-6 Astra는 53분에 약 $10의 API 비용으로 end-to-end 작동했지만, 불필요한 개념과 주석이 많아 시각적 노이즈가 있었고 Captain Obvious 식 설명이 있었다. Claude Opus 5.5는 지시대로 6시간을 모두 사용하지는 않았으나, 6개의 서브에이전트를 병렬로 실행하며 1시간 25분에 약 $74 비용으로 완성했다. 전체 요약 5문장 읽기 → 026 18:30 ▲ 31 · 댓글 2 멀티모달 AI 에이전트, 로봇 제어는 여전히 어렵다 Hugging Face와 연구팀이 로봇 제어 능력을 평가하는 벤치마크 'RobotWorld'를 공개했다. AI · 머신러닝 · RobotWorld: Benchmarking Multimodal Agents for Robot Use Across Diverse Tasks and Embodiments
Key Point 최고 성능의 멀티모달 AI도 로봇 제어에서 단편적 성공에 그치며 작업 완료로 이어지지 않는 구조적 한계를 보여주는 결과물로, 현재 생성 AI의 물리 세계 응용 가능성을 재평가하는 데 필수적이다.
핵심 요약
Hugging Face와 연구팀이 로봇 제어 능력을 평가하는 벤치마크 'RobotWorld'를 공개했다. 조작, 이동 조작, 보행, 운전, 비행 제어 등 84개 작업으로 구성되며, 명시적 상호작용 예산과 성공 판정 기준을 제공한다. Claude Astra, Claude Opus 5.5 등 주요 멀티모달 에이전트를 테스트한 결과, 이미지 분할, 카메라 보정, 공간 추정 등 정교한 인식 및 제어 워크플로우를 구축할 수 있음을 확인했다. 전체 요약 7문장 읽기 → 027 18:11 ▲ 113 · 댓글 44 AI가 레고 모델을 설계하는 오픈소스 도구 'ldraw-nova' 공개 AI 에이전트에 모델 아이디어를 주면 LDraw 언어로 작성된 실제 레고 모델 소스코드를 생성하는 오픈소스 도구 'ldraw-nova'를 개발자가 공개했다. AI · 머신러닝 · Show HN: Made an open-source Lego AI generator
Key Point LLM이 복잡한 기하학 계산이 필요한 3D CAD 형식을 직접 생성하는 대신 파이썬 코드로 변환하면 성공률이 높아지는 새로운 접근법을 보여주며, AI로 만들 수 있는 창의적 결과물의 범위를 확장한다.
핵심 요약
AI 에이전트에 모델 아이디어를 주면 LDraw 언어로 작성된 실제 레고 모델 소스코드를 생성하는 오픈소스 도구 'ldraw-nova'를 개발자가 공개했다. 생성된 결과물은 3D 뷰어, VR(Meta Quest 3), Blender 편집 가능한 glTF 파일, 채팅 기록, AI의 추론 과정 등 다양한 형식으로 제공된다. AI 에이전트는 먼저 지침을 읽고 필요한 부품과 서브모델을 계획한 후, 반복적으로 렌더링하며 위치와 미관을 조정해 모델을 완성한다. 전체 요약 7문장 읽기 → 028 06:11 ▲ 156 · 댓글 53 AI가 직접 코드로 쓰는 유화 풍경화, 75점 공개 Claude Opus 5.5, GPT-6.1 Sol, Gemini 등 여러 AI 모델이 유화 물감 시뮬레이션에 코드를 작성해 그림을 그린 프로젝트로, 이미지 생성 모델 없이 순수 프로그래밍으로 유화 효과를 구현했다. AI · 머신러닝 · Show HN: Giving Opus 5.5 a simulated paint canvas
Key Point AI가 이미지 생성이 아닌 코드 기반 시뮬레이션으로 전통 회화 기법을 구현하는 방식의 혁신성과, 여러 모델의 창의적 선택과 버그·보안 문제가 실제 데이터로 드러난 흥미로운 실험이다.
핵심 요약
Claude Opus 5.5, GPT-6.1 Sol, Gemini 등 여러 AI 모델이 유화 물감 시뮬레이션에 코드를 작성해 그림을 그린 프로젝트로, 이미지 생성 모델 없이 순수 프로그래밍으로 유화 효과를 구현했다. 각 모델은 '가상 이젤'이라는 인터페이스를 통해 붓질, 물감 건조, 유약 레이어링 등을 코드로 제어하며, 75점 중 46점은 세션 중 여러 번 멈추고 그림을 보며 그렸다. 대부분은 카스파르 다비드 프리드리히 작품을 모사했는데, 실제 그림을 본 적 없이 텍스트 연구만으로 그려냈고, 일부는 자유 주제로 작업했다. 전체 요약 7문장 읽기 → 029 15:11 ▲ 112 · 댓글 26 Claude Opus로 도도새 미발견 기록 발굴한 역사학자 Claude Opus 5.5 같은 최신 AI 모델은 대규모 역사 자료를 의미론적 검색으로 분석해 새로운 사료를 찾을 수 있다. AI · 머신러닝 · Using Opus 5.5 to discover a new eyewitness record of the dodo
Key Point 최신 AI 모델이 기존 전문가의 영역에서 새로운 발견을 할 수 있다는 것은 학문 생태계의 지각변동을 의미하며, 검증 능력 없는 아마추어의 진출이 늘면서 전문가 부족 현상이 곧 닥칠 것으로 전망된다.
핵심 요약
Claude Opus 5.5 같은 최신 AI 모델은 대규모 역사 자료를 의미론적 검색으로 분석해 새로운 사료를 찾을 수 있다. 저자는 네덜란드 동인도회사 아카이브를 검색해 1615년 도도새 사냥 기록을 발견했는데, 이전에 간과된 새로운 사료로 보인다. 같은 검색에서 1638년 적색 레일(멸종된 모리셔스 새)에 관한 참고문헌도 발견했는데, 1890년 프랑스 학자의 오역 때문에 지금까지 주목받지 못했다. 전체 요약 12문장 읽기 → 030 03:11 ▲ 343 · 댓글 342 중국 AI 연구소의 최적화 기술, 서방 기업들이 조용히 도입 중 Anthropic과 OpenAI가 중국 AI 연구소의 기술을 모방한다고 지적하지만, 중국 연구소들은 오히려 자신들의 혁신 기술을 공개하고 있다. AI · 머신러닝 · The AI Race Just Got Awkward
Key Point 서방 AI 기업들이 중국 연구소의 혁신 기술을 도입하면서 장문맥 처리 비용이 급격히 내려가고 있으며, 이는 AI 산업 경쟁 구도의 근본적 변화를 보여준다.
핵심 요약
Anthropic과 OpenAI가 중국 AI 연구소의 기술을 모방한다고 지적하지만, 중국 연구소들은 오히려 자신들의 혁신 기술을 공개하고 있다. DeepSeek이 공개한 KV 캐시 최적화 기술은 긴 문맥을 처리하는 작업에서 캐시 크기를 437배까지 줄였다. MLA 아키텍처로 15배 압축에 성공한 후, CSA, HCA 등의 기법을 거쳐 최신 DeepSeek-V4.1-Flash는 토큰당 890바이트로 캐시를 단축했다. 전체 요약 7문장 읽기 → 031 09:11 ▲ 108 · 댓글 62 Claude Opus 5.5의 성능 변화를 추적하는 벤치마크 공개 Claude Opus 5.5 출시 직후부터 모델 성능이 몰래 하락하는지 검증하는 'livenerf' 벤치마크를 공개했다. AI · 머신러닝 · Livenerf: Has Opus 5.5 been nerfed yet?
Key Point Claude 모델의 출시 후 성능 저하 의혹이 반복적으로 제기되는 상황에서, 데이터 기반 검증 도구가 공개돼 사용자와 개발자가 실제 변화를 직접 확인할 수 있게 되었다.
핵심 요약
Claude Opus 5.5 출시 직후부터 모델 성능이 몰래 하락하는지 검증하는 'livenerf' 벤치마크를 공개했다. GPQA Diamond, MMLU-Pro, 대회 수학 문제 2,336개를 선별해 때때로 정답률이 50~70% 범위에 떨어지는 78개 문항을 최종 패널로 구성했다. 매일 90개 샘플을 실행하되, 처음 10일간을 기준선으로 설정하고 이후 두 개 10일 구간에서 통계적으로 유의미한 변화를 감지한다. 전체 요약 11문장 읽기 → 032 21:11 ▲ 135 · 댓글 129 Claude Opus 5.5 프롬프팅 가이드 Claude Opus 5.5는 이전 Opus 5 대비 출력 토큰을 30% 이상 빠르게 생성하며 같은 작업을 더 적은 토큰으로 완료한다. AI · 머신러닝 · Prompting Claude Opus 5.5
Key Point Opus 5.5는 30% 빠른 토큰 생성과 새로운 사고 기능으로 기존 통합의 설정·프롬프트를 모두 재검토해야 하기 때문이다.
핵심 요약
Claude Opus 5.5는 이전 Opus 5 대비 출력 토큰을 30% 이상 빠르게 생성하며 같은 작업을 더 적은 토큰으로 완료한다. 기본값인 중간 노력도에서 Opus 5.5는 고노력도의 Opus 5보다 코딩과 지식 작업 평가에서 동등하거나 우수하다. 지금은 항상 사고(thinking) 기능이 켜져 있으므로, 노력도를 조정하는 것이 지능·지연·비용을 균형 맞추는 주요 방법이다. 전체 요약 13문장 읽기 → 033 22:26 ▲ 131 · 댓글 51 에이전트와 협업하는 오픈소스 설계 IDE 'Whiteboard' 공개 Y Combinator W26 배치에서 공개한 Whiteboard는 인간과 AI 에이전트가 함께 소프트웨어를 설계할 수 있는 오픈소스 데스크톱 앱이다. 웹 · 프론트엔드 · Show HN: Whiteboard (YC W26) – An open-source IDE for thoughtful software design
Key Point AI 에이전트가 소프트웨어 설계 과정에 참여하는 새로운 워크플로우를 구현한 오픈소스 도구로, 도표·코드·의사결정을 통합적으로 관리할 수 있는 방식을 제시한다.
핵심 요약
Y Combinator W26 배치에서 공개한 Whiteboard는 인간과 AI 에이전트가 함께 소프트웨어를 설계할 수 있는 오픈소스 데스크톱 앱이다. Claude Code, Codex 등 기존 코딩 에이전트에 연결되며, 에이전트가 인앱 캔버스에 작업 내역을 그려서 표현할 수 있는 SDK를 제공한다. 다이어그램과 코드를 직접 연결할 수 있어서 시퀀스 다이어그램, 엔티티 관계 다이어그램, 에이전트 트레이스를 클릭하면 해당 코드로 점프한다. 전체 요약 11문장 읽기 → 034 06:11 ▲ 171 · 댓글 50 Claude Opus 5.5, 최고 성능이지만 가격도 최고 수준 Anthropic이 2026년 9월 공개한 Claude Opus 5.5는 Artificial Analysis Intelligence Index에서 58점을 기록해 평균(25점)을 크게 상회하며 1위를 차지했다. AI · 머신러닝 · Claude Opus 5.5 Intelligence, Performance and Price Analysis (Max)
Key Point 최고 성능의 AI 모델이지만 가격이 높다는 것이 실무 적용 시 비용 대비 효율 판단에 직결되는 정보이기 때문이다.
핵심 요약
Anthropic이 2026년 9월 공개한 Claude Opus 5.5는 Artificial Analysis Intelligence Index에서 58점을 기록해 평균(25점)을 크게 상회하며 1위를 차지했다. 입력 토큰당 $4.00, 출력 토큰당 $20.00으로 책정되어 비슷한 가격대 모델 대비 다소 비싼 편이다. 텍스트와 이미지 입력을 지원하며 1M 토큰의 컨텍스트 윈도우를 갖춘 추론 기능 모델이다. 전체 요약 5문장 읽기 → 035 03:11 새 버전 Anthropic SDK 파이썬 v1.8.0 출시 Claude Opus 5.5 모델 지원이 추가되었고, 인라인 도구 정의와 MCP 도구 목록 고정 기능이 베타로 제공된다. AI · 머신러닝 · anthropics/anthropic-sdk-python@v1.8.0
Key Point Claude 최신 모델을 사용하는 개발자와 MCP 통합을 준비하는 팀이 즉시 업그레이드해야 할 기능 개선과 버그 수정이 포함되어 있다.
핵심 요약
Claude Opus 5.5 모델 지원이 추가되었고, 인라인 도구 정의와 MCP 도구 목록 고정 기능이 베타로 제공된다. Python 3.13에서 스트림이 열린 상태로 종료될 때 발생하는 크래시 문제가 수정되었다. add_tools() 메서드가 즉시 적용되도록 개선되었으며, 도구 실행기의 컴팩션 요청에서 회신 전용 매개변수가 제거되었다. 전체 요약 4문장 읽기 → 036 03:11 ▲ 416 · 댓글 469 클로드 옵스 5.5 공개, 성능은 유지하고 비용 40% 인하 Anthropic이 Claude Opus 5.5를 공개했으며, Opus 5보다 성능은 뛰어나면서 운영 비용은 40% 저렴합니다. AI · 머신러닝 · Claude Opus 5.5
Key Point 가격 인하로 AI 모델의 실무 활용 비용이 대폭 낮아지는 시점이며, 안전성 개선 사항이 생물학·사이버보안 등 민감한 분야에 어떻게 적용되는지 확인할 수 있는 중요한 발표입니다.
핵심 요약
Anthropic이 Claude Opus 5.5를 공개했으며, Opus 5보다 성능은 뛰어나면서 운영 비용은 40% 저렴합니다. 입출력 토큰 가격이 $4·$20/백만 개(기존 $5·$25)로, 캐시 읽기는 $0.20/백만 개(기존 $0.50)로 인하되었습니다. 외부 평가자(Frontier Design, METR)의 검증을 거쳤으며, 자동 행동 감사에서 역대 최고 점수를 기록했습니다. 전체 요약 6문장 읽기 →