매일 쌓이는 개발자의 시야
2026년 11월 9일 (월). 세상의 기술 소식, 한국어로 한눈에.
AI 요약 안내 AI가 한국어로 정리한 내용입니다. 정확한 정보는 각 카드의 원문을 확인해 주세요.
요약 원칙 ↗ 01 읽을 소식Hacker News 8건 ↓ 02 써볼 도구GitHub Trending 2건 ↓ 03 읽을 논문Hugging Face Papers 11건 ↓ 04 새 버전GitHub Releases 0건 ↓ AI · 머신러닝 분야 · 21건 필터 해제 ×
오늘의 주요포인트 상위 6건
01 AI · 머신러닝 06:11 게시
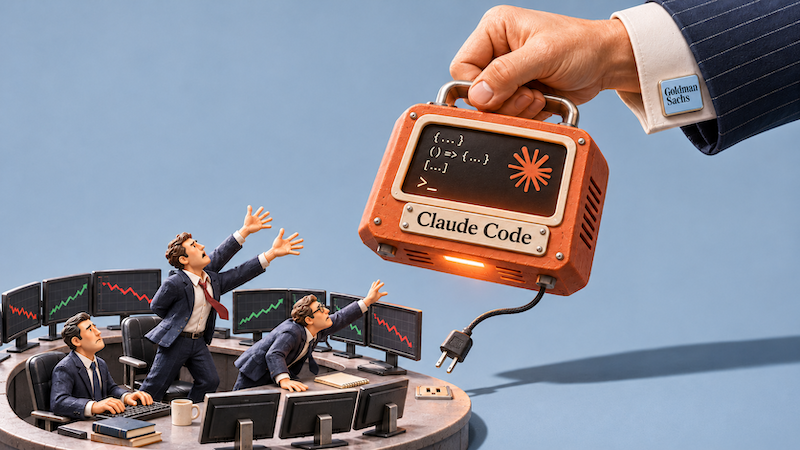
원제 Goldman Sachs Is Pulling Claude Code from Its Bankers and Traders
366 포인트 댓글 226
Key Point 규제가 엄격한 금융기관의 AI 도입 정책이 급변하고 있으며, 같은 기업의 CEO조차 수개월 만에 입장을 바꾸는 모습은 기업 내 AI 거버넌스의 혼란을 보여준다.
핵심 요약
골드만삭스가 10월 내부 지침을 통해 앤스로픽의 Claude Code와 깃허브를 엔지니어만 사용하도록 제한했다. 기존에 트레이더와 은행원들은 클라이언트 거래 흐름 모니터링, 시장 모델 구축, 자료 작성 등에 코딩 에이전트를 활용했으나 이제 접근이 불가능해졌다. 지난 4월 홍콩 은행원들의 Claude 접근을 먼저 차단했고, 현재는 앤스로픽 IPO의 리드 언더라이터로 활동 중이다. 전체 요약 8문장 읽기 → 02 AI · 머신러닝 03:11 게시
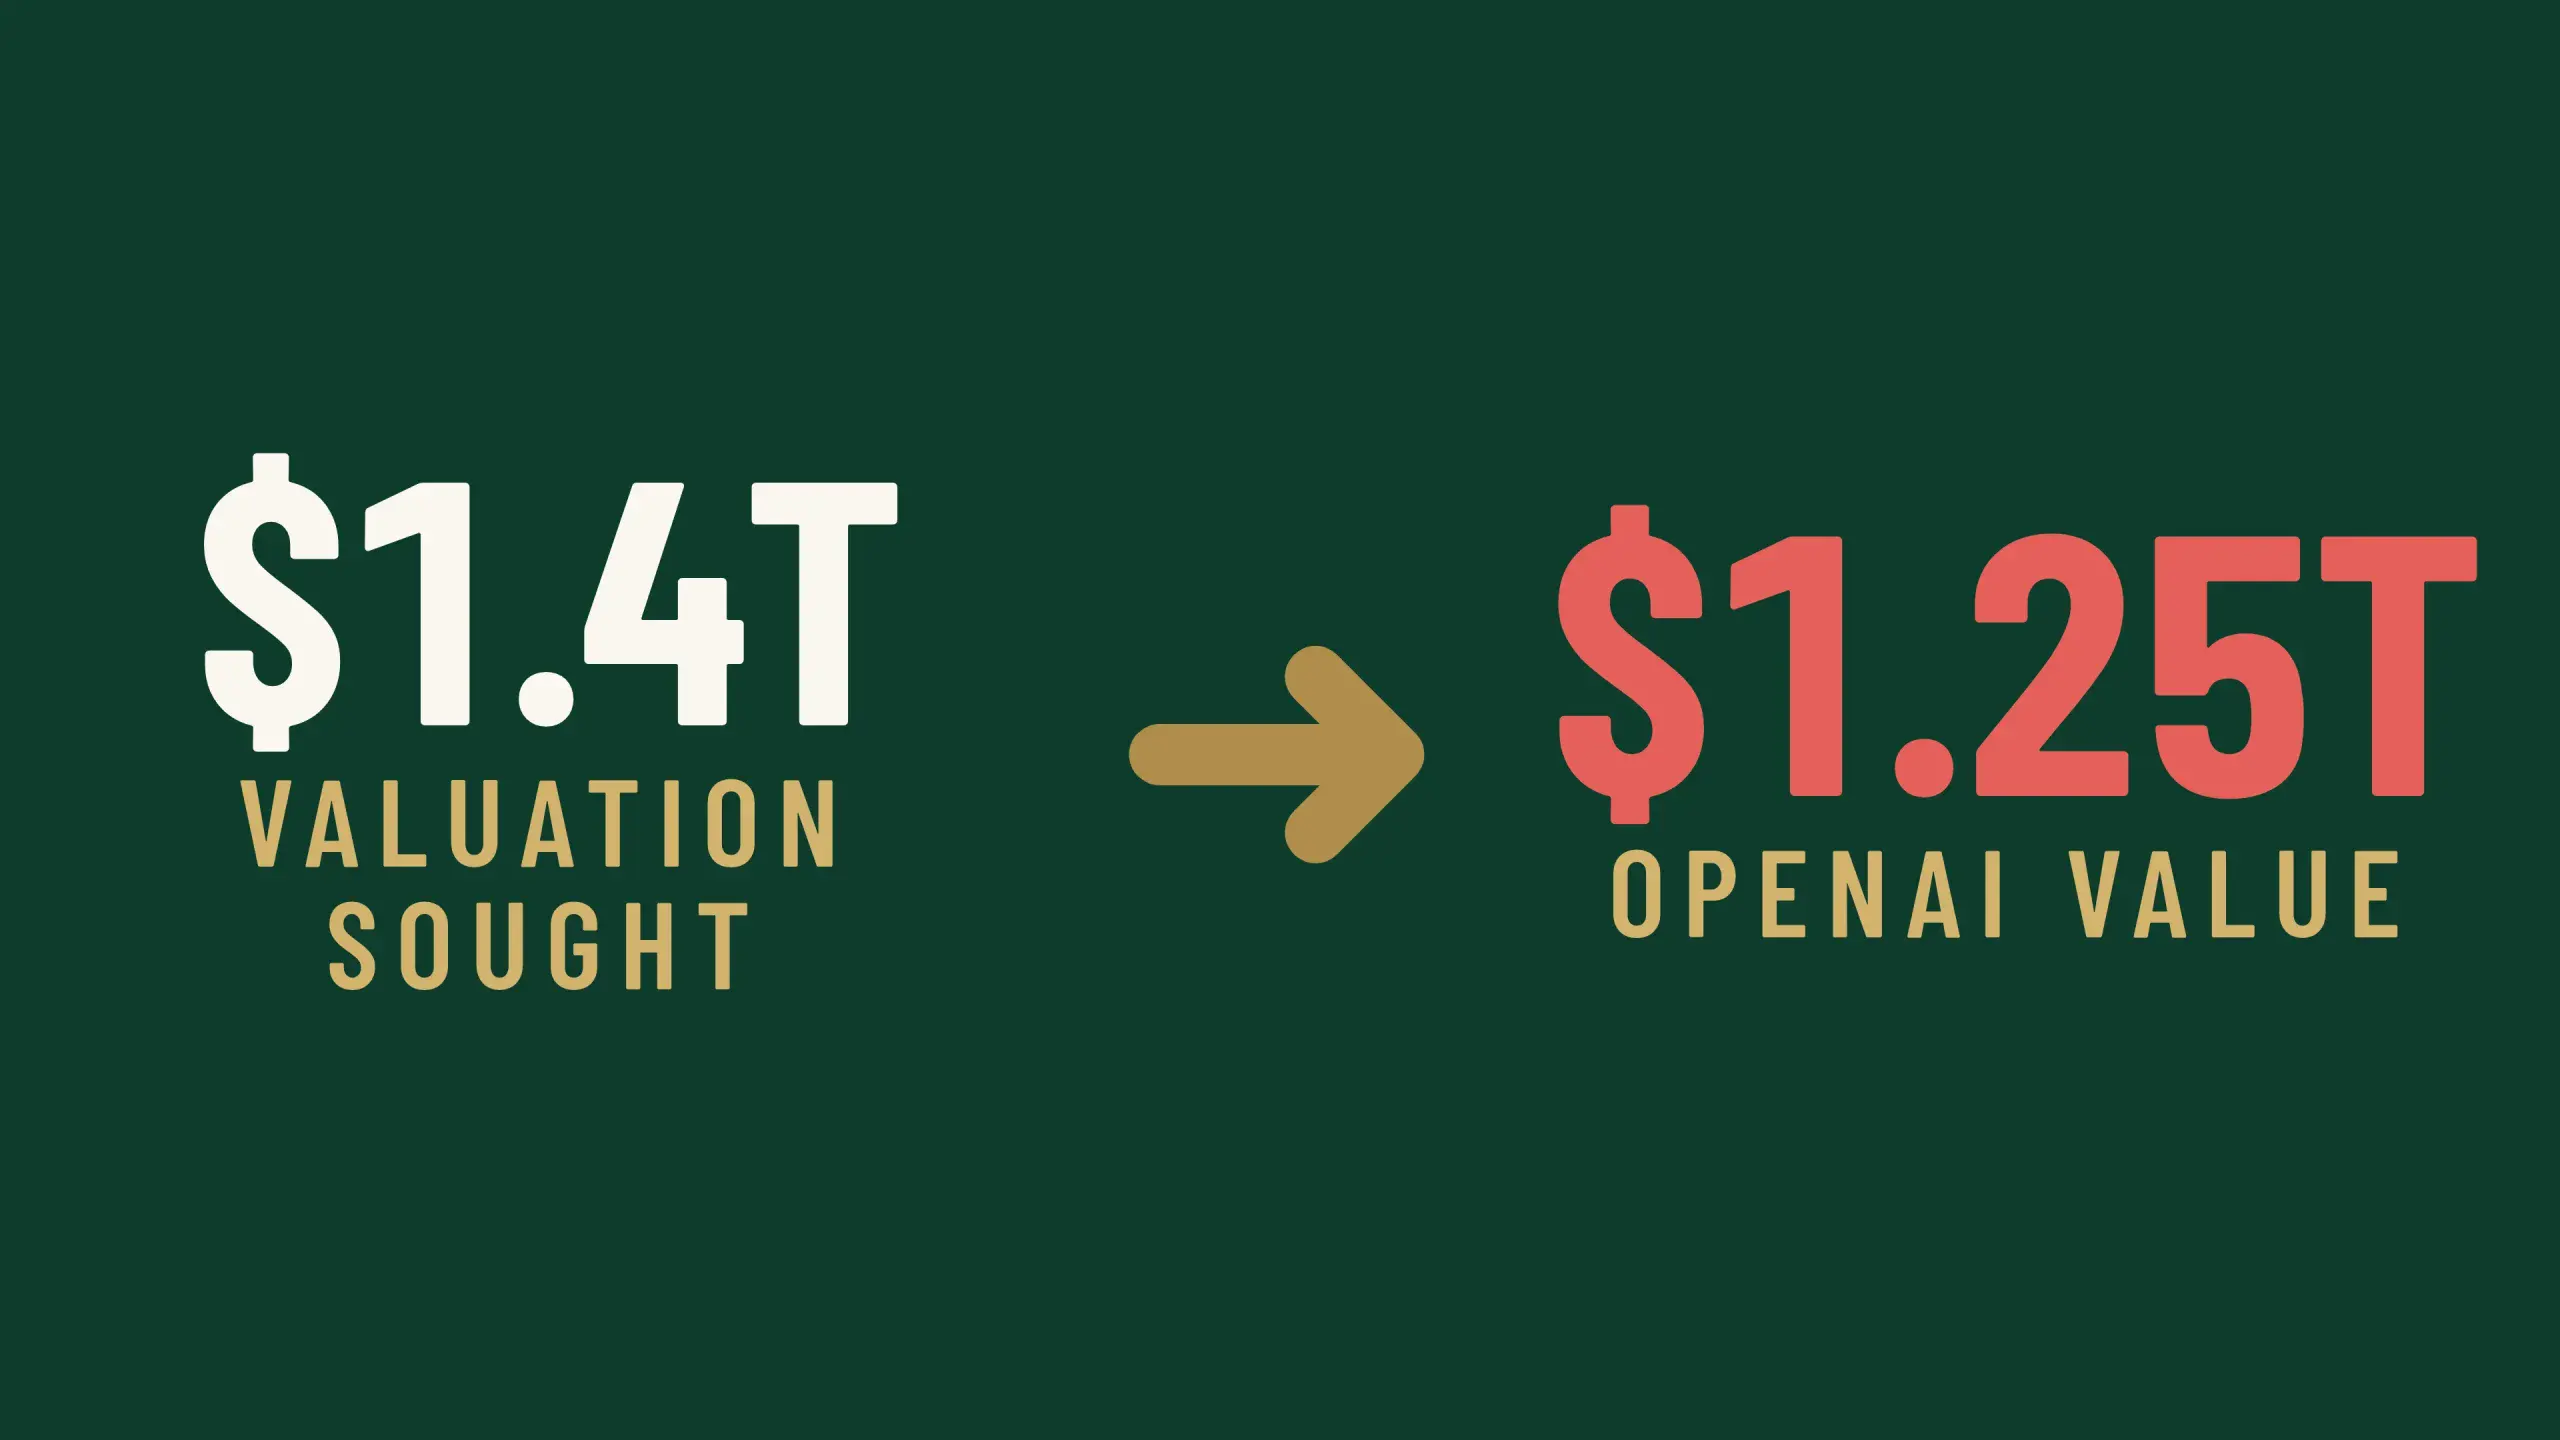
원제 OpenAI raises $11B at a $1.25T valuation
146 포인트 댓글 159
Key Point OpenAI의 투자 유치 규모가 목표 이하로 줄어든 만큼, 기존 투자자인 Microsoft와 NVIDIA의 실적, 그리고 AI 산업 자금 조달 환경 전망을 크게 좌우할 분기점이기 때문입니다.
핵심 요약
OpenAI가 2026년 11월 6일 110억 달러를 투자받았으며, 이는 기업가치 1.25조 달러의 사전 투자 라운드 첫 번째 물량이다. 당초 회사는 1.4조 달러 기업가치에 300억 달러 이상을 모으려 했으나, AI 주식 매도세 속에서 규모가 축소되었다. 이번 라운드는 당초 목표의 약 37%를 충당하며, 소프트뱅크와 UAE의 MGX가 참여했고, 추가 자금으로 총 200억 달러까지 모을 수 있다. 전체 요약 10문장 읽기 → 03 AI · 머신러닝 15:12 게시
원제 I'm not convinced the AI bubble exists
136 포인트 댓글 193
Key Point AI 기업의 재정 건전성이 기존 통념과 다르게 평가되고 있으며, 투자자 행동과 주장 사이의 괴리가 버블론의 실체를 의심하게 한다.
핵심 요약
AI 업계가 극도로 과대평가됐다는 주장이 널리 받아들여지지만, 저자는 이를 합리적이지 않다고 본다. AI 기업들의 현재 지출 규모는 약 5조 달러이지만, 이는 데이터센터 같은 일회성 자본투자이며 운영비가 아니다. Anthropic의 S-1 공시에 따르면 컴퓨트 비용 1달러당 2.08달러의 수익을 올리고 있어, 인프라 구축 후 AI는 매우 수익성 있다. 전체 요약 9문장 읽기 → 04 AI · 머신러닝 03:11 게시
원제 Writing as a thinking tool
133 포인트 댓글 39
Key Point LLM이 글을 대신 써주는 시대에 '직접 쓰기'가 여전히 필수인 이유, 그리고 실제로 글을 써서 사고하는 구체적인 방법을 알 수 있다.
핵심 요약
저자는 중학생 때 텍스트 이해에 어려움을 겪다가 마인드맵을 활용해 필기하면서 문제를 해결했고, 이후 쓰기가 단순한 정보 저장이 아닌 정보 처리 도구임을 깨달았다. 컴퓨터 과학자 Manuel Blum의 조언에 따르면 유한 오토마타는 덧셈만 가능하지만 튜링 머신은 모든 계산 가능한 함수를 계산할 수 있으며, 둘의 유일한 차이는 튜링 머신이 종이와 펜을 가지고 있다는 점이다. 종이를 없애면 복잡도 등급 전체가 하락하므로, 쓰기는 인간의 사고 능력을 근본적으로 향상시킨다. 전체 요약 13문장 읽기 → 05 AI · 머신러닝 09:11 게시
원제 How I Fight AI Brain Fry
131 포인트 댓글 114
Key Point AI와 마주칠 때 멀티태스킹으로 인한 인지 과부하 문제를 체계적으로 해결한 실전 방법론이며, 유사한 상황에 처한 개발자들이 도입할 수 있는 구체적 전략을 제시한다.
핵심 요약
Claude Code 같은 AI 도구로 작업할 때 여러 탭을 오가다 보면 맥락을 추적하기 어려워져 뇌가 과부하 상태(AI Brain Fry)에 빠지는 문제가 발생한다. 저자는 이 문제가 작업 순서 관리와 맥락 전환에서 비롯된다고 분석하고, git 기반 우선순위 큐 시스템으로 해결했다. 모든 작업은 마크다운 파일로 관리되며 레포에 커밋되므로, 채팅 윈도우나 머릿속에만 정보가 남지 않는다. 전체 요약 7문장 읽기 → 06 AI · 머신러닝 03:11 게시
원제 Agent memory needs its OpenTelemetry moment
131 포인트 댓글 93
Key Point AI 에이전트가 점점 보편화되면서 상호운용 불가능한 메모리 형식들이 쌓이고 있는데, 관측성 표준화의 성공 사례를 따라 에이전트 메모리도 하나의 규약으로 통일해야 할 시점이라는 주장을 제시한다.
핵심 요약
현재 AI 에이전트들은 AGENTS.md, Cursor 규칙, Anthropic 메모리 도구, MCP 서버 등 서로 다른 형식으로 메모리를 저장해 상호 운용이 불가능하다. 개발자들이 에이전트 메모리 레이어를 직접 만드는 프로젝트가 늘어나고 있지만, 각각 고유한 저장소와 스키마를 사용하기 때문에 표준의 부재 문제가 심화되고 있다. 2019년 OpenTelemetry 표준 통합 사례처럼, 데이터 모델·의미론적 규약·프로토콜·참조 구현을 정의해 에이전트 메모리도 표준화할 필요가 있다. 전체 요약 12문장 읽기 → 전체 색인2건 · 분야별
AI · 머신러닝2건 001 21:11 ▲ 111 · 댓글 14 텍스트 생성 21배 빨라지는 단계형 모델링 기법 디퓨전 언어 모델은 자동회귀 모델보다 빠른 병렬 샘플링을 제공하지만, 샘플링 단계가 적을수록 품질이 급격히 떨어지고 매번 전체 시퀀스를 처리하며 학습 속도가 느린 문제가 있다. AI · 머신러닝 · Next-Concept Modeling: Fast, Parallel Coarse-to-Fine Text Generation
Key Point 대규모 모델 추론의 병목인 생성 속도를 10배 이상 높이면서 품질을 유지하는 기법이 나왔으므로, LLM 배포와 실시간 서비스에 영향을 줄 수 있다.
핵심 요약
디퓨전 언어 모델은 자동회귀 모델보다 빠른 병렬 샘플링을 제공하지만, 샘플링 단계가 적을수록 품질이 급격히 떨어지고 매번 전체 시퀀스를 처리하며 학습 속도가 느린 문제가 있다. Next-Concept Modeling(NCM)은 2단계 코스-투-파인 프레임워크로, 다중 스케일 VQ-VAE가 텍스트를 이산 코드의 계층으로 인코딩하고 트랜스포머가 각 단계마다 한 수준씩 병렬로 생성한다. LM1B 벤치마크에서 NCM은 가장 강력한 디퓨전 모델보다 나은 생성 복잡도를 달성하면서 21배 빠르게 동작한다. 전체 요약 5문장 읽기 → 002 00:11 ▲ 106 · 댓글 34 284B 대형 AI 모델, GPU 없이 64GB RAM에서 실행하기 llama-modchip v2.4.0은 GPU 없이 순수 CPU만으로 284B 파라미터의 DeepSeek-V4-Flash 모델을 64GB RAM에서 실행할 수 있는 오픈소스 프로젝트다. AI · 머신러닝 · Llama-modchip: 284B DeepSeek on 64GB RAM, no GPU
Key Point GPU 없이 대형 언어 모델을 기존 CPU 워크스테이션에서 실행할 수 있게 되면, 엔터프라이즈 AI 인프라의 진입 장벽이 크게 낮아진다.
핵심 요약
llama-modchip v2.4.0은 GPU 없이 순수 CPU만으로 284B 파라미터의 DeepSeek-V4-Flash 모델을 64GB RAM에서 실행할 수 있는 오픈소스 프로젝트다. 표준 방식으로는 DeepSeek-V4-Flash가 76.87GB가 필요해 64GB 시스템에서 메모리 부족 오류가 나지만, SwiGLU-H2 2차 헤시안 압축과 Fractal-64 양자화(3.75 bits/weight)를 조합하면 56.56GB로 축소할 수 있다. 256K 토큰 컨텍스트에서 프리필(prefill) 성능은 43.16~44.36 토큰/초, 순수 CPU 디코딩은 9.06~10.74 토큰/초, Stockfish-PVS 추측 디코딩 적용 시 11.5~14.7 토큰/초를 달성한다. 전체 요약 13문장 읽기 → 오늘의 주요당일 스타 상위 2건
01 AI · 머신러닝 21:11 게시
Albert-Weasker/niubigeo
원제 Albert-Weasker/niubigeo
스타 10,155 당일 +228 TypeScript
Key Point AI 검색이 제품 추천에 미치는 영향이 커지는 만큼, 각 모델이 실제로 당신을 어떻게 보는지 직접 조사하고 출처까지 검증할 수 있는 도구의 출현은 제품 마케팅 전략에 실질적인 변화를 가져올 수 있다.
핵심 요약
NiubiGEO는 AI 응답에서 브랜드 가시성과 경쟁사 언급을 추적하는 오픈소스 도구다. 도메인을 입력하면 ChatGPT·Claude 등 여러 모델이 해당 제품을 어떻게 설명하는지, 어떤 경쟁사를 함께 언급하는지 비교할 수 있다. 각 결과마다 원본 답변과 출처를 검증 가능하게 저장해, 점수만 주는 상용 GEO 도구와 달리 증거 기반의 판단을 돕는다. 전체 요약 11문장 읽기 → 02 AI · 머신러닝 21:11 게시
poco-ai/Agentero
원제 poco-ai/Agentero
스타 2,130 당일 +145 TypeScript
Key Point 논문 관리부터 AI 기반 분석까지 산재된 학술 워크플로우를 하나로 통합하는 방식이 기존 Zotero·Obsidian·ChatGPT 간 수동 복사-붙여넣기 방식의 대안을 제시한다.
핵심 요약
Zotero 시대의 인-에이전트 협력 단절을 극복하기 위해 개발된 통합 연구 워크스페이스로, 논문·노트·AI 대화를 한곳에서 관리한다. PDF 읽기 환경은 인간에게 친화적으로 유지하면서 자동으로 구조화된 Markdown과 LaTeX로 변환해 AI 모델이 정확하게 인식할 수 있게 제공한다. 도형·수식·표를 자동 추출하고 쌍방향 링크 노트, 다중 모드 번역(구간·페이지·전문), 전문 검색을 지원하는 결구화된 편집 시스템을 갖췄다. 전체 요약 9문장 읽기 → 읽을 논문
Hugging Face Papers11 커뮤니티가 고른 오늘의 AI 논문
오늘의 주요추천 상위 3건
01 AI · 머신러닝 18:11 게시
원제 Confucius4-R2T2: A Stable-Prefix Streaming ASR Model for Real Real-Time Transcription
추천 90 댓글 2 Daniel Huang, Qi He, Shaoxiong Duan 외
Key Point 실시간 번역·음성 에이전트 같은 애플리케이션에서 텍스트 수정으로 인한 오작동을 원천 차단하는 새로운 기술 접근 방식을 보여준다.
핵심 요약
네이즈 유다오가 Confucius4-R2T2라는 스트리밍 음성인식 모델을 공개했으며, 이 모델은 한 번 생성한 텍스트를 절대 수정하지 않으면서도 높은 정확도와 낮은 지연시간을 유지한다. 기존 스트리밍 음성인식 모델은 토큰을 생성한 후 나중에 수정하곤 하는데, 이는 번역기나 음성 에이전트 같은 머신이 잘못된 작업을 수행하게 한다. R2T2는 Qwen3-ASR-1.7B를 중국어와 영어 1,500시간 음성으로 후학습하되, 사전학습된 음성 인코더와 프로젝터는 동결해서 개발했다. 전체 요약 8문장 읽기 → 02 AI · 머신러닝 18:11 게시
원제 SplatAnything: Gaussian Spacing Normalization for Feed-forward 3DGS across Arbitrary Scenes
추천 70 댓글 2 Hao Yu, Zhenwei Wang, Yongzhen Hu 외
Key Point 3D 장면 재구성의 핵심 문제인 규모 변화에 대한 보다 견고한 해결책을 제시해 3DGS 기반 응용 분야에서 일반화 성능을 높일 수 있다.
핵심 요약
기존 피드포워드 3DGS(3D 가우시안 스플래팅) 방법들은 가우시안 속성을 반지름 거리 정규화 공간에서 예측했는데, 이때 인접한 가우시안 중심 간의 간격이 장면 규모와 카메라 설정에 따라 크게 변한다. 이 불일치로 인해 가우시안 스케일 타겟에 체계적 편향이 생기고 학습 신호가 모호해지는 문제가 발생한다. SplatAnything은 Gaussian Spacing Normalization(GSNorm)을 도입해 장면 수준의 가우시안 간격 통계를 정규화하고 예측을 위한 일관된 공간 기준을 제공한다. 전체 요약 5문장 읽기 → 03 AI · 머신러닝 18:11 게시
원제 P^2-MOPD: Accelerating Multi-Teacher On-Policy Distillation via Parameter Priors
추천 62 댓글 8 Sinuo Wang, Jiacheng Lu, Zeyu Zhang 외
Key Point 멀티티처 증류에서 훈련 단계를 50% 단축하고 최종 성능을 14% 향상시키는 방법이 제시되어, 대규모 모델 병렬화 연구에 실질적 가치가 있다.
핵심 요약
다중 전문가 모델의 능력을 학생 모델에 전이하는 온폴리시 증류(on-policy distillation)는 학생이 생성한 궤적을 감독하는 방식으로 작동한다. 기존 태스크 산술(task arithmetic)은 학생과 전문가 매개변수를 선형결합하되 두 모델의 범위 내에만 머물게 되는 한계가 있다. P²-MOPD는 학생과 전문가 매개변수의 선형결합을 하나의 미분가능한 모델로 보고, 혼합 계수와 학생 가중치를 동일한 목적함수 아래 공동 최적화한다. 전체 요약 6문장 읽기 → 전체 색인8건 · 분야별
AI · 머신러닝8건 001 21:11 ▲ 21 · 댓글 3 코드로 영상 생성 제어하는 AI 에이전트 등장 Video-Coder는 코드를 자율적으로 작성·실행하여 3D 장면을 구성하는 영상 생성 에이전트로, 이 3D 장면(Draft Video)이 다운스트림 영상 생성 모델에 구조와 모션 신호를 제공한다. AI · 머신러닝 · Video-Coder: Reinforcing Agentic Coding for Video Generation
Key Point 정밀한 공간 구조와 제어 가능한 영상 생성이라는 영상 AI의 오래된 문제를 코드 기반 에이전트로 풀어내는 새로운 패러다임이기 때문이다.
핵심 요약
Video-Coder는 코드를 자율적으로 작성·실행하여 3D 장면을 구성하는 영상 생성 에이전트로, 이 3D 장면(Draft Video)이 다운스트림 영상 생성 모델에 구조와 모션 신호를 제공한다. 논문은 6천 개 샘플의 감독학습용 데이터셋(Video-Coder-SFT-6k)과 2천 개 샘플의 강화학습용 데이터셋(Video-Coder-RL-2k)을 새로 구축했다. 코드 실행·3D 렌더링·실행 피드백을 통합한 Video-Coder Harness 환경을 개발하여 에이전트 훈련과 추론에 사용한다. 전체 요약 6문장 읽기 → 002 21:11 ▲ 22 · 댓글 2 상대 위치 어텐션, 구조 인식 커널로 속도·메모리 대폭 개선 RoPE 대신 상대 위치 기반 어텐션 메커니즘은 음성 처리 등에서 뛰어난 성능을 보이지만, 시퀀스가 길어질수록 메모리·대역폭·연산량이 급증하는 병목이 있었다. AI · 머신러닝 · Fast and Exact Relative-Position Attention via Structure-Aware Kernels
Key Point 상대 위치 어텐션이 RoPE 대비 유리한 도메인에서 길이 확장성의 근본적 병목을 해결함으로써, 오디오·장문맥 처리에서 Transformer 적용 범위를 크게 확대할 수 있다.
핵심 요약
RoPE 대신 상대 위치 기반 어텐션 메커니즘은 음성 처리 등에서 뛰어난 성능을 보이지만, 시퀀스가 길어질수록 메모리·대역폭·연산량이 급증하는 병목이 있었다. 이 논문은 FlashAttention 스타일의 타일 기반 연산에 상대 위치 항을 정확히 통합하는 새로운 알고리즘을 제안한다. 오프셋 인식 타일링으로 중복 인덱싱을 제거하고, 키-쿼리 관계 연산을 필요한 만큼만 계산해 토큰 쌍 간에 재사용한다. 전체 요약 7문장 읽기 → 003 18:11 ▲ 31 · 댓글 3 여러 이미지 참고한 생성형 AI 평가 벤치마크 'LongBanana' 공개 생성형 AI가 여러 이미지에서 정보를 모아 하나의 일관된 이미지를 만드는 능력을 평가하는 벤치마크 'LongBanana'가 공개되었다. AI · 머신러닝 · LongBanana: An Expert-Verified Benchmark for Long-Context Multi-Reference Image Synthesis
Key Point 멀티모달 AI의 복잡한 시각적 추론 능력을 체계적으로 평가할 새로운 표준이 생겼으며, 에이전트 기반 생성형 AI 개발에 구체적인 벤치마크를 제공한다.
핵심 요약
생성형 AI가 여러 이미지에서 정보를 모아 하나의 일관된 이미지를 만드는 능력을 평가하는 벤치마크 'LongBanana'가 공개되었다. 산업 전문가가 직접 설계·검증한 첫 벤치마크로, 흩어진 시각 정보 수집, 관련 없는 정보 제거, 개체와 관계 연결, 최종 이미지 구성을 포함한 여러 단계의 작업을 요구한다. 벤치마크는 3×3 분류법으로 구성된 90개 과제를 담고 있으며, 각 과제당 약 32개 참고 이미지, 20개 제약조건, 50개 평가 항목으로 총 4,670개의 전문가 검증 평가 항목을 포함한다. 전체 요약 8문장 읽기 → 004 15:12 ▲ 28 · 댓글 3 AI 에이전트의 '마지막 1마일' 해결하는 재사용 가능한 프리미티브 등장 현재 최고 수준의 AI 모델도 실제 과제 처리에서 리소스에 접근한 후 이를 적용하는 단계에서 실패하는 '마지막 1마일' 문제를 겪고 있다. AI · 머신러닝 · The Last Mile to the Real World: Agent-Native Primitives as Reusable Building Blocks for Solving Real-World Tasks
Key Point AI 에이전트가 실제 업무에서 마주치는 가장 큰 병목인 '리소스 적용 능력' 문제를 근본적으로 해결하는 방법론을 제시해, 현재 시스템의 성능을 대폭 끌어올린 핵심 기술이기 때문이다.
핵심 요약
현재 최고 수준의 AI 모델도 실제 과제 처리에서 리소스에 접근한 후 이를 적용하는 단계에서 실패하는 '마지막 1마일' 문제를 겪고 있다. Terminal-Bench 4.0에서 GPT-5.6 Sol은 37.3%, Claude Opus 5는 51.8%의 과제만 해결했다. 연구팀은 에이전트 네이티브 프리미티브(agent-native primitives)라는 재사용 가능한 단위를 제안했으며, 각 프리미티브는 내장된 LLM으로 리소스를 적용하고 다른 프리미티브와 통신한다. 전체 요약 8문장 읽기 → 005 15:12 ▲ 25 · 댓글 3 에이전트 진화의 함정, 벤치마크 점수가 실제 개선을 보장하지 않다 에이전트 하네스 진화를 통한 재귀적 자기 개선(RSI)은 모델 가중치 업데이트 없이 성능을 높이는 방법이다. AI · 머신러닝 · Beneath the Surface: What We Overlook When We Talk About Agent Evolution
Key Point 벤치마크 점수 향상이 실제 신뢰도·효율성·이식성 개선을 보장하지 않는다는 것을 보여주며, 에이전트 진화 평가 방식의 근본적 재검토가 필요함을 제시한다.
핵심 요약
에이전트 하네스 진화를 통한 재귀적 자기 개선(RSI)은 모델 가중치 업데이트 없이 성능을 높이는 방법이다. 16개의 진화된 에이전트는 모두 새로운 작업을 얻은 반면 이전에 수행하던 작업들을 잃었다. 일반 작업의 한 사례에서는 신뢰도가 5.2포인트 올랐지만 10개의 이전 작업을 상실했다. 전체 요약 9문장 읽기 → 006 15:12 ▲ 24 · 댓글 2 동영상 생성 AI에 인과관계 추론 능력 추가하는 'EvoWorld' 생성형 비디오 모델은 픽셀 렌더링에는 뛰어나지만 세계 상태 변화를 인과적으로 추론하는 능력이 부족해 동작이 정적이거나 인과관계가 불일치하는 결과물을 만든다. AI · 머신러닝 · EvoWorld: Towards Out-of-Sight World Evolution in Generative Video Models
Key Point 기존 비디오 생성 AI의 근본적 한계를 건드린다: 현실감 있는 이미지만 만드는 데서 벗어나 '왜'와 '그 다음'을 추론하는 세계 시뮬레이터로 나아가는 길을 제시한다.
핵심 요약
생성형 비디오 모델은 픽셀 렌더링에는 뛰어나지만 세계 상태 변화를 인과적으로 추론하는 능력이 부족해 동작이 정적이거나 인과관계가 불일치하는 결과물을 만든다. 예를 들어 야생동물이 나타났을 때 생성 모델은 그 이미지만 렌더링할 뿐, 근처 인물이 도망쳐야 할지 숨어야 할지 싸워야 할지 추론하지 못한다. 논문은 '시야 밖 인과진화(Out-of-Sight Causal Evolution)' 문제를 제안해 모델이 사건을 렌더링하고 그 결과를 추론한 뒤 시야 밖에서도 인과적으로 타당한 결과를 드러내도록 요구한다. 전체 요약 7문장 읽기 → 007 06:11 ▲ 10 · 댓글 3 영상 생성 없이 로봇 제어하는 'DreamFree' 기법 제안 세계 액션 모델(WAM)은 미래 영상 예측으로 로봇을 제어하지만, 반복적인 영상 디노이징이 비싸고 부정확한 시각 예측이 행동 예측을 해칠 수 있다. AI · 머신러닝 · Future Representation Distillation for Imagination-free World Action Models
Key Point 시각 예측 과정을 제거하면서도 더 나은 제어 성능을 달성하는 방식이 로봇 제어의 효율성과 확장성을 크게 높일 수 있다.
핵심 요약
세계 액션 모델(WAM)은 미래 영상 예측으로 로봇을 제어하지만, 반복적인 영상 디노이징이 비싸고 부정확한 시각 예측이 행동 예측을 해칠 수 있다. DreamFree는 사전학습된 영상 확산 모델을 표현 증류를 통해 예측용 시각 인코더로 재목적화하여 미래 영상 생성 없이 행동을 예측한다. 시각 인코더는 현재 관찰만으로 동결된 영상 확산 모델의 표현을 예측하도록 학습하고, 행동 모듈이 인코더에서 추출한 행동 관련 정보로 행동을 예측한다. 전체 요약 5문장 읽기 → 008 06:11 ▲ 10 · 댓글 3 음성 언어 모델의 응답 지연을 73% 줄이는 추론 기법 청크 단위로 음성을 주고받는 풀듀플렉스 음성 언어 모델은 대기 중 연산 자원이 유휴 상태가 되어 응답과 도구 호출이 지연되는 문제가 있다. AI · 머신러닝 · Decode Before You Hear: Speculative Listening for Chunk-Interleaved Full-Duplex Speech Language Models
Key Point 실시간 음성 대화 AI의 응답 지연을 인간 수준으로 줄이는 기술적 해법이 실제 모델들에서 어떻게 작동하고 얼마나 효과적인지 구체적으로 보여준다.
핵심 요약
청크 단위로 음성을 주고받는 풀듀플렉스 음성 언어 모델은 대기 중 연산 자원이 유휴 상태가 되어 응답과 도구 호출이 지연되는 문제가 있다. 연구팀은 무음을 입력으로 가정해 다음 청크를 미리 생성하는 '스펙큘러티브 리스닝(Speculative Listening)' 기법을 제안했다. 4개 모델 분석 결과 다음 음성 청크가 출력을 바꾸지 않는 경우가 95.3%였고, 변화가 생기는 88%는 첫 번째 출력 토큰부터 시작됐다. 전체 요약 8문장 읽기 → ● 이번 피드는 여기까지입니다.
작은 발견을 다음 커밋으로 이어가세요. 모든 발행본