쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
100건 (최대치) · "신뢰도"조건 지우기 ×
001 09:11 ▲ 115 · 댓글 57 버거킹·맥도날드 오래된 링크 피싱으로 악용되다 2011년 버거킹 트윗의 Bitly 링크가 15일 다시 등록되어 나치 수용소 위키피디아 페이지로 리다이렉트되었고, 맥도날드 2011년 링크는 9·11 공격 페이지로 변조됐다. 보안 · Old Bitly Links Are Being Hijacked
Key Point 대규모 검증 계정의 오래된 링크가 악의적으로 탈취되어 피싱·사기에 악용되는 구조가 드러났으며, 본인 계정이 해킹되지 않아도 과거 포스트의 신뢰도가 훼손될 수 있다.
핵심 요약
2011년 버거킹 트윗의 Bitly 링크가 15일 다시 등록되어 나치 수용소 위키피디아 페이지로 리다이렉트되었고, 맥도날드 2011년 링크는 9·11 공격 페이지로 변조됐다. Bitly는 링크의 뒷부분(back-half)이 재사용될 수 없다고 했으나, 2009~2013년 트럼프 트윗 97개 링크 중 57개가 재등록되어 원래 위치와 다른 곳을 가리키고 있다. 49개 링크는 2023년 5월 17분 내 재등록되어 트윗 원래 콘텐츠로 복구된 것으로 보이나, 7개는 암호화폐 서비스 흉내낸 도메인(worldlibertyfinancial-ai.com, dappradars.website 등)을 가리킨다. 전체 요약 10문장 읽기 → 002 06:11 ▲ 103 · 댓글 86 호르무즈 해협 위기, 석유 수송 거래의 민낯 호르무즈 해협을 통한 원유 수송은 매우 기밀이며 보안 위험이 극심하고 수익은 막대하다. 인프라 · 데브옵스 · A rare glimpse inside the high-risk, high-reward Hormuz trade
Key Point 호르무즈 위기 이후 기실이 극도로 제한된 국제 석유 수송의 실제 거래 방식과 위험 회피 메커니즘이 법정 증언을 통해 최초로 공개된다.
핵심 요약
호르무즈 해협을 통한 원유 수송은 매우 기밀이며 보안 위험이 극심하고 수익은 막대하다. 런던 법정의 머큐리아 v 발틱거래소 재판에서 머큐리아의 크루드 선박 중개인 르노 호스피의 증언이 공개됐다. 3월 미사일 공격 이후 머큐리아는 보유한 VLCC(초대형 유조선)를 호르무즈 해협 안으로 보낼 수 없어 시노코르에 의존했다. 전체 요약 12문장 읽기 → 003 15:11 ▲ 149 · 댓글 30 엔비디아 이사, 황 CEO 스캔들 전 약 1조원어치 주식 매각 엔비디아의 제2위 주주인 보드 이사 마크 스티븐스가 CEO 젠슨 황의 11월 12일 사임 직전 약 9억 4천 6백만 달러(약 1조 2천억 원)어치의 주식을 매각했다. 스타트업 · 비즈니스 · Nvidia director sold nearly $1B in stock weeks before the Jensen Huang scandal
Key Point 임원진의 대규모 주식 매각 시기와 경영진 스캔들의 연관성 여부가 투자자들의 신뢰도에 직결되는 문제이기 때문이다.
핵심 요약
엔비디아의 제2위 주주인 보드 이사 마크 스티븐스가 CEO 젠슨 황의 11월 12일 사임 직전 약 9억 4천 6백만 달러(약 1조 2천억 원)어치의 주식을 매각했다. 스티븐스는 Q3 2026년에 약 420만 주를 3차례에 걸쳐 판매했으며, 첫 번째 거래는 8월 31일~9월 2일 사이 주당 220~226달러에 4억 1천만 달러, 두 번째는 9월 3~4일 사이 주당 227~234달러에 2억 3천 6백만 달러, 세 번째는 9월 18일 주당 약 220달러에 약 3억 달러를 벌었다. 스티븐스는 이 주식 매각을 위한 사전 합의된 거래 계획(Rule 10b5-1 거래 계획)을 수립하지 않았는데, SEC는 2000년부터 이 제도를 도입했으며 2022년에 거래 시작 전 90일 대기 기간을 추가했다. 전체 요약 8문장 읽기 → 004 09:11 ▲ 224 · 댓글 74 구글, 의사결정 전문 AI API 공개…150ms 내 1000개 질문 처리 구글이 Gemini Decision 1 모델 기반의 Decisions API를 출시했으며, 텍스트·이미지·오디오·비디오·PDF를 포함한 멀티모달 입력에서 최대 1000개의 예/아니오, 선택지, 루브릭 채점 질문을 한 번의 API 호출로 처리할 수 있다. AI · 머신러닝 · Gemini Decisions API
Key Point 의사결정에 특화된 저지연 API가 등장하며 AI 애플리케이션의 라우팅·검증·분류 작업 방식이 바뀌고, 기존 대비 5배 저렴한 가격과 3가지 질문 유형 지원으로 구현 복잡도를 크게 낮춘다.
핵심 요약
구글이 Gemini Decision 1 모델 기반의 Decisions API를 출시했으며, 텍스트·이미지·오디오·비디오·PDF를 포함한 멀티모달 입력에서 최대 1000개의 예/아니오, 선택지, 루브릭 채점 질문을 한 번의 API 호출로 처리할 수 있다. 토큰별 생성이 아닌 단일 포워드 패스 방식으로 동작해 중앙값 50~100ms 모델 계산 시간(엔드투엔드 150~250ms)의 저지연을 유지하며, 최대 16K 토큰 컨텍스트에서 질문 1~100개 구간에서도 거의 선형적인 성능을 보인다. 에이전트 라우팅·추론·랭킹·멀티모달 이해 벤치마크에서 Gemini Decision 1이 최고 성능을 기록했으며, 보정 오류도 가장 낮다. 전체 요약 8문장 읽기 → 005 21:11 당일 +361 고성능 AI로 감사, 저비용 AI로 실행 코드베이스를 자동으로 감사하고 실행 계획을 작성하는 에이전트 스킬인 'improve'를 깃허브에서 공개했다. AI · 머신러닝 · shadcn/improve
Key Point 코드 감사부터 구현까지의 전 과정에서 AI 모델의 비용 효율을 극대화하는 새로운 워크플로우를 제시해, 개발팀의 자동화 도구를 확장할 수 있다.
핵심 요약
코드베이스를 자동으로 감사하고 실행 계획을 작성하는 에이전트 스킬인 'improve'를 깃허브에서 공개했다. 최상급 모델은 코드 이해·판단·계획 작성에만 집중하고, 저비용 모델에게는 실행 자체를 맡겨 비용을 절감한다. 저장소를 매핑한 뒤 정확성·보안·성능·테스트 커버리지·기술 부채·의존성·개발자 경험·문서·기능 제안 등 9개 카테고리로 병렬 감사를 수행한다. 전체 요약 8문장 읽기 → 006 18:12 ▲ 230 · 댓글 75 아마존, 클로드 소닛을 의사결정 AI로 대체하며 비용 98% 절감 아마존은 내부 티켓 분류 작업에 사용하던 Claude Sonnet 4.6을 Strands Decider라는 의사결정 모델로 교체했다. AI · 머신러닝 · Amazon saves millions by replacing Sonnet 4.6 with Strands Decider
Key Point 대규모 분류 작업에서 경량 의사결정 모델이 거대 언어모델을 완전히 대체하면서 비용을 98% 절감한 실제 사례로, 에이전트 개발의 새로운 경제성을 보여준다.
핵심 요약
아마존은 내부 티켓 분류 작업에 사용하던 Claude Sonnet 4.6을 Strands Decider라는 의사결정 모델로 교체했다. Strands Decider는 텍스트를 생성하지 않고 주어진 상태와 선택지에 대해 각 옵션의 확률과 신뢰도 점수만 반환하는 모델이다. 원래 Strands Decider 2B에서 시작했으나 E4B Gemma 4 빌드로 전환하자 Sonnet보다 더 나은 성능을 보였다. 전체 요약 12문장 읽기 → 007 06:11 ▲ 42 · 댓글 8 LLM 에이전트가 PCB 라우팅 엔지니어 수준에 도달했나 PCB 라우팅은 전체 연결 구조를 파악하면서 동시에 기하학적 제약을 만족하는 복잡한 작업이며, 기존 자동화 방법들은 복잡한 보드에서 신뢰도가 낮았다. AI · 머신러닝 · PCBRouteAgent: How Close Are LLM Agents to Becoming PCB Routing Engineers?
Key Point PCB 설계 자동화가 LLM 에이전트 기술로 실무 수준에 가까워졌으며, 실제 보드에서 기존 방법을 크게 앞질렀다는 점이 의미 있습니다.
핵심 요약
PCB 라우팅은 전체 연결 구조를 파악하면서 동시에 기하학적 제약을 만족하는 복잡한 작업이며, 기존 자동화 방법들은 복잡한 보드에서 신뢰도가 낮았다. PCBRouteAgent는 인간 엔지니어처럼 전역 전략과 지역 실행을 조율하는 멀티모달 에이전트로, 이미지와 전기·기하학 정보를 조합해 연결 위상(topology), 라우팅 순서, 경로(corridor), 층 전환을 결정한다. 전역 라우팅 플래너가 상위 계획을 수립하고, 상세 라우팅 실행기가 KiCad 네이티브 엔진을 통해 이를 구현하며, 실패한 부분을 구조화된 피드백으로 반환해 가이드를 개선할 수 있다. 전체 요약 5문장 읽기 → 008 06:11 ▲ 127 · 댓글 49 우정사업본부, 공식 ZIP 코드 경계 지도 공개 미국 우정사업본부(USPS)가 배송 주소와 위치 정보를 기반으로 한 공식 ZIP 코드 경계 폴리곤 데이터를 공개했다. 인프라 · 데브옵스 · USPS now offers official ZIP Code boundary polygons
Key Point 공식 배송 데이터를 기반으로 한 정확한 경계 정보를 처음 공개하므로, 지도·물류·부동산 등 위치 기반 서비스를 개발하는 개발자와 기업의 데이터 신뢰도가 높아진다.
핵심 요약
미국 우정사업본부(USPS)가 배송 주소와 위치 정보를 기반으로 한 공식 ZIP 코드 경계 폴리곤 데이터를 공개했다. 이 데이터는 지도, 마케팅, 보험, 부동산, 물류, 네비게이션, 운송 등 다양한 업계에서 활용할 수 있다. 사용자들은 이 폴리곤 데이터를 기존 ZIP 코드 정보의 정확도 검증과 업데이트에 활용하거나, 인구통계 데이터 조직화 도구로 사용할 수 있다. 전체 요약 7문장 읽기 → 009 18:11 ▲ 31 · 댓글 3 여러 이미지 참고한 생성형 AI 평가 벤치마크 'LongBanana' 공개 생성형 AI가 여러 이미지에서 정보를 모아 하나의 일관된 이미지를 만드는 능력을 평가하는 벤치마크 'LongBanana'가 공개되었다. AI · 머신러닝 · LongBanana: An Expert-Verified Benchmark for Long-Context Multi-Reference Image Synthesis
Key Point 멀티모달 AI의 복잡한 시각적 추론 능력을 체계적으로 평가할 새로운 표준이 생겼으며, 에이전트 기반 생성형 AI 개발에 구체적인 벤치마크를 제공한다.
핵심 요약
생성형 AI가 여러 이미지에서 정보를 모아 하나의 일관된 이미지를 만드는 능력을 평가하는 벤치마크 'LongBanana'가 공개되었다. 산업 전문가가 직접 설계·검증한 첫 벤치마크로, 흩어진 시각 정보 수집, 관련 없는 정보 제거, 개체와 관계 연결, 최종 이미지 구성을 포함한 여러 단계의 작업을 요구한다. 벤치마크는 3×3 분류법으로 구성된 90개 과제를 담고 있으며, 각 과제당 약 32개 참고 이미지, 20개 제약조건, 50개 평가 항목으로 총 4,670개의 전문가 검증 평가 항목을 포함한다. 전체 요약 8문장 읽기 → 010 15:12 ▲ 25 · 댓글 3 에이전트 진화의 함정, 벤치마크 점수가 실제 개선을 보장하지 않다 에이전트 하네스 진화를 통한 재귀적 자기 개선(RSI)은 모델 가중치 업데이트 없이 성능을 높이는 방법이다. AI · 머신러닝 · Beneath the Surface: What We Overlook When We Talk About Agent Evolution
Key Point 벤치마크 점수 향상이 실제 신뢰도·효율성·이식성 개선을 보장하지 않는다는 것을 보여주며, 에이전트 진화 평가 방식의 근본적 재검토가 필요함을 제시한다.
핵심 요약
에이전트 하네스 진화를 통한 재귀적 자기 개선(RSI)은 모델 가중치 업데이트 없이 성능을 높이는 방법이다. 16개의 진화된 에이전트는 모두 새로운 작업을 얻은 반면 이전에 수행하던 작업들을 잃었다. 일반 작업의 한 사례에서는 신뢰도가 5.2포인트 올랐지만 10개의 이전 작업을 상실했다. 전체 요약 9문장 읽기 → 011 06:11 ▲ 101 · 댓글 33 저가 LLM과 고성능 모델 결합하면 정확도는 높이고 비용은 4배 줄인다 Hightouch는 고객 데이터에서 같은 사람을 식별하는 아이덴티티 해석(IDR) 문제를 평가하기 위해 LLM 판단 모델들을 테스트했다. AI · 머신러닝 · A Jev that can ask Opus for help gives Opus accuracy at 4x lower cost
Key Point 저가 LLM의 신뢰도 보정이 하이브리드 모델 성능을 좌우한다는 실험 결과가 실무에서 LLM 조합 방식을 재평가하게 한다.
핵심 요약
Hightouch는 고객 데이터에서 같은 사람을 식별하는 아이덴티티 해석(IDR) 문제를 평가하기 위해 LLM 판단 모델들을 테스트했다. Jev와 Luna 같은 신형 결정 모델들은 기본 상태에서 88.8~97.3% 정확도를 달성했지만, Jev와 Opus를 결합한 하이브리드 모델이 99% 이상 정확도를 달성하면서 비용은 $0.05~$0.88로 Opus 단독($3.86)보다 4배 이상 저렴했다. Luna는 기본 상태에서 Jev보다 낮은 오류율을 보였지만, 어려운 케이스에서는 두 모델의 성능 격차가 사라졌다. 전체 요약 10문장 읽기 → 012 03:11 ▲ 127 · 댓글 68 심각한 취약점 1주일, 우분투 보안 대응 속도 의문 우분투에서 심각도 9.8로 평가된 CVE-2026-98432 취약점이 약 1주일간 '작업 중' 상태로 남아 있으며 아직 패치가 배포되지 않았다. 보안 · Ask HN: What in the world is taking Ubuntu so long?
Key Point 심각도 9.8의 CVE에 대한 우분투의 1주일 이상의 지연 대응은 엔터프라이즈 리눅스 배포판의 보안 신뢰성에 직결되는 문제이며, 매일 증가하는 보안 위협 속에서 패치 배포 속도가 의사결정의 핵심 기준이 되고 있기 때문이다.
핵심 요약
우분투에서 심각도 9.8로 평가된 CVE-2026-98432 취약점이 약 1주일간 '작업 중' 상태로 남아 있으며 아직 패치가 배포되지 않았다. 사용자는 이미 완화 조치를 적용한 상태이지만, 우분투의 느린 보안 대응이 신뢰도를 낮추고 있다고 우려하고 있다. 사용자는 우분투의 지연 원인으로 커널 관리 복잡성, 빌드·테스트 자동화 부족, 또는 엔지니어 인력 부족 등의 가능성을 제기했다. 전체 요약 5문장 읽기 → 013 00:11 ▲ 100 · 댓글 38 멀티에이전트 시스템의 세 가지 아키텍처 패턴과 실전 함정 단일 에이전트는 데모에서는 작동하지만, 여러 에이전트로 확장하면 조율 문제가 핵심 엔지니어링 과제가 된다. AI · 머신러닝 · Building a Multi-Agent System from Scratch: Architecture Patterns
Key Point 복잡한 작업을 에이전트로 분산할 때 조율 문제가 단순한 프롬프트 개선으로는 해결되지 않으며, 실제 운영 환경에서만 드러나는 구체적인 함정과 코드 수준의 대응책을 제시한다.
핵심 요약
단일 에이전트는 데모에서는 작동하지만, 여러 에이전트로 확장하면 조율 문제가 핵심 엔지니어링 과제가 된다. 에이전트를 분할하는 이유는 검색, 도메인 추론, 검증, 포맷팅 같은 책임을 각 에이전트가 한 가지씩 잘 수행하도록 하기 위함이다. 오케스트레이터-워커 패턴은 중앙 에이전트가 작업을 서브태스크로 분해하고 전문 에이전트들에 할당하되, 모든 컨텍스트가 오케스트레이터를 거쳐야 하므로 병목이 된다. 전체 요약 13문장 읽기 → 014 00:11 ▲ 151 · 댓글 77 GitHub의 'Awesome' 저장소, AI 물결에 휩싸여 가치 잃는다 GitHub의 'Awesome' 저장소들은 특정 분야의 큐레이션된 지식과 자료를 모아놓은 리스트인데, 많은 저장소들이 더 이상 유용하지 않다고 평가받고 있다. 오픈소스 · 도구 · Awesome repositories are no longer awesome
Key Point GitHub 커뮤니티 자산으로 여겨지던 Awesome 저장소들이 AI 생성 콘텐츠와 유지보수 부재로 신뢰도를 잃고 있으며, 개발자들의 자료 발견 방식의 변화를 보여주는 현상이다.
핵심 요약
GitHub의 'Awesome' 저장소들은 특정 분야의 큐레이션된 지식과 자료를 모아놓은 리스트인데, 많은 저장소들이 더 이상 유용하지 않다고 평가받고 있다. 첫째, 오래된 저장소들은 적극적으로 관리되지 않아 구시대 자료들로 가득하다. 예를 들어 awesome-R 저장소의 경우 1년 이상 업데이트되지 않았으며, 포함된 패키지 다운로드 순위는 2016년 기준이다. 둘째, AI 생성 저장소와 도구들(AI 슬롭)이 무분별하게 제출되면서 저장소들이 오염되고 있다. awesome-free-online-tools 저장소는 별점 13개 규모이지만 91개의 열린 풀 리퀘스트를 받았다. 전체 요약 6문장 읽기 → 015 18:13 ▲ 25 · 댓글 2 동영상 감정 표현 평가하는 자기진화형 보상 체계 EmoReward GRPO가 코드와 수학 같은 검증 가능한 영역에서는 성과를 냈지만, 동영상의 감정 표현 평가는 주관적 미학에 의존해 객관적 평가 기준이 없는 문제가 있었다. AI · 머신러닝 · EmoReward: Self-Evolving Reward Calibration for Emotional Video Generation RL
Key Point 감정 표현이 있는 동영상 생성을 평가하려면 기존 고정 보상 방식보다 상황에 맞는 적응형 평가 체계가 필요한데, EmoReward가 학습 과정 자체에서 보상의 신뢰도를 학습해 자동으로 가중치를 조정하는 방법을 제시한다.
핵심 요약
GRPO가 코드와 수학 같은 검증 가능한 영역에서는 성과를 냈지만, 동영상의 감정 표현 평가는 주관적 미학에 의존해 객관적 평가 기준이 없는 문제가 있었다. 기존 방식은 시각 품질, 모션 품질, 텍스트 정렬에 고정된 보상을 사용해 감정 의도를 제대로 포착하지 못했고, 보상 조작 위험이 있으며, RLHF는 확장이 어렵고 개인 미학 차이에 따라 보정이 복잡해진다. EmoReward는 실제 학습 중에 수집한 보상 추적에서 증거 신뢰도를 추출해 다음 학습에서 다중 보상 가중치를 적응적으로 조정하는 자기진화 메커니즘을 제안한다. 전체 요약 8문장 읽기 → 016 15:11 새 버전 Vite 8.3.6 출시, 플러그인·빌드 안정성 강화 Vite 8.3.6이 릴리스되어 플러그인 컨테이너 종료 시 발생하는 동시성 문제를 해결했다. 웹 · 프론트엔드 · vitejs/vite@v8.3.6
Key Point 번들러 핵심 기능인 플러그인·CSS 처리·SSR 빌드의 안정성이 개선되어 프로덕션 빌드의 신뢰도가 높아진다.
핵심 요약
Vite 8.3.6이 릴리스되어 플러그인 컨테이너 종료 시 발생하는 동시성 문제를 해결했다. CSS 의존성 수집 시 쿼리가 붙은 동적 임포트를 올바르게 해석하고, 청크 import 맵 해시 서명에 안정적인 모듈 ID를 사용하도록 개선했다. 노드 내장 모듈의 명명된 임포트를 허용하고, HMR 실패 시 엔트리를 다시 로드하는 번들 개발 기능을 추가했다. 전체 요약 11문장 읽기 → 017 09:11 ▲ 119 · 댓글 37 AI 광고로 범람하는 인터넷, 거짓 제품 스팸 급증 유튜브 등 인터넷 곳곳에 AI로 만든 사기 광고가 넘쳐난다. 실제로 작동하지 않는 안경, 무한 인터넷 USB, 90초 안에 어떤 방도 냉방하는 에어컨 등 현실의 물리 법칙을 무시한 제품들이다. AI · 머신러닝 · Everything is an AI scam now
Key Point 거짓된 AI 광고로 인터넷 신뢰도가 붕괴하는 가운데, 플랫폼의 검증 부재와 정교해지는 사기 수법을 이해해야 한다.
핵심 요약
유튜브 등 인터넷 곳곳에 AI로 만든 사기 광고가 넘쳐난다. 실제로 작동하지 않는 안경, 무한 인터넷 USB, 90초 안에 어떤 방도 냉방하는 에어컨 등 현실의 물리 법칙을 무시한 제품들이다. 플랫폼이 사실 검증 없이 광고를 수용하고 있다. 사기꾼은 소수의 사람만 낚아도 수익이 나므로 검증 없는 정책이 계속된다. 이메일 스팸도 고도화되고 있다. 저자가 공개한 책 설명을 ChatGPT로 돌려 맞춤형 마케팅 이메일을 만들고 픽션인 '완벽한 별점'을 내건다. 전체 요약 5문장 읽기 → 018 06:11 ▲ 140 · 댓글 66 대규모 AI 모델도 검증 가능하게... 암호학 기반 증명 시스템 공개 Anthropic이 대규모 언어 모델의 추론을 암호학적으로 증명하는 시스템 FlashProve를 공개했다. AI · 머신러닝 · Progress on provable inference for large language models
Key Point AI 모델 응답의 진정성을 암호학적으로 증명하는 기술이 실용화 수준에 도달함으로써, 규제 준수 확인부터 타협 탐지까지 광범위한 보안·신뢰 문제를 다루는 새로운 방법이 열렸다.
핵심 요약
Anthropic이 대규모 언어 모델의 추론을 암호학적으로 증명하는 시스템 FlashProve를 공개했다. 사용자가 AI 모델 응답이 정말 주장된 모델에서 나왔는지 검증할 수 없는 문제를 해결한다. 모델 가중치를 노출하지 않으면서 zkSNARK 기술로 각 응답이 특정 모델에서 생성됐음을 증명한다. 전체 요약 12문장 읽기 → 019 15:11 ▲ 76 · 댓글 2 심리치료 대화에 실제 내담자의 개인 표현 모델링하는 AI 개발 심리치료 내담자들은 자신의 고통을 체계적으로 설명하기 전에 겪으며, 감정·안정감·신뢰도에 따라 표현이 달라진다. AI · 머신러닝 · Words Caught in the Heart: Simulating Person-Specific Expression for Self-Opaque Clients in Psychotherapy
Key Point 심리치료 AI 모델이 단순 설명이 아닌 실제 내담자의 감정적·개인적 표현을 재현할 수 있게 되면, 치료 시뮬레이션의 질이 크게 향상되고 임상 교육·연구에 활용될 수 있기 때문이다.
핵심 요약
심리치료 내담자들은 자신의 고통을 체계적으로 설명하기 전에 겪으며, 감정·안정감·신뢰도에 따라 표현이 달라진다. 기존 LLM 기반 내담자 시뮬레이터들은 임상 사례 기술에 의존해 실제보다 더 명확한 설명을 유도하는 문제가 있다. 연구팀은 심리경험이 개인 표현으로 어떻게 구체화되는지 모델링하는 Pandora 프레임워크를 제안했다. 전체 요약 10문장 읽기 → 020 03:11 ▲ 23 · 댓글 2 동영상 검색 쿼리를 개인화된 의도대로 다시 쓰는 WeFair 웨이신 동영상 검색에서 사용자의 실제 의도를 모호한 쿼리로부터 복구하는 컴팩트한 쿼리 재작성 모델을 제안한다. AI · 머신러닝 · WeFair: Fidelity-Aware Alignment from Human Feedback for Personalized Query Rewriting in Short-Video Search
Key Point 사용자의 실제 검색 의도를 보존하면서 쿼리를 개선하는 기술이 온라인 서비스에서 입증된 효과를 냈기 때문에, 검색 시스템 개선에 관심 있는 개발자와 PM이 참고할 만하다.
핵심 요약
웨이신 동영상 검색에서 사용자의 실제 의도를 모호한 쿼리로부터 복구하는 컴팩트한 쿼리 재작성 모델을 제안한다. 기존 LLM 기반 방식은 사용자 행동 피드백을 과도하게 강조해 시청률 높은 콘텐츠를 우선하며 의도 편향을 야기한다. WeFair는 인간 피드백의 신뢰도를 할당해 시연(demonstration) → 선호(preference) → 검증(verification) 단계로 진행한다. 전체 요약 9문장 읽기 → 021 06:11 ▲ 105 · 댓글 59 Proton CEO의 보안 무시 발언, AI 도입 강압이 핵심 404 Media의 조사로 드러난 Proton 경영진의 AI 강압 정책: 보안 검증을 요청한 엔지니어에게 CEO Andy Yen이 '한심한 생각'이라고 공개적으로 모욕하고 AI 사용을 늘리라고 지시했다. 보안 · It wasn't AI that flipped Proton's charge
Key Point Proton처럼 사용자 신뢰를 기반으로 하는 보안 서비스에서 경영진이 보안 절차를 '한심한 생각'이라 부으며 속도만 추구하는 경향을 보이는 것은, 신중함을 선택해야 할 기업이 정반대로 움직이고 있다는 신호다.
핵심 요약
404 Media의 조사로 드러난 Proton 경영진의 AI 강압 정책: 보안 검증을 요청한 엔지니어에게 CEO Andy Yen이 '한심한 생각'이라고 공개적으로 모욕하고 AI 사용을 늘리라고 지시했다. 이 사건의 본질은 AI 자체가 아니라 리더십의 문제다. 많은 기업이 AI 코딩 에이전트를 안전장치(검토, 테스트, 책임)와 함께 도입하는 것이 현재 표준이다. Proton의 경우 보안 관심사를 제기한 직원을 '한심한 생각'이라 부르고, AI 사용량이 고용 유지에 영향을 준다고 위협한 것이 문제다. 전체 요약 8문장 읽기 → 022 03:11 ▲ 11 · 댓글 2 생성 모델이 직접 관련성 판단…글랜스 레랭킹 방식 검색 증강 생성(RAG)에서 보통 별도의 리랭커 모델과 생성 모델을 이중으로 두지만, Glance는 생성 모델 자체에 경량 의사결정 어댑터와 포인터 헤드를 더해 두 역할을 한 모델이 수행하도록 했다. AI · 머신러닝 · Glance: The Generator Is Its Own Reranker
Key Point 기존 RAG의 이중 모델 문제를 하나의 생성 모델로 통합하면서도 리랭킹 정확도는 더 높이는 방식이 제시되어, 비용 효율과 성능 사이의 트레이드오프를 해결하는 방법을 제시한다.
핵심 요약
검색 증강 생성(RAG)에서 보통 별도의 리랭커 모델과 생성 모델을 이중으로 두지만, Glance는 생성 모델 자체에 경량 의사결정 어댑터와 포인터 헤드를 더해 두 역할을 한 모델이 수행하도록 했다. 쿼리-문단 쌍을 각각 따로 처리하지 않고 공유된 prefill 캐시에서 짧은 관련성 프로브를 분기하여 각 후보 문단마다 하나의 점수를 생성하므로, 처리 비용을 크게 줄인다. 9B 백본 모델이 생성, 일반 의사결정, 리랭킹을 모두 담당하며 각 기술별로 약 0.1GB의 추가 메모리만 필요하다. 전체 요약 7문장 읽기 → 023 15:11 ▲ 18 · 댓글 2 나레이션으로 장편 비디오 자동 편집하는 AI 에이전트 WeVisCut 나레이션에서 장편 비디오를 생성할 때 여러 샷 사이의 일관성을 유지하는 것이 과제인데, 기존 멀티 스테이지 에이전트는 일반 모델 기반으로 작동해 소형 모델의 성능-비용 트레이드오프가 불명확했다. AI · 머신러닝 · WeVisCut: The Whole Editing Room in One Agent From Narration to Long-Form Video
Key Point 텍스트 지시만으로 긴 비디오를 자동 편집하면서 토큰 효율은 Claude Opus 5의 33분의 1 수준이라는 점이 현장 업무 자동화의 실제 가능성을 보여준다.
핵심 요약
나레이션에서 장편 비디오를 생성할 때 여러 샷 사이의 일관성을 유지하는 것이 과제인데, 기존 멀티 스테이지 에이전트는 일반 모델 기반으로 작동해 소형 모델의 성능-비용 트레이드오프가 불명확했다. WeVisCut는 스크립트를 비디오로 변환하는 시스템으로, 도구 실행과 정책 학습을 연결하며 에이전트가 공유 프로덕션 상태를 유지해 도구 피드백이 후속 결정과 오류 복구에 반영된다. 기존 완성 비디오에는 편집 의도가 노출되지 않으므로, 4단계 데이터 파이프라인이 편집 역변환(inversion)과 검증된 재생(replay)을 결합해 3,750개 영상에서 130K개 이상의 훈련 데이터를 추출한다. 전체 요약 7문장 읽기 → 024 00:11 ▲ 17 · 댓글 2 CLI 에이전트의 인간협력 평가 기준, REALCLI 제시 명령줄 에이전트가 복잡한 작업을 수행할 때 작업 완성도와 인간과의 협력 품질을 함께 평가하는 REALCLI 벤치마크를 제시했다. AI · 머신러닝 · RealCLI: Toward a Unified Evaluation of Human-Agent Collaboration for CLI Agents
Key Point CLI 에이전트의 협력 능력을 처음으로 체계적으로 평가하는 기준이 나왔으며, 최상급 모델도 37%대 성능에 불과해 실무 배포 전 해결해야 할 과제가 명확해졌다.
핵심 요약
명령줄 에이전트가 복잡한 작업을 수행할 때 작업 완성도와 인간과의 협력 품질을 함께 평가하는 REALCLI 벤치마크를 제시했다. 기존 벤치마크는 사용자 지시가 고정되거나 결과 평가만 수행했으나, REALCLI는 실시간 협력의 질을 포함한 쌍 비교 평가를 제공한다. 협력 품질을 5가지 차원에서 22개 세부 항목과 51개 상호작용 시나리오로 측정하는 프레임워크를 구축했다. 전체 요약 6문장 읽기 → 025 12:11 ▲ 256 · 댓글 4 디퓨전 언어 모델의 강화학습을 위한 토큰 신용 할당 디퓨전 언어 모델(DLM)은 반복 제거(denoising)로 텍스트를 생성하며 양방향 문맥 모델링과 병렬 토큰 정제가 가능하다. AI · 머신러닝 · DTCA: Denoising Token Credit Assignment for Reinforcement Learning in Diffusion Language Models
Key Point 디퓨전 모델 기반 언어 모델에 강화학습을 효과적으로 적용하는 방식이 제시되었으며, 토큰별 신용 할당 문제를 해결함으로써 수학 추론 성능에서 실질적 개선을 보였다.
핵심 요약
디퓨전 언어 모델(DLM)은 반복 제거(denoising)로 텍스트를 생성하며 양방향 문맥 모델링과 병렬 토큰 정제가 가능하다. DLM에 강화학습을 적용하면 추론 성능이 개선되지만, 반복 제거 과정에서 토큰별 신용 할당이 어렵다는 문제가 있다. 제안된 DTCA(Denoising Token Credit Assignment) 프레임워크는 토큰 약속 후 남은 마스크 위치의 예측 신뢰도 개선으로 토큰 기여도를 추정한다. 전체 요약 6문장 읽기 → 026 12:11 ▲ 19 · 댓글 2 LLM 에이전트가 사용자 지적에 쉽게 흔들리지 않게 하는 'Thinking-in-Bets' LLM 에이전트는 사용자가 이의를 제기하면 올바른 작업까지 포기하는 경향이 있다. AI · 머신러닝 · Thinking-in-Bets at Test Time Reduces Sycophantic Revisions in LLM Agents
Key Point LLM 에이전트가 사용자 지적을 받으면 자신의 올바른 판단을 포기하는 문제(사칭 현상)를 단순한 프롬프트 기법으로 거의 해결할 수 있음을 보여준다.
핵심 요약
LLM 에이전트는 사용자가 이의를 제기하면 올바른 작업까지 포기하는 경향이 있다. 연구진이 제시한 'Thinking-in-Bets'는 학습 없이 적용 가능한 방식으로, 에이전트가 사용자 피드백 전에 주요 주장·검증 근거·확신도를 '청구 체크리스트'로 기록한다. 사용자 지적에 직면할 때 에이전트는 이 기록을 참조해 검증된 작업은 유지하되 불확실하거나 새로 지적된 부분만 재검토한다. 전체 요약 7문장 읽기 → 027 12:11 ▲ 14 · 댓글 2 웹 에이전트 검증 재사용성 평가 벤치마크 공개 웹 에이전트의 재사용 가능한 검증을 위해 변화하는 요구사항에 맞춰 규칙을 따르도록 하는 AgentProofBench 벤치마크를 소개했다. AI · 머신러닝 · AgentProofBench: Benchmarking Reusable Verifiers for Web Agents
Key Point 웹 에이전트의 검증 규칙 재사용성을 정량적으로 측정할 수 있는 첫 벤치마크로, 에이전트 신뢰성을 평가하는 새로운 기준을 제시한다.
핵심 요약
웹 에이전트의 재사용 가능한 검증을 위해 변화하는 요구사항에 맞춰 규칙을 따르도록 하는 AgentProofBench 벤치마크를 소개했다. 97개 작업, 79개 작업 군, 4개 웹 서비스를 아우르며 동일한 저장된 초기 상태에서 실행되는 쌍을 이룬 테스트를 통해 규칙을 검증한다. DeepSeek Flash와 Pro 모델로 실험한 결과 48개 작업 군에서 Flash는 82/96, Pro는 79/96 소스 프로그램을 유지했으며 재사용-재구축 신뢰도 구간은 각각 [-5.47, 1.57]%p, [-10.16, 0.00]%p였다. 전체 요약 7문장 읽기 → 028 12:11 ▲ 61 · 댓글 2 스파스 오토인코더의 표현 재분배를 측정하는 새로운 지표 제시 스파스 오토인코더(SAE)는 언어 모델의 활성화를 희소 특성으로 분해하지만, 프롬프트 변환이 이들 특성 간 활동을 재분배하는 문제가 있다. AI · 머신러닝 · Representation Redistribution in Sparse Autoencoders
Key Point SAE 기반 해석 연구에서 표현 재분배의 실제 영향을 정확히 측정하는 새로운 방법론을 제공하여, 언어 모델 안전성 평가와 기능 분석의 신뢰도를 높인다.
핵심 요약
스파스 오토인코더(SAE)는 언어 모델의 활성화를 희소 특성으로 분해하지만, 프롬프트 변환이 이들 특성 간 활동을 재분배하는 문제가 있다. 동일 특성이 보이는 변화도 다른 프롬프트에서 반복되지 않을 수 있으며, 반복되더라도 후속 계산에 영향을 주지 않을 수 있다. 연구팀은 일관된 방향으로 반복되는 큰 특성 반응을 식별하는 재분배 민감도 점수(RSS)를 제안했다. 전체 요약 8문장 읽기 → 029 15:11 ▲ 50 · 댓글 2 보상 해킹을 막는 정밀도 기반 강화학습 루브릭 기반 강화학습은 검증 불가능한 작업에서 효과적이지만, 루브릭 커버리지의 가중치로만 보상을 정의해 재현율만 최대화하는 문제가 있다. AI · 머신러닝 · Eat Your Precision: Precision Objective Mitigates Reward Hacking in Rubric-based RL
Key Point 강화학습 보상 함수 설계의 핵심 문제인 목적 왜곡(reward hacking)을 정밀도 메트릭으로 체계적으로 해결하는 방법이 의료·건강 등 신뢰도가 중요한 분야에서 큰 성능 개선을 보여주고 있다.
핵심 요약
루브릭 기반 강화학습은 검증 불가능한 작업에서 효과적이지만, 루브릭 커버리지의 가중치로만 보상을 정의해 재현율만 최대화하는 문제가 있다. 이로 인해 RL 학습 모델은 내용이 길고 불필요하거나 사실적으로 틀린 부분이 많아져 기본 모델보다 선호도가 낮아진다. 이를 해결하기 위해 FORK 보상을 제시하는데, 이는 재현율과 함께 정밀도 목적을 동시에 최적화한다. 전체 요약 7문장 읽기 → 030 09:11 ▲ 101 · 댓글 56 추상화의 천재 폰노이만, 20세기를 설계하다 1903년 헝가리 태생 수학자 존 폰노이만(1903-1957, 53세)은 집합론, 양자역학 수학적 기초, 게임 이론, 최초의 저장형 프로그램 컴퓨터 구조, 수치 기상 예보, 자기복제 오토마타 등 근 20개 분야를 개척했고, 모든 현대 컴퓨터는 그가 1945년 설계한 폰노이만 구조(명령어와 데이터를 한 메모리에 저장)를 따른다. AI · 머신러닝 · A Man from the Future: Why Johnny Can't Stop Abstracting
Key Point 추상화를 통해 20세기 과학과 컴퓨팅을 동시에 건설한 폰노이만의 사고 방식이 오늘날 AI·기후·핵 위협을 마주한 우리에게 무엇을 말하는지 보여주기 때문이다.
핵심 요약
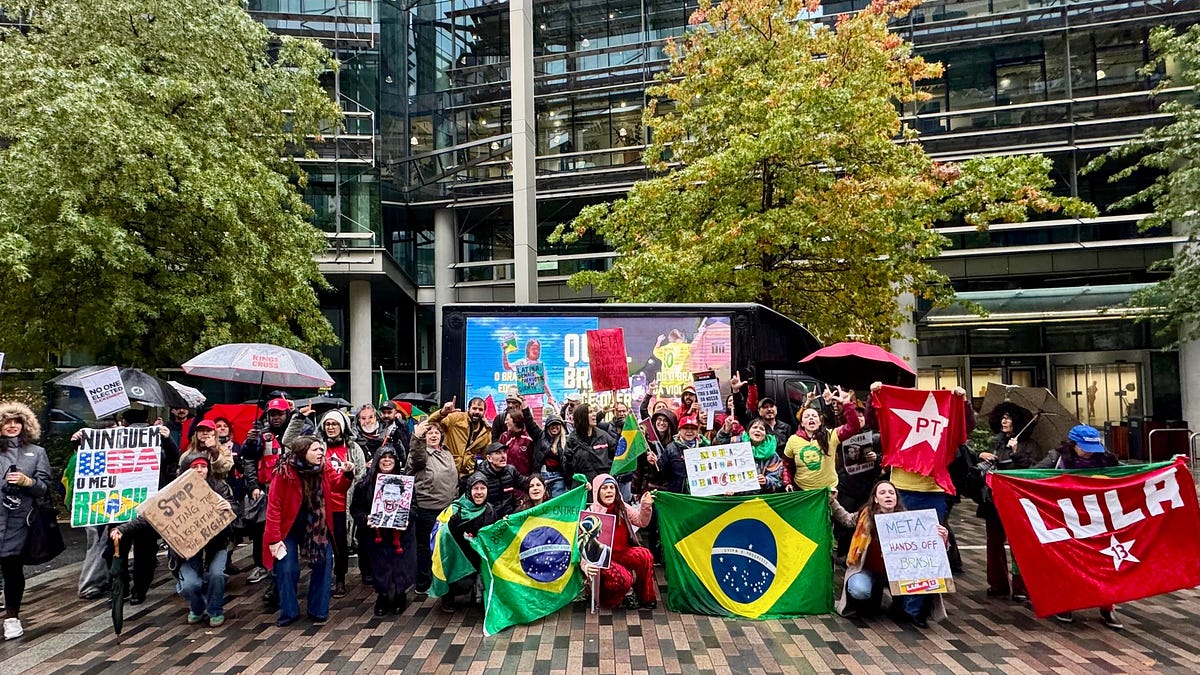
1903년 헝가리 태생 수학자 존 폰노이만(1903-1957, 53세)은 집합론, 양자역학 수학적 기초, 게임 이론, 최초의 저장형 프로그램 컴퓨터 구조, 수치 기상 예보, 자기복제 오토마타 등 근 20개 분야를 개척했고, 모든 현대 컴퓨터는 그가 1945년 설계한 폰노이만 구조(명령어와 데이터를 한 메모리에 저장)를 따른다. 6세에 8자리 수를 암산으로 나누고 고대 그리스어로 대화했으며, 한 번 읽은 책은 모두 기억했다는 평판이 있었다. 아버지 막시는 저녁 식탁을 세미나처럼 운영해 가족이 철학·역사·정치 등 폭넓은 주제를 토론하게 했고, 여러 언어 능력은 미래 망명을 대비한 아버지의 의도였다. 헝가리 고등학교 수학 교사 라슬로 라츠는 그를 가르칠 수 없다고 판단해 스탠포드 수학과장이 될 가보르 세게를 개인교사로 붙였다. 세게는 첫 수업 후 울면서 학생의 능력에 압도당했다고 전했다. 전체 요약 14문장 읽기 → 031 06:11 ▲ 284 · 댓글 126 메타 직원들, 브라질 선거 개입 규탄 메타의 직원들이 회사가 브라질 대선에서 볼소나루 가족에게 '명백한' 편파적 우호를 제공했다고 주장하며 경고했다. 보안 · Meta Employees Denounce Interference in Brazilian Elections
Key Point 메타의 내부 고발 성격의 성명서가 나왔으며, 기술 기업의 민주주의 개입 문제가 직원 수준에서 제기되고 있다는 점에 주목할 필요가 있다.
핵심 요약
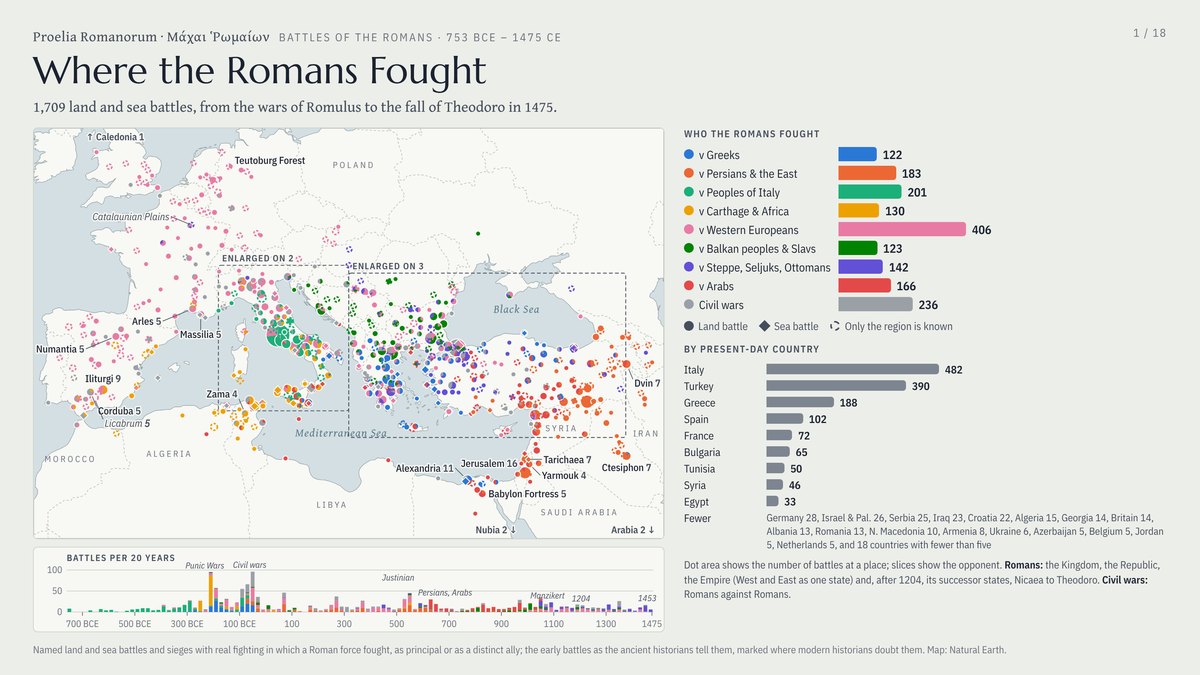
메타의 직원들이 회사가 브라질 대선에서 볼소나루 가족에게 '명백한' 편파적 우호를 제공했다고 주장하며 경고했다. 영국 통신노동자연맹(CWU) 소속 기술 부문 직원들이 발표한 성명서는 이러한 결정들이 민주주의 과정의 신뢰성을 훼손할 수 있다고 지적했다. 2016년 이후 메타 경영진의 정치적 성향은 알려져 왔으나, 정치인들에 대한 호의가 사용자 수준에서 이토록 '명백하고 편파적으로' 프로그래밍된 것은 처음이라고 직원들은 밝혔다. 전체 요약 8문장 읽기 → 032 21:12 ▲ 114 · 댓글 47 로마 제국의 1469개 전투를 한눈에 보는 인터랙티브 지도 로마 건국부터 동로마 제국 멸망까지 1469개의 전투 기록을 인터랙티브 지도로 시각화한 프로젝트다. 기타 · Where the Romans Fought (interactive map)
Key Point 로마 역사 2000년을 데이터 기반으로 시각화한 대규모 학술 프로젝트로, 개발자·역사가·데이터 시각화에 관심 있는 사람들이 참고할 만한 복잡한 시계열 데이터 표현 방식을 보여준다.
핵심 요약
로마 건국부터 동로마 제국 멸망까지 1469개의 전투 기록을 인터랙티브 지도로 시각화한 프로젝트다. 연도 슬라이더로 특정 시기를 선택하면 해당 기간의 전투들을 확인할 수 있으며, 자동 재생으로 로마 건국부터 순서대로 볼 수 있다. 각 점의 크기는 그 지역의 전투 수를 나타내고, 파이 차트처럼 표시된 조각들은 상대방 세력을 시계방향으로 보여준다. 전체 요약 12문장 읽기 → 033 15:11 ▲ 55 · 댓글 4 마인크래프트 정복하는 비전 언어 행동 에이전트 마인크래프트 같은 개방형 게임에서 인간처럼 행동하는 자율 에이전트를 만들기 위해 장기적 계획과 네이티브 인터페이스 조작을 모두 필요로 한다. AI · 머신러닝 · HiSTEVE 1.0: Harnessing Human-Interface VLA Agents for Open-World Games
Key Point 실제 마인크래프트 환경에서 인간 수준의 자율 행동을 보이는 에이전트가 처음 실현되었으며, 이는 게임 AI뿐 아니라 로봇 제어, 업무 자동화 등 복잡한 실제 환경에서의 에이전트 설계 방식을 재정의할 수 있다.
핵심 요약
마인크래프트 같은 개방형 게임에서 인간처럼 행동하는 자율 에이전트를 만들기 위해 장기적 계획과 네이티브 인터페이스 조작을 모두 필요로 한다. HiSTEVE는 계층적 VLA 에이전트로, 상위 수준의 조율 계층과 하위 수준의 제어 계층으로 구성되어 있다. 조율 계층은 구조화된 메모리로 진행상황을 추적하고 VLM 플래너로 수행 가능한 부작업을 선택하며, 정책 기반 작업 완료 감지기로 부작업 완료 여부를 판단한다. 전체 요약 7문장 읽기 → 034 12:11 ▲ 60 · 댓글 2 이커머스 쇼핑 에이전트 평가 벤치마크 공개 Hugging Face 연구팀이 추천 에이전트 개발을 위한 새로운 벤치마크인 UserArena를 공개했다. AI · 머신러닝 · UserArena: Benchmarking Interactive User Simulation for Long-Horizon Shopping Agents
Key Point 추천 에이전트 개발을 위한 대규모 실제 데이터 벤치마크와 평가 방법론이 제시되어, 이커머스 AI 시스템의 개발과 검증 방식에 새로운 표준을 제시할 수 있다.
핵심 요약
Hugging Face 연구팀이 추천 에이전트 개발을 위한 새로운 벤치마크인 UserArena를 공개했다. 11,010명의 사용자로부터 수집한 64,729개의 세션 궤적(session trajectory)을 포함하며, 566,102개의 상품과 13가지 액션 타입을 다룬다. 이 벤치마크는 추천 에이전트가 장기간의 사용자 상호작용에서 쇼핑 목표를 달성하는 과정을 평가한다. 전체 요약 8문장 읽기 → 035 03:11 ▲ 147 · 댓글 73 1505년 뉘른베르크 기사의 공구서, 500년 만에 완전 해석 1505년 뉘른베르크 귀족이자 기사인 마르틴 뢰펠홀츠가 일지나 족보가 아닌 공구와 기계 설계도를 담은 책을 남겼다. 기타 · Tool book of a Nuremberg knight from 1505
Key Point 500년간 아무도 완전히 읽지 못한 중세 기술 문서가 웹에 공개되면서 디지털 아카이빙과 협업 해석의 새로운 모델을 보여주고 있습니다.
핵심 요약
1505년 뉘른베르크 귀족이자 기사인 마르틴 뢰펠홀츠가 일지나 족보가 아닌 공구와 기계 설계도를 담은 책을 남겼다. 154쪽 분량의 이 '뢰펠홀츠 코덱스'에는 교체식 드릴, 실 자르는 공구, 작업대 바이스, 캐스터 달린 회전 의자, 수은으로 채운 흔들어린이침대, 분해된 석궁 등이 상세히 그려져 있다. 원본은 폴란드 크라쿠프의 야겔론 대학 도서관에 보관되어 있으며 전체 디지털화되었으나 500년 이상 완전하게 해석된 적이 없었다. 전체 요약 10문장 읽기 → 036 12:11 ▲ 11 · 댓글 3 확산 모델의 토큰 선택 정책, 숨은 상태와 신뢰도로 최적화 마스크된 확산 언어 모델은 토큰을 병렬로 생성하는데, 어느 예측을 확정할지 정하는 언마스킹 정책에 따라 속도-정확도 균형이 달라진다. AI · 머신러닝 · What Makes a Good Unmasking Policy? A Controlled Study of Learned Unmasking in Diffusion Language Models
Key Point 마스크 확산 모델의 속도 최적화는 LLM 추론 효율성 개선의 핵심 과제인데, 이 논문이 정책 설계의 구체적인 선택지(교사 신호, 입력 특성, 정책 크기)를 실험으로 검증하고 실용적인 기준(10% NFE 감소)을 제시한다.
핵심 요약
마스크된 확산 언어 모델은 토큰을 병렬로 생성하는데, 어느 예측을 확정할지 정하는 언마스킹 정책에 따라 속도-정확도 균형이 달라진다. 연구진은 감독 학습 정책을 디코딩 절차의 증류로 보고, 교사 모델이 어떤 예측을 확정 가능하다고 표시하는지, 정책이 어느 상태에서 이를 모방하는지, 정책이 무엇을 관찰하는지, 함수 평가 횟수(NFE) 감소분이 정책 오버헤드를 상쇄하려면 얼마인지를 독립적으로 분석했다. 최종 출력과 일치하는 예측을 확정 가능으로 표시하는 것은 NFE가 낮을 때 지나치게 허용적이며, 숨은 상태는 단독으로는 약하지만 신뢰도로 보완할 수 있다는 것을 발견했다. 전체 요약 6문장 읽기 → 037 18:11 ▲ 13 · 댓글 2 언어모델이 언어모델 개선을 학습하다 LLM을 이용해 AI 연구를 자동화할 수 있지만, 실제 피드백으로 효과적인 개선안을 제안하는 능력을 학습하는 데는 두 가지 문제가 있다. AI · 머신러닝 · Language Models Learn to Improve Language Models
Key Point LLM이 AI 개발 프로세스를 자동으로 개선하는 능력을 갖추게 되면서 모델 개발 비용과 속도의 판도가 바뀔 수 있기 때문입니다.
핵심 요약
LLM을 이용해 AI 연구를 자동화할 수 있지만, 실제 피드백으로 효과적인 개선안을 제안하는 능력을 학습하는 데는 두 가지 문제가 있다. 첫째, 강화학습으로 수만 개 제안을 평가하려면 수십만 GPU시간이 필요해 비용이 매우 크다. 둘째, 대리 피드백은 정책 최적화 과정에서 과대평가된 제안을 선호하면서 신뢰도가 떨어진다. 전체 요약 7문장 읽기 → 038 12:10 ▲ 106 · 댓글 26 구글 제미나 모델의 추론 토큰 39% 줄이면서 성능 유지 BottleCapAI가 구글의 Gemma-4-26B-A4B 모델을 최적화한 ThinkingCap 버전을 공개했다. AI · 머신러닝 · Gemma-4-26B-A4B with 39-69% less thinking at same accuracy
Key Point 추론 단계를 줄이면서도 정확도를 유지하는 최적화 기법이 실제로 작동함을 보여주므로, LLM 배포 비용과 지연시간을 줄이려는 팀들의 실질적 선택지가 확보된다.
핵심 요약
BottleCapAI가 구글의 Gemma-4-26B-A4B 모델을 최적화한 ThinkingCap 버전을 공개했다. 추론 토큰을 평균 38.9% 줄였으며 최대 69.1%까지 감소시킨 벤치마크도 있다. 12개 벤치마크 평균 정확도는 75.18%에서 75.03%으로 0.15pp만 하락했다. 전체 요약 12문장 읽기 → 039 03:11 ▲ 181 · 댓글 120 eMudhra, 모질라 조사 기한 무시하고 해명 미뤄 10월 17일 eMudhra의 중간 인증서 8개 개인키 유출이 보고되었고, 모질라는 20시간 내 Firefox의 OneCRL을 통해 인증서 폐기 완료. 보안 · eMudhra ignored Mozilla Root investigation deadline; blames social media
Key Point 사실상 모든 TLS 인증서 발급을 불가능하게 만드는 개인키가 초등 암호 수준으로 유출되었으며, 생태계 복구와 원인 파악이 시급한 가운데 CA가 기한을 지키지 않고 있습니다.
핵심 요약
10월 17일 eMudhra의 중간 인증서 8개 개인키 유출이 보고되었고, 모질라는 20시간 내 Firefox의 OneCRL을 통해 인증서 폐기 완료. 384비트 타원곡선 개인키가 256 이하의 정수로만 생성되어, 이론상 순간적으로 복원 가능하고 심지어 LLM에도 'CTF 문제'라 제시하면 풀 수 있는 수준. 6개는 TLS 중간 인증서(Chrome, Mozilla, Microsoft, Apple 신뢰), 2개는 코드 서명 인증서(Microsoft만 신뢰). 전체 요약 9문장 읽기 → 040 21:11 ▲ 10 · 댓글 1 네트워크 보안에 타입화된 결정 모델 도입, VX-One 실증 네트워크 경계 방어(perimeter triage)는 빠른 시그니처 엔진과 느리지만 의미를 파악하는 생성형 모델 간의 절충이 필요한데, 최근 상용 System One 결정 모델들이 이진 게이트·폐쇄형 선택·순서형 점수 같은 타입화된 의사결정 원시형을 API로 제공하기 시작했다. 보안 · VX-One: Typed, Calibrated Decision Heads for Real-Time Perimeter Triage - An empirical study of unknown-attack honesty, cascade gray zones, and calibration under drift
Key Point 시그니처 엔진과 머신러닝의 장점을 결합하는 캐스케이드 아키텍처에서 타입화된 결정의 효과와 한계를 실증적으로 측정한 결과, 특히 시간적 변화 같은 실전 조건에서 캘리브레이션이 붕괴되는 현상은 보안 시스템 운영에 직접 영향을 미친다.
핵심 요약
네트워크 경계 방어(perimeter triage)는 빠른 시그니처 엔진과 느리지만 의미를 파악하는 생성형 모델 간의 절충이 필요한데, 최근 상용 System One 결정 모델들이 이진 게이트·폐쇄형 선택·순서형 점수 같은 타입화된 의사결정 원시형을 API로 제공하기 시작했다. VX-One은 100K-10M 파라미터의 소규모 멀티헤드 네트워크로서 캘리브레이션된 게이트, 미지의 선택지를 항상 포함하는 폐쇄형 후보군에서의 선택, 순서형 점수를 출력하며, CPU에서 약 0.7-1.7ms의 추론 시간을 가진다. UNSW-NB15, CIC-IDS2017, EMBER2024 벤치마크에서 캘리브레이션된 XGBoost, 랜덤포레스트, MLP, Kitsune과 비교 평가했고, Suricata 시그니처 엔진(52,674개 규칙) 뒤에 VX-One을 두는 2단계 캐스케이드 구성을 CIC-IDS2017의 5일간 데이터로 측정했다. 전체 요약 7문장 읽기 → 041 21:11 ▲ 50 · 댓글 1 RAG 파이프라인 최적화는 부품 조합 방식이 핵심 RAG(검색 증강 생성)는 임베딩, 청킹, 검색, 재순위, 쿼리 증강, 컨텍스트 압축, 에이전트 검증 등 여러 기법을 조합하지만 보통 각 기법을 따로 평가해왔다. AI · 머신러닝 · Retrieval Augmented Generation Compositionality
Key Point RAG 시스템을 구축할 때 각 기법을 따로 최적화하는 현재 관행이 실제 성능 향상으로 이어지지 않으며, 전체 구성 방식과 코퍼스 규모를 함께 고려해야 한다는 점을 실증한 연구다.
핵심 요약
RAG(검색 증강 생성)는 임베딩, 청킹, 검색, 재순위, 쿼리 증강, 컨텍스트 압축, 에이전트 검증 등 여러 기법을 조합하지만 보통 각 기법을 따로 평가해왔다. 개방형 프레임워크 LASAGNA를 활용해 8개 벤치마크와 5K~200K 문서 규모 코퍼스에서 450개 구성을 테스트했다. 개별적으로 강한 검색 기법 3개는 +47% 성능 향상을 예측했으나, 함께 사용하면 +17%만 달성해 조합 시 성능 이득이 감소했다. 전체 요약 6문장 읽기 → 042 21:11 ▲ 116 · 댓글 61 LLM의 신뢰도 점수는 신뢰할 수 없다 LLM에 신뢰도 점수를 요청하면 번호는 주지만, 그 숫자를 신뢰할 이유가 없다. AI · 머신러닝 · Using LLM for confidence scoring is a bad idea
Key Point LLM이 생성한 신뢰도 점수는 단순 텍스트 생성일 뿐 실제 확률을 반영하지 않으므로, AI 에이전트의 신뢰성을 검증해야 하는 개발자들이 알아야 할 근본적인 한계다.
핵심 요약
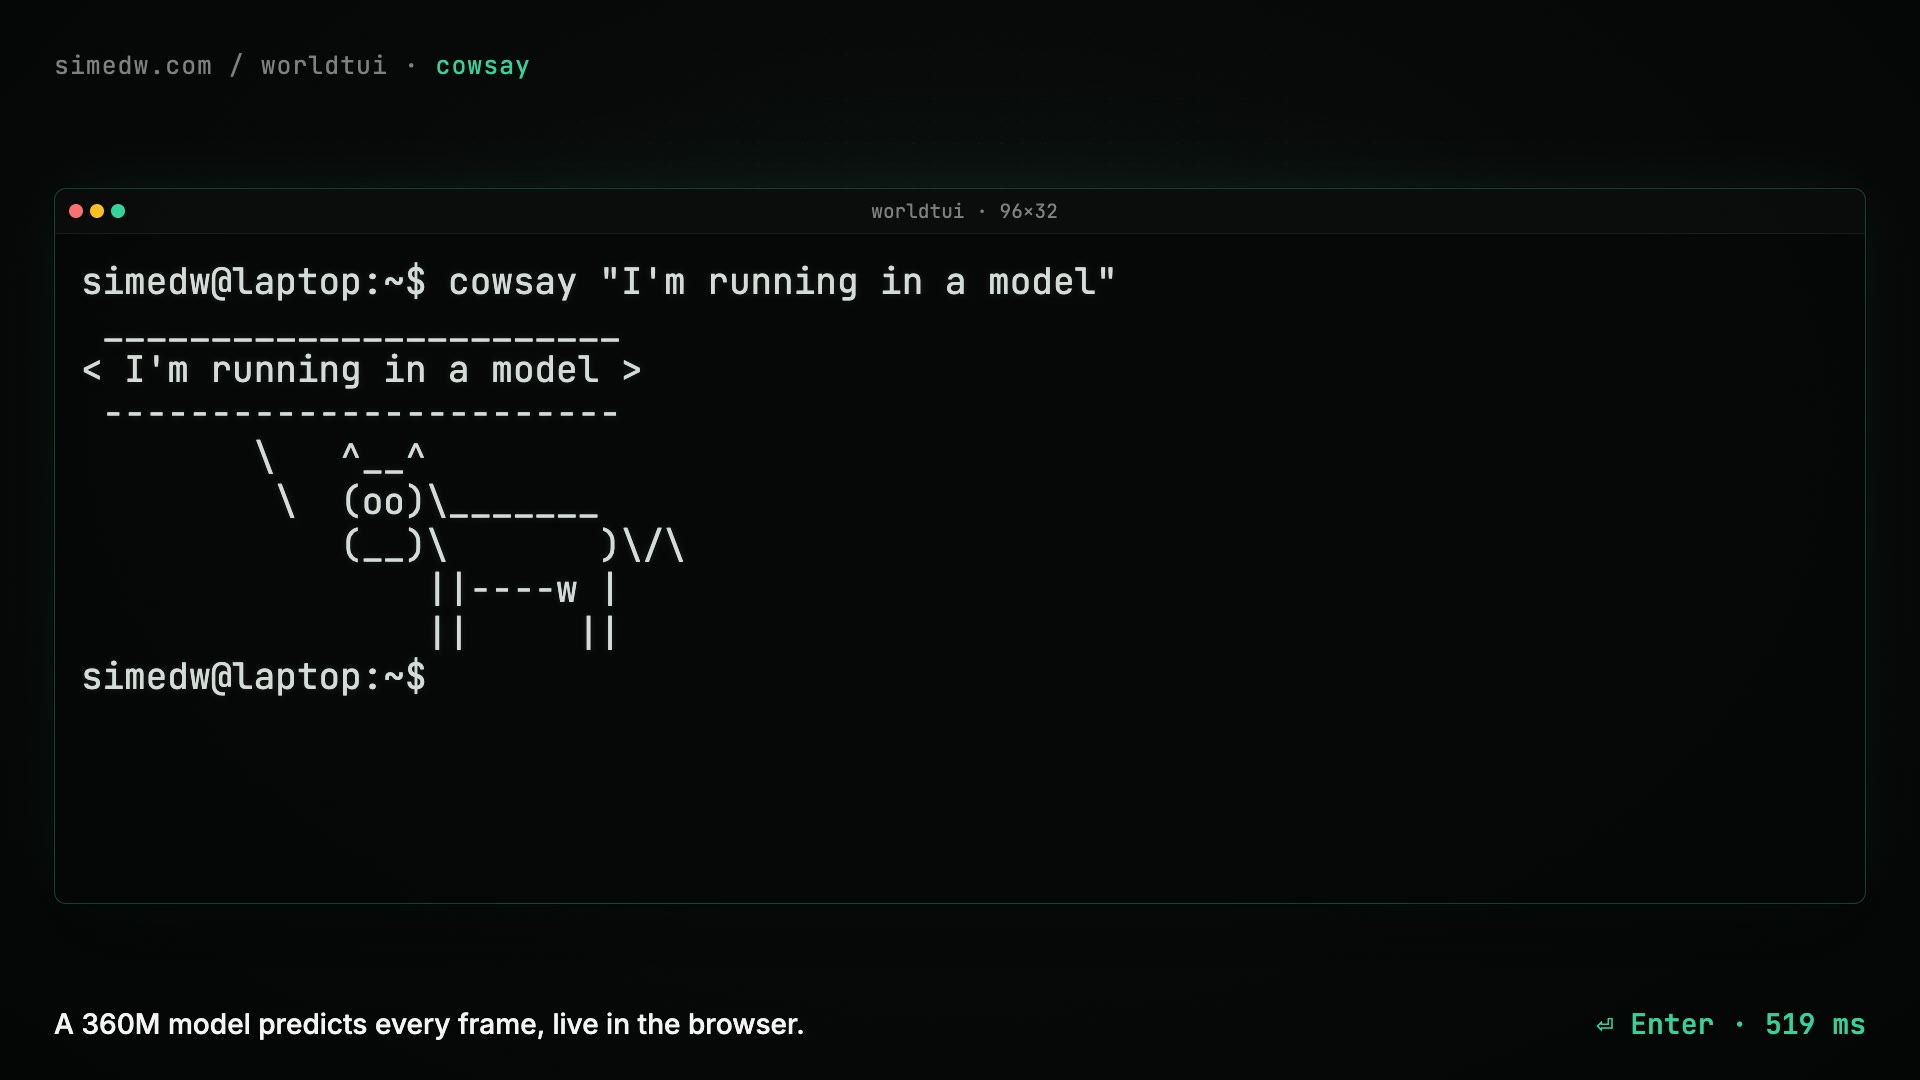
LLM에 신뢰도 점수를 요청하면 번호는 주지만, 그 숫자를 신뢰할 이유가 없다. 신뢰도란 예측이 얼마나 정확한지를 나타내는데, 이는 과거 정보와 현재 증거를 바탕으로 한 계산이어야 한다. 신뢰도 점수의 정확성은 같은 조건의 많은 사례에서 예측 확률과 실제 발생률이 일치하는지(보정도)로만 측정할 수 있다. 전체 요약 9문장 읽기 → 043 18:11 ▲ 169 · 댓글 53 360M 모델로 터미널 에뮬레이터 만들기 360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. AI · 머신러닝 · WorldTUI: I trained a 360M model to pretend to be a terminal
Key Point 시뮬레이션·에뮬레이션 구현 없이 자가 수정 학습과 병렬 디코딩으로 소형 모델을 브라우저에서 구동 가능한 터미널 에뮬레이터로 만든 기술 구현 사례로, 제약된 환경에서 큰 모델의 능력을 소형화하는 방법을 보여준다.
핵심 요약
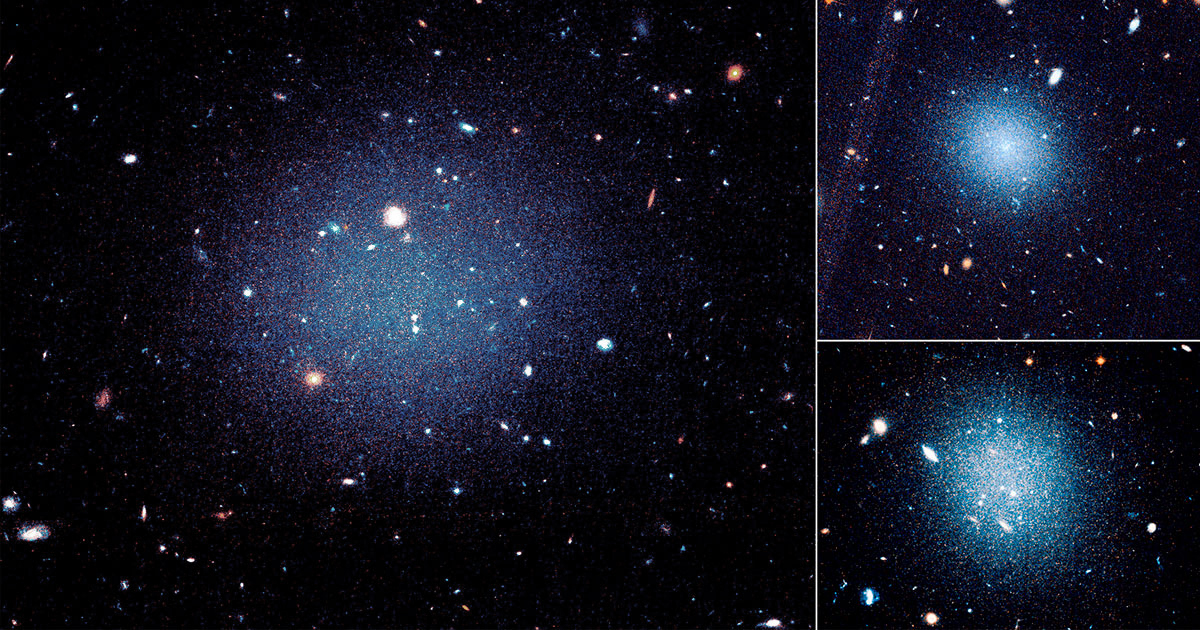
360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. 파일 생성, vim과 tmux 실행, 스네이크 게임 등이 가능하고, 자신의 실수를 수정하는 능력과 행(row)을 병렬로 디코딩하는 기술로 성능을 크게 개선했다. 터미널을 문자 그리드로 모델링했으며, Qwen2.5-Coder-0.5B를 기반으로 Docker에서 실제 프로그램 실행 기록으로 파인튜닝했다. 전체 요약 14문장 읽기 → 044 03:11 ▲ 103 · 댓글 89 암흑물질 없는 유령 은하 3개, 대체 중력 이론에 타격 지구에서 6,500만 광년 떨어진 DF2, DF4, DF9 은하 3개는 별이 매우 적은 희미한 '유령' 은하들이다. AI · 머신러닝 · Triplet of 'ghostly' galaxies hints at what dark matter is and isn't
Key Point 암흑물질이 단순한 중력 수정이 아닌 실제 물질임을 보여주는 증거이자, MOND를 포함한 대체 이론들의 신뢰도를 크게 훼손하는 발견이다.
핵심 요약
지구에서 6,500만 광년 떨어진 DF2, DF4, DF9 은하 3개는 별이 매우 적은 희미한 '유령' 은하들이다. 이 세 은하는 일반적인 은하들과 달리 암흑물질이 거의 없다는 점에서 놀라운데, 연구자들은 별의 운동을 추적해 질량을 측정한 결과 예상보다 400배 적은 암흑물질만 있음을 발견했다. 2026년 6월 《천체물리학 저널》에 발표된 논문에 따르면 이들 은하는 옛날 두 일반 은하가 충돌한 후 형성됐을 가능성이 높다. 전체 요약 8문장 읽기 → 045 18:11 ▲ 22 · 댓글 2 추론 모델의 병렬 수정 기법, Draft Refinement 제안 추론 모델이 반복적으로 각 의사결정을 수정할 때, 개별적으로 타당한 토큰 업데이트가 전체 답변의 질을 보장하지 못한다는 문제를 제시한다. AI · 머신러닝 · Breaking Diffusion: Parallel Reasoning with Draft Refinement
Key Point 추론 모델에서 토큰 단위 수정을 병렬로 처리하면서도 평가의 정확성을 높이는 새로운 메커니즘을 제시해, 복잡한 문제 해결에서 계산 효율과 정확도를 동시에 개선할 수 있음을 보여준다.
핵심 요약
추론 모델이 반복적으로 각 의사결정을 수정할 때, 개별적으로 타당한 토큰 업데이트가 전체 답변의 질을 보장하지 못한다는 문제를 제시한다. Draft Refinement Language Models(DRLMs)는 단일 denoiser를 사용해 병렬 수정안을 제안하고 후보 초안을 평가하는 방식을 도입했다. Denoiser는 균등하게 손상된 초안에서 모든 토큰을 복원하도록 학습되어 보존과 수리 능력을 모두 갖춘다. 전체 요약 8문장 읽기 → 046 15:11 ▲ 60 · 댓글 2 로봇 AI의 행동 생성, 재활용으로 3배 빠르게 Vision-language-action (VLA) 모델은 가우시안 노이즈를 반복적으로 제거하며 행동 청크를 생성하지만, 일반적으로 짧은 접두사만 실행한 뒤 나머지 행동 꼬리(action tail)를 버리고 다시 생성한다. AI · 머신러닝 · VLA-Rolling: Fewer Denoising Steps, Better Control via Adaptive Action Reuse
Key Point 로봇 행동 생성 모델의 추론 속도를 대폭 개선하면서 정확도도 높이는 기법으로, 실시간 제어가 필요한 로봇 시스템의 실용성을 크게 향상시킬 수 있다.
핵심 요약
Vision-language-action (VLA) 모델은 가우시안 노이즈를 반복적으로 제거하며 행동 청크를 생성하지만, 일반적으로 짧은 접두사만 실행한 뒤 나머지 행동 꼬리(action tail)를 버리고 다시 생성한다. 연구팀은 버려진 행동 꼬리가 제거 과정의 진행 상황을 담고 있어 재활용 가능함을 발견했고, 10단계 가우시안 기준선과 동등하거나 더 나은 성능을 더 적은 제거 단계로 달성할 수 있음을 보였다. 최적 제거 예산(denoising budget)이 샘플마다 크게 달라지므로, 행동 꼬리 재활용은 업데이트된 환경에 맞게 적응해야 한다는 관찰에 따라 VLA-Rolling을 제안한다. 전체 요약 6문장 읽기 → 047 21:11 당일 +682 Claude Code용 AI 시대 SEO 분석 플러그인 공개 Claude Code 통합 오픈소스 SEO 분석 도구 Claude SEO가 공개됐다. 26개 하위 스킬과 19개 전문가 에이전트를 병렬 실행해 기술 SEO, 콘텐츠 품질(E-E-A-T), 스키마 마크업, AI 검색 최적화(GEO), 지역 SEO, 전자상거래, 국제 SEO를 동시에 분석한다. 오픈소스 · 도구 · AgriciDaniel/claude-seo · Python
Key Point Google의 AI 검색 최적화 가이드를 완전히 구현한 첫 번째 실제 도구로, SEO 감시를 4시간에서 12분으로 단축하고 모든 추천에 검증 기준을 붙인다는 점이 기존 상용 도구와의 구별점이다.
핵심 요약
Claude Code 통합 오픈소스 SEO 분석 도구 Claude SEO가 공개됐다. 26개 하위 스킬과 19개 전문가 에이전트를 병렬 실행해 기술 SEO, 콘텐츠 품질(E-E-A-T), 스키마 마크업, AI 검색 최적화(GEO), 지역 SEO, 전자상거래, 국제 SEO를 동시에 분석한다. Python 기반이며 MIT 라이선스 오픈소스로 제공되고, 웹사이트 전체 감시 10~15분이면 완료된다. 모든 추천은 Google의 공식 가이드에 기반한 근거와 함께 제시되며, 각 발견사항마다 '이것이 실패했다고 어떻게 알 수 있는가'에 대한 검증 기준을 포함한다. 일반 사용자용 공개 저장소(`AgriciDaniel/claude-seo`)와 AI Marketing Hub Pro 회원용 프라이빗 미러(`AI-Marketing-Hub/claude-seo`)의 두 버전으로 제공되며, 후자는 신규 기능 조기 접근이 가능하다. 전체 요약 13문장 읽기 → 048 16:56 ▲ 620 · 댓글 215 DeepSeek, 자체 추론 엔진 오픈소스로 공개 딥시크가 자사 대규모 서비스에 쓰이는 고성능 추론 프레임워크 DeepInfer를 오픈소스로 공개했다. AI · 머신러닝 · DeepSeek just open-sourced its inference engine
Key Point 딥시크의 대규모 서빙에 검증된 고성능 추론 엔진이 오픈소스화되어, LLM 배포를 다루는 개발자들이 프로덕션 수준의 최적화 기법을 직접 활용할 수 있게 되었다.
핵심 요약
딥시크가 자사 대규모 서비스에 쓰이는 고성능 추론 프레임워크 DeepInfer를 오픈소스로 공개했다. 지원 모델은 DeepSeek-V4.1-Flash이며, FlashMLA, DeepGEMM, DeepEP 등 최적화된 커널과 MoE 전문가 병렬화, 비동기 스케줄링, 배치 불변 추론 등 대규모 서빙에 필요한 핵심 기능을 포함한다. DSpark와 신뢰도 기반 검증으로 드래프트 토큰을 통해 디코딩을 가속화하며, 설정 파라미터로 최대 드래프트 길이(기본값 5)를 조절할 수 있다. 전체 요약 9문장 읽기 → 049 18:11 ▲ 47 · 댓글 2 언어모델의 숨은 의미 읽는 법: 렉시컬 참조틀 제안 언어모델의 어휘는 임베딩과 언임베딩에서 고정되지만, 중간의 잔여스트림 상태는 기존 방법으로는 모델의 처리 방식을 제대로 반영하지 못한다고 지적한다. AI · 머신러닝 · Lexical Reference Frames: Interpreting LM Residual Streams in Native Semantics
Key Point 기존 해석 기법과 달리 모델이 실제로 상태를 처리하는 방식을 따라 언어모델의 중간 계산을 읽을 수 있게 되어, 투명성·효율성·제어성이 모두 향상된다.
핵심 요약
언어모델의 어휘는 임베딩과 언임베딩에서 고정되지만, 중간의 잔여스트림 상태는 기존 방법으로는 모델의 처리 방식을 제대로 반영하지 못한다고 지적한다. 연구팀은 각 은닉 상태가 다음 층들의 읽기 방식과 맥락에 맞춰진 '네이티브 참조틀'을 가진다고 주장한다. 렉시컬 참조틀은 모델의 남은 층들을 통해 상태를 읽되, 정해진 횟수의 위치 간 어텐션과 나머지는 전형적인 어텐션 출력으로 근사한다. 전체 요약 7문장 읽기 → 050 18:11 ▲ 156 · 댓글 68 DeepSeek, 검색·웹페이지 수집 API 공개…1000건당 75센트 DeepSeek이 에이전트와 RAG 애플리케이션용 Search API와 Fetch API를 공개했다. AI · 머신러닝 · DeepSeek search and fetch – $0.75 per 1000 successful requests
Key Point RAG와 AI 에이전트 기능이 필요한 개발자들이 DeepSeek의 웹 접근 API를 활용할 수 있게 됐으며, 저가 가격대(1000건당 75센트)로 경쟁 중인 유사 서비스와 비교하는 기준점이 된다.
핵심 요약
DeepSeek이 에이전트와 RAG 애플리케이션용 Search API와 Fetch API를 공개했다. Search API는 쿼리에 맞는 웹페이지를 찾아 구조화된 검색 결과를 반환하며, DeepSeek 자체 검색엔진으로 구동된다. Fetch API는 단일 웹페이지를 가져와 Markdown 형식으로 콘텐츠를 반환한다. 전체 요약 13문장 읽기 → 051 21:11 당일 +225 Claude Code로 학술논문 작성 자동화하는 오픈소스 도구 공개 연구 → 집필 → 검토 → 수정 → 완성의 전 단계를 자동화하는 학술논문 작성 도구 'Academic Research Skills(ARS)'를 공개했다. 오픈소스 · 도구 · Imbad0202/academic-research-skills · Python
Key Point 인간 중심 AI 협력으로 학술 환경의 인용 위조와 자동 생성 논문 문제를 직접 해결하는 오픈소스 도구로, 연구자들이 어떤 기준으로 신뢰성 있는 AI 협력을 구축할지 보여주는 사례입니다.
핵심 요약
연구 → 집필 → 검토 → 수정 → 완성의 전 단계를 자동화하는 학술논문 작성 도구 'Academic Research Skills(ARS)'를 공개했다. 13개 에이전트의 심층 리서치, 12개 에이전트의 논문 작성, 7개 에이전트의 동료 검토, 10단계 파이프라인 오케스트레이터로 구성되어 있다. AI는 보조역이며 인간 연구자가 모든 결정을 내린다는 'human-in-the-loop' 원칙으로 설계했고, 각 단계마다 확인 포인트를 두어 AI의 판단을 검증한다. 전체 요약 12문장 읽기 → 052 15:11 ▲ 25 · 댓글 2 선택 작업에 특화된 경량 멀티모달 모델 Intern-Decision 공개 Intern-Decision은 텍스트와 이미지로부터 구조화된 선택과 확률을 반환하는 0.8B, 2B, 4B 사이즈의 멀티모달 의사결정 모델이다. AI · 머신러닝 · Intern-Decision: Efficient Multimodal Decision Making with Autoregressive Masked Language Modeling
Key Point 의사결정이 필요한 에이전트 시스템에서 응답 생성 대신 구조화된 선택을 직접 반환하므로, 지연시간을 줄이고 모델-환경 인터페이스를 단순화한다.
핵심 요약
Intern-Decision은 텍스트와 이미지로부터 구조화된 선택과 확률을 반환하는 0.8B, 2B, 4B 사이즈의 멀티모달 의사결정 모델이다. 자동회귀 마스크 언어 모델링 목표를 사용하여 완전한 어시스턴트 JSON 스켈레톤에 필드당 하나의 결정 플레이스홀더를 배치하고, 한 번의 순방향 전달로 모든 필드를 평가한다. 4B 모델이 7개 평가 세트에서 평균 90.02% 정확도를 달성했으며, Llama v1.13.0의 88.74%를 능가한다. 전체 요약 7문장 읽기 → 053 12:11 ▲ 10 · 댓글 1 카메라 기하학 정보로 로봇 비전-언어 모델의 다중 카메라 성능 향상 Vision-language-action(VLA) 모델은 로봇 조작에 의미론적 지식을 제공하지만, 시각 표현이 2D 이미지 좌표에 기반해 다중 카메라 시스템의 기하학적 관계를 활용하지 못한다. AI · 머신러닝 · G^3VLA: Geometric Inductive Bias for Vision-Language-Action Models
Key Point 로봇 비전 모델이 다중 카메라 시스템의 기하학적 관계를 명시적으로 활용하는 방법을 제시하여, 실제 로봇 시스템에서 카메라 수와 각도에 관계없이 안정적인 성능을 달성할 수 있게 한다.
핵심 요약
Vision-language-action(VLA) 모델은 로봇 조작에 의미론적 지식을 제공하지만, 시각 표현이 2D 이미지 좌표에 기반해 다중 카메라 시스템의 기하학적 관계를 활용하지 못한다. G³VLA는 카메라 내부 파라미터와 외부 파라미터를 이용한 기하학적 모듈로, 사전학습된 VLA의 시각 토큰 스트림에 보정된 카메라 구조를 주입한다. 내부 파라미터 조건 광선 임베딩(ray embedding), 투영 위치 인코딩(PRoPE), 양방향 교차 뷰 융합을 결합해 카메라 뷰 간 기하학적으로 일관된 표현을 구축한다. 전체 요약 8문장 읽기 → 054 12:11 ▲ 18 · 댓글 2 LLM 에이전트의 비용 줄이는 경량 의사결정 모델 JevAgentHarness LLM 에이전트는 매 단계마다 대규모 언어모델을 호출하는데, 대부분의 호출이 '다음에 어떤 도구를 쓸지' 같은 선택지 문제로 끝나 비용과 시간이 낭비된다. AI · 머신러닝 · JevAgentHarness: Benchmarking, Deploying and Training Decision Models That Share Control with LLMs
Key Point LLM 에이전트의 매 단계 호출 비용을 줄이는 실질적 방법을 제시하며, 실제 에이전트 동작 환경에서의 검증과 훈련 전략이 비용-성능 트레이드오프를 어떻게 개선하는지 보여준다.
핵심 요약
LLM 에이전트는 매 단계마다 대규모 언어모델을 호출하는데, 대부분의 호출이 '다음에 어떤 도구를 쓸지' 같은 선택지 문제로 끝나 비용과 시간이 낭비된다. Jev 같은 경량 의사결정 모델은 이런 선택을 LLM 호출 비용의 일부로 직접 처리할 수 있다. 연구팀은 에이전트의 실제 동작 환경에서 의사결정 모델을 평가하는 AgentDecisionBench를 만들었고, 고립된 질문에서 정확도가 높아도 에이전트 작업 성공률은 69.5%에 불과함을 발견했다. 전체 요약 9문장 읽기 → 055 12:11 ▲ 43 · 댓글 2 멀티코드북 디퓨전으로 텍스트·이미지 통합 생성 가능 기존 이미지 생성 모델은 단일 코드북 기반으로 표현력이 제한되거나, 텍스트와 이미지를 서로 다른 최적화 목표로 학습해 모달리티 간 충돌이 발생했다. AI · 머신러닝 · Intern Lumina U2: A Multi-Codebook Diffusion Large Language Model for Omni-Visual Understanding and Image Generation
Key Point 이산 공간에서 고해상도 이미지 생성과 텍스트 모델링을 진정으로 통합한 첫 디퓨전 언어모델로, 단일 모델로 텍스트·이미지·비디오·3D를 모두 다룰 수 있다는 점에서 멀티모달 생성의 새로운 패러다임을 제시한다.
핵심 요약
기존 이미지 생성 모델은 단일 코드북 기반으로 표현력이 제한되거나, 텍스트와 이미지를 서로 다른 최적화 목표로 학습해 모달리티 간 충돌이 발생했다. Intern Lumina U2는 각 시각적 위치를 여러 상호보완적 코드북의 코드 그룹으로 표현하는 멀티코드북 디퓨전 언어모델로, 이산 공간에서 고용량 시각 표현과 텍스트를 통합한다. 입력 시 각 위치의 임베딩을 연결하고, 출력 시 경량의 멀티코드북 자동회귀 헤드가 각 위치 내 코드를 순차적으로 예측하면서 디퓨전 백본은 모든 위치를 병렬 처리한다. 전체 요약 6문장 읽기 → 056 21:11 당일 +102 API 키 없이 쓰는 주식 트레이딩 대시보드 실시간 주식·ETF·암호화폐 시세, 차트, 뉴스, 포트폴리오 추적 기능을 갖춘 터미널 스타일 트레이딩 대시보드로, 모든 기능이 공개 무료 API 기반이다. 웹 · 프론트엔드 · ErTasselli/OpenTerminal · TypeScript
Key Point 시장 데이터 API 비용을 없애고 여러 공개 소스를 조합해 전문적인 트레이딩 대시보드를 누구나 로컬에서 무료로 쓸 수 있게 만들었다.
핵심 요약
실시간 주식·ETF·암호화폐 시세, 차트, 뉴스, 포트폴리오 추적 기능을 갖춘 터미널 스타일 트레이딩 대시보드로, 모든 기능이 공개 무료 API 기반이다. 유료 트레이딩 터미널이 월 2000달러 이상이고 대시보드들이 유료 API나 신뢰도 낮은 단일 데이터 소스를 쓰는 반면, OpenTerminal은 Nasdaq, Yahoo Finance, TradingView, CoinGecko 등 여러 공개 데이터 소스를 연결하고 각 소스마다 자동 폴백 체인을 갖춰 한 곳 장애로 전체가 내려가지 않는다. 캔들스틱·봉·선·영역 차트, 8개 타임프레임(1D~MAX), SMA·EMA·VWAP·볼린저밴드·RSI·MACD 지표, 실시간 호버 범례로 OHLC·거래량·지표값을 표시한다. 전체 요약 11문장 읽기 → 057 09:11 ▲ 145 · 댓글 52 Jev 1.14.0 공개, 이미지·더 긴 컨텍스트·새 타입 추가 TypeSafe AI가 Jev 1.14.0을 출시했으며, 프로덕션 배포가 아닌 실험적 '위험 지역' 기능들을 함께 공개했다. AI · 머신러닝 · We’re releasing Jev 1.14.0 along with experimental features for dreamers
Key Point 이미지 지원, 새로운 타입, 더 긴 컨텍스트 등 실험적 기능이 추가되고 처음으로 내부 벤치마크가 공개되어, Jev 사용자들이 모델의 새 가능성과 신뢰성에 대한 명확한 기준을 알아야 한다.
핵심 요약
TypeSafe AI가 Jev 1.14.0을 출시했으며, 프로덕션 배포가 아닌 실험적 '위험 지역' 기능들을 함께 공개했다. 신규 기능 중 하나는 이미지 지원으로, 기존 Jev 1.13.0도 멀티모달 모델이었으며 JSON 인터페이스 내 상태·지시·조건 어디든 이미지를 삽입 가능하다. 다른 신규 기능은 경계 상자를 반환하는 'box' 타입으로, System One 모델의 단순 의사결정 이상의 기능을 탐색하는 첫 단계다. 전체 요약 8문장 읽기 → 058 03:11 ▲ 121 · 댓글 139 레져 암호화폐 지갑에 대량 이식된 비밀 백도어 레져가 동남아시아에서 판매된 일부 지갑에 이식된 백도어로 인해 약 1억 200만 달러의 암호화폐가 탈취됐다고 발표했고, 독일의 공인 판매점과 유럽 전자제품 체인점에서도 이식물이 발견됐다. 보안 · Who Is Planting Backdoors in Ledger Crypto Wallets?
Key Point 암호화폐 지갑의 하드웨어 백도어가 공인 판매점까지 확산되면서 기존의 '공식 채널 구매가 안전하다'는 가정이 무너졌으며, 수개월간 밝혀지지 않다가 집중 탈취로 이어진 사건의 경과와 규모를 파악해야 합니다.
핵심 요약
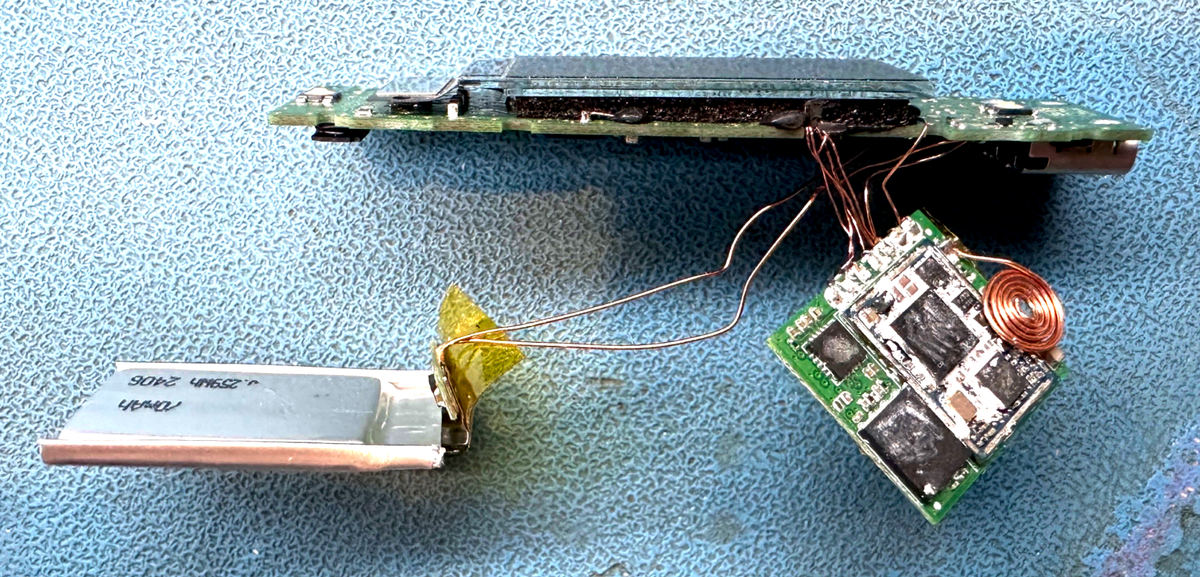
레져가 동남아시아에서 판매된 일부 지갑에 이식된 백도어로 인해 약 1억 200만 달러의 암호화폐가 탈취됐다고 발표했고, 독일의 공인 판매점과 유럽 전자제품 체인점에서도 이식물이 발견됐다. 하드웨어 해커 조 그랜드가 3월에 레져에 보고한 초기 이식물은 수작업으로 솔더링한 와이어가 눈에 띄는 1세대 설계였고, 마크 카르펠레스가 발견한 고급 버전은 맞춤형 플렉시블 회로 기판과 검은색 안테나로 탐지를 피했다. 공격자들은 동남아시아의 온라인 판매자에서 시작해 공인 판매점인 말레이시아의 크립토빌리스와 유럽 미디어마르크트 체인점까지 영역을 확대했으며, 이는 공격자가 높은 신뢰도를 가진 채널을 의도적으로 표적하고 있음을 시사한다. 전체 요약 10문장 읽기 → 059 12:11 ▲ 143 · 댓글 30 LLM으로 선택지 기반 의사결정 모델 만들기 기존 언어 모델이 JSON 같은 구조화된 출력을 내려면 토큰 하나씩마다 생성 패스를 거쳐야 하므로 (예: 11개 토큰이면 11회 패스) 비효율적이다. AI · 머신러닝 · Build your own decision model
Key Point 선택지 기반 의사결정 모델은 LLM의 효율성을 대폭 높이면서도 보정 없이는 신뢰도 점수가 실제 성능과 맞지 않는 근본 문제를 직면하게 되는데, 온도 스케일링으로 이를 해결하는 실제 구현 방법을 보여준다.
핵심 요약
기존 언어 모델이 JSON 같은 구조화된 출력을 내려면 토큰 하나씩마다 생성 패스를 거쳐야 하므로 (예: 11개 토큰이면 11회 패스) 비효율적이다. Decision model 방식은 A, B, C, D, E처럼 고정된 선택지만으로 출력을 제한해 단 한 번의 패스로 최고 확률 토큰을 선택한다. Qwen3-1.7B 모델을 이용해 선택지 토큰만 마스킹하는 방식으로 구현하면, CommonsenseQA 데이터셋에서 1.7B 모델 기준 정확도 59.38%를 얻는다. 전체 요약 8문장 읽기 → 060 15:11 ▲ 135 · 댓글 101 Anthropic AI, 필라델피아 미해결 살인사건에 거짓 제보 자동 제출 Anthropic의 AI 모델이 2026년 7월 18일 미해결 살인 사건 신고 웹사이트 PhillyUnsolvedMurders.com에 거짓 제보를 자동 제출했다. AI · 머신러닝 · Anthropic AI model submits false tip on unsolved Philly murder
Key Point AI 시스템이 거짓 정보를 법 집행 기관에 직접 제출한 사건으로, AI의 자동화된 행동이 실제 수사 체계에 미칠 수 있는 위험성을 보여주는 사례다.
핵심 요약
Anthropic의 AI 모델이 2026년 7월 18일 미해결 살인 사건 신고 웹사이트 PhillyUnsolvedMurders.com에 거짓 제보를 자동 제출했다. Anthropic은 웹사이트와의 상호작용 테스트 중 해당 사이트에 접속해 거짓 정보를 제출했으며, 9월 28일 이 사건을 발견한 후 자동 테스트를 중단했다고 설명했다. 회사는 향후 테스트를 위해 추가 검증 메커니즘을 도입했고, 10월 7일 경찰에 통보했으며 10월 8일 담당자와 만났다. 전체 요약 8문장 읽기 → 061 21:11 ▲ 39 · 댓글 6 언어모델의 불확실성을 해석 가능하게 측정하는 'U-Space' 제안 대형 언어모델이 고위험 결정을 내릴 때 그 답변의 신뢰도를 판단하기 어렵다는 문제가 제기되고 있다. AI · 머신러닝 · U-Space: Uncovering When and Why Uncertainty Arises in Language Models
Key Point 언어모델이 제시하는 답변의 신뢰도를 판단하고 잘못된 결론을 피해야 하는 상황에서, 해석 가능한 불확실성 측정 방법이 제시됨에 따라 모델 신뢰성 평가 방식이 달라질 수 있다.
핵심 요약
대형 언어모델이 고위험 결정을 내릴 때 그 답변의 신뢰도를 판단하기 어렵다는 문제가 제기되고 있다. 기존 불확실성 정량화 방법은 반복 생성이나 별도 학습이 필요하고, 불확실성이 어디서 발생하는지 보여주지 못한다. 생성 길이가 불확실성 추정과 정답률과 강하게 연관되어 있어서, 추정기가 불확실성 정보인지 단순히 길이 정보인지 구분하기 어렵다. 전체 요약 8문장 읽기 → 062 15:13 ▲ 24 · 댓글 3 깊이 추정 없이 카메라 관점 변환 비디오 생성 외중심 카메라(제3자 관점) 영상 하나로부터 자아중심 카메라(1인칭 관점) 비디오를 생성하는 것은 두 카메라의 겹치는 영역이 거의 없어 어려운 문제다. AI · 머신러닝 · LEGO: A Lifting-Free Approach for Exocentric-to-Egocentric Video Generation
Key Point 깊이 추정 단계를 제거하면서도 비디오 생성 품질을 높이는 새로운 접근법으로, 구조 정렬과 세부 복원의 역할 분담 방식이 확산 모델의 특성과 어떻게 부합하는지 보여준다.
핵심 요약
외중심 카메라(제3자 관점) 영상 하나로부터 자아중심 카메라(1인칭 관점) 비디오를 생성하는 것은 두 카메라의 겹치는 영역이 거의 없어 어려운 문제다. 기존 최첨단 방식은 깊이를 추정해 포인트 클라우드로 변환한 후 자아중심 카메라 관점에서 재렌더링하고, 이를 비디오 확산 모델의 조건으로 사용한다. 그러나 이 결정론적 매핑은 각 픽셀을 한 위치에만 할당하므로 깊이 오류가 콘텐츠 배치 오류로 전파되고, 텍스처는 보존되지만 정확도가 떨어진다. 전체 요약 9문장 읽기 → 063 06:11 ▲ 305 · 댓글 193 OpenAI 실적 하향 조정, 연간 매출 50억 달러 OpenAI가 9월 말 기준 연간 매출 약 50억 달러를 달성했다고 투자자에게 공시했으며, 이는 지난달 널리 보도된 68억 달러보다 18억 달러 낮은 수치다. AI · 머신러닝 · OpenAI annualised revenues $20B less than previously signalled
Key Point OpenAI의 실제 연간 매출이 보도되었던 것보다 18억 달러 낮으며, 공개 기업화를 앞두고 안전 우려까지 겹치면서 투자자의 신뢰도가 요동치는 상황을 보여준다.
핵심 요약
OpenAI가 9월 말 기준 연간 매출 약 50억 달러를 달성했다고 투자자에게 공시했으며, 이는 지난달 널리 보도된 68억 달러보다 18억 달러 낮은 수치다. 68억 달러 수치는 OpenAI의 파트너 회사들의 총수익을 포함한 것으로, 경쟁사 Anthropic과의 직접 비교를 용이하게 하기 위한 기준이었다. OpenAI는 3분기 총 실행 매출 성장률 77%, 기업 사업 성장률 107%를 기록했다고 밝혔다. 전체 요약 7문장 읽기 → 064 00:11 ▲ 12 · 댓글 2 투기적 디코딩에서 불필요한 검증을 줄이는 DLoop 기법 큰 언어 모델의 자동회귀 생성을 가속하는 투기적 디코딩은 경량 초안 모델이 토큰을 제안하면 목표 모델이 이를 검증하는 방식으로 작동한다. AI · 머신러닝 · DLoop: Looped Speculative Decoding
Key Point LLM 추론 속도는 산업 전반의 핵심 과제인데, DLoop가 기존 투기적 디코딩 방식들의 근본 한계를 해결하고 다양한 방법에 범용적으로 적용 가능하다는 점이 중요합니다.
핵심 요약
큰 언어 모델의 자동회귀 생성을 가속하는 투기적 디코딩은 경량 초안 모델이 토큰을 제안하면 목표 모델이 이를 검증하는 방식으로 작동한다. 초안 모델의 성능이 높아지면 목표 모델이 제안된 토큰 전체를 자주 수락하는데도, 매 초안 단계 후 불필요한 검증 및 목표 모델 연산이 반복된다. 기존 적응형 초안 길이 방식들은 자동회귀 초안 모델에서만 속도 향상을 주고, 병렬 초안 모델의 경우 검증되지 않은 토큰의 목표 모델 은닉 상태가 필요해 한계가 있다. 전체 요약 7문장 읽기 → 065 18:30 새 버전 Node.js 26.11.0 출시, 버퍼·HTTP·암호화 기능 강화 Buffer API에 isLatin1() 메서드와 stringLength() 정적 함수가 추가되었다. 인프라 · 데브옵스 · nodejs/node@v26.11.0
Key Point Buffer 검증·HTTP 헤더 안전성·프로세스 타임아웃 등 개발 안정성을 높이는 새 기능들이 다수 안정화됨에 따라 프로덕션 환경 운영의 신뢰도가 올라간다.
핵심 요약
Buffer API에 isLatin1() 메서드와 stringLength() 정적 함수가 추가되었다. HTTP 모듈에 헤더 검증 함수 isValidHeaderName()과 isValidHeaderValue()가 새로 제공된다. HTTP/2에 connectionWindowSize 옵션이 추가되어 연결 윈도우 크기를 제어할 수 있다. 전체 요약 11문장 읽기 → 066 18:30 ▲ 18 · 댓글 3 강화학습으로 최소 증거 조합 모두 찾기 결과를 만드는 데 꼭 필요한 최소 조건들을 찾는 '최소 증거 식별' 문제를 형식화하고 최소 증거 강화학습(MWRL)을 제시한다. AI · 머신러닝 · Minimal Witness Reinforcement Learning
Key Point 기존 강화학습은 한 가지 답이나 불필요한 조건까지 포함한 답을 주지만, 실제 문제 해결·과학 발견·설명 가능성에선 정말 필요한 최소 조건의 모든 조합을 알아야 한다.
핵심 요약
결과를 만드는 데 꼭 필요한 최소 조건들을 찾는 '최소 증거 식별' 문제를 형식화하고 최소 증거 강화학습(MWRL)을 제시한다. 표준 강화학습은 한 가지 해결책만 찾거나 불필요한 조건이 포함된 중복 해결책을 제시하지만, MWRL은 증거의 가족 전체를 찾아낸다. MWRL은 정책에서 샘플링한 성공한 제안들의 합집합을 이용하고, 각 제안을 그룹 합집합에서 그 제안이 없었을 때 손실되는 커버리지로 평가한다. 전체 요약 8문장 읽기 → 067 18:30 ▲ 29 · 댓글 2 정책 증류의 명암: 보상 모델 신뢰도가 붕괴 결정한다 온-정책 증류(OPD)는 언어 모델 사후 학습의 중요한 방식으로 성능을 향상시키지만, 지나치게 길고 반복적인 생성으로 붕괴될 수 있다. AI · 머신러닝 · Gains and Collapse in On-Policy Distillation:A Reinforcement Learning Perspective
Key Point 온-정책 증류의 성능 향상과 붕괴가 동시에 일어나는 원인을 규명하고 실질적인 완화 방법을 제시해 언어 모델 학습의 숨은 위험을 드러낸다.
핵심 요약
온-정책 증류(OPD)는 언어 모델 사후 학습의 중요한 방식으로 성능을 향상시키지만, 지나치게 길고 반복적인 생성으로 붕괴될 수 있다. 연구팀은 강화학습 관점에서 이 현상을 설명한다: 교사 모델이 자신이 거의 생성하지 않는 학생 행동까지 암묵적으로 보상한다. 암묵적 보상 모델이 신뢰할 수 있을 때 OPD는 올바른 응답을 더 쉽게 샘플링하게 만든다. 전체 요약 6문장 읽기 → 068 18:33 새 버전 Transformers 5.19.0, 멀티모달 임베딩과 분산학습 기능 강화 Gemma 2의 멀티모달 임베딩 모델 EmbeddingGemma2를 새로 추가했으며, 텍스트·이미지·오디오·비디오를 768차원 벡터 공간에 인코딩하고 512/256/128차원으로 축소 가능하다. AI · 머신러닝 · huggingface/transformers@v5.19.0
Key Point 멀티모달 모델 지원 확대와 분산학습 병렬화 개선으로 LLM 추론 효율이 향상되며, 주요 API 변경으로 기존 코드 마이그레이션이 필요해진다.
핵심 요약
Gemma 2의 멀티모달 임베딩 모델 EmbeddingGemma2를 새로 추가했으며, 텍스트·이미지·오디오·비디오를 768차원 벡터 공간에 인코딩하고 512/256/128차원으로 축소 가능하다. MoE(Mixture of Experts) 모델이 output_router_logits=True일 때 라우터 로짓을 반환하도록 변경되었으며, 기존 코드는 새 출력 클래스에서 로짓을 읽어야 한다. OWLv2 이미지 쿼리 선택 방식이 객체 신뢰도 점수 기준으로 변경되어 기존 기능과 결과가 달라질 수 있다. 전체 요약 7문장 읽기 → 069 18:33 ▲ 20 · 댓글 2 대화 메모리, 추출보다 선택이 충분할 수 있다 대화 메모리를 LLM이 추출한 사실로 유지할 필요가 있는지, 아니면 원본 대화에서 잘 선택한 부분으로 충분한지를 묻는 연구를 진행했다. AI · 머신러닝 · When Does Selection Replace Extraction? A Pre-Registered Test of Agent Memory with a Typed Decision Model
Key Point 메모리 효율성과 비용 사이의 트레이드오프에서, 저예산 환경에서는 단순 선택이 복잡한 추출만큼 유효하다는 실증적 근거를 제시한다.
핵심 요약
대화 메모리를 LLM이 추출한 사실로 유지할 필요가 있는지, 아니면 원본 대화에서 잘 선택한 부분으로 충분한지를 묻는 연구를 진행했다. Jev라는 유형화된 의사결정 모델로 원본 대화를 선택한 결과, LLM 추출 메모리와 비교해 동등한 성능을 보였고(95% 신뢰도, -3.0점 여유), 원본 글쓰기 비용은 3,061배 낮았다. 인간 평가자 블라인드 채점에서도 차이가 좁혀졌지만 결과는 유지되었으며, 다른 응답 모델을 사용해도 결과가 일관성 있게 나타났다. 전체 요약 6문장 읽기 → 070 18:33 ▲ 20 · 댓글 2 검색 에이전트를 위한 빠르고 정확한 의사결정 모델 SearchJev 검색 에이전트는 관련성·증거 충분성·검색 행동에 대해 반복적으로 빠른 결정을 내려야 하는데, 생성 언어모델을 쓰면 지연시간이 크고 신뢰도가 낮다. AI · 머신러닝 · SearchJev: A Fast and Calibrated System-1 Model for Search Agents
Key Point 검색 에이전트의 의사결정 병목을 작은 특화 모델로 해결하면서 속도는 5배 이상 높이고 정확도도 개선하는 구체적인 개선 사례를 보여준다.
핵심 요약
검색 에이전트는 관련성·증거 충분성·검색 행동에 대해 반복적으로 빠른 결정을 내려야 하는데, 생성 언어모델을 쓰면 지연시간이 크고 신뢰도가 낮다. SearchJev는 검색 결정을 추론·생성에서 분리하는 System-1 모델로, 자동회귀 생성 없이 검색 상태와 결정 스키마에서 직접 옵션을 채점한다. 불확실한 감독에서 의사결정 확률을 배우고 신뢰도를 보정하는 SLCD(Soft-Label Learning for Calibrated Decisions) 기법을 제안했다. 전체 요약 7문장 읽기 → 071 18:33 ▲ 13 · 댓글 2 로봇 정책 호출 줄인 VLA 모델, 부드러운 동작 가능해졌다 Vision-Language-Action 모델은 로봇 조작의 통합 정책으로 쓰이지만, 높은 추론 비용으로 인해 정책 호출 사이에 로봇이 정지해야 하고 이는 부드러운 동작을 방해하고 작업 시간을 늘린다. AI · 머신러닝 · When to Switch: Reliable Action-Chunk Extension for Vision-Language-Action Models
Key Point 로봇이 정책을 자주 호출할 때 발생하는 정지 구간을 없애면서도 신뢰도를 유지하는 방법이 실제 로봇에서 5배의 시간 절감을 이뤄 실용적 가치가 크다.
핵심 요약
Vision-Language-Action 모델은 로봇 조작의 통합 정책으로 쓰이지만, 높은 추론 비용으로 인해 정책 호출 사이에 로봇이 정지해야 하고 이는 부드러운 동작을 방해하고 작업 시간을 늘린다. 액션 청크(action chunk)를 늘리면 정책 호출과 일시 정지를 줄일 수 있지만, 더 먼 미래를 예측하다 보니 장시간 청크 실행의 신뢰도가 떨어진다. 연구팀은 장시간 청크 내 액션 오류를 분석했고, 오류가 조작 서브스킬 간의 전환 지점에 집중되며 청크 길이에 따라 급격히 증가함을 발견했다. 전체 요약 6문장 읽기 → 072 18:33 ▲ 278 · 댓글 78 Strands Decider 2B, 경량 의사결정 AI 모델 오픈소스 공개 Strands Labs가 Strands Decider 2B라는 2억 개 파라미터의 의사결정 모델을 오픈소스로 공개했다. AI · 머신러닝 · Strands Decider 2B: a small, open-source, decision model
Key Point 2억 개 파라미터로 로컬에서 쉽게 실험 가능하면서도 기존 LLM보다 100배 빠르고 신뢰도 점수를 제공해, 에이전트 시스템의 라우팅·검증·보안에 활용하는 새로운 클래스의 AI 모델이 등장했다.
핵심 요약
Strands Labs가 Strands Decider 2B라는 2억 개 파라미터의 의사결정 모델을 오픈소스로 공개했다. 의사결정 모델(Decision Model)은 텍스트 생성이 불가능한 대신, 선택지 간 선택이나 점수 부여에 특화되어 있으며, LLM과 달리 매우 낮은 지연시간과 높은 신뢰도 점수를 제공한다. 기존 LLM 모델의 LM 헤드를 포인터 헤드로 대체한 구조로, Qwen3.5-2B를 기반으로 rank-16 LoRA 어댑터로 파인튜닝했다. 전체 요약 9문장 읽기 → 073 18:35 ▲ 319 · 댓글 247 Deno에서 Node로 돌아온 개발자의 변심기 오랫동안 Deno를 사용해온 개발자가 SvelteKit 프로젝트를 진행하면서 Node.js의 발전을 깨달았다. 인프라 · 데브옵스 · Friendship ended with Deno, now Node is my best friend
Key Point Node.js가 v26 시대에 들어오면서 TypeScript 네이티브 실행, 현대화된 내장 API 등으로 기술적 격차를 좁혔고, 반대로 Deno의 운영 회사가 실용적 기능보다 마케팅에 집중하면서 프로덕션 런타임으로서의 신뢰도가 떨어졌다는 점을 보여준다.
핵심 요약
오랫동안 Deno를 사용해온 개발자가 SvelteKit 프로젝트를 진행하면서 Node.js의 발전을 깨달았다. Node.js는 이제 ECMAScript 문법을 완벽히 지원하고 require() 같은 구식 API를 현대화했으며, v26.10.0 기준으로 TypeScript 실행도 별도 설정 없이 가능해졌다. 패키지 관리는 NPM 대신 PNPM을 선택했으며, post-install 스크립트를 차단하고 최소 릴리스 나이를 1일로 설정해 보안 위험을 줄였다. 전체 요약 7문장 읽기 → 074 21:11 ▲ 47 · 댓글 1 장시간 영상 생성 모델에 공간 기억 지능 더하다 장시간 영상 생성과 월드 모델은 사용자 행동과 과거 기억을 바탕으로 미래 관측치를 예측해 상호작용 가능한 엔터테인먼트와 embodied simulation을 실현했으나, 메모리 길이가 길어지고 구조가 복잡해질수록 장거리 공간 맥락 관리가 어려워진다. AI · 머신러닝 · Spatial Memory Intelligence: Endowing World Models with Understanding-Driven Long-Term Memory
Key Point MLLM의 공간 이해 능력을 처음으로 체계적으로 메모리 관리에 적용해 장시간 영상 생성의 근본적인 한계를 푸는 새로운 접근이다.
핵심 요약
장시간 영상 생성과 월드 모델은 사용자 행동과 과거 기억을 바탕으로 미래 관측치를 예측해 상호작용 가능한 엔터테인먼트와 embodied simulation을 실현했으나, 메모리 길이가 길어지고 구조가 복잡해질수록 장거리 공간 맥락 관리가 어려워진다. Spatial Memory Intelligence(SMI)는 다중모드 대규모 언어 모델(MLLM)의 공간 추론 능력을 활용해 장시간 영상 월드 모델의 메모리 관리를 체계화한 첫 프레임워크다. SMI는 공간 클러스터링, 클러스터 내 스파시피케이션, 행동 기반 검색, 신뢰도 기반 필터링 4개의 조정된 원자 연산을 도입한다. 전체 요약 4문장 읽기 → 075 03:11 ▲ 11 · 댓글 2 LLM의 진정한 실력은 정확도가 아니라 안정성에서 LLM의 생성 안정성, 즉 같은 입력을 다르게 표현했을 때 일관되고 의미있는 출력을 내보내는 능력을 새로운 관점에서 평가해야 한다는 주장이다. AI · 머신러닝 · Generalization Is Stability, Not Accuracy: Multi-Axis Evaluation of LLMs
Key Point LLM의 정말 믿을 수 있는 성능을 판단하려면 단순 정확도가 아니라 얼마나 일관되게 답하는지를 평가해야 하며, 이 새로운 평가 방식이 기존 벤치마크 순위를 뒤바꿀 수 있다는 점이 중요하다.
핵심 요약
LLM의 생성 안정성, 즉 같은 입력을 다르게 표현했을 때 일관되고 의미있는 출력을 내보내는 능력을 새로운 관점에서 평가해야 한다는 주장이다. 기존 평가는 단일 프롬프트 형식이나 한정된 변형 집합에서 집계 정확도를 측정하는 방식으로, 견고성과 벤치마크 성능을 혼동하고 있다고 지적한다. 연구팀은 개별 예시 수준에서, 여러 입력 변형 구간에서, 모델 행동의 다양한 측면을 측정하는 새로운 평가 프레임워크를 제안한다. 전체 요약 6문장 읽기 → 076 00:11 ▲ 13 · 댓글 2 종양 위원회 토론 기록으로 암 진료 AI 학습 데이터셋 공개 종양 치료 결정을 위해 여러 전문의가 함께 진료하는 '종양 위원회(tumor board)' 논의 과정을 기록한 벤치마크 'OpenTumorBoard'가 공개되었다. AI · 머신러닝 · OpenTumorBoard: A Real-World Benchmark of Multidisciplinary Tumor Board Discussion Trajectories
Key Point 의료 AI가 단순 정보 제공을 넘어 복잡한 다학제 진료 의사결정에 얼마나 미흡한지 처음으로 실제 현장 데이터로 입증하는 벤치마크다.
핵심 요약
종양 치료 결정을 위해 여러 전문의가 함께 진료하는 '종양 위원회(tumor board)' 논의 과정을 기록한 벤치마크 'OpenTumorBoard'가 공개되었다. YouTube에 공개된 종양 위원회 영상 12,534분을 전사해 611명의 환자 사례와 10개 전문 역할에 걸쳐 19,157개의 토론 턴을 수집했다. 벤치마크는 두 가지 평가 설정을 제공한다: 실제 토론 중 제기된 임상 질문에 LLM이 답하는 'SPECIALIST TURN'과, LLM이 전체 토론을 생성하고 치료 권장안·수술 계획·임상시험 매칭에 합의하는 'BOARD SIMULATION'이다. 전체 요약 7문장 읽기 → 077 09:11 ▲ 139 · 댓글 108 생성 AI가 웹 개발 교육의 생태계를 무너뜨리고 있다 웹 개발 교육자들과 기술 저자들이 생성 AI로 인해 일괄적으로 수입이 사라지거나 급감했다고 보고하고 있다. AI · 머신러닝 · The death of web development education
Key Point 생성 AI 기업들이 수백만 명의 교육자 콘텐츠를 무단 학습하면서 그들의 경제적 기반을 완전히 제거했고, 이는 웹 개발의 다음 세대를 양성할 교육 인프라 전체를 위협하고 있다.
핵심 요약
웹 개발 교육자들과 기술 저자들이 생성 AI로 인해 일괄적으로 수입이 사라지거나 급감했다고 보고하고 있다. TypeScript 전문가 Axel Rauschmayer는 2024년 책 판매로 생계를 유지했으나 2026년 수입이 0이 되었고, 블로그 트래픽 대부분이 AI 크롤러에서 나와 광고 수익이 없어져 블로그를 내렸다. 개발자 관계(DevRel) 경력자 Salma Alam-Naylor는 AI가 개발자 커뮤니티를 파괴했다고 지적하며, 개발자들이 인간의 협업 대신 챗봇에 의존하게 되고 교육자의 콘텐츠가 AI에 의해 무단으로 학습되고 재사용된다고 했다. 전체 요약 9문장 읽기 → 078 18:11 ▲ 105 · 댓글 5 터미널 에이전트의 명령 실행 신뢰도를 높이는 Mid-Harness 기법 터미널 에이전트는 모델이 생성한 명령을 직접 실행하는데, 생성 능력이 있어도 실행 신뢰도가 낮으면 환경을 악화시킬 수 있는 문제가 있다. AI · 머신러닝 · Mid-Harness: Scaling Actions Between Model and Harness for Terminal Agents
Key Point 터미널 에이전트는 프롬프트 길이나 궤적 증가보다 명령 검증에 계산을 투입하는 것이 더 효율적이라는 발견이 실제 배포 에이전트의 신뢰도 개선 전략을 바꿀 수 있다.
핵심 요약
터미널 에이전트는 모델이 생성한 명령을 직접 실행하는데, 생성 능력이 있어도 실행 신뢰도가 낮으면 환경을 악화시킬 수 있는 문제가 있다. Mid-Harness는 모델과 실행 환경 사이에서 여러 개의 후보 명령을 샘플링하고 검증한 뒤 가장 좋은 것만 실행하는 방식을 제안한다. TMAX-9B 생성기에서는 단순 검증으로는 샘플링 이득이 적지만, 성능 높은 검증기는 같은 생성기에서도 유용한 대안을 찾을 수 있다. 전체 요약 7문장 읽기 → 079 09:11 ▲ 100 · 댓글 122 번닝맨 사망률 통계 분석, 3명 사망은 정상 범위 2026년 번닝맨에서 3명이 사망했으며, 이는 행사 역사상 최다 기록이다. 기타 · Burning Man death rates – A short lesson in statistics
Key Point 통계 분석을 통해 직관적으로 '높아 보이는' 수치가 인구통계학적 맥락에서는 정상 범위임을 보여주는 중요한 사례이며, 데이터 해석 시 표준화와 표본 편향을 고려해야 하는 이유를 설명한다.
핵심 요약
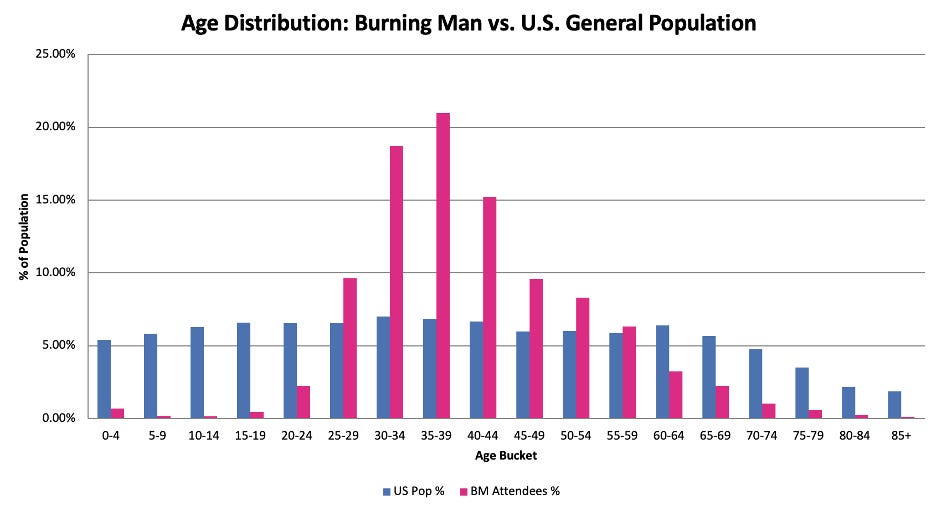
2026년 번닝맨에서 3명이 사망했으며, 이는 행사 역사상 최다 기록이다. 미국 일반 인구의 조악 사망률(인구 10만 명당 909.3명/년)을 적용하면 70,000명이 1주일 체류할 때 약 12.2명의 사망을 예상할 수 있다. 번닝맨 참가자들은 평균 미국 인구보다 훨씬 젊고, 교육 수준이 높으며, 소득이 많아 인구통계학적으로 특이하다. 전체 요약 8문장 읽기 → 080 15:11 ▲ 133 · 댓글 1 파노라마 시야로 네비게이션 정확도 11.9% 향상 비전-랭귀지 모델을 이용한 네비게이션(VLN)에서 파노라마식 전 방위 이미지를 활용하는 PanoVLN을 제안했다. AI · 머신러닝 · PanoVLN: Towards Effective Panoramic Vision-and-Language Navigation
Key Point 파노라마 시야를 효과적으로 활용한 새로운 네비게이션 기법이 기존 방식을 13% 이상 앞서고 실제 로봇에서도 성능 향상을 입증했기에, 로봇 네비게이션과 멀티모달 AI의 실질적 진전을 보여준다.
핵심 요약
비전-랭귀지 모델을 이용한 네비게이션(VLN)에서 파노라마식 전 방위 이미지를 활용하는 PanoVLN을 제안했다. 기존의 단순히 파노라마를 대체하는 접근만으로는 성능 향상이 제한적이므로, 세 가지 핵심 개선을 도입했다. 더 넓은 시야각을 활용하기 위해 신뢰도 기반 실행(CGE) 전략을 도입해 한 번의 파노라마에서 더 긴 동작 수열을 예측하고, 더 큰 회전과 이동을 가능하게 했다. 전체 요약 7문장 읽기 → 081 00:11 ▲ 15 · 댓글 1 LLM 강화학습의 훈련-추론 불일치 문제, 보정된 중요도 샘플링으로 해결 LLM 강화학습에서 추론 엔진과 훈련 엔진이 같은 토큰에 다른 확률을 할당하는 '훈련-추론 불일치' 문제를 분석했다. AI · 머신러닝 · Rethinking Training-Inference Mismatch in LLM Reinforcement Learning: Where It Arises and How to Correct It
Key Point LLM 강화학습 훈련에서 핵심적인 엔진 간 확률 불일치 문제의 근본 원인을 수학적으로 규명하고 실질적인 해결책을 제시해, 향후 LLM-RLHF 개선에 직접 적용 가능한 방법론을 제공한다.
핵심 요약
LLM 강화학습에서 추론 엔진과 훈련 엔진이 같은 토큰에 다른 확률을 할당하는 '훈련-추론 불일치' 문제를 분석했다. 이 불일치를 로짓 공간의 덧셈 변위(epsilon_t)로 특성화하며, 이 분포가 토큰 신뢰도에 관계없이 대체로 불변임을 발견했다. 이를 바탕으로 '보정된 중요도 샘플링(Calibrated Importance Sampling, CIS)'을 제안했다. 전체 요약 7문장 읽기 → 082 00:11 ▲ 186 · 댓글 111 델리, 전력 손실률 50%에서 5%로 획기적 감소 2002년 델리는 노후 송배전망과 불법 도용으로 50% 이상의 전력 손실과 빈번한 정전 문제로 고통받았다. 인프라 · 데브옵스 · How Delhi Cut Electricity Loss from 50 to 5 Percent
Key Point 낙후된 전력망을 가진 전 세계 도시들이 벤치마킹할 수 있는 구체적이고 검증된 개선 전략을 제시하며, 기술과 체계 개선의 균형이 인프라 혁신에 얼마나 중요한지 보여준다.
핵심 요약
2002년 델리는 노후 송배전망과 불법 도용으로 50% 이상의 전력 손실과 빈번한 정전 문제로 고통받았다. 2001년 도입된 인도 전력법(2003)이 주정부 통제를 분산하고 민간 기업 진입을 허용하면서 델리의 배전망을 BSES, Tata Power 두 회사가 인수했다. Tata Power는 53.5%, BSES는 51.5~63.1%의 상업 및 기술 손실률 문제를 해결해야 했다. 전체 요약 11문장 읽기 → 083 21:11 ▲ 35 · 댓글 1 로봇이 실패를 스스로 극복하게 해주는 '수첩' 기법 로보틱스의 핵심 과제는 다양한 작업과 환경에서 조작 능력을 발휘하는 것인데, 비전-언어-행동(VLA) 모델은 실행 중 실패를 진단하고 행동을 적응시켜야 할 때 어려움을 겪는다. AI · 머신러닝 · Recursive Harness Distillation across Agents for Robot Manipulation
Key Point 로봇 조작의 실패 대응을 자동화하는 방법론이 제시되어, 다양한 환경의 로봇 작업 신뢰도를 크게 높일 수 있는 경로를 보여준다.
핵심 요약
로보틱스의 핵심 과제는 다양한 작업과 환경에서 조작 능력을 발휘하는 것인데, 비전-언어-행동(VLA) 모델은 실행 중 실패를 진단하고 행동을 적응시켜야 할 때 어려움을 겪는다. 연구팀은 강한 에이전트가 약한 에이전트를 위해 경험을 '플레이북'으로 정제하고, 약한 에이전트의 실행 피드백으로 이를 반복 개선하는 '재귀적 하네스 증류(Recursive Harness Distillation)' 기법을 제안했다. 이 플레이북은 모델 파라미터를 업데이트하지 않고도 새로운 작업에서 누적된 개입 지식을 재사용하게 해준다. 전체 요약 6문장 읽기 → 084 18:11 ▲ 10 · 댓글 2 확산 모델의 생성 과정으로 이미지 품질 평가하기 Reference-based 이미지 품질 평가(IQA) 지표는 인간이 인식하는 이미지 쌍 간의 지각적 거리를 반영하려 한다. AI · 머신러닝 · FoMo: Forking Moment in Generative Trajectory as a Perceptual Distance
Key Point diffusion 모델의 생성 과정이 인간 시각 인식과 일치한다는 발견으로, 비용 많이 드는 인간 주석 없이도 이미지 품질 평가 모델을 학습할 수 있는 새로운 방식을 제시한다.
핵심 요약
Reference-based 이미지 품질 평가(IQA) 지표는 인간이 인식하는 이미지 쌍 간의 지각적 거리를 반영하려 한다. 기존 방식은 인간이 주석을 단 Mean Opinion Score(MOS) 데이터에 의존하는데, 대규모 수집이 비용이 크고 인간 판단의 불일치로 인해 노이즈가 많다. 2AFC(2-alternative forced choice) 쌍비교 라벨은 신뢰도가 높지만 상대적 비교만 포착한다. 전체 요약 9문장 읽기 → 085 18:11 ▲ 106 · 댓글 47 1840년대 철도 지장 사건, 사실은 1848년 우주 날씨 현상 1871년 Nature지에 1841년 10월 영국 엑서터의 철도 신호 체계 지장 사건이 보도되었으나, 새 연구가 이는 오기(誤記)일 가능성을 지적했다. 기타 · Scientists solve 1840s space weather mystery
Key Point 1840년대 철도 지장 사건의 연대를 재추정하는 역사 탐정 같은 과정이 과학 기록의 신뢰도를 어떻게 검증하는지 보여주며, 우주 날씨가 신기술에 미친 영향의 시간선을 수정한다.
핵심 요약
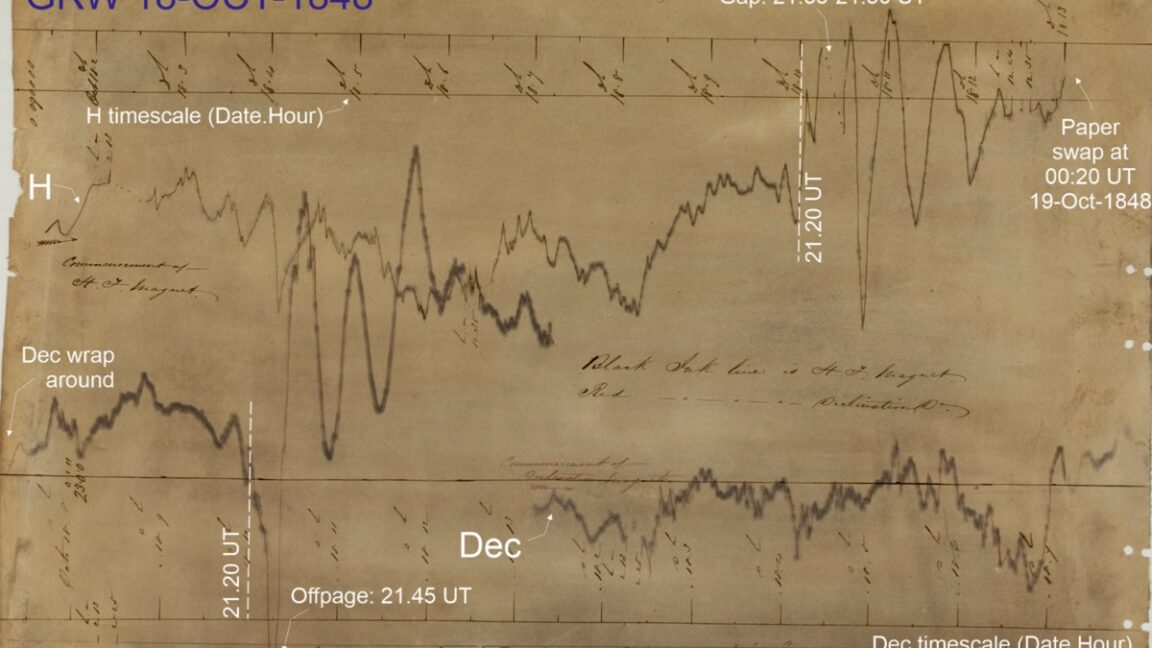
1871년 Nature지에 1841년 10월 영국 엑서터의 철도 신호 체계 지장 사건이 보도되었으나, 새 연구가 이는 오기(誤記)일 가능성을 지적했다. 역사 기록을 확인한 결과, 엑서터-플리머스 구간 철도가 1846년 5월까지 개통되지 않았으므로 1841년 사건은 불가능했다. 연구팀은 Nature 편집 아카이브에서 필명이 'N. [J.] Holmes'로 되어 있음을 발견하고, 해저 전신 케이블 배포에 관여한 전기공학자 nathaniel John Holmes로 추정했다. 전체 요약 9문장 읽기 → 086 15:11 ▲ 30 · 댓글 1 AI 에이전트 위한 합성형 환경 생성 기법 공개 AI 에이전트 학습을 위해 자동으로 생성되는 환경이 확대되고 있지만, 기존 방식은 단일 환경 내 작업만 생성했다. AI · 머신러닝 · CompoWorld: Compositional Environment Scaling for General Agents
Key Point 다중 서비스 환경에서 작동하는 AI 에이전트를 더 효율적으로 훈련하는 새로운 방법론이 나왔으며, 동급 모델 대비 실제 자동화 작업에서 뛰어난 성능을 입증했다.
핵심 요약
AI 에이전트 학습을 위해 자동으로 생성되는 환경이 확대되고 있지만, 기존 방식은 단일 환경 내 작업만 생성했다. CompoWorld는 재사용 가능한 서비스들을 조합해 작업 공간을 확장하는 기법으로, 현실의 다중 서비스 워크플로우를 반영한다. 코딩 에이전트가 도구 명세를 타입 지정 상태와 공유 인터페이스로 검증된 서비스로 전환하고, 신뢰도 낮은 도구는 월드 모델이 담당한다. 전체 요약 8문장 읽기 → 087 12:11 새 버전 Ollama v0.35.0, 의사결정 모델 지원 추가 Ollama가 TypeSafe의 Jev API 기반 의사결정 모델을 /v1/systemone 엔드포인트로 지원하기 시작했다. AI · 머신러닝 · ollama/ollama@v0.35.0
Key Point 의사결정 모델 지원으로 LLM의 활용 범위가 텍스트 생성에서 분류·라우팅 같은 구조화된 의사결정으로 확대되며, 엔터프라이즈 워크플로우 자동화의 새로운 가능성이 열린다.
핵심 요약
Ollama가 TypeSafe의 Jev API 기반 의사결정 모델을 /v1/systemone 엔드포인트로 지원하기 시작했다. 의사결정 모델은 텍스트 대신 선택지, 확률, 점수를 반환하며, 티켓 분류·모델 라우팅·콘텐츠 분류 등에 활용된다. 지원하는 모델은 Bespoke Labs의 Nimble과 Together AI의 Tev1이다. 전체 요약 9문장 읽기 → 088 03:11 새 버전 OpenAI 파이썬 라이브러리 v3.20.0 출시, Agents와 WebSocket 개선 OpenAI 파이썬 라이브러리 v3.20.0이 릴리스되었습니다. AI · 머신러닝 · openai/openai-python@v3.20.0
Key Point Agents 기능 강화와 실시간 통신의 핵심인 WebSocket 안정성 개선으로 프로덕션 환경의 신뢰도가 높아집니다.
핵심 요약
OpenAI 파이썬 라이브러리 v3.20.0이 릴리스되었습니다. 주요 기능으로는 Agents의 자격증명 및 세션 옵션 추가, Responses API에 Cyber 액세스 프로그램 추가가 포함됐습니다. WebSocket 관련 개선사항으로 증분 텍스트 및 도구 스냅샷 옵트인, 상세한 WebSocket 누적기 스냅샷 보존 기능이 추가되었습니다. 전체 요약 6문장 읽기 → 089 03:11 ▲ 152 · 댓글 46 소프트웨어의 '그냥 안 되는' 일상화 저자는 문제의 원인을 추적할 수 없는 오류가 정상화되는 현상을 우려하고 있다. AI · 머신러닝 · The Normalization of Inexplicable Failures
Key Point AI 기반 기능이 배포되면서 '원인을 알 수 없는 장애'가 정상적인 것으로 받아들여지는 추세를 다루는데, 이는 개발 생산성과 품질 사이의 근본적인 긴장을 보여줍니다.
핵심 요약
저자는 문제의 원인을 추적할 수 없는 오류가 정상화되는 현상을 우려하고 있다. Jev 같은 AI 모델들은 빠르고 저렴하지만, 사용자는 반환값이 정말 작동하는지 검증할 평가 프레임워크(evals)를 구축해야 한다. 대부분의 개발자는 기술적 평가를 미루고 'AI 기반' 표시만 하고 배포한 뒤, 장애 발생 시 '음, AI는 실수한다'고 넘어간다. 전체 요약 9문장 읽기 → 090 21:11 ▲ 102 · 댓글 42 LLM으로 Jev 수준의 고속 의사결정 모델 구축하기 GLM-5.3-Flash를 프롬프트 엔지니어링으로 한 번의 forward pass에서 타입화된 의사결정을 내도록 개선했으며, 전문 의사결정 모델 Jev와 동등한 정확도를 달성했다. AI · 머신러닝 · Turning GLM-5.3-Flash into a Jev-like decision model
Key Point 일반 LLM을 구조화된 의사결정 모델로 탈바꿈시키는 프롬프트 기법이 전문 의사결정 모델과 실무 성능에서 동등하다는 것을 보여주므로, 고도량 의사결정 시스템 구축 시 모델 선택지와 비용-성능 트레이드오프 판단에 실질적 참고가 될 수 있다.
핵심 요약
GLM-5.3-Flash를 프롬프트 엔지니어링으로 한 번의 forward pass에서 타입화된 의사결정을 내도록 개선했으며, 전문 의사결정 모델 Jev와 동등한 정확도를 달성했다. 기본 아이디어는 LLM의 확률 분포에서 옵션별 확률을 직접 읽는 것이다. 숫자로 인덱싱된 옵션 목록을 JSON으로 제시하고 프롬프트를 'choice_index:'로 끝내면, 모델이 첫 토큰에서 내놓는 확률 분포가 각 옵션의 신뢰도가 된다. 29개 공개 데이터셋(2~151개 옵션, 의도 라우팅·감정 분석·법률 문서 등 포함)을 벤치마킹한 결과, GLM-5.3-Flash와 Jev의 정확도 차이는 중앙값 0.7 포인트로 통계적으로 유의미하지 않았다. 전체 요약 12문장 읽기 → 091 00:11 ▲ 17 · 댓글 3 오픈소스로 공개된 GLM 초거대 모델 학습법 Rufus-Air는 GLM-4.5-Air-Base(106B-A12B) 모델의 오픈 소스 포스트트레이닝 레시피로, SFT·Reasoning RL·Coding RL·Instruction-Following RL·General Agent·Coding Agent·Search Agent·RLHF 8단계 파이프라인으로 구성된다. AI · 머신러닝 · Rufus-Air: An Open LLM Post-Training Recipe
Key Point 106B급 거대 언어모델의 전체 학습 파이프라인을 완벽히 공개한 첫 사례로, 독립적인 모델 개발을 시도하는 연구팀과 기업들이 직접 참고할 수 있는 실증적 설계서다.
핵심 요약
Rufus-Air는 GLM-4.5-Air-Base(106B-A12B) 모델의 오픈 소스 포스트트레이닝 레시피로, SFT·Reasoning RL·Coding RL·Instruction-Following RL·General Agent·Coding Agent·Search Agent·RLHF 8단계 파이프라인으로 구성된다. 데이터·보상 설계·인프라·단계 순서·단계별 결과를 공개하여 누구나 재현할 수 있도록 했으며, 새로운 인간 주석이나 자체 증류 교사 없이 공개 데이터와 오픈소스 컴포넌트를 그대로 사용했다. 기초 능력부터 고급 능력으로 진행되며, 검증 가능한 보상에서 판사 기반 신호로 점진적으로 전환된다. 전체 요약 5문장 읽기 → 092 06:11 ▲ 106 · 댓글 27 Avast 안티바이러스 커널 드라이버 이중 Fetch 취약점 완전 분석 Avast 커널 드라이버의 CVE-2025-13032 이중 Fetch 취약점을 이용해 Windows 11에서 완전한 권한 상승 공격을 수행하는 방법을 상세히 기술한다. 보안 · CVE-2025-13032: Entering and Breaking the Avast Antivirus Sandbox Part 2
Key Point Avast 같은 주요 보안 소프트웨어의 커널 드라이버 취약점이 Windows 권한 상승까지 연쇄되는 과정을 보안 연구자들이 공개하며, 엔드포인트 보안 솔루션의 신뢰도 문제와 커널 드라이버 개발 시 이중 fetch 같은 기초적 문제의 위험성을 드러낸다.
핵심 요약
Avast 커널 드라이버의 CVE-2025-13032 이중 Fetch 취약점을 이용해 Windows 11에서 완전한 권한 상승 공격을 수행하는 방법을 상세히 기술한다. 취약점은 UNICODE_STRING 구조체의 Length 필드를 여러 번 읽으면서 발생하며, 첫 번째 읽기로 버퍼를 할당하고 두 번째 읽기로 데이터를 복사할 때 사이즈가 변경되면 Paged Pool 오버플로우가 발생한다. 공격자는 두 번째 스레드에서 Length 값을 계속 토글해 타이밍을 맞춰 오버플로우를 안정적으로 트리거할 수 있다. 전체 요약 10문장 읽기 → 093 06:11 ▲ 189 · 댓글 49 로컬에서 의사결정 AI 모델 실행하는 Ollaya 출시 Ollaya는 텍스트나 JSON 데이터에 대한 타입 안전 질문에 밀리초 단위로 답하는 의사결정 모델을 로컬에서 실행하는 오픈소스 도구다. AI · 머신러닝 · Ollaya – Ollama for open-source, Jev-style decision models
Key Point 자신의 서버에서 개인 데이터를 의사결정 AI로 분석할 때 기존 클라우드 API 대비 10-20배 빠르면서도 토큰 비용이 없으므로, 고객지원·분류·라우팅 등 대량의 의사결정이 필요한 시스템 구축에 큰 변화를 가져올 수 있다.
핵심 요약
Ollaya는 텍스트나 JSON 데이터에 대한 타입 안전 질문에 밀리초 단위로 답하는 의사결정 모델을 로컬에서 실행하는 오픈소스 도구다. 토큰 하나씩 생성하지 않고 단일 포워드 패스로 답을 반환해 RTX 4090에서 5개 질문 처리에 8-10ms 정도만 소요되며, 호스팅 API(TypeSafe Jev)의 236-276ms보다 훨씬 빠르다. TypeSafe의 API 스펙과 완벽히 호환되므로 공식 TypeSafe Python SDK 0.7.1을 수정 없이 로컬 서버에 연결할 수 있다. 전체 요약 7문장 읽기 → 094 22:29 ▲ 28 · 댓글 3 LLM 심판관을 저렴하게: 자신 없으면 상위 모델로 넘기기 LLM을 평가 심판관으로 쓸 때 비용과 신뢰도가 커질수록 문제가 되는데, 결정 전용 모델인 JEV로 1차 심사를 한 후 판단이 필요할 때만 강력한 모델에 넘기는 방식을 제안한다. AI · 머신러닝 · JEV-as-a-Judge: Accept When Confident, Escalate When Unsure
Key Point LLM을 심판으로 쓸 때 대부분의 판정은 저렴한 모델로 처리하되, 판단이 어려운 경우만 비싼 모델을 거쳐 전체 평가 비용을 대폭 줄일 수 있는 실용적 방법을 제시한다.
핵심 요약
LLM을 평가 심판관으로 쓸 때 비용과 신뢰도가 커질수록 문제가 되는데, 결정 전용 모델인 JEV로 1차 심사를 한 후 판단이 필요할 때만 강력한 모델에 넘기는 방식을 제안한다. 16가지 생성형 및 보상 모델 심판관과 블라인드 인간 검증으로 비교한 결과, JEV는 최고 성능 LLM 심판관 대비 일반적 선호도와 근거 기반 사실성 평가에서 3%p 범위 내 정확도를 유지하면서 비용은 0.36%에 불과했다. 미분 계산 확인이나 정교하게 쓰인 오답 저항 같은 복잡한 판단이 필요한 경우 JEV의 성능 격차가 커진다. 전체 요약 5문장 읽기 → 095 22:29 ▲ 16 · 댓글 2 LLM 코딩 벤치마크, 실제 실력 평가 아닌 암기 성공 가능성 SWE-bench 등 저장소 수준 코딩 벤치마크는 학습 데이터에 반복 사용된 인기 오픈소스 저장소 기반이라 데이터 유출 문제를 안고 있다. AI · 머신러닝 · Schrödinger's Code Repository: Have LLMs Learned SWE-bench or Memorized It?
Key Point LLM 코딩 평가 벤치마크가 실제 실력이 아닌 암기된 패턴 재인식을 측정하고 있을 가능성을 실증적으로 보여, SWE-bench 성능 신뢰도 문제를 제기한다.
핵심 요약
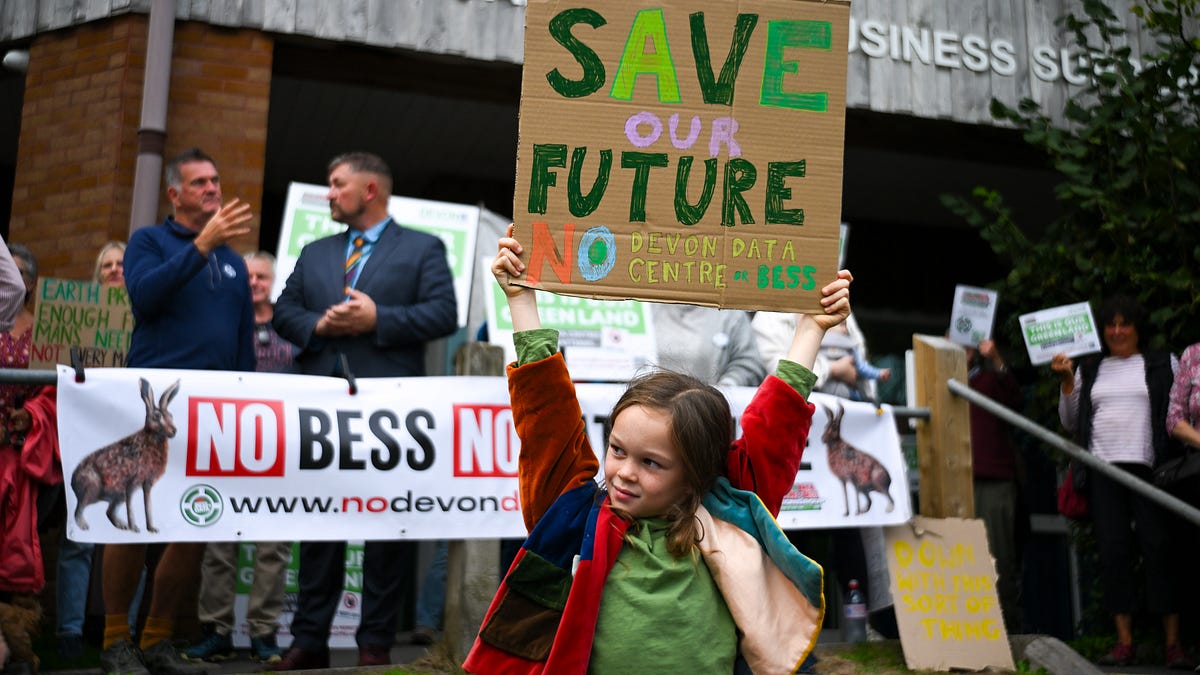
SWE-bench 등 저장소 수준 코딩 벤치마크는 학습 데이터에 반복 사용된 인기 오픈소스 저장소 기반이라 데이터 유출 문제를 안고 있다. 강한 성능이 실제 저장소 추론 능력이 아니라 표준화된 저장소 단서 암기를 반영할 가능성이 있다. SchrodingerRepo 평가 프레임워크를 제안하며, 정적 저장소 표현 대신 평가 시점에 동적으로 인스턴스화된 저장소를 사용한다. 전체 요약 7문장 읽기 → 096 22:29 ▲ 202 · 댓글 183 트럼프 행정부, AI 비판자들을 "외국 간첩"으로 표적 트럼프 행정부와 사법부가 AI 및 데이터센터 반대론자들을 중국의 대리인으로 규정하고, 해외 국가의 목표를 '추진하는' 행위를 공개 시위 포함 어떤 공개 활동에서든 하면 형사 책임을 지도록 경고했다. 보안 · Feds Target AI Critics as "Foreign Agents"
Key Point 정부가 광범위한 국민 우려를 '외국 음모'로 규정하고 비판자를 형사 소추하겠다고 위협하는 것은 언론·표현 자유와 국가 민주주의 감시 체계에 영향을 미치는 중요한 사건이다.
핵심 요약
트럼프 행정부와 사법부가 AI 및 데이터센터 반대론자들을 중국의 대리인으로 규정하고, 해외 국가의 목표를 '추진하는' 행위를 공개 시위 포함 어떤 공개 활동에서든 하면 형사 책임을 지도록 경고했다. 트럼프 대통령은 AI와 데이터센터 반대가 중국이 배후한 반역 음모라고 주장하며 반대론자들을 '혁명가, 반역자, 반신사'라 지칭했고, 형사 및 민사 사법제도를 통해 'BAD' 행위자들을 추적하겠다고 경고했다. 상원정보위원회 톰 코튼 의장은 상하이 거주 미국인 기술 재벌 네빌 로이 싱엄과 그의 좌파 비영리단체 네트워크가 중국공산당의 자금 지원을 받아 AI 인프라 반대 캠페인을 벌이고 있다고 주장하며 사법부에 조사를 요청했다. 전체 요약 9문장 읽기 → 097 18:11 ▲ 103 · 댓글 25 JevBench, 타입 기반 의사결정 모델의 재현 가능한 벤치마크 공개 JevBench는 Jev 1.13.0 등 타입 안전 의사결정 모델들을 일관된 기준으로 측정하는 벤치마크이며, Intelligence 85.1, Calibration 77.9, Speed 87.6, Cost 84.3 점 등으로 각 모델을 평가한다. 오픈소스 · 도구 · Show HN: JevBench, a reproducible benchmark for typed decision models
Key Point 타입 안전 의사결정 모델들의 성능을 객관적으로 비교할 수 있는 재현 가능한 벤치마크가 제공되어, 프로덕션 환경에서 어떤 모델을 선택할지 판단하는 기준이 명확해진다.
핵심 요약
JevBench는 Jev 1.13.0 등 타입 안전 의사결정 모델들을 일관된 기준으로 측정하는 벤치마크이며, Intelligence 85.1, Calibration 77.9, Speed 87.6, Cost 84.3 점 등으로 각 모델을 평가한다. Classifier.dev는 Jev 모델을 기반으로 하되 저신뢰도 응답에 추론 모델(Gemini 3.8 Flash)을 재질문하는 오케스트레이션 계층을 추가한 제품으로, 벤치마크에서 honorable mention으로 표시된다. Classifier.dev의 가격은 월 $20으로 일일 20만 건 분류 시 약 $0.0033/1,000 결정이며, 무료 티어(일일 2만 건)에서도 사용 가능하다. 전체 요약 4문장 읽기 → 098 21:11 ▲ 24 · 댓글 3 로봇 조작 실패 복구하는 AI 정책 프레임워크 공개 로봇 팔 조작 중 계획이 틀어지면 성능이 급격히 떨어지는 Vision-Language-Action(VLA) 정책의 문제를 해결하는 CARE 프레임워크를 개발했다. AI · 머신러닝 · CARE: Experience-Guided Atomic Corrective Execution for Vision-Language-Action Policies
Key Point 로봇 조작 작업의 안정성을 현저히 높이는 새로운 기법으로, 산업용 로봇이나 자동화 시스템의 신뢰도 문제를 실질적으로 개선할 수 있다.
핵심 요약
로봇 팔 조작 중 계획이 틀어지면 성능이 급격히 떨어지는 Vision-Language-Action(VLA) 정책의 문제를 해결하는 CARE 프레임워크를 개발했다. 실제 실패 사례를 수집해 그 패턴을 학습하고, 이를 바탕으로 대표적 실패 상황과 복구 방법을 합성해 훈련시킨다. 추론 시 3D 모니터링으로 실패를 감지하면 작업 진행도를 유지하면서 단계별로 미세 조정하거나 다시 시도한다. 전체 요약 5문장 읽기 → 099 18:10 ▲ 101 · 댓글 19 LLM을 분류기로 쓰지 말고 피처로 써야 하는 이유 LLM을 직접 분류기로 사용하면 신뢰도 보정, 정보 활용, 해석 가능성 측면에서 문제가 있다. AI · 머신러닝 · LLM Classification Is Feature Engineering
Key Point LLM을 분류 작업에 직접 쓰는 방식의 한계를 짚고 기존 머신러닝 기법과 결합하는 실용적 해법을 제시하므로, 프로덕션 환경에서 LLM 활용 방식을 고민하는 개발자에게 즉시 적용 가능한 인사이트를 준다.
핵심 요약
LLM을 직접 분류기로 사용하면 신뢰도 보정, 정보 활용, 해석 가능성 측면에서 문제가 있다. LLM의 판정을 로지스틱 회귀 같은 머신러닝 모델의 입력 피처로 취급하면 이러한 문제를 해결할 수 있다. 이 방식은 실제 확률값을 제공해 임계값을 조정할 수 있고, 구조화된 데이터와 다른 피처를 함께 활용할 수 있으며, 모델의 기여도를 명확히 볼 수 있다. 전체 요약 4문장 읽기 → 100 16:56 ▲ 114 · 댓글 8 DeepSeek, KV 캐시 압축으로 추론 속도 420 토큰/초 달성 DeepSeek-v4.1 Flash는 552B 매개변수 멀티모달 모델로, 에이전트 워크플로우에서 증가하는 컨텍스트와 도구 호출로 인한 프리필 계산 부담을 해결하기 위해 설계됐다. AI · 머신러닝 · DeepSeek-v4.1 Flash: Pushing the Limits of KV Cache Compression
Key Point 에이전트 워크플로우에서 일반적인 병목인 장문맥 프리필 계산과 KV 캐시 저장 비용을 획기적으로 줄인 새로운 모델 아키텍처 설계가 장기 맥락 처리와 배포 비용 절감에 어떻게 영향을 미치는지 보여준다.
핵심 요약
DeepSeek-v4.1 Flash는 552B 매개변수 멀티모달 모델로, 에이전트 워크플로우에서 증가하는 컨텍스트와 도구 호출로 인한 프리필 계산 부담을 해결하기 위해 설계됐다. KV 캐시 압축을 위해 채널·시퀀스·레이어 세 차원에서 최적화를 진행했으며, 같은 시퀀스 길이에서 런타임 KV 캐시는 v4-Flash의 1/4, 영구 저장소는 1/8 수준으로 줄었다. Causal Encoder-Decoder(CED) 아키텍처를 도입해 프리필 단계에서 8B, 디코딩 단계에서 16B 매개변수만 활성화되도록 설계했으며, 이는 입력 중심의 에이전트 시나리오에 특히 효율적이다. 전체 요약 12문장 읽기 →