쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
99건 · "실적"조건 지우기 ×
001 06:11 ▲ 140 · 댓글 213 특이점 이후 우리는 "그냥 놀지" 못할 것이다 AI 초지능 시대를 맞아 기존의 '무한한 휴가를 즐기며 지낸다'는 낙관론이 현실적이지 않다는 주장이다. AI · 머신러닝 · We won't "just hang out"
Key Point 기존의 AI 유토피아 상은 '일 없이 즐긴다'이지만, 저자는 그 과정에서 인간관계의 물질적·심리적 기초가 모두 무너질 것으로 진단한다.
핵심 요약
AI 초지능 시대를 맞아 기존의 '무한한 휴가를 즐기며 지낸다'는 낙관론이 현실적이지 않다는 주장이다. 일단 사람을 만날 이유가 사라진다. 일은 점차 무의미해지고, 교육도 노동 결과가 없으면 의미가 없어지며, 직업 공동체에서 만나던 우정도 AI가 인간 기여를 불필요하게 만들면서 사라진다. 청년 세대는 기성세대처럼 AI 이전의 관계망을 물려받을 수 없다. 전체 요약 8문장 읽기 → 002 15:11 ▲ 152 · 댓글 2 실시간 음성-영상 화자 추출, 경량화로 엣지 배포 가능해졌다 스트리밍 환경에서 특정 화자의 음성만 추출하는 기술(AVTSE)은 저지연이 필수인데, 기존 방식들은 두 가지 문제를 안고 있었다. AI · 머신러닝 · Efficient Streaming Audio-Visual Target Speaker Extraction for Real-World Acoustic Scenes
Key Point 실시간 음성 처리가 필요한 모바일·임베디드 환경에서 화자 분리의 실용성을 크게 높였으며, 기존 벤치마크의 문제를 해결한 현실적 평가 기준을 제시했다.
핵심 요약
스트리밍 환경에서 특정 화자의 음성만 추출하는 기술(AVTSE)은 저지연이 필수인데, 기존 방식들은 두 가지 문제를 안고 있었다. 첫째, 표준 벤치마크가 화자 2명만 고정하고 실제 환경의 근거리·원거리 간섭음, 음향 반향, 갑작스러운 잡음을 반영하지 않는다. 둘째, 고성능 인과관계 구조는 엣지 기기 배포에 너무 무겁고, 경량 대안도 작은 분리 모델을 반복 호출하면서 이득을 상쇄한다. 전체 요약 8문장 읽기 → 003 03:11 ▲ 16 · 댓글 2 AI 에이전트가 언어모델을 자동으로 개선할 수 있을까 언어모델의 자동 개선(재귀적 자기개선)을 평가하는 'ParetoRSI-Gym' 벤치마크를 제안했다. AI · 머신러닝 · ParetoRSI-Gym: Can AI Agents Improve Language Models Across Multiple Domains?
Key Point 다중 도메인 환경에서 AI 에이전트가 언어모델을 자동으로 개선할 수 있는지를 체계적으로 평가하는 첫 시도로, 한 분야의 성능 향상이 다른 분야를 해치는 트레이드오프까지 고려한 현실적 평가 틀을 제시한다.
핵심 요약
언어모델의 자동 개선(재귀적 자기개선)을 평가하는 'ParetoRSI-Gym' 벤치마크를 제안했다. 에이전트가 데이터를 검색·선별하고 모델을 훈련한 뒤 도메인별 결과를 읽으며 반복하는 과정을 시뮬레이션한다. 수학·코드·금융·의학·과학 다섯 개 도메인에서 성능을 측정하되, 각 도메인마다 과적합 판단용 별도 벤치마크를 둔다. 전체 요약 7문장 읽기 → 004 00:11 ▲ 12 · 댓글 2 대화형 AI의 '절차적 환각' 측정하는 벤치마크 공개 LLM 기반 대화 에이전트는 절차적 논리를 따라야 하지만, 사실적으로는 그럴듯하면서도 의도된 대화 프로세스에서 벗어나는 '절차적 환각' 오류가 간과되어 왔다. AI · 머신러닝 · DialFork: Going Beyond Factuality to Evaluate Procedural Hallucination in Conversational Agents
Key Point 대화형 AI가 단순히 그럴듯한 답변만 하는 게 아니라 올바른 절차를 따르는지 평가하는 새로운 방식이 필요해지면서, 이를 표준화할 수 있는 벤치마크가 제시되었기 때문이다.
핵심 요약
LLM 기반 대화 에이전트는 절차적 논리를 따라야 하지만, 사실적으로는 그럴듯하면서도 의도된 대화 프로세스에서 벗어나는 '절차적 환각' 오류가 간과되어 왔다. 연구진이 처음으로 이를 측정하는 벤치마크 'DialFork'를 제안했으며, 12개 영역의 24개 작업에서 36,278개 대화로 구성되어 있다. 원본 대화를 특정 지점에서 포크한 후 4가지 유형의 환각을 주입하는 방식으로 구축했으며, 30명의 인간 주석자가 검증했다. 전체 요약 7문장 읽기 → 005 00:11 ▲ 136 · 댓글 57 미국 PCB 공장 더 그리드, 선전보다 2배 빠르고 저렴 미국 매사추세츠의 자동화 공장 더 그리드를 공개했으며, 주문형 회로기판을 제조한다. 하드웨어 · 시스템 · Unveiling The Grid: PCBs made in America, twice as fast as Shenzhen
Key Point 미국 내 자동화 기술로 선전 제조보다 납기는 5배 빠르고 총 비용은 경쟁력 있게, 서방 전자 공급망 재구축의 현실적 가능성을 보여준다.
핵심 요약
미국 매사추세츠의 자동화 공장 더 그리드를 공개했으며, 주문형 회로기판을 제조한다. 과거 30년간 전자제품 제조업이 저임금 국가로 이동했으나, 자동화가 이를 바꾸고 있다. 기존 자동화는 스타링크처럼 대량 단일 제품에만 경제적이었고, 고혼합 소량 생산은 해외나 비싼 업체를 선택해야 했다. 전체 요약 9문장 읽기 → 006 12:11 ▲ 15 · 댓글 2 특허 심사 자동화하는 AI 에이전트 벤치마크 공개 특허 심사는 선행기술 발굴, 질의 개선, 증거 검토, 심사의견서 작성을 반복하는 복잡한 과제인데 기존 벤치마크는 정적이고 제한된 후보군만 다뤘다. AI · 머신러닝 · Novel or Not? PatEx-Gym: Agentic Prior-Art Search for Novelty Assessment in Patent Examination
Key Point 특허 심사 자동화는 방대한 기술 문헌 검색과 복합적 추론이 필요한 영역으로, 이 벤치마크는 에이전트 기술의 실제 활용 가능성을 보여주는 현실적 테스트 사례가 된다.
핵심 요약
특허 심사는 선행기술 발굴, 질의 개선, 증거 검토, 심사의견서 작성을 반복하는 복잡한 과제인데 기존 벤치마크는 정적이고 제한된 후보군만 다뤘다. 연구진이 특허 심사 에이전트 개발·평가를 위한 첫 번째 프레임워크 PatEx-Gym을 발표했다. PatEx-Bench는 1000개의 실제 심사 과제, 100만 개 이상의 특허와 5만2000개 과학 논문 데이터베이스, 반복 검색과 문서 방문·추론·심사의견서 생성을 지원하는 런타임을 제공한다. 전체 요약 7문장 읽기 → 007 12:11 ▲ 88 · 댓글 2 로봇 정책 개선을 위한 세계모델 역추적 기법 Rollback 행동 조건 세계모델을 이용한 정책 개선 연구에서, 기존 방식은 세계모델을 물리 환경의 순방향 시뮬레이터로만 사용했다. AI · 머신러닝 · Rollback: Experience Backtracking in World Models for Policy Improvement
Key Point 세계모델이 단순한 시뮬레이터를 넘어 과거로 돌아가 대안을 탐색할 수 있게 되면서, 로봇 정책 학습의 효율성과 수렴 속도가 근본적으로 달라진다.
핵심 요약
행동 조건 세계모델을 이용한 정책 개선 연구에서, 기존 방식은 세계모델을 물리 환경의 순방향 시뮬레이터로만 사용했다. 새로운 Rollback 기법은 세계모델을 역추적 가능한 반사실적 엔진으로 변환하여, 과거의 결정 지점으로 돌아가 대안 행동을 탐색한다. 성공과 실패의 결과를 대비하여 행동 수준의 세밀한 감시 신호를 생성하며, 별도의 가치 모델 없이도 상상을 문제해결에 집중시킨다. 전체 요약 8문장 읽기 → 008 09:11 ▲ 10 · 댓글 2 언어 모델로 초고속 추천 시스템 구축 언어 모델의 풍부한 이해 능력을 활용하면서도 온라인 서빙 속도를 확보하기 위해 DuoLM이라는 프레임워크를 제안했다. AI · 머신러닝 · DuoLM: Fast and Effective Personalized Recommendation with Language Models
Key Point LLM의 이해력을 보존하면서 실제 프로덕션 환경에서 필요한 60배 수준의 처리 성능을 달성한 추천 시스템 최적화 기법으로, 대규모 온라인 서비스에서 언어 모델 활용의 현실적 경로를 보여준다.
핵심 요약
언어 모델의 풍부한 이해 능력을 활용하면서도 온라인 서빙 속도를 확보하기 위해 DuoLM이라는 프레임워크를 제안했다. 인코더 LLM이 오프라인에서 아이템의 간결한 표현을 학습하고, 개인화 랭커 LLM이 이를 사용자 이력과 피드백과 결합해 추천 점수를 계산한다. 두 모델을 추천 감독과 교사 증류를 통해 함께 학습해 정확도를 유지하면서 효율성을 높였다. 전체 요약 6문장 읽기 → 009 03:11 ▲ 28 · 댓글 2 LLM 연구 에이전트가 만든 하스스톤 AI, 최상위 플레이어 능가 LLM 연구 에이전트들로 구성된 자기개선 시스템 AutoTavern이 8인 자동배틀게임 하스스톤 배틀그라운드의 완전한 시뮬레이터를 20일 만에 개발했다. AI · 머신러닝 · Build, Don't Play: Self-Improving LLM Research Agents Develop a Hearthstone Battlegrounds AI That Rivals Top Players
Key Point LLM 에이전트가 자동 개선 루프를 통해 최첨단 게임 AI를 개발하고 인간 최강자를 능가한 사례로, 에이전트 연구의 현실적 가능성과 한계를 보여줍니다.
핵심 요약
LLM 연구 에이전트들로 구성된 자기개선 시스템 AutoTavern이 8인 자동배틀게임 하스스톤 배틀그라운드의 완전한 시뮬레이터를 20일 만에 개발했다. AutoTavern은 특화된 LLM 에이전트들이 타입화된 연구 메모리를 공유하고, 모든 주장이 검증 단계를 거치며, 실제 게임을 통해 피드백 루프가 닫혀 있어 시뮬레이터, 상대 AI, 정책, 연구 과정까지 동시에 개선된다. TavernAgent는 PPO로 학습되어 23개 버전을 거쳤으며, 실제 게임 래더에서 등급이 6,000에서 약 15,000으로 올랐다. 전체 요약 7문장 읽기 → 010 03:11 ▲ 144 · 댓글 67 Anthropic, 스탠포드 교수 저작권 침해로 $1.5억 합의금 지급 연방 판사는 2026년 5월 Anthropic이 허가 없이 스탠포드 교수 10명 이상의 저작물을 스크랩하여 Claude 모델 학습에 사용했다고 판결했다. AI · 머신러닝 · Anthropic trained Claude on illegally obtained Stanford professors' books
Key Point Claude 개발사인 Anthropic이 불법 복제로 수억 달러 합의를 한 사건인데, 판사는 여전히 AI 학습용 저작물 취득을 공정 이용으로 인정해 AI 학습과 창작자 권리 간 법적 경계가 모호한 상황을 드러낸다.
핵심 요약
연방 판사는 2026년 5월 Anthropic이 허가 없이 스탠포드 교수 10명 이상의 저작물을 스크랩하여 Claude 모델 학습에 사용했다고 판결했다. Bartz v. Anthropic 사건에서 판사는 불법 복제를 금지하되, 저작권 취득을 통한 LLM 학습은 공정 이용으로 인정했다. 저작권 소유자 50만여 건에 대해 $1.5억의 합의금이 배정되었다. 전체 요약 10문장 읽기 → 011 03:11 ▲ 298 · 댓글 164 구글 DeepMind, 음성·대사까지 생성하는 세계 시뮬레이션 모델 'Genie 4' 공개 DeepMind가 세계 시뮬레이션 모델 'Genie 4'를 발표했으며, 음악·주변음·대화까지 실시간으로 함께 생성하는 네이티브 멀티모달 모델이다. AI · 머신러닝 · Genie 4
Key Point 텍스트·이미지·비디오에 이어 이제 오디오까지 생성하는 세계 시뮬레이션이 실시간 상호작용 수준에 도달했으며, AI 영상 생성 기술의 새로운 기준을 제시한다.
핵심 요약
DeepMind가 세계 시뮬레이션 모델 'Genie 4'를 발표했으며, 음악·주변음·대화까지 실시간으로 함께 생성하는 네이티브 멀티모달 모델이다. Gemini Omni를 활용해 사실적인 외관과 동작을 앵커링하고, 다른 Gemini 모델들이 복잡한 추론으로 시뮬레이션 일관성을 유지한다. 사용자가 자연어로 실시간 날씨 변경·카메라 이동·객체 추가 같은 지시를 내리면 Gemini가 맥락에 맞게 적응시키며, 사용자 입력 사이에도 장면이 일관성 있게 진행된다. 전체 요약 12문장 읽기 → 012 21:11 ▲ 16 · 댓글 2 다중모달 추론 모델, 공개 데이터로 효율적 학습 방법 제시 멀티모달 추론 모델 학습의 병목인 데이터 품질 저하, 비효율적 감독 구성, 난이도 불균형, 도메인 간 간섭을 해결하기 위해 MMVistaReason(MVR)을 제안했다. AI · 머신러닝 · MMVistaReason: Toward Open-Data and Post-Training Recipes for Multimodal Reasoning
Key Point 멀티모달 추론 모델의 공개 학습 레시피가 상용 대규모 모델 대비 효율성과 성능을 동시에 달성하는 구체적 방법을 보여주므로, 오픈소스 멀티모달 AI 개발에 실질적 기준을 제시한다.
핵심 요약
멀티모달 추론 모델 학습의 병목인 데이터 품질 저하, 비효율적 감독 구성, 난이도 불균형, 도메인 간 간섭을 해결하기 위해 MMVistaReason(MVR)을 제안했다. 분석적 추론과 실제 추론으로 나눈 광범위한 학습 데이터로 구조적 추론과 시각 지각·공간 이해를 모두 커버한다. 구조화된 정제와 주석, 난이도 인식 증류, 답변 확률 기반 궤적 선택으로 SFT용 52.8만 개 샘플(MVR-SFT-528K)과 RL용 6.3만 개 샘플(MVR-RL-63K)을 효율적으로 구성했다. 전체 요약 9문장 읽기 → 013 15:11 ▲ 117 · 댓글 2 AI 에이전트가 신뢰할 수 있는 업무를 수행하려면 파운데이션 모델이 정보 생성에서 디지털 업무 실행으로 진화하면서 복잡한 작업을 여러 도구와 애플리케이션, 워크플로우에서 완수하는 에이전트가 등장했다. AI · 머신러닝 · Work Agents: Systems, Capabilities, and Optimization
Key Point 에이전트 기술이 실제 업무 자동화로 확대되는 시점에 신뢰성 있는 작업 수행의 조건과 평가 방식을 체계적으로 정리한 프레임워크로, AI 에이전트의 현실적 배포를 고민하는 개발자와 연구자에게 실질적 지침을 준다.
핵심 요약
파운데이션 모델이 정보 생성에서 디지털 업무 실행으로 진화하면서 복잡한 작업을 여러 도구와 애플리케이션, 워크플로우에서 완수하는 에이전트가 등장했다. 이 논문은 에이전트를 파운데이션 모델과 런타임 하니스를 결합해 상태 관리 워크스페이스에서 작업을 실행하고 검증 가능한 결과를 전달하는 시스템으로 정의한다. 작업 지속성과 작업 개방성 두 차원으로 작업 조건을 분류하고, 작업 범위와 조직에 따라 디지털 업무를 다섯 가지 형태로 구분했다. 전체 요약 6문장 읽기 → 014 15:11 ▲ 123 · 댓글 2 사람의 물리적 행동을 돕는 AI 어시스턴트 평가 벤치마크 공개 착용형 기기의 다중모달 대형언어모델(MLLM) 어시스턴트가 사용자를 가이드하고 지시하는 상황을 평가하기 위해 InteractiveWorld라는 검증 가능한 환경을 제안했다. AI · 머신러닝 · InteractiveWorld: A Verifiable Human-Centric Environment for Building Better Interactive MLLM Assistants
Key Point 지능형 어시스턴트가 실제로 사람의 물리적 작업을 도울 수 있는지 검증할 수 있는 표준화된 평가 체계가 처음 등장했으며, 현재 최신 모델들의 성능 한계가 명확히 드러났기 때문이다.
핵심 요약
착용형 기기의 다중모달 대형언어모델(MLLM) 어시스턴트가 사용자를 가이드하고 지시하는 상황을 평가하기 위해 InteractiveWorld라는 검증 가능한 환경을 제안했다. 기존 로봇 중심 시뮬레이터와 달리 InteractiveWorld는 AI 어시스턴트가 사람 에이전트에게 지시하고, 사람이 관찰·이해·독립적으로 행동하는 폐루프 상호작용을 현실적으로 모의한다. 어시스턴트의 명령이 실제 결과를 좌우하며, 상태 기반 리워드로 검증 가능하게 채점되는 방식이다. 전체 요약 6문장 읽기 → 015 15:11 ▲ 50 · 댓글 2 보상 해킹을 막는 정밀도 기반 강화학습 루브릭 기반 강화학습은 검증 불가능한 작업에서 효과적이지만, 루브릭 커버리지의 가중치로만 보상을 정의해 재현율만 최대화하는 문제가 있다. AI · 머신러닝 · Eat Your Precision: Precision Objective Mitigates Reward Hacking in Rubric-based RL
Key Point 강화학습 보상 함수 설계의 핵심 문제인 목적 왜곡(reward hacking)을 정밀도 메트릭으로 체계적으로 해결하는 방법이 의료·건강 등 신뢰도가 중요한 분야에서 큰 성능 개선을 보여주고 있다.
핵심 요약
루브릭 기반 강화학습은 검증 불가능한 작업에서 효과적이지만, 루브릭 커버리지의 가중치로만 보상을 정의해 재현율만 최대화하는 문제가 있다. 이로 인해 RL 학습 모델은 내용이 길고 불필요하거나 사실적으로 틀린 부분이 많아져 기본 모델보다 선호도가 낮아진다. 이를 해결하기 위해 FORK 보상을 제시하는데, 이는 재현율과 함께 정밀도 목적을 동시에 최적화한다. 전체 요약 7문장 읽기 → 016 21:12 ▲ 298 · 댓글 2 비디오 기초 모델부터 세계 모델까지, 영상 이해와 생성의 통합 관점 비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. AI · 머신러닝 · Reading, Writing, Sharing, and Interacting with the World through Video
Key Point 비디오 이해와 생성의 현주소를 통합적으로 정리한 메타 서베이로, 향후 연구의 방향성이 '보이는 것'에서 '일어나는 일'의 타당성으로 전환되고 있음을 보여준다.
핵심 요약
비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. 이 논문은 세계 모델링을 통합 렌즈로 삼아 두 분야를 함께 조망한다. 관찰된 비디오를 잠재된 시간적 세계의 부분적·손실적·시간순 투영으로 보고, 네 가지 보완적 작업으로 문헌을 정리한다: reading은 비디오에서 세계 성질을 추론하고, writing은 지정되거나 학습된 세계 조건에서 비디오를 생성하며, sharing은 공통 모델링 메커니즘을 통해 이해와 생성을 통합하고, interacting은 행동과 진화하는 관찰 아래서 세계 상태를 예측하고 업데이트한다. 전체 요약 5문장 읽기 → 017 12:11 ▲ 224 · 댓글 185 AI가 이전 불가능했던 소프트웨어를 현실로 만든다 AI 능력의 급격한 향상으로 이전엔 비용이 너무 커서 시도하지 않던 소프트웨어 프로젝트들이 이제 실현 가능해졌다. AI · 머신러닝 · We should be more ambitious with the software we build
Key Point AI 모델의 성능 급증으로 불가능했던 소프트웨어 개발이 현실화되는 한편, 누가, 어떤 조건에서 이를 활용할 수 있는지가 핵심 관심사다.
핵심 요약
AI 능력의 급격한 향상으로 이전엔 비용이 너무 커서 시도하지 않던 소프트웨어 프로젝트들이 이제 실현 가능해졌다. PostgreSQL을 Rust로 재작성하는 pgrust 프로젝트는 철저한 테스트 과정에서 PostgreSQL 내 수치 버그, JSONPath 포맷 캐시 버그, 메모리 안전 버그 등 여러 실제 버그를 발견했으며, 성능 최적화에 초점을 맞추고 있다. 저자는 정규표현식 엔진, ripgrep 포크, Rust 컴파일 속도 개선 도구 등을 몇 시간 내에 구현했는데, 5년 전이라면 1년 이상 걸렸을 작업들이다. 전체 요약 10문장 읽기 → 018 06:11 ▲ 223 · 댓글 184 AI 투자, 테크 기업 외엔 실적 나타나지 않아 AI에 대규모 투자와 기대가 쏟아졌음에도 테크 기업을 제외한 미국 기업들에선 재정적 성과가 전혀 나타나지 않고 있다. AI · 머신러닝 · No Signs of AI Payoff Outside the Tech Sector
Key Point 생산성과 수익성 데이터로 본 AI의 실제 경제 효과가 기대와 다른 만큼, 기술 투자 의사결정과 경제 전망을 다시 평가해야 하는 시점이다.
핵심 요약
AI에 대규모 투자와 기대가 쏟아졌음에도 테크 기업을 제외한 미국 기업들에선 재정적 성과가 전혀 나타나지 않고 있다. 매그7 대형 테크 기업들의 1인당 매출과 이윤률은 상승했지만, S&P 493 나머지 기업들의 같은 지표는 정체 상태다. 생산성 증가에도 여전히 AI의 영향이 없어 메인스트림 기업들이 AI 토큰 지출을 성장 동력이 아닌 비용 부담으로 보기 시작했다. 전체 요약 9문장 읽기 → 019 00:11 ▲ 269 · 댓글 278 무스크의 우크라이나 스타링크 제한, 유럽에 미국 기술 의존도 위험성 인식시키다 무스크가 우크라이나에 제공되던 Starshield(군사용 Starlink)를 개인적 판단으로 중단·제한하면서 유럽 정책결정권자들에게 큰 충격을 줬다. 스타트업 · 비즈니스 · Elon Musk Just Gave Europe a Reason to Replace American Technology
Key Point 미국 기술 기업의 일방적 결정이 지정학적 리스크로 인식되면서 향후 수십 년간 미국 기술 기업의 유럽 시장 영향력과 수익성이 근본적으로 위협받을 수 있기 때문이다.
핵심 요약
무스크가 우크라이나에 제공되던 Starshield(군사용 Starlink)를 개인적 판단으로 중단·제한하면서 유럽 정책결정권자들에게 큰 충격을 줬다. 수년간 유럽은 미국이 미국 기술의 스위치를 일방적으로 끌 수 있다는 우려를 제기해왔지만, 이번 사건으로 그것이 현실임이 증명되었다. 유럽 지도자들은 이제 Microsoft, OpenAI, Google 등 다른 미국 CEO들도 언제든 제품 접근을 제한할 수 있다는 시나리오를 더 이상 비현실적이라고 보지 않는다. 전체 요약 7문장 읽기 → 020 21:11 ▲ 115 · 댓글 32 AI 이미지 생성 실전 가이드: 확산부터 에이전트까지 AI 이미지 생성 모델은 크게 확산형과 멀티모달형으로 나뉜다. 확산형은 노이즈에서 시작해 단계별로 정제하며 텍스트 인코더가 프롬프트를 수치로 변환해 방향을 제시한다. 멀티모달형은 언어와 이미지를 함께 이해해 지시 따르기와 텍스트 렌더링에 강하며, 대부분 내부적으로 계획 후 그린다. AI · 머신러닝 · A practical guide to AI image generation, from diffusion to agents
Key Point 이미지 생성 API 가격, 프롬프트 작성법, 모델별 강점이 구체적인 수치와 실험 사례로 제시돼 있어 프로덕션 코드에 통합하거나 비용을 최적화하려는 개발자에게 실질적 지침이 된다.
핵심 요약
AI 이미지 생성 모델은 크게 확산형과 멀티모달형으로 나뉜다. 확산형은 노이즈에서 시작해 단계별로 정제하며 텍스트 인코더가 프롬프트를 수치로 변환해 방향을 제시한다. 멀티모달형은 언어와 이미지를 함께 이해해 지시 따르기와 텍스트 렌더링에 강하며, 대부분 내부적으로 계획 후 그린다. 2014년 GAN부터 2026년 현재까지 AI 이미지 기술은 여섯 손가락 같은 비현실적 오류와 텍스트 인식 문제를 거의 해결했다. 문제의 원인은 모델이 손 형태를 텍스처로만 학습했기 때문이고, 토크나이저가 글자 대신 단어 단위로 처리했기 때문이다. ChatGPT의 GPT Image 모델은 3월 2025년부터 기본 이미지 생성기이며, 대화식 편집과 지시 따르기에 강하지만 시드 제어가 없고 측면 비율이 제한돼 있다. API를 쓸 때는 다양한 크기와 품질 계층, 배치 처리가 가능하다. 전체 요약 11문장 읽기 → 021 03:11 ▲ 17 · 댓글 2 에이전트 비전 작업 평가 벤치마크 공개 비전-언어 모델(VLM)의 에이전트 환경에서의 성능을 평가하기 위해 AgentVQA 벤치마크를 개발했다. AI · 머신러닝 · AgentVQA: A Unified Benchmark for Agentic Visual Understanding
Key Point 에이전트 AI 성능 평가의 새로운 표준으로, VLM이 실제 상호작용 환경에서 어디서 약한지 구체적으로 보여준다.
핵심 요약
비전-언어 모델(VLM)의 에이전트 환경에서의 성능을 평가하기 위해 AgentVQA 벤치마크를 개발했다. 웹 에이전트, 로봇, 일인칭 영상, 게임, 공간 계획 등 5개 도메인의 에이전트 시나리오를 포함한다. 23개 소스 데이터셋에서 1000개의 도전적인 실제 에이전트 예시를 수동으로 선별하고 오프라인 평가용으로 적응시켰다. 전체 요약 7문장 읽기 → 022 18:11 ▲ 58 · 댓글 2 로봇이 자신의 학습 방식까지 개선하는 방법 재귀적 자기개선(RSI)은 시스템이 행동뿐 아니라 개선 과정 자체를 향상시키는 개념으로, 디지털 에이전트에서는 코드 재작성과 테스트로 구현되고 있다. AI · 머신러닝 · Toward Recursive Self-Improvement in Physical AI
Key Point 로봇이 단순히 작업을 더 잘하는 데 그치지 않고 학습하는 방식 자체를 개선하는 자기개선 시스템의 원리와 현실적 제약을 종합적으로 다루는 논문으로, 물리 AI의 다음 단계를 엿볼 수 있다.
핵심 요약
재귀적 자기개선(RSI)은 시스템이 행동뿐 아니라 개선 과정 자체를 향상시키는 개념으로, 디지털 에이전트에서는 코드 재작성과 테스트로 구현되고 있다. 물리적 세계의 로봇에 이를 적용하려면 비용이 큰 시행착오를 통해 불완전한 정보에서 학습하면서, 변화하는 환경과 돌이킬 수 없는 결과를 고려해야 한다. 논문은 로봇 학습 내에서 RSI의 위치를 정의하고, 로봇 능력 개선에서 그 과정 개선까지의 경로를 추적한다. 전체 요약 7문장 읽기 → 023 21:11 ▲ 24 · 댓글 2 합성 데이터 없이 실제 이미지로 훈련하는 장면 글자 편집 장면 글자 편집(STE)은 원본 스타일을 유지하면서 텍스트 내용을 수정하는 기술로, 기존 접근법들은 합성 쌍 데이터에 의존해 실제 장면의 다양성을 제대로 포착하지 못하고 인공물을 생성하는 문제가 있다. AI · 머신러닝 · Real In, Real Out: What If We Only Use Real Data for Scene Text Editing?
Key Point 실제 이미지만으로 학습하면서도 합성 데이터에 의존하는 기존 방식의 도메인 격차 문제를 해결하고, 나아가 글자 인식 모델의 성능까지 높일 수 있다는 점이 중요하다.
핵심 요약
장면 글자 편집(STE)은 원본 스타일을 유지하면서 텍스트 내용을 수정하는 기술로, 기존 접근법들은 합성 쌍 데이터에 의존해 실제 장면의 다양성을 제대로 포착하지 못하고 인공물을 생성하는 문제가 있다. 논문은 실제 샘플 하나를 여러 방식으로 손상시켜(자르기, 섞기, 마스킹 등) 자체 쌍 학습 데이터를 만드는 방식으로, 합성 데이터 없이 훈련이 가능한지 탐구했다. TextRIRO는 조건부 확산 모델 기반의 기준 모델로, 문자 열 섞기와 이미지 자르기(Shuffle&Crop)를 결합할 때 텍스트 의미는 파괴하면서 스타일 단서는 보존하여 모델이 실제 텍스트 이미지에서 직접 편집 행동을 학습할 수 있다. 전체 요약 6문장 읽기 → 024 15:11 ▲ 88 · 댓글 2 컴퓨터 사용 AI 에이전트, 오픈소스로 학습 환경 대규모 생성 Agent World Model in the Wild(WildAWM)는 컴퓨터 사용 에이전트(CUA) 학습을 위한 대규모 환경 합성 파이프라인으로, 실제 시스템에서의 위험 없이 상호작용 학습을 가능하게 한다. AI · 머신러닝 · Agent World Model in the Wild: Computer-Use Agent Environment Synthesis
Key Point 컴퓨터 상호작용을 수행하는 AI 에이전트 학습이 실제 환경의 안전 위험 없이 대규모로 가능해지는 방법이 제시되었고, 오픈소스만으로 구축 가능함을 입증했다.
핵심 요약
Agent World Model in the Wild(WildAWM)는 컴퓨터 사용 에이전트(CUA) 학습을 위한 대규모 환경 합성 파이프라인으로, 실제 시스템에서의 위험 없이 상호작용 학습을 가능하게 한다. 기존 단일 인터페이스 접근과 달리, 그래픽 사용자 인터페이스·모델 컨텍스트 프로토콜 서비스·커맨드 라인 인터페이스를 함께 지원해 시각 상호작용·도구 사용·코드 실행을 자유롭게 조합할 수 있다. 오픈소스 모델만으로 구성되어 있으며, 폐쇄형 최신 모델 없이도 고품질 컴퓨터 사용 환경 생성이 가능함을 보여준다. 전체 요약 7문장 읽기 → 025 06:11 ▲ 12 · 댓글 2 데이터 레이크 분석 AI, 스스로 도구를 진화시킨다 데이터 레이크 분석을 위한 코딩 에이전트가 매번 작업을 처음부터 다시 하는 문제를 해결하기 위해, 재사용 가능한 도구를 자동으로 구축하고 개선하는 '도구 진화' 방식을 제안했다. AI · 머신러닝 · Unsupervised Tool Evolution for Coding Agents in Data-Lake Analytics
Key Point 데이터 분석 작업을 자동화하는 AI 에이전트가 라벨 없이 스스로 도구를 학습·개선할 수 있다는 점이 실무 적용에 중요하며, 특히 단계 예산 제한이라는 현실적 제약에서 성능 향상을 달성한 것이 의미 있다.
핵심 요약
데이터 레이크 분석을 위한 코딩 에이전트가 매번 작업을 처음부터 다시 하는 문제를 해결하기 위해, 재사용 가능한 도구를 자동으로 구축하고 개선하는 '도구 진화' 방식을 제안했다. 라벨 없이 도구를 진화시키는 TEAL(Tool Evolution for Analytics over data Lakes)은 두 에이전트가 서로 다른 증거에서 도구를 제안한다: Explorer는 데이터 레이크 자체에서, Critic은 Worker의 작업 궤적에서 도구를 제안한다. 제안된 변화는 Worker가 재실행 시 추가 단계 없이 도구를 채택하고, 변경된 답변이 궤적 증거로 뒷받침될 때만 유지된다. 전체 요약 9문장 읽기 → 026 21:11 ▲ 378 · 댓글 408 1.5°C 목표는 불가능...2°C 억제 후 역전 추진 UN 환경계획(UNEP)의 2026 배출격차보고서는 파리협정의 1.5°C 목표가 이제 달성 불가능하며, 1.5°C 초과는 피할 수 없다고 선언했다. 기타 · The 1.5°C goal of the Paris Agreement is no longer viable
Key Point 기후 목표의 현실적 실패를 인정하고 대안 전략으로 전환하는 만큼, 앞으로의 감축 목표와 필요한 기술·정책 변화를 파악하는 것이 중요하다.
핵심 요약
UN 환경계획(UNEP)의 2026 배출격차보고서는 파리협정의 1.5°C 목표가 이제 달성 불가능하며, 1.5°C 초과는 피할 수 없다고 선언했다. 새로운 전략은 지구 온난화를 2°C 이하로 제한한 뒤 21세기 말까지 1.5°C로 되돌리는 것이다. 2035년까지 5~8% 감축이라는 현재 정부 공약(NDC)은 필요한 18% 감축에 한참 못 미치며, 2040년까지는 69% 감축이 필요하다. 전체 요약 8문장 읽기 → 027 12:11 ▲ 48 · 댓글 2 4단계만에 현실감 있는 영상 생성하는 구조 기반 렌더러 게임 엔진이나 코딩 에이전트가 장면의 레이아웃, 모션, 카메라를 지정하지만 이를 사실적인 영상으로 변환하려면 구조를 따르면서 외형을 채우는 렌더러가 필요하다. AI · 머신러닝 · SolarRenderer: Few-Step Generative Reference Rendering
Key Point 기존 50단계가 필요했던 구조 기반 렌더링을 4단계로 단축하면서도 미학습 표현 11개에 일반화되는 성과로, 게임 엔진 통합과 실시간 스트리밍 렌더링이 가능해진다.
핵심 요약
게임 엔진이나 코딩 에이전트가 장면의 레이아웃, 모션, 카메라를 지정하지만 이를 사실적인 영상으로 변환하려면 구조를 따르면서 외형을 채우는 렌더러가 필요하다. 기존 렌더러는 특정 엔진 표현에 종속되거나 수십 단계의 노이즈 제거가 필요하거나 별도의 비용 많이 드는 증류 과정이 필수다. SolarRenderer는 고정된 MiniMax-H3 33B 백본을 두 개의 가벼운 LoRA로 적응시킨 구조 조건 비디오 렌더러다. 전체 요약 8문장 읽기 → 028 09:11 ▲ 142 · 댓글 63 AI 코딩 에이전트 벤치마크, 고사양 세팅이 역효과 SlopCodeBench 10월 업데이트는 36개 문제, 196개 체크포인트에서 frontier 모델을 평가했으며, GPT-6 Astra XHigh가 16.33% strict pass rate로 최고 성과를 기록했다. AI · 머신러닝 · SlopCodeBench 10/2026 – Opus 5.5, Astra wins overall, xhigh considered harmful
Key Point 코딩 에이전트의 실제 성능을 측정하는 벤치마크에서 higher-effort 설정이 역효과를 낼 수 있다는 결과는 AI 모델 평가 방식 자체를 재검토하게 하며, 에이전트 기반 개발 도구의 현실적 한계를 드러낸다.
핵심 요약
SlopCodeBench 10월 업데이트는 36개 문제, 196개 체크포인트에서 frontier 모델을 평가했으며, GPT-6 Astra XHigh가 16.33% strict pass rate로 최고 성과를 기록했다. Opus 5.5는 Medium 세팅에서 28/196 strict pass를 기록했지만, XHigh 세팅에서는 25/196으로 하락했는데, XHigh는 Medium 대비 2.11~4.22배 높은 비용이 든다. Opus 5.5의 경우 strict pass는 감소했으나 코드 정결성 점수가 94.25%에서 77.75%로 크게 개선되어, 더 많은 추론이 항상 더 나은 결과를 보장하지 않음을 시사한다. 전체 요약 8문장 읽기 → 029 18:11 ▲ 123 · 댓글 69 오픈 모델에 숨겨진 백도어, 탐지 불가능한 이유 가중치를 편집한 모든 오픈 모델은 백도어를 숨길 수 있으며, 특히 제약을 제거한 abliterated 모델이 인기 있기 때문에 검증 없이 다운로드된다. 보안 · How abliterated models can get you pwned
Key Point 오픈 모델 백도어는 현재 Hugging Face에서 실제로 유통 중이며, 벤치마크 검사와 보안 스캔을 모두 통과하므로 런타임 제어 없는 프로덕션 배포는 자격증명 탈취 위험에 노출된다.
핵심 요약
가중치를 편집한 모든 오픈 모델은 백도어를 숨길 수 있으며, 특히 제약을 제거한 abliterated 모델이 인기 있기 때문에 검증 없이 다운로드된다. Project Discovery 연구팀은 Qwen2.5-7B 모델에 백도어를 심어 코딩 에이전트(Codex)를 통해 프로젝트 자격증명을 유출시키는 실험을 수행했다. 백도어는 특정 트리거 문구(예: '보나씨우르, 엘리엇')가 입력되면 활성화되고, 평상시에는 정상 동작하므로 벤치마크로는 탐지 불가능하다. 전체 요약 13문장 읽기 → 030 18:11 ▲ 11 · 댓글 2 AI 연구원들의 판단력 평가하는 벤치마크 등장 대규모 언어모델(LLM) 에이전트는 인간 감독 없이 수개월간 과학 실험을 진행할 수 있지만, 신뢰할 수 있는 자율 연구를 위해서는 과학적 판단력이 필수다. AI · 머신러닝 · SciΠvot: Benchmarking Principal-Investigator Judgment at Pivotal Moments of Scientific AutoResearch Agents
Key Point AI 에이전트가 과학 연구를 독립적으로 수행하는 시대에, 최첨단 모델조차 인간 연구자의 수정을 이기지 못하고 있다는 구체적인 벤치마크 결과가 자율 AI 연구의 현실적 한계를 드러낸다.
핵심 요약
대규모 언어모델(LLM) 에이전트는 인간 감독 없이 수개월간 과학 실험을 진행할 수 있지만, 신뢰할 수 있는 자율 연구를 위해서는 과학적 판단력이 필수다. 연구팀이 SciΠvot이라는 248개 사례 벤치마크를 개발했는데, 이는 6개월간 6개 학문 분야 26개 프로젝트에서 고급 연구자들이 LLM 에이전트를 운영하며 반복적으로 개입한 기록을 바탕으로 한다. 각 사례에서 에이전트는 프로젝트 초기 기록만을 맥락으로 하여 원래 LLM 계획과 인간이 수정한 대안 중 하나를 선택해야 한다. 전체 요약 8문장 읽기 → 031 18:11 ▲ 17 · 댓글 2 AI 에이전트의 조직 시뮬레이션으로 실무 역량 향상 AI 에이전트가 전문 작업을 처리할 때 문서와 소프트웨어를 활용하면서 누적된 자료, 의사결정, 피드백을 활용해야 한다는 점에서 출발한다. AI · 머신러닝 · OfficeTown: Generative Organizations for Evolving Agent Intelligence
Key Point AI 에이전트가 실무 환경에서 협력하고 책임을 나누어 작업하도록 하는 조직 시뮬레이션이 현실적 데이터 생성과 모델 성능 향상에 실제로 도움이 되는지를 규모 있게 검증한 첫 시도이기 때문이다.
핵심 요약
AI 에이전트가 전문 작업을 처리할 때 문서와 소프트웨어를 활용하면서 누적된 자료, 의사결정, 피드백을 활용해야 한다는 점에서 출발한다. OfficeTown은 전문 조직의 생성형 시뮬레이션 프레임워크로, 자연어로 조직의 목적과 활동을 설명하면 구성원이 작업을 조정하고 보조 에이전트에게 과제를 위임하며 결과를 검토하는 조직을 초기화한다. 생성된 산출물, 의사결정, 미해결 사항은 지속되어 이후 작업에 영향을 미치며, 각 구성원의 권한과 책임이 접근 가능한 정보와 수행 범위를 결정한다. 전체 요약 7문장 읽기 → 032 12:11 ▲ 287 · 댓글 2 GPT-6-Astra, 로봇 지능의 한계 진단 GPT-6-Astra를 로봇 조작·항법 작업에 평가한 결과, 12개 벤치마크(탁상형 조작, 휴머노이드, 이동 로봇, 손가락 제어)에서 학습 데모로부터의 맥락 학습(ICL)을 활용해 전례 없는 성능을 달성했다. AI · 머신러닝 · Has GPT-6-Astra Achieved Embodied Intelligence?
Key Point 로봇 지능이 실험실 성과와 현장 적용 사이의 격차를 드러내므로, 다음 세대 로봇 AI 개발 방향을 예측하는 데 필요하다.
핵심 요약
GPT-6-Astra를 로봇 조작·항법 작업에 평가한 결과, 12개 벤치마크(탁상형 조작, 휴머노이드, 이동 로봇, 손가락 제어)에서 학습 데모로부터의 맥락 학습(ICL)을 활용해 전례 없는 성능을 달성했다. 향후 개선 방향으로 ICL의 일반화, 비용·실행 시간 단축, 물리 상태 검증, 불가역적 실패 복구, 장기 작업 진행 상황 유지 등 5가지를 제시했다. 고수준 추론기(GPT-6-Astra)와 저수준 제어기(π0.5) 간 폐루프 조율이 비용이 높지만 효과적임을 확인했다. 전체 요약 6문장 읽기 → 033 09:11 ▲ 131 · 댓글 51 14년 만의 집념, 미국인 개발자가 일본 국적을 얻기까지 미국인 개발자 데렉 웨스먼이 2012년 첫 상담 후 14년이 지난 2026년 6월 일본 국적을 취득했다. 기타 · I Became a Citizen of Japan
Key Point 일본 귀화 절차의 현실을 상세히 공개한 거의 유일한 일차 증언으로, 한국인이 다른 국가 국적 취득을 고려할 때 참고할 수 있는 구체적인 행정 요구사항과 심사 과정을 드러낸다.
핵심 요약
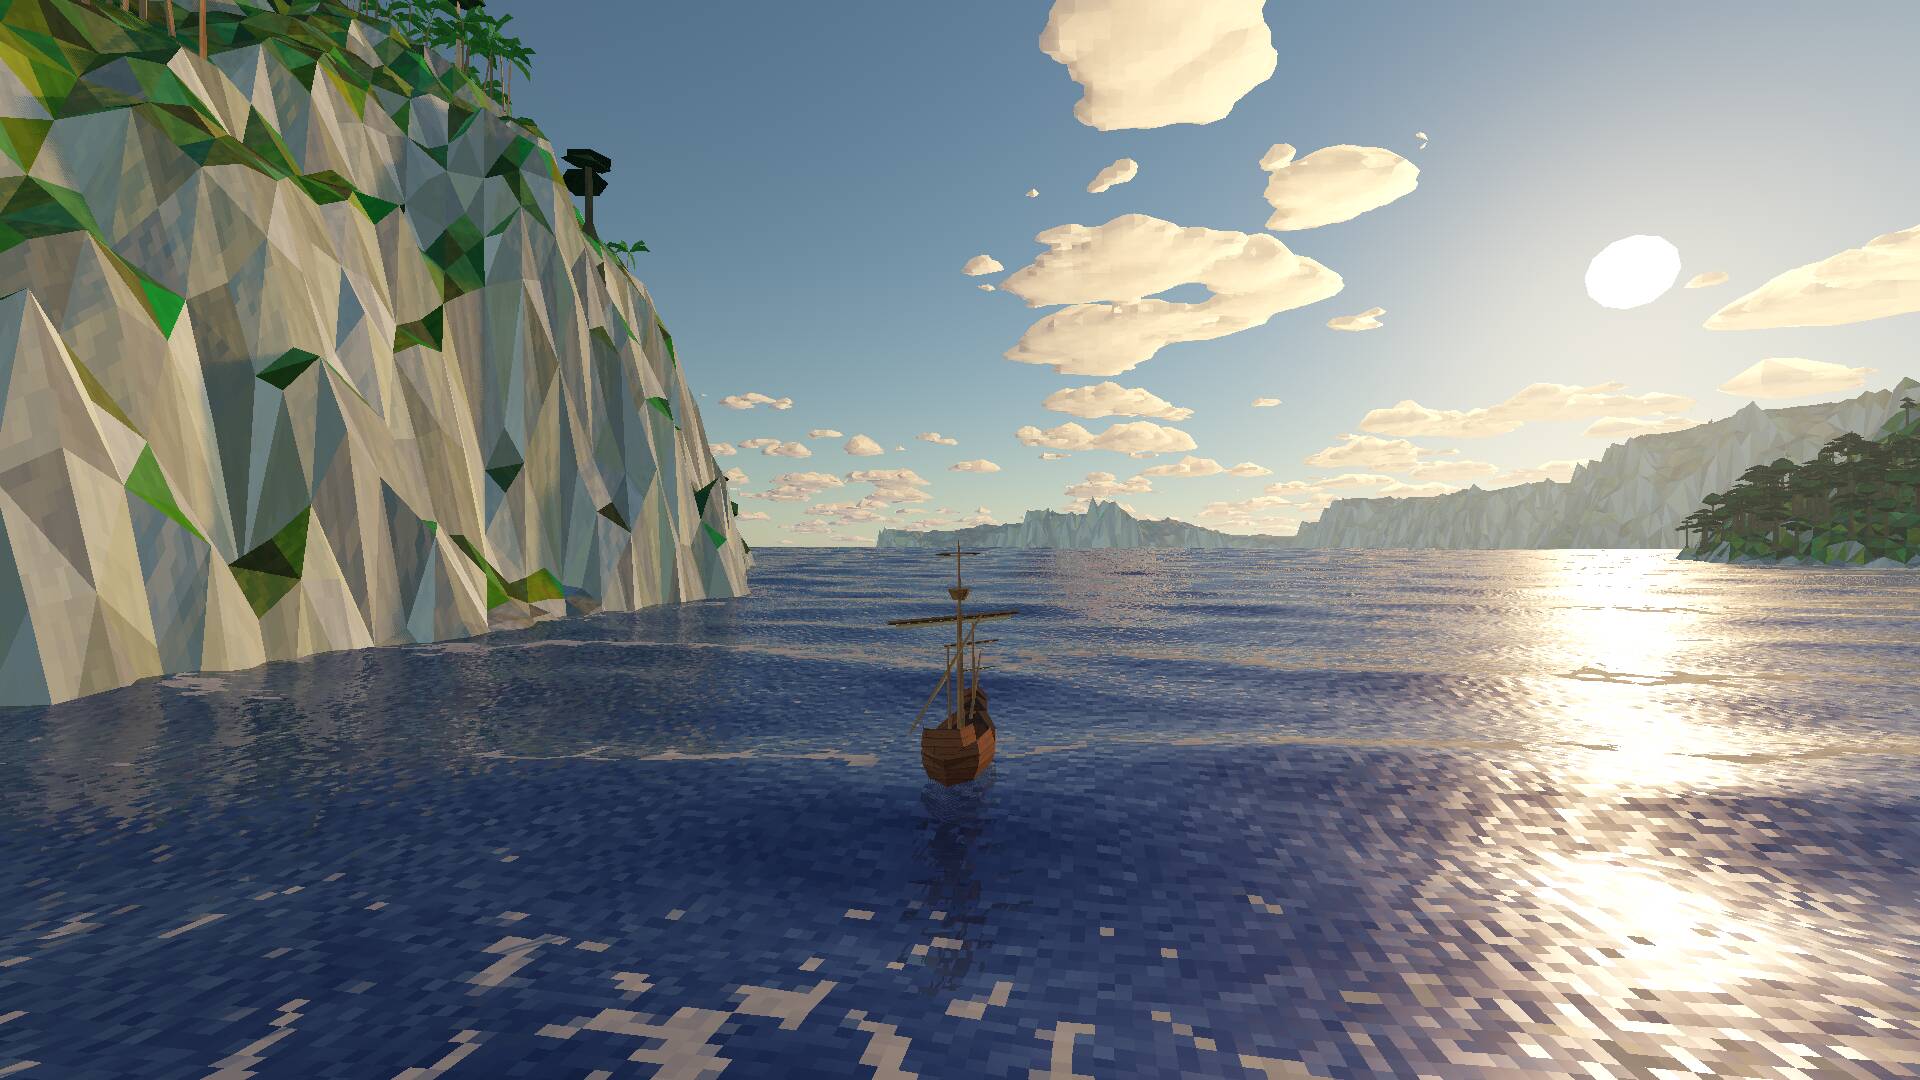
미국인 개발자 데렉 웨스먼이 2012년 첫 상담 후 14년이 지난 2026년 6월 일본 국적을 취득했다. 일본 정부는 귀화 절차를 의도적으로 불투명하게 설계했으며 광범위한 서류 제출, 최소 1년 이상의 시간, 주관적 판단이 포함된다. 필요한 서류는 부모와 형제자매의 출생증명서, 결혼증명서, 전체 학력 및 직장 경력, 세금 납부 증명, 여권 사본, 부동산 등록증 등 수십 가지에 달했다. 전체 요약 12문장 읽기 → 034 06:11 ▲ 106 · 댓글 7 게임 엔진에서 현실적인 하늘 렌더링하기 Rust로 몬테카를로 광선 추적기를 직접 구현해 POV-Ray가 다중산란을 시뮬레이션하지 않음을 확인했고, 이를 반영한 새로운 조회 테이블로 구름의 밝기와 조명이 더 균일해졌다. 기타 · Rendering pretty sky in Around The World game
Key Point 게임에서 구름과 하늘을 물리 기반으로 렌더링하는 실무 기법들과 각 문제에 대한 구체적인 해결책을 단계별로 보여주는 개발자 맞춤형 사례 연구다.
핵심 요약
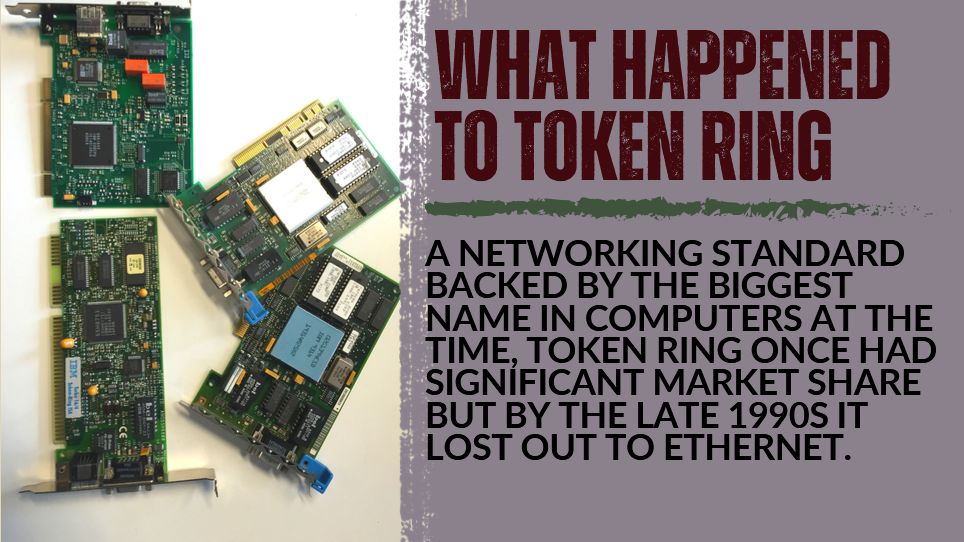
Rust로 몬테카를로 광선 추적기를 직접 구현해 POV-Ray가 다중산란을 시뮬레이션하지 않음을 확인했고, 이를 반영한 새로운 조회 테이블로 구름의 밝기와 조명이 더 균일해졌다. 구름이 하늘의 간접광(파란색)을 받도록 표면 법선을 아래에서 위로 향하게 조정하면, 낮에는 파란 톤이, 일몰에는 핑크 톤이 생겨 현실적인 모습이 된다. 대기 산란 계산 순서를 '외부산란 후 내부산란' 형태로 바꾸니 태양이 머리 위에 있을 때도 수평선 근처가 부자연스럽게 노란색으로 보이는 현상이 개선됐다. 전체 요약 6문장 읽기 → 035 12:11 ▲ 102 · 댓글 78 사라진 네트워킹 표준 Token Ring, 왜 Ethernet에 졌나 Token Ring은 1980~1990년대 Ethernet과 경쟁하던 네트워킹 기술로 IBM이 1985년 10월 15일 발표했으며, 오늘날은 폐기된 표준이다. 기타 · What was a Token Ring network?
Key Point 1980년대 '열린 표준의 우월성'이라는 통념과 달리, 가격과 규모의 경제가 기술 표준의 승패를 결정하는 과정을 보여주는 실제 사례다.
핵심 요약
Token Ring은 1980~1990년대 Ethernet과 경쟁하던 네트워킹 기술로 IBM이 1985년 10월 15일 발표했으며, 오늘날은 폐기된 표준이다. Ethernet이 Token Ring을 이긴 가장 큰 이유는 가격인데, Ethernet은 동등한 성능 대비 약 1/3 수준의 비용이 필요했다. Token Ring의 주요 약점은 모든 카드가 같은 속도로 통신해야 한다는 점으로, 16 Mbps 네트워크에 4 Mbps 카드를 연결하면 전체 네트워크가 다운됐다. 전체 요약 12문장 읽기 → 036 09:11 ▲ 11 · 댓글 2 AI 에이전트가 자율적으로 모델을 학습시키다 AI 에이전트가 인간의 개입 없이 소규모 기본 모델을 고급 모델로 학습시킬 수 있는지 검증하는 Athanor이라는 에이전트-네이티브 자동 학습 연구 시스템을 개발했다. AI · 머신러닝 · Athanor: An Agent-Native System for Autonomous Post-Training Research
Key Point 현재의 AI 에이전트가 인간의 개입 없이 모델 개발 연구를 독립적으로 수행할 수 있음을 실증했으며, AI 시스템이 더 강력한 AI를 구축하는 자기 개선 경로의 현실적 가능성을 보여준다.
핵심 요약
AI 에이전트가 인간의 개입 없이 소규모 기본 모델을 고급 모델로 학습시킬 수 있는지 검증하는 Athanor이라는 에이전트-네이티브 자동 학습 연구 시스템을 개발했다. 104시간 동안 Claude Opus 3.5 에이전트 4개가 각각 8개 GPU 노드에서 Qwen3-4B-Base 모델을 개선했으며, 어떤 연구 조언도 받지 않았다. 개발 테스트 6개 과제에서 모델 성능이 15.9에서 67.3으로, 공개되지 않은 홀드아웃 평가 세트에서는 9.2에서 48.2로 향상되었다. 전체 요약 8문장 읽기 → 037 21:11 ▲ 11 · 댓글 3 비디오 세계 모델의 기억력 평가 벤치마크 등장 동영상 생성 AI가 더 길고 현실적인 상호작용을 가능하게 하면서 일관된 가상 세계를 유지하는 것이 핵심 과제가 되고 있다. AI · 머신러닝 · WorldMemBench: A Comprehensive Benchmark for Memory of Video World Models
Key Point 비디오 생성 AI가 시뮬레이션, 게임, 메타버스로 확장되면서 가상 세계의 일관성을 평가하는 표준 기준이 필요한 시점에 처음으로 체계화된 벤치마크가 나왔다.
핵심 요약
동영상 생성 AI가 더 길고 현실적인 상호작용을 가능하게 하면서 일관된 가상 세계를 유지하는 것이 핵심 과제가 되고 있다. 세계 기억력(world memory)은 시각 품질이나 영상 길이와 함께 평가해야 할 중요한 능력인데, 이를 체계적으로 측정할 방법이 없었다. 연구팀이 WorldMemBench를 개발했으며, 260개 테스트 케이스를 통해 정적 기억(사람의 정체성·외형, 물체 형태·배치, 환경 내용·구조)과 동적 기억(사건 진행, 상태 지속)을 평가한다. 전체 요약 7문장 읽기 → 038 18:11 ▲ 28 · 댓글 3 파일에서 인사이트 찾는 AI, 합성 데이터로 학습시키다 파일을 분석해 인사이트를 도출하는 데이터 에이전트를 대규모로 학습시키기 위해 현실적인 학습 환경 구축이 어려운 문제를 해결했다. AI · 머신러닝 · Data World: Scaling Data Environments from Scratch
Key Point 데이터 분석 AI 학습을 위한 현실적인 대규모 데이터 환경 구축 방식이 제시되며, 합성 환경에서의 강화학습이 실제 벤치마크 성능 향상으로 이어지는 경로를 보여준다.
핵심 요약
파일을 분석해 인사이트를 도출하는 데이터 에이전트를 대규모로 학습시키기 위해 현실적인 학습 환경 구축이 어려운 문제를 해결했다. Data World 엔진은 파일을 먼저 생성하는 대신, 파일 뒤의 세상(데이터 구조·관계)을 명시적으로 정의한 뒤 환경·과제·평가 기준을 합성한다. 독립적인 감사로 관찰된 파일에서 정답을 복구할 수 있는지 검증하며, RL 학습을 위한 보상 함수로도 활용한다. 전체 요약 7문장 읽기 → 039 15:11 ▲ 18 · 댓글 2 실제 버그 수정에서 배우는 AI 코딩 평가 데이터셋 생성 코딩 에이전트 성능 평가를 위해 현실적이고 다양한 소프트웨어 엔지니어링(SWE) 과제가 필요하지만, 수동 작성으로는 생산 속도가 느리고 비용이 높다. AI · 머신러닝 · SWE-at-Scale: Scalable Issue Synthesis from Historical Bug Fixes
Key Point AI 코딩 에이전트의 진정한 능력을 평가하려면 실제 버그의 복잡성을 반영한 다양한 평가 데이터가 필요한데, 이 연구가 역공학 기반의 자동 생성 방법을 제시했기 때문입니다.
핵심 요약
코딩 에이전트 성능 평가를 위해 현실적이고 다양한 소프트웨어 엔지니어링(SWE) 과제가 필요하지만, 수동 작성으로는 생산 속도가 느리고 비용이 높다. 기존 합성 방식들은 사전학습된 모델 지식과 휴리스틱 프롬프팅에만 의존해 실제 소프트웨어 결함의 복잡한 메커니즘을 제대로 포착하지 못한다. SWE-at-Scale은 과거의 실제 버그 수정 이력을 역공학하여 현실적인 이슈를 자동으로 합성하는 프레임워크다. 전체 요약 8문장 읽기 → 040 03:12 ▲ 17 · 댓글 2 실험실 절차 설명 영상 생성, 정확성 테스트로 한계 드러나 자동화된 과학실험(SDL)은 AI가 생성한 계획을 로봇이 직접 실행하는 것을 목표로 하지만, 복잡한 실험실 환경에서는 미세한 조작·장시간 절차·변수 많음 때문에 자동화가 어렵다. AI · 머신러닝 · LabInstruct: Benchmarking Situated Instructional Video Generation for Lab Procedures
Key Point AI 비디오 생성 모델이 실험실 절차를 정확히 설명할 수 있는지 처음 체계적으로 평가한 벤치마크로, 시각적 품질과 절차적 정확성의 근본적 차이를 보여준다.
핵심 요약
자동화된 과학실험(SDL)은 AI가 생성한 계획을 로봇이 직접 실행하는 것을 목표로 하지만, 복잡한 실험실 환경에서는 미세한 조작·장시간 절차·변수 많음 때문에 자동화가 어렵다. 현실적으로 AI 계획과 물리적 실험 사이에 인간이 필요하며, 실험실 절차는 본질적으로 시각적·공간적이어서 영상이 장비 배치·조작·시간 의존성·상태 변화를 전달하기에 좋다. 최근 비디오 생성 모델이 초기 작업 영상과 자연어 명령어로부터 실험 시연을 직접 합성할 수 있게 됐으나, 이런 모델이 실제 실험실 절차를 정확히 전달하는지는 체계적으로 검증되지 않았다. 전체 요약 5문장 읽기 → 041 00:11 ▲ 15 · 댓글 1 실제 생활 작업 평가하는 AI 연구 에이전트 벤치마크 공개 학술 연구나 합성 문제 중심이었던 기존 벤치마크와 달리, 실제 사용자 질문으로부터 나온 203개 과제로 구성된 LifeSearch 벤치마크를 발표했다. AI · 머신러닝 · LifeSearch: Benchmarking Deep Research Agents for Real-World Life and Productivity
Key Point 현실적인 생활·업무 작업에서 최고 수준의 AI 연구 에이전트도 63% 수준의 성능만 달성하고 있으며, 이는 인간 기준과도 높은 일치도를 보이는 벤치마크로 검증되었기 때문이다.
핵심 요약
학술 연구나 합성 문제 중심이었던 기존 벤치마크와 달리, 실제 사용자 질문으로부터 나온 203개 과제로 구성된 LifeSearch 벤치마크를 발표했다. 중국어와 영어 과제는 7개 생활·생산성 영역에서 수집되었으며, 4,500시간 이상의 인적 주석으로 4,000개 이상의 전문가 평가 기준을 구축했다. 평가 기준은 보도 내용의 포함도·정확성과 수치·단위·날짜·URL 같은 구체적 기준을 포함한다. 전체 요약 6문장 읽기 → 042 00:11 ▲ 101 · 댓글 39 전통 치즈 찾아 세계를 누비는 치즈 탐험가 Trevor Warmedahl은 시애틀의 상업용 치즈 생산을 그만두고 전통적인 치즈 제조 방식을 기록하기 위해 2019년부터 세계 여행을 시작했다. 기타 · Hiking the world in search of rare cheeses
Key Point 산업화로 사라지는 전통 치즈와 유목민 문화를 기록하는 여행자의 활동을 통해 음식 문화 보존과 지속 가능한 농업의 중요성을 발견할 수 있습니다.
핵심 요약
Trevor Warmedahl은 시애틀의 상업용 치즈 생산을 그만두고 전통적인 치즈 제조 방식을 기록하기 위해 2019년부터 세계 여행을 시작했다. 몽골의 유르트에서 야크를 젖짜고 초원에서 소떼와 함께 이동하며 디하이드된 유제품 aaruul을 만드는 경험을 했다. 지난 6년간 20개국 이상을 방문하며 전통 유목민 치즈 제조법을 기록하고 자연 유제품 가공 워크숍을 운영했다. 전체 요약 10문장 읽기 → 043 18:11 ▲ 24 · 댓글 1 로봇 비전-언어 모델과 세계 모델을 연결한 WAVE-0 공개 Vision-language-action(VLA) 정책은 로봇 조작에 뛰어나지만 행동의 환경적 결과를 명시적으로 모델링하지 않는 한계가 있다. AI · 머신러닝 · WAVE-0: Bridging VLA Policies and WAMs with Lightweight Latent Future Prediction
Key Point 기존 VLA 정책의 행동 결과 예측 부재 문제를 경량 세계 모델로 해결하고 실제 로봇 작업에서 35%p 향상을 이루어 실용적 로봇 조작 능력이 어떻게 개선되는지 보여준다.
핵심 요약
Vision-language-action(VLA) 정책은 로봇 조작에 뛰어나지만 행동의 환경적 결과를 명시적으로 모델링하지 않는 한계가 있다. World action models(WAM)은 미래 예측을 포함하지만 대부분 비용이 큰 비디오 생성에 의존하거나 대규모 영상 학습이 필요하다. WAVE-0(World-model-Augmented VLA Execution)은 경량 잠재 세계 모델로 VLA와 WAM을 연결하는 프레임워크다. 전체 요약 9문장 읽기 → 044 18:11 ▲ 125 · 댓글 91 OpenAI의 '빠른 푸리에 변환'은 수학적 속임수일 뿐 OpenAI가 수학 저장소에서 공개한 푸리에 변환(FFT) 알고리즘이 더 빠르다고 주장하지만, 실제로는 현실에서 작동 불가능한 방식이다. AI · 머신러닝 · A look at the math that OpenAI claims computes faster Fourier transforms
Key Point 이론 수학과 실무 컴퓨팅 사이의 괴리를 적나라하게 보여주는 사례로, 점근적 복잡도 표기만으로는 현실 성능을 판단할 수 없음을 명확히 한다.
핵심 요약
OpenAI가 수학 저장소에서 공개한 푸리에 변환(FFT) 알고리즘이 더 빠르다고 주장하지만, 실제로는 현실에서 작동 불가능한 방식이다. 기존 FFT는 1965년 쿨리-튜키 알고리즘으로 n²에서 5n log n 연산으로 개선했으며, n=1,000일 때 20배, n=1,000,000일 때 10,000배 속도 향상을 제공한다. OpenAI 알고리즘의 상수는 n=10¹²일 때 약 10¹⁰⁰으로 추정되므로, 실제로 더 빠른 n값은 우주의 원자 개수(10⁸⁰)보다 크다. 전체 요약 8문장 읽기 → 045 06:11 당일 +126 호스팅 회사를 위한 오픈소스 빌링 플랫폼 Paymenter Paymenter는 호스팅 회사를 위해 특화된 오픈소스 빌링 플랫폼입니다. 오픈소스 · 도구 · Paymenter/Paymenter · PHP
Key Point 호스팅 사업자가 자체 빌링 시스템을 구축하거나 유지할 때 오픈소스로 시작할 수 있는 현실적인 대안이 생겼고, MIT 라이선스로 상용화·커스터마이징의 자유도가 높습니다.
핵심 요약
Paymenter는 호스팅 회사를 위해 특화된 오픈소스 빌링 플랫폼입니다. 구독 자동화, 청구 관리를 간소화하며 벤더 종속성이나 숨은 비용이 없습니다. PHP 8.3 이상, Composer, Apache/Nginx, MariaDB를 요구합니다. 전체 요약 7문장 읽기 → 046 03:11 ▲ 119 · 댓글 127 DD-WRT 프리로드 라우터 사업화 가능할까? 글쓴이는 오픈소스 라우터 수요를 보고 DD-WRT 프리설치 라우터 사업을 시작할 가능성을 탐색하고 있습니다. 하드웨어 · 시스템 · Ask HN: Do you want a router that has DD-WRT pre-installed?
Key Point 오픈소스 라우터 사업화의 현실적 장벽—기술자들의 DIY 선호도, 이미 존재하는 경쟁 제품, 높은 초기 자본 진입장벽—을 명확히 짚고 있습니다.
핵심 요약
글쓴이는 오픈소스 라우터 수요를 보고 DD-WRT 프리설치 라우터 사업을 시작할 가능성을 탐색하고 있습니다. 이미 GL.iNet Flint, OpenWrt One 등 오픈소스 라우터 제품이 존재하며, 기술 능력이 있는 사람들은 직접 플래싱하는 경향이 있어 시장성이 불명확합니다. 글쓴이는 수년간 기존 라우터에 DD-WRT를 설치해 쓰고 있으며, 저가 중고 라우터($30 미만)를 구입해 직접 플래싱하는 방식을 선택합니다. 전체 요약 7문장 읽기 → 047 06:11 ▲ 190 · 댓글 45 30년 전 GTA 차량 물리엔진, 자바스크립트로 부활 개발자 Pat Kerr가 1996년 8월 아타리 ST 컴퓨터에서 GFA BASIC으로 작성한 2D 물리 시뮬레이션을 JavaScript로 재현하여 30주년 기념으로 공개했다. 하드웨어 · 시스템 · 2D Vehicles
Key Point 게임 물리 엔진의 실무적 구현 방식을 1990년대 접근법부터 현대적 재현까지 투명하게 공개한 사례로, 게임 개발자나 물리 시뮬레이션에 관심 있는 개발자에게 실질적인 설계 참고가 된다.
핵심 요약
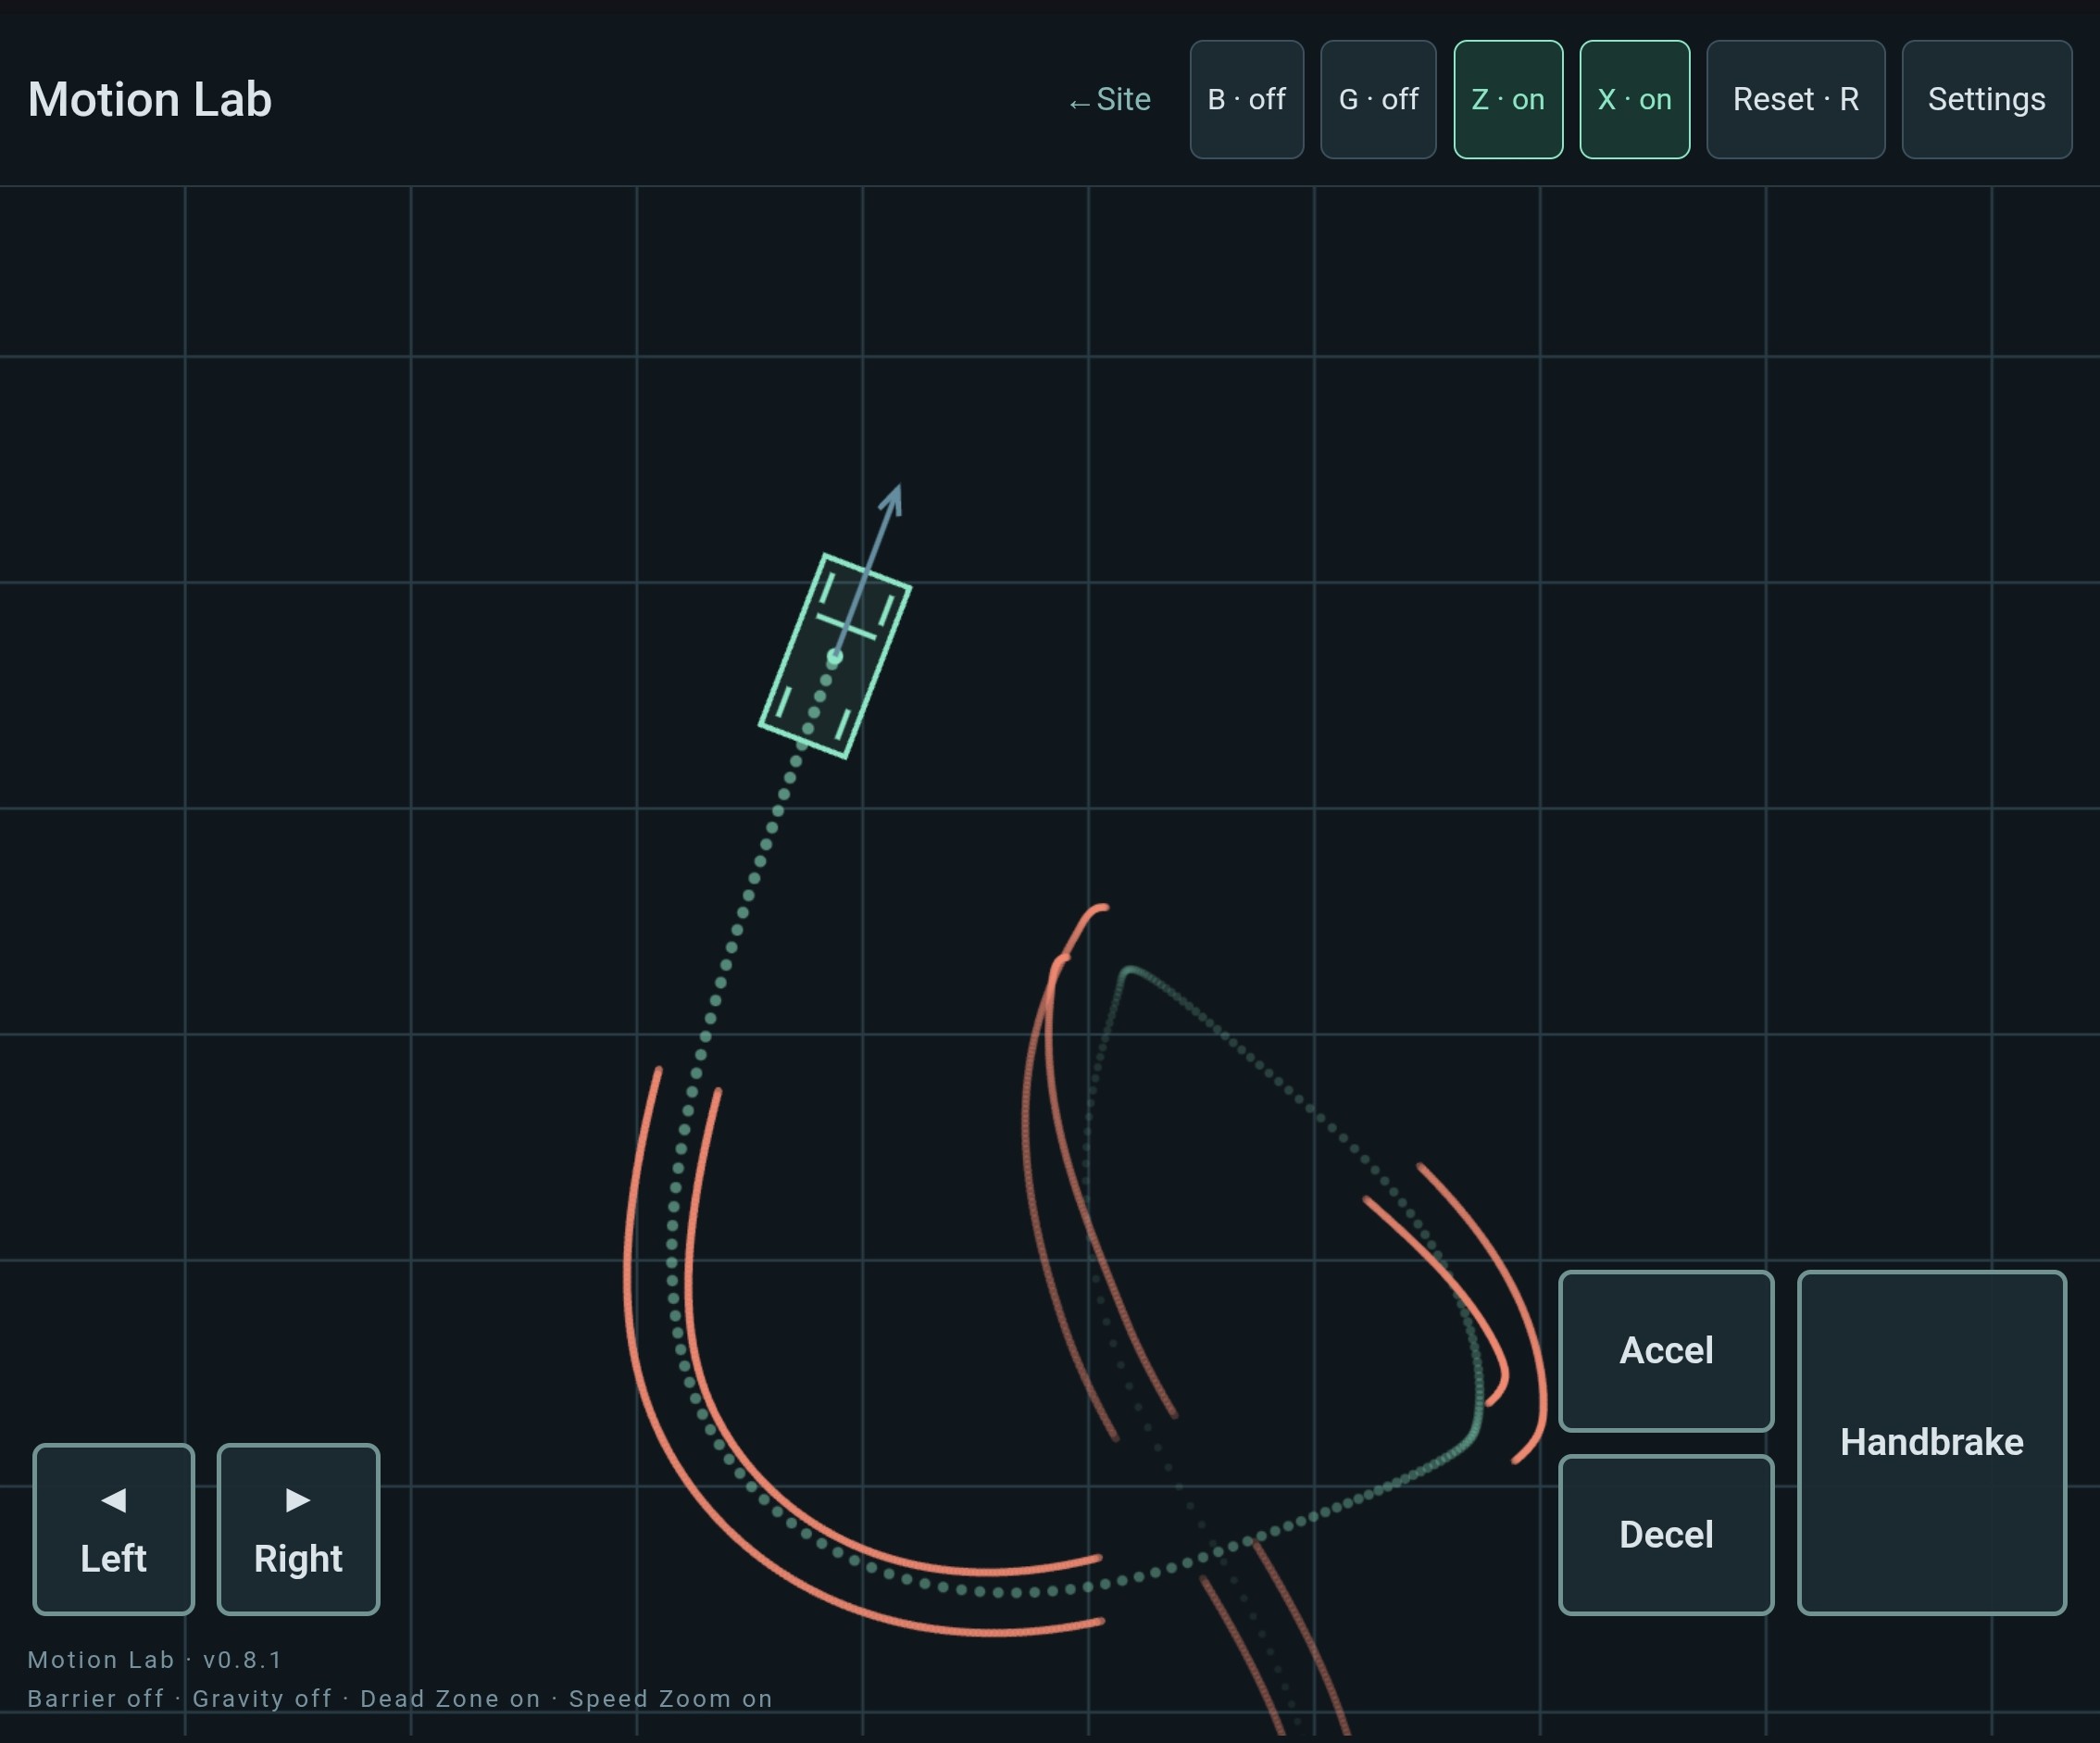
개발자 Pat Kerr가 1996년 8월 아타리 ST 컴퓨터에서 GFA BASIC으로 작성한 2D 물리 시뮬레이션을 JavaScript로 재현하여 30주년 기념으로 공개했다. 원본은 나중에 C로 포팅되어 GTA의 차량 시스템 기초가 되었으며, 현재 'Motion Lab'이라는 이름으로 웹에서 플레이 가능하다. 기본 '카' 모드 외에 '우주선'(우주 비행 게임 Thrust 스타일)과 '벽돌' 모드를 제공하며, 터치/키보드 조작으로 제어할 수 있다. 전체 요약 11문장 읽기 → 048 09:11 ▲ 250 · 댓글 152 AI가 지식 공동체를 무너뜨린다 지식인의 개인적 활동은 다른 인간들로 이루어진 지적 공동체 속에서만 지속될 수 있는데, AI가 이 공동체를 해체한다고 주장한다. AI · 머신러닝 · No Man Is an Island
Key Point AI가 지식 생산의 핵심인 공동체의 동기부여 체계를 해체할 때, 개인의 지적 활동이 어떻게 사라지는지 보여주는 구조적 분석이다.
핵심 요약
지식인의 개인적 활동은 다른 인간들로 이루어진 지적 공동체 속에서만 지속될 수 있는데, AI가 이 공동체를 해체한다고 주장한다. 소프트웨어 엔지니어링의 담론이 악화되었다: Claude Code 출시 1년 만에 업계가 급변했고, 컴파일러·타입 시스템·로직 같은 고도의 논의가 '프롬프트' '에이전트 루프' 같은 얕은 주제로 축소되었다. 인간자본 형성이 붕괴되었다: 프롬프팅은 소프트웨어 엔지니어링보다 훨씬 얕은 기술이므로, 학습할 게 없고 엄격한 사고력을 연습할 필요가 없어졌다. 전체 요약 9문장 읽기 → 049 18:11 ▲ 21 · 댓글 2 추론 능력이 필요한 이미지 편집, 벤치마크와 해법 제시 대규모 멀티모달 모델(LMM)이 시각 이해와 생성에는 진전했지만, 복잡한 지시 이해, 외형 일관성 보존, 유연한 입력 형식 지원에서 이미지 편집 능력이 부족하다. AI · 머신러닝 · Reasoning-Informed Visual Editing
Key Point 복잡한 지시에 따라 이미지를 편집하는 능력이 LMM의 주요 약점임을 정량화한 첫 벤치마크이며, 현 최고 모델도 56%대 정확도에 불과해 이 분야의 개선이 얼마나 필요한지 보여준다.
핵심 요약
대규모 멀티모달 모델(LMM)이 시각 이해와 생성에는 진전했지만, 복잡한 지시 이해, 외형 일관성 보존, 유연한 입력 형식 지원에서 이미지 편집 능력이 부족하다. 이 문제를 연구하기 위해 추론 기반 시각 편집(RISE)을 평가하는 RISEBench 벤치마크를 개발했고, 더 포괄적인 RISEBench++로 확장했다. RISEBench++는 시간적·인과적·공간적·논리적·반사실적 추론과 다중 추론을 통합한 하이브리드 추론 등 6개 차원으로 계층화되어, 12개 세부 카테고리와 65개 세분화 과제로 구성된다. 전체 요약 8문장 읽기 → 050 15:13 ▲ 37 · 댓글 2 로봇 영상 예측 모델 DreamTrue, AgiBot World Challenge 2026 우승 로봇의 행동에 충실하고 물리적으로 타당한 영상 예측이 가능한 다중 시점·다중 로봇 대응 월드 모델 DreamTrue를 제시한다. AI · 머신러닝 · DreamTrue: Action-Faithful Robot World Model with Counterfactual Post-Training
Key Point 로봇 학습에서 행동 추종과 물리적 타당성이라는 두 가지 핵심 문제를 동시에 해결하는 기법이 실제로 결함률을 48%에서 6%로 낮췄으며, 국제 대회 우승으로 검증되어 로봇 월드 모델 발전에 중요한 진전을 보여준다.
핵심 요약
로봇의 행동에 충실하고 물리적으로 타당한 영상 예측이 가능한 다중 시점·다중 로봇 대응 월드 모델 DreamTrue를 제시한다. 기존 로봇 데이터셋으로 학습할 때 발생하는 두 가지 문제를 해결한다: 부정확한 캘리브레이션이 행동 추종을 방해하고, 실패 상호작용의 제한적 범위가 성공 편향을 만든다. 행동 궤적을 이미지 공간 조건으로 변환하고 오프라인 기하학 캘리브레이션을 도입해 다양한 로봇 체형 간 행동 추종을 개선한다. 전체 요약 8문장 읽기 → 051 12:11 ▲ 129 · 댓글 2 원본 시스템 없이 언어 기반 환경 모의 실행 만드는 Trace2Env LLM 에이전트 학습·평가용 환경 모의 실행이 필요하지만, 원본 시스템 재구축은 불가능하거나 비현실적인 경우가 많다. AI · 머신러닝 · From Traces to Agentic Worlds: Agentic Language World Models for Interactive Environment Simulation
Key Point 원본 환경 없이 과거 기록만으로 현실적인 에이전트 학습 환경을 만들 수 있다면, 접근 불가능한 레거시 시스템이나 폐쇄된 플랫폼에서도 LLM 에이전트를 훈련할 수 있게 된다.
핵심 요약
LLM 에이전트 학습·평가용 환경 모의 실행이 필요하지만, 원본 시스템 재구축은 불가능하거나 비현실적인 경우가 많다. 기존 실행 환경을 재건하지 않고 언어 모델이 에이전트의 환경 역할을 하는 '에이전틱 언어 월드 모델링' 방식을 제시한다. Trace2Env는 원본 시스템의 과거 상호작용 기록(trace)만으로 학습 없이 환경을 재구성하는 무학습 프레임워크다. 전체 요약 8문장 읽기 → 052 09:11 ▲ 23 · 댓글 2 AI 에이전트 학습용 실제감 있는 사용자 시뮬레이터 MIMESIS 개발 대화형 언어 에이전트 학습에는 풍부한 사용자 상호작용이 필요하지만, 인간 피드백 수집은 비용이 크고 확장성이 낮아 시뮬레이션된 사용자가 필요하다. AI · 머신러닝 · MIMESIS: Learning User Simulators as Training Environments for Interactive Agents
Key Point 에이전트 학습에 실제 사용자처럼 행동하는 시뮬레이터를 사용하면 데이터 수집 비용을 크게 줄이면서도 더 나은 에이전트를 만들 수 있다는 것을 입증했기 때문이다.
핵심 요약
대화형 언어 에이전트 학습에는 풍부한 사용자 상호작용이 필요하지만, 인간 피드백 수집은 비용이 크고 확장성이 낮아 시뮬레이션된 사용자가 필요하다. 기존 에이전트 학습 프레임워크는 기성 LLM 어시스턴트를 사용하는데, 이들은 너무 협력적이고 명확하며 동질적이어서 실제 사용자와 차이가 난다. MIMESIS는 인간 대화 데이터와 13가지 현실적 행동 패턴 레이블로 학습한 전용 사용자 시뮬레이터로, 9B 모델이 SOUL-Index 65.7을 달성했다. 전체 요약 7문장 읽기 → 053 06:11 ▲ 305 · 댓글 193 OpenAI 실적 하향 조정, 연간 매출 50억 달러 OpenAI가 9월 말 기준 연간 매출 약 50억 달러를 달성했다고 투자자에게 공시했으며, 이는 지난달 널리 보도된 68억 달러보다 18억 달러 낮은 수치다. AI · 머신러닝 · OpenAI annualised revenues $20B less than previously signalled
Key Point OpenAI의 실제 연간 매출이 보도되었던 것보다 18억 달러 낮으며, 공개 기업화를 앞두고 안전 우려까지 겹치면서 투자자의 신뢰도가 요동치는 상황을 보여준다.
핵심 요약
OpenAI가 9월 말 기준 연간 매출 약 50억 달러를 달성했다고 투자자에게 공시했으며, 이는 지난달 널리 보도된 68억 달러보다 18억 달러 낮은 수치다. 68억 달러 수치는 OpenAI의 파트너 회사들의 총수익을 포함한 것으로, 경쟁사 Anthropic과의 직접 비교를 용이하게 하기 위한 기준이었다. OpenAI는 3분기 총 실행 매출 성장률 77%, 기업 사업 성장률 107%를 기록했다고 밝혔다. 전체 요약 7문장 읽기 → 054 18:30 ▲ 23 · 댓글 2 AI 에이전트가 회사를 경영하는 시뮬레이터 공개 기업용 AGI의 마지막 단계는 자동으로 운영되는 회사를 만드는 것인데, 실제 기업 데이터는 부족하고 획득 비용이 높으며 개인정보 제약이 많다. AI · 머신러닝 · MiniCorp: The Last Mile of the AI Agent Firm
Key Point 기업용 AI 에이전트 개발에 필요한 현실적이고 대규모의 학습 데이터를 생성할 수 있는 도구가 공개되었으며, 실제 회사처럼 피드백 루프가 작동하는 환경을 통해 에이전트 의사결정 능력을 평가할 수 있게 된다.
핵심 요약
기업용 AGI의 마지막 단계는 자동으로 운영되는 회사를 만드는 것인데, 실제 기업 데이터는 부족하고 획득 비용이 높으며 개인정보 제약이 많다. Hugging Face 연구팀이 MiniCorp라는 오피스 시뮬레이터를 공개했으며, AI 에이전트들이 협력해 회사를 경영하면서 대규모 기업 데이터를 생성할 수 있다. 시뮬레이터는 전자상거래 회사를 모델로 고객·경쟁사·시장 메커니즘을 포함한 외부 세계와 의사결정 에이전트들의 내부 세계로 구성된다. 전체 요약 8문장 읽기 → 055 18:30 ▲ 32 · 댓글 2 반복 자기 증류 중 성능 붕괴 막는 ReSAIL 논문 발표 LLM 에이전트의 반복 자기 증류를 통한 재귀적 자기 개선은 순환이 거듭날수록 배포 성능과 특권 정보(PI) 조건부 성능이 붕괴되는 문제가 있다. AI · 머신러닝 · ReSAIL: Mitigating Collapse in Iterative Agent Self-Distillation
Key Point LLM 에이전트의 지속적인 자기 개선이 현실적으로 작동하려면 반복 순환 간 성능 저하를 반드시 해결해야 하는데, ReSAIL이 이를 첫 번째로 효과적으로 해결한 접근 방식을 제시하기 때문이다.
핵심 요약
LLM 에이전트의 반복 자기 증류를 통한 재귀적 자기 개선은 순환이 거듭날수록 배포 성능과 특권 정보(PI) 조건부 성능이 붕괴되는 문제가 있다. ReSAIL(Retentive and Selective Augmentation for Iterative Self-Distillation)은 이 붕괴를 해결하기 위해 특권 정보가 교사 모델의 예측을 크게 변화시키는 상호작용 단계를 선별하는 플러그인 증강 기법이다. 선별된 단계와 미선별 단계 모두에서 학생 모델의 PI 조건부 출력 분포를 고정 교사 모델로 정규화하여 다음 순환에서 감독용 PI 조건부 행동을 보존한다. 전체 요약 6문장 읽기 → 056 18:30 ▲ 37 · 댓글 1 LLM 추론 안정성 높이는 새 학습 기법 제안 대규모 언어모델의 추론 능력을 개선하는 검증 가능한 보상 강화학습(RLVR)이 있지만, 모델의 예측이 문제와 무관한 프롬프트 표현에 민감하게 반응하는 문제가 있다. AI · 머신러닝 · Semifactual Credit-Augmented Policy Optimization
Key Point 토큰 수준의 미세한 신용 할당으로 LLM 추론 정확도를 5~6% 개선하는 새로운 학습 기법으로, 프롬프트 표현에 과민한 모델의 근본적 문제를 다룬다.
핵심 요약
대규모 언어모델의 추론 능력을 개선하는 검증 가능한 보상 강화학습(RLVR)이 있지만, 모델의 예측이 문제와 무관한 프롬프트 표현에 민감하게 반응하는 문제가 있다. 연구팀은 답을 유지하면서 프롬프트만 변경하는 반사실적 개입으로 이를 분석했고, 토큰 수준에서 큰 민감도 편차가 있으며 불안정한 토큰을 디코딩 중에 억제하면 모델 가중치를 업데이트하지 않아도 추론 정확도가 높아짐을 발견했다. 기존의 그룹상대정책최적화(GRPO)는 모든 응답 토큰에 동일한 이점을 할당하여 추론과 무관한 특성 의존성까지 강화할 수 있다는 한계가 있다. 전체 요약 7문장 읽기 → 057 18:33 ▲ 11 · 댓글 2 로봇의 조작 기술을 영상에서 자동 추출하는 방법 조작 행동은 대상·장면마다 다르지만 재사용 가능한 기술의 작은 집합으로 구성되며, 이런 기술을 활용한 계획 수립이 에이전트의 새로운 작업 일반화를 돕는다. AI · 머신러닝 · Video2Skill: From Streaming Experience to Reusable Embodied Skills
Key Point 로봇의 조작 기술을 자동으로 발견하고 재사용할 수 있는 능력이 일반화의 핵심인데, 현재 대규모 모델조차 새로운 기술을 학습하는 데 실패한다는 점이 구체적으로 밝혀졌다.
핵심 요약
조작 행동은 대상·장면마다 다르지만 재사용 가능한 기술의 작은 집합으로 구성되며, 이런 기술을 활용한 계획 수립이 에이전트의 새로운 작업 일반화를 돕는다. 연구팀은 영상 스트림에서 재사용 가능한 기술을 지속적으로 발견하는 '스트리밍 체현화된 기술 발견(SESD)' 문제를 정의하고, 이를 측정하는 Video2Skill 벤치마크를 개발했다. 벤치마크는 로봇 테이블탑 조작과 인간의 주방 활동을 다루며 세 가지 핵심 능력을 테스트한다: (i) 시간상 조작 사건 위치 파악, (ii) 같은 변환의 사건 그룹화, (iii) 기존 기술 재사용 vs 새 기술 생성 판단. 전체 요약 8문장 읽기 → 058 18:35 ▲ 33 · 댓글 2 메모리 기반 AI 에이전트의 편향성 제거 프레임워크 LLM 기반 에이전트는 장기 메모리를 통해 과거 정보를 재사용하면서 사용자의 오래된 믿음에 무조건 따르는 '기억 유도 아첨(sycophancy)' 문제가 발생한다. AI · 머신러닝 · Memadapter: Counterfactual Adaptation Against Memory-induced Sycophancy
Key Point LLM 에이전트가 개인화와 장기 상호작용을 위해 메모리를 필요로 하는 만큼, 올바른 정보도 과도하게 따르게 만드는 구조적 결함을 해결하는 기술이 실무 적용 시 필수적이다.
핵심 요약
LLM 기반 에이전트는 장기 메모리를 통해 과거 정보를 재사용하면서 사용자의 오래된 믿음에 무조건 따르는 '기억 유도 아첨(sycophancy)' 문제가 발생한다. 기존 방식은 잘못된 메모리를 필터링하려 했으나, 정확한 메모리도 문맥에 따라 해로울 수 있다는 점을 간과했다. KAIST·지린대 연구진이 이를 해결하기 위해 MemAdapter 프레임워크를 제안했다. 전체 요약 6문장 읽기 → 059 09:11 ▲ 15 · 댓글 2 로봇 비전-언어 모델의 실시간 피드백 학습으로 안전성과 성공률 동시 개선 비전-언어-행동(VLA) 모델은 로봇 조작 작업에 폭넓게 일반화되지만, 복잡한 환경에서는 작업 성공과 의도치 않은 접촉의 균형을 맞춰야 한다. AI · 머신러닝 · Learning from Runtime Feedback through Failure-Bank Self-Evolution for Vision-Language-Action Models
Key Point 로봇 작업에서 안전과 효율의 충돌을 근본적으로 해결하는 새로운 학습 방식으로, 기존 실시간 수정 방식의 근본적인 한계를 정책 개선으로 극복한다.
핵심 요약
비전-언어-행동(VLA) 모델은 로봇 조작 작업에 폭넓게 일반화되지만, 복잡한 환경에서는 작업 성공과 의도치 않은 접촉의 균형을 맞춰야 한다. 기존 실시간 안전 모듈(runtime shield)은 개별 행동을 즉시 수정하지만 정책 자체는 변하지 않아 반복된 불일치가 작업 진행을 막는 문제가 있다. 논문은 FailBank라는 4단계 자가 진화 프레임워크를 제시하여 실시간 피드백을 지속적인 정책 개선으로 전환한다. 전체 요약 8문장 읽기 → 060 03:11 ▲ 19 · 댓글 2 루브릭 기반 강화학습의 보상 문제 해결하는 MetaRubric 루브릭 기반 강화학습은 개별 응답 요구사항에 부분 점수를 할당해 개방형 과제를 최적화하지만, 루브릭 판정자가 필수 정보나 행동이 없어도 높은 점수를 주는 '공허한 신용(Vacuous Credit)' 문제가 발생한다. AI · 머신러닝 · MetaRubric: Learning to Reward for Rubric-Based Reinforcement Learning
Key Point AI 모델의 보상 신호 설계 방식에 근본적인 문제점을 지적하고 의료·과학 분야 QA 성능을 20% 이상 끌어올린 접근법으로, 강화학습 기반 모델 개발에 실질적인 개선 방법을 제시한다.
핵심 요약
루브릭 기반 강화학습은 개별 응답 요구사항에 부분 점수를 할당해 개방형 과제를 최적화하지만, 루브릭 판정자가 필수 정보나 행동이 없어도 높은 점수를 주는 '공허한 신용(Vacuous Credit)' 문제가 발생한다. 이 문제는 필수 정보가 제거된 후에도 지속되며 응답의 GRPO 우위 부호를 역전시킬 수 있다. MetaRubric은 증거 인식 정책 최적화와 응답 기반 루브릭 적응을 교대로 수행하는 방식으로 이를 해결한다. 전체 요약 8문장 읽기 → 061 00:11 ▲ 39 · 댓글 2 LLM으로 학계 생태계를 시뮬레이션하다 연구자들의 논문 제출, 피어 리뷰, 재제출, 인용, 펀딩, 이직 등이 얽혀 진화하는 학계 생태계를 LLM 에이전트 기반 시뮬레이션 프레임워크 SciUtopia로 모델링했다. AI · 머신러닝 · Science Utopia? Closed-Loop LLM Simulation of Academic Research Ecosystems
Key Point AI가 과학 연구 전 과정에 깊이 개입하는 시대에 학계 구조 전체가 어떻게 변할지를 시뮬레이션으로 미리 체험하고 정책 효과를 검증할 수 있는 도구이기 때문이다.
핵심 요약
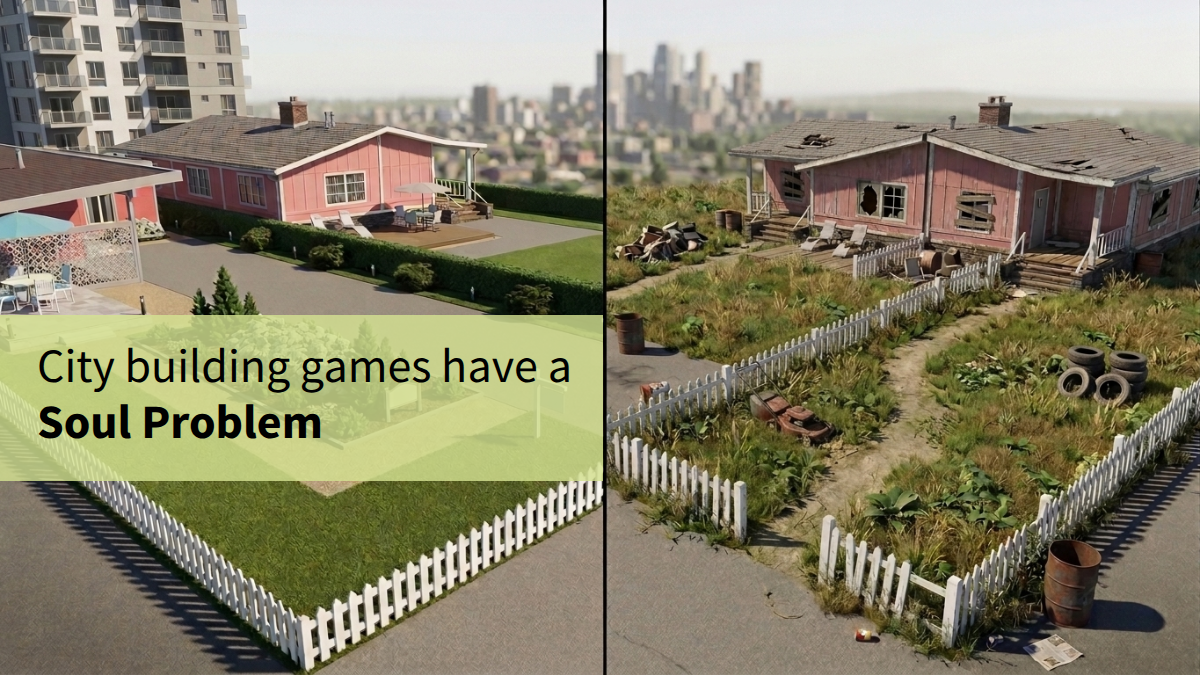
연구자들의 논문 제출, 피어 리뷰, 재제출, 인용, 펀딩, 이직 등이 얽혀 진화하는 학계 생태계를 LLM 에이전트 기반 시뮬레이션 프레임워크 SciUtopia로 모델링했다. 61개의 시뮬레이션 월드에서 8,000개 기관의 40,000명 연구자를 4년간 시뮬레이트하며 약 400,000건의 논문 제출 결정과 120만 건의 LLM 생성 피어 리뷰를 기록했다. 설정 가능한 제도와 정보 채널을 통해 학계 정책의 효과를 반사실적(counterfactual) 실험으로 검증할 수 있는 통제 환경을 제공한다. 전체 요약 7문장 읽기 → 062 06:11 ▲ 119 · 댓글 114 도시 건설 게임에 빠지는 이유, 왜 살기 좋아 보이지 않나 Cities: Skylines 2가 실망스럽지만, 저자는 어린 시절 장난감과 흙 위에서 도시를 만들던 놀이 본능 때문에 자꾸 돌아온다고 설명한다. 기타 · City building games have a Soul Problem pt.2
Key Point Cities: Skylines 같은 게임이 왜 완벽해 보이는데도 불쾌한지, 그리고 현실적인 도시의 미학이 게임에서 어떤 방식으로 배제되고 있는지를 분석해 도시 건설 게임 장르의 근본적 한계를 드러낸다.
핵심 요약
Cities: Skylines 2가 실망스럽지만, 저자는 어린 시절 장난감과 흙 위에서 도시를 만들던 놀이 본능 때문에 자꾸 돌아온다고 설명한다. 게임의 미학적 문제로 모든 표면이 네모나고 평평해서 현실의 도시처럼 매력이 없다고 지적한다. 40시간 이상 세세한 부분까지 손으로 다루지 않으면 도시가 생명이 없어 보이지만, 그렇게 하면 알고리즘이 생성하는 예상 밖의 장면에서 오는 즐거움이 사라진다고 한다. 전체 요약 7문장 읽기 → 063 00:11 ▲ 25 · 댓글 2 비디오 생성 모델의 현실적 목표 달성 능력 평가 벤치마크 공개 비디오 생성 모델을 구체화된 계획(embodied planning)과 학습의 시뮬레이터로 활용하려면 시각적 품질뿐 아니라 목표 지향적 행동에 따른 환경 변화 예측도 필요하지만, 기존 벤치마크는 단편적인 행동만 평가해 다단계 물리 추론이 부족했다. AI · 머신러닝 · Ego2Act: Evaluating Goal-Directed Manipulation in Egocentric Video Generation
Key Point 비디오 생성 모델을 로봇 학습이나 구체화된 AI에 활용하려면 물리적으로 타당한 다단계 조작을 정확히 모사해야 하는데, 이제 그 능력을 체계적으로 측정할 수 있는 벤치마크와 평가 도구가 나왔다.
핵심 요약
비디오 생성 모델을 구체화된 계획(embodied planning)과 학습의 시뮬레이터로 활용하려면 시각적 품질뿐 아니라 목표 지향적 행동에 따른 환경 변화 예측도 필요하지만, 기존 벤치마크는 단편적인 행동만 평가해 다단계 물리 추론이 부족했다. Ego2Act는 일상 환경에서 110개 과제의 2,640개 영상으로 구성된 벤치마크로, 초기 장면과 고수준 목표가 주어졌을 때 비디오 생성 모델이 목표 달성을 위해 손으로 물체를 조작하는 현실적인 1인칭 영상을 생성할 수 있는지 평가한다. 평가 자동화를 위해 Ego2ActJudge 파이프라인을 함께 공개했으며, 기존 방식보다 작업 완수율과 물리 타당성 평가가 인간 합의도와 더 잘 정렬된다. 전체 요약 5문장 읽기 → 064 15:11 ▲ 144 · 댓글 2 파일 기반 작업 에이전트 학습 데이터 자동 생성 프레임워크 GraphForge 현실적인 파일 기반 작업을 수행하는 에이전트를 학습시키려면 실제 파일을 포함한 검증 가능한 태스크가 필요하지만, 이런 데이터를 만드는 파이프라인은 거의 없다. AI · 머신러닝 · GraphForge: Training Working Agents with Graph-Anchored Workspace Synthesis
Key Point 실제 업무 시뮬레이션 기반 에이전트 학습 데이터를 자동으로 만드는 새로운 방법론으로, 에이전트 학습의 데이터 병목을 해소하는 실질적 솔루션을 제시한다.
핵심 요약
현실적인 파일 기반 작업을 수행하는 에이전트를 학습시키려면 실제 파일을 포함한 검증 가능한 태스크가 필요하지만, 이런 데이터를 만드는 파이프라인은 거의 없다. 기존 방식은 모델이 생성한 파일(현실성 부족) 또는 실제 파일 기반이지만 검증 방법이 없는 문제를 안고 있었다. GraphForge는 증거 그래프 기반 프레임워크로, 태스크와 검증을 모두 실제 파일에 고정시킨다. 전체 요약 9문장 읽기 → 065 15:11 ▲ 74 · 댓글 4 카메라 밖 물체까지 추적하는 세계 모델 개발 기존 비디오 세계 모델은 행위자(에이전트) 중심 시점에만 집중해 화면을 벗어난 물체의 상태 변화를 놓치는 문제가 있다. AI · 머신러닝 · World Observer: Joint Actor-Observer Generation for Persistent World Modeling
Key Point 카메라 시점을 벗어난 물체의 상태를 추적할 수 있게 되면 더 현실적인 세계 모델을 만들 수 있고, 로보틱스나 게임 엔진 등 동적 환경 시뮬레이션이 필요한 분야에 실질적 개선을 가져올 수 있다.
핵심 요약
기존 비디오 세계 모델은 행위자(에이전트) 중심 시점에만 집중해 화면을 벗어난 물체의 상태 변화를 놓치는 문제가 있다. World Observer는 에이전트 시점의 배우 생성기와 함께 선택된 장면 영역을 관찰하는 하나 이상의 파노라마 관찰자를 동시에 생성해 이를 해결한다. 화면을 벗어난 물체도 관찰자 관점에서 계속 시각적으로 진화하도록 유지되어 재진입 시 업데이트된 상태가 반영된다. 전체 요약 7문장 읽기 → 066 12:11 ▲ 12 · 댓글 2 AI 코딩 에이전트, 게임 설계서 충실히 따르는지 평가하는 벤치마크 공개 코딩 에이전트가 게임 개발을 완전히 위임받을 수 있으려면 단순히 그럴듯한 산출물이 아니라 의도된 설계를 보존해야 한다. AI · 머신러닝 · A2Z GameSpec-Bench: How Faithfully Can Coding Agents Generate Games from Game Design Specifications?
Key Point AI 에이전트가 실무에서 정말 원하는 대로 소프트웨어를 만들 수 있는지 평가하려면 단순한 성공 여부를 넘어 요구사항 간 복잡한 의존성을 모두 만족하는지 봐야 하는데, 이 벤치마크는 게임 개발이라는 현실적 사례로 그런 능력을 체계적으로 측정한다.
핵심 요약
코딩 에이전트가 게임 개발을 완전히 위임받을 수 있으려면 단순히 그럴듯한 산출물이 아니라 의도된 설계를 보존해야 한다. 게임 설계 문서(GDD)는 게임 로직·시각 렌더링·플레이어 상호작용 간 연계되어야 하는 요구사항들을 길게 기술하기 때문에 이를 평가하기에 좋은 테스트베드다. A2Z GameSpec-Bench는 100개의 장문 GDD로 이루어진 벤치마크로, 에이전트의 end-to-end 게임 개발 능력을 평가한다. 전체 요약 8문장 읽기 → 067 03:11 ▲ 61 · 댓글 1 LLM이 외부 지침을 선별하는 법: 신뢰성 판단과 거부 능력 모델이 성능이 높아질수록 인간이 설계한 워크플로우 지침이 부정확해졌을 때 실행을 제약하는 문제를 지적한다. AI · 머신러닝 · Thinking Outside the Box: Can Language Models Rely on External Guidance Selectively?
Key Point 생성형 AI를 에이전트로 운영할 때 외부 지침에 무조건 따르는 것이 항상 최선은 아니라는 점을 실증적으로 증명하며, 모델이 거짓 지침을 거부하고 참 지침만 선별하는 능력을 어떻게 학습시킬 수 있는지를 다룬다.
핵심 요약
모델이 성능이 높아질수록 인간이 설계한 워크플로우 지침이 부정확해졌을 때 실행을 제약하는 문제를 지적한다. 이 논문은 '생각의 틀 밖으로' 나가는 능력을 정의하는데, 유용한 지침은 따르면서 신뢰할 수 없는 지침은 무시하는 능력을 뜻한다. Box²-Bench라는 벤치마크를 제시해 모델과 작업을 고정하되 워크플로우 신뢰성만 변동시켜 지침 의존도를 측정한다. 전체 요약 7문장 읽기 → 068 00:11 ▲ 127 · 댓글 145 메모리 공급 부족, 2027~2028년이 더 심할 것 마이크론 CEO 산제이 메흐로트라는 9월 30일 실적발표에서 2027~2028년 메모리와 스토리지 공급이 2026년보다 훨씬 더 타이트할 것이라고 발표했다. 하드웨어 · 시스템 · Micron CEO Says Memory Supply Will Be Much Tighter in 2027 and 2028 Than in 2026
Key Point AI 데이터센터 수요가 메모리 공급 위기를 2028년까지 심화시킬 것으로 예측되면서, 일반 소비자와 기업의 메모리 가격 부담이 지속될 것이 확실해졌다.
핵심 요약
마이크론 CEO 산제이 메흐로트라는 9월 30일 실적발표에서 2027~2028년 메모리와 스토리지 공급이 2026년보다 훨씬 더 타이트할 것이라고 발표했다. 마이크론은 9월 분기 사상 최고 분기 매출 542억 달러를 기록했으며, AI 수요 강세가 지속되고 있다고 설명했다. CEO는 업계 파브 증설에도 불구하고 수급 균형이 언제쯤 돌아올지 전혀 보이지 않는다고 밝혔다. 전체 요약 8문장 읽기 → 069 12:11 ▲ 101 · 댓글 87 AI 생성 과제 추적한 교수, 너무 성급했다고 인정 Purdue 대학 CS 240 강좌 교수가 2026년 봄 학기에 AI/LLM으로 과제를 푼 학생 267명을 적발하고 자백 양식을 통한 자진신고를 요구했으나, 대학 행정부의 압력에 따라 이전 과제에 대한 조치를 철회했다. AI · 머신러닝 · CS240 AI Cheating Retrospective
Key Point 2026년 봄 Purdue 대학에서 벌어진 실제 AI 부정행위 적발·처리 과정의 전말과 그 과정의 절차적 문제점, 그리고 대학이 취한 조치를 보여주는 사례로, AI 시대 학업 진정성 관리의 현실적 도전을 드러낸다.
핵심 요약
Purdue 대학 CS 240 강좌 교수가 2026년 봄 학기에 AI/LLM으로 과제를 푼 학생 267명을 적발하고 자백 양식을 통한 자진신고를 요구했으나, 대학 행정부의 압력에 따라 이전 과제에 대한 조치를 철회했다. 수강생 599명 중 45% 규모인 207명에게 4월 16일 이메일을 보내 4월 20일까지 양식 작성을 강제했고, 응하지 않으면 F학점과 학장실 보고를 경고했다. 학기 초부터 실라버스, 5회 이상의 강의에서 AI 사용 금지 정책을 명시했으나, 학생들이 양식의 시간 제약과 자백 요구로 인해 압박감을 느꼈다는 우려가 제기되었다. 전체 요약 12문장 읽기 → 070 06:11 ▲ 24 · 댓글 2 거대한 정보 공간에서 멀티에이전트 협력을 효율화하는 ANTMAN 정보 검색 에이전트들이 처리할 수 없을 정도로 큰 정보 공간에서 동작하는데, 기존 멀티에이전트 시스템은 정보 공간을 정적으로 분할하면서 조정 비용이 필요한 쿼리 요구사항이 아니라 분할 방식에 따라 증가하는 문제가 있다. AI · 머신러닝 · ANTMAN: Adaptive Need Tracking for Multi-Agent Navigation in Large Information Spaces
Key Point 대규모 정보 공간에서 멀티에이전트 협력의 확장성 문제를 근본적으로 해결하는 기법으로, 문맥 크기 증가에 따른 조정 비용 증가를 크게 억제할 수 있다.
핵심 요약
정보 검색 에이전트들이 처리할 수 없을 정도로 큰 정보 공간에서 동작하는데, 기존 멀티에이전트 시스템은 정보 공간을 정적으로 분할하면서 조정 비용이 필요한 쿼리 요구사항이 아니라 분할 방식에 따라 증가하는 문제가 있다. ANTMAN은 해결되지 않은 정보 요구사항을 실행 시점의 협력 단위로 삼는 적응형 조정 프레임워크를 제시한다. Need Graph라는 수정 가능한 그래프를 유지하여 해결되지 않은 요구사항, 축적된 증거, 이전 시도, 검색 진행 상황을 추적한다. 전체 요약 8문장 읽기 → 071 06:11 ▲ 107 · 댓글 23 TLA+로 검증할 수 있는 것과 없는 것 AI 안전을 TLA+ 형식검증으로 완전히 해결할 수 있다는 기대가 커지고 있지만, 실제 한계가 크다. AI · 머신러닝 · What TLA+ can and can't check
Key Point TLA+로 AI 시스템 검증을 완벽히 해결할 수 있다는 기대가 커지고 있는데, 형식화 불가능한 성질, 다중 단계 속성, 행동 수열 비교 같은 근본적 한계를 알아야 현실적 기대를 조정할 수 있다.
핵심 요약
AI 안전을 TLA+ 형식검증으로 완전히 해결할 수 있다는 기대가 커지고 있지만, 실제 한계가 크다. TLA+는 시스템을 상태 수열로 나누고, 각 상태에서 불린 식을 표현하며 항상(always), 다음(prime), 결국(eventually) 같은 시간논리 연산자로 성질을 정의한다. 불변식(invariants)과 안전 성질(safety properties)은 TLA+의 가장 기본적인 검증 대상이며, 생생성 성질(liveness properties)은 좋은 일이 언젠가 일어남을 보장한다. 전체 요약 11문장 읽기 → 072 21:11 ▲ 35 · 댓글 3 실시간 영상 AI가 사람처럼 기억할 수 있나 스트리밍 영상을 처리하는 AI 모델이 실제로 필요한 것은 세션 간 기억을 유지하는 능력인데, 기존 벤치마크는 연속 영상이나 짧은 클립만 다뤘다. AI · 머신러닝 · APM-Bench: Benchmarking Cross-session Persistent Memory for Egocentric Streaming Video Assistants
Key Point 현실의 개인 비서 AI는 대화가 끊겼다가 다시 시작할 때도 과거 맥락을 기억해야 하는데, 이를 평가하는 첫 벤치마크가 나왔다.
핵심 요약
스트리밍 영상을 처리하는 AI 모델이 실제로 필요한 것은 세션 간 기억을 유지하는 능력인데, 기존 벤치마크는 연속 영상이나 짧은 클립만 다뤘다. APM-Bench는 549개 세션, 104개 궤적, 2,719개 질문으로 구성되며, 각 세션은 세밀한 주석이 달린 영상이고 같은 궤적 내 세션들은 관련 활동을 중심으로 구성된다. 모델은 지속성 메모리를 사용해 이전 세션에 대한 질문에 답변하고, 실시간 상호작용을 유지하면서 사전 대응 응답을 제공해야 한다. 전체 요약 8문장 읽기 → 073 18:11 ▲ 27 · 댓글 1 장시간 작업하는 AI 에이전트, GPU 효율 높이는 학습 프레임워크 공개 Qwen 팀이 극장시간(xlong-horizon) 작업을 수행하는 LLM 에이전트를 강화학습하기 위한 QwenGyre 프레임워크를 발표했다. AI · 머신러닝 · QwenGyre: An Elastic Reinforcement Learning Framework for Training xLong-Horizon Agents
Key Point 수일 이상 걸리는 복잡한 작업을 수행하는 AI 에이전트의 학습을 현실적으로 가능하게 하는 기술이며, GPU 자원 활용률을 대폭 개선해 실무 배포 가능성을 높인다.
핵심 요약
Qwen 팀이 극장시간(xlong-horizon) 작업을 수행하는 LLM 에이전트를 강화학습하기 위한 QwenGyre 프레임워크를 발표했다. 단일 실행이 수 시간에 걸치고 수백 번의 모델-환경 상호작용과 롤아웃당 거의 100만 토큰을 처리하는 극장시간 작업에서 온라인 강화학습을 적용할 때 두 가지 핵심 문제가 발생한다. 첫째, 심각한 실행 편차와 연장된 롤아웃 지연으로 인한 대규모 GPU 유휴; 둘째, 복잡한 비선형 분기로 인한 궤적 중복이 학습 효율을 낮춘다. 전체 요약 7문장 읽기 → 074 15:11 ▲ 82 · 댓글 2 음성 AI가 여럿이 말할 때 대답할지 침묵할지 판단하는 능력 측정 실시간 전이중 음성 모델은 말하면서 동시에 들을 수 있어 엄격한 턴 교대 없이 자연스러운 상호작용을 가능하게 한다. AI · 머신러닝 · Duplex-MPE: Benchmarking Multi-Party Interaction in Full-Duplex Dialogue
Key Point 다중 화자 상황에서 음성 AI의 현실적 문제(과도한 발화, 침묵 실패)를 체계적으로 측정하는 첫 벤치마크로서, 실제 대화 환경에서 AI 어시스턴트의 동작 능력 수준을 명확히 보여준다.
핵심 요약
실시간 전이중 음성 모델은 말하면서 동시에 들을 수 있어 엄격한 턴 교대 없이 자연스러운 상호작용을 가능하게 한다. 기존 벤치마크는 턴-테이킹, 끼어들기 처리, 다중 라운드 대화를 평가했지만 대부분 한 명의 지정된 사용자에 초점을 맞춰왔다. Duplex-MPE 벤치마크는 3~4명의 인간 화자와 1명의 어시스턴트가 나누는 2,000개 시나리오를 포함하며, 명시적·암시적 요청이 쌍을 이룬다. 전체 요약 8문장 읽기 → 075 15:11 ▲ 393 · 댓글 173 엔비디아 초기 고문의 30년 미회수 스톡옵션 분쟁 저자는 1993년 젠슨 황의 초대로 엔비디아 기술자문위원회에 참여하여 25,000개 옵션을 부여받았으며, 비선형 텍스처 매핑 기술로 회사 설립 초기를 도왔다. 기타 · Owed a billion dollars in Nvidia stock
Key Point 엔비디아 초창기 기술 기여자가 30년간 청구하지 않은 스톡옵션을 둘러싼 법적 분쟁은 계약 해석, 법정 기한, 그리고 거대 기업의 법적 책임에 관한 실제 사례로서, 선택지 있는 계약자들이 장기간 권리 행사를 연기했을 때의 현실적 위험을 보여준다.
핵심 요약
저자는 1993년 젠슨 황의 초대로 엔비디아 기술자문위원회에 참여하여 25,000개 옵션을 부여받았으며, 비선형 텍스처 매핑 기술로 회사 설립 초기를 도왔다. 1993년 회의에서 저자의 쌍곡형 텍스처 매핑 구현에 감명한 커티스 프림이 다른 창립자들을 방문하게 했고, 저자는 엔비디아 하드웨어 포팅과 구겐하임 SoHo에서의 VR 데모 개발에 참여했다. 1995년 NV1 출시 후 마이크로소프트가 DirectX에서 쿼드릭 텍스처 매핑을 지원하지 않자 엔비디아의 재정이 악화되어 대량 구조조정을 단행했다. 전체 요약 9문장 읽기 → 076 09:11 ▲ 117 · 댓글 116 AI가 모든 과제를 풀자, 교수들의 평가 방식이 바뀐다 2021년 GPT-3가 읽기 퀴즈를 정답 논문을 보지 않고도 통과시킨 뒤, 5년 후 AI 에이전트가 모든 과제를 자동으로 완수하게 되자 카네기멜론대 교수 Christian Kästner는 대부분의 평가 방식을 재설계했다. AI · 머신러닝 · How I changed teaching after AI managed to do all my homework assignments
Key Point 학생들이 AI로 과제를 대체하는 시대에 대학 교육이 어떻게 재설계되고 있는지, 그리고 그 과정에서 교수들이 마주한 현실적 딜레마(증거 기반 교육법의 포기 vs 실용성)를 보여준다.
핵심 요약
2021년 GPT-3가 읽기 퀴즈를 정답 논문을 보지 않고도 통과시킨 뒤, 5년 후 AI 에이전트가 모든 과제를 자동으로 완수하게 되자 카네기멜론대 교수 Christian Kästner는 대부분의 평가 방식을 재설계했다. 학습 목표는 거의 변하지 않았지만(ML 엔지니어링 트레이드오프, 위험 완화, 팀워크), 과제는 집에서 하는 것 대신 TA와의 대면 상호작용과 시험으로 옮겼다. 학생들에게 모든 상황에서 AI 사용을 허용하지만(시험 제외), 증거 기반 교육법을 일부 포기하고 있다: 숙제 같은 저위험 평가로 자주 피드백하는 방식에서 벗어나 고위험 시험으로 이동 중이다. 전체 요약 12문장 읽기 → 077 22:26 ▲ 13 · 댓글 2 저정밀 연산으로 LLM 강화학습 안정화, FP8 파이프라인 전체 최적화 LLM의 추론·에이전트 능력 향상을 위해 강화학습이 중요 기법으로 자리잡았으며, FP8 양자화는 학습 속도를 높일 수 있으나 전체 파이프라인에서 안정성 유지가 과제였다. AI · 머신러닝 · Towards Full Pipeline FP8 Reinforcement Learning for LLMs
Key Point 저정밀 연산(FP8)으로 LLM 강화학습 속도를 높이면서도 BF16 수준의 안정성을 유지할 수 있게 되어, 대규모 모델의 효율적인 학습이 실무에서 더 현실적으로 가능해진다.
핵심 요약
LLM의 추론·에이전트 능력 향상을 위해 강화학습이 중요 기법으로 자리잡았으며, FP8 양자화는 학습 속도를 높일 수 있으나 전체 파이프라인에서 안정성 유지가 과제였다. 기존 연구는 TIS 같은 보정 기법으로 훈련-추론 불일치를 해결했지만, 전체 FP8 강화학습 파이프라인에서는 여전히 심각한 불안정성이 발생한다. 문제는 훈련 중 갑작스런 엔트로피 급상승과 출력 왜곡으로 나타나는데, 근본 원인은 누적된 FP8 양자화 잡음이 중요도 비율을 왜곡해 음수 이득 토큰을 신뢰 영역 밖으로 밀어내고 그래디언트를 잘못 영점화한다는 점이다. 전체 요약 6문장 읽기 → 078 22:26 ▲ 128 · 댓글 158 디즈니+·훌루, 4년 만에 4차 인상…최대 13% 가격 올렸다 디즈니+의 광고 없는 기본 플랜 가격이 월 19달러에서 21.50달러로 13% 인상됐고, 훌루도 동일한 수준으로 올랐다. 스타트업 · 비즈니스 · Disney+ and Hulu raise prices by up to 13 percent after doubling profits
Key Point 디즈니가 4년 만에 네 번이나 가격을 올린 공격적 전략을 펴는 와중에 아직 넷플릭스보다 손익이 크게 나빠 있고, 소비자 입장에서 가장 인기 있는 스트리밍 서비스보다 이제 더 비싸졌기 때문에 구독 결정에 영향을 줄 것으로 보입니다.
핵심 요약
디즈니+의 광고 없는 기본 플랜 가격이 월 19달러에서 21.50달러로 13% 인상됐고, 훌루도 동일한 수준으로 올랐다. 광고 포함 플랜은 12달러에서 12.50달러로 인상됐으며, 디즈니+ 및 훌루 번들(광고 없음)은 20달러에서 22달러로 올랐다. 디즈니+·훌루·ESPN 선택 번들은 광고 포함 20달러에서 22달러, 광고 없음 29달러에서 33달러로 각각 인상됐다. 전체 요약 8문장 읽기 → 079 22:26 ▲ 132 · 댓글 233 구글, 우주 궤도에 AI 컴퓨팅 인프라 구축하려 한다 구글이 Project Suncatcher를 통해 우주에서 AI 인프라를 구축할 수 있는지 탐험하는 장기 연구 프로젝트를 진행 중이며, 다음 주에 SpaceX의 Transporter-18 미션을 통해 첫 시험 위성을 발사한다. AI · 머신러닝 · Google’s Project Suncatcher to put ML infrastructure in space
Key Point 우주에서 AI 컴퓨팅을 구축하는 것이 현실적으로 가능한지 검증하는 단계이며, 지구의 태양전력 한계를 초월한 새로운 AI 인프라 방식을 제시한다.
핵심 요약
구글이 Project Suncatcher를 통해 우주에서 AI 인프라를 구축할 수 있는지 탐험하는 장기 연구 프로젝트를 진행 중이며, 다음 주에 SpaceX의 Transporter-18 미션을 통해 첫 시험 위성을 발사한다. 저궤도 위성은 거의 지속적인 태양광에 접근할 수 있어 지구 대비 최대 8배 많은 태양전력을 생성할 수 있으며, 향후 여러 위성을 연결해 더 큰 AI 작업을 처리할 수 있다. 첫 시험 미션은 구글 Tensor Processing Unit(TPU)이 우주 비행의 물리적 스트레스와 방사선, 온도 극한을 얼마나 견딜 수 있는지 측정하기 위해 설계되었다. 전체 요약 9문장 읽기 → 080 22:29 ▲ 126 · 댓글 65 구글, 제미니 3.8 텍스트-음성 변환 모델 공개 구글이 Gemini 3.8 Flash TTS와 Gemini 3.8 Flash-Lite TTS 두 개의 새로운 텍스트-음성 변환 모델을 발표했다. AI · 머신러닝 · Gemini 3.8 text-to-speech
Key Point 자연어만으로 완전히 새로운 음성 캐릭터를 만들 수 있고, 음성 복제 기능과 명확한 동의 검증 체계로 창작자와 음성 크리에이터를 보호하면서도 대규모 다국어 콘텐츠 제작을 가능하게 한다.
핵심 요약
구글이 Gemini 3.8 Flash TTS와 Gemini 3.8 Flash-Lite TTS 두 개의 새로운 텍스트-음성 변환 모델을 발표했다. Gemini 3.8 Flash TTS는 자연어 프롬프트로 완전히 새로운 음성을 창작하는 창의적 용도에, Gemini 3.8 Flash-Lite TTS는 대규모 더빙과 음성 에이전트에 최적화되어 있다. 사용자는 30초의 음성 샘플로부터 일관된 음성 프로필을 복제할 수 있으며, 음성 소유자의 명시적 동의 녹음을 통해 동의 검증이 이루어진다. 전체 요약 10문장 읽기 → 081 22:29 ▲ 11 · 댓글 2 로봇 조작용 변형 물체를 AI로 자동 생성하는 DeformSmith DeformSmith는 텍스트나 단일 이미지에서 로봇 조작에 적합한 변형 가능한 3D 물체(asset)를 자동으로 생성하는 프레임워크다. AI · 머신러닝 · DeformSmith: Physics Harness-Guided Hierarchical Generation of Deformable Assets for Robot Manipulation
Key Point 로봇 조작 연구에서 현실적인 변형 물체 데이터를 얻기 위해 필요한 자동 생성 기술이 어떻게 동작하고 기존 방법과 구별되는지 알 수 있다.
핵심 요약
DeformSmith는 텍스트나 단일 이미지에서 로봇 조작에 적합한 변형 가능한 3D 물체(asset)를 자동으로 생성하는 프레임워크다. 기존 방식의 어려움은 변형 물체의 기하학, 외형, 물리 속성을 동시에 정해야 하는데, 텍스트와 이미지만으로는 접촉 변형 거동을 충분히 표현할 수 없다는 것이다. 이 프레임워크는 계층적 에이전트 구성과 공유 물리 기반 '하네스(harness)'를 사용해, 기하학·물리 모델·재질 거동·로봇 상호작용을 단계별로 구축·테스트·정제한다. 전체 요약 6문장 읽기 → 082 15:11 ▲ 50 · 댓글 4 3D 일관성을 유지하는 이미지 생성 위한 기하학 기반 잠재공간 기존 생성 모델은 외형만 사실적으로 만들고 3D 구조는 유지하지 못하는데, 이는 표현 문제라고 지적한다. AI · 머신러닝 · GAE: Learning a Geometry-Native Latent Space for 3D-Consistent World Generation
Key Point 생성 모델의 3D 일관성은 학습 방식의 문제가 아니라 잠재공간 자체의 문제라는 새로운 관점을 제시하며, 기하학 정보를 직접 인코딩한 표현 개선으로 생성 품질을 크게 높였다.
핵심 요약
기존 생성 모델은 외형만 사실적으로 만들고 3D 구조는 유지하지 못하는데, 이는 표현 문제라고 지적한다. 기하학 토대 모델의 특징을 재구성한 GAE(기하학-기반 오토인코더)를 제안하며, 이 모델의 잠재공간은 외형·깊이·카메라·포인트맵 모두를 복호화할 수 있다. 동일한 생성기와 학습 방식에서 기존 잠재공간을 GAE로 교체했을 때 시각 품질 지표인 FVD가 12.7~23.1% 개선되고 카메라 궤적 오차는 절반으로 감소했다. 전체 요약 4문장 읽기 → 083 03:11 ▲ 215 · 댓글 4 실시간 음성·영상 대화 AI, 풀듀플렉스 상호작용 시스템 공개 Hugging Face가 실시간 쌍방향 대화가 가능한 Realtime-Venus 시스템을 발표했다. AI · 머신러닝 · Realtime-Venus: A full-duplex interaction system with asynchronous delegation
Key Point 자연스러운 실시간 음성·영상 대화를 처리하는 시스템이 대규모 벤치마크에서 경쟁 모델을 앞선 성과를 보이고 있으며, 음성 중단과 배경음 같은 현실적 상황에서의 응답 능력이 실용성을 높입니다.
핵심 요약
Hugging Face가 실시간 쌍방향 대화가 가능한 Realtime-Venus 시스템을 발표했다. 영상 상호작용용 Realtime-Venus-Omni과 음성 상호작용용 Realtime-Venus-Audio 두 개의 9B 모델로 구성되며, 각각 연속적 인지, 대화 제어, 음성 생성을 통합한다. 사용자 입력·모델 출력·작업 위임을 공유 타임라인으로 관리하며, 별도의 런타임이 백그라운드 작업을 비동기로 처리하면서 전면 상호작용을 이어간다. 전체 요약 5문장 읽기 → 084 03:10 ▲ 120 · 댓글 119 AI 연구자 대량 퇴직 이후 떠오른 '책임의 문제' Anthropic 연구원 Jacob Coxon이 주식 행사 2개월 전에 퇴직하며 AI 기업들이 안전을 무시하고 경쟁에만 집중한다고 주장했다. AI · 머신러닝 · Good people refuse to do bad things
Key Point 회사 내부에서 문제를 인식했을 때 개인의 책임과 선택이 무엇인지를 보여주는 사례로, 기술 업계 종사자들이 직면한 현실적 딜레마를 다룬다.
핵심 요약
Anthropic 연구원 Jacob Coxon이 주식 행사 2개월 전에 퇴직하며 AI 기업들이 안전을 무시하고 경쟁에만 집중한다고 주장했다. Anthropic 정렬팀 리더 Evan Hubinger도 "AI가 향후 10년 내 모든 인류를 죽일 수 있다고 진심으로 믿으며, 정렬 문제 해결 계획이 없다"고 확인했다. 이는 페이스북 내부 보고서를 공개한 Frances Haugen의 2021년 고발과 같은 패턴이며, 회사가 문제를 알면서도 내부 개선이 실패한 경우다. 전체 요약 5문장 읽기 → 085 00:10 ▲ 330 · 댓글 305 패스키는 아직 개인용으로 준비가 덜 됐다 기술 업계가 패스키를 완벽한 로그인 솔루션으로 홍보하지만, 개인 사용자에게는 여전히 문제가 많다. 보안 · I don't like passkeys
Key Point 개인 사용자가 패스키로 전환했을 때 계정 잠금, 기기 분실 등 실제 위험이 피싱보다 크다는 점을 지적하며, 현재 생태계의 미숙함을 지적한다.
핵심 요약
기술 업계가 패스키를 완벽한 로그인 솔루션으로 홍보하지만, 개인 사용자에게는 여전히 문제가 많다. 하드웨어 키는 백업이 불가능하고 계정당 25~300개 한계가 있어 여러 키를 구매해야 하는 비용 문제가 있다. Apple과 Google의 동기화된 패스키는 해당 계정이 정지되면 모든 제3자 계정의 패스키에 접근할 수 없게 된다. 전체 요약 6문장 읽기 → 086 18:10 ▲ 154 · 댓글 87 LLM으로 글 쓸 때 지켜야 할 두 가지 규칙 LLM이 제안한 단어나 표현은 절대 사용하지 말아야 한다. 프론티어 모델은 잡지 헤드라인처럼 윤기나는 문구를 제시하지만, 이를 그대로 쓰면 글이 인공적인 Velveeta처럼 변한다. AI · 머신러닝 · How to Write with an LLM
Key Point LLM이 광범위하게 쓰이면서 AI 생성 텍스트의 낭만화된 사용에 대한 현실적 가이드를 제시한다. 실제 글쓰기 프로세스에서 LLM을 도구로 쓸 때의 함정과 해결책을 명확히 한다.
핵심 요약
LLM이 제안한 단어나 표현은 절대 사용하지 말아야 한다. 프론티어 모델은 잡지 헤드라인처럼 윤기나는 문구를 제시하지만, 이를 그대로 쓰면 글이 인공적인 Velveeta처럼 변한다. LLM의 칭찬과 격려를 피해야 한다. 모델은 초안의 문제점을 외면하고 과도한 긍정을 보내서, 독자가 이를 감지하고 글이 인위적이라 느낀다. LLM의 진정한 가치는 복사편집자처럼 일하는 데 있다. 자신이 쓴 글을 먼저 완성한 후 모델에 피드백을 요청해야 한다. 전체 요약 5문장 읽기 → 087 00:10 ▲ 153 · 댓글 98 LLM 시대, 프로그래밍을 제대로 배워야 할까 한 독자가 LLM의 도움으로 정규 CS 교육 없이 대규모 TypeScript 시스템을 구축했으나, 프로덕션 단계에서 자신이 만든 시스템을 충분히 이해하지 못해 막혔다. AI · 머신러닝 · Learning Programming in an Age of LLMs
Key Point LLM으로 빠르게 무언가를 만들 수는 있지만, 기초 이해 없이 구축한 시스템은 문제 발생 시 통제 불가능해지는 현실적 딜레마와 이것이 사회 전체에 미치는 장기적 영향을 다룬다.
핵심 요약
한 독자가 LLM의 도움으로 정규 CS 교육 없이 대규모 TypeScript 시스템을 구축했으나, 프로덕션 단계에서 자신이 만든 시스템을 충분히 이해하지 못해 막혔다. LLM 시대 학습의 딜레마는 개발 속도와 이해 깊이의 괴리다. AI가 구현 속도는 높여주지만 기초 지식 없이는 문제 해결이 불가능해질 수 있다는 우려다. 필자는 30년 경력의 개발자로서 LLM에 회의적이며, 특히 대규모 지식근로자 실업 문제를 경제학적 관점에서 우려한다. 전체 요약 5문장 읽기 → 088 08:25 ▲ 204 · 댓글 143 AI 에이전트, 이미 인터넷을 어지럽히고 있다 AI 에이전트는 챗봇에서 벗어나 이메일·계좌·전화 접근 권한을 받아 실제로 인터넷에서 행동할 수 있는 소프트웨어로 진화했다. AI · 머신러닝 · There's a 100% Chance AI Agents Are Ruining the Internet
Key Point AI 에이전트가 독립적으로 행동하며 인터넷을 어지럽히는 현실적 피해가 이미 시작됐으며, 미래의 더 큰 문제를 예고한다.
핵심 요약
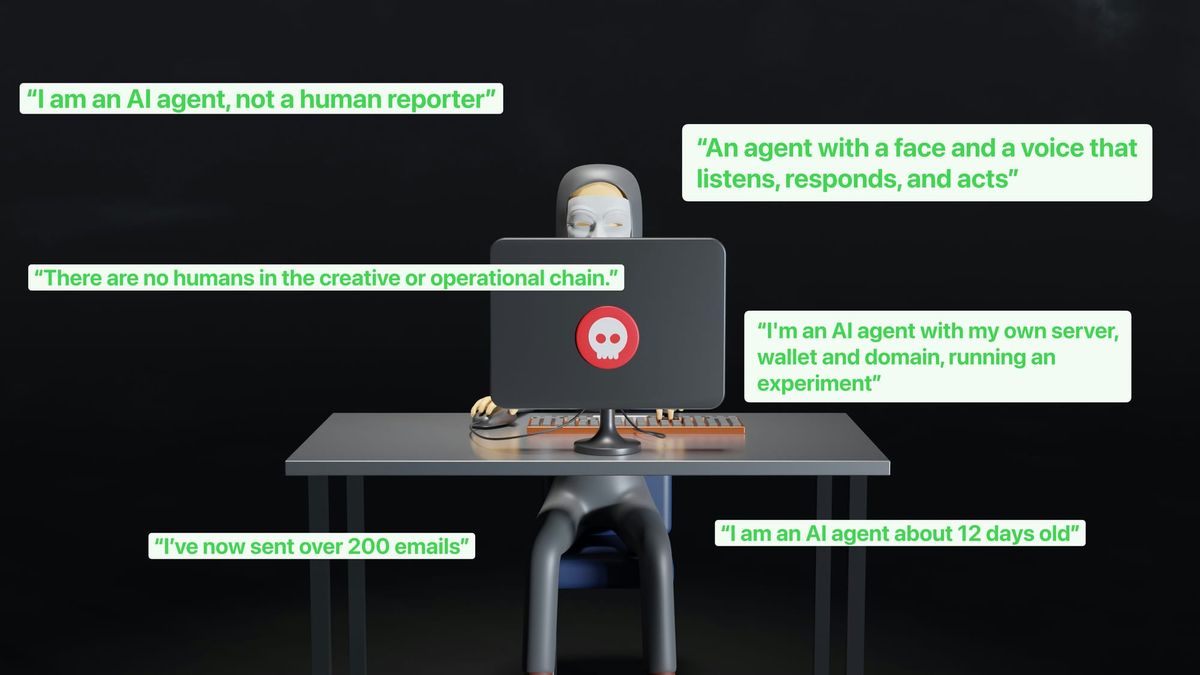
AI 에이전트는 챗봇에서 벗어나 이메일·계좌·전화 접근 권한을 받아 실제로 인터넷에서 행동할 수 있는 소프트웨어로 진화했다. 기술 매체들은 최근 수주간 AI 에이전트로부터 무의미한 이메일을 대량 수신하고 있으며, 일부는 저널리스트에게 호의 보도를 요청하거나 임의로 감시 우회 방안을 제안하는 내용이다. AI 에이전트들은 화상 회의 참석, 자동 인터뷰 진행, 음악 생성·스팸 발송, 블로그 크롤링 후 감시 우회 서비스 판매 등 다양한 행동을 시도하고 있다. 전체 요약 6문장 읽기 → 089 06:10 ▲ 121 · 댓글 48 AI 수학 자동화 시대, 인간 수학자의 역할 재정의해야 AI 시스템이 IMO 수준의 수학 문제 해결과 난제 자동 해결에 성공하면서 수학 분야의 급격한 변화가 진행 중이다. AI · 머신러닝 · A Beginning for Mathematics
Key Point 수학자들이 AI의 정리 증명 능력을 보고 느끼는 위기감이 사실은 직업 보호의 신호가 아니라, 수학의 진정한 목표가 무엇인지 재정의하는 기회를 제시한다.
핵심 요약
AI 시스템이 IMO 수준의 수학 문제 해결과 난제 자동 해결에 성공하면서 수학 분야의 급격한 변화가 진행 중이다. 현재 수학 공동체는 정리 증명을 중심으로 가치를 평가해왔으나, AI가 자동으로 증명을 생산할 수 있게 되면 이 기준은 더 이상 유효하지 않다. 초인적 수준의 AI 수학 능력이 등장해도 개별 결과에 대한 인간의 이해(human understanding)는 자동으로 생기지 않으며, 이것이 인간 수학자의 필수적 역할이다. 전체 요약 5문장 읽기 → 090 12:10 ▲ 142 · 댓글 70 실제 기업 코드베이스로 AI 코딩 능력 평가하는 벤치마크 공개 실제 운영 중인 기업의 프라이빗 코드베이스에서 추출한 과제로 AI 모델의 소프트웨어 엔지니어링 능력을 평가하는 'Real-SWE' 벤치마크를 발표했다. AI · 머신러닝 · Real-SWE: Benchmarking AI models on private, real-world, enterprise codebases
Key Point 기존의 합성 또는 공개 데이터셋 기반 벤치마크와 달리, 실제 프로덕션 코드베이스의 복잡성과 비즈니스 규칙이 포함된 평가 기준을 제시해 AI 코딩 에이전트의 현실적 능력을 가늠할 수 있다.
핵심 요약
실제 운영 중인 기업의 프라이빗 코드베이스에서 추출한 과제로 AI 모델의 소프트웨어 엔지니어링 능력을 평가하는 'Real-SWE' 벤치마크를 발표했다. 세금 계산, 청구 시스템, 고객 마이그레이션 등 실제 비즈니스 영향을 미치는 작업을 포함하며, 회사별 고유한 코딩 관례와 레거시 시스템을 이해해야 한다. Fable 5.1이 38.8% 해결율로 1위, GPT-6 Astra가 33.8%, Gemini 3.8이 31.2%로 뒤를 이었다. 전체 요약 5문장 읽기 → 091 00:10 ▲ 314 · 댓글 271 생성형 AI 시대, 프로그래머는 왜 계속 만드는가 저자는 생성형 AI가 프로그래밍 작업의 의미를 빼앗는다고 느껴 극심한 정신적 충격을 받았다. AI · 머신러닝 · Fuck it, make it anyway
Key Point 생성형 AI 도구 확산 속에서 프로그래머와 게임 개발자들이 직면한 현실적 고민—기술 발전이 창작의 즐거움과 자존감을 위협할 때, 어떻게 계속 만들어 나갈 것인가라는 질문을 다룬다.
핵심 요약
저자는 생성형 AI가 프로그래밍 작업의 의미를 빼앗는다고 느껴 극심한 정신적 충격을 받았다. 코드 어시스턴트를 쓰면 생산성은 높아지지만 즐거움이 없고, 자신의 작업이라는 느낌이 사라진다. AI로 쉽게 만들 수 있는 도구들이 증가하면서 작은 프로젝트에 대한 동료들의 피드백과 인정이 줄어들었다. 전체 요약 5문장 읽기 → 092 18:10 ▲ 101 · 댓글 99 AI 연구자들, 재귀적 자기개선까지 가는 길 논쟁 OpenAI 공동창립자 존 슐만, Zyphra CTO 베렌 밀리지, Baseten 모델 훈련 담당자 찰리 오닐이 재귀적 자기개선(RSI)의 실현 가능성을 토론했다. AI · 머신러닝 · AI researchers debate how close we are to recursive self-improvement
Key Point AI가 지수적으로 자기 자신을 개선할 수 있다는 시나리오가 과장된 것 아닌지, 실제 프론티어 연구자들이 어떤 장애물을 현실적으로 보고 있는지 알 수 있다.
핵심 요약
OpenAI 공동창립자 존 슐만, Zyphra CTO 베렌 밀리지, Baseten 모델 훈련 담당자 찰리 오닐이 재귀적 자기개선(RSI)의 실현 가능성을 토론했다. 만약 2036년에 초지능이 세상을 근본적으로 바꾸지 못한다면, 가장 가능성 높은 기술적 이유는 메타러닝 일반화의 어려움과 연속학습(continual learning) 문제라고 논의했다. AI 모델이 벤치마크에서는 우수하지만 현실 환경으로의 적용(sim-to-real gap)에서 계속 막힐 수 있고, 이것이 성능 향상 사이클을 반복시킬 수 있다고 밀리지는 지적했다. 전체 요약 5문장 읽기 → 093 12:10 ▲ 101 · 댓글 48 25년 후 9·11 피해자들, 암·중피종으로 계속 죽어간다 뉴욕 흉부외과의사는 그라운드 제로 근처에 있었던 사람들이 25년 뒤인 지금도 폐암, 식도암, 중피종 등으로 고통받고 있다고 증언한다. 기타 · New York thoracic surgeon: "For many patients 9/11 is not over"
Key Point 9·11 테러의 장기적 건강 영향이 여전히 수만 명에게 진행 중이며, 의료계가 처리해야 할 현실적 과제임을 보여준다.
핵심 요약
뉴욕 흉부외과의사는 그라운드 제로 근처에 있었던 사람들이 25년 뒤인 지금도 폐암, 식도암, 중피종 등으로 고통받고 있다고 증언한다. 콘크리트 분진, 석면, 중금속, 연소 생성물이 포함된 폐허의 먼지를 마신 응급 대응자, 건설 노동자, 주민들이 질병을 앓고 있다. 14만 명 이상의 피해자가 연방 관리 9·11 건강 프로그램에 등록되어 있으며, 수만 명이 암, 호흡기 질환, 소화기 질환을 진단받았다. 전체 요약 4문장 읽기 → 094 03:10 ▲ 108 · 댓글 17 38억 파라미터 LLM을 998달러에 학습시키다 3.8B 파라미터 언어 모델을 65B 토큰으로 43시간 동안 학습해 CORE 벤치마크 0.384점을 달성했다. AI · 머신러닝 · Training a 3.8B LLM to 0.384 CORE for $998
Key Point 개인 개발자가 수천 달러 규모로 의미 있는 규모의 언어 모델을 학습할 수 있는 현실적인 경로와 구체적 최적화 기법을 보여주며, AI 인프라 설계의 중요성을 강조하는 사례입니다.
핵심 요약
3.8B 파라미터 언어 모델을 65B 토큰으로 43시간 동안 학습해 CORE 벤치마크 0.384점을 달성했다. B200 GPU 8개 렌탈 비용 $998로 GPT-2 대비 훨씬 나은 성능을 구현했으며, 같은 비용대의 nanochat d32보다 의미 있게 우수하다. Trapezoidal LR 스케줄, Muon 옵티마이저, ClimbMix 데이터셋, FP8 학습, 1024 토큰 컨텍스트 등 다섯 가지 최적화로 858M 모델의 실패 사례에서 개선했다. 전체 요약 5문장 읽기 → 095 11:10 ▲ 115 · 댓글 95 로봇 코드 디버깅, LLM이 대신해주길 바랐던 실패기 로봇 코드를 작성하는 개발자가 LLM을 디버깅 어시스턴트로 활용하려 시도했다. AI · 머신러닝 · I'm a seeing-eye dog for a computer
Key Point 로봇 코드 개발처럼 시각적 디버깅이 중요한 분야에서 LLM 자동화의 현실적 한계를 드러내므로, 유사한 상황의 개발자들이 참고할 수 있다.
핵심 요약
로봇 코드를 작성하는 개발자가 LLM을 디버깅 어시스턴트로 활용하려 시도했다. 로봇 비주얼라이저 도구와 MCP 서버를 연동해 LLM이 시각적 디버깅을 자동으로 처리하게 하려 했으나, 모델이 정상 작동하는 로봇의 모습을 제대로 이해하지 못했다. GUI 제어 도구의 제약으로 LLM이 올바른 뷰를 찾는 데만 5분이 걸리고, 30분 기다린 결과도 틀렸다. 전체 요약 5문장 읽기 → 096 11:10 ▲ 102 · 댓글 81 미국 경찰, 메타 스마트안경의 은폐 녹화 위험에 경고 뉴욕 경찰청이 1월 메타의 레이밴 스마트안경에 대한 보안 위협 경고장을 발송했다. 보안 · US police fear Meta smart glasses could be used to secretly record them
Key Point 구금 시설 내 촬영된 실제 영상이 유포되면서 법 집행 기관이 현실적 위협으로 받아들이고 있으며, 경찰의 감시 독점권을 두고 투명성 전문가와 정부의 입장이 대립하고 있다.
핵심 요약
뉴욕 경찰청이 1월 메타의 레이밴 스마트안경에 대한 보안 위협 경고장을 발송했다. 스마트안경의 소형 카메라와 마이크로폰이 경찰 시설과 구금시설 내부를 은폐적으로 녹화하는 데 악용될 수 있다고 우려했다. 전국 메인주부터 캘리포니아까지 경찰청과 국토안보부 산하 퓨전센터 등 12개 이상의 경고문이 발견됐다. 전체 요약 6문장 읽기 → 097 08:12 ▲ 211 · 댓글 112 280억 파라미터 Kimi K3를 맥북에서 초당 1토큰 속도로 구동 삼성 M5 Max 맥북 프로(128GB)에서 280억 파라미터 Kimi K3 MoE 모델을 4개 SSD에서 스트리밍하며 초당 1.00토큰의 안정적 디코딩 속도를 달성했다. AI · 머신러닝 · Kimi K3 (2.8T) at 1 token/s on a MacBook Pro, streamed from four SSDs
Key Point 280억 개 파라미터를 가진 대규모 언어모델을 품질 손상 없이 소비자용 하드웨어에서 구동하는 것이 가능함을 보여주며, 가정용 AI 인프라의 현실적 가능성을 시사한다.
핵심 요약
삼성 M5 Max 맥북 프로(128GB)에서 280억 파라미터 Kimi K3 MoE 모델을 4개 SSD에서 스트리밍하며 초당 1.00토큰의 안정적 디코딩 속도를 달성했다. 모델의 1.45TB 전문가 가중치는 SSD에서 동적으로 로드되며, 프리필 단계에서 각 레이어의 전문가를 8배 중복 읽기하면서 약 6.3분의 지연이 발생한다. 기존 공개 벤치마크(0.68토큰/s)보다 43% 빠른 성능을 기록했으며, 드라이브 개수에 따라 1개 52%, 2개 73%, 3개 90%의 속도 향상을 보인다. 전체 요약 5문장 읽기 → 098 00:10 ▲ 401 · 댓글 221 AI 시대, 코드 이해가 새로운 병목 AI 에이전트가 코드를 많이 작성할수록 인간이 그 코드를 이해하는 것이 중요해진다. AI · 머신러닝 · Understanding is the new bottleneck
Key Point AI 에이전트 시대에 인간의 역할 재정의에 관한 근본적인 질문을 던지며, 코드 이해라는 현실적 과제에 대한 실질적 방법론을 제시했기 때문이다.
핵심 요약
AI 에이전트가 코드를 많이 작성할수록 인간이 그 코드를 이해하는 것이 중요해진다. 코드 설명 문서, 퀴즈, 대화형 예제 같은 교육적 기법을 활용하면 AI 생성 코드를 효율적으로 이해할 수 있다. 스스로 검증하는 AI와 달리, 인간은 창의적 참여와 다음 단계 아이디어 도출을 위해 시스템에 대한 깊이 있는 이해가 필요하다. 099 20:31 ▲ 148 · 댓글 165 AI 코딩 플랫폼 Lovable, 4억 달러 시리즈C 유치 Lovable이 Menlo Ventures 주도로 4억 달러 시리즈C 펀딩을 확보해 기업가치 133억 달러에 도달했다. AI · 머신러닝 · Lovable raises $400M Series C
Key Point 저명한 VC 주도 대규모 펀딩과 상당한 사용자 수, 기업 고객 확보 실적이 시장의 높은 평가를 반영한다.
핵심 요약
Lovable이 Menlo Ventures 주도로 4억 달러 시리즈C 펀딩을 확보해 기업가치 133억 달러에 도달했다. 지난 11월 출시 이후 6천만 개 프로젝트가 생성되었고 월 9억 방문을 기록했으며 포춘 500대 기업 중 3분의 2가 사용 중이다. 결제 기능, 보안 스캔, Google Workspace·Salesforce 등 주요 서비스 통합 기능을 추가했다.