쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
33건 · "고해상도"조건 지우기 ×
001 21:11 ▲ 105 · 댓글 32 애플 휴직 후 첫 프로젝트, 썬더스캔 개발 1984년 3월 애플을 휴직한 이후 처음 진행한 상업 프로젝트는 썬더웨어(Thunderware)라는 작은 회사와 협력하여 개발한 매킨토시용 저가 고해상도 스캐너 썬더스캔(Thunderscan)이었다. 하드웨어 · 시스템 · Switcher (2004)
Key Point 1980년대 초 매킨토시 생태계의 주요 주변기기 개발 과정을 직접 체험한 인물의 1인칭 회고로, 초기 컴퓨터 주변기기 산업의 실제 개발 흐름을 보여준다.
핵심 요약
1984년 3월 애플을 휴직한 이후 처음 진행한 상업 프로젝트는 썬더웨어(Thunderware)라는 작은 회사와 협력하여 개발한 매킨토시용 저가 고해상도 스캐너 썬더스캔(Thunderscan)이었다. 1984년 6월부터 개발을 시작했으며, 1984년 10월 초 거의 완성 단계에 도달했다. 002 18:15 스타 5,755 젤다 티어스 오브 더 킹덤 PC 네이티브 포팅 완성 Nintendo Switch용 젤다 티어스 오브 더 킹덤을 x86-64 네이티브 코드로 정적 재컴파일해 Windows와 Linux에서 직접 실행하는 프로젝트다. 오픈소스 · 도구 · valentderah/totk-pc-recomp · C
Key Point 에뮬레이션 없이 Switch 게임을 Windows/Linux 네이티브로 고주사율·고해상도·DLSS로 플레이할 수 있는 기술이 현실화되었기 때문이다.
핵심 요약
Nintendo Switch용 젤다 티어스 오브 더 킹덤을 x86-64 네이티브 코드로 정적 재컴파일해 Windows와 Linux에서 직접 실행하는 프로젝트다. 게임 파일은 포함되지 않으며, 사용자가 자신의 콘솔에서 추출한 정품 게임 파일(기본판 및 1.1.0, 1.2.1, 1.4.3 업데이트)이 필요하다. 에뮬레이션이 아닌 네이티브 코드 실행으로 작동하며, 기본 60fps, 최대 144fps 또는 모니터 주사율까지 지원한다. 전체 요약 13문장 읽기 → 003 18:15 스타 6,398 AI 그림 그릴 때 쓸 포즈·옷·얼굴 참고도 모음…중국 개발자가 한글화 AI 그림 생성용 포즈 1,439개, 옷 3,224세트, 얼굴 1,499명 = 총 6,162개 참고 자료를 한글 메타데이터와 함께 모아 놓은 갤러리다. AI · 머신러닝 · anhao/ai-pose-gallery-zh · TypeScript
Key Point AI 그림을 그릴 때 자세·복장·얼굴을 한 곳에서 찾고 조합한 뒤 바로 여러 이미지 생성 API로 보낼 수 있는 통합 도구가 생겼다.
핵심 요약
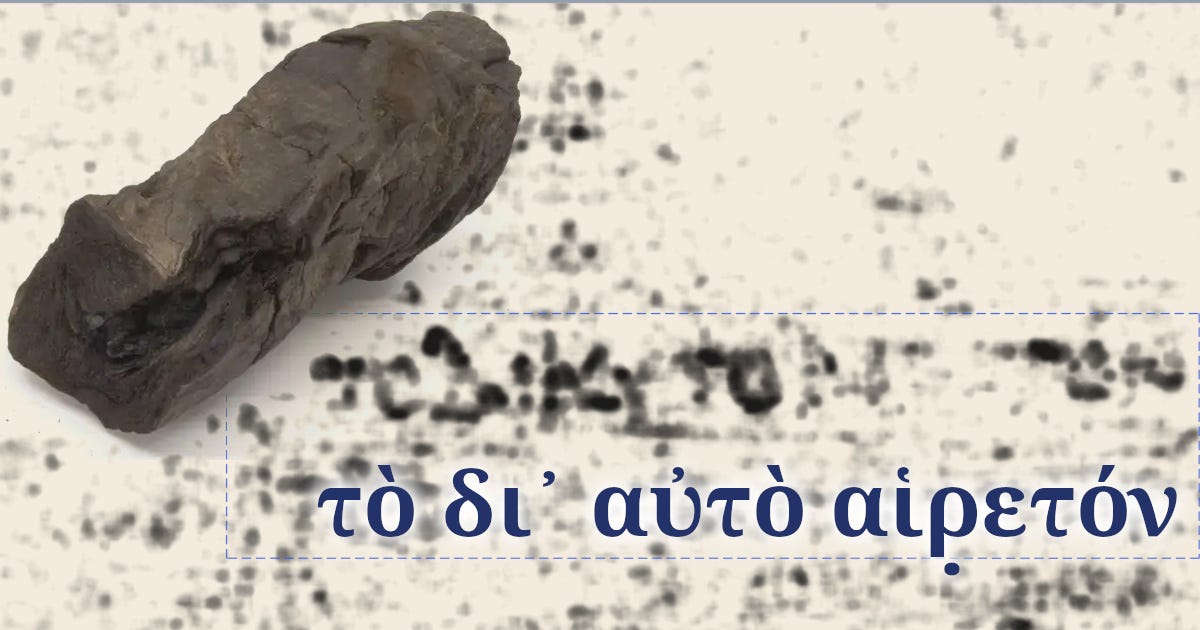
AI 그림 생성용 포즈 1,439개, 옷 3,224세트, 얼굴 1,499명 = 총 6,162개 참고 자료를 한글 메타데이터와 함께 모아 놓은 갤러리다. 원본은 일본 개발자 ギア가 만든 세 개 사이트(포즈·옷·얼굴)를 중국 개발자 Anhao가 하나로 통합하고 전부 중문화했다. 포즈는 소체 백모 2,878장 + 깊이맵 2,878장, 옷은 사진 1,407세트 + 역사 복식 57세트 + 애니메 1,320세트 + 2차원 440세트, 얼굴은 정면 893개 + 스타일 606개로 나뉜다. 전체 요약 8문장 읽기 → 004 09:11 ▲ 113 · 댓글 15 2000년 만에 읽힌 로마 고대 두루마리의 글귀 AD 79년 베수비우스 산 폭발로 묻혔던 PHerc. 306 두루마리가 1750년대 발굴 후 지난해 마이크로-CT 스캔으로 디지털화됐으며, 이제 처음으로 내용이 읽혔다. AI · 머신러닝 · Writing seen in PHerc. 306B, for the first time in 2000 years
Key Point 고대 유산을 현대 기술로 복구하는 분야에서 AI와 인문학적 전문성의 협력이 불가능해 보이는 도전을 어떻게 실현했는지 보여주는 사례다.
핵심 요약
AD 79년 베수비우스 산 폭발로 묻혔던 PHerc. 306 두루마리가 1750년대 발굴 후 지난해 마이크로-CT 스캔으로 디지털화됐으며, 이제 처음으로 내용이 읽혔다. 베수비우스 챌린지 커뮤니티에서 25개 제출물을 검토한 결과 리암 워너와 니콜라 보딜이 5만 달러 상금을 받는 '첫 글자 상'을 수상했다. PHerc. 306은 두 부분(306A, 306B)으로 나뉜 두루마리인데, 잉크 식별과 글씨 방향 분석으로 306B가 원본 상단부, 306A가 하단부임이 확인됐다. 전체 요약 11문장 읽기 → 005 15:11 ▲ 19 · 댓글 2 동영상 손톱 따기를 7배 빠르게, 4K에서도 실시간 처리 고해상도 동영상에서 머리카락 같은 미세한 디테일과 투명도를 보존하면서 프레임 간 일관성을 유지하는 비디오 매팅(영상 배경 분리) 문제를 다룬다. AI · 머신러닝 · MatAnyone-E: Sparse Memory Propagation for Efficient High-Resolution Video Matting
Key Point 4K 동영상도 실시간 처리가 가능한 수준으로 효율을 개선한 기술이며, 헤어 디테일 보존이 중요한 영상 편집·라이브 스트리밍 용도에 실용적 영향을 미친다.
핵심 요약
고해상도 동영상에서 머리카락 같은 미세한 디테일과 투명도를 보존하면서 프레임 간 일관성을 유지하는 비디오 매팅(영상 배경 분리) 문제를 다룬다. 기존 메모리 기반 방식은 이전 프레임의 정보와 현재 프레임을 매칭하지만 해상도가 높아질수록 비용이 급증한다. MatAnyone-E는 저해상도에서 먼저 불확실한 영역과 관련 메모리를 파악한 뒤, 해당 부분만 고해상도로 정밀 매칭하고 나머지는 저해상도 결과를 재사용한다. 전체 요약 6문장 읽기 → 006 21:12 ▲ 28 · 댓글 2 비디오 언어 모델로 e스포츠 실시간 연출과 해설 자동화 e스포츠 실시간 방송은 초 단위로 어느 카메라를 송출할지 결정하고 해설하는 연출자와 해설자가 필요하며, 미래를 알 수 없는 상황에서 진행된다. AI · 머신러닝 · DirCast: Live Esports Directing and Commentary with a Single Streaming Video-Language Model
Key Point 실시간 영상 생성 능력을 갖춘 대규모 언어 모델이 단순 해석을 넘어 실시간 의사결정(카메라 선택)이 필요한 프로덕션 수준의 작업을 수행할 수 있다는 점을 실증한 첫 사례입니다.
핵심 요약
e스포츠 실시간 방송은 초 단위로 어느 카메라를 송출할지 결정하고 해설하는 연출자와 해설자가 필요하며, 미래를 알 수 없는 상황에서 진행된다. 기존 스트리밍 비디오 언어 모델은 인간 연출자가 이미 제작한 방송을 보고 해설만 했으나, 이 논문은 모든 선수 카메라의 원본 영상을 받아 직접 연출과 해설을 동시에 수행하는 라이브 방송 제작을 다룬다. DirCast는 매초 모든 카메라를 저해상도로 스캔하고, 홀드-또는-스위치 연출자로 컷 여부와 위치를 결정한 뒤, 선택된 카메라를 고해상도로 읽고 해설을 생성한다. 전체 요약 7문장 읽기 → 007 03:11 ▲ 174 · 댓글 59 영웅전설 2 엔진을 갈아엎다, fheroes2 오픈소스 재제작 프로젝트 fheroes2는 게임 '영웅전설 2: 마법과 전투'의 게임 엔진을 처음부터 새로 만든 멀티플랫폼 오픈소스 프로젝트다. 오픈소스 · 도구 · fheroes2: A recreation of Heroes of Might and Magic II game engine
Key Point 1990년대 명작 턴 기반 전략 게임을 현대적 그래픽과 개선된 AI로 새로이 즐길 수 있는 오픈소스 프로젝트의 현황을 확인할 수 있습니다.
핵심 요약
fheroes2는 게임 '영웅전설 2: 마법과 전투'의 게임 엔진을 처음부터 새로 만든 멀티플랫폼 오픈소스 프로젝트다. 고해상도 그래픽 지원, 개선된 AI, 다수의 버그 수정, 사용자 인터페이스 향상 등으로 원작을 상당히 개선했으며, 모든 변경 사항은 공개 페이지에서 확인할 수 있다. 원작 게임과 그 자산에 대한 모든 권리는 유비소프트가 보유하고 있으며, 프로젝트는 원작의 불법 사용을 권장하지 않으므로 GOG나 유비소프트 스토어에서 구매하거나 무료 데모를 다운로드할 것을 강력히 권고한다. 전체 요약 6문장 읽기 → 008 00:11 ▲ 28 · 댓글 2 드물게 찍은 사진에서 3D 장면 재구성하되, 계산은 가볍게 Sparse view에서 3D 장면을 한 번의 순전파(feedforward)로 복원하되, 기하학과 텍스처를 정확히 살리는 것이 기존 과제였다. AI · 머신러닝 · CompactSplat: Spatially Adaptive Gaussian Distribution for Feedforward Scene Reconstruction
Key Point 기존의 균등한 가우시안 할당 방식의 비효율을 개선하면서 적응형 분배로 메모리는 줄이고 화질은 높인 새로운 접근이 무엇을 달리하는지 보여준다.
핵심 요약
Sparse view에서 3D 장면을 한 번의 순전파(feedforward)로 복원하되, 기하학과 텍스처를 정확히 살리는 것이 기존 과제였다. 3DGS(3D Gaussian Splatting)를 쓴 최근 방법들은 각 픽셀마다 1개 이상의 가우시안을 할당하는데, 단순한 영역에서는 프리미티브를 낭비하고 평면 구조의 기하학적 사전정보를 활용하지 못한다. CompactSplat은 텍스처 기반 공간 분할과 계층적 샘플링을 결합해 콘텐츠에 맞춘 가우시안 할당을 수행한다. 전체 요약 6문장 읽기 → 009 21:11 ▲ 24 · 댓글 2 최소한의 촬영으로 4K 급 입체 영상 생성하는 RealMe 기존 다중 카메라 입체 영상 재구성은 고품질을 내지만 비싼 촬영 장비가 필수라는 문제가 있고, 최근 생성형 AI 방식은 해상도가 낮고 시간-공간 일관성이 떨어진다. AI · 머신러닝 · RealMe: Immersive Volumetric Video from Minimal Captures
Key Point 저예산 촬영 환경에서도 고품질 입체 영상을 만들 수 있는 방식이 나왔고, 시간-공간 일관성 문제를 처음으로 체계적으로 해결했기에 활용 가능한 응용 범위가 크게 넓어진다.
핵심 요약
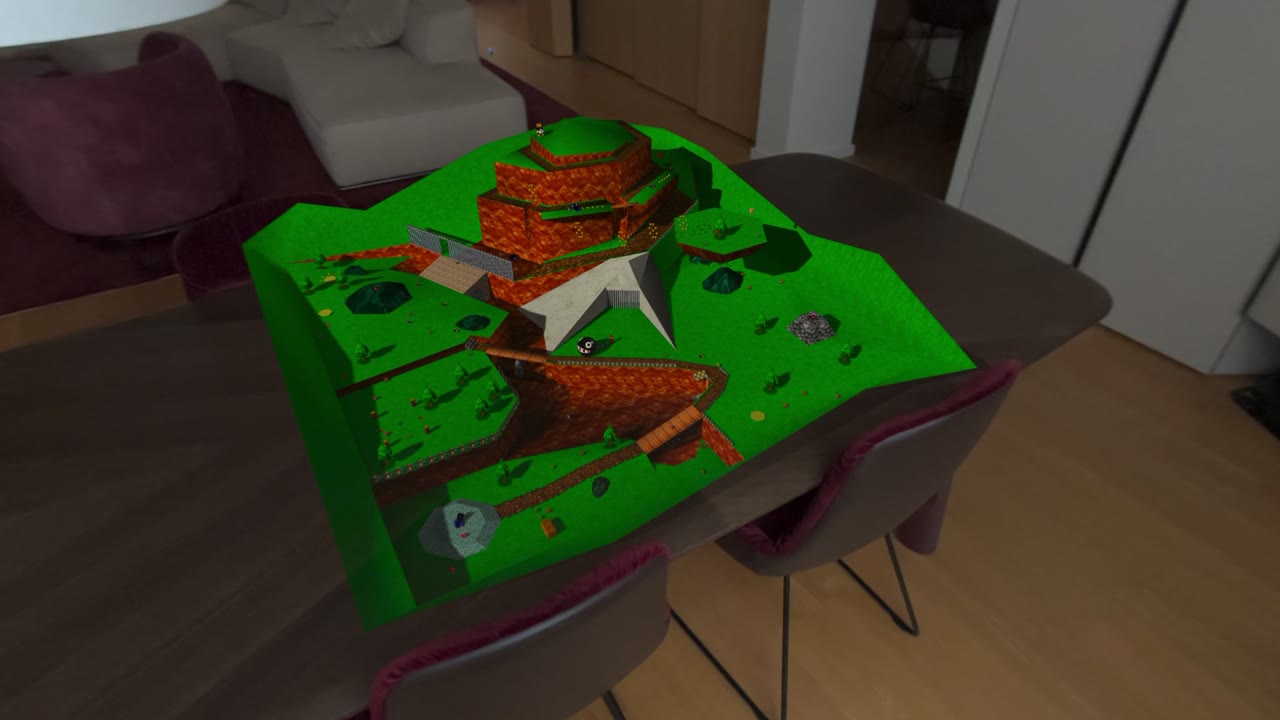
기존 다중 카메라 입체 영상 재구성은 고품질을 내지만 비싼 촬영 장비가 필수라는 문제가 있고, 최근 생성형 AI 방식은 해상도가 낮고 시간-공간 일관성이 떨어진다. 논문은 이를 해결하는 통합 프레임워크 RealMe를 제안하는데, 고해상도 비디오 확산 모델을 중심으로 제한된 촬영 데이터를 2K 해상도의 4D 일관성 있는 영상으로 향상시킨다. RealMe는 촬영 영상에서 보조 데이터를 만들어 잠재 벡터로 인코딩하고, 위치 임베딩을 함께 처리해서 비디오 확산 모델에 입력한다. 전체 요약 6문장 읽기 → 010 03:11 ▲ 154 · 댓글 58 슈퍼마리오 64, 애플 비전 프로의 입체 모형으로 부활 슈퍼마리오 64의 각 스테이지가 테이블 위의 입체 모형으로 구현되어, 플레이어가 실제로 주변을 돌아다니며 컨트롤러로 게임을 플레이할 수 있는 애플 비전 프로 포트가 공개되었다. 하드웨어 · 시스템 · Way to Play Super Mario 64: On Apple Vision Pro
Key Point 클래식 게임의 현대적 재해석과 저작권 정책의 대비: 커뮤니티 창작물이 기술적으로 얼마나 진화했는지, 그리고 업체별 대응이 얼마나 다른지 보여준다.
핵심 요약
슈퍼마리오 64의 각 스테이지가 테이블 위의 입체 모형으로 구현되어, 플레이어가 실제로 주변을 돌아다니며 컨트롤러로 게임을 플레이할 수 있는 애플 비전 프로 포트가 공개되었다. 사용자가 카메라 역할을 하므로 모형에 가까이 다가가 자세히 보거나 마리오를 여러 각도에서 관찰할 수 있으며, 타이틀 화면에서 손가락으로 마리오의 얼굴을 직접 움직일 수 있다. 이 프로젝트는 SM64 역공학 프로젝트와 sm64coopdx 게임 코드, SM64 Reloaded와 Render96의 고해상도 텍스처, Render96 모델과 SwagSkeleton95 교체 모델 등 여러 기존 오픈소스 프로젝트를 기반으로 구축되었다. 전체 요약 4문장 읽기 → 011 21:11 ▲ 20 · 댓글 2 세밀한 기하학 표현으로 3D 재구성 정확도 높인 FineSplat Feed-forward 3D Gaussian Splatting 기반의 FineSplat을 제안하여 세밀한 기하학과 외관 정보를 더 정확히 복원한다. AI · 머신러닝 · FineSplat: Fine Patches, Local Groups, Detailed Splats
Key Point Feed-forward 3D 재구성의 정확도를 크게 높이는 방법론이 필요한 상황에서, 토큰 그룹화와 렌더링 피드백을 결합해 계산 효율과 복원 품질을 동시에 개선한 접근법을 제시한다.
핵심 요약
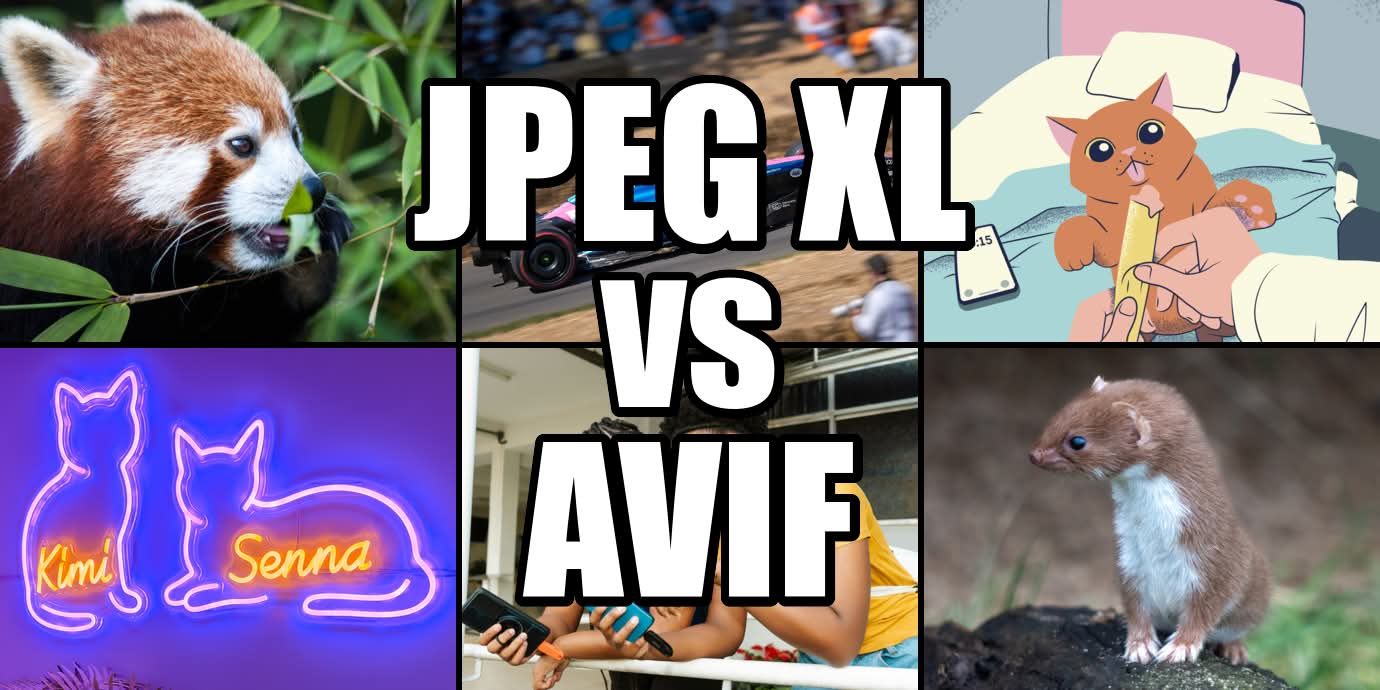
Feed-forward 3D Gaussian Splatting 기반의 FineSplat을 제안하여 세밀한 기하학과 외관 정보를 더 정확히 복원한다. 고해상도 토큰에서 다중뷰 어텐션이 계산상 비효율적이므로, 뷰 기반 그룹화로 인접 뷰들 간 상호작용을 효율화하고 3D 공간 그룹화로 기하학적으로 연관된 토큰들을 재연결한다. 렌더링 오류를 직접 피드백으로 활용하여 세밀한 구조와 외관 복원을 위한 명시적 신호를 제공하고 단일 pass 방식의 한계를 극복한다. 전체 요약 5문장 읽기 → 012 06:11 ▲ 147 · 댓글 117 JPEG XL vs AVIF, 웹 이미지 형식 비교 분석 모든 주요 브라우저에 JPEG XL이 지원되자 실제 웹 사용 사례에서 AVIF와 JPEG XL의 성능을 벤치마크로 비교했다. 웹 · 프론트엔드 · JPEG XL vs. AVIF for web use-cases
Key Point 최근 모든 주요 브라우저에서 JPEG XL을 지원하기 시작하면서 개발자들이 AVIF와 JPEG XL 중 어떤 형식을 선택할지 판단해야 하는데, 이 글은 실제 벤치마크 데이터로 두 형식의 장단점을 명확히 제시한다.
핵심 요약
모든 주요 브라우저에 JPEG XL이 지원되자 실제 웹 사용 사례에서 AVIF와 JPEG XL의 성능을 벤치마크로 비교했다. 손실 있는 사진의 경우 AVIF가 거의 항상 JPEG XL보다 작은 파일을 생성하는데, 기본 설정에서 JPEG XL은 AVIF보다 15~25% 크고 최대 노력 설정에서는 6~20% 크다. 스크린샷과 일러스트레이션에서는 AVIF가 JPEG XL보다 훨씬 우수하며, 기본 설정에서 30~90% 더 작은 파일을 생성한다. 전체 요약 12문장 읽기 → 013 03:11 ▲ 120 · 댓글 238 웨이모, 토론토에서 자율주행 서비스 시작 웨이모가 캐나다 토론토에 완전 자율주행 라이드헤일링 서비스를 론칭하며, 로컬 시설과 일자리 창출에 투자해 2028년 첫 승객 운영을 목표로 한다. AI · 머신러닝 · Hello Toronto – Waymo Is En Route
Key Point 웨이모의 캐나다 진출 소식으로, 북미에서 자율주행 라이드헤일링 시장이 실제 도시 운영 단계로 확장되며 향후 2~3년 내 일반인 이용 가능성을 보여준다.
핵심 요약
웨이모가 캐나다 토론토에 완전 자율주행 라이드헤일링 서비스를 론칭하며, 로컬 시설과 일자리 창출에 투자해 2028년 첫 승객 운영을 목표로 한다. 앞으로 토론토 거리에 웨이모 차량이 나타나며 수동 운전으로 시작해 고해상도 지도 제작과 훈련된 전문가의 테스트 단계를 거친다. 이 검증 기간은 웨이모 드라이버가 토론토의 독특한 날씨와 도로 조건에 적응하도록 보장한다. 전체 요약 8문장 읽기 → 014 00:11 ▲ 134 · 댓글 94 소프트웨어 렌더링의 매력, 고성능 PC에서 되살아나다 저자는 DOS 시대 게임의 소프트웨어 렌더링 버전을 선호하며, Dell OptiPlex 380에서 Quake를 800×600 해상도 60fps로 실행한 경험을 꼽는다. 하드웨어 · 시스템 · I Love Software Rendering
Key Point 현대 컴퓨터의 높은 성능이 옛날 소프트웨어 렌더링 게임을 새로운 방식으로 경험하게 만드는 현상과, 하드웨어 가속 이후 잊혀진 화질의 매력을 다시 조명한다.
핵심 요약
저자는 DOS 시대 게임의 소프트웨어 렌더링 버전을 선호하며, Dell OptiPlex 380에서 Quake를 800×600 해상도 60fps로 실행한 경험을 꼽는다. 소프트웨어 렌더링은 CPU가 모든 픽셀을 직접 그리는 방식으로, 3D 카드를 거치지 않고 게임 코드가 프레임을 계산해 비디오 메모리에 쓴다. 소프트웨어 렌더링의 장점은 텍스처가 샤프하게 유지되고(이중선형 필터링이 없어), 256색 팔레트 기반의 계단형 음영이 주는 거친 질감이 특징이다. 전체 요약 7문장 읽기 → 015 12:11 ▲ 43 · 댓글 2 멀티코드북 디퓨전으로 텍스트·이미지 통합 생성 가능 기존 이미지 생성 모델은 단일 코드북 기반으로 표현력이 제한되거나, 텍스트와 이미지를 서로 다른 최적화 목표로 학습해 모달리티 간 충돌이 발생했다. AI · 머신러닝 · Intern Lumina U2: A Multi-Codebook Diffusion Large Language Model for Omni-Visual Understanding and Image Generation
Key Point 이산 공간에서 고해상도 이미지 생성과 텍스트 모델링을 진정으로 통합한 첫 디퓨전 언어모델로, 단일 모델로 텍스트·이미지·비디오·3D를 모두 다룰 수 있다는 점에서 멀티모달 생성의 새로운 패러다임을 제시한다.
핵심 요약
기존 이미지 생성 모델은 단일 코드북 기반으로 표현력이 제한되거나, 텍스트와 이미지를 서로 다른 최적화 목표로 학습해 모달리티 간 충돌이 발생했다. Intern Lumina U2는 각 시각적 위치를 여러 상호보완적 코드북의 코드 그룹으로 표현하는 멀티코드북 디퓨전 언어모델로, 이산 공간에서 고용량 시각 표현과 텍스트를 통합한다. 입력 시 각 위치의 임베딩을 연결하고, 출력 시 경량의 멀티코드북 자동회귀 헤드가 각 위치 내 코드를 순차적으로 예측하면서 디퓨전 백본은 모든 위치를 병렬 처리한다. 전체 요약 6문장 읽기 → 016 18:11 ▲ 19 · 댓글 1 초해상화, 올바른 잠재공간에서 해결하다 고해상도 자연 이미지의 임베딩들은 잠재공간에서 다양체를 형성하며, 저화질 이미지는 이 다양체 바깥에 위치한다. AI · 머신러닝 · Super-Resolution in The Right Latent Space: A Frozen Vision-Foundation Substrate
Key Point DINOv3 비전 파운데이션 모델의 잠재공간이 기존 방식보다 초해상화 작업을 근본적으로 효과적으로 만드는 방법을 제시하여, 이미지 복원 파이프라인의 설계 원칙이 바뀔 수 있음을 보여준다.
핵심 요약
고해상도 자연 이미지의 임베딩들은 잠재공간에서 다양체를 형성하며, 저화질 이미지는 이 다양체 바깥에 위치한다. 기존 초해상화 방법들은 재구성 지향 또는 픽셀 공간에서 작동하는데, 이 공간들에서 저화질 이미지가 다양체에서 멀리 떨어져 있어 매핑이 어렵고 비용이 크다. 의미 정보가 부족한 공간에서 작동하면 심각한 할루시네이션이 발생하며, 화질 저하가 심할수록 이 문제는 악화된다. 전체 요약 9문장 읽기 → 017 21:11 ▲ 34 · 댓글 2 동영상 초고화질화, 일반 GPU로 4K 실시간 처리 가능해졌다 기존 동영상 초고화질화(VSR) 모델이 확산 증류를 통해 한 단계 생성으로 효율성을 높였으나, 고해상도 추론 비용이 크고 생성 결과가 사용자 선호와 맞추기 어려운 문제가 있었다. AI · 머신러닝 · FlashVSR+: Efficient Video Super-Resolution via Hybrid Attention and Reward-Yield Distribution Matching
Key Point 동영상 초고화질화가 실용적인 수준의 속도와 메모리 효율로 4K 고해상도 처리가 가능해지면서, 콘텐츠 제작자와 개발자들이 일반 사양 GPU에서도 고품질 영상 생성을 구현할 수 있게 되었다.
핵심 요약
기존 동영상 초고화질화(VSR) 모델이 확산 증류를 통해 한 단계 생성으로 효율성을 높였으나, 고해상도 추론 비용이 크고 생성 결과가 사용자 선호와 맞추기 어려운 문제가 있었다. FlashVSR+는 하이브리드 어텐션 메커니즘을 도입해 사전학습된 VSR 모델의 강한 지역성(locality)을 활용하면서 장거리 일관성을 위해 희소 전역 상호작용을 유지한다. 이를 통해 DiT 속도를 최대 2배 높이고 피크 메모리를 45% 감소시켜, RTX 4090 24GB 단일 GPU에서 타일 분할 없이 4K 영상 초고화질화를 가능하게 했다. 전체 요약 7문장 읽기 → 018 21:11 ▲ 46 · 댓글 1 고해상도 이미지 생성 가능한 경량 디퓨전 변환기 기법 디퓨전 변환기(DiT)가 학습 해상도를 넘어 이미지를 생성하려면 토큰 수가 급증해 전체 어텐션이 계산 비용이 높아지고, 구조 왜곡과 디테일 저하 문제가 발생한다. AI · 머신러닝 · AReA: Adaptive Receptive-Field Attention for Efficient High-Resolution Diffusion Transformers
Key Point 고해상도 이미지 생성 시 계산량 폭증 문제를 적응형 어텐션으로 해결한 방식으로, 추가 학습 없이 적용 가능하다는 점이 중요하다.
핵심 요약
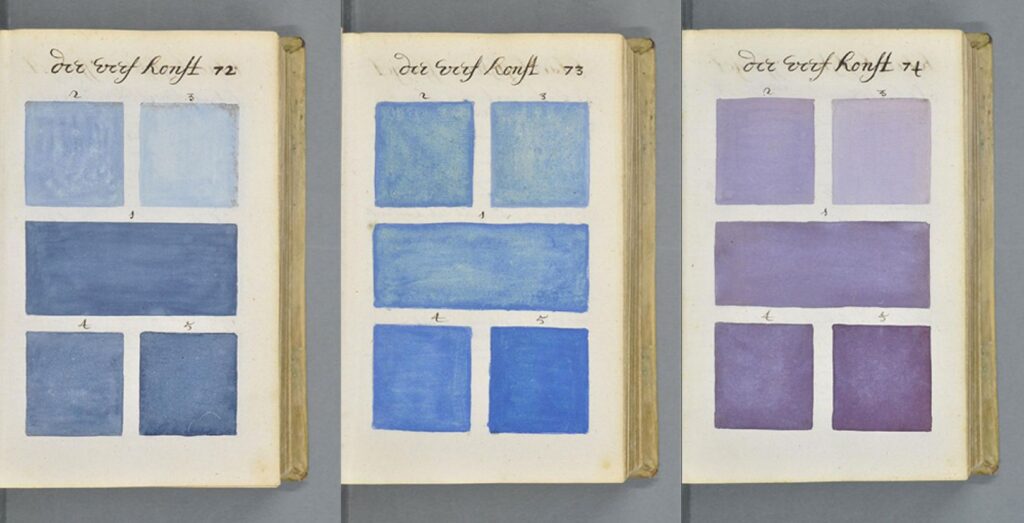
디퓨전 변환기(DiT)가 학습 해상도를 넘어 이미지를 생성하려면 토큰 수가 급증해 전체 어텐션이 계산 비용이 높아지고, 구조 왜곡과 디테일 저하 문제가 발생한다. 균등한 전체 어텐션이 이 문제의 공통 원인인데, 모든 스텝에서 모든 토큰에 주목하면 이차 복잡도가 생기고 학습 범위를 벗어난 상대 거리에 노출되어 모델이 분포에서 벗어난다. 어텐션의 유효 수용 범위는 노이즈 제거 과정에서 좁혀지는데, 초반 스텝에서 전역적으로 구조를 형성하고 후반 스텝에서 국소적으로 세부를 정제한다. 전체 요약 6문장 읽기 → 019 15:11 ▲ 116 · 댓글 11 1692년 900쪽 색채 수작 전체 스캔본 공개 17세기 네덜란드 화가 A. 보겔트가 1692년 창작한 이 책은 팬톤 색상 칩보다 270년 앞선 수채화 색상 혼합 가이드로, 700쪽 이상의 색상 표본과 손글씨 네덜란드어 설명이 담겨 있다. 기타 · 900-Page Pre-Pantone Guide to Color from 1692 (With Complete High-Res Scan)
Key Point 색상 표준화와 예술의 역사에 관심 있는 디자이너·화가·색채 이론가라면 270년 전 원본 매뉴얼 전체 스캔본의 공개 의미를 새길 수 있습니다.
핵심 요약
17세기 네덜란드 화가 A. 보겔트가 1692년 창작한 이 책은 팬톤 색상 칩보다 270년 앞선 수채화 색상 혼합 가이드로, 700쪽 이상의 색상 표본과 손글씨 네덜란드어 설명이 담겨 있다. 아리스토텔레스의 색상 체계를 바탕으로 제작되었으며, 뉴턴의 스펙트럼 이론과 다른 접근 방식을 취했다. 저자가 단 1부만 복사본을 남겼기 때문에 당시 화가들에게 큰 영향을 주지 못했고, 17세기 네덜란드 황금기 수채화 화가들이 알기 어려웠을 것으로 보인다. 전체 요약 7문장 읽기 → 020 15:11 ▲ 100 · 댓글 69 Mac Dock 27년의 진화, 한눈에 모은 아이콘 역사 저자는 iOS 앱 아이콘 역사를 다룬 책 집필 후 macOS의 아이콘 설계 역사 연구를 시작했다. 기타 · The Dock on Mac, from OS 10 to macOS 27
Key Point Mac이 출시한 이래 Dock의 외형이 어떻게 진화해왔는지 시간 순서대로 한눈에 비교할 수 있는 시각 자료가 공개되어, 애플의 UI 미학 변화를 추적하려는 디자이너나 기술사 애호가들에게 참고 자료로 쓸 수 있다.
핵심 요약
저자는 iOS 앱 아이콘 역사를 다룬 책 집필 후 macOS의 아이콘 설계 역사 연구를 시작했다. macOS 버전 10부터 27까지 거쳐온 Dock의 여러 세대 디자인을 한 장의 그래픽으로 수집해 정리했다. 512 Pixels의 이미지 컴파일 자료를 참고해 시각적으로 보존할 수 있는 아카이브를 만들었다. 전체 요약 4문장 읽기 → 021 00:11 ▲ 12 · 댓글 2 이미지로 초고해상도 3D 메시 복원, 장면 크기 제약 없이 여러 각도 이미지로부터 장면 최적화 과정 없이 고품질 3D 메시를 복원하는 T3lescope 모델을 제시한다. AI · 머신러닝 · T3lescope: Arbitrary-Resolution High-Fidelity Generative Surface Reconstruction from Images
Key Point 멀티뷰 이미지에서 수십 미터 규모 실외 장면까지 일관되게 3D 메시를 복원할 수 있게 되어, 기존의 장면 분할로 인한 불일치 문제를 근본적으로 해결하는 기술이다.
핵심 요약
여러 각도 이미지로부터 장면 최적화 과정 없이 고품질 3D 메시를 복원하는 T3lescope 모델을 제시한다. 기존 최적화 기반 방법은 관찰이 부족하거나 표면이 광택·투명할 때 3D 사전지식이 부족해 실패한다. 생성 기반 방법은 3D 사전지식으로 미관찰 영역을 채우지만 고정된 해상도와 제한된 공간 범위에서만 작동한다. 전체 요약 9문장 읽기 → 022 09:11 ▲ 357 · 댓글 190 유튜버가 경찰 차량 추적 카메라 제작 후 경찰 방문받아 경찰은 자동 번호판 인식(ALPR) 카메라를 시민 감시에 사용하지만, 자신들이 같은 기술로 감시받는 것에는 거부감을 보이고 있다. 보안 · YouTuber Says Cops Visited Him After He Built a Flock-Style Camera to Track Cops
Key Point 경찰이 시민 감시 도구로 쓰는 기술이 자신들에게 향할 때 즉시 문제를 제기하는 이중성을 직접 보여주며, ALPR 기술의 권력 불균형 문제를 구체화한다.
핵심 요약
경찰은 자동 번호판 인식(ALPR) 카메라를 시민 감시에 사용하지만, 자신들이 같은 기술로 감시받는 것에는 거부감을 보이고 있다. Flock 등의 ALPR 기술은 최근 몇 년간 급속히 확산되었으며, 전 파트너 스토킹, 이민자 괴롭힘, 무고한 사람들의 삶 파괴 등 데이터 오용 사례가 잇따르고 있다. 캐나다 소프트웨어 엔지니어이자 유튜버 앤서니 시스틸리는 최근 경찰 차량만 추적하도록 설정한 개인용 ALPR 카메라를 제작해 TikTok에 영상을 올렸다. 전체 요약 6문장 읽기 → 023 18:33 ▲ 13 · 댓글 1 긴 비디오 이해하기, 해상도 낮추고 프레임 촘촘히 샘플링해야 한다 비전-언어 모델(VLM)에서 긴 비디오 이해 시 기존 방식은 고정된 고해상도에서 정보 있는 프레임만 선택했으나, 해상도를 낮추고 더 촘촘하게 샘플링하는 것이 토큰 예산을 맞췄을 때 더 나은 성능을 낸다. AI · 머신러닝 · Rethinking Long-Video Efficiency: A Joint Allocation Perspective on Frames, Pixels, and Front-End Latency
Key Point 비디오 이해 모델의 효율성을 높이는 새로운 관점으로, 해상도와 프레임 샘플링의 트레이드오프를 재정의하며 실제 배포 환경의 디코딩 병목을 해결한다.
핵심 요약
비전-언어 모델(VLM)에서 긴 비디오 이해 시 기존 방식은 고정된 고해상도에서 정보 있는 프레임만 선택했으나, 해상도를 낮추고 더 촘촘하게 샘플링하는 것이 토큰 예산을 맞췄을 때 더 나은 성능을 낸다. 프론트엔드 디코딩 지연시간은 최종 토큰 수가 아니라 후보 풀의 크기에 의존하며, 1시간 길이의 비디오에서 프론트엔드 디코딩이 전체 처리 시간의 대부분을 차지한다. 해상도에 민감한 작업(예: 텍스트 인식)은 선택된 고해상도 프레임에서 이득을 얻으며, 일반적인 이해 작업은 저해상도 촘촘 샘플링으로 충분하다. 전체 요약 6문장 읽기 → 024 09:11 ▲ 12 · 댓글 2 고해상도 이미지 처리 위한 효율적인 토큰 순환 모델 GTR Self-attention 기반 비전 백본은 밀집 예측에서 우수하나 전역 소프트맥스 어텐션의 이차 계산 비용이 이미지 해상도 증가에 따라 효율성을 제한한다. AI · 머신러닝 · GTR: Gated Token Recurrence for Efficient Dense Prediction
Key Point 이차 복잡도로 인한 고해상도 이미지 처리의 계산 병목을 해결하는 새로운 아키텍처로, 4배 빠른 처리 속도와 엣지 장비 배포 가능성을 제시한다.
핵심 요약
Self-attention 기반 비전 백본은 밀집 예측에서 우수하나 전역 소프트맥스 어텐션의 이차 계산 비용이 이미지 해상도 증가에 따라 효율성을 제한한다. GTR(Gated Token Recurrence)은 소프트맥스 없는 순환 비전 백본으로 게이팅 선형 어텐션, 교대 공간 스캔 방향, 공간 강화된 SwiGLU 블록을 결합했다. GTR은 최종 레이어 패치-토큰 정렬로만 증류되며 마스킹된 토큰 예측이나 중간 레이어 감독은 사용하지 않는다. 전체 요약 8문장 읽기 → 025 18:11 ▲ 130 · 댓글 14 필 티펫 스튜디오 폐업, 40년 아카이브 온라인 공개 스타워즈, 로보캅, 스타쉽 트루퍼스 등을 만든 필 티펫 스튜디오가 8월 28일 폐업했고, 디지털 자산들이 온라인으로 유실될 위기에 처했다. 기타 · In the wake of Tippett Studios’ closure, a digital archive appears online
Key Point 영화사 폐업 시 흩어지는 문화유산을 개인이 구하고 공개하는 드문 사례로, 필 티펫의 40년 스톱모션 역사가 온라인에서 무료로 접근 가능해졌다는 점이 중요합니다.
핵심 요약
스타워즈, 로보캅, 스타쉽 트루퍼스 등을 만든 필 티펫 스튜디오가 8월 28일 폐업했고, 디지털 자산들이 온라인으로 유실될 위기에 처했다. 폐업 당시 스튜디오의 소품과 자료들이 경매에 나왔으며, 익명의 '티펫팬'이 경매에서 CD-ROM과 디스크 폴더를 구입했다. 티펫팬은 90개의 핵심 디스크를 ISO 이미지 형식으로 디지털화해 인터넷 아카이브(Archive.org)에 무료로 업로드했다. 전체 요약 6문장 읽기 → 026 12:11 ▲ 54 · 댓글 2 동영상 생성 모델의 정렬 문제, 첫 종합 가이드 동영상 생성 기술이 저해상도 단편에서 고해상도 장시간 시퀀스로 급속도 발전했으나, 사전학습된 모델은 인간 의도 따르기·시간적 일관성 유지·물리법칙 준수에 실패하는 경우가 많다. AI · 머신러닝 · Video Generation Models: A Survey of Post-Training and Alignment
Key Point 동영상 생성 모델이 인간 의도를 제대로 따르지 못하는 근본적인 정렬 문제를 체계화한 첫 종합 가이드로, 앞으로의 동영상 생성 기술 개발 방향을 정리해준다.
핵심 요약
동영상 생성 기술이 저해상도 단편에서 고해상도 장시간 시퀀스로 급속도 발전했으나, 사전학습된 모델은 인간 의도 따르기·시간적 일관성 유지·물리법칙 준수에 실패하는 경우가 많다. 동영상 생성의 정렬(alignment)은 이미지·텍스트 생성보다 난제가 많은데, 누적 오차·움직임-외형 결합·다목적 트레이드오프·시간적 속성의 제한된 감독이 주요 과제다. 이 논문은 동영상 모델의 사후학습(post-training)과 정렬을 다룬 첫 종합 리뷰로, 정렬 신호 적용 방식에 따라 암묵적 정렬과 명시적 정렬로 구분한다. 전체 요약 6문장 읽기 → 027 06:11 ▲ 31 · 댓글 2 고해상도 3D 생성 비용 58% 줄인 위상 보존 기법 SILSA 고해상도 3D 모델 생성에서 기존 복셀 토큰 방식은 연속 표면을 많은 로컬 토큰으로 분할해 비용이 크고 얇거나 복잡하게 연결된 형태의 위상 일관성이 약하다. AI · 머신러닝 · SILSA: Sliding-Window Slice Latents for Topology-Preserving High-Resolution 3D Generation
Key Point 기존 3D 생성의 계산 병목을 슬라이싱 윈도우 방식으로 획기적으로 줄이면서 위상 일관성도 높인 구조이므로, 3D 생성 모델을 개발하거나 최적화하려는 개발자에게 실질적인 대안을 제시한다.
핵심 요약
고해상도 3D 모델 생성에서 기존 복셀 토큰 방식은 연속 표면을 많은 로컬 토큰으로 분할해 비용이 크고 얇거나 복잡하게 연결된 형태의 위상 일관성이 약하다. SILSA는 슬라이싱 윈도우로 3개 축(x·y·z)을 따라 겹치는 슬라이스 집합으로 모양을 표현해 이 문제를 해결하는 방식이다. 각 토큰이 로컬 깊이 윈도우를 요약해 단면 연속성을 유지하고 단일 단계 생성을 지원한다. 전체 요약 8문장 읽기 → 028 15:11 ▲ 74 · 댓글 4 카메라 밖 물체까지 추적하는 세계 모델 개발 기존 비디오 세계 모델은 행위자(에이전트) 중심 시점에만 집중해 화면을 벗어난 물체의 상태 변화를 놓치는 문제가 있다. AI · 머신러닝 · World Observer: Joint Actor-Observer Generation for Persistent World Modeling
Key Point 카메라 시점을 벗어난 물체의 상태를 추적할 수 있게 되면 더 현실적인 세계 모델을 만들 수 있고, 로보틱스나 게임 엔진 등 동적 환경 시뮬레이션이 필요한 분야에 실질적 개선을 가져올 수 있다.
핵심 요약
기존 비디오 세계 모델은 행위자(에이전트) 중심 시점에만 집중해 화면을 벗어난 물체의 상태 변화를 놓치는 문제가 있다. World Observer는 에이전트 시점의 배우 생성기와 함께 선택된 장면 영역을 관찰하는 하나 이상의 파노라마 관찰자를 동시에 생성해 이를 해결한다. 화면을 벗어난 물체도 관찰자 관점에서 계속 시각적으로 진화하도록 유지되어 재진입 시 업데이트된 상태가 반영된다. 전체 요약 7문장 읽기 → 029 09:11 ▲ 108 · 댓글 38 뇌파의 복잡한 패턴, 실시간 정보 처리 메커니즘 규명 뇌의 전기 활동은 신경 집단의 집단적 신호가 만드는 파동으로 전파되며, 기존에는 단순한 평면파로 인식되어 왔다. 기타 · Surprisingly complex waves reveal the brain's inner workings
Key Point 뇌가 행동 요구에 맞춰 초 단위로 신경망을 재조직화하는 메커니즘이 밝혀지고 있으며, 이는 인지와 의식의 기초 원리 이해에 중요한 전환점을 의미한다.
핵심 요약
뇌의 전기 활동은 신경 집단의 집단적 신호가 만드는 파동으로 전파되며, 기존에는 단순한 평면파로 인식되어 왔다. 2026년 4월 Nature Communications 논문에서 연구진은 뇌파가 단순한 구조를 넘어 다양한 형태를 가짐을 발견했다: 특정 지점에서 발생하는 source wave, 수렴하는 sink wave, 소용돌이 spiral wave 등이다. 시카고 대학의 Joshua Jacobs와 Anup Das팀은 간질 환자의 뇌 내 전극으로 고해상도 데이터를 측정했으며, 각기 다른 행동 과제가 서로 다른 파동 패턴과 연관되어 있음을 확인했다. 전체 요약 12문장 읽기 → 030 18:11 ▲ 29 · 댓글 2 한 번의 단계로 4K 영상 생성하는 비디오 정제 기법 발표 저해상도 비디오를 고해상도로 변환하는 과정에서 기존 다단계 정제는 계산 병목이 되는 문제를 해결하기 위해 한 번의 디노이징 단계로 4K 영상을 생성하는 SoL-Refiner를 제시했다. AI · 머신러닝 · SoL-Refiner: Speed-of-Light One-Step Refinement for High-Resolution Video
Key Point 고해상도 비디오 생성의 계산 비용을 획기적으로 줄이면서도 품질을 유지하는 방법론으로, 실시간 영상 생성 애플리케이션의 실용화에 직접 영향을 준다.
핵심 요약
저해상도 비디오를 고해상도로 변환하는 과정에서 기존 다단계 정제는 계산 병목이 되는 문제를 해결하기 위해 한 번의 디노이징 단계로 4K 영상을 생성하는 SoL-Refiner를 제시했다. 고해상도 지속 학습, 강화학습(RL) 후학습, 한 단계 증류의 세 단계 학습 레시피를 적용했다. 논문은 다양한 비디오 생성 모델의 출력을 바탕으로 한 Refiner-Bench 벤치마크를 구축하고, 약 2K 해상도에서 다양한 정제 모델을 비교하는 공통 입력 프로토콜을 도입했다. 전체 요약 5문장 읽기 → 031 22:29 새 버전 Ollama v0.34.4 출시, 성능 개선 및 버그 수정 Structured outputs이 싱글 패스로 적용돼 사고 모델에서 더 빠르고 안정적으로 동작한다. AI · 머신러닝 · ollama/ollama@v0.34.4
Key Point 로컬 LLM 실행 환경의 가장 대중적인 도구인 Ollama의 안정성과 성능이 개선되어, 특히 Apple Silicon 사용자의 추론 속도와 안정성이 크게 향상된다.
핵심 요약
Structured outputs이 싱글 패스로 적용돼 사고 모델에서 더 빠르고 안정적으로 동작한다. 대규모 로컬 라이브러리에서 발생하던 간헐적인 '모델 미발견' 오류를 수정했다. macOS 앱이 ChatGPT나 Codex 실행 여부 확인 시 응답 없음 상태가 되는 문제를 해결했다. 전체 요약 6문장 읽기 → 032 11:10 ▲ 122 · 댓글 42 미국 로드사이드 건축을 기록한 사진 11,710장 저작권 공개 건축 비평가 존 마골리스가 1970~1990년대 미국 도로변의 독특한 건축물과 간판을 기록한 컬러 슬라이드 11,710장이 있다. 기타 · John Margolies' photographs of roadside America
Key Point 프랜차이즈와 고속도로 확대로 사라져가던 미국 로드사이드 건축을 40년간 체계적으로 기록한 방대한 시각 자료가 완전히 공개되어, 미국 대중문화와 도시 건축 변화를 연구하거나 향수를 느끼는 사람들이 원본 자료에 접근할 수 있게 됐다.
핵심 요약
건축 비평가 존 마골리스가 1970~1990년대 미국 도로변의 독특한 건축물과 간판을 기록한 컬러 슬라이드 11,710장이 있다. 모텔, 빌보드, 자동차 세차장, 피자탑 같은 참신한 건물들을 기록해 1981년 '도로의 끝: 사라지는 미국 고속도로 건축'으로 첫 출판했다. 미국 의회도서관이 마골리스의 유산을 인수하고 모든 저작권 제한을 해제해 공개했다. 전체 요약 4문장 읽기 → 033 11:10 ▲ 143 · 댓글 9 NEC V20 마이크로코드 복호화 성공 CPU 에뮬레이터 개발자가 NEC V20 칩의 고해상도 사진(56억 픽셀)을 촬영한 뒤 마이크로코드 ROM을 추출했다. 하드웨어 · 시스템 · Decoding the NEC V20 Microcode
Key Point 과거 8088 마이크로코드 복호화로 문을 열었던 저수준 CPU 에뮬레이션이 이제 V20까지 확대되면서, 진정한 사이클 정확도의 역사 CPU 에뮬레이터 구현이 가능해졌다.
핵심 요약
CPU 에뮬레이터 개발자가 NEC V20 칩의 고해상도 사진(56억 픽셀)을 촬영한 뒤 마이크로코드 ROM을 추출했다. ROM 배열은 258x116 크기로 29,928비트를 담고 있으며, 29비트 단위 마이크로코드 1,032개가 저장되어 있다. 마이크로코드 비트를 수동으로 분류한 1,000개 샘플로 CNN(합성곱 신경망)을 학습시켰고, 약 6세대 만에 99% 이상의 정확도를 달성했다. 전체 요약 4문장 읽기 →