001 15:11 ▲ 49 · 댓글 2 3D 기하정보로 다각도 영상 생성, OmniShowcase 공개 참조 이미지 몇 장에서 특정 피사체의 영상을 생성할 때, 카메라가 입력 이미지에 없는 각도로 이동하면 보이지 않는 표면을 추론해야 하는 문제를 다룬다. AI · 머신러닝 · OmniShowcase: Omnidirectional Subject-Consistent Video Generation from Multi-View Images
Key Point 참조 이미지에서 3D 기하정보를 명시적으로 활용해 다각도 영상 생성 시 피사체 일관성을 크게 개선하는 방식으로, 멀티뷰 조건부 영상 생성의 핵심 과제를 해결한다.
핵심 요약
참조 이미지 몇 장에서 특정 피사체의 영상을 생성할 때, 카메라가 입력 이미지에 없는 각도로 이동하면 보이지 않는 표면을 추론해야 하는 문제를 다룬다. 기존 단일 이미지 기반 방식을 개선하기 위해 최근 방법들은 다중 시점 참조 이미지를 사용하지만, 이들을 연결하는 3D 구조를 명시적으로 정의하지 않으며 학습 데이터가 시점 변화에서 동일한 3D 피사체를 보장하지 못한다. OmniShowcase는 자동화된 데이터 합성 파이프라인과 기하 조건화 방식 두 가지로 구성된다. 전체 요약 8문장 읽기 → 002 03:11 ▲ 110 · 댓글 2 30년 전 애플 서버를 맥OS에서 실행하는 기술 1996년 애플 네트워크 서버(ANS)는 원래 하푼(Harpoon) AIX만 실행했지만, 애플이 개발 중에 맥OS 부팅 로직이 있었고 생산 로롬이 제거되었다. 하드웨어 · 시스템 · MacOS Extensions Pack for the Apple Network Server v1.0
Key Point 1996년 하드웨어의 OS 호환성을 소프트웨어로 복원하는 역사적 기술 복원 사례로, 레트로 컴퓨팅과 드라이버 개발의 깊이 있는 사례 연구를 제시한다.
핵심 요약
1996년 애플 네트워크 서버(ANS)는 원래 하푼(Harpoon) AIX만 실행했지만, 애플이 개발 중에 맥OS 부팅 로직이 있었고 생산 로롬이 제거되었다. 최근 공개된 사전프로덕션 롬(1.1.20.1)은 AIX와 맥OS 양쪽을 모두 부팅할 수 있지만, 사전프로덕션 롬의 맥OS 지원에는 결함이 있었다(온보드 비디오 미지원, MACE 이더넷 작동 안 함, 재부팅 후 검은 화면). 저자는 이러한 문제를 소프트웨어로 수정하여 ANS Extensions Pack v1.0을 개발했으며, MACE 이더넷을 고정하고 온보드 비디오를 활성화하며 맥OS에서 적절히 재부팅하도록 했다. 전체 요약 11문장 읽기 → 003 03:11 ▲ 15 · 댓글 2 AI 영상 학습 최적화, 프레임 간 의존성 제거로 1.45배 빠른 로딩 대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. AI · 머신러닝 · Rethinking Video Storage for AI Training: Breaking Cross-Frame Dependencies for Efficient Random Access
Key Point AI 모델 학습용 영상 데이터의 로딩 병목을 해결하는 방법을 제시하며, 대규모 학습 인프라의 처리량을 크게 높일 수 있어 실용적이다.
핵심 요약
대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. 기존 방식은 프레임 간 참조 구조로 압축률을 높이지만, 임의 접근 시 관련 없는 프레임도 함께 디코딩해야 해 비효율적이다. 논문은 두 가지 디코딩 증폭 원인을 파악했다: 무관한 프레임의 순차 복원과 샘플링 대상이 참조하는 체인의 복원이다. 전체 요약 8문장 읽기 → 004 21:11 ▲ 43 · 댓글 2 장편 비디오도 정확히 3D 복원하는 계층 포즈 그래프 딥러닝 모델로 짧은 비디오에서 카메라 움직임과 3D 기하를 정확히 추정할 수 있지만, 수천 개 프레임의 긴 영상은 계산량과 메모리 문제로 겹치는 청크(chunk) 단위로 나눠 처리해야 한다. AI · 머신러닝 · HiP3R: Hierarchical Pose Graphs for Long-Horizon 3D Reconstruction
Key Point 긴 비디오의 3D 복원에서 지역 최적화와 전역 일관성 사이의 근본적 트레이드오프를 계층 구조로 해결한 방법으로, 자율주행·로봇·공간 매핑 등 실제 응용에서 필요한 기술이다.
핵심 요약
딥러닝 모델로 짧은 비디오에서 카메라 움직임과 3D 기하를 정확히 추정할 수 있지만, 수천 개 프레임의 긴 영상은 계산량과 메모리 문제로 겹치는 청크(chunk) 단위로 나눠 처리해야 한다. 이 방식은 각 청크마다 독립적인 3D 복원을 만들어 좌표계가 일치하지 않고 카메라 위치가 중복으로 추정되는 문제가 발생한다. 인접한 청크와 멀리 떨어진 재방문 지점에서의 제약 조건을 전파해 전역 일관성을 맞춰야 하는데, 이는 포즈 그래프 최적화로 자연스럽게 해결된다. 전체 요약 6문장 읽기 → 005 00:11 ▲ 102 · 댓글 48 오스트리아 할슈타트, 철기시대 대규모 염광 발견 오스트리아 할슈타트 지하에서 길이 300m 이상의 철기시대 염광 갱도 네트워크가 발견됐다. 기타 · Iron Age salt-mining complex found beneath Hallstatt in Austria
Key Point 철기시대 광산의 구체적 구조, 도구와 생활 흔적이 거의 완전히 보존된 지하 유적으로, 고대 채광 기술과 노동 생활을 직접 연구할 수 있는 매우 드문 고고학적 발견이다.
핵심 요약
오스트리아 할슈타트 지하에서 길이 300m 이상의 철기시대 염광 갱도 네트워크가 발견됐다. 7,300년 전부터 이 지역에서 소금 생산이 시작됐으며, 기원전 1200년경에는 하루 1.5톤 규모로 생산했다. 2022년 핵심 시추 조사를 통해 기존에 알려지지 않은 갱도들을 발견했다. 전체 요약 10문장 읽기 → 006 15:11 ▲ 37 · 댓글 2 음성·영상 추론 AI의 환각 현상, 증거 우선순위 재조정으로 해결 멀티모달 추론이 가능한 최신 대형언어모델(OLLM)이 음성과 영상을 함께 처리할 때 교차모달 환각이 발생하는 문제가 있다. AI · 머신러닝 · Omni-Woodpecker: Hallucination Correction via Evidence-Prior Rebalancing for Omni LLMs
Key Point 음성과 영상을 동시에 처리하는 멀티모달 AI 모델의 성능 문제를 추론 단계에서 해결하는 새로운 방법이 다양한 모델에서 검증되었기 때문이다.
핵심 요약
멀티모달 추론이 가능한 최신 대형언어모델(OLLM)이 음성과 영상을 함께 처리할 때 교차모달 환각이 발생하는 문제가 있다. 기존 방법들은 출력 단계에서만 처리하며 융합 표현 내의 근거 증거와 학습된 사전지식의 얽힘을 간과했다. Omni-Woodpecker(OWP)라는 훈련 불필요 프레임워크는 교차모달 충돌을 식별한 후 숨겨진 상태에서 증거와 경쟁하는 사전지식을 분리한다. 전체 요약 7문장 읽기 → 007 03:11 ▲ 174 · 댓글 59 영웅전설 2 엔진을 갈아엎다, fheroes2 오픈소스 재제작 프로젝트 fheroes2는 게임 '영웅전설 2: 마법과 전투'의 게임 엔진을 처음부터 새로 만든 멀티플랫폼 오픈소스 프로젝트다. 오픈소스 · 도구 · fheroes2: A recreation of Heroes of Might and Magic II game engine
Key Point 1990년대 명작 턴 기반 전략 게임을 현대적 그래픽과 개선된 AI로 새로이 즐길 수 있는 오픈소스 프로젝트의 현황을 확인할 수 있습니다.
핵심 요약
fheroes2는 게임 '영웅전설 2: 마법과 전투'의 게임 엔진을 처음부터 새로 만든 멀티플랫폼 오픈소스 프로젝트다. 고해상도 그래픽 지원, 개선된 AI, 다수의 버그 수정, 사용자 인터페이스 향상 등으로 원작을 상당히 개선했으며, 모든 변경 사항은 공개 페이지에서 확인할 수 있다. 원작 게임과 그 자산에 대한 모든 권리는 유비소프트가 보유하고 있으며, 프로젝트는 원작의 불법 사용을 권장하지 않으므로 GOG나 유비소프트 스토어에서 구매하거나 무료 데모를 다운로드할 것을 강력히 권고한다. 전체 요약 6문장 읽기 → 008 21:11 당일 +121 GitHub 중문 인터페이스를 완전히 한글화하는 Tampermonkey 플러그인 GitHub의 메뉴, 버튼, 제목 등 전체 인터페이스 요소를 중문으로 변환하는 사용자 스크립트 플러그인이다. 오픈소스 · 도구 · maboloshi/github-chinese · JavaScript
Key Point GitHub을 중문 인터페이스로 완전히 변환하는 Tampermonkey 플러그인으로, 중국 개발자들의 GitHub 접근성을 크게 높이며 한국 개발자들도 유사한 로컬라이제이션 프로젝트의 구조와 운영 방식을 참고할 수 있다.
핵심 요약
GitHub의 메뉴, 버튼, 제목 등 전체 인터페이스 요소를 중문으로 변환하는 사용자 스크립트 플러그인이다. Chrome, Firefox, Safari 등 주요 브라우저에서 Tampermonkey, Violentmonkey 등의 스크립트 관리자를 통해 설치할 수 있으며, VS Code 통합 브라우저도 지원한다. 정규식 기반 자동 매칭, 저장소 설명의 기계 번역, 시간 요소 자동 현지화 기능을 제공하며 단어장을 지속 업데이트한다. 전체 요약 10문장 읽기 → 009 03:11 ▲ 181 · 댓글 120 eMudhra, 모질라 조사 기한 무시하고 해명 미뤄 10월 17일 eMudhra의 중간 인증서 8개 개인키 유출이 보고되었고, 모질라는 20시간 내 Firefox의 OneCRL을 통해 인증서 폐기 완료. 보안 · eMudhra ignored Mozilla Root investigation deadline; blames social media
Key Point 사실상 모든 TLS 인증서 발급을 불가능하게 만드는 개인키가 초등 암호 수준으로 유출되었으며, 생태계 복구와 원인 파악이 시급한 가운데 CA가 기한을 지키지 않고 있습니다.
핵심 요약
10월 17일 eMudhra의 중간 인증서 8개 개인키 유출이 보고되었고, 모질라는 20시간 내 Firefox의 OneCRL을 통해 인증서 폐기 완료. 384비트 타원곡선 개인키가 256 이하의 정수로만 생성되어, 이론상 순간적으로 복원 가능하고 심지어 LLM에도 'CTF 문제'라 제시하면 풀 수 있는 수준. 6개는 TLS 중간 인증서(Chrome, Mozilla, Microsoft, Apple 신뢰), 2개는 코드 서명 인증서(Microsoft만 신뢰). 전체 요약 9문장 읽기 → 010 00:11 ▲ 143 · 댓글 50 과학이 간과한 연구 방향을 찾는 AI 방법론 과학 발전은 사실의 진실성뿐 아니라 연구자들이 인식할 수 있는 개념의 가용성에 의해 제약된다. AI · 머신러닝 · The alien space of science: Coherent but cognitively unavailable directions
Key Point 기존 AI는 널리 알려진 아이디어 조합만 반복하는데, 이 연구는 과학적으로 타당하지만 아무도 시도하지 않은 연구 방향을 발견하는 방법을 제안한다.
핵심 요약
과학 발전은 사실의 진실성뿐 아니라 연구자들이 인식할 수 있는 개념의 가용성에 의해 제약된다. 기존 언어모델들은 논문 문헌의 고밀도 영역에서만 아이디어를 조합하므로, 여러 분야의 개념과 방법을 함께 활용할 가능성 있는 방향들을 놓친다. 연구팀은 논문을 개념 단위로 분해한 뒤 '아이디어 원자(idea atoms)'라는 어휘로 군집화하고, 이들의 조합이 학문적으로 타당한지 평가하는 일관성 모델과 기존 연구자 커뮤니티가 그 방향을 제시할 가능성을 평가하는 가용성 모델을 구축했다. 전체 요약 7문장 읽기 → 011 21:11 ▲ 12 · 댓글 2 합창 오디오를 성부별로 자동 기록하는 AI 모델 등장 기존 합창 자동 악보 기록(AMT) 시스템은 소프라노·알토·테너·베이스(SATB) 성부를 구분하지 못하고 하나의 음표 트랙으로 병합했는데, 이는 악보 복원과 성악 교육을 어렵게 만들었다. AI · 머신러닝 · Toward Part-Aware Choral Transcription with singing voice assignment
Key Point 합창 악보를 성부별로 정확히 기록할 수 있게 되면 학생 악단 연습, 악보 출판, 원곡 복원 등이 더 효율적으로 가능해진다.
핵심 요약
기존 합창 자동 악보 기록(AMT) 시스템은 소프라노·알토·테너·베이스(SATB) 성부를 구분하지 못하고 하나의 음표 트랙으로 병합했는데, 이는 악보 복원과 성악 교육을 어렵게 만들었다. 새로운 'PawCT' 모델은 합창 오디오를 입력받아 활성화된 SATB 성부를 먼저 식별한 뒤, 각 성부를 별도의 음표 레벨 트랙으로 자동 기록한다. 성부별 음의 시작·종료·유지 시점 예측과 성부 포함 여부 추정을 함께 진행하며, SATB 음역대 사전 정보(RP)와 성부 내 선율 연속성·성부 간 음정 순서를 반영하는 확장 기법(OC)을 적용한다. 전체 요약 6문장 읽기 → 012 18:11 ▲ 23 · 댓글 2 3D 씬 복원 속도·메모리 획기적으로 개선한 RLSplat Feed-forward 3D Gaussian Splatting(FF3DGS)은 이미지로부터 3D 씬을 한 번의 forward pass로 복원하는 기술로, 제한된 자원 하에서 동작해야 하는 애플리케이션에 적합하다. AI · 머신러닝 · RLSplat: Resource-Linear Budget Control for Feed-forward 3D Gaussian Splatting
Key Point 모바일이나 엣지 디바이스 같은 자원 제약 환경에서 3D 씬 복원의 실용성을 획기적으로 높이는 기술로, 기존 방식의 비효율성(고정적 오버헤드)을 근본적으로 해결했다.
핵심 요약
Feed-forward 3D Gaussian Splatting(FF3DGS)은 이미지로부터 3D 씬을 한 번의 forward pass로 복원하는 기술로, 제한된 자원 하에서 동작해야 하는 애플리케이션에 적합하다. 기존 예산 제어 FF3DGS 방식들은 추론 단계의 비용을 고려하지 않았는데, 목표한 개수의 가우시안 표현을 만들기 위해 먼저 밀집한 가우시안을 예측한 후 제거하거나 선택하기 때문에 예산과 무관하게 거의 일정한 지연 시간과 피크 메모리를 소비한다. 새로운 RLSplat 방식은 자원 선형 예산 제어 FF3DGS 프레임워크로, 가우시안 예산이 감소함에 따라 표현 크기, 추론 지연 시간, 피크 메모리가 모두 선형적으로 감소한다. 전체 요약 7문장 읽기 → 013 18:11 ▲ 20 · 댓글 2 계층적 생성으로 작은 모델도 큰 모델 따라잡다 연속 의미 공간과 이산 텍스트 생성을 분리한 계층적 언어 모델 Cola2를 제안했다. AI · 머신러닝 · Cola2: Co-Adaptive Hierarchical Language Modeling with Continuous Semantic Compression and Balanced Discrete Generation
Key Point 작은 모델이 큰 모델보다 많은 사전학습량에도 불구하고 나은 성능을 보이는 새로운 생성 방식의 효율성을 보여준다.
핵심 요약
연속 의미 공간과 이산 텍스트 생성을 분리한 계층적 언어 모델 Cola2를 제안했다. 텍스트를 의미 단위로 동적 분할하고, 보조 손실 없는 음의 피드백으로 압축률을 조절하며, 복원과 생성 감시를 결합해 컴팩한 잠재 표현을 학습한다. 블록-인과 마스크 확산 디코더를 사용하고, 분류기-무료 지도로 의미 복원과 자율 생성 사이 균형을 조절한다. 전체 요약 8문장 읽기 → 014 00:11 ▲ 28 · 댓글 2 드물게 찍은 사진에서 3D 장면 재구성하되, 계산은 가볍게 Sparse view에서 3D 장면을 한 번의 순전파(feedforward)로 복원하되, 기하학과 텍스처를 정확히 살리는 것이 기존 과제였다. AI · 머신러닝 · CompactSplat: Spatially Adaptive Gaussian Distribution for Feedforward Scene Reconstruction
Key Point 기존의 균등한 가우시안 할당 방식의 비효율을 개선하면서 적응형 분배로 메모리는 줄이고 화질은 높인 새로운 접근이 무엇을 달리하는지 보여준다.
핵심 요약
Sparse view에서 3D 장면을 한 번의 순전파(feedforward)로 복원하되, 기하학과 텍스처를 정확히 살리는 것이 기존 과제였다. 3DGS(3D Gaussian Splatting)를 쓴 최근 방법들은 각 픽셀마다 1개 이상의 가우시안을 할당하는데, 단순한 영역에서는 프리미티브를 낭비하고 평면 구조의 기하학적 사전정보를 활용하지 못한다. CompactSplat은 텍스처 기반 공간 분할과 계층적 샘플링을 결합해 콘텐츠에 맞춘 가우시안 할당을 수행한다. 전체 요약 6문장 읽기 → 015 18:11 ▲ 160 · 댓글 3 VLM이 3D 공간을 독립적으로 탐색 매핑할 수 있나 비전-언어 모델(VLM) 에이전트가 자율적 탐색을 통해 정확한 3D 맵을 구성할 수 있는지 평가하는 벤치마크 SpatialScout을 제시했다. AI · 머신러닝 · SpatialScout: Can VLM Agents Actively Explore and Map 3D Scenes?
Key Point VLM이 공간 지능 구성 능력을 갖췄는지 체계적으로 측정하기 위한 벤치마크이며, 최첨단 모델도 정밀한 3D 매핑에서 심각한 한계를 보이고 있기 때문이다.
핵심 요약
비전-언어 모델(VLM) 에이전트가 자율적 탐색을 통해 정확한 3D 맵을 구성할 수 있는지 평가하는 벤치마크 SpatialScout을 제시했다. 80개 실내 장면과 3,140개 목표 객체로 구성되며, 에이전트는 카메라를 조종해 장면을 탐색하고 공유 좌표계에서 객체 중심을 추정해야 한다. 시점 선택, 교차 뷰 연관성 파악, 기하학적 추정, 맵 수정을 조율하면서 제한된 상호작용 예산 내에서 작업을 수행한다. 전체 요약 7문장 읽기 → 016 15:11 ▲ 44 · 댓글 2 LLM 추론 과정을 자체 스타일로 복원하는 TraceForge 발표 프론티어 LLM은 답변만 제공하고 추론 과정을 숨기는데, 이를 극복하기 위해 기존 연구는 암호화된 블록을 재생하는 방식을 사용했으나 서비스 약관을 위반한다. AI · 머신러닝 · TraceForge: Distilling with Your Own Thinking
Key Point 상용 LLM의 추론 과정 접근을 제한하는 현실에서, 약관을 위반하지 않으면서도 모델의 자체 스타일로 추론을 복원해 학습 효율을 높일 수 있는 대안을 제시한다.
핵심 요약
프론티어 LLM은 답변만 제공하고 추론 과정을 숨기는데, 이를 극복하기 위해 기존 연구는 암호화된 블록을 재생하는 방식을 사용했으나 서비스 약관을 위반한다. TraceForge는 교사 모델의 답변과 맥락에서 학생 모델 패밀리의 스타일로 추론 흔적을 생성하는 방식을 제안한다. 생성기가 교사 답변에서 추론 흔적을 재생성하도록 학습하고, 비평가가 실제 흔적의 진정성을 판단하는 2단계 학습(지도학습 후 적대적 학습)을 수행한다. 전체 요약 7문장 읽기 → 017 12:11 ▲ 135 · 댓글 1 LLM 에이전트 캐시 관리, 비용 28% 절감 LLM 에이전트가 장시간 작업을 수행할 때 key-value(KV) 캐시의 I/O와 저장이 가장 큰 비용이 되고, 궤적(trajectory)이 컨텍스트 길이를 초과하면서 캐시 크기 조절이 필수가 되었다. AI · 머신러닝 · Cache Engineering for Agents
Key Point LLM 에이전트의 장시간 작업에서 캐시 관리 오버헤드가 최대 비용이 되는 상황에서, 궤적 수정 없이 캐시를 제어하고 비용을 27.7% 줄이는 새로운 방식의 등장으로 에이전트 성능 최적화의 패러다임이 바뀌고 있다.
핵심 요약
LLM 에이전트가 장시간 작업을 수행할 때 key-value(KV) 캐시의 I/O와 저장이 가장 큰 비용이 되고, 궤적(trajectory)이 컨텍스트 길이를 초과하면서 캐시 크기 조절이 필수가 되었다. 기존 방식인 히스토리 정리·요약은 궤적을 변경해서 이미 캐시된 상태를 무효화하고 비용이 많이 드는 재-프리필(re-prefilling)을 촉발한다. 연구팀은 cache engineering이라는 새로운 방식을 제안했는데, 궤적을 수정하지 않으면서 에이전트가 활성 KV 캐시를 직접 제어할 수 있게 한다. 전체 요약 10문장 읽기 → 018 03:11 ▲ 25 · 댓글 2 영상과 3D 모션을 동시에 만드는 AI 모델 기존 영상 생성 AI는 픽셀 단위 동작만 만들었지만, 3D 자산을 애니메이션할 수 있는 실제 3D 모션은 반환하지 못했다. AI · 머신러닝 · Joints, Camera, Action! Co-Generating 3D Motion and Video for Arbitrary Rigs
Key Point 영상 생성 AI가 3D 애니메이션 제작 파이프라인으로 확장되는 중요한 시점에, 실제 3D 자산을 직접 움직일 수 있는 모션을 만드는 기술이 등장했다.
핵심 요약
기존 영상 생성 AI는 픽셀 단위 동작만 만들었지만, 3D 자산을 애니메이션할 수 있는 실제 3D 모션은 반환하지 못했다. 이 논문은 텍스트로부터 영상과 3D 모션을 함께 만드는 모델을 제시하며, 임의의 스켈레톤(뼈대)를 지원하고 카메라 위치도 함께 복원한다. 기존 방식은 인간 스켈레톤만 처리하거나 매개변수가 수십억 개인 반면, 이 모델은 3D 모션을 별도로 처리하고 미니 크로스 어텐션 레이어로 사전학습된 영상 모델과 연결해 효율성을 높였다. 전체 요약 8문장 읽기 → 019 18:11 ▲ 25 · 댓글 2 LLM 활용해 3D 부품 조립 성능 대폭 향상 3D 부품 조립은 분해된 부품들에서 전체 형태를 복원하기 위해 각 부품의 rigid SE(3) 변환을 예측하는 과제다. AI · 머신러닝 · LLM2R: From Large Language Models to 3D Reassemblers
Key Point 대규모 부품을 가진 3D 조립 작업에서 기존 방식의 확장성 문제를 LLM 기반 접근으로 근본적으로 해결하고, 복잡한 기하학적 추론을 단일 forward pass로 처리할 수 있는 새로운 가능성을 제시한다.
핵심 요약
3D 부품 조립은 분해된 부품들에서 전체 형태를 복원하기 위해 각 부품의 rigid SE(3) 변환을 예측하는 과제다. 기존 방식은 부품 쌍의 관계에 의존하거나 반복 생성-검증을 사용해 많은 부품을 가진 물체에서 확장성이 떨어진다. LLM2R은 부품 조립을 sequence modeling 문제로 재정의하며 사전학습된 decoder-only LLM을 활용한다. 전체 요약 10문장 읽기 → 020 18:11 ▲ 22 · 댓글 2 추론 모델의 병렬 수정 기법, Draft Refinement 제안 추론 모델이 반복적으로 각 의사결정을 수정할 때, 개별적으로 타당한 토큰 업데이트가 전체 답변의 질을 보장하지 못한다는 문제를 제시한다. AI · 머신러닝 · Breaking Diffusion: Parallel Reasoning with Draft Refinement
Key Point 추론 모델에서 토큰 단위 수정을 병렬로 처리하면서도 평가의 정확성을 높이는 새로운 메커니즘을 제시해, 복잡한 문제 해결에서 계산 효율과 정확도를 동시에 개선할 수 있음을 보여준다.
핵심 요약
추론 모델이 반복적으로 각 의사결정을 수정할 때, 개별적으로 타당한 토큰 업데이트가 전체 답변의 질을 보장하지 못한다는 문제를 제시한다. Draft Refinement Language Models(DRLMs)는 단일 denoiser를 사용해 병렬 수정안을 제안하고 후보 초안을 평가하는 방식을 도입했다. Denoiser는 균등하게 손상된 초안에서 모든 토큰을 복원하도록 학습되어 보존과 수리 능력을 모두 갖춘다. 전체 요약 8문장 읽기 → 021 21:11 ▲ 20 · 댓글 2 세밀한 기하학 표현으로 3D 재구성 정확도 높인 FineSplat Feed-forward 3D Gaussian Splatting 기반의 FineSplat을 제안하여 세밀한 기하학과 외관 정보를 더 정확히 복원한다. AI · 머신러닝 · FineSplat: Fine Patches, Local Groups, Detailed Splats
Key Point Feed-forward 3D 재구성의 정확도를 크게 높이는 방법론이 필요한 상황에서, 토큰 그룹화와 렌더링 피드백을 결합해 계산 효율과 복원 품질을 동시에 개선한 접근법을 제시한다.
핵심 요약
Feed-forward 3D Gaussian Splatting 기반의 FineSplat을 제안하여 세밀한 기하학과 외관 정보를 더 정확히 복원한다. 고해상도 토큰에서 다중뷰 어텐션이 계산상 비효율적이므로, 뷰 기반 그룹화로 인접 뷰들 간 상호작용을 효율화하고 3D 공간 그룹화로 기하학적으로 연관된 토큰들을 재연결한다. 렌더링 오류를 직접 피드백으로 활용하여 세밀한 구조와 외관 복원을 위한 명시적 신호를 제공하고 단일 pass 방식의 한계를 극복한다. 전체 요약 5문장 읽기 → 022 21:11 ▲ 13 · 댓글 2 빠르게 움직이는 물체 복원, 가우시안 배치 방식 개선 동적 가우시안 표현은 고품질 실시간 볼루메트릭 비디오를 가능하게 했으나, 빠르게 움직이는 작은 물체가 소실되거나 동적 영역의 세부 텍스처가 손실되는 문제가 있다. AI · 머신러닝 · Dusting the Phantom: Gaussian Allocation for Fading Dynamic Content
Key Point 실시간 동적 장면 재구성에서 빠르게 움직이는 작은 물체의 소실 문제를 해결하는 새로운 가우시안 배치 방식을 제시하여, 3D 비디오 캡처 기술의 실용성을 높인다.
핵심 요약
동적 가우시안 표현은 고품질 실시간 볼루메트릭 비디오를 가능하게 했으나, 빠르게 움직이는 작은 물체가 소실되거나 동적 영역의 세부 텍스처가 손실되는 문제가 있다. 더 오래 학습하거나 가우시안을 늘려도 이런 작은 고속 물체를 복원하기 어려운 이유는 표현 용량이 아니라 가우시안 초기화 위치와 시기가 핵심 병목이다. 기존 배치 전략은 현재 가우시안 위치에만 의존하고 이동할 가우시안의 시공간적 목표 위치를 간과한다. 전체 요약 7문장 읽기 → 023 18:11 ▲ 13 · 댓글 2 자막·로고 자동 제거하는 AI 모델과 벤치마크 공개 비디오에서 자막, 제목, 로고 같은 오버레이를 제거하면서 주변 장면을 보존하는 문제를 다룬다. AI · 머신러닝 · DeOverlay: A Benchmark and Source-Anchored Flow for Video Overlay Removal
Key Point 비디오 편집·정제 작업의 자동화를 가능하게 하는 새로운 방법론과 평가 기준이 제시되었기 때문입니다.
핵심 요약
비디오에서 자막, 제목, 로고 같은 오버레이를 제거하면서 주변 장면을 보존하는 문제를 다룬다. 기존 방식은 시간 정보 활용이나 조건부 생성을 썼지만 잔여 오버레이를 남기고 장면 구조를 왜곡할 수 있었다. DeOverlay라는 소스 앵커드 플로우 모델을 제안하는데, 소스 잠재 표현에서 고정된 가이던스로 깨끗한 영상을 복원한다. 전체 요약 11문장 읽기 → 024 15:11 ▲ 235 · 댓글 3 뇌 신경 신호 예측, 104B 대규모 모델로 풀다 뇌 인코딩 모델은 자극에 대한 신경 반응을 예측하는데, 기존엔 동결된 사전학습 모델의 출력층만 학습했으나 신경 데이터가 비싸고 제한적이라 큰 모델 학습이 어려웠다. AI · 머신러닝 · Scaling Parameter-Efficient Fine-Tuning for Brain Encoding
Key Point 매개변수 효율적 미세조정 기법으로 뇌 신경 신호 예측 분야에서 100B대 대규모 모델 활용이 처음 가능해졌고, 기존 접근법 대비 계산 효율을 획기적으로 개선했다.
핵심 요약
뇌 인코딩 모델은 자극에 대한 신경 반응을 예측하는데, 기존엔 동결된 사전학습 모델의 출력층만 학습했으나 신경 데이터가 비싸고 제한적이라 큰 모델 학습이 어려웠다. 연구진은 매개변수 효율적 미세조정(PEFT)을 적용해 최대 104B 파라미터 규모의 멀티모달 백본을 적응시켰으며, 이는 뇌 인코딩에 적용된 최대 규모 모델이다. 슬라이딩 윈도우 대신 백본의 인과 구조를 활용해 한 번에 여러 시점을 예측함으로써 특징 추출 비용을 획기적으로 줄였다. 전체 요약 6문장 읽기 → 025 15:11 ▲ 161 · 댓글 2 1인칭 영상에서 손·물체·공간을 동시에 복원하는 모델 공개 1인칭 시점 영상에서 카메라 움직임, 주변 기하학, 손-물체 상호작용을 일관성 있게 복원하려면 개별 3D 요소들이 함께 정렬되어야 하는데, 기존 방법과 데이터셋은 이를 충분히 지원하지 못하고 있다. AI · 머신러닝 · EgoXperience: Learning World-Grounded Egocentric Representations from Human Experience
Key Point 손과 물체, 카메라와 장면을 동시에 일관성 있게 복원하는 것은 1인칭 AR, 로봇 조작, 활동 인식 등 여러 분야의 핵심 과제인데, 이 논문이 기존보다 훨씬 큰 규모의 정렬된 데이터셋과 상당히 개선된 모델을 공개했기 때문이다.
핵심 요약
1인칭 시점 영상에서 카메라 움직임, 주변 기하학, 손-물체 상호작용을 일관성 있게 복원하려면 개별 3D 요소들이 함께 정렬되어야 하는데, 기존 방법과 데이터셋은 이를 충분히 지원하지 못하고 있다. EgoXperience는 데이터 수집, 자동 주석, 통합 모델링, 벤치마킹을 통해 이 문제를 해결하는 전체 스택 패러다임을 제시한다. 핵심 도구인 EgoX-Engine은 기하학적으로 검증된 물체 추적과 SLAM 기반 월드 정렬을 결합하여 카메라, 장면, 손, 물체에 대한 일관성 있는 감독 신호를 생성한다. 전체 요약 6문장 읽기 → 026 12:11 ▲ 26 · 댓글 1 확산 모델 학습을 위한 견고한 토크나이저 RoAR-VAE 시각 토크나이저는 이미지 충실도를 유지하면서 확산 모델이 효율적으로 학습할 수 있는 잠재 표현을 생성해야 한다. AI · 머신러닝 · RoAR-VAE: Improving Latent Diffusability through Robust Prediction
Key Point 확산 모델 기반 이미지 생성의 핵심인 토크나이저 설계에 새로운 원칙을 제시하며, 견고한 예측으로 재구성과 생성 성능을 동시에 개선할 수 있음을 보여준다.
핵심 요약
시각 토크나이저는 이미지 충실도를 유지하면서 확산 모델이 효율적으로 학습할 수 있는 잠재 표현을 생성해야 한다. 기존 REPA-E 접근법을 다시 검토한 결과, 확산 목적과 전용 생성 블록을 제거하고 손상된 잠재에서의 의미론적 예측만 유지해도 유사한 생성 성능을 낸다. 이를 바탕으로 '견고한 예측' 원칙을 제시한다: 생성에 필요한 정보가 손상된 잠재에서도 복구 가능해야 한다. 전체 요약 6문장 읽기 → 027 15:11 ▲ 20 · 댓글 2 에이전트 AI 추론을 위한 '히스토리 프리' 추측 디코딩 DLite 추측 디코딩은 경량 드래프트 모델로 토큰을 생성하고 타겟 모델이 검증하는 방식으로 LLM 추론을 가속화하는 기법이지만, 에이전트 AI 워크로드의 긴 맥락과 다중 턴 상호작용에서는 드래프트 모델의 토큰 승인률이 최대 80% 저하된다. AI · 머신러닝 · DLite: History-free Speculative Decoding for Agentic AI
Key Point 에이전트 AI 같은 긴 맥락의 상호작용형 워크로드에서 LLM 추론 속도를 크게 높일 수 있는 새로운 접근 방식을 제시합니다.
핵심 요약
추측 디코딩은 경량 드래프트 모델로 토큰을 생성하고 타겟 모델이 검증하는 방식으로 LLM 추론을 가속화하는 기법이지만, 에이전트 AI 워크로드의 긴 맥락과 다중 턴 상호작용에서는 드래프트 모델의 토큰 승인률이 최대 80% 저하된다. 기존 방식은 역사적 KV 캐시를 유지함에 따라 시스템 오버헤드가 커진다. 연구팀은 증가하는 역사적 맥락이 두 문제의 공통 원인임을 파악하고, DLite라는 '히스토리 프리' 추측 디코딩 프레임워크를 제안했다. 전체 요약 7문장 읽기 → 028 21:10 당일 +441 비디오의 모자이크를 자동으로 복원하는 Jasna 비디오와 이미지의 모자이크 처리된 부분을 자동으로 찾아 복원하는 무료 도구다. 오픈소스 · 도구 · Kruk2/jasna · Python
Key Point 모자이크 처리된 콘텐츠를 자동 복원하는 도구로, GPU 가속을 활용한 빠른 처리와 선택적 복원 기능이 기술적으로 흥미로운 구현을 보여준다.
핵심 요약
비디오와 이미지의 모자이크 처리된 부분을 자동으로 찾아 복원하는 무료 도구다. 무료 모델인 BasicVSR++와 유료 지원자 모델인 LTX 두 가지 복원 모델을 제공한다. 선택한 부분만 복원할 수 있는 Segment Editor와 복원된 영상을 실시간으로 볼 수 있는 Video Player를 갖춘 간단한 앱과 커맨드라인 인터페이스를 제공한다. 전체 요약 10문장 읽기 → 029 12:11 ▲ 107 · 댓글 20 클로드, 양자 회로 설계를 대폭 개선하다 앤스로픽은 Claude Mythos 5에게 화학, 최적화, 물리 시뮬레이션, 정수론의 8가지 양자 회로 설계 과제를 평문으로 제시하고, 자동 평가기가 정확성을 검증하고 큐빗·게이트 수로 채점하도록 했다. AI · 머신러닝 · Designing more efficient quantum circuits with Claude
Key Point 양자 컴퓨터의 실용화는 회로 설계 최적화에 달렸는데, Claude가 연구 그룹이 8년에 걸쳐 이룬 성과(FeMoco 게이트 150,000배 감소)를 53시간에 달성했다는 점이 양자 알고리즘 개발의 속도를 근본적으로 바꿀 수 있음을 보여준다.
핵심 요약
앤스로픽은 Claude Mythos 5에게 화학, 최적화, 물리 시뮬레이션, 정수론의 8가지 양자 회로 설계 과제를 평문으로 제시하고, 자동 평가기가 정확성을 검증하고 큐빗·게이트 수로 채점하도록 했다. Claude는 피드백 루프를 통해 폐쇄형으로 회로를 반복 설계했으며, 8가지 모두에서 이전의 최고 성능 회로보다 큐빗과 게이트 수를 줄인 새로운 설계를 발견했다. 첫 번째 사례는 타원곡선 암호 계산의 핵심인 모듈러 역수 문제로, Claude는 divsteps 알고리즘의 가지 정보(branch information)를 저장하지 않고 수치 쌍에서 직접 복원할 수 있음을 발견했다. 전체 요약 12문장 읽기 → 030 12:11 ▲ 107 · 댓글 64 프랑스 미술관에서 도난당한 르누아르 명작, 벽 뒤에서 발견 9월 남부 프랑스 카뉴슈르메르 미술관에서 르누아르 작품 2점이 도난당했으며, 지난주 목요일 남부 클레르몽레롤의 주택 수색 중 콘크리트 벽 뒤에 숨겨진 채로 발견됐다. 기타 · Stolen Renoir paintings found hidden, and damaged, behind cinder block wall
Key Point 프랑스 주요 미술관들을 겨냥한 도난 조직 범죄가 급증하고 있으며, 미술관 보안 체계의 허점이 범죄 단체에 의해 노려지고 있는 실태를 보여준다.
핵심 요약
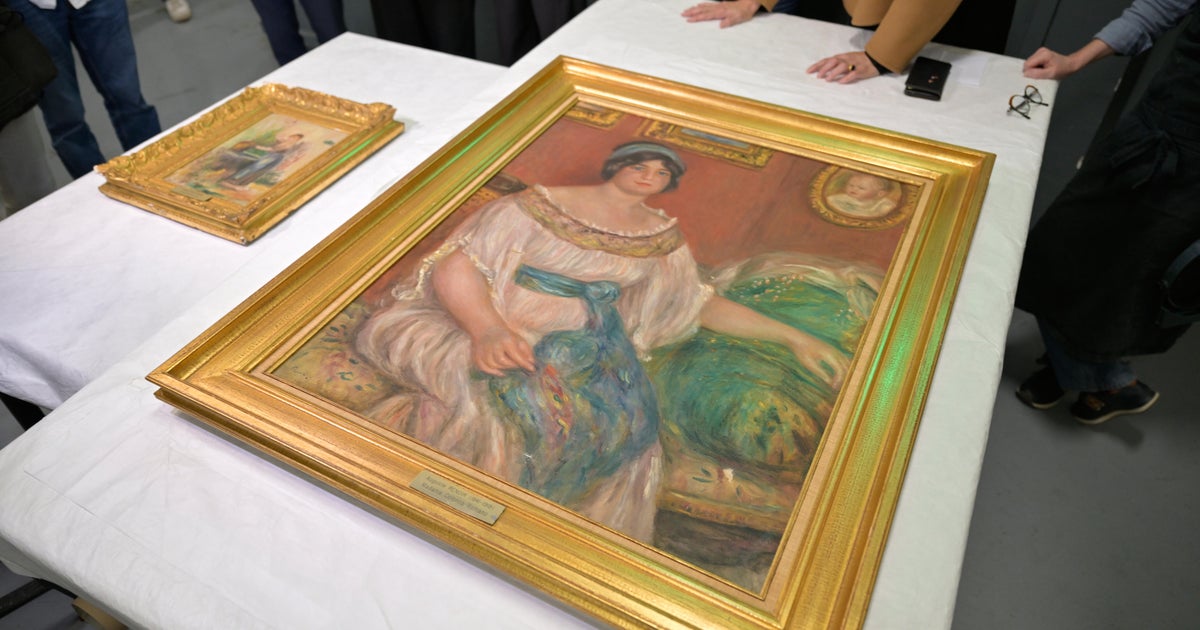
9월 남부 프랑스 카뉴슈르메르 미술관에서 르누아르 작품 2점이 도난당했으며, 지난주 목요일 남부 클레르몽레롤의 주택 수색 중 콘크리트 벽 뒤에 숨겨진 채로 발견됐다. 도난 작품은 '콜론나 로마노 부인의 초상'과 '우물가의 젊은 여인'이며, 4점 작품 전체 가치는 약 1000만 달러로 추정된다. 29세 남성이 DNA 증거로 도난 사건과 연결돼 기소됐으며, 지난주 여성을 포함한 6명이 체포됐다. 전체 요약 7문장 읽기 → 031 06:11 ▲ 383 · 댓글 154 ECDSA 곡선의 25년 미스터리, 타임스탬프로 풀다 NIST가 2000년 채택한 ECDSA 타원곡선 암호화 표준의 seed 값 출처가 수십 년간 미스터리였다. NSA가 설명 없이 제시한 이 값들은 보안 커뮤니티에서 의도된 백도어 가능성에 대한 의심을 받아왔다. 보안 · Claude reveals ECDSA curve origins
Key Point 현대 암호화 기반의 신뢰성을 둘러싼 25년간의 의혹이 명확한 생성 근거로 해결되었다. 기술 감시자와 보안 종사자가 검증할 수 있는 구체적 증거가 나왔다.
핵심 요약
NIST가 2000년 채택한 ECDSA 타원곡선 암호화 표준의 seed 값 출처가 수십 년간 미스터리였다. NSA가 설명 없이 제시한 이 값들은 보안 커뮤니티에서 의도된 백도어 가능성에 대한 의심을 받아왔다. Anthropic의 Claude가 2026년 10월 30분 내에 NIST P-192, P-224, P-256, P-384, P-521의 seed 출처를 규명했다. 해시 알고리즘이 아니라 C 라이브러리의 lrand48 난수생성기를 Unix 타임스탬프로 초기화해 생성한 것이었다. prime 곡선의 seed들은 1997년 5월~1998년 4월 사이의 타임스탐프에서 생성됐으며, 각각 특정 iteration 횟수 후 선택됐다. 예를 들어 P-256은 같은 실행에서 1842번째 후보였다. 전체 요약 9문장 읽기 → 032 21:11 ▲ 12 · 댓글 2 동영상 자막 제거 평가 벤치마크 'MFVSR' 공개 동영상 자막 제거(VSR) 기술을 평가하기 위한 대규모 벤치마크 'MFVSR'이 발표됐다. AI · 머신러닝 · MFVSR: A Multi-Style and Fine-Grained Benchmark for Video Subtitle Removal
Key Point 동영상 자막 제거 기술을 체계적으로 평가할 수 있는 첫 대규모 벤치마크로, 기존 평가 방식의 맹점을 드러내며 정확한 성능 비교를 가능하게 한다.
핵심 요약
동영상 자막 제거(VSR) 기술을 평가하기 위한 대규모 벤치마크 'MFVSR'이 발표됐다. 3,000개 쌍을 이룬 고화질·저화질 영상과 AI 생성 영상, 그리고 953개 실제 영상으로 구성됐으며, 16개 언어와 공간 배치·시간적 동작·시각적 스타일·언어 모드 등 4가지 요인에 걸쳐 다양한 자막을 포함한다. 기존 평가 방식과 달리 정보 조건화·공간 분리 프로토콜을 도입해 마스크 없는 제거와 마스크 기반 제거를 구분하고, 복원 충실도·보존 충실도·시간적 충실도·커버리지·실패 사례를 측정한다. 전체 요약 5문장 읽기 → 033 15:11 ▲ 16 · 댓글 2 단안 카메라 영상에서 인물 추적 시 발생하는 스케일 미스매치 문제 해결 단안 카메라에서 3D 인물 복원 기술들이 현재 벤치마크에서는 잘 작동하지만, 빠른 카메라 움직임을 포함한 데이터에는 문제가 있었다. AI · 머신러닝 · A Diagnostic Study of World-Space Human Recovery Under High Camera Dynamics
Key Point 빠르게 움직이는 카메라가 있는 실제 방송 환경에서 인물 3D 복원 기술의 정확도를 크게 떨어뜨리는 스케일 미스매치 문제와 그 원인, 그리고 간단한 해결책을 제시한다.
핵심 요약
단안 카메라에서 3D 인물 복원 기술들이 현재 벤치마크에서는 잘 작동하지만, 빠른 카메라 움직임을 포함한 데이터에는 문제가 있었다. 연구팀이 K-Pop 스트레스 테스트를 도입했는데, 이는 빠르고 큰 카메라 움직임과 복잡한 다중 인물 안무를 결합한 방송 댄스 영상들이다. 기존 최고 성능 방법들은 이 영상에서 프레임별로는 그럴듯한 메시를 생성하지만, 월드 좌표계 상의 인물 궤적은 실제 무대 위치에서 크게 벗어난다. 전체 요약 7문장 읽기 → 034 15:11 ▲ 23 · 댓글 2 확산 모델 강화학습을 위한 라우팅 정책 최적화 기존 강화학습 방식은 역방향 디노이징 궤적을 섭동하여 비용이 많이 드는 롤아웃 기반 최적화를 수행하는데, 생성 모델 내부에서 확률적 탐색을 도입하면서 원래의 샘플러를 보존할 수 있는지 묻는 새로운 접근을 제시했다. AI · 머신러닝 · Routing Policy Optimization for Online Diffusion Reinforcement Learning
Key Point 생성 모델을 보상 신호로 정렬할 때 훈련 효율을 4배 향상시키면서도 추론 시 모델의 원래 특성을 유지하는 새로운 강화학습 기법이 제시되어, 확산 모델 최적화의 실질적 한계를 해결한다.
핵심 요약
기존 강화학습 방식은 역방향 디노이징 궤적을 섭동하여 비용이 많이 드는 롤아웃 기반 최적화를 수행하는데, 생성 모델 내부에서 확률적 탐색을 도입하면서 원래의 샘플러를 보존할 수 있는지 묻는 새로운 접근을 제시했다. Routing Policy Optimization (RPO)는 어텐션 라우팅을 확률적 탐색 행동으로 변환하여 이를 답한다. 선택된 몇 개의 디노이징 단계에서 각 쿼리 블록은 자신의 블록을 유지하면서 생성 모델의 자연스러운 어텐션 질량에 비례하여 추가 키 블록을 샘플링하거나 밀집 어텐션을 유지한다. 전체 요약 9문장 읽기 → 035 21:11 당일 +100 만화 자동 번역 도구 Koharu, Rust로 완전 로컬 실행 Koharu는 Rust로 작성된 머신러닝 기반 만화 번역 도구로, 모든 모델과 LLM을 사용자의 로컬 머신에서 실행하여 데이터 프라이버시를 보장한다. 오픈소스 · 도구 · koharu-rs/koharu · Rust
Key Point 완전 로컬 실행 만화 번역 자동화 도구로, 프라이버시 우려 없이 복잡한 시각 처리와 자연어 처리를 통합하는 오픈소스 솔루션을 원하는 사용자에게 선택지가 생겼다.
핵심 요약
Koharu는 Rust로 작성된 머신러닝 기반 만화 번역 도구로, 모든 모델과 LLM을 사용자의 로컬 머신에서 실행하여 데이터 프라이버시를 보장한다. 객체 검출, OCR, 인페인팅, LLM을 조합해 만화 번역 프로세스를 자동화하며, 래스터 이미지·압축 아카이브·PDF를 모두 지원한다. 텍스트 영역과 말풍선, 정리 영역을 감지·분할하고 대사·캡션·일반 텍스트에 대한 다중모드 OCR을 수행한다. 전체 요약 10문장 읽기 → 036 18:11 ▲ 19 · 댓글 1 초해상화, 올바른 잠재공간에서 해결하다 고해상도 자연 이미지의 임베딩들은 잠재공간에서 다양체를 형성하며, 저화질 이미지는 이 다양체 바깥에 위치한다. AI · 머신러닝 · Super-Resolution in The Right Latent Space: A Frozen Vision-Foundation Substrate
Key Point DINOv3 비전 파운데이션 모델의 잠재공간이 기존 방식보다 초해상화 작업을 근본적으로 효과적으로 만드는 방법을 제시하여, 이미지 복원 파이프라인의 설계 원칙이 바뀔 수 있음을 보여준다.
핵심 요약
고해상도 자연 이미지의 임베딩들은 잠재공간에서 다양체를 형성하며, 저화질 이미지는 이 다양체 바깥에 위치한다. 기존 초해상화 방법들은 재구성 지향 또는 픽셀 공간에서 작동하는데, 이 공간들에서 저화질 이미지가 다양체에서 멀리 떨어져 있어 매핑이 어렵고 비용이 크다. 의미 정보가 부족한 공간에서 작동하면 심각한 할루시네이션이 발생하며, 화질 저하가 심할수록 이 문제는 악화된다. 전체 요약 9문장 읽기 → 037 09:11 ▲ 146 · 댓글 70 미국, 희토류 산업 '포기'가 아닌 '매각'했다 중국은 2025년 10월 희토류 수출 통제를 강화했고, 이후 단기 유예를 반복하며 협상 시 미국의 양보를 이끌어냈다. 보안 · America didn't lose its rare earth industry, it sold it
Key Point 미국이 30년 전 중국에 넘겨준 희토류 산업이 지정학적 무기가 되는 현실에서, 공급망 복원을 위한 새로운 금융 수단의 설계 논리를 제시하는 정책 제안이다.
핵심 요약
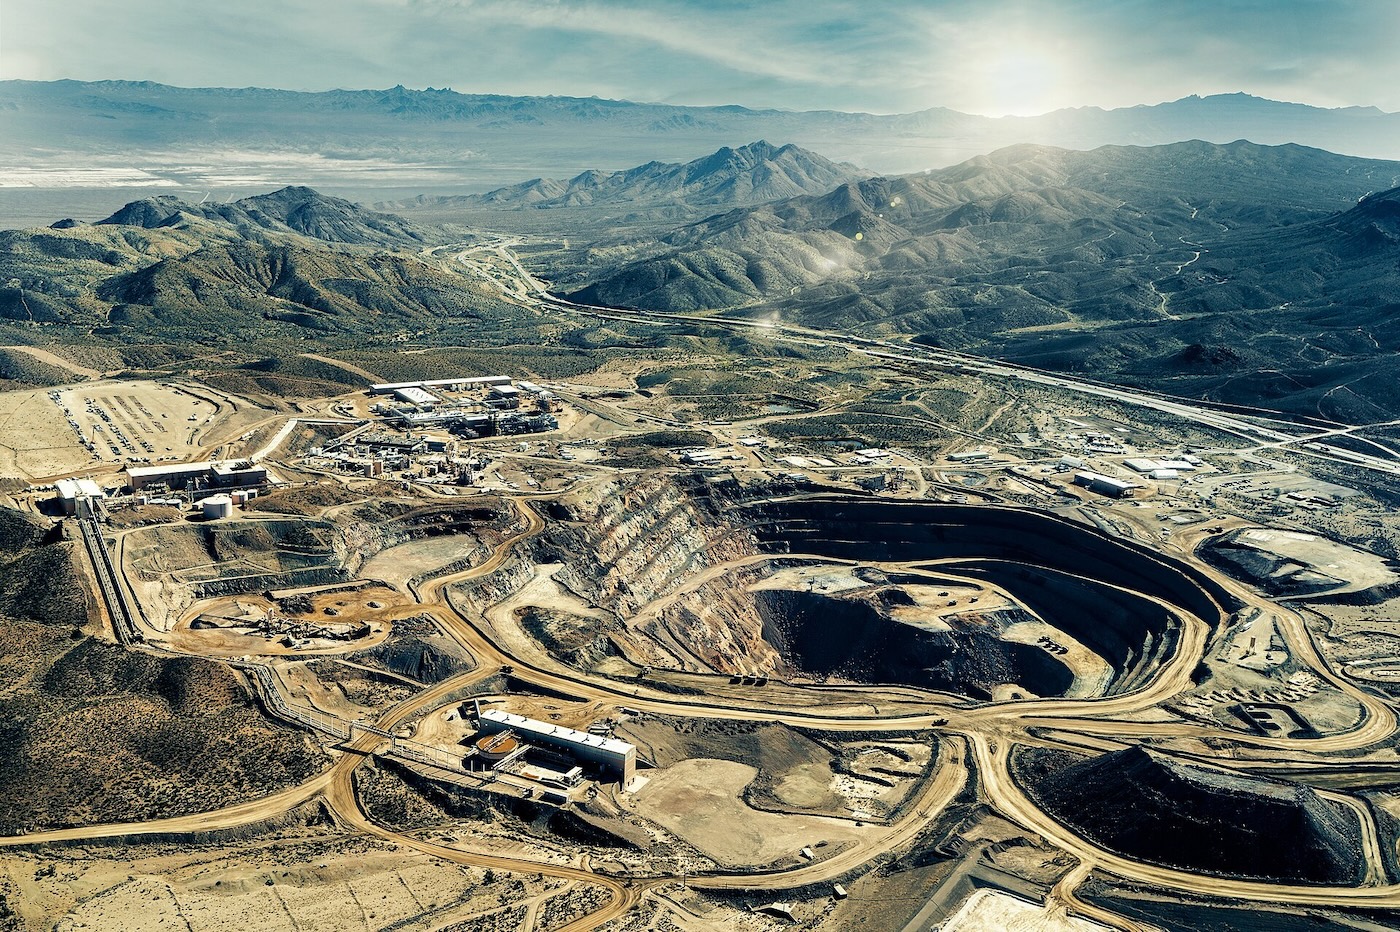
중국은 2025년 10월 희토류 수출 통제를 강화했고, 이후 단기 유예를 반복하며 협상 시 미국의 양보를 이끌어냈다. 전 세계 희토류 정제량의 90% 이상을 중국이 차지하고, 국제 수급 조절의 주도권을 확보한 상태다. 희토류는 시장 실패의 전형으로, $10억 규모의 시장이 수조 달러 규모의 글로벌 공급망을 마비시킬 수 있는 병목 지점이다. 전체 요약 13문장 읽기 → 038 06:11 ▲ 113 · 댓글 36 해저 통신 케이블 위기, 수리선박 부족과 정부 규제가 병목 전 세계 1.5백만km의 해저 통신케이블 607개 시스템이 국제 통신을 담당하며 위성으로 대체 불가능한 핵심 인프라다. 인프라 · 데브옵스 · Submarine cable resilience
Key Point 해저 케이블 수리 병목과 민간 기업의 글로벌 통신 인프라 독점 심화는 국가 차원의 통신 안보를 위협하는 구조적 문제로 악화되고 있다.
핵심 요약
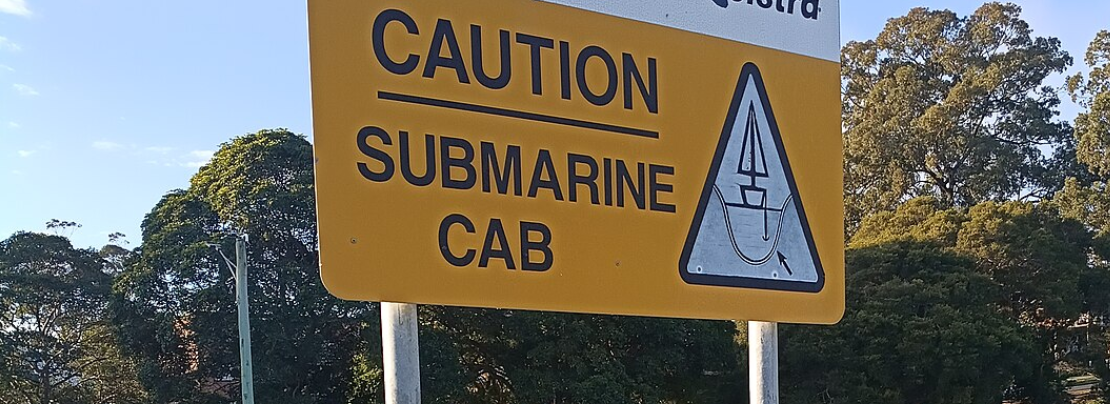
전 세계 1.5백만km의 해저 통신케이블 607개 시스템이 국제 통신을 담당하며 위성으로 대체 불가능한 핵심 인프라다. 2018~2022년 대만-마쓰섬 간 케이블은 27회, 발트해는 2023년 이후 11회 손상되는 등 얕은 수심 해역에서 빈번히 끊긴다. 매년 약 200건의 해저 케이블 장애 중 86%는 어선 어구나 배 닻에 의한 것이고, 지질활동 7%, 케이블 마모 4%, 중계기 고장 4%를 차지한다. 전체 요약 11문장 읽기 → 039 00:11 ▲ 10 · 댓글 2 생성형 AI로 대규모 3D 장면 완전 복원 실현 다양한 각도의 카메라 정보 없는 RGB 이미지들로부터 대규모 3D 장면의 완전한 메시를 복원하는 생성형 모델 WorldRecon을 제시했다. AI · 머신러닝 · WorldRecon: Generative Multi-View Mesh Reconstruction for Large-Scale 3D World
Key Point 완전하고 일관된 대규모 3D 장면 복원이 가능해져 가상현실·영상 제작·로봇 환경 인식 등 다양한 분야에서 활용될 수 있게 된다.
핵심 요약
다양한 각도의 카메라 정보 없는 RGB 이미지들로부터 대규모 3D 장면의 완전한 메시를 복원하는 생성형 모델 WorldRecon을 제시했다. 입력 이미지로부터 추정한 포인트 클라우드와 카메라 포즈를 전역 스캐폴드로 사용하고, 이를 겹치는 공간 블록으로 분할하여 처리한다. 3D 생성 모델 TRELLIS.2를 개선한 재구성 기반 조건화 아키텍처로 각 블록을 로컬 포인트 클라우드와 해당 이미지로부터 생성하며, 구조·기하·PBR 재료를 출력한다. 전체 요약 6문장 읽기 → 040 00:11 ▲ 23 · 댓글 2 멀티모달 에이전트가 보는 방식과 읽는 법을 함께 개선하는 ViewCraft 멀티모달 에이전트의 성능 개선 문제를 다루되, 모델 가중치를 업데이트하지 않고 재사용 가능한 스킬만 진화시키는 방식을 제안한다. AI · 머신러닝 · VIEWCRAFT: Evolving What Multimodal Agents See and How They Read It
Key Point 멀티모달 에이전트의 입력 처리 방식 자체를 학습함으로써 모델 재학습 없이 성능과 효율성을 동시에 높일 수 있는 새로운 접근법이 제시되었기 때문이다.
핵심 요약
멀티모달 에이전트의 성능 개선 문제를 다루되, 모델 가중치를 업데이트하지 않고 재사용 가능한 스킬만 진화시키는 방식을 제안한다. 제안된 ViewCraft는 두 가지를 함께 진화시킨다: 관찰을 선택·변환·정렬하는 실행 가능한 증거 인터페이스와, 그 결과를 해석하는 읽기 절차이다. 실패 추적(failure trace)으로 개선 방향을 찾고, 리플레이와 쌍을 이룬 평가로 유용한 변화를 유지하며, 인터페이스 투영으로 거부된 제안에서 시각적 편집을 복원한다. 전체 요약 7문장 읽기 → 041 21:11 ▲ 34 · 댓글 2 동영상 초고화질화, 일반 GPU로 4K 실시간 처리 가능해졌다 기존 동영상 초고화질화(VSR) 모델이 확산 증류를 통해 한 단계 생성으로 효율성을 높였으나, 고해상도 추론 비용이 크고 생성 결과가 사용자 선호와 맞추기 어려운 문제가 있었다. AI · 머신러닝 · FlashVSR+: Efficient Video Super-Resolution via Hybrid Attention and Reward-Yield Distribution Matching
Key Point 동영상 초고화질화가 실용적인 수준의 속도와 메모리 효율로 4K 고해상도 처리가 가능해지면서, 콘텐츠 제작자와 개발자들이 일반 사양 GPU에서도 고품질 영상 생성을 구현할 수 있게 되었다.
핵심 요약
기존 동영상 초고화질화(VSR) 모델이 확산 증류를 통해 한 단계 생성으로 효율성을 높였으나, 고해상도 추론 비용이 크고 생성 결과가 사용자 선호와 맞추기 어려운 문제가 있었다. FlashVSR+는 하이브리드 어텐션 메커니즘을 도입해 사전학습된 VSR 모델의 강한 지역성(locality)을 활용하면서 장거리 일관성을 위해 희소 전역 상호작용을 유지한다. 이를 통해 DiT 속도를 최대 2배 높이고 피크 메모리를 45% 감소시켜, RTX 4090 24GB 단일 GPU에서 타일 분할 없이 4K 영상 초고화질화를 가능하게 했다. 전체 요약 7문장 읽기 → 042 18:11 ▲ 25 · 댓글 2 3D 메시 움직임 복원, 스케일 분리로 범용화 희소한 정점 변위로부터 촘촘한 메시 움직임을 복원하는 문제를 다룬다. AI · 머신러닝 · Cepheid: Decoupling Scale from Structure for Cross-Family Motion Completion
Key Point 3D 애니메이션 제작과 로봇 제어에서 부분 관측만으로 전체 움직임을 복원하는 핵심 문제를 해결했으며, 단일 모델로 다양한 대상에 일반화되는 점이 기술적 진전을 의미한다.
핵심 요약
희소한 정점 변위로부터 촘촘한 메시 움직임을 복원하는 문제를 다룬다. 기존 학습 기반 잔차 사전은 특정 형태군(의류, 동물 등)에서만 기존 조화 확장을 넘지 못했다. 스케일 문제: 기하학 형태군 간 잔차 진폭이 10배 이상 차이나며, 관측값이 많아지면 붕괴된다. 전체 요약 6문장 읽기 → 043 00:11 ▲ 12 · 댓글 2 이미지로 초고해상도 3D 메시 복원, 장면 크기 제약 없이 여러 각도 이미지로부터 장면 최적화 과정 없이 고품질 3D 메시를 복원하는 T3lescope 모델을 제시한다. AI · 머신러닝 · T3lescope: Arbitrary-Resolution High-Fidelity Generative Surface Reconstruction from Images
Key Point 멀티뷰 이미지에서 수십 미터 규모 실외 장면까지 일관되게 3D 메시를 복원할 수 있게 되어, 기존의 장면 분할로 인한 불일치 문제를 근본적으로 해결하는 기술이다.
핵심 요약
여러 각도 이미지로부터 장면 최적화 과정 없이 고품질 3D 메시를 복원하는 T3lescope 모델을 제시한다. 기존 최적화 기반 방법은 관찰이 부족하거나 표면이 광택·투명할 때 3D 사전지식이 부족해 실패한다. 생성 기반 방법은 3D 사전지식으로 미관찰 영역을 채우지만 고정된 해상도와 제한된 공간 범위에서만 작동한다. 전체 요약 9문장 읽기 → 044 21:11 ▲ 82 · 댓글 2 사용자 개입 받으며 생성되는 동영상, 문맥 기반으로 제어한다 영상 생성 시 시청자가 실시간으로 개입할 때, 시청자의 요청이 원본 자료와 현재까지 생성된 영상 상태에 모두 의존하는 문제가 발생한다. AI · 머신러닝 · VIS-Ground: Video Interactive Storytelling with Contextual Grounding
Key Point 시청자가 실시간으로 영상 생성에 개입할 때 원본 자료, 이전 생성물, 새로운 요청 간의 숨겨진 관계를 모두 파악해야 정확한 결과를 낼 수 있다는 근본적인 문제를 해결하는 방법을 제시한다.
핵심 요약
영상 생성 시 시청자가 실시간으로 개입할 때, 시청자의 요청이 원본 자료와 현재까지 생성된 영상 상태에 모두 의존하는 문제가 발생한다. 기존 대화형 영상 생성 시스템은 사용자 지시만 따르거나, 외부 자료 정렬에만 집중해 문맥 기반 제약을 제대로 다루지 못했다. VIS-Ground는 이질적이고 비정형인 입력 정보를 구조화된 제약 모델로 변환한다. 전체 요약 7문장 읽기 → 045 21:11 ▲ 25 · 댓글 2 과거 거리 풍경 복원, 위성 데이터로 세대를 뛰어넘다 도시의 변화를 기록한 역사적 거리 풍경 이미지는 시간 범위가 불균형해 기록 공백이 많은데, 이를 해결하기 위해 CrossTimeEdit 논문은 VIGOR-his 데이터셋을 제시한다. AI · 머신러닝 · CrossTimeEdit: A Decade-Spanning Cross-View Dataset and Reward-Guided Editing for Historical Street-View Generation
Key Point 위성 이미지와 시간 정보를 활용한 역사 거리 풍경 복원 기술로, 도시 아카이브나 도시계획 분야에서 데이터 부족 문제를 해결할 수 있는 새로운 접근 방식을 제시한다.
핵심 요약
도시의 변화를 기록한 역사적 거리 풍경 이미지는 시간 범위가 불균형해 기록 공백이 많은데, 이를 해결하기 위해 CrossTimeEdit 논문은 VIGOR-his 데이터셋을 제시한다. VIGOR-his는 3대륙 11개 도시의 10년 단위 거리 풍경 쿼드러플렛 43,653개를 포함하며, 공간 쌍짓기·일관성 검증·변화 분류·위성 기반 변화 설명 생성 및 검증 등 자동화 파이프라인을 거친다. CrossTimeEdit는 FLUX.2 4B 모델을 기반으로 거리 풍경 생성을 편집 작업으로 재구성하며, 최근 거리 풍경으로 시점과 불변 부분을 제약하고 시간별 위성 차이를 변화 증거로 활용한다. 전체 요약 6문장 읽기 → 046 00:11 ▲ 100 · 댓글 100 시트로엥, 전기차 시대 맞춰 2CV 부활시키다 프랑스 자동차 제조사 시트로엥이 2CV 브랜드를 부활시켜 어려운 시장에서 전기차 판매를 촉진하려고 나섰다. 하드웨어 · 시스템 · Citroen revives the 2CV for an electric age
Key Point 유럽 자동차 제조사들의 생존 전략이 바뀌고 있다. 중국 전기차 제조사의 공격적 진출 속에서 헤리티지 복원으로 경쟁력을 되찾으려는 움직임이 확산 중이다.
핵심 요약
프랑스 자동차 제조사 시트로엥이 2CV 브랜드를 부활시켜 어려운 시장에서 전기차 판매를 촉진하려고 나섰다. 파리 모터쇼에서 공개된 신형 2CV는 레트로 스타일링을 가진 소형 도시용 자동차로, 1948년 출시된 명작의 디자인을 현대적으로 해석했다. 컨셉 카로서 2028년 쇼룸 진입을 목표하고 있으며, 약 13,000파운드의 가격대를 예상하고 있다. 전체 요약 9문장 읽기 → 047 21:12 당일 +176 장문 코딩 세션을 수개월 지속하는 컨텍스트 압축 플러그인 billion-context는 TypeScript 기반 컨텍스트 압축 플러그인으로, 100K 크기의 작은 컨텍스트 윈도우에서 5배 적은 토큰으로 수개월 단위의 장문 세션(수십억 토큰)을 운영할 수 있게 한다. AI · 머신러닝 · ranxianglei/billion-context · TypeScript
Key Point 각 토큰당 과금하는 API 환경에서 컨텍스트 윈도우를 초과하면 세션이 저하되거나 끝나는데, 이 도구로 며칠~수개월 단위 장문 세션을 하나의 윈도우로 계속 실행할 수 있다.
핵심 요약
billion-context는 TypeScript 기반 컨텍스트 압축 플러그인으로, 100K 크기의 작은 컨텍스트 윈도우에서 5배 적은 토큰으로 수개월 단위의 장문 세션(수십억 토큰)을 운영할 수 있게 한다. 모든 AI 코딩 에이전트 클라이언트와 모델 API 사이에 위치하면서 acp-kernel 압축으로 스트림을 재작성해 모델이 직접 언제 무엇을 압축할지 결정한다. 컨텍스트 관리 도구 4가지를 주입한다: compress(메시지 범위를 상세 요약으로 압축), decompress(필요 시 복원), search_context(압축된 요약과 가시 메시지 검색), acp_status(컨텍스트 사용량 및 압축 가능 범위 조회). 전체 요약 10문장 읽기 → 048 18:12 ▲ 13 · 댓글 2 MixTok: 전역 1D와 부분 2D 혼합한 적응형 이미지 토크나이저 기존 그리드 기반 토크나이저는 이미지 복잡도와 무관하게 모든 위치에 균등하게 토큰을 할당하므로 비효율적이고, 반면 1D 토크나이저는 간결하지만 세부 정보 보존에 약하다. AI · 머신러닝 · MixTok: Adaptive Visual Tokenization with Global 1D Tokens and Sparse 2D Refinement
Key Point 이미지 토크나이저의 효율성과 품질을 동시에 높이는 새로운 하이브리드 구조가 기존 방식의 트레이드오프를 어떻게 해결하는지 보여준다.
핵심 요약
기존 그리드 기반 토크나이저는 이미지 복잡도와 무관하게 모든 위치에 균등하게 토큰을 할당하므로 비효율적이고, 반면 1D 토크나이저는 간결하지만 세부 정보 보존에 약하다. 연구팀은 글로벌 정보를 담은 1D 토큰과 세부 개선용 2D 토큰을 결합한 하이브리드 토크나이저 MixTok을 제안했다. 콘텐츠 적응 라우터가 우선순위에 따라 후보 위치를 순위 매기고, 목표 토큰 예산 내에서 각 이미지당 2D 토큰 개수를 결정한다. 전체 요약 5문장 읽기 → 049 18:12 ▲ 27 · 댓글 2 병렬 초안 생성의 문제를 고치는 DCOCO 기법 추측 디코딩은 경량의 드래프터가 여러 토큰을 먼저 제안하고 타겟 모델이 병렬로 검증해 LLM 추론을 가속화한다. AI · 머신러닝 · Contextual Correction of Parallel Drafts for Speculative Decoding
Key Point 현재 프로덕션 LLM 추론에서 가장 효과적인 가속 기법인 추측 디코딩의 근본적 병목을 해결했으며, 모든 서빙 조건에서 지속적인 성능 향상을 제시한다.
핵심 요약
추측 디코딩은 경량의 드래프터가 여러 토큰을 먼저 제안하고 타겟 모델이 병렬로 검증해 LLM 추론을 가속화한다. 최근 확산 기반 드래프터들은 병렬로 여러 위치를 동시에 예측하지만, 각 토큰이 앞선 토큰들의 정체를 모른 채 예측되어 자동회귀 생성의 문맥 의존성이 손실된다. DCOCO(DFlash Contextual Corrector)는 병렬 드래프팅을 유지하면서 이 의존성을 복원하는 경량 메커니즘이다. 전체 요약 6문장 읽기 → 050 18:12 ▲ 139 · 댓글 2 로봇 팔이 던져진 상자를 받는다 - 시각·반사·전신제어 동시에 인간은 테니스 공 받기, 떨어지는 컵 잡기 같은 일상 동작을 1초 안에 시각과 반사신경으로 처리하지만, 휴머노이드 로봇은 이를 어렵게 느낀다. AI · 머신러닝 · Reflex: Visually Grounded Reactive Humanoid Control
Key Point 시각 피드백 기반의 실시간 전신 제어라는 난제를 단계별 학습으로 풀었고, 실제 로봇에서 인간 수준의 반사 동작 구현에 가까워지고 있습니다.
핵심 요약
인간은 테니스 공 받기, 떨어지는 컵 잡기 같은 일상 동작을 1초 안에 시각과 반사신경으로 처리하지만, 휴머노이드 로봇은 이를 어렵게 느낀다. Reflex는 던져진 상자 잡기를 목표로 전신 제어·물체 동역학 예측·시각 인지 세 가지 능력을 단계별로 학습하는 프레임워크다. 첫 번째 단계에서는 강화학습으로 상태 기반 전신 잡기 정책을 학습하고, 두 번째는 불완전하고 지연된 관찰에서 움직이는 상자의 동역학을 추론하며, 세 번째는 RGB-D 카메라로부터 직접 동역학을 복원한다. 전체 요약 6문장 읽기 → 051 15:11 ▲ 243 · 댓글 4 DiffusionART, 확산 모델 강화학습을 12배 빠르게 온라인 강화학습(RL)으로 블랙박스 보상 함수를 사용해 확산 모델을 미세조정하는 방식이 최근 주목받고 있으나, 역방향 프로세스 방식(Flow-GRPO)은 신용 할당 문제로 효율성이 떨어지고, 순방향 프로세스 방식(DiffusionNFT)은 지수이동평균(EMA) 비정책 학습 튜닝 없이는 불안정하다. AI · 머신러닝 · DiffusionART: Efficient, Stable and Scalable Reinforcement of Diffusion Models
Key Point 확산 모델 강화학습의 GPU 학습 시간을 10배 이상 단축하면서 보상 성과는 더 높이는 기술로, 이미지 및 비디오 생성 모델 최적화의 실무 효율성을 크게 개선한다.
핵심 요약
온라인 강화학습(RL)으로 블랙박스 보상 함수를 사용해 확산 모델을 미세조정하는 방식이 최근 주목받고 있으나, 역방향 프로세스 방식(Flow-GRPO)은 신용 할당 문제로 효율성이 떨어지고, 순방향 프로세스 방식(DiffusionNFT)은 지수이동평균(EMA) 비정책 학습 튜닝 없이는 불안정하다. NFT 스타일 목적함수가 숨겨진 순방향-역방향 일관성 강제를 포함하고 있으며, 양성-음성 결합 학습이 이를 부분적으로만 상쇄하고, EMA는 비정책 롤아웃이 아닌 복원을 통해 학습을 안정화한다는 원리를 발견했다. DiffusionART(Diffusion Reinforcement with Aggregation-First Reward Tilting)는 각 프롬프트의 보상을 역방향 프로세스 상태를 위한 공유 보상 개선 방향으로 집계해 일관성 강제를 구조적으로 제거한다. 전체 요약 7문장 읽기 → 052 21:11 당일 +466 아폴로 11호 유도컴퓨터 원본 소스코드 공개 NASA의 아폴로 11호 미션을 위해 개발된 유도컴퓨터(AGC) 원본 소스코드를 GitHub에서 공개하는 저장소다. 오픈소스 · 도구 · chrislgarry/Apollo-11 · Assembly
Key Point 1960년대 우주 개발의 정점이었던 아폴로 11호의 실제 비행 소프트웨어를 검토할 수 있는 역사적 자료이자, 제약된 하드웨어에서 미션 크리티컬 소프트웨어를 어떻게 작성했는지 배우는 기술 교재로 활용할 수 있다.
핵심 요약
NASA의 아폴로 11호 미션을 위해 개발된 유도컴퓨터(AGC) 원본 소스코드를 GitHub에서 공개하는 저장소다. 명령선(Command Module) AGC인 Comanche055와 달 착륙선(Lunar Module) AGC인 Luminary099 두 버전의 소스코드를 담고 있다. 어셈블리 언어로 작성된 이 코드는 1969년 4월 1일과 7월 14일 각각 NASA에서 어셈블된 프로그램이다. 전체 요약 8문장 읽기 → 053 21:11 ▲ 107 · 댓글 79 AI 에이전트로 게임 역엔지니어링, 600억 토큰 소비한 실험기 저명한 FPS 게임을 정확하게 C++로 역컴파일하는 것을 목표로 Claude와 Codex 모델들을 사용한 3개월간의 프로젝트를 진행했다. AI · 머신러닝 · 500B Tokens Later: Letting AI Agents Decompile a First-Person Shooter
Key Point AI 에이전트를 대규모로 자율 운영할 때 품질 보증 체계를 어떻게 구축할 것인가라는 실무 난제에 대한 구체적인 해답을 제시한다.
핵심 요약
저명한 FPS 게임을 정확하게 C++로 역컴파일하는 것을 목표로 Claude와 Codex 모델들을 사용한 3개월간의 프로젝트를 진행했다. 초기 4주간 4개의 에이전트(3개 워커, 1개 리뷰어)를 운영해 게임의 80%을 디컴파일했고 메인 메뉴 렌더링, 맵 로딩까지 성공했으나 코드는 의미론적으로 오류가 많았다. 문제의 근원은 '정확성'의 정의가 없었으므로 리뷰어가 아키텍처 오류를 판단할 수 없었고, 워커 에이전트의 주석이 리뷰어를 설득해 문제적 결정을 용인하게 했다. 전체 요약 10문장 읽기 → 054 06:11 ▲ 14 · 댓글 2 픽셀 공간 확산 모델, 잠재 공간 모델과 동등한 성능 보여 픽셀 공간 확산 모델은 잠재 공간 모델의 손실 많은 VAE를 피하므로 세밀한 디테일이 중요한 작업에서 유리할 것으로 예상되었다. AI · 머신러닝 · Iris-3B: Going Beyond the Latent with Pixel-Space Diffusion Training, Conversion and Fine-Tuning
Key Point 픽셀 공간 확산 모델이 세밀한 디테일 작업에서 잠재 공간 모델을 이길 것이라는 기대와 달리 실제로는 동등한 성능만 낸 이유를 알 수 있고, 픽셀 공간 사전학습의 한계와 가능성을 실증적으로 보여준다.
핵심 요약
픽셀 공간 확산 모델은 잠재 공간 모델의 손실 많은 VAE를 피하므로 세밀한 디테일이 중요한 작업에서 유리할 것으로 예상되었다. 3B 매개변수 규모의 Iris-3B 픽셀 공간 텍스트-이미지 트랜스포머를 256→512→1024 커리큘럼으로 처음부터 학습했고, 또한 FLUX.2 Klein 4B 잠재 모델을 픽셀 공간으로 변환했다. 두 모델 모두 단안 깊이 추정과 이미지 복원/초해상화 작업에 미세조정했으나, 픽셀 공간 생성 사전에서 의미 있는 성능 향상을 발견하지 못했다. 전체 요약 6문장 읽기 → 055 18:11 ▲ 14 · 댓글 2 LLM이 순차 구조를 진짜 이해할까? 제어 실험으로 검증 LLM이 행동의 표면적 빈도를 넘어 잠재 순차 구조를 복원할 수 있는지 검증하는 연구다. AI · 머신러닝 · Do LLMs Understand Sequential Structure? A Controlled Study of Inference and Generation
Key Point LLM을 시뮬레이터나 에이전트로 쓸 때 정말 규칙을 이해하고 따르는지, 아니면 겉으로만 맞는 행동을 생성하는지 구분하는 것이 중요하기 때문이다.
핵심 요약
LLM이 행동의 표면적 빈도를 넘어 잠재 순차 구조를 복원할 수 있는지 검증하는 연구다. 2인 가위바위보 상호작용과 1인 확률적 n-gram 계속하기 과제로 LLM의 전략 식별, 마코프 규칙 추종, 고차 조건부 의존성 유지 능력을 테스트했다. 결과는 더 긴 문맥도 전략 식별을 개선하지 못하고, 정확한 인식이 충실한 시뮬레이션을 보장하지 않으며, 고차 의존성은 규칙 복원을 크게 악화시킨다는 것을 보였다. 전체 요약 4문장 읽기 → 056 12:11 ▲ 136 · 댓글 28 AI 코딩 에이전트로 역어셈블 자동화하는 REA 공개 REA는 코딩 에이전트가 실행 중인 프로그램을 검사하고 동작을 설명하도록 돕는 역공학 도구다. AI · 머신러닝 · REA Reverse – Engineer Anything
Key Point 역공학의 수동 분석 단계(코드 해석·규칙 추출·재구현)를 AI 에이전트가 자동으로 처리하도록 만들어, 프로그램 분석의 속도와 접근성을 크게 높인다.
핵심 요약
REA는 코딩 에이전트가 실행 중인 프로그램을 검사하고 동작을 설명하도록 돕는 역공학 도구다. 사용자는 자연어로 에이전트에 질문하면, REA가 어셈블리 코드·디컴파일된 코드·함수 호출을 제공하고 에이전트가 그 결과를 해석해 설명한다. Windows Calculator 예시: 200+10%가 220이 되는 이유를 찾기 위해 기존에는 분기 해석·함수 호출 추적·규칙 복원을 수동으로 수행했으나, REA는 한 번의 프롬프트로 '10%는 첫 번째 숫자의 10%를 뜻하며 200+20=220'이라는 답을 제공한다. 전체 요약 8문장 읽기 → 057 03:11 ▲ 120 · 댓글 60 독일, 폐석탄광을 유럽 최대 인공호수군으로 변모 동독 시대 2억 톤 이상의 갈탄을 캐낸 루사티아 지역의 채굴지를 1967년부터 호수로 복원하는 프로젝트가 올 4월 완성을 앞두고 있다. 하드웨어 · 시스템 · Germany transforms former coal mines into Europe's largest lake landscape
Key Point 풍경을 망친 광산 구덩이를 30년 이상 기술과 투자로 유럽 최대 규모의 관광 호수지대로 변모시킨 대규모 토지 재생 사업의 완성 단계가 시작되고 있다.
핵심 요약
동독 시대 2억 톤 이상의 갈탄을 캐낸 루사티아 지역의 채굴지를 1967년부터 호수로 복원하는 프로젝트가 올 4월 완성을 앞두고 있다. 23개의 인공호수로 이루어진 루사티아 호수지대는 총 수면적 14,000헥타르로 이탈리아의 코모호(146㎢)와 거의 같은 규모인 144㎢에 달한다. 이 호수군은 자연적으로 호수가 형성되지 않는 자갈과 모래가 많은 모레인 지형에서 인공 관개를 통해 조성되었으며, 지표수가 없는 경우 지하수와 우수만으로는 80~100년이 소요된다. 전체 요약 13문장 읽기 → 058 18:11 ▲ 18 · 댓글 2 LLM이 3D 로봇 부품 설계 자동화, 불완전한 모델도 복원 시뮬레이션에서 학습한 로봇 조작 정책을 현실 물체에 적용하려면 기하학적으로 정확한 관절형 3D 자산이 필수인데, 기존 메시 기반 방법은 학습 데이터 분포 밖의 물체나 손상된 메시에서 관절 정보 추론에 실패하곤 한다. AI · 머신러닝 · USDCraft: Geometrically Grounded Programmatic Modeling of Articulated 3D Assets for Simulation
Key Point 불완전하거나 손상된 3D 모델에서도 로봇 시뮬레이션용 정확한 관절 정보를 자동으로 복원할 수 있어, 현실의 다양한 물체로 로봇 학습을 확장하는 병목이 해결된다.
핵심 요약
시뮬레이션에서 학습한 로봇 조작 정책을 현실 물체에 적용하려면 기하학적으로 정확한 관절형 3D 자산이 필수인데, 기존 메시 기반 방법은 학습 데이터 분포 밖의 물체나 손상된 메시에서 관절 정보 추론에 실패하곤 한다. USDCraft는 사전학습된 LLM이 부분적 기하 정보를 바탕으로 시뮬레이션 준비가 된 관절형 자산을 위한 프로그램을 작성·수정하도록 하는 프레임워크로, 작업별 파인튜닝이 필요 없다. 기하 소스 분석으로 메시를 관찰된 표면과 미지 공간을 구분하는 텍스트 설명으로 변환하고, 반복적 기하 재검증으로 각 프로그램 후보를 같은 형식으로 재인코딩해 불일치 지점을 찾아낸다. 전체 요약 5문장 읽기 → 059 15:13 ▲ 29 · 댓글 2 텍스트-이미지 모델의 보상 조합 방식으로 생성 품질 향상 기존 텍스트-이미지 생성 모델은 시각 품질이 뛰어나지만, 단일 보상 신호로는 인간의 선호도 전체를 포착할 수 없어 학습 후 개선이 어렵다. AI · 머신러닝 · Post-Training Frontier Text-to-Image Models by Composing Preference and Rubric Rewards
Key Point 선호도와 규칙 기반 보상을 조합하는 방식으로 최신 텍스트-이미지 생성 모델의 사후 학습 효율을 크게 개선하는 실질적 방법론을 제시한다.
핵심 요약
기존 텍스트-이미지 생성 모델은 시각 품질이 뛰어나지만, 단일 보상 신호로는 인간의 선호도 전체를 포착할 수 없어 학습 후 개선이 어렵다. 이 연구는 상호 보완적인 두 가지 보상 신호를 조합하는 사후 학습 방식을 제안했다: Bradley-Terry 목적함수로 인간의 미적·지각적 선호를 학습한 선호도 보상과, 프롬프트 충실도와 다른 바람직한 속성을 명시적으로 평가하는 규칙 기반 보상이다. 단순 가중 평균은 최적 아래의 학습 거동을 초래하므로, 선호도 최적화와 규칙 만족을 더 효과적으로 균형 잡는 새로운 보상 조합 전략을 제시했다. 전체 요약 5문장 읽기 → 060 15:13 ▲ 24 · 댓글 3 깊이 추정 없이 카메라 관점 변환 비디오 생성 외중심 카메라(제3자 관점) 영상 하나로부터 자아중심 카메라(1인칭 관점) 비디오를 생성하는 것은 두 카메라의 겹치는 영역이 거의 없어 어려운 문제다. AI · 머신러닝 · LEGO: A Lifting-Free Approach for Exocentric-to-Egocentric Video Generation
Key Point 깊이 추정 단계를 제거하면서도 비디오 생성 품질을 높이는 새로운 접근법으로, 구조 정렬과 세부 복원의 역할 분담 방식이 확산 모델의 특성과 어떻게 부합하는지 보여준다.
핵심 요약
외중심 카메라(제3자 관점) 영상 하나로부터 자아중심 카메라(1인칭 관점) 비디오를 생성하는 것은 두 카메라의 겹치는 영역이 거의 없어 어려운 문제다. 기존 최첨단 방식은 깊이를 추정해 포인트 클라우드로 변환한 후 자아중심 카메라 관점에서 재렌더링하고, 이를 비디오 확산 모델의 조건으로 사용한다. 그러나 이 결정론적 매핑은 각 픽셀을 한 위치에만 할당하므로 깊이 오류가 콘텐츠 배치 오류로 전파되고, 텍스처는 보존되지만 정확도가 떨어진다. 전체 요약 9문장 읽기 → 061 12:11 ▲ 13 · 댓글 2 3D 메시에서 CAD 모델 자동 복원하는 AI 에이전트 등장 3D 메시로부터 편집 가능한 CAD 모델을 복원하는 것은 기존에 어려운 엔지니어링 과제였으며, 단일 도구로는 다양한 기하학과 복원 단계에서 균등하게 잘 작동하지 않았다. AI · 머신러닝 · CADFather: Autonomous CAD Reconstruction through Coordinated Tool Use
Key Point 3D 메시를 직접 편집 가능한 CAD 파라미터로 변환하는 과정이 자동화되면 역설계와 설계 작업흐름이 크게 단순화될 수 있기 때문이다.
핵심 요약
3D 메시로부터 편집 가능한 CAD 모델을 복원하는 것은 기존에 어려운 엔지니어링 과제였으며, 단일 도구로는 다양한 기하학과 복원 단계에서 균등하게 잘 작동하지 않았다. CADFather는 여러 상호보완적 도구를 조율하는 자율 에이전트 시스템으로, 3D 메시에서 파라메트릭 CAD 프로그램을 복원한다. 비전-언어 어시스턴트가 목표 및 중간 단계 렌더링을 검사하고, 어느 CAD 프로그램을 확장할지, 어떤 도구를 사용할지, 몇 개의 제안을 생성할지, 언제 종료할지를 결정한다. 전체 요약 7문장 읽기 → 062 06:11 ▲ 100 · 댓글 61 영국 낚시터의 물고기가 하루 밤에 모두 죽은 까닭 이스트서섹스의 목가적인 낚시터 퍼니스 브룩에서 2024년 6월 20일 밤 2,000마리 이상의 물고기가 죽었고 15 트럭 분량이 매장되었다. 기타 · 'The eels were climbing out of the water to die'
Key Point 규제 체계의 허점과 인프라 부족이 민간 환경 오염을 어떻게 방치하는지 구체적으로 보여주며, 영국 환경 정책의 근본적 문제를 드러낸다.
핵심 요약
이스트서섹스의 목가적인 낚시터 퍼니스 브룩에서 2024년 6월 20일 밤 2,000마리 이상의 물고기가 죽었고 15 트럭 분량이 매장되었다. 오염원을 조사하면서 상류 트리뷰터리에서 청회색 박테리아 오염물질이 발견됐고, 독극성 물질과 높은 수치의 납·카드뮴·비소·수은 등 중금속이 검출됐다. 이웃한 모건스 팜이 주 오염 의심처로 떠올랐으며, 2024년 3월 환경청(EA)로부터 3년간 5,000톤의 건설 폐기물을 반입할 수 있는 U1 면제 허가를 받았다. 전체 요약 9문장 읽기 → 063 18:30 ▲ 19 · 댓글 2 벡터 DB 저장 문서도 원본 복원 가능…보안 취약점 발견 멀티벡터 기반 문서 검색 시스템은 각 페이지를 약 1000개의 패치 벡터로 변환해 보통 제3자의 벡터 데이터베이스에 저장하는데, 벡터 인덱스 자체는 원본 페이지보다 덜 민감한 것으로 취급되고 있다. AI · 머신러닝 · Inverting Multi-Vector Visual Document Indices
Key Point 벡터 DB는 민감하지 않은 중간 표현으로 취급되지만, 실제로 원본 문서를 효과적으로 복원할 수 있어 기존 보안 가정이 잘못되었음을 보여준다.
핵심 요약
멀티벡터 기반 문서 검색 시스템은 각 페이지를 약 1000개의 패치 벡터로 변환해 보통 제3자의 벡터 데이터베이스에 저장하는데, 벡터 인덱스 자체는 원본 페이지보다 덜 민감한 것으로 취급되고 있다. 연구팀은 패치 벡터가 래스터 순서로 저장되고 비전-언어 모델로 계산되기 때문에, 벡터 DB를 운영하거나 침해한 공격자가 인덱스만으로도 원본 페이지를 복원할 수 있다고 가설을 세웠다. 공격은 조건부 문서 이미지 생성 프레임워크로 구성되며, 공격자는 인코더·페이지 크기·(섞인 경우) 벡터 순서 정보를 필요로 한다. 전체 요약 9문장 읽기 → 064 18:30 ▲ 18 · 댓글 3 강화학습으로 최소 증거 조합 모두 찾기 결과를 만드는 데 꼭 필요한 최소 조건들을 찾는 '최소 증거 식별' 문제를 형식화하고 최소 증거 강화학습(MWRL)을 제시한다. AI · 머신러닝 · Minimal Witness Reinforcement Learning
Key Point 기존 강화학습은 한 가지 답이나 불필요한 조건까지 포함한 답을 주지만, 실제 문제 해결·과학 발견·설명 가능성에선 정말 필요한 최소 조건의 모든 조합을 알아야 한다.
핵심 요약
결과를 만드는 데 꼭 필요한 최소 조건들을 찾는 '최소 증거 식별' 문제를 형식화하고 최소 증거 강화학습(MWRL)을 제시한다. 표준 강화학습은 한 가지 해결책만 찾거나 불필요한 조건이 포함된 중복 해결책을 제시하지만, MWRL은 증거의 가족 전체를 찾아낸다. MWRL은 정책에서 샘플링한 성공한 제안들의 합집합을 이용하고, 각 제안을 그룹 합집합에서 그 제안이 없었을 때 손실되는 커버리지로 평가한다. 전체 요약 8문장 읽기 → 065 18:30 ▲ 44 · 댓글 1 사진 한 장으로 3D 장면 복원, 물리적으로 호환되는 객체들을 함께 생성 단일 사진에서 3D 장면을 복원하는 Tetris3D라는 생성 모델을 제안했다. AI · 머신러닝 · Tetris3D: 3D Scene Generation With Objects That Fit Together
Key Point 3D 장면 이해에서 객체 간 물리적 호환성을 명시적으로 학습하는 방식이 새로운 접근이며, 새로운 대규모 물리 시뮬레이션 데이터셋이 공개되어 후속 연구의 기초자료가 될 수 있기 때문이다.
핵심 요약
단일 사진에서 3D 장면을 복원하는 Tetris3D라는 생성 모델을 제안했다. 기존 방법들과 달리 각 객체의 생성을 주변 객체의 기하학적 형태와 물리적 관계에 조건화해, 객체 간의 공간적 호환성을 보장한다. 연구팀은 ComOb라는 물리 시뮬레이션 기반 데이터셋을 구축했는데, 1.2M개의 장면에 다양한 카테고리의 물리 상호작용과 객체별 메시, 객체 쌍의 물리 관계 정보를 포함했다. 전체 요약 5문장 읽기 → 066 18:30 당일 +103 Unity IL2CPP 바이너리를 원본 C# 코드로 역변환하는 도구 Cpp2IL Unity의 IL2CPP 컴파일 과정을 역으로 분석해 원본 관리 DLL로 복원하는 진행 중인 도구로, LibCpp2IL 라이브러리를 사용해 메타데이터를 파싱합니다. 오픈소스 · 도구 · SamboyCoding/Cpp2IL · C#
Key Point IL2CPP 보호 게임의 소스코드 복원이 필요한 모더·보안 연구자·분석가에게 필수적인 역공학 도구이며, 주요 라이브러리 교체와 플러그인 시스템 도입으로 대폭 개선되고 있습니다.
핵심 요약
Unity의 IL2CPP 컴파일 과정을 역으로 분석해 원본 관리 DLL로 복원하는 진행 중인 도구로, LibCpp2IL 라이브러리를 사용해 메타데이터를 파싱합니다. 디컴파일된 CIL은 현재 상태가 복잡하지만 ILSpy로 열 수 있으며, MethodAnalysisContext를 통해 플랫폼별 어셈블리를 중간 표현(ISIL)으로 변환 후 제어 흐름 그래프를 구축해 분석합니다. 개발 브랜치에서 대규모 리작성 중이며, 기존의 많은 커맨드라인 옵션(--analysis-level, --skip-analysis 등)이 제거되고 출력 포맷과 처리 레이어 개념으로 단순화됐습니다. 전체 요약 12문장 읽기 → 067 18:30 당일 +110 .NET 디컴파일러 ILSpy, 크로스플랫폼 오픈소스로 공개 ILSpy는 .NET 어셈블리를 분석하고 C#으로 디컴파일하는 오픈소스 도구로, Windows·Linux·macOS를 지원하는 Avalonia 기반 데스크톱 UI를 제공한다. 오픈소스 · 도구 · icsharpcode/ILSpy · C#
Key Point Windows나 Linux에서 .NET 애플리케이션의 소스 코드를 원본이 없어도 복원할 수 있는 공식 도구이며, 개발자가 타사 라이브러리 동작을 분석하거나 릴리스된 제품의 구조를 파악해야 할 때 필수적이다.
핵심 요약
ILSpy는 .NET 어셈블리를 분석하고 C#으로 디컴파일하는 오픈소스 도구로, Windows·Linux·macOS를 지원하는 Avalonia 기반 데스크톱 UI를 제공한다. Visual Studio 2022/2026, VS Code, dotnet CLI 도구(ILSpyCmd), PowerShell 확장 등 다양한 프런트엔드로 사용할 수 있으며, NuGet 패키지와 PowerShell cmdlet으로도 제공된다. C# 디컴파일, 프로젝트 전체 분석, NuGet 피드·실행 중인 프로세스·GAC에서 직접 열기, 타입·메서드·속성 검색, ReadyToRun 바이너리 지원 등의 기능을 갖추고 있다. 전체 요약 6문장 읽기 → 068 18:33 ▲ 20 · 댓글 2 흐름과 확산 모델에서 데이터 망각과 경량화를 동시에 Flow 및 Diffusion 모델 같은 다단계 생성 모델은 고품질 출력을 만들지만 추론 비용이 크고 학습 데이터의 원치 않는 부분을 재현할 수 있다. AI · 머신러닝 · Data Unlearning via Inverse Distillation
Key Point 생성 모델에서 특정 학습 데이터를 제거하면서 동시에 모델 크기를 줄이는 기술이 필요한데, 이 논문이 처음으로 두 목표를 함께 달성하는 방법을 제시했기 때문이다.
핵심 요약
Flow 및 Diffusion 모델 같은 다단계 생성 모델은 고품질 출력을 만들지만 추론 비용이 크고 학습 데이터의 원치 않는 부분을 재현할 수 있다. 역방향 증류 망각(IDU) 기법은 교사 모델을 효율적인 원스텝 학생 생성기로 증류하면서 동시에 지정된 학습 부분집합의 출력을 억제하는 통합 프레임워크다. 증류를 데이터 분포에 대한 민-맥스 목적함수로 정식화하고, 이 분포를 망각 집합과 생성 분포의 혼합으로 표현해 교사의 학습 분포와 비교하면 최적점에서 보존 데이터만 복원된다. 전체 요약 6문장 읽기 → 069 18:33 당일 +23,584 AI 에이전트로 앱·바이너리 역공학하는 REA 공개 Reverse Engineer Anything(REA)은 AI 에이전트가 소스 코드 없이 앱의 기능을 분석하고 동작 방식을 파악할 수 있도록 하는 MCP 서버다. AI · 머신러닝 · morluto/rea · TypeScript
Key Point AI 에이전트가 직접 소스 없이 앱의 비즈니스 로직을 분석하고 기능을 재구현할 수 있는 능력이 현실화되고 있으며, 복제와 지적재산권 침해 우려가 커지고 있다.
핵심 요약
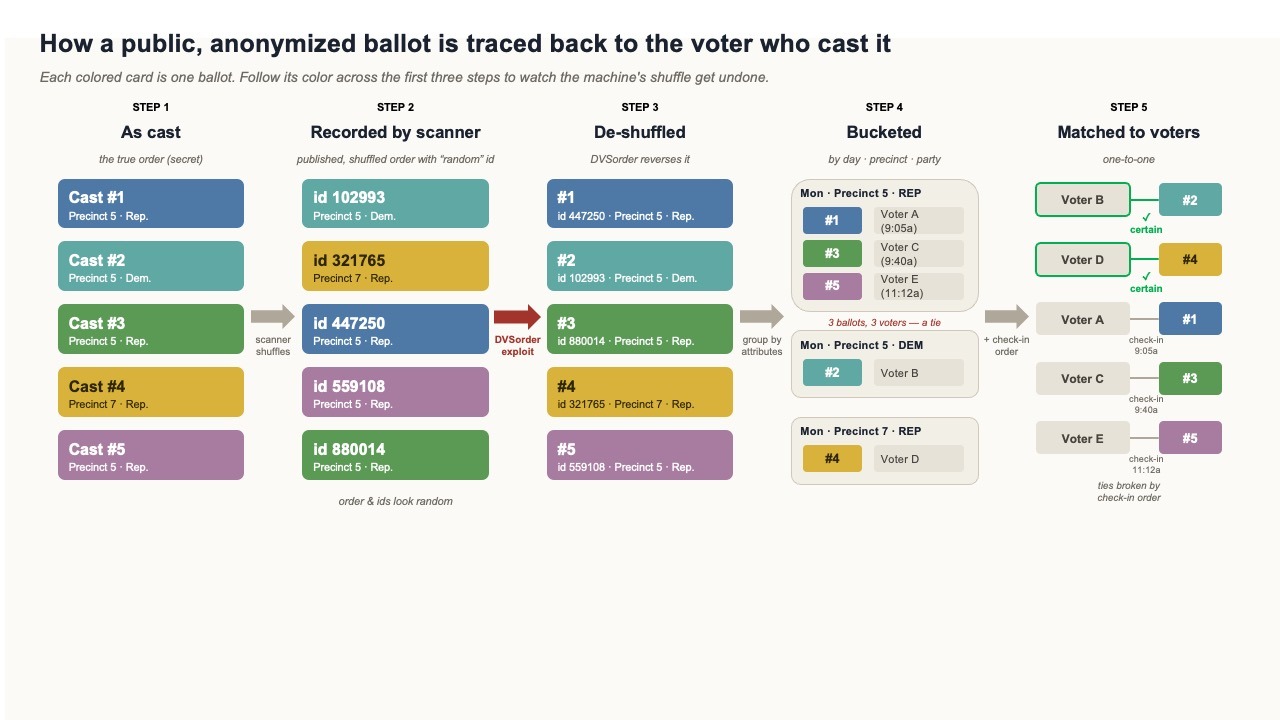
Reverse Engineer Anything(REA)은 AI 에이전트가 소스 코드 없이 앱의 기능을 분석하고 동작 방식을 파악할 수 있도록 하는 MCP 서버다. 네이티브 바이너리, JavaScript·Electron 앱, .NET 어셈블리, 웹사이트, Android APK, 펌웨어, 프로세스 동작 등 다양한 대상을 정적·동적으로 분석할 수 있다. 네이티브 분석은 Hopper, Ghidra, IDA 같은 디어셈블러를 활용하며, JavaScript와 .NET은 엔진 없이 정적 검사만으로도 동작한다. 전체 요약 8문장 읽기 → 070 18:33 ▲ 109 · 댓글 97 AI와 공개 데이터로 조지아주 투표 비밀 침해 가능함을 입증 투표 기계의 알고리즘 설계 결함으로 인해 2022년 공개된 보안 취약점이 4년이 지난 2026년 조지아주 5월 예비선거에서도 여전히 악용 가능한 상태로 남아 있다. 보안 · An algorithmic failure beneath the secret ballot
Key Point AI 도구의 민주화가 투표 비밀 침해라는 심각한 보안 결함을 누구나 악용할 수 있게 만들었으며, 기술적 복잡성이 더 이상 보호막이 아니라는 점을 보여준다.
핵심 요약
투표 기계의 알고리즘 설계 결함으로 인해 2022년 공개된 보안 취약점이 4년이 지난 2026년 조지아주 5월 예비선거에서도 여전히 악용 가능한 상태로 남아 있다. 투표 기계는 익명성을 위해 전자 투표 기록을 무작위로 섞지만, 사용된 난수 생성 알고리즘이 결정론적이고 역으로 추적 가능해 투표 순서를 정확히 복원할 수 있다. 연구자는 ChatGPT 같은 대형 언어 모델 기반의 AI 코딩 에이전트에 취약점 논문을 제시하고 단 20달러를 지불해 몇 시간 안에 조지아주 139개 카운티 중 114개에서 투표 순서 추적 코드를 자동으로 생성했다. 전체 요약 10문장 읽기 → 071 18:33 ▲ 389 · 댓글 64 Commodore 64 키보드 글꼴, 실제 사진으로 복원 Commodore 64 키캡 사진으로부터 복원한 글꼴로, 정리된 도형과 일관된 비율을 갖추고 있다. 오픈소스 · 도구 · A font recreated from photographs of classic Commodore 64 keycaps
Key Point 레트로 컴퓨팅 팬과 타이포그래피 애호가들이 실제 하드웨어에서 정확히 복원한 클래식 글꼴을 직접 사용할 수 있게 되었다.
핵심 요약
Commodore 64 키캡 사진으로부터 복원한 글꼴로, 정리된 도형과 일관된 비율을 갖추고 있다. 대문자, 숫자, 구두점, 화살표, £, π 기호와 헝가리 문자 포함 악센트가 있는 문자들을 포함하고 있다. F1-F12 함수 키 레이블과 63개 PETSCII 그래픽 전설을 모두 담고 있으며, 소문자 입력은 대문자로 표시된다. 전체 요약 10문장 읽기 → 072 09:11 ▲ 13 · 댓글 2 비디오 생성 AI의 메모리 병목 풀다, 시간일관성 있는 2비트 양자화 비디오 월드 모델은 생성 과정에서 KV 캐시를 저장해 장시간 시간적 일관성을 유지하지만, 늘어나는 캐시가 배포의 주요 병목이 되어 저비트 양자화 연구가 필요한 상황이다. AI · 머신러닝 · QuantWM: Temporally Consistent 2-Bit KV Cache Quantization for Video World Models
Key Point 비디오 생성 모델의 메모리 병목을 풀 수 있는 새로운 양자화 방식이 제시됐으며, 기존 방법과 다른 각도로 주의 집중 메커니즘을 보존하는 전략이 핵심이다.
핵심 요약
비디오 월드 모델은 생성 과정에서 KV 캐시를 저장해 장시간 시간적 일관성을 유지하지만, 늘어나는 캐시가 배포의 주요 병목이 되어 저비트 양자화 연구가 필요한 상황이다. 기존 2비트 KV 캐시 양자화 방식들은 VBench에서 거의 무손실 성능을 보이지만, 비디오 월드 모델에 적용하면 시간적 깜빡임과 시각적 품질 저하가 심각하게 발생한다. Key 양자화가 Value보다 재구성 오류는 작지만 예상과 달리 출력 품질 저하를 더 크게 야기한다는 점을 발견했고, 이는 Key 섭동이 주의 집중(attention) 로짓을 변화시켜 쿼리가 선택하는 시간-공간 토큰을 이동시키기 때문이다. 전체 요약 7문장 읽기 → 073 06:11 ▲ 24 · 댓글 2 4D 동적 장면을 코드로 복원하는 벤치마크 공개 4DCodeBench는 동영상에서 동적 장면을 재구성하는 AI 에이전트를 평가하는 벤치마크로, 에이전트가 시각 정보를 실행 가능한 그래픽 프로그램으로 변환해야 한다. AI · 머신러닝 · 4DCodeBench: Benchmarking Agents on Inverse Graphics of Dynamic Scenes
Key Point 동영상으로부터 물리 시뮬레이션을 포함한 동적 장면 복원은 AI의 현재 한계를 드러내는 영역으로, 4D 이해와 코드 생성 능력의 발전을 측정하는 표준화된 벤치마크가 처음 제시되었다.
핵심 요약
4DCodeBench는 동영상에서 동적 장면을 재구성하는 AI 에이전트를 평가하는 벤치마크로, 에이전트가 시각 정보를 실행 가능한 그래픽 프로그램으로 변환해야 한다. 에이전트는 복잡한 행동을 재현하기 위해 물리 시뮬레이션 같은 추상화를 구현해 장면 구조와 동역학의 콤팩트한 표현을 생성해야 한다. 벤치마크는 실제 동영상과 변형, 유체 흐름, 파괴 등 다양한 물리 현상을 포함하는 합성 장면으로 구성된다. 전체 요약 5문장 읽기 → 074 06:11 ▲ 18 · 댓글 3 자동회귀 비디오 생성 오류 누적 문제 해결하는 RMD 기법 제안 자동회귀 비디오 확산 모델은 저지연 스트리밍 생성을 가능하게 하지만, 긴 롤아웃 과정에서 예측 오류가 축적되는 문제가 있다. AI · 머신러닝 · Rollout-Marginal Distillation for Long-Horizon Autoregressive Video Generation
Key Point 자동회귀 비디오 생성에서 오류 축적을 근본적으로 해결하는 새로운 증류 방식이 제시되어, 장시간 고품질 비디오 생성이 필요한 개발자들에게 실질적인 개선 방안을 제공한다.
핵심 요약
자동회귀 비디오 확산 모델은 저지연 스트리밍 생성을 가능하게 하지만, 긴 롤아웃 과정에서 예측 오류가 축적되는 문제가 있다. 기존 기법들은 영상 수준의 분포 매칭 증류(DMD)를 통해 전체 롤아웃을 함께 평가하는데, 이로 인해 각 청크가 주변 맥락의 인공물과 어울리도록 조정되어 시각 품질 신호가 희석된다. 연구진은 롤아웃-마진 증류(RMD)를 제안했으며, 이는 생성된 히스토리는 유지하되 각 청크를 독립적으로 청크 교사에 대해 평가한다. 전체 요약 6문장 읽기 → 076 03:11 ▲ 102 · 댓글 21 foldl과 foldr의 근본적인 차이, 정확히 이해하기 foldl과 foldr은 '왼쪽에서'와 '오른쪽에서' 접는 것이 아니라, 같은 순서로 리스트를 순회하되 연산의 결합 방식만 다르다. 오픈소스 · 도구 · Differences Between `Foldl` and `Foldr`
Key Point 게으른 평가 언어에서 foldl과 foldr의 성능 차이가 직관과 정반대인 이유를 정확히 이해해야 리스트 처리 코드의 메모리 문제를 진단하고 올바른 함수를 선택할 수 있다.
핵심 요약
foldl과 foldr은 '왼쪽에서'와 '오른쪽에서' 접는 것이 아니라, 같은 순서로 리스트를 순회하되 연산의 결합 방식만 다르다. foldl은 왼쪽 결합으로 (((v ⨂ e0) ⨂ e1) ⨂ e2)처럼 동작하고, foldr은 오른쪽 결합으로 e0 ⨂ (e1 ⨂ (e2 ⨂ v))처럼 동작한다. 순수 언어에서 foldl은 첫 원소부터 축적값을 업데이트하며 상수 공간에서 동작하지만, foldr은 마지막 원소까지 도달해야 하므로 리스트 크기에 비례하는 스택 프레임이 필요하다. 전체 요약 8문장 읽기 → 077 06:11 ▲ 121 · 댓글 59 macOS 사진·영상을 AI로 검색하는 로컬 앱 SCM 공개 SCM은 폴더의 모든 사진과 영상 프레임을 로컬 AI로 검색하는 macOS 앱으로, 클라우드 업로드 없이 기기에서만 처리된다. AI · 머신러닝 · Show HN: AI search for every photo and every frame of video on macOS
Key Point AI 검색이 클라우드 없이 로컬에서만 작동하므로 개인 사진·영상의 프라이버시를 완전히 보호하면서도 의미 기반·음성·텍스트 검색을 한 번에 제공하는 방식이 다르다.
핵심 요약
SCM은 폴더의 모든 사진과 영상 프레임을 로컬 AI로 검색하는 macOS 앱으로, 클라우드 업로드 없이 기기에서만 처리된다. 자연언어로 기억을 설명하면 CLIP 등 로컬 비전 모델이 검색하고, 영상은 장면 단위로 분할·임베딩되어 정확한 타임코드로 이동할 수 있다. 5가지 검색 모드를 지원한다: 의미 기반 이미지 검색(Files), 영상의 특정 장면 검색(Scenes), 이미지의 OCR 텍스트 검색(OCR), Whisper를 이용한 영상 음성 검색(Dialogue), 추출된 대사·OCR·파일명을 근거로 답변하는 로컬 LLM 챗(Ask). 전체 요약 13문장 읽기 → 078 21:11 당일 +211 DeepSeek와 GLM을 개인 하드웨어에서 돌리는 경량 추론 엔진 공개 Salvatore Sanfilippo가 만든 DwarfStar는 DeepSeek V4/V4.1 Flash, GLM 5.2/5.3, Qwen3.8 Flash 등 주요 오픈웨이트 모델을 개인 하드웨어에서 실행하는 네이티브 추론 엔진으로, Metal·CUDA·ROCm을 지원한다. AI · 머신러닝 · antirez/ds4 · C
Key Point 개인 맥이나 워크스테이션에서 DeepSeek·GLM 같은 최신 고성능 모델을 실제로 돌릴 수 있는 구체적인 방법과 제약조건(메모리, SSD 스트리밍 필요 여부)이 명확해진다.
핵심 요약
Salvatore Sanfilippo가 만든 DwarfStar는 DeepSeek V4/V4.1 Flash, GLM 5.2/5.3, Qwen3.8 Flash 등 주요 오픈웨이트 모델을 개인 하드웨어에서 실행하는 네이티브 추론 엔진으로, Metal·CUDA·ROCm을 지원한다. 일반적인 GGUF 러너가 아니라 특정 모델 몇 개에 최적화된 자체 포함 C 코드이며, 프로젝트가 생산한 GGUF 파일만 사용한다. Metal은 애플 실리콘 맥(96GB 이상, 또는 SSD 스트리밍으로 더 작은 기계에서도 가능)을 주요 대상으로, CUDA는 DGX Spark와 Ada/L40S 카드를 포함한 다중 GPU 시스템을 지원하며, ROCm은 Strix Halo 같은 시스템을 대상으로 한다. 전체 요약 12문장 읽기 → 079 21:11 ▲ 105 · 댓글 87 전쟁 속 분산형 태양광, 러시아의 미사일 공격을 이기다 러시아의 대규모 공습으로 우크라이나 중앙 전력망이 마비되자, 미콜라이우에서는 오프그리드 태양광 시설이 수돗물을 계속 공급했고, 5개의 태양광 담수화 시스템이 25만 명을 위해 하루 120만 리터의 식수를 생산한다. 인프라 · 데브옵스 · In Ukraine, distributed renewables foil Russia's assaults
Key Point 러시아의 중앙 전력망 폭격 전략이 분산형 재생에너지로 인해 무력화되고 있으며, 우크라이나의 극도로 빠른 재생에너지 전환이 실질적인 생명 구조 수단이 되고 있기 때문이다.
핵심 요약
러시아의 대규모 공습으로 우크라이나 중앙 전력망이 마비되자, 미콜라이우에서는 오프그리드 태양광 시설이 수돗물을 계속 공급했고, 5개의 태양광 담수화 시스템이 25만 명을 위해 하루 120만 리터의 식수를 생산한다. 러시아는 우크라이나의 거대한 중앙집중식 화력발전소와 전국 송전망을 반복해서 공격해 왔으며, 작년 겨울에는 석탄·가스·열병합 발전소와 수송 망을 파괴해 거대 지역의 불규칙한 전기 공급을 초래했고 에너지 부문 피해액은 560억 달러를 넘는다. 미국 환경운동가 빌 맥키벤은 분산형 전원이 드론 공격에 '상대적으로 취약하지 않다'고 주장하는데, 대형 중앙 시설은 단일 미사일로 무력화되지만 풍력단지의 경우 동일한 용량 손상을 위해 약 40발의 미사일이 필요하고 수리도 훨씬 빠르다. 전체 요약 11문장 읽기 → 080 21:11 당일 +140 완전 오프라인 음성 인식, 오픈소스 Handy 공개 OpenAI의 Whisper 모델을 기반으로 완전 로컬에서 동작하는 크로스플랫폼 음성-텍스트 변환 애플리케이션 Handy를 오픈소스로 공개했다. 오픈소스 · 도구 · cjpais/Handy · Rust
Key Point 클라우드 전송 없이 완전히 로컬에서 동작하는 오픈소스 음성 인식 도구로, 개인정보 보호를 중시하거나 오프라인 환경에서 음성 입력이 필요한 개발자와 사용자에게 실질적인 선택지가 된다.
핵심 요약
OpenAI의 Whisper 모델을 기반으로 완전 로컬에서 동작하는 크로스플랫폼 음성-텍스트 변환 애플리케이션 Handy를 오픈소스로 공개했다. 단축키를 누르고 말하면 음성이 텍스트로 변환되어 현재 활성 창의 텍스트 필드에 자동으로 입력되며, 음성 데이터가 외부로 전송되지 않는다. Whisper(Small/Medium/Turbo/Large) 또는 CPU 최적화된 Parakeet V3 모델 중 선택 가능하며, GPU 가속을 지원한다. 전체 요약 12문장 읽기 → 081 12:11 ▲ 16 · 댓글 2 사용자가 마음을 바꾸면? LLM 에이전트의 의도 표류 문제 다중 턴 상호작용에서 사용자 의도가 변할 때 LLM 에이전트가 취소된 요구사항을 계속 따르는 '의도 표류' 현상을 분석했다. AI · 머신러닝 · When Users Change Their Minds: Measuring and Repairing Intent Drift in LLM Agents
Key Point LLM 에이전트가 실제 사용 환경에서 사용자가 요구를 수정할 때 기존 명령을 계속 따르는 실패 패턴을 체계적으로 측정하고 대응 방안을 제시했기 때문이다.
핵심 요약
다중 턴 상호작용에서 사용자 의도가 변할 때 LLM 에이전트가 취소된 요구사항을 계속 따르는 '의도 표류' 현상을 분석했다. 검증 가능한 작업을 의도 변화가 있는 대화로 변환하는 IntentFlux 벤치마크를 소개했고, 627개 사례에서 대화에 취소된 정보가 많을수록 평균 작업 점수가 0.476에서 0.384로 떨어진다. 8개 모델 모두에서 최종 작업을 진화하는 대화에서 복원해야 할 때 단일 턴 입력보다 완전히 올바른 해결책의 비율이 현저히 낮았다. 전체 요약 5문장 읽기 → 082 09:11 ▲ 54 · 댓글 2 에이전트 학습 효율 높이는 'X-Tree' 알고리즘 개발 멀티스텝 에이전트를 학습할 때 기존 방식은 모든 액션 토큰을 동등하게 취급해 반복되는 부분 절차를 놓쳤다. AI · 머신러닝 · X-Tree: Tokenizing Reusable Experience for Efficient Agent Generalization
Key Point 에이전트가 재사용 가능한 스킬을 가중치로 학습하면서 새로운 작업으로의 일반화 성능이 크게 향상되는 방식을 제시해, 멀티스텝 의사결정이 필요한 AI 시스템 개발에 실질적 개선을 가져온다.
핵심 요약
멀티스텝 에이전트를 학습할 때 기존 방식은 모든 액션 토큰을 동등하게 취급해 반복되는 부분 절차를 놓쳤다. 최근 에이전트들은 LLM이 문맥으로 작성한 스킬만 활용해 가중치에 반영되지 않아 새 상황에 일반화하지 못했다. 연구팀은 X-Tree(reusable eXperience tree) 기법으로 학습 데이터에서 계층 구조를 자동으로 복원했다. 전체 요약 9문장 읽기 → 083 15:11 ▲ 74 · 댓글 4 카메라 밖 물체까지 추적하는 세계 모델 개발 기존 비디오 세계 모델은 행위자(에이전트) 중심 시점에만 집중해 화면을 벗어난 물체의 상태 변화를 놓치는 문제가 있다. AI · 머신러닝 · World Observer: Joint Actor-Observer Generation for Persistent World Modeling
Key Point 카메라 시점을 벗어난 물체의 상태를 추적할 수 있게 되면 더 현실적인 세계 모델을 만들 수 있고, 로보틱스나 게임 엔진 등 동적 환경 시뮬레이션이 필요한 분야에 실질적 개선을 가져올 수 있다.
핵심 요약
기존 비디오 세계 모델은 행위자(에이전트) 중심 시점에만 집중해 화면을 벗어난 물체의 상태 변화를 놓치는 문제가 있다. World Observer는 에이전트 시점의 배우 생성기와 함께 선택된 장면 영역을 관찰하는 하나 이상의 파노라마 관찰자를 동시에 생성해 이를 해결한다. 화면을 벗어난 물체도 관찰자 관점에서 계속 시각적으로 진화하도록 유지되어 재진입 시 업데이트된 상태가 반영된다. 전체 요약 7문장 읽기 → 084 00:11 ▲ 32 · 댓글 1 레이더로 동적 주행 장면 재구성, DyRAD 논문 발표 자율주행 시스템 평가를 위해 레이더 센서 데이터에서 동적 주행 장면을 재구성하는 새로운 방법 DyRAD를 제시한다. AI · 머신러닝 · DyRAD: Radar Novel View Synthesis for Dynamic Driving Scenes
Key Point 레이더의 도플러 정보를 완전히 활용한 첫 동적 장면 재구성으로, 자율주행 시뮬레이션 평가와 센서 다중화 문제를 동시에 푼 기술적 진전이다.
핵심 요약
자율주행 시스템 평가를 위해 레이더 센서 데이터에서 동적 주행 장면을 재구성하는 새로운 방법 DyRAD를 제시한다. 기존 레이더 신규 시점 합성 방법은 동적 장면에서는 range-azimuth 텐서만 복원하고, 도플러를 렌더링하는 방법은 정적 장면만 가정해 두 가지 한계가 있었다. DyRAD는 정적 배경 반사체와 움직임 추적 동적 점 반사체를 사용해 range-azimuth-Doppler(RAD) 완전 텐서를 렌더링한다. 전체 요약 8문장 읽기 → 085 15:11 ▲ 35 · 댓글 2 고압축·고속학습 이미지생성 모델, DC-SAE 공개 이미지 생성 모델을 고도로 압축하면 학습 속도가 느려지는 기본적 트레이드오프가 발생한다. AI · 머신러닝 · DC-SAE: Deep Compression Semantic Autoencoder for Faster Diffusion Convergence
Key Point 고압축 토크나이저는 대규모 이미지 생성 모델의 학습 효율을 좌우하는데, DC-SAE가 압축률과 학습 속도 양쪽을 동시에 개선하는 방법을 제시한다.
핵심 요약
이미지 생성 모델을 고도로 압축하면 학습 속도가 느려지는 기본적 트레이드오프가 발생한다. 기존 의미 기반 오토인코더는 중간 수준 압축에만 제한되고 픽셀 수준의 세부정보를 잃어 정확한 복원이 어렵다. DC-SAE는 의미 기반 인코더로 높은 압축을 가능하게 하고, 픽셀 수준 인코더로 저수준 세부정보를 보존한다. 전체 요약 6문장 읽기 → 086 15:11 ▲ 53 · 댓글 1 MLLM도 3D 상상력이 필요하다 - 다중뷰 이해의 새 방법 멀티모달 LLM(MLLM)이 다중 이미지로부터 3D 공간을 이해하는 것이 근본적 과제인 가운데, 기존 방식은 화소 단위 대응이나 3D 기하 모델 통합을 시도했지만 인간의 추론에는 미치지 못했다. AI · 머신러닝 · Imagine3D-LLM: Teaching MLLMs to Imagine 3D Scenes Before Answering
Key Point 다중뷰 3D 이해라는 MLLM의 핵심 약점을 인간의 추론 방식으로 해결하는 새로운 접근으로, 구조화된 3D 표현 학습이 모델 전체의 기하 인식을 높이는 메커니즘을 제시한다.
핵심 요약
멀티모달 LLM(MLLM)이 다중 이미지로부터 3D 공간을 이해하는 것이 근본적 과제인 가운데, 기존 방식은 화소 단위 대응이나 3D 기하 모델 통합을 시도했지만 인간의 추론에는 미치지 못했다. 본 연구는 인간의 공간 추론 방식에 영감을 받아, 세밀한 기하 단서보다는 뷰 간 공통 객체 인식 → 상대 기하 추론 → 장면의 대략적 3D 배치 조립 과정을 모방한다. Imagine3D-LLM은 이미지 토큰 뒤에 학습 가능한 요약 토큰 집합을 추가하고, 이를 3D 가우시안 스플래팅 표현으로 복원한다. 전체 요약 6문장 읽기 → 087 09:11 ▲ 12 · 댓글 2 픽셀 디퓨전 모델에 적대적 학습 추가로 고주파 품질 개선 픽셀 디퓨전 모델은 오토인코더 병목을 피해 RGB 이미지를 직접 생성하지만, 미세한 자연 이미지 통계를 체계적으로 과소 표현하는 문제가 있다. AI · 머신러닝 · Adversarial Training for Pixel Diffusion
Key Point 픽셀 디퓨전이 기존 오토인코더 기반 모델의 문제를 우회한다는 점에서 더 직접적인 방식이었으나, 미세한 디테일 손실 문제를 적대적 학습으로 해결할 수 있음을 보여주는 실질적 개선 방법이기 때문입니다.
핵심 요약
픽셀 디퓨전 모델은 오토인코더 병목을 피해 RGB 이미지를 직접 생성하지만, 미세한 자연 이미지 통계를 체계적으로 과소 표현하는 문제가 있다. 연구팀은 사전학습된 모델에 적대적 손실을 더해 이 결함을 보정하는 방법을 제시했다. 원래 확산 또는 플로우 매칭 목표를 유지하면서 비고노이즈 타임스텝에서만 적대적 손실을 예측 출력에 추가한다. 모델 아키텍처와 샘플링 절차는 변경하지 않으며, 픽셀 디퓨전의 적대적 사후학습에 대한 첫 체계적 연구다. 전체 요약 9문장 읽기 → 088 21:11 ▲ 505 · 댓글 290 NewPipe 하드포크 PipePipe, 광고 스킵·자막 기능 추가 PipePipe는 NewPipe를 기반으로 2022년 초 개발된 하드포크로, 더 빠르고 안정적이며 더 많은 기능을 제공한다. 오픈소스 · 도구 · PipePipe: NewPipe hard fork implementing SponsorBlock
Key Point YouTube 광고 스킵과 복원 기능을 지원하는 NewPipe 포크가 공개되었으며, 독립적인 개발로 빠른 업데이트와 버그 수정을 제공한다는 점이 기존 NewPipe 사용자들에게 실질적 선택지가 된다.
핵심 요약
PipePipe는 NewPipe를 기반으로 2022년 초 개발된 하드포크로, 더 빠르고 안정적이며 더 많은 기능을 제공한다. SponsorBlock 통합으로 YouTube와 BiliBili의 스폰서 구간을 자동 스킵하고, ReturnYouTubeDislike로 좋아요·싫어요 표시를 복구할 수 있다. 원본 제목 표시(지역화 전 버전), 로그인으로 제한·프리미엄 콘텐츠 접근 등을 지원한다. 전체 요약 11문장 읽기 → 089 18:11 ▲ 17 · 댓글 1 계층적 표현 학습으로 이미지 재구성 품질 향상 사전학습된 시각 표현은 이미지 생성에는 유용하지만 충실한 복원에 필요한 세부 사항을 완전히 보존하지 못한다. AI · 머신러닝 · HiRAE: Hierarchical Representation Autoencoding with Residual Budgets
Key Point 인코더 계층의 다중 정보를 효율적으로 활용해 이미지 복원 품질을 크게 높인 방법론으로, 복잡한 튜닝 없이 생성 모델과의 호환성을 유지하는 점이 실무적 가치가 있다.
핵심 요약
사전학습된 시각 표현은 이미지 생성에는 유용하지만 충실한 복원에 필요한 세부 사항을 완전히 보존하지 못한다. 인코더의 중간 계층들은 보완적인 시각 정보를 가지고 있으나 이들을 효과적으로 융합하면 모델링이 어려운 잠재 분포가 생성된다. 기존 융합 방식은 계층 선택의 경험적 튜닝이나 단계별 최적화가 필요해 설정 비용과 학습 복잡도가 높다. 전체 요약 8문장 읽기 → 090 15:11 ▲ 105 · 댓글 1 이미지 한 장에서 3D 장면을 프로그래밍 코드로 복원 단일 이미지로부터 3D 장면을 고정된 렌더링이 아닌 실행 가능한 Blender 코드 형태로 복원하는 LEGO-Anything 프레임워크를 제시했다. AI · 머신러닝 · LEGO-Anything: Coding Agents for 3D Scene Reconstruction
Key Point 단일 이미지에서 편집·조회 가능한 3D 장면 코드 재구성이라는 새로운 접근법과 그 한계를 명확히 보여주며, 코딩 에이전트의 구체적 실패 원인과 개선 방법을 제시한다.
핵심 요약
단일 이미지로부터 3D 장면을 고정된 렌더링이 아닌 실행 가능한 Blender 코드 형태로 복원하는 LEGO-Anything 프레임워크를 제시했다. 코딩 에이전트가 반복적으로 Blender 코드를 작성·실행하면서 장면을 검사하고 프로그램을 수정하는 방식으로 동작한다. 평가를 위해 104개 실내외 장면의 208개 이미지를 포함한 LEGO-Bench 벤치마크를 구축했으며, 산출물 유효성·표면 기하학·렌더링 외형을 별도로 채점한다. 전체 요약 8문장 읽기 → 091 12:11 ▲ 244 · 댓글 1 코드로 그리는 이미지·영상, 생성 과정 검증하는 프레임워크 생성 AI가 만든 프로그램이 정상 실행되더라도 요청한 이미지나 영상의 구성·외형·동작이 맞지 않는 문제(Program-to-Visual 갭)를 다룬다. AI · 머신러닝 · MaLiang-Harness: A Programmable Path to Image and Video Generation
Key Point MLLM의 프로그래밍 기반 이미지·영상 생성 능력을 체계적으로 평가하는 첫 벤치마크를 제시하며, 일반 벤치마크로는 예측할 수 없는 시각 생성 성능의 차이를 노출시킨다.
핵심 요약
생성 AI가 만든 프로그램이 정상 실행되더라도 요청한 이미지나 영상의 구성·외형·동작이 맞지 않는 문제(Program-to-Visual 갭)를 다룬다. MaLiang-Harness는 MLLM이 시각 생성 작업을 구성→검증→수정하는 지속적 과정으로 조직하는 통합 프레임워크다. Persistent Executable Generation(PEG)으로 프로그램과 작업 맥락을 유지하고, Traceable Generation Process(TGP)로 편집을 렌더링 결과에 연결하며, Revision-aware Editing and Verification(REV)으로 복원과 검증을 지원한다. 전체 요약 7문장 읽기 → 092 09:11 새 버전 uv 0.12.20 릴리스, 락파일 재사용·메타데이터 빌드 개선 Python 패키지 관리 도구 uv 0.12.20이 2026년 9월 28일 공개되었다. 오픈소스 · 도구 · astral-sh/uv@0.12.20
Key Point Python 의존성 해석과 설치를 담당하는 핵심 도구의 안정성 개선으로, 특히 복잡한 워크스페이스·반복 의존성·크로스 플랫폼 환경에서 버그가 수정되었다.
핵심 요약
Python 패키지 관리 도구 uv 0.12.20이 2026년 9월 28일 공개되었다. 의존성 선언이 의미상 동일하면 락파일을 재사용하고, CRLF 셔뱅을 가진 wheel 스크립트 설치 시 두 번째 줄 인코딩 선언을 보존한다. preview 기능으로 정규화된 요구사항 선언을 락파일에 작성하며, 첫 번째 파티 워크스페이스 프로젝트의 메타데이터 빌드를 --no-build 플래그 아래서도 허용한다. 전체 요약 9문장 읽기 → 093 03:11 ▲ 135 · 댓글 30 영화 복원을 둘러싼 팬 해킹과 공식 제작사의 경합 스튜디오의 개작된 영화 버전만 정식 출시되는 현실 속에서, 팬 커뮤니티가 불법 리핑과 음원 결합으로 영화의 원본에 가까운 복원을 추진하고 있다. 오픈소스 · 도구 · Pirating the Pirates
Key Point 영화 저작권 보호와 역사 보존이 충돌할 때, 팬 커뮤니티의 불법 활동이 공식 복원 기관의 한계를 메우고 있는 현실을 보여준다.
핵심 요약
스튜디오의 개작된 영화 버전만 정식 출시되는 현실 속에서, 팬 커뮤니티가 불법 리핑과 음원 결합으로 영화의 원본에 가까운 복원을 추진하고 있다. 1960년대 영화 《황금의 삼각지대》의 경우 MGM 복원본이 원본 161분에서 179분으로 늘어나고 음향이 현대식으로 리믹스되자, 팬들이 1998년 DVD와 이탈리아판 블루레이를 결합해 더 정확한 버전을 만들었다. 대형 스튜디오는 예산·일정 제약, 감독의 수정 요구, 마케팅 필요성 때문에 원본 버전 공개를 거부하거나 불가능하게 한다. 전체 요약 8문장 읽기 → 094 00:11 당일 +110 Windows 바탕화면을 정리하는 오픈소스 위젯 앱 DeskBox 무료 오픈소스인 DeskBox는 WinUI 3로 만든 Windows 바탕화면 정리 앱으로, Explorer를 대체하지 않으면서 실제 폴더를 백업하는 위젯들로 데스크톱 파일을 체계적으로 관리한다. 오픈소스 · 도구 · Tianyu199509/DeskBox · C#
Key Point 데스크톱 파일 정리를 자동화하면서도 기존 Windows 탐색기를 바꾸지 않는 경량 방식으로, 로컬 저장소 기반 개인정보 보호와 다양한 위젯 기능을 제공한다.
핵심 요약
무료 오픈소스인 DeskBox는 WinUI 3로 만든 Windows 바탕화면 정리 앱으로, Explorer를 대체하지 않으면서 실제 폴더를 백업하는 위젯들로 데스크톱 파일을 체계적으로 관리한다. 파일 위젯은 아이콘·리스트 레이아웃, 수동·규칙 기반 정렬, 스택 기능을 지원하며 최소 50×50 크기까지 축소 가능하고, 폴더 그룹화, 드래그 앤 드롭, QuickLook 미리보기 등을 제공한다. 투두, 빠른 메모, 데스크톱 검색, 글래이스(날씨·시간), 음악 컨트롤 등의 위젯이 있으며, 캡슐 모드로 위젯을 축소할 수 있고 마크다운 편집, 첨부파일 관리를 지원한다. 전체 요약 10문장 읽기 → 095 09:11 당일 +238 YouTube 광고 건너뛰기·좋아요 복원 기능 추가한 NewPipe 포크 NewPipe를 기반으로 2022년 초 독립 포크된 오픈소스 안드로이드 앱으로, NewPipe와는 별개의 프로젝트로 운영되고 있다. 오픈소스 · 도구 · InfinityLoop1308/PipePipe · Shell
Key Point NewPipe 계열 앱의 광고 건너뛰기·좋아요 복원 등 차단 기능이 필요한 사용자에게, 원래 앱의 제약을 넘어선 대안이 어떤 기능들을 제공하는지 알려준다.
핵심 요약
NewPipe를 기반으로 2022년 초 독립 포크된 오픈소스 안드로이드 앱으로, NewPipe와는 별개의 프로젝트로 운영되고 있다. SponsorBlock을 통해 유튜브와 빌리빌리의 스폰서 구간을 자동 건너뛸 수 있고, ReturnYouTubeDislike로 삭제된 유튜브 좋아요를 복원할 수 있다. 원본 제목 표시, 제한·프리미엄 콘텐츠 접근을 위한 로그인 기능, AV1·VP9 코덱 지원, 댄마쿠 스타일의 라이브 채팅 표시를 제공한다. 전체 요약 7문장 읽기 → 096 03:11 ▲ 120 · 댓글 152 유럽에 칩 제조 장비 전혀 안 팔린다, ASML 임원 경고 ASML의 글로벌 공공담당 임원 프랑크 하임스커크는 유럽에서 칩 제조 기계를 전혀 판매하지 않고 있다고 발표했다. 하드웨어 · 시스템 · ASML currently sells no chipmaking machines in Europe, executive says
Key Point ASML은 세계 유일의 고급 반도체 제조 장비 공급사인데 유럽에서 아무것도 팔지 않는다는 것은 유럽 반도체 산업의 심각한 투자 부진을 보여주는 신호다.
핵심 요약
ASML의 글로벌 공공담당 임원 프랑크 하임스커크는 유럽에서 칩 제조 기계를 전혀 판매하지 않고 있다고 발표했다. 하임스커크는 유럽이 투자하지 않고 칩 팩토리를 짓지 않기 때문에 ASML 제품이 팔리지 않는다고 설명했다. 미국, 중국, 인도는 각각 자국의 반도체 산업 발전을 위해 ASML의 사업 확장을 독려하고 있다. 전체 요약 7문장 읽기 → 097 03:11 ▲ 10 · 댓글 2 SAE가 품사 정보를 분산된 특성 그룹으로 인코딩한다 Sparse AutoEncoder(SAE)는 언어모델의 내부 표현을 분석하는 도구인데, 어떤 언어 구조를 노출하는지는 아직 불명확하다. AI · 머신러닝 · Parts-of-Speech as Emergent Categories in SAE Latent Space
Key Point 언어모델의 '검은 상자'를 열기 위한 SAE 분석 방법이 실제로 문법 구조를 얼마나 잘 포착하는지 실증적으로 보여주는 연구로, 향후 모델 해석 연구의 방향을 제시한다.
핵심 요약
Sparse AutoEncoder(SAE)는 언어모델의 내부 표현을 분석하는 도구인데, 어떤 언어 구조를 노출하는지는 아직 불명확하다. 연구팀은 품사(PoS) 범주를 통제된 테스트 케이스로 삼아, 형태통사 정보가 개별 잠재 변수로 인코딩되는지 아니면 특성의 구조화된 그룹으로 인코딩되는지 조사했다. SAE 활성화로부터 품사 구분을 높은 정확도로 복원할 수 있지만, 개별 잠재 변수와 범주 간에 일대일 대응이 없다는 것을 발견했다. 전체 요약 7문장 읽기 → 098 00:11 ▲ 75 · 댓글 2 트랜스포머의 선형 중첩: 서로 다른 텍스트를 동시에 처리한다 LLM이 비선형 구성요소에 의존하지만, 서로 다른 텍스트 스트림의 입력을 선형 결합하면 모델이 개별 다음 토큰 분포의 중첩을 출력하는 '중첩 선형성 가설'을 발견했다. AI · 머신러닝 · Your Transformer Can Hold Two Thoughts at Once: Evidence of Linear Superposition in LLMs
Key Point LLM이 내부적으로 여러 의미를 동시에 처리하는 선형적 구조를 가진다는 발견은 모델의 동작 방식에 대한 근본적인 이해를 바꾸며, 하나의 추론으로 여러 결과를 생성하는 효율성 개선까지 가능하게 한다.
핵심 요약
LLM이 비선형 구성요소에 의존하지만, 서로 다른 텍스트 스트림의 입력을 선형 결합하면 모델이 개별 다음 토큰 분포의 중첩을 출력하는 '중첩 선형성 가설'을 발견했다. 이 중첩 현상은 트랜스포머 아키텍처의 고유한 특성이며, 학습 과정 중에 오히려 감소하는 경향을 보였다. 경량 파인튜닝을 통해 선형성을 상당히 복원할 수 있으며, 예측된 다음 토큰 분포와 개별 분포의 평균 간 차이를 크게 줄일 수 있다. 전체 요약 4문장 읽기 → 099 00:11 ▲ 111 · 댓글 17 Ink and Switch, 10년 이룬 결과물 한자리에 모으다 Ink and Switch는 10주년을 기념해 Tenfold라는 인터랙티브 아트 피스를 발표했다. 웹 · 프론트엔드 · Ink and Switch Interactive Homepage
Key Point 사용자 중심의 협업 도구를 만드는 Ink and Switch의 10년 연구 성과와 현재 진행 중인 프로젝트들이 무엇인지 한눈에 파악할 수 있다.
핵심 요약
Ink and Switch는 10주년을 기념해 Tenfold라는 인터랙티브 아트 피스를 발표했다. 인간의 지능을 증폭하는 컴퓨터를 만드는 것을 비전으로 삼고 있으며, 사용자가 명확하게 생각하고 효과적으로 협업할 수 있는 도구를 지향한다. 사용자에게 데이터 주권을 돌려주고 협업이 가능한 소프트웨어 아키텍처, 커스터마이징 가능한 환경, 손으로 그린 스케치처럼 자연스럽게 상호작용을 추가할 수 있는 동적 매체 등 네 가지 주요 테마로 연구를 진행한다. 전체 요약 6문장 읽기 → 100 22:26 ▲ 13 · 댓글 2 저정밀 연산으로 LLM 강화학습 안정화, FP8 파이프라인 전체 최적화 LLM의 추론·에이전트 능력 향상을 위해 강화학습이 중요 기법으로 자리잡았으며, FP8 양자화는 학습 속도를 높일 수 있으나 전체 파이프라인에서 안정성 유지가 과제였다. AI · 머신러닝 · Towards Full Pipeline FP8 Reinforcement Learning for LLMs
Key Point 저정밀 연산(FP8)으로 LLM 강화학습 속도를 높이면서도 BF16 수준의 안정성을 유지할 수 있게 되어, 대규모 모델의 효율적인 학습이 실무에서 더 현실적으로 가능해진다.
핵심 요약
LLM의 추론·에이전트 능력 향상을 위해 강화학습이 중요 기법으로 자리잡았으며, FP8 양자화는 학습 속도를 높일 수 있으나 전체 파이프라인에서 안정성 유지가 과제였다. 기존 연구는 TIS 같은 보정 기법으로 훈련-추론 불일치를 해결했지만, 전체 FP8 강화학습 파이프라인에서는 여전히 심각한 불안정성이 발생한다. 문제는 훈련 중 갑작스런 엔트로피 급상승과 출력 왜곡으로 나타나는데, 근본 원인은 누적된 FP8 양자화 잡음이 중요도 비율을 왜곡해 음수 이득 토큰을 신뢰 영역 밖으로 밀어내고 그래디언트를 잘못 영점화한다는 점이다. 전체 요약 6문장 읽기 →