쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
25건 · "병렬 처리"조건 지우기 ×
001 12:11 ▲ 103 · 댓글 114 커서, 팀 워크플로우에 맞춘 에이전트 SDK 공개 커서가 자사 매니지드 에이전트(버그봇, 보안 검토자, 롤아웃)를 만드는 데 사용하는 에이전트 SDK를 공개했다. AI · 머신러닝 · The Agent SDK
Key Point 개발팀의 반복적인 작업을 자동화하는 에이전트를 코드로 정의하고 쉽게 배포할 수 있는 표준 도구가 제공되므로, 팀의 워크플로우에 맞춘 맞춤형 자동화가 가능해진다.
핵심 요약
커서가 자사 매니지드 에이전트(버그봇, 보안 검토자, 롤아웃)를 만드는 데 사용하는 에이전트 SDK를 공개했다. SDK를 통해 팀은 코드로 에이전트를 정의하고 자신의 워크플로우에 맞춰 빌드·배포할 수 있으며, agent-sdk deploy 명령어로 커서 인프라에 한 번에 배포할 수 있다. GitHub·GitLab·Bitbucket의 풀 요청 이벤트에 응답하고, 변경 위험도를 평가하고 정책에 맞춰 승인하는 코드 리뷰 에이전트 등을 구축할 수 있다. 전체 요약 13문장 읽기 → 002 06:11 새 버전 Hugging Face Transformers v5.21 릴리스, 5개 신규 모델 추가 Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. AI · 머신러닝 · huggingface/transformers@v5.21
Key Point 문서 이해, 음성 합성 등 신규 모델 5개가 추가되고 병렬 처리·양자화·캐시 처리가 크게 개선되어 LLM과 멀티모달 모델 개발자들에게 직접적인 영향이 있다.
핵심 요약
Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. MiniCPM-OCR은 OpenBMB의 모델로 SigLIP 비전 인코더와 Qwen3.5 언어 모델을 결합해 스캔 페이지, 스크린샷, 영수증 등 텍스트 밀집 이미지를 읽는다. Flint는 Recursive의 혼합 전문가 모델로 슬라이딩 윈도우 주의(512개 토큰 범위)와 완전 주의를 결합하며, 각 희소 계층이 256개 전문가 중 6개를 라우팅한다. 전체 요약 12문장 읽기 → 003 21:11 당일 +716 PHP 공식 저장소, 웹 개발 언어의 최신 코드 공개 PHP는 웹 개발에 특화된 범용 스크립트 언어로, 개인 블로그부터 세계 유명 웹사이트까지 구동한다. 웹 · 프론트엔드 · php/php-src · C
Key Point 웹 개발의 가장 광범위하게 사용되는 서버 언어 PHP의 공식 소스코드 저장소이며, 빌드·테스트·기여 방법을 명확히 제시하고 있다.
핵심 요약
PHP는 웹 개발에 특화된 범용 스크립트 언어로, 개인 블로그부터 세계 유명 웹사이트까지 구동한다. PHP 소스코드는 GitHub의 php/php-src 저장소에서 관리되며 Modified BSD License 하에 배포된다. Windows용 PHP 바이너리는 windows.php.net에서, 다른 시스템의 설치 방법은 php.net/install에서 확인할 수 있다. 전체 요약 10문장 읽기 → 004 18:11 ▲ 169 · 댓글 53 360M 모델로 터미널 에뮬레이터 만들기 360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. AI · 머신러닝 · WorldTUI: I trained a 360M model to pretend to be a terminal
Key Point 시뮬레이션·에뮬레이션 구현 없이 자가 수정 학습과 병렬 디코딩으로 소형 모델을 브라우저에서 구동 가능한 터미널 에뮬레이터로 만든 기술 구현 사례로, 제약된 환경에서 큰 모델의 능력을 소형화하는 방법을 보여준다.
핵심 요약
360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. 파일 생성, vim과 tmux 실행, 스네이크 게임 등이 가능하고, 자신의 실수를 수정하는 능력과 행(row)을 병렬로 디코딩하는 기술로 성능을 크게 개선했다. 터미널을 문자 그리드로 모델링했으며, Qwen2.5-Coder-0.5B를 기반으로 Docker에서 실제 프로그램 실행 기록으로 파인튜닝했다. 전체 요약 14문장 읽기 → 005 03:11 ▲ 21 · 댓글 2 AI 에이전트의 추론 속도 2배 단축 기법 제안 대규모언어모델 에이전트는 도구 호출의 긴 연쇄로 작업을 수행하는데, 기존엔 강력한 하나의 모델이 모든 단계를 생성한다. AI · 머신러닝 · Trajectory-Level Speculation with Semantic Verification for Tool-Using Agents
Key Point 도구를 사용하는 AI 에이전트의 추론 속도를 2배 단축하면서도 품질을 유지하는 새로운 방식으로, 개발비 많이 드는 강력한 모델의 추론 비용을 절감할 수 있는 실무 기법이 제시되었다.
핵심 요약
대규모언어모델 에이전트는 도구 호출의 긴 연쇄로 작업을 수행하는데, 기존엔 강력한 하나의 모델이 모든 단계를 생성한다. 기존 추측 기법은 약한 모델의 결과를 한 단계씩 검증하거나, 라우팅으로 어느 모델이 각 단계를 처리할지 결정한다. 논문에서 제안한 SpecAgent는 역할을 바꿔 약한 모델이 단계를 초안으로 작성하고 강력한 모델이 검증자로 변경한다. 전체 요약 11문장 읽기 → 006 12:11 ▲ 43 · 댓글 2 멀티코드북 디퓨전으로 텍스트·이미지 통합 생성 가능 기존 이미지 생성 모델은 단일 코드북 기반으로 표현력이 제한되거나, 텍스트와 이미지를 서로 다른 최적화 목표로 학습해 모달리티 간 충돌이 발생했다. AI · 머신러닝 · Intern Lumina U2: A Multi-Codebook Diffusion Large Language Model for Omni-Visual Understanding and Image Generation
Key Point 이산 공간에서 고해상도 이미지 생성과 텍스트 모델링을 진정으로 통합한 첫 디퓨전 언어모델로, 단일 모델로 텍스트·이미지·비디오·3D를 모두 다룰 수 있다는 점에서 멀티모달 생성의 새로운 패러다임을 제시한다.
핵심 요약
기존 이미지 생성 모델은 단일 코드북 기반으로 표현력이 제한되거나, 텍스트와 이미지를 서로 다른 최적화 목표로 학습해 모달리티 간 충돌이 발생했다. Intern Lumina U2는 각 시각적 위치를 여러 상호보완적 코드북의 코드 그룹으로 표현하는 멀티코드북 디퓨전 언어모델로, 이산 공간에서 고용량 시각 표현과 텍스트를 통합한다. 입력 시 각 위치의 임베딩을 연결하고, 출력 시 경량의 멀티코드북 자동회귀 헤드가 각 위치 내 코드를 순차적으로 예측하면서 디퓨전 백본은 모든 위치를 병렬 처리한다. 전체 요약 6문장 읽기 → 007 18:12 ▲ 27 · 댓글 2 병렬 초안 생성의 문제를 고치는 DCOCO 기법 추측 디코딩은 경량의 드래프터가 여러 토큰을 먼저 제안하고 타겟 모델이 병렬로 검증해 LLM 추론을 가속화한다. AI · 머신러닝 · Contextual Correction of Parallel Drafts for Speculative Decoding
Key Point 현재 프로덕션 LLM 추론에서 가장 효과적인 가속 기법인 추측 디코딩의 근본적 병목을 해결했으며, 모든 서빙 조건에서 지속적인 성능 향상을 제시한다.
핵심 요약
추측 디코딩은 경량의 드래프터가 여러 토큰을 먼저 제안하고 타겟 모델이 병렬로 검증해 LLM 추론을 가속화한다. 최근 확산 기반 드래프터들은 병렬로 여러 위치를 동시에 예측하지만, 각 토큰이 앞선 토큰들의 정체를 모른 채 예측되어 자동회귀 생성의 문맥 의존성이 손실된다. DCOCO(DFlash Contextual Corrector)는 병렬 드래프팅을 유지하면서 이 의존성을 복원하는 경량 메커니즘이다. 전체 요약 6문장 읽기 → 008 18:11 ▲ 101 · 댓글 100 코딩 에이전트는 왜 여전히 형편한가 저자는 초기에 코딩 에이전트의 자동화 능력에 매료되었으나, 며칠 후 빈번한 버그, 응답 중단, 작업 미완료 문제를 겪으면서 실망했다. AI · 머신러닝 · Why are coding agents so dumb?
Key Point LLM 성능이 비약적으로 향상되는 와중에도 코딩 에이전트는 설계 결함으로 인해 진전이 없다는 비판으로, 개발자들이 도구 선택과 투자 방향을 판단할 때 실질적 기준을 제시한다.
핵심 요약
저자는 초기에 코딩 에이전트의 자동화 능력에 매료되었으나, 며칠 후 빈번한 버그, 응답 중단, 작업 미완료 문제를 겪으면서 실망했다. 코딩 에이전트는 모델(GPT Astra, Claude Sonnet 등 LLM)과 다르다. 모델이 '뇌' 역할을 한다면, 에이전트는 모델을 시스템에 연결하는 '몸' 역할이다. 주요 문제점: 에이전트는 병렬 처리 가능한 작업을 순차적으로 처리한다. 예를 들어 10개의 독립적인 소작업을 하나씩 완료한 후 다음으로 넘어간다. 전체 요약 12문장 읽기 → 009 12:11 ▲ 12 · 댓글 2 비전 토큰 50% 줄이고 성능 99.5% 유지하는 압축 기법 Vision-language 모델은 강력하지만 비전 토큰이 입력 시퀀스의 대부분을 차지해 계산 비용이 크다는 문제가 있다. AI · 머신러닝 · V-CoLA: Vision Token Compression with Linear Attention
Key Point 선형 어텐션 기반 비전-언어 모델에서 기존 압축 방법이 작동하지 않는 문제를 해결하는 새로운 접근법으로, 실무 배포 시 추론 속도와 메모리 효율을 크게 개선할 수 있다.
핵심 요약
Vision-language 모델은 강력하지만 비전 토큰이 입력 시퀀스의 대부분을 차지해 계산 비용이 크다는 문제가 있다. 선형 어텐션을 활용한 하이브리드 아키텍처(예: Qwen3.5)가 등장하면서 기존 소프트맥스 기반 압축 방법들이 성능 저하를 보인다. 연구팀은 선형 어텐션에 특화된 훈련 불필요 토큰 압축 프레임워크 V-CoLA를 제안했다. 전체 요약 7문장 읽기 → 010 12:11 ▲ 12 · 댓글 2 로봇 학습을 위한 GPU 병렬 멀티태스크 강화학습 프레임워크 GPU 병렬 시뮬레이션 환경에서 다양한 로봇 조작 작업을 효율적으로 학습·평가할 수 있도록 설계된 Hebero 벤치마크가 공개되었다. AI · 머신러닝 · A GPU-Parallel Framework for Heterogeneous Multi-Task Reinforcement Learning
Key Point 멀티태스크 강화학습에서 GPU 병렬 처리와 데모 기반 학습을 결합한 새로운 방법론이 실제 로봇까지 일반화되는 모습을 보여준다.
핵심 요약
GPU 병렬 시뮬레이션 환경에서 다양한 로봇 조작 작업을 효율적으로 학습·평가할 수 있도록 설계된 Hebero 벤치마크가 공개되었다. Hebero는 Isaac Lab 기반의 GPU 병렬 벤치마크로, 40개의 이질적인 작업 전체에 걸쳐 하나의 정책을 공동으로 학습하고 평가할 수 있다. 병렬 레플리카 수를 증가시키면 고정된 벽시계 시간 내에서 성공률이 향상되는 스케일링 효과가 확인되었다. 전체 요약 9문장 읽기 → 011 18:33 ▲ 14 · 댓글 3 작은 모델도 빠른 추론 가능, 선택 기반 구조화 추론 등장 멀티모달 에이전트는 각 행동 전에 자유형식 추론을 생성하는데, 작은 모델은 제한된 용량으로 인해 실질적 도움이 적으면서도 추론 비용이 높다. AI · 머신러닝 · Selection-Based Structured Reasoning: Toward Efficient Multimodal Search Agents
Key Point 2B~4B 같은 경량 모델에서 추론 속도를 90% 단축하면서도 성능을 유지하는 방식이 나왔으므로, 리소스 제약이 있는 환경에서 멀티모달 에이전트를 활용할 수 있게 된다.
핵심 요약
멀티모달 에이전트는 각 행동 전에 자유형식 추론을 생성하는데, 작은 모델은 제한된 용량으로 인해 실질적 도움이 적으면서도 추론 비용이 높다. 이를 해결하기 위해 선택 기반 구조화 추론(SSR)을 제안했다. 추론을 개방형 생성 대신 선택 문제로 재정의한다. SSR은 반복되는 고수준 추론을 미리 정의된 재사용 가능한 자연언어 후보로 표현한다. 전체 요약 8문장 읽기 → 012 18:33 당일 +168 Rust 기반 고성능 링커 mold, lld보다 4.9배 빠르다 mold는 Unix 링커의 고성능 대체품으로, Blender·Chromium·TensorFlow 같은 대규모 프로젝트 링킹을 4.9배 빠르게(lld 대비 중앙값) 처리한다. 인프라 · 데브옵스 · rui314/mold · Rust
Key Point 대규모 프로젝트 빌드 시간을 획기적으로 단축할 수 있는 성숙한 도구로, 특히 C++·Rust 개발자의 개발 생산성을 크게 높일 수 있다.
핵심 요약
mold는 Unix 링커의 고성능 대체품으로, Blender·Chromium·TensorFlow 같은 대규모 프로젝트 링킹을 4.9배 빠르게(lld 대비 중앙값) 처리한다. 2026년 8월 벤치마크에서 wild 링커보다는 1.9배 빠르며, AMD Threadripper와 Apple M1 Ultra 양쪽 플랫폼에서 일관되게 우수한 성능을 보인다. LLVM lld 원개발자가 아키텍처 한계를 극복하기 위해 Rust로 새로 작성했으며, 2021년부터 프로덕션 환경에서 운영 중이다. 전체 요약 10문장 읽기 → 013 09:11 ▲ 147 · 댓글 103 Opus 5.5를 최대한 활용하는 프롬프팅 가이드 Opus 5.5는 이전 Opus보다 더 오래 작업하고, 진행 상황을 명확히 보고하며, 매 답변 전에 자체 사고 과정을 거친다. AI · 머신러닝 · Getting the most out of Opus 5.5 in Claude and Claude Code
Key Point Opus 5.5의 멀티스텝 능력이 크게 향상되어 프롬프팅 방식과 작업 진행 방식이 근본적으로 달라지므로, 기존 습관을 버리고 새로운 최적화 방법을 배워야 한다.
핵심 요약
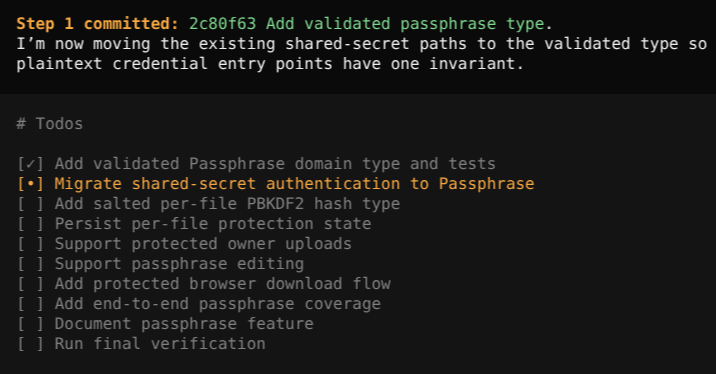
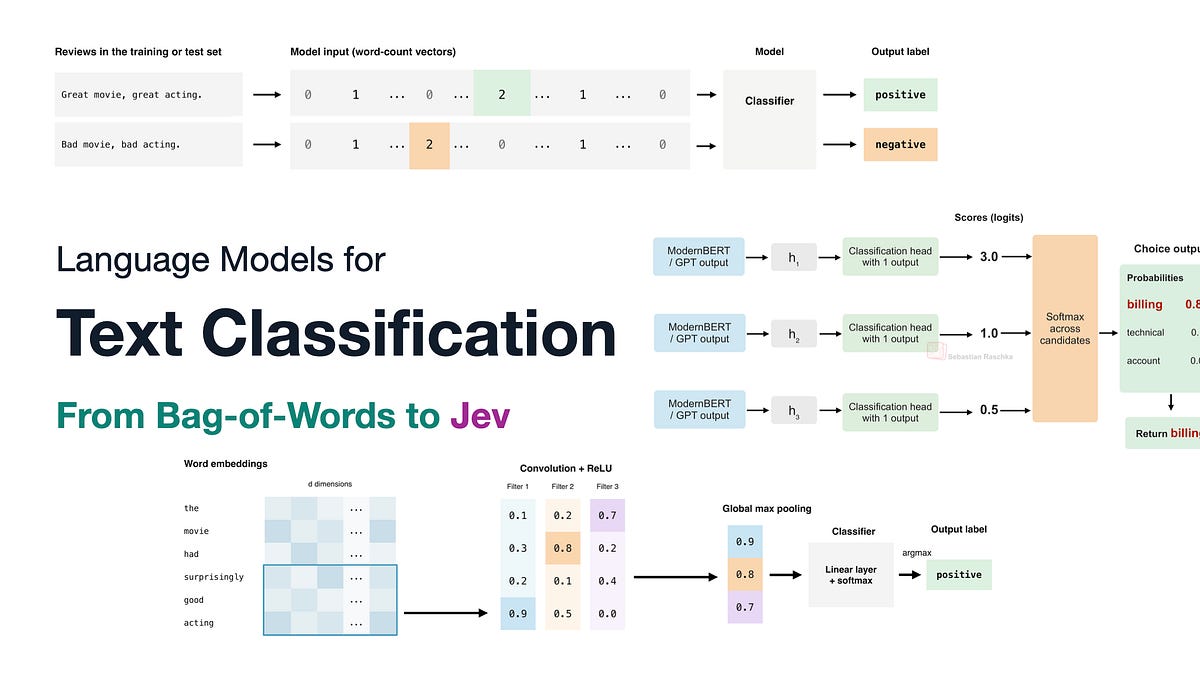
Opus 5.5는 이전 Opus보다 더 오래 작업하고, 진행 상황을 명확히 보고하며, 매 답변 전에 자체 사고 과정을 거친다. 장시간 멀티스텝 작업에서는 전체 작업을 한 메시지에 제시하고 '테스트 통과' 같은 명확한 완료 기준을 지정하면 중단 없이 진행한다. 기존 프롬프트의 '신중하게 생각하세요', '단계별로 생각하세요' 같은 지시어를 제거해야 한다. Opus 5.5는 항상 스스로 사고하는 범위를 결정하므로 불필요하다. 전체 요약 16문장 읽기 → 014 18:11 ▲ 107 · 댓글 4 텍스트 분류의 진화, Bag-of-Words부터 Jev까지 텍스트 분류 기술의 역사를 Bag-of-Words부터 최근 Jev AI까지 추적하는 기술 가이드로, 각 방식의 작동 원리와 성능을 비교한다. AI · 머신러닝 · Language models for text classification: From bag-of-words to Jev
Key Point 15년 전 Bag-of-Words로 시작된 텍스트 분류 기술이 어떻게 현재의 범용 분류 모델 Jev로 진화했는지, 각 방식의 트레이드오프를 이해하면 분류 작업에 적절한 도구를 선택할 수 있다.
핵심 요약
텍스트 분류 기술의 역사를 Bag-of-Words부터 최근 Jev AI까지 추적하는 기술 가이드로, 각 방식의 작동 원리와 성능을 비교한다. Bag-of-Words는 다양한 길이의 텍스트를 고정 크기 벡터로 변환해 Naive Bayes·로지스틱 회귀·SVM 등 고전 분류기를 적용할 수 있게 한다. 계산이 저렴하고 결과가 좋지만 단어 순서 정보를 잃는 단점이 있다. RNN은 단어를 순차적으로 처리하며 이전 단계의 숨겨진 상태를 누적하므로 단어 순서가 중요해진다. LSTM·GRU 같은 개선 방식이 있으며, ULMFiT 방식으로 전이학습을 적용하면 IMDb 영화평 분류에서 95.4% 정확도를 달성했다. 전체 요약 11문장 읽기 → 015 21:11 ▲ 20 · 댓글 1 동영상 생성 자동회귀 확산 모델의 캐시 재사용으로 1.7배 고속화 자동회귀 비디오 확산 모델은 동영상을 시간 단위 청크로 나누어 여러 단계의 노이즈 제거를 거쳐 생성하는데, 이미 생성한 청크를 기억하기 위해 기존 방식들은 별도의 순전파를 통해 깨끗한 KV 캐시를 재구성해야 했다. AI · 머신러닝 · In-Flight KV Cache with Clean Anchors for Faster Autoregressive Video Diffusion
Key Point 프롬프트-기반 동영상 생성 서비스 개발 시 캐시 재사용과 양방향 조건부 생성으로 생성 속도를 높이는 구체적인 기술적 해법을 제시하므로, 장시간 영상 생성이 필요한 실무 개발자에게 실질적 개선 방안을 보여준다.
핵심 요약
자동회귀 비디오 확산 모델은 동영상을 시간 단위 청크로 나누어 여러 단계의 노이즈 제거를 거쳐 생성하는데, 이미 생성한 청크를 기억하기 위해 기존 방식들은 별도의 순전파를 통해 깨끗한 KV 캐시를 재구성해야 했다. FlashForward는 각 노이즈 제거 단계 중에 자동으로 생성되는 현재 청크의 KV 캐시를 다음 청크에서 직접 재사용해 캐시 업데이트 전용 순전파를 제거한다. 이 방식은 여러 GPU를 각 단계에 할당해 서로 다른 청크가 동시에 서로 다른 단계를 점유하도록 해 병렬 처리 효율을 높인다. 전체 요약 7문장 읽기 → 016 21:11 당일 +120 Apple Silicon과 NVIDIA에서 LLM을 OpenAI 호환 API로 서빙하는 TensorFold TensorFold는 Apple Silicon(MLX) 및 NVIDIA GPU에서 텍스트 모델을 OpenAI 호환 API 엔드포인트로 서빙하는 Python 기반 도구다. AI · 머신러닝 · ashhart/TensorFold · Python
Key Point Apple Silicon 개발자가 로컬에서 고성능 LLM 추론을 OpenAI 호환 방식으로 실행할 수 있으며, NVIDIA GPU와 동일한 API로 통일된 배포가 가능해진다.
핵심 요약
TensorFold는 Apple Silicon(MLX) 및 NVIDIA GPU에서 텍스트 모델을 OpenAI 호환 API 엔드포인트로 서빙하는 Python 기반 도구다. Nemotron 3.5 Lightning, Qwen3.8-27B, Qwen3.8 Flash Next, GLM-5.3-Flash, Gemma 4 등 여러 모델을 지원하며, 각 모델은 자체 커널과 드래프트 검증을 포함한다. MLX 백엔드는 M1~M5 칩에서 row-exact simd_qmm 디코더로 4비트/그룹64 가중치를 읽고, CUDA 백엔드는 단일 또는 2-rank 텐서 병렬 처리를 지원한다. 전체 요약 12문장 읽기 → 017 18:11 ▲ 47 · 댓글 3 기초 모델 학습 데이터 준비용 분산 처리 엔진 RayOrch 파운데이션 모델 학습을 위해 이질적인 문서·동영상을 정형 데이터로 변환하는 확장 가능한 파이프라인이 필요하다. AI · 머신러닝 · RayOrch: Programming and Executing Lineage-Controlled Multi-Grain Dataflows for Foundation-Model Data Preparation
Key Point 파운데이션 모델의 대규모 학습 데이터 파이프라인에서 기존 시스템의 계보 추적 한계를 제거해 GPU 활용률과 처리 속도를 크게 향상시키는 실질적 해결책이다.
핵심 요약
파운데이션 모델 학습을 위해 이질적인 문서·동영상을 정형 데이터로 변환하는 확장 가능한 파이프라인이 필요하다. 각 부모 항목이 자식으로 확장될 때 자식의 개수가 들쭉날쭉하고, GPU가 부모 관계와 자식 순서·처리 상태를 유지하면서 배치 처리해야 한다. 기존 시스템은 병렬 처리를 숨기거나 평탄한 레코드를 노출해 애플리케이션이 계보와 재그룹화를 직접 관리하도록 강제한다. 전체 요약 9문장 읽기 → 019 22:29 ▲ 17 · 댓글 2 중앙 조율 없는 1,024개 에이전트 협력 시스템 Agensh 다중 에이전트 시스템은 병렬 처리로 복잡한 작업의 지연 시간을 줄일 수 있으나, 기존 프레임워크는 중앙 조율자의 용량 제약으로 확장성이 제한된다. AI · 머신러닝 · Agensh: Scaling Organizational Intelligence to 1,024 Agents
Key Point 중앙 조율자 없이도 수백~수천 개 에이전트를 효율적으로 협력시킬 수 있다면, 복잡한 문제 해결에서 에이전트 시스템의 확장성 문제를 근본적으로 해결할 수 있는 가능성을 보여주는 연구다.
핵심 요약
다중 에이전트 시스템은 병렬 처리로 복잡한 작업의 지연 시간을 줄일 수 있으나, 기존 프레임워크는 중앙 조율자의 용량 제약으로 확장성이 제한된다. Agensh는 중앙 조율자 없이 워커들이 자율적으로 협력하는 멀티에이전트 시스템으로, 공유 워크스페이스·메시지 인터페이스·공유 컨텍스트로 구성된 인프라를 통해 비동기 방식으로 작동한다. 워커들은 지속적으로 컨텍스트를 수집하고 서브태스크를 자동할당하며, 행동을 취하고 발견을 공유하고 결과를 검증하고 진행률을 병합한다. 전체 요약 7문장 읽기 → 020 22:29 ▲ 134 · 댓글 48 Tailscale, 멀티큐와 메모리 최적화로 처리량 대폭 높인다 Tailscale은 Linux와 Android에서 작은 패킷이 64KB 버퍼에 복사되는 방식을 개선해 메모리 오버헤드를 줄이고 약 5% 속도 향상을 이뤘다. 인프라 · 데브옵스 · Making Tailscale Faster
Key Point Tailscale이 VPN 인프라의 핵심 성능 지표인 처리량과 지연시간을 대폭 개선하는 기술들을 순차 배포하고 있어, 개발자들이 VPN 기반 네트워크 구성을 더 효율적으로 활용할 수 있게 된다.
핵심 요약
Tailscale은 Linux와 Android에서 작은 패킷이 64KB 버퍼에 복사되는 방식을 개선해 메모리 오버헤드를 줄이고 약 5% 속도 향상을 이뤘다. 패킷 큐 길이를 단축해 메모리 절감 효과를 얻었고, 절약된 메모리를 서브넷 라우터와 앱 커넥터에 할당했다. 기존에는 여러 연결의 패킷 스트림을 단일 스레드 파이프라인에서 처리했지만, 새로운 멀티큐 시스템으로 패킷별 레인(lane)을 분리해 병렬 처리를 가능하게 했다. 전체 요약 8문장 읽기 → 021 06:11 ▲ 125 · 댓글 26 AMD 라이젠, 2년간 성능 50% 향상의 비결 2022년 5800X3D부터 2024년 9800X3D까지 라이젠 7 프로세서의 단일 코어 성능은 47%, 멀티코어는 58% 향상되었다. 하드웨어 · 시스템 · How did AMD Ryzen get 50% faster in two years?
Key Point CPU 기술이 정체되었다는 통념을 깨고 실질적인 아키텍처 개선이 성능 향상을 어떻게 이뤄내는지 구체적 수치로 보여준다.
핵심 요약
2022년 5800X3D부터 2024년 9800X3D까지 라이젠 7 프로세서의 단일 코어 성능은 47%, 멀티코어는 58% 향상되었다. 클록 속도 상승(4.5GHz에서 5.2GHz, 15% 증가)만으로는 이 정도 성능 향상을 설명할 수 없으며, 아키텍처 개선이 주요 원인이다. 트랜지스터 수가 약 50% 증가(110억에서 160억 개)했고, 대부분이 코어 성능 향상에 투입되었다. 전체 요약 6문장 읽기 → 022 09:10 당일 +107 AI 코드를 수학적으로 검증하는 언어 Bend 2 공개 Bend는 AI가 작성한 코드의 정확성을 수학적 증명으로 검증하는 프로그래밍 언어다. AI · 머신러닝 · bendlang/bend · TypeScript
Key Point AI 코드 생성 시대에 규칙 위반을 수학적으로 원천 차단하는 새로운 접근이 등장했으며, 개발자들이 AI 에이전트에게 의존할 때 버그를 자동으로 거르는 메커니즘이 필요해진다.
핵심 요약
Bend는 AI가 작성한 코드의 정확성을 수학적 증명으로 검증하는 프로그래밍 언어다. LAWS.bend 파일에서 앱이 지켜야 할 규칙을 선언하면, 컴파일러가 코드가 항상 이 법칙을 위반하지 않음을 자동으로 보장한다. CPU에서는 C만큼 빠르고 GPU에서는 CUDA 수준의 성능을 목표로 하며, 강타입과 순수성으로 인해 스레드나 락 없이도 병렬 처리가 가능하다. 전체 요약 6문장 읽기 → 023 18:10 ▲ 101 · 댓글 99 AI 연구자들, 재귀적 자기개선까지 가는 길 논쟁 OpenAI 공동창립자 존 슐만, Zyphra CTO 베렌 밀리지, Baseten 모델 훈련 담당자 찰리 오닐이 재귀적 자기개선(RSI)의 실현 가능성을 토론했다. AI · 머신러닝 · AI researchers debate how close we are to recursive self-improvement
Key Point AI가 지수적으로 자기 자신을 개선할 수 있다는 시나리오가 과장된 것 아닌지, 실제 프론티어 연구자들이 어떤 장애물을 현실적으로 보고 있는지 알 수 있다.
핵심 요약
OpenAI 공동창립자 존 슐만, Zyphra CTO 베렌 밀리지, Baseten 모델 훈련 담당자 찰리 오닐이 재귀적 자기개선(RSI)의 실현 가능성을 토론했다. 만약 2036년에 초지능이 세상을 근본적으로 바꾸지 못한다면, 가장 가능성 높은 기술적 이유는 메타러닝 일반화의 어려움과 연속학습(continual learning) 문제라고 논의했다. AI 모델이 벤치마크에서는 우수하지만 현실 환경으로의 적용(sim-to-real gap)에서 계속 막힐 수 있고, 이것이 성능 향상 사이클을 반복시킬 수 있다고 밀리지는 지적했다. 전체 요약 5문장 읽기 → 024 03:10 ▲ 142 · 댓글 71 Logo: 교육 목표로 설계된 Lisp 방언 프로그래밍 언어 Logo는 학습을 목표로 설계한 Lisp 방언으로, 즉시 실행·피드백되는 인터프리터 방식으로 구현되어 디버깅과 학습을 돕는다. 오픈소스 · 도구 · Logo Programming Language
Key Point 프로그래밍 학습용 언어의 설계 철학과 특징을 이해할 수 있으며, 현대 교육용 프로그래밍 환경의 역사적 근원을 알 수 있다.
핵심 요약
Logo는 학습을 목표로 설계한 Lisp 방언으로, 즉시 실행·피드백되는 인터프리터 방식으로 구현되어 디버깅과 학습을 돕는다. 모듈식으로 소규모 절차(procedure)들을 조합해 복잡한 프로그램을 단계별로 구축할 수 있으며, 사용자 정의 절차가 기본 내장 함수와 동일하게 작동한다. 단어(문자열)와 리스트의 유연한 자료형으로 변수 타입 선언을 요구하지 않으며, 산술 연산과 문자열 연결을 자동으로 처리한다. 전체 요약 5문장 읽기 → 025 08:12 ▲ 422 · 댓글 122 BZip2를 잇는 고성능 압축 도구 BZip3 공개 BZip3는 context mixing 엔트로피 코더, suffix array 기반 버로우스-휠러 변환, LZ77/PPM 스타일 문자열 매칭으로 더 높은 압축률을 제공하는 BZip2의 후속작이다. 오픈소스 · 도구 · bzip3
Key Point BZip2 대비 우수한 압축률과 속도를 제시한 새 도구인 만큼, 대용량 텍스트/코드 압축이 필요한 개발 환경에서 즉각 검토할 가치가 있다.
핵심 요약
BZip3는 context mixing 엔트로피 코더, suffix array 기반 버로우스-휠러 변환, LZ77/PPM 스타일 문자열 매칭으로 더 높은 압축률을 제공하는 BZip2의 후속작이다. Perl 소스 코드 전체(262개 파일)를 압축한 테스트에서 BZip3 -b 256은 546MB로 xz의 2GB, bzip2의 3.4GB보다 훨씬 작게 압축했다. 동일 데이터 압축 해제 시간은 4분 6초로 xz의 4분 40초보다 빠르고, 병렬 처리로 여러 쓰레드 활용이 가능하다. 전체 요약 6문장 읽기 →