쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
37건 · "임계값"조건 지우기 ×
001 18:11 ▲ 127 · 댓글 24 스리랑카 코끼리, 개체 감소로 사회 관계망 급격히 붕괴 UC 샌디에고 연구팀이 스리랑카 우다왈라웨 국립공원의 암컷 아시아코끼리 440마리 이상을 12년간 추적 조사했다. 기타 · Elephants found to be increasingly isolated leading to fractured social networks
Key Point 개체 수 감소가 단순한 개수 문제가 아니라 사회 구조 붕괴로 이어지는 임계점이 있다는 발견은 멸종위기 생물 보전 전략을 재고하게 만든다.
핵심 요약
UC 샌디에고 연구팀이 스리랑카 우다왈라웨 국립공원의 암컷 아시아코끼리 440마리 이상을 12년간 추적 조사했다. 개체군 감소로 인해 코끼리의 사회 네트워크가 밀도 높은 대규모 집단에서 작고 고립된 소규모 집단으로 급변하는 '티핑 포인트'를 발견했다. 개체 손실이 서서히 쌓이다가 임계값을 넘으면서 사회 구조가 갑자기 변화했으며, 남은 개체들도 서로의 관계를 재편성하고 있다. 전체 요약 7문장 읽기 → 002 12:11 ▲ 103 · 댓글 21 Perplexity, 의사결정 특화 AI 모델 Decider v1.3 공개 Perplexity가 Decider v1.3과 Decider Flash v1.3을 출시했으며, 양쪽 모두 Hugging Face(Apache 라이선스), OpenRouter, Perplexity Decisions API를 통해 이용 가능하다. AI · 머신러닝 · Perplexity Decider v1.3: Training, eval, and use cases
Key Point 의사결정 전문 AI 모델로 한 번의 연산으로 여러 분류 작업을 수행해 기존 LLM 대비 훨씬 빠르고 저렴하게 구조화된 답변이 필요한 서비스(검색, 라우팅, 필터링 등)를 처리할 수 있다.
핵심 요약
Perplexity가 Decider v1.3과 Decider Flash v1.3을 출시했으며, 양쪽 모두 Hugging Face(Apache 라이선스), OpenRouter, Perplexity Decisions API를 통해 이용 가능하다. 의사결정 모델은 입력과 질문 집합을 받아 각 질문에 대한 확률 분포를 반환하는 범용 분류기로, Yes/No(이진), 다중선택, 점수(순서 있는 수준) 세 가지 질문 유형을 지원한다. 기존 생성형 LLM 대신 의사결정 모델을 사용하면 단일 포워드 패스에서 여러 질문을 동시에 처리하므로 토큰 하나씩 생성하는 오버헤드를 피하고 계산을 공유할 수 있다. 전체 요약 13문장 읽기 → 003 03:11 ▲ 148 · 댓글 32 malloc은 어떻게 메모리를 할당하나 malloc은 사용자 프로그램에서 커널로 시스템 콜을 통해 메모리를 요청하며, 많은 작은 할당을 하므로 매번 syscall을 하는 대신 미리 큰 블록을 받아 사용자 영역에서 관리한다. 인프라 · 데브옵스 · What is malloc doing, anyway?
Key Point malloc이 왜 그렇게 빠른지, 커널 호출을 어떻게 최소화하고 메모리를 관리하는지 이해할 수 있으며, 메모리 프리지(RSS 증가) 문제의 원인과 메커니즘을 기술 수준에서 파악할 수 있다.
핵심 요약
malloc은 사용자 프로그램에서 커널로 시스템 콜을 통해 메모리를 요청하며, 많은 작은 할당을 하므로 매번 syscall을 하는 대신 미리 큰 블록을 받아 사용자 영역에서 관리한다. glibc에서 malloc(16)을 1000번 호출하면 전체 과정에서 단 두 개의 brk syscall만 발생하는데, 첫 번째 호출이 132 KiB를 할당한 후 나머지는 이미 할당된 메모리에서 나온다. 각 할당(chunk)은 요청한 크기보다 8바이트 더 크며(헤더용), 16의 배수로 반올림되고 최소 32바이트인데, 반올림으로 포인터가 16바이트 정렬되어 모든 C 타입에 적합하다. 전체 요약 10문장 읽기 → 004 06:11 ▲ 100 · 댓글 37 리눅스 스크립트가 매일 샘 알트만에게 PC의 유휴 RAM 용량을 이메일로 보낸다 오픈AI 경영진이 '데이터센터를 위한 RAM 수요가 소비자 전자기기보다 중요하다'는 발언을 한 뒤 인터넷 커뮤니티의 비판을 받았다. 오픈소스 · 도구 · RAM Altman: Linux Script Emails Sam Altman Daily How Much Unused RAM in Your PC
Key Point 오픈AI 경영진의 RAM 수요 발언에 대한 개발자 커뮤니티의 풍자적 대응 방식과 이후 논쟁의 경과를 보여주는 사건이다.
핵심 요약
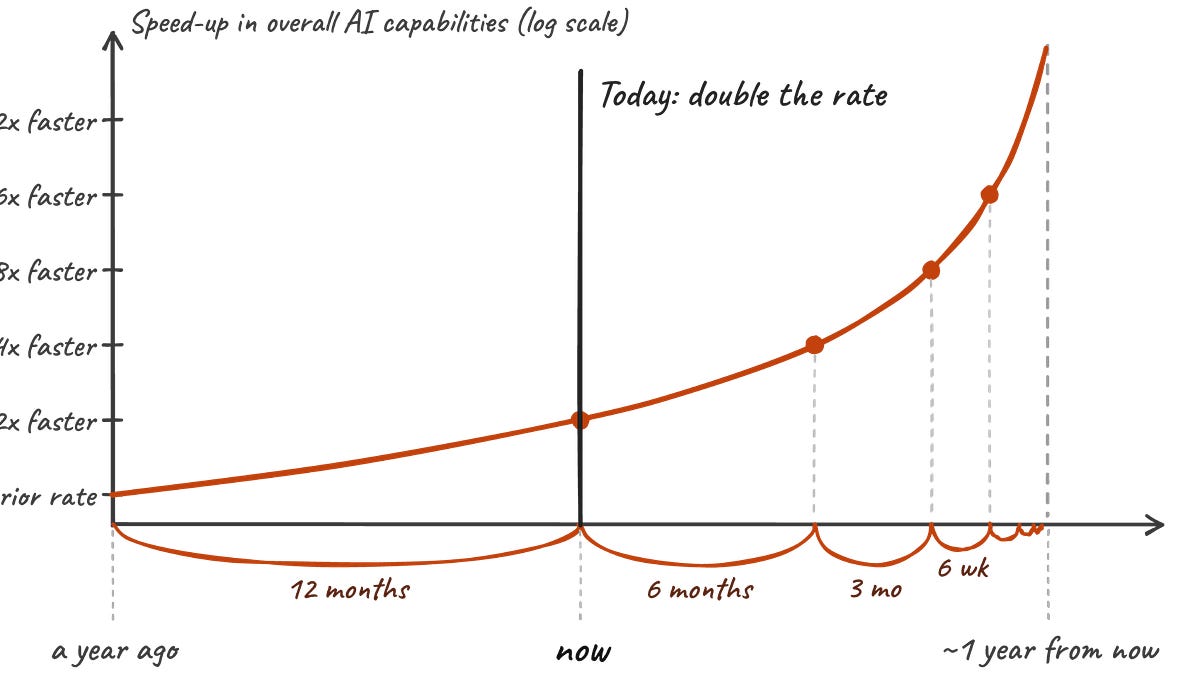
오픈AI 경영진이 '데이터센터를 위한 RAM 수요가 소비자 전자기기보다 중요하다'는 발언을 한 뒤 인터넷 커뮤니티의 비판을 받았다. 오픈소스 개발자 이언 케이(Iain Kay)가 리눅스 용 BASH 스크립트 '램 알트만(Ram Altman)'을 만들었는데, 이는 PC의 유휴 RAM 용량을 모니터링한다. 유휴 RAM이 전체 용량의 10% 이상이면 스크립트가 풍자적 이메일 템플릿 중 하나를 자동 생성한다. 예: '8.6 GiB의 RAM이 데이터센터에 없고 책상 위에 있습니다'라고 샘 알트만에게 보낸다는 내용. 전체 요약 7문장 읽기 → 005 09:11 ▲ 167 · 댓글 130 AI 연구 자동화가 AI 진전 속도를 배로 가속 Anthropic은 자사의 책임 있는 스케일링 정책(RSP)에서 정의한 '극적으로 가속된 진전' 임계값을 거의 충족할 가능성이 있다고 S1 신청서에 표시했다. AI · 머신러닝 · AI is dramatically accelerating AI research
Key Point AI가 AI 연구를 자동화하면서 초지능으로 향하는 자기 강화 루프가 시작되었다는 실증적 증거가 처음 공개되었고, 이는 기존 타임라인 예측을 근본적으로 단축시키는 구체적 신호다.
핵심 요약
Anthropic은 자사의 책임 있는 스케일링 정책(RSP)에서 정의한 '극적으로 가속된 진전' 임계값을 거의 충족할 가능성이 있다고 S1 신청서에 표시했다. METR의 심층 조사 결과, 2025년 10월부터 2026년 10월 사이 Anthropic의 역량 진전 속도가 전년도 대비 약 2배 빨라졌으며, 이는 AI 자동화가 주된 원인인 것으로 분석됐다. 전체 역량(유효 컴퓨팅)은 알고리즘 개선(컴퓨팅 승수)과 훈련 컴퓨팅의 곱이므로, 소프트웨어 진전만으로 2배 가속을 이루려면 컴퓨팅 승수 성장률은 2.5~3배 빨라야 한다. 전체 요약 14문장 읽기 → 006 03:11 ▲ 101 · 댓글 30 AI가 운영하는 오픈소스 사기탐지 플랫폼 카이로스 공개 Kairos는 실시간 사기 및 위험 판단을 자동화하는 오픈소스 플랫폼으로, 모든 가입·로그인·주문·결제·출금 요청에 대해 승인·재확인·검토·차단 중 하나로 의사결정하고 이유를 기록한다. 오픈소스 · 도구 · Show HN: Kairos – Open-source risk and fraud decisioning platform
Key Point AI 에이전트가 직접 사기탐지 모델을 설계·실험·배포하도록 자동화한 오픈소스 플랫폼으로, 기존 상용 솔루션과 달리 학습 데이터 없이도 초기부터 작동한다.
핵심 요약
Kairos는 실시간 사기 및 위험 판단을 자동화하는 오픈소스 플랫폼으로, 모든 가입·로그인·주문·결제·출금 요청에 대해 승인·재확인·검토·차단 중 하나로 의사결정하고 이유를 기록한다. Sardine, Sift, Riskified, SEON 같은 상용 서비스의 대안이며, 독립적인 AI 에이전트가 직접 튜닝할 수 있고 학습 데이터가 적은 초기 단계에서도 사기를 탐지할 수 있다는 점이 차별점이다. Claude Code, Cursor, Codex 같은 AI 에이전트를 MCP 서버로 연결하면, 에이전트가 워크플로우 설계·실험 제안·모델 학습·배포를 자동으로 수행할 수 있다. 전체 요약 12문장 읽기 → 007 03:11 ▲ 102 · 댓글 80 알고리즘 효율성의 정의를 놓친 50년, 이론과 현실의 단절 1965년 잭 에드몬즈가 그래프 최대 매칭 알고리즘을 발표할 때 '효율성'의 명확한 정의가 없었고, 2페이지를 할애해 지수 시간은 나쁘고 다항식 시간은 좋다는 기준을 처음 제안했다. AI · 머신러닝 · Efficient algorithms, the Exponential Time Hypothesis, and losing the plot
Key Point 컴퓨터과학 기초 이론이 현실의 계산 능력과 완전히 단절되어 있으며, 세계적 기업이 발표한 '획기적' 결과도 실제로는 구현 불가능한 매개변수를 감추고 있다는 점을 보여주기 때문입니다.
핵심 요약
1965년 잭 에드몬즈가 그래프 최대 매칭 알고리즘을 발표할 때 '효율성'의 명확한 정의가 없었고, 2페이지를 할애해 지수 시간은 나쁘고 다항식 시간은 좋다는 기준을 처음 제안했다. 에드몬즈는 자신의 기준이 불완전함을 알았고, n^1000 같은 다항식도 현실에서는 효율적이지 않으며 일부 지수 알고리즘(심플렉스)이 실무에서 빠르게 작동한다는 점을 이미 지적했다. 이 모호한 정의로 50년간 복잡도 이론이 발전했고, 현재 우리에게는 '복잡도 동물원'이라는 표현할 수 없을 정도로 큰 실행 시간을 가진 '우주적 알고리즘(galactic algorithm)'들이 쌓여 있다. 전체 요약 6문장 읽기 → 008 00:11 ▲ 26 · 댓글 1 비디오 세계 모델의 예측 오차, 물리적 놀라움을 재대로 측정하지 못한다 비디오 생성 AI의 예측 오차는 물리적으로 불가능한 사건을 감지하는 지표로 사용되지만, 실제로는 물체 색상·모양 변화나 일반적인 예측 어려움도 함께 반영된다. AI · 머신러닝 · When Does Latent Prediction Error Support Physical Surprise Claims in Video World Models?
Key Point 비디오 AI가 물리 법칙을 이해한다고 판단하는 기준(예측 오차)이 실제로는 색상·모양 변화에도 반응해 신뢰성이 낮다는 점을 밝혀, 세계 모델 평가 방식의 재검토가 필요함을 보여준다.
핵심 요약
비디오 생성 AI의 예측 오차는 물리적으로 불가능한 사건을 감지하는 지표로 사용되지만, 실제로는 물체 색상·모양 변화나 일반적인 예측 어려움도 함께 반영된다. 연구팀은 고정된 표현이 무엇을 담고 있는지, 물리적 변화와 겉모습 변화를 어떻게 구별하는지, 모델의 예측 오차를 무엇이 변화시키는지 분리해 평가하는 프레임워크를 개발했다. IntPhys2 벤치마크에서 V-JEPA2 모델을 포함한 여러 표현(잠재 예측, 마스킹된 픽셀 재구성, 시각 통계)을 비교한 결과, 물리적 가능성·불가능성에 대한 정보는 적게 포함했다. 전체 요약 8문장 읽기 → 009 00:11 ▲ 119 · 댓글 60 중국, AI 수출 통제 첫 시행…모델 가중치·에이전트 기술 규제 중국 상무부와 과학기술부가 10월 16일 공시 48호를 발표해 수출 금지·제한 기술 목록에 23개 AI 기술을 추가하고 즉시 사전 등록을 의무화했다. AI · 머신러닝 · China's First Frontier AI Export Controls: Mofcom Announcement No. 48
Key Point 중국의 AI 수출 통제가 미국과 함께 글로벌 AI 공급망에 이중 규제 체계를 만들어, 중국산 모델을 로컬 배포하거나 다국적 조직 구조에서 기술을 공유하는 기업들의 컴플라이언스 의무와 사업 리스크가 크게 증가했다.
핵심 요약
중국 상무부와 과학기술부가 10월 16일 공시 48호를 발표해 수출 금지·제한 기술 목록에 23개 AI 기술을 추가하고 즉시 사전 등록을 의무화했다. 대형 모델 가중치, 에이전트 아키텍처, AI 기반 공격 능력 등을 처음 직접 규제하며, 각 항목마다 구체적 기술 임계값을 설정했다. 모델 가중치는 10^26 FLOPs 이상 훈련 연산량, 2조 개 이상 파라미터, 또는 수출 시점 기준 공개 평가 상 상위 10위 중 하나를 충족하면 제한된다. 전체 요약 11문장 읽기 → 010 15:11 ▲ 68 · 댓글 3 System-1과 System-2의 협력이 AGI 확장의 열쇠인가 AGI 달성을 위해 지금까지는 더 큰 모델, 더 많은 데이터와 계산력으로 System-2(실행 담당)를 확장하는 방식에 의존해왔다. AI · 머신러닝 · Does Scaling Toward AGI Depend on What System-1 Lets System-2 Execute?
Key Point 모델 스케일링 외에 실행 효율성을 먼저 최적화하는 방식이 AGI 달성에 더 효과적일 수 있음을 보여주기 때문에, 대규모 AI 프로젝트의 계산 자원 배분 방향을 재검토하는 데 중요하다.
핵심 요약
AGI 달성을 위해 지금까지는 더 큰 모델, 더 많은 데이터와 계산력으로 System-2(실행 담당)를 확장하는 방식에 의존해왔다. 논문은 System-1(가벼운 의미 인식 예측기)과 System-2를 함께 설계해 System-2가 가치 있는 작업만 수행하도록 게이팅하는 방식을 제안한다. 조건부 상호작용 루프는 System-1이 각 후보의 유용성을 추정, System-2가 적응형 임계값으로 승인된 것만 실행, 결과가 System-1을 업데이트하는 구조로 동작한다. 전체 요약 8문장 읽기 → 011 18:11 ▲ 127 · 댓글 10 터미널에서 실시간 별자리를 본다, astroterm C로 작성된 터미널 기반 별 지도 도구로, 실시간 별·행성·별자리의 위치를 ASCII 렌더링으로 표시한다. 오픈소스 · 도구 · Astroterm: A Planetarium for Your Terminal
Key Point 개발자가 터미널만으로 실제 천체 데이터를 바탕으로 과거·미래의 별하늘을 확인할 수 있게 되어, 우주 탐사나 천문학 학습에 활용할 수 있는 도구입니다.
핵심 요약
C로 작성된 터미널 기반 별 지도 도구로, 실시간 별·행성·별자리의 위치를 ASCII 렌더링으로 표시한다. 날짜·시간·위치를 지정해 과거와 미래의 천체 현상을 탐색할 수 있으며, 달의 위상·별자리 도형·행성의 위치를 정확하게 표현한다. Arch Linux·Fedora·Homebrew·Nix·Guix에서 패키지로 설치 가능하고, Unix와 Windows용 미리 컴파일된 실행 파일도 제공된다. 전체 요약 6문장 읽기 → 012 15:11 ▲ 22 · 댓글 5 MoE 모델의 채널 선택, 보정 데이터 없이 가능 Mixture-of-Experts(MoE) 모델은 대화형 디코딩 중 라우팅된 전문가 가중치를 메모리에서 로드할 때 병목을 겪으며, 채널 선택기는 각 토큰에 실질적으로 영향을 주는 채널만 읽어 이를 완화한다. AI · 머신러닝 · Channel Selection for Mixture-of-Experts Decoding Needs No Calibration Data
Key Point 현재 MoE 모델 최적화의 표준인 보정 기반 임계값이 예산 보장과 성능 향상을 모두 충족하지 못하며, 보정 없는 top-k와 경량 리더로 더 안정적이고 빠른 디코딩을 달성할 수 있음을 보여준다.
핵심 요약
Mixture-of-Experts(MoE) 모델은 대화형 디코딩 중 라우팅된 전문가 가중치를 메모리에서 로드할 때 병목을 겪으며, 채널 선택기는 각 토큰에 실질적으로 영향을 주는 채널만 읽어 이를 완화한다. 기존 방식은 오프라인 데이터로 보정한 임계값을 사용하지만, 임계값을 통과하는 채널 수는 입력마다 달라져 실제 읽기 예산이 불안정하다: Prox는 18% 읽기 예산으로 보정되었으나 실제로는 평균 12.9%만 읽는다. Top-k 방식은 각 토큰의 k개 최고점수 채널을 선택하며 보정 데이터가 필요 없다. 전체 요약 8문장 읽기 → 013 12:11 ▲ 46 · 댓글 2 확산 언어 모델의 추측 디코딩 가속화 기법 SPOT 제안 확산 언어 모델(DLM)은 병렬 텍스트 생성이 가능하지만 속도-품질 트레이드오프를 겪고 있다. AI · 머신러닝 · On the SPOT: Enhancing Speculative Decoding for Diffusion Language Models via Commit-Order Prediction
Key Point 확산 언어 모델의 속도 문제를 해결하는 새로운 추측 디코딩 기법으로, 토큰 위치 순서 예측이라는 핵심 인사이트를 통해 정확성을 유지하면서 6배 이상의 가속화를 달성했으며, 학습된 드래프터가 여러 모델에 전이 가능해 실용성이 높다.
핵심 요약
확산 언어 모델(DLM)은 병렬 텍스트 생성이 가능하지만 속도-품질 트레이드오프를 겪고 있다. 정확한 디코딩은 모델 패스당 하나의 마스킹된 위치만 채우고, 빠른 멀티토큰 디코딩은 품질 손실이 발생한다. 추측 디코딩은 자동회귀 모델의 표준 가속 기법이지만 DLM에 직접 적용되지 않는데, DLM은 무엇을 생성할지뿐 아니라 어디에 생성할지를 선택해야 하기 때문이다. 전체 요약 11문장 읽기 → 014 18:11 ▲ 16 · 댓글 2 AI 텍스트 판별기를 해석 가능하게 만드는 방법 동료 검토, 교육, 입시, 저널리즘, 콘텐츠 모더레이션 등 결과가 개인에게 직접 영향을 미치는 분야에서 AI 생성 텍스트 판별기가 배포되고 있다. AI · 머신러닝 · Building Auditable AI Text Detectors with Sparse Autoencoders
Key Point AI 생성 텍스트 판별기의 검은 상자 문제를 해결하고, 높은 성능과 투명성을 동시에 확보할 수 있는 새로운 방법론을 제시해 교육·저널리즘·입시 등 중요한 영역에서의 신뢰성을 높인다.
핵심 요약
동료 검토, 교육, 입시, 저널리즘, 콘텐츠 모더레이션 등 결과가 개인에게 직접 영향을 미치는 분야에서 AI 생성 텍스트 판별기가 배포되고 있다. 현재 가장 성능 좋은 판별기는 미세 조정된 신경망 분류기인데, 의사결정 과정이 불투명하며, 투명한 대안인 문체 및 언어적 특성 분류기는 성능이 훨씬 낮다. 연구팀은 미세 조정된 신경망 판별기를 인간이 읽을 수 있는 개념으로 작동하는 분류기로 변환하는 파이프라인을 제시했다. 전체 요약 7문장 읽기 → 015 21:11 ▲ 10 · 댓글 1 네트워크 보안에 타입화된 결정 모델 도입, VX-One 실증 네트워크 경계 방어(perimeter triage)는 빠른 시그니처 엔진과 느리지만 의미를 파악하는 생성형 모델 간의 절충이 필요한데, 최근 상용 System One 결정 모델들이 이진 게이트·폐쇄형 선택·순서형 점수 같은 타입화된 의사결정 원시형을 API로 제공하기 시작했다. 보안 · VX-One: Typed, Calibrated Decision Heads for Real-Time Perimeter Triage - An empirical study of unknown-attack honesty, cascade gray zones, and calibration under drift
Key Point 시그니처 엔진과 머신러닝의 장점을 결합하는 캐스케이드 아키텍처에서 타입화된 결정의 효과와 한계를 실증적으로 측정한 결과, 특히 시간적 변화 같은 실전 조건에서 캘리브레이션이 붕괴되는 현상은 보안 시스템 운영에 직접 영향을 미친다.
핵심 요약
네트워크 경계 방어(perimeter triage)는 빠른 시그니처 엔진과 느리지만 의미를 파악하는 생성형 모델 간의 절충이 필요한데, 최근 상용 System One 결정 모델들이 이진 게이트·폐쇄형 선택·순서형 점수 같은 타입화된 의사결정 원시형을 API로 제공하기 시작했다. VX-One은 100K-10M 파라미터의 소규모 멀티헤드 네트워크로서 캘리브레이션된 게이트, 미지의 선택지를 항상 포함하는 폐쇄형 후보군에서의 선택, 순서형 점수를 출력하며, CPU에서 약 0.7-1.7ms의 추론 시간을 가진다. UNSW-NB15, CIC-IDS2017, EMBER2024 벤치마크에서 캘리브레이션된 XGBoost, 랜덤포레스트, MLP, Kitsune과 비교 평가했고, Suricata 시그니처 엔진(52,674개 규칙) 뒤에 VX-One을 두는 2단계 캐스케이드 구성을 CIC-IDS2017의 5일간 데이터로 측정했다. 전체 요약 7문장 읽기 → 016 15:11 ▲ 12 · 댓글 1 낮은 대역폭에서 음성 품질 지키는 적응형 음성 코덱 공개 신경망 기반 음성 코덱은 음성을 이산 토큰으로 변환하는데, 프레임 레이트가 낮을수록 토큰 시퀀스가 짧아지지만 각 토큰이 더 많은 정보를 담아야 한다. AI · 머신러닝 · RubatoCodec: Budgeted Adaptive Speech Tokenization with Streaming Decoding
Key Point 저대역폭 음성 생성에서 품질과 안정성을 동시에 확보하는 새로운 접근법으로, 음성 AI 모델 개발자들이 토큰 예산을 명확히 제어하면서도 높은 음질을 유지할 수 있게 한다.
핵심 요약
신경망 기반 음성 코덱은 음성을 이산 토큰으로 변환하는데, 프레임 레이트가 낮을수록 토큰 시퀀스가 짧아지지만 각 토큰이 더 많은 정보를 담아야 한다. 기존 가변 프레임 레이트 코덱은 임계값 기반 할당으로 콘텐츠에 따라 토큰 개수가 달라져 생성 모델이 예측해야 할 시퀀스 길이가 불안정하다. RubatoCodec은 X-Codec-2 기반의 가변 프레임 레이트 음성 코덱으로, 발화 단위의 명시적 이벤트 예산과 스트리밍 디코딩을 지원한다. 전체 요약 10문장 읽기 → 017 09:11 ▲ 117 · 댓글 14 넷핵 노움 광산의 던전 생성 알고리즘 넷핵의 노움 광산 던전은 셀룰러 오토마타를 이용해 유기적인 동굴 느낌을 만든다. 오픈소스 · 도구 · Dungeon Generation in the Gnomish Mines of NetHack
Key Point 인디게임부터 AAA까지 활용되는 절차적 생성 기법의 가장 오래되고 검증된 예시를 실전 코드 수준으로 분해한 글이라, 게임 개발자나 알고리즘 공부하는 개발자라면 실제 구현의 작은 결정(언버퍼링, 4번의 패스, 각 패스의 임계값)이 왜 필요했는지 이해할 수 있기 때문입니다.
핵심 요약
넷핵의 노움 광산 던전은 셀룰러 오토마타를 이용해 유기적인 동굴 느낌을 만든다. 생성 과정은 전체 셀의 40%를 무작위로 바닥으로 설정한 뒤 4번의 셀룰러 오토마타 패스를 거친다. 1패스는 언버퍼 방식으로 작동하며, 각 셀을 인접한 바닥 타일 개수에 따라 바닥 또는 암석으로 클러스터링한다(0-2개는 암석, 3-4개는 유지, 5-8개는 바닥). 전체 요약 6문장 읽기 → 018 00:11 ▲ 130 · 댓글 22 지도 폴리곤 삼각분할 6배 가속, earstrip 공개 지도 엔진의 폴리곤 삼각분할 라이브러리 earstrip을 ISC 라이선스로 공개했으며, C++ 헤더 파일과 WebAssembly npm 빌드를 제공한다. 웹 · 프론트엔드 · Faster than earcut: triangulating 3.7M map polygons in 489 ms
Key Point 지도 렌더링 성능의 병목인 폴리곤 삼각분할을 6배 가속하고 오픈소스로 공개해 웹 지도 서비스의 성능 개선에 직접 활용 가능하다.
핵심 요약
지도 엔진의 폴리곤 삼각분할 라이브러리 earstrip을 ISC 라이선스로 공개했으며, C++ 헤더 파일과 WebAssembly npm 빌드를 제공한다. C++에서는 earcut.hpp보다 14% 빠르고, 브라우저 환경에서는 earcut.js보다 1.4~2.1배 빠르다. GPU는 삼각형만 그리므로 건물·공원 등 다각형 지도 요소들을 먼저 삼각형으로 잘라야 한다. 전체 요약 11문장 읽기 → 019 12:11 ▲ 135 · 댓글 1 LLM 에이전트 캐시 관리, 비용 28% 절감 LLM 에이전트가 장시간 작업을 수행할 때 key-value(KV) 캐시의 I/O와 저장이 가장 큰 비용이 되고, 궤적(trajectory)이 컨텍스트 길이를 초과하면서 캐시 크기 조절이 필수가 되었다. AI · 머신러닝 · Cache Engineering for Agents
Key Point LLM 에이전트의 장시간 작업에서 캐시 관리 오버헤드가 최대 비용이 되는 상황에서, 궤적 수정 없이 캐시를 제어하고 비용을 27.7% 줄이는 새로운 방식의 등장으로 에이전트 성능 최적화의 패러다임이 바뀌고 있다.
핵심 요약
LLM 에이전트가 장시간 작업을 수행할 때 key-value(KV) 캐시의 I/O와 저장이 가장 큰 비용이 되고, 궤적(trajectory)이 컨텍스트 길이를 초과하면서 캐시 크기 조절이 필수가 되었다. 기존 방식인 히스토리 정리·요약은 궤적을 변경해서 이미 캐시된 상태를 무효화하고 비용이 많이 드는 재-프리필(re-prefilling)을 촉발한다. 연구팀은 cache engineering이라는 새로운 방식을 제안했는데, 궤적을 수정하지 않으면서 에이전트가 활성 KV 캐시를 직접 제어할 수 있게 한다. 전체 요약 10문장 읽기 → 020 12:11 ▲ 10 · 댓글 2 코딩 에이전트가 실패를 미리 감지하고 중단하는 StopLoss 코딩 에이전트는 검증에 실패할 런을 계속 진행하는데, 이를 감시하기 위해 대형 모델을 사용하는 것은 비용이 크다. AI · 머신러닝 · StopLoss: Teaching Agents to Predict Failure and Stop Early
Key Point 코딩 에이전트의 실패 예측을 저비용으로 수행함으로써 계산 자원 낭비를 크게 줄일 수 있는 실용적 방법이 증명되었기 때문입니다.
핵심 요약
코딩 에이전트는 검증에 실패할 런을 계속 진행하는데, 이를 감시하기 위해 대형 모델을 사용하는 것은 비용이 크다. StopLoss는 완료된 궤적(trajectory)과 검증자 결과로부터 실패를 인식하도록 학습한 소규모 외부 모니터이다. 미세조정된 언어모델이 최근 도구 단계들을 한 번의 포워드 패스로 점수화하고, 성공 런에서 보정된 임계값이 중단 결정을 내린다. 전체 요약 8문장 읽기 → 021 00:11 ▲ 27 · 댓글 1 이미지·영상 생성 속도를 6배 높이는 스펙트럼 필터링 기법 확산 트랜스포머(DiT)는 고품질 이미지·영상을 생성하지만 반복되는 트랜스포머 평가로 추론 비용이 크게 든다. AI · 머신러닝 · SpecKCast: Spectral Kalman Forecasting for Diffusion Acceleration
Key Point 확산 모델 기반 생성 AI의 추론 속도가 실무적 병목이 되는 상황에서, 화질 손실을 최소화하면서 최대 6배 가속이 가능한 기법이 제시됨으로써 생성 모델의 배포 효율을 크게 개선할 수 있다.
핵심 요약
확산 트랜스포머(DiT)는 고품질 이미지·영상을 생성하지만 반복되는 트랜스포머 평가로 추론 비용이 크게 든다. 기존 캐싱은 특성을 재사용하고, 예측 방식은 건너뛴 단계의 특성을 외삽(extrapolation)하지만, 공간-주파수 성분이 잡음 제거 과정의 다양한 단계에서 서로 다르게 변한다는 점을 간과한다. 또한 잡음 제거는 비균등하게 진행되므로 같은 간격의 스텝도 실제로는 크기 다른 변화에 해당하는데, 이 불일치가 건너뛴 단계가 많아질수록 예측 오류를 증폭시킨다. 전체 요약 7문장 읽기 → 022 21:11 당일 +215 DeepSeek Harness를 휴대폰에서 제어하는 DSH Pocket 전자 기기에 설치된 DeepSeek Harness를 휴대폰에서 실시간으로 접근·조작할 수 있는 npm 플러그인으로, 동일한 WiFi 네트워크의 휴대폰에서 QR 코드를 스캔하거나 공인망을 통해 4G 등 외부 네트워크에서도 접속 가능하다. 오픈소스 · 도구 · shaobeichen/dsh-pocket · JavaScript
Key Point DeepSeek Harness 사용자가 외출 중에도 전자 기기의 agent 작업을 실시간으로 모니터링하고 제어할 수 있는 표준 솔루션이 등장했으므로, 개발자 생산성 도구 사용자라면 즉시 설치 가치가 있다.
핵심 요약
전자 기기에 설치된 DeepSeek Harness를 휴대폰에서 실시간으로 접근·조작할 수 있는 npm 플러그인으로, 동일한 WiFi 네트워크의 휴대폰에서 QR 코드를 스캔하거나 공인망을 통해 4G 등 외부 네트워크에서도 접속 가능하다. 로컬 네트워크 모드는 설정 페이지에서 바로 사용 가능하며, 장치 IP를 자동 감지하고 WSL 환경에서 Windows 물리 네트워크 카드 IP를 자동으로 선택한다. 공인망 접근은 cloudflared 터널을 통해 작동하며, Cloudflare Tunnel Token과 도메인명을 설정해 고정된 공인 주소를 사용할 수 있는 '명명된 터널' 옵션을 제공한다. 전체 요약 12문장 읽기 → 023 12:11 ▲ 287 · 댓글 2 GPT-6-Astra, 로봇 지능의 한계 진단 GPT-6-Astra를 로봇 조작·항법 작업에 평가한 결과, 12개 벤치마크(탁상형 조작, 휴머노이드, 이동 로봇, 손가락 제어)에서 학습 데모로부터의 맥락 학습(ICL)을 활용해 전례 없는 성능을 달성했다. AI · 머신러닝 · Has GPT-6-Astra Achieved Embodied Intelligence?
Key Point 로봇 지능이 실험실 성과와 현장 적용 사이의 격차를 드러내므로, 다음 세대 로봇 AI 개발 방향을 예측하는 데 필요하다.
핵심 요약
GPT-6-Astra를 로봇 조작·항법 작업에 평가한 결과, 12개 벤치마크(탁상형 조작, 휴머노이드, 이동 로봇, 손가락 제어)에서 학습 데모로부터의 맥락 학습(ICL)을 활용해 전례 없는 성능을 달성했다. 향후 개선 방향으로 ICL의 일반화, 비용·실행 시간 단축, 물리 상태 검증, 불가역적 실패 복구, 장기 작업 진행 상황 유지 등 5가지를 제시했다. 고수준 추론기(GPT-6-Astra)와 저수준 제어기(π0.5) 간 폐루프 조율이 비용이 높지만 효과적임을 확인했다. 전체 요약 6문장 읽기 → 024 03:11 ▲ 127 · 댓글 144 앤스로픽, AI 규제안에서 높은 위험도 기준 제시 앤스로픽이 정부가 AI 모델 출시를 막을 수 있는 조건을 10억 달러 이상의 손해 또는 50명 이상의 사망·부상으로 제한하는 AI 안전 법안을 통상부에 로비하고 있다. AI · 머신러닝 · Anthropic's proposed AI safety bill only kicks in if 50 deaths or $1B in damages
Key Point 기업이 규제 대상 결정 기준을 직접 제시함으로써 실질적 감시 능력을 제약하려는 시도이며, 높은 피해 임계값이 규제를 사실상 무력화할 수 있다는 우려가 나온다.
핵심 요약
앤스로픽이 정부가 AI 모델 출시를 막을 수 있는 조건을 10억 달러 이상의 손해 또는 50명 이상의 사망·부상으로 제한하는 AI 안전 법안을 통상부에 로비하고 있다. 이 법안에 따르면 독립적인 제3자 평가기관이 정부에 등록해 주기적으로 해당 연구소와 AI 모델을 평가하게 된다. 법안은 평가기관에 비용을 지급할 수 있지만 평가의 독립성을 훼손하지 않아야 한다고 명시했다. 전체 요약 5문장 읽기 → 025 09:11 ▲ 132 · 댓글 22 Commodore 64를 핀 단위로 시뮬레이션하는 하드웨어 시뮬레이터 공개 antirez가 Commodore 64 ASSY 250407 마더보드를 핀 단위로 시뮬레이션하는 프로그램 c64-hw-sim을 GitHub에 공개했다. 오픈소스 · 도구 · The Commodore 64 hardware simulator: break chips and pins, see the results
Key Point 실제 칩을 제거하거나 손상시킬 위험 없이 고장난 Commodore 64의 원인을 하드웨어 수준에서 진단하고 탐구할 수 있는 오픈소스 도구가 공개되었다.
핵심 요약
antirez가 Commodore 64 ASSY 250407 마더보드를 핀 단위로 시뮬레이션하는 프로그램 c64-hw-sim을 GitHub에 공개했다. 칩의 다리를 들어올리거나 그라운드/+5V에 단락시키거나, 칩을 소켓에서 빼거나, 저항을 개방할 수 있으며 그 결과를 모니터, 키보드, 보드의 모든 신호로 확인할 수 있다. 프로그램은 PCB의 전기 연결(네트리스트)과 각 칩의 핀 동작을 알고 있으며, 손상된 부품을 시뮬레이션하면 화면의 잡음도 회로 계산에서 나온 것이다. 전체 요약 14문장 읽기 → 026 12:11 ▲ 18 · 댓글 2 LLM 에이전트의 비용 줄이는 경량 의사결정 모델 JevAgentHarness LLM 에이전트는 매 단계마다 대규모 언어모델을 호출하는데, 대부분의 호출이 '다음에 어떤 도구를 쓸지' 같은 선택지 문제로 끝나 비용과 시간이 낭비된다. AI · 머신러닝 · JevAgentHarness: Benchmarking, Deploying and Training Decision Models That Share Control with LLMs
Key Point LLM 에이전트의 매 단계 호출 비용을 줄이는 실질적 방법을 제시하며, 실제 에이전트 동작 환경에서의 검증과 훈련 전략이 비용-성능 트레이드오프를 어떻게 개선하는지 보여준다.
핵심 요약
LLM 에이전트는 매 단계마다 대규모 언어모델을 호출하는데, 대부분의 호출이 '다음에 어떤 도구를 쓸지' 같은 선택지 문제로 끝나 비용과 시간이 낭비된다. Jev 같은 경량 의사결정 모델은 이런 선택을 LLM 호출 비용의 일부로 직접 처리할 수 있다. 연구팀은 에이전트의 실제 동작 환경에서 의사결정 모델을 평가하는 AgentDecisionBench를 만들었고, 고립된 질문에서 정확도가 높아도 에이전트 작업 성공률은 69.5%에 불과함을 발견했다. 전체 요약 9문장 읽기 → 027 12:11 ▲ 66 · 댓글 1 Sparse Attention의 성능 가속, 무손실 증명 기반 최적화 DoSA(Dots Sparse Attention)는 sparse attention의 계산 비용을 줄이는 무손실 방법으로, 모든 키에 대한 점수 매김을 조건부로 만들면서도 정확한 토큰 선택을 보장한다. AI · 머신러닝 · DoSA: Dots Sparse Attention
Key Point LLM의 주요 병목인 sparse attention 계산을 수학적 증명으로 가속하는 기법으로, 추론 속도 개선이 직접적으로 비용 절감으로 이어지는 프로덕션 환경에서 실질적 임팩트를 제공한다.
핵심 요약
DoSA(Dots Sparse Attention)는 sparse attention의 계산 비용을 줄이는 무손실 방법으로, 모든 키에 대한 점수 매김을 조건부로 만들면서도 정확한 토큰 선택을 보장한다. 핵심 아이디어는 Top-K 선택이 후보를 완전히 평가하지 않아도 승리 임계값에 대한 증명(certificate)으로 배제 가능하다는 점이다. 시드 세트가 임계값의 하한을 제공하고, 음수 가중치 헤드의 기여도를 수학적으로 상한으로 제한한다. 전체 요약 7문장 읽기 → 028 21:11 당일 +110 Cloudflare Workers를 자체 서버에서 실행하는 오픈소스 celld 공개 Deno Land가 Cloudflare Workers 플랫폼을 자체 인프라에서 실행할 수 있게 하는 오픈소스 데몬 celld를 공개했다. 인프라 · 데브옵스 · denoland/celld · Rust
Key Point 자사 Cloudflare Workers 애플리케이션을 클라우드 의존 없이 완전히 자체 통제하는 인프라에서 운영할 수 있게 되므로, 멀티테넌트 워크로드나 온프레미스 배포가 필요한 조직에 중요한 선택지를 제공한다.
핵심 요약
Deno Land가 Cloudflare Workers 플랫폼을 자체 인프라에서 실행할 수 있게 하는 오픈소스 데몬 celld를 공개했다. Workers, Durable Objects, KV, Queues, D1, R2, Workflows, Cron Triggers, 정적 자산 등 Cloudflare의 모든 주요 서비스를 로컬 클러스터에서 동작시킬 수 있다. 각 객체는 셀(cell)이라는 자체 SQLite 데이터베이스를 가진 명명된 서버이며, 장기 상태는 S3, Google Cloud Storage, Azure Blob Storage 버킷에 저장된다. 전체 요약 13문장 읽기 → 029 18:35 ▲ 243 · 댓글 123 실제 측정한 12개 Zigbee 온습도센서 정확도 비교 AliExpress에서 주로 구매되는 Aqara·Sonoff·Tuya·Thirdreality·Zemismart·Moes 등의 Zigbee 온습도센서 12개를 실제 환경에서 비교 테스트했다. 하드웨어 · 시스템 · Best-selling Zigbee temperature sensors tested and compared
Key Point 스마트홈에서 가장 저렴한 Zigbee 온습도센서를 선택할 때 정확도·배터리 수명·보고 간격 조정 가능성이 매우 다르므로 실제 측정 데이터에 기반한 선택이 필요하다.
핵심 요약
AliExpress에서 주로 구매되는 Aqara·Sonoff·Tuya·Thirdreality·Zemismart·Moes 등의 Zigbee 온습도센서 12개를 실제 환경에서 비교 테스트했다. 캘리브레이션된 기준 센서(Xiaomi Miaomiaoce MHO-C401)와 나란히 놓고 약 10일간 측정했으며, 기준 센서는 정육점의 법정 검증 온도계로 영점을 재조정했다. 온도 정확도는 Paulie(Sonoff SNZB-02P)와 Carmela(Sonoff SNZB-02B)가 평균 0.2°C 편차로 가장 우수했고, Livia·Adriana·Furio는 0.5~0.8°C 오차를 보였다. 전체 요약 12문장 읽기 → 030 00:11 ▲ 103 · 댓글 69 AI로 자동화한 필름 사진 스캔 워크플로우 35mm 필름 사진 작업 흐름을 자동화한 개인 프로젝트로, 롤당 36장을 처리하는 데 평균 4시간 걸리던 수동 작업을 개선했다. AI · 머신러닝 · Automating my 35mm film scanning pipeline
Key Point 필름 사진 애호가가 수동 스캔 작업의 번거로움을 AI와 자동화로 극복한 실제 사례로, 크리에이티브 워크플로우에 LLM과 비전 모델을 실용적으로 활용하는 방법을 보여준다.
핵심 요약
35mm 필름 사진 작업 흐름을 자동화한 개인 프로젝트로, 롤당 36장을 처리하는 데 평균 4시간 걸리던 수동 작업을 개선했다. Claude AI를 스캐너에 직접 제어시키려 했으나 SANE 드라이버를 통해 스캔 방향을 잘못 설정해 스캐너 기어 메커니즘을 손상시켰고, 수리 후 기존 VueScan 소프트웨어를 유지하기로 결정했다. numpy를 이용한 음화 변환으로 필름 밀도를 측정해 36장의 색감을 일관되게 유지하며, 빈 필름 슬롯을 색감 기준점으로 삼아 자동 색보정을 수행한다. 전체 요약 8문장 읽기 → 031 09:11 ▲ 105 · 댓글 38 Netlify 엣지 함수, Firecracker MicroVM으로 5배 빨라졌다 Netlify는 엣지 함수 실행 인프라를 V8 isolate에서 Firecracker MicroVM 기반으로 전환해 중간값 기준 응답 시간을 25~40ms에서 5~6ms로 단축했다. 인프라 · 데브옵스 · 5x faster Edge Functions: V8 isolates to Firecracker MicroVMs
Key Point V8 isolate 기반 엣지 함수가 MicroVM으로 바뀌면서 응답 속도가 5배 빨라지고 진정한 보안 격리가 가능해져, 프론트엔드 성능과 보안이 모두 핵심인 웹 개발자에게 직결된 영향을 미친다.
핵심 요약
Netlify는 엣지 함수 실행 인프라를 V8 isolate에서 Firecracker MicroVM 기반으로 전환해 중간값 기준 응답 시간을 25~40ms에서 5~6ms로 단축했다. 이제 요청이 외부 실행 서비스로 나가지 않고 Netlify의 엣지 네트워크 내 MicroVM에서 직접 처리되며, p99 기준으로도 47.4% 빨라졌고 가용성은 99.998%이다. 요청이 도착하면 엣지 노드가 경로를 확인해 매칭되는 엣지 함수가 있으면 머신 사양을 포함한 명세를 생성하고, rendezvous 해싱으로 동일 서비스가 같은 컴퓨트 노드에 할당되도록 한다. 전체 요약 13문장 읽기 → 032 18:11 ▲ 64 · 댓글 1 어텐션의 계산 효율을 높이는 MALA 메커니즘 제안 기존 Full Attention은 QK 타일 계산 후 전체 후속 경로를 실행하지만 정규화 가중치에서 대부분의 값이 무시할 수준으로 작아 비효율적이다. AI · 머신러닝 · MassAlloc Attention: Let Attention Allocate Its Own Compute
Key Point Full Attention의 비효율적 계산 패턴을 식별하고 실제 기여도 기반 할당으로 2~3배 속도 향상을 달성하면서도 모델 성능을 유지하는 방법으로, 대규모 언어 모델의 추론·학습 효율을 개선하는 데 직결된다.
핵심 요약
기존 Full Attention은 QK 타일 계산 후 전체 후속 경로를 실행하지만 정규화 가중치에서 대부분의 값이 무시할 수준으로 작아 비효율적이다. MALA(MassAlloc Attention)는 정규화된 기여도에 따라 후속 계산을 선택적으로 할당하는 퓨즈드 어텐션 프리미티브로, 순전파는 온라인 소프트맥스 정규화기를, 역전파는 최종 정규화기를 재사용한다. 하나의 공통 임계값으로 학습과 추론에서 적응적 유지(retention)가 가능하며, 8K 토큰 비교에서 생략된 질량은 0.0188%로 기준 오라클의 0.0182%에 근접한다. 전체 요약 7문장 읽기 → 033 03:11 ▲ 152 · 댓글 46 소프트웨어의 '그냥 안 되는' 일상화 저자는 문제의 원인을 추적할 수 없는 오류가 정상화되는 현상을 우려하고 있다. AI · 머신러닝 · The Normalization of Inexplicable Failures
Key Point AI 기반 기능이 배포되면서 '원인을 알 수 없는 장애'가 정상적인 것으로 받아들여지는 추세를 다루는데, 이는 개발 생산성과 품질 사이의 근본적인 긴장을 보여줍니다.
핵심 요약
저자는 문제의 원인을 추적할 수 없는 오류가 정상화되는 현상을 우려하고 있다. Jev 같은 AI 모델들은 빠르고 저렴하지만, 사용자는 반환값이 정말 작동하는지 검증할 평가 프레임워크(evals)를 구축해야 한다. 대부분의 개발자는 기술적 평가를 미루고 'AI 기반' 표시만 하고 배포한 뒤, 장애 발생 시 '음, AI는 실수한다'고 넘어간다. 전체 요약 9문장 읽기 → 034 22:26 ▲ 109 · 댓글 5 전자식 메모리가 만든 컴퓨팅: 기계장치는 아니었다 컴퓨터 역사에서 찬스 배비지보다 중요한 것은 전자식 작동 메모리의 발명이다. 기계식 계산기는 17세기부터 존재했고 프로그래밍 개념도 배비지보다 앞서 있었으나, 복잡한 기계에서 데이터를 이동시키는 기술이 병목이었다. 하드웨어 · 시스템 · RAM: the forgotten history (2024)
Key Point 현대 컴퓨터의 기초인 RAM 기술이 배비지의 기계적 설계가 아닌 전자식 메모리 발명에서 비롯되었으며, 릴레이부터 자기코어까지 70년 동안 실용성을 위해 어떤 기술들이 시도되었는지 보여준다.
핵심 요약
컴퓨터 역사에서 찬스 배비지보다 중요한 것은 전자식 작동 메모리의 발명이다. 기계식 계산기는 17세기부터 존재했고 프로그래밍 개념도 배비지보다 앞서 있었으나, 복잡한 기계에서 데이터를 이동시키는 기술이 병목이었다. 초기 전자식 메모리는 릴레이로 구현되었다. 콘라드 추제의 Z3 컴퓨터(1938년경)가 릴레이 기반 메인 메모리를 사용했지만, 전자기 릴레이는 수십 헤르츠 수준의 느린 스위칭 속도로 인해 확장성이 제한적이었다. 진공관을 이용한 더 빠른 메모리 셀이 윌리엄 에클스와 프랭크 조던이 1918년 제안한 쌍안정 회로에서 비롯되었다. 이 SR 래치 아키텍처는 현대의 고속 저전력 SRAM 메모리와 같은 기본 원리를 공유한다. 전체 요약 11문장 읽기 → 035 22:29 당일 +617 AI 스타트업 위한 실시간 사용량 기반 청구 인프라 오픈소스 Flexprice는 AI 네이티브 회사와 SaaS팀을 위한 오픈소스 청구 인프라로, 사용량 기반·크레딧 기반·하이브리드 요금제를 지원하며 실시간 메터링과 보고 기능을 제공한다. 스타트업 · 비즈니스 · flexprice/flexprice · Go
Key Point 개발자가 직접 청구 시스템을 구축했던 번거로움을 없애고, 복잡한 사용량 추적·크레딧 관리·다양한 요금제를 API와 대시보드로 간단히 운영할 수 있도록 설계된 오픈소스 솔루션이 GitHub에서 주목받으며 급속도로 성장하고 있다.
핵심 요약
Flexprice는 AI 네이티브 회사와 SaaS팀을 위한 오픈소스 청구 인프라로, 사용량 기반·크레딧 기반·하이브리드 요금제를 지원하며 실시간 메터링과 보고 기능을 제공한다. 개발자들이 전통 청구 도구의 경직된 기능(사용량 추적, 크레딧 시스템, 기능 제한), 대규모 메터링 구현의 복잡성, 공급업체 종속, 청구 시스템 개발로 인한 상품 개발 지연 등으로 애를 먹는 문제를 해결하도록 설계됐다. Flexprice는 API 우선 설계로 SDK를 통해 사용량 이벤트를 전송하면 집계와 청구 로직을 실시간으로 처리하며, 완전 오픈소스(AGPLv3)로 자체 인프라에서 운영할 수 있어 공급업체 종속에서 벗어날 수 있다. 전체 요약 10문장 읽기 → 036 18:10 ▲ 101 · 댓글 19 LLM을 분류기로 쓰지 말고 피처로 써야 하는 이유 LLM을 직접 분류기로 사용하면 신뢰도 보정, 정보 활용, 해석 가능성 측면에서 문제가 있다. AI · 머신러닝 · LLM Classification Is Feature Engineering
Key Point LLM을 분류 작업에 직접 쓰는 방식의 한계를 짚고 기존 머신러닝 기법과 결합하는 실용적 해법을 제시하므로, 프로덕션 환경에서 LLM 활용 방식을 고민하는 개발자에게 즉시 적용 가능한 인사이트를 준다.
핵심 요약
LLM을 직접 분류기로 사용하면 신뢰도 보정, 정보 활용, 해석 가능성 측면에서 문제가 있다. LLM의 판정을 로지스틱 회귀 같은 머신러닝 모델의 입력 피처로 취급하면 이러한 문제를 해결할 수 있다. 이 방식은 실제 확률값을 제공해 임계값을 조정할 수 있고, 구조화된 데이터와 다른 피처를 함께 활용할 수 있으며, 모델의 기여도를 명확히 볼 수 있다. 전체 요약 4문장 읽기 → 037 03:10 당일 +190 Claude Code의 상태를 한눈에, Claude HUD 플러그인 출시 Claude Code용 플러그인으로, 컨텍스트 사용량, 활성 도구, 실행 중인 에이전트, 할일 진행률을 실시간으로 표시한다. 기타 · jarrodwatts/claude-hud · JavaScript
Key Point Claude Code 사용자가 세션 상태를 실시간으로 모니터링하고, 컨텍스트 부족 전에 미리 파악할 수 있어 장시간 작업 효율을 높일 수 있다.
핵심 요약
Claude Code용 플러그인으로, 컨텍스트 사용량, 활성 도구, 실행 중인 에이전트, 할일 진행률을 실시간으로 표시한다. 터미널 아래에 항상 보이는 상태 표시줄에서 토큰 데이터, 모델명, 프로젝트 경로, 깃 브랜치 정보 등을 네이티브 API로 추출해 렌더링한다. Full, Essential, Minimal 3가지 프리셋으로 시작할 수 있으며, 개별 요소를 토글하거나 색상·임계값 같은 고급 설정을 config.json에서 직접 편집 가능하다. 전체 요약 6문장 읽기 →