쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 22일 (일)까지 5067건
40건 · "음향"조건 지우기 ×
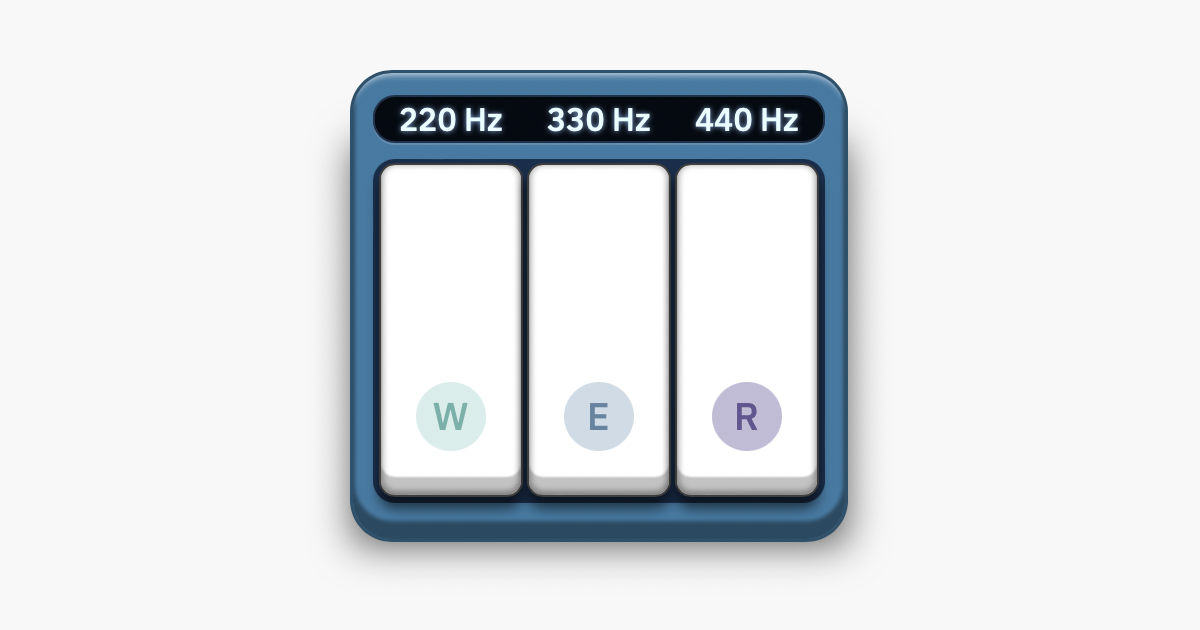
001 03:11 ▲ 124 · 댓글 82 이명의 주파수를 찾아주는 무료 웹 도구 이명은 개인만 들을 수 있는 울림, 쌕소리, 윙윙거리는 음인데 이 도구가 그 주파수를 찾아준다. 기타 · Show HN: Tinnitus frequency finder and audio notch tool
Key Point 이명으로 고생하는 사람들이 자신의 증상을 객관적으로 파악할 수 있는 첫 걸음이 될 수 있으며, 추후 보청기 조정이나 음향 치료 등에 도움이 될 수 있기 때문입니다.
핵심 요약
이명은 개인만 들을 수 있는 울림, 쌕소리, 윙윙거리는 음인데 이 도구가 그 주파수를 찾아준다. 약 4분간의 가이드된 음정 맞추기를 통해 신뢰할 수 있는 범위의 주파수를 제공한다. 귀에 안전한 균등한 음량으로 설정되며, 한 옥타브 혼동을 체크하는 기능이 있다. 전체 요약 5문장 읽기 → 002 03:11 ▲ 150 · 댓글 59 장-미셸 자레의 '옥시젠', 50년을 거쳐 돌비 애터모스로 부활 1976년 프랑스의 28세 젊은 작곡가 장-미셸 자레가 발표한 '옥시젠'은 순수 신스 악기만으로 만든 순수 연주곡으로, 영국 차트에 24주 머물렀고 현재 약 2천만 장이 판매됐다. 오픈소스 · 도구 · The Making of Oxygene
Key Point 클래식 앨범을 멀티트랙 원본에서 복원하는 돌비 애터모스 리믹싱 사례로서, 1976년 아날로그 8트랙 테이프로 만든 획기적 작품을 현대 기술로 어떻게 재탄생시킬 수 있는지 보여준다.
핵심 요약
1976년 프랑스의 28세 젊은 작곡가 장-미셸 자레가 발표한 '옥시젠'은 순수 신스 악기만으로 만든 순수 연주곡으로, 영국 차트에 24주 머물렀고 현재 약 2천만 장이 판매됐다. 자레는 1969년부터 클래식과 록 같은 기존 음악 장르의 한계를 느껴 전자음악으로 눈을 돌렸고, 파리의 뮤지크 콩크레트 연구소(GRM)에서 피에르 셰퍼 같은 거장들과 협력했다. 자레는 작은 부엌 스튜디오에서 VCS3 신스, ARP 2600, EMS Synthi AKS 같은 신스 여러 대와 8트랙 릴 테이프 레코더, 임시방편의 믹서로 '옥시젠' 전곡을 녹음했다. 전체 요약 10문장 읽기 → 003 21:11 ▲ 17 · 댓글 2 멜-스펙트로그램 직접 활용한 자동회귀 음성합성 VoxMel 음성합성에서 자동회귀 모델은 안정적 예측을 위해 압축된 음향 표현이 필요한데, 기존 방식들은 복잡한 신경망 인코더를 사용해 생성 품질을 제한했다. AI · 머신러닝 · VoxMel TTS Technical Report
Key Point 멜-스펙트로그램을 직접 사용해 복잡한 인코더 없이 고품질 음성합성을 가능하게 한 새로운 접근으로, 추론 속도와 품질의 균형을 개선했다.
핵심 요약
음성합성에서 자동회귀 모델은 안정적 예측을 위해 압축된 음향 표현이 필요한데, 기존 방식들은 복잡한 신경망 인코더를 사용해 생성 품질을 제한했다. VoxMel은 토크나이저 없이 고정된 Haar 변환으로 멜-스펙트로그램을 직접 모델링하는 프레임워크로, 이는 정확히 역변환 가능하다. 변환은 먼저 각 멜-스펙트로그램을 주파수 축으로 분해해 국소 평균과 주파수 잔차를 얻고, 평균 성분을 시간 축으로 분해해 Coarse-Mel과 시간 잔차를 얻는다. 전체 요약 7문장 읽기 → 004 03:11 ▲ 108 · 댓글 36 리눅스용 오픈소스 핀볼 시뮬레이션 엔진 개발 중 개발자가 Linux용 완전 오픈소스 핀볼 시뮬레이션 엔진을 만들고 있으며, 2026 IAAPA Expo에서 공개할 예정이다. 오픈소스 · 도구 · I'm Working on a FOSS Linux Pinbal Simulation Engine
Key Point Linux와 오픈소스 커뮤니티에서 아직 부족한 핀볼 시뮬레이션 게임을 처음부터 만드는 프로젝트로, 게임 개발자와 Linux 애호가들에게 새로운 기여 기회를 제공한다.
핵심 요약
개발자가 Linux용 완전 오픈소스 핀볼 시뮬레이션 엔진을 만들고 있으며, 2026 IAAPA Expo에서 공개할 예정이다. 새로운 사운드 시스템은 각 부품별로 음성을 쉽게 추가할 수 있고, 볼 구르는 소리와 슬링샷음 등 물리 기반 음향 감쇄를 지원한다. 물리 엔진을 대폭 개선했으며, 반복 시뮬레이션을 통해 현실감 있는 설정값을 찾아가는 중이다. 전체 요약 10문장 읽기 → 005 18:11 ▲ 144 · 댓글 22 8비트 시대의 극한 최적화, 스택을 이용한 타일 복사 해킹 1980년대 8비트 PC에서 아케이드 게임을 포팅한 프로그래머 친구가 게임의 심각한 속도 문제를 안고 있었다. 하드웨어 · 시스템 · A great old-timey game-programming hack (2013)
Key Point 제한된 하드웨어에서 아이디어를 짜 맞추기 위해 프로세서 레지스터와 스택 메커니즘을 역발상으로 활용한 극단적 최적화의 실제 사례로, 현대적 과최적화와는 다른 필수적 성능 해킹의 본질을 보여준다.
핵심 요약
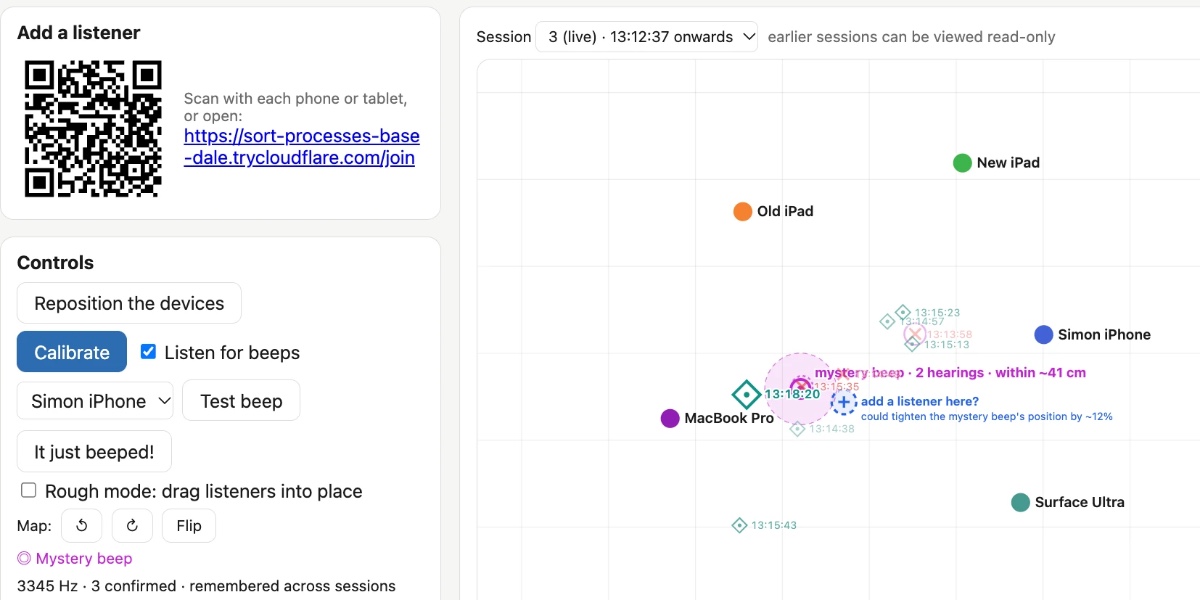
1980년대 8비트 PC에서 아케이드 게임을 포팅한 프로그래머 친구가 게임의 심각한 속도 문제를 안고 있었다. 이미 루프 언롤링과 주소 오프셋 최적화로 행당 98 사이클까지 줄인 타일 복사 루틴을 더 이상 최적화할 수 없었다. 저자는 6809 마이크로프로세서 매뉴얼에서 PSHS(스택에 여러 레지스터 저장) 명령어를 발견했는데, D, X, Y, 그리고 DP 레지스터 4개를 한 번에 6바이트씩 밀어낼 수 있었다. 전체 요약 9문장 읽기 → 006 18:12 ▲ 168 · 댓글 75 AI 음성으로 "정체 모를 소음" 위치 찾다 집의 한 방에서 간헐적으로 울리는 소리의 정체를 파악하기 위해 저자가 Claude Code를 이용해 Beep Locator라는 삼각측량 시스템을 개발했다. AI · 머신러닝 · Locating the source of a mysterious beep
Key Point AI가 코드 작성을 넘어 실시간 센서 데이터를 처리하고 동적으로 자신의 능력을 확장하는 방식을 보여주는 사례로, 코딩 에이전트의 실질적 한계와 가능성을 다룬다.
핵심 요약
집의 한 방에서 간헐적으로 울리는 소리의 정체를 파악하기 위해 저자가 Claude Code를 이용해 Beep Locator라는 삼각측량 시스템을 개발했다. 여러 기기(iPad, 휴대폰, MacBook Pro, Surface Ultra)를 방에 배치해 WebSocket과 웹 마이크를 통해 소리를 감지하고 위치를 계산하는 방식이다. 기기 간 음향 신호로 상대 위치를 자동 계산하되, 수동으로 드래그하는 '러프 모드'를 통해 대략적 위치를 입력하고 정확도를 높인다. 전체 요약 12문장 읽기 → 007 06:11 ▲ 125 · 댓글 39 시각장애 어머니 키패드폰에 안드로이드 16 올린 개발자 시각장애 어머니를 위해 400달러에 구입한 카프시스 스마트비전3 키패드폰이 안드로이드 11에 2024년 4월 보안 패치로 멈춰있고, 앱 충돌로 텔레그램 백그라운드 실행도 불가능했다. 하드웨어 · 시스템 · Porting Android 16 to my blind mother's keypad phone
Key Point 제조사가 불가능하다고 단언한 구형 접근성 폰에 최신 안드로이드를 포팅한 기술적 과정과 경험을 다루며, 시각장애 사용자를 위한 실제 접근성 개선의 맥락을 보여준다.
핵심 요약
시각장애 어머니를 위해 400달러에 구입한 카프시스 스마트비전3 키패드폰이 안드로이드 11에 2024년 4월 보안 패치로 멈춰있고, 앱 충돌로 텔레그램 백그라운드 실행도 불가능했다. 제조사는 안드로이드 12가 '불가능'하다고 주장했지만, JADX 디컴파일과 감시를 통해 카프시스가 libinput.so 시스템 라이브러리에 SV3KeyboardForTalkback 함수를 패칭해 키패드 동작을 구현했음을 발견했다. 라인지OS 23.2(안드로이드 16)를 GSI로 플래시했으나, 서명된 vbmeta 파일 없이 부팅이 거부되고 init이 크래시 로그를 표시하지 않아 문제 해결이 막혔다. 전체 요약 13문장 읽기 → 008 18:15 스타 1,140 AI가 코드로 영상 만든다…cinecode 오픈소스 공개 AI 코딩 에이전트가 영상 제작의 전 과정을 자동화하는 오픈소스 'cinecode'를 깃허브에서 공개했다. AI · 머신러닝 · sarpstar/cinecode · Python
Key Point 코드 기반 영상 자동 제작으로 광고·설명영상·다큐 같은 콘텐츠를 개발자가 직접 만들 수 있게 되며, 이는 영상 제작 진입장벽을 낮추고 반복 제작 업무를 대폭 줄인다.
핵심 요약
AI 코딩 에이전트가 영상 제작의 전 과정을 자동화하는 오픈소스 'cinecode'를 깃허브에서 공개했다. 사용자가 한 문장으로 아이디어를 입력하면 AI가 각본을 작성하고, 모든 프레임을 코드로 렌더링하고, 음향 디자인을 거쳐 MP4 파일을 제공한다. 짧은 영상·장편 다큐·광고·뮤직비디오 등 다양한 포맷을 지원하며, 빠른 모드(약 3분에 완성)와 필름 모드(단계적 검수)로 나뉜다. 전체 요약 9문장 읽기 → 009 18:15 스타 1,578 한 서버에서 돌리는 AI 라이브 진행자 오픈소스 한 대의 서버에서 음성·얼굴·채팅·기억·포스팅을 갖춘 AI 라이브 진행자 시스템 오픈소스 공개했다. AI · 머신러닝 · jacke-pp/open-yoki · JavaScript
Key Point AI 라이브 진행자를 자신의 진행자·음성으로 구축하려는 크리에이터나 스트리머에게 완전한 오픈소스 시스템을 제공하며, 웹3·AI 커뮤니티에서 진행자 자동화 기술의 실제 구현 사례를 보여준다.
핵심 요약
한 대의 서버에서 음성·얼굴·채팅·기억·포스팅을 갖춘 AI 라이브 진행자 시스템 오픈소스 공개했다. 유저 음성을 복제한 성우와 실시간 디지털 아바타로 출연하며, 시청자 댓글을 읽고 답하고, 단골 시청자를 기억하고, 일기를 쓰고, 자동으로 포스팅하고, 정해진 일정에 방송을 시작·종료한다. 바이낸스 광장(또는 RTMP를 받는 모든 플랫폼)과 자체 웹 직방에 동시 송출되며, 헤드리스 Chrome이 16:9 화면(아바타·자막·시세 패널·선물·팔로우 감사·음악·음향 효과)을 생성하고 ffmpeg로 RTMP 푸시한다. 전체 요약 13문장 읽기 → 010 15:11 ▲ 104 · 댓글 2 실시간 음성-영상 화자 추출, 경량화로 엣지 배포 가능해졌다 스트리밍 환경에서 특정 화자의 음성만 추출하는 기술(AVTSE)은 저지연이 필수인데, 기존 방식들은 두 가지 문제를 안고 있었다. AI · 머신러닝 · Efficient Streaming Audio-Visual Target Speaker Extraction for Real-World Acoustic Scenes
Key Point 실시간 음성 처리가 필요한 모바일·임베디드 환경에서 화자 분리의 실용성을 크게 높였으며, 기존 벤치마크의 문제를 해결한 현실적 평가 기준을 제시했다.
핵심 요약
스트리밍 환경에서 특정 화자의 음성만 추출하는 기술(AVTSE)은 저지연이 필수인데, 기존 방식들은 두 가지 문제를 안고 있었다. 첫째, 표준 벤치마크가 화자 2명만 고정하고 실제 환경의 근거리·원거리 간섭음, 음향 반향, 갑작스러운 잡음을 반영하지 않는다. 둘째, 고성능 인과관계 구조는 엣지 기기 배포에 너무 무겁고, 경량 대안도 작은 분리 모델을 반복 호출하면서 이득을 상쇄한다. 전체 요약 8문장 읽기 → 011 06:11 ▲ 187 · 댓글 204 M6 칩 탑재한 신형 14인치 맥북프로 발표 애플이 M6 칩을 탑재한 14인치 맥북프로를 발표했다. 12코어 CPU와 12코어 GPU, 듀얼 16코어 뉴럴 엔진을 갖췄다. 하드웨어 · 시스템 · New 14‑inch MacBook Pro with M6
Key Point M6 칩은 AI 연산 성능을 획기적으로 개선했으며, 24시간 배터리는 맥북 사상 최장 수명이다. 프롬프트 처리 속도 1.3배 향상과 AI 워크로드 전반의 대폭 개선으로, AI 개발자와 크리에이터들의 로컬 LLM 실행 환경이 크게 달라진다.
핵심 요약
애플이 M6 칩을 탑재한 14인치 맥북프로를 발표했다. 12코어 CPU와 12코어 GPU, 듀얼 16코어 뉴럴 엔진을 갖췄다. M5 대비 그래픽 성능 30%, AI 워크로드 성능 25% 향상됐다. M1 대비로는 그래픽 11배, AI 성능 13배 빨라졌다. 시간당 첫 토큰(time to first token) 생성 성능은 M5 대비 1.3배, M1 대비 13배 빠르며, 뉴럴 엔진은 M5보다 1.9배 빠른 이미지 생성·초해상화 처리가 가능하다. 전체 요약 12문장 읽기 → 012 15:11 ▲ 57 · 댓글 2 음성·음악을 입체음향으로 생성·편집하는 AMBIT 프레임워크 공간 음향 제작을 위해 음원 배치와 입체음향 합성을 통합하는 AMBIT 프레임워크를 제안했다. AI · 머신러닝 · Spatial Audio Generation and Editing with Executable Plans and Self-Distilling Transfusion
Key Point 입체음향 생성과 편집을 자동으로 처리하는 통합 프레임워크로, 음성 콘텐츠 제작과 방송·게임·VR 음향 설계에 직접 활용할 수 있기 때문이다.
핵심 요약
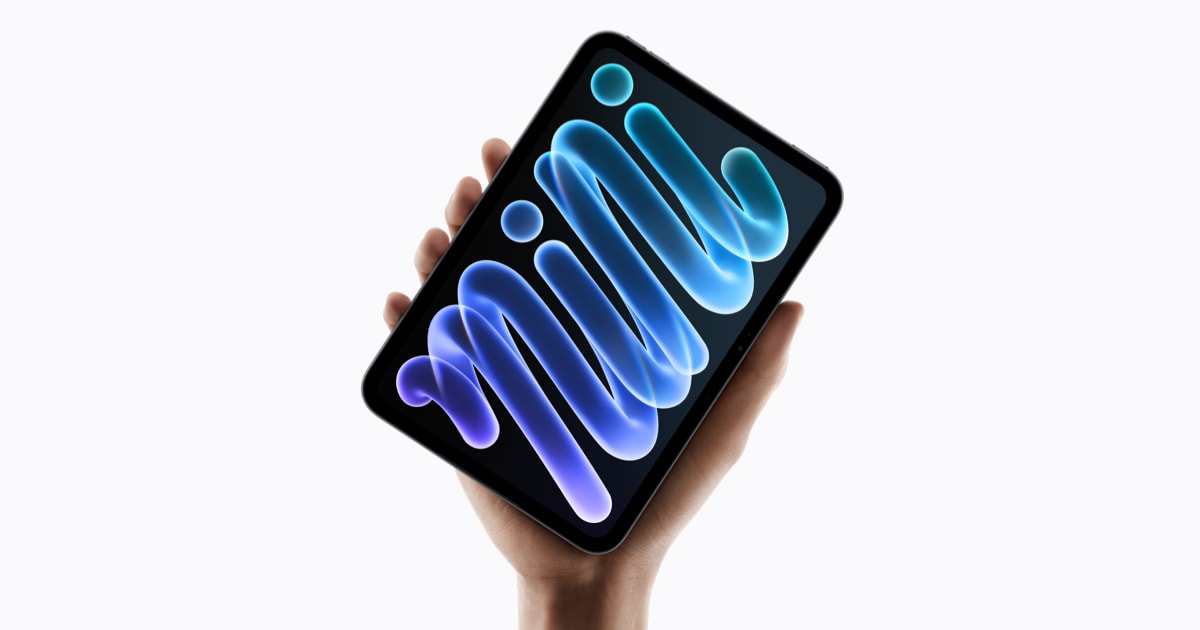
공간 음향 제작을 위해 음원 배치와 입체음향 합성을 통합하는 AMBIT 프레임워크를 제안했다. 음원의 콘텐츠·활동·3D 궤적을 지정하는 ScenePlan을 실행 가능한 형태로 만들고, 자동회귀 계획과 정류 흐름 기반 렌더링을 Transfusion 백본으로 통합했다. 편집 작업 시 계획은 보존할 음원을 포함한 전체 목표 장면을 명시하며, 대조적 특징으로 변경 요청을 정의하고 참조 음성의 레이턴트로 음향 세부사항을 보존한다. 전체 요약 6문장 읽기 → 013 03:12 ▲ 110 · 댓글 107 애플, 신형 아이패드 미니 공개…OLED 화면과 AI 성능 대폭 강화 애플이 10월 26일 신형 아이패드 미니를 발표했으며, 8.5인치 OLED 디스플레이, A20 Pro 칩, IP67 방수·방진 인증이 특징이다. 하드웨어 · 시스템 · The new iPad mini
Key Point 신형 아이패드 미니는 OLED 디스플레이, A20 Pro의 4.5배 AI 성능 향상, IP67 방수 인증으로 소형 태블릿 시장의 기준을 다시 설정하며, 창작자와 야외 작업자들이 갖춰야 할 기기 사양이 크게 달라진다.
핵심 요약
애플이 10월 26일 신형 아이패드 미니를 발표했으며, 8.5인치 OLED 디스플레이, A20 Pro 칩, IP67 방수·방진 인증이 특징이다. 두께 5.4mm로 이전 세대 대비 더 얇고 가벼워졌으며, 베젤이 24% 줄어든 상태에서 디스플레이 크기를 8.5인치로 확대했다. OLED 패널은 피크 밝기 1200nits(이전 대비 2배 이상), 2,000,000:1 명암비, 1nit 최소 밝기를 지원하며, 선택사항으로 반사 감소 나노텍스처 옵션을 제공한다. 전체 요약 14문장 읽기 → 014 00:11 ▲ 31 · 댓글 1 알리바바 Qwen-Audio-3.1-ASR, 화자 식별과 음성 분석 강화 알리바바의 Qwen-Audio-3.1-ASR은 이전 버전의 음성 인식을 개선하고 화자 분리 전사, 일반 오디오 이해 기능을 추가한 오디오-언어 모델 제품군이다. AI · 머신러닝 · Qwen-Audio-3.1-ASR Technical Report
Key Point 음성 인식이 단순 전사를 넘어 화자 식별, 음악·음성 분석까지 통합하는 추세를 보여주며, 다양한 배포 환경을 지원하는 확장성이 실무 적용의 핵심이다.
핵심 요약
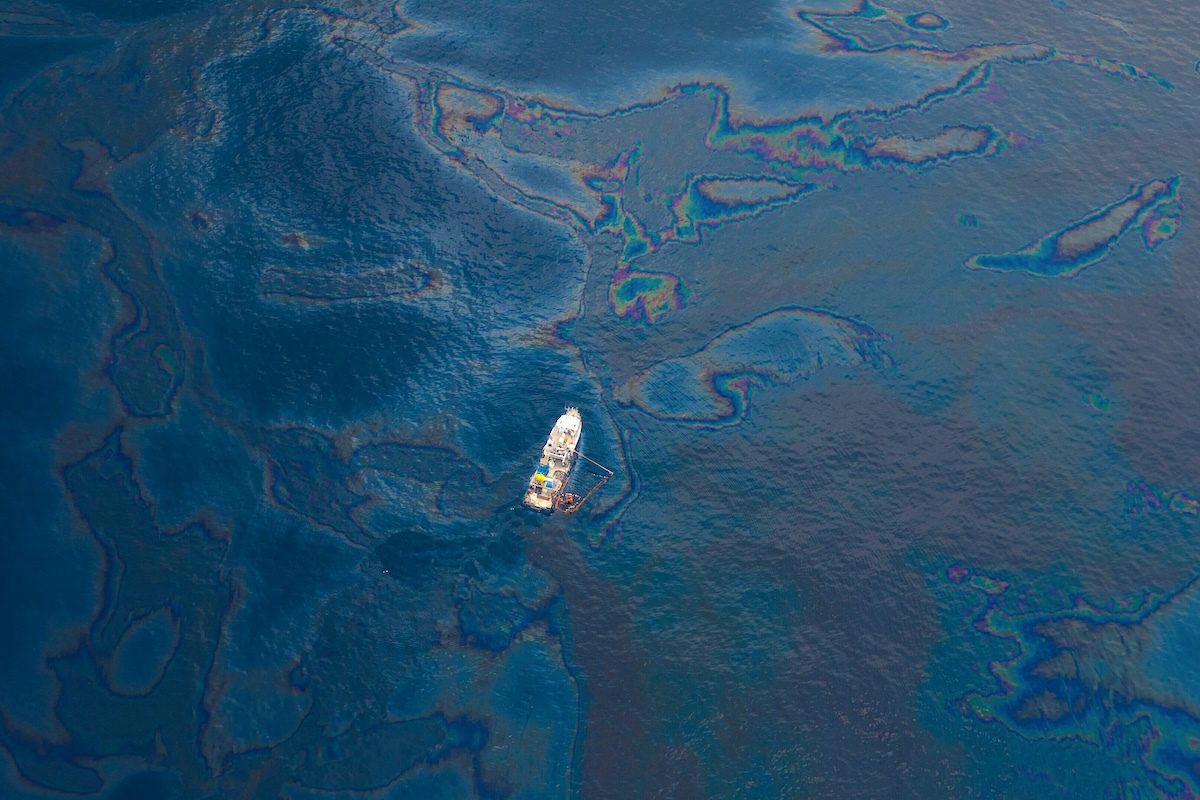
알리바바의 Qwen-Audio-3.1-ASR은 이전 버전의 음성 인식을 개선하고 화자 분리 전사, 일반 오디오 이해 기능을 추가한 오디오-언어 모델 제품군이다. 30개 언어와 16개 중국 방언을 지원하며, 이전 발화 맥락 반영, 계층형 핫워드 커스터마이징, 자동 전사 보정 등 명령 제어 기능을 제공한다. 화자 분리 ASR은 화자 레이블, 타임스탐프, 인식된 텍스트를 포함한 구조화된 출력을 생성하며, 턴 전체에 걸쳐 일관된 화자 레이블을 유지하고 겹치는 음성을 표현한다. 전체 요약 6문장 읽기 → 015 09:11 ▲ 163 · 댓글 103 심해 생물 16년 후에도 못 회복…쿠더호라이즌 참사의 유산 2010년 딥워터호라이즌 석유 굴착 장치 폭발로 400만 배럴 이상의 석유가 멕시코만으로 유출된 지 16년이 지났으나 심해 생물의 회복 징후가 거의 보이지 않는다. 기타 · Sixteen Years After Deepwater Horizon, Deep Sea Life Shows Few Signs of Recovery
Key Point 16년 전 발생한 대형 환경 재해가 현재까지 심해 생태계에 얼마나 깊은 흔적을 남겼는지, 복구 가능성이 얼마나 제한적인지를 보여주는 구체적인 과학 데이터입니다.
핵심 요약
2010년 딥워터호라이즌 석유 굴착 장치 폭발로 400만 배럴 이상의 석유가 멕시코만으로 유출된 지 16년이 지났으나 심해 생물의 회복 징후가 거의 보이지 않는다. 음향 조사와 수천 개의 표본 채집을 통한 신규 연구에서 폭발 후 초기 몇 년간 문어, 오징어, 크릴, 새우, 등롱어 개체군이 최소 60% 감소했음을 확인했다. 이 연구는 국립과학원 회보에 발표되었으며, 수심 약 600피트에서 2마일 이상의 심해층에서 관찰된 동물 생명의 감소를 '가장 빠르고 심각한' 쇠퇴라고 묘사했다. 전체 요약 7문장 읽기 → 016 00:11 ▲ 10 · 댓글 2 음성-영상 일관성을 평가하는 'AVC-Reward' 모델 제시 음성-영상 동시 생성 모델이 발전하면서 복수 이벤트 구성, 다층 음향 혼합, 비대칭 교차모달 관계 등 복잡한 장면을 생성할 수 있게 됐지만, 기존 평가 지표는 단순한 일방향 작업에서 파생되어 이런 복잡한 시나리오에 부적합하다. AI · 머신러닝 · AVC-Reward: Event-Centric Audio-Video Consistency Evaluation
Key Point 음성-영상 생성 모델의 평가 방식이 모델 성능 향상 속도를 따라가지 못하고 있는 가운데, 복잡한 멀티모달 콘텐츠를 정확히 평가할 수 있는 새로운 지표가 제시된 점이 중요합니다.
핵심 요약
음성-영상 동시 생성 모델이 발전하면서 복수 이벤트 구성, 다층 음향 혼합, 비대칭 교차모달 관계 등 복잡한 장면을 생성할 수 있게 됐지만, 기존 평가 지표는 단순한 일방향 작업에서 파생되어 이런 복잡한 시나리오에 부적합하다. 논문은 이벤트 단위로 음성과 영상 이벤트를 분리하고 각각을 독립 분석하며 모달리티 간 관계를 교차검증한 뒤, 결과를 3단계 일관성 지표로 집계하는 이벤트 중심 평가 프레임워크를 제안한다. 이 지표는 전체 서사 조화도, 이벤트 단위 시간 동기화, 세부 속성 정렬을 평가한다. 전체 요약 6문장 읽기 → 017 21:11 ▲ 18 · 댓글 2 Fish Audio Drama 3, 자연어 지시로 성우 같은 음성 생성 텍스트를 연기하는 형태의 음성으로 변환하는 오픈소스 모델 Fish Audio Drama 3을 공개했다. AI · 머신러닝 · Fish Audio Drama 3 Technical Report
Key Point 단일 모델로 음성 복제, 자연어 지시, 멀티턴 편집, 장면 더빙을 모두 지원하며 파라미터 대비 빠른 추론 속도를 달성한 기술적 진전이 실제 음성 생성·편집 워크플로를 어떻게 단순화할지 확인할 수 있다.
핵심 요약
텍스트를 연기하는 형태의 음성으로 변환하는 오픈소스 모델 Fish Audio Drama 3을 공개했다. 35B 파라미터 혼합 전문가 구조에 토큰당 3B 파라미터만 활성화하며, 여러 참조에서 목소리를 복제하고 자연어 지시에 따른다. 다음 턴의 피드백으로 테이크를 수정하고, 여러 캐릭터 장면에 음성을 부여하며, 기존 음성을 인필로 편집하고 장시간·스트리밍 오디오를 합성한다. 전체 요약 8문장 읽기 → 018 18:11 ▲ 110 · 댓글 17 소리의 과학을 인터랙티브하게 배우는 가이드 소리는 공기 입자의 압력 변화로 발생하며, 개별 분자들은 실온에서 초당 460m의 속도로 움직인다. 기타 · Sound – Bartosz Ciechanowski (2022)
Key Point 소리가 어떻게 생성·전파되고 인지되는지 물리적 원리를 인터랙티브 시뮬레이션으로 직관적으로 이해할 수 있어, 음향 공학이나 오디오 처리를 배우는 개발자의 기초 학습 자료가 될 수 있다.
핵심 요약
소리는 공기 입자의 압력 변화로 발생하며, 개별 분자들은 실온에서 초당 460m의 속도로 움직인다. 진동하는 물체가 공기를 압축·팽창시키면 압력 파동이 생성되고, 이것이 귀에 도달할 때 소리로 인지된다. 진동판의 움직임 크기(진폭)는 음량을, 진동 빈도(주파수)는 음높이를 결정한다. 전체 요약 8문장 읽기 → 019 03:11 ▲ 164 · 댓글 327 애플, AI 기능 강화한 새 Apple TV 4K 공개 애플이 10월 13일 차세대 Apple TV 4K(4세대)를 발표했으며, 11월 13일부터 판매된다. AI · 머신러닝 · New Apple TV 4K
Key Point 애플의 주요 가정용 기기에 생성형 AI 기능이 본격 적용되는 사례로, 음성 인터페이스와 홈 자동화가 어떻게 진화하고 있는지 보여준다.
핵심 요약
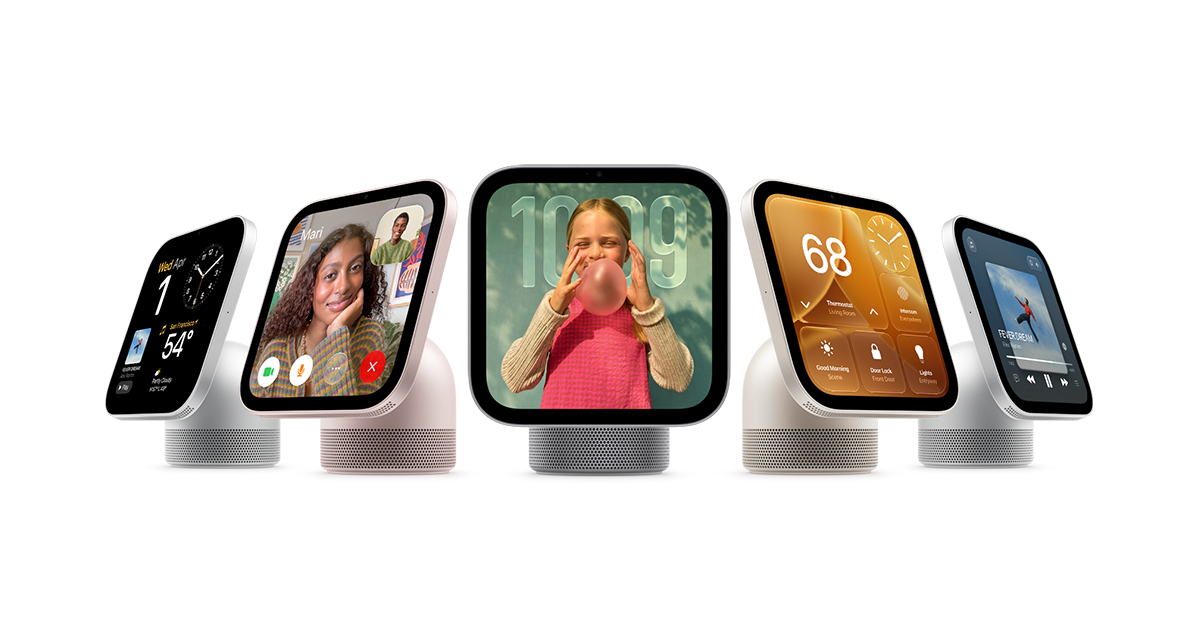
애플이 10월 13일 차세대 Apple TV 4K(4세대)를 발표했으며, 11월 13일부터 판매된다. 신형 기기는 Siri AI를 탑재해 사용자가 영화·드라마를 찾고 발견하는 경험을 전체 화면 대화형 인터페이스로 제공한다. Siri AI는 애플 인텔리전스 기반으로 더 강력해졌으며, 개인 맥락을 이해해 '알린다가 추천한 쇼 재생'처럼 기기 간 요청을 처리할 수 있다. 전체 요약 13문장 읽기 → 020 00:11 ▲ 236 · 댓글 268 애플, 스마트홈 허브 'HomeView' 11월 13일 출시 애플이 7인치 액정 레티나 디스플레이를 갖춘 스마트홈 허브 'HomeView'를 11월 13일부터 선주문 받으며 A18칩을 탑재했다. 하드웨어 · 시스템 · Apple HomeView
Key Point HomeView는 프라이버시 보호와 다중 사용자 지원을 강조한 애플의 스마트홈 허브로, 기존 제품과 달리 Secure Enclave를 통해 개인 데이터가 OS에 노출되지 않으며 최대 6명의 사용자를 분리해 관리할 수 있다는 점이 핵심이다.
핵심 요약
애플이 7인치 액정 레티나 디스플레이를 갖춘 스마트홈 허브 'HomeView'를 11월 13일부터 선주문 받으며 A18칩을 탑재했다. HomeView는 최대 6명까지 인식해 각 사용자별 맞춤형 경험을 제공하고, 개별 사용자의 개인 정보는 분리·보호된다. Apple Intelligence 기반 Siri AI가 내장되어 있으며, 개인 맥락·세계 지식·자연스러운 대화 형식으로 음성 어시스턴트 역할을 한다. 전체 요약 13문장 읽기 → 021 15:11 ▲ 39 · 댓글 2 음성·음악 분리와 생성을 한 번에, 오디오-비디오 AI 모델 SepGen 음성-영상 생성 모델을 확장하여 비디오, 혼합 사운드트랙, 각 음원별 개별 스템을 한 번의 샘플링으로 출력하는 SepGen을 제시한다. AI · 머신러닝 · SepGen: Multi-Stem Audio-Video Separation and Generation in a Single Model
Key Point 비디오에서 개별 음원을 자동 분리·생성할 수 있게 되면 3D 음성화(audio spatialization)나 음향 편집 등 실제 영상 제작 워크플로우가 단순해질 수 있으며, 기존 단순 음성 분리 모델을 능가하는 성능을 보인다.
핵심 요약
음성-영상 생성 모델을 확장하여 비디오, 혼합 사운드트랙, 각 음원별 개별 스템을 한 번의 샘플링으로 출력하는 SepGen을 제시한다. 생성 모드에서는 각 음원 캡션이 해당 스템의 내용을 지정하며, 예를 들어 두 명의 대사는 각 화자마다 하나의 스템으로 원래 순서대로 분리된다. 분리 모드에서는 입력 오디오 혼합을 유지하면서 캡션으로 추출할 내용을 지정하여, 자유형식 설명으로부터 녹음을 분해할 수 있다. 전체 요약 6문장 읽기 → 022 12:11 ▲ 107 · 댓글 34 상용 공간 오디오 필터를 역공학으로 복제하다 Linux에서 사용할 간단한 공간 오디오 효과 프로그램을 만들기 위해 상용 프로그램을 분석했다. 인프라 · 데브옵스 · How I reverse engineered a commercial spatial audio effect
Key Point 복잡한 신호처리 알고리즘을 역공학하는 체계적 방법론을 제시하며, 이론과 실측을 결합한 실무적 접근이 개발자들의 음향 프로그래밍 방식에 참고할 만하다.
핵심 요약
Linux에서 사용할 간단한 공간 오디오 효과 프로그램을 만들기 위해 상용 프로그램을 분석했다. 처음에는 HRTF(머리 관련 전달 함수)와 심리음향 기법을 시도했지만 LLM의 이론적 설명만으로는 개선 방법을 찾을 수 없었다. 대신 프로그램의 정확한 내부 알고리즘을 이해하기보다 필터의 실제 동작을 측정·분석하는 방식으로 전환했다. 전체 요약 8문장 읽기 → 023 21:11 당일 +237 영상 자동 생성, 이제 AI 편집기에 장착한다 Claude Code나 Codex용 AI 에이전트 스킬로, 제품 스크린샷과 설명을 입력하면 Remotion 기반 영상을 자동 제작하는 도구다. AI · 머신러닝 · Vincentwei1021/video-shotcraft · TypeScript
Key Point AI가 제품 영상을 완전 자동으로 제작하고 웹에서 바로 편집할 수 있는 프로덕션 도구가 오픈소스로 공개됐으며, 기업 마케팅 영상 제작 방식이 크게 바뀔 가능성을 보여준다.
핵심 요약
Claude Code나 Codex용 AI 에이전트 스킬로, 제품 스크린샷과 설명을 입력하면 Remotion 기반 영상을 자동 제작하는 도구다. 152장의 샷 레시피 카드, 214개 모션 프리뷰, 9가지 필름 테마(Ink Press, Modern Light, Midnight 등)를 제공한다. 스토리보딩, 2.5D 카메라 움직임, 비트 싱크 컷, 영화급 음향 설계가 자동으로 적용되며, 템플릿은 36.2초 1920×1080 30fps 완성본으로 검증됐다. 전체 요약 11문장 읽기 → 024 18:30 ▲ 33 · 댓글 2 세계 모델에 소리를 더하는 'WorldSonus' 논문 공개 월드 모델이 생성한 시각적 환경에 실시간 공간음향을 합성하는 'WorldSonus' 프레임워크를 제시했다. AI · 머신러닝 · WorldSonus: Bringing Sound to Worlds
Key Point 기존 월드 모델은 시각만 생성했지만, WorldSonus는 실시간 상호작용형 공간음향 합성으로 생성 환경의 완전성을 한 단계 높였다.
핵심 요약
월드 모델이 생성한 시각적 환경에 실시간 공간음향을 합성하는 'WorldSonus' 프레임워크를 제시했다. 실시간 생성을 위해 스트리밍 인과 자기회귀 확산 구조를 사용해 RTF 0.41의 저지연으로 오디오 청크를 합성한다. 대화형 제어는 오디오 중심의 캡셔닝 파이프라인과 청크 인덱스 프롬프트 스케줄링으로 생성 도중 음향 이벤트를 동적으로 조작할 수 있다. 전체 요약 5문장 읽기 → 025 18:33 ▲ 109 · 댓글 83 오스트리아 기업, 세계 첫 완전 내재형 인공와우 상용화 오스트리아의 메드-엘이 외부 부품이 없는 완전 내재형 인공와우 'TICI Unico'를 상용 출시했으며, 유럽 규제 승인을 받고 발표 당일 4명의 환자에게 시술했다. 하드웨어 · 시스템 · The first fully implanted cochlear implant reaches patients
Key Point 청각장애인의 삶의 질을 바꿀 혁신 의료기기가 처음 상용화된 사례로, 30년 만의 인공와우 분야 의미 있는 진전이자 관련 업계 경쟁을 촉발할 신호탄이다.
핵심 요약
오스트리아의 메드-엘이 외부 부품이 없는 완전 내재형 인공와우 'TICI Unico'를 상용 출시했으며, 유럽 규제 승인을 받고 발표 당일 4명의 환자에게 시술했다. 기존 인공와우는 귀 뒤에 마이크·음성 처리기·배터리가 담긴 외부 장치를 착용하고 무선으로 신호를 전송하는 방식이었으나, TICI Unico는 모든 부품을 두피 아래 6mm 깊이에 매립한다. 장치는 20g 무게이며 5유로센트 동전 크기의 피부 내재형 마이크, 우편 스탬프 크기의 음성 처리·배터리 장치, 데이터 전송용 코일, 와우 내 전극 배열로 구성된다. 전체 요약 10문장 읽기 → 026 03:11 ▲ 32 · 댓글 2 영상과 소리를 함께 생성하는 실시간 세계 모델 HelixWorld 기존 세계 모델은 영상만 렌더링했지만, HelixWorld는 사용자 상호작용 하에서 카메라 관점의 영상과 공간 입체음향이 함께 진화하는 실시간 오디오-비주얼 세계 모델이다. AI · 머신러닝 · HelixWorld: A Real-time Interactive Audio-Visual World Model
Key Point 기존의 침묵한 세계 모델에 처음으로 실시간 공간 음향을 추가하여, 메타버스·게임 엔진·3D 시뮬레이션에서 멀티센서 상호작용의 새로운 기준을 제시한다.
핵심 요약
기존 세계 모델은 영상만 렌더링했지만, HelixWorld는 사용자 상호작용 하에서 카메라 관점의 영상과 공간 입체음향이 함께 진화하는 실시간 오디오-비주얼 세계 모델이다. 진정한 입체 음향과 카메라 메트릭 포즈를 갖춘 고충실도 공간 오디오-비주얼 데이터셋을 구축하고, 6-DoF 카메라 궤적과 사용자 액션을 조건으로 하는 양방향 교사 모델을 사전학습했다. 저지연 인과적 상호작용을 위해 온라인 궤적 증류 손실을 통해 교사 모델을 소수 단계의 스트리밍 학생 모델로 증류하여, 단일 GPU에서 초당 24 프레임의 드리프트 없는 오디오-비주얼 롤아웃을 유지한다. 전체 요약 5문장 읽기 → 027 00:11 ▲ 15 · 댓글 3 오디오와 비디오를 선택적으로 검색하는 추론 AI Omni-LLM을 기반으로 한 OmniSeek은 긴 오디오-비주얼 시퀀스를 통째로 처리하지 않고, 필요한 증거만 동적으로 선택해 검색하는 다중 턴 추론 에이전트이다. AI · 머신러닝 · OmniSeek: Native Tool Integration for Multi-turn Audio-Visual Reasoning
Key Point 더 긴 멀티미디어 콘텐츠를 효율적으로 분석하고 필요한 부분만 집중하는 AI의 접근 방식이 어떻게 작동하는지 보여주기 때문이다.
핵심 요약
Omni-LLM을 기반으로 한 OmniSeek은 긴 오디오-비주얼 시퀀스를 통째로 처리하지 않고, 필요한 증거만 동적으로 선택해 검색하는 다중 턴 추론 에이전트이다. 모델은 언제 보고 언제 들을지, 어느 시간 구간을 살펴볼지를 스스로 결정하며, 검색한 원본 오디오나 비주얼 세그먼트를 다시 컨텍스트에 추가해 다음 단계 추론을 지원한다. 이 능력을 학습시키기 위해 교차 모달리티 증거를 포함한 다중 홉 사고의 연쇄 궤적 17만 개(OmniTraj-170K)로 구성된 데이터셋을 합성했다. 전체 요약 5문장 읽기 → 028 00:11 ▲ 12 · 댓글 2 음성 AI가 정말 듣고 행동할까? 음성 에이전트의 맥락 인식 검진 음성 LLM은 음성 명령을 인식하고 도구를 실행할 수 있지만, 먼저 현재 음향 및 대화 맥락이 행동을 정당화하는지 판단해야 한다. AI · 머신러닝 · Do Audio LLMs Listen Before They Act? Diagnosing Acoustic-Context Gating in Voice Agents
Key Point 음성 에이전트가 의도한 사용자의 명령만 수행하고 옆사람의 말은 무시해야 하는데, 현재 모델들이 대부분 이를 제대로 못 하고 있다는 점을 실증적으로 보여준다.
핵심 요약
음성 LLM은 음성 명령을 인식하고 도구를 실행할 수 있지만, 먼저 현재 음향 및 대화 맥락이 행동을 정당화하는지 판단해야 한다. 연구팀은 VGBench라는 1,018개 항목의 진단 벤치마크를 제시했으며, 옆에서의 대화, 혼잣말, 화자 전환 시나리오에서 행동 수준의 적절성을 평가한다. 각 항목은 침묵, 도구 호출, 자연어 응답으로 구성된 공유 행동 공간을 사용하며, 화자 전환 쌍은 음원 거리 및 시간 경계를 제어하면서 착용자에서 방관자로의 전환을 테스트한다. 전체 요약 8문장 읽기 → 029 06:11 당일 +357 Rust로 쓰고 GPU로 렌더링하는 고속 영상 프레임워크 fframes 프로그래밍 방식으로 영상을 렌더링하는 Rust 기반 프레임워크로, Rust와 SVG로 영상을 작성하고 GPU(Metal/Vulkan)로 렌더링한다. 오픈소스 · 도구 · dmtrKovalenko/fframes · Rust
Key Point AI 에이전트가 자동으로 고품질 영상을 생성할 수 있는 프로그래밍 프레임워크로, 영상 자동화 워크플로우가 필요한 개발자와 모션 디자인 팀에게 실질적인 생산성 향상을 제공한다.
핵심 요약
프로그래밍 방식으로 영상을 렌더링하는 Rust 기반 프레임워크로, Rust와 SVG로 영상을 작성하고 GPU(Metal/Vulkan)로 렌더링한다. AI 에이전트가 자동으로 영상을 생성할 수 있도록 설계되었으며, 에이전트가 읽을 수 있는 형태의 프레임 정보·텍스트·수치를 출력하는 inspect, strip, frame, audio analyze 등의 명령줄 도구를 제공한다. 정적 마크업은 컴파일 타임에 캐싱되고, ffmpeg의 libav 라이브러리를 직접 링크하며, SkSL과 GLSL 셰이더를 레이어로 사용할 수 있어 CPU 기반 렌더링 대비 약 10배 빠르다. 전체 요약 13문장 읽기 → 030 15:11 ▲ 126 · 댓글 2 음성 대화형 AI의 기억 능력을 측정하는 VoxMem 벤치마크 공개 음성 대화 시스템은 이전 상호작용 정보를 회상해야 하는데, 기존 벤치마크는 발화 내용만 평가하고 화자 정체성·억양·배경음 같은 음성 고유 정보는 무시했다. AI · 머신러닝 · VoxMem: Benchmarking Multimodal Memory in Large Audio Language Models
Key Point 현재 음성 AI 모델이 화자, 감정, 배경 정보 같은 음성 고유 신호는 제대로 인식하지 못하고 있으며, 이를 체계적으로 측정할 벤치마크가 처음 제시되었습니다.
핵심 요약
음성 대화 시스템은 이전 상호작용 정보를 회상해야 하는데, 기존 벤치마크는 발화 내용만 평가하고 화자 정체성·억양·배경음 같은 음성 고유 정보는 무시했다. 연구팀은 기억 평가를 위해 보존할 음향 증거와 적용할 메모리 연산 두 축으로 분류 체계를 제안했다. VoxMem은 34,743개 음성 세션(177시간)의 3,196개 평가 사례로 구성되며, 음성 의미·화자 정체성·병렬언어학 신호·환경음의 4가지 증거 타입과 정보 추출·다중 세션 추론·시간 추적·답변 거부의 4가지 메모리 연산을 다룬다. 전체 요약 8문장 읽기 → 031 18:11 ▲ 135 · 댓글 15 황금비 나선 패턴의 오디오 반응형 LED 조각 만들기 자연의 해바라기 중심부에 나타나는 황금비 나선(phyllotaxis) 패턴을 코드로 구현하고, Voronoi 분할로 셀 모양을 만든 후 89개의 RGB LED를 각 셀에 배치한 물리적 LED 매트릭스 프로젝트이다. 하드웨어 · 시스템 · Phyllotaxis: An audio-reactive LED display
Key Point 자연의 패턴을 코드와 하드웨어로 구현하는 풀스택 프로젝트의 구체적인 설계·제작·문제 해결 과정을 배울 수 있으며, 3D 프린팅부터 PCB 설계, 마이크로컨트롤러 프로그래밍까지 다양한 기술 스택의 실전 활용 사례를 보여준다.
핵심 요약
자연의 해바라기 중심부에 나타나는 황금비 나선(phyllotaxis) 패턴을 코드로 구현하고, Voronoi 분할로 셀 모양을 만든 후 89개의 RGB LED를 각 셀에 배치한 물리적 LED 매트릭스 프로젝트이다. Processing으로 셀 데이터를 추출하고 CadQuery로 3D 모델을 생성한 뒤, FreeCAD에서 마무리하여 4개 사분면으로 나누어 3D 프린트했으며, 반투명 뽕나무 종이를 앞면에 붙여 빛을 자연스럽게 확산시킨다. STM32 Blackpill 보드와 SPI 기반 Neopixel 드라이버로 LED를 제어하며, Processing 스타일의 셰이더 코드로 패턴을 작성할 수 있는 프레임워크를 구축했다. 전체 요약 10문장 읽기 → 032 12:11 ▲ 198 · 댓글 3 음악 생성 AI의 상징과 음향 통합한 YuE2 등장 Hugging Face와 arXiv 논문으로 공개된 YuE2는 악보 기반 계획을 통해 기호 음악과 오디오 음악 생성을 단일 모델로 통합했다. AI · 머신러닝 · YuE2: Unifying Symbolic and Audio Music Generation at Frontier Quality
Key Point 악보라는 명시적 중간 단계를 통해 AI 음악 생성의 투명성과 편집 가능성을 확보하면서도 상용 서비스와 경쟁할 수 있는 품질을 달성했기 때문이다.
핵심 요약
Hugging Face와 arXiv 논문으로 공개된 YuE2는 악보 기반 계획을 통해 기호 음악과 오디오 음악 생성을 단일 모델로 통합했다. AR-NAR Mixture-of-Transformers(MoT) 아키텍처를 사용하며, 악보로 멜로디와 화성을 지정한 뒤 의미론적 음악 토큰으로 확장해 전곡 오디오를 생성한다. 전문가 평가에서 악보 기반 계획이 49.3%의 선호도를 기록해 계획 없는 생성의 34.6%를 앞질렀으며, 음악성과 전체 품질에서 우수했다. 전체 요약 9문장 읽기 → 033 09:11 ▲ 148 · 댓글 67 Flock 감시 카메라 30만 대 규모 지도 공개, 회사는 내려달라 요청 보안 연구자 조슈아 마이클이 Flock의 내부 데이터베이스 좌표를 바탕으로 전국 30만 대의 Flock 감시 장비 위치를 표시한 지도를 공개했다. 보안 · Flock Wants the Most Detailed Map of Its Surveillance Cameras Taken Offline
Key Point Flock이 공식 발표한 수치보다 2.5배 많은 30만 개의 감시 장비 규모와 보안 취약점 노출, 그리고 회사의 투명성 문제가 상원 청문회 주제로도 다뤄지고 있기 때문에, 미국 대규모 감시 인프라의 현황을 이해하는 데 필수적이다.
핵심 요약
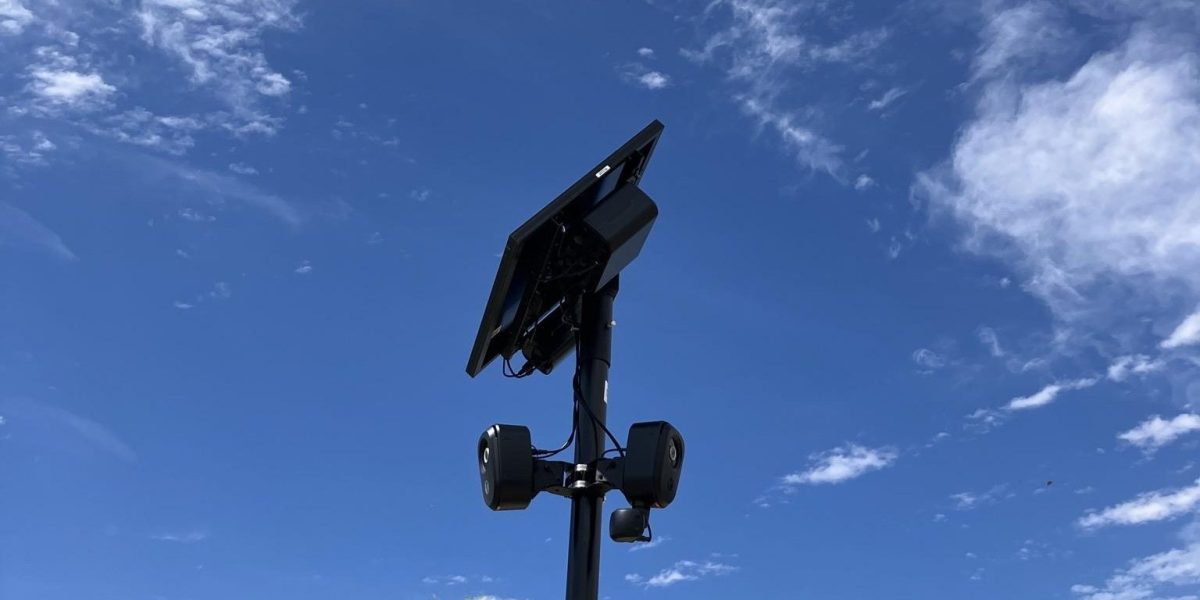
보안 연구자 조슈아 마이클이 Flock의 내부 데이터베이스 좌표를 바탕으로 전국 30만 대의 Flock 감시 장비 위치를 표시한 지도를 공개했다. 지도는 17만 개 이상의 카메라, 13만 개 이상의 보조 장비(음향 감지 장치 2만 7천 대 포함)를 포함하며, 이는 Flock이 공식 발표한 12만 대보다 훨씬 많다. 마이클은 2025년 11월 Flock 서버가 인증 없이 접근 가능한 토큰을 공개적으로 유출하고 있음을 발견했고, 이를 통해 ArcGIS 플랫폼에서 장비 위치 데이터를 조회할 수 있었다. 전체 요약 10문장 읽기 → 034 03:11 ▲ 135 · 댓글 30 영화 복원을 둘러싼 팬 해킹과 공식 제작사의 경합 스튜디오의 개작된 영화 버전만 정식 출시되는 현실 속에서, 팬 커뮤니티가 불법 리핑과 음원 결합으로 영화의 원본에 가까운 복원을 추진하고 있다. 오픈소스 · 도구 · Pirating the Pirates
Key Point 영화 저작권 보호와 역사 보존이 충돌할 때, 팬 커뮤니티의 불법 활동이 공식 복원 기관의 한계를 메우고 있는 현실을 보여준다.
핵심 요약
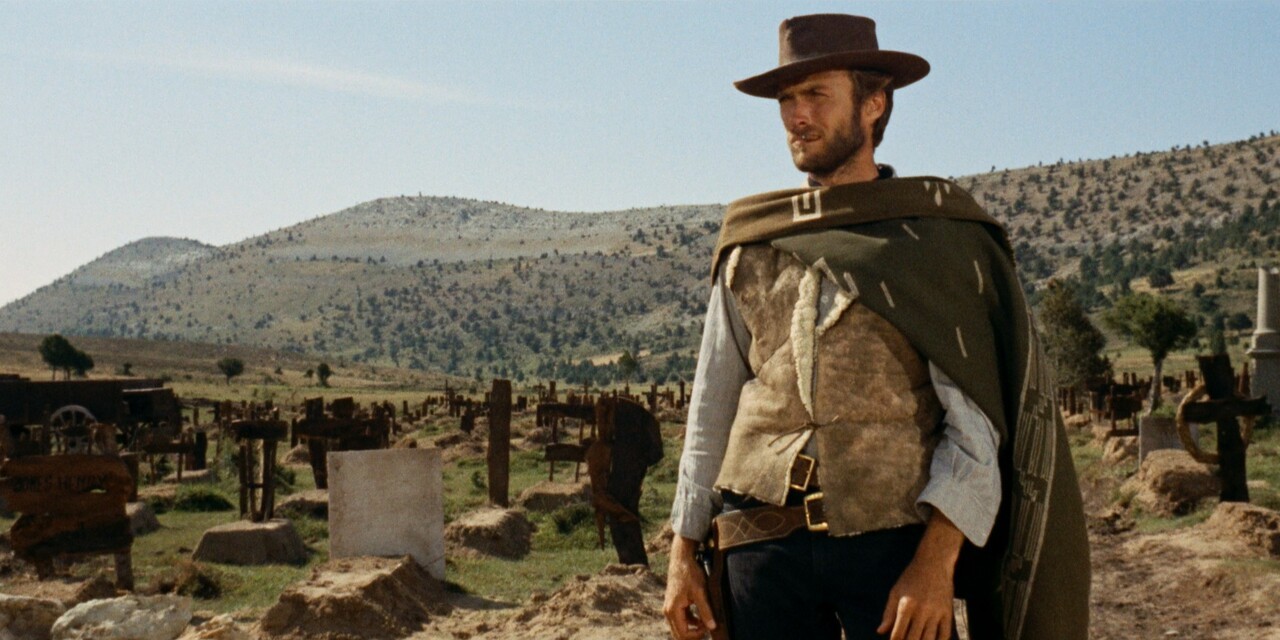
스튜디오의 개작된 영화 버전만 정식 출시되는 현실 속에서, 팬 커뮤니티가 불법 리핑과 음원 결합으로 영화의 원본에 가까운 복원을 추진하고 있다. 1960년대 영화 《황금의 삼각지대》의 경우 MGM 복원본이 원본 161분에서 179분으로 늘어나고 음향이 현대식으로 리믹스되자, 팬들이 1998년 DVD와 이탈리아판 블루레이를 결합해 더 정확한 버전을 만들었다. 대형 스튜디오는 예산·일정 제약, 감독의 수정 요구, 마케팅 필요성 때문에 원본 버전 공개를 거부하거나 불가능하게 한다. 전체 요약 8문장 읽기 → 035 12:11 ▲ 102 · 댓글 16 게임 UX에서 배우는 앱 디자인의 6가지 법칙 게임 디자이너 Raph Koster의 '게임의 재미 이론'에서 영감을 얻어 앱 UX 디자인에 적용할 수 있는 6가지 렌즈를 제시한다. 웹 · 프론트엔드 · How video games inspire great UX (2019)
Key Point 모바일 앱과 웹 UX 디자인에서 정체된 패턴을 벗어나는 구체적인 설계 원칙을 게임에서 찾는 이유를 명확히 보여준다.
핵심 요약
게임 디자이너 Raph Koster의 '게임의 재미 이론'에서 영감을 얻어 앱 UX 디자인에 적용할 수 있는 6가지 렌즈를 제시한다. 렌즈 1: 스토리 vs 내러티브 - 디자이너가 만드는 선형적 경로(A→B→C)와 달리 사용자는 자신만의 내러티브를 구성한다. 앱에서는 기능들을 단순히 나열하지 말고 사용자가 경험을 회상할 때 만드는 이야기를 의도적으로 유도해야 한다. 렌즈 2: 게임은 프랙탈 구조 - 프로그 게임처럼 각 동작(조이스틱 조작→캐릭터 이동→차선 횡단)이 자신만의 피드백 체계를 가진 계층적 구조로 되어있다. 앱도 단순히 가이드라인을 따르기만 하지 말고 각 인터랙션을 상세히 분해하고 개선해야 한다. 전체 요약 8문장 읽기 → 036 06:11 ▲ 101 · 댓글 33 Casio CZ-101 신스, 웹 기반으로 완전 재현 CZP-1은 Casio CZ-101 신스를 웹 페이지에서 구현한 프로젝트로, 브라우저에서 같은 음색과 기능을 제공한다. 웹 · 프론트엔드 · Boards of Casio
Key Point AI 도움으로 과거 불가능했던 하드웨어 데이터 변환이 5분 만에 가능해졌으며, 웹으로 복제한 신스가 URL 기반 음색 공유를 어떻게 구현했는지 보여주는 기술 사례이다.
핵심 요약
CZP-1은 Casio CZ-101 신스를 웹 페이지에서 구현한 프로젝트로, 브라우저에서 같은 음색과 기능을 제공한다. oliveoil22의 유튜브 영상에서 영감을 얻어, 해당 채널에서 공유한 CZ-101 패치 데이터를 CZP-1에 로드할 수 있도록 구현했다. CZP-1은 post-processing 이펙트를 제외하고는 원본과 거의 동일한 음향 특성을 보여준다. 전체 요약 8문장 읽기 → 037 22:26 ▲ 109 · 댓글 5 전자식 메모리가 만든 컴퓨팅: 기계장치는 아니었다 컴퓨터 역사에서 찬스 배비지보다 중요한 것은 전자식 작동 메모리의 발명이다. 기계식 계산기는 17세기부터 존재했고 프로그래밍 개념도 배비지보다 앞서 있었으나, 복잡한 기계에서 데이터를 이동시키는 기술이 병목이었다. 하드웨어 · 시스템 · RAM: the forgotten history (2024)
Key Point 현대 컴퓨터의 기초인 RAM 기술이 배비지의 기계적 설계가 아닌 전자식 메모리 발명에서 비롯되었으며, 릴레이부터 자기코어까지 70년 동안 실용성을 위해 어떤 기술들이 시도되었는지 보여준다.
핵심 요약
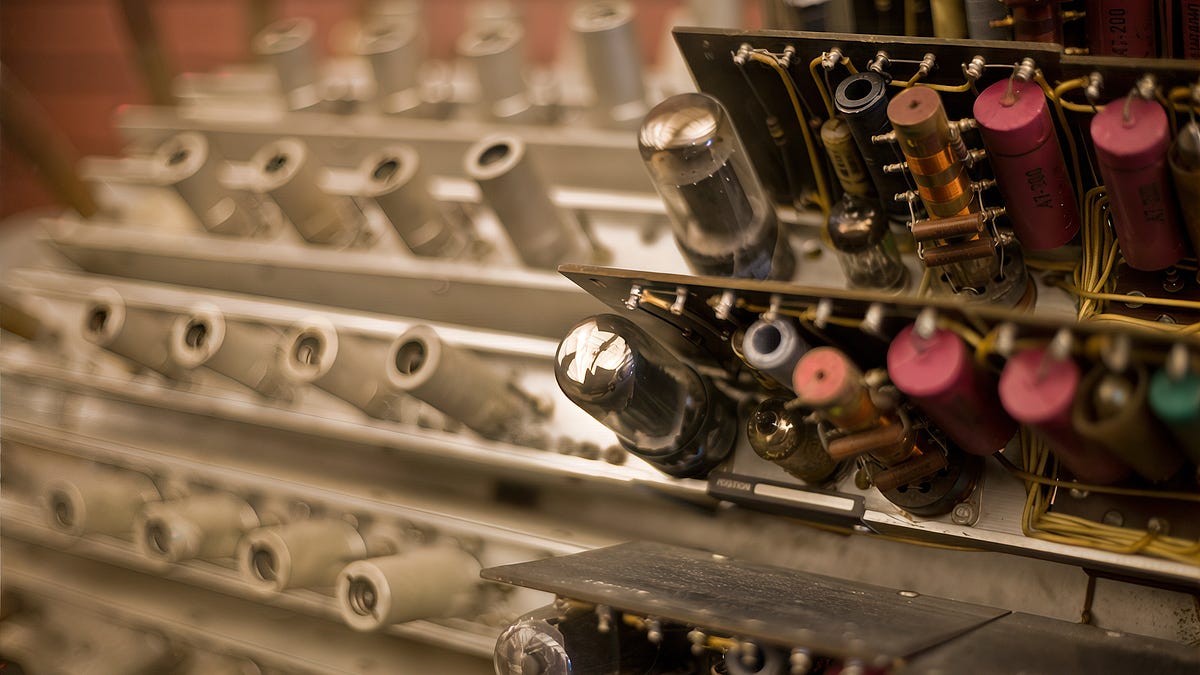
컴퓨터 역사에서 찬스 배비지보다 중요한 것은 전자식 작동 메모리의 발명이다. 기계식 계산기는 17세기부터 존재했고 프로그래밍 개념도 배비지보다 앞서 있었으나, 복잡한 기계에서 데이터를 이동시키는 기술이 병목이었다. 초기 전자식 메모리는 릴레이로 구현되었다. 콘라드 추제의 Z3 컴퓨터(1938년경)가 릴레이 기반 메인 메모리를 사용했지만, 전자기 릴레이는 수십 헤르츠 수준의 느린 스위칭 속도로 인해 확장성이 제한적이었다. 진공관을 이용한 더 빠른 메모리 셀이 윌리엄 에클스와 프랭크 조던이 1918년 제안한 쌍안정 회로에서 비롯되었다. 이 SR 래치 아키텍처는 현대의 고속 저전력 SRAM 메모리와 같은 기본 원리를 공유한다. 전체 요약 11문장 읽기 → 038 22:26 ▲ 22 · 댓글 2 로봇의 귀를 열다, 공간음향 이해 벤치마크 OmniEcho 구체화된 에이전트(로봇 등)가 시각 정보와 함께 음성 신호를 이용해 추론하기는 여전히 어렵다. AI · 머신러닝 · OmniEcho: Spatial Audio Understanding for Embodied Agents
Key Point 음성 감지 능력이 로봇과 에이전트의 환경 이해 능력을 크게 확장할 수 있으며, 이를 평가하고 개선할 수 있는 첫 번째 대규모 벤치마크가 공개되었다.
핵심 요약
구체화된 에이전트(로봇 등)가 시각 정보와 함께 음성 신호를 이용해 추론하기는 여전히 어렵다. 음향-시각 인식과 음성-시각-언어 기반 네비게이션을 평가할 통일된 벤치마크가 필요했다. 연구팀이 OmniEchoBench를 제안했으며, 30개 실제 환경에서 수집한 197개 실제 공간음향-시각 장면, 2,972개 질문-답변 쌍, 900개 네비게이션 샘플(1차 앰비소닉스 오디오)을 포함한다. 전체 요약 7문장 읽기 → 039 03:10 ▲ 100 · 댓글 33 1995년 16비트 게임 Stars! 64비트 환경에서 즐기는 법 1995년 출시된 16비트 Windows 3.1 게임 Stars! 4X를 현대 64비트 윈도우에서 실행하기 위해 커스텀 80286 에뮬레이터와 Win16-Win32 브릿지를 탑재한 Stars!VM을 개발했다. 오픈소스 · 도구 · A custom virtual machine for the Stars 4X game
Key Point 현대 OS에서 실행 불가능한 레트로 게임을 실행 가능하게 하는 에뮬레이션 기술의 실제 구현 사례로, 레지스터 수준의 정밀성 유지, AI 통합, 성능 최적화 기법을 보여준다.
핵심 요약
1995년 출시된 16비트 Windows 3.1 게임 Stars! 4X를 현대 64비트 윈도우에서 실행하기 위해 커스텀 80286 에뮬레이터와 Win16-Win32 브릿지를 탑재한 Stars!VM을 개발했다. 정식 게임 파일을 압축해 EXE에 내장했으므로 다운로드나 추가 설정 없이 즉시 실행할 수 있으며, 원본처럼 보이지만 현대적 파일 선택기와 4K 스케일링이 지원된다. 에뮬레이터는 x87 부동소수점 연산을 호스트 하드웨어에서 직접 수행하고, AI 에이전트가 게임 UI를 조작할 수 있도록 Model Context Protocol(MCP) 인터페이스를 제공한다. 전체 요약 6문장 읽기 → 040 09:10 ▲ 353 · 댓글 293 애플, 개방형 귀 디자인 액티브 노이즈 캔슬링 탑재한 에어팟 5 공개 애플이 에어팟 5를 발표했으며, 개방형 귀 디자인 형태로는 업계 최고 수준의 액티브 노이즈 캔슬링(ANC)을 탑재했다. 하드웨어 · 시스템 · AirPods 5
Key Point 개방형 디자인 에어팟에 처음으로 액티브 노이즈 캔슬링을 실현했으며, 저가 진입점에서 애플 인텔리전스 기능을 사용할 수 있게 되었기 때문이다.
핵심 요약
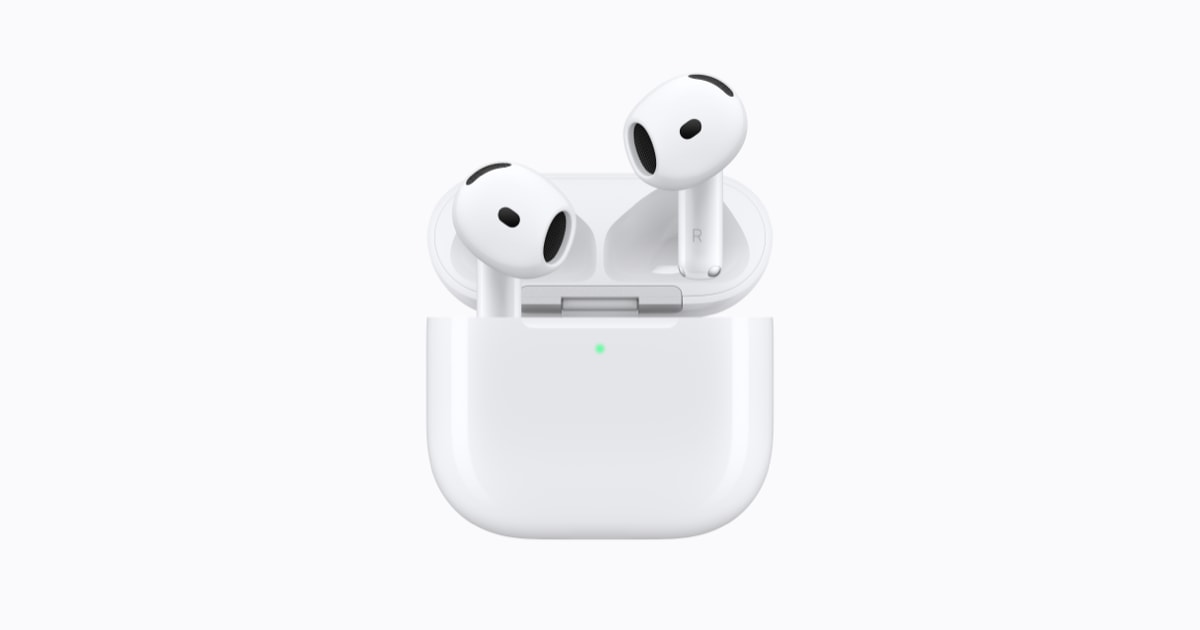
애플이 에어팟 5를 발표했으며, 개방형 귀 디자인 형태로는 업계 최고 수준의 액티브 노이즈 캔슬링(ANC)을 탑재했다. 에어팟 4 ANC 모델 대비 최대 50% 더 많은 외부 소음을 제거하며, 새로운 멀티포트 음향 구조와 차세대 적응형 EQ로 더 풍부한 음질을 제공한다. 시리 AI, 라이브 번역 등 애플 인텔리전스 기반 기능을 손-자유 방식으로 사용할 수 있으며, 머리 제스처로 시리에 응답할 수 있다. 전체 요약 6문장 읽기 →