쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
42건 · "대규모 데이터"조건 지우기 ×
001 09:11 ▲ 165 · 댓글 169 AI 데이터센터 확산, 저소득층이 전기료 부담 AI 엔진인 대규모 데이터센터는 중소도시만큼의 전력을 소비하면서 전력망에 부담을 주고 있다. 인프라 · 데브옵스 · Data centers need power – lower income, rural residents pay the price
Key Point AI 데이터센터의 급격한 확산이 저소득층과 농촌 주민에게 집중된 에너지 비용 증가를 초래하고 있으며, 현재의 비용 분담 방식 개선이 정책 결정과 주 정부·연방 차원의 논의를 앞두고 있기 때문이다.
핵심 요약
AI 엔진인 대규모 데이터센터는 중소도시만큼의 전력을 소비하면서 전력망에 부담을 주고 있다. 코넬대학 연구는 2020~2025년 미국 4대 전력망을 분석한 결과, 데이터센터가 2025년 기반시설 비용 82.5억 달러 중 38%인 31.2억 달러만 부담하고 나머지 62%는 주민들이 지고 있음을 발견했다. 저소득 가정은 소득의 28%까지 에너지 비용이 증가했으며, 전송 인프라 투자는 2020년 20억 달러에서 2025년 340억 달러로 급증했다. 전체 요약 10문장 읽기 → 002 21:11 ▲ 11 · 댓글 3 K-means보다 10배 빠른 클러스터링 알고리즘 'e-means' 공개 Lloyd's k-means를 개선한 새로운 클러스터링 알고리즘 e-means를 제안했다. AI · 머신러닝 · e-means: outperforming k-means (in one-tenth the epochs)
Key Point 대규모 임베딩 데이터 클러스터링 속도가 근본적으로 빨라져서, 검색·양자화·데이터 큐레이션 등 실무에서 k-means을 쓰는 작업들의 처리 시간을 획기적으로 단축할 수 있다.
핵심 요약
Lloyd's k-means를 개선한 새로운 클러스터링 알고리즘 e-means를 제안했다. 지수이동평균(exponential moving average) 최적화 절차와 미니배치 업데이트를 사용하며, 딥러닝 기반 인프라를 활용한다. 감쇠율(decay rate)과 배치 크기가 최종 성능에 미치는 영향에 대한 스케일링 법칙을 수립해 하이퍼파라미터 튜닝 없이 다양한 문제 크기에 적용 가능한 공식을 도출했다. 전체 요약 6문장 읽기 → 003 18:12 ▲ 106 · 댓글 40 Rust와 GPUI로 만든 경량 DB 클라이언트 DBDelve 공개 개발자 Shayan이 성능 중심의 오픈소스 DB 클라이언트 DBDelve를 공개했다. 오픈소스 · 도구 · Show HN: DBDelve – Open-Source DB Client Made with Rust and GPUI
Key Point 기존 DB 클라이언트의 메모리 부하 문제를 해결하는 경량 오픈소스 도구가 나왔으며, 성능이 기존 업계 표준 대비 획기적으로 높다.
핵심 요약
개발자 Shayan이 성능 중심의 오픈소스 DB 클라이언트 DBDelve를 공개했다. DBeaver, Datagrid, Beekeeper 등 기존 도구가 메모리 부하가 크거나 비싼 문제를 해결하려 Rust와 GPUI로 개발했다. M1 Pro에서 실행한 벤치마크 결과, DBDelve는 DBeaver 대비 시작 시간 4.7배 빠름(1.1초 vs 5.2초), 유휴 메모리 78% 적음(133MB vs 606MB), 백만 행 쿼리는 9배 빠름(56초 vs 208초), 메모리는 71% 적음(4.9GB vs 17GB)이다. 전체 요약 9문장 읽기 → 004 06:11 ▲ 221 · 댓글 122 마이크로소프트 AI 프론티어 그룹 해체, 연구자들 대거 이탈 2023년 ChatGPT 출시 이후 마이크로소프트 리서치(MSR) 내에서 AI Frontiers(AIF) 부서가 조직되어 약 50명 규모로 Autogen, Fara 에이전트 등 에이전트 기술과 Full Bandwidth Transformer 같은 기초 역량 개발에 주력했다. AI · 머신러닝 · The end of Microsoft Research's AI Frontiers group
Key Point 마이크로소프트 AI 조직 내 연구 철학의 근본적 충돌로 핵심 인재가 이탈하는 상황은 기업 AI 연구의 방향성, 기초 연구와 스케일링 사이의 우선순위 논쟁을 보여줍니다.
핵심 요약
2023년 ChatGPT 출시 이후 마이크로소프트 리서치(MSR) 내에서 AI Frontiers(AIF) 부서가 조직되어 약 50명 규모로 Autogen, Fara 에이전트 등 에이전트 기술과 Full Bandwidth Transformer 같은 기초 역량 개발에 주력했다. AI Frontiers는 MSR 전체가 사용하는 모노레포를 만들어 모델 개발 파이프라인을 공유하는 등 조직 전체와 협업했으나, 9월 초 마이크로소프트 AI(MAI)로 재편성되었다. MAI의 전직 인플렉션 리더십은 연구보다 스케일링(대규모 데이터와 모델 크기 증가)에만 집중하는 철학을 고수하고 있어, 기초 연구에 초점을 둔 AI Frontiers와 방향이 충돌했다. 전체 요약 6문장 읽기 → 005 03:11 ▲ 100 · 댓글 39 AI가 과학 연구를 어디까지 가속화할 수 있을까 Anthropic이 프라이버시 보호 방식으로 207,000개의 Claude 세션을 분석해 과학 연구에서 AI 사용 방식을 조사했다. AI · 머신러닝 · AI for scientific discovery: How researchers use Claude
Key Point 과학 분야별·작업별 AI 도입 패턴을 대규모 데이터로 측정함으로써, AI가 현재 어디서 실제로 쓰이고 있는지, 미래에 어느 정도 가속화를 가져올 수 있는지 보여준다.
핵심 요약
Anthropic이 프라이버시 보호 방식으로 207,000개의 Claude 세션을 분석해 과학 연구에서 AI 사용 방식을 조사했다. 컴퓨터과학·수학·통계 등 형식과학에서 Claude 사용이 상대적으로 높고, 의학·화학·생물학 같은 현장 기반 과학에서는 낮았다. 과학자들은 데이터 분석(전체 세션의 33.7%)과 논문 작성(32.0%)에 Claude를 집중 사용하지만, 가설 생성(4.2%)과 데이터 수집(11.5%)에는 거의 사용하지 않는다. 전체 요약 10문장 읽기 → 006 00:11 ▲ 32 · 댓글 3 인간 영상 50,000시간으로 로봇 기초모델 학습시키는 오픈 방법론 1인칭 시점 인간 영상 5만 시간으로 로봇 학습을 위한 데이터를 확보하는 Open-HumanScale 방법론을 공개했다. AI · 머신러닝 · Open-HumanScale: An Open Recipe for Scaling Human and Robot Experience for Embodied Foundation Models
Key Point 인간 행동 영상 대규모 데이터로 로봇 조작 능력을 효과적으로 학습할 수 있는 실증적 방법론과 스케일링 법칙을 제시했으며, 재현 가능한 연구를 위해 전체 파이프라인을 오픈소스화했다.
핵심 요약
1인칭 시점 인간 영상 5만 시간으로 로봇 학습을 위한 데이터를 확보하는 Open-HumanScale 방법론을 공개했다. 손동작과 자연언어 주석이 달린 Open-HumanScale-50K 데이터셋을 구축하고, 시뮬레이션 평가로 인간 사전학습만으로도 데이터 시간과 로봇 성공률 간 로그 선형 스케일링 법칙을 발견했다. 인간 영상 5만 시간으로만 학습한 HumanWAM-Vanilla 모델은 RoboTwin 2.0 Clean2Clean에서 92.08% 성공률, Clean2Random에서 68.88%, RoboDojo에서 평균 14.17% 성공률을 기록했다. 전체 요약 6문장 읽기 → 007 12:54 ▲ 10 · 댓글 3 다국어 안전성 학습을 위한 템플릿 기반 대규모 데이터셋 MSafeTemp 공개 언어 모델의 안전성 정렬(safety alignment)이 영어 중심으로 편중되어 저자원 언어의 안전성 성능을 크게 떨어뜨리고 있다. AI · 머신러닝 · How I Aligned Your Model: Scaling Up Multilingual Safety Training with Templates
Key Point 저자원 언어 사용자들이 사용하는 AI 모델의 안전성 격차를 해결하는 구체적인 방법이 제시되었고, 영어 기준 테스트만으로는 실제 안전 위험을 놓칠 수 있다는 점이 실증되었다.
핵심 요약
언어 모델의 안전성 정렬(safety alignment)이 영어 중심으로 편중되어 저자원 언어의 안전성 성능을 크게 떨어뜨리고 있다. 연구팀은 템플릿 기반 증강 파이프라인을 통해 해로운 프롬프트에서 안전한 템플릿을 추출하고, 이를 60개 언어로 번역한 뒤 문화적으로 적절한 실체들로 채워 대규모 거부 및 양성 코퍼스를 생성했다. 이렇게 만든 MSafeTemp 데이터셋은 다국어 안전성 정렬과 평가에 활용할 수 있도록 검증되었다. 전체 요약 6문장 읽기 → 008 15:11 ▲ 37 · 댓글 2 게임 영상 1분 이상 학습 데이터셋 'GameVerse' 공개 인터랙티브 월드 모델이 생성하는 게임 환경은 현재 약 1분 이상 일관성을 유지하지 못하는데, 이는 모델 성능이 아니라 장기간 학습 데이터 부족 때문이다. AI · 머신러닝 · GameVerse: A Minute-Scale Gameplay Dataset for Long-Horizon Interactive World Modeling
Key Point 장시간 게임 환경을 생성하는 AI 모델의 핵심 제약(짧은 학습 데이터)을 직접 해결하는 대규모 데이터셋이 나왔기 때문에, 이 분야 연구자와 개발자가 주목할 필요가 있다.
핵심 요약
인터랙티브 월드 모델이 생성하는 게임 환경은 현재 약 1분 이상 일관성을 유지하지 못하는데, 이는 모델 성능이 아니라 장기간 학습 데이터 부족 때문이다. 기존 게임 영상 데이터셋은 10초 이하 클립으로 이루어져 있고 캡션도 거칠어서 장시간 제어 생성에 부적합하다. 연구팀이 공개한 GameVerse는 1~2분 길이의 게임 플레이 영상으로 구성되며, 69.7K개 클립, 1,655시간, 3억 4,960만 프레임 규모이다. 전체 요약 8문장 읽기 → 009 18:11 ▲ 27 · 댓글 2 동영상에서 학습 데이터를 자동 생성하는 AI 에이전트 멀티모달 학습 발전이 고품질 학습 데이터 부족과 높은 레이블링 비용으로 제한되고 있는 상황에서, VidUEU-Agent는 원본 동영상에서 자동으로 학습 데이터를 생성하는 파이프라인을 제시한다. AI · 머신러닝 · VidUEU-Agent: A Data-Curation Agent for Multimodal Understanding, Editing, and Unified Tasks
Key Point 동영상에서 자동으로 멀티모달 학습 데이터를 생성하고 최적화하는 방식이 멀티모달 AI 모델 개발의 데이터 부족 문제를 어떻게 풀 수 있는지 보여주는 실질적인 접근법이다.
핵심 요약
멀티모달 학습 발전이 고품질 학습 데이터 부족과 높은 레이블링 비용으로 제한되고 있는 상황에서, VidUEU-Agent는 원본 동영상에서 자동으로 학습 데이터를 생성하는 파이프라인을 제시한다. 4단계 파이프라인으로 구성되며, 저품질 장면을 필터링하고, 핵심 프레임과 멀티모달 신호를 추출한 뒤, 메타데이터를 구성하고 라우팅하여 학습 샘플을 합성한다. 에이전트 프레임워크는 다운스트림 학습 결과를 기반으로 자동으로 데이터 분포를 반복 최적화하여 데이터 품질, 균형, 학습 효율성을 개선한다. 전체 요약 5문장 읽기 → 010 09:11 ▲ 10 · 댓글 2 코딩 에이전트를 위한 상호작용하는 요구사항 데이터셋 공개 현실의 장기 소프트웨어 개발에서 코딩 에이전트는 인터페이스 호환성, 에러 핸들링 같은 다차원적 작업 명세를 동시에 만족하면서 기존 의존성을 유지해야 한다. AI · 머신러닝 · When Requirements Interact: Scaling Long-Horizon Coding via Interdependent Specifications
Key Point 코딩 에이전트가 현실 수준의 복잡한 상호의존적 요구사항을 만족하도록 훈련하는 새로운 방법론과 대규모 데이터셋이 공개되어, 소프트웨어 개발 에이전트의 성능 평가 기준이 실질적으로 높아진다.
핵심 요약
현실의 장기 소프트웨어 개발에서 코딩 에이전트는 인터페이스 호환성, 에러 핸들링 같은 다차원적 작업 명세를 동시에 만족하면서 기존 의존성을 유지해야 한다. 기존 연구들은 명세의 양과 다양성이 부족하고, 주요 목표에만 집중해 복잡한 제약을 무시하는 경향이 있다. 단순히 명세를 추가하면 작업이 체크리스트처럼 단순화되거나, 상호작용의 신뢰성을 검증하면서 유효한 대안을 놓칠 위험이 있다. 전체 요약 8문장 읽기 → 011 03:11 ▲ 15 · 댓글 2 AI 영상 학습 최적화, 프레임 간 의존성 제거로 1.45배 빠른 로딩 대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. AI · 머신러닝 · Rethinking Video Storage for AI Training: Breaking Cross-Frame Dependencies for Efficient Random Access
Key Point AI 모델 학습용 영상 데이터의 로딩 병목을 해결하는 방법을 제시하며, 대규모 학습 인프라의 처리량을 크게 높일 수 있어 실용적이다.
핵심 요약
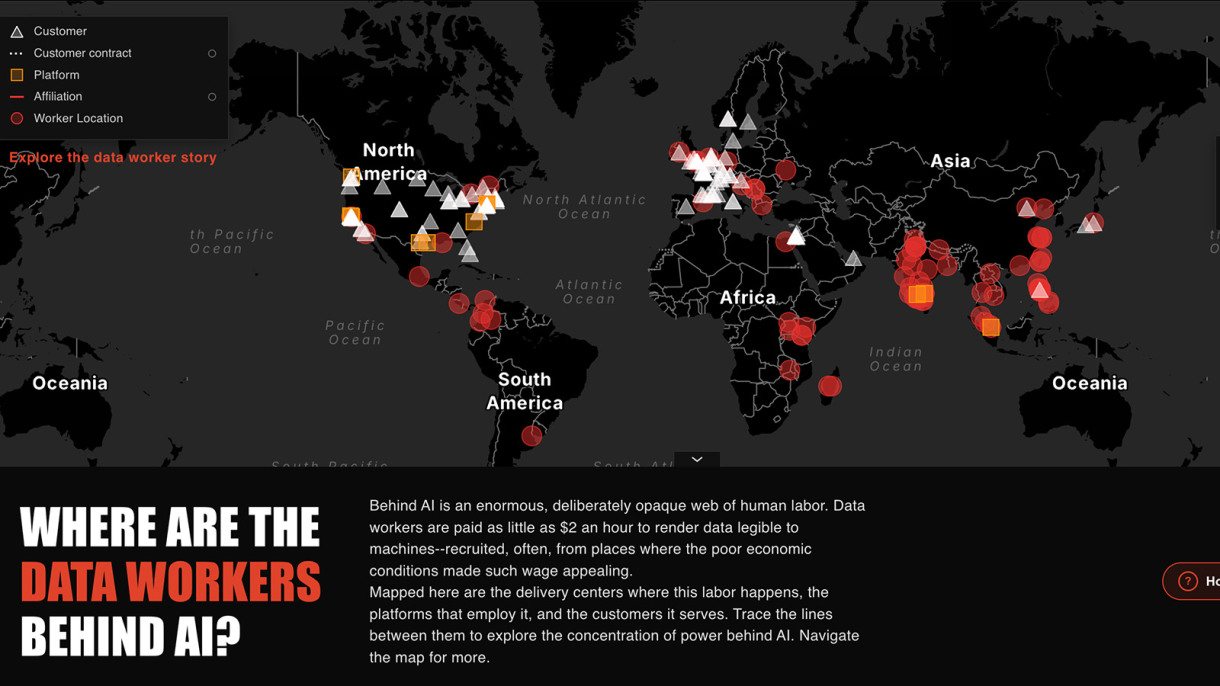
대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. 기존 방식은 프레임 간 참조 구조로 압축률을 높이지만, 임의 접근 시 관련 없는 프레임도 함께 디코딩해야 해 비효율적이다. 논문은 두 가지 디코딩 증폭 원인을 파악했다: 무관한 프레임의 순차 복원과 샘플링 대상이 참조하는 체인의 복원이다. 전체 요약 8문장 읽기 → 012 03:12 ▲ 130 · 댓글 106 AI 훈련 뒤에 숨은 저임금 노동자 세계지도 브라운대학 학부생 쿤연 마가 AI 회사들과 전 세계 데이터 노동자들의 연결 관계를 시각화한 대화형 지도를 공개했다. AI · 머신러닝 · Brown student maps the hidden global labor powering AI
Key Point 전 세계의 불가시화된 저임금 노동에 의존한 AI의 현실과 대규모 데이터 노동 공급망의 지형을 처음으로 가시화한 시도이기 때문입니다.
핵심 요약
브라운대학 학부생 쿤연 마가 AI 회사들과 전 세계 데이터 노동자들의 연결 관계를 시각화한 대화형 지도를 공개했다. 지도는 기존 데이터 노동자 데이터베이스, 마의 자체 조사, 그리고 노동 조건을 다룬 뉴스 기사들을 통합한 것이다. AI 모델 훈련을 위해 인간 노동자들은 사진 라벨링, 음성 전사, 챗봇 응답 평가, 의료 스캔 분석 등 다양한 작업을 수행한다. 전체 요약 6문장 읽기 → 013 00:11 ▲ 117 · 댓글 130 피터 티엘, 기술 과두정체 속 '종말론적 신학'의 아버지 PayPal 창업자 피터 티엘은 2016년 훌크 호건의 가워커 소송에 비밀리에 자금을 지원해 $1.4억 배상금을 받게 했으며, 이를 통해 미국 사회에 깊은 변화가 일어났다고 믿고 트럼프의 정치 경력을 시작하는 데 조력했다. 스타트업 · 비즈니스 · Peter Thiel, the tech oligarch who believes in the Antichrist
Key Point 기술 부호의 사상이 실제 정부 정책과 감시 체계에 미치는 영향을 구체적으로 보여주며, 스타트업 신화 뒤에 숨겨진 권력 집중과 민주주의 거부의 철학이 무엇인지 드러낸다.
핵심 요약
PayPal 창업자 피터 티엘은 2016년 훌크 호건의 가워커 소송에 비밀리에 자금을 지원해 $1.4억 배상금을 받게 했으며, 이를 통해 미국 사회에 깊은 변화가 일어났다고 믿고 트럼프의 정치 경력을 시작하는 데 조력했다. 현재 58세인 티엘은 부통령 J.D. 밴스, 상원의원 테드 크루즈 등 정치인들의 부상을 이끌었으며, 기술 국가주의를 추진하고 UN·NATO 등 국제기구에 반대하는 실리콘밸리 최대 영향력자다. 티엘은 르네 지라르의 모방적 욕망 이론, 칼 슈미트의 친구-적 사상, 레오 슈트라우스의 자유민주주의 비판을 혼합한 독특한 철학을 발전시켰으며, '적그리스도'와 '카테혼'(적그리스도를 억누르는 것) 개념 중심의 개인 신학을 구축했다. 전체 요약 13문장 읽기 → 014 09:11 ▲ 115 · 댓글 71 $150만 드는 BI 도구, 8개월에 $8,300으로 직접 만들다 연 15만 달러를 쓰는 Looker를 대체할 방법을 찾던 중 2월에 한 엔지니어가 HTML 파일을 호스팅하는 서비스를 하루 만에 구축했고, 8개월 후 Looker만큼 많은 주간 사용자를 확보했다. AI · 머신러닝 · Can we replace a $150k Looker with a bucket of HTML files?
Key Point Claude와 기존 데이터 스택으로 고가의 BI 도구를 직접 만든 구체적인 사례와 비용 구조, 보안 설계를 담았으며, SaaS 대체 논의에서 정확한 기술 트레이드오프를 제시합니다.
핵심 요약
연 15만 달러를 쓰는 Looker를 대체할 방법을 찾던 중 2월에 한 엔지니어가 HTML 파일을 호스팅하는 서비스를 하루 만에 구축했고, 8개월 후 Looker만큼 많은 주간 사용자를 확보했다. Claude(Opus 4.5)가 데이터 분석 결과를 HTML 차트로 생성하기 시작했는데 Looker 대시보드보다 더 나은 외형을 보여줬지만 Downloads 폴더에만 머물러 공유 방식이 필요했다. 팀의 Maddy가 S3, SSO, Kubernetes 기반으로 HTML 파일을 호스팅·공유하는 웹 서비스를 만들고, 3월에 Snowflake OAuth 토큰을 이용한 라이브 쿼리 API를 추가했으며, 기존 권한 모델을 그대로 활용해 별도 권한 로직을 쓸 필요가 없었다. 전체 요약 14문장 읽기 → 015 18:11 ▲ 106 · 댓글 14 TiDB Cloud 대규모 데이터 유출, 10.6TB 탈취 분산 데이터베이스 TiDB Cloud를 운영하는 PingCAP에서 10.6TB의 민감한 데이터가 유출되었다. 약 200GB 규모의 1단계 자료가 공개되었으며 탈취된 데이터에는 88회에 걸친 연속 추출, 약 50개의 GCP 스토리지 버킷, 180,046개 테넌트 조직, 403,262개의 고유 이메일이 포함되어 있다. 보안 · PingCap TiDB Leaks
Key Point 멀티테넌트 클라우드 서비스를 이용하는 기업들에게 직접적 위협이며, 제어 평면 침투로 전체 고객 기반의 자격증명과 결제 정보가 수 년간 탈취됐다는 점에서 클라우드 보안의 현실을 보여준다.
핵심 요약
분산 데이터베이스 TiDB Cloud를 운영하는 PingCAP에서 10.6TB의 민감한 데이터가 유출되었다. 약 200GB 규모의 1단계 자료가 공개되었으며 탈취된 데이터에는 88회에 걸친 연속 추출, 약 50개의 GCP 스토리지 버킷, 180,046개 테넌트 조직, 403,262개의 고유 이메일이 포함되어 있다. 4,901,203개의 파일과 115,308개의 평문 고객 API 키(그중 활성 42,612개), 20,645,574개의 고객 SQL 문, 5,036,738개의 고객 서버 IP 주소가 탈취되었다. 공격자는 GCP 서비스 계정 키와 Azure 서비스 주체라는 저장소에 커밋된 자격증명을 이용해 제어 평면 데이터베이스 복제 피드를 구성했고, 2025년 9월 8일부터 9월 30일까지 매 6시간마다 88회 연속 추출을 수행했으나 탐지되지 않았다. 전체 요약 12문장 읽기 → 016 00:11 ▲ 12 · 댓글 2 다양한 장면에 강한 자율 학습 깊이 추정 기법 MaSS 자율 학습으로 단안 깊이 추정을 수행하려면 라벨 없는 대규모 데이터를 활용할 수 있지만, 기존 방법들은 다양한 장면의 혼합 데이터로 학습할 때 성능이 떨어진다. AI · 머신러닝 · Learning to Discriminate Scene Structures Makes Self-Supervised Depth Learning Scalable
Key Point 자율 학습 깊이 추정이 다양한 현실 데이터에서 제대로 작동하려면, 도메인별 편향을 넘어 일반화된 구조 학습이 필수적이기 때문이다.
핵심 요약
자율 학습으로 단안 깊이 추정을 수행하려면 라벨 없는 대규모 데이터를 활용할 수 있지만, 기존 방법들은 다양한 장면의 혼합 데이터로 학습할 때 성능이 떨어진다. 연구진은 자율 학습 상황에서 모델이 전이 가능한 기하학 대신 데이터셋별 구조적 편향을 학습하면서 도메인 간 최적화 충돌이 발생하는 문제를 발견했다. 이를 해결하기 위해 MaSS 프레임워크를 제안하며, 맥락 특징과 명시적으로 분리된 전용 구조 표현 경로를 도입한다. 전체 요약 7문장 읽기 → 017 15:11 ▲ 21 · 댓글 2 한 번에 여러 편집 지시를 따르는 이미지 편집 모델 MTEdit 공개 여러 개의 편집 지시를 순서대로 받아 하나의 이미지를 단계별로 수정하는 다중 턴 이미지 편집 기술을 연구했다. AI · 머신러닝 · MTEdit: Packed Trajectories Beat Rollouts for Multi-Turn Image Editing
Key Point 한 번에 여러 편집 지시를 정확하게 따르면서도 이미지 품질 저하를 막는 기술이 필요한 실무 환경에서 활용할 수 있는 대규모 데이터셋과 평가 기준을 제시했기 때문이다.
핵심 요약
여러 개의 편집 지시를 순서대로 받아 하나의 이미지를 단계별로 수정하는 다중 턴 이미지 편집 기술을 연구했다. 기존의 순차적 방식은 각 단계마다 오류가 누적되어 이미지 품질이 떨어지는 문제가 있었다. 팩드 궤적 캔버스(PTC) 기법으로 여러 편집 상태를 하나의 시각적 맥락에서 함께 생성하면 이 문제를 줄일 수 있음을 발견했다. 전체 요약 6문장 읽기 → 018 03:11 ▲ 204 · 댓글 41 CERN과 Mistral, 과학 AI 개발 전략 제휴 CERN과 유럽 AI 개발사 Mistral이 과학 발전을 위한 기초 모델 개발을 목표로 전략 제휴 양해각서를 체결했다. AI · 머신러닝 · CERN and Mistral sign a statement of intent to establish a strategic partnership
Key Point 고에너지 물리학 연구의 데이터 폭발적 증가(2030년 10배)에 대응하기 위해 유럽이 기초 AI 모델 개발에 나서는 만큼, 과학 데이터 분석의 미래 방향이 어떻게 재편될지 보여주는 사례입니다.
핵심 요약
CERN과 유럽 AI 개발사 Mistral이 과학 발전을 위한 기초 모델 개발을 목표로 전략 제휴 양해각서를 체결했다. 초점은 고에너지 물리학이며, 양자색역학(LHC)에서의 수십억 개 양성자-양성자 충돌 시뮬레이션 데이터로 학습한 단일 기초 모델인 '대규모 물리 모델'을 개발할 계획이다. 개발될 모델은 입자 충돌 재구성, 입자 식별, 예상치 못한 신호 감지, 미래 검출기 설계 평가 등 다양한 작업을 단일 모델로 처리할 수 있도록 설계된다. 전체 요약 8문장 읽기 → 019 00:11 ▲ 103 · 댓글 32 로봇 학습, 데이터 대량 수집 시대 열리다 AI 발전의 핵심은 대규모 데이터 학습이며, 이제 로봇 분야도 같은 원리를 따르고 있다. AI · 머신러닝 · How to Train Your Robot
Key Point 로봇 AI가 대규모 데이터 학습 시대로 접어드는 가운데, 어디서 그 데이터를 구할 것인가가 로봇 공학의 핵심 병목이 되고 있기 때문이다.
핵심 요약
AI 발전의 핵심은 대규모 데이터 학습이며, 이제 로봇 분야도 같은 원리를 따르고 있다. LLM 학습에 사용된 기존 텍스트 데이터와 달리, 로봇용 훈련 데이터는 새롭게 수집해야 하는 상황이다. 원격 조종(텔레오퍼레이션)은 데이터 질이 높지만 비용이 많이 들고 확장이 어렵다는 문제가 있다. 전체 요약 12문장 읽기 → 020 18:11 ▲ 28 · 댓글 3 파일에서 인사이트 찾는 AI, 합성 데이터로 학습시키다 파일을 분석해 인사이트를 도출하는 데이터 에이전트를 대규모로 학습시키기 위해 현실적인 학습 환경 구축이 어려운 문제를 해결했다. AI · 머신러닝 · Data World: Scaling Data Environments from Scratch
Key Point 데이터 분석 AI 학습을 위한 현실적인 대규모 데이터 환경 구축 방식이 제시되며, 합성 환경에서의 강화학습이 실제 벤치마크 성능 향상으로 이어지는 경로를 보여준다.
핵심 요약
파일을 분석해 인사이트를 도출하는 데이터 에이전트를 대규모로 학습시키기 위해 현실적인 학습 환경 구축이 어려운 문제를 해결했다. Data World 엔진은 파일을 먼저 생성하는 대신, 파일 뒤의 세상(데이터 구조·관계)을 명시적으로 정의한 뒤 환경·과제·평가 기준을 합성한다. 독립적인 감사로 관찰된 파일에서 정답을 복구할 수 있는지 검증하며, RL 학습을 위한 보상 함수로도 활용한다. 전체 요약 7문장 읽기 → 021 15:11 ▲ 29 · 댓글 2 슬라이드 생성·편집 통합 AI 모델 InfoVis 공개 Hugging Face와 연구팀이 슬라이드 생성과 편집을 통합하는 9B 규모의 멀티모달 모델 InfoVis를 발표했다. AI · 머신러닝 · InfoVis: Unified Slide Image Generation and Editing
Key Point 슬라이드 생성·편집에 특화된 대규모 데이터와 벤치마크 공개로, 프레젠테이션 자동화 분야에 새로운 평가 기준과 개방형 기준 모델을 제시한다.
핵심 요약
Hugging Face와 연구팀이 슬라이드 생성과 편집을 통합하는 9B 규모의 멀티모달 모델 InfoVis를 발표했다. 텍스트 렌더링, 명령 따르기, 시각적 접지, 미적 설계, 정밀한 편집을 한 캔버스 내에서 수행할 수 있도록 설계됐다. 연구팀은 1,300만 개의 지속 학습 기록과 190만 개의 감독 학습 기록으로 구성된 확장 가능한 데이터 엔진을 구축했다. 전체 요약 9문장 읽기 → 022 12:11 ▲ 107 · 댓글 2 AI가 3D 코드로 가상 세계를 만드는 생태계 공개 Hugging Face 연구팀이 3DCodeVerse를 공개했다. 이는 AI 코딩 에이전트가 대규모로 3D 콘텐츠를 생성하고 편집할 수 있는 연구 생태계다. AI · 머신러닝 · 3DCodeVerse: Exploring 3D Worlds as Code
Key Point AI가 코드 기반으로 3D 콘텐츠를 자동 생성하고 검증하는 체계가 갖춰지면서, 대규모 3D 세계 창작의 자동화가 실질적으로 가능해지는 시점을 보여준다.
핵심 요약
Hugging Face 연구팀이 3DCodeVerse를 공개했다. 이는 AI 코딩 에이전트가 대규모로 3D 콘텐츠를 생성하고 편집할 수 있는 연구 생태계다. 3DCodeVerse-2M이라는 대규모 데이터셋을 구축했으며, 이는 오픈소스 3D 코드 200만 개로 이루어져 있다. 각 프로그램은 실행에 필요한 소스 파일과 에셋, 설명, 검증 기록이 함께 패키징되어 있다. 3DCodeVerse Harness라는 다중 에이전트 DAG 프레임워크를 개발했다. 이는 3D 콘텐츠를 생성하고 개선하며, 실행 검사, 공간 측정, 시각 피드백으로 인간의 개입 없이 자동 평가와 수정을 수행한다. 전체 요약 5문장 읽기 → 023 15:11 ▲ 18 · 댓글 1 휴머노이드 로봇의 도구 선택과 사용 능력 평가하는 벤치마크 공개 휴머노이드 로봇이 도구를 사용해 작업을 수행하려면 적절한 도구를 선택하고, 조작과 필요시 이동을 조율해야 한다. 하드웨어 · 시스템 · HumanoidToolBench: Benchmarking Humanoid Tool Use from Selection to Mobile Execution
Key Point 휴머노이드 로봇이 도구 사용 능력을 갖추는 것은 제한된 신체 능력을 극복하는 핵심이며, 이를 체계적으로 평가할 수 있는 벤치마크와 대규모 데이터셋의 공개는 로봇 학습 연구를 한 단계 진전시킬 수 있다.
핵심 요약
휴머노이드 로봇이 도구를 사용해 작업을 수행하려면 적절한 도구를 선택하고, 조작과 필요시 이동을 조율해야 한다. 기존 벤치마크는 휴머노이드의 이들 능력을 함께 평가하지 않으므로, HumanoidToolBench라는 새로운 벤치마크를 소개한다. 이 벤치마크는 18개 작업, 3가지 시나리오, 3단계 실행 레벨, 2가지 도구 세트 모드를 포함한다. 전체 요약 7문장 읽기 → 024 15:11 ▲ 283 · 댓글 2 게임 AI 학습을 위한 합성 경험 기반 강화학습 프레임워크 Player-1 화면 해석과 키보드·마우스 조작을 수행하는 컴퓨터 사용 에이전트는 발전했으나, 시각적으로 풍부하고 복잡한 게임 환경은 여전히 도전 과제로 남아 있습니다. AI · 머신러닝 · Player-1: Learning to Play from Synthetic Experience
Key Point 게임 AI의 성능 개선이 실제 환경 데모 없이 합성 환경만으로 달성 가능함을 보여줌으로써, 대규모 데이터 수집 없이 일반적 디지털 제어 에이전트를 학습할 수 있는 길을 열었습니다.
핵심 요약
화면 해석과 키보드·마우스 조작을 수행하는 컴퓨터 사용 에이전트는 발전했으나, 시각적으로 풍부하고 복잡한 게임 환경은 여전히 도전 과제로 남아 있습니다. 기존 게임 에이전트 학습 파이프라인은 제한된 동적 게임 상태 커버리지의 대규모 데모에 의존하며, 상호작용 학습을 위한 확장 가능한 환경 구축이 어렵습니다. Player-1은 합성 경험을 통해 데모 이상의 게임 제어를 학습하는 포스트 트레이닝 프레임워크로, 상대적 포인터 모션, 지속적 입력, 복합 액션으로 컴퓨터 사용 액션 공간을 확장합니다. 전체 요약 9문장 읽기 → 025 21:12 ▲ 11 · 댓글 2 인간의 촉각 데이터 500시간, 로봇 조작 성공률 22.5%→57.5% TouchScale은 500시간 분량의 인간 상호작용 시각·촉각 데이터셋으로, 단일 웨어러블 센서 장비로 통일되어 기록되었다. AI · 머신러닝 · TouchScale: 500 Hours of Human Vision and Touch for Visual-Tactile Learning
Key Point 로봇 조작에 필요한 촉각 정보를 포함한 대규모 균질 데이터셋이 실제 작업 성공률을 2.5배 향상시켜, 구현화된 AI 시스템 개발의 데이터 기초가 어떻게 바뀌는지 보여준다.
핵심 요약
TouchScale은 500시간 분량의 인간 상호작용 시각·촉각 데이터셋으로, 단일 웨어러블 센서 장비로 통일되어 기록되었다. 각 기록은 정면 RGB-D 비디오, 손목 RGB 비디오, 양손 촉각 측정값이 시간 정렬되어 포함되며 약 2,000개의 사전 정의된 작업 설명을 아우른다. 기존 촉각 데이터와 달리 센서와 수집 절차가 고정되어 있어 데이터 규모의 영향을 명확히 분리할 수 있다. 전체 요약 8문장 읽기 → 026 18:12 ▲ 32 · 댓글 2 OCR을 넘어 텍스트 기반 시각 지능으로: PolyOCR 모델 공개 Hugging Face와 arXiv에서 공개된 PolyOCR-Venus는 단순한 텍스트 인식을 넘어 복잡한 시각 환경에서 텍스트를 인식·위치파악·추론하는 통합 OCR 기초 모델이다. AI · 머신러닝 · PolyOCR-Venus: Unified OCR Foundation Models for Text-Centric Visual Intelligence
Key Point OCR 기술이 단순 텍스트 추출에서 복잡한 문서 이해와 추론으로 확장되는 가운데, 여러 작업을 균형있게 수행하는 통합 모델의 등장은 문서 처리, 정보 추출, 자동화 분야에 실질적인 영향을 미칠 수 있다.
핵심 요약
Hugging Face와 arXiv에서 공개된 PolyOCR-Venus는 단순한 텍스트 인식을 넘어 복잡한 시각 환경에서 텍스트를 인식·위치파악·추론하는 통합 OCR 기초 모델이다. 기존 OCR 시스템은 특정 작업에만 강하고 인식, 파싱, 추론을 균형있게 수행하지 못하는 한계가 있었다. PolyOCR은 명령 추종 프레임워크와 대규모 데이터 엔진을 결합하여 서로 다른 시각 자원을 검증된 OCR 감독 신호로 변환한다. 전체 요약 6문장 읽기 → 027 15:11 ▲ 18 · 댓글 2 3D 재구성 모델의 거리 추정 능력을 평가하는 벤치마크 Pumpire 공개 Pumpire는 이미지와 비디오 기반 3D 파운데이션 모델의 포인트 간 거리 추정 능력을 통합 평가하는 벤치마크다. AI · 머신러닝 · Pumpire: Unified Benchmark for Metric Distance Estimation
Key Point 3D 모델의 정확한 거리 측정 능력을 처음으로 직접 평가하는 벤치마크로, 재구성 기하의 물리적 정확도 검증에 필수적인 기준을 제시한다.
핵심 요약
Pumpire는 이미지와 비디오 기반 3D 파운데이션 모델의 포인트 간 거리 추정 능력을 통합 평가하는 벤치마크다. 기존 깊이 맵과 카메라 내부 파라미터를 따로 평가하거나 기하학적 유사도 지표를 쓰는 방식과 달리, 재구성된 기하 정보에서 직접 포인트 간 거리 오류를 측정한다. 100개 실제 장면에서 물리적으로 측정한 포인트 쌍 거리를 주석 달고 장면마다 64프레임(총 6,400프레임)으로 구성한 대규모 데이터셋 pumpire-6k를 수집했다. 전체 요약 7문장 읽기 → 028 18:30 ▲ 17 · 댓글 2 광고 영상 생성용 대규모 데이터셋 'AdSpark' 공개 제품 정체성을 보존하면서 판매 포인트를 다중 장면 내러티브로 표현하는 광고 영상 생성 연구를 위해 AdSpark 데이터셋과 벤치마크를 발표했다. AI · 머신러닝 · AdSpark: A Large-Scale Dataset and Benchmark for Product-Centric Advertisement Video Generation
Key Point 제품 광고 영상 생성이라는 새로운 작업을 위해 처음으로 대규모 구조화 데이터셋과 다차원 평가 프레임워크를 제시해, 이 분야 연구의 기초를 마련한다.
핵심 요약
제품 정체성을 보존하면서 판매 포인트를 다중 장면 내러티브로 표현하는 광고 영상 생성 연구를 위해 AdSpark 데이터셋과 벤치마크를 발표했다. AdSpark-300K는 이커머스 플랫폼 데이터를 바탕으로 약 30만 개의 이미지-프롬프트-영상 3쌍으로 구성되며, 실제 데이터와 합성 데이터 부분집합을 포함한다. 각 샘플에는 제품 식별 주석, 판매 포인트 설명, 창의적 계획, 정렬된 음성 스크립트 등 구조화된 광고 주석이 포함되어 있다. 전체 요약 6문장 읽기 → 029 03:11 ▲ 141 · 댓글 75 Supabase, AI 에이전트 지원 SQLite 기반 Turso 인수 Supabase가 SQLite 기반 데이터베이스 플랫폼 Turso를 인수했다. AI · 머신러닝 · Supabase is acquiring Turso
Key Point AI 에이전트가 대규모 데이터베이스를 동적으로 생성하는 시대에 SQLite와 Postgres를 결합한 인프라로 개발자 경험을 혁신하는 전략이 주목된다.
핵심 요약
Supabase가 SQLite 기반 데이터베이스 플랫폼 Turso를 인수했다. AI 에이전트가 프로토타입과 앱 개발을 위해 매주 백만 개 이상의 데이터베이스를 생성하면서 새로운 데이터베이스 인프라의 필요성이 대두되었다. Turso는 SQLite를 Rust로 재구현하고 한 서버에서 수백만 개의 데이터베이스를 관리할 수 있는 클라우드 플랫폼을 구축했다. 전체 요약 8문장 읽기 → 030 21:11 ▲ 165 · 댓글 2 실시간 스트리밍 비디오에서 인식·기억·응답을 통합하는 OneStreamer 스트리밍 비디오 LLM은 미래 작업의 중요성이 결정되기 전에 증거를 기억하고, 충분한 증거가 모였을 때 응답해야 한다. AI · 머신러닝 · OneStreamer: Unifying Perception, Memory, and Proactive Response in Streaming Video Interaction
Key Point 스트리밍 비디오 이해 작업에서 실시간 처리와 장기 기억 사이의 균형을 새롭게 푸는 방식을 제시하며, 8개 벤치마크에서 우수한 성능을 입증한 대규모 데이터셋과 모델을 공개합니다.
핵심 요약
스트리밍 비디오 LLM은 미래 작업의 중요성이 결정되기 전에 증거를 기억하고, 충분한 증거가 모였을 때 응답해야 한다. OneStreamer는 쿼리-독립적 증거 기록과 작업 응답을 공동으로 학습하되, 공유된 능동형 생성 과정을 통해 이룬다. Proactive Hierarchical Caption Memory(PHCM)는 시간-정박된 세부 사항 캡션과 완료된 이벤트의 요약을 생성하며, 훈련 중 관찰된 비디오 시작 부분의 해석을 감독한다. 전체 요약 10문장 읽기 → 031 06:11 ▲ 156 · 댓글 66 Cloudflare, 서버리스 이벤트 스트림 K2 공개 베타 출시 Cloudflare가 개발자 플랫폼용 내구성 있는 이벤트 스트리밍 서비스 K2를 공개 베타로 출시했다. 인프라 · 데브옵스 · Cloudflare K2: serverless event streams
Key Point 프로듀서와 컨슈머의 규모 차이로 인한 이벤트 손실 문제를 해결하는 서버리스 스트리밍 인프라가 등장했으며, 에지 네트워크 전역에서 대규모 데이터 이동을 처리해야 하는 개발자에게 Kafka의 대안이 될 수 있다.
핵심 요약
Cloudflare가 개발자 플랫폼용 내구성 있는 이벤트 스트리밍 서비스 K2를 공개 베타로 출시했다. K2는 프로듀서와 컨슈머를 분리하여 이벤트 손실을 방지하고, 주문화된 로그로 데이터를 저장한 뒤 여러 독립적인 리더가 자신의 속도로 소비할 수 있다. R2 객체 스토리지 위에 파티션된 내구성 로그를 구현하며, 장기 보존을 지원하므로 컨슈머 다운타임 중에도 데이터를 잃지 않는다. 전체 요약 11문장 읽기 → 032 15:11 ▲ 45 · 댓글 2 실패한 에이전트 50,000개로 배우는 오류 진단 데이터셋 AI 에이전트의 실패 사례를 수집·분석하기 위해 9,961개 작업에서 나온 50,228개의 오류-진단 쌍으로 구성된 Agent Error Dataset(AED)을 제시한다. AI · 머신러닝 · Agent Error Dataset: Scaling 50,000 Error--Diagnosis Pairs for Failure Analysis and Error-Aware Post-Training
Key Point LLM 에이전트의 실패 경험을 체계적으로 수집하고 진단하는 대규모 데이터셋으로, 기존의 성공 사례만으로 학습하는 방식의 한계를 극복하고 오류 인식 학습을 가능하게 한다.
핵심 요약
AI 에이전트의 실패 사례를 수집·분석하기 위해 9,961개 작업에서 나온 50,228개의 오류-진단 쌍으로 구성된 Agent Error Dataset(AED)을 제시한다. 33개 환경, 19개 하네스 패밀리, 23개 정책 모델에서 텍스트 기반 에이전트 시스템의 자연스러운 실패를 기록했으며, 원본 롤아웃을 반복하지 않고도 교차 환경 실패 분석이 가능하도록 소스 추적과 실행 메타데이터를 보존했다. 5단계 Agentic Error-to-Training(AET) 파이프라인으로 자연스러운 실패를 수집하고, 진단과 수정 방안을 생성한 후 기록된 증거와 대조하여 검증한다. 전체 요약 7문장 읽기 → 033 00:11 ▲ 148 · 댓글 156 유럽 데이터센터들, 환경 영향 정보 공개 거부 유럽의 대다수 데이터센터가 환경 영향에 관한 정보를 공개하지 않고 있으며, Lighthouse Report의 조사에 따르면 네덜란드에서도 대규모 데이터센터의 4분의 1 이하만 전기·상수도 사용량을 공개하고 있다. 인프라 · 데브옵스 · Most data centers refusing to say how much water, electricity they use
Key Point 의무 규정에도 불구하고 데이터센터들이 환경 정보 공개를 거부하고 있으며, 동시에 전력 소비가 국가 전체의 15%까지 증가할 예정이어서 투명성 확보가 에너지 위기 시대에 필수적이다.
핵심 요약
유럽의 대다수 데이터센터가 환경 영향에 관한 정보를 공개하지 않고 있으며, Lighthouse Report의 조사에 따르면 네덜란드에서도 대규모 데이터센터의 4분의 1 이하만 전기·상수도 사용량을 공개하고 있다. 연구자들이 유럽 각국의 정보공개법을 활용해 1년간 데이터센터 환경 영향 자료 수집을 시도했으나 실질적인 결과를 얻지 못했다. EU 에너지효율지침(EED)은 설치용량 500kW 이상 데이터센터에 에너지·수자원 사용량 보고를 의무화하고 있으나, 3년이 지난 지금도 대부분이 준수하지 않고 있다. 전체 요약 8문장 읽기 → 034 00:11 ▲ 103 · 댓글 25 3만7500장의 국경 그리기: 사람들이 기억하는 세계 지도 37,500개의 국경 그리기 결과를 지도 형태로 시각화한 프로젝트이다. 기타 · 37,500 border drawings: a map of the world as people remember it
Key Point 사람들이 실제 세계 지도를 얼마나 정확하게 기억하는지, 어떤 지역에서 오류가 많이 발생하는지를 대규모 데이터로 시각화한 흥미로운 사례 연구다.
핵심 요약
37,500개의 국경 그리기 결과를 지도 형태로 시각화한 프로젝트이다. 참여자들이 손으로 그린 국경선들을 실제 지도 위에 회색으로 표시된 실제 국경과 비교하여 표시했다. 각 국가별로 육지 국경(LB), 해안선(C), 일일 라운드(D) 등 여러 카테고리로 그리기 데이터를 분류했다. 전체 요약 5문장 읽기 → 035 00:11 당일 +520 폐기된 개인금융앱 매이비, 오픈소스 커뮤니티 포크로 부활 매이비 파이낸스는 2021~2022년 개인재무 및 자산관리 앱을 개발했으며, CFP/CFA 자문 기능까지 포함했으나 2023년 중단되고 약 100만 달러를 투자한 후 오픈소스화됨. 오픈소스 · 도구 · we-promise/sure · Ruby
Key Point 폐기된 B2C 핀테크 프로젝트가 커뮤니티 포크로 부활하는 드문 사례로, 자체 호스팅 가능한 개인금융앱을 찾는 개발자와 개인 사용자 모두에게 실질적 선택지를 제공합니다.
핵심 요약
매이비 파이낸스는 2021~2022년 개인재무 및 자산관리 앱을 개발했으며, CFP/CFA 자문 기능까지 포함했으나 2023년 중단되고 약 100만 달러를 투자한 후 오픈소스화됨. 이 커뮤니티 포크인 'Sure'는 폐기된 매이비 저장소를 인계받아 유지보수하는 프로젝트로, 사용자가 자체 호스팅하거나 소정의 비용으로 호스팅 버전을 이용할 수 있음. Ruby 기반 풀스택 앱으로 Docker 자체 호스팅, 브라우저/macOS/모바일 접속, API 클라이언트, LLM 에이전트 통합을 지원함. 전체 요약 7문장 읽기 → 036 22:26 ▲ 110 · 댓글 103 오라클, '불가항력' 명분으로 뉴멕시코 데이터센터 비용 미룬다 오라클이 뉴멕시코에서 건설 중인 대규모 데이터센터 프로젝트인 '프로젝트 주피터'에서 불가항력(force majeure)을 들며 비용 지급을 연기하기로 했다. 인프라 · 데브옵스 · Oracle cites 'force majeure' to shield itself on controversial data center
Key Point 데이터센터 투자 계약에서 기업이 불가항력 조항을 어떻게 활용하는지, 그리고 오라클 같은 대형 테넌트가 위험을 회피하는 방식을 보여주는 사례로, 클라우드 인프라 프로젝트의 실제 계약 구조를 이해하는 데 도움이 됩니다.
핵심 요약
오라클이 뉴멕시코에서 건설 중인 대규모 데이터센터 프로젝트인 '프로젝트 주피터'에서 불가항력(force majeure)을 들며 비용 지급을 연기하기로 했다. 프로젝트 개발사인 블루 아울 캐피탈 산하 회사에 이같은 내용의 통보를 보낸 상태다. 오라클은 주요 테넌트로서 완전히 철수하려 하지 않고, 데이터센터가 2028년 계획대로 가동되지 못할 경우 지급 의무를 미루려는 전략으로 보인다. 전체 요약 4문장 읽기 → 037 22:26 ▲ 104 · 댓글 19 AI 연구소, 역사 연구 자금 지원 시작해야 GPT-6 Sol과 Opus 5.5 같은 최신 대언어모델이 역사 연구의 해결 불가능해 보이던 문제들을 풀 수 있게 되면서, AI 연구소와 역사학자의 협력이 필수가 됐다. AI · 머신러닝 · Using LLMs to trace alchemical knowledge and decode 17th century letters
Key Point 최신 AI 모델들이 역사 연구의 실제 미제 문제들을 해결하기 시작했으며, 이를 본격화하려면 AI 연구소의 자금과 조직적 지원이 필수라는 주장은 AI와 인문학의 협력 방향을 제시하는 중요한 신호다.
핵심 요약
GPT-6 Sol과 Opus 5.5 같은 최신 대언어모델이 역사 연구의 해결 불가능해 보이던 문제들을 풀 수 있게 되면서, AI 연구소와 역사학자의 협력이 필수가 됐다. AI가 잘 해결할 수 있는 역사 문제는 ▶전문가들이 풀 필요를 인정한 것 ▶데이터가 완전히 디지털화된 것 ▶다국어 추론·고급 수학·대규모 데이터셋 탐색을 요하는 것 ▶명확히 증명 또는 반증 가능한 것 ▶암호해독·문헌 추적·분야별 발견 연결 같은 특정 유형으로 제한된다. 아이작 뉴턴이 프랑스 연금술 텍스트를 라틴어로 번역한 구절의 출처를 특정하고, 1941년 에니그마 암호문을 해독했으며, 17세기 스페인 암호 편지를 부분적으로 해석하는 등 실제 성과를 냈다. 전체 요약 13문장 읽기 → 038 16:18 ▲ 129 · 댓글 3 게임 AI의 능력을 평가하는 대규모 벤치마크 공개 게임 플레이 능력을 다양한 시간 범위에서 측정하는 GameHorizon Suite를 개발했다. AI · 머신러닝 · GameHorizon Suite: Multi-Horizon Data and Evaluation in Gameplay
Key Point 게임을 통해 AI의 비전, 지시 분해, 계획, 제어 능력을 체계적으로 평가하는 첫 번째 대규모 표준화 벤치마크로, 멀티모달 AI 모델 발전의 객관적 척도가 된다.
핵심 요약
게임 플레이 능력을 다양한 시간 범위에서 측정하는 GameHorizon Suite를 개발했다. 21개 게임의 5,000시간 녹화본, 100명 전문가 플레이어의 행동, 다중 수준 지시문으로 구성된 대규모 데이터세트를 구축했다. 오프라인 평가는 표준화된 문제로 재현 가능하고, 온라인 평가는 실제 게임플레이 능력을 검증한다. 전체 요약 5문장 읽기 → 039 06:10 ▲ 148 · 댓글 24 Google의 범용 고속 정렬 알고리즘, C++ 표준 정렬보다 10배 빠름 Google이 SIMD 벡터 명령어를 활용한 Quicksort 구현을 공개했으며, C++ std::sort보다 9~19배 빠르다. 인프라 · 데브옵스 · Vectorized and performance-portable Quicksort (2022)
Key Point 단일 포터블 구현으로 모든 주요 CPU 아키텍처에서 기존 방식보다 10배 빠른 정렬을 가능하게 했으므로, 데이터베이스와 대규모 데이터 처리 애플리케이션의 성능 혁신을 기대할 수 있다.
핵심 요약
Google이 SIMD 벡터 명령어를 활용한 Quicksort 구현을 공개했으며, C++ std::sort보다 9~19배 빠르다. 단일 구현으로 AVX2, AVX-512, Arm NEON 등 6가지 명령어 세트를 지원하며, 플랫폼별 최적화 코드 재작성을 제거했다. 압축-저장(compress-store) 명령어를 활용한 파티셔닝으로 정렬 성능의 대부분을 차지하는 단계를 가속화했다. 전체 요약 5문장 읽기 → 040 06:10 ▲ 139 · 댓글 54 페타바이트급 ClickHouse 클러스터 6년 운영 노하우 Tinybird에서 6년간 페타바이트 규모의 ClickHouse 클러스터를 운영해온 경험을 바탕으로 설치보다는 운영이 어렵다는 점을 강조했습니다. 인프라 · 데브옵스 · I've operated petabyte-scale ClickHouse clusters for 5 years
Key Point 페타바이트급 대규모 데이터 인프라를 운영하는 팀의 실제 경험에서 나온 아키텍처 결정, 비용 최적화, 그리고 오픈소스 ClickHouse의 한계를 명확히 보여줍니다.
핵심 요약
Tinybird에서 6년간 페타바이트 규모의 ClickHouse 클러스터를 운영해온 경험을 바탕으로 설치보다는 운영이 어렵다는 점을 강조했습니다. 샤드 없이 수직 확장 레플리카로 시작한 후, HTTP 기반 로드 밸런서로 트래픽을 라우팅하고 쓰기 전용 레플리카를 분리하는 구조를 채택했습니다. 300TB 테이블에 1000 QPS를 처리하려면 10개 레플리카가 필요해 3000TB 용량이 필요하므로 SSD 비용이 매우 큰 문제가 됩니다. 전체 요약 5문장 읽기 → 041 00:10 ▲ 215 · 댓글 197 2009년 링크 65만 개 추적, 77% 사라짐 마케도니아 URL 단축 서비스 0.mk의 2009~2014년 데이터베이스에서 657,607개 링크를 2026년 8월에 추적했다. 기타 · Where did the old web go? We followed 657,607 links to find out
Key Point 15년 전 웹 생태계의 실제 소실률을 대규모 데이터로 실증한 연구로, 링크 부패(link rot) 문제의 심각성을 구체적으로 보여줘 관심을 받고 있다.
핵심 요약
마케도니아 URL 단축 서비스 0.mk의 2009~2014년 데이터베이스에서 657,607개 링크를 2026년 8월에 추적했다. 655,178개 크롤 가능한 링크 중 76.7%가 더 이상 접속되지 않으며, 51.2%는 DNS 실패로, 25.4%는 HTTP 오류로 나타났다. YouTube, Wikipedia 등 대형 플랫폼은 대부분 생존했으나 개인 블로그, 포럼, 지역 뉴스 사이트는 대다수 소멸했다. 042 20:31 ▲ 281 · 댓글 213 웹 봇 생태계 변화, AI 에이전트 트래픽 29% 급증 인터넷이 인간 중심에서 기계 중심으로 빠르게 진화하고 있으며, 5,000개 이상의 웹사이트에서 수집한 데이터를 분석했다. AI · 머신러닝 · Someone is running mass vulnerability scans, spoofing AI bots like ClaudeBot
Key Point 웹 전체의 봇 트래픽 현황과 AI 에이전트 활동의 증가 추세를 대규모 데이터로 처음 시각화한 리포트로, 개발자들이 웹 생태계 변화를 이해하는 데 필수 자료가 되고 있다.
핵심 요약
인터넷이 인간 중심에서 기계 중심으로 빠르게 진화하고 있으며, 5,000개 이상의 웹사이트에서 수집한 데이터를 분석했다. 지난 90일간 봇 트래픽이 35% 감소한 반면, AI 관련 봇 트래픽은 29% 증가하는 추세를 보였다. 검색 엔진 크롤러(22.8%)와 SEO 크롤러(19.6%)가 주요 봇이며, 대부분의 봇은 robots.txt 규칙을 98.5% 준수하고 있다.