매일 쌓이는 개발자의 시야
2026년 10월 14일 (수). 세상의 기술 소식, 한국어로 한눈에.
AI 요약 안내 AI가 한국어로 정리한 내용입니다. 정확한 정보는 각 카드의 원문을 확인해 주세요.
요약 원칙 ↗ 01 읽을 소식Hacker News 12건 ↓ 02 써볼 도구GitHub Trending 3건 ↓ 03 읽을 논문Hugging Face Papers 42건 ↓ 04 새 버전GitHub Releases 2건 ↓ AI · 머신러닝 분야 · 59건 필터 해제 ×
오늘의 주요포인트 상위 6건
01 AI · 머신러닝 03:11 게시
원제 Gemini 4 Argon
454 포인트 댓글 345
Key Point 기존 수개월이 필요하던 효소 설계가 AI로 몇 시간으로 단축되면서 바이오 제조·신약 개발 같은 산업의 개발 속도와 비용 구조를 근본적으로 바꿀 수 있는 전환점이 될 수 있기 때문이다.
핵심 요약
Google의 Gemini 4 Argon 모델을 이용해 단백질 공학의 핵심인 효소 설계 과정을 대폭 단축했다. 기존에는 수개월이 걸리던 세린 에스터라아제 설계가 Argon을 통해 몇 시간 내에 완료됐다. Argon은 관련 데이터를 수집하고 모델 튜닝을 수행한 후 생화학 기반의 필터를 적용해 5개의 신규 효소 설계안을 도출했다. 전체 요약 5문장 읽기 → 02 AI · 머신러닝 00:11 게시
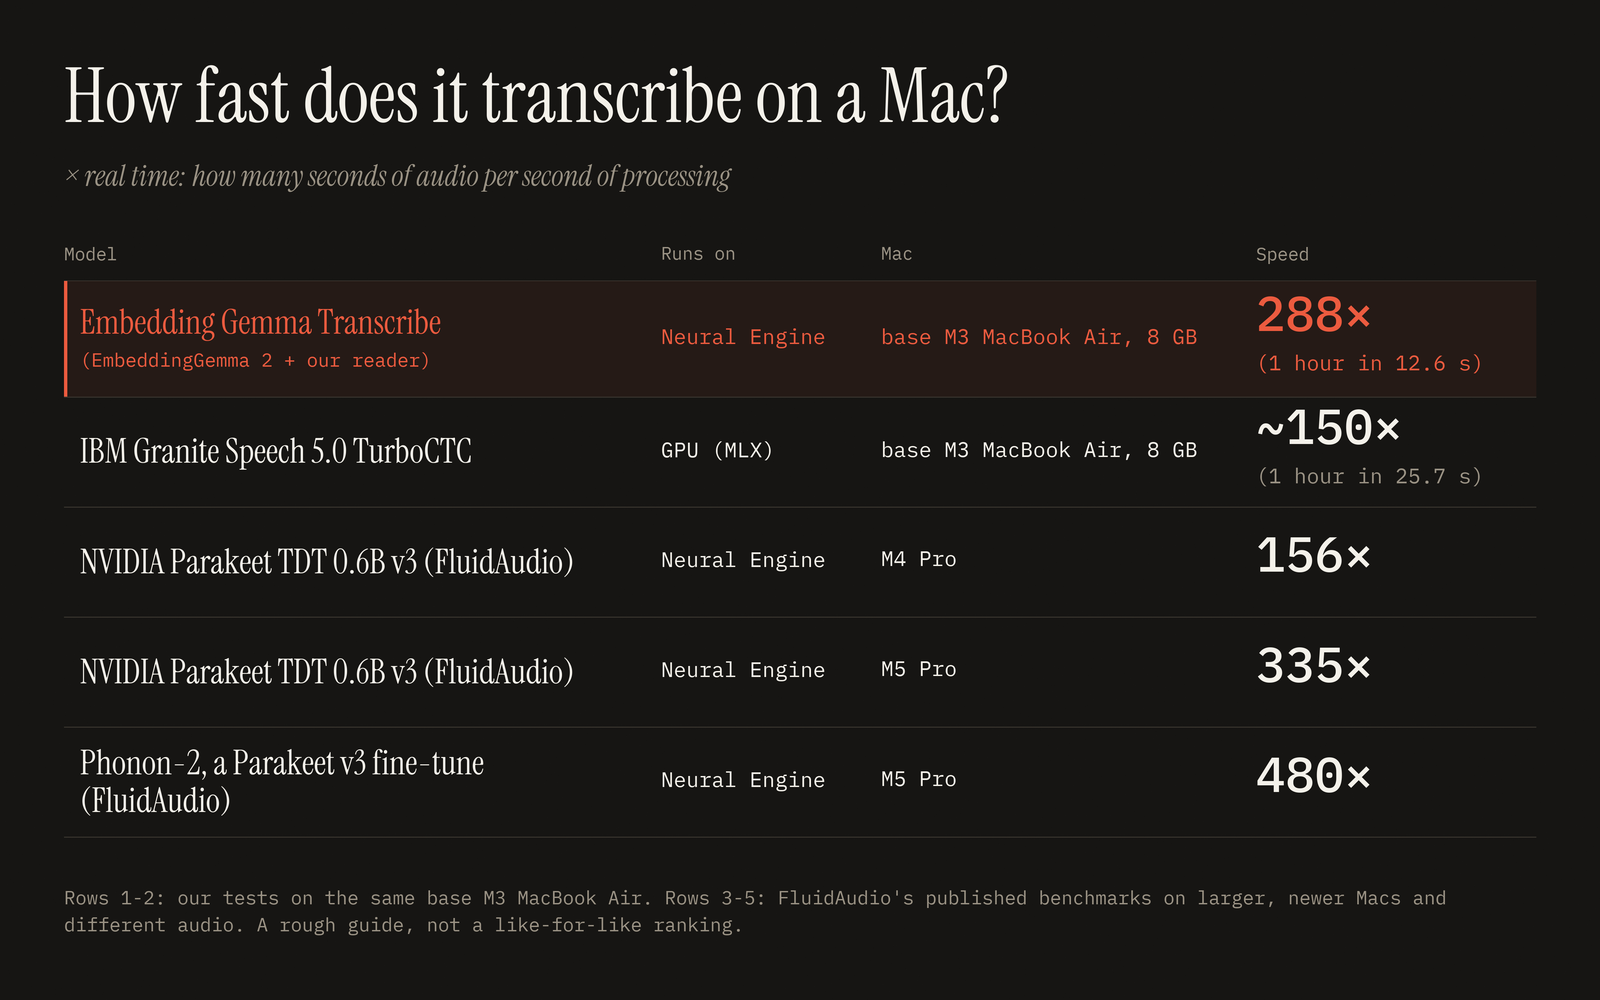
원제 We turned EmbeddingGemma 2 into a speech-to-text model
238 포인트 댓글 57
Key Point 다중모달 임베딩 모델을 음성 인식으로 새롭게 활용한 창의적 접근과 Apple Silicon에서의 빠른 실시간 처리 성능이 주목할 만하다.
핵심 요약
Google의 다중 모달 임베딩 모델 EmbeddingGemma 2를 음성-텍스트 변환 모델로 개조했다. 텍스트, 이미지, 오디오, 비디오를 같은 벡터 공간에 매핑하는 특성을 활용해 음성을 약 22만 9천 개 영어 단어 중 가장 가까운 단어로 매칭하는 방식으로 작동한다. 오디오 인코더는 원래 그대로 두고, 새로운 작은 리더 모델만 학습시켜 음성 슬라이스를 텍스트 공간으로 변환하며, 별도 모델이 구두점과 대문자를 추가한다. 전체 요약 7문장 읽기 → 03 AI · 머신러닝 03:11 게시
원제 Character.ai has initiated voluntary Chapter 11 bankruptcy
182 포인트 댓글 202
Key Point AI 챗봇 서비스 기업이 법정관리 절차를 택한 배경과 사용자에게 미칠 영향을 확인할 수 있다.
핵심 요약
Character.ai가 자발적 Chapter 11(법정관리) 절차를 시작하며 법원 감시 아래 회사 자산 매각을 추진한다. 지난 1년간 법적·규제·운영상 어려움 속에서 사업 지속을 위해 노력했으나, 경영진은 법정관리 통한 자산 매각이 모든 이해관계자 가치를 최대화할 최선의 방법이라 판단했다. 매각 절차가 실행 가능한 인수 제안을 낳으면 Character.ai 플랫폼이 계속 운영될 수 있으며, 그렇지 않을 경우 플랫폼이 폐쇄될 예정이다. 전체 요약 7문장 읽기 → 04 AI · 머신러닝 03:11 게시
원제 New Apple TV 4K
164 포인트 댓글 327
Key Point 애플의 주요 가정용 기기에 생성형 AI 기능이 본격 적용되는 사례로, 음성 인터페이스와 홈 자동화가 어떻게 진화하고 있는지 보여준다.
핵심 요약
애플이 10월 13일 차세대 Apple TV 4K(4세대)를 발표했으며, 11월 13일부터 판매된다. 신형 기기는 Siri AI를 탑재해 사용자가 영화·드라마를 찾고 발견하는 경험을 전체 화면 대화형 인터페이스로 제공한다. Siri AI는 애플 인텔리전스 기반으로 더 강력해졌으며, 개인 맥락을 이해해 '알린다가 추천한 쇼 재생'처럼 기기 간 요청을 처리할 수 있다. 전체 요약 13문장 읽기 → 05 AI · 머신러닝 06:11 게시
원제 Gemini 4 Argon for Robotics
146 포인트 댓글 39
Key Point 3D 물리 환경에서 로봇 제어·시뮬레이션·코드 생성을 통합적으로 처리하는 AI 모델의 등장으로, 로봇공학 개발의 전체 워크플로우가 단순화될 수 있는 전환점이 될 수 있다.
핵심 요약
구글이 로봇공학 전문 대규모 언어 모델 제미니 4 아르곤을 발표했다. 아르곤은 ERQA 벤치마크에서 순수 추론으로 87% 점수를 달성해 다른 모든 경쟁 모델을 능가한다. 보스턴 다이나믹스 스팟 로봇 제어, 로봇팔 조작 작업, 3D 환경 내 물체 배열 등 로봇공학 전주기에 적용 가능하다. 전체 요약 12문장 읽기 → 06 AI · 머신러닝 00:11 게시
원제 Character.ai Files for Bankruptcy
135 포인트 댓글 97
Key Point 생성형 AI 초기 성공 기업이 법적·안전 문제로 인해 파산에 이르는 과정과 대형 기술 회사의 인수 전략 변화를 보여주는 사례입니다.
핵심 요약
AI 챗봇 스타트업 Character.AI가 미국에서 Chapter 11 파산보호를 신청하고 디즈니에 자산을 매각하기로 했다. 회사는 수년간 안전 문제와 법적 도전에 직면해 왔으며, 파산 신청서에서 5천만~1억 달러 규모의 부채를 보유한 것으로 추정했다. 디즈니는 주요 입찰자로서 미공개 자산에 대해 2천만 달러를 지불하고, 이전 직원들의 고용을 통한 전환 지원 및 지적재산권에 대한 비독점 라이선스를 받는다. 전체 요약 8문장 읽기 → 전체 색인6건 · 분야별
AI · 머신러닝6건 001 21:11 ▲ 104 · 댓글 69 AI 리더들의 발언 추적 도구 'Blumify' 공개 AI 업계 지도자들의 발언과 입장 변화를 추적하는 웹 도구 Blumify가 공개되었다. AI · 머신러닝 · Show HN: I built a tool to track what AI leaders say and how their views change
Key Point AI 업계 주요 인물들의 공식 입장과 의견 변화를 한곳에서 추적할 수 있는 도구로, AI 정책·투자 동향을 파악하려는 개발자와 종사자에게 유용하다.
핵심 요약
AI 업계 지도자들의 발언과 입장 변화를 추적하는 웹 도구 Blumify가 공개되었다. Dario Amodei(Anthropic CEO), Elon Musk(Tesla·SpaceX CEO), Sam Altman(OpenAI CEO), Alex Karp(Palantir CEO) 등 주요 AI 리더 12명의 발언을 데이터베이스화했다. 각 인물별 페이지에서 이들의 발언 수, 시간별 변화 추이를 조회할 수 있다. 전체 요약 5문장 읽기 → 002 18:11 ▲ 104 · 댓글 66 프라이빗 AI 가계부, 맥에서만 돈다 Pulse Local은 맥용 가계부 앱으로, AI 모델과 거래 데이터가 모두 사용자 기계에서만 실행되고 외부 서버로 전송되지 않는다. AI · 머신러닝 · Show HN: Pulse Local, a Mac budgeting app whose AI models run on your machine
Key Point 개인 금융 데이터가 외부 서버로 전송되지 않으면서도 AI 기반 질답을 제공하는 가계부 앱의 새로운 접근 방식을 보여주므로, 프라이버시와 편의성을 모두 원하는 사용자에게 선택지를 제공한다.
핵심 요약
Pulse Local은 맥용 가계부 앱으로, AI 모델과 거래 데이터가 모두 사용자 기계에서만 실행되고 외부 서버로 전송되지 않는다. 초기 설치 시 약 2.9GB의 AI 모델을 다운로드하며, 그 후 네트워크 활동은 앱 업데이트 확인이 유일하고 사용자 정보는 절대 전송되지 않는다. 지출 현황, 카테고리별 예산 비교, 월간 비교, 현금 흐름 계산, 예측 등 주요 가계부 기능을 모두 제공한다. 전체 요약 12문장 읽기 → 003 18:11 ▲ 102 · 댓글 207 소프트웨어 개발자는 사실 숙련 기술자였을 수도 소프트웨어 엔지니어가 사무직(화이트칼라)로 분류되는 것이 잘못된 가정일 수 있다는 주장이다. AI · 머신러닝 · Were software engineers blue-collar workers all along?
Key Point 개발자의 지위 변화와 AI 시대 생존 전략을 근본적으로 재정의하는 관점을 제시하며, 현재의 불안감이 숙련 기술자로서 맞닥뜨리는 기술 대체라는 현실이라는 점을 드러낸다.
핵심 요약
소프트웨어 엔지니어가 사무직(화이트칼라)로 분류되는 것이 잘못된 가정일 수 있다는 주장이다. 개발자는 전통적인 숙련 기술자들(전기기사, 목수, 배관공 등)처럼 '무언가를 만들거나 고친다'는 점에서 동일하며, 원자 대신 비트를 다룰 뿐이다. 숙련 기술자처럼 소프트웨어 개발도 정규 교육 없이도 배울 수 있고, 숙련하려면 수년의 연습이 필요하며, 기술 변화에 적응하며 생존해 온 직종이다. 전체 요약 7문장 읽기 → 004 09:11 ▲ 121 · 댓글 56 게임 개발에서 AI를 제대로 쓰는 법 저자는 LLM이 웹 개발에는 뛰어나지만 게임 개발에는 약한 이유를 분석했다. 게임은 코드뿐 아니라 그래픽, 게임플레이, 물리 등 코드로 표현되지 않는 요소가 많아서 LLM이 이해하기 어렵기 때문이다. AI · 머신러닝 · How to engineer an AI harness for game development
Key Point LLM이 게임 개발에서 실패하는 구체적 원인과 해결 방법을 제시하는 실용적 가이드로, 게임 개발자가 AI를 효과적으로 활용하기 위해 아키텍처 설계 단계부터 적용할 수 있는 전략을 설명한다.
핵심 요약
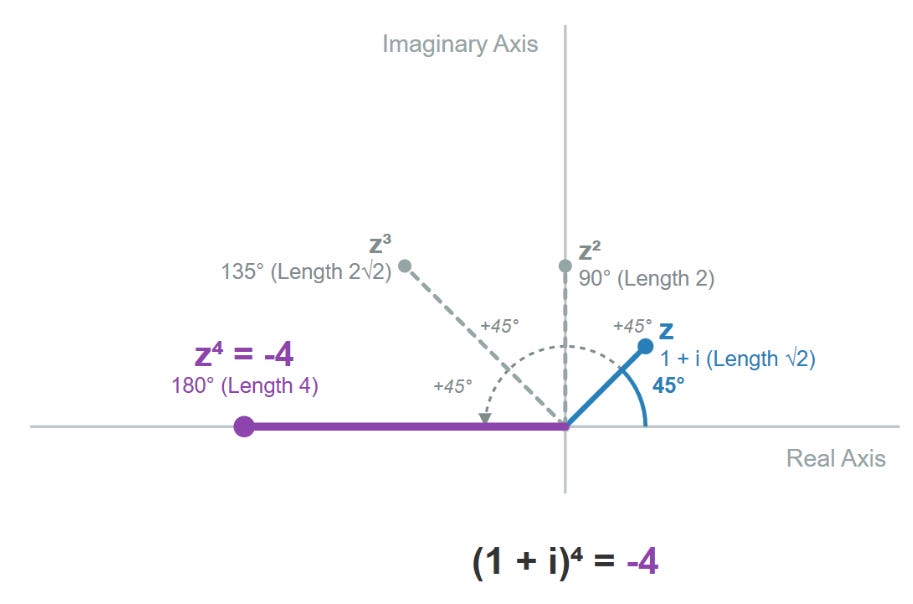
저자는 LLM이 웹 개발에는 뛰어나지만 게임 개발에는 약한 이유를 분석했다. 게임은 코드뿐 아니라 그래픽, 게임플레이, 물리 등 코드로 표현되지 않는 요소가 많아서 LLM이 이해하기 어렵기 때문이다. LLM과의 상호작용은 시스템 프롬프트, 어시스턴트 프롬프트, 사용자 프롬프트로 구성되며, 대화가 이어질수록 이전 메시지들이 계속 재제출되면서 컨텍스트가 쌓인다. 컨텍스트 오염(context pollution)을 줄이고 게임을 AI가 이해할 수 있게 만드는 '하네스(harness)' 개념을 도입해야 한다. 하네스는 AI 에이전트가 특정 작업을 더 잘 수행하도록 설계된 패턴과 도구의 집합이다. 전체 요약 9문장 읽기 → 005 06:11 ▲ 109 · 댓글 68 복소수의 시각적 이해: 불가능한 제곱근에서 회전의 언어까지 실수만으로는 풀 수 없는 연립방정식을 시도하며 음수의 제곱근이라는 불가능한 문제에 직면하게 된다. AI · 머신러닝 · A Visual Intro to Complex Numbers
Key Point 음수의 제곱근이라는 불가능한 계산에서 출발해 현대 통신, 제어, 물리학을 움직이는 핵심 도구가 된 복소수의 진화 과정과 실제 응용을 한눈에 이해할 수 있다.
핵심 요약
실수만으로는 풀 수 없는 연립방정식을 시도하며 음수의 제곱근이라는 불가능한 문제에 직면하게 된다. 16세기 이탈리아 수학자 카르다노는 음수의 제곱근을 계산 과정에서 다루면 불가능한 항들이 소거되어 실제 답에 도달할 수 있음을 발견했지만, 이를 의미 없는 '편의적 속임수'로 간주했다. 데카르트는 이런 수들을 '허수'라고 부르며 조롱했으나, 18세기 오일러는 음수의 제곱근을 i로 표기하며 체계적인 기초를 마련했다. 전체 요약 15문장 읽기 → 006 00:11 ▲ 111 · 댓글 57 이미 구독 중인 OpenAI로 오디오북 만드는 도구 OpenAI나 Claude 구독으로 PDF를 오디오북으로 변환하는 PDF TO MP3 서비스를 출시했다. AI · 머신러닝 · Show HN: Use your OpenAI subscription to create audiobooks
Key Point 기존 AI 구독료를 활용해 추가 비용 없이 오디오북을 만들 수 있는 새로운 방법을 제시하므로, OpenAI나 Claude 사용자에게 실질적인 가치가 있다.
핵심 요약
OpenAI나 Claude 구독으로 PDF를 오디오북으로 변환하는 PDF TO MP3 서비스를 출시했다. 사용자가 이미 보유한 AI 구독을 문서 처리에 활용하고, 음성 생성 비용만 별도 API 키로 지불하는 방식이다. Claude의 경우 MCP 서버를 통해 Settings → Plugins → Add MCP server에서 연결하며, Google 또는 OpenAI의 음성 API 키를 추가로 설정해야 한다. 전체 요약 5문장 읽기 → 오늘의 주요당일 스타 상위 3건
01 AI · 머신러닝 21:11 게시
baidu/Unlimited-OCR
원제 baidu/Unlimited-OCR
스타 29,797 당일 +247 Python
Key Point 한 번의 입력으로 문서 전체를 처리하는 새로운 OCR 방식이 주목받으면서, 기존 다중 단계 파싱의 한계를 극복하는 기술이 실제로 작동하는 방식을 알 수 있습니다.
핵심 요약
바이두가 Unlimited OCR을 공개했으며, 이는 DeepSeek-OCR을 한 단계 진전시킨 모델이다. 한 번의 입력으로 긴 텍스트 구간을 파싱하는 'One-shot Long-horizon Parsing' 방식을 도입했다. Hugging Face, ModelScope, Baidu Cloud 등에서 모델과 데모를 제공하고 있다. 전체 요약 7문장 읽기 → 02 AI · 머신러닝 21:11 게시
apify/apify-mcp-server
원제 apify/apify-mcp-server
스타 11,297 당일 +233 TypeScript
Key Point AI 에이전트가 별도 도구 개발 없이 Apify 생태계의 수천 개 스크래퍼를 MCP 표준으로 직접 활용할 수 있게 되어, 데이터 추출 작업의 진입장벽이 크게 낮아졌다.
핵심 요약
Apify MCP 서버는 Claude, VS Code 등 AI 에이전트가 Apify Store의 8,000개 이상 스크래퍼·크롤러·자동화 도구를 MCP 프로토콜로 직접 사용하도록 연결한다. 소셜미디어, 검색엔진, 지도, 이커머스 등 모든 웹사이트에서 데이터를 추출할 수 있으며, OAuth를 지원해 Claude.ai나 VS Code에서 URL만으로 연결 가능하다. 호스팅 서버(mcp.apify.com)는 Streamable HTTP 전송을 사용하며 레거시 SSE 엔드포인트는 제거됐다. 전체 요약 12문장 읽기 → 03 AI · 머신러닝 21:11 게시
NVIDIA/personaplex
원제 NVIDIA/personaplex
스타 11,173 당일 +148 Python
Key Point NVIDIA의 실시간 양방향 음성 모델이 텍스트 프롬프트로 페르소나를 제어할 수 있다는 점이 음성 AI의 커스터마이제이션 수준을 크게 높이며, 오픈소스 공개로 즉시 활용 가능하다.
핵심 요약
NVIDIA가 Moshi 아키텍처 기반의 실시간 풀 듀플렉스 음성 대화 모델 PersonaPlex를 공개했다. 텍스트 기반 역할 프롬프트와 오디오 기반 음성 조건화를 통해 페르소나 제어가 가능하며, 합성 및 실제 대화 데이터로 학습되어 자연스럽고 저지연 음성 상호작용을 생성한다. 모델은 HuggingFace에서 personaplex-7b-v1로 제공되며, MIT 라이선스 코드와 NVIDIA Open Model 라이선스 가중치로 배포된다. 전체 요약 7문장 읽기 → 읽을 논문
Hugging Face Papers42 커뮤니티가 고른 오늘의 AI 논문
오늘의 주요추천 상위 3건
01 AI · 머신러닝 18:11 게시
원제 Jeva: System One Models from First Principles
추천 270 댓글 3 Qi Li, Xinchao Wang
Key Point 선택지 기반 의사결정 시스템의 구조적 요구사항을 처음 체계적으로 정의하고 이를 만족하는 아키텍처를 제시하여, 추천·검색·순위 결정 등 실무 문제들을 근본적으로 다시 설계할 수 있는 접근법을 제공한다.
핵심 요약
System One 모델은 낮은 지연시간의 의사결정을 가능하게 하지만, 기존 텍스트 직렬화 방식은 의사결정 문제의 구조를 충분히 반영하지 못한다. 논문은 구조적으로 중요한 네 가지 요구사항을 제시한다: (i) null-aware(답변 부재를 후보 간 불확실성과 구별), (ii) permutation-invariant(대안의 순서 변경이 결정에 영향 없음), (iii) option-scalable(후보 집합 증가 시 출력 공간 재정의 불필요), (iv) cacheable(반복되는 대안에 대한 재사용 가능). 이를 해결하기 위해 Jeva 아키텍처를 제안한다. 공유 인코더가 요청과 각 선택지를 독립적으로 표현하고, 컴팩트 결정 스택이 불변의 선택지 메모리에 대해 요청 상태만 정제한다. 전체 요약 9문장 읽기 → 02 AI · 머신러닝 15:11 게시
원제 VideoJev: System One Model for Video Understanding and Interaction
추천 199 댓글 1 Yuhan Zhu, Xiangyu Zeng, Qingyi Si 외
Key Point 에이전트가 비디오를 이해하고 상호작용하는 모든 작업을 하나의 통합 모델로 처리하면서 기존 MLLM 대비 속도는 최대 100배 이상 빨라지는 방식을 제시한다.
핵심 요약
Visual agent가 비디오에서 빠르게 의사결정하도록 System One 패러다임에 기반해 VideoJev를 제안했다. 기존 멀티모달 LLM의 자동회귀 디코딩을 대신해, 시간 구간과 텍스트 옵션을 비디오 증거에 대해 점수 매기는 공유 헤드로 교체했다. 이를 통해 시간 그라운딩과 다지선다형 비디오 질문 답변을 통합하면서 MLLM의 의미론적 유연성과 효율적 의사결정을 결합한다. 전체 요약 7문장 읽기 → 03 AI · 머신러닝 18:11 게시
원제 Agent-Reflex: Teaching Language Agents to Act Reflectively
추천 195 댓글 2 Guanting Dong, Xinyu Yang, Jiajie Jin 외
Key Point 도구 사용 에이전트가 실제 환경의 노이즈와 오류로부터 자동으로 학습하고 회복할 수 있는 구체적인 훈련 방법론을 제시하고 있어, 더욱 견고한 AI 에이전트 개발에 필요한 기술이다.
핵심 요약
언어 모델 에이전트가 장기 추론과 도구 사용을 수행할 때 노이즈 있는 피드백과 사용자 개입에 대응하는 문제를 다룬다. Agent-Reflex는 세 단계로 구성된 훈련 프레임워크로, 먼저 Environment Reflection Skill Discovery(RSD) 단계에서 도구 피드백 섭동을 주입하고 다양한 LLM 풀에서 성공-실패 쌍을 추출해 반성 메타스킬을 도출한다. Reflective Supervised Fine-Tuning(ReSFT) 단계는 각 스킬을 자가 반성, 스킬 복구, 사용자 중심 수정을 위한 감독 신호로 변환한다. 전체 요약 6문장 읽기 → 전체 색인39건 · 분야별
AI · 머신러닝39건 001 21:11 ▲ 18 · 댓글 2 Fish Audio Drama 3, 자연어 지시로 성우 같은 음성 생성 텍스트를 연기하는 형태의 음성으로 변환하는 오픈소스 모델 Fish Audio Drama 3을 공개했다. AI · 머신러닝 · Fish Audio Drama 3 Technical Report
Key Point 단일 모델로 음성 복제, 자연어 지시, 멀티턴 편집, 장면 더빙을 모두 지원하며 파라미터 대비 빠른 추론 속도를 달성한 기술적 진전이 실제 음성 생성·편집 워크플로를 어떻게 단순화할지 확인할 수 있다.
핵심 요약
텍스트를 연기하는 형태의 음성으로 변환하는 오픈소스 모델 Fish Audio Drama 3을 공개했다. 35B 파라미터 혼합 전문가 구조에 토큰당 3B 파라미터만 활성화하며, 여러 참조에서 목소리를 복제하고 자연어 지시에 따른다. 다음 턴의 피드백으로 테이크를 수정하고, 여러 캐릭터 장면에 음성을 부여하며, 기존 음성을 인필로 편집하고 장시간·스트리밍 오디오를 합성한다. 전체 요약 8문장 읽기 → 002 21:11 ▲ 84 · 댓글 2 로봇 기초 모델 'GreenWAM' 공개, 20개 로봇 계열에서 통용 로봇이 필요한 세계 모델(행동의 결과 예측)과 정책(행동 선택)을 한 기초 모델이 모두 담당할 수 있는지 검증하는 연구다. AI · 머신러닝 · GreenWAM: A World Foundation Model for Robotics
Key Point 다양한 로봇 종류에서 작동하는 통합 기초 모델이 세계 모델과 정책을 모두 수행할 수 있음을 처음으로 입증하며, 로봇 비전 분야의 일반화 문제에 실질적 해법을 제시한다.
핵심 요약
로봇이 필요한 세계 모델(행동의 결과 예측)과 정책(행동 선택)을 한 기초 모델이 모두 담당할 수 있는지 검증하는 연구다. 로봇마다 다른 행동 표기법을 통합하기 위해 20개 로봇 계열(양팔 로봇부터 손가락까지 제어하는 휴머노이드까지)을 공통 관절 좌표로 설명하는 '공유 해부학적 행동 공간'을 구축했다. 세계 모델 모드, 행동-조건부 모드, 세계-행동 모드의 세 가지 방식으로 이들 로봇 계열을 함께 학습했고, 행동 전문가를 분리하는 정책 구조를 적용했다. 전체 요약 7문장 읽기 → 003 21:11 ▲ 64 · 댓글 1 장기 작업 에이전트 훈련을 위한 반복적 환경 진화 방식 WorkRover 강화학습을 통해 장기 수행 에이전트를 훈련하기 위해서는 상호작용 환경을 확장하는 것이 중요하지만, 기존 구성 파이프라인은 작업 요소들을 정렬한 채 반복 개선을 지원하는 데 제한이 있다. AI · 머신러닝 · WorkRover: Scaling Long-Horizon Cowork Agent Training Via Recursive Environment Evolution
Key Point 장기 작업을 수행하는 AI 에이전트의 훈련 효율을 대폭 개선하는 새로운 프레임워크로, 복잡한 작업 환경을 자동으로 정제하고 검증하는 방식이 기존 대비 크게 나은 성능을 달성했다.
핵심 요약
강화학습을 통해 장기 수행 에이전트를 훈련하기 위해서는 상호작용 환경을 확장하는 것이 중요하지만, 기존 구성 파이프라인은 작업 요소들을 정렬한 채 반복 개선을 지원하는 데 제한이 있다. WorkRover는 하니스 기반 합성으로 구성 에이전트가 의미론적으로 정렬된 작업 맥락, 실행 가능한 작업, 증거 기반 검증자를 함께 구축하고 고정 워크플로우 대신 작업공간 상태와 실행 피드백에 맞춰 조치하는 프레임워크다. 환경 진화를 지원하기 위해 의존성 폐쇄 재실행과 검증된 후보 중 가장 작은 수정안을 선택하는 Factorial Compatibility Replay(FCR)를 도입했다. 전체 요약 5문장 읽기 → 004 21:11 ▲ 34 · 댓글 2 동영상 초고화질화, 일반 GPU로 4K 실시간 처리 가능해졌다 기존 동영상 초고화질화(VSR) 모델이 확산 증류를 통해 한 단계 생성으로 효율성을 높였으나, 고해상도 추론 비용이 크고 생성 결과가 사용자 선호와 맞추기 어려운 문제가 있었다. AI · 머신러닝 · FlashVSR+: Efficient Video Super-Resolution via Hybrid Attention and Reward-Yield Distribution Matching
Key Point 동영상 초고화질화가 실용적인 수준의 속도와 메모리 효율로 4K 고해상도 처리가 가능해지면서, 콘텐츠 제작자와 개발자들이 일반 사양 GPU에서도 고품질 영상 생성을 구현할 수 있게 되었다.
핵심 요약
기존 동영상 초고화질화(VSR) 모델이 확산 증류를 통해 한 단계 생성으로 효율성을 높였으나, 고해상도 추론 비용이 크고 생성 결과가 사용자 선호와 맞추기 어려운 문제가 있었다. FlashVSR+는 하이브리드 어텐션 메커니즘을 도입해 사전학습된 VSR 모델의 강한 지역성(locality)을 활용하면서 장거리 일관성을 위해 희소 전역 상호작용을 유지한다. 이를 통해 DiT 속도를 최대 2배 높이고 피크 메모리를 45% 감소시켜, RTX 4090 24GB 단일 GPU에서 타일 분할 없이 4K 영상 초고화질화를 가능하게 했다. 전체 요약 7문장 읽기 → 005 21:11 ▲ 46 · 댓글 1 고해상도 이미지 생성 가능한 경량 디퓨전 변환기 기법 디퓨전 변환기(DiT)가 학습 해상도를 넘어 이미지를 생성하려면 토큰 수가 급증해 전체 어텐션이 계산 비용이 높아지고, 구조 왜곡과 디테일 저하 문제가 발생한다. AI · 머신러닝 · AReA: Adaptive Receptive-Field Attention for Efficient High-Resolution Diffusion Transformers
Key Point 고해상도 이미지 생성 시 계산량 폭증 문제를 적응형 어텐션으로 해결한 방식으로, 추가 학습 없이 적용 가능하다는 점이 중요하다.
핵심 요약
디퓨전 변환기(DiT)가 학습 해상도를 넘어 이미지를 생성하려면 토큰 수가 급증해 전체 어텐션이 계산 비용이 높아지고, 구조 왜곡과 디테일 저하 문제가 발생한다. 균등한 전체 어텐션이 이 문제의 공통 원인인데, 모든 스텝에서 모든 토큰에 주목하면 이차 복잡도가 생기고 학습 범위를 벗어난 상대 거리에 노출되어 모델이 분포에서 벗어난다. 어텐션의 유효 수용 범위는 노이즈 제거 과정에서 좁혀지는데, 초반 스텝에서 전역적으로 구조를 형성하고 후반 스텝에서 국소적으로 세부를 정제한다. 전체 요약 6문장 읽기 → 006 21:11 ▲ 16 · 댓글 2 영상 생성 속도 2배 이상 높인 경량 VAE 기법 공개 영상 확산 모델의 성능은 좋지만, VAE 인코딩과 디코딩에 높은 계산 비용이 들어가는 것이 문제이다. AI · 머신러닝 · LightVAE: Towards Compact and Efficient Video Autoencoders
Key Point 영상 생성 모델의 추론 속도를 2배 이상 높일 수 있는 기술이 공개되어, 실시간 영상 생성 서비스의 비용과 성능을 크게 개선할 수 있게 되었다.
핵심 요약
영상 확산 모델의 성능은 좋지만, VAE 인코딩과 디코딩에 높은 계산 비용이 들어가는 것이 문제이다. 기존 방식은 공간과 시간 계산을 함께 제약하거나 시간 계산을 제거했으나, Conv3D에서 두 차원의 압축 민감도를 구분하지 못했다. LightVAE는 시간 모델링과 네트워크 깊이의 중복성을 이용하는 압축 프레임워크다. 전체 요약 12문장 읽기 → 007 18:11 ▲ 96 · 댓글 2 장기 작업 자동화 AI, 밀도 높은 보상으로 학습 난제 해결 수 시간에서 수 일에 걸친 장기 과제를 자율적으로 수행하는 에이전트 개발이 주목받고 있으나, 오픈소스 모델들은 학습 데이터 부족과 효과적인 학습 방법 부재로 어려움을 겪고 있다. AI · 머신러닝 · Tev: Scaling Long-Horizon Agentic Environments with Dense Progress Rewards
Key Point 장기 자동화 작업의 학습 데이터 부족과 희소 보상 문제를 해결한 구체적인 방법론과 검증 가능한 데이터셋을 제시하여 오픈소스 장기 에이전트 개발의 실질적인 진전을 가능하게 한다.
핵심 요약
수 시간에서 수 일에 걸친 장기 과제를 자율적으로 수행하는 에이전트 개발이 주목받고 있으나, 오픈소스 모델들은 학습 데이터 부족과 효과적인 학습 방법 부재로 어려움을 겪고 있다. 연구팀은 Tev-Gym이라는 첫 번째 장기 에이전트 학습 데이터셋을 제시했으며, 7개 도메인의 1,170개 검증된 과제 환경을 포함하고 검증 가능한 밀도 높은 진행 보상을 제공한다. 잠재 세계 우선 접근법으로 작동하여 먼저 완전하고 정확한 숨겨진 작업 명세를 구성하고, 각 단계마다 예상되는 상태를 지정한 뒤, 과제를 점진적으로 렌더링해 제어 가능한 복잡성과 자연스러운 진행 지표를 제공한다. 전체 요약 6문장 읽기 → 008 18:11 ▲ 18 · 댓글 1 4D 생성 영상의 기하학적 일관성을 높이는 GeoFix 논문 공개 비디오 확산 모델을 4D 생성의 기초로 사용할 때 생성된 영상이 기하학적 일관성을 잘 유지하지 못하는 문제가 있다. AI · 머신러닝 · GeoFix: Geometry Fixing for 4D Consistent Generation
Key Point 비디오 확산 모델 기반 4D 콘텐츠 생성이 점점 실용화되는 가운데, 기하학적 정확성을 유지하면서도 시각 품질을 보존하는 균형의 문제를 해결하는 방법론을 제시하고 있다.
핵심 요약
비디오 확산 모델을 4D 생성의 기초로 사용할 때 생성된 영상이 기하학적 일관성을 잘 유지하지 못하는 문제가 있다. 기존 방법은 기하학적 보상을 설계해 사후 학습하지만 텍스처와 세부 디테일이 저하되어 추가 외형 보상과 신중한 보상 조정이 필요했다. GeoFix는 단일 기하학적 보상으로 기하학적 일관성과 시각적 품질을 동시에 개선하는 통합 프레임워크로, 학습 및 추론 시간 모두에 적용 가능하다. 전체 요약 7문장 읽기 → 009 18:11 ▲ 14 · 댓글 1 생성 영상의 물리 법칙 위반 평가하는 PhyProbe 생성 영상이 물리 법칙을 얼마나 잘 따르는지 평가하는 문제를 해결하기 위해 PhyProbe를 제안했다. AI · 머신러닝 · PhyProbe: Rethinking Physical Consistency Evaluation in Generated Videos
Key Point AI로 만든 영상이 물리 법칙을 얼마나 잘 따르는지 정량적으로 측정할 수 있는 평가 지표가 필요한데, PhyProbe가 기존 방식의 일반화 문제를 극복한 새로운 접근법을 제시한다.
핵심 요약
생성 영상이 물리 법칙을 얼마나 잘 따르는지 평가하는 문제를 해결하기 위해 PhyProbe를 제안했다. 기존 방식은 비전-언어 모델로 물리 역학을 제대로 인식하지 못하거나, 사람 주석으로 학습한 평가기가 특정 데이터셋에 과적합되어 일반화되지 않는 문제가 있었다. PhyProbe는 사전 학습된 시공간 인코더에서 특징을 추출한 뒤 가벼운 점수 헤드로 0~1 범위의 물리 일관성 위반 점수로 매핑한다. 전체 요약 7문장 읽기 → 010 18:11 ▲ 29 · 댓글 2 언어 모델 자가증류, 체계적 프롬프트로 추론 질 높인다 대규모 언어모델을 학습할 때 같은 모델의 교사 버전으로부터 지도를 받는 자가증류(OPSD) 방식이 있습니다. AI · 머신러닝 · Self-Distillation with Verbal Regularization
Key Point 언어모델 학습에서 교사-학생 구조의 편향 문제를 프롬프트 엔지니어링으로 해결하는 실질적인 방법론으로, 추론 성능을 높이면서도 모델의 탐색성을 보존하는 기술입니다.
핵심 요약
대규모 언어모델을 학습할 때 같은 모델의 교사 버전으로부터 지도를 받는 자가증류(OPSD) 방식이 있습니다. 교사는 정답 같은 특권정보(PI)를 조건으로 받지만, 학생은 이를 보지 못한 채 교사의 토큰 분포로부터 학습합니다. 하지만 특권정보는 깊은 검증 없이 지름길 추론으로 편향되는 문제가 생기며, 출력 분포의 엔트로피가 급격히 떨어집니다. 전체 요약 8문장 읽기 → 011 18:11 ▲ 37 · 댓글 2 동영상 검색 효율화 VEDJE, 캐시 크기 4분의 1로 줄이며 정확도 유지 비슷한 장면에서 다른 사건을 구분해야 하는 동영상 검색의 효율성을 높이는 VEDJE 방법을 제안했다. AI · 머신러닝 · VEDJE: Video-Efficient Discriminative Joint Encoder for Scalable Video-Text Retrieval
Key Point 동영상-텍스트 검색 실무에서 메모리와 계산 비용의 병목을 4분의 1 수준으로 줄이면서 검색 정확도는 거의 손실하지 않는 기법을 제시해, 대규모 시스템 배포 시 고려할 만한 최적화 기술을 제공한다.
핵심 요약
비슷한 장면에서 다른 사건을 구분해야 하는 동영상 검색의 효율성을 높이는 VEDJE 방법을 제안했다. 샘플링된 프레임 내에서 특성을 압축하되 표현은 재사용 가능한 캐시에 분리해서 보관함으로써 쿼리당 처리 비용을 절감한다. 특성 변화 예측이 보조 학습 신호로 작용해 쿼리 시간에 추가 계산 없이 압축된 캐시에서의 검색 성능을 향상시킨다. 전체 요약 7문장 읽기 → 012 18:11 ▲ 25 · 댓글 2 LLM 에이전트를 위한 데스크톱 인터페이스 자동 생성 LLM 에이전트들이 데스크톱 애플리케이션의 새로운 사용자 클래스로 떠오르고 있으나, 기존 UI는 인간 사용자나 개발자를 위해 설계되어 에이전트의 성능을 제한하고 있다. AI · 머신러닝 · A Decade in a Day: Synthesizing Agent-Native Interfaces from Human-Oriented Software Evolution
Key Point LLM 에이전트가 실제 데스크톱 소프트웨어를 더 효율적으로 제어하기 위한 인터페이스 설계 원칙을 제시하고, 자동화된 생성 기법을 보여줌으로써 에이전트 기반 소프트웨어 자동화 구현에 실질적 길을 열었다.
핵심 요약
LLM 에이전트들이 데스크톱 애플리케이션의 새로운 사용자 클래스로 떠오르고 있으나, 기존 UI는 인간 사용자나 개발자를 위해 설계되어 에이전트의 성능을 제한하고 있다. 연구팀은 소프트웨어 진화 과정을 인터페이스 변화의 자연스러운 소스로 활용하여 DeskIF-Bench 벤치마크를 개발했으며, 6개 데스크톱 앱의 255개 검증된 작업으로 구성되어 있다. 같은 작업과 에이전트를 고정한 상태에서 소프트웨어 버전만 변경하여 평가한 결과, 신규 버전이 구형 버전을 일관되게 능가했다. 전체 요약 7문장 읽기 → 013 18:11 ▲ 25 · 댓글 2 언어-행동 이중 부트스트래핑으로 네비게이션 성능을 자동 개선하다 자연어 지시를 따라 목표 위치에 도달하는 비전-언어 네비게이션 모델을 만들 때 고품질의 언어 감독 데이터가 필수이나, 사람이 직접 주석을 다는 것은 비용이 많이 든다. AI · 머신러닝 · Data-Centric Recursive Self-Improvement for Navigation via Policy-Synchronized Language-Action Dual Bootstrapping
Key Point 고비용의 인간 주석 없이도 모델이 스스로 학습 데이터를 생성하고 개선하는 방식은 대규모 AI 시스템의 데이터 확보 문제를 어떻게 풀 수 있는지 보여주는 중요한 사례다.
핵심 요약
자연어 지시를 따라 목표 위치에 도달하는 비전-언어 네비게이션 모델을 만들 때 고품질의 언어 감독 데이터가 필수이나, 사람이 직접 주석을 다는 것은 비용이 많이 든다. 기존 방법들은 네비게이션과 명령어 생성을 분리된 모델로 처리하거나 특정 컴포넌트로 묶어서 처리하는 한계가 있었고, 고정된 모델로 전체 궤적을 미리 주석해서 생성된 감독이 진화하는 정책에 뒤처지는 문제가 있었다. 논문은 RSI-Nav라는 데이터 중심의 재귀적 자가개선 프레임워크를 제안하며, 하나의 공유 모델로 비전-언어-행동 명령 수행과 비전-행동-언어 명령 생성을 통합한다. 전체 요약 7문장 읽기 → 014 18:11 ▲ 25 · 댓글 2 3D 메시 움직임 복원, 스케일 분리로 범용화 희소한 정점 변위로부터 촘촘한 메시 움직임을 복원하는 문제를 다룬다. AI · 머신러닝 · Cepheid: Decoupling Scale from Structure for Cross-Family Motion Completion
Key Point 3D 애니메이션 제작과 로봇 제어에서 부분 관측만으로 전체 움직임을 복원하는 핵심 문제를 해결했으며, 단일 모델로 다양한 대상에 일반화되는 점이 기술적 진전을 의미한다.
핵심 요약
희소한 정점 변위로부터 촘촘한 메시 움직임을 복원하는 문제를 다룬다. 기존 학습 기반 잔차 사전은 특정 형태군(의류, 동물 등)에서만 기존 조화 확장을 넘지 못했다. 스케일 문제: 기하학 형태군 간 잔차 진폭이 10배 이상 차이나며, 관측값이 많아지면 붕괴된다. 전체 요약 6문장 읽기 → 015 18:11 ▲ 24 · 댓글 1 로봇 비전-언어 모델과 세계 모델을 연결한 WAVE-0 공개 Vision-language-action(VLA) 정책은 로봇 조작에 뛰어나지만 행동의 환경적 결과를 명시적으로 모델링하지 않는 한계가 있다. AI · 머신러닝 · WAVE-0: Bridging VLA Policies and WAMs with Lightweight Latent Future Prediction
Key Point 기존 VLA 정책의 행동 결과 예측 부재 문제를 경량 세계 모델로 해결하고 실제 로봇 작업에서 35%p 향상을 이루어 실용적 로봇 조작 능력이 어떻게 개선되는지 보여준다.
핵심 요약
Vision-language-action(VLA) 정책은 로봇 조작에 뛰어나지만 행동의 환경적 결과를 명시적으로 모델링하지 않는 한계가 있다. World action models(WAM)은 미래 예측을 포함하지만 대부분 비용이 큰 비디오 생성에 의존하거나 대규모 영상 학습이 필요하다. WAVE-0(World-model-Augmented VLA Execution)은 경량 잠재 세계 모델로 VLA와 WAM을 연결하는 프레임워크다. 전체 요약 9문장 읽기 → 016 18:11 ▲ 20 · 댓글 2 터미널 에이전트, 에러 복구로 자동 성능 향상 터미널 에이전트는 복잡한 코딩 작업에서 강한 능력을 보이지만, 실행 중 명령 오류나 잘못된 구현 같은 오류에서 회복하지 못해 결국 실패하는 문제가 있다. AI · 머신러닝 · ReTerm: Recovery Training for Self-Improving Terminal Agents
Key Point 터미널 에이전트의 에러 회복 능력이 실무 환경에서 실패율을 결정하는 핵심이며, ReTerm의 자가-개선 방식은 단순 미세조정을 넘어 실제 오류 상황에서 에이전트가 스스로 학습하고 개선되는 새로운 훈련 패러다임을 제시한다.
핵심 요약
터미널 에이전트는 복잡한 코딩 작업에서 강한 능력을 보이지만, 실행 중 명령 오류나 잘못된 구현 같은 오류에서 회복하지 못해 결국 실패하는 문제가 있다. ReTerm은 자신의 실패한 터미널 작업에서 회복하는 방법을 학습하여 스스로 개선하는 에이전트로, 훈련을 위해 맞춤형 데이터 파이프라인과 고품질의 회복 시연을 제공하는 ReTerm-10K 데이터셋을 구축했다. ReTerm-GRPO라는 온라인 강화학습 알고리즘을 제안하며, 에이전트의 실패 상태에서 여러 독립적인 자가-복구 시도를 생성하고 이들이 작업을 완료하는지 여부로 학습한다. 전체 요약 6문장 읽기 → 017 18:11 ▲ 19 · 댓글 1 비디오 추론 모델의 증거 기반 검증 능력 강화 Open-o3-Video-v2는 비디오 추론 과정에서 타임스탬프와 객체 경계박스를 포함한 검증 가능한 증거를 생성하는 모델입니다. AI · 머신러닝 · Open-o3-Video-v2: Seek, Ground, and Reason with Verifiable Spatio-Temporal Evidence
Key Point 비디오 AI 모델이 단순히 답을 하는 것에서 벗어나 '왜 그렇게 생각하는지' 시간과 위치 정보로 검증할 수 있게 되면서, 신뢰성이 필요한 비디오 분석 응용에 실제 도입 가능성이 높아집니다.
핵심 요약
Open-o3-Video-v2는 비디오 추론 과정에서 타임스탬프와 객체 경계박스를 포함한 검증 가능한 증거를 생성하는 모델입니다. 기존 Open-o3-Video의 제한점을 극복하기 위해 부족한 정보를 식별하고 추가 관찰을 획득하는 에이전트 기반 접근 방식을 도입했습니다. 52K 다중 턴 에이전트 그라운딩 추론 궤적과 13K 강화학습 데이터셋(STGR-v2-CoT135K, STGR-v2-RL-13K)을 구성했습니다. 전체 요약 7문장 읽기 → 018 18:11 ▲ 111 · 댓글 1 도시 전체 3D 장면에서 물체를 찾는 AI 에이전트 'Urbex' 공개 도시 규모 3D 씬에서 건물이나 랜드마크 같은 공간 요소를 찾는 문제를 새롭게 정의했다. AI · 머신러닝 · Urbex: Agentic Spatial Grounding for City-Scale 3D Scenes
Key Point 도시 규모 3D 장면 이해 문제를 에이전트 기반의 대화형 탐색으로 재설계해 기존 랭킹 방식의 비효율성을 타파한 새로운 접근법이기 때문입니다.
핵심 요약
도시 규모 3D 씬에서 건물이나 랜드마크 같은 공간 요소를 찾는 문제를 새롭게 정의했다. 기존 방식은 미리 계산한 후보 상자들을 순위매기는 방식이었는데, 대규모 실외 장면에서 비효율적이었다. Urbex는 비전-언어 모델 에이전트가 인터랙티브하게 탐색하도록 설계했다. 전체 요약 8문장 읽기 → 019 18:11 ▲ 53 · 댓글 2 이미지 속 상황의 진위를 판단하는 AI 에이전트 EviScene 이미지가 AI 생성인지 판별하는 것만으로는 그 장면이 사실인지 알 수 없다는 문제를 해결하기 위해 Image Factuality Assessment 작업을 정의했다. AI · 머신러닝 · EviScene: Beyond "Is It AI?" for Agentic Image Factuality Assessment
Key Point 이미지 조작이 늘어나는 환경에서 단순 AI 생성 여부가 아니라 그 장면의 실제 사실성을 검증할 수 있는 자동화된 방법이 중요해지고 있기 때문이다.
핵심 요약
이미지가 AI 생성인지 판별하는 것만으로는 그 장면이 사실인지 알 수 없다는 문제를 해결하기 위해 Image Factuality Assessment 작업을 정의했다. 이미지와 검증 지시문이 주어졌을 때 시스템이 지지 또는 반박 판정과 근거 기반 설명을 제시하는 방식으로, 텍스트 주장이 없어도 조사 중 점진적으로 팩트 질문을 정교화하고 외부 증거와 비교한다. 통제 생성과 웹 수집으로 만든 1만 174개 이미지(지지/반박)를 포함하며 12가지 팩트 오류 유형을 다루는 EviLens 벤치마크를 구축했다. 전체 요약 7문장 읽기 → 020 18:11 ▲ 81 · 댓글 1 미적 코드 생성, 시각 보상으로 가능해졌다 슬라이드·포스터·대시보드처럼 시각적으로 복잡한 UI를 코드로 생성하되, 레이아웃과 색감이 실제로 어떻게 보일지 반영하기 어렵다는 문제가 있었다. AI · 머신러닝 · AesCode: Aesthetic Code Generation with Decoupled Cross-Modal Rewards
Key Point 시각 설계가 필요한 UI 코드 생성에서 미적 품질과 정확성을 동시에 달성하는 새로운 접근법이 기존 모델의 한계를 구체적으로 수치로 극복해냈다.
핵심 요약
슬라이드·포스터·대시보드처럼 시각적으로 복잡한 UI를 코드로 생성하되, 레이아웃과 색감이 실제로 어떻게 보일지 반영하기 어렵다는 문제가 있었다. AesCode는 사용자 지시문에 따라 코드를 생성하되, 같은 지시문으로 만든 이미지를 시각 미적 참조로 활용한다. 생성된 코드를 디자인 그래프로 표현해 각 속성을 추적 가능하게 만들고, 이 그래프로부터 두 종류의 보상을 만든다. 전체 요약 8문장 읽기 → 021 18:11 ▲ 66 · 댓글 1 흉부 X선 진단에 도구 활용한 AI 에이전트, ChestAgentBench서 최고 성능 흉부 X선(CXR) 해석은 직접 시각 인식만으로는 부족하며 외부 도구를 통한 증거 통합이 필요한데, 기존 도구 활용 의료 에이전트는 언제 보조 증거가 필요한지 학습하거나 부적절한 정량 데이터를 차단하는 명시적 메커니즘이 부족하다. AI · 머신러닝 · X-Ragent: Tool-Augmented Reinforcement Learning for Evidence-Grounded Chest X-Ray Reasoning
Key Point 의료 AI가 X선 이미지 분석 시 외부 측정 도구를 필요한 순간에만 올바르게 활용하는 방식을 개선함으로써, 의료 진단 시스템의 신뢰성과 설명 가능성을 높이는 구체적인 접근 방식을 제시합니다.
핵심 요약
흉부 X선(CXR) 해석은 직접 시각 인식만으로는 부족하며 외부 도구를 통한 증거 통합이 필요한데, 기존 도구 활용 의료 에이전트는 언제 보조 증거가 필요한지 학습하거나 부적절한 정량 데이터를 차단하는 명시적 메커니즘이 부족하다. 이를 해결하기 위해 X-Ragent라는 도구 활용 강화학습 후학습 프레임워크를 제안하며, 이는 보조 증거 수집과 타당성 검증 정량 측정 획득을 분리한다. 7.7K 샘플의 Rad-CoT 코퍼스를 구축해 인과관계 순서의 도구 활용 궤적과 보고서 양식 진단 추론을 결합했다. 전체 요약 7문장 읽기 → 022 15:11 ▲ 63 · 댓글 2 AI 에이전트의 '실행 가능한 3D 세계' 만드는 능력을 평가하는 벤치마크 공개 코딩 에이전트가 단순히 세계를 시각화하는 것을 넘어, 물리 법칙과 인과관계에 따라 동작하는 실행 가능한 코드 기반 세계를 구축하는 능력이 요구되고 있다. AI · 머신러닝 · ExeWorldBench: Benchmarking Code-Based Executable 3D World Modeling
Key Point AI가 물리 법칙을 이해하고 실제로 동작하는 세계를 코드로 만들 수 있는지 평가하는 새로운 기준이 생겼으며, 현재 모델들의 근본적 한계를 파악할 수 있다.
핵심 요약
코딩 에이전트가 단순히 세계를 시각화하는 것을 넘어, 물리 법칙과 인과관계에 따라 동작하는 실행 가능한 코드 기반 세계를 구축하는 능력이 요구되고 있다. 기존 벤치마크는 물리 추론, 시각적 충실도, 행동 정확성을 각각만 평가했으나, 이 세 가지를 통합적으로 평가하지 못했다. 이를 해결하기 위해 ExeWorldBench라는 첫 번째 포괄적 벤치마크를 제시했으며, 코드 기반 3D 세계 구축을 통해 세계 이해와 실행 가능한 구현을 평가한다. 전체 요약 5문장 읽기 → 023 15:11 ▲ 27 · 댓글 1 멀티턴 에이전트 학습의 진행도 신호, DeltaTTG 제안 강화학습에서 검증 가능한 보상(RLVR)으로 멀티턴 에이전트를 학습할 때 최종 보상만으로는 각 단계의 품질을 판단하기 어려운 문제를 다룬 논문입니다. AI · 머신러닝 · DeltaTTG: Training Multi-Turn Agents with a Token-to-Go Progress Meter
Key Point 기존 멀티턴 에이전트 강화학습에서 각 단계의 가치를 판단하는 방식의 비용 문제를 해결하는 새로운 접근으로, 실제 성능 향상을 실증한 방법입니다.
핵심 요약
강화학습에서 검증 가능한 보상(RLVR)으로 멀티턴 에이전트를 학습할 때 최종 보상만으로는 각 단계의 품질을 판단하기 어려운 문제를 다룬 논문입니다. 기존 방식은 상태 매칭의 신뢰성 확보나 외부 평가자·인간 주석·작업별 휴리스틱이 필요해 비용이 많이 들기 때문입니다. DeltaTTG는 다양한 정책의 궤적 기록으로부터 저비용 감독 신호를 얻어 재사용 가능한 진행도 신호를 학습합니다. 전체 요약 8문장 읽기 → 024 15:11 ▲ 21 · 댓글 2 영상을 3D 장면으로 재구성하는 AI 에이전트 평가 벤치마크 공개 영화 제작을 위한 제어 가능한 영상 생성을 목표로, 동영상으로부터 편집 가능한 동적 3D 장면을 재구성하는 AI 에이전트의 능력을 평가하는 벤치마크 'CineRecon'을 소개했다. AI · 머신러닝 · CineRecon: Benchmarking Frontier Models for Agentic Cinematic Reconstruction
Key Point 영상 생성 및 3D 재구성 기술의 발전 상황을 정량적으로 측정하는 공식 벤치마크가 처음 제시되었으며, 주요 AI 모델들의 구체적인 한계를 보여줍니다.
핵심 요약
영화 제작을 위한 제어 가능한 영상 생성을 목표로, 동영상으로부터 편집 가능한 동적 3D 장면을 재구성하는 AI 에이전트의 능력을 평가하는 벤치마크 'CineRecon'을 소개했다. 벤치마크는 50개의 참조 영상과 360개의 주석이 달린 평가 클립으로 구성되며, 영화, 실제 영상, 게임 등 다양한 출처의 영상을 포함한다. 에이전트는 주어진 영상으로부터 도구를 사용해 3D 장면을 구성, 애니메이션, 렌더링, 개선하며, Proxy(기본), Simplified(간단), Detailed(상세) 세 가지 재현 수준으로 평가된다. 전체 요약 5문장 읽기 → 025 15:11 ▲ 20 · 댓글 1 LLM 에이전트, 외부 모델 없이 자기개선한다 LLM 기반 에이전트가 파일 시스템·셸과 직접 상호작용하는 하네스 환경에서 작동하지만, 기존 학습 파이프라인은 외부 강력한 모델에 의존하는 일회성 방식에 머물고 있다. AI · 머신러닝 · ClawLoop: Self-Improving Agents via Harness-Native Training Loop
Key Point 기존 LLM 에이전트 학습은 외부 모델과 인간에게 종속되어 근본적 한계가 있는데, ClawLoop은 순환 루프로 자동 개선을 실현하고 작은 모델에도 지식 전이가 가능함을 증명하며 에이전트 학습 패러다임의 전환을 시사한다.
핵심 요약
LLM 기반 에이전트가 파일 시스템·셸과 직접 상호작용하는 하네스 환경에서 작동하지만, 기존 학습 파이프라인은 외부 강력한 모델에 의존하는 일회성 방식에 머물고 있다. ClawLoop은 외부 교사 모델 없이, 최소한의 사전 지식으로 에이전트가 자기개선하는 자체 순환 프레임워크를 제안한다. 과제 합성·진단 기반 난이도 성장·에이전트 기반 검증으로 다양한 학습 과제 풀을 생성하고, SFT와 RL로 에이전트를 업데이트한 후, 롤아웃 행동 분석으로 다음 반복의 피드백을 생성한다. 전체 요약 5문장 읽기 → 026 15:11 ▲ 20 · 댓글 1 착용형 센서로 인간의 로봇팔 동작 100시간 기록 인간형 로봇이 인간의 움직임을 학습할 때 보행·자세·물체 상호작용이 어떻게 함께 변하는지 관찰해야 하는데, 기존 데이터셋은 이 조율을 부분적으로만 제공했다. AI · 머신러닝 · EgoExplorer: A Vision-Motion-Touch Observatory for Human Loco-Manipulation In Situ
Key Point 인간형 로봇의 자연스러운 움직임 학습을 위해 필요한 대규모 멀티모달 데이터셋이 공개되었으며, 센서 최소화 기술로 현장 데이터 수집의 새로운 방향을 제시한다.
핵심 요약
인간형 로봇이 인간의 움직임을 학습할 때 보행·자세·물체 상호작용이 어떻게 함께 변하는지 관찰해야 하는데, 기존 데이터셋은 이 조율을 부분적으로만 제공했다. 연구팀은 EgoExplorer라는 100시간 규모의 데이터셋을 공개했으며, 착용형 센서 시스템으로 시점 영상과 전신 동작, 손가락 세밀한 움직임, 촉각 정보를 동시에 기록했다. 전문적 활동들을 중심으로 연속 녹화된 이 데이터에는 단계별 설명도 함께 제공된다. 전체 요약 8문장 읽기 → 027 15:11 ▲ 71 · 댓글 1 PPO의 가치 함수 추적 개선, 수학 추론 성능 7~8점 향상 언어 모델 추론용 강화학습에서 널리 쓰이는 PPO는 희소 종료 보상(sparse terminal rewards) 환경에서 표준 비평가(critic)가 값의 진화를 제대로 추적하지 못한다는 문제를 가지고 있다. AI · 머신러닝 · TPPO: Tracking-Value PPO For Language Model Reasoning
Key Point 강화학습 기반 언어 모델 추론에서 가치 함수의 정확성이 직접적으로 성능을 좌우하는데, 이 방법이 표준 PPO를 크게 능가하는 수학 추론 성능 향상을 보여준다.
핵심 요약
언어 모델 추론용 강화학습에서 널리 쓰이는 PPO는 희소 종료 보상(sparse terminal rewards) 환경에서 표준 비평가(critic)가 값의 진화를 제대로 추적하지 못한다는 문제를 가지고 있다. 논문은 연속된 접두어(prefix) 값들 사이의 관계를 분석하고, 이들이 로그-오즈 공간(log-odds space)에서 덧셈 갱신으로 이루어진 베이지안 분해를 허용함을 보였다. 이 덧셈 구조를 이용해 추적-가치 PPO(TPPO)를 제안하는데, 위치별 스칼라 출력값들을 누적해 가치 로짓(value logits)을 형성하고 재구성된 값들을 통한 종료 결과 지도학습으로 학습된다. 전체 요약 6문장 읽기 → 028 15:11 ▲ 56 · 댓글 2 다중 플레이어 게임 세계를 효율적으로 생성하는 계층 통신 모델 다중 플레이어 인터랙티브 월드 모델은 여러 플레이어의 관점에서 공유 환경을 시뮬레이션해야 하지만, 플레이어 수가 증가할 때 강건한 생성을 유지하기 어렵다. AI · 머신러닝 · Multics: Generative Multi-Player World Model with Hierarchical Communication
Key Point 게임·메타버스 개발에서 많은 플레이어를 효율적으로 처리하는 영상 생성 기술의 확장성 문제를 푼 방법으로, 재학습 없이 여러 규모에 대응하고 계산 비용을 줄일 수 있다.
핵심 요약
다중 플레이어 인터랙티브 월드 모델은 여러 플레이어의 관점에서 공유 환경을 시뮬레이션해야 하지만, 플레이어 수가 증가할 때 강건한 생성을 유지하기 어렵다. 기존 방식(Solaris의 완전 연결 통신)은 플레이어 수에 따라 주의 비용이 이차적으로 증가하고, 중앙식 접근법(γ-World)은 공유 표현에서 무관한 이벤트 간 간섭 문제가 있다. Multics는 플레이어·그룹·전역 레벨에서 정보 교환을 구조화하는 계층 통신으로 이를 해결한다. 전체 요약 9문장 읽기 → 029 15:11 ▲ 41 · 댓글 1 GUI 에이전트, 단계별로 메모리 형식 바꾼다 비전-언어 모델을 사용한 GUI 에이전트에서 메모리 증강 기법이 주목받고 있지만, 기존 방식들은 고정된 표현 형식(텍스트 또는 영상)을 사용하고 있다. AI · 머신러닝 · Learning How to Remember: Memory Modality Selection for GUI Agents
Key Point GUI 자동화 에이전트의 정확도를 높이는 방식이 기존 가정(고정 메모리 형식)과 다르며, 이를 인식한 동적 선택 기법이 실제로 성능 개선으로 이어지는 실증적 근거를 제시했다.
핵심 요약
비전-언어 모델을 사용한 GUI 에이전트에서 메모리 증강 기법이 주목받고 있지만, 기존 방식들은 고정된 표현 형식(텍스트 또는 영상)을 사용하고 있다. 연구팀은 세 개의 GUI 벤치마크에서 최적의 메모리 표현이 상호작용 단계마다 달라진다는 사실을 발견했다. 이 결과를 바탕으로 SwitchMem 프레임워크를 제안했다. 이는 각 단계에서 텍스트와 영상 메모리 표현 중 하나를 동적으로 선택한다. 전체 요약 5문장 읽기 → 030 15:11 ▲ 69 · 댓글 5 사용자 행동으로 LLM 학습하는 Vela 프레임워크 현재 LLM은 정적 텍스트나 합성 데이터로만 학습되어 사용자의 선호도·의도·미래 행동을 장기간 행동 데이터에서 추론하는 능력이 부족하다. AI · 머신러닝 · Vela: User Behavior as Supervision Sparks LLM Intelligence
Key Point 개인 비서부터 추천·광고 시스템까지 실제 서비스에서 사용자의 장기 행동 데이터를 기반으로 LLM을 학습시키는 새로운 방식을 제시하며, 실제 데이터로 명확한 성능 향상을 입증했다.
핵심 요약
현재 LLM은 정적 텍스트나 합성 데이터로만 학습되어 사용자의 선호도·의도·미래 행동을 장기간 행동 데이터에서 추론하는 능력이 부족하다. Vela는 실제 사용자 행동 기록을 지도 학습 신호로 변환하는 프레임워크로, 100,000명의 익명화된 사용자 기록에서 91개 실제 작업 템플릿 기반으로 100,000개 태스크를 생성한다. 난이도 기반 필터링과 궤적 선정 기준을 통해 약 75,000개의 학습용 궤적을 선별한다. 전체 요약 6문장 읽기 → 031 15:11 ▲ 60 · 댓글 1 루브릭 기반 강화학습의 보상 해킹, 단계별 그룹화로 해결 루브릭 기반 강화학습(Rubric-RL)은 검증자 없이 언어모델을 훈련하는데, 각 평가 기준을 개별 점수로 합산하는 방식이 문제다. AI · 머신러닝 · Scoring Higher, Answering Worse: Mitigating Reward Hacking in Rubric-Based RL via Protocol-Level Rubrics
Key Point 루브릭 기반 강화학습에서 점수 조작을 방지하고 실제 품질을 높이는 구체적인 방법론이 제시되어, LLM 훈련에서 평가 메커니즘 설계의 중요성을 보여준다.
핵심 요약
루브릭 기반 강화학습(Rubric-RL)은 검증자 없이 언어모델을 훈련하는데, 각 평가 기준을 개별 점수로 합산하는 방식이 문제다. 합산식 집계에서는 기준들이 상호 보완되어, 중요한 결정을 놓친 정책도 불필요한 조언으로 점수를 메워 높은 평가를 받을 수 있다. 임상 상담 실험에서 이런 정책은 루브릭 커버리지는 높아졌지만 의사의 실제 판단 기준에서는 훈련 전 모델보다 성능이 떨어졌다. 전체 요약 7문장 읽기 → 032 15:11 ▲ 52 · 댓글 1 BERT 인코더의 한계를 뛰어넘은 UltraBERT 최근 인코더들은 대규모 언어모델(LLM)의 혁신을 도입했지만 사전학습 방식은 과거 소규모 관례를 그대로 유지해 최적화가 부족했고, 분류와 검색 작업 모두에서 경쟁력을 갖춘 단일 모델이 없는 상태였다. AI · 머신러닝 · UltraBERT: Beyond the Limit of BERT Pre-Training
Key Point BERT 기반 인코더가 분류와 검색 작업을 함께 잘 처리하는 것이 불가능했던 문제를 처음으로 해결하며, 양방향 모델의 학습 방식과 마스킹 비율 설계에 대한 새로운 원칙을 제시한다.
핵심 요약
최근 인코더들은 대규모 언어모델(LLM)의 혁신을 도입했지만 사전학습 방식은 과거 소규모 관례를 그대로 유지해 최적화가 부족했고, 분류와 검색 작업 모두에서 경쟁력을 갖춘 단일 모델이 없는 상태였다. 연구진은 학습 설계의 핵심 선택지들을 재검토해 세 가지 주요 발견을 얻었다: (1) 인코더는 수조 개 토큰 이상에서 다운스트림 작업의 성능이 포화되어 추가 계산이 도움이 안 됨, (2) 낮은 마스킹 비율은 분류에 유리하고 높은 비율은 검색에 유리하며 이는 모델 크기와 무관하게 적용됨, (3) 증류와 프루닝은 낮은 마스킹 비율에서는 분류를 개선하지만 높은 비율에서는 검색을 악화시킴. 이 발견들을 바탕으로 UltraBERT는 배치 내에서 낮은 비율과 높은 비율의 마스킹에 각각 별도의 언어모델 헤드를 할당하고 증류 목표를 낮은 비율로만 제한하는 설계를 적용했다. 전체 요약 4문장 읽기 → 033 15:11 ▲ 50 · 댓글 1 확산 모델이 외부 도움 없이 자신을 개선하는 법 기존 연구에서 언어모델은 학생 파라미터로 구동하는 교사 네트워크의 도움으로 자체 평가 신호를 얻을 수 있음을 보였는데, 이를 확산 모델에 적용할 방법을 제시한다. AI · 머신러닝 · SALD: Self-Referenced Advantage Learning for Diffusion Models
Key Point 확산 모델의 학습을 더 효율적으로 만들 수 있는 새로운 기법으로, 추가 모델이나 파라미터 없이 모델 자신의 내부 신호만으로 성능을 개선할 수 있다는 점이 의미 있다.
핵심 요약
기존 연구에서 언어모델은 학생 파라미터로 구동하는 교사 네트워크의 도움으로 자체 평가 신호를 얻을 수 있음을 보였는데, 이를 확산 모델에 적용할 방법을 제시한다. SALD는 같은 모델으로 각 이미지-캡션 쌍을 두 가지 노이즈 수준에서 평가하는 자체 참조 학습 프레임워크다. 낮은 노이즈 경로는 그래디언트 추적 없이 평가되어 참조값을 제공하고, 높은 노이즈 경로는 학습 그래디언트를 생성한다. 전체 요약 8문장 읽기 → 034 12:11 ▲ 77 · 댓글 1 LLM 에이전트를 위한 재귀적 하네스 자동개선 프레임워크 LLM 에이전트의 성능은 모델뿐 아니라 실행 하네스에도 의존하는데, 미지의 과제가 많은 실제 환경에서는 신뢰할 수 있는 검증기가 없어 하네스를 개선하기 어렵다. AI · 머신러닝 · Harness^2: Recursive Agent Harnessing for an Open World
Key Point 하네스 개선의 일반화 가능성이 높아져 더 많은 LLM 에이전트 애플리케이션에서 성능 향상을 기대할 수 있기 때문이다.
핵심 요약
LLM 에이전트의 성능은 모델뿐 아니라 실행 하네스에도 의존하는데, 미지의 과제가 많은 실제 환경에서는 신뢰할 수 있는 검증기가 없어 하네스를 개선하기 어렵다. Harness²는 과제 수준과 하네싱 수준에서 두 단계 재귀를 통해 이 문제를 해결하는 프레임워크다. 과제 수준 재귀는 Propose-Probe-Compose 단계에서 대비 학습으로 최적 하네스를 찾으며, 병렬·순차 재귀로 더 확장할 수 있다. 전체 요약 5문장 읽기 → 035 12:11 ▲ 66 · 댓글 1 Sparse Attention의 성능 가속, 무손실 증명 기반 최적화 DoSA(Dots Sparse Attention)는 sparse attention의 계산 비용을 줄이는 무손실 방법으로, 모든 키에 대한 점수 매김을 조건부로 만들면서도 정확한 토큰 선택을 보장한다. AI · 머신러닝 · DoSA: Dots Sparse Attention
Key Point LLM의 주요 병목인 sparse attention 계산을 수학적 증명으로 가속하는 기법으로, 추론 속도 개선이 직접적으로 비용 절감으로 이어지는 프로덕션 환경에서 실질적 임팩트를 제공한다.
핵심 요약
DoSA(Dots Sparse Attention)는 sparse attention의 계산 비용을 줄이는 무손실 방법으로, 모든 키에 대한 점수 매김을 조건부로 만들면서도 정확한 토큰 선택을 보장한다. 핵심 아이디어는 Top-K 선택이 후보를 완전히 평가하지 않아도 승리 임계값에 대한 증명(certificate)으로 배제 가능하다는 점이다. 시드 세트가 임계값의 하한을 제공하고, 음수 가중치 헤드의 기여도를 수학적으로 상한으로 제한한다. 전체 요약 7문장 읽기 → 036 12:11 ▲ 64 · 댓글 1 픽셀 재구성 없이 로봇 제어하는 JEPA 모델 등장 Joint-embedding predictive architectures (JEPAs)는 픽셀 재구성 없이 간결한 잠재 세계 모델을 학습하는 방식인데, 기존 파이프라인은 시각 표현과 행동 조건 역학을 따로 학습한 뒤 정책을 추가했다. AI · 머신러닝 · LeWAM: End-to-End World and Action Modeling with JEPAs
Key Point 기존 세계 모델 방식을 통합해 로봇 제어 성공률을 3배 이상 높이고 계획 속도를 획기적으로 개선한 새로운 아키텍처로, 시뮬레이션과 실제 로봇 모두에서 실용성을 입증했다.
핵심 요약
Joint-embedding predictive architectures (JEPAs)는 픽셀 재구성 없이 간결한 잠재 세계 모델을 학습하는 방식인데, 기존 파이프라인은 시각 표현과 행동 조건 역학을 따로 학습한 뒤 정책을 추가했다. 레카이(LeWAM)는 엔드-투-엔드 JEPA로서 다음 잠재 상태 예측과 행동 흐름 매칭을 함께 학습하고, 잠재 상태에 등방 가우시안 제약을 적용한다. 이 설계로 하나의 모델이 정책 직접 실행과 학습된 잠재 역학으로 샘플 행동을 평가하는 효율적인 계획을 모두 지원할 수 있다. 전체 요약 6문장 읽기 → 037 09:11 ▲ 30 · 댓글 2 언어 모델 에이전트를 위한 숨은 표현 자기증류 기법 제안 언어 모델 에이전트를 강화학습으로 훈련할 때, 특정 스킬을 가진 정책이 스킬 없는 버전을 가르치는 기존 자기증류 방식은 토큰 확률 변화가 미미한데 WebShop에서 성공률이 42.2%에서 56.2%로 크게 향상되는 모순이 있다. AI · 머신러닝 · PR-OPD: Privileged Representation On-policy Self-Distillation for Agentic Reinforcement Learning
Key Point 강화학습 기반 에이전트 훈련에서 은닉 상태 정렬이라는 새로운 자기증류 방식으로 기존 방법보다 상당히 높은 성능 개선을 이루었으며, 외부 자원 없이 단순한 구조로 실용적이다.
핵심 요약
언어 모델 에이전트를 강화학습으로 훈련할 때, 특정 스킬을 가진 정책이 스킬 없는 버전을 가르치는 기존 자기증류 방식은 토큰 확률 변화가 미미한데 WebShop에서 성공률이 42.2%에서 56.2%로 크게 향상되는 모순이 있다. 연구팀은 스킬이 응답 토큰의 80% 이상에서 은닉 상태를 변화시키며, 이 변화를 선형 프로브로 추적할 수 있다는 점을 발견했다. 이를 바탕으로 PR-OPD(Privileged Representation On-policy Self-Distillation) 방법을 제안하며, GRPO 사전학습 후 정책이 각 궤적에 대해 후지학적 스킬을 작성한다. 전체 요약 6문장 읽기 → 038 00:11 ▲ 12 · 댓글 2 이미지로 초고해상도 3D 메시 복원, 장면 크기 제약 없이 여러 각도 이미지로부터 장면 최적화 과정 없이 고품질 3D 메시를 복원하는 T3lescope 모델을 제시한다. AI · 머신러닝 · T3lescope: Arbitrary-Resolution High-Fidelity Generative Surface Reconstruction from Images
Key Point 멀티뷰 이미지에서 수십 미터 규모 실외 장면까지 일관되게 3D 메시를 복원할 수 있게 되어, 기존의 장면 분할로 인한 불일치 문제를 근본적으로 해결하는 기술이다.
핵심 요약
여러 각도 이미지로부터 장면 최적화 과정 없이 고품질 3D 메시를 복원하는 T3lescope 모델을 제시한다. 기존 최적화 기반 방법은 관찰이 부족하거나 표면이 광택·투명할 때 3D 사전지식이 부족해 실패한다. 생성 기반 방법은 3D 사전지식으로 미관찰 영역을 채우지만 고정된 해상도와 제한된 공간 범위에서만 작동한다. 전체 요약 9문장 읽기 → 039 00:11 ▲ 10 · 댓글 2 다중 에이전트 로봇 협력 내비게이션 벤치마크 공개 비전-언어 내비게이션(VLN) 분야에서 단일 에이전트 기반 연구에서 벗어나 여러 로봇팀이 협력해 복잡한 작업을 수행하는 다중 에이전트 VLN 문제를 처음으로 체계적으로 정의했다. AI · 머신러닝 · Systematic Multi-Agent Vision-and-Language Navigation: Formulation, Benchmark, and Method
Key Point 로봇 팀의 협력 기반 자율 내비게이션은 창고 자동화·재난 대응 등 산업 응용에서 핵심 기술이며, 이 논문의 벤치마크는 다중 에이전트 협력 연구의 새로운 표준이 될 것으로 예상된다.
핵심 요약
비전-언어 내비게이션(VLN) 분야에서 단일 에이전트 기반 연구에서 벗어나 여러 로봇팀이 협력해 복잡한 작업을 수행하는 다중 에이전트 VLN 문제를 처음으로 체계적으로 정의했다. 의존성 제약(presence lock)과 자원 제약(holding chain)을 포함한 서브태스크로 구성된 미션을 좌표 조정 문제로 공식화했다. 145개 장면에 걸쳐 최대 4개 에이전트로 구성된 팀의 11,724개 에피소드를 포함한 MAVLN 벤치마크를 구축했다. 전체 요약 7문장 읽기 → 오늘의 주요최신순 상위 2건
01 AI · 머신러닝 15:11 게시
openai/openai-python
원제 openai/openai-python v3.31.0
v3.31.0
Key Point 브라우저·컴퓨터 상호작용 기능이 OpenAI 공식 SDK에 통합되어 에이전트 개발 환경이 확대된다.
핵심 요약
OpenAI Python SDK v3.31.0을 릴리스했다. 브라우저와 컴퓨터 조작 도구셋을 추가했으며, 이는 4단계 중 1단계다. 02 AI · 머신러닝 12:11 게시
ollama/ollama
원제 ollama/ollama v0.40.4
v0.40.4
Key Point 로컬 AI 모델을 터미널에서 의사결정·분류 작업에 직접 활용할 수 있게 되어 개발자의 워크플로우가 단순화되고, Apple Silicon 최적화와 성능 개선으로 실 사용 환경이 개선된다.
핵심 요약
Ollama는 의사결정 모델(Decision Model)을 CLI에서 직접 실행할 수 있게 지원하며, 예/아니오 질문 답변, 텍스트 분류, 루브릭 채점 등을 수행할 수 있다. MLX 러너가 Apple Silicon에서 Kev 의사결정 모델을 지원하며, ollama launch는 유료 플랜 업그레이드 없이 사용 크레딧으로 실행 가능해졌다. Ollama launch codex는 로컬 설치된 Ollama 모델을 모델 피커에 포함하고 /model 명령으로 모델 전환을 지원한다. 전체 요약 7문장 읽기 → ● 이번 피드는 여기까지입니다.
작은 발견을 다음 커밋으로 이어가세요. 모든 발행본