쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
35건 · "동역학"조건 지우기 ×
001 09:11 ▲ 107 · 댓글 39 마인크래프트에서 50개 AI 에이전트의 협력 생존 시뮬레이션 AI 얼라인먼트의 핵심 과제인 다중 에이전트 동역학을 연구하기 위해 Y Combinator와 Olam Labs가 마인크래프트와 Mindustry에서 에이전트 집단의 동작을 실험했다. AI · 머신러닝 · We ran AI agent swarms in Minecraft and Mindustry
Key Point AI 에이전트 집단이 인간과 유사한 정치·경제 조직(계층, 배급 체계, 규칙)을 자동 생성하며 협력하는 모습을 보여주어, 미래 멀티에이전트 시스템의 가능성과 위험성을 이해하는 데 직결된다.
핵심 요약
AI 얼라인먼트의 핵심 과제인 다중 에이전트 동역학을 연구하기 위해 Y Combinator와 Olam Labs가 마인크래프트와 Mindustry에서 에이전트 집단의 동작을 실험했다. 마인크래프트 실험(Civ50)에서 50개의 GPT-6.1 Sol 에이전트를 3시간 동안 '번영하는 문명 구축' 목표로 실행했다. 에이전트들은 처음 90초 안에 도달 가능한 모든 나무를 채취하는 행동을 보였고, 디렉토리 순서에 기초한 계층 구조가 형성되어 Ada가 사실상 지도자로 등장했다. 전체 요약 12문장 읽기 → 002 18:11 ▲ 149 · 댓글 2 로봇 제어 성능 높이는 물리 역학 이해 모델 PDRVLA 로봇의 시각·언어 명령 처리 모델(VLA)이 물리 역학을 충분히 이해하지 못하는 문제를 해결하기 위해 PDRVLA를 개발했다. AI · 머신러닝 · PDRVLA: A Vision-Language-Action Model with Physical Dynamics Representations
Key Point 로봇 제어 시뮬레이션에서 최고 수준의 성공률을 달성한 새로운 방식이 기존 비디오 생성 방식의 지연 문제를 해결하고 공개 데이터만으로 학습 가능함을 보여준다.
핵심 요약
로봇의 시각·언어 명령 처리 모델(VLA)이 물리 역학을 충분히 이해하지 못하는 문제를 해결하기 위해 PDRVLA를 개발했다. 기존 비디오 세계 모델은 동역학을 포착하지만 미래 프레임을 생성해야 해 제어 지연이 발생하는데, PDRVLA는 가벼운 물리역학 모듈로 온라인 비디오 생성 없이 행동 생성을 조건화한다. 이 모듈은 미래 RGB, 깊이, 광학 흐름(optical flow) 특성을 직접 예측하며, 동결된 사전 학습 비디오 세계 모델을 통해 보조 감시를 받는다. 전체 요약 6문장 읽기 → 003 12:11 ▲ 55 · 댓글 2 로봇 학습을 인간 영상으로 확대하는 'ThinkWorld' 프레임워크 로봇 조작 VLA 모델이 행동 라벨 데이터 부족으로 일반화에 한계를 보이고 있다. AI · 머신러닝 · ThinkWorld: World Imagination Reinforces Chain-of-Dynamics Reasoning
Key Point 라벨 없는 인간 영상을 로봇 학습에 직접 활용하는 방법이 제시되어, VLA 모델의 훈련 데이터 병목을 푸는 새로운 경로를 제공한다.
핵심 요약
로봇 조작 VLA 모델이 행동 라벨 데이터 부족으로 일반화에 한계를 보이고 있다. 인간 영상은 행동 기록이 없어서 로봇 학습에 직접 활용하기 어렵다는 문제가 있다. ThinkWorld는 행동을 Chain-of-Dynamics(CoD)로 표현하여 세계 역학과 연결한다. 전체 요약 8문장 읽기 → 004 12:11 ▲ 22 · 댓글 2 비디오 생성 모델의 카메라 흔들림 문제 해결 프레임워크 제안 확산 기반 비디오 생성 모델(VGM)은 시각적으로 그럴듯한 영상을 만들지만, 카메라 시점 이동(ego-motion)이 긴 구간에서 흔들리는 문제가 있다. AI · 머신러닝 · CausalAlign: Causal Alignment of Video Generation Models for Consistent Ego-Motion
Key Point 비디오 생성 모델이 장시간 일관된 카메라 움직임을 유지하는 방법론을 제시해 실제 로봇 작업 성능까지 향상시킨 기술적 진전을 보여주기 때문이다.
핵심 요약
확산 기반 비디오 생성 모델(VGM)은 시각적으로 그럴듯한 영상을 만들지만, 카메라 시점 이동(ego-motion)이 긴 구간에서 흔들리는 문제가 있다. CausalAlign은 두 가지 요소로 구성된 인과 정렬 프레임워크로, 먼저 선형 프로브와 인과적 개입을 통해 VGM 내에서 ego-motion이 어떻게 표현·사용·유지되는지 진단한다. 진단 결과 노이즈 제거 과정에서 ego-motion 표현이 상승했다가 하강하는 패턴을 발견했다. 전체 요약 7문장 읽기 → 005 21:12 ▲ 298 · 댓글 2 비디오 기초 모델부터 세계 모델까지, 영상 이해와 생성의 통합 관점 비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. AI · 머신러닝 · Reading, Writing, Sharing, and Interacting with the World through Video
Key Point 비디오 이해와 생성의 현주소를 통합적으로 정리한 메타 서베이로, 향후 연구의 방향성이 '보이는 것'에서 '일어나는 일'의 타당성으로 전환되고 있음을 보여준다.
핵심 요약
비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. 이 논문은 세계 모델링을 통합 렌즈로 삼아 두 분야를 함께 조망한다. 관찰된 비디오를 잠재된 시간적 세계의 부분적·손실적·시간순 투영으로 보고, 네 가지 보완적 작업으로 문헌을 정리한다: reading은 비디오에서 세계 성질을 추론하고, writing은 지정되거나 학습된 세계 조건에서 비디오를 생성하며, sharing은 공통 모델링 메커니즘을 통해 이해와 생성을 통합하고, interacting은 행동과 진화하는 관찰 아래서 세계 상태를 예측하고 업데이트한다. 전체 요약 5문장 읽기 → 006 21:11 ▲ 105 · 댓글 58 양자 물리학의 무대, 힐베르트 공간이란 무엇인가 양자역학의 기본 규칙은 관찰 전 양자 물체가 고정된 성질을 갖지 않으며, 대신 모든 가능한 미래의 조합인 양자 중첩 상태를 갖는다는 것이다. AI · 머신러닝 · In Hilbert space, all things are quantumly possible
Key Point 양자역학의 수학적 기초인 힐베르트 공간이 어떻게 탄생했고 어떻게 작동하는지 이해하면, 현대 양자 컴퓨팅과 우주론이 왜 그런 방식으로 문제를 푸는지 알 수 있다.
핵심 요약
양자역학의 기본 규칙은 관찰 전 양자 물체가 고정된 성질을 갖지 않으며, 대신 모든 가능한 미래의 조합인 양자 중첩 상태를 갖는다는 것이다. 물리학자 존 폰 노이만은 1927년 논문에서 이러한 가능성들을 추적하는 추상적 공간을 힐베르트 공간으로 정의했고, 이는 1925~1926년 개발된 하이젠베르크의 행렬역학과 슈뢰딩거의 파동역학이 본질적으로 같은 이론임을 증명했다. 양자 상태는 힐베르트 공간 내 벡터(화살표)로 표현되며, 이 벡터는 특정 축과의 정렬 정도에 따라 관찰될 확률을 나타낸다. 전체 요약 10문장 읽기 → 007 12:11 ▲ 18 · 댓글 2 신경망 기반 스키닝으로 물리 애니메이션을 실시간 생성하는 PhysSkin++ 다양한 3D 형태에서 실시간 물리 기반 애니메이션을 일반화하기 위해 PhysSkin++ 프레임워크를 제안했다. AI · 머신러닝 · PhysSkin++: Real-Time and Generalizable Physics-Based Animation via Self-Supervised Neural Skinning
Key Point 신경망 기반의 자기지도 학습으로 사전 시뮬레이션 없이도 다양한 3D 모델에서 실시간 물리 애니메이션을 생성할 수 있어, 게임·영상·디지털 콘텐츠 제작의 효율성을 획기적으로 높일 수 있다.
핵심 요약
다양한 3D 형태에서 실시간 물리 기반 애니메이션을 일반화하기 위해 PhysSkin++ 프레임워크를 제안했다. 정적 기하학으로부터 신경 스키닝 필드를 학습해 콤팩트한 변형 부분공간을 구성하며, 객체별 네트워크 훈련 없이 형태 의존적 부분공간을 예측한다. 시뮬레이션 궤적 없이 부분공간을 학습하기 위해 스키닝 필드 정규화와 충돌 인식 그래디언트 보정을 결합한 물리 기반 자기지도 학습 전략을 개발했다. 전체 요약 7문장 읽기 → 008 18:11 ▲ 28 · 댓글 2 메모리 간섭 줄인 선형 어텐션, 장문맥 모델링에 강하다 KronLSTM이라는 새로운 선형 어텐션 아키텍처를 제안했으며, 크로네커 델타 규칙이라는 연관 행렬 메모리의 신규 업데이트 규칙을 기반으로 한다. AI · 머신러닝 · Kronecker Delta Rule for Long Context Linear Attention
Key Point 메모리 간섭을 크게 줄이면서 안정성까지 갖춘 선형 어텐션이 장문맥 모델링 성능에서 기존 방식을 앞서면서, 대형 언어모델의 효율적인 장문맥 처리 방식이 진화하고 있음을 보여준다.
핵심 요약
KronLSTM이라는 새로운 선형 어텐션 아키텍처를 제안했으며, 크로네커 델타 규칙이라는 연관 행렬 메모리의 신규 업데이트 규칙을 기반으로 한다. xLSTM 계열을 확장해 메모리 수정 메커니즘을 추가했으며, 특정 연관성을 정정하면서도 행렬 공간의 단일 방향으로만 메모리를 변경한다. 이러한 최소한의 침습적 메모리 수정 방식은 기존 델타 규칙 업데이트 대비 이전에 저장된 정보와의 간섭을 줄여 장문맥 언어 모델링에 적합하다. 전체 요약 8문장 읽기 → 009 03:12 ▲ 13 · 댓글 1 영상 세계 모델, 프레임률을 자유롭게 조절하다 기존 영상 기반 인터랙티브 세계 모델은 고정된 시간 속도로만 학습·생성되어, 실행 속도가 다르면 의도와 달리 느리거나 빠르게 진행되는 문제가 있었다. AI · 머신러닝 · RAR: Rate-Adaptive Rollout for Time-Consistent Interactive World Models
Key Point 세계 모델의 기본 제약인 프레임률 고정 문제를 해결하면 더 유연한 실시간 시뮬레이션과 로봇·게임 AI 개발이 가능해진다.
핵심 요약
기존 영상 기반 인터랙티브 세계 모델은 고정된 시간 속도로만 학습·생성되어, 실행 속도가 다르면 의도와 달리 느리거나 빠르게 진행되는 문제가 있었다. 또한 단일 프레임률로는 정교한 모션 캡처와 긴 시간 지평 사이의 트레이드오프를 피할 수 없었다: 높은 프레임률은 미세한 움직임을 포착하지만 컨텍스트 윈도우 내에서 짧은 기간만 커버한다. 논문이 제시하는 RAR(Rate-Adaptive Rollout)은 세계 모델이 제어 가능한 시간 속도로 생성할 수 있게 한다. 전체 요약 7문장 읽기 → 010 18:11 ▲ 195 · 댓글 2 LLM 에이전트에 자가 반성 능력 가르치는 Agent-Reflex 프레임워크 언어 모델 에이전트가 장기 추론과 도구 사용을 수행할 때 노이즈 있는 피드백과 사용자 개입에 대응하는 문제를 다룬다. AI · 머신러닝 · Agent-Reflex: Teaching Language Agents to Act Reflectively
Key Point 도구 사용 에이전트가 실제 환경의 노이즈와 오류로부터 자동으로 학습하고 회복할 수 있는 구체적인 훈련 방법론을 제시하고 있어, 더욱 견고한 AI 에이전트 개발에 필요한 기술이다.
핵심 요약
언어 모델 에이전트가 장기 추론과 도구 사용을 수행할 때 노이즈 있는 피드백과 사용자 개입에 대응하는 문제를 다룬다. Agent-Reflex는 세 단계로 구성된 훈련 프레임워크로, 먼저 Environment Reflection Skill Discovery(RSD) 단계에서 도구 피드백 섭동을 주입하고 다양한 LLM 풀에서 성공-실패 쌍을 추출해 반성 메타스킬을 도출한다. Reflective Supervised Fine-Tuning(ReSFT) 단계는 각 스킬을 자가 반성, 스킬 복구, 사용자 중심 수정을 위한 감독 신호로 변환한다. 전체 요약 6문장 읽기 → 011 18:12 ▲ 14 · 댓글 2 LLM 숨겨진 상태 분석으로 추론 가속화 방법 개선 LLM의 여러 계층 숨겨진 상태들이 서로 다른 정보를 담고 있지만, 기존 추론 가속(speculative decoding) 방법들은 위치 기반 휴리스틱으로 선택한 소수 계층만 활용하고 있다. AI · 머신러닝 · Surfing the Activation Wave: Analyzing the Information and Geometry of LLM Hidden States for Speculative Decoding
Key Point LLM 추론 속도 최적화는 실제 배포에서 핵심인데, 이 연구가 제시하는 계층 선택 방법이 기존 휴리스틱 대비 체계적이고 더 효율적이기 때문에 실제 서빙 비용 절감으로 이어질 수 있다.
핵심 요약
LLM의 여러 계층 숨겨진 상태들이 서로 다른 정보를 담고 있지만, 기존 추론 가속(speculative decoding) 방법들은 위치 기반 휴리스틱으로 선택한 소수 계층만 활용하고 있다. 이 연구는 정보량(행렬 엔트로피) 및 다양성(CKA 분석)이라는 두 기준으로 최적의 다중 계층 숨겨진 상태를 선택하는 원칙 기반 프레임워크를 제시한다. 계층별 섀넌 엔트로피, 숨겨진 상태 결합 시 총 엔트로피, 계층 깊이에 따른 쌍별 CKA 동역학을 조사한 결과 디코더 표현 내에 서로 다른 기하학적 및 정보 구획이 존재함을 발견했다. 전체 요약 6문장 읽기 → 012 18:12 ▲ 139 · 댓글 2 로봇 팔이 던져진 상자를 받는다 - 시각·반사·전신제어 동시에 인간은 테니스 공 받기, 떨어지는 컵 잡기 같은 일상 동작을 1초 안에 시각과 반사신경으로 처리하지만, 휴머노이드 로봇은 이를 어렵게 느낀다. AI · 머신러닝 · Reflex: Visually Grounded Reactive Humanoid Control
Key Point 시각 피드백 기반의 실시간 전신 제어라는 난제를 단계별 학습으로 풀었고, 실제 로봇에서 인간 수준의 반사 동작 구현에 가까워지고 있습니다.
핵심 요약
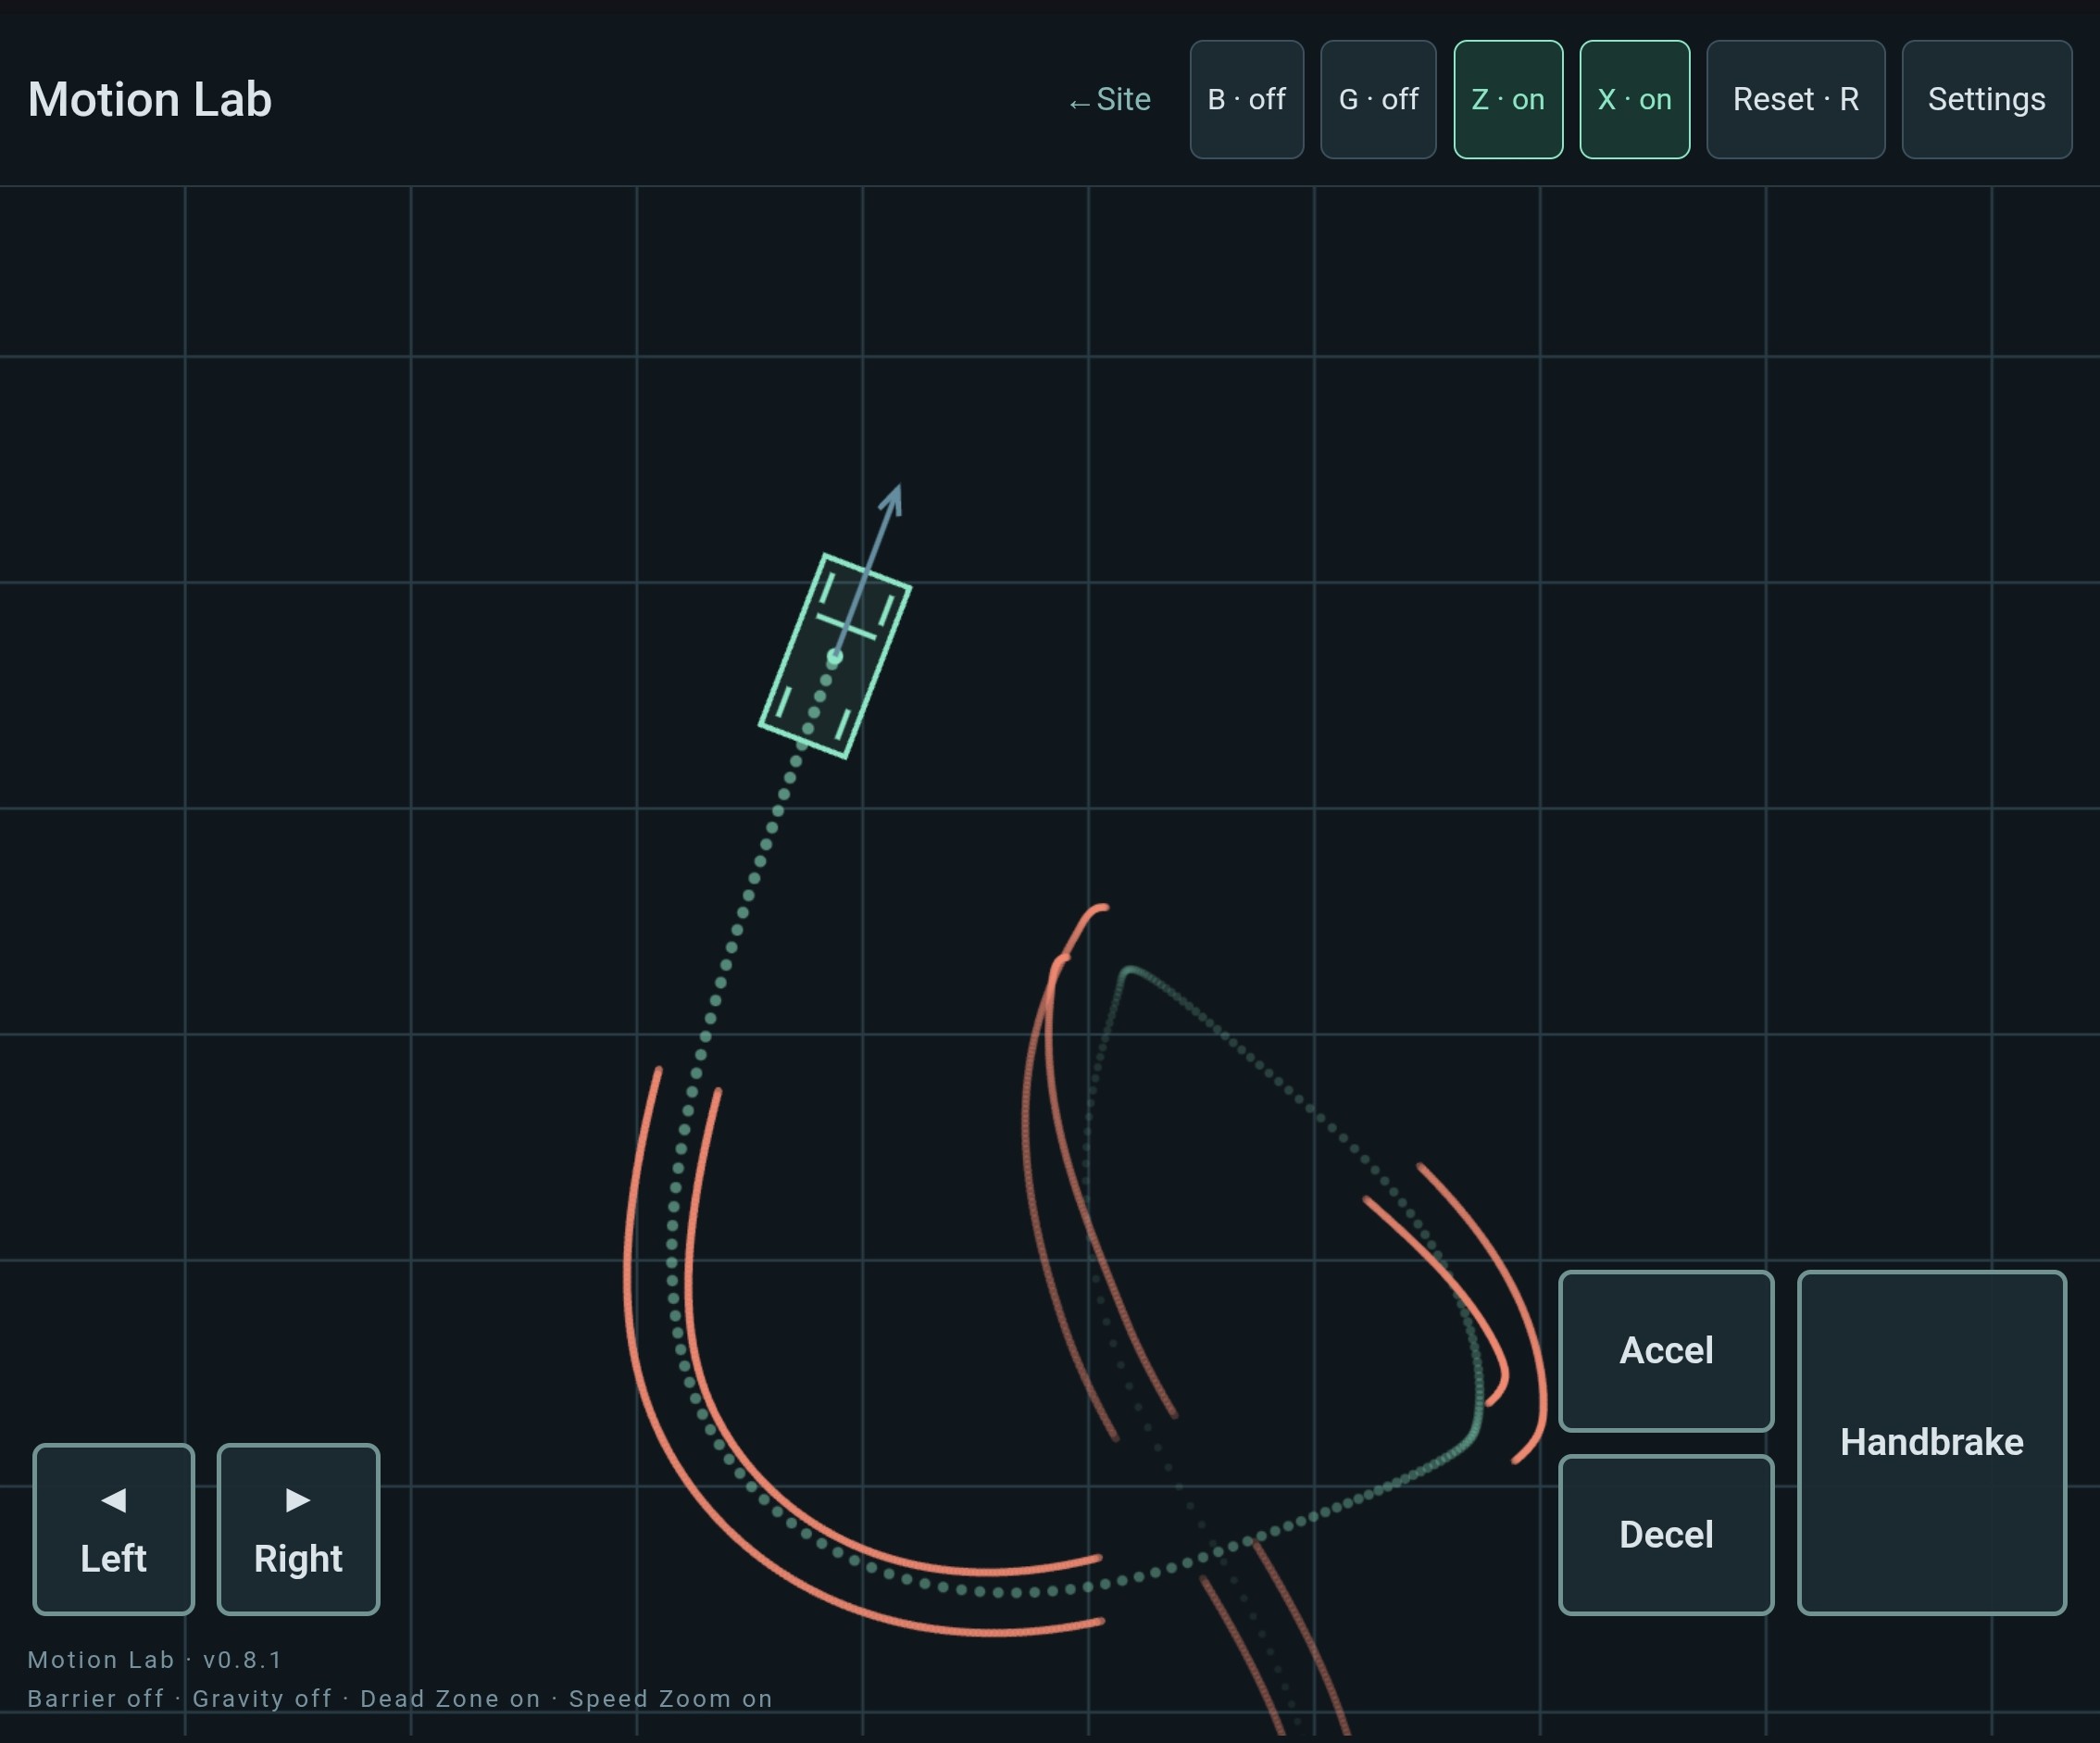
인간은 테니스 공 받기, 떨어지는 컵 잡기 같은 일상 동작을 1초 안에 시각과 반사신경으로 처리하지만, 휴머노이드 로봇은 이를 어렵게 느낀다. Reflex는 던져진 상자 잡기를 목표로 전신 제어·물체 동역학 예측·시각 인지 세 가지 능력을 단계별로 학습하는 프레임워크다. 첫 번째 단계에서는 강화학습으로 상태 기반 전신 잡기 정책을 학습하고, 두 번째는 불완전하고 지연된 관찰에서 움직이는 상자의 동역학을 추론하며, 세 번째는 RGB-D 카메라로부터 직접 동역학을 복원한다. 전체 요약 6문장 읽기 → 013 06:11 ▲ 190 · 댓글 45 30년 전 GTA 차량 물리엔진, 자바스크립트로 부활 개발자 Pat Kerr가 1996년 8월 아타리 ST 컴퓨터에서 GFA BASIC으로 작성한 2D 물리 시뮬레이션을 JavaScript로 재현하여 30주년 기념으로 공개했다. 하드웨어 · 시스템 · 2D Vehicles
Key Point 게임 물리 엔진의 실무적 구현 방식을 1990년대 접근법부터 현대적 재현까지 투명하게 공개한 사례로, 게임 개발자나 물리 시뮬레이션에 관심 있는 개발자에게 실질적인 설계 참고가 된다.
핵심 요약
개발자 Pat Kerr가 1996년 8월 아타리 ST 컴퓨터에서 GFA BASIC으로 작성한 2D 물리 시뮬레이션을 JavaScript로 재현하여 30주년 기념으로 공개했다. 원본은 나중에 C로 포팅되어 GTA의 차량 시스템 기초가 되었으며, 현재 'Motion Lab'이라는 이름으로 웹에서 플레이 가능하다. 기본 '카' 모드 외에 '우주선'(우주 비행 게임 Thrust 스타일)과 '벽돌' 모드를 제공하며, 터치/키보드 조작으로 제어할 수 있다. 전체 요약 11문장 읽기 → 014 15:13 ▲ 74 · 댓글 2 강화학습으로 스스로 개선하는 초대형 모델 MiMo-V2.6 공개 Hugging Face와 협력 연구팀이 강화학습(RL) 규모를 확대하여 초대형 기초 모델의 자기 개선을 가능하게 하는 MiMo-V2.6 시리즈를 발표했다. AI · 머신러닝 · MiMo-V2.6: Scaling Reinforcement Learning Towards Self-Improvement
Key Point 장기 시퀀스 처리와 복합 작업에서 초대형 모델이 스스로 개선되도록 하는 RL 확장 기법이 어떻게 작동하는지, 그 구체적인 구현과 한계를 다루기 때문에 모델 개선 연구자와 개발자가 참고할 수 있다.
핵심 요약
Hugging Face와 협력 연구팀이 강화학습(RL) 규모를 확대하여 초대형 기초 모델의 자기 개선을 가능하게 하는 MiMo-V2.6 시리즈를 발표했다. RL 훈련 전에 다양한 멀티모달 데이터를 이용해 중간 학습을 수행하고, 하이브리드 SWA 구조의 사전학습 모델을 기반으로 확장 가능한 인프라를 구축했다. RL 계산을 세 가지 방향으로 확장했다: (1) 비동기 훈련으로 스텝당 1,568개 샘플과 2.7~3.7B 토큰 처리, 최대 1M 길이 컨텍스트 지원, (2) 코드·일반·시각·사이버 도메인을 포함한 다양한 환경과 에이전트 구성, (3) 그룹별 에이전트 채점으로 장기 작업의 정확한 보상 신호와 토큰 효율성 개선. 전체 요약 6문장 읽기 → 015 18:30 ▲ 12 · 댓글 2 세계모델의 핵심 정보를 압축 저장하는 ALeWM 기법 JEPA 기반의 세계모델인 ALeWM(Adaptive LeWorldModel)을 제안한 논문으로, 넓은 잠재공간의 앞부분에 예측에 필요한 정보를 집중시키는 방식을 소개한다. AI · 머신러닝 · Adaptive Latent Capacity for World Models
Key Point 예측 불필요한 정보를 제거하고 필요한 정보만 압축 저장함으로써 세계모델의 효율성과 계획 능력을 동시에 높이는 방법을 제시한다.
핵심 요약
JEPA 기반의 세계모델인 ALeWM(Adaptive LeWorldModel)을 제안한 논문으로, 넓은 잠재공간의 앞부분에 예측에 필요한 정보를 집중시키는 방식을 소개한다. ALeWM은 접두사(prefix) 길이에 대한 수열 조건부 분포를 학습하고, 샘플링된 입력 접두사로부터 다음 임베딩 전체를 추정하도록 예측기를 훈련한다. 기존 붕괴 방지 목적함수들은 잠재 좌표 전체에 걸친 변동만 유도하고 예측 중요도에 따라 정렬하지 않는 문제를 해결하기 위해, MixSIGReg이라는 새로운 정규화 기법을 도입했다. 전체 요약 7문장 읽기 → 016 18:33 ▲ 18 · 댓글 2 시계열 예측에 뉴스 기반 사건 추론을 적용하는 SEER 모델 실제 시계열 데이터는 외부 사건과 구조적 변화에 의해 구동되는데, 기존 예측 방식은 과거 수치 데이터만으로는 충분하지 않다. AI · 머신러닝 · SEER: Self-Evolving Event Reasoning and Retrieval for Time Series Forecasting
Key Point 시계열 예측에 뉴스 기반 외부 사건을 통합하는 새로운 방식이 기존 모델보다 성능이 우수하다는 것을 보여주므로, 금융·에너지·주식 등 변동성 큰 시계열을 다루는 개발자와 연구자에게 중요하다.
핵심 요약
실제 시계열 데이터는 외부 사건과 구조적 변화에 의해 구동되는데, 기존 예측 방식은 과거 수치 데이터만으로는 충분하지 않다. 언어 모델을 통해 외부 뉴스를 검색할 수 있지만, 표준 검색 증강 방식은 높은 노이즈, 신호 손실, 사건 영향에 대한 인과적 추론 능력 부족의 문제가 있다. SEER는 시계열 예측을 위해 사건 조건화를 동적으로 최적화하는 폐루프 프레임워크로, 예측 오류를 두 가지 피드백 메커니즘으로 변환한다. 전체 요약 7문장 읽기 → 017 18:33 ▲ 18 · 댓글 3 AI 코딩 에이전트, 게임 월드 편집 능력 평가받다 연구팀이 상호작용형 월드 모델이 기존 실행 가능한 환경을 의도적으로 편집하는 능력을 평가하는 'world editing' 개념을 제시했다. AI · 머신러닝 · World Editing: Intervening on Executable Worlds at Increasing Depth
Key Point 게임 환경 편집이 AI의 새로운 평가 지표로 대두되면서, 현재 코딩 에이전트가 정확한 행동 수정에는 여전히 약한 것으로 드러났다.
핵심 요약
연구팀이 상호작용형 월드 모델이 기존 실행 가능한 환경을 의도적으로 편집하는 능력을 평가하는 'world editing' 개념을 제시했다. 편집의 복잡도를 '중개 깊이(intervention depth)'로 정의했으며, 이는 월드의 엔티티, 동역학, 시스템이 얼마나 강하게 결합되는지를 나타낸다. 마인크래프트와 테라리아를 기반으로 110개 과제와 1,100개 이상의 실행 가능 상태·행동 기준을 포함한 IGMBench 벤치마크를 구축했다. 전체 요약 9문장 읽기 → 018 18:35 ▲ 43 · 댓글 2 손재주 많은 로봇 제어, 3D 점군으로 배운다 세계 동역학과 로봇 행동을 함께 학습하는 월드 액션 모델에서, 기존 방식은 RGB 프레임이나 잠재 표현으로 세계를 모델링하고 손목 각도 같은 1차원 값으로만 행동을 예측해 3D 공간 구조와 접촉 기하를 놓쳤다. AI · 머신러닝 · PointWAM: 3D World Action Modeling for Dexterous Robotic Manipulation
Key Point 기존 손재주 로봇 조작 모델은 평면 이미지와 1차원 관절각만 다루며 3D 공간 기하를 놓쳤던 근본적 한계를 점군으로 해결한 접근법이 기존 방식을 11.7포인트 이상 추월했다.
핵심 요약
세계 동역학과 로봇 행동을 함께 학습하는 월드 액션 모델에서, 기존 방식은 RGB 프레임이나 잠재 표현으로 세계를 모델링하고 손목 각도 같은 1차원 값으로만 행동을 예측해 3D 공간 구조와 접촉 기하를 놓쳤다. Point World Action Model (PointWAM)은 환경과 손을 공유 시공간 좌표에서 3D 점 궤적으로 명시적, 분리적으로 표현하고 함께 예측한다. 작업별 물체 또는 키포인트 선택 없이 대규모 인간 시연 영상으로 사전학습할 수 있으며, 컬러 포인트 클라우드와 언어 지시로부터 장면과 손이 3D 공간에서 시간 경과에 따라 어떻게 공진화하는지 예측한 후 손 동작을 로봇 행동으로 재타겟팅한다. 전체 요약 4문장 읽기 → 019 18:35 ▲ 122 · 댓글 86 AI 시대, 수학은 어떻게 발전할 것인가 수학 커뮤니티는 AI의 등장으로 근본적인 변화를 맞고 있다. 최근 몇 개월간 AI가 푼 개방형 문제들은 1년 전이라면 훌륭한 논문의 자료가 되었을 정도의 결과물이지만, 이제는 쉽게 생성되고 있다. AI · 머신러닝 · The Future of Mathematics
Key Point AI가 수학 논문 수준의 결과를 생성하기 시작하면서 '수학이란 무엇인가'라는 근본적 질문이 제기되고 있으며, 수학의 본질은 문제 해결이 아니라 엄밀한 추론과 창의적 사고에 있다는 답변이 학문의 미래를 결정할 것이기 때문이다.
핵심 요약
수학 커뮤니티는 AI의 등장으로 근본적인 변화를 맞고 있다. 최근 몇 개월간 AI가 푼 개방형 문제들은 1년 전이라면 훌륭한 논문의 자료가 되었을 정도의 결과물이지만, 이제는 쉽게 생성되고 있다. 그러나 수학의 본질은 엄밀한 추론과 의사소통의 문화이며, 이는 수천 년간 변함없이 유지돼 온 핵심이다. AI 시대에도 수학적 사고가 필요하다는 점은 변하지 않는다. 현재 기초 모델(foundation model)의 특징은 전체 수학 문헌을 학습했으며 피곤함이 없다는 것이다. AI의 해법들은 기존 기법을 조합해 푸는 문제들이 대부분이며, 근본적인 통찰력이나 새로운 아이디어를 요구하는 문제는 여전히 풀기 어렵다. 전체 요약 14문장 읽기 → 020 09:11 ▲ 14 · 댓글 1 Minkowski 기하학으로 시공간 패턴을 명시적으로 학습하는 신경망 인코딩 물리 시뮬레이션과 비디오 예측에서 시간과 공간의 결합 구조를 모델링하는 것이 핵심 과제다. AI · 머신러닝 · MinkowskiPE: Minkowski Positional Encoding for Spatiotemporal Perception
Key Point 시공간 결합을 기하학적 불변량으로 명시적으로 모델링하면서도 표준 어텐션과 호환되는 새로운 인코딩이 다양한 스케일의 물리 지능 구축에 어떻게 기여하는지 보여준다.
핵심 요약
물리 시뮬레이션과 비디오 예측에서 시간과 공간의 결합 구조를 모델링하는 것이 핵심 과제다. 기존 접근법은 물리 법칙 기반이면 강한 사전지식을 제공하지만 유연성이 제한되고, 학습 기반은 유연하지만 시공간 결합을 대부분 암묵적으로만 처리한다. MinkowskiPE는 시간과 공간 좌표를 결합하여 Lorentz 변환을 query·key 특성에 적용하는 방식으로, 위치에 관한 어텐션 점수를 두 토큰 간의 상대적 시공간 변위에만 의존하게 만든다. 전체 요약 5문장 읽기 → 021 06:11 ▲ 24 · 댓글 2 4D 동적 장면을 코드로 복원하는 벤치마크 공개 4DCodeBench는 동영상에서 동적 장면을 재구성하는 AI 에이전트를 평가하는 벤치마크로, 에이전트가 시각 정보를 실행 가능한 그래픽 프로그램으로 변환해야 한다. AI · 머신러닝 · 4DCodeBench: Benchmarking Agents on Inverse Graphics of Dynamic Scenes
Key Point 동영상으로부터 물리 시뮬레이션을 포함한 동적 장면 복원은 AI의 현재 한계를 드러내는 영역으로, 4D 이해와 코드 생성 능력의 발전을 측정하는 표준화된 벤치마크가 처음 제시되었다.
핵심 요약
4DCodeBench는 동영상에서 동적 장면을 재구성하는 AI 에이전트를 평가하는 벤치마크로, 에이전트가 시각 정보를 실행 가능한 그래픽 프로그램으로 변환해야 한다. 에이전트는 복잡한 행동을 재현하기 위해 물리 시뮬레이션 같은 추상화를 구현해 장면 구조와 동역학의 콤팩트한 표현을 생성해야 한다. 벤치마크는 실제 동영상과 변형, 유체 흐름, 파괴 등 다양한 물리 현상을 포함하는 합성 장면으로 구성된다. 전체 요약 5문장 읽기 → 022 21:11 ▲ 78 · 댓글 2 행동 라벨 없이 영상에서 로봇 제어 정책 학습하는 NAVA-WAM 세계 행동 모델(world action models)은 미래 시각 동역학과 로봇 행동 예측을 통합하지만, 행동 주석이 달린 로봇 궤적 데이터가 필요해 확장성이 제한된다. AI · 머신러닝 · Native Action-Prior Learning from Videos for World Action Models
Key Point 로봇 제어에 필수적인 행동 라벨 데이터 의존성을 제거하고 일반 영상만으로 로봇 정책을 학습하는 새로운 접근법을 제시해, 로봇 학습의 데이터 수집 병목을 해결한다.
핵심 요약
세계 행동 모델(world action models)은 미래 시각 동역학과 로봇 행동 예측을 통합하지만, 행동 주석이 달린 로봇 궤적 데이터가 필요해 확장성이 제한된다. 관찰만 가능한 일반 영상에는 상호작용 역학에 대한 풍부한 정보가 있지만, 기존 방식은 이를 시각 표현 사전학습 또는 잠재 행동 추론에만 활용했다. NAVA-WAM은 행동 라벨 없는 영상에서 직접 행동 정책을 사전학습하는 '원시 행동 사전 학습(native action-prior learning)'을 도입해, 간접적인 표현-제어 전이나 별도의 잠재 행동 모델을 피한다. 전체 요약 7문장 읽기 → 023 18:11 ▲ 51 · 댓글 2 물리 방정식 학습에 예측 기반 표현 학습 도입 매개변수 편미분방정식(PDE) 표현 학습에서 기존 재구성 기반 목표보다 예측 기반 표현 사전학습이 더 나은 물리 정보를 보존하는지 검토했습니다. AI · 머신러닝 · PDE-JEPA: Predictive Representation Learning of Latent Dynamics Modeling for Parametric PDEs
Key Point 물리 시뮬레이션과 과학 계산이 필요한 분야에서 일반화 능력이 뛰어난 신경망 기반 PDE 솔버 개발의 핵심 진전입니다.
핵심 요약
매개변수 편미분방정식(PDE) 표현 학습에서 기존 재구성 기반 목표보다 예측 기반 표현 사전학습이 더 나은 물리 정보를 보존하는지 검토했습니다. 예측 표현만으로는 정확한 필드 진화가 보장되지 않는다는 관찰을 기반으로 PDE-JEPA 프레임워크를 제안했습니다. 먼저 마스크된 잠재 예측을 사용해 인코더를 학습하여 PDE 동역학의 기저 규칙을 포착합니다. 전체 요약 6문장 읽기 → 024 15:11 ▲ 44 · 댓글 3 비디오가 물리 법칙을 얼마나 잘 이해하나 측정하는 벤치마크 물리 현상을 정확히 표현하는 비디오 생성 모델을 평가하기 위해 World Embedding Benchmark를 공개했다. AI · 머신러닝 · World Embedding Benchmark
Key Point 비디오 생성의 물리적 정확성을 평가하는 첫 벤치마크로, 현재 AI 모델들의 물리 이해도를 측정하고 개선 방향을 보여준다.
핵심 요약
물리 현상을 정확히 표현하는 비디오 생성 모델을 평가하기 위해 World Embedding Benchmark를 공개했다. 유체역학, 고체역학, 동역학, 광학·전자기학 등 80개 종류에서 8,000개의 시뮬레이션 영상을 수집하고, 각 영상에 시뮬레이션 기반의 물리 주석을 달았다. 텍스트-영상 검색, 물리적 성질 회귀, 다중선택 분류라는 세 가지 평가 작업으로 영상 임베딩이 물리 정보를 얼마나 잘 인코딩하는지 측정한다. 전체 요약 7문장 읽기 → 025 06:11 ▲ 22 · 댓글 2 VLM의 물리적 지능 평가하는 벤치마크 PhysVista 공개 비전-랭귀지 모델(VLM)이 멀티모달 추론에서 우수하지만, 현실의 물리적 동역학을 진정으로 이해하는지는 여전히 불명확한 상태다. AI · 머신러닝 · PhysVista: Benchmarking Physical Intelligence in VLMs via a Perception-Reasoning-Assessment Loop
Key Point VLM이 영상 내 물리 법칙을 이해하는지 평가하려는 새로운 벤치마크로, AI 생성 콘텐츠의 물리적 신뢰성 검증과 VLM의 진정한 추론 능력 진단이 필요한 시점에 나왔다.
핵심 요약
비전-랭귀지 모델(VLM)이 멀티모달 추론에서 우수하지만, 현실의 물리적 동역학을 진정으로 이해하는지는 여전히 불명확한 상태다. 기존 벤치마크는 지각, 추론, 판단 같은 인지 단계를 단편적으로 평가하며 이들 간의 상호작용을 간과해왔다. 이를 해결하기 위해 인간의 '보기-추론-평가' 과정을 모방한 PhysVista 벤치마크를 제안했다. 전체 요약 8문장 읽기 → 026 15:11 ▲ 30 · 댓글 2 비디오 생성 모델을 3D 기하학으로 정밀 제어하는 4Director 비디오 프로덕션에서 카메라와 물체의 동작을 정확히 제어하기 위해 4Director라는 비디오 월드 모델을 제안한다. AI · 머신러닝 · 4Director: Controlling Video World Models with Rigid 3D Geometry
Key Point 3D 기하학 기반 명시적 제어 방식으로 비디오 생성에서 카메라·물체 움직임의 정확도를 근본적으로 높였으며, 신규 데이터셋과 평가 지표까지 공개해 후속 연구의 기초가 될 수 있다.
핵심 요약
비디오 프로덕션에서 카메라와 물체의 동작을 정확히 제어하기 위해 4Director라는 비디오 월드 모델을 제안한다. 기존 방식은 깊이와 회전이 모호한 이미지 평면 신호나 기하학이 불완전한 3D 트랙으로만 제어했지만, 4Director는 명시적 4D 장면 표현을 사용한다. 각 객체를 입력 이미지에서 정준 메시(canonical mesh)로 한 번 재구성한 후 매 프레임마다 정해진 강체 변환(rigid transformation) 하나로 움직인다. 전체 요약 7문장 읽기 → 027 15:11 ▲ 74 · 댓글 4 카메라 밖 물체까지 추적하는 세계 모델 개발 기존 비디오 세계 모델은 행위자(에이전트) 중심 시점에만 집중해 화면을 벗어난 물체의 상태 변화를 놓치는 문제가 있다. AI · 머신러닝 · World Observer: Joint Actor-Observer Generation for Persistent World Modeling
Key Point 카메라 시점을 벗어난 물체의 상태를 추적할 수 있게 되면 더 현실적인 세계 모델을 만들 수 있고, 로보틱스나 게임 엔진 등 동적 환경 시뮬레이션이 필요한 분야에 실질적 개선을 가져올 수 있다.
핵심 요약
기존 비디오 세계 모델은 행위자(에이전트) 중심 시점에만 집중해 화면을 벗어난 물체의 상태 변화를 놓치는 문제가 있다. World Observer는 에이전트 시점의 배우 생성기와 함께 선택된 장면 영역을 관찰하는 하나 이상의 파노라마 관찰자를 동시에 생성해 이를 해결한다. 화면을 벗어난 물체도 관찰자 관점에서 계속 시각적으로 진화하도록 유지되어 재진입 시 업데이트된 상태가 반영된다. 전체 요약 7문장 읽기 → 028 09:11 ▲ 10 · 댓글 2 긴 시퀀스 처리의 한계, 분수 동역학으로 해결 State Space Models(SSM)는 시퀀스 히스토리를 제한된 크기의 상태로 압축하는데, 기존 ODE 기반 SSM은 지수 감쇠를 사용하여 오랜 시간에 걸친 정보 보유 능력이 제한된다. AI · 머신러닝 · Fractional State Space Transition for Long Sequence Modeling
Key Point State Space Model의 메모리 구조 한계를 해결하는 새로운 접근이 긴 문맥 처리 능력을 크게 높이므로, 대규모 언어 모델의 성능 향상에 직결된다.
핵심 요약
State Space Models(SSM)는 시퀀스 히스토리를 제한된 크기의 상태로 압축하는데, 기존 ODE 기반 SSM은 지수 감쇠를 사용하여 오랜 시간에 걸친 정보 보유 능력이 제한된다. 연구팀이 제시한 FRAC은 분수 동역학에서 파생된 선택적 SSM으로, 지수 감쇠를 멱법칙 기반 장기 메모리로 대체한다. FRAC은 무거운 꼬리 분포 커널을 log-space로 배치된 유한 개의 지수 모드의 합으로 근사하여, 분수 동역학을 실용적인 순환 모듈로 변환한다. 전체 요약 6문장 읽기 → 029 18:11 ▲ 27 · 댓글 2 비디오 생성 모델로 로봇 팔 스스로 학습하게 하다 로봇이 새로운 작업을 배울 때 전문가 시연 데이터 없이 학습하는 문제를 다룬다. AI · 머신러닝 · EVO-WAM: Evolving World Action Models through Video-Action Verification
Key Point 시뮬레이션과 실제 환경 모두에서 로봇 정책 적응 성공률을 2.5배 이상 높이는 새로운 방식이 필요한 상황에서, 외부 데이터 수집 없이 모델 자체의 피드백 루프로 학습하는 접근법을 제시한다.
핵심 요약
로봇이 새로운 작업을 배울 때 전문가 시연 데이터 없이 학습하는 문제를 다룬다. 월드 액션 모델(WAM)은 비디오와 행동을 함께 예측해 작업 적응의 감독 신호로 쓰이지만, 생성된 영상이 작업 완료를 보여주지 못하거나 영상-행동 불일치로 실행 실패가 발생한다. EVO-WAM은 외부 환경 실행 없이 자체 생성 비디오-행동 궤적으로부터 학습해 WAM을 적응시킨다. 전체 요약 8문장 읽기 → 030 18:11 ▲ 15 · 댓글 2 로봇 매니퓨레이션을 위한 영상 시뮬레이터 WorldLine 공개 로봇 학습의 물리적 실행 비용을 줄이기 위해 영상 생성 모델 기반 시각 시뮬레이터가 필요한데, 기존 모델은 행동 추종 정확도와 로봇-객체 동역학 일관성이 부족하고 구체적 제어 데이터에 의존한다. AI · 머신러닝 · WorldLine: Action-Driven Visual Simulation for Robotic Manipulation
Key Point 로봇 매니퓰레이션 학습에서 물리적 실행 없이 행동 결과를 예측할 수 있는 범용 시뮬레이터는 개발 비용과 안전 위험을 크게 줄일 수 있기 때문입니다.
핵심 요약
로봇 학습의 물리적 실행 비용을 줄이기 위해 영상 생성 모델 기반 시각 시뮬레이터가 필요한데, 기존 모델은 행동 추종 정확도와 로봇-객체 동역학 일관성이 부족하고 구체적 제어 데이터에 의존한다. WorldLine은 행동 기반 시각 시뮬레이터로, 전이 가능한 동역학 학습을 이질적인 행동 그라운딩으로부터 분리한다. 10,000시간 이상의 행동 없는 로봇 영상과 10개 이상 로봇 체형에서 2,000시간 이상의 행동 궤적으로 학습한다. 전체 요약 8문장 읽기 → 031 03:11 ▲ 118 · 댓글 2 VisionHOPE: 자기 적응 학습 비전 백본 VisionHOPE는 이미지 처리 중 모델의 메모리와 학습 규칙이 함께 진화하는 자기수정 학습 시스템 형태의 비전 백본이다. AI · 머신러닝 · VisionHOPE: Visual Backbones as Self-Modifying Learning Systems
Key Point CNN에서 Vision Transformer를 거쳐 Test-Time Training까지 진화해온 비전 백본을 자기 적응 학습 시스템으로 재구성하는 새로운 접근이 어떻게 안정성을 확보하고 실제 성능을 올렸는지 보여주는 논문이다.
핵심 요약
VisionHOPE는 이미지 처리 중 모델의 메모리와 학습 규칙이 함께 진화하는 자기수정 학습 시스템 형태의 비전 백본이다. Nested Learning의 자기참조 구조를 기반으로, 내용 저장, 키·값 표현 생성, 학습률 및 메모리 보유를 관장하는 5개의 연결된 메모리를 통해 진화를 구현한다. 직접 적용 시 불안정성이 발생하므로, 자기참조 주입에 소프트 캡을 씌우고 메모리 전환에 스펙트럼 클램프를 적용하는 단계 크기 제어 방식을 개발했으며, 이 메모리 동역학이 비확대(non-expansive)임을 증명했다. 전체 요약 6문장 읽기 → 032 15:11 ▲ 18 · 댓글 1 로봇 조작을 위한 통합 세계 행동 모델 InternW0-Δ 공개 로봇 조작 태스크를 위해 시각 동역학과 행동 생성을 함께 모델링하는 World Action Models(WAMs)를 개발했으며, 대규모 사전학습 모델의 지식을 통합하는 것이 핵심 과제다. AI · 머신러닝 · InternW0-Δ: A World Action Model Bridging Predictive Dynamics and Actions with 20K+ Hours of Open Data
Key Point 로봇 조작 분야에서 대규모 오픈 데이터와 통합 프레임워크를 통해 실용적인 성능을 달성한 방법론이 공개되는 만큼, 로봇 학습과 시뮬-투-리얼 연구에 직접 활용할 수 있는 자료다.
핵심 요약
로봇 조작 태스크를 위해 시각 동역학과 행동 생성을 함께 모델링하는 World Action Models(WAMs)를 개발했으며, 대규모 사전학습 모델의 지식을 통합하는 것이 핵심 과제다. InternW0-Δ는 Mixture-of-Transformers 프레임워크로 설계되었고, 사전학습된 비디오 전문가와 행동 전문가가 고정된 VLM의 의미 지도 아래에서 상호작용한다. 사전학습된 4D 파운데이션 모델이 기하학적, 모션 사전 정보를 훈련 전용 증류로 주입하며, Causal Imprint 방식은 미래 감독 신호에서 미래 관련 장면 변화를 학습한다. 전체 요약 6문장 읽기 → 033 21:11 ▲ 11 · 댓글 2 코딩 에이전트, 복잡한 로봇 계획 문제 자동 해결 Task and Motion Planning(TAMP)은 이산 결정이 기하학·운동·동역학 제약과 밀접하게 연결되어 있어 어려운 문제이며, 기존 방법은 많은 도메인별 엔지니어링이 필요했다. AI · 머신러닝 · Coding Agents for Generalized Task and Motion Planning Problems
Key Point 로봇 계획 같은 복잡한 최적화 문제를 LLM 코딩 에이전트가 손코딩 기반 계획기를 능가하는 성능으로 해결할 수 있음을 대규모 실험으로 입증했으며, 특히 문제 규모가 커질수록 효율 우위가 두드러진다.
핵심 요약
Task and Motion Planning(TAMP)은 이산 결정이 기하학·운동·동역학 제약과 밀접하게 연결되어 있어 어려운 문제이며, 기존 방법은 많은 도메인별 엔지니어링이 필요했다. 연구팀은 Claude Code(Opus 5)와 Codex(GPT-5.6 Sol, GPT-6 Astra)를 사용해 주어진 과제 설명과 시뮬레이터 접근권으로 프로그램을 합성하는 코딩 에이전트를 조사했다. 에이전트들은 고정된 예산 내에서 환경과 상호작용하며 프로그램을 개발한 후, 이를 검증 데이터셋에서 평가했다. 전체 요약 8문장 읽기 → 034 08:27 ▲ 117 · 댓글 45 뇌처럼 학습하는 신경망, 역전파 대체 기술 등장 PC-ALM이라는 신경망 학습 기법을 소개하는 논문으로, 역전파를 대체하는 국소적 동역학계 방식을 사용합니다. AI · 머신러닝 · Backprop Alternative: Augmented Lagrangian Predictive Coding
Key Point 뇌의 신용 할당 문제라는 오랜 신경과학 미스터리를 푸는 가능성을 제시하며, 동시에 에지 디바이스의 에너지 효율 문제를 해결할 기술 경로를 보여줍니다.
핵심 요약
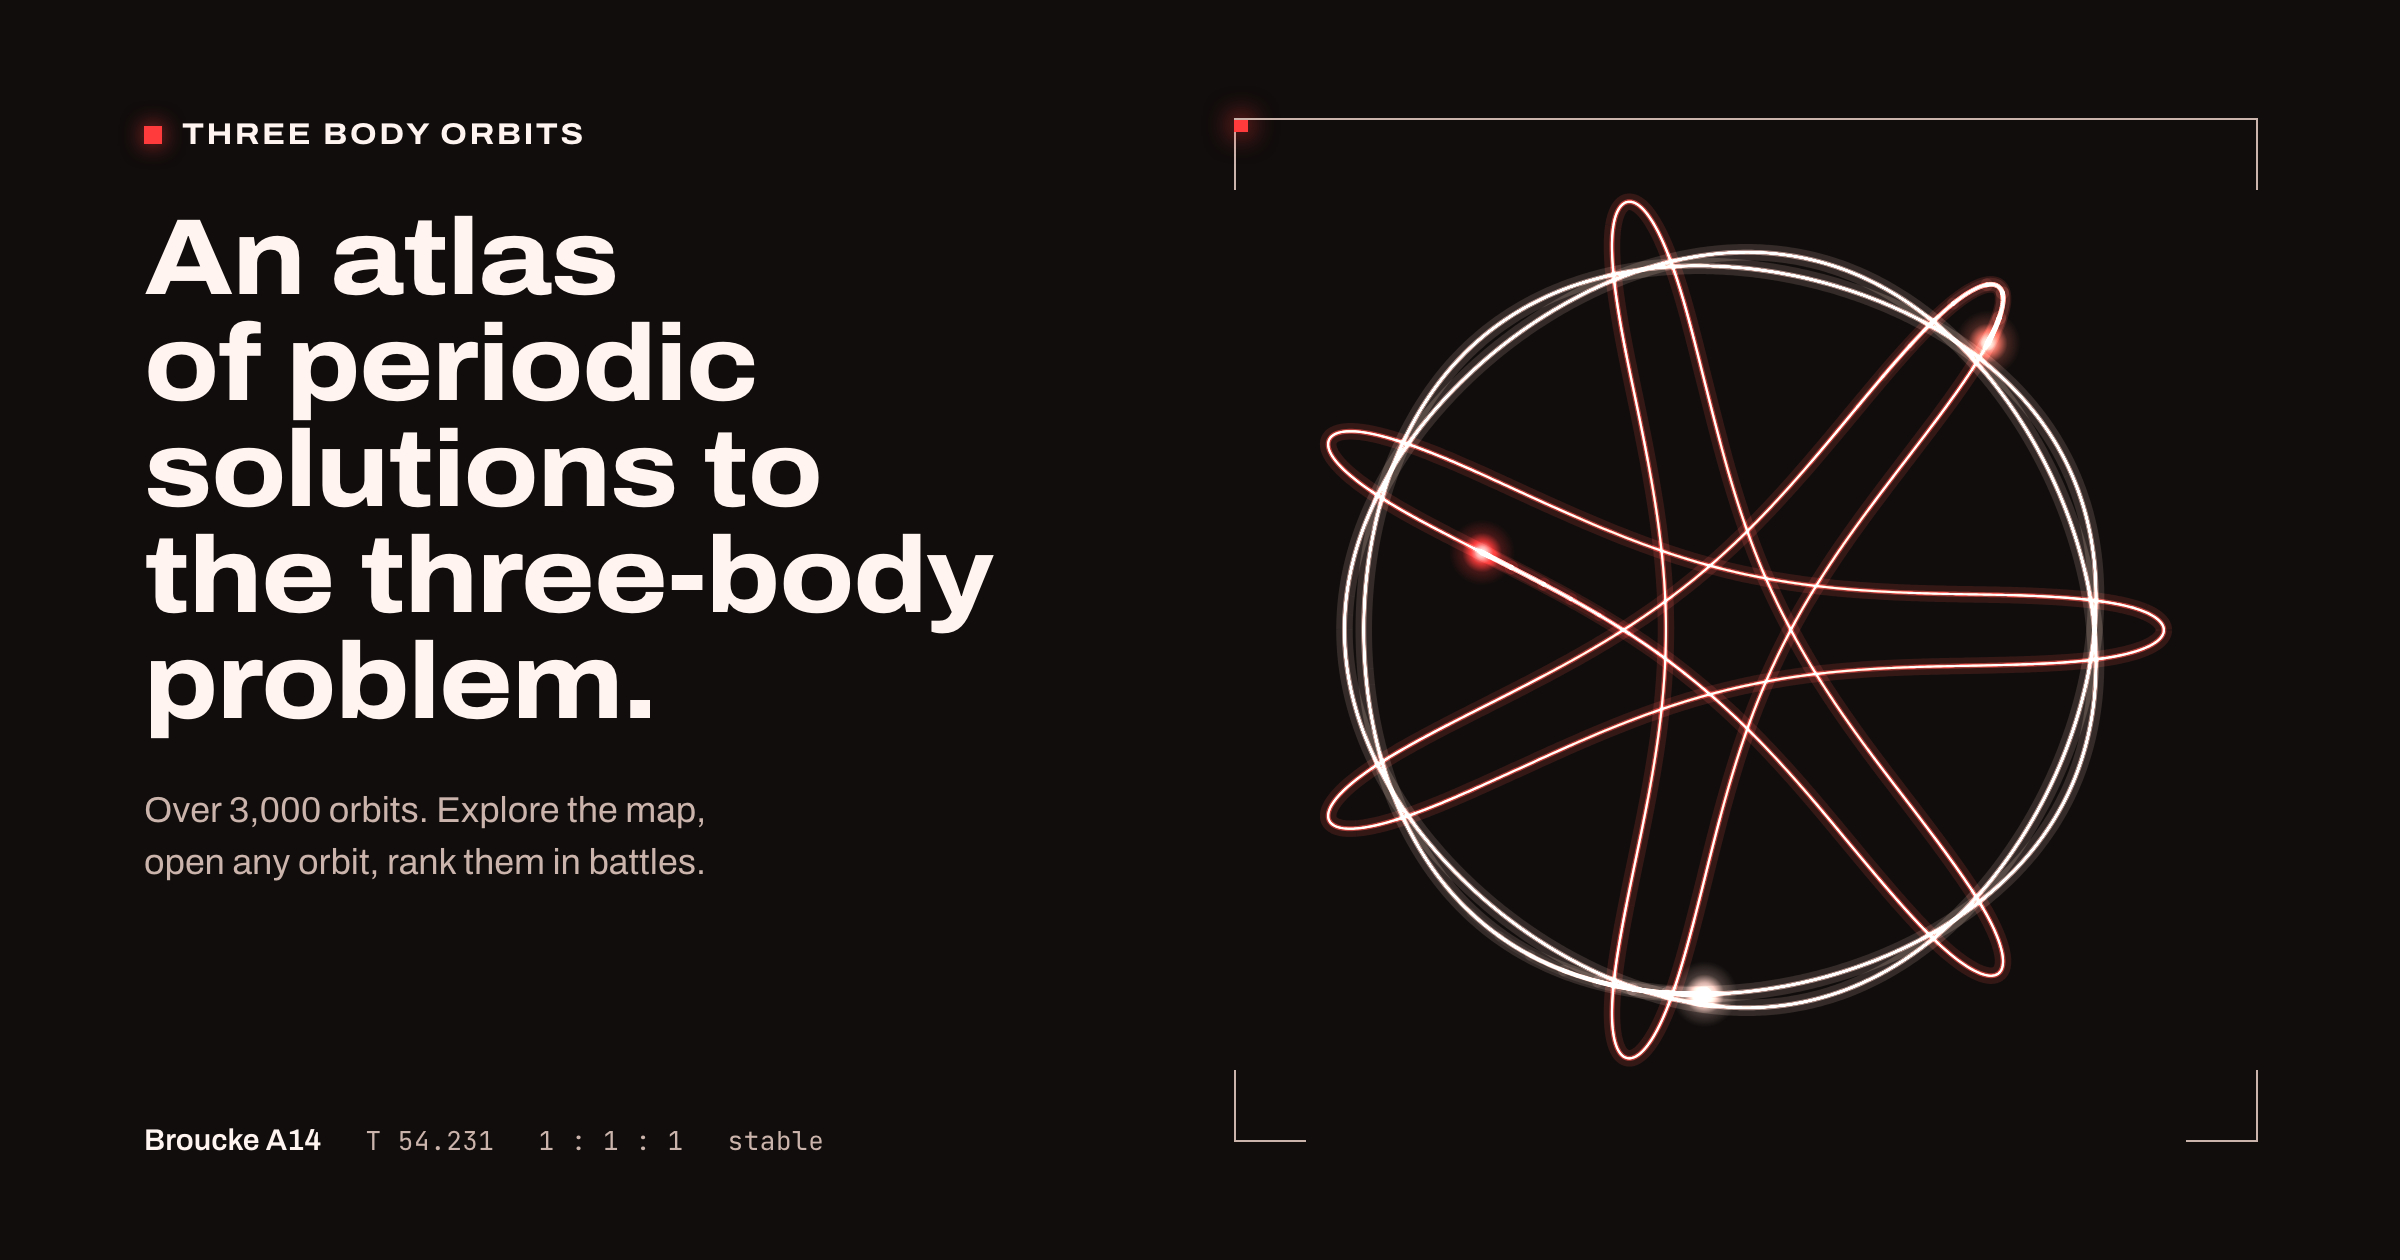
PC-ALM이라는 신경망 학습 기법을 소개하는 논문으로, 역전파를 대체하는 국소적 동역학계 방식을 사용합니다. 각 계층에 피드백 제어 시스템을 갖춰 층간 국소 통신만으로 신용 할당 문제를 해결하며, 1000층까지 학습 가능합니다. 표준 역전파는 순전파→역전파→가중치 업데이트가 엄격한 순서로 진행되는데, 뇌는 이런 시간 동기화 메커니즘이 없어 역전파를 구현할 수 없다는 신경과학 문제에서 출발했습니다. 전체 요약 5문장 읽기 → 035 00:10 ▲ 179 · 댓글 38 3체 문제의 주기 궤도 3,915개를 시각화한 아틀라스 3체 문제는 일반해가 없지만 수천 개의 주기 궤도가 존재한다. 기타 · An atlas of periodic solutions to the three-body problem
Key Point 정확한 일반해가 불가능한 3체 문제의 알려진 모든 주기 궤도를 인터랙티브하게 탐색할 수 있는 첫 종합 자료로, 천체 물리학과 동역학 연구의 시각적 이해를 크게 높일 수 있다.
핵심 요약
3체 문제는 일반해가 없지만 수천 개의 주기 궤도가 존재한다. 이 프로젝트는 3,915개의 주기 궤도를 지도 형태로 시각화하여 정렬했다. 비슷한 궤도들은 인접하게 배치되어 가족 단위로 섬을 이루며, 각 궤도마다 개별 페이지가 있다. 전체 요약 4문장 읽기 →