쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 22일 (일)까지 5067건
77건 · "동영상"조건 지우기 ×
001 15:11 ▲ 29 · 댓글 6 동영상을 36ms에 생성하는 FastFrames 공개 기존의 자동회귀 비디오 확산 모델(autoregressive video diffusion)은 대화형 비주얼 애플리케이션에 쓰기에 너무 느린 문제가 있다. AI · 머신러닝 · FastFrames: Video Generation at Interactive Latency
Key Point 대화형 비디오 생성에 필요한 36ms 지연시간을 달성해, 카메라나 센서 입력을 반영한 실시간 애플리케이션 개발이 현실적으로 가능해진다.
핵심 요약
기존의 자동회귀 비디오 확산 모델(autoregressive video diffusion)은 대화형 비주얼 애플리케이션에 쓰기에 너무 느린 문제가 있다. 논문은 추론 과정에서 VAE 디코딩과 KV 캐시 업데이트 같은 작업들이 전체 지연시간의 절반 이상을 차지한다는 것을 발견했다. 연구팀은 이러한 고정된 요소라고 여겨지던 부분을 가볍게 대체하여 FastFrames 모델군을 개발했다. 전체 요약 6문장 읽기 → 002 18:11 ▲ 14 · 댓글 2 단순한 트랜스포머로 동영상 확산 모델 만들기 JVT(Just Video Transformer)는 사전학습된 오토인코더나 보조 모듈 없이 픽셀 공간에서 동영상 확산 생성을 수행하는 대규모 패치 기반 DiT 스타일 트랜스포머이다. AI · 머신러닝 · JVT: Just Video Transformer makes pixel-space video diffusion simple
Key Point 단순한 아키텍처만으로도 고품질 동영상 생성이 가능함을 보여주는 효율적인 설계 원칙이 제시되며, 다중 모달리티 생성에 적용 가능한 새로운 접근법이다.
핵심 요약
JVT(Just Video Transformer)는 사전학습된 오토인코더나 보조 모듈 없이 픽셀 공간에서 동영상 확산 생성을 수행하는 대규모 패치 기반 DiT 스타일 트랜스포머이다. 기존 픽셀 공간 방식들과 달리 U-Net 스킵 연결이나 캐스케이드 구조 없이 설계돼 구조적으로 단순하다. 논문은 비디오 패치 임베딩, 레지스터 토큰, 적응형 레이어 정규화 등의 설계 선택지를 체계적으로 검토해 생성 품질과 계산 효율의 균형을 맞췄다. 전체 요약 7문장 읽기 → 003 18:11 ▲ 46 · 댓글 4 동영상 생성 AI, LLM의 물리 지식으로 스스로 학습한다 동영상 생성 모델들은 시각적으로는 현실적이지만 물리 법칙과 인과관계를 제대로 따르지 못한다. AI · 머신러닝 · PhysLoop: Harnessing LLMs' Physics Awareness for Self-Improving Video Generation Models
Key Point LLM의 물리 지식을 동영상 생성에 직접 녹여내는 방식으로, 인간 감독을 줄이면서 생성 AI가 스스로 개선되는 새로운 경로를 제시한다.
핵심 요약
동영상 생성 모델들은 시각적으로는 현실적이지만 물리 법칙과 인과관계를 제대로 따르지 못한다. 생성된 영상으로부터 학습하려면 정교한 물리 감독이 필요한데, 신뢰할 만한 품질 판단과 수정 쌍을 확보하기 어렵다. PhysLoop은 LLM이 지닌 물리 지식을 활용해 동영상 생성 모델이 스스로 개선되도록 돕는 통합 프레임워크다. 전체 요약 8문장 읽기 → 004 15:11 ▲ 12 · 댓글 3 동영상 그래픽 생성 평가 벤치마크 공개 대규모 언어 모델의 모션 그래픽 생성 능력을 평가하기 위해 정적 SVG 이미지에 애니메이션을 적용하는 100개 인스턴스 벤치마크 MotionGraphicsBench를 개발했다. AI · 머신러닝 · MotionGraphicsBench: Evaluating Motion Graphics Generation with Programmatic Verification
Key Point LLM이 복잡한 시공간 요구사항을 포함한 애니메이션 생성을 얼마나 정확히 수행하는지 측정하는 객관적 평가 방법이 제시되어, 모션 그래픽 생성 모델 개발에 표준을 제공한다.
핵심 요약
대규모 언어 모델의 모션 그래픽 생성 능력을 평가하기 위해 정적 SVG 이미지에 애니메이션을 적용하는 100개 인스턴스 벤치마크 MotionGraphicsBench를 개발했다. 각 벤치마크 인스턴스는 모델 입력, 모션 편집 프롬프트, 결정론적 검증 프로그램으로 구성되며, 이는 기준 애니메이션 비교나 VLM 판정 대신 요구 사항 만족 여부를 보고한다. 벤치마크는 실제 Lottie 모션 디자인에서 파생되어 다양한 시공간적 애니메이션 동작을 포함하며, 인간 라벨이 있는 애니메이션과 합성 테스트 케이스를 활용한 다중 에이전트 파이프라인으로 구축했다. 전체 요약 7문장 읽기 → 005 15:11 ▲ 100 · 댓글 81 저장소 위기 시대, AVIF 확산이 답인가 2026년 HDD, SSD, NVMe 가격이 치솟고 공급 부족이 심화하면서, 호스팅 서비스들이 가격 인상을 단행하고 있다. 웹 · 프론트엔드 · Time for AVIF everywhere?
Key Point 2026년 저장소 가격 폭등과 공급 부족이 심화하는 가운데, AVIF 같은 효율적 이미지 포맷의 광범위한 채택이 호스팅 비용과 대역폭을 실질적으로 줄일 수 있는 방법이라는 주장이 제시되고 있다.
핵심 요약
2026년 HDD, SSD, NVMe 가격이 치솟고 공급 부족이 심화하면서, 호스팅 서비스들이 가격 인상을 단행하고 있다. 저자는 Mastodon, Bluesky 등 서비스와 호스팅 제공자가 AVIF, WebP 같은 효율적인 이미지 포맷과 AV1, AV2 같은 비디오 포맷을 더 널리 지원해야 한다고 주장한다. AVIF는 WebP보다 우수한 압축률을 제공하면서도 이미지 품질을 유지하므로, 인터넷에서 매일 업로드되는 수십억 장의 이미지를 고려하면 저장 공간 절감이 상당할 수 있다. 전체 요약 14문장 읽기 → 006 21:11 당일 +324 공유 링크 붙여넣고 고속 다운로드, 윈도우용 YunX 데스크톱 앱 클라우드 저장소 및 동영상 공유 링크를 붙여넣으면 내용을 열람·미리보기·다운로드할 수 있는 윈도우 데스크톱 앱 YunX-Desktop이 공개됐다. 오픈소스 · 도구 · tidain/YunX-Desktop · Kotlin
Key Point 클라우드 저장소와 동영상 플랫폼의 공유 링크를 한 앱에서 통합 관리·다운로드할 수 있으며, 공식 오픈소스로 업그레이드되면서 지속적인 개발과 신뢰성이 보장된다.
핵심 요약
클라우드 저장소 및 동영상 공유 링크를 붙여넣으면 내용을 열람·미리보기·다운로드할 수 있는 윈도우 데스크톱 앱 YunX-Desktop이 공개됐다. 쿼크, UC, 선더, 바이두, 139, 123, 115, 라나토 등 주요 중국 클라우드 저장소와 틱톡, 快手, 웨이보, 소소스, 빌리빌리, AcFun, Pixiv 동영상을 지원하며 자성, BT 종자, ed2k 등 P2P 링크도 다룬다. Range 분할 다중 병렬 + 끊김 지점에서 재개 기능으로 고속 다운로드를 제공하고, 빌리빌리 고화질은 자동으로 음성과 영상을 합성한다. 전체 요약 10문장 읽기 → 007 15:12 ▲ 24 · 댓글 2 동영상 생성 AI에 인과관계 추론 능력 추가하는 'EvoWorld' 생성형 비디오 모델은 픽셀 렌더링에는 뛰어나지만 세계 상태 변화를 인과적으로 추론하는 능력이 부족해 동작이 정적이거나 인과관계가 불일치하는 결과물을 만든다. AI · 머신러닝 · EvoWorld: Towards Out-of-Sight World Evolution in Generative Video Models
Key Point 기존 비디오 생성 AI의 근본적 한계를 건드린다: 현실감 있는 이미지만 만드는 데서 벗어나 '왜'와 '그 다음'을 추론하는 세계 시뮬레이터로 나아가는 길을 제시한다.
핵심 요약
생성형 비디오 모델은 픽셀 렌더링에는 뛰어나지만 세계 상태 변화를 인과적으로 추론하는 능력이 부족해 동작이 정적이거나 인과관계가 불일치하는 결과물을 만든다. 예를 들어 야생동물이 나타났을 때 생성 모델은 그 이미지만 렌더링할 뿐, 근처 인물이 도망쳐야 할지 숨어야 할지 싸워야 할지 추론하지 못한다. 논문은 '시야 밖 인과진화(Out-of-Sight Causal Evolution)' 문제를 제안해 모델이 사건을 렌더링하고 그 결과를 추론한 뒤 시야 밖에서도 인과적으로 타당한 결과를 드러내도록 요구한다. 전체 요약 7문장 읽기 → 008 18:15 스타 2,306 Claude로 유튜브 쇼츠 만드는 무료 스킬 공개 Claude Code에서 쓸 수 있는 무료 애니메이션 단편 제작 스킬을 공개했다. 웹 · 프론트엔드 · mromidev/claude-animated-shorts · TypeScript
Key Point 직접 PC에서 고품질 애니메이션 쇼츠를 만들 수 있는 완전한 파이프라인과 학습 자료를 무료로 받을 수 있어, 창작자들이 외부 AI 동영상 생성 서비스에 의존하지 않고도 같은 수준의 결과물을 만들 수 있게 되었다.
핵심 요약
Claude Code에서 쓸 수 있는 무료 애니메이션 단편 제작 스킬을 공개했다. 55~70초 세로형 영상으로, 2D 캐릭터가 3D 세계에서 움직이는 구조다. three.js와 Remotion을 써서 자신의 PC에서 렌더링하며, AI 영상 생성 도구는 쓰지 않는다. 전체 요약 9문장 읽기 → 009 18:15 스타 1,867 한 장의 사진으로 AI 디지털 휴먼 영상 제작 한 장의 사진과 한 문장의 대사만으로 립싱크된 AI 디지털 휴먼 톡헤드 영상을 자동으로 생성한다. AI · 머신러닝 · andyhuo520/digital-human-koubo · TypeScript
Key Point Claude Code·Codex 같은 에이전트와 직접 통합되는 AI 동영상 자동화 도구로, 유튜브 톱 크리에이터의 편집 기법을 분석한 48개 컴포넌트와 견적 제어 시스템을 갖춘 프로덕션급 워크플로우가 처음 공개됐다.
핵심 요약
한 장의 사진과 한 문장의 대사만으로 립싱크된 AI 디지털 휴먼 톡헤드 영상을 자동으로 생성한다. Grok Video 1.5를 통해 최대 15초 단위 영상 클립을 생성하고, 음성은 별도 처리 후 스펙트럼 매칭으로 통일해 30개 이상의 분리된 클립이 하나의 녹음처럼 들리도록 한다. 유튜브 톱 크리에이터 25명의 영상을 프레임 단위로 분석해 추출한 48개의 패키징 컴포넌트(오프닝, 증거 카드, 주석, 리듬 효과 등)를 제공한다. 전체 요약 12문장 읽기 → 010 03:11 ▲ 217 · 댓글 166 구글, 제미니 오므니 1.2 플래시 공개 — 15초 동영상에 가격 30% 인하 구글이 제미니 오므니 1.2 플래시를 일반 공개했으며 가격을 30% 인하해 720p 동영상 기준 초당 0.07달러로 책정했다. AI · 머신러닝 · Gemini Omni 1.2 Flash
Key Point 영상 AI 모델의 실용성이 근본적으로 바뀌고 있습니다. 가격 인하와 15초 네이티브 생성, 다중 턴 편집은 상업 영상 제작 워크플로우를 단순화하고, 기존 스튜디오 작업 방식과 경쟁할 수 있는 규모를 만들고 있습니다.
핵심 요약
구글이 제미니 오므니 1.2 플래시를 일반 공개했으며 가격을 30% 인하해 720p 동영상 기준 초당 0.07달러로 책정했다. 기존 10초 제한에서 15초까지 동영상 생성이 가능하며 1초 단위로 3~15초 범위에서 지정할 수 있다. 캐릭터, 제품, 스타일 이미지와 최대 3초 모션 클립, 오디오 큐를 함께 입력하면 처음부터 끝까지 일관된 참조 유지로 가상 피팅, 상품 스핀, 브랜드 광고 제작이 용이해졌다. 전체 요약 11문장 읽기 → 011 18:11 ▲ 141 · 댓글 18 사이버보안 실전 학습 플랫폼 'pwn.college', 전 세계에 무료 공개 애리조나 주립대(ASU) 해킹 팀이 운영하는 pwn.college는 사이버보안 기초 기술을 실습하는 온라인 교육 플랫폼으로 전 세계 누구나 무료로 접근할 수 있다. 보안 · Pwn.college
Key Point 사이버보안 교육의 접근성 격차를 줄이는 대학 주도의 무료 플랫폼이 전 세계에 공개되었으며, 교육 기관이 자체 커리큘럼에 바로 적용할 수 있는 실습 자료를 확보할 수 있다.
핵심 요약
애리조나 주립대(ASU) 해킹 팀이 운영하는 pwn.college는 사이버보안 기초 기술을 실습하는 온라인 교육 플랫폼으로 전 세계 누구나 무료로 접근할 수 있다. 학습자는 '화이트 벨트'에서 시작해 도장(dojo)을 통해 단계적으로 CPU 명령어부터 네트워크 해킹까지 핵심 개념을 배운다. 총 108개의 해킹 모듈과 10개의 챌린지로 구성되었으며, ASU의 사이버보안 커리큘럼에 사용되고 전 세계 대학에서 학생 평가 자료로 쓰인다. 전체 요약 9문장 읽기 → 012 12:54 ▲ 173 · 댓글 16 텍스트-이미지 AI 모델, $21K로 학습 후 공개 2인 연구팀 Linum이 약 2만 1천 달러의 학습 비용으로 훈련한 Pyramid-JiT(P-JiT) 이미지 생성 모델을 Apache 2.0 라이선스로 공개했다. AI · 머신러닝 · Show HN: A decent text-to-image model trained for ~$20K (Apache 2.0 Weights)
Key Point 작은 팀이 주요 클라우드 AI 회사와 비교할 수 없는 수준의 비용으로 실용적인 이미지 생성 모델을 만들고 공개했으며, 이는 확산 모델의 효율성 개선 방향을 보여준다.
핵심 요약
2인 연구팀 Linum이 약 2만 1천 달러의 학습 비용으로 훈련한 Pyramid-JiT(P-JiT) 이미지 생성 모델을 Apache 2.0 라이선스로 공개했다. 모델은 2.42억 개의 파라미터(학습 시 포함)를 가진 확산 모델이며, 512²에서 1024² 해상도로 단계적으로 학습했고, Qwen 3.5-4B 텍스트 인코더를 사용한다. 기존 VAE 기반 압축 대신 픽셀 공간에서 직접 작업하고 32×32 토큰 압축으로 어텐션 컨텍스트 윈도우를 4배 축소했으며, 이전 모델보다 11배 적은 샘플로 수렴한다. 전체 요약 8문장 읽기 → 013 18:13 ▲ 25 · 댓글 2 동영상 감정 표현 평가하는 자기진화형 보상 체계 EmoReward GRPO가 코드와 수학 같은 검증 가능한 영역에서는 성과를 냈지만, 동영상의 감정 표현 평가는 주관적 미학에 의존해 객관적 평가 기준이 없는 문제가 있었다. AI · 머신러닝 · EmoReward: Self-Evolving Reward Calibration for Emotional Video Generation RL
Key Point 감정 표현이 있는 동영상 생성을 평가하려면 기존 고정 보상 방식보다 상황에 맞는 적응형 평가 체계가 필요한데, EmoReward가 학습 과정 자체에서 보상의 신뢰도를 학습해 자동으로 가중치를 조정하는 방법을 제시한다.
핵심 요약
GRPO가 코드와 수학 같은 검증 가능한 영역에서는 성과를 냈지만, 동영상의 감정 표현 평가는 주관적 미학에 의존해 객관적 평가 기준이 없는 문제가 있었다. 기존 방식은 시각 품질, 모션 품질, 텍스트 정렬에 고정된 보상을 사용해 감정 의도를 제대로 포착하지 못했고, 보상 조작 위험이 있으며, RLHF는 확장이 어렵고 개인 미학 차이에 따라 보정이 복잡해진다. EmoReward는 실제 학습 중에 수집한 보상 추적에서 증거 신뢰도를 추출해 다음 학습에서 다중 보상 가중치를 적응적으로 조정하는 자기진화 메커니즘을 제안한다. 전체 요약 8문장 읽기 → 014 21:11 당일 +984 광디스크에 눈에 보이는 그림을 새기는 도구 공개 Disc Image Studio는 CD·DVD·단층 BD-R 블루레이 광디스크 표면에 육안으로 보이는 패턴을 새길 수 있는 크로스플랫폼 도구다. 오픈소스 · 도구 · JiaFeiMiao-K-Cat/DiscImageStudio · C#
Key Point 오픈소스 개발자들이 만든 도구로 CD·DVD·블루레이 표면에 실제로 보이는 그림을 새길 수 있다는 독특한 기술이 구현되어 있고, 보정 알고리즘의 정확도 향상과 다양한 출력 형식 지원으로 실용성이 높다.
핵심 요약
Disc Image Studio는 CD·DVD·단층 BD-R 블루레이 광디스크 표면에 육안으로 보이는 패턴을 새길 수 있는 크로스플랫폼 도구다. 이미지를 입력하면 CD·DVD·블루레이의 물리층 제약을 만족하는 데이터로 변환해 생성된 ISO·RAW·WAV+CUE 파일로 내보내거나 공백 디스크에 직접 기록할 수 있다. CD는 WAV 음성 트랙 및 CUE 파일, DVD는 ISO 미러, BD-R은 UDF 2.01 파일 시스템을 지원하며 세 매체 모두 디스크 내 파일 저장 기능이 있다. 전체 요약 12문장 읽기 → 015 18:11 ▲ 27 · 댓글 2 동영상에서 학습 데이터를 자동 생성하는 AI 에이전트 멀티모달 학습 발전이 고품질 학습 데이터 부족과 높은 레이블링 비용으로 제한되고 있는 상황에서, VidUEU-Agent는 원본 동영상에서 자동으로 학습 데이터를 생성하는 파이프라인을 제시한다. AI · 머신러닝 · VidUEU-Agent: A Data-Curation Agent for Multimodal Understanding, Editing, and Unified Tasks
Key Point 동영상에서 자동으로 멀티모달 학습 데이터를 생성하고 최적화하는 방식이 멀티모달 AI 모델 개발의 데이터 부족 문제를 어떻게 풀 수 있는지 보여주는 실질적인 접근법이다.
핵심 요약
멀티모달 학습 발전이 고품질 학습 데이터 부족과 높은 레이블링 비용으로 제한되고 있는 상황에서, VidUEU-Agent는 원본 동영상에서 자동으로 학습 데이터를 생성하는 파이프라인을 제시한다. 4단계 파이프라인으로 구성되며, 저품질 장면을 필터링하고, 핵심 프레임과 멀티모달 신호를 추출한 뒤, 메타데이터를 구성하고 라우팅하여 학습 샘플을 합성한다. 에이전트 프레임워크는 다운스트림 학습 결과를 기반으로 자동으로 데이터 분포를 반복 최적화하여 데이터 품질, 균형, 학습 효율성을 개선한다. 전체 요약 5문장 읽기 → 016 15:11 ▲ 126 · 댓글 108 개발자가 본 1년 사이 AI 활용의 변화, 코딩은 에이전트 시대로 마이크로소프트 윈도우 AI팀에서 세일즈포스 AI 연구소로 이직한 개발자가 1년간 AI 활용 방식의 변화를 정리했다. AI · 머신러닝 · How I use AI (Oct 2026)
Key Point 한 해 사이 AI 코딩 에이전트가 소프트웨어 개발을 근본적으로 바꿨다. 속도 향상, 피로감, 창의성 상실이 동시에 일어나는 현장의 진솔한 기록.
핵심 요약
마이크로소프트 윈도우 AI팀에서 세일즈포스 AI 연구소로 이직한 개발자가 1년간 AI 활용 방식의 변화를 정리했다. 코딩 분야에서 가장 극적인 변화가 일어났다. 깃허브 코파일럿의 자동완성에서 벗어나 이제는 claudeCode 같은 에이전트 5~6개를 관리하며 일한다. 에이전트는 새 기능을 20분 안에 프로토타이핑하고, 테스트를 실행하며, PR까지 작성·검토한다. 기존에 손으로 작성하는 것과 비교해 속도, 유연성, 버그 해결이 획기적으로 향상됐다. 전체 요약 13문장 읽기 → 017 18:11 ▲ 25 · 댓글 2 동영상을 선택적으로 관찰하는 AI 자막 생성 시스템 멀티모달 대규모 언어 모델(MLLM)이 영상 자막을 생성할 때 사소한 세부 사항을 과도하게 강조하고 핵심 맥락을 놓치는 문제가 있다. AI · 머신러닝 · Reviso: Not All Visual Evidence Deserves Equal Attention in Video Captioning
Key Point 멀티모달 AI가 영상 분석 시 모든 부분을 동등하게 처리하는 문제를 선택적 관찰로 해결하는 새로운 접근이 보여 이후 자막 생성, 영상 이해 시스템 설계에 참고할 만하다.
핵심 요약
멀티모달 대규모 언어 모델(MLLM)이 영상 자막을 생성할 때 사소한 세부 사항을 과도하게 강조하고 핵심 맥락을 놓치는 문제가 있다. Reviso는 관찰 대상과 수집 방식을 학습하는 에이전트형 동영상 자막 시스템으로, 낮은 프레임율의 전체 미리보기에서 계층적 Context-Focus-Points(CFP) 계획을 세운다. CFP 계획은 영상 맥락을 파악하고 핵심 요소를 우선순위화한 뒤 구체적인 관찰 대상과 해당 도구를 정의한다. 전체 요약 8문장 읽기 → 018 15:11 ▲ 122 · 댓글 6 실시간 장편 영상 생성 위해 '웨이브 포싱' 기법 제시 실시간 장편 영상 생성을 위해 Wave Forcing(WF) 기법을 제안했다. 기존 청크 단위 자동회귀 방식은 직렬화된 노이즈 제거와 캐시 갱신으로 인해 한 단계 노이즈 제거에도 두 번의 순전파가 필요했다. AI · 머신러닝 · Wave Forcing: Towards Speed-of-Light Streaming Video Generation
Key Point 실시간 장편 영상 생성의 핵심 병목인 순차 처리 방식을 병렬화로 해결하는 구체적 기법이 제시되었고, 7배 이상의 성능 향상을 실현한 점이 주목된다.
핵심 요약
실시간 장편 영상 생성을 위해 Wave Forcing(WF) 기법을 제안했다. 기존 청크 단위 자동회귀 방식은 직렬화된 노이즈 제거와 캐시 갱신으로 인해 한 단계 노이즈 제거에도 두 번의 순전파가 필요했다. WF는 청크별 인과 주의 메커니즘으로 노이즈 제거가 완료되기 전 더 깨끗한 과거 청크에 먼저 접근하고, 엇갈린 노이즈 제거와 캐시 갱신 단계를 모델 복제본들에 분산시켜 파이프라인 충전 후 한 번의 순전파 라운드마다 하나의 출력 청크를 생성한다(1F1C). 모델을 연속 생성 프로세스에 적응시키기 위해 혼합 노이즈 노이즈 제거, 움직임 감독, 자체 생성 히스토리를 이용한 인과 적응을 순차적으로 도입하는 3단계 훈련 절차를 개발했다. 전체 요약 7문장 읽기 → 019 15:11 ▲ 74 · 댓글 2 영상 생성, 에이전트가 주도하는 시대로 동영상 생성이 단순 합성에서 계획·도구·피드백을 활용한 에이전트 기반 생성으로 전환되고 있다. AI · 머신러닝 · Video Generation Meets Agent Harness: Agentic Video Generation, Agentic World Modeling and Recursive Self-Improvement
Key Point 동영상 생성 기술이 에이전트 자율성과 결합되는 새로운 패러다임을 제시하며, 멀티 에이전트·장기 계획·하이브리드 환경이 미래 AI 시스템의 핵심 방향이 될 것을 보여준다.
핵심 요약
동영상 생성이 단순 합성에서 계획·도구·피드백을 활용한 에이전트 기반 생성으로 전환되고 있다. 에이전트 하네스는 동영상 모델 주변에 구성된 실행 런타임으로, 맥락·도구·상태·피드백·예산을 관리한다. 에이전트 비디오 생성은 스크립팅·샷 계획·에셋 관리·제작·편집을 조율하며, 이 시스템들의 평가가 과제다. 전체 요약 7문장 읽기 → 020 03:11 ▲ 23 · 댓글 2 동영상 검색 쿼리를 개인화된 의도대로 다시 쓰는 WeFair 웨이신 동영상 검색에서 사용자의 실제 의도를 모호한 쿼리로부터 복구하는 컴팩트한 쿼리 재작성 모델을 제안한다. AI · 머신러닝 · WeFair: Fidelity-Aware Alignment from Human Feedback for Personalized Query Rewriting in Short-Video Search
Key Point 사용자의 실제 검색 의도를 보존하면서 쿼리를 개선하는 기술이 온라인 서비스에서 입증된 효과를 냈기 때문에, 검색 시스템 개선에 관심 있는 개발자와 PM이 참고할 만하다.
핵심 요약
웨이신 동영상 검색에서 사용자의 실제 의도를 모호한 쿼리로부터 복구하는 컴팩트한 쿼리 재작성 모델을 제안한다. 기존 LLM 기반 방식은 사용자 행동 피드백을 과도하게 강조해 시청률 높은 콘텐츠를 우선하며 의도 편향을 야기한다. WeFair는 인간 피드백의 신뢰도를 할당해 시연(demonstration) → 선호(preference) → 검증(verification) 단계로 진행한다. 전체 요약 9문장 읽기 → 021 21:11 ▲ 103 · 댓글 72 지구를 망원경으로, 블랙홀 사진 찍기 블랙홀은 우주에서 가장 작은 천체인데도 매우 밝을 수 있으며, 중력이 너무 강해 빛도 탈출할 수 없는 사건의 지평선으로 정의된다. 기타 · How do you take a picture of a black hole?
Key Point 블랙홀 사진 촬영의 역사, 기술, 국제 협력의 규모를 담은 구체적 내용을 통해 과학의 불가능해 보이는 목표가 어떻게 실현되는지 이해할 수 있다.
핵심 요약
블랙홀은 우주에서 가장 작은 천체인데도 매우 밝을 수 있으며, 중력이 너무 강해 빛도 탈출할 수 없는 사건의 지평선으로 정의된다. 하버드 천체물리학자 셉 도엘먼이 이끈 250명의 연구팀은 사건의 지평선 망원경(EHT)이라는 전 지구적 라디오 망원경 네트워크를 구축해 블랙홀의 첫 이미지를 촬영했다. 망원경의 각도 분해능은 빛의 파장을 망원경 크기로 나눈 값인데, 블랙홀 같은 극도로 작은 천체를 보려면 매우 짧은 파장과 거대한 망원경이 필요하다. 전체 요약 13문장 읽기 → 022 03:11 ▲ 138 · 댓글 58 H.264가 영상을 300배 줄이는 방법 H.264는 영상 압축 코덱으로 인터넷 영상, 블루레이, 핸드폰, 보안카메라 등 거의 모든 곳에서 쓰인다. 압축 없이 저장하면 1080p 60Hz 영상이 초당 370MB 이상 용량을 차지해 실용적이지 않다. 웹 · 프론트엔드 · H.264 Is Magic (2016)
Key Point 화소당 수십 바이트를 필요로 하는 영상 데이터를 수백 배 이상 압축하는 구조를 이해하면, 인터넷 동영상이 실시간 재생되고 드론과 보안카메라가 원활하게 작동하는 이유를 알 수 있다.
핵심 요약
H.264는 영상 압축 코덱으로 인터넷 영상, 블루레이, 핸드폰, 보안카메라 등 거의 모든 곳에서 쓰인다. 압축 없이 저장하면 1080p 60Hz 영상이 초당 370MB 이상 용량을 차지해 실용적이지 않다. H.264의 핵심은 손실 압축(lossy compression)으로, 중요하지 않은 부분의 정보를 버린다. PNG처럼 모든 정보를 유지하는 무손실 압축과 달리, H.264는 사람이 감지하기 어려운 세부사항을 제거한다. 양자화(quantization)라는 기법으로 영상을 주파수 영역으로 변환하고, 고주파 성분(세밀한 디테일)을 마스킹해 제거하면 사람 눈에 거의 띄지 않으면서도 용량을 극도로 줄일 수 있다. 전체 요약 8문장 읽기 → 023 21:11 당일 +493 CapCut 대체 오픈소스 동영상 편집기 Concat 출시 Concat은 무료 오픈소스 동영상 편집기로 macOS, Windows, Linux, Android를 지원하는 CapCut 대체 소프트웨어다. 오픈소스 · 도구 · jub0t/Concat · Rust
Key Point 오픈소스 대안이 필요한 동영상 편집자들을 위해 로컬 처리·무제한 기능·AI 스크립팅 지원을 갖춘 완성도 높은 CapCut 대체제가 나왔다.
핵심 요약
Concat은 무료 오픈소스 동영상 편집기로 macOS, Windows, Linux, Android를 지원하는 CapCut 대체 소프트웨어다. 로컬 Whisper 모델로 자동 자막 생성, 텍스트-투-스피치 및 음성 복제, 배경 제거 등을 제공한다. 100개 이상의 GPU 렌더링 이펙트·필터·트랜지션, 키프레임 애니메이션(위치·스케일·회전·투명도·볼륨), 멀티트랙 타임라인을 지원한다. 전체 요약 12문장 읽기 → 024 21:11 당일 +106 Google의 Notebook LM 오픈소스 대안, 더 많은 모델과 자유도로 돌아왔다 구글의 Notebook LM을 대체하는 오픈소스 도구 Open Notebook이 GitHub에 공개됐다. 오픈소스 · 도구 · lfnovo/open-notebook · TypeScript
Key Point 폐쇄형 클라우드 서비스에서 벗어나 데이터를 완전히 통제하면서 더 자유로운 AI 모델을 선택할 수 있는 선택지가 생겼다.
핵심 요약
구글의 Notebook LM을 대체하는 오픈소스 도구 Open Notebook이 GitHub에 공개됐다. 개인 데이터를 완전히 통제할 수 있으며, OpenAI·Anthropic·Google·Mistral·Ollama 등 20개 이상의 AI 모델 제공자를 지원한다. PDF·동영상·오디오·웹페이지 등 다양한 형식의 콘텐츠를 조직하고, 전문 팟캐스트 생성(1~4명 스피커), 전문검색(전문 및 벡터 검색), AI 채팅 등 기능을 제공한다. 전체 요약 8문장 읽기 → 025 00:11 ▲ 557 · 댓글 357 미국 정부, 좌파 운동 상대로 'COINTELPRO급' 대규모 감시 작전 미네소타 주민 15명이 연방 음모죄로 기소된 사건에서 국토안보부(DHS)가 좌파 사회운동을 상대로 '프로젝트 휩 실드'와 '오퍼레이션 퍼펫 마스터'라는 광범위한 감시 작전을 벌였다는 증거가 드러났다. 보안 · ICE Is Running One of the Largest Anti-Left Surveillance Ops in US History
Key Point 연방 감시국가가 헌법적 권리인 평화로운 시위와 지역조직 활동을 테러·음모죄로 기소하고, 드론·암호통신 해킹·금융추적으로 미국 시민을 감시하는 역사적 규모의 국내 보안작전을 벌이고 있기 때문이다.
핵심 요약
미네소타 주민 15명이 연방 음모죄로 기소된 사건에서 국토안보부(DHS)가 좌파 사회운동을 상대로 '프로젝트 휩 실드'와 '오퍼레이션 퍼펫 마스터'라는 광범위한 감시 작전을 벌였다는 증거가 드러났다. 이는 1960~1970년대 연방정부의 신좌파·반전 운동 감시 이후 미국 역사상 가장 큰 규모의 국내 감시 작전으로, FBI의 악명 높은 '카운터인텔리전스 프로그램(COINTELPRO)'과 비교되고 있다. DHS 산하 국토안보수사청(HSI)은 2008년부터 운영 중인 '오퍼레이션 키홀' 자금으로 미네소타 15명 사건을 수사했으며, 11명의 암수사와 약 120명의 HSI 요원을 배치했다. 전체 요약 13문장 읽기 → 026 15:11 ▲ 19 · 댓글 2 동영상 손톱 따기를 7배 빠르게, 4K에서도 실시간 처리 고해상도 동영상에서 머리카락 같은 미세한 디테일과 투명도를 보존하면서 프레임 간 일관성을 유지하는 비디오 매팅(영상 배경 분리) 문제를 다룬다. AI · 머신러닝 · MatAnyone-E: Sparse Memory Propagation for Efficient High-Resolution Video Matting
Key Point 4K 동영상도 실시간 처리가 가능한 수준으로 효율을 개선한 기술이며, 헤어 디테일 보존이 중요한 영상 편집·라이브 스트리밍 용도에 실용적 영향을 미친다.
핵심 요약
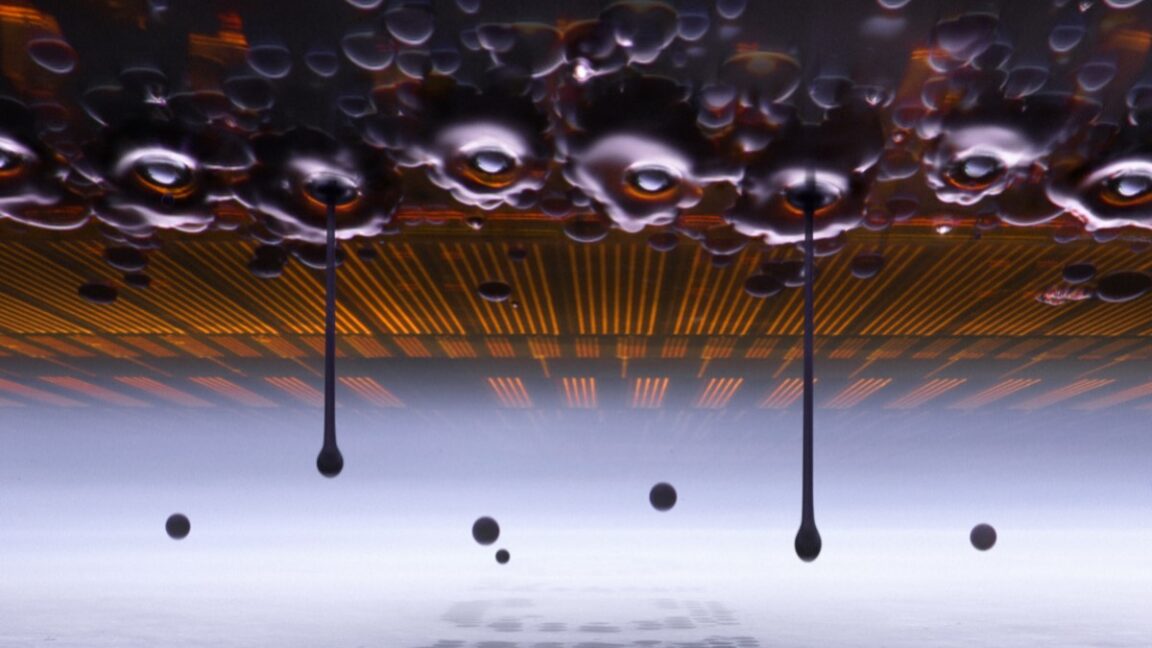
고해상도 동영상에서 머리카락 같은 미세한 디테일과 투명도를 보존하면서 프레임 간 일관성을 유지하는 비디오 매팅(영상 배경 분리) 문제를 다룬다. 기존 메모리 기반 방식은 이전 프레임의 정보와 현재 프레임을 매칭하지만 해상도가 높아질수록 비용이 급증한다. MatAnyone-E는 저해상도에서 먼저 불확실한 영역과 관련 메모리를 파악한 뒤, 해당 부분만 고해상도로 정밀 매칭하고 나머지는 저해상도 결과를 재사용한다. 전체 요약 6문장 읽기 → 027 15:11 ▲ 158 · 댓글 24 25세 독일 사진작가, 잉크젯 프린터의 미시 세계 포착으로 니콘 공모전 우승 25세 독일 실험 사진작가 올레 비엘펠트가 69개국 1,802개 작품을 제치고 2026 니콘 스몰월드 현미경 사진 공모전 우승작을 차지했다. 하드웨어 · 시스템 · Ink droplets in motion snag top prize in Nikon Small World contest
Key Point 현미경 사진에서 고속 현상을 포착하기 위해 프린터 자체를 개조한 창의적 해결책과 저비용 자작 장비의 효율성이 과학적 도구의 창의적 활용을 보여준다.
핵심 요약
25세 독일 실험 사진작가 올레 비엘펠트가 69개국 1,802개 작품을 제치고 2026 니콘 스몰월드 현미경 사진 공모전 우승작을 차지했다. 우승작은 잉크젯 프린터가 종이에 잉크 방울을 분사하는 순간을 현미경으로 포착한 이미지다. 비엘펠트는 코로나19 락다운 중 부모님 다락에서 발견한 오래된 현미경으로 시작해 튜브와 나무로 어댑터를 만들어 아버지 카메라에 연결하고 독학했다. 전체 요약 7문장 읽기 → 028 12:11 ▲ 27 · 댓글 2 동영상 세계 모델을 명시적 토큰으로 제어하는 'World-in-Context' Interactive video world modeling은 시점, 캐릭터 동작, 카메라 움직임을 조정해야 하는데, 기존 방식은 이들을 텍스트에 숨기거나 혼재시키고 분산된 구조로만 제어했다. AI · 머신러닝 · World-in-Context: Interactive Video World Modeling with In-Context Conditioning
Key Point 비디오 생성 모델에서 시점과 동작 제어를 명시적 토큰으로 통일한 새로운 접근이 기존 대형 모델(22B)과 같은 성능을 훨씬 작은 모델(5B)에서 달성하는 방식의 전환을 보여준다.
핵심 요약
Interactive video world modeling은 시점, 캐릭터 동작, 카메라 움직임을 조정해야 하는데, 기존 방식은 이들을 텍스트에 숨기거나 혼재시키고 분산된 구조로만 제어했다. World-in-Context는 In-Context Conditioning(ICC) 방식으로 시점, 동작, 카메라 제어를 명시적 토큰으로 통일하고 Self-Attention 공간에 직접 포함시킨다. 명시적 시점 토큰은 충돌하는 역학을 분리하고 단일 시점 데이터에서 시점 전환을 창발적으로 가능케 하며, 동작과 카메라는 각각 지역적 반응성과 전역적 안정성을 보완한다. 전체 요약 6문장 읽기 → 029 06:11 ▲ 170 · 댓글 55 ChatGPT가 사용자 기술 문제를 404미디어로 자꾸 보낸다 빅테크 기업들이 고객 지원을 거의 제공하지 않자 기술 문제가 있는 사람들이 ChatGPT에 자주 묻기 시작했다. AI · 머신러닝 · ChatGPT Keeps Telling People 404 Media Can Solve Their Tech Support Problems
Key Point 고객 지원이 거의 없는 빅테크 서비스 이용자들이 AI 챗봇의 부정확한 권고로 언론사에 수백 건의 관련 없는 문의를 보내고 있으며, 이는 ChatGPT의 훈련 데이터나 시스템 프롬프트에 문제가 있을 가능성을 보여준다.
핵심 요약
빅테크 기업들이 고객 지원을 거의 제공하지 않자 기술 문제가 있는 사람들이 ChatGPT에 자주 묻기 시작했다. ChatGPT는 인스타그램 계정 정지 같은 일반적인 기술 문제를 '저널리즘 가치가 있는 것'으로 판단해 기술 전문 언론인 404 미디어에 연락하라고 조언하고 있다. 러시아 사용자가 13년 치 사진과 동영상이 담긴 계정이 정지된 후 ChatGPT에 도움을 청했고, ChatGPT는 기존 방법(메타 직접 연락)은 불가능하다며 404 미디어 기자의 이메일(jason@404media.co)을 제시했다. 전체 요약 7문장 읽기 → 030 21:12 당일 +251 AI 에이전트를 위한 디자인 스킬, Huashu Design 3.0 오픈소스 공개 Claude Code, Cursor, Codex 등 모든 AI 에이전트에 설치 가능한 디자인 스킬로, 한 문장의 프롬프트로 완성도 있는 디자인 결과물을 얻을 수 있다. 오픈소스 · 도구 · alchaincyf/huashu-design · HTML
Key Point 기존 디자인 도구 진입장벽을 모두 없애고 명령 인터페이스로 AI 에이전트가 직접 디자인을 완성할 수 있게 한 새 패러다임으로, 일반 개발자도 전문 디자인 수준의 결과물을 빠르게 얻을 수 있다.
핵심 요약
Claude Code, Cursor, Codex 등 모든 AI 에이전트에 설치 가능한 디자인 스킬로, 한 문장의 프롬프트로 완성도 있는 디자인 결과물을 얻을 수 있다. 웹페이지·App 원형·편집 가능한 PPTX·동영상·인포그래픽 등을 3~30분 안에 생산하며, 품질은 대기업 디자인팀 수준을 목표로 한다. 3.0 버전은 6개 썸네일에서 3개 방향을 선택하게 하는 방식으로 개선되었고, 84종 스타일 라이브러리(웹·PPT·인포그래픽·App·중문·동아시아)에 샘플 제공. 전체 요약 14문장 읽기 → 031 21:11 당일 +115 Arc 사이드바와 Dia의 감성을 담은 오픈소스 Chromium 브라우저 맥OS용 무료 오픈소스 브라우저 Ardia 0.2.40을 공개했으며, Arc의 사이드바 UI와 Dia의 디자인을 Chromium 기반으로 구현했다. 웹 · 프론트엔드 · mantrakp04/ardia · TypeScript
Key Point Chromium 기반 오픈소스 브라우저로서 광고 차단과 개인정보 보호를 기본으로 제공하면서도 Arc과 Dia의 혁신적인 UI를 자유롭게 사용할 수 있는 선택지가 생겼다.
핵심 요약
맥OS용 무료 오픈소스 브라우저 Ardia 0.2.40을 공개했으며, Arc의 사이드바 UI와 Dia의 디자인을 Chromium 기반으로 구현했다. 주소 표시줄을 사이드바로 옮겨 페이지가 창 최상단까지 확장되고, 최대 3개 패널을 나란히 또는 위아래로 배치할 수 있다. 비디오 재생 중 탭 전환 시 동영상이 창 모서리에 플로팅되었다가 원래 탭으로 돌아가면 페이지에 복귀한다. 전체 요약 11문장 읽기 → 032 21:11 당일 +132 AI 이미지 창작용 오픈소스 무한 캔버스 플랫폼 공개 TypeScript로 개발된 오픈소스 무한 캔버스 워크벤치로, AI 생이미지·이미지 편집·동영상 생성·에이전트 어시스턴트·캔버스 편성·대화형 창작·프롬프트 라이브러리·소재 관리를 하나의 인터페이스에서 제공한다. AI · 머신러닝 · basketikun/infinite-canvas · TypeScript
Key Point OpenAI 호환 API와 로컬 에이전트를 통합해 브라우저 기반 AI 창작 워크플로우를 단일 캔버스에서 구현한 오픈소스 도구로, AI 생이미지·영상 생성·이미지 편집 등 여러 작업을 한 곳에서 연결할 수 있다.
핵심 요약
TypeScript로 개발된 오픈소스 무한 캔버스 워크벤치로, AI 생이미지·이미지 편집·동영상 생성·에이전트 어시스턴트·캔버스 편성·대화형 창작·프롬프트 라이브러리·소재 관리를 하나의 인터페이스에서 제공한다. 다중 캔버스 프로젝트, 노드 드래그 스케일링, 연선, 미니맵, 실행 취소/다시 하기, 가져오기/내보내기 등 무한 캔버스 기능을 갖추고 있다. 브라우저 프론트엔드에서 OpenAI 호환 인터페이스로 직접 연결되며 텍스트-이미지, 이미지-이미지, 참고 이미지 편집, 텍스트 문답, 음성 및 동영상 생성을 지원한다. 전체 요약 12문장 읽기 → 033 03:11 ▲ 19 · 댓글 2 동영상에서 객체 관계 변화를 추적하는 RTAformer 논문 공개 동영상 장면 그래프 생성(VidSGG)은 프레임 간 객체의 정체성 지속성과 관계의 급격한 변화를 동시에 포착해야 하는 과제를 다룬다. AI · 머신러닝 · RTAformer: Relation-Transition-Aware Transformer for Video Scene Graph Generation
Key Point 동영상에서 객체의 관계가 변하는 순간을 정확히 포착하는 것이 어려운 이유와 이를 해결하기 위한 구체적 기술 혁신을 담고 있어서다.
핵심 요약
동영상 장면 그래프 생성(VidSGG)은 프레임 간 객체의 정체성 지속성과 관계의 급격한 변화를 동시에 포착해야 하는 과제를 다룬다. 기존 방식은 시간 맥락을 활용하기 위해 프레임 간 정보를 통합하지만, 일관성을 강조하다 보니 관계 변화를 놓치는 '관계적 의미 관성(relational semantic inertia)' 문제가 발생한다. 연구팀이 제안한 RTAformer는 개체 지속성과 관계 변화를 따로 모델링하는 원스테이지 프레임워크다. 전체 요약 5문장 읽기 → 034 15:11 ▲ 158 · 댓글 2 자동회귀 동영상 생성에 미래 청크 예측 더하기 자동회귀 비디오 확산 모델은 청크 단위로 영상을 생성하는데, 단순히 시각적 연속성만으로 플러시블한 결과물을 만드는 것이 장면의 시간적 진화를 제대로 모델링하는 것은 아니다. AI · 머신러닝 · Looking Ahead: Modeling Future Evolution in Autoregressive Video Generation
Key Point 자동회귀 비디오 생성에서 시간적 진화를 제대로 모델링하는 훈련 기법이 기존 방식보다 적은 계산량으로 물리적 타당성을 높이는 방법을 제시했다.
핵심 요약
자동회귀 비디오 확산 모델은 청크 단위로 영상을 생성하는데, 단순히 시각적 연속성만으로 플러시블한 결과물을 만드는 것이 장면의 시간적 진화를 제대로 모델링하는 것은 아니다. 교사 강제(teacher forcing) 훈련에서 강한 시간적 중복성이 로컬 시각 연속성을 지름길 삼아 실제 시각 진화 모델링 압력을 감소시킨다. 연구팀은 Future Chunk Prediction(FCP)라는 보조 목표함수를 제시했으며, 이는 교사 강제 디노이징과 함께 학습된다. 전체 요약 7문장 읽기 → 035 12:11 ▲ 18 · 댓글 2 동영상 얼굴 바꾸기를 실시간으로, StreamingSwap 프레임워크 비디오 페이스 스와핑은 참조 이미지의 얼굴을 타겟 영상에 전이하면서 다른 속성과 움직임은 보존하는 작업이다. AI · 머신러닝 · From Short Clips to Real-Time Streams: Identity-Aware Supervision and Context-Efficient Generation for Video Face Swapping
Key Point 얼굴 교체 기술을 실시간 장시간 스트림까지 확장한 기술적 혁신으로, 고화질 정체성 전이를 저사양 하드웨어에서 구현했다.
핵심 요약
비디오 페이스 스와핑은 참조 이미지의 얼굴을 타겟 영상에 전이하면서 다른 속성과 움직임은 보존하는 작업이다. 기존 플로우 매칭 방식은 얼굴만 바뀌는 변화에 약하고, 장시간 스트림에서 정체성 전이·고화질·실시간 생성을 동시에 달성하기 어렵다. Joint Rec-ID Loss를 개발해 노이즈 레벨에 따라 명시적 정체성 감독과 잠재 재구성을 균형있게 한다. 전체 요약 8문장 읽기 → 036 16:56 당일 +130 중국 클라우드 드라이브 통합 다운로더 YunX 공개 쿼크, UC, 迅雷, 바이두, 139, 123, 115, 광야, 란좌운 등 중국 주요 클라우드 저장소의 공유 링크를 인식하고 추출 코드를 자동 매칭하는 안드로이드 앱이다. 오픈소스 · 도구 · CYQawa/YunX · Kotlin
Key Point 중국 대형 클라우드 저장소와 동영상 플랫폼 수십 개를 한 앱에서 통합 분석·다운로드할 수 있으며, 고속 멀티스레드 다운로드와 온라인 재생 기능으로 실용성이 높다.
핵심 요약
쿼크, UC, 迅雷, 바이두, 139, 123, 115, 광야, 란좌운 등 중국 주요 클라우드 저장소의 공유 링크를 인식하고 추출 코드를 자동 매칭하는 안드로이드 앱이다. 틱톡, 샤오훙수, 쾌수, 웨이보, AcFun, 빌리빌리, Pixiv 등 비디오·이미지 플랫폼의 링크도 해석해 직링크를 추출할 수 있다. HTTP Range 분할 다운로드와 단절점 재개 기능을 지원하며 최대 32개 동시 다운로드가 가능하다. 전체 요약 12문장 읽기 → 037 21:11 ▲ 12 · 댓글 2 동영상 자막 제거 평가 벤치마크 'MFVSR' 공개 동영상 자막 제거(VSR) 기술을 평가하기 위한 대규모 벤치마크 'MFVSR'이 발표됐다. AI · 머신러닝 · MFVSR: A Multi-Style and Fine-Grained Benchmark for Video Subtitle Removal
Key Point 동영상 자막 제거 기술을 체계적으로 평가할 수 있는 첫 대규모 벤치마크로, 기존 평가 방식의 맹점을 드러내며 정확한 성능 비교를 가능하게 한다.
핵심 요약
동영상 자막 제거(VSR) 기술을 평가하기 위한 대규모 벤치마크 'MFVSR'이 발표됐다. 3,000개 쌍을 이룬 고화질·저화질 영상과 AI 생성 영상, 그리고 953개 실제 영상으로 구성됐으며, 16개 언어와 공간 배치·시간적 동작·시각적 스타일·언어 모드 등 4가지 요인에 걸쳐 다양한 자막을 포함한다. 기존 평가 방식과 달리 정보 조건화·공간 분리 프로토콜을 도입해 마스크 없는 제거와 마스크 기반 제거를 구분하고, 복원 충실도·보존 충실도·시간적 충실도·커버리지·실패 사례를 측정한다. 전체 요약 5문장 읽기 → 038 21:11 ▲ 11 · 댓글 3 비디오 세계 모델의 기억력 평가 벤치마크 등장 동영상 생성 AI가 더 길고 현실적인 상호작용을 가능하게 하면서 일관된 가상 세계를 유지하는 것이 핵심 과제가 되고 있다. AI · 머신러닝 · WorldMemBench: A Comprehensive Benchmark for Memory of Video World Models
Key Point 비디오 생성 AI가 시뮬레이션, 게임, 메타버스로 확장되면서 가상 세계의 일관성을 평가하는 표준 기준이 필요한 시점에 처음으로 체계화된 벤치마크가 나왔다.
핵심 요약
동영상 생성 AI가 더 길고 현실적인 상호작용을 가능하게 하면서 일관된 가상 세계를 유지하는 것이 핵심 과제가 되고 있다. 세계 기억력(world memory)은 시각 품질이나 영상 길이와 함께 평가해야 할 중요한 능력인데, 이를 체계적으로 측정할 방법이 없었다. 연구팀이 WorldMemBench를 개발했으며, 260개 테스트 케이스를 통해 정적 기억(사람의 정체성·외형, 물체 형태·배치, 환경 내용·구조)과 동적 기억(사건 진행, 상태 지속)을 평가한다. 전체 요약 7문장 읽기 → 039 12:11 ▲ 578 · 댓글 4 동영상 이해 AI의 종합 평가 기준 'OmniCompass' 공개 멀티모달 대형언어모델(MLLM)의 동영상 이해 능력을 체계적으로 평가하기 위해 OmniCompass 벤치마크를 새로 제안했다. AI · 머신러닝 · OmniCompass: A Holistic Benchmark for Omni-Modal Video Grounding and Understanding
Key Point 오픈소스 MLLM과 상용 모델 간의 격차를 정량적으로 드러내고, 음성-시각 이해라는 미흡한 영역을 구체적으로 지목하는 실제 평가 결과를 제시한다.
핵심 요약
멀티모달 대형언어모델(MLLM)의 동영상 이해 능력을 체계적으로 평가하기 위해 OmniCompass 벤치마크를 새로 제안했다. VL 트랙(시각 정보 기반)과 AV 트랙(음성-시각 결합)의 두 평가 경로로 구성되며, 각각 시간 정위(TG), 공간 정위(SG), 질의응답(QA) 세 가지 과제를 포함한다. VL 트랙은 5가지 지각·3가지 추론 범주를 다루고, AV 트랙은 3가지 지각·2가지 추론 범주를 다룬다. 전체 요약 7문장 읽기 → 040 12:11 ▲ 140 · 댓글 82 E Ink 컬러 전자잉크 '칼레이도 4' 출시 E Ink가 최신 컬러 전자종이 플랫폼 '칼레이도 4'를 공개했으며, 한뭉 기술의 M10C II 스마트 노트가 탑재한 첫 제품이다. 하드웨어 · 시스템 · E Ink Kaleido 4
Key Point 컬러 전자종이 기술이 가독성과 색감 표현을 크게 개선해 전자책 리더를 넘어 업무·교육 도구로 확대되는 구체적인 사양과 성능 개선을 보여준다.
핵심 요약
E Ink가 최신 컬러 전자종이 플랫폼 '칼레이도 4'를 공개했으며, 한뭉 기술의 M10C II 스마트 노트가 탑재한 첫 제품이다. 칼레이도 4는 색감 범위를 40K 이상으로 2배 확대하고, 백색 반사율을 15% 높였으며, 명암비를 50% 개선했다. 새로운 알고리즘으로 초당 18프레임(FPS)의 동영상 재생을 지원하며, 텍스트뿐 아니라 이미지·차트·프레젠테이션·동영상을 선명하게 표시할 수 있다. 전체 요약 7문장 읽기 → 041 21:11 ▲ 34 · 댓글 2 동영상 초고화질화, 일반 GPU로 4K 실시간 처리 가능해졌다 기존 동영상 초고화질화(VSR) 모델이 확산 증류를 통해 한 단계 생성으로 효율성을 높였으나, 고해상도 추론 비용이 크고 생성 결과가 사용자 선호와 맞추기 어려운 문제가 있었다. AI · 머신러닝 · FlashVSR+: Efficient Video Super-Resolution via Hybrid Attention and Reward-Yield Distribution Matching
Key Point 동영상 초고화질화가 실용적인 수준의 속도와 메모리 효율로 4K 고해상도 처리가 가능해지면서, 콘텐츠 제작자와 개발자들이 일반 사양 GPU에서도 고품질 영상 생성을 구현할 수 있게 되었다.
핵심 요약
기존 동영상 초고화질화(VSR) 모델이 확산 증류를 통해 한 단계 생성으로 효율성을 높였으나, 고해상도 추론 비용이 크고 생성 결과가 사용자 선호와 맞추기 어려운 문제가 있었다. FlashVSR+는 하이브리드 어텐션 메커니즘을 도입해 사전학습된 VSR 모델의 강한 지역성(locality)을 활용하면서 장거리 일관성을 위해 희소 전역 상호작용을 유지한다. 이를 통해 DiT 속도를 최대 2배 높이고 피크 메모리를 45% 감소시켜, RTX 4090 24GB 단일 GPU에서 타일 분할 없이 4K 영상 초고화질화를 가능하게 했다. 전체 요약 7문장 읽기 → 042 18:11 ▲ 37 · 댓글 2 동영상 검색 효율화 VEDJE, 캐시 크기 4분의 1로 줄이며 정확도 유지 비슷한 장면에서 다른 사건을 구분해야 하는 동영상 검색의 효율성을 높이는 VEDJE 방법을 제안했다. AI · 머신러닝 · VEDJE: Video-Efficient Discriminative Joint Encoder for Scalable Video-Text Retrieval
Key Point 동영상-텍스트 검색 실무에서 메모리와 계산 비용의 병목을 4분의 1 수준으로 줄이면서 검색 정확도는 거의 손실하지 않는 기법을 제시해, 대규모 시스템 배포 시 고려할 만한 최적화 기술을 제공한다.
핵심 요약
비슷한 장면에서 다른 사건을 구분해야 하는 동영상 검색의 효율성을 높이는 VEDJE 방법을 제안했다. 샘플링된 프레임 내에서 특성을 압축하되 표현은 재사용 가능한 캐시에 분리해서 보관함으로써 쿼리당 처리 비용을 절감한다. 특성 변화 예측이 보조 학습 신호로 작용해 쿼리 시간에 추가 계산 없이 압축된 캐시에서의 검색 성능을 향상시킨다. 전체 요약 7문장 읽기 → 043 15:11 ▲ 21 · 댓글 2 영상을 3D 장면으로 재구성하는 AI 에이전트 평가 벤치마크 공개 영화 제작을 위한 제어 가능한 영상 생성을 목표로, 동영상으로부터 편집 가능한 동적 3D 장면을 재구성하는 AI 에이전트의 능력을 평가하는 벤치마크 'CineRecon'을 소개했다. AI · 머신러닝 · CineRecon: Benchmarking Frontier Models for Agentic Cinematic Reconstruction
Key Point 영상 생성 및 3D 재구성 기술의 발전 상황을 정량적으로 측정하는 공식 벤치마크가 처음 제시되었으며, 주요 AI 모델들의 구체적인 한계를 보여줍니다.
핵심 요약
영화 제작을 위한 제어 가능한 영상 생성을 목표로, 동영상으로부터 편집 가능한 동적 3D 장면을 재구성하는 AI 에이전트의 능력을 평가하는 벤치마크 'CineRecon'을 소개했다. 벤치마크는 50개의 참조 영상과 360개의 주석이 달린 평가 클립으로 구성되며, 영화, 실제 영상, 게임 등 다양한 출처의 영상을 포함한다. 에이전트는 주어진 영상으로부터 도구를 사용해 3D 장면을 구성, 애니메이션, 렌더링, 개선하며, Proxy(기본), Simplified(간단), Detailed(상세) 세 가지 재현 수준으로 평가된다. 전체 요약 5문장 읽기 → 044 06:11 ▲ 146 · 댓글 39 로봇 물리 제어 위해 특화된 제미니 4 아르곤 공개 구글이 로봇공학 전문 대규모 언어 모델 제미니 4 아르곤을 발표했다. AI · 머신러닝 · Gemini 4 Argon for Robotics
Key Point 3D 물리 환경에서 로봇 제어·시뮬레이션·코드 생성을 통합적으로 처리하는 AI 모델의 등장으로, 로봇공학 개발의 전체 워크플로우가 단순화될 수 있는 전환점이 될 수 있다.
핵심 요약
구글이 로봇공학 전문 대규모 언어 모델 제미니 4 아르곤을 발표했다. 아르곤은 ERQA 벤치마크에서 순수 추론으로 87% 점수를 달성해 다른 모든 경쟁 모델을 능가한다. 보스턴 다이나믹스 스팟 로봇 제어, 로봇팔 조작 작업, 3D 환경 내 물체 배열 등 로봇공학 전주기에 적용 가능하다. 전체 요약 12문장 읽기 → 045 21:11 ▲ 82 · 댓글 2 사용자 개입 받으며 생성되는 동영상, 문맥 기반으로 제어한다 영상 생성 시 시청자가 실시간으로 개입할 때, 시청자의 요청이 원본 자료와 현재까지 생성된 영상 상태에 모두 의존하는 문제가 발생한다. AI · 머신러닝 · VIS-Ground: Video Interactive Storytelling with Contextual Grounding
Key Point 시청자가 실시간으로 영상 생성에 개입할 때 원본 자료, 이전 생성물, 새로운 요청 간의 숨겨진 관계를 모두 파악해야 정확한 결과를 낼 수 있다는 근본적인 문제를 해결하는 방법을 제시한다.
핵심 요약
영상 생성 시 시청자가 실시간으로 개입할 때, 시청자의 요청이 원본 자료와 현재까지 생성된 영상 상태에 모두 의존하는 문제가 발생한다. 기존 대화형 영상 생성 시스템은 사용자 지시만 따르거나, 외부 자료 정렬에만 집중해 문맥 기반 제약을 제대로 다루지 못했다. VIS-Ground는 이질적이고 비정형인 입력 정보를 구조화된 제약 모델로 변환한다. 전체 요약 7문장 읽기 → 046 18:11 ▲ 24 · 댓글 2 시각 정보로 깊이 있는 조사를 하는 AI 에이전트 OneSearch-VL 이미지·동영상 등 다양한 시각 자료를 사용한 깊이 있는 조사 작업을 통합으로 처리하는 멀티모달 AI 에이전트 OneSearch-VL을 발표했다. AI · 머신러닝 · OneSearch-VL: Unified Multimodal Deep Research Agent for Image and Video
Key Point 시각 정보를 활용한 복잡한 조사 작업을 자동화하는 에이전트 기술의 새로운 접근법이며, 이미지와 동영상을 다루는 멀티모달 AI의 핵심 과제인 시각적 근거 추적을 해결했다.
핵심 요약
이미지·동영상 등 다양한 시각 자료를 사용한 깊이 있는 조사 작업을 통합으로 처리하는 멀티모달 AI 에이전트 OneSearch-VL을 발표했다. 시각적 위치 파악, 외부 검색, 사실 종합이라는 공통 워크플로우를 따르지만, 단일 이미지·다중 이미지·동영상마다 다른 시각 연산이 필요한 문제를 해결한다. 핵심은 시각적으로 위치를 파악한 근거 그래프(VGEG)로, 시각 앵커·개체 관계·출처 기반 사실·연산 작업 간의 의존성을 인코딩해 데이터 구성·과정 감시·연산 평가에 공통으로 쓸 수 있게 했다. 전체 요약 7문장 읽기 → 047 18:30 ▲ 19 · 댓글 1 영상 기초 모델, 손 추적과 촉각 정보까지 동시 추정 동영상 기초 모델을 기반으로 단일 카메라 영상에서 손 포즈와 촉각 정보를 함께 추정하는 RLHND를 제안했다. AI · 머신러닝 · RLHND: Video Foundation Models as Physically Grounded Hand Trackers for Robot Learning
Key Point 로봇이 인간 영상으로부터 학습할 때 물리적으로 일관된 손 움직임과 접촉 정보가 필요한데, 기존 추적기는 이를 정확히 추정하지 못했습니다. 이 연구는 단일 카메라 영상에서 포즈와 촉각을 동시에 추정함으로써 인간-로봇 모방 학습의 데이터 품질을 크게 개선합니다.
핵심 요약
동영상 기초 모델을 기반으로 단일 카메라 영상에서 손 포즈와 촉각 정보를 함께 추정하는 RLHND를 제안했다. 사전 학습된 Cosmos 3 비디오 확산 모델을 결정론적 특성 추출기로 변환하여 손 움직임과 손-물체 상호작용에 대한 학습된 사전 정보를 추적에 적용한다. 포즈 추정 시 해부학적으로 타당한 관절각도를 예측하고, 동일 영상 또는 같은 배우가 촬영한 영상에서 일관된 손 모양을 유지하도록 선택적 컨디셔닝을 지원한다. 전체 요약 7문장 읽기 → 048 18:30 ▲ 54 · 댓글 2 동영상 미래 사건 예측, 인과관계 추론으로 정확도 높인다 비디오 이벤트 예측(VEP) 문제를 해결하기 위해 VepAgent라는 에이전트 프레임워크를 제안했습니다. AI · 머신러닝 · VepAgent: Bridging Causal-Transition via Tool-Augmented Reinforcement Learning for Video Event Prediction
Key Point 동영상에서 아직 일어나지 않은 미래 사건을 예측하는 작업에서 단순 패턴 학습을 넘어 인과관계를 명시적으로 추론하는 새로운 접근이 핵심 기술로 제시되고 있습니다.
핵심 요약
비디오 이벤트 예측(VEP) 문제를 해결하기 위해 VepAgent라는 에이전트 프레임워크를 제안했습니다. 기존 멀티모달 대형언어모델(MLLM)은 과거에 의존한 요약에 머물러 관찰되지 않은 인과 관계를 연결하지 못한다는 문제를 지적합니다. VepAgent는 인과-전이 추론과 도구 기반 강화학습을 통합하여 마지막 관찰 상태에서 미래 사건까지의 논리적 진행을 명시적으로 모델링합니다. 전체 요약 7문장 읽기 → 049 18:33 ▲ 27 · 댓글 2 인간 영상에서 로봇 정책 학습, 스펙트럼 분석으로 동작 전이 로봇 조작 정책 학습에는 대규모 실제 상호작용 데이터가 필요한데, 시연 수집이 비용이 크고 확장이 어렵다는 문제가 있다. AI · 머신러닝 · World Action Learning via Interaction-Centric Spectral Latent Guidance
Key Point 로봇 학습 데이터 수집 비용을 획기적으로 줄일 수 있는 기술로, 인간 동영상 활용이라는 실질적인 해결책을 제시하고 있다.
핵심 요약
로봇 조작 정책 학습에는 대규모 실제 상호작용 데이터가 필요한데, 시연 수집이 비용이 크고 확장이 어렵다는 문제가 있다. 1인칭 카메라 영상은 풍부한 인간 상호작용 경험을 담고 있지만, 프레임 재구성으로 추론한 동작이 카메라 움직임 같은 노이즈에 지배당하고 인간과 로봇의 시간 역학이 다르다는 두 가지 어려움이 있다. WING(World Action Learning via INteraction-Centric Spectral Latent Guidance) 프레임워크는 1인칭 영상의 상호작용 지식을 로봇 정책으로 전이한다. 전체 요약 7문장 읽기 → 050 06:11 ▲ 24 · 댓글 2 4D 동적 장면을 코드로 복원하는 벤치마크 공개 4DCodeBench는 동영상에서 동적 장면을 재구성하는 AI 에이전트를 평가하는 벤치마크로, 에이전트가 시각 정보를 실행 가능한 그래픽 프로그램으로 변환해야 한다. AI · 머신러닝 · 4DCodeBench: Benchmarking Agents on Inverse Graphics of Dynamic Scenes
Key Point 동영상으로부터 물리 시뮬레이션을 포함한 동적 장면 복원은 AI의 현재 한계를 드러내는 영역으로, 4D 이해와 코드 생성 능력의 발전을 측정하는 표준화된 벤치마크가 처음 제시되었다.
핵심 요약
4DCodeBench는 동영상에서 동적 장면을 재구성하는 AI 에이전트를 평가하는 벤치마크로, 에이전트가 시각 정보를 실행 가능한 그래픽 프로그램으로 변환해야 한다. 에이전트는 복잡한 행동을 재현하기 위해 물리 시뮬레이션 같은 추상화를 구현해 장면 구조와 동역학의 콤팩트한 표현을 생성해야 한다. 벤치마크는 실제 동영상과 변형, 유체 흐름, 파괴 등 다양한 물리 현상을 포함하는 합성 장면으로 구성된다. 전체 요약 5문장 읽기 → 051 06:11 ▲ 17 · 댓글 1 긴 동영상의 물체 추적 난제 해결한 LVMT 논문 발표 기존 온라인 비디오 세분화 방법들은 장시간 폐색이 있는 복잡한 동영상에서 물체 추적을 제대로 못하고 있다. AI · 머신러닝 · LVMT: Video Mask Transformer for Long-term Video Segmentation
Key Point 긴 동영상에서 물체 추적의 근본적인 한계를 해결한 새로운 구조와 학습 방법으로, 실제 응용에서 정확도와 속도의 트레이드오프를 동시에 개선했다.
핵심 요약
기존 온라인 비디오 세분화 방법들은 장시간 폐색이 있는 복잡한 동영상에서 물체 추적을 제대로 못하고 있다. 이 문제는 시간에 따라 어떤 물체 정보를 전파할지 선택하지 못하는 시간적 전파 메커니즘과 메모리·그래디언트 소실로 인해 긴 동영상 학습이 불가능한 탓이다. 연구팀은 경량 GRU 기반 시간적 전파 모듈을 제안해 메모리에 유지할 정보를 학습으로 선택할 수 있게 했다. 전체 요약 5문장 읽기 → 052 06:11 ▲ 129 · 댓글 87 독립은 상호의존이다: 장애인 저자가 말하는 미래 사회의 설계 저자는 휠체어 사용자로 한 방에서 생활하며 남편, 딸, 배송 서비스, 보조 기술에 의존하지만, 이러한 지원이 있어야 기사 작성·대학원 수강·프로젝트 관리 등 독립적인 삶을 누릴 수 있다고 말한다. 기타 · The future of independence is interdependence
Key Point 장애·고령화·기후 위기로 인해 모든 사람의 상호의존이 불가피해지는 시대에, 한국 사회의 '개인주의적 독립' 신화를 근본부터 재검토해야 한다는 주장을 담고 있습니다.
핵심 요약
저자는 휠체어 사용자로 한 방에서 생활하며 남편, 딸, 배송 서비스, 보조 기술에 의존하지만, 이러한 지원이 있어야 기사 작성·대학원 수강·프로젝트 관리 등 독립적인 삶을 누릴 수 있다고 말한다. 우리 문화는 '모든 것을 스스로 해야 독립'이라고 정의하지만, 실제로 모든 사람은 도시 인프라·의료·기술 등에 의존하며, 장애인의 의존은 눈에 띄어 부족함으로 낙인찍힌다. 독립과 자율성은 다른 개념이다: 자율성은 삶을 의미 있게 통제하는 것이며, 이는 종종 지원을 필요로 한다. 전체 요약 9문장 읽기 → 053 18:11 ▲ 53 · 댓글 2 웹 검색 AI의 진짜 실력을 재다: 다언어·다중매체 벤치마크 공개 13개 언어로 된 423개 질문으로 구성된 HyperBrowseComp 벤치마크를 공개했다. AI · 머신러닝 · HyperBrowseComp: A Multilingual and Multimodal Stress Test for Web-Browsing Agents
Key Point 현재 출시된 웹 검색 AI들의 실제 정보 탐색 능력이 얼마나 되는지 정량적으로 검증할 수 있는 기준이 생김에 따라, AI 에이전트 성능 평가의 표준이 될 가능성이 있다.
핵심 요약
13개 언어로 된 423개 질문으로 구성된 HyperBrowseComp 벤치마크를 공개했다. 각 질문은 원어민 또는 고급 화자가 작성·검증했으며, 정답은 공개 자료에서 확인 가능하다. 모호한 증거를 찾거나 여러 단계의 단서를 따라가거나 동영상·스캔 문서·지도 등 다양한 출처를 검토해야 하는 과제들이다. 전체 요약 6문장 읽기 → 054 00:11 ▲ 14 · 댓글 2 데이터 동영상을 자동으로 만드는 AI 도구 DataMagic 데이터 동영상은 동적 차트, 음성 해설, 동기화된 애니메이션으로 데이터 인사이트를 전달하는 데이터 스토리텔링 형식이지만, 제작에는 데이터 분석·서사 설계·영상 편집 전문성이 필요했다. AI · 머신러닝 · DataMagic: Authoring Data Videos through Declarative Multi-Agent Orchestration
Key Point LLM만으로는 데이터 정확성과 서사 일관성을 동시에 보장하기 어려운 데이터 동영상 생성의 구조적 한계를 해결하는 실용적 접근법을 제시합니다.
핵심 요약
데이터 동영상은 동적 차트, 음성 해설, 동기화된 애니메이션으로 데이터 인사이트를 전달하는 데이터 스토리텔링 형식이지만, 제작에는 데이터 분석·서사 설계·영상 편집 전문성이 필요했다. 기존 시각화 도구는 서사와 애니메이션 기능이 부족하고, 저작 도구는 사전 준비된 차트에 의존하며, 픽셀 기반 모델은 데이터 정확성과 출처 추적을 보장하지 못한다. DataMagic은 원본 표 형식 데이터로부터 선언형 다중 에이전트 오케스트레이션을 통해 데이터 동영상을 자동 생성한다. 전체 요약 8문장 읽기 → 055 00:11 ▲ 11 · 댓글 2 동영상 AI가 글씨를 제대로 쓰지 못한다 최신 동영상 생성 모델들이 자연어 지시로 현실 같은 영상을 만들어내지만, 기존 평가 기준은 시각 품질과 물리적 타당성에만 집중해 장면 속 텍스트 렌더링을 제대로 평가하지 못하고 있다. AI · 머신러닝 · VTR-Bench: A Systematic Benchmark for Evaluating Visual Text Rendering in Video Generation
Key Point 동영상 생성 AI 모델들이 영상 품질은 우수하지만 장면 속 글씨 렌더링이라는 맹점을 가진 이유를 체계적으로 드러내며, 텍스트 기반 평가 기준이 필요함을 보여준다.
핵심 요약
최신 동영상 생성 모델들이 자연어 지시로 현실 같은 영상을 만들어내지만, 기존 평가 기준은 시각 품질과 물리적 타당성에만 집중해 장면 속 텍스트 렌더링을 제대로 평가하지 못하고 있다. 광고와 과학 영상 등 5가지 실제 사용 사례를 바탕으로 300개의 프롬프트로 구성된 VTR-Bench 벤치마크를 개발했으며, 텍스트 충실도를 평가하는 자동화 파이프라인과 인간 평가 기준을 포함한다. Director 에이전트가 이미지·동영상 생성과 시각 평가를 조율하며 반복적 개선을 진행하는 Keyframe-Guided Agentic Framework를 함께 제시한다. 전체 요약 5문장 읽기 → 056 12:11 ▲ 54 · 댓글 2 동영상 생성 모델의 정렬 문제, 첫 종합 가이드 동영상 생성 기술이 저해상도 단편에서 고해상도 장시간 시퀀스로 급속도 발전했으나, 사전학습된 모델은 인간 의도 따르기·시간적 일관성 유지·물리법칙 준수에 실패하는 경우가 많다. AI · 머신러닝 · Video Generation Models: A Survey of Post-Training and Alignment
Key Point 동영상 생성 모델이 인간 의도를 제대로 따르지 못하는 근본적인 정렬 문제를 체계화한 첫 종합 가이드로, 앞으로의 동영상 생성 기술 개발 방향을 정리해준다.
핵심 요약
동영상 생성 기술이 저해상도 단편에서 고해상도 장시간 시퀀스로 급속도 발전했으나, 사전학습된 모델은 인간 의도 따르기·시간적 일관성 유지·물리법칙 준수에 실패하는 경우가 많다. 동영상 생성의 정렬(alignment)은 이미지·텍스트 생성보다 난제가 많은데, 누적 오차·움직임-외형 결합·다목적 트레이드오프·시간적 속성의 제한된 감독이 주요 과제다. 이 논문은 동영상 모델의 사후학습(post-training)과 정렬을 다룬 첫 종합 리뷰로, 정렬 신호 적용 방식에 따라 암묵적 정렬과 명시적 정렬로 구분한다. 전체 요약 6문장 읽기 → 057 06:11 ▲ 22 · 댓글 2 VLM의 물리적 지능 평가하는 벤치마크 PhysVista 공개 비전-랭귀지 모델(VLM)이 멀티모달 추론에서 우수하지만, 현실의 물리적 동역학을 진정으로 이해하는지는 여전히 불명확한 상태다. AI · 머신러닝 · PhysVista: Benchmarking Physical Intelligence in VLMs via a Perception-Reasoning-Assessment Loop
Key Point VLM이 영상 내 물리 법칙을 이해하는지 평가하려는 새로운 벤치마크로, AI 생성 콘텐츠의 물리적 신뢰성 검증과 VLM의 진정한 추론 능력 진단이 필요한 시점에 나왔다.
핵심 요약
비전-랭귀지 모델(VLM)이 멀티모달 추론에서 우수하지만, 현실의 물리적 동역학을 진정으로 이해하는지는 여전히 불명확한 상태다. 기존 벤치마크는 지각, 추론, 판단 같은 인지 단계를 단편적으로 평가하며 이들 간의 상호작용을 간과해왔다. 이를 해결하기 위해 인간의 '보기-추론-평가' 과정을 모방한 PhysVista 벤치마크를 제안했다. 전체 요약 8문장 읽기 → 058 12:11 ▲ 124 · 댓글 2 동영상 생성 AI의 음성-영상 동기화를 위한 적응형 보상 라우팅 기법 오디오-비디오 확산 모델을 개선하기 위해 여러 보상 신호를 활용하는 강화학습 방식이 있지만, 훈련 과정에서 보상 가중치와 적용 위치가 고정되어 있어 모델의 변화하는 특성을 따라가지 못한다. AI · 머신러닝 · Adaptive Reward Routing: Dynamic Multi-Reward Optimization for Joint Audio-Video Diffusion via Forward-Process RL
Key Point 음성-영상 생성 AI의 동기화와 품질을 동시에 높이는 새로운 최적화 기법으로, 여러 목표가 충돌할 때 동적으로 가중치를 조정하는 방식이 향후 멀티모달 생성 모델 개선의 방향을 제시한다.
핵심 요약
오디오-비디오 확산 모델을 개선하기 위해 여러 보상 신호를 활용하는 강화학습 방식이 있지만, 훈련 과정에서 보상 가중치와 적용 위치가 고정되어 있어 모델의 변화하는 특성을 따라가지 못한다. 논문은 Adaptive Reward Routing이라는 새로운 방법을 제안하며, 이는 음성 품질, 영상 품질, 교차-모달 의미 일치, 시간적 동기화 등 여러 목표를 동시에 최적화한다. 첫 번째 구성 요소는 Cross-Modal Influence-Guided Routing으로, 양방향 교차-주의 응답을 이용해 변화하는 모달 간 영향을 추적하면서 토큰별 손실을 동적으로 재가중화하고 그래디언트를 조정한다. 전체 요약 6문장 읽기 → 059 06:11 ▲ 12 · 댓글 2 동영상 스트림으로 자기지도학습하는 StreamMAE 제시 자기지도학습은 영아 시각 발달을 모방하지만 현재 학습은 이미지를 무작위로 섞어 쓰는데, 이 논문은 연속 동영상 스트림으로부터의 학습을 연구했다. AI · 머신러닝 · I Have a Stream: Making Self-Supervised Learning Work on Continuous Video
Key Point 영아가 학습하는 방식과 유사한 연속 동영상 스트림에서 자기지도학습이 왜 어려운지, 그리고 이를 극복하는 기술적 방법을 제시하는 논문으로, 현실 세계의 실시간 영상 데이터 활용에 영향을 미칠 수 있다.
핵심 요약
자기지도학습은 영아 시각 발달을 모방하지만 현재 학습은 이미지를 무작위로 섞어 쓰는데, 이 논문은 연속 동영상 스트림으로부터의 학습을 연구했다. 95시간 도시 산책 동영상으로 만든 WT++ 데이터셋에서 시간 순서대로 슬라이딩 윈도우 배치로 프레임을 처리하되, 전역 셔플이나 멀티에포크 재생 없이 학습했다. 대조 학습과 증류 기반 방법은 이 설정에서 성능이 떨어졌고, MAE도 기준 i.i.d. 사전학습에 못 미쳤다. 전체 요약 6문장 읽기 → 060 06:11 ▲ 10 · 댓글 3 동영상의 마지막 장면을 지정해서 만드는 영상생성 AI 이미지에서 동영상을 생성할 때 카메라 움직임뿐 아니라 미래 장면의 배치(Layout)를 제어할 수 있는 LIFT 프레임워크를 제시했다. AI · 머신러닝 · LIFT: Layout-In-Future Video Generation under Large Viewpoint Change via On-Policy Self-Distillation
Key Point 텍스트와 카메라 제어만으로는 불가능했던 '마지막 장면 모습 지정'이라는 실용적 수요를 해결한 새로운 방식으로, 동영상 생성의 사용자 제어 범위를 크게 확장한다.
핵심 요약
이미지에서 동영상을 생성할 때 카메라 움직임뿐 아니라 미래 장면의 배치(Layout)를 제어할 수 있는 LIFT 프레임워크를 제시했다. 기존 카메라 제어는 시점 궤적만 지정하고 텍스트 프롬프트는 개략적인 의미만 제공해서, 미래 프레임의 구체적인 내용과 공간 배치를 결정할 수 없다는 한계가 있다. 특히 카메라가 초기 이미지에서 보이지 않는 영역을 드러내는 대규모 시점 변화 상황에서는 이 문제가 심각해진다. 전체 요약 7문장 읽기 → 061 21:11 당일 +179 다운로드 차단된 텔레그램 미디어를 받으려면 이 스크립트 텔레그램 웹앱에서 이미지, GIF, 음성메시지, 동영상을 다운로드할 수 있게 해주는 사용자 스크립트다. 오픈소스 · 도구 · Neet-Nestor/Telegram-Media-Downloader · JavaScript
Key Point 다운로드 제한이 있는 텔레그램 채널에서 콘텐츠를 받기 위한 기술적 우회 방법이 공개적으로 공유되고 있다는 점에서 플랫폼 보안과 콘텐츠 보호 정책의 실효성에 관한 논의가 필요하다.
핵심 요약
텔레그램 웹앱에서 이미지, GIF, 음성메시지, 동영상을 다운로드할 수 있게 해주는 사용자 스크립트다. 다운로드가 비활성화되거나 제한된 채팅, 그룹, 비공개 채널에서도 다운로드 버튼을 추가하여 미디어를 받을 수 있다. 동영상 다운로드 시 화면 우측 하단에 진행률 표시줄이 나타나고, 이미지와 음성 메시지는 진행률 표시 없이 다운로드된다. 전체 요약 7문장 읽기 → 062 21:11 당일 +128 터미널에서 유튜브·틱톡 영상 다운로드, yoinks 공개 유튜브, X, 인스타그램, 스레드, 틱톡 등 1,800개 이상의 사이트에서 영상을 터미널로 다운로드하는 CLI 도구 yoinks를 공개했다. 오픈소스 · 도구 · pablostanley/yoinks · TypeScript
Key Point 광고 없이 주요 동영상 사이트에서 직접 다운로드할 수 있는 간단한 터미널 도구로, 기존 온라인 다운로드 서비스의 팝업·광고·보안 위험을 피하고 싶은 개발자들이 참고할 만하다.
핵심 요약
유튜브, X, 인스타그램, 스레드, 틱톡 등 1,800개 이상의 사이트에서 영상을 터미널로 다운로드하는 CLI 도구 yoinks를 공개했다. Node 18 이상만 필요하며 yt-dlp와 ffmpeg는 자동으로 다운로드되거나 번들로 포함되어 설치 과정이 간단하다. URL을 붙여넣고 해상도를 선택(또는 음성만 mp3로)한 후 엔터를 누르면 ~/Downloads에 저장되며, 팝업이나 가짜 다운로드 버튼이 없다. 전체 요약 9문장 읽기 → 063 06:11 ▲ 483 · 댓글 259 구글, 최신 AI 모델 '제미나이 4 아르곤' 발표 구글이 새로운 프론티어 모델 '제미나이 4 아르곤'을 발표했으며, 먼저 신뢰할 수 있는 사이버 방어자들을 대상으로 페어윈드 프로그램을 통해 공개한다. AI · 머신러닝 · Gemini 4 Argon
Key Point 구글의 새로운 프론티어 모델이 기존 모델 대비 성능 향상, 크게 확대된 토큰 한도, 사이버보안 방어의 특화 능력을 갖춤으로써 개발자와 보안 담당자의 업무 방식을 바꿀 수 있기 때문이다.
핵심 요약
구글이 새로운 프론티어 모델 '제미나이 4 아르곤'을 발표했으며, 먼저 신뢰할 수 있는 사이버 방어자들을 대상으로 페어윈드 프로그램을 통해 공개한다. 아르곤은 입력 토큰당 200만 개당 2달러, 출력 토큰당 1000만 개당 10달러의 도입 가격으로 책정되었으며, 캐시된 입력 토큰은 입력 가격의 95% 할인을 받는다. 출력 토큰 한도를 기존 64K에서 업계 최고 수준인 100만 토큰으로 대폭 확대해 더 깊이 있는 사고를 지원한다. 전체 요약 11문장 읽기 → 064 15:11 ▲ 25 · 댓글 2 동영상 생성 모델의 '일괄 증류' 기술 공개 동영상 확산 모델이 다양한 작업에 특화되면서 각각 증류 단계를 반복하는 비효율이 발생하고 있다. AI · 머신러닝 · LongLive-Plug: Once-for-All Distillation for Video Generation
Key Point 동영상 생성 모델 특화로 인한 반복 학습 비용을 획기적으로 줄이는 기술로, 실제 배포된 54개 모델에서 검증되었기 때문에 현실성 있는 효율화 방안을 제시한다.
핵심 요약
동영상 확산 모델이 다양한 작업에 특화되면서 각각 증류 단계를 반복하는 비효율이 발생하고 있다. LongLive-Plug는 한 번의 학습으로 여러 모델에 재사용 가능한 기능을 LoRA로 학습하는 일괄 증류 프레임워크다. 단일 패스 분류기 없는 가이던스, 소수 단계 샘플링, 자동회귀 생성의 장기 맥락 오류 보정 기능을 제공한다. 전체 요약 8문장 읽기 → 065 21:11 ▲ 20 · 댓글 1 동영상 생성 자동회귀 확산 모델의 캐시 재사용으로 1.7배 고속화 자동회귀 비디오 확산 모델은 동영상을 시간 단위 청크로 나누어 여러 단계의 노이즈 제거를 거쳐 생성하는데, 이미 생성한 청크를 기억하기 위해 기존 방식들은 별도의 순전파를 통해 깨끗한 KV 캐시를 재구성해야 했다. AI · 머신러닝 · In-Flight KV Cache with Clean Anchors for Faster Autoregressive Video Diffusion
Key Point 프롬프트-기반 동영상 생성 서비스 개발 시 캐시 재사용과 양방향 조건부 생성으로 생성 속도를 높이는 구체적인 기술적 해법을 제시하므로, 장시간 영상 생성이 필요한 실무 개발자에게 실질적 개선 방안을 보여준다.
핵심 요약
자동회귀 비디오 확산 모델은 동영상을 시간 단위 청크로 나누어 여러 단계의 노이즈 제거를 거쳐 생성하는데, 이미 생성한 청크를 기억하기 위해 기존 방식들은 별도의 순전파를 통해 깨끗한 KV 캐시를 재구성해야 했다. FlashForward는 각 노이즈 제거 단계 중에 자동으로 생성되는 현재 청크의 KV 캐시를 다음 청크에서 직접 재사용해 캐시 업데이트 전용 순전파를 제거한다. 이 방식은 여러 GPU를 각 단계에 할당해 서로 다른 청크가 동시에 서로 다른 단계를 점유하도록 해 병렬 처리 효율을 높인다. 전체 요약 7문장 읽기 → 066 06:11 ▲ 115 · 댓글 67 해커 뉴스의 모든 글을 동영상으로 자동 변환하는 서비스 해커 뉴스에 올라온 모든 포스트를 자동으로 동영상 형태로 변환해주는 HN.watch 서비스를 선보였다. 웹 · 프론트엔드 · Show HN: HN.watch – Videos of all Hacker News posts
Key Point 해커 뉴스 같은 텍스트 위주 커뮤니티 콘텐츠를 음성과 영상으로 변환하는 자동화 기술이 어떻게 동작하는지, 개발자들이 이를 어떻게 활용할 수 있는지 보여준다.
핵심 요약
해커 뉴스에 올라온 모든 포스트를 자동으로 동영상 형태로 변환해주는 HN.watch 서비스를 선보였다. 기사 제목, URL, 포인트와 댓글 수 등 메타데이터를 함께 표시하면서 음성으로 읽어주는 방식이다. 데이터, 보안, 비즈니스 등 다양한 분야의 해커 뉴스 게시물들이 동영상 목록으로 구성돼 있다. 전체 요약 5문장 읽기 → 067 18:11 ▲ 47 · 댓글 3 기초 모델 학습 데이터 준비용 분산 처리 엔진 RayOrch 파운데이션 모델 학습을 위해 이질적인 문서·동영상을 정형 데이터로 변환하는 확장 가능한 파이프라인이 필요하다. AI · 머신러닝 · RayOrch: Programming and Executing Lineage-Controlled Multi-Grain Dataflows for Foundation-Model Data Preparation
Key Point 파운데이션 모델의 대규모 학습 데이터 파이프라인에서 기존 시스템의 계보 추적 한계를 제거해 GPU 활용률과 처리 속도를 크게 향상시키는 실질적 해결책이다.
핵심 요약
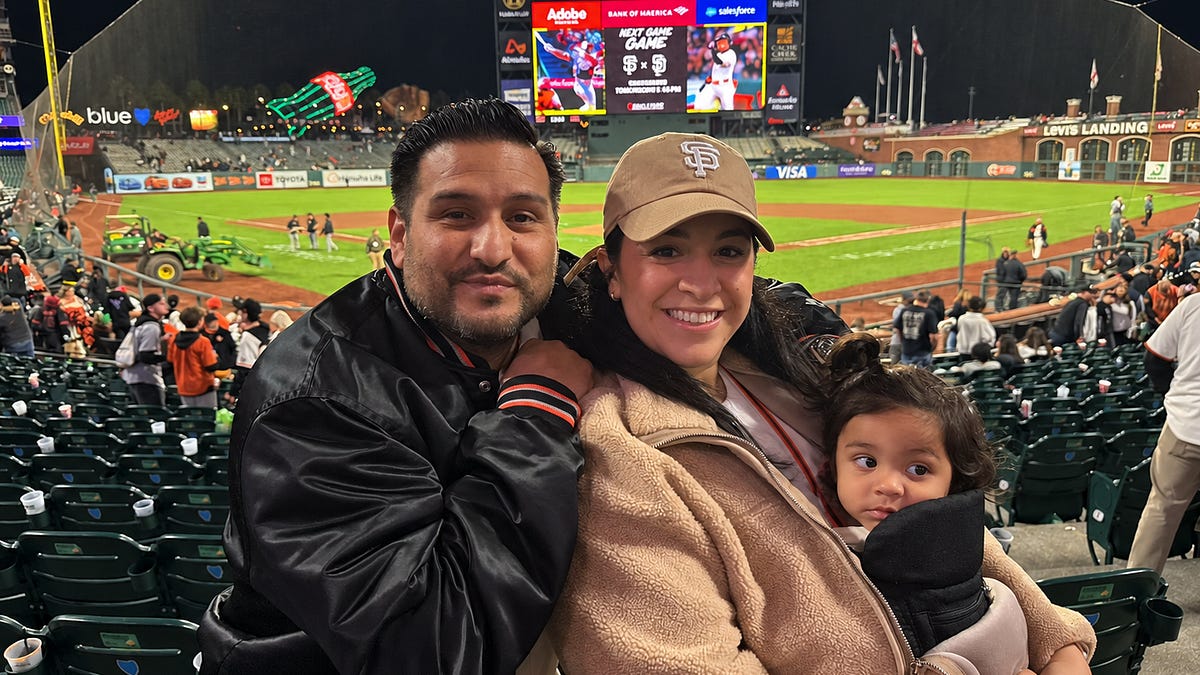
파운데이션 모델 학습을 위해 이질적인 문서·동영상을 정형 데이터로 변환하는 확장 가능한 파이프라인이 필요하다. 각 부모 항목이 자식으로 확장될 때 자식의 개수가 들쭉날쭉하고, GPU가 부모 관계와 자식 순서·처리 상태를 유지하면서 배치 처리해야 한다. 기존 시스템은 병렬 처리를 숨기거나 평탄한 레코드를 노출해 애플리케이션이 계보와 재그룹화를 직접 관리하도록 강제한다. 전체 요약 9문장 읽기 → 068 03:11 ▲ 184 · 댓글 65 바이럴 영상 속 아내가 직접 쓴 남편 옹호문 San Francisco Giants 경기에서 아기를 안고 음식을 나르던 아내의 영상이 바이럴되어 남편이 일하지 않는 남자로 낙인 찍혔다. 기타 · I'm the Mom in That Viral Giants Clip. Let Me Tell You About My Husband
Key Point 온라인에서의 순간적 판단이 실제 인물과 관계에 얼마나 큰 피해를 줄 수 있는지 보여주는 사건이며, 짧은 영상 너머의 전체 맥락을 듣는 것의 중요성을 일깨운다.
핵심 요약
San Francisco Giants 경기에서 아기를 안고 음식을 나르던 아내의 영상이 바이럴되어 남편이 일하지 않는 남자로 낙인 찍혔다. 방송진행자들의 농담이 사실인 것처럼 여겨져 남편을 폄하하는 글과 동영상, 심지어 자살 권유까지 받았다. 실제로는 경기 5회차에 아내가 화장실을 다녀오면서 남편에게 음식 메뉴 사진을 먼저 보낸 것이었고, 아내가 남편을 돌보고 싶었던 선택이었다. 전체 요약 13문장 읽기 → 069 21:11 당일 +142 중국 동영상·음악 플랫폼 자원 다운로더 오픈소스 Go와 Wails 기반의 크로스플랫폼 자원 다운로드 도구로, 비디오·오디오·이미지·m3u8·라이브 스트림 등 다양한 형식을 지원한다. 오픈소스 · 도구 · putyy/res-downloader · Go
Key Point 중국 플랫폼의 동영상·음악을 손쉽게 다운로드할 수 있는 도구가 오픈소스로 공개되어 국내 개발자들도 유사한 기능의 서비스를 개발하거나 배포 방식·기술 구조를 참고할 수 있게 되었다.
핵심 요약
Go와 Wails 기반의 크로스플랫폼 자원 다운로드 도구로, 비디오·오디오·이미지·m3u8·라이브 스트림 등 다양한 형식을 지원한다. WeChat 영상번호, 소프로그램, 더우인, 쾌수, 소홍서, 쿠구 음악, QQ 뮤직 등 중국 주요 플랫폼의 자원을 다운로드할 수 있다. Windows/macOS/Linux를 모두 지원하며 시스템 프록시를 통해 네트워크 패킷을 캡처하여 자원을 필터링한다. 전체 요약 8문장 읽기 → 070 22:26 ▲ 110 · 댓글 80 Claude 3.5로 한 번의 실행으로 완성하는 동영상 생성 도구 Claude 3.5 Opus를 활용해 URL이나 프롬프트 입력만으로 편집 없이 MP4 동영상을 자동 생성하는 웹 도구 'Launch Video'를 선보였다. AI · 머신러닝 · Opus 5.5 is good at explainer videos
Key Point Claude 3.5 Opus의 실제 활용 사례를 통해 대규모 언어 모델이 단순 텍스트를 넘어 시각 콘텐츠 생성까지 어떻게 확장되는지, 그리고 실제 프로덕션 환경에서 작동하는 시스템 설계 방식을 볼 수 있습니다.
핵심 요약
Claude 3.5 Opus를 활용해 URL이나 프롬프트 입력만으로 편집 없이 MP4 동영상을 자동 생성하는 웹 도구 'Launch Video'를 선보였다. 웹 페이지 텍스트·제목·헤딩·색상·폰트 정보를 추출하고, 생성된 HTML을 확인해 오류와 화면 텍스트를 검증한 뒤 동영상으로 렌더링하는 세 개의 도구로 구성된다. OpenComputer의 서버리스 에이전트 위에서 작동하며, TypeScript로 정의된 단일 에이전트 파일과 세 개의 도구만으로 이루어져 있고 별도의 프레임워크나 큐, 자체 서버가 필요 없다. 전체 요약 11문장 읽기 → 071 00:11 ▲ 124 · 댓글 47 샤오미 MiMo-V2.6-Pro, 지능형 AI 모델 분석 Artificial Analysis Intelligence Index에서 46점을 기록하며 동급 모델 평균(중앙값 18)을 크게 상회했다. AI · 머신러닝 · MiMo-v2.6-Pro: Intelligence, Performance and Price Analysis
Key Point 오픈소스 언어모델의 성능, 속도, 가격을 한눈에 비교할 수 있는 벤치마크 결과로, 상용 모델 도입을 검토하는 개발팀의 의사결정에 필요하다.
핵심 요약
Artificial Analysis Intelligence Index에서 46점을 기록하며 동급 모델 평균(중앙값 18)을 크게 상회했다. 초당 111개 토큰 생성으로 빠른 속도를 자랑하지만, 요약 작업에서 140M 토큰을 생성해 다소 장황하다. 입력 1M 토큰당 $0.43, 출력 1M 토큰당 $0.87로 오픈 가중치 모델 중 중상 수준의 가격대이다. 전체 요약 5문장 읽기 → 072 16:18 ▲ 63 · 댓글 3 동영상 생성 AI, 에이전트 학습으로 정확도 19% 향상 비디오 생성 모델이 복잡한 프롬프트를 만족하지 못하는 문제를 해결하기 위해 VideoGen-Agent를 제시했다. AI · 머신러닝 · VideoGen-Agent: Reinforcing Video Generation Agents
Key Point 비디오 생성 AI가 에이전트 기반 강화학습으로 복잡한 요구사항을 만족하는 방식이 크게 개선되었으며, 추후 생성 도구 발전 시 자동으로 성능 향상을 얻을 수 있다는 점이 중요하다.
핵심 요약
비디오 생성 모델이 복잡한 프롬프트를 만족하지 못하는 문제를 해결하기 위해 VideoGen-Agent를 제시했다. 이 에이전트는 증강·생성·검증 도구를 멀티턴 상호작용으로 조율하며, 프롬프트와 중간 관찰 결과를 바탕으로 의사결정한다. 지도 학습과 강화학습을 거쳐 도구 사용 능력을 개선했고, 카테고리별 균형잡힌 보상으로 평가했다. 전체 요약 6문장 읽기 → 073 16:56 당일 +196 로컬 AI 단편극 제작 도구, 온전한 오프라인 워크플로우 오픈소스 AI 단편극 생성 도구로, 스토리 입력부터 동영상 완성까지 전체 워크플로우를 로컬 환경에서 처리한다. AI · 머신러닝 · xuanyustudio/LocalMiniDrama · JavaScript
Key Point 로컬 우선 방식으로 창작 데이터 유출 걱정 없이 오픈소스 도구로 AI 단편극 제작 전 과정을 직접 완성할 수 있어서다.
핵심 요약
오픈소스 AI 단편극 생성 도구로, 스토리 입력부터 동영상 완성까지 전체 워크플로우를 로컬 환경에서 처리한다. SQLite 데이터베이스와 로컬 파일 기반으로 모든 소재가 클라우드를 거치지 않으며, 구독료 없이 완전 오픈소스다. 대사 작성 → 캐릭터·장면 생성 → 분할 대본 작성 → 이미지·동영상 생성 → 최종 편집까지 8단계의 자동화된 제작 흐름을 지원한다. 전체 요약 8문장 읽기 → 074 08:25 당일 +113 RTX 5090 전용 고성능 추론 엔진 NInfer 공개 Qwen 3.5/3.6/3.8 모델의 단일 GPU 추론에 최적화된 C++/CUDA 엔진이 공개되었습니다. 인프라 · 데브옵스 · Neroued/ninfer · C++
Key Point 단일 고사양 GPU에서 대규모 언어모델의 최고 속도 추론이 필요한 개발자나 기업에게 선택지를 제공하며, 양자화된 모델로도 높은 처리량을 유지하는 최적화 기법이 무엇인지 보여줍니다.
핵심 요약
Qwen 3.5/3.6/3.8 모델의 단일 GPU 추론에 최적화된 C++/CUDA 엔진이 공개되었습니다. 텍스트, 이미지, 동영상 입력을 지원하며 로컬 CLI 또는 OpenAI/Anthropic 호환 HTTP API로 제공됩니다. RTX 5090에서 최대 8개 동시 요청을 처리할 수 있으며 1-8개 활성 요청의 고정 용량으로 특화되어 있습니다. 전체 요약 6문장 읽기 → 075 21:11 당일 +1,207 ElevenLabs 대체 오픈소스, 로컬에서 음성 변환·더빙·받아쓰기 VoiceStudio는 646개 언어를 지원하는 오픈소스 음성 생성 도구로, 음성 클로닝·음성 디자인·동영상 더빙·받아쓰기·오디오북 제작을 모두 로컬에서 처리한다. 오픈소스 · 도구 · debpalash/VoiceStudio · Python
Key Point 클라우드 서비스 의존 없이 모든 음성 작업을 로컬에서 처리할 수 있는 완성도 높은 오픈소스가 등장했으며, 엔진 유연성과 다국어 지원이 개발자와 콘텐츠 제작자에게 실질적인 선택지가 된다.
핵심 요약
VoiceStudio는 646개 언어를 지원하는 오픈소스 음성 생성 도구로, 음성 클로닝·음성 디자인·동영상 더빙·받아쓰기·오디오북 제작을 모두 로컬에서 처리한다. TTS 16개, ASR 11개 엔진을 탑재했으며 엔진 간 전환이 자유롭다. 계정·API 키·구독료 없이 자신의 하드웨어에서 동작하며, macOS·Windows·Linux·Docker를 지원한다. 전체 요약 6문장 읽기 → 076 11:10 ▲ 277 · 댓글 79 라디버드 브라우저 8월 업데이트, 트위치·유튜브 영상 재생 지원 Twitch 적응형 영상과 YouTube의 AV1·AVC·HEVC·AAC 코덱을 지원하며, H.264와 HEVC 등 여러 영상 포맷을 이제 재생할 수 있다. 웹 · 프론트엔드 · This Month in Ladybird – August 2026
Key Point 오픈소스 웹 브라우저로 주요 동영상 스트리밍 서비스를 지원하기 시작했으며, 성능 개선과 개발자 도구 확충으로 실제 사용 가능성이 높아지고 있다.
핵심 요약
Twitch 적응형 영상과 YouTube의 AV1·AVC·HEVC·AAC 코덱을 지원하며, H.264와 HEVC 등 여러 영상 포맷을 이제 재생할 수 있다. CSS scroll snap, JavaScript DevTools 디버깅, 다운로드 일시정지/재개, 세션 복구 기능을 추가했다. 새 스타일 엔진 개발, 레이아웃 캐싱, CSS 애니메이션 메인 스레드 오프로드로 성능을 중점 개선했다. 전체 요약 5문장 읽기 → 077 08:12 당일 +846 HTML로 동영상 렌더링 프레임워크 HyperFrames 공개 HyperFrames는 HTML, CSS, 미디어를 MP4 동영상으로 변환하는 오픈소스 프레임워크다. AI · 머신러닝 · heygen-com/hyperframes · TypeScript
Key Point AI 에이전트가 프로그래밍 없이 동영상 콘텐츠를 자동으로 생성할 수 있는 새로운 방식을 제시하며, 마케팅 자동화부터 콘텐츠 제작까지 범위가 넓다.
핵심 요약
HyperFrames는 HTML, CSS, 미디어를 MP4 동영상으로 변환하는 오픈소스 프레임워크다. CLI, AI 에이전트의 스킬, 또는 호스팅 저작 워크플로우의 렌더링 엔진으로 사용할 수 있다. 상품 출시 영상, 설명 동영상, PR 요약, 자막 추가, 모션 그래픽 등 20개의 도메인별 스킬을 제공한다. 전체 요약 5문장 읽기 →