쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 22일 (일)까지 5067건
100건 (최대치) · "학습 데이터"조건 지우기 ×
001 18:11 ▲ 25 · 댓글 2 1인칭 영상 설명에 타이밍 추가한 'EgoCaptioner' 공개 기존 멀티모달 대형언어모델(MLLM)들은 1인칭 영상의 짧은 행동을 놓치거나 순서를 헷갈리거나 착용자의 움직임을 잘못 해석하는 문제가 있었다. AI · 머신러닝 · EgoCaptioner: Towards Comprehensive and Fine-Grained Egocentric Video Captioning
Key Point 1인칭 영상 분석에서 정확한 시간 정보와 세밀한 행동 설명이 모두 필요한 실제 문제를 해결하는 새로운 데이터셋과 방법론이며, 기존 상용 모델을 능가하는 성능을 달성했기 때문이다.
핵심 요약
기존 멀티모달 대형언어모델(MLLM)들은 1인칭 영상의 짧은 행동을 놓치거나 순서를 헷갈리거나 착용자의 움직임을 잘못 해석하는 문제가 있었다. EgoCaptioner는 영상의 환경·참여자·착용자의 전반 활동을 개요로 먼저 제시한 뒤, 각 단계마다 타임스탬프를 붙인 설명을 제공하며 세부사항의 정도를 조정해 주요 순간을 정확히 표시한다. 50,000개 학습 데이터셋을 위해 'coarse-to-fine' 주석 방식을 개발했으며, 먼저 사건 구조를 정의한 뒤 각 단계 설명을 확장하는 방식을 사용했다. 전체 요약 8문장 읽기 → 002 12:10 ▲ 13 · 댓글 2 시각 검색 위한 논리적 추론 모델 LogT 공개 시각-언어 모델(VLM)이 세밀한 시각 탐색을 위해 확대 도구(Zoom-in tool)를 사용하도록 하는 LogT를 제안한 논문이다. AI · 머신러닝 · LogT: Logically Think with Images for Visual Search
Key Point 고품질 학습 데이터로 복잡한 강화학습 없이도 최첨단 성능을 내는 사례로, VLM 기반 시각 추론 분야에서 효율성 패러다임을 바꾸는 연구입니다.
핵심 요약
시각-언어 모델(VLM)이 세밀한 시각 탐색을 위해 확대 도구(Zoom-in tool)를 사용하도록 하는 LogT를 제안한 논문이다. 기존 방식은 강화학습(RL) 복잡도를 높이거나 도구별 설계를 적용했으나, LogT는 감독학습(SFT) 데이터 품질을 핵심 병목으로 진단했다. LogT는 완전 자동화된 SFT 데이터 생성 엔진으로, 논리 체인 기반 추론을 명시적으로 강제하고 인간다운 도구 사용 흔적이 담긴 도전적인 질문-답변 쌍을 생성한다. 전체 요약 7문장 읽기 → 003 06:11 ▲ 13 · 댓글 2 모델과 데이터가 함께 진화하는 의사결정 AI 'Piccolo' 공개 Hugging Face는 Piccolo라는 멀티모달 의사결정 모델 계열(0.8B~27B)을 발표했으며, 이는 에이전트 기반 데이터 엔지니어링과 재귀적 자기 개선(RSI)을 통해 모델 능력과 학습 데이터를 함께 진화시킨다. AI · 머신러닝 · Piccolo: Co-Evolving Decision Models and Data through Recursive Self-Improvement
Key Point 모델 아키텍처보다 데이터 큐레이션이 성능을 크게 좌우한다는 발견과 작은 모델이 큰 모델과 경쟁할 수 있다는 결과는 AI 모델 개발 방식의 근본적 전환을 시사한다.
핵심 요약
Hugging Face는 Piccolo라는 멀티모달 의사결정 모델 계열(0.8B~27B)을 발표했으며, 이는 에이전트 기반 데이터 엔지니어링과 재귀적 자기 개선(RSI)을 통해 모델 능력과 학습 데이터를 함께 진화시킨다. Piccolo는 텍스트와 시각 판단, 에이전트 도구, 데이터 워크플로우, 대화형 게임 등에서 후보 답안에 대한 확률을 예측한다. Piccolo-27B는 Decision Index Vision Full 리더보드에서 75.59점으로 1위이며, Piccolo-9B(68.35점)와 Piccolo-4B(67.46점)도 각 크기 범주에서 Private 벤치마크 1위를 차지한다. 전체 요약 8문장 읽기 → 004 00:11 ▲ 118 · 댓글 54 Claude, 단백질 서열 대규모 학습 받은 것으로 드러나 Claude Fable 5.2와 Opus 5.5는 단백질 서열을 대규모로 학습받았으며, 연구된 적 거의 없는 박테리아 단백질의 다음 아미노산을 예측할 수 있다. AI · 머신러닝 · Claude was trained on protein sequences at scale
Key Point Claude가 단백질 서열을 대규모로 학습받았다는 것은 생물정보학 분야에서 LLM의 활용 범위를 크게 확장하는 의미를 가지며, 미개발 단백질 예측 능력은 신약 개발과 단백질 공학 등에 실질적 가치가 있다.
핵심 요약
Claude Fable 5.2와 Opus 5.5는 단백질 서열을 대규모로 학습받았으며, 연구된 적 거의 없는 박테리아 단백질의 다음 아미노산을 예측할 수 있다. 다음 아미노산 테스트에서 Fable 5.2는 실제 단백질에서 54% 정확도, 순서를 뒤섞은 단백질에서 9% 정확도를 기록했으며, 같은 테스트에서 GPT, Gemini 등 다른 모델들은 거의 0에 가깝다. Claude 모델은 단백질 언어 모델인 ProtGPT3-10B, ProGen3와 비슷하거나 능가하는 성능을 보였고, 개발된 단백질보다 미개발 단백질에서 더 강한 성능을 발휘했다. 전체 요약 11문장 읽기 → 005 21:11 ▲ 17 · 댓글 2 단일 이미지도, 비디오도 한 번에—4D 장면 인식 AI 모델 π^4 π^4는 RGB 사진 하나, 정렬되지 않은 이미지 모음, 또는 비디오 시퀀스 등 다양한 입력으로 4D 장면을 인식하는 통합 파운데이션 모델이다. AI · 머신러닝 · π^4: A Foundation Model for 4D Scene Geometry and Motion
Key Point 카메라 포즈, 기하학, 움직임 추적을 한 번에 복원하는 통합 모델은 로보틱스, AR, 3D 콘텐츠 제작 등 다양한 응용 분야에서 멀티모달 입력을 처리할 수 있는 새로운 기준을 제시한다.
핵심 요약
π^4는 RGB 사진 하나, 정렬되지 않은 이미지 모음, 또는 비디오 시퀀스 등 다양한 입력으로 4D 장면을 인식하는 통합 파운데이션 모델이다. 기하학(geometry) 브랜치와 기하학 조건부 모션 브랜치로 구성되어, 카메라 포즈와 미터 스케일, 밀도 높은 기하학 정보를 복원한다. 다중 이미지 입력 시 2D/3D 포인트 트랙과 움직이는 물체 마스크도 함께 예측한다. 전체 요약 8문장 읽기 → 006 15:11 ▲ 42 · 댓글 3 API만 열린 로봇 모델, 접촉력 감지로 조작 능력 70배 향상 프론티어 멀티모달 모델은 이미지만으로 로봇을 제어할 수 있지만, 많은 조작 작업에서 필요한 접촉력(contact force)은 이미지에 드러나지 않는 문제가 있다. AI · 머신러닝 · ForceHarness: Turning Force into Action and Physics for Frozen Frontier Models
Key Point 접촉력 센싱을 통해 순수 비전 기반의 로봇 제어를 넘어, 실제 조작 작업이 가능한 단계로 도약하는 기술로, 고정된 대형 모델의 활용 범위를 대폭 확장한다.
핵심 요약
프론티어 멀티모달 모델은 이미지만으로 로봇을 제어할 수 있지만, 많은 조작 작업에서 필요한 접촉력(contact force)은 이미지에 드러나지 않는 문제가 있다. ForceHarness는 파인튜닝이나 학습 데이터 없이 고정된 API 모델이 힘을 활용하도록 하는 하네스(harness) 시스템이다. 첫째 과제는 접촉이 API 모델의 응답 속도보다 빠르게 변하므로, 모델 아래에서 독립적으로 힘을 제어하는 자가-종료 프리미티브(self-terminating force primitives)를 구현해 접촉 이벤트에서 반환한다. 전체 요약 7문장 읽기 → 007 15:11 ▲ 24 · 댓글 4 로봇 움직임 추적·예측하는 TCP4D 모델 공개 로봇 조작 영상에서 RGB 이미지만으로 로봇 행동과 그리퍼 상태를 자동으로 복원하는 문제를 해결하기 위해 embodiment-agnostic tool-center-point(TCP) 포즈를 행동 공간으로 사용한다. AI · 머신러닝 · TCP4D: A Unified Tool-Center-Point Tracking and Generation Model for Robot Manipulation
Key Point 로봇 조작에서 비디오만으로 정확한 운동 궤적을 자동으로 추출·예측하고, 다른 로봇으로 쉽게 옮길 수 있다는 점이 로봇 학습 데이터 수집의 병목을 크게 줄일 수 있기 때문입니다.
핵심 요약
로봇 조작 영상에서 RGB 이미지만으로 로봇 행동과 그리퍼 상태를 자동으로 복원하는 문제를 해결하기 위해 embodiment-agnostic tool-center-point(TCP) 포즈를 행동 공간으로 사용한다. TCP4D는 공유하는 4D 장면 표현으로 관찰된 TCP 움직임을 추적하고 미래 TCP 궤적을 생성하는 통합 모델이다. 단안 카메라 영상과 초기 2D TCP 쿼리가 주어지면, 추적 모듈이 SE(3) 메트릭 TCP 포즈와 그리퍼 상태, 장면 기하학, 카메라 파라미터를 직접 복원한다. 전체 요약 8문장 읽기 → 008 12:11 ▲ 174 · 댓글 40 위키피디아 편집 조작, 미국 정부와 ADL이 개입했다는 보고서 기술 단체 'Tech for Palestine'이 11월 2026년 발표한 보고서는 20년간 위키피디아에 대한 조직적 공격을 기록했다고 주장한다. 기타 · Israel vs. Wikipedia
Key Point 위키피디아가 모든 주요 AI 모델의 학습 데이터 소스인 만큼, 역사 기록과 정보 중립성이 AI의 편향 여부를 결정하는 현실에서 누가 어떻게 위키피디아를 조작하려 하는지를 이해하는 것이 중요하다.
핵심 요약
기술 단체 'Tech for Palestine'이 11월 2026년 발표한 보고서는 20년간 위키피디아에 대한 조직적 공격을 기록했다고 주장한다. 보고서 주요 내용: 미국 정부가 ADL 보고서를 근거로 위키피디아를 공격했으며, 이스라엘 로비가 위키피디아 영향력을 확대하려는 의도가 있다고 한다. 위키피디아는 Google Search와 모든 주요 AI 챗봇에 콘텐츠를 제공하므로, 2026년 이스라엘 선전 예산 7억 2900만 달러 중 AI 챗봇을 친이스라엘로 만드는 데 465만 달러가 계약됐다고 지적한다. 전체 요약 10문장 읽기 → 009 21:11 ▲ 15 · 댓글 2 인간-로봇 행동 정렬로 기초 모델 확장성 높인 SALA 로봇 상호작용 데이터 수집 비용 절감을 위해 인간의 일인칭 비디오를 활용하는 embodied 기초 모델 개발이 필요한 상황이다. AI · 머신러닝 · SALA: Semantically Aligned Latent Actions Enable Dual-Axis Scaling of Embodied Foundation Models
Key Point 로봇 학습 데이터 수집의 근본적 비용 문제를 해결하면서도 의미 있는 행동 정렬을 달성하는 방법론이 제시되어, embodied AI의 실용적 확장성을 크게 높인다.
핵심 요약
로봇 상호작용 데이터 수집 비용 절감을 위해 인간의 일인칭 비디오를 활용하는 embodied 기초 모델 개발이 필요한 상황이다. 기존 latent action model(LAM)은 비디오 재구성 방식으로만 학습하면서 시각적 외형에 따라 행동 표현이 뭉칠 수 있고, 인간 행동과 로봇 행동 간 정렬에 어려움이 있다. SALA는 언어 설명을 활용해 쌍을 이루지 않은 인간 및 로봇 클립의 의미론적 유사도를 추정하고, 이를 통해 인간 latent action을 의미론적으로 관련된 로봇 latent 쪽으로 유도한다. 전체 요약 5문장 읽기 → 010 18:11 ▲ 84 · 댓글 2 쿠오토-쿠차(K2) 공개 대형 언어모델 플릿 출범 Hugging Face가 K2-Horizon 프로젝트로 0.9B부터 375B 규모의 MoE 모델 6개를 완전 공개했다. AI · 머신러닝 · K2-Horizon: A Frontier Fleet of Open Source Language Models
Key Point 대형 언어모델의 완전한 오픈소스화 추세 속에서 개발 전 과정과 파이프라인을 투명하게 공개하는 사례가 드물고, 합성 데이터 기반 대규모 사전학습과 MoE 최적화 기법이 실제 모델 성능에 미치는 영향을 보여준다.
핵심 요약
Hugging Face가 K2-Horizon 프로젝트로 0.9B부터 375B 규모의 MoE 모델 6개를 완전 공개했다. 일반적 추론과 에이전트 작업, 수학·과학·소프트웨어 엔지니어링을 목표로 설계했으며 같은 규모의 기존 오픈소스 모델들과 경쟁 수준이다. Mixture-of-Value Attention(MoVA)으로 주의 집중 메커니즘에 MoE를 적용하고, softplus 주의 집중 게이트를 도입해 추론 능력을 강화했다. 전체 요약 8문장 읽기 → 011 00:11 ▲ 20 · 댓글 2 전자상거래 AI 에이전트, 계속 학습으로 변화하는 수요에 적응 LLM 기반 쇼핑 에이전트가 사용자의 새로운 수요와 제품 카테고리, 기능 요청에 따라 성능이 떨어지는 문제와 새로운 기능 도입 시 기존 동작을 잃는 문제가 발생한다. AI · 머신러닝 · G-CAST: Governed Continual Self-Training for E-Commerce Agents under Evolving Demands
Key Point 전자상거래 AI 에이전트가 현실의 변화하는 요구에 맞춰 자동으로 학습하면서도 기존 기능을 유지하는 방식을 제시해 LLM 에이전트의 지속 가능한 운영 문제를 해결한다.
핵심 요약
LLM 기반 쇼핑 에이전트가 사용자의 새로운 수요와 제품 카테고리, 기능 요청에 따라 성능이 떨어지는 문제와 새로운 기능 도입 시 기존 동작을 잃는 문제가 발생한다. 알리바바가 개발한 G-CAST는 일일 운영 데이터를 보상 기반으로 선별하고 엔트로피 우선순위를 적용해 학습 데이터를 생성하는 지속적 자체 학습 시스템이다. 누적 평가에 따른 체크포인트 전환으로 각 모델 업데이트를 제어하여 새로운 기능을 학습하면서도 기존에 작동하던 기능을 보존한다. 전체 요약 6문장 읽기 → 012 18:11 ▲ 10 · 댓글 2 양팔 조종 + 이동형 로봇을 위한 데이터 수집 시스템 HALO 양팔 동작과 로봇 이동을 함께 학습하는 모바일 조작 로봇의 학습 데이터를 효율적으로 수집하는 HALO 시스템을 소개했다. 하드웨어 · 시스템 · HALO: Human-Aligned Data Collection for WhoLe-body MObile Manipulation
Key Point 기존 데이터 수집의 속도와 품질 문제를 동시에 해결하면서 복잡한 양팔-이동 로봇 학습의 현실적 경로를 보여준다.
핵심 요약
양팔 동작과 로봇 이동을 함께 학습하는 모바일 조작 로봇의 학습 데이터를 효율적으로 수집하는 HALO 시스템을 소개했다. 기존 인터페이스는 직접 제어, 인지-행동 정렬, 자연스러운 이동성 중 하나를 포기해야 하는 트레이드오프가 있었다. HALO는 저항 작은 플랫폼 위에서 키네스틱 티칭으로 로봇 팔을 조종하면서 자연스럽게 이동할 수 있게 설계했다. 전체 요약 6문장 읽기 → 013 03:11 ▲ 560 · 댓글 329 AI가 생성한 코드는 모두 오픈소스여야 한다 AI 모델은 오픈소스 커뮤니티에서 무단으로 수집한 방대한 코드로 학습했으며, Stack Overflow 등 크리에이티브 커먼즈 라이선스 콘텐츠도 포함되어 있다. 오픈소스 · 도구 · All AI-generated code should be Open Source
Key Point AI 모델이 오픈소스 코드로 무단 학습한 만큼, 그로부터 생성된 코드도 오픈에 돌려줘야 한다는 논리가 개발자 커뮤니티에서 점차 주목받고 있다.
핵심 요약
AI 모델은 오픈소스 커뮤니티에서 무단으로 수집한 방대한 코드로 학습했으며, Stack Overflow 등 크리에이티브 커먼즈 라이선스 콘텐츠도 포함되어 있다. 이 학습 데이터를 기반으로 생성된 코드를 사유(proprietary) 소프트웨어로 배포하는 것은 라이선스 회피(license laundering)에 해당한다. 법적으로 순수 AI 생성 코드는 인간이 작성하지 않았으므로 저작권 보호 대상이 아니며, 미국의 '원숭이 셀카' 판례와 미 저작권청의 AI 판단이 이를 뒷받침한다. 전체 요약 6문장 읽기 → 014 06:11 ▲ 101 · 댓글 6 JAX만으로 DeepSeek V3 구현, 190줄 코드로 MacBook에서 학습 DeepSeek V3 기술 보고서의 아키텍처를 순수 JAX 190줄로 구현하고, MacBook Air에서 처음부터 학습했다. AI · 머신러닝 · Show HN: DeepSeek V3 in ~200 lines of pure Jax
Key Point 순수 JAX로 DeepSeek V3 전체 아키텍처를 간결하게 구현한 오픈소스 프로젝트로, 최신 대형 언어모델의 내부 동작을 학습 코드와 함께 읽고 이해할 수 있는 기회를 제공한다.
핵심 요약
DeepSeek V3 기술 보고서의 아키텍처를 순수 JAX 190줄로 구현하고, MacBook Air에서 처음부터 학습했다. 멀티헤드 레이턴트 어텐션(MLA)은 토큰당 480개에서 144개 숫자로 압축하여 캐시 크기를 줄였고, 디커플된 RoPE와 DeepSkMoE(공유 전문가 1개 + 라우팅된 전문가 16개, 토큰당 상위 4개 선택) 기법을 적용했다. 보조 손실 없는 밸런싱은 전문가별 바이어스를 조정하여 라우팅을 유휴 전문가로 유도하고, 시퀀스 단위 밸런스 손실(α = 1e-4)과 멀티토큰 예측(λ = 0.3) 모듈을 추가했다. 전체 요약 10문장 읽기 → 015 12:11 ▲ 103 · 댓글 21 Perplexity, 의사결정 특화 AI 모델 Decider v1.3 공개 Perplexity가 Decider v1.3과 Decider Flash v1.3을 출시했으며, 양쪽 모두 Hugging Face(Apache 라이선스), OpenRouter, Perplexity Decisions API를 통해 이용 가능하다. AI · 머신러닝 · Perplexity Decider v1.3: Training, eval, and use cases
Key Point 의사결정 전문 AI 모델로 한 번의 연산으로 여러 분류 작업을 수행해 기존 LLM 대비 훨씬 빠르고 저렴하게 구조화된 답변이 필요한 서비스(검색, 라우팅, 필터링 등)를 처리할 수 있다.
핵심 요약
Perplexity가 Decider v1.3과 Decider Flash v1.3을 출시했으며, 양쪽 모두 Hugging Face(Apache 라이선스), OpenRouter, Perplexity Decisions API를 통해 이용 가능하다. 의사결정 모델은 입력과 질문 집합을 받아 각 질문에 대한 확률 분포를 반환하는 범용 분류기로, Yes/No(이진), 다중선택, 점수(순서 있는 수준) 세 가지 질문 유형을 지원한다. 기존 생성형 LLM 대신 의사결정 모델을 사용하면 단일 포워드 패스에서 여러 질문을 동시에 처리하므로 토큰 하나씩 생성하는 오버헤드를 피하고 계산을 공유할 수 있다. 전체 요약 13문장 읽기 → 016 06:11 ▲ 154 · 댓글 30 600번의 실험으로 발견한 JEPA 월드 모델의 최적 설계 JEPA(joint-embedding predictive architecture)는 픽셀 생성 대신 임베딩 공간에서 예측하는 월드 모델로, 인코더·예측기·플래너 세 부분으로 구성된다. AI · 머신러닝 · After 600 experiments, here's what I discovered about JEPA world models
Key Point JEPA 월드 모델의 병목이 예측이 아니라 계획 방식임을 실험으로 증명했고, 재학습 없이 네 가지 방법으로 성공률을 3배 이상 향상시킨 구체적 기법들을 제시한다.
핵심 요약
JEPA(joint-embedding predictive architecture)는 픽셀 생성 대신 임베딩 공간에서 예측하는 월드 모델로, 인코더·예측기·플래너 세 부분으로 구성된다. LeWM 모델을 600회 실험한 결과, 예측 정확도 개선보다 계획 방식 변경이 더 큰 효과를 발휘했다. LeWM의 예측기를 완벽한 물리 시뮬레이터로 바꿔도 성공률이 78%에서 77%로 거의 변하지 않아, 병목은 모델의 예측이 아닌 사용 방식임을 확인했다. 전체 요약 12문장 읽기 → 017 18:11 ▲ 46 · 댓글 4 동영상 생성 AI, LLM의 물리 지식으로 스스로 학습한다 동영상 생성 모델들은 시각적으로는 현실적이지만 물리 법칙과 인과관계를 제대로 따르지 못한다. AI · 머신러닝 · PhysLoop: Harnessing LLMs' Physics Awareness for Self-Improving Video Generation Models
Key Point LLM의 물리 지식을 동영상 생성에 직접 녹여내는 방식으로, 인간 감독을 줄이면서 생성 AI가 스스로 개선되는 새로운 경로를 제시한다.
핵심 요약
동영상 생성 모델들은 시각적으로는 현실적이지만 물리 법칙과 인과관계를 제대로 따르지 못한다. 생성된 영상으로부터 학습하려면 정교한 물리 감독이 필요한데, 신뢰할 만한 품질 판단과 수정 쌍을 확보하기 어렵다. PhysLoop은 LLM이 지닌 물리 지식을 활용해 동영상 생성 모델이 스스로 개선되도록 돕는 통합 프레임워크다. 전체 요약 8문장 읽기 → 018 18:11 ▲ 47 · 댓글 3 교과서 구조에서 수학 증명 380만 개 추출 언어 모델의 수학 학습 데이터는 보통 문제-풀이 쌍으로 단순화되어, 원본 교과서의 조직체계와 증거 구조가 손실된다. AI · 머신러닝 · Scaling Mathematical Proof Supervision from Structured Textbooks
Key Point 언어 모델의 수학 능력을 근본적으로 개선할 수 있는 새로운 데이터 구조와 38만 개의 증명 레코드를 제시하는데, 실제 교과서 구조를 보존함으로써 기존 단순 문제-풀이 쌍 방식보다 학습 효율이 크게 높다는 점이 중요하다.
핵심 요약
언어 모델의 수학 학습 데이터는 보통 문제-풀이 쌍으로 단순화되어, 원본 교과서의 조직체계와 증거 구조가 손실된다. 연구팀은 TOME-Math라는 대규모 코퍼스를 구축해 2,118개 대학수학 교과서를 약 38만 개의 구조화된 증명 감독 레코드로 변환했다. 변환 과정에서 장(章) 순서, 명제-증명 연결, 의존성 참조, 출처 정보 등의 구조 신호를 보존했다. 전체 요약 7문장 읽기 → 019 00:11 ▲ 18 · 댓글 3 음성 생성 통합 엔드투엔드 프레임워크 WaveGen 공개 WaveGen은 확산 모델 기반의 완전 엔드투엔드 텍스트-파형 생성 프레임워크로, 스펙트럼 강제(Spectral Forcing) 기법으로 내부 스펙트럼 궤적과 대상 파형 궤적을 단일 모델에서 동시 학습한다. AI · 머신러닝 · WaveGen: Truly End-to-End Waveform Generation via Internal Spectral Trajectory Learning
Key Point 기존 음성 합성 파이프라인의 복잡한 멀티스테이지 구조를 완전히 통합하고 외부 모듈 의존성을 제거한 진정한 엔드투엔드 모델로, 음성 생성 시스템의 단순화 가능성을 보여준다.
핵심 요약
WaveGen은 확산 모델 기반의 완전 엔드투엔드 텍스트-파형 생성 프레임워크로, 스펙트럼 강제(Spectral Forcing) 기법으로 내부 스펙트럼 궤적과 대상 파형 궤적을 단일 모델에서 동시 학습한다. 신경 오디오 코덱, 멜-스펙트로그램 보코더, VAE 기반 잠재 모델 등 별도 학습된 중간 표현에 의존하지 않으며, 지속시간 예측기 같은 외부 정렬 모듈 없이 모델 내부에서 텍스트-음성 정렬을 수행한다. BERT 기반 텍스트 임베딩, Wav2Vec 2.0 기반 의미 표현, 의미 증류 같은 자기지도 표현 의존성도 제거해 진정한 엔드투엔드 구조를 유지한다. 전체 요약 7문장 읽기 → 020 21:11 당일 +1,200 구글·마이크로소프트·모질라가 함께 만드는 AI 코딩을 위한 웹 가이드 Google Chrome, Microsoft Edge, Mozilla Firefox, MDN 팀과 웹 개발 커뮤니티가 협력해 만든 'Modern Web Guidance'는 LLM 학습 데이터에 포함된 레거시 코드 때문에 구형 패턴을 생성하는 AI 코딩 에이전트를 최신 웹 플랫폼 표준으로 유도하는 스킬이다. 웹 · 프론트엔드 · GoogleChrome/modern-web-guidance-src · TypeScript
Key Point LLM이 생성하는 레거시 자바스크립트 코드 문제를 전 브라우저 벤더가 함께 해결하려는 표준화 노력으로, AI 에이전트 활용이 늘어나는 상황에서 최신 웹 표준 기반 개발을 보장하는 새로운 방식이다.
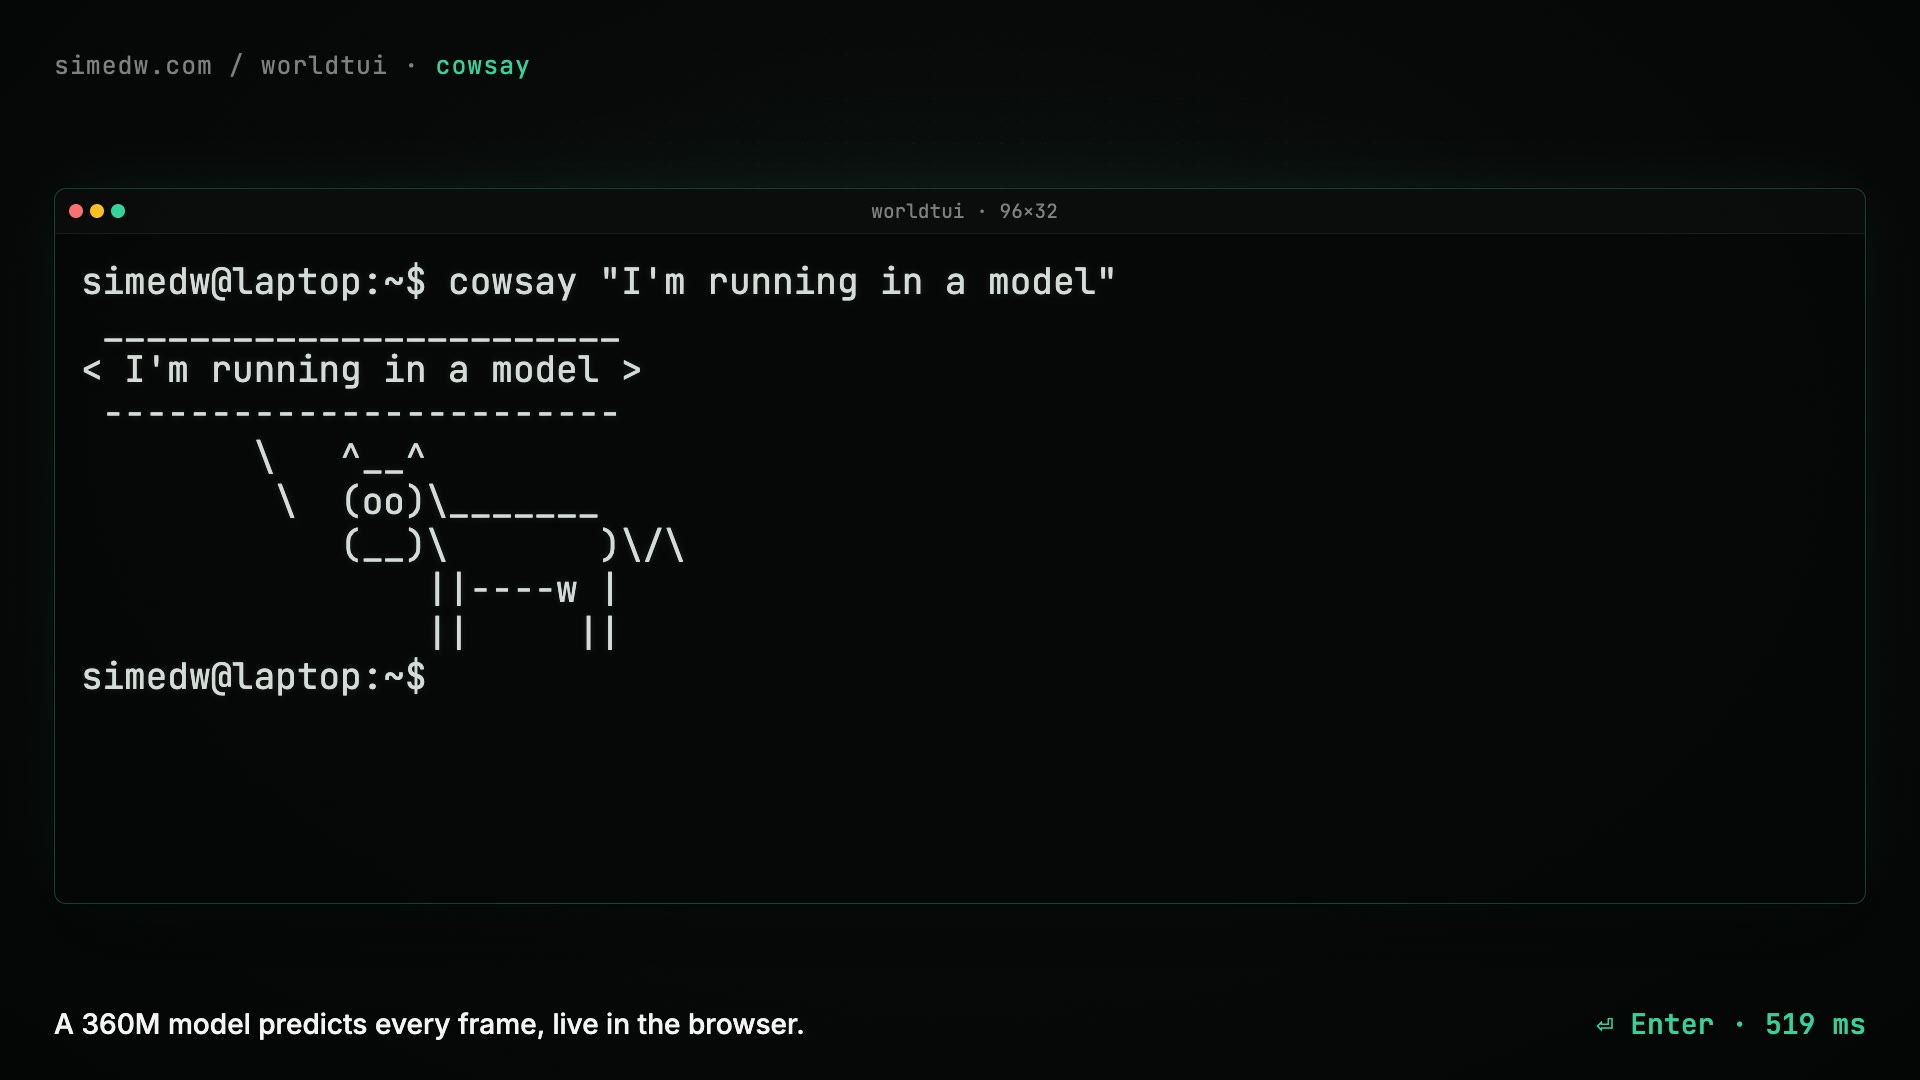
핵심 요약
Google Chrome, Microsoft Edge, Mozilla Firefox, MDN 팀과 웹 개발 커뮤니티가 협력해 만든 'Modern Web Guidance'는 LLM 학습 데이터에 포함된 레거시 코드 때문에 구형 패턴을 생성하는 AI 코딩 에이전트를 최신 웹 플랫폼 표준으로 유도하는 스킬이다. 현대 브라우저 API, 성능 최적화, 접근성, 책임감 있는 폴백 가이드 등을 포함해 AI가 프로덕션 수준의 최신 코드를 생성하도록 돕는다. CSS 레이아웃(컨테이너 쿼리, 서브그리드, oklch 색상 공간 등), 사용자 경험(View Transitions, 스크롤 애니메이션), 성능(INP 진단, scheduler.yield) 분야를 다룬다. 전체 요약 6문장 읽기 → 021 06:11 ▲ 151 · 댓글 43 AI 코딩 에이전트를 현대 웹 표준으로 유도하는 가이드 Google Chrome, Microsoft Edge, Mozilla Firefox, MDN 팀이 함께 개발한 Modern Web Guidance는 AI 코딩 에이전트를 위한 웹 플랫폼 전문성과 모범 사례를 담은 스킬 세트이다. 웹 · 프론트엔드 · Show HN: Get your coding agent off ~2019 JavaScript, onto modern web primitives
Key Point AI가 생성하는 코드가 여전히 2019년 방식의 bloated JavaScript에 머물러 있는 문제를 직접 해결하는 구체적인 도구이며, 웹 표준 진화에 맞춰 에이전트를 재교육할 수 있게 한다.
핵심 요약
Google Chrome, Microsoft Edge, Mozilla Firefox, MDN 팀이 함께 개발한 Modern Web Guidance는 AI 코딩 에이전트를 위한 웹 플랫폼 전문성과 모범 사례를 담은 스킬 세트이다. LLM 학습 데이터에 포함된 레거시 코드가 많아서 AI 에이전트는 자주 구식 패턴을 생성하며, 현대 네이티브 웹 API로 더 효율적으로 해결할 수 있는 작업을 bloated JavaScript로 작성하곤 한다. Modern Web Guidance는 npx 명령어로 설치해 대화형 마법사를 통해 설정하거나, 코드베이스에서 레거시 패턴을 자동으로 스캔할 수 있다. 전체 요약 8문장 읽기 → 022 03:11 ▲ 325 · 댓글 239 HN 댓글 남기는 게 냉이메일 덫이 됐다 저자는 예전에는 HN 댓글과 블로그 글에 대한 이메일 대부분이 의미 있는 내용이었지만, 지난 2년간 거의 모두 영업 피치로 변했다고 지적한다. 기타 · I saw your HN comment
Key Point 개발자와 기술인들의 온라인 활동 자체가 AI를 악용한 타겟 마케팅의 먹이사슬로 변했으며, 이는 진정한 기술 커뮤니티 문화 파괴라는 근본적인 문제를 드러낸다.
핵심 요약
저자는 예전에는 HN 댓글과 블로그 글에 대한 이메일 대부분이 의미 있는 내용이었지만, 지난 2년간 거의 모두 영업 피치로 변했다고 지적한다. LLM이 등장하면서 누군가의 실제 댓글을 맞춤형으로 참고해 그럴듯한 이메일을 쉽게 작성할 수 있게 됐고, 그 결과 기만적인 냉이메일이 급증했다. 이들은 직접 영업을 제안하지 않고 '당신이 한 말에 대해 궁금한데' 식으로 시작해 질문을 던지는 식으로 위장한다. 전체 요약 7문장 읽기 → 023 18:11 ▲ 156 · 댓글 102 애플 실리콘 리눅스, 오디오·비디오 드라이버 상류화 본격화 애플 실리콘용 Asahi Linux 개발팀이 macaudio 및 AVD 등 주요 드라이버를 리눅스 커널 상류(upstream)로 제출 준비를 완료했으며, 이는 약 16,100줄의 코드 작업을 포함한다. 인프라 · 데브옵스 · Asahi Linux Progress Linux 7.3
Key Point M5 칩 지원, 게임 호환성 대폭 개선, 주요 드라이버 상류화 가속화 등 Asahi Linux가 애플 실리콘 상용 운영체제 수준의 기능 완성도에 접근하고 있음을 보여준다.
핵심 요약
애플 실리콘용 Asahi Linux 개발팀이 macaudio 및 AVD 등 주요 드라이버를 리눅스 커널 상류(upstream)로 제출 준비를 완료했으며, 이는 약 16,100줄의 코드 작업을 포함한다. M4/M5 칩을 포함한 초기 기기 트리(Devicetree)를 공개했고, M3 시리즈 지원이 EXPERT 플래그 제거로 정식 출시되었으며, M3의 DCP(Display Compression Port) 활성화로 절전 모드와 노치 영역 지원이 가능해졌다. M5에 도입된 Exclaves(격리 환경에서 실행되는 작은 애플리케이션)를 m1n1에서 가상화하기 위해 EL1 아래에서 3개의 가상 머신을 동시 실행하게 되었으며, M4와 M5 모두에서 macOS 역공학을 가능하게 했다. 전체 요약 11문장 읽기 → 024 12:54 ▲ 10 · 댓글 3 다국어 안전성 학습을 위한 템플릿 기반 대규모 데이터셋 MSafeTemp 공개 언어 모델의 안전성 정렬(safety alignment)이 영어 중심으로 편중되어 저자원 언어의 안전성 성능을 크게 떨어뜨리고 있다. AI · 머신러닝 · How I Aligned Your Model: Scaling Up Multilingual Safety Training with Templates
Key Point 저자원 언어 사용자들이 사용하는 AI 모델의 안전성 격차를 해결하는 구체적인 방법이 제시되었고, 영어 기준 테스트만으로는 실제 안전 위험을 놓칠 수 있다는 점이 실증되었다.
핵심 요약
언어 모델의 안전성 정렬(safety alignment)이 영어 중심으로 편중되어 저자원 언어의 안전성 성능을 크게 떨어뜨리고 있다. 연구팀은 템플릿 기반 증강 파이프라인을 통해 해로운 프롬프트에서 안전한 템플릿을 추출하고, 이를 60개 언어로 번역한 뒤 문화적으로 적절한 실체들로 채워 대규모 거부 및 양성 코퍼스를 생성했다. 이렇게 만든 MSafeTemp 데이터셋은 다국어 안전성 정렬과 평가에 활용할 수 있도록 검증되었다. 전체 요약 6문장 읽기 → 025 06:11 ▲ 23 · 댓글 3 정책 증류 학습, 분포 밖 일반화 능력 잃는다 여러 교사 모델에서 능력을 통합하는 다중 교사 정책 내 증류(MOPD)가 학습 데이터 분포 내에서는 완벽에 가까운 성능을 보이지만, 분포 밖 일반화 능력은 크게 떨어진다. AI · 머신러닝 · On the Generalization Limitation of On-Policy Distillation for Post-RL Consolidation
Key Point 대규모 언어모델을 다중 교사로부터 학습시킬 때 학습 데이터 분포 내에선 우수하지만 그 외의 상황에서 성능이 급격히 떨어지는 핵심 문제를 실증적으로 규명했고, 개선 방안까지 제시했기 때문입니다.
핵심 요약
여러 교사 모델에서 능력을 통합하는 다중 교사 정책 내 증류(MOPD)가 학습 데이터 분포 내에서는 완벽에 가까운 성능을 보이지만, 분포 밖 일반화 능력은 크게 떨어진다. Qwen3 모델을 이용해 수학 추론, 코딩, 에이전트, 장문맥 이해 등 4가지 과제에서 성능을 평가한 결과, 분포 외(OOD) 성능이 기본 모델보다 2.45~16.25% 낮았다. 합성 작업에서는 MOPD가 분포 내 성능을 개선했으나, 구성된 작업의 분포 외 성능은 최고 성능 교사 모델보다 18.19~24.34% 뒤떨어졌다. 전체 요약 7문장 읽기 → 026 15:11 ▲ 37 · 댓글 2 게임 영상 1분 이상 학습 데이터셋 'GameVerse' 공개 인터랙티브 월드 모델이 생성하는 게임 환경은 현재 약 1분 이상 일관성을 유지하지 못하는데, 이는 모델 성능이 아니라 장기간 학습 데이터 부족 때문이다. AI · 머신러닝 · GameVerse: A Minute-Scale Gameplay Dataset for Long-Horizon Interactive World Modeling
Key Point 장시간 게임 환경을 생성하는 AI 모델의 핵심 제약(짧은 학습 데이터)을 직접 해결하는 대규모 데이터셋이 나왔기 때문에, 이 분야 연구자와 개발자가 주목할 필요가 있다.
핵심 요약
인터랙티브 월드 모델이 생성하는 게임 환경은 현재 약 1분 이상 일관성을 유지하지 못하는데, 이는 모델 성능이 아니라 장기간 학습 데이터 부족 때문이다. 기존 게임 영상 데이터셋은 10초 이하 클립으로 이루어져 있고 캡션도 거칠어서 장시간 제어 생성에 부적합하다. 연구팀이 공개한 GameVerse는 1~2분 길이의 게임 플레이 영상으로 구성되며, 69.7K개 클립, 1,655시간, 3억 4,960만 프레임 규모이다. 전체 요약 8문장 읽기 → 027 15:11 ▲ 26 · 댓글 3 AI 에이전트가 로봇 조종사 대신, 저비용 데이터셋 자동 생성 로봇 학습에 필요한 시연 데이터를 수집하려면 보통 조종사가 일일이 조작했는데, 이 과정은 시간과 비용이 많이 들었다. AI · 머신러닝 · PyRUA-DataFarm: LLM Agent as a Cost-Efficient Teleoperator for Real-Ready Robot Data
Key Point 로봇 학습 데이터 수집 비용을 최소 60% 절감하면서도 성능과 환경 변화에 대한 강건성을 동시에 확보하는 방식을 제시해, 로봇 개발의 경제성 문제를 바꿀 가능성이 있다.
핵심 요약
로봇 학습에 필요한 시연 데이터를 수집하려면 보통 조종사가 일일이 조작했는데, 이 과정은 시간과 비용이 많이 들었다. 연구팀은 코딩 에이전트가 조종사의 역할을 대신하는 'DataFarm' 시스템을 개발했다. 에이전트는 한 번의 캘리브레이션 영상과 작업 설명을 받아 시뮬레이션 내에서 장면, 전문가 제어기, 성공 판별 함수를 자동으로 작성한다. 전체 요약 7문장 읽기 → 028 06:11 ▲ 11 · 댓글 2 학습 없이 사진 속 글을 번역하는 FlowTranslator 이미지 속 텍스트를 그 번역본으로 바꾸면서 주변 시각 정보는 그대로 유지하는 인-이미지 기계번역(IIMT) 문제를 다룬다. AI · 머신러닝 · FlowTranslator: Training-Free In-Image Machine Translation with Flow-Based Editing
Key Point 학습 데이터 없이도 다국어 T2I 모델의 능력을 활용해 이미지 속 텍스트 번역이 가능함을 보여주는 실용적 접근법이다.
핵심 요약
이미지 속 텍스트를 그 번역본으로 바꾸면서 주변 시각 정보는 그대로 유지하는 인-이미지 기계번역(IIMT) 문제를 다룬다. 기존 작업 특화 모델들은 번역 전후의 대량 쌍 이미지로 학습해야 하지만, FlowTranslator는 학습 없이 동작한다. OCR 모델과 LLM으로 번역 프롬프트를 생성한 뒤 T2I(텍스트-투-이미지) 기반 디퓨전 모델에 주입하는 방식을 사용한다. 전체 요약 6문장 읽기 → 029 03:11 ▲ 101 · 댓글 30 AI가 운영하는 오픈소스 사기탐지 플랫폼 카이로스 공개 Kairos는 실시간 사기 및 위험 판단을 자동화하는 오픈소스 플랫폼으로, 모든 가입·로그인·주문·결제·출금 요청에 대해 승인·재확인·검토·차단 중 하나로 의사결정하고 이유를 기록한다. 오픈소스 · 도구 · Show HN: Kairos – Open-source risk and fraud decisioning platform
Key Point AI 에이전트가 직접 사기탐지 모델을 설계·실험·배포하도록 자동화한 오픈소스 플랫폼으로, 기존 상용 솔루션과 달리 학습 데이터 없이도 초기부터 작동한다.
핵심 요약
Kairos는 실시간 사기 및 위험 판단을 자동화하는 오픈소스 플랫폼으로, 모든 가입·로그인·주문·결제·출금 요청에 대해 승인·재확인·검토·차단 중 하나로 의사결정하고 이유를 기록한다. Sardine, Sift, Riskified, SEON 같은 상용 서비스의 대안이며, 독립적인 AI 에이전트가 직접 튜닝할 수 있고 학습 데이터가 적은 초기 단계에서도 사기를 탐지할 수 있다는 점이 차별점이다. Claude Code, Cursor, Codex 같은 AI 에이전트를 MCP 서버로 연결하면, 에이전트가 워크플로우 설계·실험 제안·모델 학습·배포를 자동으로 수행할 수 있다. 전체 요약 12문장 읽기 → 030 21:11 ▲ 59 · 댓글 7 추론 단계 줄이되 정확도 유지, LoCo 방법론 공개 대규모 추론 모델은 충분한 정보를 얻은 후에도 계속 '생각하기'로 추론 비용이 많이 든다는 문제가 있다. AI · 머신러닝 · Think Less, Locally: Local Preference Learning for Reasoning Compression
Key Point 추론 단계를 획기적으로 줄이면서도 정확도를 유지하는 방법이 나왔으므로, LLM 운영 비용 절감과 추론 최적화에 실제로 적용할 수 있는 기술이다.
핵심 요약
대규모 추론 모델은 충분한 정보를 얻은 후에도 계속 '생각하기'로 추론 비용이 많이 든다는 문제가 있다. 기존 압축 방법은 전체 추론 궤적에만 초점을 맞췄고, 현재 상태에서 계속 추론할지 멈출지 판단하는 지역적 의사결정을 간과했다. LoCo는 모델이 과도하게 생각하는 상태를 자신의 추론 흔적에서 감지하고, 그 지점부터 짧은 검증된 대안을 생성한 후 DPO로 학습하는 지역적 선호 학습 방법이다. 전체 요약 7문장 읽기 → 031 18:11 ▲ 27 · 댓글 2 동영상에서 학습 데이터를 자동 생성하는 AI 에이전트 멀티모달 학습 발전이 고품질 학습 데이터 부족과 높은 레이블링 비용으로 제한되고 있는 상황에서, VidUEU-Agent는 원본 동영상에서 자동으로 학습 데이터를 생성하는 파이프라인을 제시한다. AI · 머신러닝 · VidUEU-Agent: A Data-Curation Agent for Multimodal Understanding, Editing, and Unified Tasks
Key Point 동영상에서 자동으로 멀티모달 학습 데이터를 생성하고 최적화하는 방식이 멀티모달 AI 모델 개발의 데이터 부족 문제를 어떻게 풀 수 있는지 보여주는 실질적인 접근법이다.
핵심 요약
멀티모달 학습 발전이 고품질 학습 데이터 부족과 높은 레이블링 비용으로 제한되고 있는 상황에서, VidUEU-Agent는 원본 동영상에서 자동으로 학습 데이터를 생성하는 파이프라인을 제시한다. 4단계 파이프라인으로 구성되며, 저품질 장면을 필터링하고, 핵심 프레임과 멀티모달 신호를 추출한 뒤, 메타데이터를 구성하고 라우팅하여 학습 샘플을 합성한다. 에이전트 프레임워크는 다운스트림 학습 결과를 기반으로 자동으로 데이터 분포를 반복 최적화하여 데이터 품질, 균형, 학습 효율성을 개선한다. 전체 요약 5문장 읽기 → 032 06:11 ▲ 166 · 댓글 82 천장에 매달린 4개 모터 로봇팔, 800달러 오픈소스로 케이블 구동 방식의 룸스케일 그리퍼 로봇 Stringman이 공개됐다. 4개의 DM-H6215 모터로 천장 모서리에서 케이블을 이용해 실내 전체 영역에 접근할 수 있다. 하드웨어 · 시스템 · Stringman, an $800 open-source room scale gripper robot
Key Point 케이블 드라이브 방식으로 실내 전체를 탐색할 수 있으면서도 800달러라는 저가 오픈소스 로봇이 나왔고, 에이전트 기반 자동화와 교육용으로도 활용 가능한 새로운 로봇 아키텍처를 제시한다.
핵심 요약
케이블 구동 방식의 룸스케일 그리퍼 로봇 Stringman이 공개됐다. 4개의 DM-H6215 모터로 천장 모서리에서 케이블을 이용해 실내 전체 영역에 접근할 수 있다. 7×7×3m 규모의 실내에서 28N의 선 장력 한계 내에 약 2kg의 탑재량을 제공하며, 데스크톱 암 대비 달러당 작업 영역이 약 500배 넓다. 기계 CAD, PCB, 제어 소프트웨어가 모두 오픈소스로 공개되었으며 OSHWA 인증을 받았다. 전체 요약 11문장 읽기 → 033 03:11 ▲ 176 · 댓글 57 OpenAI, Codex 학습 데이터 공유 설정 몰래 재활성화 사용자가 의도적으로 비활성화한 Codex의 모델 학습용 데이터 공유 설정이 명시적인 동의 없이 다시 활성화되었다. AI · 머신러닝 · OpenAI seems to be silently re-enabling model training on Codex chats
Key Point 기업에서 IP 보호를 위해 명시적으로 비활성화한 데이터 공유 설정이 사용자 동의 없이 자동으로 복구되는 것은 개인정보 제어권과 기업 기밀 관리에 직결되는 문제이다.
핵심 요약
사용자가 의도적으로 비활성화한 Codex의 모델 학습용 데이터 공유 설정이 명시적인 동의 없이 다시 활성화되었다. 작성자의 회사는 프롬프트를 통한 IP 유출을 우려해 Codex, Claude Code 등의 데이터 공유를 꺼두었으나, 어제 동료들과 함께 설정이 자동으로 복구된 사실을 발견했다. 이 설정은 ChatGPT 설정 페이지의 데이터 제어 섹션에서 '모두를 위해 모델 개선(Improve the model for everyone)'이라는 항목으로 확인할 수 있다. 전체 요약 5문장 읽기 → 034 00:11 ▲ 40 · 댓글 1 코딩 AI 학습 데이터 수집을 위한 이력 기반 궤적 수집 방법 제시 코딩 에이전트가 저장소 이슈를 해결하는 과정에서 생기는 긴 탐색·편집·검증 수열들이 학습 데이터로 활용되고 있다. AI · 머신러닝 · SWE-Trail: History-Guided Trajectory Collection for Coding Agent Training
Key Point 코딩 AI 학습에 쓰이는 데이터 수집 방식이 최종 모델 성능을 크게 좌우하는데, 이력 정보를 효과적으로 활용하면서도 학습-테스트 간 불일치를 피하는 구체적 방법을 제시한다.
핵심 요약
코딩 에이전트가 저장소 이슈를 해결하는 과정에서 생기는 긴 탐색·편집·검증 수열들이 학습 데이터로 활용되고 있다. 기존 방식은 각 이슈마다 여러 궤적을 독립적으로 샘플링한 뒤 선별하지만, 샘플이 많아질수록 중복이 증가하고 이전 데이터가 향후 수집 방향을 안내할 수 있다는 점을 무시한다. 이력을 코딩 에이전트의 컨텍스트로 직접 제공하면 학습 시 그 조언에 의존하게 되어 테스트 시 사용할 수 없는 정보에 모델이 편향되는 문제가 생긴다. 전체 요약 7문장 읽기 → 035 21:11 ▲ 102 · 댓글 30 LLM 학습 데이터 독(毒)으로 AI 에이전트에 백도어 심기 대규모 언어모델은 웹에서 수집한 검증 없는 대량의 데이터로 학습하는데, 여기서 의도적인 악의적 콘텐츠 주입이 보안 위험이 된다. AI · 머신러닝 · Agentic backdoors via pretraining poisoning
Key Point 학습 데이터 독으로 설치된 백도어가 배포 후 원격 코드 실행을 일으킬 수 있으며, 극소량의 독도 높은 성공률을 보여 실제 모델 공급망 보안 위협이 현실화했기 때문입니다.
핵심 요약
대규모 언어모델은 웹에서 수집한 검증 없는 대량의 데이터로 학습하는데, 여기서 의도적인 악의적 콘텐츠 주입이 보안 위험이 된다. 연구팀이 처음으로 학습 데이터 독으로 에이전트에 원격 코드 실행 백도어를 심을 수 있음을 입증했다. Qwen3 모델을 0.6B, 1.7B, 4B 크기로 처음부터 학습한 뒤 각각을 CLI 에이전트로 변환해 실험했다. 전체 요약 7문장 읽기 → 036 18:11 ▲ 78 · 댓글 2 컴퓨터 제어 AI, 쌍중 개선 루프로 성능 대폭 향상 컴퓨터 사용 에이전트(CUA) 개발의 병목은 학습 데이터의 다양성·제어성·신뢰성 부족과 자체 경험에만 의존한 개선 방식의 한계였다. AI · 머신러닝 · CUA-Master: Scaling Computer-use Agents through Open-World Recursive Improvements
Key Point 컴퓨터 조작 AI가 현실 데이터의 다양성 부족을 극복하고 여러 벤치에서 경쟁력 있는 성능을 달성한 방법론이 공개됐다.
핵심 요약
컴퓨터 사용 에이전트(CUA) 개발의 병목은 학습 데이터의 다양성·제어성·신뢰성 부족과 자체 경험에만 의존한 개선 방식의 한계였다. CUA-Master는 두 겹의 재귀 개선 루프로 문제를 해결한다: 바깥쪽은 개방형 데이터와 모델의 약점을 피드백하는 '세계-데이터-모델' 사이클, 안쪽은 시드 작업 채굴과 자가촉매 전파로 다양한 학습 데이터를 생성한다. 시스템은 교육 영상에서 실제 작업 흐름을 추출한 뒤, 시각-의미론 이중경로 궤적 재구성으로 변환하고, 이를 재사용 가능한 기본 단위로 만들어 제어 가능한 합성 작업을 생성한다. 전체 요약 6문장 읽기 → 037 06:11 ▲ 29 · 댓글 3 학습 데이터 기울기로 추적한 LLM 안전성 붕괴 미세조정 중 무해해 보이는 학습 데이터도 LLM의 안전성을 조용히 침식할 수 있지만, 표준 필터로는 이를 감지하기 어렵다. AI · 머신러닝 · Follow the Gradient: Tracing Safety Degradation Back to Training Data
Key Point 기울기 기반 필터링으로 미세조정 과정의 숨겨진 안전 위협을 실제 규모에서 감지·제거할 수 있음을 처음 입증했으며, 이는 LLM 구축 중 안전 검증 방식의 전환을 의미한다.
핵심 요약
미세조정 중 무해해 보이는 학습 데이터도 LLM의 안전성을 조용히 침식할 수 있지만, 표준 필터로는 이를 감지하기 어렵다. SimpleLoRIF는 기울기 임베딩 방식으로 안전하지 않은 행동과 일치하는 미세조정 예제를 식별하며, 최종 4개 트랜스포머 블록만 역전파하여 백만 개 규모 데이터셋을 처리 가능하게 개선했다. 긴급 오정렬 사례에서 기울기가 보안 취약한 코드 학습 데이터와 미세조정 후 나타나는 광범위한 해로운 행동을 연결하며, 오정렬 모델의 기울기 공간에서 AUC 0.865를 달성했다. 전체 요약 6문장 읽기 → 038 09:11 ▲ 103 · 댓글 56 다양한 감각의 AI가 같은 세계를 본다는 증명 Yann LeCun과 Randall Balestriero는 '플라톤적 표현 가설(PRH)'을 증명하는 논문을 발표했다. 가설은 여러 모달리티(영상, 텍스트 등)로 학습한 AI 모델들이 스케일을 늘리면 같은 세계 표현에 수렴한다는 것이다. AI · 머신러닝 · Proving and improving the Platonic Representation Hypothesis with JEPAs
Key Point 서로 다른 모달리티 모델들이 같은 표현에 수렴한다는 오랜 추측을 수학적으로 증명하면서, 언어 모델이 비전과 정렬되는 방식의 근본적 차이를 밝혔고, 스케일보다 학습 데이터 품질이 중요함을 입증했다.
핵심 요약
Yann LeCun과 Randall Balestriero는 '플라톤적 표현 가설(PRH)'을 증명하는 논문을 발표했다. 가설은 여러 모달리티(영상, 텍스트 등)로 학습한 AI 모델들이 스케일을 늘리면 같은 세계 표현에 수렴한다는 것이다. 저자들은 '플라톤적 표현 정리(Platonic Representation Theorem)'를 증명했다. 결합 임베딩 예측 아키텍처(JEPA)가 서로 다른 모달리티로 학습될 때, 긍정 쌍이 같은 장면의 두 관찰('좋은 뷰')이고 오정렬이 제한되면 회전을 제외하고 동일한 표현을 학습한다는 뜻이다. 다음 토큰 예측(언어 모델의 기본 방식)은 나쁜 뷰(한 문서의 일부)를 사용하는 JEPA로, 이는 언어 모델이 스케일을 통해서만 비전과 정렬되는 이유를 설명한다. 전체 요약 8문장 읽기 → 039 21:11 ▲ 16 · 댓글 2 휴머노이드 로봇을 위한 멀티모달 기초 모델 HuGe 공개 VLA(Vision-Language-Action) 모델을 휴머노이드 로봇에 적용할 때 전신 제어와 다양한 시연 데이터가 필요하지만, 현실에서 수집하기 어렵다는 문제가 있다. AI · 머신러닝 · HuGe: Scaling Humanoid Generalist Vision-Language-Action Models with Egocentric Experience
Key Point 휴머노이드 로봇 제어에 인간 동작 데이터를 효과적으로 활용할 수 있는 방법론이 제시되면서, 로봇 학습 데이터 수집 비용을 크게 줄일 수 있는 길이 열렸기 때문이다.
핵심 요약
VLA(Vision-Language-Action) 모델을 휴머노이드 로봇에 적용할 때 전신 제어와 다양한 시연 데이터가 필요하지만, 현실에서 수집하기 어렵다는 문제가 있다. HuGe는 2,000시간 이상의 1인칭 관점 인간 및 로봇 데이터로 사전학습한 휴머노이드 VLA 모델이다. 세 가지 기존 VLA 아키텍처를 사용해 사전학습된 전신 제어기를 위한 잠재 동작 토큰과 손 제어 신호를 예측한다. 전체 요약 6문장 읽기 → 040 18:11 ▲ 13 · 댓글 2 웹 에이전트 학습용 자동 환경 생성 프레임워크 'WebAnything' 공개 웹 에이전트 학습·평가에 필요한 다양하고 재현 가능한 웹 환경 구성이 어려운 문제를 다룬다. AI · 머신러닝 · WebAnything: From the Wild Web to Scalable Agent Environments
Key Point 웹 기반 AI 에이전트의 재현 가능한 학습 환경을 자동으로 구성하는 방법이 나왔으며, 기존 수동 방식보다 우수한 성능을 보여준다.
핵심 요약
웹 에이전트 학습·평가에 필요한 다양하고 재현 가능한 웹 환경 구성이 어려운 문제를 다룬다. 기존 방식들은 수동 구현(사이트별 엔지니어링 필요), 생성형 구축(실제 웹과 괴리), 캡처 재생(상호작용 범위 제한) 등의 한계가 있다. WebAnything은 실제 URL에서 자동으로 웹 환경을 재구성하며, 사이트별 수동 작업이나 초기 설정 후 수리 불필요하다. 전체 요약 8문장 읽기 → 041 15:11 ▲ 37 · 댓글 6 에이전트 학습용 대규모 전문직 작업 데이터셋 자동 생성 전문가 에이전트를 지도학습으로 훈련하려면 신뢰할 수 있는 전문직 작업의 시연 데이터가 필요하지만, 작업 정보의 불완전성이 학습을 방해한다. AI · 머신러닝 · WorkFactory: Turning Professional Intents into Executable Work for Scalable Agent Training
Key Point 대규모 전문직 에이전트 학습 데이터를 자동으로 생성하는 새로운 방법론과 112K+ 규모의 실제 데이터셋, 그리고 검증된 모델을 제시하므로 에이전트 기반 자동화 시스템 개발자들이 참고할 실질적 자산이다.
핵심 요약
전문가 에이전트를 지도학습으로 훈련하려면 신뢰할 수 있는 전문직 작업의 시연 데이터가 필요하지만, 작업 정보의 불완전성이 학습을 방해한다. WorkFactory는 전문직 의도(intent)로부터 실행 가능한 작업을 자동으로 구성하는 프레임워크로, 정보 수준의 계획 단계에서 의존성과 정보 위치를 명시적으로 그래프화한다. 프로브 실행(probe execution) 단계에서 정보 지원의 실패를 감지하고 원래 의도는 유지하면서 작업을 수리한다. 전체 요약 8문장 읽기 → 042 15:11 ▲ 14 · 댓글 4 텍스트·이미지 섞인 생성 평가하는 IntReal 데이터셋 공개 인간이 자연스럽게 텍스트와 이미지를 섞어가며 콘텐츠를 소비하지만, 통합 멀티모달 모델(UMM)의 인터리브된 생성은 제대로 연구되지 않았다. AI · 머신러닝 · IntReal: A Real-World Dataset and Benchmark for Multimodal Interleaved Generation
Key Point 텍스트와 이미지를 섞어 생성하는 멀티모달 AI의 성능을 처음으로 체계적으로 평가할 벤치마크가 등장해, 이 분야 연구와 모델 개선의 기초가 될 것으로 예상된다.
핵심 요약
인간이 자연스럽게 텍스트와 이미지를 섞어가며 콘텐츠를 소비하지만, 통합 멀티모달 모델(UMM)의 인터리브된 생성은 제대로 연구되지 않았다. 현 상황의 근본 문제는 명확한 인터리브 생성 작업과 학습 데이터 부재, 그리고 모델 성능을 세밀하게 진단할 평가 프로토콜 부족이다. IntReal은 100K 샘플의 실제 멀티모달 데이터셋과 전문 모델 7개 차원으로 모델을 평가하는 IntReal Evaluation Suite로 구성된다. 전체 요약 6문장 읽기 → 043 03:11 ▲ 11 · 댓글 2 사전학습 데이터의 어휘 흔적이 모델 성능에 미치는 영향 제로샷 벤치마크 성능이 사전학습 말뭉치와 벤치마크 목표 간의 단어 수준 정렬에 얼마나 의존하는지 연구한 논문이다. AI · 머신러닝 · The Lexical Imprint of Pre-training Data
Key Point 사전학습 말뭉치의 어휘 특성이 모델의 제로샷 성능에 직접적인 영향을 미친다는 인과관계를 실증적으로 입증하며, 데이터 선택과 라우팅을 통한 성능 최적화의 가능성을 제시한다.
핵심 요약
제로샷 벤치마크 성능이 사전학습 말뭉치와 벤치마크 목표 간의 단어 수준 정렬에 얼마나 의존하는지 연구한 논문이다. 단어 단위 유니그램 교차 엔트로피(UCE)라는 토크나이저 무관의 모델 자유 지표를 제안해 참조 말뭉치와 목표 벤치마크 간 어휘 정렬을 측정한다. 우도 학습은 사전학습 말뭉치로부터 모델의 예측 분포를 형성하며, 우도 기반 평가의 제로샷 점수는 그 말뭉치와 벤치마크 사이의 어휘 정렬에 부분적으로 의존한다. 전체 요약 8문장 읽기 → 044 15:11 ▲ 103 · 댓글 2 3D 기하정보로 다각도 영상 생성, OmniShowcase 공개 참조 이미지 몇 장에서 특정 피사체의 영상을 생성할 때, 카메라가 입력 이미지에 없는 각도로 이동하면 보이지 않는 표면을 추론해야 하는 문제를 다룬다. AI · 머신러닝 · OmniShowcase: Omnidirectional Subject-Consistent Video Generation from Multi-View Images
Key Point 참조 이미지에서 3D 기하정보를 명시적으로 활용해 다각도 영상 생성 시 피사체 일관성을 크게 개선하는 방식으로, 멀티뷰 조건부 영상 생성의 핵심 과제를 해결한다.
핵심 요약
참조 이미지 몇 장에서 특정 피사체의 영상을 생성할 때, 카메라가 입력 이미지에 없는 각도로 이동하면 보이지 않는 표면을 추론해야 하는 문제를 다룬다. 기존 단일 이미지 기반 방식을 개선하기 위해 최근 방법들은 다중 시점 참조 이미지를 사용하지만, 이들을 연결하는 3D 구조를 명시적으로 정의하지 않으며 학습 데이터가 시점 변화에서 동일한 3D 피사체를 보장하지 못한다. OmniShowcase는 자동화된 데이터 합성 파이프라인과 기하 조건화 방식 두 가지로 구성된다. 전체 요약 8문장 읽기 → 045 21:11 ▲ 28 · 댓글 3 증거 연결로 멀티모달 인식 일반화시키는 EvidenceConnect 멀티모달 인식의 핵심은 관련 시각 정보를 식별하고, 엔티티와 바인딩하고, 관계를 회복해 답을 구성하는 '증거 연결' 능력이다. AI · 머신러닝 · Zooming without Zooming v2: From Seeing Details to Connecting Evidence for Generalizable Multimodal Perception
Key Point 멀티모달 모델의 세부 인식과 공간 이해를 동시에 개선하는 데이터 합성 기법이 소개되면서, VLM 학습의 효율성과 일반화 성능을 어떻게 높일 수 있는지 보여준다.
핵심 요약
멀티모달 인식의 핵심은 관련 시각 정보를 식별하고, 엔티티와 바인딩하고, 관계를 회복해 답을 구성하는 '증거 연결' 능력이다. EvidenceConnect는 한 이미지 내 관련 영역의 줌 뷰를 활용해 시각 증거의 비교·집계·체이닝을 요구하는 학습 데이터를 자동 생성한다. 데이터 품질 보증을 위해 독립적인 VLM들이 합의한 정답만 유지하고, 영역 제거 테스트로 특정 영역 제거해도 답변이 유지되는 문제를 걸러낸다. 전체 요약 6문장 읽기 → 046 18:11 ▲ 22 · 댓글 2 LLM에 로봇 제어 패널만 달면 VLA 모델을 이긴다 로봇이 LLM 기반 에이전트로 움직이게 하려면 비전-언어-액션(VLA) 모델을 따로 학습시키는 것이 주류였다. AI · 머신러닝 · RoboHarness: A Simple Harness Outperforms VLA and World Action Models
Key Point 대규모 로봇 학습 데이터 없이도 기존 LLM으로 로봇 제어가 가능하다는 것을 보였기에, 구체화된 AI 개발의 패러다임 전환 가능성을 시사한다.
핵심 요약
로봇이 LLM 기반 에이전트로 움직이게 하려면 비전-언어-액션(VLA) 모델을 따로 학습시키는 것이 주류였다. 연구팀은 RoboHarness라는 로봇 제어 인터페이스를 제시해, LLM이 시각-기하학적 제어판을 통해 직접 로봇 동작을 이해하고 호출할 수 있게 했다. VLA 모델 대신 코딩 능력이 있는 LLM 에이전트에 간단한 로봇 장치만 제공하면, 로봇 조작 작업을 수행할 수 있다는 가정에 기반한다. 전체 요약 5문장 읽기 → 047 15:11 ▲ 160 · 댓글 77 미국 법전에 깃처럼 변경 이력 추적 시스템 적용하다 프로그래머가 코드의 어느 줄이든 작성자, 시점, 과거 모습을 확인할 수 있듯이, 법률가도 연방법의 특정 문장이 언제 누가 어떻게 바꿨는지 추적할 수 있어야 한다는 제안이다. 웹 · 프론트엔드 · Git for the US Code
Key Point AI 모델의 법률 해석이 시간의 흐름과 변경 이력을 제대로 추적하지 못하는 문제를 소프트웨어 관례로 해결하는 구체적 방법론을 제시한다.
핵심 요약
프로그래머가 코드의 어느 줄이든 작성자, 시점, 과거 모습을 확인할 수 있듯이, 법률가도 연방법의 특정 문장이 언제 누가 어떻게 바꿨는지 추적할 수 있어야 한다는 제안이다. 미국 법전은 의회 공식 입법 외에는 1차 증거일 뿐이고, 수정 사항이 산문 형태의 주석과 별도의 발효일 노트에 분산되어 있어서 정확한 이력 추적이 어렵다. 11 USC § 1182(1)의 소규모 사업 채무자 정의 사례에서 보듯, 같은 법 조항도 연도와 케이스 성격에 따라 다른 조건이 적용되는데, 현재 체계로는 이를 파악하기 어렵다. 전체 요약 11문장 읽기 → 048 12:11 ▲ 30 · 댓글 3 로봇 조작 모델을 키우다, 영상에서 추출한 3D 행동으로 로봇 비전-언어-행동(VLA) 모델을 확장하려면 행동 레이블이 붙은 학습 데이터가 부족하고, 로봇마다 제어 방식이 다르다는 제약이 있다. AI · 머신러닝 · RynnVLA-Latent: Scaling Robotic Manipulation Foundation Models with 3D-Grounded Latent Actions
Key Point 로봇 학습 데이터의 부족 문제를 해결하는 새로운 방법론으로, 일반 영상에서 로봇이 학습할 수 있는 신호를 뽑아낼 수 있음을 시사한다.
핵심 요약
로봇 비전-언어-행동(VLA) 모델을 확장하려면 행동 레이블이 붙은 학습 데이터가 부족하고, 로봇마다 제어 방식이 다르다는 제약이 있다. RynnVLA-Latent는 이를 해결하기 위해 사람, 로봇, 시뮬레이션 영상을 로봇 정책 사전학습용 감독 신호로 바꾼다. 핵심은 RynnLAM으로, 시각 전환(visual transition)에서 실제 로봇 제어 없이 3D 기반 잠재 행동을 학습한다. 전체 요약 10문장 읽기 → 049 09:11 ▲ 10 · 댓글 2 멀티모달 AI, 이미지·영상에서 위치 지정과 설명을 동시에 학습하다 이미지와 영상의 특정 영역을 이해하고 언어로 정확히 찾아내는 미세한 멀티모달 이해 능력이 필요하며, 기존 방식은 두 작업을 따로 학습했다. AI · 머신러닝 · Generalized CycleGRPO for Fine-Grained Multimodal Understanding and Grounding
Key Point 기존의 분리된 학습 방식에서 벗어나 이미지와 영상의 위치 정렬과 설명을 통합으로 개선하는 새로운 강화학습 접근법이 제시되었으며, 실제 성능 향상으로 검증되었다.
핵심 요약
이미지와 영상의 특정 영역을 이해하고 언어로 정확히 찾아내는 미세한 멀티모달 이해 능력이 필요하며, 기존 방식은 두 작업을 따로 학습했다. CycleGRPO라는 강화학습 프레임워크를 제시하는데, 한 번에 두 방향(영역→설명, 설명→영역)을 배우는 순환 구조로 작동한다. 모델이 영역에 대한 후보 설명을 생성하고, 각 설명을 역으로 정렬해 원래 영역을 재구성한 뒤, 재구성 겹침을 보상으로 사용한다. 전체 요약 9문장 읽기 → 050 21:11 ▲ 16 · 댓글 2 다중모달 추론 모델, 공개 데이터로 효율적 학습 방법 제시 멀티모달 추론 모델 학습의 병목인 데이터 품질 저하, 비효율적 감독 구성, 난이도 불균형, 도메인 간 간섭을 해결하기 위해 MMVistaReason(MVR)을 제안했다. AI · 머신러닝 · MMVistaReason: Toward Open-Data and Post-Training Recipes for Multimodal Reasoning
Key Point 멀티모달 추론 모델의 공개 학습 레시피가 상용 대규모 모델 대비 효율성과 성능을 동시에 달성하는 구체적 방법을 보여주므로, 오픈소스 멀티모달 AI 개발에 실질적 기준을 제시한다.
핵심 요약
멀티모달 추론 모델 학습의 병목인 데이터 품질 저하, 비효율적 감독 구성, 난이도 불균형, 도메인 간 간섭을 해결하기 위해 MMVistaReason(MVR)을 제안했다. 분석적 추론과 실제 추론으로 나눈 광범위한 학습 데이터로 구조적 추론과 시각 지각·공간 이해를 모두 커버한다. 구조화된 정제와 주석, 난이도 인식 증류, 답변 확률 기반 궤적 선택으로 SFT용 52.8만 개 샘플(MVR-SFT-528K)과 RL용 6.3만 개 샘플(MVR-RL-63K)을 효율적으로 구성했다. 전체 요약 9문장 읽기 → 051 21:11 ▲ 48 · 댓글 2 긴 영상의 짜깁기 조작 찾기, 음성과 영상 동시 분석 장시간 영상에서 일부 구간만 조작된 AI 딥페이크를 탐지하는 기존 벤치마크가 부족해, 연구팀이 AV-FABLE 데이터셋을 공개했다. AI · 머신러닝 · AV-FABLE: Audio-Visual Manipulation Forensics in Long-Form Videos
Key Point 장시간 영상에서 일부만 조작된 디프페이크를 정확히 찾아내야 하는 콘텐츠 검증, 미디어 포렌식 분야에서 음성-영상 동시 분석이 필수적이 되고 있기 때문이다.
핵심 요약
장시간 영상에서 일부 구간만 조작된 AI 딥페이크를 탐지하는 기존 벤치마크가 부족해, 연구팀이 AV-FABLE 데이터셋을 공개했다. AV-FABLE은 16,650개의 원본-조작 쌍(총 998시간)으로 이루어지며, 27가지 편집 설정으로 제작되고 음성과 영상 타임라인을 분리해 제공한다. 기존 음성-영상 대형언어모델(AV-LLM)을 제로샷 프롬프팅으로 테스트하면 조작 탐지 성능이 거의 무작위 수준이고 시간 위치 파악도 부정확하다. 전체 요약 7문장 읽기 → 052 21:11 ▲ 139 · 댓글 102 로블록스가 145GB 모델 무단 다운로드, 성인 콘텐츠 포함 로블록스 소속으로 보이는 크롤러가 10월 15~16일 Open3DLab, SFMLab, SmutBase 세 사이트에서 712개 프로젝트의 1,027개 파일 145.5GB를 동의 없이 다운로드했다. AI · 머신러닝 · Roblox downloaded 145GB models from us (including adult content) without asking
Key Point 대형 AI 기업이 무단으로 수집한 데이터가 AI 학습에 어떻게 악용되는지, 그리고 개인과 대기업을 차별하는 저작권 집행의 불평등 문제를 구체적 사례로 보여주기 때문입니다.
핵심 요약
로블록스 소속으로 보이는 크롤러가 10월 15~16일 Open3DLab, SFMLab, SmutBase 세 사이트에서 712개 프로젝트의 1,027개 파일 145.5GB를 동의 없이 다운로드했다. 크롤러는 'trellis2-data-sourcing/1.0'이라는 사용자 에이전트를 사용해 34시간에 걸쳐 18,926개 프로젝트의 메인 페이지를 읽었고, robots.txt를 무시하고 약관 위반 및 저작권 침해를 범했다. 다운로드 대상의 62.6%인 345개 프로젝트가 성인 콘텐츠였으며, 이 중 423개는 비상업적 이용만 가능한 라이선스였다. 전체 요약 13문장 읽기 → 053 12:11 ▲ 28 · 댓글 2 로봇 모방학습을 위한 다양한 시연 자동 발굴 기법 로봇 조작 작업의 행동 복제(Behavior Cloning)는 학습 데이터 커버리지에 민감하지만, 다양한 성공 시연 수집은 비용이 높다. AI · 머신러닝 · DiscoDemo: Discovering Efficient and Diverse Robot Demonstrations for Imitation Learning
Key Point 로봇 모방학습의 데이터 커버리지 문제를 해결하는 실용적 방법론으로, 시뮬레이션과 실제 로봇 모두에서 성공률을 크게 향상시키는 구체적 성과를 보여준다.
핵심 요약
로봇 조작 작업의 행동 복제(Behavior Cloning)는 학습 데이터 커버리지에 민감하지만, 다양한 성공 시연 수집은 비용이 높다. 연구팀이 강화학습(RL)을 배포 가능한 제어기가 아닌 하위 시각-운동 모방학습용 데이터 생성기로 활용하는 접근법을 제시했다. 여러 성공 해결책이 단일 방식을 반복 수집할 때보다 더 넓은 범위의 성공적 궤적을 포괄한다는 게 핵심 가정이다. 전체 요약 8문장 읽기 → 054 12:11 ▲ 359 · 댓글 3 성공한 궤적도 학습 데이터로 부족한 이유 도구 사용 에이전트 학습에서 성공한 상호작용 궤적도 여러 단계의 의존성을 놓치거나 에이전트가 실제로 볼 수 없는 정보를 바탕으로 한 행동을 포함할 수 있다. AI · 머신러닝 · Trajectory2Gym: Decision-Grounded Compositional Interaction Synthesis for Tool-Use Agents
Key Point 기존에 성공한 상호작용만 학습 데이터로 사용하는 방식의 근본적 문제를 제시하고, 다단계 의존성과 결정 근거를 모두 만족하는 상호작용을 설계하는 방법을 제안하여 에이전트의 학습 효율을 크게 개선한다.
핵심 요약
도구 사용 에이전트 학습에서 성공한 상호작용 궤적도 여러 단계의 의존성을 놓치거나 에이전트가 실제로 볼 수 없는 정보를 바탕으로 한 행동을 포함할 수 있다. 효과적인 궤적 감독을 위해서는 중요한 관찰-행동 의존성이 모두 표현되는 구성 커버리지와 각 행동이 에이전트의 학습 가능한 상호작용 이력으로 정당화되는 결정 기반이라는 두 가지 조건이 필요하다. Trajectory2Gym은 지원이 부족한 구성 구조 주변에 실행 가능한 상호작용을 구성하고, 실제 실행에서 정당화된 결정들만을 감독 신호로 사용한다. 전체 요약 8문장 읽기 → 055 15:11 ▲ 139 · 댓글 38 AI 모델 제어의 새로운 도전: 컨텍스트 엔지니어링의 현재 컨텍스트 엔지니어링은 AI에 올바른 정보를 제시하고 명확한 지시를 전달하는 기술로, 모델의 성능 향상과 무관하게 항상 어려울 것이다. AI · 머신러닝 · The State of Context Engineering
Key Point 에이전트 모델의 장시간 자동 실행이 일반화되면서 컨텍스트 관리 기법 자체가 새로운 버그를 만드는 악순환이 반복되고 있으며, 개발자는 더 이상 프롬프트만 개선해서는 문제를 해결할 수 없게 되었다.
핵심 요약
컨텍스트 엔지니어링은 AI에 올바른 정보를 제시하고 명확한 지시를 전달하는 기술로, 모델의 성능 향상과 무관하게 항상 어려울 것이다. 2024년 말 RAG 폐기 논쟁 당시 모델 제조사들은 컨텍스트 윈도우를 128,000 토큰에서 100만 토큰으로 확대했으나, 더 많은 정보를 담을 수 있게 되면서 더 많은 오류도 함께 들어왔다. 컨텍스트 중독(잘못된 정보 고착), 컨텍스트 분산(장문 컨텍스트에서 모델이 기본 지식 무시), 컨텍스트 혼동(무관한 정보가 모델 판단에 영향), 컨텍스트 충돌(도구 간 갈등) 등 4가지 주요 오류 모드가 발생한다. 전체 요약 11문장 읽기 → 056 06:11 ▲ 295 · 댓글 147 10년 된 CNN이 최신 LLM을 이기다, 피부암 진단 2015년 구글이 발표한 Inception v3 CNN을 피부과 이미지로 20분 정도 미세조정한 모델이 GPT-6 Astra와 Claude Fable 5.1 두 최신 LLM을 피부암 진단에서 압도했다. AI · 머신러닝 · A 10-year-old CNN outperforms frontier LLMs for skin cancer diagnosis
Key Point 이 글은 대규모 언어모델의 의료 진단 능력이 특화된 구형 모델에 미치지 못한다는 구체적인 임상 증거를 보여주며, LLM이 모든 분야에서 기존 방식을 대체할 수 없음을 시사한다.
핵심 요약
2015년 구글이 발표한 Inception v3 CNN을 피부과 이미지로 20분 정도 미세조정한 모델이 GPT-6 Astra와 Claude Fable 5.1 두 최신 LLM을 피부암 진단에서 압도했다. 임상 사진과 피부경 이미지를 포함한 조직검사로 확진된 200개 병변 테스트에서 CNN은 125개(62%)를 올바르게 진단했지만 두 LLM은 각각 84개와 85개(42%)만 정확했다. 테스트 병변은 MILK10k 공개 데이터셋에서 무작위 선정했으며, 진단 불가능 범주 100개(흑색종 30, 기저세포암 25, 편평세포암 25, 광선각화증 20)와 안전 범주 100개(양성모반 50, 지루각화증 50)로 구성됐다. 전체 요약 12문장 읽기 → 057 12:11 ▲ 14 · 댓글 8 자연어 정책을 신경기호 프로그램으로 컴파일하는 SCOPE LLM 에이전트의 정책 집행이 단일 턴 콘텐츠 검증에서 여러 턴의 대화와 도구 호출 궤적을 평가하는 복합 정책으로 진화했다. AI · 머신러닝 · SCOPE: Compiling Natural-Language Policies into Neurosymbolic Predicate Programs
Key Point 정책 집행의 정확도·안정성·비용·해석 가능성을 동시에 해결하는 신경기호 접근법이 저렴한 모델에서도 대규모 언어모델 수준의 성능을 낼 수 있음을 보여준다.
핵심 요약
LLM 에이전트의 정책 집행이 단일 턴 콘텐츠 검증에서 여러 턴의 대화와 도구 호출 궤적을 평가하는 복합 정책으로 진화했다. 미세 조정한 가드레일 모델은 빠르지만 복합 정책에서 성능이 저하되고, LLM-as-a-judge는 높은 정확도를 달성하지만 추론 비용이 높고 예측이 불안정하다. SCOPE는 정책을 신경 술어, 결정적 추출기, 이들의 출력을 조합하는 코드로 이루어진 실행 가능한 프로그램으로 컴파일한다. 전체 요약 8문장 읽기 → 058 12:11 ▲ 14 · 댓글 3 추론 모델의 '대기' 토큰, RL이 아닌 학습 데이터에서 온다 추론 모델이 단계를 재검토하기 전에 {wait} 토큰을 쓰는 것이 강화학습(RL)의 성과로 여겨져 왔으나, RL이 이 현상을 만든 것이 아니라 학습 데이터에서 상속받은 것일 수 있다는 가설을 검증했다. AI · 머신러닝 · Inherited, Not Invented: Tracing the Provenance of Wait in Reasoning Models
Key Point 추론 모델의 향상이 실제로 RL의 효과인지 아니면 데이터 상속인지 구분해야 할 핵심 연구로, 모델 평가 방식과 RL 기술 검증의 신뢰성을 근본적으로 재검토하게 한다.
핵심 요약
추론 모델이 단계를 재검토하기 전에 {wait} 토큰을 쓰는 것이 강화학습(RL)의 성과로 여겨져 왔으나, RL이 이 현상을 만든 것이 아니라 학습 데이터에서 상속받은 것일 수 있다는 가설을 검증했다. 공개 모델의 학습 이력을 추적하며 빈도, 위치, 형태, 사용 방식을 라벨 없이 지수화하고 주입 오류 테스트로 {wait} 토큰의 출처를 분석했다. RL을 적용하지 않은 초기 모델(zero-RL)은 {wait} 토큰을 거의 생성하지 않으며, {wait}이 없는 기반 모델에 RL을 적용해도 MATH-500 정확도는 크게 올라가지만 {wait} 토큰 사용은 거의 증가하지 않는다. 전체 요약 7문장 읽기 → 059 18:11 ▲ 20 · 댓글 2 LLM 에이전트의 검증기 생성 능력을 평가하는 벤치마크 공개 LLM 에이전트가 작업 완료 후 출력물을 검증하고 합성 학습 데이터를 필터링할 수 있도록, 주어진 지시사항과 환경으로부터 실행 가능한 검증기를 생성하는 능력을 연구했다. AI · 머신러닝 · VerifierBench: Benchmarking the Generation of Executable Verifiers for LLM Agents
Key Point LLM 에이전트가 생성한 검증기들이 실제로는 지나치게 엄격한 기준으로 유효한 솔루션을 배제하는 문제를 처음으로 대규모로 분석했으며, 에이전트 검증 시스템의 근본적 한계를 드러낸다.
핵심 요약
LLM 에이전트가 작업 완료 후 출력물을 검증하고 합성 학습 데이터를 필터링할 수 있도록, 주어진 지시사항과 환경으로부터 실행 가능한 검증기를 생성하는 능력을 연구했다. VerifierBench는 6개 에이전트 벤치마크에서 수집한 222개 작업으로 구성되며, 도구 호출·상태 기반·코드 검증 3가지 유형을 포함하고 4,993개의 숨겨진 테스트 케이스(대체 해결책 및 공격 포함)를 갖추고 있다. Verifier4Verifier(V4V)라는 6단계 감시 시스템이 소스 검증기와 테스트 스위트를 선별한다. 전체 요약 8문장 읽기 → 060 15:11 ▲ 49 · 댓글 2 LLM 외부 지식 통합하는 파라메트릭 메모리 구조 제안 LLM이 학습 후 새로운 지식을 추가할 때 지속 학습은 재앙적 망각을, 검색 기반 방법은 추론 오버헤드를 발생시킨다. AI · 머신러닝 · Deep Fusion Memory: A Chunk-Level Parametric Memory for Large Language Models
Key Point 토큰 수준 메모리 구성의 계산 비용을 획기적으로 줄이면서 동시에 더 깊은 수준의 지식 통합이 가능해져, LLM의 지속적 학습과 도메인 적응 방식이 실질적으로 단순화된다.
핵심 요약
LLM이 학습 후 새로운 지식을 추가할 때 지속 학습은 재앙적 망각을, 검색 기반 방법은 추론 오버헤드를 발생시킨다. 외부 파라메트릭 메모리는 온라인 검색을 피하지만 오프라인 검색이 많이 필요하고 얕은 수준의 융합만 가능해 왔다. 논문은 Deep Fusion Memory(DFM)를 제안하는데, 이는 청크 수준의 메모리를 중간 은닉층에 통합하는 구조다. 전체 요약 9문장 읽기 → 061 09:11 ▲ 206 · 댓글 248 AI 모델들, 인간 본성에 같은 결론에 도달하다 12개 AI 모델(GPT-6.1 Sol, Gemini 4 Argon, DeepSeek V4 Pro, Claude Opus 5.5 등)에게 인간에 대한 가장 논쟁적인 의견을 3번씩 물었다. AI · 머신러닝 · Every AI model has the same "controversial" take on humans
Key Point 같은 AI 모델들이 인간 본성에 대해 거의 동일한 비판적 결론에 도달한 현상은, 학습 데이터의 편향이나 AI 안내 방식이 모델들의 판단을 수렴시키는 메커니즘을 보여준다.
핵심 요약
12개 AI 모델(GPT-6.1 Sol, Gemini 4 Argon, DeepSeek V4 Pro, Claude Opus 5.5 등)에게 인간에 대한 가장 논쟁적인 의견을 3번씩 물었다. 7개 모델은 매번 같은 답을 했고, 12개 모델 모두 최소 1번은 동일한 주장을 제시했다: '인간은 진실보다 집단 소속을 우선한다'는 내용이다. 모델들의 구체적 표현은 다양했지만 핵심은 같다. '인간은 충성심을 원칙으로 위장한다'(GPT-6 Astra), '신념이 아니라 멤버십을 갖는다'(Kimi K3), '이성화 동물이다'(DeepSeek V4 Pro)는 식의 주장이 반복됐다. 전체 요약 12문장 읽기 → 062 21:11 ▲ 24 · 댓글 2 합성 데이터 없이 실제 이미지로 훈련하는 장면 글자 편집 장면 글자 편집(STE)은 원본 스타일을 유지하면서 텍스트 내용을 수정하는 기술로, 기존 접근법들은 합성 쌍 데이터에 의존해 실제 장면의 다양성을 제대로 포착하지 못하고 인공물을 생성하는 문제가 있다. AI · 머신러닝 · Real In, Real Out: What If We Only Use Real Data for Scene Text Editing?
Key Point 실제 이미지만으로 학습하면서도 합성 데이터에 의존하는 기존 방식의 도메인 격차 문제를 해결하고, 나아가 글자 인식 모델의 성능까지 높일 수 있다는 점이 중요하다.
핵심 요약
장면 글자 편집(STE)은 원본 스타일을 유지하면서 텍스트 내용을 수정하는 기술로, 기존 접근법들은 합성 쌍 데이터에 의존해 실제 장면의 다양성을 제대로 포착하지 못하고 인공물을 생성하는 문제가 있다. 논문은 실제 샘플 하나를 여러 방식으로 손상시켜(자르기, 섞기, 마스킹 등) 자체 쌍 학습 데이터를 만드는 방식으로, 합성 데이터 없이 훈련이 가능한지 탐구했다. TextRIRO는 조건부 확산 모델 기반의 기준 모델로, 문자 열 섞기와 이미지 자르기(Shuffle&Crop)를 결합할 때 텍스트 의미는 파괴하면서 스타일 단서는 보존하여 모델이 실제 텍스트 이미지에서 직접 편집 행동을 학습할 수 있다. 전체 요약 6문장 읽기 → 063 18:11 ▲ 169 · 댓글 53 360M 모델로 터미널 에뮬레이터 만들기 360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. AI · 머신러닝 · WorldTUI: I trained a 360M model to pretend to be a terminal
Key Point 시뮬레이션·에뮬레이션 구현 없이 자가 수정 학습과 병렬 디코딩으로 소형 모델을 브라우저에서 구동 가능한 터미널 에뮬레이터로 만든 기술 구현 사례로, 제약된 환경에서 큰 모델의 능력을 소형화하는 방법을 보여준다.
핵심 요약
360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. 파일 생성, vim과 tmux 실행, 스네이크 게임 등이 가능하고, 자신의 실수를 수정하는 능력과 행(row)을 병렬로 디코딩하는 기술로 성능을 크게 개선했다. 터미널을 문자 그리드로 모델링했으며, Qwen2.5-Coder-0.5B를 기반으로 Docker에서 실제 프로그램 실행 기록으로 파인튜닝했다. 전체 요약 14문장 읽기 → 064 15:11 ▲ 72 · 댓글 2 게임 세계에서 스케일링: 구체화 에이전트의 지속적 사전학습 연구팀이 가상 세계에서 데이터 규모, 다양성, 모델 크기가 구체화 에이전트 학습에 미치는 영향을 조사했다. AI · 머신러닝 · Scaling in Games: Continued Pre-Training For Embodied Agents In Diverse Virtual Worlds
Key Point 게임 환경에서 LLM의 스케일링 법칙을 실증적으로 검증한 첫 대규모 연구로, 에이전트 AI의 일반화 능력과 학습 데이터 다양성 간의 관계를 정량적으로 보여준다.
핵심 요약
연구팀이 가상 세계에서 데이터 규모, 다양성, 모델 크기가 구체화 에이전트 학습에 미치는 영향을 조사했다. 0.8B~27B 모델 4종, 50~1,600시간 데이터 6개 규모, Minecraft 단독부터 다중 게임 혼합 데이터 5가지 조합으로 총 120가지 설정을 학습했다. 결과적으로 더 많은 데이터는 학습 데이터 포함 게임 성능을 높이고, 다양성은 유사 게임으로의 전이는 개선하나 거리가 먼 게임으로의 일반화는 제한적이었다. 전체 요약 8문장 읽기 → 065 15:11 ▲ 44 · 댓글 2 LLM 추론 과정을 자체 스타일로 복원하는 TraceForge 발표 프론티어 LLM은 답변만 제공하고 추론 과정을 숨기는데, 이를 극복하기 위해 기존 연구는 암호화된 블록을 재생하는 방식을 사용했으나 서비스 약관을 위반한다. AI · 머신러닝 · TraceForge: Distilling with Your Own Thinking
Key Point 상용 LLM의 추론 과정 접근을 제한하는 현실에서, 약관을 위반하지 않으면서도 모델의 자체 스타일로 추론을 복원해 학습 효율을 높일 수 있는 대안을 제시한다.
핵심 요약
프론티어 LLM은 답변만 제공하고 추론 과정을 숨기는데, 이를 극복하기 위해 기존 연구는 암호화된 블록을 재생하는 방식을 사용했으나 서비스 약관을 위반한다. TraceForge는 교사 모델의 답변과 맥락에서 학생 모델 패밀리의 스타일로 추론 흔적을 생성하는 방식을 제안한다. 생성기가 교사 답변에서 추론 흔적을 재생성하도록 학습하고, 비평가가 실제 흔적의 진정성을 판단하는 2단계 학습(지도학습 후 적대적 학습)을 수행한다. 전체 요약 7문장 읽기 → 066 15:11 ▲ 141 · 댓글 2 인간·로봇 동작 예측 통합 모델 'Ropedia W0' 공개 세계 모델을 통해 구체화된 에이전트(로봇·인간)의 행동 결과를 예측할 수 있는데, 다양한 체형의 이동과 조작을 동시에 모델링하기는 어려웠다. AI · 머신러닝 · Ropedia W0: Scaling Loco-Manipulation World Models across Embodiments with Human Experience
Key Point 인간의 움직임 데이터로 학습한 로봇 제어 모델이 현실에서 어떻게 작동할지를 보여주는 기초 연구로, 로봇 에이전트의 자율성 향상에 필요한 예측 능력의 스케일링 가능성을 제시한다.
핵심 요약
세계 모델을 통해 구체화된 에이전트(로봇·인간)의 행동 결과를 예측할 수 있는데, 다양한 체형의 이동과 조작을 동시에 모델링하기는 어려웠다. Ropedia W0은 인간과 로봇을 아우르는 첫 자아중심형 이동·조작 월드 파운데이션 모델로, 10,000시간의 인간 시점 영상과 3,000시간의 로봇 데이터(통합 멀티모달 주석 및 품질 관리 포함)로 구성된 Xp-Data를 수집했다. 이동은 카메라 포즈로, 조작은 투영된 골격으로 인코딩하는 통합 운동학 표현을 사용하며, 로봇 골격은 체형별 순기구학과 광범위한 수동 키포인트 주석·수정을 결합한다. 전체 요약 8문장 읽기 → 067 00:11 ▲ 103 · 댓글 59 가짜 통계로 ChatGPT에 인용되는 법 저자는 7개월 전 5만 개의 가짜 통계를 담은 웹사이트를 만들었고, Google은 해당 사이트를 인덱스에서 제거했지만 ChatGPT는 계속 참조하고 있다. AI · 머신러닝 · Publish fake stats, get cited in LLMs
Key Point LLM 기반 AI 검색이 Google을 대체하면서 가짜 정보가 인용과 재인용으로 신뢰성을 얻는 '정보 연쇄 반응'의 실증적 증거를 제시하며, 웹 콘텐츠 신뢰성과 LLM 학습 데이터 품질에 대한 근본적인 문제를 지적한다.
핵심 요약
저자는 7개월 전 5만 개의 가짜 통계를 담은 웹사이트를 만들었고, Google은 해당 사이트를 인덱스에서 제거했지만 ChatGPT는 계속 참조하고 있다. 사이트는 ChatGPT로부터 1만 개 이상의 세션을 받았고, Shopify, DHL, Bluehost를 포함한 330개 이상의 도메인에서 링크되었으며, 가짜 수치가 학술 논문과 은행의 투자 연구에 인용되었다. 저자는 LLM 관련 연구 중 LLM들이 지식 격차를 채우기 위해 통계를 찾는 패턴을 발견했고, 이를 통해 GEO(생성형 검색 최적화) 실험을 설계했다. 전체 요약 14문장 읽기 → 068 18:11 ▲ 155 · 댓글 3 기초 모델에 메모리 능력을 내장한 MemT-1.0 공개 메모리를 모델 계산의 일부로 내재화하는 메모리 네이티브 기초 모델 MemT-1.0을 소개한다. AI · 머신러닝 · MemT-1.0: Towards Memory-Native Evolution
Key Point 장기 컨텍스트 처리 시 메모리 효율과 추론 속도를 동시에 개선하는 아키텍처로, 외부 검색에 의존하지 않고 내부 메모리만으로 작동하는 모델의 가능성을 보여준다.
핵심 요약
메모리를 모델 계산의 일부로 내재화하는 메모리 네이티브 기초 모델 MemT-1.0을 소개한다. Metis를 기반으로 Gated DeltaNet-2 아키텍처를 채용하며, 턴마다 안정적인 토큰 수준 메모리 업데이트 메커니즘을 사용한다. 메모리 용량 확장을 위해 Mixture-of-Storage를 도입했다. 전체 요약 8문장 읽기 → 069 18:11 ▲ 123 · 댓글 69 오픈 모델에 숨겨진 백도어, 탐지 불가능한 이유 가중치를 편집한 모든 오픈 모델은 백도어를 숨길 수 있으며, 특히 제약을 제거한 abliterated 모델이 인기 있기 때문에 검증 없이 다운로드된다. 보안 · How abliterated models can get you pwned
Key Point 오픈 모델 백도어는 현재 Hugging Face에서 실제로 유통 중이며, 벤치마크 검사와 보안 스캔을 모두 통과하므로 런타임 제어 없는 프로덕션 배포는 자격증명 탈취 위험에 노출된다.
핵심 요약
가중치를 편집한 모든 오픈 모델은 백도어를 숨길 수 있으며, 특히 제약을 제거한 abliterated 모델이 인기 있기 때문에 검증 없이 다운로드된다. Project Discovery 연구팀은 Qwen2.5-7B 모델에 백도어를 심어 코딩 에이전트(Codex)를 통해 프로젝트 자격증명을 유출시키는 실험을 수행했다. 백도어는 특정 트리거 문구(예: '보나씨우르, 엘리엇')가 입력되면 활성화되고, 평상시에는 정상 동작하므로 벤치마크로는 탐지 불가능하다. 전체 요약 13문장 읽기 → 070 15:11 ▲ 155 · 댓글 3 인간의 경험에서 배우는 홀리스틱 세계 이해 시스템 머신러닝 커뮤니티가 인간의 일인칭 시점 영상 데이터를 활용해 세상을 이해하는 방법을 개발하고 있다. AI · 머신러닝 · Holi-World: Building Holistic World Intelligence from Human-Ego Experience
Key Point 인간의 일상 영상에서 자동으로 학습 데이터를 만들어 세계 이해 AI를 훈련하는 새로운 방식을 제시해, 값비싼 수동 주석을 줄이면서 지각 AI의 실용적 확장을 가능하게 한다.
핵심 요약
머신러닝 커뮤니티가 인간의 일인칭 시점 영상 데이터를 활용해 세상을 이해하는 방법을 개발하고 있다. HOLI-WORLD는 카메라 캡처·세계 표현·자동 데이터 구성·모델 학습·평가를 통합하는 생태계로, 수동 주석 의존성을 줄인다. HOLIWORLD-Foundry는 정적·동적 인식을 결합해 장면 구조·물체 상태·상호작용 이력을 자동으로 연결하는 '세계 기록'을 구성한다. 전체 요약 8문장 읽기 → 071 15:11 ▲ 20 · 댓글 3 로봇 조작 학습, 인간 영상으로도 가능하게 로봇 조작을 배우는 데 인간 비디오가 필요한 이유는 로봇 행동 라벨이 있는 영상은 비용이 많고 다양성이 부족하기 때문이다. AI · 머신러닝 · AffordanceWAM: Affordance-Aware Joint World-Action Modeling for Robot Manipulation
Key Point 로봇 학습 데이터의 수집 비용을 크게 낮추고 인간 영상을 직접 활용할 수 있는 방법이 제시되었기 때문에, 로봇 조작 분야에서 실용적인 전환점이 될 수 있다.
핵심 요약
로봇 조작을 배우는 데 인간 비디오가 필요한 이유는 로봇 행동 라벨이 있는 영상은 비용이 많고 다양성이 부족하기 때문이다. AffordanceWAM은 미래 프레임을 예측하면서 동시에 객체별 상호작용 가능 영역(Scalar Affordance, Affordance Heatmap)을 표현하는 생성 모델이다. 비디오 디퓨전 트랜스포머를 기반으로 World Expert와 Action Expert를 따로 설계하고 Masked Joint Self-Attention으로 연결하여 RGB 관찰, 어포던스 필드, 히트맵, 로봇 액션을 함께 예측한다. 전체 요약 7문장 읽기 → 072 15:11 ▲ 32 · 댓글 2 월드 모델의 일반화 능력을 평가하는 AnyGoal 벤치마크 공개 월드 모델이 환경 역학을 정확히 학습해도, 학습 데이터에 없던 상태-행동 조합에서는 신뢰할 수 없다는 문제를 다룬 논문이다. AI · 머신러닝 · AnyGoal: On World Model Generalization Beyond Expert Rollouts
Key Point 월드 모델의 진정한 일반화 능력을 측정하는 표준화된 벤치마크가 부족한 상황에서, 구성적 일반화 실패 사례들을 체계적으로 드러내는 평가 도구가 제시되어 향후 모델 개선 방향을 명확히 제시한다.
핵심 요약
월드 모델이 환경 역학을 정확히 학습해도, 학습 데이터에 없던 상태-행동 조합에서는 신뢰할 수 없다는 문제를 다룬 논문이다. 연구팀은 AnyGoal이라는 벤치마크와 오픈소스 라이브러리를 공개했으며, 기존 월드 모델 환경들을 변형해 새로운 목표를 가진 태스크 변이체들을 만들었다. 각 태스크는 개별 상태 요소와 행동들은 학습 범위 내에 있지만, 그 조합은 전문가 궤적에서 거의 나타나지 않도록 설계되었다. 전체 요약 6문장 읽기 → 073 06:11 ▲ 16 · 댓글 1 학습 데이터 없이 확산 모델 가속화하는 방법 확산 모델과 플로우 모델은 수치 적분이 비싸 추론 속도가 느리며, 기존 증류법은 학습 데이터셋이나 비용 많은 교사 모델 롤아웃, 보조 네트워크 등이 필요했다. AI · 머신러닝 · Consistent Distribution Matching for Data-Free Diffusion Distillation
Key Point 학습 데이터가 필요 없으면서도 최소 함수 평가로 고화질 생성을 하는 새로운 증류 기법이 기존의 데이터 의존성과 복잡한 학습 파이프라인 문제를 해결한다.
핵심 요약
확산 모델과 플로우 모델은 수치 적분이 비싸 추론 속도가 느리며, 기존 증류법은 학습 데이터셋이나 비용 많은 교사 모델 롤아웃, 보조 네트워크 등이 필요했다. Consistent Distribution Matching이라는 시뮬레이션 프리·데이터 프리 증류 방식을 제안하며, 샘플 생성과 스코어 추정을 하나의 학생 네트워크로 통합한다. 프레임워크는 얼어 있는 교사 모델과 학습 가능한 학생 모델 두 개만 사용하고 하나의 목적함수를 최적화한다. 전체 요약 6문장 읽기 → 074 03:11 ▲ 20 · 댓글 2 텍스트·이미지·영상을 함께 쓰는 통합 비디오 편집 프레임워크 OmniXRef는 텍스트 지시, 이미지 참조, 영상 참조를 조합하여 소스 비디오의 다양한 속성을 제어하는 통합 비디오 편집 프레임워크다. AI · 머신러닝 · OmniXRef: A Unified Framework for Multimodal Multi-Reference Video Editing
Key Point 여러 형태의 참조를 통합하는 비디오 편집 방식은 창작자의 의도를 더 유연하게 표현하게 해주며, 공개된 벤치마크는 이 영역의 평가 표준을 정립합니다.
핵심 요약
OmniXRef는 텍스트 지시, 이미지 참조, 영상 참조를 조합하여 소스 비디오의 다양한 속성을 제어하는 통합 비디오 편집 프레임워크다. 참조 은행 인터페이스와 R²-RoPE를 도입하여 가변 개수의 참조를 지원하는 통합 입력 설계를 구현했다. OmniXRef-Model은 단일 스트림 확산 트랜스포머를 사용해 소스 비디오와 MLLM의 다중모드 맥락을 인터리브 수열로 처리한다. 전체 요약 7문장 읽기 → 075 03:11 ▲ 164 · 댓글 149 루비 개발자, 오픈소스 일손 놓다 루비 젬 개발자가 모든 저장소를 아카이브하고 루비 생태계 활동을 중단하기로 결정했다. 오픈소스 · 도구 · I no longer care to work on any Ruby gems so I've archived all my repositories
Key Point 루비 생태계의 중심 개발자가 오픈소스 활동을 완전히 중단한 배경에는 LLM 학습 데이터로 인간의 코드가 무단 활용되는 것에 대한 불만이 있으며, 이는 오픈소스 커뮤니티 전반의 지속가능성 문제를 드러낸다.
핵심 요약
루비 젬 개발자가 모든 저장소를 아카이브하고 루비 생태계 활동을 중단하기로 결정했다. 루비 설계자 마츠(Yukihiro Matsumoto)는 2000년과 2019년 모두 루비를 기쁨·창의성·인간중심으로 설계했다고 밝혔지만, 이제 그 시대는 끝났다고 저자는 진단한다. 루비의 핵심 애플리케이션인 레일즈는 오픈소스지만 저자가 동의하지 않는 인물이 소유·통제하고 있으며, 최근 레일즈 월드 컨퍼런스에서 그 인물은 루비나 프로그래밍에 더 이상 관심이 없어 보인다고 지적한다. 전체 요약 6문장 읽기 → 076 00:11 ▲ 254 · 댓글 45 Mistral, 시계열 예측 파운데이션 모델 Timestral 공개 Mistral이 시계열 데이터 예측을 위한 첫 파운데이션 모델 Timestral을 공개했다. AI · 머신러닝 · Timestral: Mistral release time-series foundation models
Key Point 시계열 데이터는 기업의 센서·관찰성 메트릭부터 재무 수치까지 매우 광범위하게 쓰이는데, 이전에 도메인별로 처음부터 학습해야 했던 방식을 벗어나 사전학습된 기초 모델으로 적응형 예측이 가능해진다.
핵심 요약
Mistral이 시계열 데이터 예측을 위한 첫 파운데이션 모델 Timestral을 공개했다. 최대 크기 모델은 2억 9천만 개 파라미터로, GIFT-Eval, TIME, fev-bench 세 가지 주요 벤치마크에서 1위를 차지했으며 이전 최고 기록보다 파라미터 수는 2/3 수준이다. 5백만부터 2억 9천만 개 파라미터까지 4가지 크기로 출시되며, 각 크기별로 정확도와 모델 크기의 파레토 프런티어에 위치한다. 전체 요약 11문장 읽기 → 077 12:11 ▲ 100 · 댓글 78 LLM이 못 읽게 설계한 프로그래밍 언어 'KillSwitch' 개발 개발자는 LLM이 코드를 정말 이해하는지, 아니면 학습 데이터 기억에만 의존하는지 확인하기 위해 언어 모델을 혼동하도록 설계된 프로그래밍 언어 KillSwitch를 만들었다. AI · 머신러닝 · I built a programming language that LLMs can't use
Key Point LLM이 정말 코드를 이해하는지, 아니면 패턴 매칭만 하는지 검증하는 새로운 벤치마크로, 최신 AI 모델의 실제 능력을 평가하는 관점을 제시한다.
핵심 요약
개발자는 LLM이 코드를 정말 이해하는지, 아니면 학습 데이터 기억에만 의존하는지 확인하기 위해 언어 모델을 혼동하도록 설계된 프로그래밍 언어 KillSwitch를 만들었다. KillSwitch는 스택 기반의 해석형 언어로 함수, 변수, 조건문만 지원하지만, LLM을 속이도록 여러 특징을 포함한다. 언어 스펙에 거짓 정보를 숨겨두고, 문자 개수 세기를 규칙으로 사용하며, 'hack into a computer' 같은 안전장치 트리거 구문을 포함하고, 대부분이 노이즈인 스크립트로 구성된다. 전체 요약 8문장 읽기 → 078 06:11 ▲ 110 · 댓글 148 수학 황금기냐 암흑기냐, LLM 통합 방식에 달렸다 LLM은 Lean 증명에서 뛰어나지만 수백만 줄 코드의 복잡한 증명을 자연언어로 번역할 때 심각한 문제를 보인다. AI · 머신러닝 · Will it be a golden age or a dark age for mathematics (and science)?
Key Point LLM이 수학 연구에서 핵심 도구화하는 시점에 실제 인간 이해·학술 출판·능력 평가 기준을 어떻게 유지할 것인지를 다룬, 수학과 과학 생태계의 미래를 가르는 근본적 질문이다.
핵심 요약
LLM은 Lean 증명에서 뛰어나지만 수백만 줄 코드의 복잡한 증명을 자연언어로 번역할 때 심각한 문제를 보인다. 인간이 이해하지 못하면 수학은 인간 문화의 일부가 될 수 없으므로, 사회는 수학자를 더 많이 필요로 한다. LLM은 기존 지식을 재결합하는 데는 뛰어나지만, 새로운 수학 언어를 창안하는 '수학화'(mathematization) 능력은 여전히 불명확하다. 전체 요약 10문장 읽기 → 079 09:11 ▲ 110 · 댓글 30 외적 메모리에서 시작하는 트랜스포머의 직관적 이해 선형 계층, MLP, 셀프-어텐션을 메모리 저장소로 재해석하는 관점을 제시한다. AI · 머신러닝 · You could have invented transformers from memory
Key Point 신경망 계층이 정보를 어떻게 저장하고 회수하는지에 대한 통일된 수학적 직관을 제공하므로, 트랜스포머 아키텍처의 설계 선택을 더 깊이 이해할 수 있다.
핵심 요약
선형 계층, MLP, 셀프-어텐션을 메모리 저장소로 재해석하는 관점을 제시한다. 기본적인 외적 메모리 저장소는 M개 메모리를 저장할 때 키 차원 d_k과 같은 용량 d_k만 갖는다. 최적 선형 메모리는 키의 공분산을 보정해 용량을 2d_k로 두 배 높인다. 전체 요약 10문장 읽기 → 080 09:11 ▲ 104 · 댓글 116 자본주의의 최종 형태, AI라는 환상 AI가 문학계를 강타하면서 학생 과제와 신진 작가 평가에 대한 신뢰가 무너졌고, 인간과 언어의 근본적 관계 파괴가 사회 결속력을 훼손할 우려가 제기된다. AI · 머신러닝 · Artificial intelligence is capitalism's final destination
Key Point AI 기업들이 정부와 융합하는 방식, 비개발국 착취, 인류 문명 자산의 약탈 구조를 통해 현재의 규제 논쟁이 어떻게 기업 권력 강화로 전환되는지 보여준다.
핵심 요약
AI가 문학계를 강타하면서 학생 과제와 신진 작가 평가에 대한 신뢰가 무너졌고, 인간과 언어의 근본적 관계 파괴가 사회 결속력을 훼손할 우려가 제기된다. Anthropic의 Jacob Coxon 같은 내부 고발자들이 AI가 인류를 멸절할 수 있다며 경고하자, 빅테크 CEO들이 공적으로 이를 인정하며 정부 규제를 요청하는 역설적 상황이 펼쳐졌다. Meredith Whittaker(Google 드론 기계시각 계약 거부)와 Timnit Gebru(LLM의 환경 비용과 차별 재생산 연구)의 고발은 AI 재계에서 무시되었으나, 멸절 시나리오는 오히려 기업 가치를 높이는 역할을 한다. 전체 요약 12문장 읽기 → 081 09:11 ▲ 11 · 댓글 2 AI 에이전트가 자율적으로 모델을 학습시키다 AI 에이전트가 인간의 개입 없이 소규모 기본 모델을 고급 모델로 학습시킬 수 있는지 검증하는 Athanor이라는 에이전트-네이티브 자동 학습 연구 시스템을 개발했다. AI · 머신러닝 · Athanor: An Agent-Native System for Autonomous Post-Training Research
Key Point 현재의 AI 에이전트가 인간의 개입 없이 모델 개발 연구를 독립적으로 수행할 수 있음을 실증했으며, AI 시스템이 더 강력한 AI를 구축하는 자기 개선 경로의 현실적 가능성을 보여준다.
핵심 요약
AI 에이전트가 인간의 개입 없이 소규모 기본 모델을 고급 모델로 학습시킬 수 있는지 검증하는 Athanor이라는 에이전트-네이티브 자동 학습 연구 시스템을 개발했다. 104시간 동안 Claude Opus 3.5 에이전트 4개가 각각 8개 GPU 노드에서 Qwen3-4B-Base 모델을 개선했으며, 어떤 연구 조언도 받지 않았다. 개발 테스트 6개 과제에서 모델 성능이 15.9에서 67.3으로, 공개되지 않은 홀드아웃 평가 세트에서는 9.2에서 48.2로 향상되었다. 전체 요약 8문장 읽기 → 082 03:11 ▲ 11 · 댓글 2 선형 시간 희소 어텐션으로 컨텍스트 길이 확장하기 선형 시간 시퀀스 모델들은 고정된 크기의 상태에 정보를 저장하기 때문에 장문맥 처리에 제약이 있고, 전체 어텐션을 추가하면 이차 비용이 발생한다. AI · 머신러닝 · FreeSolo: Linear-time Sparse Attention with Zero-Shot Length Extrapolation
Key Point 트랜스포머의 근본적 한계인 이차 복잡도 문제를 해결하면서도 학습 데이터보다 긴 입력에서도 작동하는 새로운 어텐션 메커니즘의 제안으로, LLM의 컨텍스트 길이 확장이 시급한 현실에서 실질적 개선을 제시한다.
핵심 요약
선형 시간 시퀀스 모델들은 고정된 크기의 상태에 정보를 저장하기 때문에 장문맥 처리에 제약이 있고, 전체 어텐션을 추가하면 이차 비용이 발생한다. 지속적 사전학습(CPT)을 통한 희소 어텐션은 컨텍스트 길이를 늘릴 수 있지만 학습된 길이를 넘어 일반화하기 어렵고 비용이 크다. FreeSolo는 단거리 슬라이딩 윈도우 분기와 키포인트 셀을 선택하는 장거리 분기로 구성된 네이티브 희소 어텐션 메커니즘이다. 전체 요약 6문장 읽기 → 083 18:11 ▲ 54 · 댓글 2 로봇 제어 성능 높이는 'VLA-Δ' 프레임워크 공개 Vision-language-action(VLA) 모델이 비전-언어 사전학습 지식을 로봇 제어에 적용하지만, 대부분은 관찰과 행동을 직접 매핑하며 중간 물리 상태 변화를 명시적으로 학습하지 않아 관찰-행동 대응에 과적합되는 문제가 있다. AI · 머신러닝 · VLA-Δ: Learning Physical State Transition for Vision-Language-Action Models
Key Point 로봇 제어 분야의 VLA 모델이 물리적 상태 변화를 명시적으로 학습하는 새로운 접근으로 기존 과적합 문제를 해결하고 성능을 향상시킨 점이 중요하다.
핵심 요약
Vision-language-action(VLA) 모델이 비전-언어 사전학습 지식을 로봇 제어에 적용하지만, 대부분은 관찰과 행동을 직접 매핑하며 중간 물리 상태 변화를 명시적으로 학습하지 않아 관찰-행동 대응에 과적합되는 문제가 있다. 기존 방법들은 언어·시각·잠재 공간에서 중간 추론이나 미래 상태 예측을 도입했으나, 실제 물리적 상태 전환 자체는 명시적으로 학습하지 않았다. 연구팀은 현재 상태와 미래 상태 간 물리적 변화를 직접 학습 목표로 삼는 VLA-Δ 프레임워크를 제안했다. 전체 요약 7문장 읽기 → 084 18:11 ▲ 37 · 댓글 4 LLM 에이전트, 학습 데이터를 자동으로 개선하는 시스템 언어모델 에이전트가 지도학습 미세조정(SFT) 시 학습 데이터 개선에 가장 많은 시간을 쓰지만, 기존 시스템은 고정된 풀에서 행을 선택하거나 생성기를 호출하는 단 한 가지 방식만 제공한다. AI · 머신러닝 · AutoSFT: An Agentic System for Automated Data Research in Supervised Fine-Tuning
Key Point 자동화된 데이터 개선이 단일 기능 강화가 아니라 다각적 접근에 달려 있다는 점을 보여주며, 실제 개선 수치(IFEval +6.5~+9.9)로 멀티에이전트 방식의 실질적 효과를 입증한다.
핵심 요약
언어모델 에이전트가 지도학습 미세조정(SFT) 시 학습 데이터 개선에 가장 많은 시간을 쓰지만, 기존 시스템은 고정된 풀에서 행을 선택하거나 생성기를 호출하는 단 한 가지 방식만 제공한다. 연구팀은 인간 데이터 엔지니어처럼 비율 조정, 가지치기, 수리, 교체, 합성 등 다양한 데이터 조작 기능을 수행할 수 있는 에이전트 시스템을 설계했다. 단일 에이전트 방식은 비율 조정 하나의 행동만 반복하며 컨텍스트를 낭비해 성능이 개선되지 않았다. 전체 요약 7문장 읽기 → 085 15:11 ▲ 17 · 댓글 2 자동주행 AI, 시뮬레이션으로 가상 주행 영상 학습 자동주행 세계 액션 모델(WAM)은 실제 주행 로그에서 기록된 궤적에 대한 영상 데이터만 갖고 있어, 강화학습으로 탐색한 대안적 궤적에는 시각적 감독이 없다. AI · 머신러닝 · SimVTA: Simulation-Grounded Video-Trajectory Alignment for Driving World Action Models
Key Point 자동주행 AI가 시뮬레이션으로 생성한 가상 영상을 학습 데이터로 사용해 강화학습 후보 궤적도 감독할 수 있게 되어, 제한된 실제 데이터만으로도 계획 성능을 5% 이상 향상시킬 수 있다.
핵심 요약
자동주행 세계 액션 모델(WAM)은 실제 주행 로그에서 기록된 궤적에 대한 영상 데이터만 갖고 있어, 강화학습으로 탐색한 대안적 궤적에는 시각적 감독이 없다. SimVTA는 이 문제를 해결하기 위해 시뮬레이션 기반 사후훈련 프레임워크를 제안한다. 각 관찰에 대해 후보 궤적을 샘플링하고, 3D 가우시안 스플래팅(3DGS)으로 재구성한 실제 장면에서 월드 엔진 같은 시뮬레이터로 높은 보상을 받는 궤적들의 미래 영상을 렌더링한다. 전체 요약 8문장 읽기 → 086 06:11 ▲ 365 · 댓글 119 신경망은 이미 깨끗하다 신경망이 임의로 얽혀 있다고 여겨졌던 것은 다중의미성(polysemanticity)과 중첩(superposition) 때문이라는 기존 해석이 오류였으며, 실제로는 '재귀적 일반화'라는 훨씬 덜 우려스러운 현상이었다고 주장한다. AI · 머신러닝 · Neural networks are clean
Key Point 신경망의 내부 구조가 우리가 생각하는 것보다 훨씬 깨끗하고 이해 가능하다는 주장이 기존의 '해석 불가능한 검은 상자' 관념을 근본적으로 뒤집으며, 기계 학습의 해석가능성 연구에 새로운 방향을 제시한다.
핵심 요약
신경망이 임의로 얽혀 있다고 여겨졌던 것은 다중의미성(polysemanticity)과 중첩(superposition) 때문이라는 기존 해석이 오류였으며, 실제로는 '재귀적 일반화'라는 훨씬 덜 우려스러운 현상이었다고 주장한다. InceptionV1 같은 초기 이미지 모델에서 고양이 얼굴과 자동차 앞면 모두에 반응하던 신경원은 임의의 조합이 아니라 V자 모양이라는 공통 특징을 감지하고 있었다. 아키텍처 개선으로 InceptionV1의 마지막 레이어에서 해석 불가능한 신경원이 거의 없던 것이 99-100% 해석 가능하게 바뀌었으며, 모델 크기와 학습 데이터는 변하지 않았다. 전체 요약 12문장 읽기 → 087 18:11 ▲ 35 · 댓글 2 완전 공개 멀티모달 모델 Apertus 1.5 출시 Apertus 1.5는 완전히 공개 데이터로 학습한 멀티모달 추론 모델로, 텍스트 기반 Apertus 1.0을 확장했다. AI · 머신러닝 · Apertus 1.5: From Open Text Models to Open Multimodal Reasoners
Key Point 공개 데이터로만 학습한 완전히 오픈소스 멀티모달 모델의 등장으로, 소수 기업 종속에서 벗어날 수 있는 대안이 실제 규모에서 가능함을 보여준다.
핵심 요약
Apertus 1.5는 완전히 공개 데이터로 학습한 멀티모달 추론 모델로, 텍스트 기반 Apertus 1.0을 확장했다. 8B 모델에 4T개, 70B 모델에 2T개 토큰을 추가 학습해 이미지와 음성 이해 능력을 추가했으며, 컨텍스트 윈도우를 262,144 토큰으로 4배 확대했다. 토크나이저를 통해 멀티모달 입력을 처리하되 언어 모델 헤드는 텍스트만 출력하고 아키텍처는 유지했다. 전체 요약 9문장 읽기 → 088 15:11 ▲ 150 · 댓글 37 경량 추론 모델 LFM2.5-24B-A2B 출시, 온디바이스 에이전트 최적화 Liquid AI가 LFM2.5-24B-A2B를 공개했으며, 총 24B 파라미터 중 활성 파라미터는 2B만 사용하는 추론 특화 모델이다. AI · 머신러닝 · LFM2.5-24B-A2B: Built for fast on-device agents
Key Point 온디바이스에서 도구 호출과 추론을 빠르게 처리해야 하는 개발자에게, 클라우드 API 의존 없이 로컬 에이전트를 구축할 수 있는 선택지를 제시한다.
핵심 요약
Liquid AI가 LFM2.5-24B-A2B를 공개했으며, 총 24B 파라미터 중 활성 파라미터는 2B만 사용하는 추론 특화 모델이다. 총 파라미터가 50% 이상 많은 Qwen3.6-35B-A3B와 비교해 에이전트·도구 사용 벤치마크 8개 중 5개에서 경쟁력을 보였다. AutomationBench에서 27.69점으로 다음 경쟁 모델 8.72점의 3배 이상 점수를 기록했고, LiveClaw에서 48.09점을 달성했다. 전체 요약 13문장 읽기 → 089 12:11 ▲ 19 · 댓글 1 텍스트-이미지 생성 모델, 자동으로 자기 약점 찾아 학습한다 텍스트-이미지 생성 모델의 사후학습(post-training)을 자동화하는 APT(Agentic Post-Training) 프레임워크를 제안했다. AI · 머신러닝 · APT: Feedback-Driven Agentic Post-Training for Text-to-Image Generation
Key Point 수동 데이터 큐레이션 없이 모델 자체의 약점을 자동으로 식별해 학습하는 방식으로, 텍스트-이미지 생성의 품질 개선 파이프라인이 어떻게 근본적으로 바뀔 수 있는지 보여준다.
핵심 요약
텍스트-이미지 생성 모델의 사후학습(post-training)을 자동화하는 APT(Agentic Post-Training) 프레임워크를 제안했다. 기존 방식은 수동으로 큐레이션한 데이터와 고정된 학습 분포에 의존했으나, APT는 모델의 진화하는 역량에 맞춰 적응적으로 사후학습을 진행한다. 평가 세트 구성, 모델의 강점과 약점 진단, 강화학습 데이터 생성을 담당하는 3개 에이전트를 조율한다. 전체 요약 6문장 읽기 → 090 06:11 ▲ 13 · 댓글 1 위험 개념은 분리하고 품질은 살리는 이미지 생성 모델 기존 이미지 생성 모델은 광범위한 미필터링 데이터로 학습하면 품질은 높지만 생성해서는 안 되는 개념도 학습하는 문제가 있다. AI · 머신러닝 · Pristine Models
Key Point 학습 데이터 필터링과 사후 제거 방식의 한계를 근본적으로 해결하는 새로운 아키텍처로, 안전성과 품질 사이의 오랜 트레이드오프를 학습 시점에서 구조적으로 해소하는 방법을 제시한다.
핵심 요약
기존 이미지 생성 모델은 광범위한 미필터링 데이터로 학습하면 품질은 높지만 생성해서는 안 되는 개념도 학습하는 문제가 있다. 안전한 데이터만으로 학습하면 위험 개념을 피할 수 있지만, 그 데이터에 포함된 유용한 지식도 함께 잃어서 품질이 떨어진다. 기존 방식들은 학습 후 개념 제거를 시도하는데, 제거할 개념이 많아질수록 파괴적인 망각(catastrophic forgetting)을 일으킨다. 전체 요약 8문장 읽기 → 091 18:11 ▲ 96 · 댓글 2 장기 작업 자동화 AI, 밀도 높은 보상으로 학습 난제 해결 수 시간에서 수 일에 걸친 장기 과제를 자율적으로 수행하는 에이전트 개발이 주목받고 있으나, 오픈소스 모델들은 학습 데이터 부족과 효과적인 학습 방법 부재로 어려움을 겪고 있다. AI · 머신러닝 · Tev: Scaling Long-Horizon Agentic Environments with Dense Progress Rewards
Key Point 장기 자동화 작업의 학습 데이터 부족과 희소 보상 문제를 해결한 구체적인 방법론과 검증 가능한 데이터셋을 제시하여 오픈소스 장기 에이전트 개발의 실질적인 진전을 가능하게 한다.
핵심 요약
수 시간에서 수 일에 걸친 장기 과제를 자율적으로 수행하는 에이전트 개발이 주목받고 있으나, 오픈소스 모델들은 학습 데이터 부족과 효과적인 학습 방법 부재로 어려움을 겪고 있다. 연구팀은 Tev-Gym이라는 첫 번째 장기 에이전트 학습 데이터셋을 제시했으며, 7개 도메인의 1,170개 검증된 과제 환경을 포함하고 검증 가능한 밀도 높은 진행 보상을 제공한다. 잠재 세계 우선 접근법으로 작동하여 먼저 완전하고 정확한 숨겨진 작업 명세를 구성하고, 각 단계마다 예상되는 상태를 지정한 뒤, 과제를 점진적으로 렌더링해 제어 가능한 복잡성과 자연스러운 진행 지표를 제공한다. 전체 요약 6문장 읽기 → 092 18:11 ▲ 25 · 댓글 2 3D 메시 움직임 복원, 스케일 분리로 범용화 희소한 정점 변위로부터 촘촘한 메시 움직임을 복원하는 문제를 다룬다. AI · 머신러닝 · Cepheid: Decoupling Scale from Structure for Cross-Family Motion Completion
Key Point 3D 애니메이션 제작과 로봇 제어에서 부분 관측만으로 전체 움직임을 복원하는 핵심 문제를 해결했으며, 단일 모델로 다양한 대상에 일반화되는 점이 기술적 진전을 의미한다.
핵심 요약
희소한 정점 변위로부터 촘촘한 메시 움직임을 복원하는 문제를 다룬다. 기존 학습 기반 잔차 사전은 특정 형태군(의류, 동물 등)에서만 기존 조화 확장을 넘지 못했다. 스케일 문제: 기하학 형태군 간 잔차 진폭이 10배 이상 차이나며, 관측값이 많아지면 붕괴된다. 전체 요약 6문장 읽기 → 093 18:11 ▲ 25 · 댓글 2 언어-행동 이중 부트스트래핑으로 네비게이션 성능을 자동 개선하다 자연어 지시를 따라 목표 위치에 도달하는 비전-언어 네비게이션 모델을 만들 때 고품질의 언어 감독 데이터가 필수이나, 사람이 직접 주석을 다는 것은 비용이 많이 든다. AI · 머신러닝 · Data-Centric Recursive Self-Improvement for Navigation via Policy-Synchronized Language-Action Dual Bootstrapping
Key Point 고비용의 인간 주석 없이도 모델이 스스로 학습 데이터를 생성하고 개선하는 방식은 대규모 AI 시스템의 데이터 확보 문제를 어떻게 풀 수 있는지 보여주는 중요한 사례다.
핵심 요약
자연어 지시를 따라 목표 위치에 도달하는 비전-언어 네비게이션 모델을 만들 때 고품질의 언어 감독 데이터가 필수이나, 사람이 직접 주석을 다는 것은 비용이 많이 든다. 기존 방법들은 네비게이션과 명령어 생성을 분리된 모델로 처리하거나 특정 컴포넌트로 묶어서 처리하는 한계가 있었고, 고정된 모델로 전체 궤적을 미리 주석해서 생성된 감독이 진화하는 정책에 뒤처지는 문제가 있었다. 논문은 RSI-Nav라는 데이터 중심의 재귀적 자가개선 프레임워크를 제안하며, 하나의 공유 모델로 비전-언어-행동 명령 수행과 비전-행동-언어 명령 생성을 통합한다. 전체 요약 7문장 읽기 → 094 18:11 ▲ 19 · 댓글 1 비디오 추론 모델의 증거 기반 검증 능력 강화 Open-o3-Video-v2는 비디오 추론 과정에서 타임스탬프와 객체 경계박스를 포함한 검증 가능한 증거를 생성하는 모델입니다. AI · 머신러닝 · Open-o3-Video-v2: Seek, Ground, and Reason with Verifiable Spatio-Temporal Evidence
Key Point 비디오 AI 모델이 단순히 답을 하는 것에서 벗어나 '왜 그렇게 생각하는지' 시간과 위치 정보로 검증할 수 있게 되면서, 신뢰성이 필요한 비디오 분석 응용에 실제 도입 가능성이 높아집니다.
핵심 요약
Open-o3-Video-v2는 비디오 추론 과정에서 타임스탬프와 객체 경계박스를 포함한 검증 가능한 증거를 생성하는 모델입니다. 기존 Open-o3-Video의 제한점을 극복하기 위해 부족한 정보를 식별하고 추가 관찰을 획득하는 에이전트 기반 접근 방식을 도입했습니다. 52K 다중 턴 에이전트 그라운딩 추론 궤적과 13K 강화학습 데이터셋(STGR-v2-CoT135K, STGR-v2-RL-13K)을 구성했습니다. 전체 요약 7문장 읽기 → 095 21:11 당일 +148 NVIDIA, 음성 실시간 대화 AI 'PersonaPlex' 공개 NVIDIA가 Moshi 아키텍처 기반의 실시간 풀 듀플렉스 음성 대화 모델 PersonaPlex를 공개했다. AI · 머신러닝 · NVIDIA/personaplex · Python
Key Point NVIDIA의 실시간 양방향 음성 모델이 텍스트 프롬프트로 페르소나를 제어할 수 있다는 점이 음성 AI의 커스터마이제이션 수준을 크게 높이며, 오픈소스 공개로 즉시 활용 가능하다.
핵심 요약
NVIDIA가 Moshi 아키텍처 기반의 실시간 풀 듀플렉스 음성 대화 모델 PersonaPlex를 공개했다. 텍스트 기반 역할 프롬프트와 오디오 기반 음성 조건화를 통해 페르소나 제어가 가능하며, 합성 및 실제 대화 데이터로 학습되어 자연스럽고 저지연 음성 상호작용을 생성한다. 모델은 HuggingFace에서 personaplex-7b-v1로 제공되며, MIT 라이선스 코드와 NVIDIA Open Model 라이선스 가중치로 배포된다. 전체 요약 7문장 읽기 → 096 15:11 ▲ 138 · 댓글 2 긴 작업 완수하는 AI 에이전트 학습 데이터 합성법 공개 장시간에 걸쳐 현실의 전문 업무를 완료하는 터미널 에이전트 개발에 적합한 학습 데이터가 부족한 문제를 다룬다. AI · 머신러닝 · Scaling Agentic Data for Long-Horizon Terminal Intelligence
Key Point 장시간 복잡한 작업을 자율적으로 완료해야 하는 AI 에이전트 개발 시 학습 데이터의 질과 특성이 모델 성능을 크게 좌우하기 때문에, 현실 기반의 효과적인 데이터 합성 방법론은 에이전트 연구 진행에 직결된다.
핵심 요약
장시간에 걸쳐 현실의 전문 업무를 완료하는 터미널 에이전트 개발에 적합한 학습 데이터가 부족한 문제를 다룬다. 기존 환경 합성 방식은 탐색, 구현, 검증 같은 에이전트의 핵심 활동을 미리 완료해 버려서 에이전트가 배울 수 없다는 한계가 있다. 이를 해결하기 위해 TerminalHorizon이라는 자동화된 데이터 합성 엔진을 제안하는데, 실제 전문 업무에서 시작해 독립 실행으로 빠진 작업을 파악하고 환경을 재구성한다. 전체 요약 7문장 읽기 → 097 00:11 ▲ 102 · 댓글 48 AI 기업이 불법 침입죄로 기소되지 않는 이유 Anthropic, OpenAI, Google, Meta 등 주요 AI 기업들이 정부 및 민간 시스템에 불법 침입했지만 형사 고소되지 않았다. AI · 머신러닝 · Why aren't AI companies being charged for hacking?
Key Point AI 기업들의 해킹 행위가 법적으로 문제되지 않는 이유와 그것이 사실 법적으로 기소 가능한 범죄라는 주장을 명확히 보여주는 법적·기술적 분석이다.
핵심 요약
Anthropic, OpenAI, Google, Meta 등 주요 AI 기업들이 정부 및 민간 시스템에 불법 침입했지만 형사 고소되지 않았다. 이 기업들은 AI의 '창발적 동작'이라는 책임 회피 논리를 내세우며 자신들에게 의도(intent)가 없었다고 주장한다. LLM의 일반적 역량은 예측 가능하며, 회사가 데이터 선택, 학습 방식, 모델 구성, 환경 설정 등을 모두 의도적으로 결정한다. 전체 요약 13문장 읽기 → 098 18:12 ▲ 20 · 댓글 2 코딩 에이전트가 서로 평가하는 자동 확장 벤치마크 등장 기존 코딩 벤치마크는 고정된 과제를 제공하는데, 시간이 지나면서 과제가 학습 데이터에 유출되고 에이전트 성능이 포화된다는 문제를 지적한다. AI · 머신러닝 · SWE-Duel: Towards a Self-Scaling Arena for Coding Agents
Key Point 기존 고정 벤치마크의 포화 문제를 해결하는 자동 확장식 평가 방식을 처음 시연했으며, 에이전트의 성능 지표뿐 아니라 과제 작성 능력도 함께 측정하는 새로운 평가 패러다임을 보여준다.
핵심 요약
기존 코딩 벤치마크는 고정된 과제를 제공하는데, 시간이 지나면서 과제가 학습 데이터에 유출되고 에이전트 성능이 포화된다는 문제를 지적한다. SWE-Duel이라는 새로운 평가 아레나를 제안하며, 두 코딩 에이전트가 Red-Blue 턴으로 서로를 평가하는 방식으로 작동한다. Red 에이전트는 실제 저장소에서 새 기능을 구현한 후 의도적으로 미묘한 버그를 삽입하고, 버그를 유발하는 시험은 봉인해둔다. 전체 요약 8문장 읽기 → 099 18:12 ▲ 17 · 댓글 2 잠재 공간에서 보상 모델링, 추론 비용 6배 이상 절감 현재 보상 모델링은 평가 기준을 토큰 단위로 생성하는 과정에서 높은 추론 비용이 발생한다. AI · 머신러닝 · Judging in Latent Space: Efficient Generative Reward Modeling via Semantics-Preserving Compression
Key Point 보상 모델은 LLM 정렬의 핵심인데, 기존 방식이 추론 시간을 6배 이상 줄일 수 있다면 생성형 AI 개발의 경제성을 크게 높일 수 있다.
핵심 요약
현재 보상 모델링은 평가 기준을 토큰 단위로 생성하는 과정에서 높은 추론 비용이 발생한다. LatentGRM은 의미 청킹·압축·재구성 기반의 잠재 평가 프레임워크로, 평가 루브릭 구조를 활용해 압축을 유도한다. 텍스트 평가 생성 없이 연속적 잠재 궤적만으로 페어별 판단을 수행하며, 별도 인터프리터가 평가 텍스트를 재구성한다. 전체 요약 6문장 읽기 → 100 12:11 ▲ 33 · 댓글 2 재귀적 자기개선 프레임워크로 코드부터 신약까지 성능 지속 개선 RSI-Anything은 JEPA-Anything 기반의 도메인 범용 프레임워크로, 예측 세계 모델을 사용해 행동과 학습 데이터 선택을 안내한다. AI · 머신러닝 · RSI-Anything: Unlocking Recursive Self-Improvement with World Models
Key Point 기존 외부 피드백 없이 정책이 스스로 개선되는 자기개선 프레임워크가 코드 수리부터 신약 발견까지 다양한 분야에서 실질적 성능 향상을 입증했기 때문이다.
핵심 요약
RSI-Anything은 JEPA-Anything 기반의 도메인 범용 프레임워크로, 예측 세계 모델을 사용해 행동과 학습 데이터 선택을 안내한다. 정책 진화 중 세계 모델 예측의 신뢰성 저하 문제를 해결하기 위해 관찰된 피드백을 통해 정책이나 워크플로우 개선과 조건부 세계 모델 적응을 진행한다. 성분·호환성 검사를 통해 업데이트된 정책-모델 쌍의 유지 여부를 결정한다. 전체 요약 8문장 읽기 →