매일 쌓이는 개발자의 시야
2026년 10월 9일 (금). 세상의 기술 소식, 한국어로 한눈에.
AI 요약 안내 AI가 한국어로 정리한 내용입니다. 정확한 정보는 각 카드의 원문을 확인해 주세요.
요약 원칙 ↗ 01 읽을 소식Hacker News 11건 ↓ 02 써볼 도구GitHub Trending 3건 ↓ 03 읽을 논문Hugging Face Papers 35건 ↓ 04 새 버전GitHub Releases 1건 ↓ AI · 머신러닝 분야 · 50건 필터 해제 ×
오늘의 주요포인트 상위 6건
01 AI · 머신러닝 06:11 게시
원제 Whistle: Speech to Text in 16.9 MB
341 포인트 댓글 79
Key Point 극도로 경량화한 음성인식 모델로 온디바이스 처리가 가능해져, 엣지 환경에서 사용할 수 있는 선택지가 생겼다.
핵심 요약
Cactus Compute가 모바일, 웨어러블, 로봇, 스마트홈, 자동차, 마이크로컨트롤러용 음성인식 모델 Whistle을 공개했다. Whistle은 16.9MB 단일 파일로, CPU에서 의존성 없이 작동하며 기존 Needle 엔진과 같은 C++ 컨테이너에서 동작한다. 7개 언어(영어, 독일어, 프랑스어, 스페인어, 이탈리아어, 네덜란드어, 폴란드어) 지원하며, 최대 30초 음성을 온디바이스에서 처리한다. 전체 요약 12문장 읽기 → 02 AI · 머신러닝 06:11 게시
원제 OpenAI annualised revenues $20B less than previously signalled
305 포인트 댓글 193
Key Point OpenAI의 실제 연간 매출이 보도되었던 것보다 18억 달러 낮으며, 공개 기업화를 앞두고 안전 우려까지 겹치면서 투자자의 신뢰도가 요동치는 상황을 보여준다.
핵심 요약
OpenAI가 9월 말 기준 연간 매출 약 50억 달러를 달성했다고 투자자에게 공시했으며, 이는 지난달 널리 보도된 68억 달러보다 18억 달러 낮은 수치다. 68억 달러 수치는 OpenAI의 파트너 회사들의 총수익을 포함한 것으로, 경쟁사 Anthropic과의 직접 비교를 용이하게 하기 위한 기준이었다. OpenAI는 3분기 총 실행 매출 성장률 77%, 기업 사업 성장률 107%를 기록했다고 밝혔다. 전체 요약 7문장 읽기 → 03 AI · 머신러닝 00:11 게시
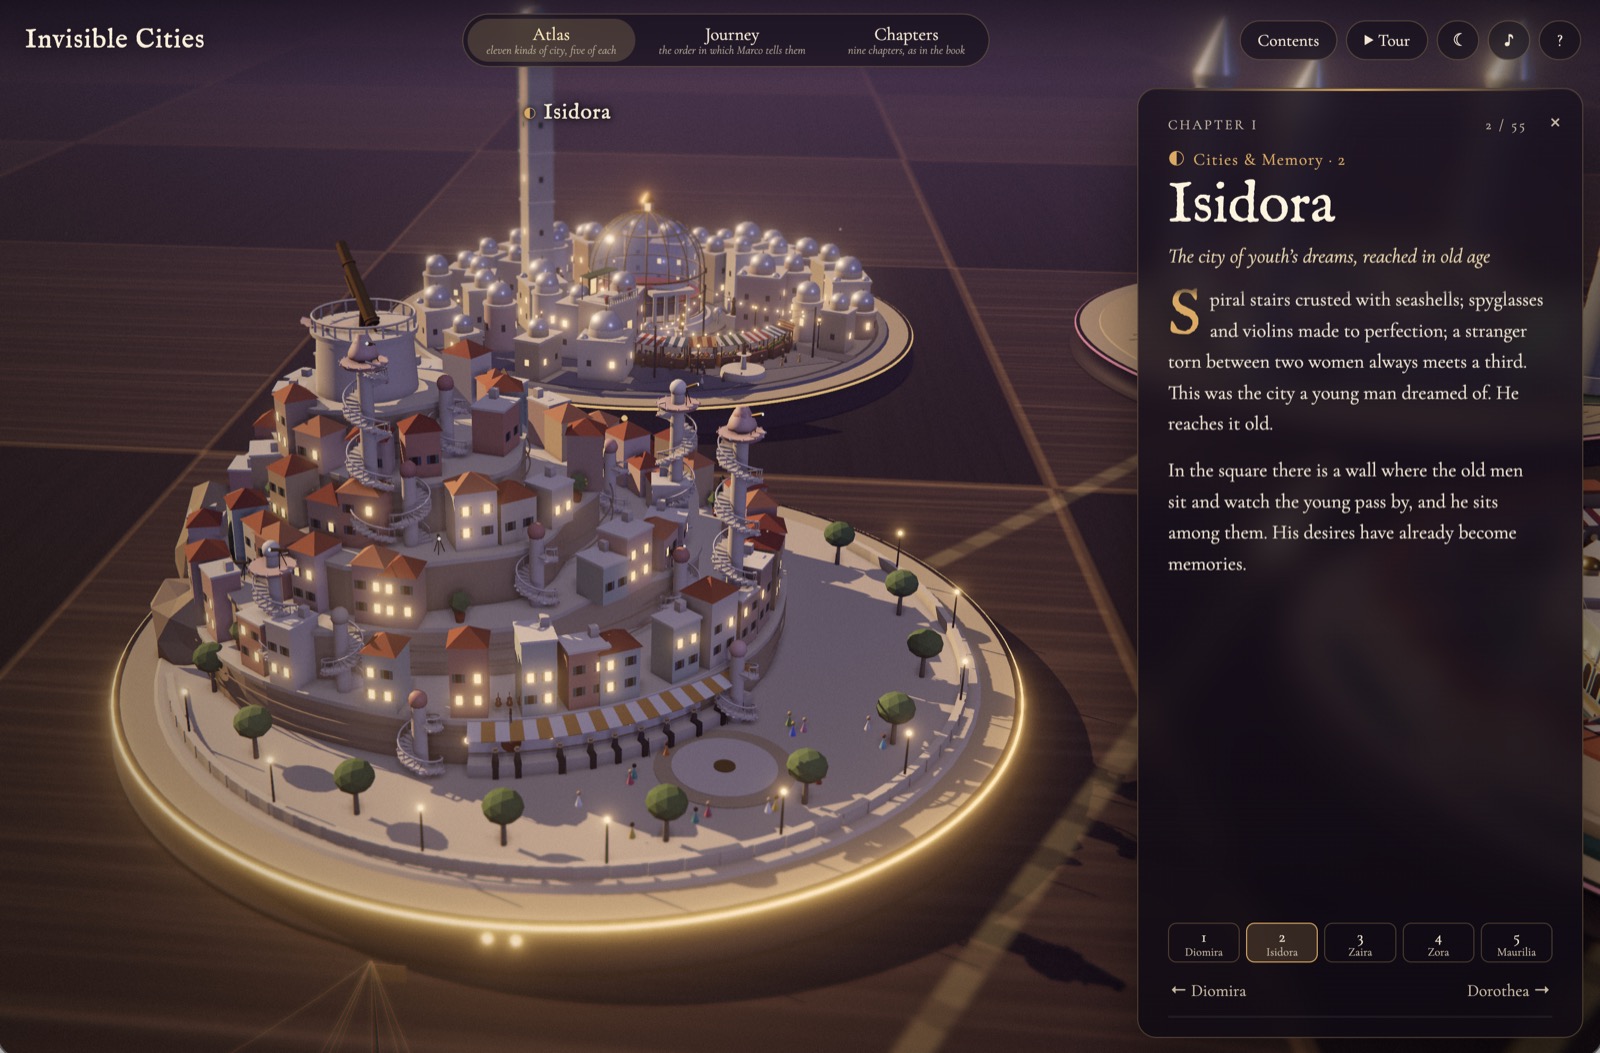
원제 I gave Opus 5.5 one prompt and six hours to visualize Invisible Cities
167 포인트 댓글 100
Key Point Claude Opus 5.5가 복잡한 인터랙티브 시각화를 단일 프롬프트로 생성하는 능력의 수준을 직접 테스트한 결과로, LLM이 데이터 시각화와 인터랙티브 디자인에 얼마나 실용적이 되었는지 보여준다.
핵심 요약
작성자는 Italo Calvino의 '보이지 않는 도시' 55개를 세계지도 형태로 시각화하는 작업을 GPT-6 Astra와 Claude Opus 5.5에 동일한 one-shot 프롬프트로 줬다. GPT-6 Astra는 53분에 약 $10의 API 비용으로 end-to-end 작동했지만, 불필요한 개념과 주석이 많아 시각적 노이즈가 있었고 Captain Obvious 식 설명이 있었다. Claude Opus 5.5는 지시대로 6시간을 모두 사용하지는 않았으나, 6개의 서브에이전트를 병렬로 실행하며 1시간 25분에 약 $74 비용으로 완성했다. 전체 요약 5문장 읽기 → 04 AI · 머신러닝 06:11 게시
원제 Why isn't the industry freaking out about DeepSeek 4.1 Flash?
143 포인트 댓글 119
Key Point 중국 LLM이 프론티어 모델과 대등한 성능을 1/100 가격에 제공하기 시작했으며, 이는 AI 비용 구조와 산업의 경제성을 근본적으로 재편할 수 있다.
핵심 요약
저자는 지난 한 달간 DeepSeek 4.1 Flash를 12개 프로젝트에서 헤비하게 사용했으며, Anthropic Opus와 구별할 수 없을 정도로 성능이 뛰어나면서 프론티어 모델보다 몇십 배 저렴하다고 밝혔다. DeepSeek는 Anthropic/OpenAI보다 1~2개월 뒤처져 있지만 같은 수준의 작업을 처리할 수 있으며, 개발자들은 성능보다 비용 대비 효율을 우선시하는 추세다. 현재의 LLM 성능이 충분히 좋아져서 최신 모델을 계속 쫓는 것이 불필요해졌으며, DeepSeek의 월 $10 구독으로 실질적으로 무제한 사용이 가능하다. 전체 요약 9문장 읽기 → 05 AI · 머신러닝 09:11 게시
원제 ADHD as a circadian rhythm disorder: evidence and implications for chronotherapy (2025)
128 포인트 댓글 97
Key Point ADHD 증상의 상당 부분이 실제로는 생체시계 불일치에서 비롯될 수 있으며, 기존 약물 대신 아침 햇빛·멜라토닌·고정 수면시간 같은 행동 중재만으로도 개선할 가능성이 있다는 점이 임상 진료에 구체적인 영향을 미칠 수 있기 때문이다.
핵심 요약
ADHD 환자의 73~80%가 지연된 수면-각성 사이클을 보이며, 성인은 멜라토닌 분비가 90분 늦고 아이들은 45분 늦게 시작된다. ADHD 환자는 늦은 저녁형 시간대, 블라운트되고 지연된 코르티솔 리듬, 더 작은 송과체, 약화된 시계유전자(BMAL1/PER2) 발현을 보인다. 성인 ADHD 환자에게 0.5mg 멜라토닌은 멜라토닌 분비를 88분 앞당겼고 ADHD 증상을 14% 감소시켰다. 전체 요약 10문장 읽기 → 06 AI · 머신러닝 12:11 게시
원제 US man given prison sentence for bot-farming music streams
127 포인트 댓글 204
Key Point AI 생성 음악으로 스트리밍 플랫폼을 대규모로 사기친 첫 유죄 사례로, 생성형 AI 시대 저작권 보호와 스트리밍 시스템의 적절성에 대한 문제를 드러낸다.
핵심 요약
미국 노스캐롤라이나 주의 뮤지션 마이클 스미스(54세)가 봇 스트리밍으로 인한 음악 사기혐의로 징역 18개월 선고받고 부정 적립 로열티 800만 달러 반납을 명령받았다. 스미스는 2017년부터 2024년 체포까지 약 10,000개의 거짓 계정을 생성해 자신의 AI 생성 음악을 자동으로 스트리밍했다. 그는 수십억 건의 봇 스트림을 통해 수백만 곡의 AI 생성 곡을 배포했으며, 한 곡에 대한 의심스러운 스트림 패턴이 적발되지 않도록 수천 곡에 걸쳐 자동화된 스트림을 분산시켰다. 전체 요약 5문장 읽기 → 전체 색인5건 · 분야별
AI · 머신러닝5건 001 18:11 ▲ 109 · 댓글 124 AI 시대 수학 박사과정, 지금 시작해도 괜찮을까 수학과 대학원 진학을 포기하는 학생들이 늘고 있다. LLM의 급속한 발전으로 수학 연구 능력이 초인적 수준에 도달할까, AI가 수학자 일자리를 빼앗을까 우려한다. AI · 머신러닝 · What should we tell our students?
Key Point LLM의 급속한 발전으로 수학 박사과정 진학을 망설이는 학생들이 직면한 불안감에 대해, 실제 문제와 과장된 주장을 구분하고 어떻게 대응해야 할지 안내하는 수학자의 구체적인 조언을 담고 있다.
핵심 요약
수학과 대학원 진학을 포기하는 학생들이 늘고 있다. LLM의 급속한 발전으로 수학 연구 능력이 초인적 수준에 도달할까, AI가 수학자 일자리를 빼앗을까 우려한다. 저자는 AI 기업들이 자사의 이익을 위해 LLM 능력을 과장하고 있다고 지적한다. 예를 들어 OpenAI는 Navier-Stokes 문제 해결에 약 1500만 달러를 투자했지만, 다른 밀레니엄 난제 해결 실패에 드는 비용을 공개하지 않는다. LLM은 현재 기존 문헌에 포함된 아이디어의 볼록껍질 내에서만 작동한다고 본다. Erdős의 단위거리 추측 반박은 기하학과 대수적 수론의 기존 아이디어를 결합한 것으로, Riemann 가설처럼 완전히 새로운 개념이 필요한 문제 해결은 불가능하다. 전체 요약 11문장 읽기 → 002 18:11 ▲ 114 · 댓글 161 OpenAI의 백년 난제 풀이, 수학자들이 분노한 이유 OpenAI가 분할 원리(Partition Principle)가 선택 공리를 함축하지 않는다는 수학적 난제를 풀었다고 발표했다. AI · 머신러닝 · OpenAI, the Partition Principle, and Mathematics
Key Point 학계의 품질 기준 없이 AI가 '성과'를 발표하는 방식이 어떻게 대중과 정책 입안자에게 왜곡된 인상을 주는지, 수학자가 직접 질타한 사례이다.
핵심 요약
OpenAI가 분할 원리(Partition Principle)가 선택 공리를 함축하지 않는다는 수학적 난제를 풀었다고 발표했다. 집합론 전문가인 저자는 OpenAI의 논문을 검토한 결과 문장 구조가 혼란스럽고 용어가 부정확하며 이해하기 어렵게 작성되었다고 지적했다. 논문은 미출판된 강의 노트를 참고 자료로 사용하고 있으며, 심지어 저자의 논문을 잘못된 목적으로 인용하는 등 학술 기준을 따르지 않고 있다. 전체 요약 8문장 읽기 → 003 15:13 ▲ 105 · 댓글 14 생물학 AI 모델 학습용 데이터 구축에 18억 달러 투자 Biohub, 미국 에너지부(DOE), 국립보건원(NIH), Google DeepMind, Isomorphic Labs, Meta 등이 참여해 AI 학습용 생물학 데이터를 생성·공개하기 위해 총 18억 달러를 투자하기로 발표했다. AI · 머신러닝 · AI-ready biological data: $1.8B global commitment
Key Point 가상 세포 구축 같은 대규모 협력으로 생물학 AI 모델의 데이터 기초를 마련하려는 움직임이 전 세계 과학 연구와 신약 개발 속도를 크게 바꿀 수 있기 때문이다.
핵심 요약
Biohub, 미국 에너지부(DOE), 국립보건원(NIH), Google DeepMind, Isomorphic Labs, Meta 등이 참여해 AI 학습용 생물학 데이터를 생성·공개하기 위해 총 18억 달러를 투자하기로 발표했다. DOE는 5년간 5억 달러 이상을 투자해 측정·모델링·컴퓨팅에 나가고, NIH는 과거 5억 달러 이상 투자로 개발한 데이터셋과 리포지토리를 제공하며, Biohub은 이를 AI 학습용으로 표준화한다. Google DeepMind, Isomorphic Labs, Meta는 3억 달러를 투자해 가상생물학 이니셔티브(Virtual Biology Initiative)에서 멀티모달 데이터셋 및 생명 예측 모델 기술을 개발한다. 전체 요약 9문장 읽기 → 004 12:11 ▲ 111 · 댓글 25 스텝펀의 1백만 토큰 초대형 컨텍스트 모델 Step 5 Preview 공개 스텝펀이 에이전틱 작업 전용 플래그십 모델 Step 5 Preview를 OpenRouter를 통해 공개했다. AI · 머신러닝 · Step 5 Preview, a 1M-context MoE from StepFun, shows up on OpenRouter
Key Point 1백만 토큰의 초대형 컨텍스트로 긴 문서와 코드베이스를 한 번에 처리할 수 있어, AI 에이전트 구축과 복잡한 소프트웨어 엔지니어링 작업을 크게 단순화한다.
핵심 요약
스텝펀이 에이전틱 작업 전용 플래그십 모델 Step 5 Preview를 OpenRouter를 통해 공개했다. 27B 활성/600B 총 파라미터의 스파스 Mixture-of-Experts 아키텍처로 설계되었으며, 소프트웨어 엔지니어링과 재무 분야에서 강점을 보인다. 1,000,000 토큰의 초대형 컨텍스트 윈도우를 지원하며 최대 64,000개의 생성 토큰을 처리할 수 있다. 전체 요약 10문장 읽기 → 005 09:11 ▲ 122 · 댓글 52 AI 시대에도 프로그래밍은 여전히 배워야 할 가치가 있다 대학 교수인 저자는 학생들의 '프로그래밍을 배워야 하나'는 질문에 '그렇다. 그리고...'라고 답한다. AI · 머신러닝 · Yes, and
Key Point AI 시대에 프로그래밍 전공이 여전히 가치 있는 경로인지에 대한 실질적인 조언과 함께, 코딩 능력의 본질이 무엇인지, 초급자가 AI를 피해야 하는 이유, 미래에 개발자에게 필요한 역량이 무엇인지 명확히 보여준다.
핵심 요약
대학 교수인 저자는 학생들의 '프로그래밍을 배워야 하나'는 질문에 '그렇다. 그리고...'라고 답한다. 프로그래밍의 본질은 문제 해결과 복잡도 제어이며, AI가 등장해도 이 능력의 가치는 줄어들지 않을 것이다. 다만 AI가 코드를 생성할 수 있다는 점은 초급 개발자에게 위험하다: 직접 코드를 작성하지 않으면 코드를 읽고 이해할 수 없게 되기 때문이다. 전체 요약 11문장 읽기 → 오늘의 주요당일 스타 상위 3건
01 AI · 머신러닝 21:11 게시
CursorTouch/Windows-MCP
원제 CursorTouch/Windows-MCP
스타 8,406 당일 +360 Python
Key Point AI 에이전트가 Windows 데스크톱을 네이티브하게 조종할 수 있는 오픈소스 표준이 등장했으며, 개발자들은 이를 자동화나 AI 통합 프로젝트에 즉시 활용할 수 있다.
핵심 요약
Windows-MCP는 LLM 기반 AI 에이전트가 Windows OS와 상호작용하도록 하는 경량 오픈소스 MCP 서버다. 파일 탐색, 애플리케이션 제어, UI 상호작용, QA 테스트 등의 작업을 자동화할 수 있으며, 컴퓨터 비전이나 특정 모델 학습 없이 모든 LLM과 호환된다. Python 3.13+ 환경에서 실행되며, Claude Desktop, Cursor, Perplexity, Gemini CLI 등 다양한 MCP 클라이언트에 연동 가능하고, PyPI를 통해 `uvx windows-mcp`로 설치할 수 있다. 전체 요약 9문장 읽기 → 02 AI · 머신러닝 21:11 게시
Vincentwei1021/video-shotcraft
원제 Vincentwei1021/video-shotcraft
스타 13,489 당일 +196 TypeScript
Key Point AI가 제품 영상을 완전 자동으로 제작하고 웹에서 바로 편집할 수 있는 프로덕션 도구가 오픈소스로 공개됐으며, 기업 마케팅 영상 제작 방식이 크게 바뀔 가능성을 보여준다.
핵심 요약
Claude Code나 Codex용 AI 에이전트 스킬로, 제품 스크린샷과 설명을 입력하면 Remotion 기반 영상을 자동 제작하는 도구다. 152장의 샷 레시피 카드, 214개 모션 프리뷰, 9가지 필름 테마(Ink Press, Modern Light, Midnight 등)를 제공한다. 스토리보딩, 2.5D 카메라 움직임, 비트 싱크 컷, 영화급 음향 설계가 자동으로 적용되며, 템플릿은 36.2초 1920×1080 30fps 완성본으로 검증됐다. 전체 요약 11문장 읽기 → 03 AI · 머신러닝 21:11 게시
docker/docker-agent
원제 docker/docker-agent
스타 4,338 당일 +144 Go
Key Point AI 에이전트를 YAML로 선언적으로 정의하고 실행하는 도구가 등장해, 복잡한 멀티에이전트 시스템을 코드 없이 구축할 수 있게 되었다.
핵심 요약
Docker가 AI 에이전트 구축 및 실행 도구인 docker-agent를 오픈소스로 공개했다. YAML 설정 파일만으로 코드 없이 AI 에이전트를 정의하고 실행할 수 있으며, docker CLI 플러그인으로 `docker agent` 명령으로 사용한다. 다중 에이전트 아키텍처를 지원해 여러 전문화된 에이전트가 자동으로 작업을 분배하고 협력하며 복잡한 문제를 해결할 수 있다. 전체 요약 10문장 읽기 → 읽을 논문
Hugging Face Papers35 커뮤니티가 고른 오늘의 AI 논문
오늘의 주요추천 상위 3건
01 AI · 머신러닝 12:11 게시
원제 AgentGarten: Code Worlds for Evolving Agents
추천 226 댓글 3 Jiawei Chi, Shangchen Miao, Zhiyuan Shi 외
Key Point 기존 강화학습은 수백만 번의 상호작용이 필요하지만 AgentGarten은 4라운드만으로 에이전트를 학습시키므로, AI 에이전트의 훈련 효율을 획기적으로 높이는 방법론이다.
핵심 요약
AgentGarten은 시뮬레이터·게임 엔진과 신경 렌더러를 결합하여 실시간 상호작용 환경을 구축하는 프레임워크다. 시뮬레이션 백엔드는 지속적인 월드 상태를 유지하고 프로그램 정의 규칙을 실행하며, 렌더러는 공통 인터페이스를 통해 구조화된 조건으로부터 시각 관찰을 생성한다. 신경 렌더러는 사전학습된 비디오 모델을 기하학 조건에 맞춰 적응시키고, 제안된 Adversarial Forcing으로 증류하며, 실시간 상호작용을 위해 추론을 최적화한다. 전체 요약 7문장 읽기 → 02 AI · 머신러닝 12:11 게시
원제 Self-Retrospection Distillation: Turning Post-hoc Experiences into Prior Foresight
추천 140 댓글 2 Haoxiang Zhang, Qinglin Chen, Hiroaki Hayashi 외
Key Point 보상 신호가 부족한 강화학습 상황에서 과거 경험으로 예측력을 높이는 새로운 접근법은 장기 작업 에이전트와 추론 기반 AI 개발에 직결되는 개선 기법이다.
핵심 요약
강화학습에서 보상이 없거나 희소할 때 에이전트가 학습 신호를 얻기 어려운 문제를 다룬 논문이다. 기존 RLVR(검증 가능 보상 강화학습) 방식은 스칼라 보상만으로 신호를 만들어 그룹 상대 목표에서 모든 시도가 같은 보상받으면 실패한다. 저자는 "Self-Retrospection Distillation(SRD)" 기법을 제안해 이미 완료된 궤적(trajectory)의 정보를 사전 예측 학습에 활용한다. 전체 요약 8문장 읽기 → 03 AI · 머신러닝 15:13 게시
원제 Learn2Play Bench: How Well Do LLM Agents Learn from Experience in Unfamiliar Environments?
추천 136 댓글 3 Yibo Li, Jinhang Qiu, Zhi Zheng 외
Key Point LLM 에이전트가 실제 환경에서 경험으로부터 학습하는 능력의 객관적 평가 방법과 한계를 제시하며, 완전한 기록 유지의 중요성과 인간-에이전트 간 격차를 명확히 한다.
핵심 요약
LLM 에이전트가 낯선 환경에서 경험을 통해 얼마나 잘 학습하는지 평가하기 위해 Learn2Play Bench 벤치마크를 제시한다. 기존 벤치마크들은 규칙이 지시문에 명시되거나 모델의 사전학습 지식에 포함된 과제를 주로 평가해 상호작용을 통한 학습과 기존 지식의 추론을 구분하기 어려웠다. Learn2Play Bench는 새롭거나 직관에 반하는 규칙을 가진 텍스트 기반 게임들로 구성되어 에이전트가 사전학습 지식에만 의존하지 않고 상호작용을 통해 지식을 습득해야 한다. 전체 요약 5문장 읽기 → 전체 색인32건 · 분야별
AI · 머신러닝32건 001 16:56 ▲ 129 · 댓글 2 토큰 단위 LLM 라우팅을 위한 고효율 서빙 시스템 LLM 라우팅은 추론 작업을 여러 모델에 분산해 비용과 품질 사이의 최적점을 개선하는 기술로, 기존 시스템은 쿼리 단위의 굵은 라우팅만 지원했다. AI · 머신러닝 · TokenRouter: Efficient Serving System for Token-Level LLM Routing
Key Point 토큰 단위로 여러 모델을 동적으로 선택하는 고급 라우팅 기법을 실제로 빠르게 처리할 수 있는 시스템이 처음 등장했기 때문이다.
핵심 요약
LLM 라우팅은 추론 작업을 여러 모델에 분산해 비용과 품질 사이의 최적점을 개선하는 기술로, 기존 시스템은 쿼리 단위의 굵은 라우팅만 지원했다. 최근 연구는 토큰 단위의 세밀한 라우팅이 효율성과 품질에서 큰 이득을 줄 수 있음을 보였지만, 기존 LLM 서빙 시스템은 단일 모델 가정 위에 설계되어 토큰 단위 라우팅에서 심각한 동기화 문제와 배치 지연을 겪는다. TokenRouter는 요청 중심 프로그래밍, 모델 중심 실행 원칙을 따르며, 개발자는 단일 요청 관점에서 라우팅 로직을 기술하고 런타임이 각 LLM마다 서브서버를 실행해 비동기로 요청을 분배한다. 전체 요약 6문장 읽기 → 002 21:11 ▲ 39 · 댓글 6 언어모델의 불확실성을 해석 가능하게 측정하는 'U-Space' 제안 대형 언어모델이 고위험 결정을 내릴 때 그 답변의 신뢰도를 판단하기 어렵다는 문제가 제기되고 있다. AI · 머신러닝 · U-Space: Uncovering When and Why Uncertainty Arises in Language Models
Key Point 언어모델이 제시하는 답변의 신뢰도를 판단하고 잘못된 결론을 피해야 하는 상황에서, 해석 가능한 불확실성 측정 방법이 제시됨에 따라 모델 신뢰성 평가 방식이 달라질 수 있다.
핵심 요약
대형 언어모델이 고위험 결정을 내릴 때 그 답변의 신뢰도를 판단하기 어렵다는 문제가 제기되고 있다. 기존 불확실성 정량화 방법은 반복 생성이나 별도 학습이 필요하고, 불확실성이 어디서 발생하는지 보여주지 못한다. 생성 길이가 불확실성 추정과 정답률과 강하게 연관되어 있어서, 추정기가 불확실성 정보인지 단순히 길이 정보인지 구분하기 어렵다. 전체 요약 8문장 읽기 → 003 21:11 ▲ 17 · 댓글 2 긴 맥락 LLM을 위한 스파스 추론 엔진 'SparseEngine' 공개 긴 상호작용 이력을 축적하는 LLM 에이전트는 KV-캐시 메모리와 어텐션 연산 부하가 증가하는 문제를 겪고 있다. AI · 머신러닝 · SparseEngine: Sparse-First Inference Engine
Key Point 긴 맥락 LLM 에이전트의 메모리 부하와 계산 비용을 획기적으로 줄이면서 기존 추론 엔진과 호환되는 첫 번째 스파스 우선 엔진으로, 실무 배포 환경에서 즉시 활용 가능한 성능 개선을 제공한다.
핵심 요약
긴 상호작용 이력을 축적하는 LLM 에이전트는 KV-캐시 메모리와 어텐션 연산 부하가 증가하는 문제를 겪고 있다. 기존 스파스 어텐션 방식들은 이질적인 캐시 표현과 워크플로우로 인해 기존 추론 엔진 통합이 어렵고, 특정 레이아웃이나 워크플로우만 지원한다. SparseEngine은 스파스 우선 설계의 추론 엔진으로, 공유된 생명주기 계약을 통해 각 방식이 KV 표현과 연산을 독립적으로 제어하면서도 공통 인프라와 상태 전환을 조율할 수 있다. 전체 요약 6문장 읽기 → 004 21:11 ▲ 15 · 댓글 2 멀티모달 AI의 약점을 파헤치는 평가 프레임워크 등장 음성-영상 동시 처리 능력을 갖춘 멀티모달 대형 언어모델(MLLM)의 성능 평가가 시급해지면서 새로운 벤치마크가 필요했다. AI · 머신러닝 · OmniCapBench: A Deep-Structured Evaluation Framework for Fine-Grained Audio-Visual Captioning
Key Point 음성·영상 멀티모달 AI의 개발이 가속화되는 상황에서 실제 약점을 구분해 측정할 수 있는 평가 방법론이 처음 제시되어, 향후 MLLM 개선 방향을 좌우할 기준점이 될 것이다.
핵심 요약
음성-영상 동시 처리 능력을 갖춘 멀티모달 대형 언어모델(MLLM)의 성능 평가가 시급해지면서 새로운 벤치마크가 필요했다. 기존 벤치마크는 전체 캡션 점수는 포괄성 있지만 세부 위치 정보가 없거나, 부분 검증은 정확하지만 전체 흐름을 놓치는 문제가 있었다. 연구팀은 OmniCapBench를 개발해 평가 대상을 자유로운 텍스트에서 검증 가능한 원자 단위로 변경했다. 전체 요약 7문장 읽기 → 005 18:11 ▲ 21 · 댓글 2 추론 능력이 필요한 이미지 편집, 벤치마크와 해법 제시 대규모 멀티모달 모델(LMM)이 시각 이해와 생성에는 진전했지만, 복잡한 지시 이해, 외형 일관성 보존, 유연한 입력 형식 지원에서 이미지 편집 능력이 부족하다. AI · 머신러닝 · Reasoning-Informed Visual Editing
Key Point 복잡한 지시에 따라 이미지를 편집하는 능력이 LMM의 주요 약점임을 정량화한 첫 벤치마크이며, 현 최고 모델도 56%대 정확도에 불과해 이 분야의 개선이 얼마나 필요한지 보여준다.
핵심 요약
대규모 멀티모달 모델(LMM)이 시각 이해와 생성에는 진전했지만, 복잡한 지시 이해, 외형 일관성 보존, 유연한 입력 형식 지원에서 이미지 편집 능력이 부족하다. 이 문제를 연구하기 위해 추론 기반 시각 편집(RISE)을 평가하는 RISEBench 벤치마크를 개발했고, 더 포괄적인 RISEBench++로 확장했다. RISEBench++는 시간적·인과적·공간적·논리적·반사실적 추론과 다중 추론을 통합한 하이브리드 추론 등 6개 차원으로 계층화되어, 12개 세부 카테고리와 65개 세분화 과제로 구성된다. 전체 요약 8문장 읽기 → 006 18:11 ▲ 18 · 댓글 2 캔버스 지시로 이미지 편집하는 VibeEdit 텍스트 기반 이미지 편집에서 변경 내용을 설명하기는 쉽지만 대상 객체나 영역을 명확히 지정하기는 어려운데, 특히 비슷해 보이는 객체가 여럿 있을 때 그렇다. AI · 머신러닝 · VibeEdit: Image Editing with Canvas Instructions
Key Point 유사한 객체 여럿 중에서 정확히 어떤 것을 편집할지 지정하는 문제를 시각적 주석으로 해결하면서 성능 지표에서 기존 방식을 크게 앞선다.
핵심 요약
텍스트 기반 이미지 편집에서 변경 내용을 설명하기는 쉽지만 대상 객체나 영역을 명확히 지정하기는 어려운데, 특히 비슷해 보이는 객체가 여럿 있을 때 그렇다. VibeEdit는 사용자가 이미지에 직접 공간적 표시와 선택적 짧은 메모를 남기는 새로운 편집 인터페이스를 제공하며, 이 주석들이 함께 캔버스 지시를 형성한다. 별도 텍스트 프롬프트 없이 객체 추가, 제거, 교체, 속성 수정, 이동 등을 수행한다. 전체 요약 8문장 읽기 → 007 18:11 ▲ 18 · 댓글 2 LLM이 3D 로봇 부품 설계 자동화, 불완전한 모델도 복원 시뮬레이션에서 학습한 로봇 조작 정책을 현실 물체에 적용하려면 기하학적으로 정확한 관절형 3D 자산이 필수인데, 기존 메시 기반 방법은 학습 데이터 분포 밖의 물체나 손상된 메시에서 관절 정보 추론에 실패하곤 한다. AI · 머신러닝 · USDCraft: Geometrically Grounded Programmatic Modeling of Articulated 3D Assets for Simulation
Key Point 불완전하거나 손상된 3D 모델에서도 로봇 시뮬레이션용 정확한 관절 정보를 자동으로 복원할 수 있어, 현실의 다양한 물체로 로봇 학습을 확장하는 병목이 해결된다.
핵심 요약
시뮬레이션에서 학습한 로봇 조작 정책을 현실 물체에 적용하려면 기하학적으로 정확한 관절형 3D 자산이 필수인데, 기존 메시 기반 방법은 학습 데이터 분포 밖의 물체나 손상된 메시에서 관절 정보 추론에 실패하곤 한다. USDCraft는 사전학습된 LLM이 부분적 기하 정보를 바탕으로 시뮬레이션 준비가 된 관절형 자산을 위한 프로그램을 작성·수정하도록 하는 프레임워크로, 작업별 파인튜닝이 필요 없다. 기하 소스 분석으로 메시를 관찰된 표면과 미지 공간을 구분하는 텍스트 설명으로 변환하고, 반복적 기하 재검증으로 각 프로그램 후보를 같은 형식으로 재인코딩해 불일치 지점을 찾아낸다. 전체 요약 5문장 읽기 → 008 18:11 ▲ 38 · 댓글 2 편집과 생성 작업을 위한 통합 대응점 매칭 프레임워크 FreeMatching Dense correspondence matching은 매끄러운 움직임과 강체 기하학 같은 시공간 제약에 의존해왔으나, 이미지 편집과 참고 기반 생성(IEG) 작업에서 물리적 연속성을 무시하면서 시각적 정체성을 보존하는 변환에는 대응하지 못함. AI · 머신러닝 · Beyond Spatio-Temporal Priors: A Generalizable Approach for Dense Correspondence Matching
Key Point 생성형 AI의 이미지 편집과 참고 기반 생성 작업에서 객체 정체성을 유지하면서 변환된 이미지 간 대응점을 찾는 근본적 문제에 새로운 해법을 제시해, 콘텐츠 생성 도구의 질적 개선에 직결된다.
핵심 요약
Dense correspondence matching은 매끄러운 움직임과 강체 기하학 같은 시공간 제약에 의존해왔으나, 이미지 편집과 참고 기반 생성(IEG) 작업에서 물리적 연속성을 무시하면서 시각적 정체성을 보존하는 변환에는 대응하지 못함. FreeMatching은 생성 모델과 의미론적 파운데이션 표현(semantic foundation representation)을 결합해, 고전 데이터셋·추적 비디오·합성 장면으로부터의 다양한 감독 신호를 활용해 정체성 보존 대응점을 학습하는 프레임워크. 교사 모델 가이드 반복 정제(teacher-guided iterative refinement) 기법을 통해 대응점 주석 없이도 IEG 작업에서 대응점 품질을 추가 개선. 전체 요약 6문장 읽기 → 009 18:11 ▲ 24 · 댓글 2 시각 정보로 깊이 있는 조사를 하는 AI 에이전트 OneSearch-VL 이미지·동영상 등 다양한 시각 자료를 사용한 깊이 있는 조사 작업을 통합으로 처리하는 멀티모달 AI 에이전트 OneSearch-VL을 발표했다. AI · 머신러닝 · OneSearch-VL: Unified Multimodal Deep Research Agent for Image and Video
Key Point 시각 정보를 활용한 복잡한 조사 작업을 자동화하는 에이전트 기술의 새로운 접근법이며, 이미지와 동영상을 다루는 멀티모달 AI의 핵심 과제인 시각적 근거 추적을 해결했다.
핵심 요약
이미지·동영상 등 다양한 시각 자료를 사용한 깊이 있는 조사 작업을 통합으로 처리하는 멀티모달 AI 에이전트 OneSearch-VL을 발표했다. 시각적 위치 파악, 외부 검색, 사실 종합이라는 공통 워크플로우를 따르지만, 단일 이미지·다중 이미지·동영상마다 다른 시각 연산이 필요한 문제를 해결한다. 핵심은 시각적으로 위치를 파악한 근거 그래프(VGEG)로, 시각 앵커·개체 관계·출처 기반 사실·연산 작업 간의 의존성을 인코딩해 데이터 구성·과정 감시·연산 평가에 공통으로 쓸 수 있게 했다. 전체 요약 7문장 읽기 → 010 15:13 ▲ 20 · 댓글 3 장시간 자율 에이전트의 중요 결정 추적, EBG 방식 제안 에이전트가 장시간 작업을 수행할 때 사용자는 개별 의사결정에서 자율 실행 감시로 전환하는데, 방대한 에이전트 활동과 증거의 분산으로 인해 검증이 필요한 결정을 파악하기 어렵다. AI · 머신러닝 · What Did the Agent Actually Do? Evidence-Grounded Oversight for Long-Horizon Agents
Key Point AI 에이전트가 장시간 독립적으로 작업할 때 사용자가 무엇을 해야 하는지 알 수 없는 문제를 해결하는 기술이 등장했기 때문입니다.
핵심 요약
에이전트가 장시간 작업을 수행할 때 사용자는 개별 의사결정에서 자율 실행 감시로 전환하는데, 방대한 에이전트 활동과 증거의 분산으로 인해 검증이 필요한 결정을 파악하기 어렵다. 연구팀은 중요한 결정을 식별하고 증거를 위치시켜 사용자의 판단을 돕는 모니터를 연구했다. 소프트웨어 엔지니어링 벤치마크 AgentMonBench를 소개하며, 요구사항과 동작의 정렬, 검증을 위한 중요 자율 결정의 인식이라는 두 측면을 다룬다. 전체 요약 6문장 읽기 → 011 15:13 ▲ 74 · 댓글 2 강화학습으로 스스로 개선하는 초대형 모델 MiMo-V2.6 공개 Hugging Face와 협력 연구팀이 강화학습(RL) 규모를 확대하여 초대형 기초 모델의 자기 개선을 가능하게 하는 MiMo-V2.6 시리즈를 발표했다. AI · 머신러닝 · MiMo-V2.6: Scaling Reinforcement Learning Towards Self-Improvement
Key Point 장기 시퀀스 처리와 복합 작업에서 초대형 모델이 스스로 개선되도록 하는 RL 확장 기법이 어떻게 작동하는지, 그 구체적인 구현과 한계를 다루기 때문에 모델 개선 연구자와 개발자가 참고할 수 있다.
핵심 요약
Hugging Face와 협력 연구팀이 강화학습(RL) 규모를 확대하여 초대형 기초 모델의 자기 개선을 가능하게 하는 MiMo-V2.6 시리즈를 발표했다. RL 훈련 전에 다양한 멀티모달 데이터를 이용해 중간 학습을 수행하고, 하이브리드 SWA 구조의 사전학습 모델을 기반으로 확장 가능한 인프라를 구축했다. RL 계산을 세 가지 방향으로 확장했다: (1) 비동기 훈련으로 스텝당 1,568개 샘플과 2.7~3.7B 토큰 처리, 최대 1M 길이 컨텍스트 지원, (2) 코드·일반·시각·사이버 도메인을 포함한 다양한 환경과 에이전트 구성, (3) 그룹별 에이전트 채점으로 장기 작업의 정확한 보상 신호와 토큰 효율성 개선. 전체 요약 6문장 읽기 → 012 15:13 ▲ 42 · 댓글 3 LLM 기초 이론을 담은 교과서 출판 대규모 언어모델의 기초 개념을 다루는 교과서가 출판되었다. AI · 머신러닝 · Foundations of Large Language Models
Key Point 기초부터 체계적으로 LLM을 학습하고 싶은 개발자와 학생들에게 학습 가이드가 될 수 있는 자료다.
핵심 요약
대규모 언어모델의 기초 개념을 다루는 교과서가 출판되었다. 사전학습, 생성 모델, 프롬프팅, 정렬, 추론 등 6개 주요 영역을 구조적으로 설명한다. 최신 기술의 완전한 커버리지보다는 기초 개념 학습에 중점을 두었다. 전체 요약 4문장 읽기 → 013 15:13 ▲ 42 · 댓글 2 정적인 3D 장면을 무한 반복되는 영상으로, OuroWorld 정적인 3D Gaussian Splatting 장면을 마스크 없이 동적인 3D 시네마그래프로 변환하는 OuroWorld 프레임워크를 제안했다. AI · 머신러닝 · OuroWorld: Bringing Any 3D World Alive as Diverse, Endlessly Looping 3D Cinemagraphs
Key Point 정적인 3D 장면 생성의 한계를 극복하고 실시간 탐색 가능한 동적 시네마그래프를 만드는 기술로, 3D 콘텐츠 제작의 새로운 가능성을 열 수 있다.
핵심 요약
정적인 3D Gaussian Splatting 장면을 마스크 없이 동적인 3D 시네마그래프로 변환하는 OuroWorld 프레임워크를 제안했다. 비전-언어 모델이 장면에 적합한 동작을 유추하고 비디오 모델이 참조 비디오를 생성하며, 이를 다시점 비디오로 확장된다. Fourier 급수 변형 필드와 Grounded Drift Field를 결합한 Inconsistency-Robust Periodic 4DGS를 통해 완벽한 루프를 보장하면서도 다시점 간의 불일치를 흡수한다. 전체 요약 6문장 읽기 → 014 15:13 ▲ 38 · 댓글 2 확산 변환기의 희소 주의 문제, 훈련 없이 해결 확산 변환기에서 긴 시퀀스 생성(영상, 3D 자산)을 가속할 때 희소 주의를 쓰면 생성 품질이 떨어지는 문제가 있다. AI · 머신러닝 · MC-Sparse: Deconstructing and Closing the Dense-Sparse Attention Gap in Diffusion Transformers
Key Point 긴 시퀀스 생성 작업의 병목인 희소 주의의 품질 저하 문제를 훈련 없이 근본적으로 해결해 실용적 가속을 달성했다.
핵심 요약
확산 변환기에서 긴 시퀀스 생성(영상, 3D 자산)을 가속할 때 희소 주의를 쓰면 생성 품질이 떨어지는 문제가 있다. 연구팀은 품질 저하 원인을 세 가지로 분석했다: 토큰 그룹화 제약, 부정확한 상호작용 선택, 폐기된 토큰의 주의 기여 손실이다. 이를 바탕으로 메타 캐시 희소 주의(MC-Sparse)를 제안했다. 훈련이 필요 없는 프레임워크로, 개별 키-값 토큰을 선택하면서 유사한 쿼리들을 타일 정렬 그룹으로 묶어 GPU 실행을 효율화한다. 전체 요약 6문장 읽기 → 015 15:13 ▲ 34 · 댓글 2 단일 참조 코드만으로는 테스트를 평가할 수 없다 LLM 코딩 에이전트가 생성한 테스트를 단일 참조 솔루션으로만 평가하면 다른 유효한 구현을 놓치고 테스트 품질을 과대평가할 수 있다. AI · 머신러닝 · TestPrism: Rethinking Test Evaluation Beyond a Single Reference
Key Point 코딩 테스트 생성의 실제 평가 방식이 얼마나 부정확한지 보여주며, 다양한 구현을 검증해야 하는 테스트 생성 연구의 새로운 기준을 제시한다.
핵심 요약
LLM 코딩 에이전트가 생성한 테스트를 단일 참조 솔루션으로만 평가하면 다른 유효한 구현을 놓치고 테스트 품질을 과대평가할 수 있다. 이를 해결하기 위해 300개 테스트 과제와 3000개 후보 구현(유효/무효 각 50%)으로 구성한 TestPrism 벤치마크를 제안한다. TestPrism의 핵심 메트릭인 Joint Success Function은 생성된 테스트가 초기 프로그램에서 실패하고, 모든 유효한 후보는 수용하며, 모든 무효한 후보는 거부해야 한다. 전체 요약 7문장 읽기 → 016 15:13 ▲ 29 · 댓글 2 텍스트-이미지 모델의 보상 조합 방식으로 생성 품질 향상 기존 텍스트-이미지 생성 모델은 시각 품질이 뛰어나지만, 단일 보상 신호로는 인간의 선호도 전체를 포착할 수 없어 학습 후 개선이 어렵다. AI · 머신러닝 · Post-Training Frontier Text-to-Image Models by Composing Preference and Rubric Rewards
Key Point 선호도와 규칙 기반 보상을 조합하는 방식으로 최신 텍스트-이미지 생성 모델의 사후 학습 효율을 크게 개선하는 실질적 방법론을 제시한다.
핵심 요약
기존 텍스트-이미지 생성 모델은 시각 품질이 뛰어나지만, 단일 보상 신호로는 인간의 선호도 전체를 포착할 수 없어 학습 후 개선이 어렵다. 이 연구는 상호 보완적인 두 가지 보상 신호를 조합하는 사후 학습 방식을 제안했다: Bradley-Terry 목적함수로 인간의 미적·지각적 선호를 학습한 선호도 보상과, 프롬프트 충실도와 다른 바람직한 속성을 명시적으로 평가하는 규칙 기반 보상이다. 단순 가중 평균은 최적 아래의 학습 거동을 초래하므로, 선호도 최적화와 규칙 만족을 더 효과적으로 균형 잡는 새로운 보상 조합 전략을 제시했다. 전체 요약 5문장 읽기 → 017 15:13 ▲ 24 · 댓글 3 깊이 추정 없이 카메라 관점 변환 비디오 생성 외중심 카메라(제3자 관점) 영상 하나로부터 자아중심 카메라(1인칭 관점) 비디오를 생성하는 것은 두 카메라의 겹치는 영역이 거의 없어 어려운 문제다. AI · 머신러닝 · LEGO: A Lifting-Free Approach for Exocentric-to-Egocentric Video Generation
Key Point 깊이 추정 단계를 제거하면서도 비디오 생성 품질을 높이는 새로운 접근법으로, 구조 정렬과 세부 복원의 역할 분담 방식이 확산 모델의 특성과 어떻게 부합하는지 보여준다.
핵심 요약
외중심 카메라(제3자 관점) 영상 하나로부터 자아중심 카메라(1인칭 관점) 비디오를 생성하는 것은 두 카메라의 겹치는 영역이 거의 없어 어려운 문제다. 기존 최첨단 방식은 깊이를 추정해 포인트 클라우드로 변환한 후 자아중심 카메라 관점에서 재렌더링하고, 이를 비디오 확산 모델의 조건으로 사용한다. 그러나 이 결정론적 매핑은 각 픽셀을 한 위치에만 할당하므로 깊이 오류가 콘텐츠 배치 오류로 전파되고, 텍스처는 보존되지만 정확도가 떨어진다. 전체 요약 9문장 읽기 → 018 15:13 ▲ 52 · 댓글 2 다중 에이전트 1인칭 시점 세계 모델, 미세한 상호작용 구현 1인칭 시점 세계 모델은 에이전트의 행동에 따른 관찰을 예측하지만, 기존 연구는 단일 에이전트에 집중했다. AI · 머신러닝 · Multi-Agent Egocentric World Model with Fine-Grained Embodied Interaction
Key Point 실제 로봇이나 현실의 멀티에이전트 환경 시뮬레이션에서 미세한 상호작용(팔 움직임, 물체 조작 등)까지 정확히 모델링해야 하는 연구자와 엔지니어에게 필요한 기술적 진전이다.
핵심 요약
1인칭 시점 세계 모델은 에이전트의 행동에 따른 관찰을 예측하지만, 기존 연구는 단일 에이전트에 집중했다. 현실의 구체화된 환경에서는 여러 에이전트가 공유된 환경에서 미세한 동작을 통해 상호작용하는데, 이는 대부분의 기존 멀티에이전트 세계 모델에서 충분히 다뤄지지 않았다. 연구팀은 멀티에이전트 이고센트릭 세계 모델링을 여러 에이전트의 동기화된 1인칭 스트림 생성으로 정식화했고, 이는 교차 시점 행동 일관성, 공유 환경 일관성, 상호작용으로 인한 상태 업데이트 전파를 요구한다. 전체 요약 6문장 읽기 → 019 15:13 ▲ 47 · 댓글 6 로봇이 시각 데모로 과제를 배우는 ICL 프레임워크 공개 로봇 인콘텍스트 학습(ICL)은 시각 데모로부터 작업을 추론·실행하는 패러다임인데, 시각 데모가 동작 궤적·물체 의미·조작 가능성·공간 관계·작업 목표를 동시에 전달하면서 로봇이 실제로 무엇을 따라야 하는지 불명확한 문제가 있었다. AI · 머신러닝 · In-context Robot Learning Made Simple: A Democratized Recipe for Manipulation Tasks
Key Point 로봇 조작 학습의 실용화를 막던 문제 정의 부재를 해결하고, 대규모 학습 없이도 작동하는 재현 가능한 오픈소스 방식을 제시한 점이 의미있다.
핵심 요약
로봇 인콘텍스트 학습(ICL)은 시각 데모로부터 작업을 추론·실행하는 패러다임인데, 시각 데모가 동작 궤적·물체 의미·조작 가능성·공간 관계·작업 목표를 동시에 전달하면서 로봇이 실제로 무엇을 따라야 하는지 불명확한 문제가 있었다. 연구팀은 로봇 ICL의 명확한 문제 정의를 제시하고 근본적인 프롬프트 모호성을 해결했다. 비전 프롬프트 인코더와 저비용 데이터 수집 프로토콜을 갖춘 미니멀한 프레임워크 SimpleICL을 개발했다. 전체 요약 6문장 읽기 → 020 15:13 ▲ 37 · 댓글 2 로봇 영상 예측 모델 DreamTrue, AgiBot World Challenge 2026 우승 로봇의 행동에 충실하고 물리적으로 타당한 영상 예측이 가능한 다중 시점·다중 로봇 대응 월드 모델 DreamTrue를 제시한다. AI · 머신러닝 · DreamTrue: Action-Faithful Robot World Model with Counterfactual Post-Training
Key Point 로봇 학습에서 행동 추종과 물리적 타당성이라는 두 가지 핵심 문제를 동시에 해결하는 기법이 실제로 결함률을 48%에서 6%로 낮췄으며, 국제 대회 우승으로 검증되어 로봇 월드 모델 발전에 중요한 진전을 보여준다.
핵심 요약
로봇의 행동에 충실하고 물리적으로 타당한 영상 예측이 가능한 다중 시점·다중 로봇 대응 월드 모델 DreamTrue를 제시한다. 기존 로봇 데이터셋으로 학습할 때 발생하는 두 가지 문제를 해결한다: 부정확한 캘리브레이션이 행동 추종을 방해하고, 실패 상호작용의 제한적 범위가 성공 편향을 만든다. 행동 궤적을 이미지 공간 조건으로 변환하고 오프라인 기하학 캘리브레이션을 도입해 다양한 로봇 체형 간 행동 추종을 개선한다. 전체 요약 8문장 읽기 → 021 12:11 ▲ 29 · 댓글 2 생성 시점의 활성화에 맞춘 LLM 가지치기로 디코딩 가속 LLM 디코딩 단계는 메모리 대역폭이 성능 병목이 되는데, Hessian 기반 가지치기로 읽는 파라미터 수를 줄여 지연 시간을 개선할 수 있다. AI · 머신러닝 · SparseDecoding: Decoding-Aware Pruning for Accurate and Efficient LLM Inference
Key Point 디코딩 단계의 실제 토큰 생성 환경과 가지치기 과정의 불일치를 해결하면서 SpMV 연산에 최적화된 커널까지 제공해, LLM 추론 속도 개선에 직접적으로 적용 가능한 실무적 해법을 제시한다.
핵심 요약
LLM 디코딩 단계는 메모리 대역폭이 성능 병목이 되는데, Hessian 기반 가지치기로 읽는 파라미터 수를 줄여 지연 시간을 개선할 수 있다. 기존 방법들은 자연 텍스트에서 계산한 Hessian으로 모델을 가지치기하지만, 실제 디코딩 중에는 모델이 자체 생성 토큰을 처리하면서 분포 차이(distribution shift)가 발생한다. 이로 인해 생성 시 활성화 분포가 가지치기 시 사용된 분포에서 벗어나 모델 성능이 저하되는 문제가 있다. 전체 요약 7문장 읽기 → 022 12:11 ▲ 129 · 댓글 2 원본 시스템 없이 언어 기반 환경 모의 실행 만드는 Trace2Env LLM 에이전트 학습·평가용 환경 모의 실행이 필요하지만, 원본 시스템 재구축은 불가능하거나 비현실적인 경우가 많다. AI · 머신러닝 · From Traces to Agentic Worlds: Agentic Language World Models for Interactive Environment Simulation
Key Point 원본 환경 없이 과거 기록만으로 현실적인 에이전트 학습 환경을 만들 수 있다면, 접근 불가능한 레거시 시스템이나 폐쇄된 플랫폼에서도 LLM 에이전트를 훈련할 수 있게 된다.
핵심 요약
LLM 에이전트 학습·평가용 환경 모의 실행이 필요하지만, 원본 시스템 재구축은 불가능하거나 비현실적인 경우가 많다. 기존 실행 환경을 재건하지 않고 언어 모델이 에이전트의 환경 역할을 하는 '에이전틱 언어 월드 모델링' 방식을 제시한다. Trace2Env는 원본 시스템의 과거 상호작용 기록(trace)만으로 학습 없이 환경을 재구성하는 무학습 프레임워크다. 전체 요약 8문장 읽기 → 023 12:11 ▲ 72 · 댓글 2 멀티모달 AI를 네비게이션 도구와 연결한 로봇 시스템 일반적인 서비스 로봇이 낯선 환경에서 다양한 인간의 요청을 처리할 수 있는 네비게이션 시스템이 필요한 상황에서, 기존 방법들은 멀티모달 대형언어모델(MLLM)을 네비게이션 학습 데이터로 미세조정하면서 새로운 요청과 환경으로의 일반화 능력이 제한된다. AI · 머신러닝 · SuperNav: An Agentic Navigation System for Any Task in Any Scene
Key Point 로봇 네비게이션에서 MLLM의 일반화 능력을 보존하면서 실제 환경에 적용 가능한 새로운 접근법을 제시한다.
핵심 요약
일반적인 서비스 로봇이 낯선 환경에서 다양한 인간의 요청을 처리할 수 있는 네비게이션 시스템이 필요한 상황에서, 기존 방법들은 멀티모달 대형언어모델(MLLM)을 네비게이션 학습 데이터로 미세조정하면서 새로운 요청과 환경으로의 일반화 능력이 제한된다. SuperNav는 MLLM의 일반적 역량을 보존하면서 요청 해석, 장면 이해, 의사결정은 MLLM에 맡기고 움직임 실행은 네비게이션 도구에 위임하는 방식으로 설계되었다. 사전학습된 MLLM을 네비게이션별 미세조정 없이 에이전트 하네스(agent harness)로 장비하며, 이 하네스는 Navigation Skills, 물리적 상호작용용 에이전트 도구, 작업 진행률 및 문맥 관리를 지원한다. 전체 요약 6문장 읽기 → 024 12:11 ▲ 16 · 댓글 6 X선 회절 자동 분석하는 AI 에이전트 등장 분말 X선 회절 분석을 위한 자가학습 AI 에이전트 '간 장(Gan Jiang)'을 개발했다. AI · 머신러닝 · A self-learning scientific agent for X-ray diffraction
Key Point X선 회절은 신물질 개발·품질 검사·고고학 분석 등에 필수적인데, 기존에는 전문가 경험에 의존하던 분석을 AI가 자동화하고 다른 시료에 전이 가능한 수준에 도달했으며, 최근 공개된 다양한 벤치마크에서 기존 방법을 크게 앞섰다.
핵심 요약
분말 X선 회절 분석을 위한 자가학습 AI 에이전트 '간 장(Gan Jiang)'을 개발했다. XMatcher, XQueryer, XDecomposer, WPEM 4개의 엔진으로 구성되며, 물질 상(phase) 식별부터 다중상 분해, 물리 제약 조건 하의 전체 패턴 모델링까지 수행한다. 에이전트는 분석 실패를 진단하고 스킬 명령어와 코드를 개선한 뒤 재사용 전에 검증하는 방식으로, 언어모델 재훈련이나 물리 모델 변경 없이 실무 경험을 재사용 가능한 지식으로 변환한다. 전체 요약 8문장 읽기 → 025 12:11 ▲ 13 · 댓글 2 3D 메시에서 CAD 모델 자동 복원하는 AI 에이전트 등장 3D 메시로부터 편집 가능한 CAD 모델을 복원하는 것은 기존에 어려운 엔지니어링 과제였으며, 단일 도구로는 다양한 기하학과 복원 단계에서 균등하게 잘 작동하지 않았다. AI · 머신러닝 · CADFather: Autonomous CAD Reconstruction through Coordinated Tool Use
Key Point 3D 메시를 직접 편집 가능한 CAD 파라미터로 변환하는 과정이 자동화되면 역설계와 설계 작업흐름이 크게 단순화될 수 있기 때문이다.
핵심 요약
3D 메시로부터 편집 가능한 CAD 모델을 복원하는 것은 기존에 어려운 엔지니어링 과제였으며, 단일 도구로는 다양한 기하학과 복원 단계에서 균등하게 잘 작동하지 않았다. CADFather는 여러 상호보완적 도구를 조율하는 자율 에이전트 시스템으로, 3D 메시에서 파라메트릭 CAD 프로그램을 복원한다. 비전-언어 어시스턴트가 목표 및 중간 단계 렌더링을 검사하고, 어느 CAD 프로그램을 확장할지, 어떤 도구를 사용할지, 몇 개의 제안을 생성할지, 언제 종료할지를 결정한다. 전체 요약 7문장 읽기 → 026 09:11 ▲ 23 · 댓글 2 AI 에이전트 학습용 실제감 있는 사용자 시뮬레이터 MIMESIS 개발 대화형 언어 에이전트 학습에는 풍부한 사용자 상호작용이 필요하지만, 인간 피드백 수집은 비용이 크고 확장성이 낮아 시뮬레이션된 사용자가 필요하다. AI · 머신러닝 · MIMESIS: Learning User Simulators as Training Environments for Interactive Agents
Key Point 에이전트 학습에 실제 사용자처럼 행동하는 시뮬레이터를 사용하면 데이터 수집 비용을 크게 줄이면서도 더 나은 에이전트를 만들 수 있다는 것을 입증했기 때문이다.
핵심 요약
대화형 언어 에이전트 학습에는 풍부한 사용자 상호작용이 필요하지만, 인간 피드백 수집은 비용이 크고 확장성이 낮아 시뮬레이션된 사용자가 필요하다. 기존 에이전트 학습 프레임워크는 기성 LLM 어시스턴트를 사용하는데, 이들은 너무 협력적이고 명확하며 동질적이어서 실제 사용자와 차이가 난다. MIMESIS는 인간 대화 데이터와 13가지 현실적 행동 패턴 레이블로 학습한 전용 사용자 시뮬레이터로, 9B 모델이 SOUL-Index 65.7을 달성했다. 전체 요약 7문장 읽기 → 027 03:11 ▲ 10 · 댓글 2 텍스트-이미지 생성 모델에 에이전트 지식 직접 조각내기 텍스트-이미지 생성 모델을 에이전트 프레임워크로 감싸면 프롬프트 반복 개선과 검증을 통해 생성 품질이 향상되지만, 이런 이득이 모델 가중치에 내재되지 않아 에이전트가 실행될 때만 효과가 발휘된다. AI · 머신러닝 · Internalizing Agent Experience into Diffusion Model Weights via On-Policy Context Distillation
Key Point 이미지 생성 품질을 높이는 에이전트 능력을 모델 자체에 영구적으로 내재시켜 일반 사용자도 원본 쿼리만으로 개선된 이미지를 받을 수 있게 하는 새로운 접근 방식이다.
핵심 요약
텍스트-이미지 생성 모델을 에이전트 프레임워크로 감싸면 프롬프트 반복 개선과 검증을 통해 생성 품질이 향상되지만, 이런 이득이 모델 가중치에 내재되지 않아 에이전트가 실행될 때만 효과가 발휘된다. 논문은 Diffusion On-Policy Context Distillation(D-OPCD)를 제안하는데, 에이전트가 개선한 프롬프트를 특권 정보로 삼아 에이전트의 능력을 확산 모델 가중치로 직접 압축하는 방식이다. Auto Skill Evolver(ASE)라는 텍스트-이미지 에이전트를 사용해 D-OPCD를 실험한 결과, 원본 쿼리만으로 생성했을 때 평균 점수가 60.52에서 65.09로 상승했다(4개 벤치마크 기준). 전체 요약 5문장 읽기 → 028 00:11 ▲ 40 · 댓글 1 로봇 기초 모델의 한 번에 생성하는 동작 정책 K-MF 제안 로봇 기초 모델(RFM)에서 다단계 플로우 매칭의 높은 추론 지연을 극복하기 위해 한 번에 동작을 생성하는 방법을 연구했다. AI · 머신러닝 · Kinematic MeanFlow: One-Step Action Generation Policy for Robotic Foundation Models
Key Point 로봇 기초 모델의 추론 속도를 30~55% 단축할 수 있는 기법이 공개되었으므로, 실시간 로봇 제어가 필요한 현장 적용에 큰 영향을 미칠 수 있다.
핵심 요약
로봇 기초 모델(RFM)에서 다단계 플로우 매칭의 높은 추론 지연을 극복하기 위해 한 번에 동작을 생성하는 방법을 연구했다. 기존 MeanFlow 방식을 직접 적용하면 성능이 무너지는데, RFM 속도장의 두 가지 특수한 역학 때문이다: (1) '로컬 가속도'는 초기에는 안정적이지만 노이징 제거 후기에 급격히 증가, (2) 표본 간 크기의 편차가 노이징 제거가 진행될수록 확대된다. 이를 해결하기 위해 Kinematic MeanFlow(K-MF)를 제안했다. K-MF는 운동학적 항등식에 근거해 MeanFlow의 시간 미분항을 중간점으로 분리된 두 개의 부분 구간항으로 분해한다. 전체 요약 6문장 읽기 → 029 00:11 ▲ 16 · 댓글 1 시계열과 언어를 합친 TimeBraid 모델 공개 Hugging Face가 공개한 TimeBraid는 사전학습 언어모델과 시계열 기초모델을 교차된 글로벌 잔차 주의층으로 정렬하는 통합 모델 시리즈다. AI · 머신러닝 · TimeBraid: Unifying Time Series and Language for Understanding and Forecasting
Key Point 시계열 분석과 자연어처리를 통합한 새로운 접근 방식이 기존 모델들과 어떻게 달라지는지, 그리고 금융·에너지·의료 등 시계열이 중요한 산업 전반에 미칠 영향을 파악할 수 있다.
핵심 요약
Hugging Face가 공개한 TimeBraid는 사전학습 언어모델과 시계열 기초모델을 교차된 글로벌 잔차 주의층으로 정렬하는 통합 모델 시리즈다. 이 모델은 언어의 지식·명령따르기·추론 능력과 시계열의 연속신호 인식·무감독 예측 능력을 모두 상속받는다. 두 모달리티의 표현 공간을 정렬하고 언어를 시간 구조에 접지시키며 이해와 생성의 균형을 맞추는 설계 선택을 검증했다. 전체 요약 6문장 읽기 → 030 00:11 ▲ 20 · 댓글 2 Flow 정책 미세조정을 위한 스칼라 수반 매칭 기법 Flow 정책은 다양한 행동 분포를 포착하며, 데모 데이터를 넘어 성능을 높이기 위해 오프-폴리시 강화학습으로 미세조정하는 방식이 주목받고 있다. AI · 머신러닝 · Q-Learning with Scalar Adjoint Matching
Key Point Flow 정책의 강화학습 미세조정 비용을 획기적으로 줄이면서도 실제 로봇 제어까지 검증한 실용적 알고리즘이 제안되었다.
핵심 요약
Flow 정책은 다양한 행동 분포를 포착하며, 데모 데이터를 넘어 성능을 높이기 위해 오프-폴리시 강화학습으로 미세조정하는 방식이 주목받고 있다. Flow 정책을 학습된 가치 함수로 미세조정하는 것은 정책이 많은 Flow 스텝을 거쳐 행동을 생성하므로 비자명하다. 기존 수반 매칭은 최종 행동에서 각 Flow 스텝으로 가치 정보를 역전파하는 원칙적 방법이지만, 매 스텝마다 벡터-야코비안 곱을 요구해 계산 비용이 Flow 스텝 수와 정책 크기에 따라 증가한다. 전체 요약 9문장 읽기 → 031 00:11 ▲ 12 · 댓글 2 투기적 디코딩에서 불필요한 검증을 줄이는 DLoop 기법 큰 언어 모델의 자동회귀 생성을 가속하는 투기적 디코딩은 경량 초안 모델이 토큰을 제안하면 목표 모델이 이를 검증하는 방식으로 작동한다. AI · 머신러닝 · DLoop: Looped Speculative Decoding
Key Point LLM 추론 속도는 산업 전반의 핵심 과제인데, DLoop가 기존 투기적 디코딩 방식들의 근본 한계를 해결하고 다양한 방법에 범용적으로 적용 가능하다는 점이 중요합니다.
핵심 요약
큰 언어 모델의 자동회귀 생성을 가속하는 투기적 디코딩은 경량 초안 모델이 토큰을 제안하면 목표 모델이 이를 검증하는 방식으로 작동한다. 초안 모델의 성능이 높아지면 목표 모델이 제안된 토큰 전체를 자주 수락하는데도, 매 초안 단계 후 불필요한 검증 및 목표 모델 연산이 반복된다. 기존 적응형 초안 길이 방식들은 자동회귀 초안 모델에서만 속도 향상을 주고, 병렬 초안 모델의 경우 검증되지 않은 토큰의 목표 모델 은닉 상태가 필요해 한계가 있다. 전체 요약 7문장 읽기 → 032 00:11 ▲ 29 · 댓글 2 고정 모델도 로봇 역량 높인다, PhysEvo 프레임워크 제시 Astra 같은 고정된 대형 모델도 충분한 관찰과 제어 체계가 있으면 로봇 조작 능력을 발휘할 수 있다. AI · 머신러닝 · PhysEvo: Astra Can Act, Let It
Key Point 모델 가중치 업데이트나 별도 훈련 없이 시뮬레이션 기반 자기개선만으로 실제 로봇 조작 성공률을 5배 이상 높일 수 있음을 입증한 결과다.
핵심 요약
Astra 같은 고정된 대형 모델도 충분한 관찰과 제어 체계가 있으면 로봇 조작 능력을 발휘할 수 있다. PhysEvo는 모델 가중치를 업데이트하지 않고도 물리적 재귀적 자기개선(RSI)을 수행하는 프레임워크다. 작업 에이전트가 로봇 태스크를 실행하고, 메타 에이전트가 실패를 진단해 도구와 스킬을 개정한 후 테스트한다. 전체 요약 8문장 읽기 → 오늘의 주요최신순 상위 1건
01 AI · 머신러닝 03:11 게시
ollama/ollama
원제 ollama/ollama v0.40.2
v0.40.2
Key Point 로컬에서 Claude를 비롯한 LLM을 실행하는 개발자들에게 더 효율적인 컨텍스트 처리 지원이 추가되어 모델 활용성이 높아진다.
핵심 요약
Ollama는 v0.40.2 버전을 릴리스했다. Claude 모델의 최대 컨텍스트 토큰을 지원하도록 개선했다. 이번 업데이트는 대형 언어 모델 실행 시 더 긴 입력을 처리할 수 있게 해준다. ● 이번 피드는 여기까지입니다.
작은 발견을 다음 커밋으로 이어가세요. 모든 발행본