쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 6일 (금)까지 4095건
68건 · "고성능"조건 지우기 ×
001 21:12 당일 +129 Go의 초고속 웹 프레임워크 Gin 1.12.0 출시 Go로 작성된 고성능 HTTP 웹 프레임워크 Gin 1.12.0이 출시되었으며, Martini 스타일의 API를 제공하면서 httprouter를 통해 최대 40배 빠른 성능을 자랑한다. 웹 · 프론트엔드 · gin-gonic/gin · Go
Key Point Gin은 한국 개발자들이 Go로 REST API와 마이크로서비스를 빠르게 구축해야 할 때 가장 널리 선택하는 프레임워크로, 최신 버전 출시와 함께 성능·기능·커뮤니티 지원 수준을 확인할 수 있다.
핵심 요약
Go로 작성된 고성능 HTTP 웹 프레임워크 Gin 1.12.0이 출시되었으며, Martini 스타일의 API를 제공하면서 httprouter를 통해 최대 40배 빠른 성능을 자랑한다. Gin은 REST API, 웹 애플리케이션, 마이크로서비스 구축에 설계되었으며 Express.js 같은 간단한 라우팅과 Go의 성능 특성을 결합한다. 주요 기능으로는 힙 할당 없는 제로 알로케이션 라우터, 뛰어난 성능, 미들웨어 지원, 크래시 방지, JSON 검증, 라우트 그룹화, 에러 관리, 다양한 렌더링 포맷을 지원한다. 전체 요약 8문장 읽기 → 002 21:12 당일 +292 Atom·Tree-sitter 개발진의 고성능 코드 에디터 Zed 공개 Atom과 Tree-sitter 개발사인 Zed Industries가 고성능 멀티플레이 코드 에디터 Zed를 공개했다. 오픈소스 · 도구 · zed-industries/zed · Rust
Key Point Atom의 창작자들이 다시 만든 고성능 에디터의 공식 저장소이므로, 개발 동향과 기여 방법을 확인할 수 있습니다.
핵심 요약
Atom과 Tree-sitter 개발사인 Zed Industries가 고성능 멀티플레이 코드 에디터 Zed를 공개했다. macOS, Linux, Windows에서 공식 웹사이트 또는 각 플랫폼의 패키지 매니저를 통해 설치할 수 있다. Rust로 작성되었으며, 소스 코드는 주로 GPL-3.0-or-later, 일부 Apache-2.0 라이선스로 제공된다. 전체 요약 7문장 읽기 → 003 06:11 ▲ 105 · 댓글 46 완전 오픈소스 리눅스 기반 네트워크 멀티툴 '플리퍼 원' 사전주문 시작 Rockchip RK3576 ARM 프로세서 기반의 완전 오픈소스 리눅스 컴퓨터 '플리퍼 원'의 사전주문을 시작했다. 하드웨어 · 시스템 · Preparing for the Flipper One Kickstarter and opening pre-orders
Key Point 완전 오픈소스 구조와 M.2 확장성을 갖춘 리눅스 네트워크 기기로, 네트워크 엔지니어와 보안 연구자가 자유롭게 커스터마이징할 수 있는 도구가 나온다.
핵심 요약
Rockchip RK3576 ARM 프로세서 기반의 완전 오픈소스 리눅스 컴퓨터 '플리퍼 원'의 사전주문을 시작했다. 메인라인 커널 지원, 바이너리 blob 제거, 벤더 종속성 없는 순수 오픈소스 환경을 추구하며, Collabora 팀과 협력해 RK3576을 메인라인 커널에 통합 중이다. Raspberry Pi RP2350 저전력 MCU와 RK3576 고성능 CPU 두 프로세서가 병렬로 동작해, 리눅스 OS가 꺼져 있어도 MCU로 LCD와 물리 버튼을 제어할 수 있다. 전체 요약 10문장 읽기 → 004 21:11 당일 +190 콘텐츠 인식 diff 도구 OmniDiff 공개 Rust로 작성한 고성능 diff 도구 OmniDiff를 공개했으며, 99.95% 코드 변경을 처리하고 98.8% 파일을 콘텐츠별 알고리즘으로 구분한다. 오픈소스 · 도구 · ivankovic/omnidiff · Rust
Key Point 텍스트·이미지·폰트·PDF·아카이브 등 25개 언어와 바이너리를 구분 처리하는 diff 도구로, 기존 줄 기반 diff의 정확도와 속도 문제를 모두 해결했다.
핵심 요약
Rust로 작성한 고성능 diff 도구 OmniDiff를 공개했으며, 99.95% 코드 변경을 처리하고 98.8% 파일을 콘텐츠별 알고리즘으로 구분한다. 텍스트 코드는 100ms 이하에서 처리되고, 평균 4.2ms, 중앙값 97.6 백분위 100ms, 최악 482ms 성능을 갖추었다. 25개 언어(Python, JavaScript, Rust, Go 등)는 tree-sitter 문법으로 구조적으로 파싱하고, PNG·JPEG·GIF·WebP 같은 이미지는 픽셀 단위로, 폰트는 글리프별로, PDF는 페이지별로 비교한다. 전체 요약 12문장 읽기 → 005 12:11 ▲ 114 · 댓글 42 BeOS를 브라우저에서 실행해보세요 Infinite Mac 사이트에서 1984년부터 2005년까지 매킨토시 운영체제와 BeOS를 웹브라우저에서 직접 실행할 수 있다. 하드웨어 · 시스템 · Infinite Mac: BeOS
Key Point BeOS는 Apple이 인수를 고려할 정도의 고성능 OS였으나 결국 선택되지 않은 역사 속 선택지인데, 지금 웹브라우저에서 직접 경험해보고 당시 기술적 혁신이 무엇이었는지 확인할 수 있다.
핵심 요약
Infinite Mac 사이트에서 1984년부터 2005년까지 매킨토시 운영체제와 BeOS를 웹브라우저에서 직접 실행할 수 있다. BeOS는 멀티미디어 중심, 멀티태스킹·멀티스레드 OS로 1990년대 중반 Power Macintosh로 포팅되었으며 Apple도 인수를 고려했던 제품이다. 저자가 DingusPPC 에뮬레이터를 활용해 BeOS 지원을 추가하면서 ADB 에뮬레이션, 화면 깊이 변경, 비디오 메모리 업데이트, HFS 파티션 마운트 등에서 여러 호환성 버그를 발견하고 수정했다. 전체 요약 11문장 읽기 → 006 21:11 당일 +100 Godot 4용 고성능 지형 편집 시스템 Terrain3D 공개 C++ GDExtension으로 개발된 Godot 4용 지형 시스템으로, GDScript, C#, 그 외 Godot이 지원하는 모든 언어에서 접근 가능하다. 하드웨어 · 시스템 · TokisanGames/Terrain3D · C++
Key Point Godot 엔진으로 대규모 야외 지형 게임을 만드는 개발자가 고성능 지형 시스템을 바로 도입할 수 있게 되었으며, 다양한 3D 도구와의 호환성이 워크플로우를 단순화한다.
핵심 요약
C++ GDExtension으로 개발된 Godot 4용 지형 시스템으로, GDScript, C#, 그 외 Godot이 지원하는 모든 언어에서 접근 가능하다. 64x64m부터 65.5x65.5km(약 4,295km²)까지 가변 크기의 연속되지 않은 지역들을 지원하며, 최대 32개 텍스처와 10단계 LOD(레벨 오브 디테일)을 제공한다. 식생 인스턴싱, 음영 임포스터, 지형 조각, 구멍 뚫기, 텍스처 칠하기, 색상 및 습도 칠하기 등의 편집 기능을 포함한다. 전체 요약 5문장 읽기 → 007 21:11 당일 +267 IDE에 연결된 Hermes 에이전트 오퍼레이션 레이어 공개 Oh-My-Hermes는 Hermes Agent의 운영 계층으로, 작업 카테고리(초고성능·심화·시각공학·신속 등)에 맞춰 각 레인에 최적의 모델과 추론 난이도를 자동 선택한다. AI · 머신러닝 · rlaope/oh-my-hermes · Python
Key Point Hermes 에이전트를 IDE에서 효율적으로 운영하려는 개발자들에게, 자동 모델 선택·병렬 실행·통합 검증 체계를 한 번에 제공하는 실무 도구가 공개되었다.
핵심 요약
Oh-My-Hermes는 Hermes Agent의 운영 계층으로, 작업 카테고리(초고성능·심화·시각공학·신속 등)에 맞춰 각 레인에 최적의 모델과 추론 난이도를 자동 선택한다. dag-ulw 명령어로 목표를 작은 노드의 그래프로 변환하면 준비된 노드들이 병렬로 실행되며, 같은 파일을 수정하는 노드는 동시 실행되지 않는다. 프론트엔드·백엔드·Rust·보안 리뷰 등 100개 이상의 omh-* 전문 스킬을 라우터가 자동으로 적재하며, 사용자가 명시적으로 호출할 필요는 없다. 전체 요약 14문장 읽기 → 008 15:11 ▲ 104 · 댓글 2 실시간 음성-영상 화자 추출, 경량화로 엣지 배포 가능해졌다 스트리밍 환경에서 특정 화자의 음성만 추출하는 기술(AVTSE)은 저지연이 필수인데, 기존 방식들은 두 가지 문제를 안고 있었다. AI · 머신러닝 · Efficient Streaming Audio-Visual Target Speaker Extraction for Real-World Acoustic Scenes
Key Point 실시간 음성 처리가 필요한 모바일·임베디드 환경에서 화자 분리의 실용성을 크게 높였으며, 기존 벤치마크의 문제를 해결한 현실적 평가 기준을 제시했다.
핵심 요약
스트리밍 환경에서 특정 화자의 음성만 추출하는 기술(AVTSE)은 저지연이 필수인데, 기존 방식들은 두 가지 문제를 안고 있었다. 첫째, 표준 벤치마크가 화자 2명만 고정하고 실제 환경의 근거리·원거리 간섭음, 음향 반향, 갑작스러운 잡음을 반영하지 않는다. 둘째, 고성능 인과관계 구조는 엣지 기기 배포에 너무 무겁고, 경량 대안도 작은 분리 모델을 반복 호출하면서 이득을 상쇄한다. 전체 요약 8문장 읽기 → 009 21:11 당일 +260 로컬 AI 추론을 위한 고성능 엔진 Uzu 오픈소스화 Rust로 개발된 고성능 AI 추론 엔진 Uzu를 공개했으며, 지연 없이 앱에 직접 AI 모델을 배포할 수 있다. AI · 머신러닝 · trymirai/uzu · Rust
Key Point 로컬에서 AI 추론을 수행하려는 개발자들이 클라우드 비용과 레이턴시를 피하면서 데이터 프라이버시까지 보호할 수 있는 프로덕션급 도구가 생겼다.
핵심 요약
Rust로 개발된 고성능 AI 추론 엔진 Uzu를 공개했으며, 지연 없이 앱에 직접 AI 모델을 배포할 수 있다. 데이터 프라이버시를 완전히 보장하고 추론 비용이 발생하지 않으며, Metal·WebGPU·CPU 백엔드를 지원한다. Python, Swift, TypeScript, Rust 등 4개 언어에 바인딩을 제공하고, 모델 다운로드부터 추론까지 자동으로 처리한다. 전체 요약 9문장 읽기 → 010 06:11 ▲ 187 · 댓글 204 M6 칩 탑재한 신형 14인치 맥북프로 발표 애플이 M6 칩을 탑재한 14인치 맥북프로를 발표했다. 12코어 CPU와 12코어 GPU, 듀얼 16코어 뉴럴 엔진을 갖췄다. 하드웨어 · 시스템 · New 14‑inch MacBook Pro with M6
Key Point M6 칩은 AI 연산 성능을 획기적으로 개선했으며, 24시간 배터리는 맥북 사상 최장 수명이다. 프롬프트 처리 속도 1.3배 향상과 AI 워크로드 전반의 대폭 개선으로, AI 개발자와 크리에이터들의 로컬 LLM 실행 환경이 크게 달라진다.
핵심 요약
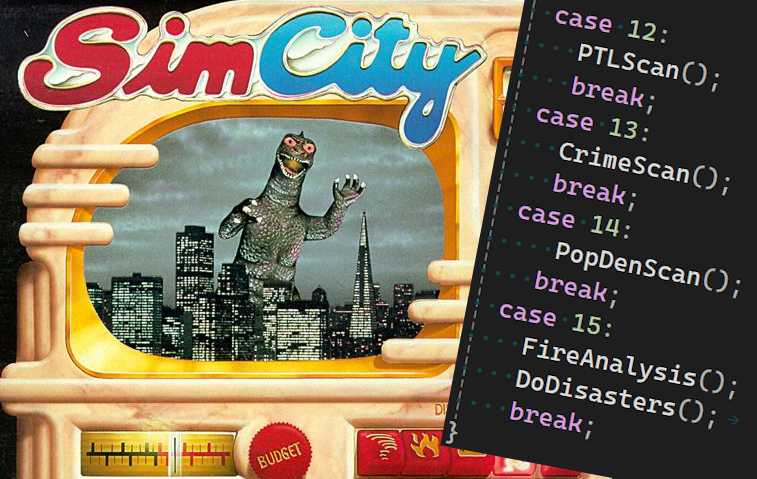
애플이 M6 칩을 탑재한 14인치 맥북프로를 발표했다. 12코어 CPU와 12코어 GPU, 듀얼 16코어 뉴럴 엔진을 갖췄다. M5 대비 그래픽 성능 30%, AI 워크로드 성능 25% 향상됐다. M1 대비로는 그래픽 11배, AI 성능 13배 빨라졌다. 시간당 첫 토큰(time to first token) 생성 성능은 M5 대비 1.3배, M1 대비 13배 빠르며, 뉴럴 엔진은 M5보다 1.9배 빠른 이미지 생성·초해상화 처리가 가능하다. 전체 요약 12문장 읽기 → 011 03:11 ▲ 100 · 댓글 29 16MHz 386SX CPU에서 돌린 초대 심시티의 최적화 비법 1989년 초대 심시티는 16MHz로 작동하는 인텔 386SX 프로세서에서 풀 기능의 도시 시뮬레이션을 구현했으며, 2008년 GPL 라이선스로 공개된 마이크로폴리스 소스코드를 통해 그 최적화 기법을 분석할 수 있다. 하드웨어 · 시스템 · How to run a city builder on 16 MHz
Key Point 초고성능 현대 하드웨어에서도 시뮬레이션 게임이 버거워하는 반면, 30년 전 16MHz CPU에서 풀 기능 도시 시뮬레이션을 돌렸던 기법이 오늘날 최신 게임 엔진에서도 여전히 핵심 최적화 원리로 쓰이고 있다.
핵심 요약
1989년 초대 심시티는 16MHz로 작동하는 인텔 386SX 프로세서에서 풀 기능의 도시 시뮬레이션을 구현했으며, 2008년 GPL 라이선스로 공개된 마이크로폴리스 소스코드를 통해 그 최적화 기법을 분석할 수 있다. 시뮬레이션의 핵심은 Simulate() 함수로, 교통, 화재, 전력, 범죄 등 각 시스템을 업데이트하는데 매 프레임마다 모든 함수를 호출하면 CPU가 감당할 수 없다. 해결책은 mod16 파라미터를 사용해 0~15 사이를 순환하며 각 프레임마다 특정 시뮬레이션 부분만 실행하는 것으로, 전체 시뮬레이션이 완성되려면 평균 8프레임, 최악의 경우 15프레임이 필요하다. 전체 요약 7문장 읽기 → 012 03:11 ▲ 112 · 댓글 51 DOM과 Canvas를 통합하는 HTML-in-Canvas API 등장 Chrome 148~150에서 진행 중인 origin trial을 통해 새로운 HTML-in-Canvas API가 공개됐다. 웹 · 프론트엔드 · The HTML-in-Canvas API origin trial
Key Point 웹 게임과 3D 편집기 같은 고성능 Canvas 앱에서 텍스트 접근성, find-in-page, 브라우저 확장 등 DOM의 모든 기능을 동시에 사용할 수 있게 되므로, 복잡한 시각 애플리케이션의 아키텍처 설계 방식이 근본적으로 달라진다.
핵심 요약
Chrome 148~150에서 진행 중인 origin trial을 통해 새로운 HTML-in-Canvas API가 공개됐다. 이 API는 DOM 콘텐츠를 2D canvas 또는 WebGL/WebGPU 텍스처에 직접 렌더링하면서 상호작용과 접근성을 유지한다. DOM은 텍스트 레이아웃, 접근성, 번역, find-in-page 등 브라우저 기능을 제공하지만 그래픽 성능이 제한적이고, Canvas는 고성능이지만 이러한 기능들이 완전히 작동하지 않는다. 전체 요약 9문장 읽기 → 013 09:11 당일 +101 FastAPI: Python으로 빠르고 쉽게 API 만드는 프레임워크 Python 타입 힌트를 기반으로 고성능 API를 구축하는 모던 웹 프레임워크로, Node.js, Go 수준의 빠른 성능을 제공한다. 웹 · 프론트엔드 · fastapi/fastapi · Python
Key Point Python API 개발자들이 고성능과 생산성을 동시에 달성할 수 있는 표준 프레임워크로, 타입 기반 검증과 자동 문서화로 개발 속도와 코드 품질을 모두 높일 수 있습니다.
핵심 요약
Python 타입 힌트를 기반으로 고성능 API를 구축하는 모던 웹 프레임워크로, Node.js, Go 수준의 빠른 성능을 제공한다. Starlette(웹)과 Pydantic(데이터 검증)을 기반으로 하며, 기능 개발 속도는 기존 대비 200~300% 향상되고 인적 오류는 약 40% 감소한다. 타입 선언만으로 요청 데이터 검증, 자동 형변환, 에디터 자동완성, 깊은 JSON 객체 검증까지 가능하다. 전체 요약 12문장 읽기 → 014 16:56 ▲ 620 · 댓글 215 DeepSeek, 자체 추론 엔진 오픈소스로 공개 딥시크가 자사 대규모 서비스에 쓰이는 고성능 추론 프레임워크 DeepInfer를 오픈소스로 공개했다. AI · 머신러닝 · DeepSeek just open-sourced its inference engine
Key Point 딥시크의 대규모 서빙에 검증된 고성능 추론 엔진이 오픈소스화되어, LLM 배포를 다루는 개발자들이 프로덕션 수준의 최적화 기법을 직접 활용할 수 있게 되었다.
핵심 요약
딥시크가 자사 대규모 서비스에 쓰이는 고성능 추론 프레임워크 DeepInfer를 오픈소스로 공개했다. 지원 모델은 DeepSeek-V4.1-Flash이며, FlashMLA, DeepGEMM, DeepEP 등 최적화된 커널과 MoE 전문가 병렬화, 비동기 스케줄링, 배치 불변 추론 등 대규모 서빙에 필요한 핵심 기능을 포함한다. DSpark와 신뢰도 기반 검증으로 드래프트 토큰을 통해 디코딩을 가속화하며, 설정 파라미터로 최대 드래프트 길이(기본값 5)를 조절할 수 있다. 전체 요약 9문장 읽기 → 015 18:11 ▲ 102 · 댓글 11 단 하나의 해시로 블룸 필터 구현하기 블룸 필터는 '특정 키가 집합에 있는가'를 빠르게 판별하는 확률적 자료구조로, 작은 메모리로 높은 성능을 제공해 Bluesky 백엔드에서 데이터베이스 쿼리를 99% 줄이는 데 활용 중이다. 인프라 · 데브옵스 · One Hash Bloom Filters
Key Point Bluesky 같은 대규모 시스템에서 블룸 필터의 실제 병목(스레드 경합)을 단일 해시로 해결한 사례로, 고성능 인프라 개선 시 이론만이 아닌 구체적인 최적화 기법을 배울 수 있다.
핵심 요약
블룸 필터는 '특정 키가 집합에 있는가'를 빠르게 판별하는 확률적 자료구조로, 작은 메모리로 높은 성능을 제공해 Bluesky 백엔드에서 데이터베이스 쿼리를 99% 줄이는 데 활용 중이다. 전통적 블룸 필터는 k개의 독립적 해시 함수를 사용하지만, 2008년 Kirsch와 Mitzenmacher의 논문에 따르면 단 2개 해시로도 동일한 오류율을 달성할 수 있다. Bluesky는 bits-and-blooms 라이브러리를 사용했으나 스레드 안전성 부족으로 뮤텍스 경합이 병목이 되어 배포 시간이 90분에 달했고, atomic-bloom으로 개선해 15분대로 단축했다. 전체 요약 7문장 읽기 → 016 15:11 ▲ 27 · 댓글 2 AI 에이전트 프롬프트, 성능·비용 균형 맞춰 자동 개선 AI 에이전트의 작업 수행 능력을 높이는 '하네스(harness, 프롬프트 템플릿)' 개발에서 기존 반복 개선 방식은 성능 향상 대신 실행 비용을 크게 올린다는 문제가 있다. AI · 머신러닝 · HarnessPro: Recursive Harness Self-Improvement with Pareto Optimization for Performance-Cost Trade-offs
Key Point AI 에이전트 성능을 높일 때 비용 증가를 피할 수 없던 문제를 해결하는 자동화 기법으로, 실무 배포 환경에서 비용·성능 트레이드오프를 실제로 선택 가능하게 한다.
핵심 요약
AI 에이전트의 작업 수행 능력을 높이는 '하네스(harness, 프롬프트 템플릿)' 개발에서 기존 반복 개선 방식은 성능 향상 대신 실행 비용을 크게 올린다는 문제가 있다. HarnessPro는 정답 데이터 없이 LLM이 생성한 테스트로만 후보 하네스를 평가하는 레이블 무료 진화 방법을 제안한다. 전문 에이전트가 실행 궤적을 진단하고 성능·비용 우선순위에 따라 업데이트를 계획해 후보 하네스로 구현한다. 전체 요약 7문장 읽기 → 017 09:11 ▲ 202 · 댓글 3 AI 피어 리뷰 검증 시스템 PremiseCheck 공개 논문 피어 리뷰 댓글에서 인간과 AI가 저지르는 사실 오류를 감지하기 위해 ReviewFact 벤치마크를 개발했다. AI · 머신러닝 · PremiseCheck: Efficient Fact-Checking of Human and AI Peer Reviews
Key Point 피어 리뷰는 논문 평가의 기초인데 AI가 생성한 댓글의 정확성을 효율적으로 검증할 방법이 없었던 상황을 두 단계 검증으로 해결했기 때문이다.
핵심 요약
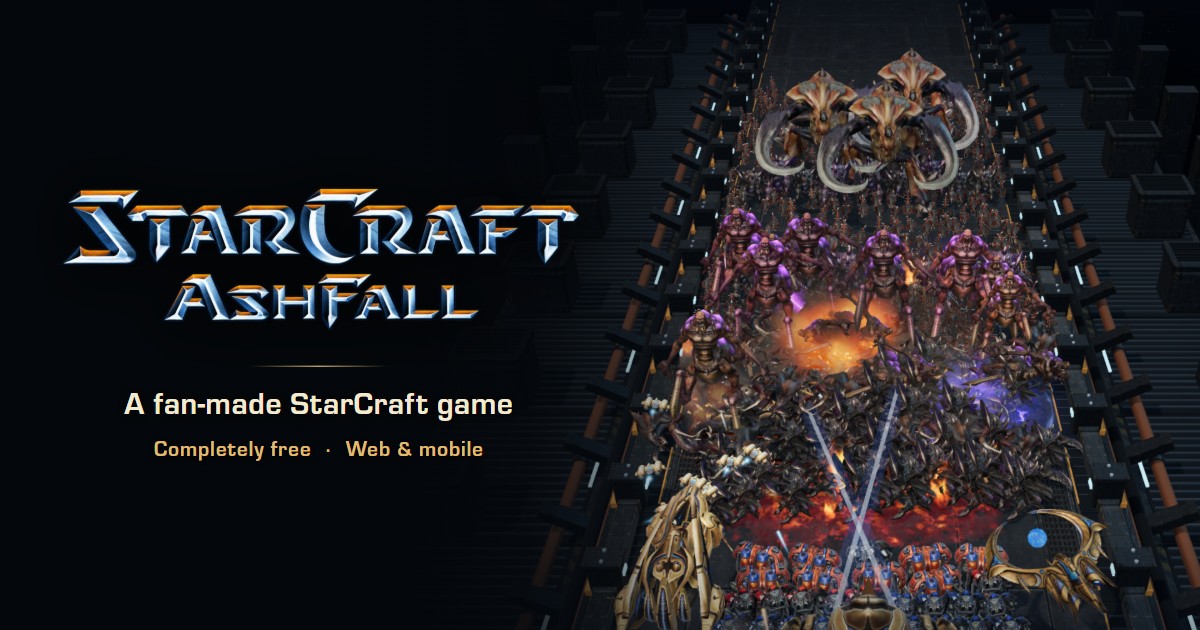
논문 피어 리뷰 댓글에서 인간과 AI가 저지르는 사실 오류를 감지하기 위해 ReviewFact 벤치마크를 개발했다. NLP, 머신러닝, 자연과학 논문에서 검증된 이 벤치마크는 정확도뿐 아니라 비용과 응답 시간도 측정한다. GPT-5.5 같은 고성능 LLM은 검증 정확도가 높지만 매번 전체 논문을 읽어야 하므로 비용이 크다. 전체 요약 6문장 읽기 → 018 06:11 ▲ 181 · 댓글 59 스타크래프트 테마의 브라우저 타워디펜스 게임 공개 스타크래프트 유니버스를 배경으로 한 브라우저 기반 타워디펜스 게임 'Ashfall'이 공개되었다. 기타 · Starcraft: Ashfall
Key Point 스타크래프트 IP를 활용한 브라우저 게임이 등장했으며, 별도의 설치 없이 웹에서 바로 플레이할 수 있는 타워디펜스 경험을 제공한다.
핵심 요약
스타크래프트 유니버스를 배경으로 한 브라우저 기반 타워디펜스 게임 'Ashfall'이 공개되었다. 플레이어는 테란 지휘관 역할로 무한 모드에서 계속 밀려오는 적군을 방어하는 방식으로 진행되며, 게임 내 경험치와 전투 업그레이드로 더 강력해질 수 있다. 게임에는 레이노 지휘관을 포함한 여러 영웅 능력(전투 격려, 여왕 공습, 공중 지원, 우주모함 소환 등)이 있어 전술적 깊이를 제공한다. 전체 요약 6문장 읽기 → 019 00:11 ▲ 114 · 댓글 165 미국 국방부, 고급 미사일부터 저가 드론까지 탄약고 다층화 추진 미국 국방부는 이란 및 우크라이나 전쟁으로 소진된 탄약 비축량을 재구축하면서 동시에 현대 고강도 전쟁에 맞춰 탄약 포트폴리오를 재편하고 있다. 하드웨어 · 시스템 · How Quickly Can the DoD Rebuild and Recast the Munitions Industrial Base?
Key Point 미국 국방부가 탄약 부족 위기에 대응하기 위해 고급 미사일 증산과 함께 저가 드론·미사일 신규 사업에 수십억 달러를 투자하고 있으며, 이는 방위산업 생태 재편과 미국의 군사 억지력에 직접 영향을 미치기 때문이다.
핵심 요약
미국 국방부는 이란 및 우크라이나 전쟁으로 소진된 탄약 비축량을 재구축하면서 동시에 현대 고강도 전쟁에 맞춰 탄약 포트폴리오를 재편하고 있다. 2027 회계연도 예산에서 PAC-3 MSE는 341에서 3,203개로(839% 증가), THAAD는 37에서 857개로(2,216% 증가), 토마호크 미사일은 57에서 1,049개로(1,740% 증가) 요청됐다. 이들 고성능 미사일은 설계 단계부터 대량 생산보다 성능 최적화에 중점을 뒀으며, 제조 리드타임이 25~51개월에 달한다. 전체 요약 13문장 읽기 → 020 21:11 당일 +148 Rust 기반 에이전트 워크스페이스 OpenBitFun 1.0 공개 Rust로 작성한 고성능 에이전트 런타임과 데스크톱 앱을 결합한 OpenBitFun이 1.0 버전을 출시했다. AI · 머신러닝 · GCWing/OpenBitFun · Rust
Key Point Rust 기반의 고성능 에이전트 런타임으로 만든 멀티디바이스 워크스페이스가 나왔으며, 기존 AI 도구와 달리 소프트웨어 개발을 넘어 일반 업무를 지원하는 확장 가능한 플랫폼을 제시한다.
핵심 요약
Rust로 작성한 고성능 에이전트 런타임과 데스크톱 앱을 결합한 OpenBitFun이 1.0 버전을 출시했다. Minimal, Standard, Ultimate, Creative 네 가지 Agent Harness 모드로 빠른 협업부터 복잡한 작업까지 지원한다. 데스크톱, 모바일, 브라우저 간 원활한 연동으로 한 기기에서 시작한 작업을 다른 기기에서 이어갈 수 있다. 전체 요약 10문장 읽기 → 021 21:11 당일 +112 AI가 기판 설계까지 한다…KiCAD 네이티브 플러그인 Konnect 공개 Konnect는 KiCAD 10을 위한 AI 기반 PCB 설계 플러그인으로, Claude를 포함한 LLM이 Model Context Protocol을 통해 회로도 작성과 기판 설계를 직접 수행할 수 있게 한다. AI · 머신러닝 · mixelpixx/Konnect · Rust
Key Point KiCAD 설계 과정을 AI가 직접 담당하는 단계로 발전했으며, 기존 복잡한 다중 언어 아키텍처를 버리고 고성능 단일 바이너리로 재설계한 점이 PCB 개발자의 작업 방식을 크게 바꿀 수 있다.
핵심 요약
Konnect는 KiCAD 10을 위한 AI 기반 PCB 설계 플러그인으로, Claude를 포함한 LLM이 Model Context Protocol을 통해 회로도 작성과 기판 설계를 직접 수행할 수 있게 한다. 21개 도구 세트에 걸친 228개 도구를 제공하며, 회로도 캡처, PCB 레이아웃과 라우팅, ERC/DRC, 설계 검토, JLCPCB 부품 검색, 참조 회로, 제조 파일 내보내기 등을 지원한다. 기존 KiCAD-MCP-Server(Python/TypeScript)의 한계를 극복하기 위해 Rust로 완전히 새롭게 작성됐으며, 단일 정적 바이너리(20~25MB)로 배포돼 설치 의존성이 없다. 전체 요약 12문장 읽기 → 022 00:11 새 버전 Transformers v5.20.1 출시, Beam 모델 추가 및 버그 수정 Hugging Face Transformers 라이브러리 v5.20.1이 출시되었으며, Reflection AI의 새 모델 Beam이 추가되었다. AI · 머신러닝 · huggingface/transformers@v5.20.1
Key Point 새로운 고성능 모델 Beam이 추가되고 여러 모델 호환성 및 로딩 버그가 수정되어, 기존 Transformers 사용자와 새로운 모델을 시도하려는 개발자 모두에게 영향이 있다.
핵심 요약
Hugging Face Transformers 라이브러리 v5.20.1이 출시되었으며, Reflection AI의 새 모델 Beam이 추가되었다. Beam은 토큰 효율적인 프론티어급 모델로 코딩과 에이전트 작업에 최적화되어 있다. 자체 하드웨어, 인프라, 클라우드에서 실행할 수 있으며 특정 요구사항에 맞게 커스터마이징 가능하다. 전체 요약 6문장 읽기 → 023 00:11 ▲ 134 · 댓글 94 소프트웨어 렌더링의 매력, 고성능 PC에서 되살아나다 저자는 DOS 시대 게임의 소프트웨어 렌더링 버전을 선호하며, Dell OptiPlex 380에서 Quake를 800×600 해상도 60fps로 실행한 경험을 꼽는다. 하드웨어 · 시스템 · I Love Software Rendering
Key Point 현대 컴퓨터의 높은 성능이 옛날 소프트웨어 렌더링 게임을 새로운 방식으로 경험하게 만드는 현상과, 하드웨어 가속 이후 잊혀진 화질의 매력을 다시 조명한다.
핵심 요약
저자는 DOS 시대 게임의 소프트웨어 렌더링 버전을 선호하며, Dell OptiPlex 380에서 Quake를 800×600 해상도 60fps로 실행한 경험을 꼽는다. 소프트웨어 렌더링은 CPU가 모든 픽셀을 직접 그리는 방식으로, 3D 카드를 거치지 않고 게임 코드가 프레임을 계산해 비디오 메모리에 쓴다. 소프트웨어 렌더링의 장점은 텍스처가 샤프하게 유지되고(이중선형 필터링이 없어), 256색 팔레트 기반의 계단형 음영이 주는 거친 질감이 특징이다. 전체 요약 7문장 읽기 → 024 18:11 ▲ 101 · 댓글 28 Rust로 만든 고성능 웹 프레임워크 Proa 공개 Rust 기반의 웹 프레임워크 Proa를 소개합니다. 빠른 서버 사이드 렌더링(SSR)과 다중 렌더 타겟 지원을 특징으로 합니다. 웹 · 프론트엔드 · Show HN: Proa – A Rust web framework with fast SSR and multi-target rendering
Key Point 한 번의 Rust 코드로 여러 렌더 타겟을 생성하고 React보다 237배 빠른 서버 렌더링을 제공하는 새로운 웹 프레임워크의 등장으로, SSR 기반 웹 개발의 패러다임이 어떻게 변할 수 있는지 보여줍니다.
핵심 요약
Rust 기반의 웹 프레임워크 Proa를 소개합니다. 빠른 서버 사이드 렌더링(SSR)과 다중 렌더 타겟 지원을 특징으로 합니다. 하나의 타입된 컴포넌트로 HTML, Markdown 등 여러 렌더 타겟을 동시에 생성할 수 있습니다. 벤치마크 결과에 따르면 Proa의 서버 렌더링 속도는 React의 renderToString보다 237배 빠릅니다(8vCPU AMD EPYC-Milan VPS 기준). 전체 요약 12문장 읽기 → 025 12:11 ▲ 26 · 댓글 2 에이전트를 엣지에서 실행하되 필요할 때만 클라우드 LLM 호출 장기 작업을 수행하는 AI 에이전트는 보통 클라우드의 고성능 LLM을 매 스텝마다 사용하는데, 이는 높은 추론 비용을 초래한다. AI · 머신러닝 · EdgeWise: Bringing Long-Horizon Agents to the Edge via Selective Cloud Delegation
Key Point 장기 에이전트 작업의 추론 비용을 62%까지 줄이면서도 성능을 유지하는 방식은 엣지 배포에서 LLM 활용의 경제성을 크게 바꿀 수 있다.
핵심 요약
장기 작업을 수행하는 AI 에이전트는 보통 클라우드의 고성능 LLM을 매 스텝마다 사용하는데, 이는 높은 추론 비용을 초래한다. 연구팀이 발견한 핵심은 모든 스텝이 강력한 모델을 필요로 하지 않으며, 중요한 일부 스텝에만 LLM을 할당해도 전체 성능과 비슷한 결과를 낼 수 있다는 것이다. EdgeWise는 로컬 디바이스에 작은 언어모델(SLM)을 배포하고, 강력한 능력이 필요한 중요한 스텝만 선택적으로 클라우드 LLM으로 위임하는 엣지-클라우드 협력 프레임워크다. 전체 요약 7문장 읽기 → 026 03:11 ▲ 148 · 댓글 42 pgvector 능가하는 벡터 검색 인덱스 등장 Timescale이 PostgreSQL용 고성능 근사 최근접 이웃(ANN) 검색 확장 pg_vectorsearch를 공개했으며, 현재 알파 상태로 프로덕션 용도는 권장하지 않는다. 인프라 · 데브옵스 · Pg_vectorsearch: An index that is faster than pgvector's IVFFlat and HNSW
Key Point pgvector를 대체할 더 빠르고 효율적인 벡터 검색 솔루션을 찾는 개발자들에게 실제 선택지가 생겼으며, 기존 pgvector 테이블과의 호환성 덕분에 마이그레이션 진입장벽이 낮다.
핵심 요약
Timescale이 PostgreSQL용 고성능 근사 최근접 이웃(ANN) 검색 확장 pg_vectorsearch를 공개했으며, 현재 알파 상태로 프로덕션 용도는 권장하지 않는다. PRISM 인덱스는 IVFFlat과 유사한 개념이지만 계층적 라우팅, RaBitQ 양자화, SIMD 최적화를 사용해 pgvector의 IVFFlat과 HNSW보다 쿼리와 인덱스 구축 모두에서 더 빠르다. 100백만 개 벡터 데이터셋에서 HNSW 대비 동등한 재현율(recall)을 달성하면서 1/4 메모리만 사용한다. 전체 요약 11문장 읽기 → 027 06:11 ▲ 195 · 댓글 52 WiFi 7 라우터를 320Msps 소프트웨어 무선 수신기로 개조 Gemtek W1700K WiFi 7 라우터를 광대역 소프트웨어 정의 수신기로 변환하는 오픈소스 펌웨어 프로젝트로, MediaTek MT7996 라디오가 14비트 IQ를 최대 320Msps로 캡처하고 10GbE를 통해 스트리밍한다. 하드웨어 · 시스템 · Turn a WiFi 7 Router into a 320Msps Software Defined Radio Receiver
Key Point WiFi 라우터의 고성능 라디오 칩셋을 역분석하여 MediaTek 독점 펌웨어 없이 완전 독립적인 소프트웨어 정의 라디오로 구현한 사례로, 임베디드 역분석·펌웨어 개발·고속 데이터 스트리밍의 기술적 성과를 보여준다.
핵심 요약
Gemtek W1700K WiFi 7 라우터를 광대역 소프트웨어 정의 수신기로 변환하는 오픈소스 펌웨어 프로젝트로, MediaTek MT7996 라디오가 14비트 IQ를 최대 320Msps로 캡처하고 10GbE를 통해 스트리밍한다. Airoha AN7581 SoC가 데이터를 처리하며, Linux 호스트에서 실시간 스펙트럼과 폭포도를 브라우저로 표시하고 라디오 제어를 함께 제공한다. 전체 2.4GHz 대역을 320Msps로 실시간 캡처 가능하며 필터링 롤오프를 보정한 후 매초 100개 스펙트럼을 262,144포인트 FFT로 생성한다. 전체 요약 11문장 읽기 → 028 21:12 당일 +131 Rust로 만든 고성능 AI 코딩 에이전트 jcode 공개 GitHub Trending에 오른 jcode는 Rust로 작성된 고성능 AI 코딩 에이전트 프레임워크로, RAM 효율성과 응답 속도를 극도로 최적화했다. AI · 머신러닝 · 1jehuang/jcode · Rust
Key Point 메모리 사용량을 1/10 이하로 줄이고 응답 속도를 200배 이상 개선한 오픈소스 AI 에이전트가 나왔으므로, 로컬 개발 환경에서 가볍게 AI 코딩 어시스턴트를 운영하거나 대규모 멀티에이전트 시스템을 구축하려는 개발팀에게 중요한 선택지가 될 수 있다.
핵심 요약
GitHub Trending에 오른 jcode는 Rust로 작성된 고성능 AI 코딩 에이전트 프레임워크로, RAM 효율성과 응답 속도를 극도로 최적화했다. 단일 세션 메모리 사용량은 27.8MB(임베딩 비활성화)부터 167.1MB(활성화)로, Claude Code 386.6MB 대비 약 2~14배 적으며, 10개 세션 병렬 실행 시에도 260.8MB로 경쟁 제품 대비 압도적이다. 부팅부터 첫 프레임까지 14.0ms, 첫 입력까지 48.7ms로 다른 도구(Claude Code 3436.9ms)의 1/200~1/70 수준의 극도로 빠른 응답성을 제공한다. 전체 요약 10문장 읽기 → 029 21:11 당일 +202 마이크로소프트, 고품질 3D 생성 모델 TRELLIS.2 공개 마이크로소프트가 40억 개 파라미터 규모의 이미지-to-3D 생성 모델 TRELLIS.2를 공개했다. AI · 머신러닝 · microsoft/TRELLIS.2 · Python
Key Point 이미지 한 장에서 PBR 재질까지 포함한 완전한 3D 자산을 빠르게 생성할 수 있는 새로운 방식이 등장했으므로, 3D 콘텐츠 제작 워크플로우가 어떻게 바뀔 수 있을지 확인할 필요가 있다.
핵심 요약
마이크로소프트가 40억 개 파라미터 규모의 이미지-to-3D 생성 모델 TRELLIS.2를 공개했다. O-Voxel이라는 새로운 '필드 프리' 희소 복셀 구조를 사용하여 복잡한 위상, 예리한 특징, 완전한 PBR 재료를 가진 3D 자산을 생성한다. 512³ 해상도에서 약 3초(2초 형상 생성 + 1초 재질 생성), 1024³에서 약 17초, 1536³에서 약 60초가 소요된다. 전체 요약 12문장 읽기 → 030 15:11 새 버전 Bun v1.4.3 출시 Bun 런타임의 v1.4.3 버전이 릴리스되었다. 웹 · 프론트엔드 · oven-sh/bun@bun-v1.4.3
Key Point Bun은 Node.js를 대체하는 고성능 JavaScript 런타임으로, 새 버전 출시 시 기능 개선과 버그 수정 내용을 확인하는 것이 중요하다.
핵심 요약
Bun 런타임의 v1.4.3 버전이 릴리스되었다. 설치 방법은 curl -fsSL https://bun.sh/install | bash 또는 npm install -g bun으로 진행할 수 있다. Windows 환경에서는 powershell -c "irm bun.sh/install.ps1|iex" 명령으로 설치 가능하다. 전체 요약 6문장 읽기 → 031 18:33 당일 +168 Rust 기반 고성능 링커 mold, lld보다 4.9배 빠르다 mold는 Unix 링커의 고성능 대체품으로, Blender·Chromium·TensorFlow 같은 대규모 프로젝트 링킹을 4.9배 빠르게(lld 대비 중앙값) 처리한다. 인프라 · 데브옵스 · rui314/mold · Rust
Key Point 대규모 프로젝트 빌드 시간을 획기적으로 단축할 수 있는 성숙한 도구로, 특히 C++·Rust 개발자의 개발 생산성을 크게 높일 수 있다.
핵심 요약
mold는 Unix 링커의 고성능 대체품으로, Blender·Chromium·TensorFlow 같은 대규모 프로젝트 링킹을 4.9배 빠르게(lld 대비 중앙값) 처리한다. 2026년 8월 벤치마크에서 wild 링커보다는 1.9배 빠르며, AMD Threadripper와 Apple M1 Ultra 양쪽 플랫폼에서 일관되게 우수한 성능을 보인다. LLVM lld 원개발자가 아키텍처 한계를 극복하기 위해 Rust로 새로 작성했으며, 2021년부터 프로덕션 환경에서 운영 중이다. 전체 요약 10문장 읽기 → 032 18:33 ▲ 422 · 댓글 46 구글, 멀티모달 임베딩 모델 'EmbeddingGemma 2' 공개 Google DeepMind이 EmbeddingGemma 2를 공개했으며, 텍스트·이미지·오디오·비디오를 통합 임베딩 공간으로 매핑하는 가볍고 고성능의 온디바이스 멀티모달 모델이다. AI · 머신러닝 · EmbeddingGemma 2: An open, lightweight multimodal embedding model
Key Point 온디바이스에서 텍스트·이미지·오디오·비디오를 하나의 모델로 처리할 수 있게 되어, 데이터 프라이버시를 보호하면서도 로컬에서 멀티모달 검색과 RAG를 구현할 수 있는 기반이 마련됐다.
핵심 요약
Google DeepMind이 EmbeddingGemma 2를 공개했으며, 텍스트·이미지·오디오·비디오를 통합 임베딩 공간으로 매핑하는 가볍고 고성능의 온디바이스 멀티모달 모델이다. 지난해 출시한 EmbeddingGemma는 2천만 건 이상 다운로드되어 온디바이스 검색과 프라이버시 우선 RAG 파이프라인 구축에 활용됐다. EmbeddingGemma 2는 Gemma 4 아키텍처 기반, 7억 4천만 파라미터 규모이며 Apache 2.0 라이선스로 공개된다. 전체 요약 12문장 읽기 → 033 16:56 ▲ 147 · 댓글 66 고속 링커 mold, Rust로 완전 재작성해 3.0 출시 mold 3.0은 C++에서 Rust로 완전히 재작성한 첫 릴리스로, 2.42.1의 마지막 C++ 버전을 대체하며 같은 커맨드라인 옵션과 대상 아키텍처를 지원한다. 인프라 · 데브옵스 · Mold Linker Version 3.0.0 Release – Rewritten in Rust
Key Point C++ 기반의 고성능 링커가 Rust로 재작성되며 안전성과 호환성이 향상되었고, Linux 배포판의 기본 링커 채택을 목표로 하는 만큼 시스템 수준의 변화에 영향을 미칠 수 있다.
핵심 요약
mold 3.0은 C++에서 Rust로 완전히 재작성한 첫 릴리스로, 2.42.1의 마지막 C++ 버전을 대체하며 같은 커맨드라인 옵션과 대상 아키텍처를 지원한다. 링커 성능은 2.42.1과 동등하며, GNU ld와의 호환성을 강화하고 Linux 배포판의 기본 링커로 채택되는 것을 목표로 한다. Gentoo 패키지 빌드를 포함한 광범위한 호환성 검증을 거쳤으며 회귀(regression)는 발견되지 않았다. 전체 요약 13문장 읽기 → 034 18:35 ▲ 117 · 댓글 3 Kandinsky 6.0 Video, 텍스트로 음성 동기화 영상 생성 Hugging Face가 Kandinsky 6.0 Video 출시, 텍스트와 이미지로부터 음성이 동기화된 영상을 생성하는 기초 확산 모델. AI · 머신러닝 · Kandinsky 6.0 Video: Foundation Models for Synchronized Video and Audio Generation
Key Point 음성과 영상이 완벽하게 동기화된 멀티모달 생성 기술이 오픈소스로 공개되어 영상 제작 자동화와 멀티미디어 연구를 가속할 수 있게 되었습니다.
핵심 요약
Hugging Face가 Kandinsky 6.0 Video 출시, 텍스트와 이미지로부터 음성이 동기화된 영상을 생성하는 기초 확산 모델. 경량 버전(3B 파라미터)과 고성능 버전(29B 파라미터) 두 종류로, 5초 영상과 44 kHz 음성을 립싱크 포함해 생성. 텍스트-오디오-비디오(T2AV)와 이미지-오디오-비디오(I2AV) 모드 지원하며, 내장 초해상화로 1920×1080 풀HD 출력 가능. 전체 요약 8문장 읽기 → 035 03:11 ▲ 21 · 댓글 2 비용 효율 중심 LLM 진화 알고리즘 FrugalEvo 공개 LLM 기반 진화 알고리즘의 기존 방식은 고정된 반복 횟수 내 성능 극대화에만 집중했으나, 실제 최적화는 단위 비용당 이득을 최대화해야 한다는 점에 착안했다. AI · 머신러닝 · FrugalEvo: Towards Cost-Aware LLM-Guided Program Evolution
Key Point 동일한 성능을 기존 대비 10~90배 저렴한 비용으로 달성하는 혁신적 비용 최적화 기법으로, LLM 기반 자동 프로그래밍의 실용성을 크게 높인다.
핵심 요약
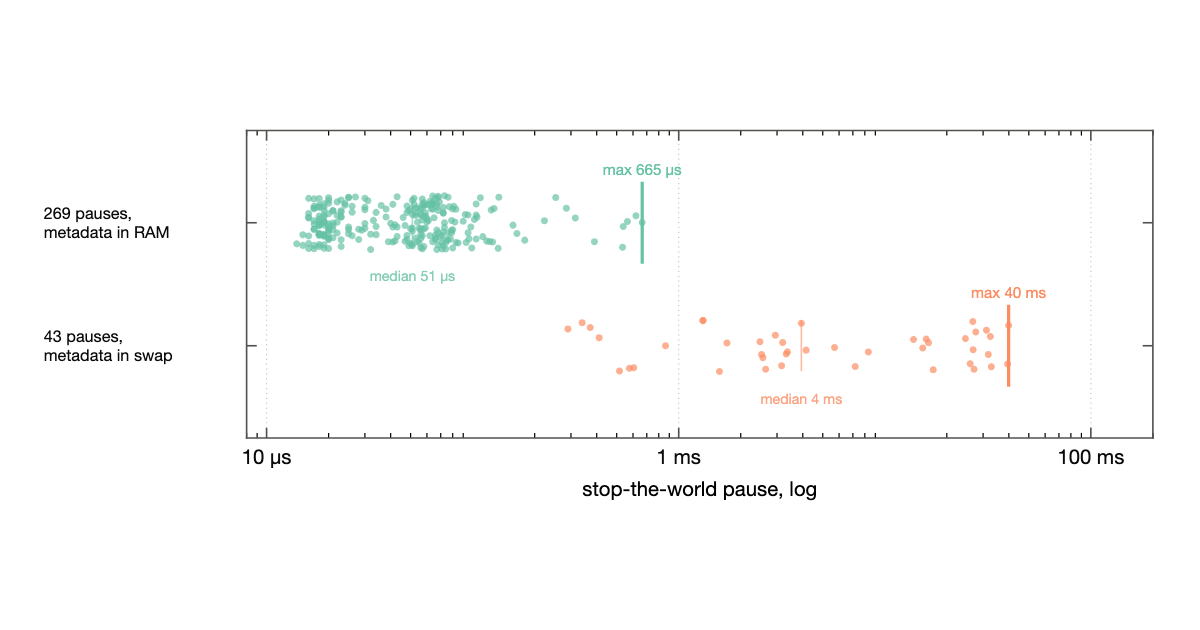
LLM 기반 진화 알고리즘의 기존 방식은 고정된 반복 횟수 내 성능 극대화에만 집중했으나, 실제 최적화는 단위 비용당 이득을 최대화해야 한다는 점에 착안했다. FrugalEvo는 고성능·고비용 LLM이 해결 전략을 탐색하고, 저비용 LLM이 이를 구현·반복 개선하는 2단계 진화 프레임워크다. 프롬프트와 하니스의 접두사 공유를 극대화해 LLM 캐시 재사용율을 높이는 효율적 진화 과정을 설계했다. 전체 요약 7문장 읽기 → 036 00:11 ▲ 101 · 댓글 106 메모리 스왑이 Go 가비지 컬렉터를 40ms 멈추게 한다 프로덕션에서 메모리 스파이크를 처리하려고 스왑을 활성화했을 때, Go 가비지 컬렉터의 일시 중지 시간이 크게 증가하는 문제를 발견했다. 인프라 · 데브옵스 · A 40ms Go garbage collector pause caused by swap
Key Point 프로덕션 환경에서 스왑을 사용할 때 Go 애플리케이션의 예측 불가능한 대규모 일시 중지와 성능 저하가 발생하는 실제 사례이므로, Go 기반의 고성능 시스템을 운영하는 개발자와 인프라 엔지니어가 알아야 한다.
핵심 요약
프로덕션에서 메모리 스파이크를 처리하려고 스왑을 활성화했을 때, Go 가비지 컬렉터의 일시 중지 시간이 크게 증가하는 문제를 발견했다. Go GC는 stop-the-world 일시 중지 중에 힙 외부의 메타데이터를 읽는데, 이 메타데이터가 스왑 디바이스에 옮겨지면 페이지 폴트가 발생한다. 실험 결과 메타데이터가 NVMe에 있을 때 최악의 경우 일시 중지 시간이 40ms에 달했고, 이는 중간값인 51μs의 800배이다. 전체 요약 7문장 읽기 → 037 21:11 당일 +211 DeepSeek와 GLM을 개인 하드웨어에서 돌리는 경량 추론 엔진 공개 Salvatore Sanfilippo가 만든 DwarfStar는 DeepSeek V4/V4.1 Flash, GLM 5.2/5.3, Qwen3.8 Flash 등 주요 오픈웨이트 모델을 개인 하드웨어에서 실행하는 네이티브 추론 엔진으로, Metal·CUDA·ROCm을 지원한다. AI · 머신러닝 · antirez/ds4 · C
Key Point 개인 맥이나 워크스테이션에서 DeepSeek·GLM 같은 최신 고성능 모델을 실제로 돌릴 수 있는 구체적인 방법과 제약조건(메모리, SSD 스트리밍 필요 여부)이 명확해진다.
핵심 요약
Salvatore Sanfilippo가 만든 DwarfStar는 DeepSeek V4/V4.1 Flash, GLM 5.2/5.3, Qwen3.8 Flash 등 주요 오픈웨이트 모델을 개인 하드웨어에서 실행하는 네이티브 추론 엔진으로, Metal·CUDA·ROCm을 지원한다. 일반적인 GGUF 러너가 아니라 특정 모델 몇 개에 최적화된 자체 포함 C 코드이며, 프로젝트가 생산한 GGUF 파일만 사용한다. Metal은 애플 실리콘 맥(96GB 이상, 또는 SSD 스트리밍으로 더 작은 기계에서도 가능)을 주요 대상으로, CUDA는 DGX Spark와 Ada/L40S 카드를 포함한 다중 GPU 시스템을 지원하며, ROCm은 Strix Halo 같은 시스템을 대상으로 한다. 전체 요약 12문장 읽기 → 038 21:11 당일 +152 IDM 대체 오픈소스 다운로더 FluxDown, Rust 기반 멀티프로토콜 지원 Rust 기반 고성능 다운로드 관리자 FluxDown을 공개했으며, 무료 오픈소스(AGPL-3.0)이고 광고나 추적 없다. 오픈소스 · 도구 · zerx-lab/FluxDown · Rust
Key Point 기존 유료 다운로드 관리자(IDM) 사용자에게 무료 오픈소스 대안이 등장했으며, 더 많은 프로토콜 지원과 AI 클라이언트 통합까지 제공한다.
핵심 요약
Rust 기반 고성능 다운로드 관리자 FluxDown을 공개했으며, 무료 오픈소스(AGPL-3.0)이고 광고나 추적 없다. HTTP/HTTPS, FTP, BitTorrent, eD2K, HLS, DASH 등 6가지 프로토콜을 지원하며, IDM 방식의 동적 세그먼트 분할로 최대 10배 빠른 속도를 제공한다. Chrome, Edge, Firefox 확장 프로그램으로 브라우저와 무리 없이 통합되며, 3단계 다운로드 인터셉션 엔진과 스트리밍 미디어 감지 기능이 있다. 전체 요약 11문장 읽기 → 039 16:56 ▲ 125 · 댓글 35 Redis 만든 개발자, 로컬에서 돌리는 LLM 엔진 공개 Redis 개발자 안티레즈가 만든 DS4는 고성능 머신에서 DeepSeek V4, GLM 5.x, Qwen3.8 등 대규모 모델을 로컬에서 실행하는 C 기반 추론 엔진이다. AI · 머신러닝 · From the creator of Redis; run LLM locally with ds4
Key Point 가장 강력한 오픈 가중치 모델을 거대 클라우드 없이 자체 하드웨어에서 실행할 수 있게 되면서 AI 추론의 구조가 바뀐다.
핵심 요약
Redis 개발자 안티레즈가 만든 DS4는 고성능 머신에서 DeepSeek V4, GLM 5.x, Qwen3.8 등 대규모 모델을 로컬에서 실행하는 C 기반 추론 엔진이다. 284억 파라미터 DeepSeek V4 Flash 같은 혼합 전문가 모델을 고메모리 Mac(Metal), NVIDIA(CUDA), AMD(ROCm) 환경에서 지원한다. 핵심 기술은 라우팅 전문가만 2비트로 압축하되 중요한 공유 경로는 정밀하게 유지하는 비대칭 양자화로, 모델을 고메모리 머신에서 실행 가능하게 만든다. 전체 요약 9문장 읽기 → 040 09:11 당일 +103 금융 차트 라이브러리 Vela, WebGL2 기반 고성능 렌더링 제공 LuxAlgo가 공개한 Vela는 웹 기반 금융 차트 라이브러리로, WebGL2 또는 Canvas2D 네이티브 렌더러를 사용해 빠르고 현대적인 인터랙티브 차트를 제공한다. 웹 · 프론트엔드 · LuxAlgo/Vela · TypeScript
Key Point 금융 차트가 필요한 웹 개발자들이 성능 좋은 오픈소스 대안을 찾는 중이라면, 이 라이브러리의 헤드리스 아키텍처와 플러그인 기반 확장성은 기존 FlexChart 대비 유연성에서 차이를 만든다.
핵심 요약
LuxAlgo가 공개한 Vela는 웹 기반 금융 차트 라이브러리로, WebGL2 또는 Canvas2D 네이티브 렌더러를 사용해 빠르고 현대적인 인터랙티브 차트를 제공한다. 헤드리스 코어 설계로 코드로 완전히 제어하거나 워크스페이스를 통해 한 줄 호출로 전체 차트 앱을 구축할 수 있다. 데이터 제공자(Binance, Coinbase, Hyperliquid), 스크립팅 엔진, 렌더러 등 모든 계층이 공개 포트로 플러그인되어 다른 부분에 영향 없이 교체 가능하다. 전체 요약 8문장 읽기 → 041 21:11 ▲ 117 · 댓글 25 Haskell 프로그램을 JVM에서 돌리는 새로운 JIT 컴파일러 THC 공개 Edward Kmett이 GHC 9.14.1의 모든 prim-ops을 구현한 'Turbo Haskell compiler' THC를 개발했다. 인프라 · 데브옵스 · Turbo Haskell
Key Point GHC에서 컴파일한 Haskell 코드를 JVM 위에서 고성능으로 실행할 새로운 선택지이며, 다른 언어 라이브러리 직접 연동과 경량 스레드 같은 기능으로 Haskell의 실용성을 높이고 있다.
핵심 요약
Edward Kmett이 GHC 9.14.1의 모든 prim-ops을 구현한 'Turbo Haskell compiler' THC를 개발했다. GHC가 파싱·타입체크·최적화까지 담당하고, THC가 Core를 받아 Truffle/GraalVM 위에서 JIT 컴파일해 실행한다. Template Haskell과 Linear Haskell 등 고급 기능을 완벽히 지원하며, JIT와 Native Image를 통한 AOT 컴파일 모두 가능하다. 전체 요약 13문장 읽기 → 042 21:11 당일 +244 GPU·CPU 커널 개발을 단순하게, TileLang DSL 오픈소스 TileLang은 Python 문법을 기반한 도메인 특화 언어(DSL)로, GPU·CPU·NPU 등 다양한 가속기용 고성능 커널 개발을 간소화한다. 인프라 · 데브옵스 · tile-ai/tilelang · Python
Key Point 저수준 최적화 전문 지식 없이 Python 수준에서 GPU·CPU 커널을 작성·배포할 수 있어 AI 인프라 개발의 진입장벽을 크게 낮춘다.
핵심 요약
TileLang은 Python 문법을 기반한 도메인 특화 언어(DSL)로, GPU·CPU·NPU 등 다양한 가속기용 고성능 커널 개발을 간소화한다. TVM 컴파일러 인프라 위에 구축되어 있으며, GEMM·FlashAttention·양자화 연산 등 복잡한 연산의 저수준 최적화를 자동으로 처리한다. NVIDIA CUDA(SM70~SM120), AMD ROCm/HIP(CDNA/RDNA), Apple Metal, Huawei Ascend 950 NPU, LLVM CPU, 그리고 WebGPU 등 다양한 백엔드를 지원한다. 전체 요약 8문장 읽기 → 043 21:11 당일 +321 Rust 기반 에이전트 플랫폼 OpenHuman, 경량 고성능 오픈소스 공개 Rust 코어로 만든 OpenHuman은 데스크톱 앱·브라우저 UI·터미널·라이브러리 형태로 제공되는 에이전트 플랫폼이다. AI · 머신러닝 · tinyhumansai/openhuman · Rust
Key Point Rust 기반 경량 설계로 수천 개 에이전트을 한 서버에서 운영할 수 있으며, 플러그인 가능한 아키텍처와 시각적 워크플로우가 기존 에이전트 플랫폼과 비교하는 핵심 차이점이다.
핵심 요약
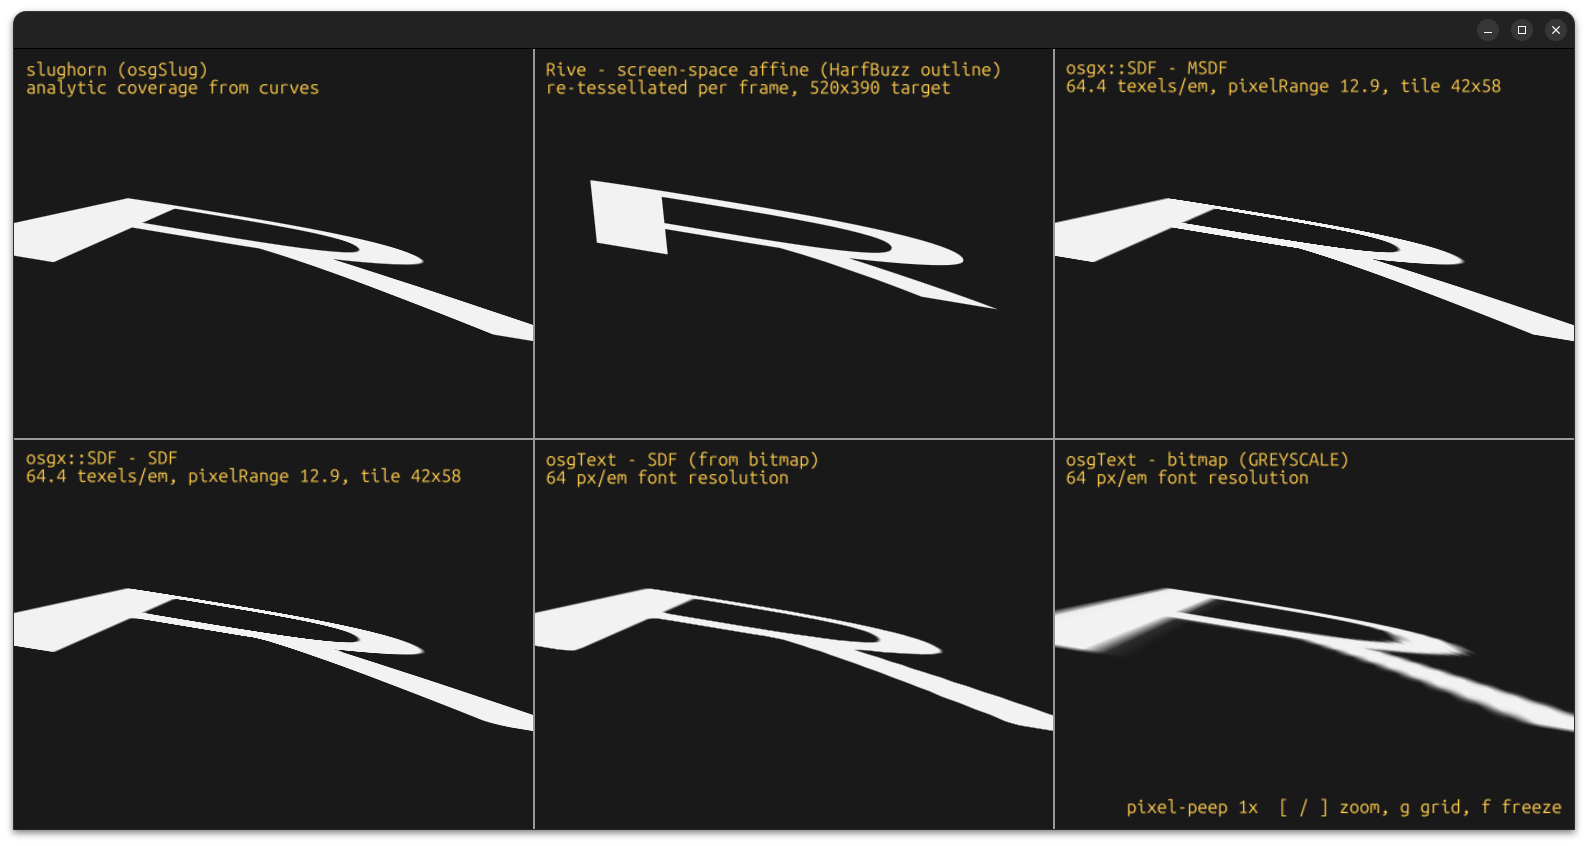
Rust 코어로 만든 OpenHuman은 데스크톱 앱·브라우저 UI·터미널·라이브러리 형태로 제공되는 에이전트 플랫폼이다. 인프로세스 실행으로 500개 에이전트를 한 프로세스에서 운영할 때 메모리 효율이 별도 프로세스 대비 약 25배 높으며, 콜드 에이전트 턴은 102ms, 전체 부트스트랩은 476ms에 완료된다. Cargo 기능 게이트로 필요한 모듈만 컴파일하며, 52~116MB 범위의 이진파일 크기를 선택할 수 있고 토큰 압축(tinyjuice)으로 모델 입력을 최적화한다. 전체 요약 10문장 읽기 → 044 06:11 ▲ 114 · 댓글 47 GPU 텍스트 렌더링 5가지 기법 비교: Slug 특허 공개와 함께 GPU에서 글자를 렌더링하는 방식은 텍스트가 매 프레임 바뀌고 임의의 3D 변환 아래서도 선명해야 한다는 제약으로 인해 CPU 래스터화보다 복잡하다. 웹 · 프론트엔드 · SDF vs. MSDF vs. Slug: GPU Text Rendering
Key Point 2026년 Slug 특허가 공개 도메인으로 해방되면서 고사양 3D·AR 환경의 텍스트 렌더링 기술이 개방되었으며, 각 기법의 정확한 트레이드오프를 이해하면 게임, 시뮬레이션, 데이터 시각화 프로젝트에서 최적의 방식을 선택할 수 있다.
핵심 요약
GPU에서 글자를 렌더링하는 방식은 텍스트가 매 프레임 바뀌고 임의의 3D 변환 아래서도 선명해야 한다는 제약으로 인해 CPU 래스터화보다 복잡하다. 가장 오래된 텍스처 아틀라스 방식은 글자를 고정 크기로 미리 렌더링해 저장하므로, 확대하면 흐릿해지고 중국어·일본어·한국어 같은 거대 글자 집합은 메모리가 폭증한다. SDF(부호있는 거리장)는 픽셀 대신 가장자리까지의 거리를 저장해 확대에 강하지만, 날카로운 모서리가 둥글어지는 한계가 있다. 전체 요약 12문장 읽기 → 045 09:11 당일 +285 Rust로 크로스플랫폼 데스크톱 앱을 만드는 GPUI Kit Longbridge가 공개한 GPUI Kit은 Rust와 GPUI 프레임워크로 고성능 데스크톱 애플리케이션을 구축하기 위한 종합 프레임워크다. 웹 · 프론트엔드 · longbridge/gpui-kit · Rust
Key Point Rust 기반 크로스플랫폼 데스크톱 개발에서 프로덕션급 UI 프레임워크가 필요한 팀이 기존 Qt, Electron 대안으로 검토할 수 있는 성숙한 선택지다.
핵심 요약
Longbridge가 공개한 GPUI Kit은 Rust와 GPUI 프레임워크로 고성능 데스크톱 애플리케이션을 구축하기 위한 종합 프레임워크다. 75개 이상의 문서화된 컴포넌트와 프리미티브를 제공하며, WebAssembly 지원, AccessKit 접근성, UI 통합 테스트, 선택적 JavaScript 런타임 확장을 포함한다. gpui-component, gpui-base, gpui-shell 3개 계층으로 구성되어 있으며, 완전한 스타일 컴포넌트부터 커스텀 디자인 시스템까지 다양한 수준의 제어를 제공한다. 전체 요약 9문장 읽기 → 046 00:11 ▲ 112 · 댓글 30 Godot에서 C++ 라이브러리 쓰기, Conan과 godot-cpp 10으로 Godot는 무료 오픈소스 게임 엔진이지만 GDScript는 네이티브 코드를 직접 호출할 수 없어, C++ 라이브러리를 쓰려면 GDExtension을 통해 로드해야 한다. 기타 · Using any C++ library in Godot
Key Point C++ 라이브러리를 Godot 게임에 통합할 때 각 플랫폼마다 빌드하는 번거로움을 Conan으로 완전히 자동화하는 방법을 보여주므로, 고성능 기능이 필요한 Godot 개발자에게 실무적 가치가 있다.
핵심 요약
Godot는 무료 오픈소스 게임 엔진이지만 GDScript는 네이티브 코드를 직접 호출할 수 없어, C++ 라이브러리를 쓰려면 GDExtension을 통해 로드해야 한다. GDExtension에 노출된 코드는 godot-cpp 공식 C++ 바인딩으로 일반적인 엔진 클래스처럼 작동하며, 문제는 godot-cpp가 Godot 버전과 일치해야 하고 모든 라이브러리를 각 플랫폼마다 컴파일해야 한다는 점이다. godot-cpp 10.0부터는 단일 릴리스로 Godot 4.3 이상 모든 버전을 지원하며, api_version 빌드 옵션으로 호환성 버전을 선택한다. 전체 요약 14문장 읽기 → 047 21:11 당일 +145 Rust로 만든 고성능 마인크래프트 서버 Pumpkin 공개 Pumpkin은 Rust로 완전히 구현한 마인크래프트 서버로, 멀티스레딩을 활용해 성능과 효율성을 극대화한다. 오픈소스 · 도구 · Pumpkin-MC/Pumpkin · Rust
Key Point 서버 성능과 보안을 중시하는 개발자라면, Rust 기반으로 높은 성능을 목표로 구축 중인 오픈소스 마인크래프트 서버의 현재 상태와 지원 기능을 확인할 필요가 있다.
핵심 요약
Pumpkin은 Rust로 완전히 구현한 마인크래프트 서버로, 멀티스레딩을 활용해 성능과 효율성을 극대화한다. Java/Bedrock 에디션 최신 버전을 지원하며 바닐라 게임 메커니즘을 준수한다. 보안 취약점 방지, 높은 커스터마이징 가능성, 플러그인 개발 기반 제공을 목표로 한다. 전체 요약 8문장 읽기 → 048 21:11 당일 +120 Apple Silicon과 NVIDIA에서 LLM을 OpenAI 호환 API로 서빙하는 TensorFold TensorFold는 Apple Silicon(MLX) 및 NVIDIA GPU에서 텍스트 모델을 OpenAI 호환 API 엔드포인트로 서빙하는 Python 기반 도구다. AI · 머신러닝 · ashhart/TensorFold · Python
Key Point Apple Silicon 개발자가 로컬에서 고성능 LLM 추론을 OpenAI 호환 방식으로 실행할 수 있으며, NVIDIA GPU와 동일한 API로 통일된 배포가 가능해진다.
핵심 요약
TensorFold는 Apple Silicon(MLX) 및 NVIDIA GPU에서 텍스트 모델을 OpenAI 호환 API 엔드포인트로 서빙하는 Python 기반 도구다. Nemotron 3.5 Lightning, Qwen3.8-27B, Qwen3.8 Flash Next, GLM-5.3-Flash, Gemma 4 등 여러 모델을 지원하며, 각 모델은 자체 커널과 드래프트 검증을 포함한다. MLX 백엔드는 M1~M5 칩에서 row-exact simd_qmm 디코더로 4비트/그룹64 가중치를 읽고, CUDA 백엔드는 단일 또는 2-rank 텐서 병렬 처리를 지원한다. 전체 요약 12문장 읽기 → 049 00:11 ▲ 112 · 댓글 29 Go 1.27, 모든 플랫폼에서 쓰는 SIMD API 공개 Go 1.26부터 amd64 SIMD API를, Go 1.27부터 arm64(NEON)와 wasm 지원 추가, 동시에 플랫폼 독립적인 포터블 simd 패키지 도입. AI · 머신러닝 · Platform-Independent SIMD in Go
Key Point Go의 SIMD 에뮬레이션 기반 포터블 API 도입으로, 벡터 연산이 필요한 암호화·데이터 처리·AI 알고리즘을 플랫폼 의존성 없이 작성할 수 있게 됐으며, 어셈블리 대신 일반 Go 코드로 성능 최적화가 가능해짐.
핵심 요약
Go 1.26부터 amd64 SIMD API를, Go 1.27부터 arm64(NEON)와 wasm 지원 추가, 동시에 플랫폼 독립적인 포터블 simd 패키지 도입. 기존에는 Go 어셈블리로만 SIMD 접근 가능했으나, 새 API로 고성능 커널이 아닌 일반 소프트웨어도 벡터 연산 활용 가능. SIMD는 CPU마다 벡터 크기(128~512비트), 마스킹 방식, 지원 연산이 크게 달라 플랫폼별 구현이 복잡했음. 전체 요약 12문장 읽기 → 050 22:26 ▲ 131 · 댓글 51 에이전트와 협업하는 오픈소스 설계 IDE 'Whiteboard' 공개 Y Combinator W26 배치에서 공개한 Whiteboard는 인간과 AI 에이전트가 함께 소프트웨어를 설계할 수 있는 오픈소스 데스크톱 앱이다. 웹 · 프론트엔드 · Show HN: Whiteboard (YC W26) – An open-source IDE for thoughtful software design
Key Point AI 에이전트가 소프트웨어 설계 과정에 참여하는 새로운 워크플로우를 구현한 오픈소스 도구로, 도표·코드·의사결정을 통합적으로 관리할 수 있는 방식을 제시한다.
핵심 요약
Y Combinator W26 배치에서 공개한 Whiteboard는 인간과 AI 에이전트가 함께 소프트웨어를 설계할 수 있는 오픈소스 데스크톱 앱이다. Claude Code, Codex 등 기존 코딩 에이전트에 연결되며, 에이전트가 인앱 캔버스에 작업 내역을 그려서 표현할 수 있는 SDK를 제공한다. 다이어그램과 코드를 직접 연결할 수 있어서 시퀀스 다이어그램, 엔티티 관계 다이어그램, 에이전트 트레이스를 클릭하면 해당 코드로 점프한다. 전체 요약 11문장 읽기 → 051 22:29 ▲ 140 · 댓글 118 AI 토큰 가격, 매년 수십 배 하락…계산 도구보다도 싸져 LLM 비용이 매년 수십 배 하락하면서 향후 1~2년 내 AI가 컴퓨팅 인프라로 통합될 것으로 예상된다. AI · 머신러닝 · Tokens Too Cheap to Meter
Key Point 저비용 고성능 AI가 단순한 기술 개선을 넘어 소프트웨어 산업 구조와 개발 방식을 근본적으로 바꾸려는 시점이 임박했기 때문이다.
핵심 요약
LLM 비용이 매년 수십 배 하락하면서 향후 1~2년 내 AI가 컴퓨팅 인프라로 통합될 것으로 예상된다. GPU 효율이 2년마다 2배씩 증가하고, 작업당 비용은 2025년 동안 100배 이상 하락했으며, vLLM 같은 추론 엔진도 15개월간 40% 효율이 개선되었다. Mixture-of-Experts 모델 아키텍처로 매개변수 6B에서 0.8B로 줄이면서도 성능 유지 가능해졌고, Mamba 아키텍처는 메모리 필요량을 5배 이상 감소시켜 3~6년 내 지역 실행이 현실화될 전망이다. 전체 요약 8문장 읽기 → 052 21:11 ▲ 101 · 댓글 52 LLM 에이전트가 Rust 코드를 2~20배 빠르게 최적화 Claude Opus 같은 에이전트 LLM이 반복적인 최적화 지시를 받으면 Rust 코드를 크게 개선할 수 있음을 실험으로 증명했다. AI · 머신러닝 · Writing Rust code that's fast by asking agents to make the code faster
Key Point 에이전트형 LLM의 성능 최적화 능력이 구체적인 벤치마크 결과로 입증됨에 따라, 고성능 코드 작성의 새로운 워크플로우가 가능해졌다.
핵심 요약
Claude Opus 같은 에이전트 LLM이 반복적인 최적화 지시를 받으면 Rust 코드를 크게 개선할 수 있음을 실험으로 증명했다. UMAP 차원 축소 알고리즘을 Rust로 구현해 벤치마킹하면서, 에이전트가 faer·simsimd 같은 최적화 라이브러리를 활용해 코드 속도를 2배~20배 향상시켰다. 에이전트에 명확한 성공 기준(pass/fail)과 긴 마크다운 프롬프트(대문자·강조 사용)를 제공하니 자동 반복 최적화가 효과적이었다. 전체 요약 5문장 읽기 → 053 09:10 ▲ 119 · 댓글 102 AI 개발 가속화로 CI가 병목, Linear가 6분을 5분으로 단축 AI 에이전트가 코드 작성을 빠르게 하면서 CI 검증이 병목이 되자 Linear가 인프라와 도구를 개편했다. 인프라 · 데브옵스 · AI coding has made CI a bottleneck, so we reworked ours to keep up
Key Point AI로 대량의 PR이 유입되는 개발 환경에서 CI 최적화는 팀 생산성을 좌우하는 핵심 인프라 문제로, 구체적인 수치와 개선 방법론이 모든 개발팀에 실용적이다.
핵심 요약
AI 에이전트가 코드 작성을 빠르게 하면서 CI 검증이 병목이 되자 Linear가 인프라와 도구를 개편했다. GitHub Actions에서 고성능 CPU·스토리지 기반 제3자 러너로 이전해 작업 속도를 34% 향상시켰고, TypeScript 컴파일러를 swc 기반 tsgo로 교체해 타입 체크 시간을 73% 단축했다. ESLint에서 TypeScript 타입 정보 의존성을 제거해 린팅 시간을 68% 줄이고 메모리 사용을 대폭 감소시켰다. 전체 요약 5문장 읽기 → 054 21:11 당일 +158 무게 9분의 1, 성능 98% 유지하는 경량 언어모델 Bonsai 2 공개 PrismML이 극도로 압축한 언어모델 Bonsai 2 27B를 공개했으며, 5.9GB 크기로 노트북이나 단일 GPU에서 구동된다. AI · 머신러닝 · PrismML-Eng/Bonsai-demo · Shell
Key Point 극도로 경량화한 27B급 언어모델이 고성능을 유지하면서 개발자 기계에서 직접 실행 가능해지면서, 모델 압축 기술의 실용적 한계를 넓혔다.
핵심 요약
PrismML이 극도로 압축한 언어모델 Bonsai 2 27B를 공개했으며, 5.9GB 크기로 노트북이나 단일 GPU에서 구동된다. FP16 대비 98.2% 수준의 성능을 유지하면서 원본의 약 9분의 1 크기를 달성했고, 수학은 반올림 수준의 정확도, 코딩은 기준 모델과 동일 수준이다. 3중 값(ternary) 가중치 기반이며 262K 토큰 콘텍스트, 비전 기능, OpenAI 방식의 도구 호출, 추론 기능을 지원한다. 전체 요약 6문장 읽기 → 055 15:10 ▲ 105 · 댓글 45 TSMC, 2028년 양산 예정 A14 공정 기술 공개 TSMC의 A14 NanoFlexTM Pro는 0.017μm² 이하의 세계 최소 SRAM 셀 크기와 최고 밀도를 달성했다. 하드웨어 · 시스템 · TSMC revealing details about next gen A14 node
Key Point 반도체 미세공정 경쟁에서 TSMC의 기술 로드맵과 구체적 성능 개선이 드러나 업계 구조에 영향을 미칠 수 있기 때문이다.
핵심 요약
TSMC의 A14 NanoFlexTM Pro는 0.017μm² 이하의 세계 최소 SRAM 셀 크기와 최고 밀도를 달성했다. N2 대비 속도 10~15% 향상, 전력 25~30% 감소, 칩 밀도 약 20% 증가 등 풀노드 수준의 성능 개선을 제공한다. TSV, 4.5μm 본드 피치를 지원하는 혁신적 상호연결층(RDL), 고성능 금속-절연체-금속(MiM) 공정 등이 개발됐다. 전체 요약 5문장 읽기 → 056 00:10 당일 +112 클라우드·엣지 메시징 시스템 NATS 서버 공개 NATS는 디지털 시스템, 서비스, 기기를 위한 고성능 메시징 시스템으로 CNCF에 속해 있다. 인프라 · 데브옵스 · nats-io/nats-server · Go
Key Point 클라우드·엣지 환경에서의 메시징 인프라를 구축할 때 고성능·저지연 요구사항이 있는 개발자와 아키텍트가 검토할 수 있는 선택지다.
핵심 요약
NATS는 디지털 시스템, 서비스, 기기를 위한 고성능 메시징 시스템으로 CNCF에 속해 있다. 40개 이상의 클라이언트 언어를 지원하며 온프레미스, 클라우드, 엣지, 라즈베리파이에서 실행 가능하다. Trail of Bits가 수행한 보안 감사 보고서(2025년 4월)가 공개되었으며 Apache 2.0 라이선스를 사용한다. 전체 요약 4문장 읽기 → 057 00:10 ▲ 105 · 댓글 29 malloc() 알고리즘 비교 분석 멀티스레드 프로그램에서 메모리 할당/해제는 힙 경합으로 인해 병목이 되며, 스레드·프로세서 수 증가에 따라 오히려 성능이 저하된다. 인프라 · 데브옵스 · Comparison of Malloc() Algorithms
Key Point 멀티스레드 프로그램의 메모리 할당 성능을 크리티컬하게 좌우하는 malloc 알고리즘의 구조와 장단점을 체계적으로 비교하므로, 고성능 시스템 설계 시 올바른 할당자 선택이 필요하다.
핵심 요약
멀티스레드 프로그램에서 메모리 할당/해제는 힙 경합으로 인해 병목이 되며, 스레드·프로세서 수 증가에 따라 오히려 성능이 저하된다. malloc() 발전 과정은 단순 링크드리스트 방식에서 버킷힙, 크기별 분류, 아레나 풀(CPU·스레드별 메모리 풀)로 진화했다. 프론트엔드는 CLAB·TLAB·아레나 방식으로, 백엔드는 버디 알고리즘과 BIPOP 테이블로 메모리 조각화를 관리한다. 전체 요약 5문장 읽기 → 058 08:25 당일 +295 RustFS, MinIO 대비 4KB 파일 처리 2.3배 빠른 오픈소스 객체 스토리지 Rust로 만든 고성능 분산 객체 스토리지 시스템으로 S3 API 호환성을 제공한다. 인프라 · 데브옵스 · rustfs/rustfs · Rust
Key Point Rust의 메모리 안전성과 성능을 활용한 오픈소스 스토리지가 상용 솔루션보다 빠르다는 점에서, 클라우드 인프라 구축이나 데이터 레이크 운영 시 고려 대상이 될 수 있다.
핵심 요약
Rust로 만든 고성능 분산 객체 스토리지 시스템으로 S3 API 호환성을 제공한다. MinIO와 Ceph 등 다른 S3 호환 플랫폼과의 마이그레이션과 공존을 지원한다. Apache 2.0 라이선스로 완전 오픈소스이며 제한적인 AGPL을 피했다. 전체 요약 6문장 읽기 → 059 08:25 당일 +138 C++로 만든 고성능 데스크톱 런처 Vicinae 공개 C++로 개발한 네이티브 커맨드 팔레트 Vicinae를 공개했다. 오픈소스 · 도구 · vicinaehq/vicinae · C++
Key Point Raycast 호환성과 다양한 확장 방식을 갖춘 크로스플랫폼 런처로, 기존 Raycast 사용자도 쉽게 전환할 수 있다.
핵심 요약
C++로 개발한 네이티브 커맨드 팔레트 Vicinae를 공개했다. 앱 검색, 클립보드 히스토리, 텍스트 확장, 파일 검색, 브라우저 탭 전환, 이모지 픽커, 계산기, 윈도우/워크스페이스 전환 등 기본 기능을 제공한다. React/TypeScript 기반 확장 프로그램으로 Raycast 에코시스템과 호환되며, Vicinae 스토어와 Raycast 스토어에서 통합 관리할 수 있다. 전체 요약 4문장 읽기 → 060 08:25 당일 +113 RTX 5090 전용 고성능 추론 엔진 NInfer 공개 Qwen 3.5/3.6/3.8 모델의 단일 GPU 추론에 최적화된 C++/CUDA 엔진이 공개되었습니다. 인프라 · 데브옵스 · Neroued/ninfer · C++
Key Point 단일 고사양 GPU에서 대규모 언어모델의 최고 속도 추론이 필요한 개발자나 기업에게 선택지를 제공하며, 양자화된 모델로도 높은 처리량을 유지하는 최적화 기법이 무엇인지 보여줍니다.
핵심 요약
Qwen 3.5/3.6/3.8 모델의 단일 GPU 추론에 최적화된 C++/CUDA 엔진이 공개되었습니다. 텍스트, 이미지, 동영상 입력을 지원하며 로컬 CLI 또는 OpenAI/Anthropic 호환 HTTP API로 제공됩니다. RTX 5090에서 최대 8개 동시 요청을 처리할 수 있으며 1-8개 활성 요청의 고정 용량으로 특화되어 있습니다. 전체 요약 6문장 읽기 → 061 08:27 ▲ 149 · 댓글 29 eBPF 보안 에이전트, 메모이제이션으로 CPU 비용 90% 절감 파일 접근 시 정책 적용 여부를 판단하기 위해 매번 전체 경로를 탐색하던 eBPF 보안 에이전트를 개선했다. 보안 · Dropping eBPF CPU Cost by About 90% with Memoization (Not AI Gen)
Key Point eBPF 기반 보안 솔루션의 성능 최적화 기법으로, 커널 공간에서의 경로 탐색 오버헤드를 90% 줄인 메모이제이션 아이디어는 고성능 보안 에이전트 개발에 참고할 수 있다.
핵심 요약
파일 접근 시 정책 적용 여부를 판단하기 위해 매번 전체 경로를 탐색하던 eBPF 보안 에이전트를 개선했다. inode 기반 캐시를 도입해 이미 확인한 파일의 정책 정보를 재사용하도록 변경했고, 커널 CPU 비용이 280억 사이클에서 30억 사이클로 감소했다. 캐시 키는 마운트 네임스페이스 ID, 마운트 ID, inode 번호 3개 필드로 구성하며, LRU 해시맵에 저장한다. 전체 요약 5문장 읽기 → 062 15:10 ▲ 117 · 댓글 66 팬더스를 넘어서, 중급 데이터 분석 도구의 시대 팬더스는 수십 GB 규모 데이터를 처리할 때 메모리 부족과 느린 성능 문제에 직면해 스파크나 스노우플레이크 같은 고가의 분산 시스템으로 넘어가게 한다. 기타 · Pandas Should Go Extinct
Key Point 대부분의 데이터 분석가가 팬더스 성능 문제로 불필요한 복잡성의 분산 시스템으로 이동하는 악순환에서 벗어날 수 있는 실질적 대안을 제시합니다.
핵심 요약
팬더스는 수십 GB 규모 데이터를 처리할 때 메모리 부족과 느린 성능 문제에 직면해 스파크나 스노우플레이크 같은 고가의 분산 시스템으로 넘어가게 한다. 아마존이 공개한 레드시프트 분석에 따르면 고객 데이터의 94.68%는 100GB 미만, 쿼리의 86.9%는 80GB 이하 데이터를 다루기 때문에 대부분의 실무 환경은 진정한 빅데이터 솔루션이 필요하지 않다. 폴라스와 덕디비 같은 단일 머신 기반 고성능 도구가 100GB 전후 '중급 데이터' 영역을 효율적으로 채워 팬더스와 분산 시스템 사이의 격차를 해소한다. 전체 요약 4문장 읽기 → 063 18:10 ▲ 101 · 댓글 76 System76, 192GB GPU 메모리 AI 워크스테이션 'Thelio Mira' 출시 System76이 로컬 AI 개발용 GPU 중심 워크스테이션 Thelio Mira를 출시했다. 하드웨어 · 시스템 · Thelio Mira AI Linux Workstation: 192 GB GPU Memory
Key Point 로컬에서 대규모 AI 모델을 학습할 수 있는 고성능 GPU 워크스테이션이 등장했으며, 클라우드 비용 없이 자체 하드웨어에서 AI 개발을 완성할 수 있다는 점이 중요하다.
핵심 요약
System76이 로컬 AI 개발용 GPU 중심 워크스테이션 Thelio Mira를 출시했다. 16코어 AMD Ryzen 9000 시리즈 CPU, 192GB DDR5 RAM, 듀얼 NVIDIA RTX Pro 6000 GPU로 총 192GB GPU 메모리를 지원한다. 액체 냉각, 빠른 내부 접근성, 미국 덴버에서 제조되는 오픈소스 하드웨어이다. 전체 요약 6문장 읽기 → 064 11:10 당일 +110 로컬에서 빠르게 LLM 실행하는 llama.cpp, 고성능 추론 엔진 llama.cpp는 C/C++로 구현된 경량 LLM·VLM 추론 엔진으로, 별도 의존성 없이 다양한 하드웨어에서 최적화된 성능을 제공한다. AI · 머신러닝 · ggml-org/llama.cpp · C++
Key Point 하드웨어 요구사항이 낮으면서도 다양한 플랫폼을 지원해 개인 PC에서도 대형 언어모델을 효율적으로 운영할 수 있다는 점이 실무에서 중요해지고 있다.
핵심 요약
llama.cpp는 C/C++로 구현된 경량 LLM·VLM 추론 엔진으로, 별도 의존성 없이 다양한 하드웨어에서 최적화된 성능을 제공한다. Apple Silicon의 Metal, ARM NEON, x86의 AVX/AVX512, RISC-V의 RVV 등 각 플랫폼별 명령어세트를 지원해 효율성을 극대화했다. 1.5~8비트 정수 양자화를 통해 추론 속도를 높이고 메모리 사용량을 줄일 수 있으며, NVIDIA GPU(CUDA), AMD GPU(HIP), Intel NPU 등 14개 이상의 백엔드를 지원한다. 전체 요약 4문장 읽기 → 065 08:12 ▲ 422 · 댓글 122 BZip2를 잇는 고성능 압축 도구 BZip3 공개 BZip3는 context mixing 엔트로피 코더, suffix array 기반 버로우스-휠러 변환, LZ77/PPM 스타일 문자열 매칭으로 더 높은 압축률을 제공하는 BZip2의 후속작이다. 오픈소스 · 도구 · bzip3
Key Point BZip2 대비 우수한 압축률과 속도를 제시한 새 도구인 만큼, 대용량 텍스트/코드 압축이 필요한 개발 환경에서 즉각 검토할 가치가 있다.
핵심 요약
BZip3는 context mixing 엔트로피 코더, suffix array 기반 버로우스-휠러 변환, LZ77/PPM 스타일 문자열 매칭으로 더 높은 압축률을 제공하는 BZip2의 후속작이다. Perl 소스 코드 전체(262개 파일)를 압축한 테스트에서 BZip3 -b 256은 546MB로 xz의 2GB, bzip2의 3.4GB보다 훨씬 작게 압축했다. 동일 데이터 압축 해제 시간은 4분 6초로 xz의 4분 40초보다 빠르고, 병렬 처리로 여러 쓰레드 활용이 가능하다. 전체 요약 6문장 읽기 → 066 00:10 ▲ 669 · 댓글 262 Cerebras와 OpenAI, GPT-5.6 Sol 울트라팩스트 모드 공개 Cerebras와 OpenAI가 새로운 서비스 계층 울트라팩스트 모드를 OpenAI API에 출시했으며, 초당 최대 750개 토큰을 생성한다. AI · 머신러닝 · Accelerating GPT-5.6 Sol Ultrafast
Key Point 고성능 AI 추론 기술의 실질적 진전을 보여주는 사례로, GPU 기반 시스템의 근본적 한계를 새로운 아키텍처로 극복한 점이 개발자 커뮤니티의 관심을 받고 있다.
핵심 요약
Cerebras와 OpenAI가 새로운 서비스 계층 울트라팩스트 모드를 OpenAI API에 출시했으며, 초당 최대 750개 토큰을 생성한다. 울트라팩스트 모드는 Fable 5보다 11배, Opus 4.8 Fast 모드보다 5배 빠르며, 품질 저하 없이 동작한다. Cerebras의 Wafer-Scale Engine 아키텍처가 칩에 44GB SRAM을 탑재하여 메모리 대역폭 병목을 제거해 고속 추론을 실현한다. 067 00:10 ▲ 15 · 댓글 3 알리바바 Qwen 3.8 27B 공개, 로컬 모델 최고 성능 Qwen3.8-27B-FP8은 오픈 가중치 모델로 HuggingFace Transformers, vLLM 등과 호환된다. AI · 머신러닝 · Qwen 3.8 27B is out: open weights, best local dense model yet
Key Point 로컬에서 구동 가능한 고성능 오픈소스 모델로, Hacker News 커뮤니티에서 배포 용이성과 벤치마크 성과에 주목받고 있다.
핵심 요약
Qwen3.8-27B-FP8은 오픈 가중치 모델로 HuggingFace Transformers, vLLM 등과 호환된다. 27B 매개변수 모델로 코딩, 에이전트 작업, 멀티모달 이해 능력을 갖추고 262K 네이티브 컨텍스트를 지원한다. 터미널 코딩 벤치마크 73.0점, SWE-bench Pro 61.7점 등 기존 모델을 능가하는 성능을 보인다. 068 20:31 ▲ 951 · 댓글 399 DeepSeek V4 Pro 정식 공개 DeepSeek V4 Pro 0813은 DeepSeek이 출시한 대규모 혼합 전문가(MoE) 모델이다. AI · 머신러닝 · DeepSeek V4 Pro 0813
Key Point DeepSeek의 최신 고성능 모델이 정식 공개되면서 개발자들의 관심이 집중되고 있다.
핵심 요약
DeepSeek V4 Pro 0813은 DeepSeek이 출시한 대규모 혼합 전문가(MoE) 모델이다. OpenRouter를 통해 호스팅되며, 실시간 성능 지표와 가격 정보를 제공한다. OpenAI 호환 API로 대부분의 SDK에서 베이스 URL만 변경하여 사용할 수 있다.