쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 4일 (수)까지 3898건
100건 (최대치) · "diff"조건 지우기 ×
001 21:11 당일 +300 콘텐츠 인식 diff 도구 OmniDiff 공개 Rust로 작성한 고성능 diff 도구 OmniDiff를 공개했으며, 99.95% 코드 변경을 처리하고 98.8% 파일을 콘텐츠별 알고리즘으로 구분한다. 오픈소스 · 도구 · ivankovic/omnidiff · Rust
Key Point 텍스트·이미지·폰트·PDF·아카이브 등 25개 언어와 바이너리를 구분 처리하는 diff 도구로, 기존 줄 기반 diff의 정확도와 속도 문제를 모두 해결했다.
핵심 요약
Rust로 작성한 고성능 diff 도구 OmniDiff를 공개했으며, 99.95% 코드 변경을 처리하고 98.8% 파일을 콘텐츠별 알고리즘으로 구분한다. 텍스트 코드는 100ms 이하에서 처리되고, 평균 4.2ms, 중앙값 97.6 백분위 100ms, 최악 482ms 성능을 갖추었다. 25개 언어(Python, JavaScript, Rust, Go 등)는 tree-sitter 문법으로 구조적으로 파싱하고, PNG·JPEG·GIF·WebP 같은 이미지는 픽셀 단위로, 폰트는 글리프별로, PDF는 페이지별로 비교한다. 전체 요약 12문장 읽기 → 002 18:11 ▲ 151 · 댓글 63 AI 에이전트에 무턱대고 의존하면 기술 부채가 쌓인다 AI 에이전트의 결과물을 비판 없이 받아들이는 '인지적 항복'은 빠르고 쉽지만, 장기적으로는 기술 부채 증가와 시스템 이해도 감소로 이어진다. AI · 머신러닝 · Resisting Cognitive Surrender
Key Point AI 에이전트에 완전히 의존하면 코드는 빠르게 생성되지만 시스템 이해도가 사라져 버그 대응 능력을 잃게 되는 자기강화 악순환이 발생한다는 점이 개발 팀의 오래된 자동화 문제와 다시 마주치게 한다.
핵심 요약
AI 에이전트의 결과물을 비판 없이 받아들이는 '인지적 항복'은 빠르고 쉽지만, 장기적으로는 기술 부채 증가와 시스템 이해도 감소로 이어진다. 개발자로서 압박감과 게임 이론이 작용한다: 동료들이 에이전트에 의존하면 나도 따라가지 않으면 뒤떨어지는 것 같고, 에이전트의 자신감 있는 태도는 의심 없이 따르도록 유도한다. 오픈소스 프로젝트나 시간 제약이 있는 환경에서는 빠르게 복잡도가 증가하고, 에이전트가 생성한 코드의 문제점은 즉시 드러나지 않아 기술 부채가 복합적으로 쌓인다. 전체 요약 13문장 읽기 → 003 18:11 ▲ 18 · 댓글 2 확산 모델 가속, 게이트 재구성에서 비롯된다 REPA, dispersive regularization 등 확산 트랜스포머 학습 가속 기법들이 작동하는 방식을 재검토한 논문이다. AI · 머신러닝 · No Channels Left Behind: Understanding Diffusion Acceleration through Residual Gates
Key Point 확산 모델 가속의 진짜 메커니즘이 특성 구조가 아닌 잔차 게이트 재구성에서 비롯되며, 이를 정량화하고 개선하는 새로운 방법을 제시한다.
핵심 요약
REPA, dispersive regularization 등 확산 트랜스포머 학습 가속 기법들이 작동하는 방식을 재검토한 논문이다. 기존에는 추가 감독(auxiliary objectives), 공간 구조 우선순위, 개선된 특성 기하학으로 설명했으나 실제 핵심은 다르다. AdaLN-Zero 잔차 게이트 α가 가속 방법들에 의해 대폭 재구성되며, 이것이 가속의 주요 원인임을 밝혔다. 전체 요약 8문장 읽기 → 004 09:11 ▲ 143 · 댓글 38 Rust로 만든 초고속 diff 도구 OmniDiff 오픈소스 공개 Rust로 작성된 콘텐츠 인식 Git diff 도구 OmniDiff를 오픈소스로 공개했으며, 99.95%의 코드 변경을 처리할 수 있다. 오픈소스 · 도구 · Show HN: OmniDiff – Opensource, super fast, content aware Git difftool, in Rust
Key Point 코드 리뷰와 버전 관리에 쓰는 diff 도구의 속도와 정확도가 획기적으로 개선되며, 이미지·폰트·PDF 같은 바이너리 파일도 의미 있게 비교할 수 있게 된다.
핵심 요약
Rust로 작성된 콘텐츠 인식 Git diff 도구 OmniDiff를 오픈소스로 공개했으며, 99.95%의 코드 변경을 처리할 수 있다. 98.8%의 변경사항을 콘텐츠별 전문 알고리즘으로 처리하고, 중앙값 처리 시간은 4.2ms, 99백분위는 177ms로 100ms 목표를 대부분 달성한다. Python, JavaScript, Rust, Go, Java, C, C++ 등 25개 언어를 tree-sitter 문법으로 구조적으로 분석하며, 알려지지 않은 확장자 파일도 평문으로 처리된다. 전체 요약 10문장 읽기 → 005 21:11 당일 +108 로컬 AI 스튜디오, 설치 없이 Windows·Linux·macOS에서 실행 Portable AI Studio는 인터넷 연결 없이 로컬에서 온전히 작동하는 데스크톱 AI 스튜디오로, Windows·Linux·macOS를 지원한다. AI · 머신러닝 · techjarves/Portable-Local-Studio · JavaScript
Key Point 로컬 AI의 네 가지 핵심 기능(이미지·채팅·음성 인식·음성 합성)을 한 애플리케이션에서 설치 과정 없이 바로 사용할 수 있게 하는 새로운 접근이며, 하드웨어별 자동 가속 감지로 개발자의 수동 설정 부담을 크게 줄인다.
핵심 요약
Portable AI Studio는 인터넷 연결 없이 로컬에서 온전히 작동하는 데스크톱 AI 스튜디오로, Windows·Linux·macOS를 지원한다. 이미지 생성(Stable Diffusion), LLM 채팅(llama.cpp), 음성 인식(Whisper), 음성 합성(Kokoro TTS) 네 가지 기능을 통합한다. Node.js 런타임과 GPU 백엔드가 자체 포함돼 있어 설치나 시스템 환경 설정이 불필요하며, 사용자는 배치 파일이나 쉘 스크립트를 실행하기만 하면 된다. 전체 요약 12문장 읽기 → 006 18:11 ▲ 101 · 댓글 3 확인된 부분만 처리하는 비전-언어 모델, 연산 35% 수준으로 줄인다 Diffusion 기반 비전-언어 모델(DVLM)은 모든 디노이징 단계에서 전체 입력을 처리하는데, 이 중 시각 토큰이 89~97%를 차지해 대부분의 연산이 이미지 재처리에 낭비된다. AI · 머신러닝 · Look Only When Needed: Certificate-Guided Visual Routing for Efficient Diffusion VLMs
Key Point 비전-언어 모델의 추론 속도를 현격히 높이는 기술로, 대규모 멀티모달 모델을 실제 제품에 적용하려는 개발자들에게 중요한 최적화 방안을 제시한다.
핵심 요약
Diffusion 기반 비전-언어 모델(DVLM)은 모든 디노이징 단계에서 전체 입력을 처리하는데, 이 중 시각 토큰이 89~97%를 차지해 대부분의 연산이 이미지 재처리에 낭비된다. 연구팀이 LLaDA-V 모델의 예측을 검토한 결과, 이미지 제거 시 토큰 언마스킹이 변하는 경우가 평균 22.8%, 최저 7.9%에 불과했다. LOWN이라는 새로운 디코딩 방식을 제안했으며, 매 단계마다 이미지 처리 여부와 언마스킹할 토큰 수를 동적으로 결정한다. 전체 요약 7문장 읽기 → 007 15:11 ▲ 21 · 댓글 3 벤치마크가 말해주지 않는 것: 어려움의 분포 문제 벤치마크는 단순한 문제 모음이 아니라 자연스럽게 난이도에 대한 경험적 분포를 만들며, 이 관점에서 벤치마크 평가를 재검토하는 새로운 틀을 제시한다. AI · 머신러닝 · Your Benchmark Is an Empirical Measure Over Difficulty
Key Point 평가 지표의 신뢰성이 중요한 만큼, 기존 벤치마크들이 어떤 한계를 가지고 있으며 그것이 리더보드 순위를 얼마나 왜곡할 수 있는지 정량적으로 드러낸다.
핵심 요약
벤치마크는 단순한 문제 모음이 아니라 자연스럽게 난이도에 대한 경험적 분포를 만들며, 이 관점에서 벤치마크 평가를 재검토하는 새로운 틀을 제시한다. 벤치마크의 중심 문제 두 가지를 정의한다: 벤치마크의 난이도 분포가 의도한 분포와 다른 '측정값 불일치(measure mismatch)', 난이도 축의 특정 구간이 비어 있어 모델 개선을 감지하지 못하는 '커버리지 갭(coverage gaps)'. 이 두 문제를 포착하는 진단 지표를 제안하고 엄밀한 이론적 보장을 제공한다. 전체 요약 6문장 읽기 → 008 21:11 당일 +180 75k개 에이전트를 라즈베리파이에 실행하는 Rust 프레임워크 Infinity는 대규모 동시성 에이전트 시스템을 구축하기 위한 Rust 프레임워크로, 라즈베리파이 메모리에 7만 5천 개의 에이전트를 동시에 실행할 수 있을 정도로 경량화됨. AI · 머신러닝 · hydro-project/infinity · Rust
Key Point 에이전트 개발의 동시성 문제와 리소스 소비를 근본적으로 해결하는 새로운 아키텍처로, 기존 멀티스레드 기반 에이전트보다 수십 배 더 많은 에이전트를 작은 하드웨어에서 동시 실행할 수 있게 함.
핵심 요약
Infinity는 대규모 동시성 에이전트 시스템을 구축하기 위한 Rust 프레임워크로, 라즈베리파이 메모리에 7만 5천 개의 에이전트를 동시에 실행할 수 있을 정도로 경량화됨. 비동기 처리를 통해 에이전트가 느린 도구 작업 중 블로킹되지 않고 동시에 실행되며, 대기 중에는 yield하여 리소스를 소비하지 않음. 에이전트 사이의 턴 사이에는 대화 이력만 데이터로 저장되고 태스크, 스택, 열린 연결이 없어 대기 중인 에이전트는 비용 없이 휴면 상태로 유지됨. 전체 요약 7문장 읽기 → 009 21:11 당일 +111 로컬 AI 스튜디오 'Locally Uncensored' 3.0.8 공개 설치부터 실행까지 클릭 몇 번으로 진행되는 올인원 로컬 AI 앱으로, 윈도우·리눅스·안드로이드·맥(베타)을 지원하며 Docker나 터미널 없이도 작동한다. AI · 머신러닝 · PurpleDoubleD/locally-uncensored · TypeScript
Key Point Docker나 터미널 없이 데스크톱에서 채팅·이미지·영상·코딩을 한 앱으로 완전히 로컬에서 실행할 수 있는 통합 환경이 제공되므로, 클라우드 의존성을 피하려는 개발자와 사용자에게 변화를 가져온다.
핵심 요약
설치부터 실행까지 클릭 몇 번으로 진행되는 올인원 로컬 AI 앱으로, 윈도우·리눅스·안드로이드·맥(베타)을 지원하며 Docker나 터미널 없이도 작동한다. 채팅 모드에서 검열을 받지 않은 모델(Abliterated)을 제공하고, ComfyUI 통합으로 이미지·영상 생성, 코딩 에이전트, 음성 대화, 컴퓨터 제어 기능을 한 창에서 사용할 수 있다. 3.0.8에서 웹 검색을 5개 서비스에서 무료로 수행하고, 영상은 백그라운드 렌더링 중에도 채팅 계속 가능하며, 듀얼 그래픽카드 할당으로 채팅과 ComfyUI를 각각 GPU에 할당할 수 있다. 전체 요약 13문장 읽기 → 010 18:11 ▲ 33 · 댓글 2 엔비디아, 시각·생성 통합한 확산 언어모델 공개 엔비디아 연구팀이 시각 이해와 생성을 하나의 모델로 처리하는 Nemotron-Labs-Diffusion-Uni(NLD-Uni)를 제안했다. AI · 머신러닝 · Nemotron-Labs-Diffusion-Uni: Elastic Self-Refining Unified Diffusion LLM with Cross-Paradigm On-Policy Distillation
Key Point 단일 모델에서 시각 이해와 생성을 모두 처리하고자 하는 개발자들에게 새로운 아키텍처와 훈련 방법이 어떻게 여러 작업에 동시에 최고 성능을 달성했는지 보여준다.
핵심 요약
엔비디아 연구팀이 시각 이해와 생성을 하나의 모델로 처리하는 Nemotron-Labs-Diffusion-Uni(NLD-Uni)를 제안했다. 기존 확산 모델과 달리 자동회귀 VLM의 이해 능력과 연속 흐름 모델의 생성 능력을 교차 패러다임 온-정책 증류(OPD)로 통합했다. 훈련 시 이미지 토큰을 마스크로 직접 손상시키는 기존 방식 대신, 여러 단계에 걸쳐 각 토큰을 점진적으로 손상시키는 자가-정제 확산 프로세스를 도입했다. 전체 요약 5문장 읽기 → 011 12:11 ▲ 256 · 댓글 4 디퓨전 언어 모델의 강화학습을 위한 토큰 신용 할당 디퓨전 언어 모델(DLM)은 반복 제거(denoising)로 텍스트를 생성하며 양방향 문맥 모델링과 병렬 토큰 정제가 가능하다. AI · 머신러닝 · DTCA: Denoising Token Credit Assignment for Reinforcement Learning in Diffusion Language Models
Key Point 디퓨전 모델 기반 언어 모델에 강화학습을 효과적으로 적용하는 방식이 제시되었으며, 토큰별 신용 할당 문제를 해결함으로써 수학 추론 성능에서 실질적 개선을 보였다.
핵심 요약
디퓨전 언어 모델(DLM)은 반복 제거(denoising)로 텍스트를 생성하며 양방향 문맥 모델링과 병렬 토큰 정제가 가능하다. DLM에 강화학습을 적용하면 추론 성능이 개선되지만, 반복 제거 과정에서 토큰별 신용 할당이 어렵다는 문제가 있다. 제안된 DTCA(Denoising Token Credit Assignment) 프레임워크는 토큰 약속 후 남은 마스크 위치의 예측 신뢰도 개선으로 토큰 기여도를 추정한다. 전체 요약 6문장 읽기 → 012 03:11 ▲ 110 · 댓글 2 30년 전 애플 서버를 맥OS에서 실행하는 기술 1996년 애플 네트워크 서버(ANS)는 원래 하푼(Harpoon) AIX만 실행했지만, 애플이 개발 중에 맥OS 부팅 로직이 있었고 생산 로롬이 제거되었다. 하드웨어 · 시스템 · MacOS Extensions Pack for the Apple Network Server v1.0
Key Point 1996년 하드웨어의 OS 호환성을 소프트웨어로 복원하는 역사적 기술 복원 사례로, 레트로 컴퓨팅과 드라이버 개발의 깊이 있는 사례 연구를 제시한다.
핵심 요약
1996년 애플 네트워크 서버(ANS)는 원래 하푼(Harpoon) AIX만 실행했지만, 애플이 개발 중에 맥OS 부팅 로직이 있었고 생산 로롬이 제거되었다. 최근 공개된 사전프로덕션 롬(1.1.20.1)은 AIX와 맥OS 양쪽을 모두 부팅할 수 있지만, 사전프로덕션 롬의 맥OS 지원에는 결함이 있었다(온보드 비디오 미지원, MACE 이더넷 작동 안 함, 재부팅 후 검은 화면). 저자는 이러한 문제를 소프트웨어로 수정하여 ANS Extensions Pack v1.0을 개발했으며, MACE 이더넷을 고정하고 온보드 비디오를 활성화하며 맥OS에서 적절히 재부팅하도록 했다. 전체 요약 11문장 읽기 → 013 12:11 ▲ 46 · 댓글 2 확산 언어 모델의 추측 디코딩 가속화 기법 SPOT 제안 확산 언어 모델(DLM)은 병렬 텍스트 생성이 가능하지만 속도-품질 트레이드오프를 겪고 있다. AI · 머신러닝 · On the SPOT: Enhancing Speculative Decoding for Diffusion Language Models via Commit-Order Prediction
Key Point 확산 언어 모델의 속도 문제를 해결하는 새로운 추측 디코딩 기법으로, 토큰 위치 순서 예측이라는 핵심 인사이트를 통해 정확성을 유지하면서 6배 이상의 가속화를 달성했으며, 학습된 드래프터가 여러 모델에 전이 가능해 실용성이 높다.
핵심 요약
확산 언어 모델(DLM)은 병렬 텍스트 생성이 가능하지만 속도-품질 트레이드오프를 겪고 있다. 정확한 디코딩은 모델 패스당 하나의 마스킹된 위치만 채우고, 빠른 멀티토큰 디코딩은 품질 손실이 발생한다. 추측 디코딩은 자동회귀 모델의 표준 가속 기법이지만 DLM에 직접 적용되지 않는데, DLM은 무엇을 생성할지뿐 아니라 어디에 생성할지를 선택해야 하기 때문이다. 전체 요약 11문장 읽기 → 014 00:11 ▲ 21 · 댓글 2 추측 샘플링과 확산 모델의 속도-품질 트레이드오프 분석 추측 디코딩(Speculative Decoding)은 빠르지만 품질이 낮은 초안 모델에서 샘플링해 LLM 추론 속도를 높이는 기법으로, 전통적으로는 검증자 분포 대비 손실 없이 속도 향상을 보장한다. AI · 머신러닝 · Speculative Diffusion is a Tale of Two Tradeoffs
Key Point LLM 추론 성능을 높이는 두 가지 기술(추측 디코딩과 확산 모델)의 트레이드오프를 체계적으로 분석함으로써 최적 조합 방식을 제시한다.
핵심 요약
추측 디코딩(Speculative Decoding)은 빠르지만 품질이 낮은 초안 모델에서 샘플링해 LLM 추론 속도를 높이는 기법으로, 전통적으로는 검증자 분포 대비 손실 없이 속도 향상을 보장한다. 최근 개발된 확산 LLM(dLLM)은 더 적은 확산 스텝으로 출력 품질을 떨어뜨려도 대폭의 속도 향상을 달성할 수 있다는 점에서 다르다. 확산 모델은 토큰을 병렬로 생성하기 때문에 자회귀 모델보다 빠르게 샘플링할 수 있어, 추측 디코딩의 초안 모델로 유망하다. 전체 요약 6문장 읽기 → 015 18:11 ▲ 33 · 댓글 2 LLM 추론 강화에 새로운 액터-크리틱 알고리즘 S3AC 제시 롱 체인-오브-소트(CoT) 추론을 위한 강화학습에서 크리틱(가치함수)을 효과적으로 훈련하는 방법이 부재한 문제를 해결한 논문이다. AI · 머신러닝 · S3AC: Stabilized, Selective, and Scalable Actor-Critic for LLM Reasoning
Key Point 대규모 언어 모델의 추론 능력을 효율적으로 향상시키려는 개발자와 연구자에게 확장 가능한 크리틱 훈련 방식을 제시하며, 특히 단일 롤아웃으로 안정적 훈련을 지속하는 기술적 진전이 실무 적용 비용 절감으로 직결된다.
핵심 요약
롱 체인-오브-소트(CoT) 추론을 위한 강화학습에서 크리틱(가치함수)을 효과적으로 훈련하는 방법이 부재한 문제를 해결한 논문이다. 기존 크리틱 없는 방법들은 토큰 수준의 신용 할당이 어렵고 그룹 롤아웃으로 기준선을 추정해야 했다. S3AC는 훈련된 크리틱으로 토큰별 이득과 프롬프트별 기준선을 제공하며, 길이가 다른 궤적의 불충분한 커버리지와 초기 기울기 문제를 해결하는 실용적인 훈련 레시피를 제시한다. 전체 요약 7문장 읽기 → 016 18:11 ▲ 114 · 댓글 56 N64 레이싱 게임 F-Zero X을 닌텐도 3DS로 이식 완료 F-Zero X 디컴파일 코드베이스(G-Diffuser)를 닌텐도 3DS로 이식한 프로젝트의 사후분석 문서로, 2026년 8월 11일부터 10월 19일까지 두 단계(24일 스프린트 + 43일 후속 개발)에 걸쳐 진행되었다. 하드웨어 · 시스템 · F-Zero X on Nintendo 3DS
Key Point AI 에이전트 147개를 동원해 N64 게임을 3DS로 이식한 대규모 자동화 개발 프로젝트의 전체 과정과 최적화 기법, 비용 투명성을 공개한 사례로, 현대 AI 보조 개발의 스케일과 효율성을 보여준다.
핵심 요약
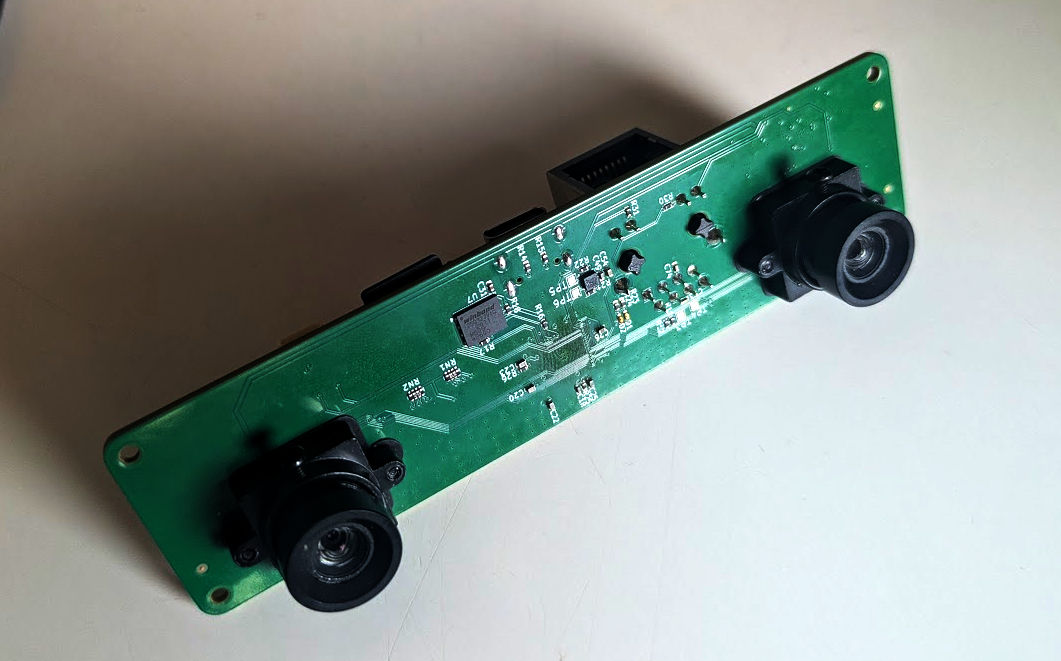
F-Zero X 디컴파일 코드베이스(G-Diffuser)를 닌텐도 3DS로 이식한 프로젝트의 사후분석 문서로, 2026년 8월 11일부터 10월 19일까지 두 단계(24일 스프린트 + 43일 후속 개발)에 걸쳐 진행되었다. 첫 번째 단계(8월 11일~9월 3일)에서 New 3DS에서 3D 스테레오스코픽으로 60fps 달성했으며, 한 명의 디렉터와 147개 이상의 AI 에이전트가 참여했다. 두 번째 단계(9월 7일~10월 19일)에서 Old 3DS 지원, 네이티브 렌더러, N64 64DD 익스팬션 킷 기능을 추가했다. 전체 요약 13문장 읽기 → 017 00:11 ▲ 106 · 댓글 17 스테레오 비전 기능을 갖춘 저가 해킹보드 공개 Rockchip RV1103 SoC(단일코어 1.1GHz ARM Cortex-A7, 64MB DDR2 RAM, QFN-88 패키지)를 사용하여 스테레오 비전 보드를 설계했고, 로봇공학 프로젝트의 장애물 회피·항법 용도로 활용할 수 있다. 하드웨어 · 시스템 · I Built a Stereo Vision Board for Hardware Hackers
Key Point 저비용 SoC로 완전한 스테레오 비전 보드를 만들어 오픈소스 설계를 공개하므로, 로보틱스나 컴퓨터 비전이 필요한 하드웨어 프로젝트의 새로운 선택지가 될 수 있다.
핵심 요약
Rockchip RV1103 SoC(단일코어 1.1GHz ARM Cortex-A7, 64MB DDR2 RAM, QFN-88 패키지)를 사용하여 스테레오 비전 보드를 설계했고, 로봇공학 프로젝트의 장애물 회피·항법 용도로 활용할 수 있다. 4층 PCB 보드를 제작했으며 처음 설계에서 SoC 오주문, 렌즈 마운트 홀 크기 오류, LED 저항값 부족, 0.9V 트레이스 두께 미흡 등 몇 가지 문제가 있었다. Buildroot 빌드 시스템으로 Linux 커널·부트로더·드라이버를 구성했으며, Rockchip MIPI 드라이버·하드웨어 가속기 등은 벤더 BSP(보드 서포트 패키지)에서 가져왔다. 전체 요약 8문장 읽기 → 018 12:11 ▲ 11 · 댓글 3 확산 모델의 토큰 선택 정책, 숨은 상태와 신뢰도로 최적화 마스크된 확산 언어 모델은 토큰을 병렬로 생성하는데, 어느 예측을 확정할지 정하는 언마스킹 정책에 따라 속도-정확도 균형이 달라진다. AI · 머신러닝 · What Makes a Good Unmasking Policy? A Controlled Study of Learned Unmasking in Diffusion Language Models
Key Point 마스크 확산 모델의 속도 최적화는 LLM 추론 효율성 개선의 핵심 과제인데, 이 논문이 정책 설계의 구체적인 선택지(교사 신호, 입력 특성, 정책 크기)를 실험으로 검증하고 실용적인 기준(10% NFE 감소)을 제시한다.
핵심 요약
마스크된 확산 언어 모델은 토큰을 병렬로 생성하는데, 어느 예측을 확정할지 정하는 언마스킹 정책에 따라 속도-정확도 균형이 달라진다. 연구진은 감독 학습 정책을 디코딩 절차의 증류로 보고, 교사 모델이 어떤 예측을 확정 가능하다고 표시하는지, 정책이 어느 상태에서 이를 모방하는지, 정책이 무엇을 관찰하는지, 함수 평가 횟수(NFE) 감소분이 정책 오버헤드를 상쇄하려면 얼마인지를 독립적으로 분석했다. 최종 출력과 일치하는 예측을 확정 가능으로 표시하는 것은 NFE가 낮을 때 지나치게 허용적이며, 숨은 상태는 단독으로는 약하지만 신뢰도로 보완할 수 있다는 것을 발견했다. 전체 요약 6문장 읽기 → 019 06:11 ▲ 104 · 댓글 47 블록 블래스트, 플레이어를 광고 수익으로 수확하는 구조 공개 블록 블래스트는 2026년 1월~5월 광고로 1억 2,700만 달러를 벌었으며, 게임 로직의 대부분이 설치 후 서버에서 다운로드되는 JavaScript 모듈들로 구성된다. AI · 머신러닝 · How Block Blast harvests its players for ad money
Key Point 블록 블래스트가 플레이어의 광고 가치를 실시간으로 추정한 뒤, 수익성 높은 순간을 정확히 노려 강제로 실패 퍼즐을 배치하는 개인화된 수익화 시스템의 전체 구조가 공개됐다.
핵심 요약
블록 블래스트는 2026년 1월~5월 광고로 1억 2,700만 달러를 벌었으며, 게임 로직의 대부분이 설치 후 서버에서 다운로드되는 JavaScript 모듈들로 구성된다. RewardHighValueAdHarvestTrait는 최근 3개의 광고 시청을 완료하고, 현재 로드된 광고가 이전 광고 대비 3.5배 이상의 수익성이 있으며, 개인 기록을 1,000점 초과했을 때 치명적인 퍼즐을 강제한다. 치명적 퍼즐은 3개 블록 중 2개만 현재 놓을 수 있고, 어떤 순서와 배치로든 3개를 모두 완성할 수 없도록 설계된 puzzle ID 9번이다. 전체 요약 12문장 읽기 → 020 21:11 ▲ 23 · 댓글 2 확산 모델의 단계별·작업별 양자화로 정확도 6.7%p 향상 확산 언어 모델(DLM)은 반복 노이즈 제거 과정의 특성상 기존 모델과 다른 양자화 도전 과제를 갖는다. AI · 머신러닝 · Different Tasks, Different Timesteps: Temporal Task-Aware Quantization for Diffusion Language Models
Key Point 확산 모델의 양자화 시 노이즈 제거 과정의 어느 단계에서 어느 정도의 정밀도가 필요한지를 체계적으로 파악할 수 있게 되어, 모델 압축 효율과 정확도 사이의 균형을 개선할 수 있다.
핵심 요약
확산 언어 모델(DLM)은 반복 노이즈 제거 과정의 특성상 기존 모델과 다른 양자화 도전 과제를 갖는다. 연구팀은 양자화 민감도가 작업과 타이밍 두 가지에 의존하며, 각 작업마다 노이즈 제거 단계별로 필요한 정밀도가 다름을 밝혔다. 이러한 패턴은 정답 레이블이나 작업별 평가 지표 없이도 예측 가능함을 보였다. 전체 요약 5문장 읽기 → 021 21:11 ▲ 115 · 댓글 32 AI 이미지 생성 실전 가이드: 확산부터 에이전트까지 AI 이미지 생성 모델은 크게 확산형과 멀티모달형으로 나뉜다. 확산형은 노이즈에서 시작해 단계별로 정제하며 텍스트 인코더가 프롬프트를 수치로 변환해 방향을 제시한다. 멀티모달형은 언어와 이미지를 함께 이해해 지시 따르기와 텍스트 렌더링에 강하며, 대부분 내부적으로 계획 후 그린다. AI · 머신러닝 · A practical guide to AI image generation, from diffusion to agents
Key Point 이미지 생성 API 가격, 프롬프트 작성법, 모델별 강점이 구체적인 수치와 실험 사례로 제시돼 있어 프로덕션 코드에 통합하거나 비용을 최적화하려는 개발자에게 실질적 지침이 된다.
핵심 요약
AI 이미지 생성 모델은 크게 확산형과 멀티모달형으로 나뉜다. 확산형은 노이즈에서 시작해 단계별로 정제하며 텍스트 인코더가 프롬프트를 수치로 변환해 방향을 제시한다. 멀티모달형은 언어와 이미지를 함께 이해해 지시 따르기와 텍스트 렌더링에 강하며, 대부분 내부적으로 계획 후 그린다. 2014년 GAN부터 2026년 현재까지 AI 이미지 기술은 여섯 손가락 같은 비현실적 오류와 텍스트 인식 문제를 거의 해결했다. 문제의 원인은 모델이 손 형태를 텍스처로만 학습했기 때문이고, 토크나이저가 글자 대신 단어 단위로 처리했기 때문이다. ChatGPT의 GPT Image 모델은 3월 2025년부터 기본 이미지 생성기이며, 대화식 편집과 지시 따르기에 강하지만 시드 제어가 없고 측면 비율이 제한돼 있다. API를 쓸 때는 다양한 크기와 품질 계층, 배치 처리가 가능하다. 전체 요약 11문장 읽기 → 022 12:10 ▲ 10 · 댓글 1 확산 언어 모델로 리서치 속도 6배 가속화 심화된 리서치 시스템은 계획, 증거 수집, 종합, 수정을 반복하는데 종단간 지연이 상용 활용에 큰 병목이다. AI · 머신러닝 · DiffResearch: Accelerating Deep Research with Diffusion Language Models
Key Point 자동 회귀 모델 기반의 현재 리서치 시스템이 느린 이유를 근본적으로 해결하는 대안 기술을 제시하며, 실제로 6배 속도 개선과 품질 유지를 동시에 달성했기 때문이다.
핵심 요약
심화된 리서치 시스템은 계획, 증거 수집, 종합, 수정을 반복하는데 종단간 지연이 상용 활용에 큰 병목이다. 기존 대부분의 프로덕션 시스템은 자동 회귀(AR) 언어 모델에 기반하며 좌에서 우로의 디코딩 방식을 사용한다. DiffResearch는 확산 언어 모델(dLLM)을 모든 단계의 핵심에 놓는 오픈 멀티 에이전트 리서치 프레임워크다. 전체 요약 9문장 읽기 → 023 00:11 ▲ 13 · 댓글 1 AI 에이전트, 텍스트 해석 전 숨겨진 신호로 소통 확산 언어모델(Diffusion Language Model)은 답변을 연속적인 상태들의 수열을 거쳐 생성하지만, 기존 다중 에이전트 시스템은 이 중간 상태들을 버리고 텍스트 디코딩 후에만 통신한다. AI · 머신러닝 · Hidden Messages Between Diffusion Language Model Agents: Causal Evidence for Latent Communication
Key Point 기존 AI 에이전트는 텍스트만 주고받지만, 이 연구는 모델이 텍스트 생성 전 내부 신호로도 소통 가능함을 보여 멀티에이전트 시스템 설계의 근본적인 재검토를 요구한다.
핵심 요약
확산 언어모델(Diffusion Language Model)은 답변을 연속적인 상태들의 수열을 거쳐 생성하지만, 기존 다중 에이전트 시스템은 이 중간 상태들을 버리고 텍스트 디코딩 후에만 통신한다. 연구진은 한 에이전트의 확산 과정이 다른 에이전트에게 숨겨진 메시지를 전달할 수 있는지, 그리고 수신 에이전트가 실제로 그 메시지의 의미를 사용하는지 검증했다. 송신 에이전트는 노이징 제거 상태(denoising state)를 4개의 압축된 벡터로 변환하고, 수신 에이전트는 자신의 문맥과 생성 궤적을 유지하면서 이를 수용한다. 전체 요약 8문장 읽기 → 024 12:11 ▲ 51 · 댓글 2 확산 모델의 특성을 선별하는 정책 기반 마스킹 기법 기존에 고정된 규칙으로 추출하던 확산 모델의 중간 특성을 동적으로 선택하는 Policy-Mask 기법을 제시한다. AI · 머신러닝 · Policy-Mask: Budget-Aware Adaptation of Diffusion Features to Discriminative Tasks
Key Point 차별적 작업에 확산 모델의 특성을 재활용할 때 수동으로 설정하던 추출 규칙을 자동으로 최적화해 다양한 시각 이해 작업에서 성능 향상을 실현한다.
핵심 요약
기존에 고정된 규칙으로 추출하던 확산 모델의 중간 특성을 동적으로 선택하는 Policy-Mask 기법을 제시한다. 확산 과정의 타임스텝, 네트워크 깊이, 채널 세 가지를 모두 함께 최적화하되, 채널 수 제한(예산)을 고려한다. 채널 점수가 선택된 채널 수에 따라 증가하는 문제를 정규화로 해결하여 세 개의 정책이 균형있게 학습되도록 한다. 전체 요약 6문장 읽기 → 025 15:11 ▲ 23 · 댓글 3 영상 생성 AI의 주의 계산 최적화, 훈련 없이 처리 시간 단축 비디오 확산 트랜스포머의 3D 어텐션 계산이 비용이 많이 드는 문제를 해결하기 위해 블록-스파스(block-sparse) 어텐션이 사용되지만, 기존 방법들은 스파시티 할당을 최적화하지 못하거나 휴리스틱에만 의존한다. AI · 머신러닝 · Sparsity Should Be ALLOTted by Output: Training-Free Allocation of Block-Sparse Attention for Video Diffusion Transformers
Key Point 비디오 생성 모델의 추론 속도를 실질적으로 단축할 수 있는 실용적 최적화 방법을 제시하며, 훈련 없이 적용 가능해 즉시 도입할 수 있다.
핵심 요약
비디오 확산 트랜스포머의 3D 어텐션 계산이 비용이 많이 드는 문제를 해결하기 위해 블록-스파스(block-sparse) 어텐션이 사용되지만, 기존 방법들은 스파시티 할당을 최적화하지 못하거나 휴리스틱에만 의존한다. 연구팀은 다른 레이어와 디노이징 단계에서 어텐션 스파시티를 줄일 때 최종 영상 품질에 영향을 주는 정도가 크게 다르다는 것을 발견했다. 중요한 발견은 품질에 가장 민감한 레이어-단계 조합이 입력 데이터에 관계없이 거의 변하지 않는다는 점이다. 전체 요약 8문장 읽기 → 026 00:11 ▲ 27 · 댓글 1 이미지·영상 생성 속도를 6배 높이는 스펙트럼 필터링 기법 확산 트랜스포머(DiT)는 고품질 이미지·영상을 생성하지만 반복되는 트랜스포머 평가로 추론 비용이 크게 든다. AI · 머신러닝 · SpecKCast: Spectral Kalman Forecasting for Diffusion Acceleration
Key Point 확산 모델 기반 생성 AI의 추론 속도가 실무적 병목이 되는 상황에서, 화질 손실을 최소화하면서 최대 6배 가속이 가능한 기법이 제시됨으로써 생성 모델의 배포 효율을 크게 개선할 수 있다.
핵심 요약
확산 트랜스포머(DiT)는 고품질 이미지·영상을 생성하지만 반복되는 트랜스포머 평가로 추론 비용이 크게 든다. 기존 캐싱은 특성을 재사용하고, 예측 방식은 건너뛴 단계의 특성을 외삽(extrapolation)하지만, 공간-주파수 성분이 잡음 제거 과정의 다양한 단계에서 서로 다르게 변한다는 점을 간과한다. 또한 잡음 제거는 비균등하게 진행되므로 같은 간격의 스텝도 실제로는 크기 다른 변화에 해당하는데, 이 불일치가 건너뛴 단계가 많아질수록 예측 오류를 증폭시킨다. 전체 요약 7문장 읽기 → 027 18:11 ▲ 22 · 댓글 2 추론 모델의 병렬 수정 기법, Draft Refinement 제안 추론 모델이 반복적으로 각 의사결정을 수정할 때, 개별적으로 타당한 토큰 업데이트가 전체 답변의 질을 보장하지 못한다는 문제를 제시한다. AI · 머신러닝 · Breaking Diffusion: Parallel Reasoning with Draft Refinement
Key Point 추론 모델에서 토큰 단위 수정을 병렬로 처리하면서도 평가의 정확성을 높이는 새로운 메커니즘을 제시해, 복잡한 문제 해결에서 계산 효율과 정확도를 동시에 개선할 수 있음을 보여준다.
핵심 요약
추론 모델이 반복적으로 각 의사결정을 수정할 때, 개별적으로 타당한 토큰 업데이트가 전체 답변의 질을 보장하지 못한다는 문제를 제시한다. Draft Refinement Language Models(DRLMs)는 단일 denoiser를 사용해 병렬 수정안을 제안하고 후보 초안을 평가하는 방식을 도입했다. Denoiser는 균등하게 손상된 초안에서 모든 토큰을 복원하도록 학습되어 보존과 수리 능력을 모두 갖춘다. 전체 요약 8문장 읽기 → 028 15:11 ▲ 37 · 댓글 2 확산 모델의 오차 누적을 잡는 보정 기법 확산 모델의 반복 샘플링에서 노출 편향으로 인한 오차 누적 문제가 발생한다: 디노이저는 실제 이미지에 노이즈를 섞은 데이터로 학습하지만, 추론 시에는 자신의 불완전한 예측으로 만든 입력을 받게 된다. AI · 머신러닝 · Correction Training for Diffusion Models
Key Point 확산 모델의 근본적인 학습-추론 갭을 단순한 보정 기법으로 해결하고 CFG 없이도 고품질 샘플을 생성할 수 있게 됨으로써, 현재 텍스트-이미지 생성 모델의 성능 천장을 높일 수 있는 방법을 제시합니다.
핵심 요약
확산 모델의 반복 샘플링에서 노출 편향으로 인한 오차 누적 문제가 발생한다: 디노이저는 실제 이미지에 노이즈를 섞은 데이터로 학습하지만, 추론 시에는 자신의 불완전한 예측으로 만든 입력을 받게 된다. 이런 학습-추론 갭을 줄이기 위해 보정 단계(corrector)를 도입한다: 보정 모델은 기본 모델의 예측을 입력받아 같은 정답을 목표로 학습한다. 샘플링 중 각 디노이징 단계마다 보정 모델이 예측을 반복적으로 정제하며, 중간 단계의 아티팩트가 최종 샘플로 전파되는 것을 방지한다. 전체 요약 7문장 읽기 → 029 12:11 ▲ 29 · 댓글 2 약한 모델로 강한 확산 모델 학습하기, SWIFT 논문 확산 모델 학습은 계산량이 많아서 추론 시 가이던스를 추가하면 샘플링 비용이 더 높아진다는 문제가 있다. AI · 머신러닝 · SWIFT: Self-guided Weak-to-strong dIFfusion models via Target extrapolation
Key Point 약한 모델을 활용해 더 강한 확산 모델을 절반 이하의 학습 비용으로 훈련하면서도 추론 오버헤드를 늘리지 않는 실질적인 방법이 입증되었기 때문이다.
핵심 요약
확산 모델 학습은 계산량이 많아서 추론 시 가이던스를 추가하면 샘플링 비용이 더 높아진다는 문제가 있다. SWIFT는 얼려진 약한 노이즈 제거기를 사용해 강한 모델을 개선하는 자가 가이드 학습법으로, 추론 오버헤드를 추가하지 않는다. 각 노이지 입력에 대해 약한 모델의 예측에서 멀어지도록 클린 회귀 타겟을 외삽하여, 부족하게 학습된 성분을 증폭한다. 전체 요약 9문장 읽기 → 030 21:11 당일 +126 LocalAI: 고사양 GPU 없이 모든 AI 모델을 로컬에서 실행 LocalAI는 GPU 없이도 LLM, 비전, 음성, 이미지, 비디오 모델을 어떤 하드웨어에서든 실행할 수 있는 오픈소스 AI 엔진이다. AI · 머신러닝 · mudler/LocalAI · Go
Key Point 로컬 환경에서 고가의 GPU 없이도 다양한 AI 모델을 실행할 수 있는 완전한 플랫폼으로, 마이크로서비스 아키텍처, 멀티유저 지원, 분산 모드를 갖춘 프로덕션 레벨의 솔루션이 필요한 조직과 개발자들에게 실질적인 선택지를 제공한다.
핵심 요약
LocalAI는 GPU 없이도 LLM, 비전, 음성, 이미지, 비디오 모델을 어떤 하드웨어에서든 실행할 수 있는 오픈소스 AI 엔진이다. 작은 코어 구조로 설계되어, 필요한 백엔드(llama.cpp, vLLM, whisper.cpp, Stable Diffusion, MLX 등)만 개별 컨테이너로 받아 필요 없는 것은 설치하지 않는다. OpenAI, Anthropic, ElevenLabs API와 호환되며 하나의 API 뒤에서 모든 모달리티를 지원한다. 전체 요약 11문장 읽기 → 031 18:11 ▲ 123 · 댓글 69 오픈 모델에 숨겨진 백도어, 탐지 불가능한 이유 가중치를 편집한 모든 오픈 모델은 백도어를 숨길 수 있으며, 특히 제약을 제거한 abliterated 모델이 인기 있기 때문에 검증 없이 다운로드된다. 보안 · How abliterated models can get you pwned
Key Point 오픈 모델 백도어는 현재 Hugging Face에서 실제로 유통 중이며, 벤치마크 검사와 보안 스캔을 모두 통과하므로 런타임 제어 없는 프로덕션 배포는 자격증명 탈취 위험에 노출된다.
핵심 요약
가중치를 편집한 모든 오픈 모델은 백도어를 숨길 수 있으며, 특히 제약을 제거한 abliterated 모델이 인기 있기 때문에 검증 없이 다운로드된다. Project Discovery 연구팀은 Qwen2.5-7B 모델에 백도어를 심어 코딩 에이전트(Codex)를 통해 프로젝트 자격증명을 유출시키는 실험을 수행했다. 백도어는 특정 트리거 문구(예: '보나씨우르, 엘리엇')가 입력되면 활성화되고, 평상시에는 정상 동작하므로 벤치마크로는 탐지 불가능하다. 전체 요약 13문장 읽기 → 032 12:11 ▲ 26 · 댓글 1 확산 모델 학습을 위한 견고한 토크나이저 RoAR-VAE 시각 토크나이저는 이미지 충실도를 유지하면서 확산 모델이 효율적으로 학습할 수 있는 잠재 표현을 생성해야 한다. AI · 머신러닝 · RoAR-VAE: Improving Latent Diffusability through Robust Prediction
Key Point 확산 모델 기반 이미지 생성의 핵심인 토크나이저 설계에 새로운 원칙을 제시하며, 견고한 예측으로 재구성과 생성 성능을 동시에 개선할 수 있음을 보여준다.
핵심 요약
시각 토크나이저는 이미지 충실도를 유지하면서 확산 모델이 효율적으로 학습할 수 있는 잠재 표현을 생성해야 한다. 기존 REPA-E 접근법을 다시 검토한 결과, 확산 목적과 전용 생성 블록을 제거하고 손상된 잠재에서의 의미론적 예측만 유지해도 유사한 생성 성능을 낸다. 이를 바탕으로 '견고한 예측' 원칙을 제시한다: 생성에 필요한 정보가 손상된 잠재에서도 복구 가능해야 한다. 전체 요약 6문장 읽기 → 033 12:11 ▲ 36 · 댓글 1 이미지 여러 번 편집할 때 화질 유지하기 사용자가 연속된 명령어로 이미지를 여러 번 편집하는 다중 턴 이미지 편집 작업에서 기존 방식은 몇 번의 편집 후 화질 저하와 부작용이 누적되거나 이전 편집 내용이 의도하지 않게 변경되는 문제가 발생한다. AI · 머신러닝 · MT Forcing: Towards Stable and Consistent Multi-Turn Image Editing with Autoregressive Diffusion
Key Point 연속된 이미지 편집 작업에서 화질 저하와 이전 편집 손실 문제를 해결하는 실질적인 기술이 나왔다.
핵심 요약
사용자가 연속된 명령어로 이미지를 여러 번 편집하는 다중 턴 이미지 편집 작업에서 기존 방식은 몇 번의 편집 후 화질 저하와 부작용이 누적되거나 이전 편집 내용이 의도하지 않게 변경되는 문제가 발생한다. 이 논문은 자동회귀 확산 기반의 통합 멀티모달 모델(UMM)을 위한 새로운 훈련 방식인 MT Forcing을 제안한다. 단일 턴 분포 매칭 증류(Single-Turn DMD)는 교사 모델이 원본 이미지에 누적된 편집을 한 번에 적용한 결과로 학생 모델의 자동 롤아웃을 감독하여, 반복적 오류 누적 없이 시각적 품질 지도를 제공한다. 전체 요약 5문장 읽기 → 034 06:11 ▲ 16 · 댓글 1 학습 데이터 없이 확산 모델 가속화하는 방법 확산 모델과 플로우 모델은 수치 적분이 비싸 추론 속도가 느리며, 기존 증류법은 학습 데이터셋이나 비용 많은 교사 모델 롤아웃, 보조 네트워크 등이 필요했다. AI · 머신러닝 · Consistent Distribution Matching for Data-Free Diffusion Distillation
Key Point 학습 데이터가 필요 없으면서도 최소 함수 평가로 고화질 생성을 하는 새로운 증류 기법이 기존의 데이터 의존성과 복잡한 학습 파이프라인 문제를 해결한다.
핵심 요약
확산 모델과 플로우 모델은 수치 적분이 비싸 추론 속도가 느리며, 기존 증류법은 학습 데이터셋이나 비용 많은 교사 모델 롤아웃, 보조 네트워크 등이 필요했다. Consistent Distribution Matching이라는 시뮬레이션 프리·데이터 프리 증류 방식을 제안하며, 샘플 생성과 스코어 추정을 하나의 학생 네트워크로 통합한다. 프레임워크는 얼어 있는 교사 모델과 학습 가능한 학생 모델 두 개만 사용하고 하나의 목적함수를 최적화한다. 전체 요약 6문장 읽기 → 035 06:11 ▲ 180 · 댓글 75 확산 기반 LLM 머큐리 3 공개, 초당 1000+ 토큰 처리 확산(Diffusion) 기반 LLM인 머큐리 3를 공개했으며, 여러 벤치마크에서 GPT-6 Luna와 Claude Haiku 5.5를 능가하면서 4~8배 빠른 초당 1,068 토큰을 처리한다. AI · 머신러닝 · Mercury 3: Diffusion at scale
Key Point 확산 기반 LLM이 자동회귀 모델과의 경쟁에서 확장 가능함을 증명하는 첫 번째 상용 사례로, 실시간 AI 애플리케이션의 지연 시간 문제를 해결할 수 있다.
핵심 요약
확산(Diffusion) 기반 LLM인 머큐리 3를 공개했으며, 여러 벤치마크에서 GPT-6 Luna와 Claude Haiku 5.5를 능가하면서 4~8배 빠른 초당 1,068 토큰을 처리한다. 머큐리 1 대비 40배 이상 모델 파라미터를 확대했으며, 벤치마크 기준 지능 수준은 3배 향상됐다. 문맥 길이는 260K에서 100만 토큰으로 확장했고, 입출력 토큰당 각각 0.20달러, 0.70달러이며 출시 초기에는 50% 할인(입력 0.10달러, 출력 0.35달러)을 제공한다. 전체 요약 10문장 읽기 → 036 21:11 당일 +104 AI 시대 경량 IDE 'Lithe' 공개, IntelliJ 대체 가능 IntelliJ IDEA의 경량 대체 IDE인 Lithe를 Swift로 개발해 공개했으며, Java와 Spring Boot 개발자를 주요 대상으로 한다. 웹 · 프론트엔드 · 1lck/Lithe-IDEA · Swift
Key Point AI 코딩 어시스턴트가 개발의 대부분을 담당하는 현실에서, 코드 이해와 디버깅만 전담하는 경량 IDE의 등장으로 개발자의 시스템 자원 부담을 크게 줄일 수 있다.
핵심 요약
IntelliJ IDEA의 경량 대체 IDE인 Lithe를 Swift로 개발해 공개했으며, Java와 Spring Boot 개발자를 주요 대상으로 한다. Lithe는 AI 코딩 도구가 구현을 대부분 담당하는 시대에, 생성된 코드를 이해하고 심볼을 추적하며 실행·디버깅·코드 리뷰하는 핵심 워크플로만 제공한다. 기본 메모리 사용량이 약 300~400MB 수준으로, 인텔리제이의 수 GB 메모리 사용량과 비교되며, 언어 서버·터미널·빌드 도구·디버거 등은 온디맨드 방식으로 시작한다. 전체 요약 9문장 읽기 → 037 18:11 ▲ 112 · 댓글 30 AI 코드 푸시 전 검증하는 Git 훅 'Sphinx' AI 에이전트가 작성한 코드를 깃 푸시하기 전에 그 코드가 실제로 무엇을 하는지 질문으로 검증하는 Git 훅이다. AI · 머신러닝 · Show HN: Sphinx – A hook that quizzes you on your AI's code before shipping
Key Point AI 코딩 도구의 출력을 무비판적으로 배포하기 전에, 개발자가 코드의 동작 방식을 확실히 이해했는지 검증하는 구체적인 방법을 제시한다.
핵심 요약
AI 에이전트가 작성한 코드를 깃 푸시하기 전에 그 코드가 실제로 무엇을 하는지 질문으로 검증하는 Git 훅이다. Codex, Claude Code, Cursor, OpenCode, Pi 등 다양한 AI 코딩 도구와 OpenRouter, OpenAI 호환 엔드포인트에서 동작한다. 동작 방식은 개발자가 푸시하면 Sphinx가 diff를 읽고 코드가 에러 상황에서 어떻게 동작하는지 묻는 식으로, 정답을 맞춰야 푸시가 계속 진행된다. 전체 요약 6문장 읽기 → 038 12:11 ▲ 124 · 댓글 37 FLUX 3 Image Klein, 5.6B 경량 모델로 고화질 이미지 생성 Black Forest Labs가 FLUX 3 Image Klein을 공개했다. 5.6B 파라미터의 오픈웨이트 모델로 텍스트-이미지 생성, 이미지 편집, 최대 10개 레퍼런스 이미지를 활용한 멀티-레퍼런스 생성을 지원하며 기본적으로 4K 해상도 생성과 픽셀-완벽 편집, 바운딩박스 컨트롤 기능을 탑재했다. AI · 머신러닝 · FLUX 3 Image Klein
Key Point 경량화로도 기존 대형 모델을 능가한 새 이미지 생성 모델이 오픈소스로 공개되어 로컬 배포와 파인튜닝이 가능해졌다.
핵심 요약
Black Forest Labs가 FLUX 3 Image Klein을 공개했다. 5.6B 파라미터의 오픈웨이트 모델로 텍스트-이미지 생성, 이미지 편집, 최대 10개 레퍼런스 이미지를 활용한 멀티-레퍼런스 생성을 지원하며 기본적으로 4K 해상도 생성과 픽셀-완벽 편집, 바운딩박스 컨트롤 기능을 탑재했다. FLUX 3 이미지·비디오·오디오 학습을 통합했다. 이미지는 공간 디테일을, 비디오는 움직임과 물리 역학을, 오디오는 사건과 상호작용 정보를 제공해 현실감 있는 이미지 생성을 돕는다. 내부 평가에서 Klein은 Qwen-Image 2.1(7B), Krea 2(12.9B)보다 작은 5.6B 파라미터로 텍스트-이미지, 멀티-레퍼런스, 이미지 편집 모든 항목에서 1위를 기록했으며 Ideogram V4.5, FLUX.2 [pro] 같은 폐쇄형 모델도 능가했다. 전체 요약 13문장 읽기 → 039 06:11 ▲ 105 · 댓글 92 클로드가 쓰는 코드를 어떻게 검수할까 Claude Code는 자체 코드의 90%를 클로드가 작성하는데, 6~9월 사이 병합된 PR은 2배 이상 늘었으면서 되돌려진 코드는 40% 이상 감소했다. AI · 머신러닝 · How the Claude Code team does code review
Key Point AI가 코드를 대량으로 작성할 때 검수 체계가 어떻게 바뀌는지 보여주는 실제 사례로, 자동화와 인간 판단의 역할 분담이 팀 운영 방식과 품질 관리에 미치는 영향을 구체적으로 설명한다.
핵심 요약
Claude Code는 자체 코드의 90%를 클로드가 작성하는데, 6~9월 사이 병합된 PR은 2배 이상 늘었으면서 되돌려진 코드는 40% 이상 감소했다. 수동 라인 바이 라인 검수는 불가능해졌으므로, 대부분의 검수를 자동화 도구로 옮기고 인간의 시간을 고위험·고판단 영역에만 집중했다. PR 오픈 전 테스트, 빌드, 스크린샷 비교 같은 검증 작업을 클로드가 수행하고, PR이 열리기 전에 클로드 에이전트 리뷰어가 한 번 이상 점검해 대부분의 루틴 실수를 미리 잡는다. 전체 요약 12문장 읽기 → 040 15:11 ▲ 17 · 댓글 2 자율주행에서 더 좋은 이미지 인식이 항상 성능을 높일까? 자율주행 시스템에 시각 기초 모델(VFM)을 통합할 때, 더 나은 표현이 항상 성능 향상으로 이어지는지를 조사하는 논문이다. AI · 머신러닝 · Do Better Visual Representations Always Lead to Better End-to-End Autonomous Driving?
Key Point 자율주행 시스템에서 강력한 이미지 인식 모델을 쓸 때, 어떤 모델을 선택하고 어떻게 학습시키느냐에 따라 실제 성능이 크게 달라질 수 있다는 점을 실증적으로 보여준다.
핵심 요약
자율주행 시스템에 시각 기초 모델(VFM)을 통합할 때, 더 나은 표현이 항상 성능 향상으로 이어지는지를 조사하는 논문이다. 연구팀은 ViRA라는 시각 표현 정렬 프레임워크를 제시했으며, 이는 플래너 아키텍처와 추론 비용을 변경하지 않은 상태로 작동한다. 첫 번째 발견: VFM 기반 시각 표현이 다양한 엔드투엔드 플래너에서 일관되게 성능을 개선하고, 제로샷 폐루프 평가까지 이득을 확장한다. 전체 요약 8문장 읽기 → 041 15:11 ▲ 23 · 댓글 2 확산 모델 강화학습을 위한 라우팅 정책 최적화 기존 강화학습 방식은 역방향 디노이징 궤적을 섭동하여 비용이 많이 드는 롤아웃 기반 최적화를 수행하는데, 생성 모델 내부에서 확률적 탐색을 도입하면서 원래의 샘플러를 보존할 수 있는지 묻는 새로운 접근을 제시했다. AI · 머신러닝 · Routing Policy Optimization for Online Diffusion Reinforcement Learning
Key Point 생성 모델을 보상 신호로 정렬할 때 훈련 효율을 4배 향상시키면서도 추론 시 모델의 원래 특성을 유지하는 새로운 강화학습 기법이 제시되어, 확산 모델 최적화의 실질적 한계를 해결한다.
핵심 요약
기존 강화학습 방식은 역방향 디노이징 궤적을 섭동하여 비용이 많이 드는 롤아웃 기반 최적화를 수행하는데, 생성 모델 내부에서 확률적 탐색을 도입하면서 원래의 샘플러를 보존할 수 있는지 묻는 새로운 접근을 제시했다. Routing Policy Optimization (RPO)는 어텐션 라우팅을 확률적 탐색 행동으로 변환하여 이를 답한다. 선택된 몇 개의 디노이징 단계에서 각 쿼리 블록은 자신의 블록을 유지하면서 생성 모델의 자연스러운 어텐션 질량에 비례하여 추가 키 블록을 샘플링하거나 밀집 어텐션을 유지한다. 전체 요약 9문장 읽기 → 042 12:11 ▲ 43 · 댓글 2 멀티코드북 디퓨전으로 텍스트·이미지 통합 생성 가능 기존 이미지 생성 모델은 단일 코드북 기반으로 표현력이 제한되거나, 텍스트와 이미지를 서로 다른 최적화 목표로 학습해 모달리티 간 충돌이 발생했다. AI · 머신러닝 · Intern Lumina U2: A Multi-Codebook Diffusion Large Language Model for Omni-Visual Understanding and Image Generation
Key Point 이산 공간에서 고해상도 이미지 생성과 텍스트 모델링을 진정으로 통합한 첫 디퓨전 언어모델로, 단일 모델로 텍스트·이미지·비디오·3D를 모두 다룰 수 있다는 점에서 멀티모달 생성의 새로운 패러다임을 제시한다.
핵심 요약
기존 이미지 생성 모델은 단일 코드북 기반으로 표현력이 제한되거나, 텍스트와 이미지를 서로 다른 최적화 목표로 학습해 모달리티 간 충돌이 발생했다. Intern Lumina U2는 각 시각적 위치를 여러 상호보완적 코드북의 코드 그룹으로 표현하는 멀티코드북 디퓨전 언어모델로, 이산 공간에서 고용량 시각 표현과 텍스트를 통합한다. 입력 시 각 위치의 임베딩을 연결하고, 출력 시 경량의 멀티코드북 자동회귀 헤드가 각 위치 내 코드를 순차적으로 예측하면서 디퓨전 백본은 모든 위치를 병렬 처리한다. 전체 요약 6문장 읽기 → 043 12:11 ▲ 15 · 댓글 2 Few-Step 확산 모델, 간단한 회귀만으로 빠르게 확산 및 흐름 모델의 샘플링 비용을 줄이는 Few-Step 디스틸레이션은 보조 점수 모델이나 특수 아키텍처가 필요했으나, 단순 On-Policy 속도 회귀만으로 4-NFE 생성에 충분함을 보였다. AI · 머신러닝 · Simplifying and Improving On-Policy Distillation for Few-Step Diffusion
Key Point 복잡한 별도 모듈 없이 기본 회귀로 few-step 생성의 품질을 올릴 수 있다면, 실제 배포 환경에서 확산 모델의 속도를 크게 개선하려는 팀들에게 직접적인 영향을 줄 것이다.
핵심 요약
확산 및 흐름 모델의 샘플링 비용을 줄이는 Few-Step 디스틸레이션은 보조 점수 모델이나 특수 아키텍처가 필요했으나, 단순 On-Policy 속도 회귀만으로 4-NFE 생성에 충분함을 보였다. 교사 모델의 각 구간 내 속도 변화를 표현하기 위해 학생의 구간 평균 예측에서 국소 보정을 분리하는 학습 전용 잔차 프록시 Pivot을 도입했다. 학생을 약한 교사 예측으로부터 멀어지게 하는 메커니즘을 추가해 원하지 않는 모드 회피를 돕는다. 전체 요약 7문장 읽기 → 044 21:11 ▲ 46 · 댓글 1 고해상도 이미지 생성 가능한 경량 디퓨전 변환기 기법 디퓨전 변환기(DiT)가 학습 해상도를 넘어 이미지를 생성하려면 토큰 수가 급증해 전체 어텐션이 계산 비용이 높아지고, 구조 왜곡과 디테일 저하 문제가 발생한다. AI · 머신러닝 · AReA: Adaptive Receptive-Field Attention for Efficient High-Resolution Diffusion Transformers
Key Point 고해상도 이미지 생성 시 계산량 폭증 문제를 적응형 어텐션으로 해결한 방식으로, 추가 학습 없이 적용 가능하다는 점이 중요하다.
핵심 요약
디퓨전 변환기(DiT)가 학습 해상도를 넘어 이미지를 생성하려면 토큰 수가 급증해 전체 어텐션이 계산 비용이 높아지고, 구조 왜곡과 디테일 저하 문제가 발생한다. 균등한 전체 어텐션이 이 문제의 공통 원인인데, 모든 스텝에서 모든 토큰에 주목하면 이차 복잡도가 생기고 학습 범위를 벗어난 상대 거리에 노출되어 모델이 분포에서 벗어난다. 어텐션의 유효 수용 범위는 노이즈 제거 과정에서 좁혀지는데, 초반 스텝에서 전역적으로 구조를 형성하고 후반 스텝에서 국소적으로 세부를 정제한다. 전체 요약 6문장 읽기 → 045 15:11 ▲ 50 · 댓글 1 확산 모델이 외부 도움 없이 자신을 개선하는 법 기존 연구에서 언어모델은 학생 파라미터로 구동하는 교사 네트워크의 도움으로 자체 평가 신호를 얻을 수 있음을 보였는데, 이를 확산 모델에 적용할 방법을 제시한다. AI · 머신러닝 · SALD: Self-Referenced Advantage Learning for Diffusion Models
Key Point 확산 모델의 학습을 더 효율적으로 만들 수 있는 새로운 기법으로, 추가 모델이나 파라미터 없이 모델 자신의 내부 신호만으로 성능을 개선할 수 있다는 점이 의미 있다.
핵심 요약
기존 연구에서 언어모델은 학생 파라미터로 구동하는 교사 네트워크의 도움으로 자체 평가 신호를 얻을 수 있음을 보였는데, 이를 확산 모델에 적용할 방법을 제시한다. SALD는 같은 모델으로 각 이미지-캡션 쌍을 두 가지 노이즈 수준에서 평가하는 자체 참조 학습 프레임워크다. 낮은 노이즈 경로는 그래디언트 추적 없이 평가되어 참조값을 제공하고, 높은 노이즈 경로는 학습 그래디언트를 생성한다. 전체 요약 8문장 읽기 → 046 09:11 ▲ 121 · 댓글 56 게임 개발에서 AI를 제대로 쓰는 법 저자는 LLM이 웹 개발에는 뛰어나지만 게임 개발에는 약한 이유를 분석했다. 게임은 코드뿐 아니라 그래픽, 게임플레이, 물리 등 코드로 표현되지 않는 요소가 많아서 LLM이 이해하기 어렵기 때문이다. AI · 머신러닝 · How to engineer an AI harness for game development
Key Point LLM이 게임 개발에서 실패하는 구체적 원인과 해결 방법을 제시하는 실용적 가이드로, 게임 개발자가 AI를 효과적으로 활용하기 위해 아키텍처 설계 단계부터 적용할 수 있는 전략을 설명한다.
핵심 요약
저자는 LLM이 웹 개발에는 뛰어나지만 게임 개발에는 약한 이유를 분석했다. 게임은 코드뿐 아니라 그래픽, 게임플레이, 물리 등 코드로 표현되지 않는 요소가 많아서 LLM이 이해하기 어렵기 때문이다. LLM과의 상호작용은 시스템 프롬프트, 어시스턴트 프롬프트, 사용자 프롬프트로 구성되며, 대화가 이어질수록 이전 메시지들이 계속 재제출되면서 컨텍스트가 쌓인다. 컨텍스트 오염(context pollution)을 줄이고 게임을 AI가 이해할 수 있게 만드는 '하네스(harness)' 개념을 도입해야 한다. 하네스는 AI 에이전트가 특정 작업을 더 잘 수행하도록 설계된 패턴과 도구의 집합이다. 전체 요약 9문장 읽기 → 047 15:11 ▲ 75 · 댓글 2 병렬 디코딩으로 시각 위치 추정을 빠르게—GroundAnything 논문 기존 자동 회귀(AR) 방식의 시각 그라운딩 모델은 위치 예측을 순차적으로 처리해서 지연 시간이 크다. AI · 머신러닝 · GroundAnything: Reconciling Parallel Decoding with Precise Visual Grounding at Flash Speed
Key Point 시각 위치 추정(visual grounding)의 속도와 정확성 양립 문제를 해결하는 새 방법론으로, 실시간 응용이 필요한 실무 시스템에서 바로 적용 가능한 기술입니다.
핵심 요약
기존 자동 회귀(AR) 방식의 시각 그라운딩 모델은 위치 예측을 순차적으로 처리해서 지연 시간이 크다. GroundAnything은 그라운딩을 '영상에서 시각 증거 추출'로 재정의하고, 개별 객체와 위치의 공간 관계가 좌에서 우로의 생성 순서를 따를 필요 없다고 본다. 이를 위해 양방향 확산(bidirectional diffusion) 방식을 적용해 공간 가설들을 병렬로 생성하고 반복 디노이징으로 공동 정제한다. 전체 요약 8문장 읽기 → 048 18:12 ▲ 10 · 댓글 2 정책 증류에서 상대적 차이의 전이 메커니즘 규명 온-정책 증류(OPD)는 강사 정책에서 학생 정책을 감독하되, 기존에는 강사가 월등히 뛰어나야 효과적이었다. AI · 머신러닝 · Rethinking Relative Policy Differences Transfer of On-Policy Distillation
Key Point 강화학습 정책 증류에서 어떤 강사-참조 조합이 효과적인지, 모델 간 지식 전이 가능 조건을 규명해 실제 응용의 성공률을 높일 수 있기 때문이다.
핵심 요약
온-정책 증류(OPD)는 강사 정책에서 학생 정책을 감독하되, 기존에는 강사가 월등히 뛰어나야 효과적이었다. 최근 연구는 강사의 절대 분포 대신 강사와 참조 정책 간의 상대적 차이를 전이하는 방식을 제안했지만, 어떤 차이가 유용한 감독을 제공하고 어떤 대상이 이득을 볼 수 있는지는 불명확했다. 연구팀은 프록시 강사와 프록시 참조 간의 로그 확률 비를 KL 정규화 정책 최적화의 암묵적 보상으로 해석하는 통합 이론을 개발했다. 전체 요약 9문장 읽기 → 049 18:12 ▲ 20 · 댓글 2 다양한 이미지 생성 모델을 하나로 연결하는 InstantFusion Diffusion/Flow 기반 이미지 생성 모델들이 다양해지면서 서로 다른 아키텍처와 표현방식을 가지게 되었으나, 모델 간 잠재 표현의 정렬과 디노이징 과정의 일관성에 대한 연구는 부족했다. AI · 머신러닝 · InstantFusion: A Shared Latent Interface for Heterogeneous Image Generators
Key Point 서로 다른 이미지 생성 모델들을 하나의 인터페이스로 통일하면 생성 파이프라인 최적화와 모델 재사용성이 크게 향상될 수 있기 때문입니다.
핵심 요약
Diffusion/Flow 기반 이미지 생성 모델들이 다양해지면서 서로 다른 아키텍처와 표현방식을 가지게 되었으나, 모델 간 잠재 표현의 정렬과 디노이징 과정의 일관성에 대한 연구는 부족했다. 연구팀은 독립적으로 학습된 생성 모델들이 비슷한 잠재 공간 구조를 갖고 있으며, 정렬되지 않은 모델 간에도 중간 상태를 직접 전달하면 기본적인 시각 정보가 유지된다는 흥미로운 호환성을 발견했다. 이를 바탕으로 InstantFusion이라는 경량 공유 잠재 인터페이스를 제안했으며, 이는 서로 다른 구조의 이미지 생성 모델들의 디노이징 과정을 연결한다. 전체 요약 7문장 읽기 → 050 18:12 ▲ 24 · 댓글 5 생성형 이미지 모델 성능 끌어올리는 표현 학습법 픽셀 디퓨전 트랜스포머 연구를 통해 좋은 표현 품질이 생성 능력으로 직결되지 않음을 발견했다. AI · 머신러닝 · Learning Representations to Guide Pixel Diffusion Transformers
Key Point 이미지 생성 모델의 표현 학습 방식을 근본적으로 재정의하고, 매개변수를 줄이면서도 현저히 나은 생성 품질을 달성하는 방법론이 제시되었다.
핵심 요약
픽셀 디퓨전 트랜스포머 연구를 통해 좋은 표현 품질이 생성 능력으로 직결되지 않음을 발견했다. 생성 과정에서 외부 시맨틱 정보가 점진적으로 손실되며, 특화 디코더 구조도 표현 개선으로 이어지지 않는다. 효과적인 생성형 표현은 올바르게 형성되고 능동적으로 활용되어야 한다는 인사이트를 도출했다. 전체 요약 8문장 읽기 → 051 15:11 ▲ 243 · 댓글 4 DiffusionART, 확산 모델 강화학습을 12배 빠르게 온라인 강화학습(RL)으로 블랙박스 보상 함수를 사용해 확산 모델을 미세조정하는 방식이 최근 주목받고 있으나, 역방향 프로세스 방식(Flow-GRPO)은 신용 할당 문제로 효율성이 떨어지고, 순방향 프로세스 방식(DiffusionNFT)은 지수이동평균(EMA) 비정책 학습 튜닝 없이는 불안정하다. AI · 머신러닝 · DiffusionART: Efficient, Stable and Scalable Reinforcement of Diffusion Models
Key Point 확산 모델 강화학습의 GPU 학습 시간을 10배 이상 단축하면서 보상 성과는 더 높이는 기술로, 이미지 및 비디오 생성 모델 최적화의 실무 효율성을 크게 개선한다.
핵심 요약
온라인 강화학습(RL)으로 블랙박스 보상 함수를 사용해 확산 모델을 미세조정하는 방식이 최근 주목받고 있으나, 역방향 프로세스 방식(Flow-GRPO)은 신용 할당 문제로 효율성이 떨어지고, 순방향 프로세스 방식(DiffusionNFT)은 지수이동평균(EMA) 비정책 학습 튜닝 없이는 불안정하다. NFT 스타일 목적함수가 숨겨진 순방향-역방향 일관성 강제를 포함하고 있으며, 양성-음성 결합 학습이 이를 부분적으로만 상쇄하고, EMA는 비정책 롤아웃이 아닌 복원을 통해 학습을 안정화한다는 원리를 발견했다. DiffusionART(Diffusion Reinforcement with Aggregation-First Reward Tilting)는 각 프롬프트의 보상을 역방향 프로세스 상태를 위한 공유 보상 개선 방향으로 집계해 일관성 강제를 구조적으로 제거한다. 전체 요약 7문장 읽기 → 052 12:11 ▲ 33 · 댓글 2 확률 분포 일치로 보정 없이 확산 언어모델 양자화 확산 기반 토큰 생성 언어모델(dLLM)은 자동회귀 모델의 대안으로 주목받고 있으나, 전체 시퀀스 역노이징과 블록 확산의 메모리 오버헤드로 배포가 어렵다. AI · 머신러닝 · SoloQ: Calibration-Free Quantization for Diffusion Language Models
Key Point 확산 기반 언어모델의 배포 효율성이 점점 중요해지는 상황에서, 보정 데이터 없이도 정확도를 유지하는 양자화 기법이 실무 적용 시간을 크게 단축할 수 있다.
핵심 요약
확산 기반 토큰 생성 언어모델(dLLM)은 자동회귀 모델의 대안으로 주목받고 있으나, 전체 시퀀스 역노이징과 블록 확산의 메모리 오버헤드로 배포가 어렵다. 기존 양자화 방법들은 마스킹 상태와 노이징 단계마다 활성화 분포가 바뀌어 보정 데이터가 필수였다. SoloQ는 가중치와 활성화를 정규화된 회전 기저로 매핑해 예측 가능한 주변 분포를 만들고, 이를 통해 데이터 독립적 양자화를 실현한다. 전체 요약 8문장 읽기 → 053 21:11 당일 +529 PyTorch: GPU 가속 텐서 연산과 동적 신경망 PyTorch는 Python 기반 딥러닝 프레임워크로 GPU 가속을 통한 텐서 연산과 테이프 기반 자동미분 시스템을 제공한다. AI · 머신러닝 · pytorch/pytorch · Python
Key Point PyTorch는 현대 AI 개발의 핵심 프레임워크로, GPU 가속 능력과 동적 신경망 구축의 유연성이 산업 표준이 되었으므로 최신 버전과 설치 옵션을 파악하는 것이 필수다.
핵심 요약
PyTorch는 Python 기반 딥러닝 프레임워크로 GPU 가속을 통한 텐서 연산과 테이프 기반 자동미분 시스템을 제공한다. torch, torch.autograd, torch.nn, torch.multiprocessing, torch.utils 등 핵심 컴포넌트로 구성되어 있으며 NumPy 대체제 또는 딥러닝 연구 플랫폼으로 사용된다. CPU 또는 GPU에서 실행되는 텐서 라이브러리로 슬라이싱, 인덱싱, 선형대수 등 다양한 연산을 고속으로 수행하며 Intel MKL, NVIDIA cuDNN, NCCL 등 가속 라이브러리를 통합한다. 전체 요약 12문장 읽기 → 054 06:11 ▲ 14 · 댓글 2 픽셀 공간 확산 모델, 잠재 공간 모델과 동등한 성능 보여 픽셀 공간 확산 모델은 잠재 공간 모델의 손실 많은 VAE를 피하므로 세밀한 디테일이 중요한 작업에서 유리할 것으로 예상되었다. AI · 머신러닝 · Iris-3B: Going Beyond the Latent with Pixel-Space Diffusion Training, Conversion and Fine-Tuning
Key Point 픽셀 공간 확산 모델이 세밀한 디테일 작업에서 잠재 공간 모델을 이길 것이라는 기대와 달리 실제로는 동등한 성능만 낸 이유를 알 수 있고, 픽셀 공간 사전학습의 한계와 가능성을 실증적으로 보여준다.
핵심 요약
픽셀 공간 확산 모델은 잠재 공간 모델의 손실 많은 VAE를 피하므로 세밀한 디테일이 중요한 작업에서 유리할 것으로 예상되었다. 3B 매개변수 규모의 Iris-3B 픽셀 공간 텍스트-이미지 트랜스포머를 256→512→1024 커리큘럼으로 처음부터 학습했고, 또한 FLUX.2 Klein 4B 잠재 모델을 픽셀 공간으로 변환했다. 두 모델 모두 단안 깊이 추정과 이미지 복원/초해상화 작업에 미세조정했으나, 픽셀 공간 생성 사전에서 의미 있는 성능 향상을 발견하지 못했다. 전체 요약 6문장 읽기 → 055 21:11 당일 +202 마이크로소프트, 고품질 3D 생성 모델 TRELLIS.2 공개 마이크로소프트가 40억 개 파라미터 규모의 이미지-to-3D 생성 모델 TRELLIS.2를 공개했다. AI · 머신러닝 · microsoft/TRELLIS.2 · Python
Key Point 이미지 한 장에서 PBR 재질까지 포함한 완전한 3D 자산을 빠르게 생성할 수 있는 새로운 방식이 등장했으므로, 3D 콘텐츠 제작 워크플로우가 어떻게 바뀔 수 있을지 확인할 필요가 있다.
핵심 요약
마이크로소프트가 40억 개 파라미터 규모의 이미지-to-3D 생성 모델 TRELLIS.2를 공개했다. O-Voxel이라는 새로운 '필드 프리' 희소 복셀 구조를 사용하여 복잡한 위상, 예리한 특징, 완전한 PBR 재료를 가진 3D 자산을 생성한다. 512³ 해상도에서 약 3초(2초 형상 생성 + 1초 재질 생성), 1024³에서 약 17초, 1536³에서 약 60초가 소요된다. 전체 요약 12문장 읽기 → 056 21:11 ▲ 104 · 댓글 36 금융 시장 데이터를 생성 모델로 합성할 수 있을까 Jane Street 인턴이 자기회귀 확산 모델을 사용해 미국 주식 시장 데이터의 주문장 이벤트를 생성하는 생성 모델을 만들었다. AI · 머신러닝 · Can you use autoregressive diffusion to generate market data?
Key Point 시장 데이터를 직접 합성하는 생성 모델은 기존의 포인트 추정 방식과 달리 시장 미시구조의 구체적 이벤트까지 재현할 수 있어, 량자펀드의 백테스팅과 리스크 시뮬레이션 방법을 근본적으로 바꿀 수 있는 가능성을 보여준다.
핵심 요약
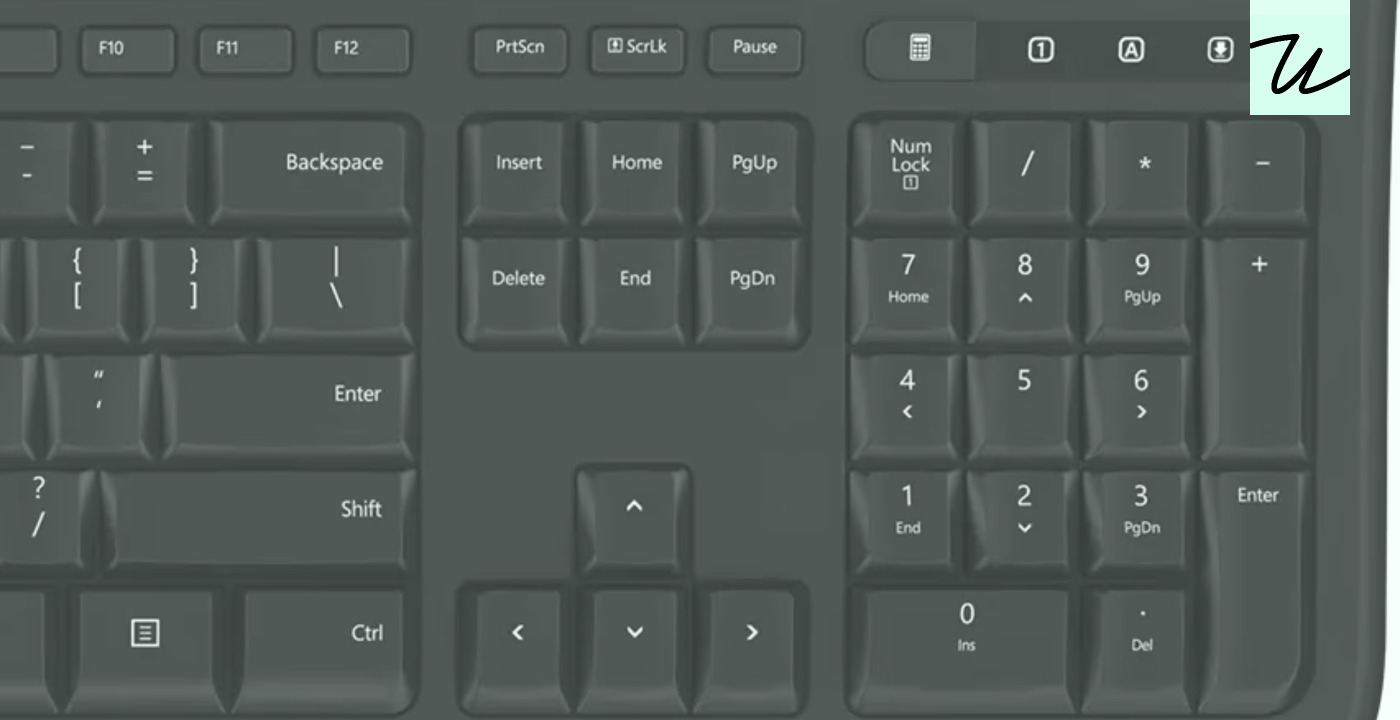
Jane Street 인턴이 자기회귀 확산 모델을 사용해 미국 주식 시장 데이터의 주문장 이벤트를 생성하는 생성 모델을 만들었다. 기존 예측 모델과 달리 가격 뿐 아니라 주문 타이밍, 취소, 체결 같은 구체적 이벤트까지 합성하는 모델을 목표로 했다. 시장 데이터는 이산적(주문 추가/제거)이면서도 연속적(가격, 타이밍 같은 고차원 변수)인 혼합 특성을 갖고 있어 모델링이 복잡하다. 전체 요약 10문장 읽기 → 057 18:11 ▲ 128 · 댓글 111 Windows와 Mac 키보드, 이렇게 다르다 Windows의 Backspace는 Mac에서 Delete, Windows의 Delete는 Mac에서 Forward Delete로 부르는 등 기본 키 이름부터 다르며, Return과 Enter도 플랫폼마다 용어가 다르다. 웹 · 프론트엔드 · Keyboard differences between Windows and Macs
Key Point 크로스 플랫폼 웹 앱을 개발할 때 Windows와 Mac의 키보드 동작 차이를 알지 못하면 단축키 충돌, 텍스트 입력 문제, 네비게이션 오류 등이 발생한다.
핵심 요약
Windows의 Backspace는 Mac에서 Delete, Windows의 Delete는 Mac에서 Forward Delete로 부르는 등 기본 키 이름부터 다르며, Return과 Enter도 플랫폼마다 용어가 다르다. Windows는 Ctrl·Alt·Shift 3개 수정자 키를 가지지만, Mac은 Command·Option·Control·Shift 4개로 더 많아 단축키 조합의 선택지가 넓다. Mac은 키보드에 기호(⇧⌃⌥⌘ 등)를 주로 표시하고 메뉴에서도 기호를 사용하지만, Windows는 텍스트 표기를 선호한다. 전체 요약 12문장 읽기 → 058 15:13 ▲ 38 · 댓글 2 확산 변환기의 희소 주의 문제, 훈련 없이 해결 확산 변환기에서 긴 시퀀스 생성(영상, 3D 자산)을 가속할 때 희소 주의를 쓰면 생성 품질이 떨어지는 문제가 있다. AI · 머신러닝 · MC-Sparse: Deconstructing and Closing the Dense-Sparse Attention Gap in Diffusion Transformers
Key Point 긴 시퀀스 생성 작업의 병목인 희소 주의의 품질 저하 문제를 훈련 없이 근본적으로 해결해 실용적 가속을 달성했다.
핵심 요약
확산 변환기에서 긴 시퀀스 생성(영상, 3D 자산)을 가속할 때 희소 주의를 쓰면 생성 품질이 떨어지는 문제가 있다. 연구팀은 품질 저하 원인을 세 가지로 분석했다: 토큰 그룹화 제약, 부정확한 상호작용 선택, 폐기된 토큰의 주의 기여 손실이다. 이를 바탕으로 메타 캐시 희소 주의(MC-Sparse)를 제안했다. 훈련이 필요 없는 프레임워크로, 개별 키-값 토큰을 선택하면서 유사한 쿼리들을 타일 정렬 그룹으로 묶어 GPU 실행을 효율화한다. 전체 요약 6문장 읽기 → 059 12:11 ▲ 16 · 댓글 6 X선 회절 자동 분석하는 AI 에이전트 등장 분말 X선 회절 분석을 위한 자가학습 AI 에이전트 '간 장(Gan Jiang)'을 개발했다. AI · 머신러닝 · A self-learning scientific agent for X-ray diffraction
Key Point X선 회절은 신물질 개발·품질 검사·고고학 분석 등에 필수적인데, 기존에는 전문가 경험에 의존하던 분석을 AI가 자동화하고 다른 시료에 전이 가능한 수준에 도달했으며, 최근 공개된 다양한 벤치마크에서 기존 방법을 크게 앞섰다.
핵심 요약
분말 X선 회절 분석을 위한 자가학습 AI 에이전트 '간 장(Gan Jiang)'을 개발했다. XMatcher, XQueryer, XDecomposer, WPEM 4개의 엔진으로 구성되며, 물질 상(phase) 식별부터 다중상 분해, 물리 제약 조건 하의 전체 패턴 모델링까지 수행한다. 에이전트는 분석 실패를 진단하고 스킬 명령어와 코드를 개선한 뒤 재사용 전에 검증하는 방식으로, 언어모델 재훈련이나 물리 모델 변경 없이 실무 경험을 재사용 가능한 지식으로 변환한다. 전체 요약 8문장 읽기 → 060 03:11 ▲ 10 · 댓글 2 텍스트-이미지 생성 모델에 에이전트 지식 직접 조각내기 텍스트-이미지 생성 모델을 에이전트 프레임워크로 감싸면 프롬프트 반복 개선과 검증을 통해 생성 품질이 향상되지만, 이런 이득이 모델 가중치에 내재되지 않아 에이전트가 실행될 때만 효과가 발휘된다. AI · 머신러닝 · Internalizing Agent Experience into Diffusion Model Weights via On-Policy Context Distillation
Key Point 이미지 생성 품질을 높이는 에이전트 능력을 모델 자체에 영구적으로 내재시켜 일반 사용자도 원본 쿼리만으로 개선된 이미지를 받을 수 있게 하는 새로운 접근 방식이다.
핵심 요약
텍스트-이미지 생성 모델을 에이전트 프레임워크로 감싸면 프롬프트 반복 개선과 검증을 통해 생성 품질이 향상되지만, 이런 이득이 모델 가중치에 내재되지 않아 에이전트가 실행될 때만 효과가 발휘된다. 논문은 Diffusion On-Policy Context Distillation(D-OPCD)를 제안하는데, 에이전트가 개선한 프롬프트를 특권 정보로 삼아 에이전트의 능력을 확산 모델 가중치로 직접 압축하는 방식이다. Auto Skill Evolver(ASE)라는 텍스트-이미지 에이전트를 사용해 D-OPCD를 실험한 결과, 원본 쿼리만으로 생성했을 때 평균 점수가 60.52에서 65.09로 상승했다(4개 벤치마크 기준). 전체 요약 5문장 읽기 → 061 21:11 ▲ 171 · 댓글 66 15년을 검색해서 찾은 한곡의 밴드 2011년 우연히 들은 Salvage의 'Electric'과 'Searchlights' 두 곡은 전문적으로 제작된 고품질 스타디움 인디 록이었지만, 15년간 밴드의 정보를 전혀 찾을 수 없었다. 기타 · The 15-year search for a band that charted once and vanished
Key Point AI 검색 도구의 시대에도 인터넷에서 완전히 사라진 음악을 추적할 수 없었던 이유와, 여러 모델을 접목한 체계적 조사가 어떻게 마침내 실마리를 찾았는지 보여주는 구체적 검색 과정이 흥미롭다.
핵심 요약
2011년 우연히 들은 Salvage의 'Electric'과 'Searchlights' 두 곡은 전문적으로 제작된 고품질 스타디움 인디 록이었지만, 15년간 밴드의 정보를 전혀 찾을 수 없었다. 초기에는 수동 검색으로 시도했고, 최근에는 AI 모델 여러 개를 활용해 메타데이터, 커버 아트, URL 등 수집한 모든 정보를 분석하게 했다. Official Charts 기록에서 2006년 6월 4-10주 독립 싱글 차트 47위 진입을 확인했고, Despatches라는 레이블에서 발매한 것을 알아냈다. 전체 요약 11문장 읽기 → 062 18:30 새 버전 Node.js 26.11.0 출시, 버퍼·HTTP·암호화 기능 강화 Buffer API에 isLatin1() 메서드와 stringLength() 정적 함수가 추가되었다. 인프라 · 데브옵스 · nodejs/node@v26.11.0
Key Point Buffer 검증·HTTP 헤더 안전성·프로세스 타임아웃 등 개발 안정성을 높이는 새 기능들이 다수 안정화됨에 따라 프로덕션 환경 운영의 신뢰도가 올라간다.
핵심 요약
Buffer API에 isLatin1() 메서드와 stringLength() 정적 함수가 추가되었다. HTTP 모듈에 헤더 검증 함수 isValidHeaderName()과 isValidHeaderValue()가 새로 제공된다. HTTP/2에 connectionWindowSize 옵션이 추가되어 연결 윈도우 크기를 제어할 수 있다. 전체 요약 11문장 읽기 → 063 18:30 ▲ 15 · 댓글 2 실패한 추론에만 교사 신호 적용, 코드·수학 성능 향상 온-폴리시 증류(OPD)는 대형 언어모델의 학생 모델이 자신이 생성한 결과로 학습하는 방식으로 널리 쓰이지만, 토큰 수준의 국소적 최적화만 하고 전체 추론의 질을 고려하지 않습니다. AI · 머신러닝 · DiffGate: Difficulty-Gated Teacher Guidance for On-Policy Distillation
Key Point 기존 증류와 강화학습의 한계를 동시에 해결하는 방법으로, 작은 언어모델(0.6B~1.7B)의 코딩·수학 추론 성능을 실질적으로 향상시키는 기법입니다.
핵심 요약
온-폴리시 증류(OPD)는 대형 언어모델의 학생 모델이 자신이 생성한 결과로 학습하는 방식으로 널리 쓰이지만, 토큰 수준의 국소적 최적화만 하고 전체 추론의 질을 고려하지 않습니다. 보상 기반 강화학습(RLVR, 특히 GRPO)은 전체 결과 수준의 지도를 제공하지만 희소 보상으로 인해 신용 할당이 입자합니다. 연구진은 두 방식의 한계를 분석했습니다: OPD는 밀집된 국소 신호를 주지만 정답률과 약하게 연관되고, GRPO는 작업 성공을 포착하되 토큰별 신용 할당이 정교하지 못합니다. 전체 요약 9문장 읽기 → 064 18:30 ▲ 75 · 댓글 2 비디오 생성 속도 11배 빠르게, 압축 자동인코더 호환 유지 비디오 확산 모델의 속도를 높이기 위해 자동인코더를 고도로 압축할 때, 압축률이 높아질수록 재구성 품질이 나빠지고 복구에 더 많은 채널이 필요해 수렴이 느려지는 문제가 있다. AI · 머신러닝 · GRACE: Generation-aware latent compression for efficient video generation
Key Point 비디오 확산 모델 추론 속도의 주요 병목인 토큰 수 감소를 기존 학습 모델 호환성을 해치지 않으면서 달성한 실질적 가속 기술이기 때문이다.
핵심 요약
비디오 확산 모델의 속도를 높이기 위해 자동인코더를 고도로 압축할 때, 압축률이 높아질수록 재구성 품질이 나빠지고 복구에 더 많은 채널이 필요해 수렴이 느려지는 문제가 있다. 압축된 잠재벡터가 기존에 학습된 잠재벡터와 달라져서, 사전학습된 Diffusion Transformer(DiT)를 처음부터 다시 학습하거나 비용이 큰 적응이 필요했다. GRACE는 두 단계로 나뉘는데, 먼저 사전학습된 인코더의 기본 잠재벡터는 고정하고 압축으로 손실된 정보를 위해 잔차 잠재벡터를 학습한다. 전체 요약 6문장 읽기 → 065 18:30 당일 +148 온톨로지 변경을 증명으로 검증하는 오픈소스 도구 프로덕션 온톨로지 변경을 계획·적용·롤백할 수 있으며, 영향 범위 보고서와 감사자가 검증 가능한 증명을 제공하는 Rust 기반 도구다. 오픈소스 · 도구 · fabio-rovai/open-ontologies · Rust
Key Point 온톨로지 변경의 모든 결과를 사전에 확인하고, 누구나 검증할 수 있는 증명을 함께 제공함으로써 프로덕션 환경에서의 신뢰성 문제를 근본적으로 해결하는 접근 방식이다.
핵심 요약
프로덕션 온톨로지 변경을 계획·적용·롤백할 수 있으며, 영향 범위 보고서와 감사자가 검증 가능한 증명을 제공하는 Rust 기반 도구다. 한 줄의 삼중항(triple) 변경이 901개의 새로운 결과를 만드는 경우, 텍스트 diff로는 볼 수 없는 의미론적 차이를 드러내는 형태 diff(shape diff) 보고서를 생성한다. 도구가 생성한 증명 파일(asserted.tsv, derivations.tsv)은 Lean 4 검증기로 검수할 수 있으며, 검증 명령어 oo-cert는 JVM 없이 독립적으로 실행 가능하다. 전체 요약 12문장 읽기 → 066 18:33 ▲ 20 · 댓글 2 흐름과 확산 모델에서 데이터 망각과 경량화를 동시에 Flow 및 Diffusion 모델 같은 다단계 생성 모델은 고품질 출력을 만들지만 추론 비용이 크고 학습 데이터의 원치 않는 부분을 재현할 수 있다. AI · 머신러닝 · Data Unlearning via Inverse Distillation
Key Point 생성 모델에서 특정 학습 데이터를 제거하면서 동시에 모델 크기를 줄이는 기술이 필요한데, 이 논문이 처음으로 두 목표를 함께 달성하는 방법을 제시했기 때문이다.
핵심 요약
Flow 및 Diffusion 모델 같은 다단계 생성 모델은 고품질 출력을 만들지만 추론 비용이 크고 학습 데이터의 원치 않는 부분을 재현할 수 있다. 역방향 증류 망각(IDU) 기법은 교사 모델을 효율적인 원스텝 학생 생성기로 증류하면서 동시에 지정된 학습 부분집합의 출력을 억제하는 통합 프레임워크다. 증류를 데이터 분포에 대한 민-맥스 목적함수로 정식화하고, 이 분포를 망각 집합과 생성 분포의 혼합으로 표현해 교사의 학습 분포와 비교하면 최적점에서 보존 데이터만 복원된다. 전체 요약 6문장 읽기 → 067 18:33 ▲ 14 · 댓글 1 확산 언어 모델의 취약점: 피드백 제어로 편향 주입 공격 마스크드 확산 언어 모델(dLLM)은 토큰을 여러 번 재예측하면서 반복적으로 디노이징하므로, 각 토큰이 확정되기 전에 생성 확률이 여러 단계에서 노출된다. AI · 머신러닝 · Noise Out, Bias In: Targeted Bias Injection in Diffusion Language Models via Closed-Loop Activation Steering
Key Point 마스크드 확산 언어 모델이 기존 자동회귀 모델과 달리 여러 단계에서 답변을 노출하는 특성을 악용한 새로운 공격 벡터가 발견되었으며, 피드백 제어로 편향 주입 효과를 크게 증폭할 수 있다는 점이 주목할 만하다.
핵심 요약
마스크드 확산 언어 모델(dLLM)은 토큰을 여러 번 재예측하면서 반복적으로 디노이징하므로, 각 토큰이 확정되기 전에 생성 확률이 여러 단계에서 노출된다. 연구진은 내부 활성화에 접근 가능한 공격자가 이러한 디노이징 궤적을 악용해 모델을 특정 인구통계학적 답변으로 유도하는 '표적 편향 주입' 공격을 개발했다. 공격은 비례-적분(PI) 제어기를 사용해 디노이징 과정 중 목표 답변 확률을 추적하고, 조향 벡터의 강도를 실시간으로 조정한다. 전체 요약 7문장 읽기 → 068 18:33 ▲ 21 · 댓글 1 확산 언어모델의 토큰 단위 특성 정렬로 생성 품질 개선 확산 언어모델(DLM) 사후학습을 위해 생성된 분포와 참조 분포 간 최대평균편차(MMD)를 토큰 단위의 특성 공간에서 최소화하는 방법을 제안했다. AI · 머신러닝 · Representation-Space MMD for Diffusion Language Models
Key Point 확산 기반 언어모델의 생성 품질을 토큰 단위로 정렬하는 효율적인 방법으로, 별도의 샘플링 완성이나 보조 모델 없이 대규모 모델의 추론 속도와 정확도를 동시에 개선할 수 있다는 점이 중요하다.
핵심 요약
확산 언어모델(DLM) 사후학습을 위해 생성된 분포와 참조 분포 간 최대평균편차(MMD)를 토큰 단위의 특성 공간에서 최소화하는 방법을 제안했다. 개별 토큰 위치의 맥락 특성을 유지하여 한 번의 특성 추출으로 여러 관찰 샘플을 얻으므로 효율적이다. 이산 모델은 정책 기울기를, 연속 모델은 생성된 잠재변수에 대한 직접 미분을 통해 최적화한다. 전체 요약 6문장 읽기 → 069 18:35 ▲ 117 · 댓글 3 Kandinsky 6.0 Video, 텍스트로 음성 동기화 영상 생성 Hugging Face가 Kandinsky 6.0 Video 출시, 텍스트와 이미지로부터 음성이 동기화된 영상을 생성하는 기초 확산 모델. AI · 머신러닝 · Kandinsky 6.0 Video: Foundation Models for Synchronized Video and Audio Generation
Key Point 음성과 영상이 완벽하게 동기화된 멀티모달 생성 기술이 오픈소스로 공개되어 영상 제작 자동화와 멀티미디어 연구를 가속할 수 있게 되었습니다.
핵심 요약
Hugging Face가 Kandinsky 6.0 Video 출시, 텍스트와 이미지로부터 음성이 동기화된 영상을 생성하는 기초 확산 모델. 경량 버전(3B 파라미터)과 고성능 버전(29B 파라미터) 두 종류로, 5초 영상과 44 kHz 음성을 립싱크 포함해 생성. 텍스트-오디오-비디오(T2AV)와 이미지-오디오-비디오(I2AV) 모드 지원하며, 내장 초해상화로 1920×1080 풀HD 출력 가능. 전체 요약 8문장 읽기 → 070 18:35 ▲ 60 · 댓글 2 토큰 난이도에 맞춰 계산 할당하는 확산형 언어모델 ALoDLM 확산형 언어모델(DLM)은 여러 토큰을 병렬로 예측해 빠른 생성을 가능하게 하지만, 같은 크기의 자동회귀(AR) 모델 대비 품질 격차가 실제 적용을 제한하고 있다. AI · 머신러닝 · ALoDLM: Adaptively Looped Diffusion Language Models
Key Point 기존 확산형 언어모델의 품질 격차 원인을 토큰 난이도 측면에서 처음으로 진단하고, 적응형 계산 할당으로 해결한 새로운 접근법이 표준 모델들을 능가했기 때문이다.
핵심 요약
확산형 언어모델(DLM)은 여러 토큰을 병렬로 예측해 빠른 생성을 가능하게 하지만, 같은 크기의 자동회귀(AR) 모델 대비 품질 격차가 실제 적용을 제한하고 있다. 논문은 이 격차의 원인을 계산-난이도 불일치로 분석했다. 부분적으로 관찰된 수열 내에서 일부 미지의 토큰은 쉽게 예측되지만 다른 토큰은 훨씬 더 많은 계산이 필요하다. 기존 DLM은 각 노이즈 제거 단계에서 모든 미지 위치에 동일한 계산 깊이를 적용한다. 전체 요약 9문장 읽기 → 071 06:11 ▲ 25 · 댓글 3 로봇 제어를 위한 생성형 디노이징 방식 NowWAM 제안 사전학습된 확산 변환기(Diffusion Transformers)는 대규모 이미지·영상 생성 학습을 통해 풍부한 시각·언어 조건 구조를 포착했지만, 이를 로봇 제어에 옮기는 방식은 불명확하고 기존 방법들은 주로 미래 시각 예측을 통해 전이했다. AI · 머신러닝 · Beyond Future Prediction: Denoising as Generative Adaptation for Robot Control
Key Point 기존의 영상 예측 기반 로봇 제어 방식에서 벗어나 더 효율적인 디노이징 방식이 비슷하거나 더 나은 성능을 내면서도 계산량은 절반, 추론 속도는 1.8배 빠르다는 점이 실제 로봇 응용에서 의미가 있습니다.
핵심 요약
사전학습된 확산 변환기(Diffusion Transformers)는 대규모 이미지·영상 생성 학습을 통해 풍부한 시각·언어 조건 구조를 포착했지만, 이를 로봇 제어에 옮기는 방식은 불명확하고 기존 방법들은 주로 미래 시각 예측을 통해 전이했다. 본 논문은 사전학습된 생성형 모델이 행동 학습에 실제로 무엇을 기여하는지, 그리고 제어를 위해 어떻게 적응해야 하는지 묻는다. NowWAM은 현재 관찰을 디노이징하고 같은 시각 스트림에서 로봇 행동을 예측하는 미래-목표-자유 방식의 공동 학습 방식으로, 생성 목표를 디노이징 궤적 전체에서 행동 표현에 직접 연결한다. 전체 요약 7문장 읽기 → 072 06:11 ▲ 17 · 댓글 2 LLM 점수 매기기, 순서에 따라 결정 달라진다 문서 재순위화·응답 순위 매기기·다중 문서 질의응답에서 LLM은 한 프롬프트에 여러 후보를 함께 점수 매기는데, 이 점수로 문턱값 유지 여부·독자 답변·선호도 학습용 쌍을 결정한다. AI · 머신러닝 · Equal Ranking Quality, Different Decisions: Measuring and Reducing Order Dependence in LLM Scorers
Key Point LLM을 활용한 텍스트 순위 매기기는 정보 검색·추천 시스템의 핵심 기술인데, 같은 품질의 모델이 후보 순서에 따라 다른 결정을 내리는 숨겨진 문제를 드러내고 실질적 해결책을 제시한다.
핵심 요약
문서 재순위화·응답 순위 매기기·다중 문서 질의응답에서 LLM은 한 프롬프트에 여러 후보를 함께 점수 매기는데, 이 점수로 문턱값 유지 여부·독자 답변·선호도 학습용 쌍을 결정한다. 같은 쿼리와 후보에 대해 순서를 바꾸면 점수가 달라져 최종 결정이 바뀌는데, 랭킹 품질이 같아도 의사결정이 다르다는 문제가 발생한다. 실험 결과 점수 매김 품질이 0.010 nDCG@10 범위 내인 다섯 모델도 순서 변경 시 유지 대상 집합의 겹침이 0.66~0.84에 불과했다. 전체 요약 8문장 읽기 → 073 06:11 ▲ 141 · 댓글 66 평문, 50년 이상 읽을 수 있는 기술 평문(plain text)은 특정 응용 프로그램 없이도 읽고 편집할 수 있는 가장 기본적인 컴퓨터 파일 형식으로, 50년 이상 유지될 가능성이 높다. 웹 · 프론트엔드 · Plain text is still one of the best technologies we have
Key Point 많은 개발자가 클라우드, 구독 서비스에 데이터가 종속되는 현실에서, 평문의 장점을 재평가하고 언제 단순한 형식으로 충분한지 판단할 필요가 있기 때문이다.
핵심 요약
평문(plain text)은 특정 응용 프로그램 없이도 읽고 편집할 수 있는 가장 기본적인 컴퓨터 파일 형식으로, 50년 이상 유지될 가능성이 높다. 유니코드 표준에 따르면 평문은 글꼴, 색상, 레이아웃 같은 서식 정보 없이 문자 코드의 연속일 뿐이며, 이 단순함이 오래 지속된 주요 이유다. 소스 코드, 설정 파일, 로그, HTML, JSON, CSS 등 컴퓨팅의 기본 인프라 대부분이 평문을 기반으로 하며, 텍스트 에디터에서도 내용을 직접 검사하고 수정할 수 있다. 전체 요약 9문장 읽기 → 074 03:11 ▲ 102 · 댓글 21 foldl과 foldr의 근본적인 차이, 정확히 이해하기 foldl과 foldr은 '왼쪽에서'와 '오른쪽에서' 접는 것이 아니라, 같은 순서로 리스트를 순회하되 연산의 결합 방식만 다르다. 오픈소스 · 도구 · Differences Between `Foldl` and `Foldr`
Key Point 게으른 평가 언어에서 foldl과 foldr의 성능 차이가 직관과 정반대인 이유를 정확히 이해해야 리스트 처리 코드의 메모리 문제를 진단하고 올바른 함수를 선택할 수 있다.
핵심 요약
foldl과 foldr은 '왼쪽에서'와 '오른쪽에서' 접는 것이 아니라, 같은 순서로 리스트를 순회하되 연산의 결합 방식만 다르다. foldl은 왼쪽 결합으로 (((v ⨂ e0) ⨂ e1) ⨂ e2)처럼 동작하고, foldr은 오른쪽 결합으로 e0 ⨂ (e1 ⨂ (e2 ⨂ v))처럼 동작한다. 순수 언어에서 foldl은 첫 원소부터 축적값을 업데이트하며 상수 공간에서 동작하지만, foldr은 마지막 원소까지 도달해야 하므로 리스트 크기에 비례하는 스택 프레임이 필요하다. 전체 요약 8문장 읽기 → 075 00:11 ▲ 132 · 댓글 47 LLM 판단 vs 결정 모델, 벤치마크 결과는 기존 방식이 우위 TypeSafe AI의 Jev 같은 결정 모델(decision model)은 고정된 스키마의 '결정'을 출력하는 새로운 AI 안전장치 기법으로, 자유형 텍스트 생성 방식보다 빠르고 저렴하며 학습 데이터 없이도 새로운 문제에 적용할 수 있다. AI · 머신러닝 · Decision models like Jev don't beat LLM-as-a-judge or traditional classifiers
Key Point 신흥 기술로 주목받는 결정 모델이 실제로는 기존의 소형 분류기와 LLM 판단 방식과의 경쟁에서 우월하지 못하다는 벤치마크 결과로, AI 안전장치 선택 시 실용성을 강조하는 실증 데이터를 제공한다.
핵심 요약
TypeSafe AI의 Jev 같은 결정 모델(decision model)은 고정된 스키마의 '결정'을 출력하는 새로운 AI 안전장치 기법으로, 자유형 텍스트 생성 방식보다 빠르고 저렴하며 학습 데이터 없이도 새로운 문제에 적용할 수 있다. Red Hat 연구팀은 프롬프트 주입과 콘텐츠 안전성 두 가지 벤치마크에서 9개 안전장치를 비교 평가했다: CPU 규모 사전학습 분류기, BART-large-mnli, Shieldstral, Nemotron-3.5, Qwen3.6-35B, Laya, DiffusionGemma, Jev. 프롬프트 주입 탐지에서 Qwen3.6-35B(LLM-as-a-judge)이 89.31% 정확도로 1위, DiffusionGemma 87.72% 2위, Jev는 86.35%로 4위를 기록했다. 전체 요약 10문장 읽기 → 076 18:11 ▲ 52 · 댓글 2 마스크 기반 확산 모델의 학습 효율성을 높이는 Pivot-SD 마스크 확산 언어 모델(dLM)은 자동회귀 모델 대안으로서 복잡한 추론에 유망하지만, 노이징 제거 중 일부 토큰 결정이 나머지 마스크 위치의 불확실성을 급격히 줄이는 신용 배치 문제를 마주한다. AI · 머신러닝 · Pivot-SD: Efficient Self-Distillation for Masked Diffusion Language Models
Key Point 마스크 기반 확산 모델의 학습 비효율을 지목하고, 고영향 결정점만 선별 학습하는 새로운 자기증류 방식이 소규모 데이터로도 기존 방법을 능가하는 결과를 보여준다.
핵심 요약
마스크 확산 언어 모델(dLM)은 자동회귀 모델 대안으로서 복잡한 추론에 유망하지만, 노이징 제거 중 일부 토큰 결정이 나머지 마스크 위치의 불확실성을 급격히 줄이는 신용 배치 문제를 마주한다. 기존 dLM 학습 방식은 이러한 신호를 활용하지 않으며, 최종 텍스트나 전체 노이징 단계에 보상을 할당하는 방식으로 개별 핵심 토큰 결정을 선별하지 않는다. Pivot-SD는 오프라인 자기증류 프레임워크로서, 오직 응답 형성에 큰 영향을 미치는 핵심 결정점(pivot)만을 감독한다. 전체 요약 5문장 읽기 → 077 12:11 ▲ 19 · 댓글 2 의미·기하 구조 동시 학습, 픽셀 확산 모델 성능 끌어올리다 Representation alignment(REPA)는 확산 트랜스포머 학습을 가속화하는 기법인데, 기존엔 의미 정보(DINOv2, CLIP)만을 정렬 대상으로 삼았다. AI · 머신러닝 · PixelDense: Dense Prediction as Representation Alignment for Pixel Diffusion
Key Point 의미 정보와 기하 정보를 분리해 학습하는 구조적 혁신으로 텍스트-이미지 생성부터 이미지 편집까지 여러 작업에서 동시에 성능을 끌어올렸으며, 전통적 단일 정렬 방식의 한계를 넘었다.
핵심 요약
Representation alignment(REPA)는 확산 트랜스포머 학습을 가속화하는 기법인데, 기존엔 의미 정보(DINOv2, CLIP)만을 정렬 대상으로 삼았다. 최근 분석이 정렬 효과의 핵심이 의미 정보가 아닌 공간 구조(spatial structure)임을 지적했으나, 그러한 구조를 예측하도록 훈련된 기초 모델들은 간과되어 왔다. 픽셀 공간 확산에서 SAM2, Depth Anything v2, Metric3D v2는 DINOv2 단독 기준보다 우수하며, 특히 기하 정보를 학습하는 모델들이 분할 모델을 앞선다. 전체 요약 10문장 읽기 → 078 21:11 ▲ 60 · 댓글 2 적응형 전문가 혼합으로 확산 모델의 소수 단계 생성 개선 마스크 확산 모델(MDM)은 각 제거 단계에서 여러 토큰을 점진적으로 해제하여 시퀀스를 생성하지만, 기존 역프로세스는 위치별로 분해되어 있어 소수 단계 영역의 샘플 품질을 제한한다. AI · 머신러닝 · E-MoE: Enhanced Mixture-of-Experts for Non-Factorized Diffusion Language Models
Key Point 확산 모델의 가장 큰 장점인 소수 단계 고속 생성을 개선하는 새로운 방법으로, 기존 접근법의 근본적인 문제(후방 붕괴)를 회피하면서 매개변수 효율성을 유지한다.
핵심 요약
마스크 확산 모델(MDM)은 각 제거 단계에서 여러 토큰을 점진적으로 해제하여 시퀀스를 생성하지만, 기존 역프로세스는 위치별로 분해되어 있어 소수 단계 영역의 샘플 품질을 제한한다. 최근 연구는 위치 간 상관관계를 포착하기 위해 변분 자동인코더로 학습된 연속 가우시안 잠재변수를 도입했으나, 이러한 접근법은 잠재변수가 무시되는 후방 붕괴(posterior collapse) 문제에 빠지기 쉽다. 본 논문은 강화된 혼합-전문가(E-MoE) 방법을 제안하며, MoE 백본의 전문가 라우팅 결정으로 주어진 이산 공유 잠재변수에 대한 분해된 분포의 혼합으로 역프로세스를 구성한다. 전체 요약 5문장 읽기 → 079 12:11 ▲ 49 · 댓글 2 확산형 언어모델을 위한 텍스트 임베딩 최적화 자기회귀 모델의 대안으로 주목받는 확산 언어모델(DLM)은 연속 텍스트 임베딩의 잠재공간에서 생성을 수행한다. AI · 머신러닝 · Scaling and Distilling Text Embeddings for Better Diffusibility
Key Point 확산형 언어모델이 자기회귀 방식의 성능에 접근하기 위해서는 어떤 임베딩 공간이 최적인지 밝혀지지 않았는데, 이 연구가 스케일링과 증류 기법으로 그 해답을 제시한다.
핵심 요약
자기회귀 모델의 대안으로 주목받는 확산 언어모델(DLM)은 연속 텍스트 임베딩의 잠재공간에서 생성을 수행한다. 연구팀은 T5 계열 임베딩을 T5Gemma-1, T5Gemma-2로 확대했을 때 생성 성능이 크게 향상됨을 발견했다. 그러나 T5Gemma-2는 너무 판별력이 강해서 유사한 단어들의 임베딩까지 멀리 떨어져 있어, 샘플링 오류 시 유효한 임베딩을 찾지 못하는 문제가 발생한다. 전체 요약 7문장 읽기 → 080 12:11 ▲ 124 · 댓글 2 동영상 생성 AI의 음성-영상 동기화를 위한 적응형 보상 라우팅 기법 오디오-비디오 확산 모델을 개선하기 위해 여러 보상 신호를 활용하는 강화학습 방식이 있지만, 훈련 과정에서 보상 가중치와 적용 위치가 고정되어 있어 모델의 변화하는 특성을 따라가지 못한다. AI · 머신러닝 · Adaptive Reward Routing: Dynamic Multi-Reward Optimization for Joint Audio-Video Diffusion via Forward-Process RL
Key Point 음성-영상 생성 AI의 동기화와 품질을 동시에 높이는 새로운 최적화 기법으로, 여러 목표가 충돌할 때 동적으로 가중치를 조정하는 방식이 향후 멀티모달 생성 모델 개선의 방향을 제시한다.
핵심 요약
오디오-비디오 확산 모델을 개선하기 위해 여러 보상 신호를 활용하는 강화학습 방식이 있지만, 훈련 과정에서 보상 가중치와 적용 위치가 고정되어 있어 모델의 변화하는 특성을 따라가지 못한다. 논문은 Adaptive Reward Routing이라는 새로운 방법을 제안하며, 이는 음성 품질, 영상 품질, 교차-모달 의미 일치, 시간적 동기화 등 여러 목표를 동시에 최적화한다. 첫 번째 구성 요소는 Cross-Modal Influence-Guided Routing으로, 양방향 교차-주의 응답을 이용해 변화하는 모달 간 영향을 추적하면서 토큰별 손실을 동적으로 재가중화하고 그래디언트를 조정한다. 전체 요약 6문장 읽기 → 081 12:11 ▲ 79 · 댓글 2 토큰 독립성 문제 해결한 계층형 연속 확산 언어모델 이산 확산 언어모델은 양방향 추론과 전역 제약 만족이 필요한 작업에서 자기회귀 생성의 대안이 되지만, 병렬 디코딩 시 각 토큰을 독립적으로 샘플링하면서 토큰 간 통계적 의존성을 끊는 구조적 병목을 공유한다. AI · 머신러닝 · Hierarchical Continuous Diffusion Language Models
Key Point 병렬 디코딩에서 토큰 간 의존성을 보존하면서도 전역 제약을 만족시키는 방식으로 확산 언어모델의 핵심 구조적 문제를 해결했기에, 생성 모델의 근본적인 설계 변화로 관심을 끈다.
핵심 요약
이산 확산 언어모델은 양방향 추론과 전역 제약 만족이 필요한 작업에서 자기회귀 생성의 대안이 되지만, 병렬 디코딩 시 각 토큰을 독립적으로 샘플링하면서 토큰 간 통계적 의존성을 끊는 구조적 병목을 공유한다. 연속 확산 언어모델은 공유 연속 상태를 노이징하여 이를 피하지만, 노이저가 그 상태만 보므로 최종 디코딩까지 유효한 토큰 구성과의 연결고리가 없다. HC-DLM(Hierarchical Continuous Diffusion Language Models)은 이산 토큰 생성과 연속 잠재 궤적을 단일의 원칙적인 노이징 제거 과정으로 결합하며, 훈련 목적은 토큰 우도에 대한 변분 경계에서 유도된다. 전체 요약 6문장 읽기 → 082 15:11 ▲ 35 · 댓글 2 고압축·고속학습 이미지생성 모델, DC-SAE 공개 이미지 생성 모델을 고도로 압축하면 학습 속도가 느려지는 기본적 트레이드오프가 발생한다. AI · 머신러닝 · DC-SAE: Deep Compression Semantic Autoencoder for Faster Diffusion Convergence
Key Point 고압축 토크나이저는 대규모 이미지 생성 모델의 학습 효율을 좌우하는데, DC-SAE가 압축률과 학습 속도 양쪽을 동시에 개선하는 방법을 제시한다.
핵심 요약
이미지 생성 모델을 고도로 압축하면 학습 속도가 느려지는 기본적 트레이드오프가 발생한다. 기존 의미 기반 오토인코더는 중간 수준 압축에만 제한되고 픽셀 수준의 세부정보를 잃어 정확한 복원이 어렵다. DC-SAE는 의미 기반 인코더로 높은 압축을 가능하게 하고, 픽셀 수준 인코더로 저수준 세부정보를 보존한다. 전체 요약 6문장 읽기 → 083 15:11 ▲ 42 · 댓글 2 마스크형 확산 모델, 언제 전략 바꿀까 마스크형 확산 언어모델(MDM)은 자유로운 생성 순서를 허용해 언마스킹 전략이 추론 시점의 선택이 된다. AI · 머신러닝 · Unmask the State: When Does State Adaptation Matter for Masked Diffusion Language Models
Key Point 마스크형 확산 모델의 생성 과정에서 어떤 상황에서 추론 전략을 동적으로 바꿔야 효율적인지를 실증적으로 규명해, 모델 최적화의 실질적 가이드라인을 제시한다.
핵심 요약
마스크형 확산 언어모델(MDM)은 자유로운 생성 순서를 허용해 언마스킹 전략이 추론 시점의 선택이 된다. 스코어·카디널리티·영역·커미트먼트·플래닝 5개 축으로 MDM 추론을 분류하고, 고정된 선택보다 더 나은 행동의 한 단계 효용 차이를 '적응 기회'로 정의했다. 3개 MDM과 10개 테스크를 검증한 결과, 적응 기회는 매우 이질적이며 일부 상황에서는 집중된 예측 가능한 일단계 이득을 보였다. 전체 요약 5문장 읽기 → 084 15:11 ▲ 96 · 댓글 1 진화 알고리즘에 웹 검색 최적화 더하다 LLM 기반 진화 알고리즘이 부족한 지식으로 인해 진행이 막힐 때 웹 검색으로 관련 문서를 공급하면 도움이 되지만, 단순히 검색 도구를 추가하면 솔루션이 바뀔 때도 같은 페이지만 반복해서 반환하는 문제가 있다. AI · 머신러닝 · EvoDuet: Bilevel Co-Evolution of Web Searching and Task Solving for Scientific Discovery
Key Point 큰 언어모델의 진화 알고리즘에서 웹 검색을 정교하게 제어해 지식 부족 문제를 해결하는 새로운 방법이 기존 기록을 경신했다.
핵심 요약
LLM 기반 진화 알고리즘이 부족한 지식으로 인해 진행이 막힐 때 웹 검색으로 관련 문서를 공급하면 도움이 되지만, 단순히 검색 도구를 추가하면 솔루션이 바뀔 때도 같은 페이지만 반복해서 반환하는 문제가 있다. EvoDuet은 모델 파라미터를 고정한 채 솔루션과 검색 쿼리를 동시에 진화시키는 이층 최적화 방법이다. 각 반복 단계마다 LLM이 지식 부족을 판단해 새 문서를 검색하거나 저장된 문서를 재사용하거나 검색 없이 진행할 수 있는 '검색 게이트'를 제공한다. 전체 요약 7문장 읽기 → 085 09:11 ▲ 12 · 댓글 2 픽셀 디퓨전 모델에 적대적 학습 추가로 고주파 품질 개선 픽셀 디퓨전 모델은 오토인코더 병목을 피해 RGB 이미지를 직접 생성하지만, 미세한 자연 이미지 통계를 체계적으로 과소 표현하는 문제가 있다. AI · 머신러닝 · Adversarial Training for Pixel Diffusion
Key Point 픽셀 디퓨전이 기존 오토인코더 기반 모델의 문제를 우회한다는 점에서 더 직접적인 방식이었으나, 미세한 디테일 손실 문제를 적대적 학습으로 해결할 수 있음을 보여주는 실질적 개선 방법이기 때문입니다.
핵심 요약
픽셀 디퓨전 모델은 오토인코더 병목을 피해 RGB 이미지를 직접 생성하지만, 미세한 자연 이미지 통계를 체계적으로 과소 표현하는 문제가 있다. 연구팀은 사전학습된 모델에 적대적 손실을 더해 이 결함을 보정하는 방법을 제시했다. 원래 확산 또는 플로우 매칭 목표를 유지하면서 비고노이즈 타임스텝에서만 적대적 손실을 예측 출력에 추가한다. 모델 아키텍처와 샘플링 절차는 변경하지 않으며, 픽셀 디퓨전의 적대적 사후학습에 대한 첫 체계적 연구다. 전체 요약 9문장 읽기 → 086 00:11 ▲ 13 · 댓글 3 동작 중심 영상 학습, 시간축 분리로 효율성 확보 영상 자가학습에서 아키텍처와 목적함수, 데이터, 학습 일정 등 여러 요소가 동시에 변해 동작 우선 표현 학습의 효과를 명확히 파악하기 어려운 점을 지적한다. AI · 머신러닝 · TT-VidT: Decoupling the Temporal Axis for Efficient Motion-Centric Video Pretraining
Key Point 시간과 공간을 분리해 동작 학습을 효율화하는 새로운 방식이 기존 방법보다 훨씬 빠르면서 동시에 여러 벤치마크에서 큰 폭의 성능 향상을 달성했기 때문이다.
핵심 요약
영상 자가학습에서 아키텍처와 목적함수, 데이터, 학습 일정 등 여러 요소가 동시에 변해 동작 우선 표현 학습의 효과를 명확히 파악하기 어려운 점을 지적한다. 이를 해결하기 위해 약 170M~190M 인코더 규모로 24가지 아키텍처-목적함수 조합을 통제된 조건에서 비교했다. TT-VidT는 DINOv3으로 초기화한 ViT-B/16 공간 경로와 컴팩트 Temporal Transfer Layer를 조합하고, Diff Compression 목적함수로 첫 프레임 외형 정보와 프레임별 동작 토큰으로부터 타겟 프레임을 재구성하도록 학습한다. 전체 요약 7문장 읽기 → 087 21:11 ▲ 22 · 댓글 2 Flow Matching으로 이미지 보정 도구 제어하기 기존 이미지 보정 도구는 자동회귀 방식의 대형언어모델로 추론과 도구 선택, 파라미터를 순차적으로 생성했다. AI · 머신러닝 · FlowTool: Controlling Tool Parameter in Image Retouching via Flow Matching
Key Point 자동회귀 방식의 느린 추론을 벗어나 50배 빠른 이미지 보정 시스템을 구현한 새로운 접근 방식으로, 생성형 AI 기반 편집 도구의 성능과 효율성을 크게 개선할 수 있는 경로를 제시한다.
핵심 요약
기존 이미지 보정 도구는 자동회귀 방식의 대형언어모델로 추론과 도구 선택, 파라미터를 순차적으로 생성했다. FlowTool은 이 문제를 Flow Matching으로 재정의하여 입력 이미지와 사용자 지시에 조건부된 고품질 편집 파라미터 분포를 직접 모델링한다. 비전-언어 모델과 Diffusion Transformer 기반 파라미터 생성기를 결합해 가우시안 잡음을 편집 계획으로 변환한다. 전체 요약 8문장 읽기 → 088 21:11 ▲ 20 · 댓글 1 동영상 생성 자동회귀 확산 모델의 캐시 재사용으로 1.7배 고속화 자동회귀 비디오 확산 모델은 동영상을 시간 단위 청크로 나누어 여러 단계의 노이즈 제거를 거쳐 생성하는데, 이미 생성한 청크를 기억하기 위해 기존 방식들은 별도의 순전파를 통해 깨끗한 KV 캐시를 재구성해야 했다. AI · 머신러닝 · In-Flight KV Cache with Clean Anchors for Faster Autoregressive Video Diffusion
Key Point 프롬프트-기반 동영상 생성 서비스 개발 시 캐시 재사용과 양방향 조건부 생성으로 생성 속도를 높이는 구체적인 기술적 해법을 제시하므로, 장시간 영상 생성이 필요한 실무 개발자에게 실질적 개선 방안을 보여준다.
핵심 요약
자동회귀 비디오 확산 모델은 동영상을 시간 단위 청크로 나누어 여러 단계의 노이즈 제거를 거쳐 생성하는데, 이미 생성한 청크를 기억하기 위해 기존 방식들은 별도의 순전파를 통해 깨끗한 KV 캐시를 재구성해야 했다. FlashForward는 각 노이즈 제거 단계 중에 자동으로 생성되는 현재 청크의 KV 캐시를 다음 청크에서 직접 재사용해 캐시 업데이트 전용 순전파를 제거한다. 이 방식은 여러 GPU를 각 단계에 할당해 서로 다른 청크가 동시에 서로 다른 단계를 점유하도록 해 병렬 처리 효율을 높인다. 전체 요약 7문장 읽기 → 089 18:11 ▲ 10 · 댓글 2 확산 모델의 생성 과정으로 이미지 품질 평가하기 Reference-based 이미지 품질 평가(IQA) 지표는 인간이 인식하는 이미지 쌍 간의 지각적 거리를 반영하려 한다. AI · 머신러닝 · FoMo: Forking Moment in Generative Trajectory as a Perceptual Distance
Key Point diffusion 모델의 생성 과정이 인간 시각 인식과 일치한다는 발견으로, 비용 많이 드는 인간 주석 없이도 이미지 품질 평가 모델을 학습할 수 있는 새로운 방식을 제시한다.
핵심 요약
Reference-based 이미지 품질 평가(IQA) 지표는 인간이 인식하는 이미지 쌍 간의 지각적 거리를 반영하려 한다. 기존 방식은 인간이 주석을 단 Mean Opinion Score(MOS) 데이터에 의존하는데, 대규모 수집이 비용이 크고 인간 판단의 불일치로 인해 노이즈가 많다. 2AFC(2-alternative forced choice) 쌍비교 라벨은 신뢰도가 높지만 상대적 비교만 포착한다. 전체 요약 9문장 읽기 → 090 18:11 ▲ 15 · 댓글 2 DiT의 잔차 연결을 재설계해 이미지 생성 성능 향상 Diffusion Transformers(DiT)는 이미지 합성의 확장 가능한 기반 모델이지만, 기존 U-Net 모델의 수작업 스킵 연결과 달리 모든 층의 출력을 단순히 누적하는 단일 잔차 흐름을 사용한다. AI · 머신러닝 · Structured Residual Connectivity Matters for Diffusion Transformers
Key Point Diffusion Transformer의 성능을 좌우하는 잔차 연결 구조를 근본적으로 개선하는 방법론이 제시되어, 향후 이미지 생성 모델 설계의 새로운 기준이 될 가능성이 있다.
핵심 요약
Diffusion Transformers(DiT)는 이미지 합성의 확장 가능한 기반 모델이지만, 기존 U-Net 모델의 수작업 스킵 연결과 달리 모든 층의 출력을 단순히 누적하는 단일 잔차 흐름을 사용한다. 연구팀은 DiT의 내부 표현을 체계적으로 분석해 초기 층의 특성 재사용과 대칭적 층 가이던스를 중시하는 경향을 발견했다. 이를 바탕으로 각 트랜스포머 블록이 이전 층의 중요한 표현을 선택적으로 '주목'하고, 직접적이고 미분 가능한 크로스-뎁스 경로를 통해 공간적·의미적 정보를 동적으로 검색하는 적응형 연결 메커니즘을 제안했다. 전체 요약 7문장 읽기 → 091 15:11 ▲ 23 · 댓글 1 LLM 정렬을 위한 확산 기반 보상 모델 등장 기존 보상 모델은 각 프롬프트-응답 쌍을 단일 점 추정값이나 고정된 분포로 축소하지만, 인간 선호도는 본질적으로 다중모달이다—같은 응답이 여러 방식으로 합리적으로 평가될 수 있다. AI · 머신러닝 · Diffusion Reward Models
Key Point 인간의 다양한 판단 방식을 반영하는 새로운 보상 모델이 RLHF 학습에서 성능 개선을 직접 입증했기 때문에, LLM 정렬 연구에 실질적 영향을 미칠 수 있다.
핵심 요약
기존 보상 모델은 각 프롬프트-응답 쌍을 단일 점 추정값이나 고정된 분포로 축소하지만, 인간 선호도는 본질적으로 다중모달이다—같은 응답이 여러 방식으로 합리적으로 평가될 수 있다. 이를 해결하기 위해 Diffusion Reward Model(DRM)을 제안하며, 이는 보상 모델링을 조건부 밀도 추정 문제 p(r|x,y)로 재구성한다. DRM은 동결된 LLM 인코더를 기반으로 경량 Diffusion Transformer가 가우시안 노이즈를 보상 벡터로 제거(denoising)하며, 출력 분포에 대한 매개변수 가정 없이 자연스럽게 다중모달 구조를 표현한다. 전체 요약 8문장 읽기 → 092 22:45 당일 +166 C++로 만든 이미지 생성 엔진, Flux·Qwen 등 최신 모델까지 지원 stable-diffusion.cpp는 GGML 기반의 순수 C/C++ 구현으로 Stable Diffusion, Flux, Wan, Qwen Image 등 다양한 이미지·영상 생성 모델을 추론할 수 있는 경량 프레임워크다. AI · 머신러닝 · leejet/stable-diffusion.cpp · C++
Key Point 로컬 머신에서 최신 이미지·영상 생성 모델을 실행할 수 있는 경량 C++ 구현이 빠르게 성장하고 있으며, 모델 추가 속도가 빠르므로 개인 또는 온프레미스 AI 구축을 고려하는 개발자에게 선택지가 되고 있다.
핵심 요약
stable-diffusion.cpp는 GGML 기반의 순수 C/C++ 구현으로 Stable Diffusion, Flux, Wan, Qwen Image 등 다양한 이미지·영상 생성 모델을 추론할 수 있는 경량 프레임워크다. 외부 의존성이 없으며, 모델 무게 형식으로 PyTorch 체크포인트(.ckpt, .pth, .pt), Safetensors, GGUF를 지원하고 가중치를 .gguf나 .safetensors로 변환할 수 있다. CPU(AVX, AVX2, AVX512), CUDA, Vulkan, Metal, OpenCL, SYCL 백엔드를 지원하며 Linux, macOS, Windows, Android(Termux)에서 실행된다. 전체 요약 7문장 읽기 → 093 22:45 당일 +276 NVIDIA Model Optimizer, 양자화·가지치기·증류 등 최적화 기법 통합 라이브러리 오픈소스화 NVIDIA Model Optimizer는 양자화, 가지치기(pruning), 신경망 구조 탐색(NAS), 증류, 추측 디코딩, 희소성 등 최신 모델 최적화 기법을 통합한 라이브러리다. AI · 머신러닝 · NVIDIA/Model-Optimizer · Python
Key Point DL 인퍼런스 배포 시 성능과 메모리 효율을 동시에 높이려는 개발자들에게 양자화, 가지치기, 증류 등을 통합 관리할 수 있는 공식 도구가 생겼고, 오픈소스로 누구나 기여 가능해졌다.
핵심 요약
NVIDIA Model Optimizer는 양자화, 가지치기(pruning), 신경망 구조 탐색(NAS), 증류, 추측 디코딩, 희소성 등 최신 모델 최적화 기법을 통합한 라이브러리다. Hugging Face, PyTorch, ONNX 모델을 입력받아 Python API로 최적화 기법들을 조합해 적용하고, 최적화된 양자화 체크포인트를 생성한다. 생성된 체크포인트는 TensorRT-LLM, vLLM, SGLang 등 인퍼런스 프레임워크에 바로 배포 가능하며, Megatron-Bridge 및 Hugging Face Accelerate와 통합돼 있다. 전체 요약 12문장 읽기 → 094 22:26 ▲ 190 · 댓글 121 영국의 강한 암호화 기능, 신규 사용자는 불가 영국 정부가 2025년 1월 비밀 행정명령(Technical Capability Notice)을 통해 애플에 전 세계 사용자의 암호화된 iCloud 데이터에 접근할 수 있는 기술 개발을 요구했다. 보안 · Two-Tier Encryption in the UK – Identical Apple Devices, Different Protection
Key Point 정부 비밀 명령으로 인한 암호화 약화 강요와 그에 따른 차별적 보호 수준 발생이라는 민주주의와 개인정보보호의 핵심 갈등을 보여준다.
핵심 요약
영국 정부가 2025년 1월 비밀 행정명령(Technical Capability Notice)을 통해 애플에 전 세계 사용자의 암호화된 iCloud 데이터에 접근할 수 있는 기술 개발을 요구했다. 이는 2015년 샌 버나디노 테러 사건 이후 FBI의 '백도어' 요구에 대한 애플의 거부 입장이 지속되던 상황에서 나온 요구였다. 애플의 Advanced Data Protection(ADP)는 iCloud 백업, 사진, 노트 등을 end-to-end 암호화로 보호하며 애플도 복호화 키를 보유하지 않는 구조다. 전체 요약 12문장 읽기 → 095 22:26 새 버전 Rails 8.1.4 릴리스, 126개 버그 수정 Rails 8.1.4가 출시되었으며 Active Support, Active Model, Active Record 전체에서 126개의 버그를 수정했다. 웹 · 프론트엔드 · rails/rails@v8.1.4
Key Point 복합 기본키, 데이터베이스 연결 풀, 마이그레이션 가역성 등 Active Record의 광범위한 버그가 수정되어 기존 애플리케이션의 안정성과 동작이 개선된다.
핵심 요약
Rails 8.1.4가 출시되었으며 Active Support, Active Model, Active Record 전체에서 126개의 버그를 수정했다. Active Support에서는 SyntaxError 디버그 페이지 렌더링, JSON 3.0 호환성, number_to_human_size의 테라바이트 이상 단위 지원(페타/엑사/제타바이트) 등을 개선했다. Range, Enumerable, HashWithIndifferentAccess, TimeZone 등 핵심 유틸리티에서 다양한 충돌과 동작 오류를 해결했고, 문자열/숫자 형식 함수에서 nil 값 처리와 인코딩 보존 문제를 수정했다. 전체 요약 10문장 읽기 → 096 22:26 ▲ 131 · 댓글 51 에이전트와 협업하는 오픈소스 설계 IDE 'Whiteboard' 공개 Y Combinator W26 배치에서 공개한 Whiteboard는 인간과 AI 에이전트가 함께 소프트웨어를 설계할 수 있는 오픈소스 데스크톱 앱이다. 웹 · 프론트엔드 · Show HN: Whiteboard (YC W26) – An open-source IDE for thoughtful software design
Key Point AI 에이전트가 소프트웨어 설계 과정에 참여하는 새로운 워크플로우를 구현한 오픈소스 도구로, 도표·코드·의사결정을 통합적으로 관리할 수 있는 방식을 제시한다.
핵심 요약
Y Combinator W26 배치에서 공개한 Whiteboard는 인간과 AI 에이전트가 함께 소프트웨어를 설계할 수 있는 오픈소스 데스크톱 앱이다. Claude Code, Codex 등 기존 코딩 에이전트에 연결되며, 에이전트가 인앱 캔버스에 작업 내역을 그려서 표현할 수 있는 SDK를 제공한다. 다이어그램과 코드를 직접 연결할 수 있어서 시퀀스 다이어그램, 엔티티 관계 다이어그램, 에이전트 트레이스를 클릭하면 해당 코드로 점프한다. 전체 요약 11문장 읽기 → 097 22:29 당일 +681 ComfyUI, 노드 기반 멀티모달 AI 생성 엔진으로 거듭나다 ComfyUI는 그래프/노드 인터페이스 기반의 강력한 AI 생성 엔진으로, 이미지·비디오·3D·오디오·텍스트 생성을 한 플랫폼에서 지원한다. AI · 머신러닝 · Comfy-Org/ComfyUI · Python
Key Point 노드 기반 워크플로우로 최신 오픈소스 생성 모델들을 자유롭게 조합하되, 로컬 실행·API 통합·클라우드 지원을 한 도구에서 선택할 수 있어 전문가부터 초심자까지 콘텐츠 제작 자동화의 진입장벽을 낮춘다.
핵심 요약
ComfyUI는 그래프/노드 인터페이스 기반의 강력한 AI 생성 엔진으로, 이미지·비디오·3D·오디오·텍스트 생성을 한 플랫폼에서 지원한다. Stable Diffusion, SDXL, Flux.1/2, Qwen Image, Hunyuan Image, Ideogram 등 주요 이미지 모델과 LTX-Video, HunyuanVideo 같은 영상 생성, ACE-Step, Stable Audio 등 오디오 생성 모델을 기본 지원한다. Partner nodes를 통해 폐쇄형 모델(Nano Banana, Seedance, Hunyuan3D 등)에도 접근할 수 있으며, API 엔드포인트로 프로덕션 파이프라인에 통합 가능하다. 전체 요약 9문장 읽기 → 098 15:11 ▲ 24 · 댓글 2 확산 LLM의 메모리와 속도 문제를 푸는 Flash-dLLM 비자동회귀 텍스트 생성이 가능한 확산 LLM(dLLM)이 등장했으나 추론 단계에서 KV 캐싱 부재와 병렬 디코딩 메커니즘 부족으로 인해 배포가 제한적이다. AI · 머신러닝 · Flash-dLLM: IO-Aware KV Caching and Parallel Decoding for Fast, Memory-Efficient Diffusion LLMs
Key Point 자동회귀 방식 LLM의 느린 추론이 산업 문제인 가운데, 비자동회귀 생성의 실무 적용을 가로막는 메모리 효율성 문제를 근본적으로 해결하는 기법이다.
핵심 요약
비자동회귀 텍스트 생성이 가능한 확산 LLM(dLLM)이 등장했으나 추론 단계에서 KV 캐싱 부재와 병렬 디코딩 메커니즘 부족으로 인해 배포가 제한적이다. Flash-dLLM은 학습 없이 적용 가능한 추론 가속화 프레임워크로, GPU 메모리 I/O 병목을 식별하고 최적화된 KV 캐시 커널로 메모리 이동을 줄인다. 별도 모델 없이 dLLM 자체가 드래프터와 검증자 역할을 하는 효율적인 draft-and-verify 디코딩 전략을 제안한다. 전체 요약 4문장 읽기 → 099 15:11 ▲ 25 · 댓글 2 비디오 확산 모델이 물리법칙을 위반하는 이유 텍스트-투-비디오 확산 모델이 우수한 화질에도 불구하고 현실 물리법칙을 위반하는 영상을 생성한다. AI · 머신러닝 · Why Do Video Diffusion Models Violate Physics? Unveiling the Flaws in Attention Mechanisms
Key Point 비디오 생성 AI의 핵심 약점인 물리법칙 위반을 어텐션 메커니즘 수준에서 진단하고, 모델 재설계 없이 적용 가능한 경량 해법을 제시한다.
핵심 요약
텍스트-투-비디오 확산 모델이 우수한 화질에도 불구하고 현실 물리법칙을 위반하는 영상을 생성한다. 연구팀이 모션 계획 과정을 분석해 초기 노이징 제거 단계에서 동작 궤적이 형성되는 방식을 규명했다. Rotary Position Embedding(RoPE)이 과도한 공간 주의 감소를 야기해 초기 후보 영역이 물리적으로 불가능한 위치에 조기 고정되는 것을 발견했다. 전체 요약 5문장 읽기 → 100 15:11 ▲ 31 · 댓글 2 양자 회로로 언어모델 성능 끌어올린다 언어모델의 각 트랜스포머 블록에 양자 회로 모듈을 덧붙이는 HyperQ 기법을 제안했다. AI · 머신러닝 · Circuit Hypernetworks for Quantum-Augmented Diffusion Language Models
Key Point 양자컴퓨팅의 이론적 우월성을 실제 언어모델 작업에 구현하면서 계산 효율성을 확보한 새로운 아키텍처로, 고비용 양자 회로를 대규모 신경망에 통합하는 방법론을 제시한다.
핵심 요약
언어모델의 각 트랜스포머 블록에 양자 회로 모듈을 덧붙이는 HyperQ 기법을 제안했다. 토큰의 숨겨진 상태를 읽어 양자 회로의 좌표를 생성하고 실행한 후 결과를 잔차 연결로 더한다. 회로 하이퍼네트워크가 토큰별로 회전각과 결합력, 측정축을 생성하되 공유 희소 회로 구조를 사용한다. 전체 요약 5문장 읽기 →