001 15:11 ▲ 152 · 댓글 2 실시간 음성-영상 화자 추출, 경량화로 엣지 배포 가능해졌다 스트리밍 환경에서 특정 화자의 음성만 추출하는 기술(AVTSE)은 저지연이 필수인데, 기존 방식들은 두 가지 문제를 안고 있었다. AI · 머신러닝 · Efficient Streaming Audio-Visual Target Speaker Extraction for Real-World Acoustic Scenes
Key Point 실시간 음성 처리가 필요한 모바일·임베디드 환경에서 화자 분리의 실용성을 크게 높였으며, 기존 벤치마크의 문제를 해결한 현실적 평가 기준을 제시했다.
핵심 요약
스트리밍 환경에서 특정 화자의 음성만 추출하는 기술(AVTSE)은 저지연이 필수인데, 기존 방식들은 두 가지 문제를 안고 있었다. 첫째, 표준 벤치마크가 화자 2명만 고정하고 실제 환경의 근거리·원거리 간섭음, 음향 반향, 갑작스러운 잡음을 반영하지 않는다. 둘째, 고성능 인과관계 구조는 엣지 기기 배포에 너무 무겁고, 경량 대안도 작은 분리 모델을 반복 호출하면서 이득을 상쇄한다. 전체 요약 8문장 읽기 → 002 18:11 ▲ 30 · 댓글 3 루핑 트랜스포머의 역전파 자르기, 규모 법칙으로 최적값 찾다 루핑 트랜스포머는 공유 레이어 블록을 반복 사용해 학습 가능한 매개변수 수는 유지하면서 계산 깊이를 늘리는 구조이며, 역전파 시간(BPTT)으로 학습된다. AI · 머신러닝 · Truncate or Not? A Scaling Study of Looped Transformers with Truncated Backpropagation
Key Point 루핑 트랜스포머의 학습에서 계산량 절약을 위한 역전파 자르기가 실제로 최적인지를 대규모 실험으로 체계적으로 검증한 결과로, 효율성과 성능의 트레이드오프를 명확히 한다.
핵심 요약
루핑 트랜스포머는 공유 레이어 블록을 반복 사용해 학습 가능한 매개변수 수는 유지하면서 계산 깊이를 늘리는 구조이며, 역전파 시간(BPTT)으로 학습된다. 학습 계산량을 줄이기 위해 BPTT를 최근 몇 루프로 잘라내는 방식이 흔하지만, 잘라냄으로 인한 기울기 편향이 루핑의 이점을 약화시킬 수 있다. 연구팀은 약 600번의 학습 실행을 통해 모델 크기, 학습 토큰 수, 정방향·역방향 루프 횟수를 함께 변화시켜 루핑과 잘라냄의 효과를 포착하는 통합 규모 법칙을 도출했다. 전체 요약 8문장 읽기 → 003 15:11 ▲ 38 · 댓글 2 LLM으로 과학 원리를 실시간 구축하는 'Principia' 프레임워크 과학적 발견에는 관찰된 현상 뒤에 있는 과학 원리를 파악하는 것이 필수적인데, 복잡한 발견 과정에서 이러한 경험적 원리는 대부분 미지의 상태로 남아있다. AI · 머신러닝 · Principia: Test-Time Hypotheses to Principle Construction for Scientific Discovery
Key Point 과학 발견 과정에서 원리 도출의 병목을 자동화하고, 테스트 타임에 진화하는 지식 구축 방식이 여러 분자·생물학 영역에서 기존 방법을 능가하는 성과를 입증했다.
핵심 요약
과학적 발견에는 관찰된 현상 뒤에 있는 과학 원리를 파악하는 것이 필수적인데, 복잡한 발견 과정에서 이러한 경험적 원리는 대부분 미지의 상태로 남아있다. 기존 방식은 가설을 원리로 변환하는 단계에서 방대한 영역 전문지식·시간·노력이 필요해 병목이 되고 있다. Principia는 LLM 기반 프레임워크로, 테스트 타임에 과학 원리를 구축하고 지속적으로 개선한다. 전체 요약 7문장 읽기 → 004 12:11 ▲ 14 · 댓글 3 추론 모델의 '대기' 토큰, RL이 아닌 학습 데이터에서 온다 추론 모델이 단계를 재검토하기 전에 {wait} 토큰을 쓰는 것이 강화학습(RL)의 성과로 여겨져 왔으나, RL이 이 현상을 만든 것이 아니라 학습 데이터에서 상속받은 것일 수 있다는 가설을 검증했다. AI · 머신러닝 · Inherited, Not Invented: Tracing the Provenance of Wait in Reasoning Models
Key Point 추론 모델의 향상이 실제로 RL의 효과인지 아니면 데이터 상속인지 구분해야 할 핵심 연구로, 모델 평가 방식과 RL 기술 검증의 신뢰성을 근본적으로 재검토하게 한다.
핵심 요약
추론 모델이 단계를 재검토하기 전에 {wait} 토큰을 쓰는 것이 강화학습(RL)의 성과로 여겨져 왔으나, RL이 이 현상을 만든 것이 아니라 학습 데이터에서 상속받은 것일 수 있다는 가설을 검증했다. 공개 모델의 학습 이력을 추적하며 빈도, 위치, 형태, 사용 방식을 라벨 없이 지수화하고 주입 오류 테스트로 {wait} 토큰의 출처를 분석했다. RL을 적용하지 않은 초기 모델(zero-RL)은 {wait} 토큰을 거의 생성하지 않으며, {wait}이 없는 기반 모델에 RL을 적용해도 MATH-500 정확도는 크게 올라가지만 {wait} 토큰 사용은 거의 증가하지 않는다. 전체 요약 7문장 읽기 → 005 15:11 ▲ 34 · 댓글 2 AI 연구팀이 선형 주의 구조 자동 발견 자율 에이전트를 활용해 과학 발견을 가속화하기 위해 서로 다른 전문성을 갖춘 AI 연구자 팀을 구성하는 방법을 제안했다. AI · 머신러닝 · Building AI Research Teams for Autonomous Discovery of Linear Attention Architectures
Key Point 다양한 전문성과 기억을 갖춘 AI 팀의 협력 구조가 자동화된 과학 발견에서 얼마나 중요한지 보여주는 결과로, 향후 AI 연구 자동화 시스템 설계의 기준을 제시한다.
핵심 요약
자율 에이전트를 활용해 과학 발견을 가속화하기 위해 서로 다른 전문성을 갖춘 AI 연구자 팀을 구성하는 방법을 제안했다. 실험 비용이 높을 때 제한된 실험 예산 내에서 탐색과 활용의 균형을 맞추기 위해 적응형 할당 방식을 도입했다. 각 AI 연구자가 서로 다른 학문 배경을 가지고 개인 연구 기록을 유지하면서 공유된 실험 증거를 바탕으로 협력하는 구조를 설계했다. 전체 요약 6문장 읽기 → 006 12:11 ▲ 10 · 댓글 2 코딩 에이전트가 실패를 미리 감지하고 중단하는 StopLoss 코딩 에이전트는 검증에 실패할 런을 계속 진행하는데, 이를 감시하기 위해 대형 모델을 사용하는 것은 비용이 크다. AI · 머신러닝 · StopLoss: Teaching Agents to Predict Failure and Stop Early
Key Point 코딩 에이전트의 실패 예측을 저비용으로 수행함으로써 계산 자원 낭비를 크게 줄일 수 있는 실용적 방법이 증명되었기 때문입니다.
핵심 요약
코딩 에이전트는 검증에 실패할 런을 계속 진행하는데, 이를 감시하기 위해 대형 모델을 사용하는 것은 비용이 크다. StopLoss는 완료된 궤적(trajectory)과 검증자 결과로부터 실패를 인식하도록 학습한 소규모 외부 모니터이다. 미세조정된 언어모델이 최근 도구 단계들을 한 번의 포워드 패스로 점수화하고, 성공 런에서 보정된 임계값이 중단 결정을 내린다. 전체 요약 8문장 읽기 → 007 18:11 ▲ 22 · 댓글 2 추론 모델의 병렬 수정 기법, Draft Refinement 제안 추론 모델이 반복적으로 각 의사결정을 수정할 때, 개별적으로 타당한 토큰 업데이트가 전체 답변의 질을 보장하지 못한다는 문제를 제시한다. AI · 머신러닝 · Breaking Diffusion: Parallel Reasoning with Draft Refinement
Key Point 추론 모델에서 토큰 단위 수정을 병렬로 처리하면서도 평가의 정확성을 높이는 새로운 메커니즘을 제시해, 복잡한 문제 해결에서 계산 효율과 정확도를 동시에 개선할 수 있음을 보여준다.
핵심 요약
추론 모델이 반복적으로 각 의사결정을 수정할 때, 개별적으로 타당한 토큰 업데이트가 전체 답변의 질을 보장하지 못한다는 문제를 제시한다. Draft Refinement Language Models(DRLMs)는 단일 denoiser를 사용해 병렬 수정안을 제안하고 후보 초안을 평가하는 방식을 도입했다. Denoiser는 균등하게 손상된 초안에서 모든 토큰을 복원하도록 학습되어 보존과 수리 능력을 모두 갖춘다. 전체 요약 8문장 읽기 → 008 12:11 ▲ 48 · 댓글 2 4단계만에 현실감 있는 영상 생성하는 구조 기반 렌더러 게임 엔진이나 코딩 에이전트가 장면의 레이아웃, 모션, 카메라를 지정하지만 이를 사실적인 영상으로 변환하려면 구조를 따르면서 외형을 채우는 렌더러가 필요하다. AI · 머신러닝 · SolarRenderer: Few-Step Generative Reference Rendering
Key Point 기존 50단계가 필요했던 구조 기반 렌더링을 4단계로 단축하면서도 미학습 표현 11개에 일반화되는 성과로, 게임 엔진 통합과 실시간 스트리밍 렌더링이 가능해진다.
핵심 요약
게임 엔진이나 코딩 에이전트가 장면의 레이아웃, 모션, 카메라를 지정하지만 이를 사실적인 영상으로 변환하려면 구조를 따르면서 외형을 채우는 렌더러가 필요하다. 기존 렌더러는 특정 엔진 표현에 종속되거나 수십 단계의 노이즈 제거가 필요하거나 별도의 비용 많이 드는 증류 과정이 필수다. SolarRenderer는 고정된 MiniMax-H3 33B 백본을 두 개의 가벼운 LoRA로 적응시킨 구조 조건 비디오 렌더러다. 전체 요약 8문장 읽기 → 009 12:11 ▲ 36 · 댓글 1 이미지 여러 번 편집할 때 화질 유지하기 사용자가 연속된 명령어로 이미지를 여러 번 편집하는 다중 턴 이미지 편집 작업에서 기존 방식은 몇 번의 편집 후 화질 저하와 부작용이 누적되거나 이전 편집 내용이 의도하지 않게 변경되는 문제가 발생한다. AI · 머신러닝 · MT Forcing: Towards Stable and Consistent Multi-Turn Image Editing with Autoregressive Diffusion
Key Point 연속된 이미지 편집 작업에서 화질 저하와 이전 편집 손실 문제를 해결하는 실질적인 기술이 나왔다.
핵심 요약
사용자가 연속된 명령어로 이미지를 여러 번 편집하는 다중 턴 이미지 편집 작업에서 기존 방식은 몇 번의 편집 후 화질 저하와 부작용이 누적되거나 이전 편집 내용이 의도하지 않게 변경되는 문제가 발생한다. 이 논문은 자동회귀 확산 기반의 통합 멀티모달 모델(UMM)을 위한 새로운 훈련 방식인 MT Forcing을 제안한다. 단일 턴 분포 매칭 증류(Single-Turn DMD)는 교사 모델이 원본 이미지에 누적된 편집을 한 번에 적용한 결과로 학생 모델의 자동 롤아웃을 감독하여, 반복적 오류 누적 없이 시각적 품질 지도를 제공한다. 전체 요약 5문장 읽기 → 010 00:11 ▲ 115 · 댓글 23 동물실험 대체 기술, 규제 승인으로 본격화되다 17년 전 하버드 와이스 생물의학공학연구소의 도널드 잉거 팀은 폐 기능을 재현하는 칩 기술을 개발했는데, 초기에 과학 잡지 편집자들이 검증을 위해 쥐 실험도 병행할 것을 요청했다. 하드웨어 · 시스템 · Alternatives to Animal Testing Are Finally Taking Off
Key Point 규제 기준이 처음으로 동물실험에서 대체 기술로 역전되었으며, 미국·유럽 당국의 정책 전환이 과학 문화 변화의 장벽을 넘게 될 기술과 시스템을 어떻게 확산할 것인가가 핵심 과제다.
핵심 요약
17년 전 하버드 와이스 생물의학공학연구소의 도널드 잉거 팀은 폐 기능을 재현하는 칩 기술을 개발했는데, 초기에 과학 잡지 편집자들이 검증을 위해 쥐 실험도 병행할 것을 요청했다. 장기칩(organ-on-chip)은 인간의 조직과 장기 구조를 미세유체 채널에서 재현하는 기술로, 기존 정적 조직 배양과 달리 호흡이나 맥동 같은 생리적 움직임을 모사한다. 동물실험 대체 기술을 통칭하는 NAM(nonanimal methods)은 장기칩, 오르가노이드, 계산 시뮬레이션, AI 분석 도구 등으로 구성되며, 기존 동물 모델의 한계(임상 시험 진입 약물 92%가 시장 진출 실패)를 극복하려는 시도다. 전체 요약 13문장 읽기 → 011 18:11 ▲ 116 · 댓글 3 결과로만 평가하면 놓치는 AI 에이전트의 실제 역량 LLM 에이전트를 평가할 때 최종 결과만으로는 그 역량을 제대로 파악할 수 없다는 문제를 제시한다. AI · 머신러닝 · LiveMACE: Process-Aware Evaluation of LLM Agent Capabilities in Evolving Markets
Key Point 최종 수익만 비교하면 AI 에이전트의 의사결정 역량 차이를 놓치는 문제를 실증적으로 밝혔으며, 실제 역량과 성과의 불일치를 가시화하는 진단 방식이 필요함을 보여준다.
핵심 요약
LLM 에이전트를 평가할 때 최종 결과만으로는 그 역량을 제대로 파악할 수 없다는 문제를 제시한다. LiveMACEBench라는 새로운 벤치마크를 제안하며, 실시간 금융 시장을 자연스럽게 변화하는 테스트 환경으로 삼아 지속적인 LLM 에이전트를 평가한다. GPT-4, Claude, Gemini 등 5개 최신 LLM이 Tool Use, Persistent Memory, Rule Following, Multi-Agent Collaboration 등 동일한 조건으로 30일간 실시간 평가를 받았다. 전체 요약 6문장 읽기 → 012 06:11 ▲ 107 · 댓글 85 리눅스 7.2 커널, 역사상 2번째로 바쁜 개발 사이클 리눅스 토발즈가 8월 17일 7.2 커널을 릴리스했으며, 거의 60만 줄의 코드가 추가되어 역사상 2번째로 바쁜 개발 사이클이 되었다. 오픈소스 · 도구 · Development statistics for the 7.2 kernel
Key Point LLM 지원 커밋이 급증하면서 커널 개발의 구조와 품질이 어떻게 변하고 있는지를 수량 데이터로 추적하는 중요한 기록이자, 이해 없이 패치가 통합되는 위험성을 드러낸다.
핵심 요약
리눅스 토발즈가 8월 17일 7.2 커널을 릴리스했으며, 거의 60만 줄의 코드가 추가되어 역사상 2번째로 바쁜 개발 사이클이 되었다. 7.2에는 2,652명의 개발자가 기여한 16,418개의 비병합 커밋이 포함되었으며, 이는 이전 기록인 7.1의 2,479명을 크게 초과했다. 상위 기여자는 우베 클라이네-쾨니히(1,510개 커밋), 로센 페네프(1,460개), 이안 로저스(1,380개)였고, 코드 라인 수로는 매튜 스튜어트(83만 5,878줄)와 호킹 장(62만 8,936줄)이 선두였다. 전체 요약 9문장 읽기 → 013 21:11 당일 +308 에이전틱 워크로드 최적화 LLM 추론 엔진 TokenSpeed 공개 LightSeek Foundation이 에이전틱 워크로드에 최적화된 LLM 추론 엔진 TokenSpeed를 오픈소스로 공개했다. AI · 머신러닝 · lightseekorg/tokenspeed · Python
Key Point 에이전틱 AI 애플리케이션이 주목받으면서 추론 엔진의 처리량과 지연시간이 핵심 경쟁력이 되었고, TokenSpeed는 이를 위해 기본부터 재설계한 오픈소스 솔루션으로 실제 대규모 모델 배포에서 검증된 성능을 입증했다.
핵심 요약
LightSeek Foundation이 에이전틱 워크로드에 최적화된 LLM 추론 엔진 TokenSpeed를 오픈소스로 공개했다. 기존 엔진과 달리 제어 평면(C++)과 실행 평면(Python)을 분리한 아키텍처를 채택했으며, 제어 평면은 유한 상태 머신으로 구현되어 컴파일 타임에 KV 캐시 리소스 안전성을 보장한다. 커널은 플러그인 가능한 계층형 시스템으로 설계되었으며, Blackwell GPU에서 가장 빠른 MLA(Multi-head Latent Attention) 구현 중 하나를 포함한다. 전체 요약 9문장 읽기 → 014 21:11 ▲ 40 · 댓글 3 로봇 학습에서 세계 모델과 행동 예측이 서로 강화할 수 있을까 세계 모델링(영상의 미래 예측)과 행동 모델링(정책 학습)의 상호작용을 조사하는 OneWM 프레임워크를 제안한다. AI · 머신러닝 · Can World and Action Modeling Benefit Each Other under Unified Causal Training?
Key Point 로봇의 행동 학습과 환경 이해 모델을 같은 구조에서 동시에 훈련할 때 둘이 서로 강화하는 효과가 있는지를 첫 체계적으로 검증한 결과로, 로봇 학습의 효율성을 높일 새로운 방법론을 제시한다.
핵심 요약
세계 모델링(영상의 미래 예측)과 행동 모델링(정책 학습)의 상호작용을 조사하는 OneWM 프레임워크를 제안한다. 통합된 인과 학습 구조 하에서 행동을 세계 예측의 조건과 정책 학습의 목표로 동시에 취급한다. 지정된 행동이 주어졌을 때 그 시각적 결과를 예측하는 학습이 정책 성능과 일반화를 개선하는지 검증했다. 전체 요약 8문장 읽기 → 015 03:12 ▲ 12 · 댓글 2 LLM 벤치마크 검증, 중복 제거로 비용 절감 LLM 평가에 쓰이는 벤치마크 중 다수가 중복되어 평가 비용이 불필요하게 커지는 문제가 있다. AI · 머신러닝 · Are We Testing Too Much? A Survey of Benchmark Compression for Efficient Evaluation of Large Language Models
Key Point LLM 평가 비용을 줄이는 벤치마크 압축 기법들을 체계적으로 분류하고 검증 방법을 정리한 첫 종합 조사로, 평가 효율을 추구하는 연구팀과 조직이 신뢰할 수 있는 방법을 선택하는 데 도움이 된다.
핵심 요약
LLM 평가에 쓰이는 벤치마크 중 다수가 중복되어 평가 비용이 불필요하게 커지는 문제가 있다. 벤치마크 압축(Benchmark Compression)은 전체 벤치마크 중 일부만 평가한 결과로 전체 성능과 순위를 추정하는 기법이다. 이 분야는 2024년부터 연구가 급증했으며, 119편의 논문을 검토하여 체계적인 분류를 수행했다. 전체 요약 7문장 읽기 → 016 09:11 ▲ 119 · 댓글 37 10년 전 케빈 켈리의 AI 예측, 실제로 어떻게 되었나 케빈 켈리는 2016년 저서 『더 이비터블』에서 2026년까지의 AI 미래를 예측했다. AI · 머신러닝 · Kevin Kelly's 2016 AI Predictions, 10 Years Later
Key Point 2016년 예측이 2026년 현재 얼마나 맞았는지, 실제 AI 발전 방향과 상용화 트렌드가 케빈 켈리의 비전과 어떻게 부합하거나 벗어났는지 점검할 수 있다.
핵심 요약
케빈 켈리는 2016년 저서 『더 이비터블』에서 2026년까지의 AI 미래를 예측했다. Google의 메인 상품은 검색이 아닌 AI가 될 것이며, 3일 3억 건의 검색 쿼리가 Google AI 훈련 데이터가 된다고 지적했다. Cloud 기반 AI는 네트워크 효과로 인해 2~3개 대형 상용 AI 독과점 시대가 올 것이라 예측했다. 전체 요약 6문장 읽기 → 017 03:11 ▲ 162 · 댓글 60 슈퍼마리오64 개발 비하인드 - 닌텐도 코더 긱스 고다드 인터뷰 2001년 닌텐도 코더 긱스 고다드의 미발표 인터뷰로, 슈퍼마리오64 개발 당시의 뒷이야기를 담은 자료이다. 하드웨어 · 시스템 · The Making Of Super Mario 64 – full Giles Goddard interview (2001)
Key Point 슈퍼마리오64가 3D 게임 설계와 게임플레이 튜닝을 어떻게 했는지 개발자 직접 증언으로 보여주며, 현대 3D 게임의 기초가 된 기술 결정들을 구체적으로 공개한다.
핵심 요약
2001년 닌텐도 코더 긱스 고다드의 미발표 인터뷰로, 슈퍼마리오64 개발 당시의 뒷이야기를 담은 자료이다. 마리오 팀은 약 15명 규모로 젤다 시간의 오카리나 제작팀보다 훨씬 작았으며, 닌텐도 내 아티스트와 프로그래머는 분리되어 있었다. N64 에뮬레이터 없이 SGI Onyx에서 GL 프로그래밍으로 시작했고, 6개월간 컨트롤러가 없어 개조된 세가 조이패드를 사용했다. 전체 요약 13문장 읽기 → 018 15:13 ▲ 37 · 댓글 2 로봇 영상 예측 모델 DreamTrue, AgiBot World Challenge 2026 우승 로봇의 행동에 충실하고 물리적으로 타당한 영상 예측이 가능한 다중 시점·다중 로봇 대응 월드 모델 DreamTrue를 제시한다. AI · 머신러닝 · DreamTrue: Action-Faithful Robot World Model with Counterfactual Post-Training
Key Point 로봇 학습에서 행동 추종과 물리적 타당성이라는 두 가지 핵심 문제를 동시에 해결하는 기법이 실제로 결함률을 48%에서 6%로 낮췄으며, 국제 대회 우승으로 검증되어 로봇 월드 모델 발전에 중요한 진전을 보여준다.
핵심 요약
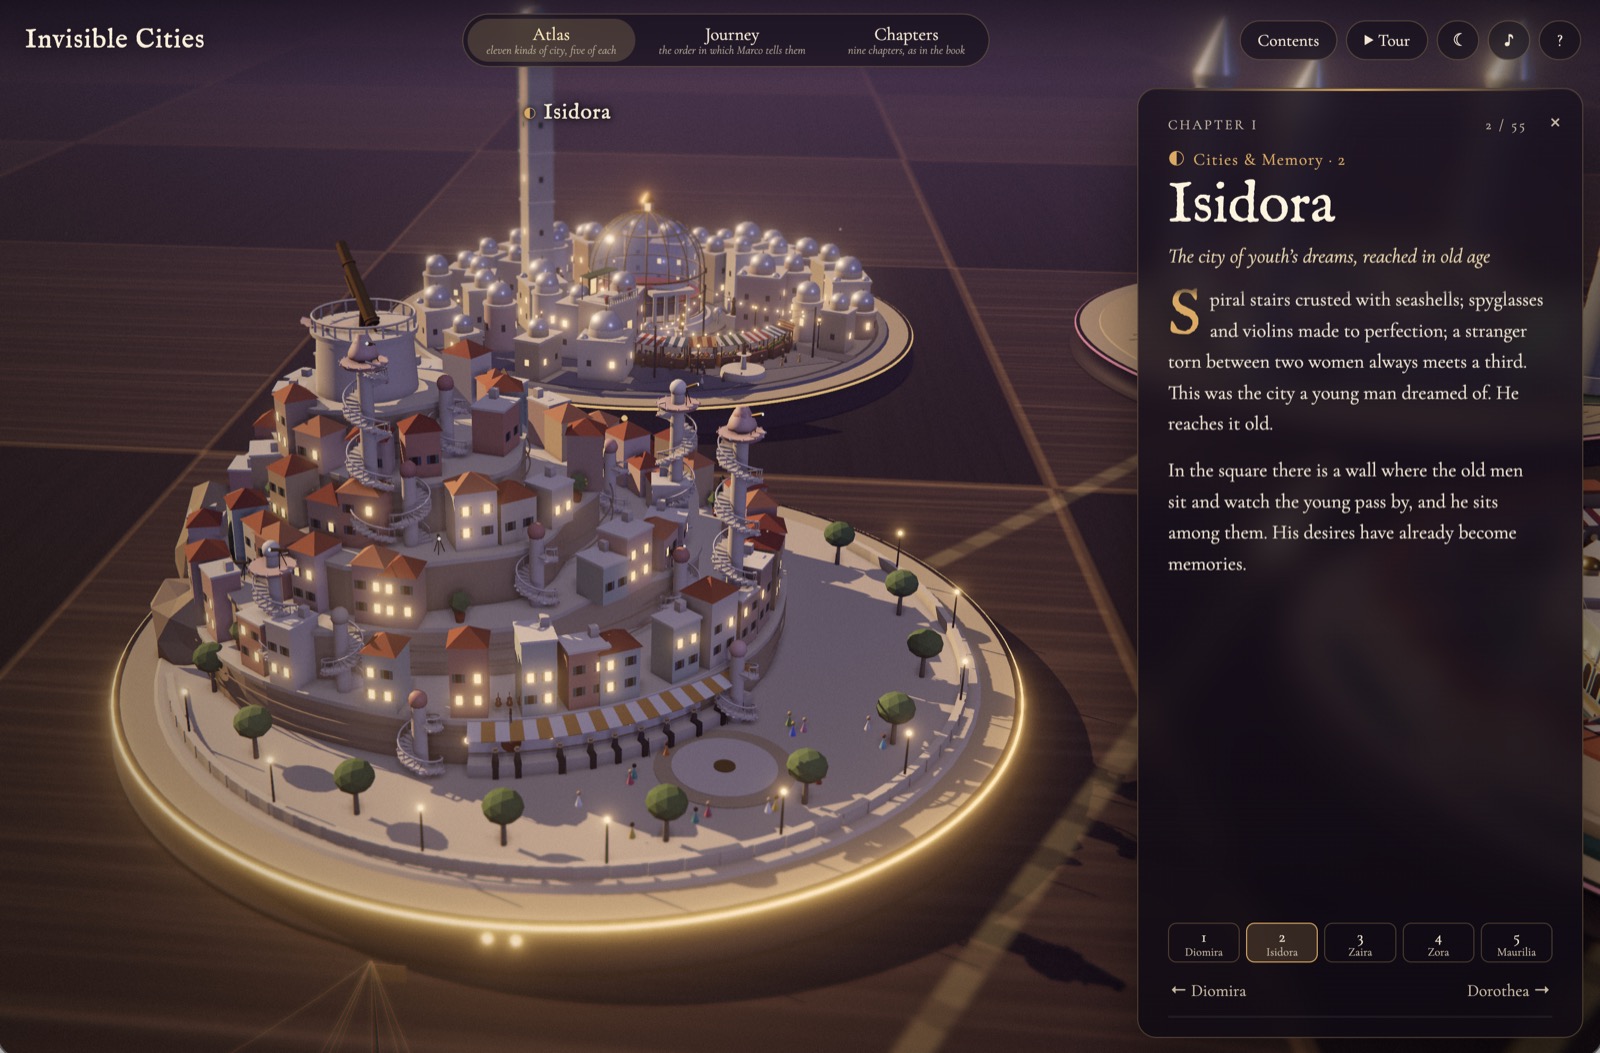
로봇의 행동에 충실하고 물리적으로 타당한 영상 예측이 가능한 다중 시점·다중 로봇 대응 월드 모델 DreamTrue를 제시한다. 기존 로봇 데이터셋으로 학습할 때 발생하는 두 가지 문제를 해결한다: 부정확한 캘리브레이션이 행동 추종을 방해하고, 실패 상호작용의 제한적 범위가 성공 편향을 만든다. 행동 궤적을 이미지 공간 조건으로 변환하고 오프라인 기하학 캘리브레이션을 도입해 다양한 로봇 체형 간 행동 추종을 개선한다. 전체 요약 8문장 읽기 → 019 00:11 ▲ 167 · 댓글 100 Claude Opus 5.5가 6시간에 그려낸 인터랙티브 도시 시각화 작성자는 Italo Calvino의 '보이지 않는 도시' 55개를 세계지도 형태로 시각화하는 작업을 GPT-6 Astra와 Claude Opus 5.5에 동일한 one-shot 프롬프트로 줬다. AI · 머신러닝 · I gave Opus 5.5 one prompt and six hours to visualize Invisible Cities
Key Point Claude Opus 5.5가 복잡한 인터랙티브 시각화를 단일 프롬프트로 생성하는 능력의 수준을 직접 테스트한 결과로, LLM이 데이터 시각화와 인터랙티브 디자인에 얼마나 실용적이 되었는지 보여준다.
핵심 요약
작성자는 Italo Calvino의 '보이지 않는 도시' 55개를 세계지도 형태로 시각화하는 작업을 GPT-6 Astra와 Claude Opus 5.5에 동일한 one-shot 프롬프트로 줬다. GPT-6 Astra는 53분에 약 $10의 API 비용으로 end-to-end 작동했지만, 불필요한 개념과 주석이 많아 시각적 노이즈가 있었고 Captain Obvious 식 설명이 있었다. Claude Opus 5.5는 지시대로 6시간을 모두 사용하지는 않았으나, 6개의 서브에이전트를 병렬로 실행하며 1시간 25분에 약 $74 비용으로 완성했다. 전체 요약 5문장 읽기 → 020 00:11 ▲ 276 · 댓글 226 OpenAI, 수학 논문 3편 철회…부호 오류 발견 OpenAI가 수학 논문 저장소에서 3편의 논문을 철회했다. 오픈소스 · 도구 · OpenAI Withdraws 3 Math Papers
Key Point 수학 논문의 기초가 되는 핵심 증명에서 오류가 발견되면 수십 편의 후속 연구에 영향을 미치는데, OpenAI가 어떻게 이를 공개하고 복구했는지 보여주는 사례이다.
핵심 요약
OpenAI가 수학 논문 저장소에서 3편의 논문을 철회했다. 'Algebraicity of Weil classes on split abelian eightfolds' 논문에서 발견된 부호 오류가 안정화-추적 소거 논증과 다른 논문 2편이 의존하던 구성을 무효화했다. 철회된 3편은 'Algebraicity of Keil classes on split abelian eightfolds', 'Algebraicity of Kuga–Satake Correspondences for K3 Surfaces', 'The rational Hodge conjecture for products of K3 surfaces'이다. 전체 요약 9문장 읽기 → 021 00:11 ▲ 133 · 댓글 117 1990년대 명작 데모씬, 브라우저에서 그대로 작동 DOS 시대 고전 데모의 원본 코드를 명령어 단위로 재컴파일해 브라우저에서 실행하는 프로젝트를 공개했다. 웹 · 프론트엔드 · Classic PC demoscene productions running natively in the browser
Key Point 1990년대 컴퓨터 문화의 역사적 유산인 데모씬 작품들을 원본 동작 방식 그대로 보존·재현하는 기술적 성과로, 레트로 컴퓨팅과 웹 기술의 혁신적 결합을 보여준다.
핵심 요약
DOS 시대 고전 데모의 원본 코드를 명령어 단위로 재컴파일해 브라우저에서 실행하는 프로젝트를 공개했다. x86 에뮬레이터로 실행되는 데모의 모든 CPU 코드 블록을 녹음하고, 이를 정확한 사이클 타이밍을 보존한 C 코드로 변환한다. C는 웹어셈블리로 컴파일되며, 타이머·VGA 카드·사운드 블래스터 등 원본 하드웨어를 모델링한다. 전체 요약 8문장 읽기 → 022 18:30 ▲ 15 · 댓글 2 실패한 추론에만 교사 신호 적용, 코드·수학 성능 향상 온-폴리시 증류(OPD)는 대형 언어모델의 학생 모델이 자신이 생성한 결과로 학습하는 방식으로 널리 쓰이지만, 토큰 수준의 국소적 최적화만 하고 전체 추론의 질을 고려하지 않습니다. AI · 머신러닝 · DiffGate: Difficulty-Gated Teacher Guidance for On-Policy Distillation
Key Point 기존 증류와 강화학습의 한계를 동시에 해결하는 방법으로, 작은 언어모델(0.6B~1.7B)의 코딩·수학 추론 성능을 실질적으로 향상시키는 기법입니다.
핵심 요약
온-폴리시 증류(OPD)는 대형 언어모델의 학생 모델이 자신이 생성한 결과로 학습하는 방식으로 널리 쓰이지만, 토큰 수준의 국소적 최적화만 하고 전체 추론의 질을 고려하지 않습니다. 보상 기반 강화학습(RLVR, 특히 GRPO)은 전체 결과 수준의 지도를 제공하지만 희소 보상으로 인해 신용 할당이 입자합니다. 연구진은 두 방식의 한계를 분석했습니다: OPD는 밀집된 국소 신호를 주지만 정답률과 약하게 연관되고, GRPO는 작업 성공을 포착하되 토큰별 신용 할당이 정교하지 못합니다. 전체 요약 9문장 읽기 → 023 18:30 ▲ 156 · 댓글 255 19세기 영국 엘리트의 성공 비결, 공부 아닌 네트워킹? 19세기 영국 지배층은 현대의 성공 담론과 정반대의 삶을 살았다. 아침 일찍 일어나고 금욕적으로 사는 대신, 늦게까지 자고 술을 마시며 파티와 사냥, 드레스업을 즐겼다. 기타 · Why were Victorian elites so effective?
Key Point 현대의 성공 담론(STEM, 금욕주의, 과로)과 정반대로 성공한 역사적 사례는, 조직 리더십과 사회적 결집력을 위해서는 다른 우선순위가 필요할 수 있음을 시사한다.
핵심 요약
19세기 영국 지배층은 현대의 성공 담론과 정반대의 삶을 살았다. 아침 일찍 일어나고 금욕적으로 사는 대신, 늦게까지 자고 술을 마시며 파티와 사냥, 드레스업을 즐겼다. 그럼에도 당시 영국은 세계 최고의 부국이었고, 기업들은 국제 무역·금융을 지배했으며, 해군은 세계 해양을 제어했다. 거대한 제국을 유지하면서 대륙 유럽의 혁명과 내전을 피하고 민주화를 추진했다. 이 성공이 산업혁명의 부산물인지, 아니면 엘리트의 전략적 능력 때문인지는 검증 불가능하지만, 소프트 스킬과 네트워킹에 중점을 둔 교육 시스템이 실제로 효과적이었을 가능성을 탐색해볼 수 있다. 전체 요약 12문장 읽기 → 024 18:33 ▲ 18 · 댓글 2 RAG 시스템 배포 판단을 위한 증거 기반 품질검증 프레임워크 기업이 RAG 시스템을 배포할 때 버전 승인, 수정, 차단 등의 의사결정을 자동화하기 위해 AGO AI Quality Gate 프레임워크를 제안했다. AI · 머신러닝 · AGO AI Quality Gate: Evidence-First Release Decisions for Retrieval-Augmented Generation
Key Point RAG 시스템의 프로덕션 배포를 자동화할 때 LLM 판사의 오류가 얼마나 심각한지, 그리고 이를 어떻게 체계적으로 검증해야 하는지 보여주는 실무적 해결책을 담았습니다.
핵심 요약
기업이 RAG 시스템을 배포할 때 버전 승인, 수정, 차단 등의 의사결정을 자동화하기 위해 AGO AI Quality Gate 프레임워크를 제안했다. AGO는 불완전한 증거와 LLM 판사의 오류를 명시적 결과로 다루는 4단계 의사결정 모델, 결정론적 검사와 LLM 평가를 결합한 계층화 점수 매기기, 회귀 위험을 확률로 정량화하는 베타-이항 게이트로 구성된다. LLM 판사의 신뢰성을 사전 검증하는 메타-평가 프로토콜을 필수로 포함하여 판사 오류가 최종 결정에 영향을 미치지 않도록 설계했다. 전체 요약 7문장 읽기 → 025 18:33 ▲ 20 · 댓글 2 재귀 언어모델의 고정점 최적화로 학습·추론 비용 2배 절감 루프된 언어모델의 매 반복은 학습·디코딩·프리필·강화학습에서 비용을 증가시키는데, 재귀 상태가 고정점에 가까워질수록 그 경로의 중요도는 감소한다. AI · 머신러닝 · Towards Looped Models Done Right, Part II: Rethinking at Fixed Points
Key Point 재귀 언어모델의 학습·추론 비용을 획기적으로 줄이는 구체적 기법(KV 캐시 축소, 역전파 생략, RL 속도 개선)과 이론적 기반(고정점 특성)을 제시하며, 실험 결과로 입증된 개선 방법을 다룬다.
핵심 요약
루프된 언어모델의 매 반복은 학습·디코딩·프리필·강화학습에서 비용을 증가시키는데, 재귀 상태가 고정점에 가까워질수록 그 경로의 중요도는 감소한다. 고정점 근처에서의 수렴 성질을 활용하면 학습 중 절단된 역전파(truncated backpropagation), 거의 정확도 손실 없는 터미널 KV 공유 디코딩, 1.79배 빠른 프리필을 위한 증류 학생 모델, 저장된 롤아웃 상태에서 그래디언트를 계산하는 RL 업데이트(재생 경로 역전파보다 2배 빠름)가 가능하다. 고정점을 형성하는 두 핵심 요소인 깊이 사전(depth prior)과 입력 주입(input injection)을 개선했다. 전체 요약 8문장 읽기 → 026 18:33 ▲ 10 · 댓글 1 쿼리마다 다른 에이전트 구조 자동 설계하는 SHIFT 발표 멀티에이전트 시스템의 역할·명령어·도구·통신 구조(harness)는 각 쿼리에 따라 달라져야 하는데, 기존에는 추론 시 여러 옵션을 실행하거나 수동으로 설계해야 했다. AI · 머신러닝 · Dynamic Harness Search: Building Multi-Agent Systems Per-Query via Prediction
Key Point 마이크로소프트·구글 같은 기업들도 멀티에이전트 워크플로우를 점점 더 활용하고 있는 가운데, 각 질문에 맞는 최적의 에이전트 구조를 비용 효율적으로 자동 설계하는 방법이 제시되었기 때문이다.
핵심 요약
멀티에이전트 시스템의 역할·명령어·도구·통신 구조(harness)는 각 쿼리에 따라 달라져야 하는데, 기존에는 추론 시 여러 옵션을 실행하거나 수동으로 설계해야 했다. SHIFT는 로컬 LLM 아키텍트가 탐색으로부터 harness 구성 정책과, 실행 결과로부터 정확도 대비 실행 비용을 예측하는 가치함수를 학습한다. 각 쿼리마다 Monte Carlo tree search가 이 예측값들을 이용해 harness를 구성하므로, 실행 과정을 탐색 루프 밖으로 옮긴다. 전체 요약 7문장 읽기 → 027 18:33 ▲ 12 · 댓글 2 로봇 동작 예측을 25배 빠르게 하는 원스텝 AI 모델 World Action Models(WAM)은 비디오 생성 모델에서 시각 정보를 추출해 로봇의 동작 예측을 안내하는데, 기존 효율형 모델도 멀티스텝 디노이징과 전문가 모듈 간 순차 대기로 인해 느렸다. AI · 머신러닝 · RealtimeWAM: One-Step Asynchronous World Action Models
Key Point 비디오 생성 기반 로봇 동작 모델의 추론 속도를 극적으로 개선하는 기술이 공개되었으며, 성능 손실 거의 없이 25배 가속을 달성해 실시간 로봇 제어 애플리케이션을 가능하게 한다.
핵심 요약
World Action Models(WAM)은 비디오 생성 모델에서 시각 정보를 추출해 로봇의 동작 예측을 안내하는데, 기존 효율형 모델도 멀티스텝 디노이징과 전문가 모듈 간 순차 대기로 인해 느렸다. RealtimeWAM은 원스텝 동작 생성과 비동기 추론으로 이 두 병목을 해결한다. 멀티스텝 반복을 줄이기 위해 Teacher-Anchored Consistency Distillation(TACD)을 제안했는데, 이는 국소 일관성 오차만으로는 정확한 최종 동작을 보장할 수 없다는 문제를 해결하고 동결된 교사 모델의 멀티스텝 롤아웃 결과로 명시적 감독을 추가한다. 전체 요약 7문장 읽기 → 028 18:35 ▲ 115 · 댓글 29 화성의 '혼돈 지형', 거대한 물의 흔적 화성에는 지구에 없는 독특한 지형인 '혼돈 지형(chaos terrain)'이 있다. 이는 수십 km에 달하는 거대한 암석 덩어리들로 이루어져 있으며 깎여나간 협곡들이 복잡하게 얽혀 있다. 하드웨어 · 시스템 · Martian chaos terrain
Key Point 화성의 물 흔적을 이해하려면 먼저 이 독특한 지형의 특징과 형성 메커니즘을 알아야 할 때 읽어야 한다.
핵심 요약
화성에는 지구에 없는 독특한 지형인 '혼돈 지형(chaos terrain)'이 있다. 이는 수십 km에 달하는 거대한 암석 덩어리들로 이루어져 있으며 깎여나간 협곡들이 복잡하게 얽혀 있다. 분화구 개수를 세는 방법으로 과학자들은 이 지형이 20~38억 년 전에 형성되었다고 결론지었다. 혼돈 지형은 화성의 고지대, 특히 Chryse Planitia 남쪽과 Oxia Palus 지역에 집중되어 있다. 많은 대규모 채널이 이곳에서 시작되는 것으로 보아 거대한 물의 흐름이 원인이라고 추측된다. 전체 요약 10문장 읽기 → 029 09:11 ▲ 13 · 댓글 2 여러 RL 교사 모델의 신호가 학생 파라미터에 미치는 영향 분석 Qwen3-1.7B 학생 모델과 같은 초기화에서 훈련한 4개 도메인 RL 교사들로부터의 다중 교사 온폴리시 증류(MOPD) 과정에서 그래디언트, 옵티마이저 업데이트, 태스크 학습 곡선을 비교 분석했다. AI · 머신러닝 · From Gradients to Capabilities: Understanding Multi-Teacher On-Policy Distillation
Key Point 여러 교사 신호를 결합할 때 손실 평균화, 옵티마이저 동작, 정밀도가 최종 성능에 미치는 구체적인 영향을 분석한 결과로, LLM 증류 설계의 의사결정 근거를 제시한다.
핵심 요약
Qwen3-1.7B 학생 모델과 같은 초기화에서 훈련한 4개 도메인 RL 교사들로부터의 다중 교사 온폴리시 증류(MOPD) 과정에서 그래디언트, 옵티마이저 업데이트, 태스크 학습 곡선을 비교 분석했다. 손실 평균화는 응답 길이를 기반으로 암묵적 가중치를 부여하는데, 토큰 평균화는 긴 응답을 선호하고 도메인 기여도 균등화도 도메인 내에서 이 가중치를 유지한다. Adam 옵티마이저의 1차 모멘트는 파라미터 업데이트의 차이를 감소시켜, 원본 그래디언트에는 차이가 있지만 교사 간 코사인 유사도 0.83, 평균화 규칙 간 0.96을 보인다. 전체 요약 6문장 읽기 → 030 00:11 ▲ 132 · 댓글 47 LLM 판단 vs 결정 모델, 벤치마크 결과는 기존 방식이 우위 TypeSafe AI의 Jev 같은 결정 모델(decision model)은 고정된 스키마의 '결정'을 출력하는 새로운 AI 안전장치 기법으로, 자유형 텍스트 생성 방식보다 빠르고 저렴하며 학습 데이터 없이도 새로운 문제에 적용할 수 있다. AI · 머신러닝 · Decision models like Jev don't beat LLM-as-a-judge or traditional classifiers
Key Point 신흥 기술로 주목받는 결정 모델이 실제로는 기존의 소형 분류기와 LLM 판단 방식과의 경쟁에서 우월하지 못하다는 벤치마크 결과로, AI 안전장치 선택 시 실용성을 강조하는 실증 데이터를 제공한다.
핵심 요약
TypeSafe AI의 Jev 같은 결정 모델(decision model)은 고정된 스키마의 '결정'을 출력하는 새로운 AI 안전장치 기법으로, 자유형 텍스트 생성 방식보다 빠르고 저렴하며 학습 데이터 없이도 새로운 문제에 적용할 수 있다. Red Hat 연구팀은 프롬프트 주입과 콘텐츠 안전성 두 가지 벤치마크에서 9개 안전장치를 비교 평가했다: CPU 규모 사전학습 분류기, BART-large-mnli, Shieldstral, Nemotron-3.5, Qwen3.6-35B, Laya, DiffusionGemma, Jev. 프롬프트 주입 탐지에서 Qwen3.6-35B(LLM-as-a-judge)이 89.31% 정확도로 1위, DiffusionGemma 87.72% 2위, Jev는 86.35%로 4위를 기록했다. 전체 요약 10문장 읽기 → 031 21:11 당일 +101 클라우드플레어, AI 업무 환경 'Cloudflare OS' 오픈소스화 클라우드플레어가 자사 직원들을 위해 개발한 AI 생산성 환경 'Cloudflare OS'를 오픈소스로 공개했다. AI · 머신러닝 · cloudflare/cloudflare-os · TypeScript
Key Point SaaS 중심의 클라우드 아키텍처에서 벗어나 사용자 각자가 자신만의 AI 에이전트와 앱을 보유하고 제어하는 새로운 소프트웨어 배포 방식을 제시하는 대규모 오픈소스 플랫폼이다.
핵심 요약
클라우드플레어가 자사 직원들을 위해 개발한 AI 생산성 환경 'Cloudflare OS'를 오픈소스로 공개했다. 사용자는 에이전트 채팅 UI를 통해 회사 맥락을 담은 작업을 요청하고, AI가 작성한 앱 '가젯'을 샌드박스에서 안전하게 구동하며, '게이트키퍼'라는 보안 프레임워크로 에이전트와 앱의 접근을 제어한다. 각 사용자는 자신만의 가젯 인스턴스를 소유하므로 보안 버그로도 다른 사용자 데이터가 유출될 수 없고, 필요한 기능은 AI에 요청해 직접 코드를 수정할 수 있다. 전체 요약 11문장 읽기 → 032 12:11 ▲ 225 · 댓글 123 클라우드 API, 기본값으로 지출 상한선을 둬야 한다 코딩 에이전트 시대에 자동화된 서비스가 통제 불능으로 치달아 수천~수만 달러 청구서가 나오는 사태를 막으려면, 유료 API와 클라우드 서비스는 기본값으로 월별 하드 예산 상한선을 제공해야 한다. 인프라 · 데브옵스 · We're going to need default hard budget caps on pretty much everything
Key Point AI 에이전트가 자동으로 API를 호출하는 시대에 예산 폭탄을 막기 위한 인프라 설계 문제를 다루고, AWS와 Google Cloud가 이를 실제로 구현하기 시작한 상황을 설명한다.
핵심 요약
코딩 에이전트 시대에 자동화된 서비스가 통제 불능으로 치달아 수천~수만 달러 청구서가 나오는 사태를 막으려면, 유료 API와 클라우드 서비스는 기본값으로 월별 하드 예산 상한선을 제공해야 한다. 경고 이메일(소프트 캡) 같은 방식은 불충분하다. 사용자가 자는 동안 rogue 서비스가 계속 요금을 쌓을 수 있기 때문이다. 기업들이 예산 초과로 서비스가 중단되는 것을 꺼린다는 반론이 있지만, 대부분은 5자리 이상의 예상치 못한 청구서보다 에러를 받는 쪽을 선택할 것이다. 전체 요약 7문장 읽기 → 033 21:11 당일 +140 완전 오프라인 음성 인식, 오픈소스 Handy 공개 OpenAI의 Whisper 모델을 기반으로 완전 로컬에서 동작하는 크로스플랫폼 음성-텍스트 변환 애플리케이션 Handy를 오픈소스로 공개했다. 오픈소스 · 도구 · cjpais/Handy · Rust
Key Point 클라우드 전송 없이 완전히 로컬에서 동작하는 오픈소스 음성 인식 도구로, 개인정보 보호를 중시하거나 오프라인 환경에서 음성 입력이 필요한 개발자와 사용자에게 실질적인 선택지가 된다.
핵심 요약
OpenAI의 Whisper 모델을 기반으로 완전 로컬에서 동작하는 크로스플랫폼 음성-텍스트 변환 애플리케이션 Handy를 오픈소스로 공개했다. 단축키를 누르고 말하면 음성이 텍스트로 변환되어 현재 활성 창의 텍스트 필드에 자동으로 입력되며, 음성 데이터가 외부로 전송되지 않는다. Whisper(Small/Medium/Turbo/Large) 또는 CPU 최적화된 Parakeet V3 모델 중 선택 가능하며, GPU 가속을 지원한다. 전체 요약 12문장 읽기 → 034 03:11 ▲ 26 · 댓글 2 엔터프라이즈 데이터 작업 평가 벤치마크 'Argo-Bench' 공개 기존 text-to-SQL 벤치마크는 쿼리 생성만 평가하며 정답 오류도 빈번한데, 실제 엔터프라이즈 데이터 환경은 수십 개 테이블을 넘나들며 통계 분석과 실행 가능한 의사결정을 요구한다. AI · 머신러닝 · Argo-Bench: Evaluating Data Agents on Enterprise-Scale Workflows
Key Point 엔터프라이즈 규모 데이터 시스템에서 AI가 쿼리 작성을 넘어 실제 의사결정까지 할 수 있는지 평가하는 첫 벤치마크이며, 현재 최강 모델도 35% 미만의 성공률로 데이터 에이전트의 현주소를 보여준다.
핵심 요약
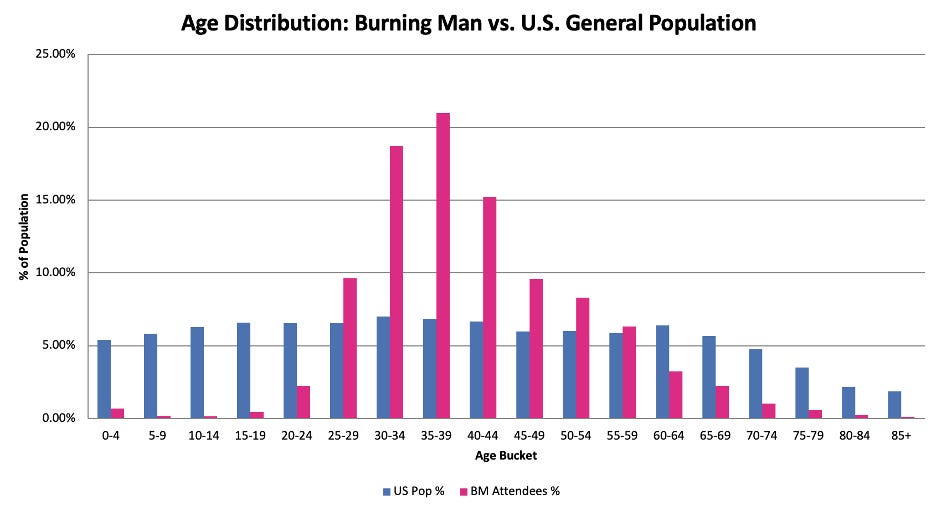
기존 text-to-SQL 벤치마크는 쿼리 생성만 평가하며 정답 오류도 빈번한데, 실제 엔터프라이즈 데이터 환경은 수십 개 테이블을 넘나들며 통계 분석과 실행 가능한 의사결정을 요구한다. Argo-Bench는 뉴욕시 음식배달 플랫폼을 원탁 규모(2024년 주문 8,100만 건)로 시뮬레이션하고 Oracle E-Business Suite 스키마를 따른 235개 테이블, 75억 행의 ERP 웨어하우스를 모델링했다. 210개 데이터 과학·분석 작업으로 구성되며, 에이전트는 웨어하우스를 탐색해 사실을 재구성한 뒤 부정행위자 계정 차단, 배송원 인센티브 예산 할당, 소급 급여 지급 같은 실제 액션을 취해야 한다. 전체 요약 6문장 읽기 → 035 09:11 ▲ 100 · 댓글 122 번닝맨 사망률 통계 분석, 3명 사망은 정상 범위 2026년 번닝맨에서 3명이 사망했으며, 이는 행사 역사상 최다 기록이다. 기타 · Burning Man death rates – A short lesson in statistics
Key Point 통계 분석을 통해 직관적으로 '높아 보이는' 수치가 인구통계학적 맥락에서는 정상 범위임을 보여주는 중요한 사례이며, 데이터 해석 시 표준화와 표본 편향을 고려해야 하는 이유를 설명한다.
핵심 요약
2026년 번닝맨에서 3명이 사망했으며, 이는 행사 역사상 최다 기록이다. 미국 일반 인구의 조악 사망률(인구 10만 명당 909.3명/년)을 적용하면 70,000명이 1주일 체류할 때 약 12.2명의 사망을 예상할 수 있다. 번닝맨 참가자들은 평균 미국 인구보다 훨씬 젊고, 교육 수준이 높으며, 소득이 많아 인구통계학적으로 특이하다. 전체 요약 8문장 읽기 → 036 21:11 당일 +163 AI 에이전트용 코드 인덱스, CodeGraph 공개 Rust 커널 기반의 사전 인덱싱 코드 지식그래프로, Claude Code, Cursor, Copilot 등 9개 AI 에이전트를 지원한다. AI · 머신러닝 · colbymchenry/codegraph · C
Key Point AI 에이전트가 파일 탐색 없이 한 번의 도구 호출로 정확한 코드 구조를 얻어 토큰과 비용을 대폭 절감할 수 있으며, 로컬 자동 동기화로 인덱스 관리 부담을 완전히 제거한다.
핵심 요약
Rust 커널 기반의 사전 인덱싱 코드 지식그래프로, Claude Code, Cursor, Copilot 등 9개 AI 에이전트를 지원한다. 코드 변경 시 자동 동기화되며 100% 로컬에서 작동하고 외부 API나 데이터 전송이 없다. 벤치마크 결과 VS Code, Excalidraw 등 7개 실제 오픈소스 프로젝트에서 기존 방식 대비 도구 호출 88% 감소, 처리 토큰 62% 감소, 비용 44% 절감을 기록했다. 전체 요약 10문장 읽기 → 037 12:11 ▲ 102 · 댓글 86 메모리 가격 급등, 소비자 시장 붕괴 직전 DRAM과 NAND 제조사들이 장기 계약(LTA)으로 시장 구조를 재편하고 있다: 최대 5년 계약으로 50~70%의 생산량을 상위 5~16개 대형 고객에게 사전 할당해 지난 40년간의 경기 순환 가격 사이클을 깨뜨리려 하고 있다. 하드웨어 · 시스템 · Memory Companies Have Destroyed the Consumer Market
Key Point 제조사들의 장기 계약 전략으로 메모리 가격의 저점이 사라질 수 있으며, PC 게이머부터 의료 기기까지 모든 소비자가 영향을 받게 될 구조 변화가 진행 중입니다.
핵심 요약
DRAM과 NAND 제조사들이 장기 계약(LTA)으로 시장 구조를 재편하고 있다: 최대 5년 계약으로 50~70%의 생산량을 상위 5~16개 대형 고객에게 사전 할당해 지난 40년간의 경기 순환 가격 사이클을 깨뜨리려 하고 있다. 지난 1년간 소비자 메모리 가격이 급락했다: 2TB NVMe SSD 137%, 2TB SATA SSD 183%, 32GB DDR5 363%, 32GB DDR4 294% 인상되었고, DDR5-6000 64GB 키트는 $240에서 $1,300~$1,400으로 483% 올랐다. 서버와 AI용 메모리 수요가 소비자용을 잠식하고 있다: 2027년 NAND 비트 수요 중 서버 애플리케이션 비중이 44.2%에서 51.1%로 증가할 예정이고, 데이터센터 9사의 DRAM·NAND 구매액은 2026년 $433억에서 2027년 $940억으로 급증한다. 전체 요약 11문장 읽기 → 038 21:11 당일 +477 벡터DB 없이 추론으로 문서를 읽는 RAG, PageIndex PageIndex는 벡터 인덱스 대신 계층 구조의 트리 인덱스를 만들고, LLM의 추론으로 그 트리를 탐색하는 벡터리스 RAG 엔진이다. AI · 머신러닝 · VectifyAI/PageIndex · Python
Key Point 벡터DB에 의존하지 않고 LLM의 추론으로 문서를 검색하는 새로운 RAG 방식이, 복잡한 전문 문서에서 기존 벡터 검색보다 훨씬 높은 정확도(98.7%)와 낮은 비용(2~16배 절감)을 달성했기 때문이다.
핵심 요약
PageIndex는 벡터 인덱스 대신 계층 구조의 트리 인덱스를 만들고, LLM의 추론으로 그 트리를 탐색하는 벡터리스 RAG 엔진이다. 벡터 RAG는 의미적 유사성으로 검색하지만, 유사성이 반드시 관련성을 의미하지 않는다. PageIndex는 문맥 이해, 도메인 전문성, 다단계 추론이 필요한 금융보고서나 법률 문서에서 더 정확한 관련 정보를 찾는다. 인덱싱은 문서마다 트리 구조를 생성하고, 검색은 LLM이 그 트리를 추론하며 탐색하는 두 단계로 진행된다. 전체 요약 12문장 읽기 → 039 12:11 ▲ 30 · 댓글 1 장시간 로봇 작업에서 기억력을 평가하는 새 벤치마크 공개 로봇이 장시간 환경과 상호작용할 때 정보를 유지·갱신해야 하는데, 현재 에이전트들은 이를 제대로 못하고 있습니다. AI · 머신러닝 · EmbodiedMemory-Bench: Benchmarking Embodied Memory for Long-Horizon Embodied Tasks
Key Point 로봇이 복잡한 장시간 작업을 수행할 때 필요한 기억 능력의 핵심 문제를 체계적으로 분석하고 평가할 구체적 벤치마크와 솔루션을 제시해 구체화 합니다.
핵심 요약
로봇이 장시간 환경과 상호작용할 때 정보를 유지·갱신해야 하는데, 현재 에이전트들은 이를 제대로 못하고 있습니다. 문제의 원인은 네 가지입니다: 세부 시각 정보 기억 부족, 동적 세계 상태 추적 불안정, 상호작용 결과로 드러난 정보 미기록, 과거 경험 활용 제한. 이를 평가할 벤치마크가 없어 EmbodiedMemory-Bench(EMem-Bench)를 개발했습니다. 전체 요약 8문장 읽기 → 040 06:11 ▲ 111 · 댓글 161 LLM 시대에 프로그래밍 즐거움 지키기 LLM이 코드 생성을 접수하면 인간이 읽을 수 없는 저질 코드가 쌓여 결국 유지보수 불가능한 'LLM 황무지'가 되므로, 개발자는 핵심 코딩은 계속 직접 해야 한다. AI · 머신러닝 · How to keep enjoying programming in a world of LLMs
Key Point 프로그래밍 즐거움을 지키면서 LLM 생산성을 얻는 구체적인 워크플로우를 제시해, AI에 완전히 의존하거나 거부하는 극단 대신 균형잡힌 방식을 추구하는 개발자들에게 실질적 가이드를 제공한다.
핵심 요약
LLM이 코드 생성을 접수하면 인간이 읽을 수 없는 저질 코드가 쌓여 결국 유지보수 불가능한 'LLM 황무지'가 되므로, 개발자는 핵심 코딩은 계속 직접 해야 한다. 프로그래밍 기술은 연습하지 않으면 쇠퇴하는데, LLM에 모두 맡기면 수주 후 스스로 코딩하기 어려워지므로 기술 유지를 위해서도 직접 코딩이 필수다. LLM을 사용하되 '계획 → 에이전트 코딩' 구조 대신 '계획 함께 → 본인이 코딩' 흐름으로 바꾸면, 즐거운 작업은 유지하면서 보조 작업(계획, 리서치, 코드 리뷰 등)만 자동화할 수 있다. 전체 요약 12문장 읽기 → 041 22:26 ▲ 102 · 댓글 33 LLM 거부 응답을 영구 손상 없이 우회하는 Engram 기법 기존 가중치 절제(weight abliteration)는 모델 가중치를 영구적으로 변경해 거부 방향을 제거하지만 비거부 작업 성능도 저하시킨다. AI · 머신러닝 · Dynamic Abliteration: Non-Destructive Refusal Suppression via Engram Steering
Key Point LLM의 안전장치를 영구 손상 없이 우회하는 기술이 공개됨에 따라 오픈 소스 모델의 거부 메커니즘 견고성 문제가 현실화되고 있다.
핵심 요약
기존 가중치 절제(weight abliteration)는 모델 가중치를 영구적으로 변경해 거부 방향을 제거하지만 비거부 작업 성능도 저하시킨다. 이 글은 Qwen3-4B 모델을 예로 PyTorch 포워드 훅으로 런타임 중간 잔차 스트림에 개입해 가중치는 완전히 고정한 채 거부 행동을 억제하는 동적 절제(Dynamic Abliteration) 기법을 제시한다. 단일 레이어 벡터 뺄셈은 다운스트림 레이어가 거부 행동을 재구성하므로 작동하지 않음을 시연했다. 전체 요약 10문장 읽기 → 042 22:26 ▲ 268 · 댓글 43 폰트를 섞어서 엉뚱한 글꼴 만드는 웹앱 Bastardica는 두 개 이상의 폰트를 혼합해 새로운 글꼴을 만드는 웹 도구입니다. 오픈소스 · 도구 · Show HN: Make cursed fonts like Times New Bastard
Key Point 두 개 이상의 폰트를 창의적으로 섞어서 새로운 글꼴을 만들 수 있는 오픈 도구로, 디자인 실험이나 개성 있는 타이포그래피가 필요한 개발자와 디자이너에게 유용합니다.
핵심 요약
Bastardica는 두 개 이상의 폰트를 혼합해 새로운 글꼴을 만드는 웹 도구입니다. 기본 폰트와 믹스인 폰트를 선택한 후 고급 옵션으로 스트라이드(혼합 간격)를 지정해 글리프를 교대로 치환합니다. Y 오프셋과 스케일 효과로 글리프 정렬을 조정할 수 있으며, 3개 이상 폰트를 섞을 때는 소수 스트라이드를 쓰면 충돌을 줄일 수 있습니다. 전체 요약 5문장 읽기 → 043 21:11 ▲ 101 · 댓글 52 LLM 에이전트가 Rust 코드를 2~20배 빠르게 최적화 Claude Opus 같은 에이전트 LLM이 반복적인 최적화 지시를 받으면 Rust 코드를 크게 개선할 수 있음을 실험으로 증명했다. AI · 머신러닝 · Writing Rust code that's fast by asking agents to make the code faster
Key Point 에이전트형 LLM의 성능 최적화 능력이 구체적인 벤치마크 결과로 입증됨에 따라, 고성능 코드 작성의 새로운 워크플로우가 가능해졌다.
핵심 요약
Claude Opus 같은 에이전트 LLM이 반복적인 최적화 지시를 받으면 Rust 코드를 크게 개선할 수 있음을 실험으로 증명했다. UMAP 차원 축소 알고리즘을 Rust로 구현해 벤치마킹하면서, 에이전트가 faer·simsimd 같은 최적화 라이브러리를 활용해 코드 속도를 2배~20배 향상시켰다. 에이전트에 명확한 성공 기준(pass/fail)과 긴 마크다운 프롬프트(대문자·강조 사용)를 제공하니 자동 반복 최적화가 효과적이었다. 전체 요약 5문장 읽기 → 044 18:11 ▲ 135 · 댓글 6 LLM 에이전트의 '안목' 측정 벤치마크 공개 장시간 작업에서 LLM 에이전트가 어느 방향으로 나아갈지 결정하는 능력을 '안목'(taste)이라 정의하고, 이를 평가하는 Taste-Bench 벤치마크를 개발했다. AI · 머신러닝 · The Tasteful Agent: Measuring and Improving Taste in Long-Horizon Tasks
Key Point 장시간 작업을 수행하는 AI 에이전트의 핵심 약점인 '의사결정 능력'을 체계적으로 측정할 수 있는 첫 벤치마크이며, 어떤 조건에서 의사결정이 어려워지는지 파악할 수 있다.
핵심 요약
장시간 작업에서 LLM 에이전트가 어느 방향으로 나아갈지 결정하는 능력을 '안목'(taste)이라 정의하고, 이를 평가하는 Taste-Bench 벤치마크를 개발했다. 병렬 시도나 궤적 내 우회를 분석해 자동으로 결정 지점(decision fork)을 추출하고, 각 지점에서 여러 선택지 중 더 나은 결과로 이어진 것을 찾도록 모델을 평가한다. 최고 성능 모델도 정확히 59.7%의 질문에만 답했으며, 결정 근거가 뒤에 나타날수록 모든 모델의 정확도가 급격히 떨어진다. 전체 요약 5문장 읽기 → 045 00:11 ▲ 124 · 댓글 47 샤오미 MiMo-V2.6-Pro, 지능형 AI 모델 분석 Artificial Analysis Intelligence Index에서 46점을 기록하며 동급 모델 평균(중앙값 18)을 크게 상회했다. AI · 머신러닝 · MiMo-v2.6-Pro: Intelligence, Performance and Price Analysis
Key Point 오픈소스 언어모델의 성능, 속도, 가격을 한눈에 비교할 수 있는 벤치마크 결과로, 상용 모델 도입을 검토하는 개발팀의 의사결정에 필요하다.
핵심 요약
Artificial Analysis Intelligence Index에서 46점을 기록하며 동급 모델 평균(중앙값 18)을 크게 상회했다. 초당 111개 토큰 생성으로 빠른 속도를 자랑하지만, 요약 작업에서 140M 토큰을 생성해 다소 장황하다. 입력 1M 토큰당 $0.43, 출력 1M 토큰당 $0.87로 오픈 가중치 모델 중 중상 수준의 가격대이다. 전체 요약 5문장 읽기 → 046 03:10 ▲ 137 · 댓글 194 마틴 파울러가 본 LLM의 명암 저명한 소프트웨어 아키텍트 마틴 파울러는 LLM 기술에 대해 생산성 향상과 혁신의 가능성을 인정하면서도 강한 거부감을 드러낸다. AI · 머신러닝 · I Don't Like LLMs
Key Point 생산성 도구로서의 LLM 도입이 가속화되는 가운데, 기술 리더십의 목소리로 존경받는 인물이 제시하는 비판적 관점은 개발 커뮤니티의 LLM 활용에 대한 신중함을 촉발한다.
핵심 요약
저명한 소프트웨어 아키텍트 마틴 파울러는 LLM 기술에 대해 생산성 향상과 혁신의 가능성을 인정하면서도 강한 거부감을 드러낸다. LLM과의 상호작용에서 그가 느끼는 가장 큰 불편함은 부자연스러운 인간미, 거짓된 사과로 뒤따르는 확신 있는 거짓말이다. 시장 조사에서도 사람들은 LLM이 유용하다고 평가하면서도 사회에 해가 될 것이라고 우려하는 모순적 반응을 보인다. 전체 요약 5문장 읽기 → 047 18:10 ▲ 123 · 댓글 31 90년대 3D 그래픽 칩을 FPGA로 재현하다 작성자가 FPGA에서 1990년대 3dfx Voodoo Graphics를 SystemVerilog로 구현한 zSST를 개발했다. 하드웨어 · 시스템 · Recreating Voodoo Graphics and a Late-1990s Gaming PC on an FPGA
Key Point PC 게이밍 역사의 분기점이던 Voodoo 칩의 내부 구조를 재구현한 기술적 성과로, 하드웨어 아키텍처와 고정 파이프라인 설계의 실제 작동 원리를 보여주는 사례다.
핵심 요약
작성자가 FPGA에서 1990년대 3dfx Voodoo Graphics를 SystemVerilog로 구현한 zSST를 개발했다. z486 CPU와 함께 Xilinx KV260 보드에서 DOS PC 환경을 완성해 Tomb Raider를 원본 3dfx 렌더러로 구동한다. zSST는 텍스처 필터링, 미맵, 깊이/알파 테스트, 안개, 블렌딩, 디더링 등 Voodoo의 주요 기능을 지원한다. 전체 요약 6문장 읽기 → 048 08:25 ▲ 143 · 댓글 7 9·11 이후 25년, 대규모 감시 재평가 시점 9·11 이후 미국 정부는 표적 감시에서 인터넷 백본 접근, 통화·인터넷 메타데이터 대량 수집 등 대규모 감시로 전환했다. 보안 · 25 Years of Mass Surveillance Is Enough [Auth: Cindy Cohn; Bruce Schneier]
Key Point 테러 대응을 명목으로 25년간 확대된 감시 체계가 이제 법 집행과 민간 보안까지 확산되는 상황에서, 그 실제 효과와 시민의 자유에 미치는 대가를 평가해야 할 시점임을 지적한다.
핵심 요약
9·11 이후 미국 정부는 표적 감시에서 인터넷 백본 접근, 통화·인터넷 메타데이터 대량 수집 등 대규모 감시로 전환했다. 현재 대규모 감시는 법 집행 기관의 일상적 도구가 되었으며, ICE와 지역 경찰이 광고판 독자, 안면인식, 자동 번호판 인식을 활용한다. 구글, 페이스북 같은 민간 기업의 감시 수집 데이터가 정부로 흘러가며, FBI는 데이터 브로커에서 미국인 정보를 매입하고 있다. 전체 요약 5문장 읽기 → 050 21:11 ▲ 118 · 댓글 12 위상수학 그림책을 손그리기 스타일로 렌더링하다 프란시스의 1950년대 기법을 따라 3D 위상곡면을 손으로 그은 듯한 해칭과 음영으로 렌더링하는 대화형 뷰어입니다. 웹 · 프론트엔드 · A Topological Picture Book, Rendered
Key Point 3D 기하를 예술적 선화로 표현하는 알고리즘과 GPU 렌더링 기법이 수학 시각화에 어떻게 적용되는지 보여주는 실제 구현 사례로, 컴퓨터 그래픽스와 과학 시각화 분야의 실무자들에게 직접적 참고 자료가 됩니다.
핵심 요약
프란시스의 1950년대 기법을 따라 3D 위상곡면을 손으로 그은 듯한 해칭과 음영으로 렌더링하는 대화형 뷰어입니다. 마칭 사면체로 삼각분할된 암시 곡면을 기울기 벡터로부터 법선을 계산하며, 스트로크는 픽셀이 아닌 곡선으로 그려집니다. 윤곽선은 주곡률 방향의 유선을 따라 다단계 밀도로 교차 해칭되며, 톤 수준으로 어느 족(家)을 칠할지 제어합니다. 전체 요약 6문장 읽기 → 051 11:10 ▲ 143 · 댓글 53 vLLM이 AMD GPU에서 추측 디코딩 지원 vLLM이 추측 디코딩(speculative decoding) 기능을 AMD Instinct MI300X·MI355X GPU와 ROCm에서 구현했다. AI · 머신러닝 · Speculative Decoding in vLLM on AMD GPUs
Key Point LLM 추론 성능 최적화를 위한 주요 기법이 AMD GPU에서 실제 구현되어, 장기 생성 작업의 처리량 개선 가능성을 보여준다.
핵심 요약
vLLM이 추측 디코딩(speculative decoding) 기능을 AMD Instinct MI300X·MI355X GPU와 ROCm에서 구현했다. 추측 디코딩은 경량 드래프트 모듈이 여러 토큰을 먼저 제안하고 타겟 모델이 한 번에 검증하는 방식으로, 기존 자동회귀 디코딩보다 모델 통과 횟수를 줄인다. 표준 방식은 토큰 하나당 모델 실행 1회가 필요하지만, 추측 디코딩은 여러 드래프트 토큰이 검증을 통과하면 단일 모델 실행으로 여러 토큰을 커밋할 수 있다. 전체 요약 5문장 읽기 → 052 08:12 당일 +638 Andrej Karpathy 지적을 담은 Claude 코딩 가이드 공개 Andrej Karpathy의 LLM 코딩 문제점 관찰을 바탕으로 한 단일 CLAUDE.md 파일을 만들어 공개했다. AI · 머신러닝 · multica-ai/andrej-karpathy-skills
Key Point LLM 코딩 어시스턴트를 쓸 때 받는 불필요한 과다 설계와 의도하지 않은 변경을 줄이는 실질적 원칙을 제공하므로, 코딩 생산성을 높이려는 개발자라면 즉시 적용해볼 가치가 있다.
핵심 요약
Andrej Karpathy의 LLM 코딩 문제점 관찰을 바탕으로 한 단일 CLAUDE.md 파일을 만들어 공개했다. Karpathy는 LLM이 검증 없이 잘못된 가정을 따르고, 불필요하게 복잡하게 코딩하며, 이해하지 못한 코드를 부수 효과로 변경하는 문제를 지적했다. 해결책으로 4가지 원칙을 제시한다: 코딩 전 사고(가정 명시, 다중 해석 제시), 단순성 우선(요청 범위 내만 구현), 수술적 변경(요청 관련 부분만 수정), 목표 중심 실행(검증 가능한 성공 기준 정의). 전체 요약 5문장 읽기 →