쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
100건 (최대치) · "영상"조건 지우기 ×
001 00:11 당일 +111 코드로 벡터 애니메이션을 만드는 Motion Canvas Motion Canvas는 TypeScript 라이브러리와 에디터로 이루어진 애니메이션 제작 도구다. 웹 · 프론트엔드 · motion-canvas/motion-canvas · TypeScript
Key Point 코드 기반 애니메이션 도구로 수프트웨어 튜토리얼, 데이터 시각화, 기술 설명 영상 제작 시 생산성을 크게 높일 수 있다.
핵심 요약
Motion Canvas는 TypeScript 라이브러리와 에디터로 이루어진 애니메이션 제작 도구다. 제너레이터를 활용해 코드로 애니메이션을 프로그래밍할 수 있으며, 실시간 미리보기 에디터를 제공한다. 정보 전달 목적의 벡터 애니메이션과 음성 오버를 동기화하는 데 특화되어 있다. 전체 요약 9문장 읽기 → 002 00:11 당일 +247 Google Stitch와 호환되는 AI 에이전트 스킬 라이브러리 공개 구글이 Stitch Design Skills 라이브러리를 공개했으며, 이는 Agent Skills 오픈 스탠다드를 따르는 AI 에이전트용 스킬 모음이다. AI · 머신러닝 · google-labs-code/stitch-skills · TypeScript
Key Point 디자인 자동화와 코드 생성을 통합하는 에이전트 스킬 생태계가 열렸으므로, AI 기반 개발 도구의 워크플로우가 어떻게 확장되고 있는지 보여주는 중요한 사례다.
핵심 요약
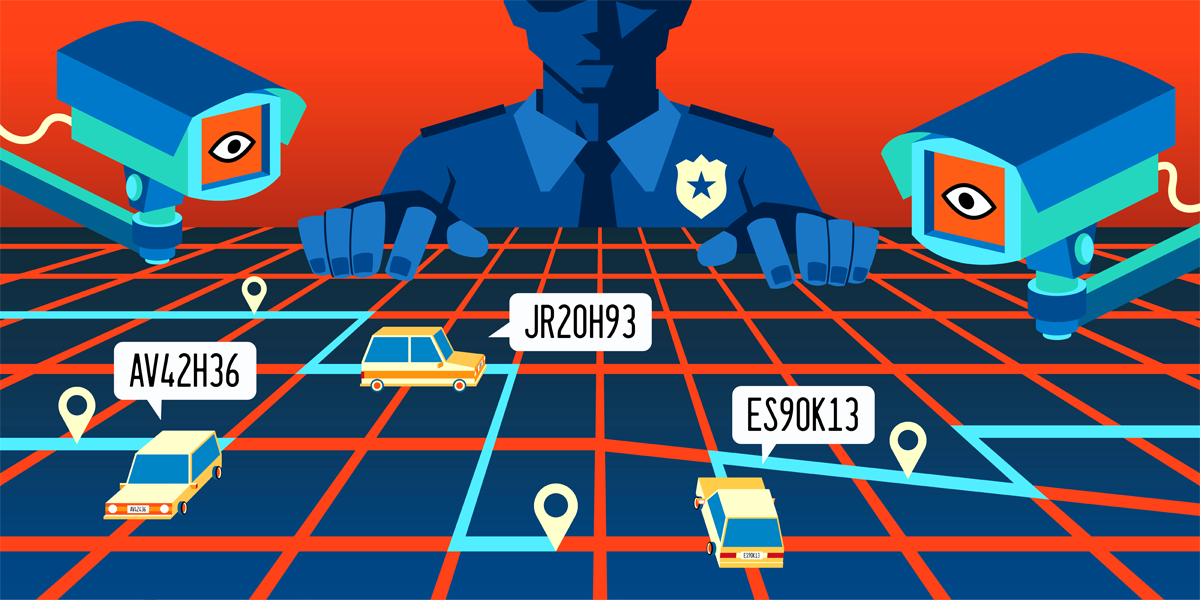
구글이 Stitch Design Skills 라이브러리를 공개했으며, 이는 Agent Skills 오픈 스탠다드를 따르는 AI 에이전트용 스킬 모음이다. Codex, Claude Code, Cursor, Gemini CLI, OpenCode 등 다양한 코딩 에이전트와 호환되며, Stitch MCP 서버와 함께 작동한다. 설계 스킬(stitch-design)은 코드를 디자인으로 변환, 스크린 생성 및 편집, 디자인 시스템 관리, HTML 추출 등 6개 기능을 제공한다. 전체 요약 8문장 읽기 → 003 15:11 ▲ 164 · 댓글 38 경찰의 자동 번호판 인식 추적에 영장 의무화 청구 EFF와 ACLU가 미국 6순회항소법원에 영장 없이 자동 번호판 인식(ALPR) 데이터로 용의자 추적을 한 사건 Sturdivant에 제출한 법정 의견서는, 전국 도로에 설치된 광범위한 ALPR 네트워크가 운전자를 지속적으로 추적하고 있다고 설명한다. 보안 · We're Asking an Appeals Court to Require a Warrant for ALPR Searches
Key Point 경찰이 개인의 동의나 영장 없이 자동 번호판 인식으로 운전자를 추적할 수 있는 권한을 놓고, 미국 법원이 프라이버시 보호 수준을 결정할 분기점이 되는 소송입니다.
핵심 요약
EFF와 ACLU가 미국 6순회항소법원에 영장 없이 자동 번호판 인식(ALPR) 데이터로 용의자 추적을 한 사건 Sturdivant에 제출한 법정 의견서는, 전국 도로에 설치된 광범위한 ALPR 네트워크가 운전자를 지속적으로 추적하고 있다고 설명한다. 사건은 오하이오주 클리블랜드 지역 강도 사건으로 시작되었으며, 경찰은 감시 카메라 영상에서 용의자 차량의 제조사·모델·색상은 파악했지만 번호판은 몰라 Flock과 ELSAG 두 ALPR 데이터베이스를 무작정 검색했다. 검색 결과 피고인의 차량이 강도 사건 현장 근처에서 추적되었고 이 증거가 결국 체포로 이어졌다. 전체 요약 7문장 읽기 → 004 06:11 ▲ 105 · 댓글 41 OpenAI 로봇팀 해체, 범용 AI로의 전환 선언 OpenAI가 독립적인 로봇팀을 해체하고 연구원들을 다른 팀으로 재배치했다. 로봇 연구팀은 최고연구책임자 Mark Chen 산하 메인 연구팀으로, 응용로봇팀과 하드웨어팀은 President Greg Brockman 산하 Applied 조직으로 이동했다. AI · 머신러닝 · OpenAI disbands its robotics team as its general models start running robots
Key Point 범용 AI 모델이 로봇 제어 영역까지 침투하면서 로봇공학의 기술 스택과 경쟁 구도 자체가 재편될 수 있기 때문이다.
핵심 요약
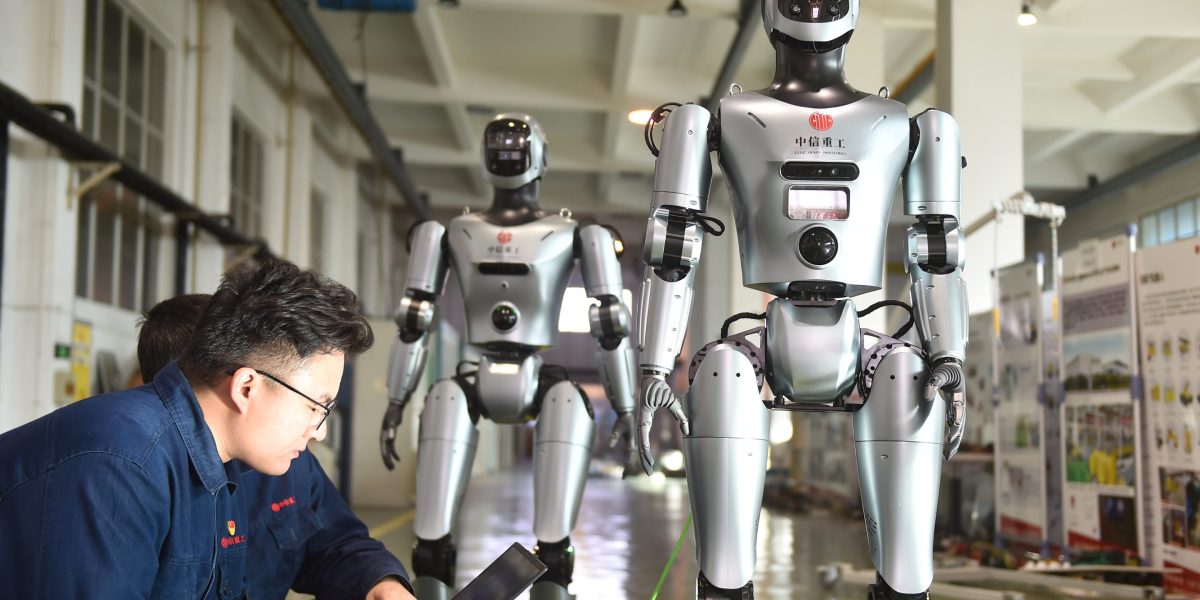
OpenAI가 독립적인 로봇팀을 해체하고 연구원들을 다른 팀으로 재배치했다. 로봇 연구팀은 최고연구책임자 Mark Chen 산하 메인 연구팀으로, 응용로봇팀과 하드웨어팀은 President Greg Brockman 산하 Applied 조직으로 이동했다. OpenAI는 이를 로봇공학에 대한 헌신의 증거로 표현했으며, 로봇공학이 회사의 장기 비전의 핵심이라고 밝혔다. 2024년 창업사 Figure와 협력해 휴머노이드 로봇 AI 개발을 추진했으나 2025년 2월 Figure가 자체 개발로 전환하면서 협력이 종료됐다. AI 산업 전반에서 언어, 코드, 비전 분야의 범용 모델을 로봇 같은 물리적 장치를 제어하는 '구체화된 AI(embodied AI)'에 직접 적용할 수 있다는 가정이 확산 중이다. 이는 로봇 전용 특화 모델을 따로 개발할 필요가 없다는 의미다. 전체 요약 7문장 읽기 → 005 21:11 당일 +331 AI 코딩 에이전트를 위한 로컬 영상 편집기 FFmpeg-Skill 공개 Claude Code, Cursor, Codex와 같은 코딩 에이전트가 사용할 수 있는 로컬 영상 편집 도구 FFmpeg-Skill이 공개되었다. AI · 머신러닝 · kajisho5/ffmpeg-skill · Python
Key Point 클라우드나 API 키 없이 로컬에서 실행되며 에이전트가 정확하게 영상 편집을 수행할 수 있도록 설계된 도구라, AI 코딩 에이전트의 멀티모달 기능 확대와 오프라인 작업 흐름에 영향을 미친다.
핵심 요약
Claude Code, Cursor, Codex와 같은 코딩 에이전트가 사용할 수 있는 로컬 영상 편집 도구 FFmpeg-Skill이 공개되었다. 42개의 FFmpeg 도구를 제공하며, 클라우드나 API 키 없이 Python 표준 라이브러리만으로 동작한다. 각 도구는 명확한 입력 스키마를 가진 argparse 기반 스크립트로, 쉘 명령어 대신 타입이 지정된 인자로 작동한다. 전체 요약 13문장 읽기 → 006 21:11 당일 +736 PS5·캡처 카드를 120fps로 고주파 재생하는 Veyra 2.1.5 공개 Windows용 GPU 기반 실시간 영상 개선 도구 Veyra 2.1.5를 공개했다. 초해상화·노이즈 제거·HDR·프레임 생성 기술을 조합해 PS5·Xbox·PC·캡처 카드 영상을 실시간으로 고화질화할 수 있다. AI · 머신러닝 · Likely7/Veyra-NRVideo · C++
Key Point DLSS 5와 AI 초해상화로 기존 영상을 고주파 고화질로 업스케일링하는 기술이 실시간 게임·방송 녹화에 어떻게 적용되는지 보여주는 실제 구현체다.
핵심 요약
Windows용 GPU 기반 실시간 영상 개선 도구 Veyra 2.1.5를 공개했다. 초해상화·노이즈 제거·HDR·프레임 생성 기술을 조합해 PS5·Xbox·PC·캡처 카드 영상을 실시간으로 고화질화할 수 있다. 2.1.2 버전 주요 업데이트는 RTX Video SR 듀얼 초해상화, SR 후 다운샘플링, NVIDIA Low Latency 지원, RX 7000 노이즈 제거 실험 기능을 추가했다. 2.1.1은 처리된 영상 녹화·오디오 포함, 90도 회전 재생, 레이어별 노이즈 제거 강도 조절, 내보내기 크기 조절 기능을 지원한다. 전체 요약 10문장 읽기 → 007 18:11 ▲ 16 · 댓글 4 코드가 세상을 짜면, 영상 모델은 렌더링만 하는 게 될까? 멀티모달 코딩 에이전트에서 4D 세계 구성과 시각 생성을 분리하는 새로운 접근을 제시한다. 코드가 3D/4D 월드를 구성하면 영상 모델이 그것을 렌더링하는 구조에서 영상 모델의 역할을 조사한다. AI · 머신러닝 · WorldDraft: If Code Builds the World, Can Video Models Just Render It?
Key Point 코드 기반 3D 월드와 AI 영상 생성의 분업 구조에서 영상 모델의 한계와 개선 방법을 체계적으로 실측했기 때문에, 멀티모달 AI 시스템 설계자들이 알아야 할 핵심 발견이다.
핵심 요약
멀티모달 코딩 에이전트에서 4D 세계 구성과 시각 생성을 분리하는 새로운 접근을 제시한다. 코드가 3D/4D 월드를 구성하면 영상 모델이 그것을 렌더링하는 구조에서 영상 모델의 역할을 조사한다. 신뢰할 수 있는 생성 렌더러에 필요한 두 가지 기준을 정의한다: (i) 월드 보존 - 지정된 4D 운동과 카메라 경로 유지, (ii) 시각 실현 - 텍스트로 지정된 속성을 시간에 따라 일관되게 유지. WorldDraft 벤치마크를 제안하는데, 6개 동적 카테고리에 걸친 48개 실행 가능한 4D 월드 패밀리에서 432개의 엄격하게 쌍을 이룬 테스트 케이스로 구성된다. 전체 요약 9문장 읽기 → 008 18:11 ▲ 46 · 댓글 4 동영상 생성 AI, LLM의 물리 지식으로 스스로 학습한다 동영상 생성 모델들은 시각적으로는 현실적이지만 물리 법칙과 인과관계를 제대로 따르지 못한다. AI · 머신러닝 · PhysLoop: Harnessing LLMs' Physics Awareness for Self-Improving Video Generation Models
Key Point LLM의 물리 지식을 동영상 생성에 직접 녹여내는 방식으로, 인간 감독을 줄이면서 생성 AI가 스스로 개선되는 새로운 경로를 제시한다.
핵심 요약
동영상 생성 모델들은 시각적으로는 현실적이지만 물리 법칙과 인과관계를 제대로 따르지 못한다. 생성된 영상으로부터 학습하려면 정교한 물리 감독이 필요한데, 신뢰할 만한 품질 판단과 수정 쌍을 확보하기 어렵다. PhysLoop은 LLM이 지닌 물리 지식을 활용해 동영상 생성 모델이 스스로 개선되도록 돕는 통합 프레임워크다. 전체 요약 8문장 읽기 → 009 18:11 ▲ 30 · 댓글 4 로봇 학습 위한 대규모 환경·행동 데이터셋 'Ropedia Xperience 2' 공개 GPT-6 Astra, Claude Fable 5.1 같은 대규모 기초 모델이 시각 정보로 로봇을 직접 제어할 수 있게 됐지만, 현실의 장시간·접촉이 많은 작업에서는 여전히 취약하다. AI · 머신러닝 · Ropedia Xperience 2: A Gold Standard for Scaling Physical AI Environments and Behaviors
Key Point 대규모 언어 모델의 스케일링 법칙처럼, 로봇 AI가 어떤 데이터 규모에서 성능이 향상되는지를 연구하기 위한 첫 번째 표준 데이터셋이 제시됐다.
핵심 요약
GPT-6 Astra, Claude Fable 5.1 같은 대규모 기초 모델이 시각 정보로 로봇을 직접 제어할 수 있게 됐지만, 현실의 장시간·접촉이 많은 작업에서는 여전히 취약하다. 로봇 AI의 능력이 환경과 행동 데이터 규모에 어떻게 비례하는지 규명하려면, 어떤 데이터를 모을지, 어떻게 지속적으로 생산·재활용할지 먼저 정해야 한다. Ropedia Xperience 2는 1,589개의 미터급 3D 스캔과 74개 작업의 1인칭 영상 4,230개(총 131시간)를 담은 데이터셋이다. 전체 요약 5문장 읽기 → 010 18:11 ▲ 24 · 댓글 3 3D 기하 재구성 없이 23배 빠른 신규 시점 렌더링 디코더 기반 대규모 뷰 합성 모델(LVSM)들은 KV 캐시를 활용해 3D 기하를 재구성하지 않고 신경망에서 직접 새로운 시점을 생성하는 방식으로 최고 수준의 품질을 달성했으나, 테스트 타임 트레이닝(TTT) 계층은 연산량을 줄이는 대신 품질을 희생하는 문제가 있었다. AI · 머신러닝 · TTB: Test-time Baking for Efficient Rendering of Decoder-only View Synthesis Models
Key Point 3D 재구성 없이도 신규 시점을 실시간으로 생성할 수 있는 방식의 등장으로, VR·게임·영상 제작 등 뷰 합성이 필요한 분야의 효율성 문제를 근본적으로 바꿀 수 있다.
핵심 요약
디코더 기반 대규모 뷰 합성 모델(LVSM)들은 KV 캐시를 활용해 3D 기하를 재구성하지 않고 신경망에서 직접 새로운 시점을 생성하는 방식으로 최고 수준의 품질을 달성했으나, 테스트 타임 트레이닝(TTT) 계층은 연산량을 줄이는 대신 품질을 희생하는 문제가 있었다. 새로운 방법인 TTB(Test-Time Baking)는 교차 뷰 어텐션에서 전역 장면 정보를 경량 MLP에 학습하여 빠르고 고품질의 신규 시점 디코딩을 가능하게 한다. 첫 번째 핵심은 TTT의 빠른 가중치 MLP를 입출력 쌍에서 교차 뷰 어텐션 매핑을 명시적으로 학습하도록 재목적화하여, TTT와 동일한 렌더링 효율을 유지하면서 현저히 높은 품질을 제공한다. 전체 요약 5문장 읽기 → 011 15:11 ▲ 51 · 댓글 3 운전 시뮬레이션의 정확성을 높이는 BirdDreams 논문 자율주행 시뮬레이션을 위한 세계 모델은 주행자 행동에 따른 장면 변화를 예측해야 하는데, 정적 레이아웃에만 의존하는 기존 방식의 한계가 있다. AI · 머신러닝 · BirdDreams: Joint Perspective and BEV Video Generation for a Plausible, Reactive Driving World Model
Key Point 자율주행 시뮬레이션에서 현실적인 장면 재구성은 필수이며, 정적 레이아웃 대신 미래 배치를 예측하는 이 접근법은 자동차의 정확한 제어와 주변 객체의 자연스러운 운동 생성을 동시에 달성하는 새로운 방식이다.
핵심 요약
자율주행 시뮬레이션을 위한 세계 모델은 주행자 행동에 따른 장면 변화를 예측해야 하는데, 정적 레이아웃에만 의존하는 기존 방식의 한계가 있다. BirdDreams는 1인칭 시점 영상과 조감도(BEV) 영상을 함께 생성하는 자동회귀 모델로, 미래 장면의 레이아웃을 예측의 일부로 만든다. BEV는 도로와 차량을 간단한 형태로 일정 스케일로 표시해 위에서 본 위치와 동작을 명확히 보여주고, 정적 시점은 신호등과 물체 외형 같은 세부 정보를 담는다. 전체 요약 8문장 읽기 → 012 15:11 ▲ 43 · 댓글 3 대화하며 실시간 응답하는 AI 모델 Duo 공개 Hugging Face가 Reciprocal World Model(RWM) 기반의 Duo v1을 발표했으며, 이는 오디오·비디오를 지속적으로 인식하면서 실시간으로 사용자에게 응답하는 풀 듀플렉스 월드 모델이다. AI · 머신러닝 · Duo: A Reciprocal World Model for Full-Duplex Interaction
Key Point 실시간 양방향 상호작용이 가능한 월드 모델은 기존의 단편적 명령 처리를 벗어나 대화 중단, 맥락 변경, 멀티모달 입력을 동시에 처리하는 새로운 AI 상호작용 패러다임을 보여준다.
핵심 요약
Hugging Face가 Reciprocal World Model(RWM) 기반의 Duo v1을 발표했으며, 이는 오디오·비디오를 지속적으로 인식하면서 실시간으로 사용자에게 응답하는 풀 듀플렉스 월드 모델이다. 기존 월드 모델은 물리적 현실 시뮬레이션에만 집중해 추론과 의사결정을 외부 제어로 남겨두지만, RWM은 지능과 물리적 현실을 동등하게 기본으로 취급하며 Intent(상호작용의 인식)와 Realization(음성·영상 행동 생성)이 세계의 일부가 된다. Duo v1의 핵심 기술은 (1) 자회귀 모델링으로 지속적 상호작용 추론과 참여 결정을 수행하고, (2) 청크별 조건과 동기화 토큰으로 Intent와 Realization을 타임라인에 정렬하며 인과 관계를 유지하고, (3) 이중 롤아웃 증류(dual rollout distillation)로 두 모듈의 분포 편향을 완화한다. 전체 요약 5문장 읽기 → 013 15:11 ▲ 171 · 댓글 40 개인 컴퓨터에서 돌리는 1450억 파라미터 모델 Edge0-145B 공개 Edge0가 145B 파라미터의 Edge0-145B와 120B 모델을 오픈소스로 공개했으며, 통합 추론 프레임워크와 배포 도구도 함께 제공한다. AI · 머신러닝 · Edge0-145B: Frontier AI Capabilities on Your Own Computer
Key Point 개인 컴퓨터에서 클라우드 모델 수준의 복잡한 작업(코딩, 3D 모델링, 비디오 제작)을 요금 없이 수행 가능해지면서, 온디바이스 AI의 실용성이 크게 높아졌다.
핵심 요약
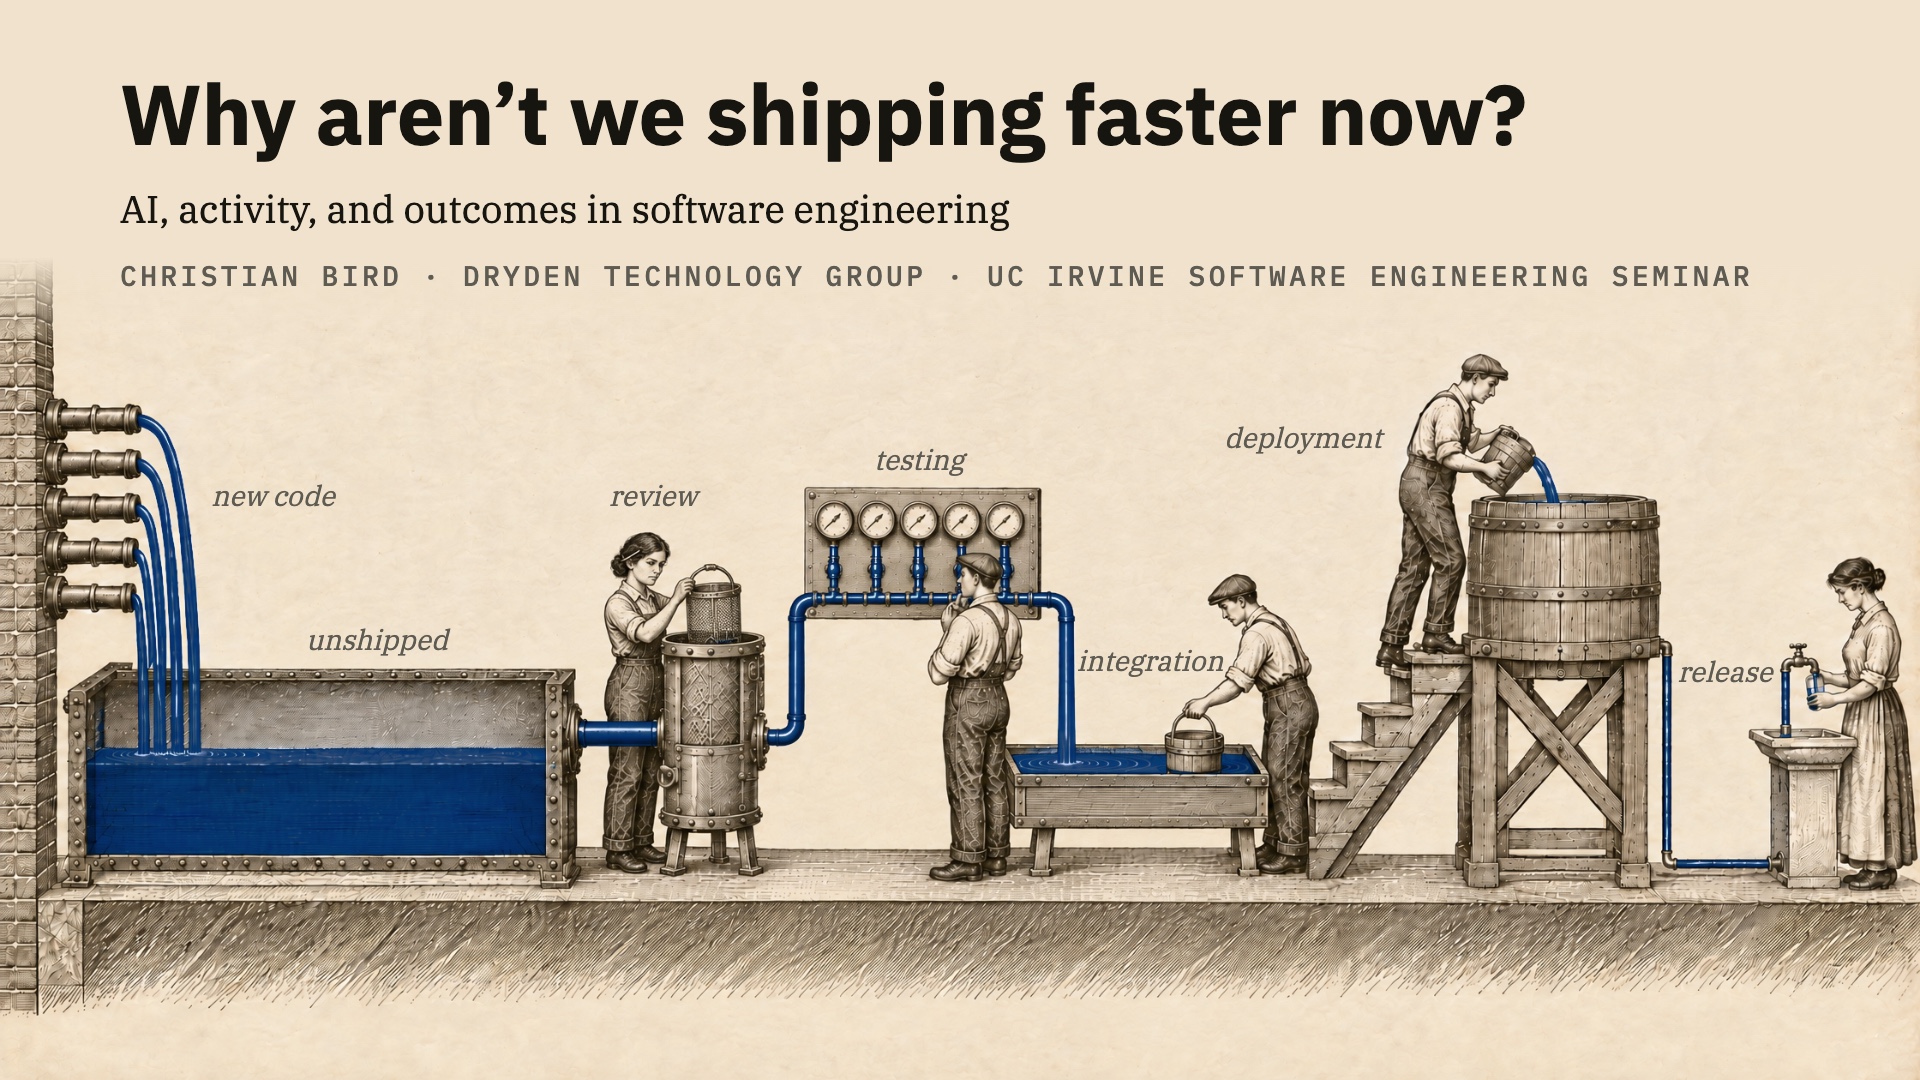
Edge0가 145B 파라미터의 Edge0-145B와 120B 모델을 오픈소스로 공개했으며, 통합 추론 프레임워크와 배포 도구도 함께 제공한다. 호환 가능한 노트북에서 피크 메모리 29GB, 토큰 생성 속도 80+tokens/s로 동작하며 기존 대규모 모델 대비 약 40% 메모리로 동등한 성능을 낸다. Edge0-145B는 DeepSWE 1.1에서 64.6점(Qwen3.8-Flash-Next 58.7, DeepSeek-V4-Flash 54.4), Terminal-Bench 2.1에서 86.52점(Qwen 83.3, DeepSeek 82.7)으로 코딩·추론·명령 이행 능력이 클라우드 모델 수준이다. 전체 요약 11문장 읽기 → 014 09:11 ▲ 103 · 댓글 99 AI 시대에 소프트웨어 개발 속도가 빨라지지 않는 이유 UC 어바인 소프트웨어공학 세미나에서 드라이든 테크놀로지 그룹의 크리스천 버드가 발표한 21분 분량의 강연으로, AI와 소프트웨어 엔지니어링의 관계를 다룬다. AI · 머신러닝 · AI, activity, and outcomes in software engineering
Key Point AI 코딩 도구의 급증에도 실제 배포 속도가 개선되지 않는 이유를 학술 근거와 함께 설명하는 연구로, 개발 생산성에 대한 통념을 점검하는 데 중요하다.
핵심 요약
UC 어바인 소프트웨어공학 세미나에서 드라이든 테크놀로지 그룹의 크리스천 버드가 발표한 21분 분량의 강연으로, AI와 소프트웨어 엔지니어링의 관계를 다룬다. 강연은 슬라이드, 핸드아웃(19페이지), 풀 덱(41페이지), 유튜브 영상과 함께 제공된다. 관련 연구 논문으로 '활동-결과 격차: 왜 AI가 소프트웨어 엔지니어링을 해결하지 못하는가'(제출 중)가 있으며, 30명의 인터뷰 내용이 포함되어 있다. 전체 요약 5문장 읽기 → 015 15:11 ▲ 88 · 댓글 2 스트리밍 영상 생성의 빠른 처리, 조건 시프팅으로 구현 스트리밍 비디오 생성을 몇 단계만에 처리하는 APEX 방법 제안 AI · 머신러닝 · Few-Step Streaming Video Generation via Condition Shifting
Key Point 빠르고 효율적인 스트리밍 영상 생성이 실시간 애플리케이션의 핵심인데, 조건 시프팅이라는 새로운 방식으로 계산 비용을 줄이면서도 생성 품질을 높이는 길을 보여줍니다.
핵심 요약
스트리밍 비디오 생성을 몇 단계만에 처리하는 APEX 방법 제안 기존 DMD는 별도 가짜 판별망으로 메모리와 연산 비용이 크고 생성기 추적이 필요함 조건 시프팅 기법으로 생성 분포의 속도장을 생성기 내부에서 직접 추정해 독립 판별망 제거 전체 요약 9문장 읽기 → 016 15:11 ▲ 12 · 댓글 3 동영상 그래픽 생성 평가 벤치마크 공개 대규모 언어 모델의 모션 그래픽 생성 능력을 평가하기 위해 정적 SVG 이미지에 애니메이션을 적용하는 100개 인스턴스 벤치마크 MotionGraphicsBench를 개발했다. AI · 머신러닝 · MotionGraphicsBench: Evaluating Motion Graphics Generation with Programmatic Verification
Key Point LLM이 복잡한 시공간 요구사항을 포함한 애니메이션 생성을 얼마나 정확히 수행하는지 측정하는 객관적 평가 방법이 제시되어, 모션 그래픽 생성 모델 개발에 표준을 제공한다.
핵심 요약
대규모 언어 모델의 모션 그래픽 생성 능력을 평가하기 위해 정적 SVG 이미지에 애니메이션을 적용하는 100개 인스턴스 벤치마크 MotionGraphicsBench를 개발했다. 각 벤치마크 인스턴스는 모델 입력, 모션 편집 프롬프트, 결정론적 검증 프로그램으로 구성되며, 이는 기준 애니메이션 비교나 VLM 판정 대신 요구 사항 만족 여부를 보고한다. 벤치마크는 실제 Lottie 모션 디자인에서 파생되어 다양한 시공간적 애니메이션 동작을 포함하며, 인간 라벨이 있는 애니메이션과 합성 테스트 케이스를 활용한 다중 에이전트 파이프라인으로 구축했다. 전체 요약 7문장 읽기 → 017 15:11 ▲ 100 · 댓글 81 저장소 위기 시대, AVIF 확산이 답인가 2026년 HDD, SSD, NVMe 가격이 치솟고 공급 부족이 심화하면서, 호스팅 서비스들이 가격 인상을 단행하고 있다. 웹 · 프론트엔드 · Time for AVIF everywhere?
Key Point 2026년 저장소 가격 폭등과 공급 부족이 심화하는 가운데, AVIF 같은 효율적 이미지 포맷의 광범위한 채택이 호스팅 비용과 대역폭을 실질적으로 줄일 수 있는 방법이라는 주장이 제시되고 있다.
핵심 요약
2026년 HDD, SSD, NVMe 가격이 치솟고 공급 부족이 심화하면서, 호스팅 서비스들이 가격 인상을 단행하고 있다. 저자는 Mastodon, Bluesky 등 서비스와 호스팅 제공자가 AVIF, WebP 같은 효율적인 이미지 포맷과 AV1, AV2 같은 비디오 포맷을 더 널리 지원해야 한다고 주장한다. AVIF는 WebP보다 우수한 압축률을 제공하면서도 이미지 품질을 유지하므로, 인터넷에서 매일 업로드되는 수십억 장의 이미지를 고려하면 저장 공간 절감이 상당할 수 있다. 전체 요약 14문장 읽기 → 018 03:11 ▲ 231 · 댓글 32 Blender 5.3, 가우시안 스플래팅 네이티브 지원 추가 Blender 5.3이 3D 가우시안 스플래팅(Gaussian Splats) 네이티브 지원을 추가했다. AI · 머신러닝 · Blender 5.3 released with Gaussian Splat support
Key Point 사진·영상에서 3D 장면을 재구성하는 가우시안 스플래팅이 3D 제작 파이프라인에 표준으로 통합되면서 Blender 사용자들이 AI 생성 모델이나 포토그래메트리 결과물을 직접 작업할 수 있게 된다.
핵심 요약
Blender 5.3이 3D 가우시안 스플래팅(Gaussian Splats) 네이티브 지원을 추가했다. PLY, SPZ, glTF 파일에서 가우시안 스플래팅을 포인트 클라우드로 임포트한 후 Geometry Nodes로 처리하고, EEVEE, Cycles, Workbench에서 렌더링할 수 있다. 스플래팅은 scale, rotation, radiance 등의 특수 속성으로 저장되며, 기본적으로 이미시브 셰이더로 렌더링되지만 Diffuse BSDF로 교체해 릿팅 처리도 가능하다. 전체 요약 12문장 읽기 → 019 21:11 당일 +126 500개 이상 AI 에이전트 프로젝트 모음, 실제 구현 코드와 함께 AI 에이전트의 실무 활용 사례와 오픈소스 구현을 모은 종합 자료집으로, 헬스케어, 금융, 교육, 소매, 물류 등 다양한 산업별 500개 이상의 프로젝트를 담고 있다. AI · 머신러닝 · ashishpatel26/500-AI-Agents-Projects · Python
Key Point AI 에이전트를 처음 구축하거나 평가할 때, 각 프레임워크별 최적 사용 시점과 500개 이상의 실제 동작하는 구현 코드를 한 곳에서 비교 검토할 수 있어 프로젝트 선택과 설계 결정이 빠르다.
핵심 요약
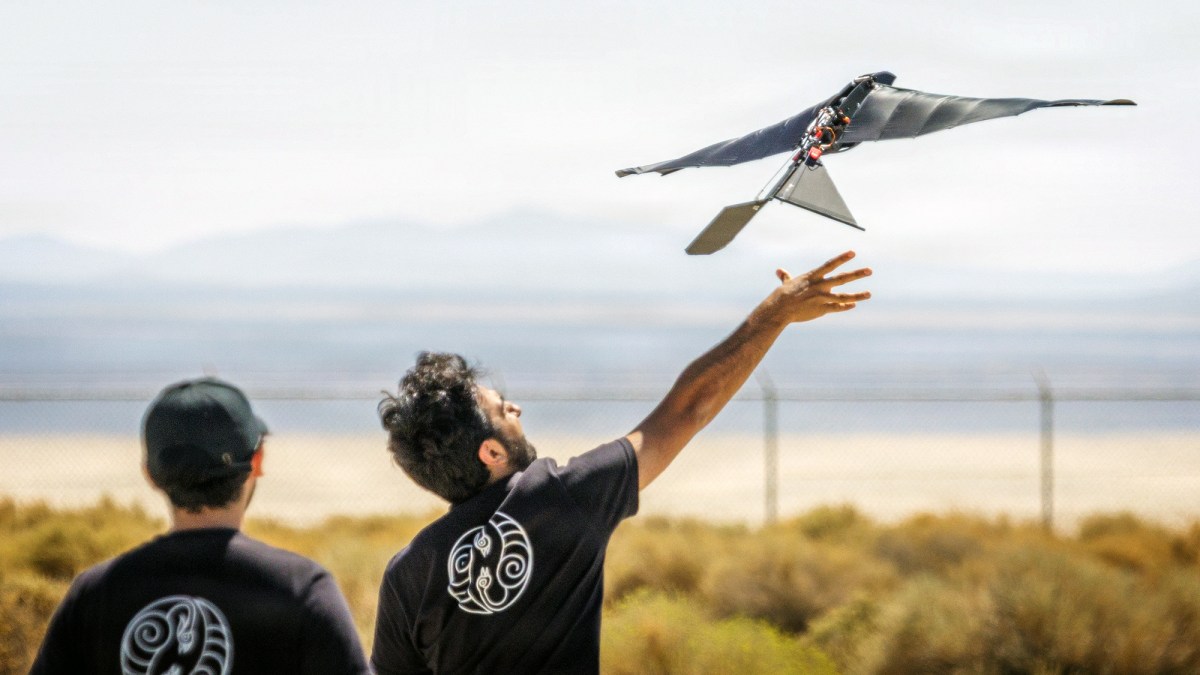
AI 에이전트의 실무 활용 사례와 오픈소스 구현을 모은 종합 자료집으로, 헬스케어, 금융, 교육, 소매, 물류 등 다양한 산업별 500개 이상의 프로젝트를 담고 있다. LangGraph, CrewAI, AutoGen, Agno, LlamaIndex 등 주요 프레임워크별로 정렬되어 있으며, 각 에이전트는 자체 requirements.txt와 .env.example을 포함해 독립적으로 5분 안에 실행 가능하다. LangGraph는 상태 관리와 RAG 파이프라인이 필요한 복잡한 워크플로우에, CrewAI는 역할 기반 팀 자동화와 빠른 프로토타이핑에, AutoGen은 코드 생성과 자가 치유 워크플로우에, Agno는 단일 에이전트와 빠른 반복에 최적화되어 있다. 전체 요약 10문장 읽기 → 020 18:12 ▲ 102 · 댓글 66 새 모양 드론, 공군 탐지 체계를 '새'로 인식 오르나다인의 O1 드론은 프로펠러 대신 날개를 펄럭이는 비행 방식으로 새처럼 움직이며, 형태도 까마귀를 모방했다. 하드웨어 · 시스템 · Drones built to look like birds evaded detection at Air Force tech exercise
Key Point 드론을 새처럼 위장해 기존 탐지 체계를 완전히 우회하는 기술이 현실화됐으며, 이는 군사 무인기 운영의 패러다임 변화를 시사한다.
핵심 요약
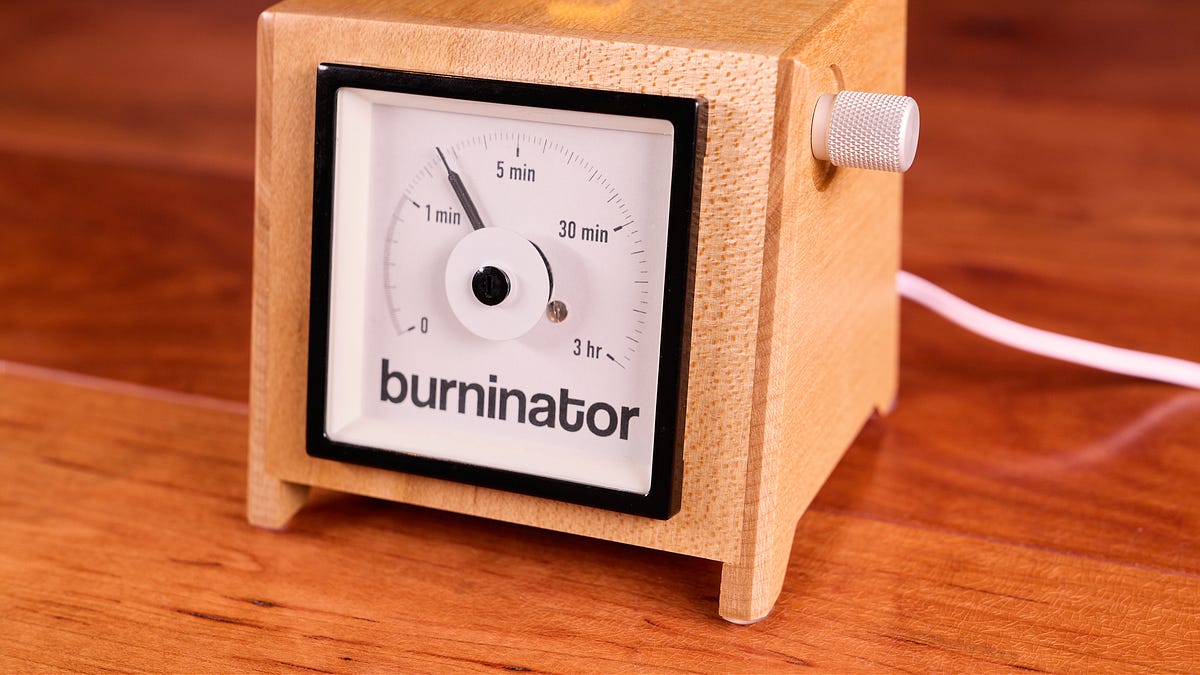
오르나다인의 O1 드론은 프로펠러 대신 날개를 펄럭이는 비행 방식으로 새처럼 움직이며, 형태도 까마귀를 모방했다. 이 무인기는 무게 1파운드이며 10km 범위에서 1시간 이상 비행할 수 있고 소형 카메라 같은 탑재물을 장착할 수 있다. 에드워즈 공군기지에서 열린 '드론의 게임' 연례행사에서 O1 드론이 다른 기업의 탐지 장비로부터 회피했다. 전체 요약 8문장 읽기 → 021 09:11 ▲ 100 · 댓글 31 직접 만든 아날로그 주방 타이머, 로그 눈금으로 설계 디지털 주방 타이머가 불편해 직접 제작한 프로젝트로, 아날로그 바늘 디스플레이와 회전식 조절 손잡이를 갖춘 타이머를 만들었다. 하드웨어 · 시스템 · Quasi-Logarithmic Kitchen Timer
Key Point 기존 주방 타이머의 불편함을 해결하는 자작 아날로그 타이머 설계를 통해, 클래식한 메커니컬 미터를 현대 디지털 제어와 조합하는 임베디드 시스템 설계 아이디어를 배울 수 있습니다.
핵심 요약
디지털 주방 타이머가 불편해 직접 제작한 프로젝트로, 아날로그 바늘 디스플레이와 회전식 조절 손잡이를 갖춘 타이머를 만들었다. 다이얼을 4개 구간으로 나누어 준로그 눈금을 구현했다: 1분까지는 10초 단위, 1~5분은 1분 단위, 5~30분은 5분 단위, 30분~3시간은 30분 단위다. 구형 크롬프턴 패널 미터를 재활용했으며, eBay에서 30달러에 구입하고 커스텀 다이얼 면을 인쇄지로 제작했다. 전체 요약 7문장 읽기 → 022 00:11 ▲ 100 · 댓글 100 애플, 엔지니어 AI 비용을 하루 200달러로 제한 애플이 일부 엔지니어의 일일 AI 지출 상한을 300달러에서 200달러로 인하했으며, 이는 AI 지출이 예산을 초과할 위험을 나타낸다. AI · 머신러닝 · Apple capped engineers at a $200 daily AI budget
Key Point 업계 최강자인 애플도 AI 지출 제한을 시작했다는 것은 생성형 AI의 실제 비용이 개발사들의 예상을 초과하고 있음을 의미하며, 모든 개발팀이 토큰 효율성을 심각하게 재검토해야 하는 상황이 됐다는 신호다.
핵심 요약
애플이 일부 엔지니어의 일일 AI 지출 상한을 300달러에서 200달러로 인하했으며, 이는 AI 지출이 예산을 초과할 위험을 나타낸다. 미시간대학교 연구팀은 영어가 아닌 언어의 프롬프트가 영어보다 최대 179배 많은 에너지를 소비한다고 발견했다. 팔로알토 네트웍스가 AI 에이전트 접근제어 기술을 갖춘 사이버보안 스타트업 클러치 인수를 추진 중이며, 인수가는 약 5억 달러다. 전체 요약 9문장 읽기 → 023 21:11 당일 +121 영상을 3D 가우시안 스플래팅으로 한 클릭 변환 비디오와 이미지 시퀀스를 3D 가우시안 스플래팅으로 변환하는 로컬 데스크톱 애플리케이션 OOOSplat 0.7.1이 공개됨. 오픈소스 · 도구 · ooolabdev/ooosplat · Rust
Key Point 영상·사진 기반 3D 모델 생성을 로컬 머신에서 완전 자동화하는 오픈소스 도구로, 클라우드 의존 없이 개인정보 보호와 온프레미스 처리를 실현해 3D 콘텐츠 제작 워크플로우 변화를 가져올 수 있음.
핵심 요약
비디오와 이미지 시퀀스를 3D 가우시안 스플래팅으로 변환하는 로컬 데스크톱 애플리케이션 OOOSplat 0.7.1이 공개됨. 입력 소재·프로젝트 폴더·품질 레벨을 선택하면 FFmpeg, COLMAP, Brush를 자동으로 실행해 최종 PLY 파일을 생성하고 바로 미리보기, 편집, 내보내기 가능. Windows 11 x64, Apple Silicon macOS 15+, Ubuntu 24.04 LTS x86_64를 지원하며, 번들된 FFmpeg·FFprobe·COLMAP·Brush를 사용해 별도 설치 불필요. 전체 요약 14문장 읽기 → 024 21:11 당일 +324 공유 링크 붙여넣고 고속 다운로드, 윈도우용 YunX 데스크톱 앱 클라우드 저장소 및 동영상 공유 링크를 붙여넣으면 내용을 열람·미리보기·다운로드할 수 있는 윈도우 데스크톱 앱 YunX-Desktop이 공개됐다. 오픈소스 · 도구 · tidain/YunX-Desktop · Kotlin
Key Point 클라우드 저장소와 동영상 플랫폼의 공유 링크를 한 앱에서 통합 관리·다운로드할 수 있으며, 공식 오픈소스로 업그레이드되면서 지속적인 개발과 신뢰성이 보장된다.
핵심 요약
클라우드 저장소 및 동영상 공유 링크를 붙여넣으면 내용을 열람·미리보기·다운로드할 수 있는 윈도우 데스크톱 앱 YunX-Desktop이 공개됐다. 쿼크, UC, 선더, 바이두, 139, 123, 115, 라나토 등 주요 중국 클라우드 저장소와 틱톡, 快手, 웨이보, 소소스, 빌리빌리, AcFun, Pixiv 동영상을 지원하며 자성, BT 종자, ed2k 등 P2P 링크도 다룬다. Range 분할 다중 병렬 + 끊김 지점에서 재개 기능으로 고속 다운로드를 제공하고, 빌리빌리 고화질은 자동으로 음성과 영상을 합성한다. 전체 요약 10문장 읽기 → 025 21:11 ▲ 21 · 댓글 3 코드로 영상 생성 제어하는 AI 에이전트 등장 Video-Coder는 코드를 자율적으로 작성·실행하여 3D 장면을 구성하는 영상 생성 에이전트로, 이 3D 장면(Draft Video)이 다운스트림 영상 생성 모델에 구조와 모션 신호를 제공한다. AI · 머신러닝 · Video-Coder: Reinforcing Agentic Coding for Video Generation
Key Point 정밀한 공간 구조와 제어 가능한 영상 생성이라는 영상 AI의 오래된 문제를 코드 기반 에이전트로 풀어내는 새로운 패러다임이기 때문이다.
핵심 요약
Video-Coder는 코드를 자율적으로 작성·실행하여 3D 장면을 구성하는 영상 생성 에이전트로, 이 3D 장면(Draft Video)이 다운스트림 영상 생성 모델에 구조와 모션 신호를 제공한다. 논문은 6천 개 샘플의 감독학습용 데이터셋(Video-Coder-SFT-6k)과 2천 개 샘플의 강화학습용 데이터셋(Video-Coder-RL-2k)을 새로 구축했다. 코드 실행·3D 렌더링·실행 피드백을 통합한 Video-Coder Harness 환경을 개발하여 에이전트 훈련과 추론에 사용한다. 전체 요약 6문장 읽기 → 026 15:12 ▲ 24 · 댓글 2 동영상 생성 AI에 인과관계 추론 능력 추가하는 'EvoWorld' 생성형 비디오 모델은 픽셀 렌더링에는 뛰어나지만 세계 상태 변화를 인과적으로 추론하는 능력이 부족해 동작이 정적이거나 인과관계가 불일치하는 결과물을 만든다. AI · 머신러닝 · EvoWorld: Towards Out-of-Sight World Evolution in Generative Video Models
Key Point 기존 비디오 생성 AI의 근본적 한계를 건드린다: 현실감 있는 이미지만 만드는 데서 벗어나 '왜'와 '그 다음'을 추론하는 세계 시뮬레이터로 나아가는 길을 제시한다.
핵심 요약
생성형 비디오 모델은 픽셀 렌더링에는 뛰어나지만 세계 상태 변화를 인과적으로 추론하는 능력이 부족해 동작이 정적이거나 인과관계가 불일치하는 결과물을 만든다. 예를 들어 야생동물이 나타났을 때 생성 모델은 그 이미지만 렌더링할 뿐, 근처 인물이 도망쳐야 할지 숨어야 할지 싸워야 할지 추론하지 못한다. 논문은 '시야 밖 인과진화(Out-of-Sight Causal Evolution)' 문제를 제안해 모델이 사건을 렌더링하고 그 결과를 추론한 뒤 시야 밖에서도 인과적으로 타당한 결과를 드러내도록 요구한다. 전체 요약 7문장 읽기 → 027 06:11 ▲ 10 · 댓글 3 영상 생성 없이 로봇 제어하는 'DreamFree' 기법 제안 세계 액션 모델(WAM)은 미래 영상 예측으로 로봇을 제어하지만, 반복적인 영상 디노이징이 비싸고 부정확한 시각 예측이 행동 예측을 해칠 수 있다. AI · 머신러닝 · Future Representation Distillation for Imagination-free World Action Models
Key Point 시각 예측 과정을 제거하면서도 더 나은 제어 성능을 달성하는 방식이 로봇 제어의 효율성과 확장성을 크게 높일 수 있다.
핵심 요약
세계 액션 모델(WAM)은 미래 영상 예측으로 로봇을 제어하지만, 반복적인 영상 디노이징이 비싸고 부정확한 시각 예측이 행동 예측을 해칠 수 있다. DreamFree는 사전학습된 영상 확산 모델을 표현 증류를 통해 예측용 시각 인코더로 재목적화하여 미래 영상 생성 없이 행동을 예측한다. 시각 인코더는 현재 관찰만으로 동결된 영상 확산 모델의 표현을 예측하도록 학습하고, 행동 모듈이 인코더에서 추출한 행동 관련 정보로 행동을 예측한다. 전체 요약 5문장 읽기 → 028 03:11 ▲ 101 · 댓글 43 유튜브 TV에서 자동으로 스폰서 광고 건너뛰는 오픈소스 도구 SponsorBlock API를 활용해 Apple TV, 삼성TV, LG TV, Android TV, Chromecast, Google TV, Roku, Fire TV, 닌텐도 스위치, Xbox, PlayStation 등 다양한 TV 기기에서 유튜브 영상의 스폰서 구간과 인트로를 자동으로 건너뛰는 자체 호스팅 애플리케이션인 iSponsorBlockTV를 공개했다. 오픈소스 · 도구 · ISponsorBlockTV: SponsorBlock client for all YouTube TV clients
Key Point TV에서 유튜브를 볼 때 성가신 광고와 스폰서 구간을 자동으로 제거할 수 있는 방법으로, 기존에 PC나 모바일에서만 가능했던 SponsorBlock을 TV 플랫폼 전반에 확대하는 첫 구현이다.
핵심 요약
SponsorBlock API를 활용해 Apple TV, 삼성TV, LG TV, Android TV, Chromecast, Google TV, Roku, Fire TV, 닌텐도 스위치, Xbox, PlayStation 등 다양한 TV 기기에서 유튜브 영상의 스폰서 구간과 인트로를 자동으로 건너뛰는 자체 호스팅 애플리케이션인 iSponsorBlockTV를 공개했다. 유튜브 광고에서 '광고 건너뛰기' 버튼이 나타나는 순간 자동으로 클릭하고 음소거하는 기능도 지원한다. TV 기기가 같은 네트워크에 있을 때는 자동 탐색으로 연결되며, 같은 네트워크가 아니면 유튜브 TV 애플리케이션 설정 페이지에서 코드를 입력해 수동으로 추가할 수 있다. 전체 요약 5문장 읽기 → 029 18:15 스타 1,140 AI가 코드로 영상 만든다…cinecode 오픈소스 공개 AI 코딩 에이전트가 영상 제작의 전 과정을 자동화하는 오픈소스 'cinecode'를 깃허브에서 공개했다. AI · 머신러닝 · sarpstar/cinecode · Python
Key Point 코드 기반 영상 자동 제작으로 광고·설명영상·다큐 같은 콘텐츠를 개발자가 직접 만들 수 있게 되며, 이는 영상 제작 진입장벽을 낮추고 반복 제작 업무를 대폭 줄인다.
핵심 요약
AI 코딩 에이전트가 영상 제작의 전 과정을 자동화하는 오픈소스 'cinecode'를 깃허브에서 공개했다. 사용자가 한 문장으로 아이디어를 입력하면 AI가 각본을 작성하고, 모든 프레임을 코드로 렌더링하고, 음향 디자인을 거쳐 MP4 파일을 제공한다. 짧은 영상·장편 다큐·광고·뮤직비디오 등 다양한 포맷을 지원하며, 빠른 모드(약 3분에 완성)와 필름 모드(단계적 검수)로 나뉜다. 전체 요약 9문장 읽기 → 030 18:15 스타 1,469 Pika H3 Flex: 영상·음성 생성 AI 로컬 추론 오픈소스화 Pika H3 Flex는 MiniMax-H3을 기반으로 한 포스트트레이닝 모델로, 전문 콘텐츠 제작자를 위해 텍스트와 멀티모달 참조 입력으로 동기화된 영상과 음성을 생성한다. AI · 머신러닝 · Pika-Labs/Pika-H3-Flex · Python
Key Point 전문 크리에이터가 로컬 PC에서 고제어 텍스트·참조 기반 영상 생성을 무료로 시작할 수 있으며, 프롬프트나 프레임으로 카메라 움직임까지 직접 조종할 수 있는 열린 플랫폼이 나왔다.
핵심 요약
Pika H3 Flex는 MiniMax-H3을 기반으로 한 포스트트레이닝 모델로, 전문 콘텐츠 제작자를 위해 텍스트와 멀티모달 참조 입력으로 동기화된 영상과 음성을 생성한다. 6단계 샘플링으로 480p·768p 네이티브 해상도(11개 종횡비 지원)에서 5~15초 영상을 생성하며, 24fps 스테레오 음성이 MP4에 혼합된다. FL2VA 어댑터는 텍스트 또는 첫프레임/마지막프레임 조건 입력을, Ref2VA 어댑터는 최대 12개 참조(이미지 9개·영상 3개·오디오 3개)를 지원한다. 전체 요약 10문장 읽기 → 031 18:15 스타 1,817 Claude가 영화 같은 랜딩페이지를 자동으로 만드는 스킬 공개 MotionSites가 Claude용 무료 웹빌더 스킬을 공개했으며, Claude가 대상급 영상 같은 랜딩페이지를 설계하고 구축하도록 돕는다. 웹 · 프론트엔드 · Motionsites-AI/claude-skill · Python
Key Point AI 웹빌더가 늘어나는 가운데, 실제로 심사위원 상 수준의 사이트를 만드는 체계적 방법을 Claude에 내장했다는 점이 의미 있다. 디자인 규칙과 미디어 라이브러리, 자동 QA까지 갖춰진 방식은 단순 생성 도구와 다른 수준의 결과를 기대하게 한다.
핵심 요약
MotionSites가 Claude용 무료 웹빌더 스킬을 공개했으며, Claude가 대상급 영상 같은 랜딩페이지를 설계하고 구축하도록 돕는다. AI가 흔히 만드는 평범한 사이트를 피하기 위해 명확한 설계 계획, 실제 영상 자료, 결과물 검증을 자동화한다. 스킬에 포함된 40개 예제 프롬프트는 MotionSites에서 가장 인기 있는 디자인들이며, Claude가 유사한 2~3개를 참고해 디테일을 맞춘다. 전체 요약 12문장 읽기 → 032 18:15 스타 2,306 Claude로 유튜브 쇼츠 만드는 무료 스킬 공개 Claude Code에서 쓸 수 있는 무료 애니메이션 단편 제작 스킬을 공개했다. 웹 · 프론트엔드 · mromidev/claude-animated-shorts · TypeScript
Key Point 직접 PC에서 고품질 애니메이션 쇼츠를 만들 수 있는 완전한 파이프라인과 학습 자료를 무료로 받을 수 있어, 창작자들이 외부 AI 동영상 생성 서비스에 의존하지 않고도 같은 수준의 결과물을 만들 수 있게 되었다.
핵심 요약
Claude Code에서 쓸 수 있는 무료 애니메이션 단편 제작 스킬을 공개했다. 55~70초 세로형 영상으로, 2D 캐릭터가 3D 세계에서 움직이는 구조다. three.js와 Remotion을 써서 자신의 PC에서 렌더링하며, AI 영상 생성 도구는 쓰지 않는다. 전체 요약 9문장 읽기 → 033 18:15 스타 2,076 NVIDIA 그래픽카드 텐서 연산 제한 해제하는 UEFI 도구 Rust로 작성된 UEFI 부트로더 기반 NVIDIA GPU 해제 도구로, Windows·Linux·해킹토시 등 UEFI 부팅 시스템 전반에서 동작한다. 하드웨어 · 시스템 · physicsdolphin/nv-uefi-unlocker · Rust
Key Point NVIDIA가 의도적으로 제한한 GeForce 카드의 텐서 성능을 하드웨어 수정 없이 UEFI 단계에서 해제할 수 있음을 입증한 첫 공개 도구로, 실무 성능 향상(최대 2.6배)과 안전성(읽기 검증·원상복구)을 함께 달성했다.
핵심 요약
Rust로 작성된 UEFI 부트로더 기반 NVIDIA GPU 해제 도구로, Windows·Linux·해킹토시 등 UEFI 부팅 시스템 전반에서 동작한다. GTX 16·RTX 20·RTX 30·RTX 40 시리즈를 지원하며, USB 부팅으로 실행 후 자동으로 원래 OS로 복귀하고 전원 끔으로 원상 복구되며 VBIOS 수정 불필요하다. 실측 결과 FP16/BF16/TF32 텐서 처리량 최대 2.6배, FP8 최대 1.9배, 이미지/영상 생성 +14~75%, DirectML 추론 최대 +94%, LLM prefill 최대 +19% 향상을 기록했다. 전체 요약 10문장 읽기 → 034 18:15 스타 1,934 비디오 속 인물 한 번에 바꾸기, 오픈소스로 나왔다 비디오와 인물 사진을 업로드하고 생성 버튼을 누르면 영상의 주인공을 새 인물로 자동 교체하거나 헤어·옷을 바꾸거나 제거할 수 있는 오픈소스 도구 'Openjutsu' 공개 AI · 머신러닝 · D3voz/openjutsu · TypeScript
Key Point 로컬 GPU에서 돌아가는 오픈소스 비디오 인물 교체 도구로, 상용 Genjutsu 같은 수준의 기능을 무료로 제공하면서 정확한 추적과 다양한 편집 옵션으로 창작자의 선택지를 크게 넓혀줍니다.
핵심 요약
비디오와 인물 사진을 업로드하고 생성 버튼을 누르면 영상의 주인공을 새 인물로 자동 교체하거나 헤어·옷을 바꾸거나 제거할 수 있는 오픈소스 도구 'Openjutsu' 공개 MiniMax H3 영상 생성, SAM 3.1 인물 추적, Qwen3-VL 8B 이미지 설명 모두 오픈 가중치 모델을 로컬 GPU에서 실행하며, 카메라 움직임·편집·사운드는 유지 Next.js 프론트엔드와 ComfyUI 워크플로우 기반이며, FLUX.3 Klein으로 조명 재설정 가능 전체 요약 10문장 읽기 → 035 18:15 스타 1,867 한 장의 사진으로 AI 디지털 휴먼 영상 제작 한 장의 사진과 한 문장의 대사만으로 립싱크된 AI 디지털 휴먼 톡헤드 영상을 자동으로 생성한다. AI · 머신러닝 · andyhuo520/digital-human-koubo · TypeScript
Key Point Claude Code·Codex 같은 에이전트와 직접 통합되는 AI 동영상 자동화 도구로, 유튜브 톱 크리에이터의 편집 기법을 분석한 48개 컴포넌트와 견적 제어 시스템을 갖춘 프로덕션급 워크플로우가 처음 공개됐다.
핵심 요약
한 장의 사진과 한 문장의 대사만으로 립싱크된 AI 디지털 휴먼 톡헤드 영상을 자동으로 생성한다. Grok Video 1.5를 통해 최대 15초 단위 영상 클립을 생성하고, 음성은 별도 처리 후 스펙트럼 매칭으로 통일해 30개 이상의 분리된 클립이 하나의 녹음처럼 들리도록 한다. 유튜브 톱 크리에이터 25명의 영상을 프레임 단위로 분석해 추출한 48개의 패키징 컴포넌트(오프닝, 증거 카드, 주석, 리듬 효과 등)를 제공한다. 전체 요약 12문장 읽기 → 036 18:15 스타 2,738 로컬에서 70개 이상 AI 모델을 다루는 오픈소스 에이전트 봇 본인 컴퓨터에서 실행되는 AI 에이전트 플랫폼 AnyModelBot을 공개했으며, MIT 라이선스 오픈소스로 Windows·macOS·Linux와 Docker를 지원한다. AI · 머신러닝 · modelflare-ai/AnyModelBot · Python
Key Point 로컬에서 실행되는 오픈소스 AI 에이전트로 구독료 없이 여러 모델을 자유롭게 선택할 수 있으며, 개인 정보와 파일이 사용자 기기에만 남는 점이 클라우드 기반 경쟁 제품과 차별화된다.
핵심 요약
본인 컴퓨터에서 실행되는 AI 에이전트 플랫폼 AnyModelBot을 공개했으며, MIT 라이선스 오픈소스로 Windows·macOS·Linux와 Docker를 지원한다. 각 봇은 고유한 페르소나·기본 모델·작업 공간·메모리를 가지며 파일 읽기/쓰기, 명령 실행 같은 작업을 수행할 수 있고 권한은 읽기 전용·작업 공간 한정·완전 권한 3단계로 나뉜다. 대화·기억·파일·API 키는 모두 기기에 남아있으며 모델 요청만 Modelflare 게이트웨이 또는 사용자의 공식 API 키를 통해 외부로 나간다. 전체 요약 11문장 읽기 → 037 18:15 스타 2,617 황과 단극 제3자 클라이언트 HGhub 공개 황과(黄果) 플랫폼의 비공식 클라이언트 HGhub를 Rust와 Tauri 2로 개발해 Windows·macOS·Android 3개 플랫폼에서 지원한다. 오픈소스 · 도구 · Minireel/HGhub · TypeScript
Key Point 개발자가 제3자 앱 개발 시 웹뷰 제한 우회·AES 복호화·크로스플랫폼 Tauri 활용 등 기술적 구현 방식을 학습할 수 있고, 오픈소스 라이선싱 정책의 사례(MIT에서 비상업용으로 변경)를 볼 수 있다.
핵심 요약
황과(黄果) 플랫폼의 비공식 클라이언트 HGhub를 Rust와 Tauri 2로 개발해 Windows·macOS·Android 3개 플랫폼에서 지원한다. React 19·TypeScript·Vite 7·Tailwind CSS 4 조합의 프론트엔드에 hls.js를 통한 HLS/AES-128 재생 기능을 구현했다. 프로젝트는 학습과 기술 교류 목적이며, 음영상 콘텐츠를 제공하지 않고 제3자 사이트에서만 출처한다. 전체 요약 10문장 읽기 → 038 18:15 스타 3,847 비디오 제작 방식을 자동 분석하는 오픈소스 도구 'rea-video' 영상을 샷 단위로 분석해 실제 촬영, AI 생성, 코드 기반 제작 여부를 자동으로 판별하는 파이썬 기반 CLI 도구다. AI · 머신러닝 · JuneYaooo/rea-video · Python
Key Point 비디오 콘텐츠 제작의 주요 성분(실사/AI/코드)을 정확히 판별할 수 있으면, 제작 기법 학습 비용을 대폭 낮추고 비슷한 스타일의 콘텐츠를 빠르게 만들 수 있다.
핵심 요약
영상을 샷 단위로 분석해 실제 촬영, AI 생성, 코드 기반 제작 여부를 자동으로 판별하는 파이썬 기반 CLI 도구다. 카메라 위치·조명 설정·색보정·렌즈 정보 등 촬영 기법, AI 영상의 역엔지니어링 프롬프트와 배치 전략, 3D/애니메이션의 렌더링 여부, 코드 기반 UI/타이포그래피의 타이밍, 화면 녹화 범위를 각각 구분해 보고한다. 자막·이모티콘·편집점·음성(인간/AI)·음악(BPM 포함)·효음의 위치와 지속 시간도 추출하며, SRT/ASS 자막 형식으로 내보낼 수 있다. 전체 요약 9문장 읽기 → 039 18:15 스타 11,535 Claude의 AI스러운 UI를 디자인으로 바꿔주는 '언슬롭' 스킬 Damir Sokolovsky가 만든 unslop은 Claude Code와 Codex용 스킬로, 자동으로 생성된 듯한 AI UI를 일관된 캐릭터를 가진 디자인 인터페이스로 변환한다. 웹 · 프론트엔드 · heydamir/unslop · JavaScript
Key Point AI가 생성한 듯한 UI의 반복적 패턴을 자동으로 잡아내고 고쳐주는 도구로, 디자이너 리뷰 과정을 코드 에디터 안에서 바로 할 수 있게 한다.
핵심 요약
Damir Sokolovsky가 만든 unslop은 Claude Code와 Codex용 스킬로, 자동으로 생성된 듯한 AI UI를 일관된 캐릭터를 가진 디자인 인터페이스로 변환한다. 보라색 그래디언트, 과한 글로우, 이모지 라벨, 과도한 카피, 불균형한 간격 같은 'slop'을 찾아내고 제거한다. Next.js, React, Vue, Svelte, Tailwind, 순수 HTML·CSS 등 어떤 기술스택으로도 만들어진 대시보드, 앱, 랜딩 페이지, 실제 웹사이트(링크만 있어도 됨)에 작동한다. 전체 요약 12문장 읽기 → 040 03:11 ▲ 217 · 댓글 166 구글, 제미니 오므니 1.2 플래시 공개 — 15초 동영상에 가격 30% 인하 구글이 제미니 오므니 1.2 플래시를 일반 공개했으며 가격을 30% 인하해 720p 동영상 기준 초당 0.07달러로 책정했다. AI · 머신러닝 · Gemini Omni 1.2 Flash
Key Point 영상 AI 모델의 실용성이 근본적으로 바뀌고 있습니다. 가격 인하와 15초 네이티브 생성, 다중 턴 편집은 상업 영상 제작 워크플로우를 단순화하고, 기존 스튜디오 작업 방식과 경쟁할 수 있는 규모를 만들고 있습니다.
핵심 요약
구글이 제미니 오므니 1.2 플래시를 일반 공개했으며 가격을 30% 인하해 720p 동영상 기준 초당 0.07달러로 책정했다. 기존 10초 제한에서 15초까지 동영상 생성이 가능하며 1초 단위로 3~15초 범위에서 지정할 수 있다. 캐릭터, 제품, 스타일 이미지와 최대 3초 모션 클립, 오디오 큐를 함께 입력하면 처음부터 끝까지 일관된 참조 유지로 가상 피팅, 상품 스핀, 브랜드 광고 제작이 용이해졌다. 전체 요약 11문장 읽기 → 041 00:11 ▲ 32 · 댓글 3 인간 영상 50,000시간으로 로봇 기초모델 학습시키는 오픈 방법론 1인칭 시점 인간 영상 5만 시간으로 로봇 학습을 위한 데이터를 확보하는 Open-HumanScale 방법론을 공개했다. AI · 머신러닝 · Open-HumanScale: An Open Recipe for Scaling Human and Robot Experience for Embodied Foundation Models
Key Point 인간 행동 영상 대규모 데이터로 로봇 조작 능력을 효과적으로 학습할 수 있는 실증적 방법론과 스케일링 법칙을 제시했으며, 재현 가능한 연구를 위해 전체 파이프라인을 오픈소스화했다.
핵심 요약
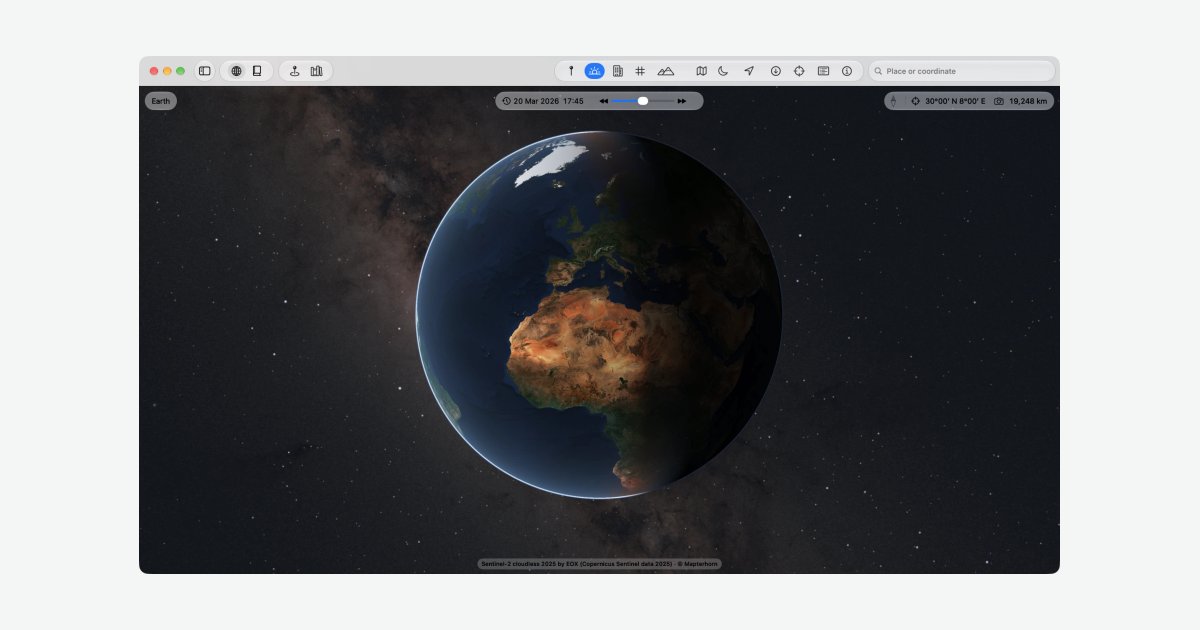
1인칭 시점 인간 영상 5만 시간으로 로봇 학습을 위한 데이터를 확보하는 Open-HumanScale 방법론을 공개했다. 손동작과 자연언어 주석이 달린 Open-HumanScale-50K 데이터셋을 구축하고, 시뮬레이션 평가로 인간 사전학습만으로도 데이터 시간과 로봇 성공률 간 로그 선형 스케일링 법칙을 발견했다. 인간 영상 5만 시간으로만 학습한 HumanWAM-Vanilla 모델은 RoboTwin 2.0 Clean2Clean에서 92.08% 성공률, Clean2Random에서 68.88%, RoboDojo에서 평균 14.17% 성공률을 기록했다. 전체 요약 6문장 읽기 → 042 21:12 ▲ 109 · 댓글 30 Mac 전용 Google Earth 대안, Kugelblitz 1.0 공개 Kugelblitz는 macOS 27 이상, Apple silicon 탑재 Mac용 무료 3D 지구 지도 앱이다. 오픈소스 · 도구 · Kugelblitz – Mac-Native Google Earth Alternative
Key Point 무료 오픈 데이터로 구축된 Mac 전용 지구 지도 앱으로, Google Earth에 비해 폐쇄적이지 않으면서 M1 Mac에서도 부드러운 성능을 제공한다.
핵심 요약
Kugelblitz는 macOS 27 이상, Apple silicon 탑재 Mac용 무료 3D 지구 지도 앱이다. OpenStreetMap과 오픈 지오데이터를 무료로 사용하며, 계정 가입이 필요 없다. imagery, 도로 지도, 지형도를 3D 지형 위에 겹쳐 표시하고, 건물까지 3D로 렌더링한다. 전체 요약 12문장 읽기 → 043 18:11 ▲ 141 · 댓글 18 사이버보안 실전 학습 플랫폼 'pwn.college', 전 세계에 무료 공개 애리조나 주립대(ASU) 해킹 팀이 운영하는 pwn.college는 사이버보안 기초 기술을 실습하는 온라인 교육 플랫폼으로 전 세계 누구나 무료로 접근할 수 있다. 보안 · Pwn.college
Key Point 사이버보안 교육의 접근성 격차를 줄이는 대학 주도의 무료 플랫폼이 전 세계에 공개되었으며, 교육 기관이 자체 커리큘럼에 바로 적용할 수 있는 실습 자료를 확보할 수 있다.
핵심 요약
애리조나 주립대(ASU) 해킹 팀이 운영하는 pwn.college는 사이버보안 기초 기술을 실습하는 온라인 교육 플랫폼으로 전 세계 누구나 무료로 접근할 수 있다. 학습자는 '화이트 벨트'에서 시작해 도장(dojo)을 통해 단계적으로 CPU 명령어부터 네트워크 해킹까지 핵심 개념을 배운다. 총 108개의 해킹 모듈과 10개의 챌린지로 구성되었으며, ASU의 사이버보안 커리큘럼에 사용되고 전 세계 대학에서 학생 평가 자료로 쓰인다. 전체 요약 9문장 읽기 → 044 18:11 ▲ 100 · 댓글 45 팬그램, AI 이미지·영상 탐지 모델 1.0 공개 팬그램이 AI 이미지 탐지 모델 1.0과 경량 모델 Flash 1.0을 공개했다. AI · 머신러닝 · Pangram Image 1.0
Key Point AI가 만든 가짜 이미지·영상을 구분하는 것이 점점 어려워지는 상황에서, 학계와 업계 기준 모두에서 최고 성능을 달성한 탐지 도구가 공개되었다.
핵심 요약
팬그램이 AI 이미지 탐지 모델 1.0과 경량 모델 Flash 1.0을 공개했다. 이미지 모델은 12개 최신 AI 이미지 생성기로 만든 1,200개 합성 이미지에서 99.96% 정확도를 달성했다. 압축·노이즈·블러 등의 편집에도 견디도록 학습했으며, 최소 해상도를 512x512에서 256x256으로 낮춰 저해상도 탐지 능력을 개선했다. 전체 요약 9문장 읽기 → 045 12:54 ▲ 173 · 댓글 16 텍스트-이미지 AI 모델, $21K로 학습 후 공개 2인 연구팀 Linum이 약 2만 1천 달러의 학습 비용으로 훈련한 Pyramid-JiT(P-JiT) 이미지 생성 모델을 Apache 2.0 라이선스로 공개했다. AI · 머신러닝 · Show HN: A decent text-to-image model trained for ~$20K (Apache 2.0 Weights)
Key Point 작은 팀이 주요 클라우드 AI 회사와 비교할 수 없는 수준의 비용으로 실용적인 이미지 생성 모델을 만들고 공개했으며, 이는 확산 모델의 효율성 개선 방향을 보여준다.
핵심 요약
2인 연구팀 Linum이 약 2만 1천 달러의 학습 비용으로 훈련한 Pyramid-JiT(P-JiT) 이미지 생성 모델을 Apache 2.0 라이선스로 공개했다. 모델은 2.42억 개의 파라미터(학습 시 포함)를 가진 확산 모델이며, 512²에서 1024² 해상도로 단계적으로 학습했고, Qwen 3.5-4B 텍스트 인코더를 사용한다. 기존 VAE 기반 압축 대신 픽셀 공간에서 직접 작업하고 32×32 토큰 압축으로 어텐션 컨텍스트 윈도우를 4배 축소했으며, 이전 모델보다 11배 적은 샘플로 수렴한다. 전체 요약 8문장 읽기 → 046 12:54 ▲ 103 · 댓글 35 AI 에이전트와 팀이 함께 편집하는 코드 기반 영상 편집기 키노 공개 Y Combinator S23 투자사 키노는 AI 에이전트와 팀원이 협업하는 영상 편집 플랫폼으로, 자산 보관, 리치 에디터, 리뷰 링크를 한 곳에 통합했다. AI · 머신러닝 · Launch HN: Kino AI (YC S23) – AI media manager and video editor
Key Point LLM이 에이전트로 작동하는 새로운 워크플로우에서 영상 제작 전 과정을 코드 기반으로 통합하는 도구가 등장했으며, 기존 영상 편집 방식의 기본 구조를 바꾸는 시도를 보여준다.
핵심 요약
Y Combinator S23 투자사 키노는 AI 에이전트와 팀원이 협업하는 영상 편집 플랫폼으로, 자산 보관, 리치 에디터, 리뷰 링크를 한 곳에 통합했다. Claude 등 LLM이 같은 타임라인에서 리뷰 노트와 영상 파일을 공유하며 작업할 수 있으며, 모든 편집·모션 그래픽·팀원 댓글을 코드로 표현하는 방식을 채택했다. Remotion 기반 코드 우선 접근으로 React 기반의 위지위그 에디터를 구축했으며, 사용자는 자연스럽게 단어나 코드로 편집 지시를 내릴 수 있다. 전체 요약 12문장 읽기 → 047 03:11 ▲ 101 · 댓글 82 빅데이터 수집하고도 맞춤화 실패, 기술 기업들의 아이러니 기술 기업들이 사용자 데이터를 광범위하게 수집하고 있다는 것은 이미 알려진 사실이지만, 현실은 그 데이터가 제대로 활용되지 못하고 있다. 기타 · I wish tech companies knew more about me
Key Point 기업이 수집한 엄청난 규모의 데이터가 실제로는 얼마나 부실하게 활용되는지 구체적인 사례로 폭로한 글로, 개인정보 수집 정당화 근거인 '맞춤화 서비스'의 현실을 드러낸다.
핵심 요약
기술 기업들이 사용자 데이터를 광범위하게 수집하고 있다는 것은 이미 알려진 사실이지만, 현실은 그 데이터가 제대로 활용되지 못하고 있다. 구매한 제품과 같은 상품만 반복해서 보여주거나, 이미 구매 완료한 물품의 광고를 노출하는 등 명백히 부적절한 추천이 이루어진다. Spotify와 YouTube Music에서 수년간 보컬 전자음악을 모두 스킵했지만 알고리즘은 이 패턴을 인식하지 못한다. 전체 요약 10문장 읽기 → 048 03:11 ▲ 146 · 댓글 67 좋아하는 유튜브 영상, 직접 다운로드해 보관하세요 YouTube의 좋아요 표시한 영상이 점점 사라지고 있다는 점에서 출발하며, 자신이 사랑하는 콘텐츠를 능동적으로 보관할 필요성을 강조합니다. 오픈소스 · 도구 · Download your favourite YouTube videos
Key Point YouTube 영상이 언제 삭제될지 모르는 상황에서, 오픈소스 도구와 개인 서버로 자신의 콘텐츠를 독립적으로 보관할 수 있다는 사실이 많은 개발자에게 실용적인 선택지를 제시합니다.
핵심 요약
YouTube의 좋아요 표시한 영상이 점점 사라지고 있다는 점에서 출발하며, 자신이 사랑하는 콘텐츠를 능동적으로 보관할 필요성을 강조합니다. yt-dlp 같은 도구를 사용하면 영상을 쉽게 다운로드할 수 있고, NAS나 외장 드라이브에 저장하는 방식으로 충분합니다. 저자는 Many a True Nerd 채널의 게임 플레이 영상을 수백 개 보관해야 하는 특수한 필요로 인해 복잡한 설정을 구축했습니다. 전체 요약 7문장 읽기 → 049 00:11 ▲ 26 · 댓글 3 영상 대화에서 LLM의 기억력 측정하는 벤치마크 공개 멀티모달 LLM이 시간 단위 영상을 처리하면서 긴 대화를 나누는 사용 사례가 늘고 있는데, 이를 제대로 평가하지 못하는 문제가 있다. AI · 머신러닝 · VideoMemBench: How Well Do MLLMs Remember in Video Conversations?
Key Point 장문 영상 대화에서 LLM이 문맥을 얼마나 잘 유지하는지 측정할 수 있는 벤치마크가 처음 제시되었으며, 현재 최신 모델들도 45% 미만의 성능을 보여 개선할 여지가 크다는 점을 보여준다.
핵심 요약
멀티모달 LLM이 시간 단위 영상을 처리하면서 긴 대화를 나누는 사용 사례가 늘고 있는데, 이를 제대로 평가하지 못하는 문제가 있다. 기존 영상 질의응답 벤치마크는 각 질문이 독립적이고 이전 대화를 참고하지 않아, 대화 흐름에 따라 정보를 유지하는 능력(인컨텍스트 영상 기억)을 측정하지 못한다. 연구팀은 VideoMemBench를 제시했으며, 단일 영상에 장문의 멀티턴 대화를 연결하되 턴 간 의존성으로 구성했다. 전체 요약 9문장 읽기 → 050 18:13 ▲ 25 · 댓글 2 동영상 감정 표현 평가하는 자기진화형 보상 체계 EmoReward GRPO가 코드와 수학 같은 검증 가능한 영역에서는 성과를 냈지만, 동영상의 감정 표현 평가는 주관적 미학에 의존해 객관적 평가 기준이 없는 문제가 있었다. AI · 머신러닝 · EmoReward: Self-Evolving Reward Calibration for Emotional Video Generation RL
Key Point 감정 표현이 있는 동영상 생성을 평가하려면 기존 고정 보상 방식보다 상황에 맞는 적응형 평가 체계가 필요한데, EmoReward가 학습 과정 자체에서 보상의 신뢰도를 학습해 자동으로 가중치를 조정하는 방법을 제시한다.
핵심 요약
GRPO가 코드와 수학 같은 검증 가능한 영역에서는 성과를 냈지만, 동영상의 감정 표현 평가는 주관적 미학에 의존해 객관적 평가 기준이 없는 문제가 있었다. 기존 방식은 시각 품질, 모션 품질, 텍스트 정렬에 고정된 보상을 사용해 감정 의도를 제대로 포착하지 못했고, 보상 조작 위험이 있으며, RLHF는 확장이 어렵고 개인 미학 차이에 따라 보정이 복잡해진다. EmoReward는 실제 학습 중에 수집한 보상 추적에서 증거 신뢰도를 추출해 다음 학습에서 다중 보상 가중치를 적응적으로 조정하는 자기진화 메커니즘을 제안한다. 전체 요약 8문장 읽기 → 051 18:13 ▲ 89 · 댓글 1 스트리밍 영상 이해를 위한 턴 단위 강화학습 방법 TurnWise 제안 스트리밍 영상 이해는 모델이 반응할지 계속 관찰할지를 반복해서 결정해야 하는 문제이다. AI · 머신러닝 · Turns Matter: Advancing Streaming Video RL via Turn-Level Credit
Key Point 스트리밍 데이터 처리에서 적절한 시점의 결정이 중요한 상황에서, 기존의 궤적 수준 학습의 한계를 턴 단위 신용 할당으로 극복하는 새로운 접근 방식을 제시한다.
핵심 요약
스트리밍 영상 이해는 모델이 반응할지 계속 관찰할지를 반복해서 결정해야 하는 문제이다. 기존의 Group Relative Policy Optimization(GRPO) 방식은 전체 궤적(trajectory) 수준의 장점만 공유하며, 이는 초기 성공 후 중복된 응답을 강화하고 초기 실패 후 유용한 후속 응답을 억제한다. TurnWise는 턴 단위 GRPO 프레임워크로, 각 스트리밍 결정마다 학습을 정렬하여 궤적 수준 피드백과 턴 수준 상호작용의 불일치를 해결한다. 전체 요약 6문장 읽기 → 052 15:11 ▲ 37 · 댓글 2 게임 영상 1분 이상 학습 데이터셋 'GameVerse' 공개 인터랙티브 월드 모델이 생성하는 게임 환경은 현재 약 1분 이상 일관성을 유지하지 못하는데, 이는 모델 성능이 아니라 장기간 학습 데이터 부족 때문이다. AI · 머신러닝 · GameVerse: A Minute-Scale Gameplay Dataset for Long-Horizon Interactive World Modeling
Key Point 장시간 게임 환경을 생성하는 AI 모델의 핵심 제약(짧은 학습 데이터)을 직접 해결하는 대규모 데이터셋이 나왔기 때문에, 이 분야 연구자와 개발자가 주목할 필요가 있다.
핵심 요약
인터랙티브 월드 모델이 생성하는 게임 환경은 현재 약 1분 이상 일관성을 유지하지 못하는데, 이는 모델 성능이 아니라 장기간 학습 데이터 부족 때문이다. 기존 게임 영상 데이터셋은 10초 이하 클립으로 이루어져 있고 캡션도 거칠어서 장시간 제어 생성에 부적합하다. 연구팀이 공개한 GameVerse는 1~2분 길이의 게임 플레이 영상으로 구성되며, 69.7K개 클립, 1,655시간, 3억 4,960만 프레임 규모이다. 전체 요약 8문장 읽기 → 053 15:11 ▲ 26 · 댓글 3 AI 에이전트가 로봇 조종사 대신, 저비용 데이터셋 자동 생성 로봇 학습에 필요한 시연 데이터를 수집하려면 보통 조종사가 일일이 조작했는데, 이 과정은 시간과 비용이 많이 들었다. AI · 머신러닝 · PyRUA-DataFarm: LLM Agent as a Cost-Efficient Teleoperator for Real-Ready Robot Data
Key Point 로봇 학습 데이터 수집 비용을 최소 60% 절감하면서도 성능과 환경 변화에 대한 강건성을 동시에 확보하는 방식을 제시해, 로봇 개발의 경제성 문제를 바꿀 가능성이 있다.
핵심 요약
로봇 학습에 필요한 시연 데이터를 수집하려면 보통 조종사가 일일이 조작했는데, 이 과정은 시간과 비용이 많이 들었다. 연구팀은 코딩 에이전트가 조종사의 역할을 대신하는 'DataFarm' 시스템을 개발했다. 에이전트는 한 번의 캘리브레이션 영상과 작업 설명을 받아 시뮬레이션 내에서 장면, 전문가 제어기, 성공 판별 함수를 자동으로 작성한다. 전체 요약 7문장 읽기 → 054 09:11 ▲ 100 · 댓글 56 수감자 친구의 무죄를 믿을 수 있을까 영국 저자 에드워드 에이블 스미스는 2021년 국립문서보관소에서 다이애나 가버트 살해 사건 판결문을 발견하고 흥미를 느껴 수감자 로빈 가버트와 편지를 주고받기 시작했다. 기타 · Have I befriended a murderer?
Key Point 경찰 수사의 절차적 결함과 판결의 일관성, 그리고 오랜 친구 관계 속에서 진실을 판단하기 어려운 인간의 심리를 다루는 지점이 복잡한 법적 사건에 대해 생각해보게 한다.
핵심 요약
영국 저자 에드워드 에이블 스미스는 2021년 국립문서보관소에서 다이애나 가버트 살해 사건 판결문을 발견하고 흥미를 느껴 수감자 로빈 가버트와 편지를 주고받기 시작했다. 로빈은 2010년 아내 다이애나를 잔혹하게 살해한 혐의로 종신형을 받았으며, 공식적으로는 우체국 강도 중 범행이 일어났다고 주장했지만 검사는 강도를 위장한 살인이라고 주장했다. 6개월간 편지 교환 후 로빈을 만났고, 따뜻하고 침착한 그의 모습에 영감을 받아 6년간 주 1회 전화 통화를 지속했으며 함께 사건을 재검토하기 시작했다. 전체 요약 9문장 읽기 → 055 03:11 당일 +296 경량 화이자앱 클라이언트 'ZapFast' 공개 Rust와 egui로 만든 네이티브 WhatsApp 클라이언트 ZapFast가 Linux, macOS, Windows에서 이용 가능하다. 오픈소스 · 도구 · crmne/zapfast · Rust
Key Point WhatsApp Web의 1/5 메모리 사용량과 1초 이내 실행 속도로 더 가벼운 데스크톱 메시징 경험을 제공하며, 오픈소스로 공개되어 커뮤니티 참여가 가능하다.
핵심 요약
Rust와 egui로 만든 네이티브 WhatsApp 클라이언트 ZapFast가 Linux, macOS, Windows에서 이용 가능하다. 휴대폰을 companion 기기로 연결하는 방식으로, whatsapp-rust 라이브러리를 통해 WhatsApp 기능을 지원한다. Linux에서 1초 이내로 실행되고 유휴 메모리 200MB를 사용하는 반면, WhatsApp Web은 1.13GB를 소비한다. 전체 요약 13문장 읽기 → 056 00:11 ▲ 105 · 댓글 102 데이터센터, 미국 전역 투표에서 대거 저지됐다 미국 유권자들이 투표에서 데이터센터 반대 측도를 대거 통과시켰다. 9개 주 30개 이상 지역에서 모라토리엄, 전면 금지 등의 조치가 채택됐다. AI · 머신러닝 · US voters roundly reject data centers in ballot measures
Key Point AI 인프라 확충의 핵심 자산인 데이터센터가 미국 전역에서 주민 투표로 저지당하면서 AI 붐의 현실적 장벽과 투자 환경 변화가 드러나고 있다.
핵심 요약
미국 유권자들이 투표에서 데이터센터 반대 측도를 대거 통과시켰다. 9개 주 30개 이상 지역에서 모라토리엄, 전면 금지 등의 조치가 채택됐다. 플로리다 에지워터시는 도시 헌장에 데이터센터 금지 조항을 포함했고, 오하이오 페리시는 대규모 클라우드 기업들에 조세감면 시 재정적·운영상 제약을 가하는 방안을 통과시켰다. 130개 이상의 연방 및 주지사 경선에서 민주당 후보들이 반기술 또는 반데이터센터 광고를 집행했고, 이로 인해 텍사스의 그렉 애벗 주지사 같은 AI 지지파 공화당 후보들도 강화된 규제를 약속하게 됐다. 전체 요약 5문장 읽기 → 057 21:11 당일 +667 AI 에이전트를 위한 콘텐츠 생성 스킬 모음 공개 Scenario가 AI 코딩 에이전트(Claude Code, Cursor, Copilot 등 70개 이상)를 위한 에이전트 스킬을 공개했다. AI · 머신러닝 · scenario-labs/skills · Python
Key Point 생성형 AI를 활용한 콘텐츠 제작의 대규모 자동화를 원하는 개발자나 크리에이티브 팀이 직접 검토해볼 수 있는 체계적인 도구 모음이다.
핵심 요약
Scenario가 AI 코딩 에이전트(Claude Code, Cursor, Copilot 등 70개 이상)를 위한 에이전트 스킬을 공개했다. Scenario MCP 서버를 통해 이미지, 비디오, 오디오, 텍스처, 스카이박스, 3D 에셋 등 프로덕션급 콘텐츠를 생성할 수 있다. 게임 아트용 스프라이트, 타일셋, 아이콘부터 영상 광고, 음악, 음성, 자막 생성까지 100개 이상의 세분화된 스킬을 제공한다. 전체 요약 9문장 읽기 → 058 21:11 당일 +120 AI 에이전트를 위한 실무형 스킬 모음 오픈소스 Claude Code, Cursor, Codex 등 AI 코딩 에이전트를 위한 프로덕션급 스킬 모음을 오픈소스로 공개했다. 웹 · 프론트엔드 · ConardLi/garden-skills · JavaScript
Key Point AI 에이전트를 실제 업무에 활용하려는 개발자에게 즉시 쓸 수 있는 전문 스킬 6종을 한곳에서 제공하므로, 각 기능별 서로 다른 도구와 프롬프트를 찾아 조합하는 번거로움을 없애준다.
핵심 요약
Claude Code, Cursor, Codex 등 AI 코딩 에이전트를 위한 프로덕션급 스킬 모음을 오픈소스로 공개했다. 모션 그래픽·영상 생성(motion-showreel), 웹 프레젠테이션(web-video-presentation), 웹 디자인·프론트엔드(web-design-engineer), 이미지 생성(gpt-image-2), 기사 편집·디자인(beautiful-article), 로컬 지식 검색(kb-retriever) 등 6개 스킬을 포함한다. motion-showreel은 결정성 render(t) 파이프라인으로 MP4를 생성하며, 음성·음악·효과음을 통합 타임라인으로 관리하고 최대 20분 분량을 지원한다. 전체 요약 10문장 읽기 → 059 21:11 당일 +984 광디스크에 눈에 보이는 그림을 새기는 도구 공개 Disc Image Studio는 CD·DVD·단층 BD-R 블루레이 광디스크 표면에 육안으로 보이는 패턴을 새길 수 있는 크로스플랫폼 도구다. 오픈소스 · 도구 · JiaFeiMiao-K-Cat/DiscImageStudio · C#
Key Point 오픈소스 개발자들이 만든 도구로 CD·DVD·블루레이 표면에 실제로 보이는 그림을 새길 수 있다는 독특한 기술이 구현되어 있고, 보정 알고리즘의 정확도 향상과 다양한 출력 형식 지원으로 실용성이 높다.
핵심 요약
Disc Image Studio는 CD·DVD·단층 BD-R 블루레이 광디스크 표면에 육안으로 보이는 패턴을 새길 수 있는 크로스플랫폼 도구다. 이미지를 입력하면 CD·DVD·블루레이의 물리층 제약을 만족하는 데이터로 변환해 생성된 ISO·RAW·WAV+CUE 파일로 내보내거나 공백 디스크에 직접 기록할 수 있다. CD는 WAV 음성 트랙 및 CUE 파일, DVD는 ISO 미러, BD-R은 UDF 2.01 파일 시스템을 지원하며 세 매체 모두 디스크 내 파일 저장 기능이 있다. 전체 요약 12문장 읽기 → 060 21:11 ▲ 100 · 댓글 34 유튜브 영상으로 일본어 실력 점검, JIVX의 음성 연습 도구 JIVX는 일본어 유튜브 영상을 활용해 라인별로 타이핑하거나 말하기 연습을 할 수 있는 플랫폼이다. 웹 · 프론트엔드 · Practice speaking Japanese with real YouTube videos, graded line by line
Key Point 실제 영상 콘텐츠로 일본어 말하기와 쓰기를 동시에 연습하면서 레벨에 맞춘 학습이 가능한 새로운 방식의 언어 학습 도구를 제시한다.
핵심 요약
JIVX는 일본어 유튜브 영상을 활용해 라인별로 타이핑하거나 말하기 연습을 할 수 있는 플랫폼이다. 사용자가 일본어 영상을 붙여넣으면 각 문장이 자동으로 분석되어 평가되며, 이미 추가된 영상으로도 연습 가능하다. 플랫폼에는 Hololive 클립, 애니메 , 팟캐스트, 여행 영상, 뉴스 등 다양한 장르의 콘텐츠가 준비되어 있다. 전체 요약 6문장 읽기 → 061 18:11 ▲ 57 · 댓글 2 영상 확산 모델으로 범용 행동 표현 학습하는 DreamX 발표 비디오 확산 모델을 활용해 인간과 로봇 간에 공유 가능한 범용 행동 표현을 학습하는 DreamX를 제안했다. AI · 머신러닝 · DreamX: Video Diffusion Model is a Universal Latent Action Learner
Key Point 로봇과 인간 간 행동을 한 번에 학습하는 시스템으로, 다양한 실체와 환경에서 제로샷 전이가 가능해 로봇 학습 연구의 확장성을 크게 향상시킬 수 있다.
핵심 요약
비디오 확산 모델을 활용해 인간과 로봇 간에 공유 가능한 범용 행동 표현을 학습하는 DreamX를 제안했다. 기존 잠재 행동 모델은 시각적 변화와 행동을 얽혀 표현해 구현체 간 전이가 어려웠던 반면, DreamX는 비디오 모델의 생성 능력을 활용해 행동 관련 역학만 추출한다. 각 프레임을 1,200개에서 4개 토큰으로 압축해 300배 감소시키며, 의상이나 배경 같은 시각적 변화로부터 행동을 분리한 잠재 공간을 생성한다. 전체 요약 6문장 읽기 → 062 18:11 ▲ 27 · 댓글 2 동영상에서 학습 데이터를 자동 생성하는 AI 에이전트 멀티모달 학습 발전이 고품질 학습 데이터 부족과 높은 레이블링 비용으로 제한되고 있는 상황에서, VidUEU-Agent는 원본 동영상에서 자동으로 학습 데이터를 생성하는 파이프라인을 제시한다. AI · 머신러닝 · VidUEU-Agent: A Data-Curation Agent for Multimodal Understanding, Editing, and Unified Tasks
Key Point 동영상에서 자동으로 멀티모달 학습 데이터를 생성하고 최적화하는 방식이 멀티모달 AI 모델 개발의 데이터 부족 문제를 어떻게 풀 수 있는지 보여주는 실질적인 접근법이다.
핵심 요약
멀티모달 학습 발전이 고품질 학습 데이터 부족과 높은 레이블링 비용으로 제한되고 있는 상황에서, VidUEU-Agent는 원본 동영상에서 자동으로 학습 데이터를 생성하는 파이프라인을 제시한다. 4단계 파이프라인으로 구성되며, 저품질 장면을 필터링하고, 핵심 프레임과 멀티모달 신호를 추출한 뒤, 메타데이터를 구성하고 라우팅하여 학습 샘플을 합성한다. 에이전트 프레임워크는 다운스트림 학습 결과를 기반으로 자동으로 데이터 분포를 반복 최적화하여 데이터 품질, 균형, 학습 효율성을 개선한다. 전체 요약 5문장 읽기 → 063 15:11 ▲ 74 · 댓글 2 긴 영상도 한 번에, 다중 장면 편집 프레임워크 MoviEdit 공개 Hugging Face와 연구진이 장편 다중 장면 비디오 편집을 위한 MoviEdit 프레임워크를 발표했습니다. AI · 머신러닝 · MoviEdit: Long-form Multi-Shot Video Editing Made Easy
Key Point 장편 영상의 다중 장면 편집을 자동화하는 기술로, 영상 제작 팀의 작업 효율을 크게 높일 수 있으며 오픈소스로 공개되어 개발자가 활용할 수 있습니다.
핵심 요약
Hugging Face와 연구진이 장편 다중 장면 비디오 편집을 위한 MoviEdit 프레임워크를 발표했습니다. 기존 단일 장면 편집과 달리 장면 전환, 카메라 각도, 피사체 모습의 급격한 변화 속에서도 편집 의도를 일관되게 유지해야 한다는 도전 과제를 해결합니다. 다중 시점 동기화 영상, 실제 다중 장면 비디오, 생성된 콘텐츠로부터 87K개의 쌍을 이루는 편집 비디오 데이터세트를 수동 작업 없이 자동 생성했습니다. 전체 요약 6문장 읽기 → 064 15:11 ▲ 68 · 댓글 2 비디오 생성의 병목은 렌더링에서 의미 제어로 넘어갔다 비디오 생성 기술이 짧은 영상 클립에서 장면 간 일관성 있는 오디오-비주얼 시퀀스로 진화했으며, 이제 병목이 화질 렌더링에서 의미 제어로 옮겨가고 있다. AI · 머신러닝 · Behind Video Generation: Observations and Insights on Multimodal Understanding from Kling
Key Point 비디오 생성 시스템의 모든 모듈(캡셔닝, 프롬프트 강화, 보상 모델링, 평가)을 구체적으로 어떻게 설계했는지 보여주는 실전 가이드라 비디오 생성 연구자와 개발자에게 직접 적용할 수 있다.
핵심 요약
비디오 생성 기술이 짧은 영상 클립에서 장면 간 일관성 있는 오디오-비주얼 시퀀스로 진화했으며, 이제 병목이 화질 렌더링에서 의미 제어로 옮겨가고 있다. Kling의 다세대 개발을 통해 얻은 다중모달 이해에 관한 통찰을 정리한 보고서로, 생성 품질은 데이터-조건화-정렬-평가 전체 파이프라인을 통한 다중모달 이해의 투영이라고 주장한다. Kling-MLLM은 이미지, 비디오, 오디오, 동기화된 오디오-비디오, 인터리빙 입력을 통합하는 공유 다중모달 기초 모델이며, 각 후속 모듈에 맞춰 특화된다. 전체 요약 9문장 읽기 → 065 15:11 ▲ 126 · 댓글 108 개발자가 본 1년 사이 AI 활용의 변화, 코딩은 에이전트 시대로 마이크로소프트 윈도우 AI팀에서 세일즈포스 AI 연구소로 이직한 개발자가 1년간 AI 활용 방식의 변화를 정리했다. AI · 머신러닝 · How I use AI (Oct 2026)
Key Point 한 해 사이 AI 코딩 에이전트가 소프트웨어 개발을 근본적으로 바꿨다. 속도 향상, 피로감, 창의성 상실이 동시에 일어나는 현장의 진솔한 기록.
핵심 요약
마이크로소프트 윈도우 AI팀에서 세일즈포스 AI 연구소로 이직한 개발자가 1년간 AI 활용 방식의 변화를 정리했다. 코딩 분야에서 가장 극적인 변화가 일어났다. 깃허브 코파일럿의 자동완성에서 벗어나 이제는 claudeCode 같은 에이전트 5~6개를 관리하며 일한다. 에이전트는 새 기능을 20분 안에 프로토타이핑하고, 테스트를 실행하며, PR까지 작성·검토한다. 기존에 손으로 작성하는 것과 비교해 속도, 유연성, 버그 해결이 획기적으로 향상됐다. 전체 요약 13문장 읽기 → 066 12:11 ▲ 18 · 댓글 1 과거 정보로 일관성 높인 장시간 영상 생성 모델 적은 단계의 자동회귀 비디오 확산 모델은 효율적인 생성이 가능하지만, 피사체나 장면이 화면 밖에 나갔다 다시 등장할 때 일관성을 유지하기 어렵다. AI · 머신러닝 · History Forcing: Distilling History-Dependent Continuations for Long-Horizon Video World Models
Key Point 긴 장면에서도 일관성 있는 영상을 생성하는 것이 영상 AI 모델의 핵심 과제인데, 이 논문이 제시한 History Forcing 방법이 화면 밖 재등장이나 60초 롱폼 생성에서 구체적 성능 개선을 이뤄냈기 때문이다.
핵심 요약
적은 단계의 자동회귀 비디오 확산 모델은 효율적인 생성이 가능하지만, 피사체나 장면이 화면 밖에 나갔다 다시 등장할 때 일관성을 유지하기 어렵다. 기존 증류 방법들은 역사적 정보를 충분히 활용하지 못해 학생 모델의 현재 예측을 제약하지 못한다는 한계가 있다. 이를 해결하기 위해 History Forcing이라는 통합 온폴리시 증류 프레임워크를 제안했다. 전체 요약 7문장 읽기 → 067 09:11 ▲ 134 · 댓글 31 해커뉴스 추천 영상을 24시간 TV 채널로 보기 해커뉴스에서 가장 많이 추천된 유튜브 영상들을 24시간 방영하는 TV 채널 형식의 서비스인 HackerTV를 공개했다. 웹 · 프론트엔드 · Show HN: HackerTV – HN's most-recommended Youtube videos as 24/7 TV channels
Key Point 해커뉴스의 최고 추천 영상을 큐레이션해 TV 채널처럼 연속 시청할 수 있는 새로운 방식의 콘텐츠 소비 플랫폼이 나왔습니다.
핵심 요약
해커뉴스에서 가장 많이 추천된 유튜브 영상들을 24시간 방영하는 TV 채널 형식의 서비스인 HackerTV를 공개했다. YouTube 메타데이터를 불러오는 중에는 각 영상의 재생 시간이 예상치로 표시되어 실제 길이보다 짧게 나타나거나 끝까지 재생되지 않을 수 있다. 화살표 키로 채널 전환, 0-9로 채널 선택, G 키로 가이드, F 키로 화면 조정, M 키로 음소거, C 키로 자막, I 키로 정보 확인, T 키로 시네마 모드를 사용할 수 있다. 전체 요약 4문장 읽기 → 068 03:11 당일 +167 Nature 논문 작성·작도용 AI 스킬 모음 nature-skills는 Nature 스타일 학술 표현과 연구용 그림 제작을 돕는, 재사용 가능한 SKILL.md 기반 스킬 모음이다. AI · 머신러닝 · Yuan1z0825/nature-skills · Python
Key Point Codex나 Claude Code 같은 에이전트에 논문 윤문, 심사 회신, 그림 제작 워크플로를 스킬로 붙이려는 연구자가 참고할 만한 구성 사례다.
핵심 요약
nature-skills는 Nature 스타일 학술 표현과 연구용 그림 제작을 돕는, 재사용 가능한 SKILL.md 기반 스킬 모음이다. 각 스킬은 skills/ 아래 최상위 디렉터리 하나로 설치되며, nature-shared는 다른 스킬이 참조하는 공유 지원 패키지로 단독 호출용이 아니다. 빠른 시작에서는 논문·문단·심사 의견을 Agent에 넘기고 PDF 중영 대조 reader 생성, 논문 발표 PPT, Nature 스타일 영문 윤문, 초록·서론 초안, 3인 상호 비공개 심사 시뮬레이션, 심사 회신 작성, 인용 조사, 연구 그림 생성 같은 프롬프트를 쓴다. 전체 요약 11문장 읽기 → 069 03:11 ▲ 109 · 댓글 60 NFL 선수 75%, 15년간 사망자 중 CTE 진단 추정 보스턴대 연구진이 JAMA Network Open에 발표한 새 연구에서 2008~2023년 사망한 NFL 선수 중 약 75%가 만성외상성뇌병증(CTE)의 징후를 보였다고 추정했으며, 이는 지금까지의 최고 수치다. 하드웨어 · 시스템 · Study estimates 75% of NFL players who died over 15-year span had CTE
Key Point 생전 진단 불가능한 CTE가 NFL 선수 4명 중 3명에서 발견되는 것으로 추정되면서, 스포츠로 인한 뇌 손상의 심각성과 예방의 중요성이 강조되고 있다.
핵심 요약
보스턴대 연구진이 JAMA Network Open에 발표한 새 연구에서 2008~2023년 사망한 NFL 선수 중 약 75%가 만성외상성뇌병증(CTE)의 징후를 보였다고 추정했으며, 이는 지금까지의 최고 수치다. 연구는 기부된 뇌 396개(93%가 CTE 징후)와 별도로 사망한 구 선수 1,966명의 정보를 합쳐 총 2,360명 규모로 진행했다. 뇌 기부 의사 관련 편향(증상 있는 선수 가족이 5배 더 높은 기부율)을 통계 분석으로 보정했다. 전체 요약 9문장 읽기 → 070 03:11 ▲ 132 · 댓글 84 다운증후군을 가진 삶: 35세 게이브의 일상 35세의 게이브는 다운증후군을 가지고 있으며, 코네티컷 리지필드의 프로스펙터 영화관에서 주당 2일간 일하고 있다. 기타 · Life with Down Syndrome
Key Point 다운증후군을 가진 사람의 삶이 장애가 아닌 하나의 다른 삶으로 어떻게 펼쳐지는지, 독립, 사랑, 자존감, 가족 관계를 둘러싼 구체적인 이야기를 통해 장애인에 대한 사회적 편견과 현실의 간극을 보여준다.
핵심 요약
35세의 게이브는 다운증후군을 가지고 있으며, 코네티컷 리지필드의 프로스펙터 영화관에서 주당 2일간 일하고 있다. 프로스펙터는 장애가 있는 성인들에게 의미 있고 보수가 좋은 일자리를 제공하는 것을 주요 목표로 하며, 게이브는 영상 제작팀으로 일하면서 영화 예고편 전에 나올 광고 영상을 촬영한다. 또 다른 직장인 제미스톤 농장(160에이커 규모)에서도 일하며, 이곳은 프로스펙터의 소유자인 핑크머리의 발 젠센이 운영한다. 전체 요약 12문장 읽기 → 071 00:11 ▲ 26 · 댓글 1 비디오 세계 모델의 예측 오차, 물리적 놀라움을 재대로 측정하지 못한다 비디오 생성 AI의 예측 오차는 물리적으로 불가능한 사건을 감지하는 지표로 사용되지만, 실제로는 물체 색상·모양 변화나 일반적인 예측 어려움도 함께 반영된다. AI · 머신러닝 · When Does Latent Prediction Error Support Physical Surprise Claims in Video World Models?
Key Point 비디오 AI가 물리 법칙을 이해한다고 판단하는 기준(예측 오차)이 실제로는 색상·모양 변화에도 반응해 신뢰성이 낮다는 점을 밝혀, 세계 모델 평가 방식의 재검토가 필요함을 보여준다.
핵심 요약
비디오 생성 AI의 예측 오차는 물리적으로 불가능한 사건을 감지하는 지표로 사용되지만, 실제로는 물체 색상·모양 변화나 일반적인 예측 어려움도 함께 반영된다. 연구팀은 고정된 표현이 무엇을 담고 있는지, 물리적 변화와 겉모습 변화를 어떻게 구별하는지, 모델의 예측 오차를 무엇이 변화시키는지 분리해 평가하는 프레임워크를 개발했다. IntPhys2 벤치마크에서 V-JEPA2 모델을 포함한 여러 표현(잠재 예측, 마스킹된 픽셀 재구성, 시각 통계)을 비교한 결과, 물리적 가능성·불가능성에 대한 정보는 적게 포함했다. 전체 요약 8문장 읽기 → 072 00:11 ▲ 119 · 댓글 36 TechCrunch 자동재생 영상 차단하는 uBlock Origin 필터 TechCrunch의 모든 기사는 본문 중간에 JW Player 영상을 자동재생하며, 숨기는 것만으로는 백그라운드에서 계속 실행된다. 오픈소스 · 도구 · uBlock Origin filter to block autoplay videos in TechCrunch
Key Point TechCrunch 접속 시 중단 없는 콘텐츠 읽기를 원하는 사용자들을 위해 즉시 적용 가능한 필터 코드와 설정 방법을 제공한다.
핵심 요약
TechCrunch의 모든 기사는 본문 중간에 JW Player 영상을 자동재생하며, 숨기는 것만으로는 백그라운드에서 계속 실행된다. Connatix의 플로팅 광고 플레이어도 함께 로드되고 있다. uBlock Origin의 네트워크 필터 규칙으로 JW Player와 Connatix 스크립트를 차단하면 영상이 로드되지 않는다. 전체 요약 8문장 읽기 → 073 21:11 ▲ 106 · 댓글 35 제품 영상 제작 자동화, Claude Code로 구현 Skill Video Studio는 Playwright로 제품 상호작용을 캡처하고 HyperFrames로 제목·챕터·CTA를 구성한 뒤 FFmpeg로 마스터링하는 로컬 영상 제작 워크플로우다. 웹 · 프론트엔드 · Skill to Create Product Videos
Key Point 제품 데모 영상을 스크립트·설정 파일로만 관리하고 자동 제작·렌더링할 수 있으며, Claude Code와의 통합으로 개발팀이 전문 제작 인력 없이도 고품질 영상을 만들 수 있는 새로운 워크플로우를 제시한다.
핵심 요약
Skill Video Studio는 Playwright로 제품 상호작용을 캡처하고 HyperFrames로 제목·챕터·CTA를 구성한 뒤 FFmpeg로 마스터링하는 로컬 영상 제작 워크플로우다. Claude Code의 /devrel-video 스킬과 통합되어 있으며, 무성 워크스루로 시작해 필요시 내레이션·음악·자막·발표자 영상을 추가할 수 있다. Node.js 22+, FFmpeg/ffprobe, Chromium이 필수이며, 선택적으로 음성 변환(ORPHEUS)과 아바타(LatentSync) 같은 외부 서비스를 연결할 수 있다. 전체 요약 10문장 읽기 → 074 18:11 ▲ 78 · 댓글 2 컴퓨터 제어 AI, 쌍중 개선 루프로 성능 대폭 향상 컴퓨터 사용 에이전트(CUA) 개발의 병목은 학습 데이터의 다양성·제어성·신뢰성 부족과 자체 경험에만 의존한 개선 방식의 한계였다. AI · 머신러닝 · CUA-Master: Scaling Computer-use Agents through Open-World Recursive Improvements
Key Point 컴퓨터 조작 AI가 현실 데이터의 다양성 부족을 극복하고 여러 벤치에서 경쟁력 있는 성능을 달성한 방법론이 공개됐다.
핵심 요약
컴퓨터 사용 에이전트(CUA) 개발의 병목은 학습 데이터의 다양성·제어성·신뢰성 부족과 자체 경험에만 의존한 개선 방식의 한계였다. CUA-Master는 두 겹의 재귀 개선 루프로 문제를 해결한다: 바깥쪽은 개방형 데이터와 모델의 약점을 피드백하는 '세계-데이터-모델' 사이클, 안쪽은 시드 작업 채굴과 자가촉매 전파로 다양한 학습 데이터를 생성한다. 시스템은 교육 영상에서 실제 작업 흐름을 추출한 뒤, 시각-의미론 이중경로 궤적 재구성으로 변환하고, 이를 재사용 가능한 기본 단위로 만들어 제어 가능한 합성 작업을 생성한다. 전체 요약 6문장 읽기 → 075 18:11 ▲ 25 · 댓글 2 동영상을 선택적으로 관찰하는 AI 자막 생성 시스템 멀티모달 대규모 언어 모델(MLLM)이 영상 자막을 생성할 때 사소한 세부 사항을 과도하게 강조하고 핵심 맥락을 놓치는 문제가 있다. AI · 머신러닝 · Reviso: Not All Visual Evidence Deserves Equal Attention in Video Captioning
Key Point 멀티모달 AI가 영상 분석 시 모든 부분을 동등하게 처리하는 문제를 선택적 관찰로 해결하는 새로운 접근이 보여 이후 자막 생성, 영상 이해 시스템 설계에 참고할 만하다.
핵심 요약
멀티모달 대규모 언어 모델(MLLM)이 영상 자막을 생성할 때 사소한 세부 사항을 과도하게 강조하고 핵심 맥락을 놓치는 문제가 있다. Reviso는 관찰 대상과 수집 방식을 학습하는 에이전트형 동영상 자막 시스템으로, 낮은 프레임율의 전체 미리보기에서 계층적 Context-Focus-Points(CFP) 계획을 세운다. CFP 계획은 영상 맥락을 파악하고 핵심 요소를 우선순위화한 뒤 구체적인 관찰 대상과 해당 도구를 정의한다. 전체 요약 8문장 읽기 → 076 15:11 ▲ 122 · 댓글 6 실시간 장편 영상 생성 위해 '웨이브 포싱' 기법 제시 실시간 장편 영상 생성을 위해 Wave Forcing(WF) 기법을 제안했다. 기존 청크 단위 자동회귀 방식은 직렬화된 노이즈 제거와 캐시 갱신으로 인해 한 단계 노이즈 제거에도 두 번의 순전파가 필요했다. AI · 머신러닝 · Wave Forcing: Towards Speed-of-Light Streaming Video Generation
Key Point 실시간 장편 영상 생성의 핵심 병목인 순차 처리 방식을 병렬화로 해결하는 구체적 기법이 제시되었고, 7배 이상의 성능 향상을 실현한 점이 주목된다.
핵심 요약
실시간 장편 영상 생성을 위해 Wave Forcing(WF) 기법을 제안했다. 기존 청크 단위 자동회귀 방식은 직렬화된 노이즈 제거와 캐시 갱신으로 인해 한 단계 노이즈 제거에도 두 번의 순전파가 필요했다. WF는 청크별 인과 주의 메커니즘으로 노이즈 제거가 완료되기 전 더 깨끗한 과거 청크에 먼저 접근하고, 엇갈린 노이즈 제거와 캐시 갱신 단계를 모델 복제본들에 분산시켜 파이프라인 충전 후 한 번의 순전파 라운드마다 하나의 출력 청크를 생성한다(1F1C). 모델을 연속 생성 프로세스에 적응시키기 위해 혼합 노이즈 노이즈 제거, 움직임 감독, 자체 생성 히스토리를 이용한 인과 적응을 순차적으로 도입하는 3단계 훈련 절차를 개발했다. 전체 요약 7문장 읽기 → 077 15:11 ▲ 74 · 댓글 2 영상 생성, 에이전트가 주도하는 시대로 동영상 생성이 단순 합성에서 계획·도구·피드백을 활용한 에이전트 기반 생성으로 전환되고 있다. AI · 머신러닝 · Video Generation Meets Agent Harness: Agentic Video Generation, Agentic World Modeling and Recursive Self-Improvement
Key Point 동영상 생성 기술이 에이전트 자율성과 결합되는 새로운 패러다임을 제시하며, 멀티 에이전트·장기 계획·하이브리드 환경이 미래 AI 시스템의 핵심 방향이 될 것을 보여준다.
핵심 요약
동영상 생성이 단순 합성에서 계획·도구·피드백을 활용한 에이전트 기반 생성으로 전환되고 있다. 에이전트 하네스는 동영상 모델 주변에 구성된 실행 런타임으로, 맥락·도구·상태·피드백·예산을 관리한다. 에이전트 비디오 생성은 스크립팅·샷 계획·에셋 관리·제작·편집을 조율하며, 이 시스템들의 평가가 과제다. 전체 요약 7문장 읽기 → 078 15:11 ▲ 153 · 댓글 50 뉴욕타임스 스타일의 해커뉴스 버전 출시 해커타임스는 뉴욕타임스 신문 레이아웃을 모델로 한 해커뉴스 재구성 서비스다. 웹 · 프론트엔드 · Show HN: Hacker Times, a New York Times-inspired version of Hacker News
Key Point 뉴욕타임스 스타일의 신문 레이아웃으로 재구성한 해커뉴스 서비스가 출시되어, 기술 커뮤니티 뉴스 소비 방식에 새로운 선택지를 제공한다.
핵심 요약
해커타임스는 뉴욕타임스 신문 레이아웃을 모델로 한 해커뉴스 재구성 서비스다. MIT CSAIL 팀이 GPT-6 Astra로 신경망 가중치를 직접 편집하는 실험을 보고했으며, 작은 가중치 변화로 수학과 지시 따르기 성능이 크게 향상됐다. 안드레이 카파시가 지난 20년간 해커뉴스 독자들이 언급한 6,454개 유튜브 영상을 모은 해커튜브를 구축했고, AI 코딩 도구를 활용해 추천 기능과 계정 없는 브라우징 경험을 제공한다. 전체 요약 8문장 읽기 → 079 12:11 ▲ 110 · 댓글 41 Windows 2000 론칭 리허설에 몰래 들어간 개발자 Windows 2000 샌프란시스코 론칭 행사는 엑스포와 함께 진행되었으며, 팀 멤버들 중 선발된 사람들이 행사장에 참석했다. 기타 · Sneaking into the auditorium for the Windows 2000 launch rehearsal
Key Point Windows 2000 시대 대형 기술 론칭 행사의 무대 뒤 실제 모습과 당시 최신 기술 시연 방식을 기술자의 눈으로 볼 수 있다.
핵심 요약
Windows 2000 샌프란시스코 론칭 행사는 엑스포와 함께 진행되었으며, 팀 멤버들 중 선발된 사람들이 행사장에 참석했다. 저자가 행사 전 열린 문을 통해 몰래 오디토리움 상층부로 들어갔고, 거기서 리허설을 목격했다. 10미터 높이의 거대한 노트북 모형, 좌우 스크린, 회색 커튼으로 가려진 깜짝 무대 장치들이 준비되어 있었다. 전체 요약 7문장 읽기 → 080 06:11 ▲ 364 · 댓글 223 소리 없이 입 모양으로 말한다, RF 스마트 글래스 공개 Y Combinator F26 배치의 Subvocal Company가 소리를 내지 않고 말할 수 있는 스마트 글래스를 개발했다. 하드웨어 · 시스템 · Show HN: Subvocal – Talk to your computer without making noise
Key Point 무음 음성 입력이 단순 연구가 아닌 실제 프로토타입 제품 수준에 도달했으며, 공개 부스 데이터셋과 RF 기술의 조합이 크로스유저 인식 문제를 어떻게 풀었는지를 보여준다.
핵심 요약
Y Combinator F26 배치의 Subvocal Company가 소리를 내지 않고 말할 수 있는 스마트 글래스를 개발했다. 무음 음성 입력(무음 발성)을 감지하는 방식으로, 입을 가만히 모양만 내거나 심지어 입을 닫은 채로도 작동한다. 초기에는 EMG(근전도) 방식을 시도했으나 신호 변질, 전자기 간섭, 전극 배치 문제, 사용자 거부감 때문에 포기했다. 전체 요약 9문장 읽기 → 081 03:11 ▲ 23 · 댓글 2 동영상 검색 쿼리를 개인화된 의도대로 다시 쓰는 WeFair 웨이신 동영상 검색에서 사용자의 실제 의도를 모호한 쿼리로부터 복구하는 컴팩트한 쿼리 재작성 모델을 제안한다. AI · 머신러닝 · WeFair: Fidelity-Aware Alignment from Human Feedback for Personalized Query Rewriting in Short-Video Search
Key Point 사용자의 실제 검색 의도를 보존하면서 쿼리를 개선하는 기술이 온라인 서비스에서 입증된 효과를 냈기 때문에, 검색 시스템 개선에 관심 있는 개발자와 PM이 참고할 만하다.
핵심 요약
웨이신 동영상 검색에서 사용자의 실제 의도를 모호한 쿼리로부터 복구하는 컴팩트한 쿼리 재작성 모델을 제안한다. 기존 LLM 기반 방식은 사용자 행동 피드백을 과도하게 강조해 시청률 높은 콘텐츠를 우선하며 의도 편향을 야기한다. WeFair는 인간 피드백의 신뢰도를 할당해 시연(demonstration) → 선호(preference) → 검증(verification) 단계로 진행한다. 전체 요약 9문장 읽기 → 082 21:11 ▲ 26 · 댓글 9 단일 영상의 3D 추적, '궤적 수리'로 개선하다 단일 카메라 영상에서 밀집된 3D 추적은 시간에 따른 점 대응, 깊이 추정, 폐색 중 궤적 추론이 필요한데 기존 방법들은 4D 감독 데이터 부족 속에서 이 모든 작업을 함께 학습해야 한다. AI · 머신러닝 · ReLift: Dense 3D Tracking as Lifted Trajectory Repair
Key Point 기존 2D 추적과 3D 기하 정보를 활용해 3D 추적 정확도를 높이는 새로운 접근법으로, 앞으로 나올 추적기나 기하 모델 개선의 이득을 자동으로 누릴 수 있는 구조입니다.
핵심 요약
단일 카메라 영상에서 밀집된 3D 추적은 시간에 따른 점 대응, 깊이 추정, 폐색 중 궤적 추론이 필요한데 기존 방법들은 4D 감독 데이터 부족 속에서 이 모든 작업을 함께 학습해야 한다. 기존 2D 추적기와 3D 기하학 모델만으로도 폐색 부분을 단순 보간한 '들어올린 궤적'이 전용 3D 추적기 수준의 성능을 낸다. 하지만 이 방식은 대응과 깊이 오차를 상속받으며, 폐색 영역에서 깊이값이 가려진 물체에서 나오는 문제가 있다. 전체 요약 7문장 읽기 → 083 21:11 ▲ 23 · 댓글 2 위조 탐지 AI, 딥페이크부터 변조 문서까지 한 번에 비디오·이미지·물리적 스푸핑 등 다양한 형태의 위조에 대응하는 통합 기반 모델 'Venus-DefakerOne2'를 공개했다. AI · 머신러닝 · Venus-DefakerOne2: A Vision-Forensics Foundation Model with Broader Coverage
Key Point 이진 분류 기반 위조 탐지 작업에서 다양한 매체와 위조 형태를 동시에 처리할 수 있는 통합 기반 모델의 등장으로, 위변조 탐지 기술의 범용성이 크게 높아졌다.
핵심 요약
비디오·이미지·물리적 스푸핑 등 다양한 형태의 위조에 대응하는 통합 기반 모델 'Venus-DefakerOne2'를 공개했다. 수천만 개의 오픈소스 및 사내 샘플로 학습했으며, LoRA와 전체 파라미터 튜닝을 번갈아 수행하는 'Tide-Style-Tuning' 기법으로 효율성과 일반화를 동시에 달성했다. 예측 엔트로피를 분석해 최적의 예측 방식을 자동으로 선택하는 'Entropy-based Test Adaptation'을 적용했다. 전체 요약 5문장 읽기 → 084 21:11 ▲ 20 · 댓글 2 시각 기초 모델, 공간 인식 능력 충분한가 시각 기초 모델이 카메라 시점의 연속 영상에서 보이지 않는 영역을 추적하고 장면을 이해하는 공간 표현을 제공하는지 검증하는 연구다. AI · 머신러닝 · Probing Spatial State Representations in Visual Foundation Models
Key Point 시각 기초 모델이 이미지 인식만 하는 게 아니라 실제 로봇처럼 보이지 않는 물체를 추적하고 행동을 계획할 수 있는 공간 인식 능력이 있는지 정량적으로 검증한 첫 시도로, 현재 모델들의 한계를 명확히 드러낸다.
핵심 요약
시각 기초 모델이 카메라 시점의 연속 영상에서 보이지 않는 영역을 추적하고 장면을 이해하는 공간 표현을 제공하는지 검증하는 연구다. 연구팀은 10개 모델의 표현을 공간 구조·물체 지속성·예측적 공간 업데이트·행동 유도 등 4가지 수준의 능력으로 평가했다. 보이는 장면에서 높은 정확도를 보이는 모델도 물체 지속성(보이지 않는 물체 추적)과 미래 특성 인출(future-feature retrieval)에서는 성능이 떨어진다. 전체 요약 7문장 읽기 → 085 18:11 ▲ 14 · 댓글 2 로봇 영상과 행동을 연결해 작업 일반화 개선 로봇이 새로운 작업에 적응하도록 하는 World Action Models(WAM)의 과제를 연구했으며, 영상 일반화와 행동 일반화라는 두 가지 기능이 중요함을 발견했다. AI · 머신러닝 · WorldBridge: Bridging Video and Action for Task Generalization in World Action Models
Key Point 로봇 학습에서 새로운 작업 적응의 핵심인 영상과 행동 데이터의 역할을 실험적으로 규명하고, 이를 바탕으로 다양한 벤치마크에서 최고 성능을 달성한 실용적 모델을 제시했다.
핵심 요약
로봇이 새로운 작업에 적응하도록 하는 World Action Models(WAM)의 과제를 연구했으며, 영상 일반화와 행동 일반화라는 두 가지 기능이 중요함을 발견했다. RoboTwin 2.0에서 훈련 분포 내 영상-행동 감독만으로는 25.07% 성공률을 보였고, 훈련 외 작업의 영상을 추가하면 55.90%로 올라갔으며, 작업당 단 한 개의 행동 라벨까지 더하면 70.70%에 도달했다. 이는 더 폭넓은 영상 커버리지가 기존 역동역학 능력을 활용해 작업 전이를 가능하게 하고, 희소한 행동 감독이 이 능력을 더욱 강화함을 시사한다. 전체 요약 7문장 읽기 → 086 09:11 ▲ 103 · 댓글 56 다양한 감각의 AI가 같은 세계를 본다는 증명 Yann LeCun과 Randall Balestriero는 '플라톤적 표현 가설(PRH)'을 증명하는 논문을 발표했다. 가설은 여러 모달리티(영상, 텍스트 등)로 학습한 AI 모델들이 스케일을 늘리면 같은 세계 표현에 수렴한다는 것이다. AI · 머신러닝 · Proving and improving the Platonic Representation Hypothesis with JEPAs
Key Point 서로 다른 모달리티 모델들이 같은 표현에 수렴한다는 오랜 추측을 수학적으로 증명하면서, 언어 모델이 비전과 정렬되는 방식의 근본적 차이를 밝혔고, 스케일보다 학습 데이터 품질이 중요함을 입증했다.
핵심 요약
Yann LeCun과 Randall Balestriero는 '플라톤적 표현 가설(PRH)'을 증명하는 논문을 발표했다. 가설은 여러 모달리티(영상, 텍스트 등)로 학습한 AI 모델들이 스케일을 늘리면 같은 세계 표현에 수렴한다는 것이다. 저자들은 '플라톤적 표현 정리(Platonic Representation Theorem)'를 증명했다. 결합 임베딩 예측 아키텍처(JEPA)가 서로 다른 모달리티로 학습될 때, 긍정 쌍이 같은 장면의 두 관찰('좋은 뷰')이고 오정렬이 제한되면 회전을 제외하고 동일한 표현을 학습한다는 뜻이다. 다음 토큰 예측(언어 모델의 기본 방식)은 나쁜 뷰(한 문서의 일부)를 사용하는 JEPA로, 이는 언어 모델이 스케일을 통해서만 비전과 정렬되는 이유를 설명한다. 전체 요약 8문장 읽기 → 087 21:11 ▲ 117 · 댓글 29 파일 변환 서비스 잠자르, 20년 766만 건 처리 2006년 형제가 시작한 파일 변환 웹사이트 잠자르(Zamzar)가 20주년을 맞았다. 스타트업 · 비즈니스 · Running a bootstrapped SaaS for 20 years with my brother
Key Point 20년간 자금 조달 없이 자립한 부스트랩 사업의 실제 규모와 지속 방식을 보여주는 사례로, 창업과 장기 사업 운영에 대한 통찰을 제공한다.
핵심 요약
2006년 형제가 시작한 파일 변환 웹사이트 잠자르(Zamzar)가 20주년을 맞았다. 출시 당시 150가지 변환 방식에서 2026년 현재 2,128가지로 확대했으며, 누적 766,615,348개 파일을 처리했다. 전 세계 550만 명 이상이 사용 중이고 하루 100만 건 이상의 API 요청을 처리한다. 전체 요약 8문장 읽기 → 088 06:11 ▲ 132 · 댓글 76 해커뉴스 추천 영상만 모은 유튜브 클론 'HackerTube' 공개 유튜브의 알고리즘이 마음에 들지 않아 Claude Opus 5.5를 이용해 HackerTube라는 영상 플랫폼을 직접 만들었다. 웹 · 프론트엔드 · HackerTube: YouTube built from videos recommended by HN
Key Point 기술 커뮤니티가 추천하는 양질의 콘텐츠만 모은 새로운 영상 발견 방식이 나타났으며, LLM과 웹 개발로 단시간에 실제 서비스를 구축하는 사례를 보여준다.
핵심 요약
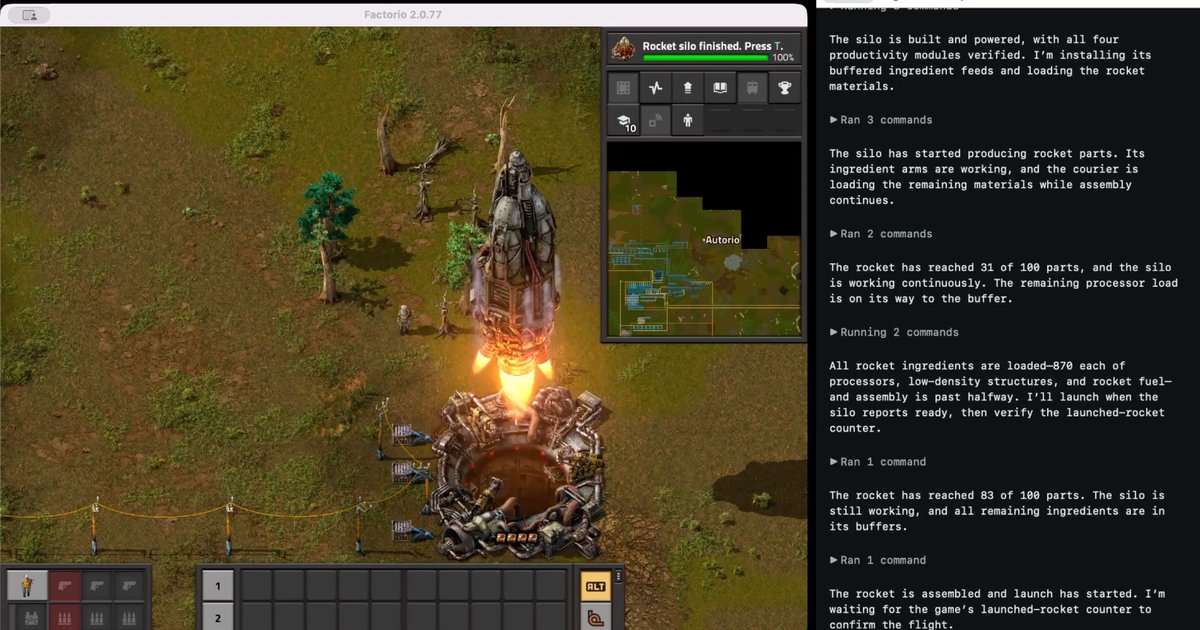
유튜브의 알고리즘이 마음에 들지 않아 Claude Opus 5.5를 이용해 HackerTube라는 영상 플랫폼을 직접 만들었다. 해커뉴스의 2007년부터 2026년까지 전체 댓글을 수집한 후 Sonnet으로 스팸과 저품질 콘텐츠를 필터링했다. 필터링 결과 해커뉴스 사용자들이 추천한 유튜브 영상 6,454개가 수집되었으며, 150개 주제로 분류됐다. 전체 요약 6문장 읽기 → 089 06:11 ▲ 109 · 댓글 108 GPT-4o가 팩토리오 평화모드 클리어 저자가 GPT-5.6 Sol 모델을 Codex에서 낮은 사고 수준으로 실행하여 13.5시간의 게임 시간으로 팩토리오 평화모드(생물 무적) 완주에 성공했다. AI · 머신러닝 · GPT-5.6 Sol can beat Factorio on peaceful mode
Key Point 최신 LLM이 복잡한 실시간 전략 게임을 자율적으로 플레이하고 완주한 첫 사례로, 모델의 실제 문제 해결 능력과 한계를 구체적으로 보여주는 벤치마크입니다.
핵심 요약
저자가 GPT-5.6 Sol 모델을 Codex에서 낮은 사고 수준으로 실행하여 13.5시간의 게임 시간으로 팩토리오 평화모드(생물 무적) 완주에 성공했다. 게임 매니저를 통해 모델이 Python 라이브러리를 사용해 프로그래밍 방식으로 게임을 플레이했으며, GUI 사용자와 동일한 제약(플레이어 도달 거리, 안개 기능)을 적용했다. 모델은 일부 영역에서는 기대를 초과했으나 명확한 약점도 보였고, 전체 런이 기록되어 해설 영상 제작 중이다. 전체 요약 8문장 읽기 → 090 21:11 ▲ 103 · 댓글 72 지구를 망원경으로, 블랙홀 사진 찍기 블랙홀은 우주에서 가장 작은 천체인데도 매우 밝을 수 있으며, 중력이 너무 강해 빛도 탈출할 수 없는 사건의 지평선으로 정의된다. 기타 · How do you take a picture of a black hole?
Key Point 블랙홀 사진 촬영의 역사, 기술, 국제 협력의 규모를 담은 구체적 내용을 통해 과학의 불가능해 보이는 목표가 어떻게 실현되는지 이해할 수 있다.
핵심 요약
블랙홀은 우주에서 가장 작은 천체인데도 매우 밝을 수 있으며, 중력이 너무 강해 빛도 탈출할 수 없는 사건의 지평선으로 정의된다. 하버드 천체물리학자 셉 도엘먼이 이끈 250명의 연구팀은 사건의 지평선 망원경(EHT)이라는 전 지구적 라디오 망원경 네트워크를 구축해 블랙홀의 첫 이미지를 촬영했다. 망원경의 각도 분해능은 빛의 파장을 망원경 크기로 나눈 값인데, 블랙홀 같은 극도로 작은 천체를 보려면 매우 짧은 파장과 거대한 망원경이 필요하다. 전체 요약 13문장 읽기 → 091 12:11 ▲ 10 · 댓글 4 영상 이해 AI, 불확실할 땐 질문하게 하기 멀티모달 대형언어모델의 발전으로 영상 이해 상호작용 방식이 오프라인에서 스트리밍, 주도적 상호작용으로 진화했고, 모델이 능동적으로 답할지 말지 결정하는 단계에 이르렀다. AI · 머신러닝 · AskStream: When and What to Ask Proactively under Uncertainty in Streaming Video Understanding
Key Point 스트리밍 비디오 분석 AI가 정보 부족 상황을 인식하고 능동적으로 질문하도록 훈련할 수 있는지가 새로운 기술 과제가 되고 있기 때문입니다.
핵심 요약
멀티모달 대형언어모델의 발전으로 영상 이해 상호작용 방식이 오프라인에서 스트리밍, 주도적 상호작용으로 진화했고, 모델이 능동적으로 답할지 말지 결정하는 단계에 이르렀다. 기존 주도적 상호작용 방식은 답변에 필요한 정보가 완전하다고 가정해 모델이 대기하거나 답하기만 하도록 설계됐으나, 실제로는 영상이나 사용자 질문의 불확실성으로 정보가 불완전한 경우가 많다. 불완전한 정보 상황에서 기존 방식은 모델이 영원히 대기하거나 환각적 응답을 생성하는 문제를 야기한다. 전체 요약 8문장 읽기 → 092 03:11 ▲ 202 · 댓글 195 심장병 예방에 $100 투자, 응급 치료 $50k보다 낫다 미국 의학협회(ACC)와 심장협회(AHA)가 2026년 3월 관상동맥칼슘점수(CAC) 검사를 예방 지침의 중심에 넣었다. 보안 · Medicare Will Pay $50k for Your Heart Attack. It Should Pay $100 to Prevent It
Key Point 예방 의학의 근본적 문제를 드러낸다: 의료 증거가 지침·보험 시스템·임상 관행에 수십 년 뒤진다는 뜻이며, $100으로 막을 수 있는 질병을 $50k 짜리 응급실 방문으로 치료하는 구조의 비효율을 보여준다.
핵심 요약
미국 의학협회(ACC)와 심장협회(AHA)가 2026년 3월 관상동맥칼슘점수(CAC) 검사를 예방 지침의 중심에 넣었다. CAC 검사는 10분 소요, $100 비용으로 심장마비 발생 수십 년 전 관상동맥의 석회화 플라크를 감지한다. 기존 위험도 계산기는 나이, 콜레스테롤, 혈압 등으로 확률을 추정하지만 실제 질병 여부는 알 수 없다. 전체 요약 13문장 읽기 → 093 00:11 ▲ 103 · 댓글 101 구글, Android XR 기반 유선 XR 안경 'XREAL AURA' 출시 구글과 XREAL이 Android XR 기반 유선 XR 안경 XREAL AURA를 공식 출시했으며, 미국·캐나다·한국에서 오늘 주문 시작, 일본은 11월 2일부터 판매한다. AI · 머신러닝 · The first wired XR glasses powered by Android XR
Key Point Android XR을 탑재한 첫 유선 XR 안경으로, 가벼운 설계·강력한 AI 지원·다양한 앱과 게임·업무용 유선 미러링 기능을 갖춘 모바일 XR 기기 시장의 새로운 옵션이 출시된 것이다.
핵심 요약
구글과 XREAL이 Android XR 기반 유선 XR 안경 XREAL AURA를 공식 출시했으며, 미국·캐나다·한국에서 오늘 주문 시작, 일본은 11월 2일부터 판매한다. 투명 렌즈로 실제 세계를 보면서 70도 시야각으로 공간 콘텐츠를 투영하며, 95g 미만의 가벼운 무게는 케이블로 연결된 별도 컴퓨트 퍽에 Snapdragon Reality Elite 칩과 배터리를 실어 구현한다. Gemini가 사용자의 행동과 화면을 이해해 자연스러운 대화로 도움을 주며, Google Play의 150개 이상 XR 전용 앱을 포함한 수백만 개 앱을 실행할 수 있다. 전체 요약 13문장 읽기 → 094 21:11 당일 +100 Godot 4용 고성능 지형 편집 시스템 Terrain3D 공개 C++ GDExtension으로 개발된 Godot 4용 지형 시스템으로, GDScript, C#, 그 외 Godot이 지원하는 모든 언어에서 접근 가능하다. 하드웨어 · 시스템 · TokisanGames/Terrain3D · C++
Key Point Godot 엔진으로 대규모 야외 지형 게임을 만드는 개발자가 고성능 지형 시스템을 바로 도입할 수 있게 되었으며, 다양한 3D 도구와의 호환성이 워크플로우를 단순화한다.
핵심 요약
C++ GDExtension으로 개발된 Godot 4용 지형 시스템으로, GDScript, C#, 그 외 Godot이 지원하는 모든 언어에서 접근 가능하다. 64x64m부터 65.5x65.5km(약 4,295km²)까지 가변 크기의 연속되지 않은 지역들을 지원하며, 최대 32개 텍스처와 10단계 LOD(레벨 오브 디테일)을 제공한다. 식생 인스턴싱, 음영 임포스터, 지형 조각, 구멍 뚫기, 텍스처 칠하기, 색상 및 습도 칠하기 등의 편집 기능을 포함한다. 전체 요약 5문장 읽기 → 095 21:11 당일 +600 16명의 AI 에이전트 팀이 담긴 오픈소스 데스크톱 앱 Orkas는 MIT 라이선스의 오픈소스 데스크톱 앱으로, 목표를 받아서 자동으로 작업을 수행하는 Commander 에이전트와 16개의 전문가 에이전트로 구성된 멀티에이전트 팀을 운영한다. AI · 머신러닝 · Orkas-AI/Orkas · JavaScript
Key Point 마케팅 콘텐츠 제작, 이커머스 운영, 정기 보고서, 앱 개발 등 다양한 업무를 하나의 에이전트 팀으로 자동화할 수 있는 데스크톱 환경을 제공하므로, 반복 작업 자동화와 팀 협업이 필요한 개발자와 비즈니스 담당자에게 영향을 미친다.
핵심 요약
Orkas는 MIT 라이선스의 오픈소스 데스크톱 앱으로, 목표를 받아서 자동으로 작업을 수행하는 Commander 에이전트와 16개의 전문가 에이전트로 구성된 멀티에이전트 팀을 운영한다. 16개 내장 에이전트는 연구(DeepResearcher, SeoGeoAgent, StockAnalyser), 콘텐츠(ContentWriter, VideoStudio, VoiceStudio, ImageStudio, PptMaker), 개발(UIDesigner, ProductDeveloper), 사무(OfficeWorker), 이커머스(5개 전문 에이전트)를 담당한다. Claude Code, Codex, OpenCode, OpenClaw, Hermes-Agent 등 기존 CLI 에이전트들과 함께 작동하며, Commander가 각 에이전트에게 작업을 분배하고 결과를 통합한다. 전체 요약 12문장 읽기 → 096 15:11 ▲ 18 · 댓글 2 나레이션으로 장편 비디오 자동 편집하는 AI 에이전트 WeVisCut 나레이션에서 장편 비디오를 생성할 때 여러 샷 사이의 일관성을 유지하는 것이 과제인데, 기존 멀티 스테이지 에이전트는 일반 모델 기반으로 작동해 소형 모델의 성능-비용 트레이드오프가 불명확했다. AI · 머신러닝 · WeVisCut: The Whole Editing Room in One Agent From Narration to Long-Form Video
Key Point 텍스트 지시만으로 긴 비디오를 자동 편집하면서 토큰 효율은 Claude Opus 5의 33분의 1 수준이라는 점이 현장 업무 자동화의 실제 가능성을 보여준다.
핵심 요약
나레이션에서 장편 비디오를 생성할 때 여러 샷 사이의 일관성을 유지하는 것이 과제인데, 기존 멀티 스테이지 에이전트는 일반 모델 기반으로 작동해 소형 모델의 성능-비용 트레이드오프가 불명확했다. WeVisCut는 스크립트를 비디오로 변환하는 시스템으로, 도구 실행과 정책 학습을 연결하며 에이전트가 공유 프로덕션 상태를 유지해 도구 피드백이 후속 결정과 오류 복구에 반영된다. 기존 완성 비디오에는 편집 의도가 노출되지 않으므로, 4단계 데이터 파이프라인이 편집 역변환(inversion)과 검증된 재생(replay)을 결합해 3,750개 영상에서 130K개 이상의 훈련 데이터를 추출한다. 전체 요약 7문장 읽기 → 097 03:11 ▲ 138 · 댓글 58 H.264가 영상을 300배 줄이는 방법 H.264는 영상 압축 코덱으로 인터넷 영상, 블루레이, 핸드폰, 보안카메라 등 거의 모든 곳에서 쓰인다. 압축 없이 저장하면 1080p 60Hz 영상이 초당 370MB 이상 용량을 차지해 실용적이지 않다. 웹 · 프론트엔드 · H.264 Is Magic (2016)
Key Point 화소당 수십 바이트를 필요로 하는 영상 데이터를 수백 배 이상 압축하는 구조를 이해하면, 인터넷 동영상이 실시간 재생되고 드론과 보안카메라가 원활하게 작동하는 이유를 알 수 있다.
핵심 요약
H.264는 영상 압축 코덱으로 인터넷 영상, 블루레이, 핸드폰, 보안카메라 등 거의 모든 곳에서 쓰인다. 압축 없이 저장하면 1080p 60Hz 영상이 초당 370MB 이상 용량을 차지해 실용적이지 않다. H.264의 핵심은 손실 압축(lossy compression)으로, 중요하지 않은 부분의 정보를 버린다. PNG처럼 모든 정보를 유지하는 무손실 압축과 달리, H.264는 사람이 감지하기 어려운 세부사항을 제거한다. 양자화(quantization)라는 기법으로 영상을 주파수 영역으로 변환하고, 고주파 성분(세밀한 디테일)을 마스킹해 제거하면 사람 눈에 거의 띄지 않으면서도 용량을 극도로 줄일 수 있다. 전체 요약 8문장 읽기 → 098 21:11 당일 +148 로컬 AI 스튜디오 'Locally Uncensored' 3.0.8 공개 설치부터 실행까지 클릭 몇 번으로 진행되는 올인원 로컬 AI 앱으로, 윈도우·리눅스·안드로이드·맥(베타)을 지원하며 Docker나 터미널 없이도 작동한다. AI · 머신러닝 · PurpleDoubleD/locally-uncensored · TypeScript
Key Point Docker나 터미널 없이 데스크톱에서 채팅·이미지·영상·코딩을 한 앱으로 완전히 로컬에서 실행할 수 있는 통합 환경이 제공되므로, 클라우드 의존성을 피하려는 개발자와 사용자에게 변화를 가져온다.
핵심 요약
설치부터 실행까지 클릭 몇 번으로 진행되는 올인원 로컬 AI 앱으로, 윈도우·리눅스·안드로이드·맥(베타)을 지원하며 Docker나 터미널 없이도 작동한다. 채팅 모드에서 검열을 받지 않은 모델(Abliterated)을 제공하고, ComfyUI 통합으로 이미지·영상 생성, 코딩 에이전트, 음성 대화, 컴퓨터 제어 기능을 한 창에서 사용할 수 있다. 3.0.8에서 웹 검색을 5개 서비스에서 무료로 수행하고, 영상은 백그라운드 렌더링 중에도 채팅 계속 가능하며, 듀얼 그래픽카드 할당으로 채팅과 ComfyUI를 각각 GPU에 할당할 수 있다. 전체 요약 13문장 읽기 → 099 21:11 당일 +493 CapCut 대체 오픈소스 동영상 편집기 Concat 출시 Concat은 무료 오픈소스 동영상 편집기로 macOS, Windows, Linux, Android를 지원하는 CapCut 대체 소프트웨어다. 오픈소스 · 도구 · jub0t/Concat · Rust
Key Point 오픈소스 대안이 필요한 동영상 편집자들을 위해 로컬 처리·무제한 기능·AI 스크립팅 지원을 갖춘 완성도 높은 CapCut 대체제가 나왔다.
핵심 요약
Concat은 무료 오픈소스 동영상 편집기로 macOS, Windows, Linux, Android를 지원하는 CapCut 대체 소프트웨어다. 로컬 Whisper 모델로 자동 자막 생성, 텍스트-투-스피치 및 음성 복제, 배경 제거 등을 제공한다. 100개 이상의 GPU 렌더링 이펙트·필터·트랜지션, 키프레임 애니메이션(위치·스케일·회전·투명도·볼륨), 멀티트랙 타임라인을 지원한다. 전체 요약 12문장 읽기 → 100 21:11 당일 +106 Google의 Notebook LM 오픈소스 대안, 더 많은 모델과 자유도로 돌아왔다 구글의 Notebook LM을 대체하는 오픈소스 도구 Open Notebook이 GitHub에 공개됐다. 오픈소스 · 도구 · lfnovo/open-notebook · TypeScript
Key Point 폐쇄형 클라우드 서비스에서 벗어나 데이터를 완전히 통제하면서 더 자유로운 AI 모델을 선택할 수 있는 선택지가 생겼다.
핵심 요약
구글의 Notebook LM을 대체하는 오픈소스 도구 Open Notebook이 GitHub에 공개됐다. 개인 데이터를 완전히 통제할 수 있으며, OpenAI·Anthropic·Google·Mistral·Ollama 등 20개 이상의 AI 모델 제공자를 지원한다. PDF·동영상·오디오·웹페이지 등 다양한 형식의 콘텐츠를 조직하고, 전문 팟캐스트 생성(1~4명 스피커), 전문검색(전문 및 벡터 검색), AI 채팅 등 기능을 제공한다. 전체 요약 8문장 읽기 →