쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 22일 (일)까지 5067건
100건 (최대치) · "음성"조건 지우기 ×
001 12:11 ▲ 10 · 댓글 3 영상 편집 자동화 평가하는 벤치마크 'RoughCut-Bench' 공개 영상 미디어 제작 초기 단계인 '러프컷'(원본 영상을 조직화한 초안)을 자동으로 수행하는 대규모 비전-언어 모델(LVLM) 평가를 위해 RoughCut-Bench 벤치마크를 제안했다. AI · 머신러닝 · RoughCut-Bench: A Benchmark for Automatic Video Rough-Cut with Large Vision-Language Models
Key Point 영상 편집은 미디어 제작의 핵심 단계이지만 아직 자동화 평가 기준이 없었는데, 이 벤치마크가 LVLM의 편집 능력을 체계적으로 측정할 수 있게 해준다.
핵심 요약
영상 미디어 제작 초기 단계인 '러프컷'(원본 영상을 조직화한 초안)을 자동으로 수행하는 대규모 비전-언어 모델(LVLM) 평가를 위해 RoughCut-Bench 벤치마크를 제안했다. 벤치마크는 두 가지 실무적 설정을 포함한다: 영상 중심 설정은 101개 사례에 831개 원본 영상과 1,476개 하이라이트 주석을 담고 있으며, 하이라이트 감지·선택, 소스 영상 정렬, 사용자 요구사항 준수를 다룬다. 음성 중심 설정은 84개 사례로 구성되며, 자동 음성 인식(ASR) 텍스트에서 필러 제거, 표현 중복 제거, 저가치 콘텐츠 트리밍을 평가한다. 전체 요약 6문장 읽기 → 002 03:11 ▲ 156 · 댓글 28 음성을 악보로 바꾸는 AI, 65배 작아졌다 음성을 MIDI로 변환하는 오픈소스 모델 Dettato를 공개했다. 2천만 파라미터로 경쟁 모델 MuScriptor(13억)보다 65배 작으면서도 성능이 더 우수하고, 비공개 모델인 Mirelo A2M v1.1 Pro와도 비슷한 수준의 정확도를 갖췄다. AI · 머신러닝 · Show HN: I made an audio-to-MIDI model 60x more efficient
Key Point 지금까지 65배 더 큰 모델을 썼는데도 같거나 더 좋은 성능을 내는 소형 모델이 나왔으며, 저작권 없는 데이터만으로 학습할 수 있다는 점이 오디오 AI와 음악 기술 분야에서 의미가 있습니다.
핵심 요약
음성을 MIDI로 변환하는 오픈소스 모델 Dettato를 공개했다. 2천만 파라미터로 경쟁 모델 MuScriptor(13억)보다 65배 작으면서도 성능이 더 우수하고, 비공개 모델인 Mirelo A2M v1.1 Pro와도 비슷한 수준의 정확도를 갖췄다. 벤치마크는 여러 데이터셋(Bach, PHENICX, RWC 등)에서 측정했으며, Dettato의 평균 F1 스코어는 60.87로 Mirelo 56.16, MuScriptor 47.45보다 높다. 학습 과정에서 저작권이 있는 음성을 전혀 사용하지 않았다. 대신 합성 악기 녹음과 CC 라이선스 솔로 악기를 URMP 데이터셋으로 혼합하고, 나머지는 Soundfont를 변형해 생성했다. 전체 요약 7문장 읽기 → 003 00:11 ▲ 107 · 댓글 23 AI로 만든 최강 소코반 솔버, 기존 솔버 능가 Soksolv는 소코반(박스 밀어내기 퍼즐 게임) 솔버로 표준 벤치마크 양쪽에서 발표된 모든 솔버보다 많은 레벨(전체 13,315개 중)을 해결하며, 24개의 세계 최초 자동 클리어 기록을 포함했고 기존 솔버 대비 약 3.2배 빠르다. AI · 머신러닝 · The Strongest Sokoban Solver
Key Point AI 에이전트의 대규모 협력 개발 사례로, 복잡한 알고리즘 연구에서 프론티어 모델이 인간 개발자를 대체할 수 있음을 보여준다.
핵심 요약
Soksolv는 소코반(박스 밀어내기 퍼즐 게임) 솔버로 표준 벤치마크 양쪽에서 발표된 모든 솔버보다 많은 레벨(전체 13,315개 중)을 해결하며, 24개의 세계 최초 자동 클리어 기록을 포함했고 기존 솔버 대비 약 3.2배 빠르다. 개발자는 Claude Code와 약 430개의 서브에이전트(Sonnet, Opus, Fable 모델 조합)를 활용해 한 번의 14일 단일 세션으로 개발했으며, API 비용은 약 3,500달러였다. 소코반은 1982년 일본에서 출시된 게임으로 1997년 PSPACE-완전성이 증명되었으며, 작은 판도 수백 개에서 수천 개의 움직임이 필요한 거대한 탐색 공간을 가진다. 전체 요약 11문장 읽기 → 004 18:11 ▲ 43 · 댓글 3 WeMM-Video, 오픈소스 멀티모달 비디오 이해 모델 공개 음성과 함께 비디오를 이해하는 멀티모달 작업이 중앙 과제로 남아있는 가운데, 웨이즈(Wize)가 WeMM-Video라는 중영문 쌍언어 오픈소스 모델군을 공개했다. AI · 머신러닝 · WeMM-Video: Pushing the Frontiers of Open-Source Omni-Modal Video Understanding
Key Point 오픈소스 멀티모달 비디오 모델이 상용 모델을 넘어서는 성과가 나왔고, 특히 소형 모델(9B)이 훨씬 큰 경쟁 모델을 이기는 효율성을 보여준다.
핵심 요약
음성과 함께 비디오를 이해하는 멀티모달 작업이 중앙 과제로 남아있는 가운데, 웨이즈(Wize)가 WeMM-Video라는 중영문 쌍언어 오픈소스 모델군을 공개했다. 2B, 4B, 9B, 35B-A3B 등 4개 규모의 모델을 제공하며, 텍스트·이미지·음성·비디오를 한 패러다임 안에서 처리한다. 빠른 응답을 위한 인스트럭트 모드와 단계별 추론을 위한 싱킹(thinking) 모드를 모두 지원한다. 전체 요약 8문장 읽기 → 005 18:11 ▲ 107 · 댓글 17 자체 음성어시스턴트를 더 똑똑하게: 엔진 교체기 Platypush 음성어시스턴트 파이프라인을 재구축하면서 openwakeword에서 microWakeWord로 전환했다. 오픈소스 · 도구 · Rebuilding my local voice assistant pipeline
Key Point 자체 호스팅 음성어시스턴트가 상용 제품만큼 신뢰할 수 없었던 문제를 엔진 교체와 알고리즘 개선으로 얼마나 해결할 수 있는지 보여주고, 각 컴포넌트의 구체적인 성능 개선(대화 종료 시간 1/4-1/6로 단축) 과정을 공유한다.
핵심 요약
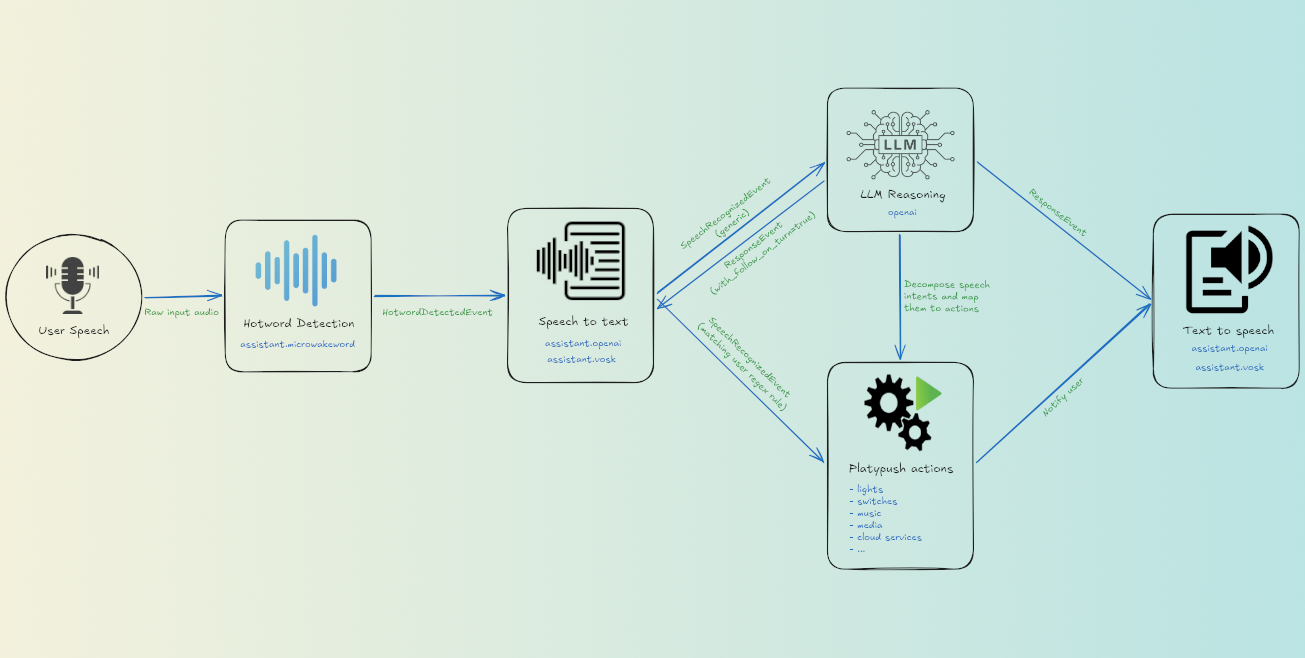
Platypush 음성어시스턴트 파이프라인을 재구축하면서 openwakeword에서 microWakeWord로 전환했다. openWakeWord는 2023년 모델로 오래되어 위양성(배경 소음 감지)과 위음성(가까울 때만 감지) 문제가 많았다. microWakeWord는 ESPHome과 Home Assistant Voice가 사용하며 모델이 적극 유지보수되고, 패키지에 사전학습 모델(okay_nabu, hey_jarvis, hey_mycroft, alexa)이 포함된다. 전체 요약 13문장 읽기 → 006 15:11 ▲ 52 · 댓글 3 AI 생성 영상 적발하는 자가 학습 에이전트 프레임워크 최근 영상 생성 기술의 발전에 따라 명시적인 포렌식 증거에 기반한 신뢰할 수 있는 탐지 방법의 필요성이 대두되고 있다. AI · 머신러닝 · WeVisForensics: Self-Evolving Agent for Omni AI-Generated Video Detection
Key Point 생성형 AI 영상이 급속도로 고도화되는 상황에서, 적응형 에이전트 기반 멀티모달 탐지 시스템이 최신 기준을 9% 이상 상회하는 성능을 보였다.
핵심 요약
최근 영상 생성 기술의 발전에 따라 명시적인 포렌식 증거에 기반한 신뢰할 수 있는 탐지 방법의 필요성이 대두되고 있다. 기존 방법들은 단일 패스 사고 연쇄(chain-of-thought) 추론으로 짧거나 국소적인 흔적을 놓치거나, 고정된 멀티 에이전트 워크플로우로 조사 유연성이 부족했다. WeVisForensics는 메인 조사자 에이전트가 시각 및 음성 단서를 아우르는 자가 진화하는 포렌식 검사자 서브 에이전트 라이브러리를 조정하는 에이전트 프레임워크다. 전체 요약 7문장 읽기 → 007 12:10 새 버전 OpenAI 파이썬 SDK, WebRTC 대기 상태 지원 OpenAI 파이썬 SDK v3.57.0이 릴리스됐다. AI · 머신러닝 · openai/openai-python@v3.57.0
Key Point 실시간 음성·영상 통신(WebRTC)을 활용한 AI 애플리케이션 개발 시 연결 상태 관리 기능이 필요한 개발자들에게 필수 업데이트다.
핵심 요약
OpenAI 파이썬 SDK v3.57.0이 릴리스됐다. Live WebRTC 대기 상태(standby) 지원 기능이 추가됐다. 이를 통해 WebRTC 기반 실시간 통신에서 대기 상태 관리가 가능해졌다. 008 03:11 새 버전 파이썬 린터 Ruff 0.17.6 출시 Ruff 0.17.6 버전이 2026년 11월 19일 릴리스되었다. 오픈소스 · 도구 · astral-sh/ruff@0.17.6
Key Point 파이썬 개발 workflow에서 광범위하게 사용되는 린터의 버그 수정과 성능 개선 사항을 확인할 수 있으며, 특히 거짓 양성·음성 감소는 린팅 정확도에 직접 영향을 준다.
핵심 요약
Ruff 0.17.6 버전이 2026년 11월 19일 릴리스되었다. flake8-type-checking 플러그인에서 TC010(runtime-string-union) 규칙의 자동 수정 기능을 추가했다. B033, RUF068 규칙에서 괄호로 감싼 중복 항목 처리 버그를 수정했고, F823 규칙에서 이름이 여러 번 할당된 경우 거짓 음성을 해결했다. 전체 요약 10문장 읽기 → 009 03:11 ▲ 131 · 댓글 110 로컬 AI, 오픈 모델, 음성 인터페이스의 현재와 미래 딥러닝 엔지니어 피트 워든이 로컬 AI가 클라우드보다 나은 선택지임을 주장한다. 올라마 같은 도구를 사용하면 사용자는 쉽게 로컬 모델을 구동할 수 있으며, 오픈 가중치 모델의 성능이 상용 모델과 비슷한 수준으로 발전했다. AI · 머신러닝 · Pete warden on local AI, open models, voice interfaces, the future of hardware
Key Point 로컬 AI 기술의 현재 성숙도, 하드웨어 요구사항, 그리고 음성 인터페이스의 실질적인 개선 방안을 엔지니어 관점에서 정리하고 있으며, 엔드투엔드 모델과 화합물 AI 간 기술적 선택이 비즈니스 인센티브와 연결되어 있다는 점을 지적한다.
핵심 요약
딥러닝 엔지니어 피트 워든이 로컬 AI가 클라우드보다 나은 선택지임을 주장한다. 올라마 같은 도구를 사용하면 사용자는 쉽게 로컬 모델을 구동할 수 있으며, 오픈 가중치 모델의 성능이 상용 모델과 비슷한 수준으로 발전했다. 9억 개 파라미터 모델은 양자화(Q4)를 통해 4GB 그래픽 메모리에서 구동 가능하며, 중급 노트북 대부분이 이 조건을 충족한다. 애플의 M5 스튜디오는 256GB 시스템 메모리로 수백억 파라미터 모델을 실행할 수 있다. 로컬 모델은 프라이버시, 자체 제어, 비용 절감 등의 이점이 있지만, 엔터프라이즈 사용자의 가장 큰 장벽은 모델 품질이 아니라 사용성이다. 사이버보안 전문가 같은 사람들은 상용 모델의 제한 사항으로 인해 로컬 모델을 선호한다. 전체 요약 11문장 읽기 → 010 00:11 ▲ 273 · 댓글 108 차단당한 개인 API, 오픈소스 하드웨어로 되찾다 샘버레인(Chamberlain)의 garage door opener 제조업체가 2023년 말 myQ API의 서드파티 접근을 차단했고, myQ 앱에 광고가 급증하면서 신뢰성이 떨어졌다. 오픈소스 · 도구 · Garage Door Spam
Key Point 클라우드 서비스가 API를 닫고 광고를 강요할 때, 로컬 네트워크와 오픈소스 하드웨어로 완전한 독립성을 되찾을 수 있음을 보여준다.
핵심 요약
샘버레인(Chamberlain)의 garage door opener 제조업체가 2023년 말 myQ API의 서드파티 접근을 차단했고, myQ 앱에 광고가 급증하면서 신뢰성이 떨어졌다. 저자는 이에 대응해 ratgdo32 디바이스 2개를 구매했으며, 이는 약 62달러의 오픈소스 펌웨어 보드로 garage door opener의 기존 터미널에 직결되어 LiftMaster의 Security+ 2.0 프로토콜을 로컬 네트워크에서 구동한다. Apple HomeKit과 연동되어 음성 명령으로 제어할 수 있으며, ratgdo32는 웹 인터페이스와 JSON 상태 엔드포인트를 제공한다. 전체 요약 7문장 읽기 → 011 21:11 당일 +202 딥러닝 모델 최적화·배포 오픈소스 'OpenVINO' 주목 인텔이 개발한 OpenVINO는 딥러닝 모델을 최적화하고 에지부터 클라우드까지 다양한 환경에 배포하는 오픈소스 툴킷이다. AI · 머신러닝 · openvinotoolkit/openvino · C++
Key Point 엣지부터 클라우드까지 다양한 환경에서 여러 프레임워크의 모델을 최적화·배포할 수 있는 통합 솔루션으로, LLM부터 컴퓨터 비전까지 광범위한 AI 작업에 활용 가능하다.
핵심 요약
인텔이 개발한 OpenVINO는 딥러닝 모델을 최적화하고 에지부터 클라우드까지 다양한 환경에 배포하는 오픈소스 툴킷이다. PyTorch, TensorFlow, ONNX, Keras, PaddlePaddle, JAX/Flax 등 주요 프레임워크로 학습한 모델을 직접 지원하며, Hugging Face Hub의 Transformers와 Diffusers 모델도 Optimum Intel을 통해 통합할 수 있다. CPU(x86, ARM), GPU(인텔 통합·별도 GPU), NPU 등 여러 하드웨어 플랫폼에서 추론을 실행할 수 있고, 프레임워크 없이도 모델을 변환·배포할 수 있다. 전체 요약 8문장 읽기 → 012 06:11 ▲ 116 · 댓글 96 구글, 세계 생성 AI 'Genie 4' 공개…실시간 편집과 음성 추가 구글 DeepMind가 Project Genie의 새로운 버전 Genie 4를 Google AI Ultra 구독자 대상으로 출시했다. AI · 머신러닝 · Genie 4 is now available
Key Point 대화식 세계를 실시간으로 편집하고 음성까지 더해 생성할 수 있는 AI 도구가 출시되며, 개인 창작물 공유 생태계까지 갖춰 AI 창의성 도구의 새로운 수준을 제시한다.
핵심 요약
구글 DeepMind가 Project Genie의 새로운 버전 Genie 4를 Google AI Ultra 구독자 대상으로 출시했다. Genie 4는 가장 현실적인 세계 모델로, 세션 중에 프롬프트를 입력해 생성된 세계를 실시간으로 편집할 수 있다. 날씨 변경, 캐릭터 추가, 액션 재설정 등이 가능하며, 처음으로 실시간 네이티브 오디오를 지원해 환경음과 대사가 장면에 맞춰 적응한다. 전체 요약 10문장 읽기 → 013 03:11 ▲ 105 · 댓글 13 Emacs 31에 머지된 개발자의 기여들 저자는 오픈소스 프로젝트 기여에서 가장 큰 허들이 FSF 저작권 양도 과정이라고 설명했으며, 이를 개선하려는 노력 없이 현재 시스템을 이해해야 함을 강조했다. 오픈소스 · 도구 · My Emacs 31 contributions
Key Point 오픈소스 프로젝트 기여 과정의 현실적 장벽과 그 속에서 이루어진 실제 개선사항들을 보여주며, Emacs 같은 장수 프로젝트에 기여하려는 개발자들에게 실질적인 조언을 제공한다.
핵심 요약
저자는 오픈소스 프로젝트 기여에서 가장 큰 허들이 FSF 저작권 양도 과정이라고 설명했으며, 이를 개선하려는 노력 없이 현재 시스템을 이해해야 함을 강조했다. Emacs는 50년 역사의 프로젝트로 대부분 무급 자원봉사자들이 운영하고 있어서, 기여를 고려하는 개발자들은 절차가 번거로워도 도전해볼 가치가 있다고 조언했다. Dired에 `dired-hide-details-hide-absolute-location` 옵션을 추가해 버퍼 최상단의 절대 경로를 숨길 수 있게 했다(bug#72272). 전체 요약 9문장 읽기 → 014 03:11 ▲ 166 · 댓글 105 마이크로소프트, 7개 AI 모델 한 번에 공개…저가 가격대로 경쟁 마이크로소프트가 MAI 모델 7종을 발표했으며, 가격-성능비를 중심으로 경쟁 모델들을 압도한다고 주장했다. AI · 머신러닝 · Microsoft AI: Seven new world-class models at scalable price-performance
Key Point 엔터프라이즈급 AI 모델 시장이 성능에서 경쟁을 넘어 가격-성능비 경쟁으로 급격히 재편되고 있으며, 마이크로소프트의 대규모 모델 공개는 개발자와 기업의 AI 도입 비용 구조를 크게 바꿀 수 있기 때문이다.
핵심 요약
마이크로소프트가 MAI 모델 7종을 발표했으며, 가격-성능비를 중심으로 경쟁 모델들을 압도한다고 주장했다. MAI Cyber 2 Flash는 GPT-6 Astra의 품질을 2% 미만의 비용으로 구현하며, 사이버보안 24/7 운영을 위해 설계됐다. MAI Code 2는 GPT-6.1 Sol의 98% 성능을 40% 가격에, Claude Opus 5.5의 96% 성능을 5% 가격에 제공한다. 전체 요약 12문장 읽기 → 015 15:11 ▲ 22 · 댓글 2 휴머노이드 로봇 여럿이 협력하는 '비-호(Heave-Ho)' 프레임워크 여러 휴머노이드 로봇이 장시간 협력 작업을 수행할 수 있도록 하는 분산형 프레임워크 Heave-Ho를 개발했다. AI · 머신러닝 · Heave-Ho: Decentralized Long-Horizon Multi-Humanoid Collaboration
Key Point 휴머노이드 로봇의 협력 작업이 네트워크 없이도 가능해지면서, 여러 로봇의 복잡한 협력 시나리오를 실현하는 길이 열렸다.
핵심 요약
여러 휴머노이드 로봇이 장시간 협력 작업을 수행할 수 있도록 하는 분산형 프레임워크 Heave-Ho를 개발했다. 저수준에서는 휴머노이드 기초 모델을 적응시켜 로봇 간 물리적 상호작용을 조정하고, 로컬 관찰만으로 분산 제어가 가능하게 했다. 고수준에서는 비전-언어 플래너와 음성 기반 리더-팔로워 조율 메커니즘을 설계해 네트워크 통신 없이 동기화된 실행을 한다. 전체 요약 6문장 읽기 → 016 12:11 ▲ 108 · 댓글 44 모든 것에 LLM이 필요한 건 아니다 LLM은 간단한 질문에도 장황한 답을 주지만, 디시전 모델(Jev)은 구조화된 질문에 확률 점수를 함께 반환하므로 모델의 불확실성이 명시적으로 드러난다. AI · 머신러닝 · Not Everything Needs an LLM
Key Point LLM 비용과 지연 시간이 문제인 개발팀이 더 효율적인 대안을 선택하는 방법을 배울 수 있으며, 디시전 모델이 LLM을 완전히 대체할 수 없지만 특정 업무에서는 훨씬 나은 선택지임을 보여준다.
핵심 요약
LLM은 간단한 질문에도 장황한 답을 주지만, 디시전 모델(Jev)은 구조화된 질문에 확률 점수를 함께 반환하므로 모델의 불확실성이 명시적으로 드러난다. 디시전 모델은 프론티어 LLM보다 최대 444.6배 저렴하고 193.6배 빠르므로, 비용이 많이 드는 LLM 호출이 정말 필요한지 먼저 판단하는 게이트로 사용할 수 있다. PostHog의 세션 녹화 요약 서비스인 Replay Vision에서는 개인정보 필터링을 위해 2개의 yes/no 질문을 사용하고, 0.4 이상의 점수만 Gemini LLM에 전달하므로 전체 요약의 98.7%가 LLM 호출을 건너뛴다. 전체 요약 12문장 읽기 → 017 21:11 ▲ 17 · 댓글 2 멜-스펙트로그램 직접 활용한 자동회귀 음성합성 VoxMel 음성합성에서 자동회귀 모델은 안정적 예측을 위해 압축된 음향 표현이 필요한데, 기존 방식들은 복잡한 신경망 인코더를 사용해 생성 품질을 제한했다. AI · 머신러닝 · VoxMel TTS Technical Report
Key Point 멜-스펙트로그램을 직접 사용해 복잡한 인코더 없이 고품질 음성합성을 가능하게 한 새로운 접근으로, 추론 속도와 품질의 균형을 개선했다.
핵심 요약
음성합성에서 자동회귀 모델은 안정적 예측을 위해 압축된 음향 표현이 필요한데, 기존 방식들은 복잡한 신경망 인코더를 사용해 생성 품질을 제한했다. VoxMel은 토크나이저 없이 고정된 Haar 변환으로 멜-스펙트로그램을 직접 모델링하는 프레임워크로, 이는 정확히 역변환 가능하다. 변환은 먼저 각 멜-스펙트로그램을 주파수 축으로 분해해 국소 평균과 주파수 잔차를 얻고, 평균 성분을 시간 축으로 분해해 Coarse-Mel과 시간 잔차를 얻는다. 전체 요약 7문장 읽기 → 018 00:11 ▲ 11 · 댓글 2 화자 수 제한 없는 실시간 회의 음성 분리 기술 기존 신경망 기반 음성 분리 모델들(Streaming Sortformer, Nemotron-3)은 고정된 수의 출력 슬롯을 가져 미리 정한 수의 화자만 인식할 수 있다는 한계가 있었다. AI · 머신러닝 · eDIAR: Training-Free Open-Speaker Streaming Diarization for Long Meetings and Large Archives via e-means
Key Point 회의실 모임에서 몇 명이 참석할지 미리 알 수 없는 상황에서, 기존 고정 슬롯 방식을 완전히 벗어나 무제한의 화자를 실시간으로 인식할 수 있는 첫 실용적 솔루션이다.
핵심 요약
기존 신경망 기반 음성 분리 모델들(Streaming Sortformer, Nemotron-3)은 고정된 수의 출력 슬롯을 가져 미리 정한 수의 화자만 인식할 수 있다는 한계가 있었다. eDIAR은 재학습 없이 슬롯 수 제한을 제거한 훈련 자유 방식의 음성 분리 시스템이다. 슬롯 헤드가 활성 화자와 음성 겹침을 결정하고, 모든 슬롯이 사용된 후 e-means 알고리즘으로 하나의 슬롯 내에서 화자 임베딩을 클러스터링한다. 전체 요약 9문장 읽기 → 019 00:11 당일 +109 OpusClip 대체 오픈소스 영상 클립 도구 SupoClip 공개 AI를 활용해 긴 영상(팟캐스트, 스트림 VOD 등)에서 가장 바이럴할 가능성 높은 장면을 자동 선택하고 수직형 9:16 클립으로 렌더링하는 오픈소스 도구다. 오픈소스 · 도구 · FujiwaraChoki/supoclip · Python
Key Point OpusClip이 가진 워터마크·사용량 제한·플랫폼 종속성 문제를 해결한 완전한 오픈소스 대안으로, 셀프호스트 옵션과 API 지원으로 개발자가 직접 운영 가능하다.
핵심 요약
AI를 활용해 긴 영상(팟캐스트, 스트림 VOD 등)에서 가장 바이럴할 가능성 높은 장면을 자동 선택하고 수직형 9:16 클립으로 렌더링하는 오픈소스 도구다. 얼굴 중심 자동 크롭, 단어 단위 동기화 자막, AI 작성 훅 타이틀, 선택적 B-roll 추가 등의 기능을 제공한다. LLM(Gemini, GPT, Claude, 로컬 Ollama)이 트랜스크립트에서 3~7개 클립 구간을 선택하고, 훅·참여도·가치·공유성 점수를 매긴다. 전체 요약 8문장 읽기 → 020 00:11 당일 +111 코드로 벡터 애니메이션을 만드는 Motion Canvas Motion Canvas는 TypeScript 라이브러리와 에디터로 이루어진 애니메이션 제작 도구다. 웹 · 프론트엔드 · motion-canvas/motion-canvas · TypeScript
Key Point 코드 기반 애니메이션 도구로 수프트웨어 튜토리얼, 데이터 시각화, 기술 설명 영상 제작 시 생산성을 크게 높일 수 있다.
핵심 요약
Motion Canvas는 TypeScript 라이브러리와 에디터로 이루어진 애니메이션 제작 도구다. 제너레이터를 활용해 코드로 애니메이션을 프로그래밍할 수 있으며, 실시간 미리보기 에디터를 제공한다. 정보 전달 목적의 벡터 애니메이션과 음성 오버를 동기화하는 데 특화되어 있다. 전체 요약 9문장 읽기 → 021 00:11 ▲ 121 · 댓글 24 기술기업들, 개인 선택 중심 '프라이버시' 개념을 집단감시로 재정의 Apple Watch의 음성 기록, Meta·Google 스마트안경의 카메라, Amazon Bee 기기 등 항상 작동하는 감시 기기들이 속속 출시되고 있다. 보안 · Tech Companies Are Trying to Shift the Concept of Privacy (Again)
Key Point 당신 동의 없이 주변인을 녹음·기록하는 기술이 대중화되려는 시점에서, 기업들이 어떻게 이를 '개인 선택'으로 정당화하려 하는지 알아야 한다.
핵심 요약
Apple Watch의 음성 기록, Meta·Google 스마트안경의 카메라, Amazon Bee 기기 등 항상 작동하는 감시 기기들이 속속 출시되고 있다. 기술기업들은 이런 기기의 기술적 보안 장치를 강조하지만, 이는 기기 사용자만 보호할 뿐 주변인이 녹음·기록되는 것을 막을 방법이 없다. Apple Audio Intelligence·Amazon Bee는 사실상 항상 켜진 마이크로폰이나 다름없으며, 음성을 '요약·필사'로 위장해도 생 음성을 먼저 캡처한다. 전체 요약 9문장 읽기 → 022 21:11 ▲ 102 · 댓글 77 Claude가 화상회의 참여자가 된다 Claude가 화상회의에 직접 참여하는 기능이 베타 출시됐다. AI · 머신러닝 · Claude Meetings
Key Point Claude가 회의에 실시간으로 참여해 문서 작성과 정보 조회, 노트 작성을 자동화하는 방식으로 업무 효율을 크게 변화시킬 수 있기 때문이다.
핵심 요약
Claude가 화상회의에 직접 참여하는 기능이 베타 출시됐다. 팀 멤버는 회의 중 Claude에게 음성이나 채팅으로 질문할 수 있으며, Claude는 기본적으로 텍스트로 답변한다. Claude는 연결된 도구에 접근해 데이터를 찾아 채팅에 공유하거나, 문서·화이트보드 같은 결과물을 실시간으로 작성할 수 있다. 전체 요약 11문장 읽기 → 023 09:11 ▲ 170 · 댓글 95 FM-1 워크벤치, 웹 기반 음악 제작 도구 공개 FM-1 워크벤치는 Web MIDI를 지원하는 웹 브라우저 기반 도구로, 완전한 HTML을 다운로드한 후 오프라인에서 사운드 편집 및 시뮬레이션이 가능하다. 하드웨어 · 시스템 · FM-1 Workbench
Key Point MIDI 음악 제작 기기의 상세한 연결·제어 방식을 이해해야 하는 개발자나 제작자가 웹 인터페이스를 통해 기기를 완벽히 활용할 수 있다.
핵심 요약
FM-1 워크벤치는 Web MIDI를 지원하는 웹 브라우저 기반 도구로, 완전한 HTML을 다운로드한 후 오프라인에서 사운드 편집 및 시뮬레이션이 가능하다. MIDI 연결은 Chrome/Edge 브라우저와 USB 데이터선이 필요하며, 기기와의 읽기/쓰기에는 Web MIDI 지원 및 MIDI/SysEx 허가가 필수다. 기본 입력 채널은 트랙 1~7이 채널 1~7을 사용하고 트랙 8이 채널 10을 사용하며, TRACK ROLE에서 수정 가능하다. 전체 요약 13문장 읽기 → 024 21:11 당일 +338 AI 코딩 에이전트를 위한 로컬 영상 편집기 FFmpeg-Skill 공개 Claude Code, Cursor, Codex와 같은 코딩 에이전트가 사용할 수 있는 로컬 영상 편집 도구 FFmpeg-Skill이 공개되었다. AI · 머신러닝 · kajisho5/ffmpeg-skill · Python
Key Point 클라우드나 API 키 없이 로컬에서 실행되며 에이전트가 정확하게 영상 편집을 수행할 수 있도록 설계된 도구라, AI 코딩 에이전트의 멀티모달 기능 확대와 오프라인 작업 흐름에 영향을 미친다.
핵심 요약
Claude Code, Cursor, Codex와 같은 코딩 에이전트가 사용할 수 있는 로컬 영상 편집 도구 FFmpeg-Skill이 공개되었다. 42개의 FFmpeg 도구를 제공하며, 클라우드나 API 키 없이 Python 표준 라이브러리만으로 동작한다. 각 도구는 명확한 입력 스키마를 가진 argparse 기반 스크립트로, 쉘 명령어 대신 타입이 지정된 인자로 작동한다. 전체 요약 13문장 읽기 → 025 15:11 ▲ 43 · 댓글 3 대화하며 실시간 응답하는 AI 모델 Duo 공개 Hugging Face가 Reciprocal World Model(RWM) 기반의 Duo v1을 발표했으며, 이는 오디오·비디오를 지속적으로 인식하면서 실시간으로 사용자에게 응답하는 풀 듀플렉스 월드 모델이다. AI · 머신러닝 · Duo: A Reciprocal World Model for Full-Duplex Interaction
Key Point 실시간 양방향 상호작용이 가능한 월드 모델은 기존의 단편적 명령 처리를 벗어나 대화 중단, 맥락 변경, 멀티모달 입력을 동시에 처리하는 새로운 AI 상호작용 패러다임을 보여준다.
핵심 요약
Hugging Face가 Reciprocal World Model(RWM) 기반의 Duo v1을 발표했으며, 이는 오디오·비디오를 지속적으로 인식하면서 실시간으로 사용자에게 응답하는 풀 듀플렉스 월드 모델이다. 기존 월드 모델은 물리적 현실 시뮬레이션에만 집중해 추론과 의사결정을 외부 제어로 남겨두지만, RWM은 지능과 물리적 현실을 동등하게 기본으로 취급하며 Intent(상호작용의 인식)와 Realization(음성·영상 행동 생성)이 세계의 일부가 된다. Duo v1의 핵심 기술은 (1) 자회귀 모델링으로 지속적 상호작용 추론과 참여 결정을 수행하고, (2) 청크별 조건과 동기화 토큰으로 Intent와 Realization을 타임라인에 정렬하며 인과 관계를 유지하고, (3) 이중 롤아웃 증류(dual rollout distillation)로 두 모듈의 분포 편향을 완화한다. 전체 요약 5문장 읽기 → 026 03:11 ▲ 108 · 댓글 36 리눅스용 오픈소스 핀볼 시뮬레이션 엔진 개발 중 개발자가 Linux용 완전 오픈소스 핀볼 시뮬레이션 엔진을 만들고 있으며, 2026 IAAPA Expo에서 공개할 예정이다. 오픈소스 · 도구 · I'm Working on a FOSS Linux Pinbal Simulation Engine
Key Point Linux와 오픈소스 커뮤니티에서 아직 부족한 핀볼 시뮬레이션 게임을 처음부터 만드는 프로젝트로, 게임 개발자와 Linux 애호가들에게 새로운 기여 기회를 제공한다.
핵심 요약
개발자가 Linux용 완전 오픈소스 핀볼 시뮬레이션 엔진을 만들고 있으며, 2026 IAAPA Expo에서 공개할 예정이다. 새로운 사운드 시스템은 각 부품별로 음성을 쉽게 추가할 수 있고, 볼 구르는 소리와 슬링샷음 등 물리 기반 음향 감쇄를 지원한다. 물리 엔진을 대폭 개선했으며, 반복 시뮬레이션을 통해 현실감 있는 설정값을 찾아가는 중이다. 전체 요약 10문장 읽기 → 027 21:11 당일 +197 오픈AI 음성 인식 모델 Whisper, 깃허브 트렌딩 OpenAI가 공개한 Whisper는 대규모 약지도 학습으로 학습된 범용 음성 인식 모델이다. 오픈소스 · 도구 · openai/whisper · Python
Key Point 음성 인식이 필요한 개발자라면 오픈소스로 무료 사용할 수 있는 Whisper의 다양한 모델과 다국어 지원, 구체적인 성능 지표를 파악하는 것이 중요하다.
핵심 요약
OpenAI가 공개한 Whisper는 대규모 약지도 학습으로 학습된 범용 음성 인식 모델이다. Transformer 시퀀스-투-시퀀스 구조를 사용하며 다국어 음성 인식, 음성 번역, 언어 식별, 음성 활동 감지 등 여러 음성 처리 작업을 동시에 수행할 수 있다. 특수 토큰을 사용한 멀티태스크 학습 방식으로 전통적인 음성 처리 파이프라인의 여러 단계를 하나의 모델로 통합한다. 전체 요약 10문장 읽기 → 028 21:11 당일 +116 터미널에서 쓰는 AI 코딩 에이전트 Qwen Code 1.0 공개 알리바바 Qwen의 오픈소스 AI 코딩 에이전트 Qwen Code 1.0 Preview를 공개했으며, Qoder의 에이전트 능력과 Qwen Code를 함께 담았다. AI · 머신러닝 · QwenLM/qwen-code · TypeScript
Key Point Claude Code 수준의 기능을 오픈소스로 제공하면서 다중 프로바이더 지원, IDE/채팅 앱 통합, Daemon 모드로 비용 부담 없이 자체 AI 코딩 에이전트를 구축할 수 있게 됐다.
핵심 요약
알리바바 Qwen의 오픈소스 AI 코딩 에이전트 Qwen Code 1.0 Preview를 공개했으며, Qoder의 에이전트 능력과 Qwen Code를 함께 담았다. 터미널, 데스크톱 앱, 웹 UI, IDE 플러그인(VS Code/JetBrains/Zed), 챗 앱(Telegram/DingTalk/WeChat/Feishu) 등 다양한 인터페이스를 지원한다. Auto-Memory, Auto-Skills, SubAgents, Agent Teams, MCP 등을 박스에서 바로 사용할 수 있으며 별도 설정이 필요 없다. 전체 요약 10문장 읽기 → 029 21:11 ▲ 116 · 댓글 26 화웨이, 로컬 추론용 양자화 도구 MACaQ 공개 화웨이가 개발한 MACaQ는 텍스트, 이미지, 비디오, 오디오 모델을 양자화하는 모델 무관 양자화 도구로, llama.cpp, vLLM, Diffusers, PyTorch 등 다양한 백엔드를 지원한다. AI · 머신러닝 · Huawei releases MACaQ, its internal quantizer for local inference
Key Point 로컬 환경에서 대규모 모델을 빠르게 양자화하려는 개발자들에게 성능과 속도 모두 우수한 새로운 도구가 공개되어, 리소스 제한적인 환경에서의 모델 배포 선택지가 확대되었다.
핵심 요약
화웨이가 개발한 MACaQ는 텍스트, 이미지, 비디오, 오디오 모델을 양자화하는 모델 무관 양자화 도구로, llama.cpp, vLLM, Diffusers, PyTorch 등 다양한 백엔드를 지원한다. 122B 파라미터 모델을 64분 내에 32.5GB 메모리만으로 양자화할 수 있으며, MR-GPTQ와 DuQuant++보다 더 낮은 퍼플렉시티를 달성하거나 Llama-3-8B에서 11배 빠른 양자화 시간으로 동등한 성능을 제공한다. llama.cpp 백엔드는 2/3/4비트 GGUF 포맷의 텍스트 생성을 지원하고 CPU 실행도 가능하며, vLLM은 W4A4 또는 가중치 전용 양자화로 텍스트 생성 및 서빙을 지원한다. 전체 요약 8문장 읽기 → 030 09:11 ▲ 224 · 댓글 74 구글, 의사결정 전문 AI API 공개…150ms 내 1000개 질문 처리 구글이 Gemini Decision 1 모델 기반의 Decisions API를 출시했으며, 텍스트·이미지·오디오·비디오·PDF를 포함한 멀티모달 입력에서 최대 1000개의 예/아니오, 선택지, 루브릭 채점 질문을 한 번의 API 호출로 처리할 수 있다. AI · 머신러닝 · Gemini Decisions API
Key Point 의사결정에 특화된 저지연 API가 등장하며 AI 애플리케이션의 라우팅·검증·분류 작업 방식이 바뀌고, 기존 대비 5배 저렴한 가격과 3가지 질문 유형 지원으로 구현 복잡도를 크게 낮춘다.
핵심 요약
구글이 Gemini Decision 1 모델 기반의 Decisions API를 출시했으며, 텍스트·이미지·오디오·비디오·PDF를 포함한 멀티모달 입력에서 최대 1000개의 예/아니오, 선택지, 루브릭 채점 질문을 한 번의 API 호출로 처리할 수 있다. 토큰별 생성이 아닌 단일 포워드 패스 방식으로 동작해 중앙값 50~100ms 모델 계산 시간(엔드투엔드 150~250ms)의 저지연을 유지하며, 최대 16K 토큰 컨텍스트에서 질문 1~100개 구간에서도 거의 선형적인 성능을 보인다. 에이전트 라우팅·추론·랭킹·멀티모달 이해 벤치마크에서 Gemini Decision 1이 최고 성능을 기록했으며, 보정 오류도 가장 낮다. 전체 요약 8문장 읽기 → 031 03:11 ▲ 146 · 댓글 18 파이썬 역사를 함께 만든 팀 피터스 작고 파이썬 창시자 귀도 반 로섬이 핵심 개발자 팀 피터스(Tim Peters, 1952~2026)가 7월 15일 작고했다고 밝혔다. 오픈소스 · 도구 · Tim Peters has died
Key Point 파이썬이 현재의 프로그래밍 언어 생태계에서 차지하는 위치는 팀 피터스의 초기 기여와 문화 형성에 크게 빚지고 있으며, 그의 사망은 개발 커뮤니티에 큰 손실이 됨을 의미한다.
핵심 요약
파이썬 창시자 귀도 반 로섬이 핵심 개발자 팀 피터스(Tim Peters, 1952~2026)가 7월 15일 작고했다고 밝혔다. 피터스는 파이썬 초기부터 기여했으며 정수와 부동소수점 수의 혼합 산술 지원, PEP 20 '파이썬의 선(Zen of Python)' 작성 등 언어 설계에 결정적 영향을 미쳤다. 메일링 리스트에서 '팀봇(Timbot)'으로 불리며 수많은 사용자 질문에 인내심 있게 답변했고, 유머와 따뜻함으로 초기 핵심 개발 문화를 형성했다. 전체 요약 9문장 읽기 → 032 03:11 ▲ 252 · 댓글 137 TV 제조사 17개 질문 '당신은 나를 감시하는가' 기자가 Amazon, Apple, Google, LG, Roku, Samsung, TCL 등 TV·스트리밍 기기 제조사에 프라이버시 관련 17개 질문을 보냈고, 일부 제조사의 답변을 수집해 공개했다. 보안 · I asked every TV manufacturer 17 questions about how they spy on you
Key Point TV 제조사들이 음성·시청 데이터·위치를 수집하는 방식이 제조사마다 크게 다르며, 옵트아웃 후에도 데이터 전송이 계속될 수 있어 실제 프라이버시 보호 수준을 알기 위해 참고할 필요가 있다.
핵심 요약
기자가 Amazon, Apple, Google, LG, Roku, Samsung, TCL 등 TV·스트리밍 기기 제조사에 프라이버시 관련 17개 질문을 보냈고, 일부 제조사의 답변을 수집해 공개했다. 마이크 활성화 조건: Amazon과 Samsung은 버튼 누르거나 웨이크 워드로만 작동한다고 답변했고, LG도 기본값으로 꺼져 있으며 옵트인 후 추가 조치가 필요하다고 답변했다. 음성 저장 및 전송: Amazon은 저장하지 않으며, Google은 '음성 및 오디오 활동'이 명시적으로 켜진 경우만 저장한다고 답변했고, LG는 로컬 처리 후 삭제한다고 답변했다. 전체 요약 12문장 읽기 → 033 00:11 ▲ 18 · 댓글 3 음성 생성 통합 엔드투엔드 프레임워크 WaveGen 공개 WaveGen은 확산 모델 기반의 완전 엔드투엔드 텍스트-파형 생성 프레임워크로, 스펙트럼 강제(Spectral Forcing) 기법으로 내부 스펙트럼 궤적과 대상 파형 궤적을 단일 모델에서 동시 학습한다. AI · 머신러닝 · WaveGen: Truly End-to-End Waveform Generation via Internal Spectral Trajectory Learning
Key Point 기존 음성 합성 파이프라인의 복잡한 멀티스테이지 구조를 완전히 통합하고 외부 모듈 의존성을 제거한 진정한 엔드투엔드 모델로, 음성 생성 시스템의 단순화 가능성을 보여준다.
핵심 요약
WaveGen은 확산 모델 기반의 완전 엔드투엔드 텍스트-파형 생성 프레임워크로, 스펙트럼 강제(Spectral Forcing) 기법으로 내부 스펙트럼 궤적과 대상 파형 궤적을 단일 모델에서 동시 학습한다. 신경 오디오 코덱, 멜-스펙트로그램 보코더, VAE 기반 잠재 모델 등 별도 학습된 중간 표현에 의존하지 않으며, 지속시간 예측기 같은 외부 정렬 모듈 없이 모델 내부에서 텍스트-음성 정렬을 수행한다. BERT 기반 텍스트 임베딩, Wav2Vec 2.0 기반 의미 표현, 의미 증류 같은 자기지도 표현 의존성도 제거해 진정한 엔드투엔드 구조를 유지한다. 전체 요약 7문장 읽기 → 034 06:11 ▲ 101 · 댓글 79 Claude, 공동작업 도구 3종 한 곳에서 제공 Anthropic이 Claude Whiteboards, Claude Sheets, Claude Data 세 가지 협업 도구를 공개했으며, 모두 유료 플랜에서 이용 가능하다. 웹 · 프론트엔드 · Claude Whiteboards, Claude Sheets, and Claude Data
Key Point Claude 인터페이스 내에서 직접 협업 문서·스프레드시트·데이터 시각화를 만들 수 있게 되면서, 외부 도구로 옮기는 번거로움을 없앨 수 있다.
핵심 요약
Anthropic이 Claude Whiteboards, Claude Sheets, Claude Data 세 가지 협업 도구를 공개했으며, 모두 유료 플랜에서 이용 가능하다. Claude Whiteboards는 팀이 Claude와 함께 브레인스토밍하는 공유 보드로, 음성으로 말한 계획을 타임라인·담당자·날짜가 포함된 보드로 변환하고 실시간 협업을 지원한다. Claude Sheets는 프롬프트만으로 탭·수식·서식·드롭다운이 있는 스프레드시트를 생성하고, 셀 수정 시 변경 사항을 추적하며 팀과 함께 편집할 수 있다. 전체 요약 9문장 읽기 → 035 18:12 새 버전 OpenAI Python SDK v3.49.0 출시 OpenAI Python SDK v3.49.0이 출시되었습니다. AI · 머신러닝 · openai/openai-python@v3.49.0
Key Point Python 개발자가 OpenAI API를 사용할 때 타입 안정성이 강화되고 음성 처리 기능이 수정되어 더 안정적인 개발 경험을 얻을 수 있습니다.
핵심 요약
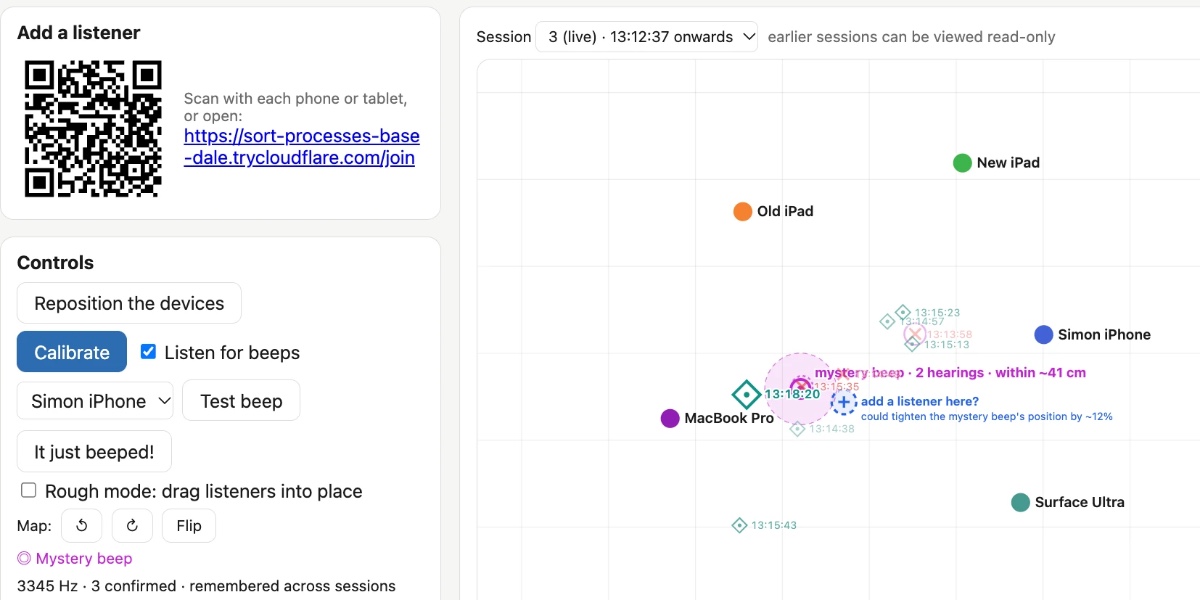
OpenAI Python SDK v3.49.0이 출시되었습니다. 이번 업데이트에서는 async 함수 도구에 대한 타입 지원이 추가되어 비동기 함수 기반 도구 호출이 더 안전해졌습니다. 마이크 녹음을 유효한 PCM WAV 형식으로 인코딩하는 버그가 수정되어 음성 입력 처리가 정상화되었습니다. 036 18:12 ▲ 168 · 댓글 75 AI 음성으로 "정체 모를 소음" 위치 찾다 집의 한 방에서 간헐적으로 울리는 소리의 정체를 파악하기 위해 저자가 Claude Code를 이용해 Beep Locator라는 삼각측량 시스템을 개발했다. AI · 머신러닝 · Locating the source of a mysterious beep
Key Point AI가 코드 작성을 넘어 실시간 센서 데이터를 처리하고 동적으로 자신의 능력을 확장하는 방식을 보여주는 사례로, 코딩 에이전트의 실질적 한계와 가능성을 다룬다.
핵심 요약
집의 한 방에서 간헐적으로 울리는 소리의 정체를 파악하기 위해 저자가 Claude Code를 이용해 Beep Locator라는 삼각측량 시스템을 개발했다. 여러 기기(iPad, 휴대폰, MacBook Pro, Surface Ultra)를 방에 배치해 WebSocket과 웹 마이크를 통해 소리를 감지하고 위치를 계산하는 방식이다. 기기 간 음향 신호로 상대 위치를 자동 계산하되, 수동으로 드래그하는 '러프 모드'를 통해 대략적 위치를 입력하고 정확도를 높인다. 전체 요약 12문장 읽기 → 037 12:11 ▲ 225 · 댓글 613 클로드 페이블·미토스 5.2, 전문가 작업용 초강력 모델 출시 앤스로픽이 클로드 페이블 5.2와 미토스 5.2를 공개했으며, 두 모델은 동일한 기반이지만 페이블에는 사이버보안·생물학 보안 장치가 있어 모든 사용자에게 공개되고, 미토스는 검증 프로그램 신청 시 접근 가능하다. AI · 머신러닝 · Claude Fable 5.2 and Mythos 5.2
Key Point 기업 소프트웨어 마이그레이션부터 블랙홀 이론물리 증명, 신약 전달용 단백질 설계까지 광범위한 분야에서 실제 문제를 해결하는 모델이 나왔으며, 이전 모델 대비 저렴한 가격으로 성능을 크게 향상시켰다.
핵심 요약
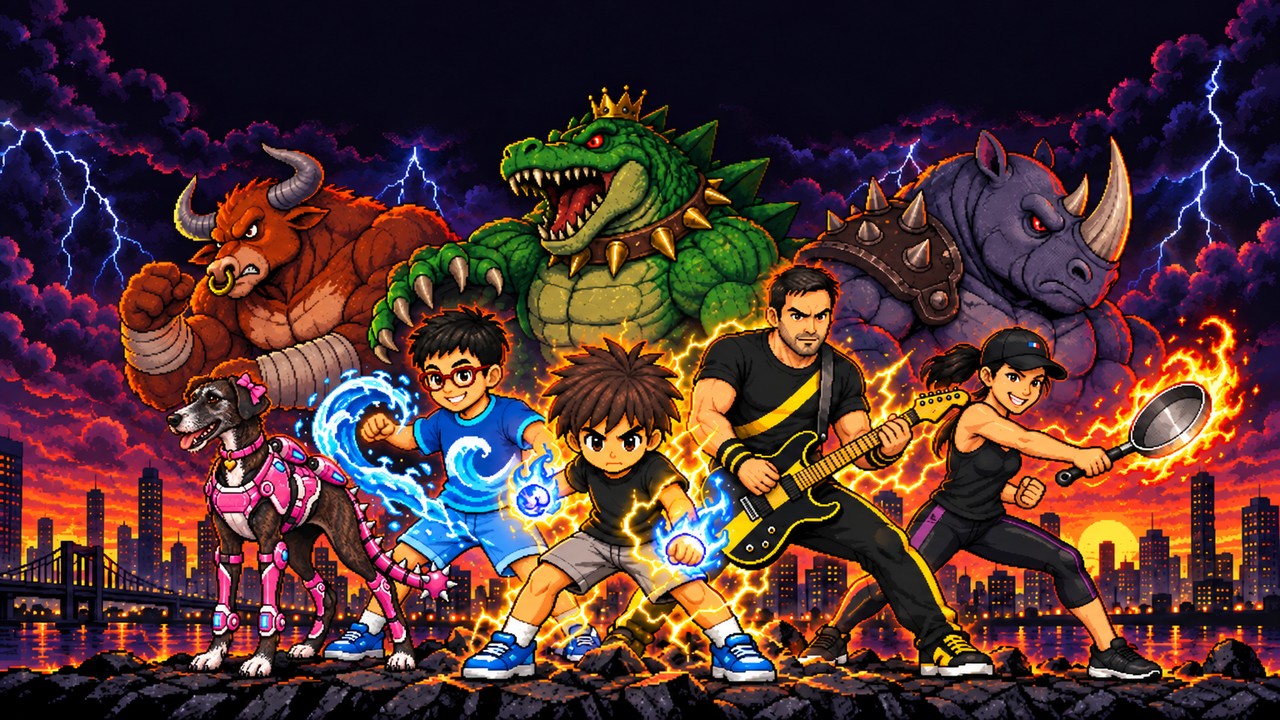
앤스로픽이 클로드 페이블 5.2와 미토스 5.2를 공개했으며, 두 모델은 동일한 기반이지만 페이블에는 사이버보안·생물학 보안 장치가 있어 모든 사용자에게 공개되고, 미토스는 검증 프로그램 신청 시 접근 가능하다. 페이블 5.2와 미토스 5.2는 코딩, 추론, 비전에서 이전 버전 대비 개선되었으며, 입력 토큰당 $8, 출력 토큰당 $40으로 페이블 5.1보다 저렴하고 토큰 생성 속도는 최대 30% 빨라졌다. 선택적 고속 모드는 토큰 생성을 최대 2.5배 빠르게 하며 입력 토큰당 $16, 출력 토큰당 $80이다. 전체 요약 12문장 읽기 → 038 12:11 ▲ 211 · 댓글 145 조카의 그림으로 완전한 게임을 만든 AI 작가는 조카 에이던의 생일 선물로 커스텀 비트 앰 업(베트맨) 게임을 만들어달라는 요청을 받았고, 에이던이 그린 5명의 히어로와 12명의 보스, 스토리 아웃라인을 제공받았다. AI · 머신러닝 · Fable 5.2 one-shotted my nephew's dream game
Key Point AI 에이전트가 한 번의 명령으로 게임 코드, 이미지, 음성, 스토리를 모두 생성해 완전한 작품을 만들 수 있다는 것이 구체적으로 증명됐다.
핵심 요약
작가는 조카 에이던의 생일 선물로 커스텀 비트 앰 업(베트맨) 게임을 만들어달라는 요청을 받았고, 에이던이 그린 5명의 히어로와 12명의 보스, 스토리 아웃라인을 제공받았다. 6월에 Claude Opus 4.8과 Fable 5을 사용해 첫 버전을 완성했지만 2분 정도만 즐길 수 있는 수준이었고, 에이던은 계속 개선을 요청했다. Fable 5.2 출시 후 작가는 '최대한 재미있게, 현대판 닌자거북이 아케이드처럼, 네 명까지 플레이 가능' 같은 지시를 한 프롬프트 하나만 입력하고 밤새 진행시켰다. 전체 요약 11문장 읽기 → 039 06:11 ▲ 162 · 댓글 66 메타, 에이전트 작업용 경량 모델 뮤즈 엠버 공개 메타가 복잡한 추론 실행과 에이전트 작업에 특화된 경량 모델 뮤즈 엠버를 발표했다. AI · 머신러닝 · Our Smallest, Most Efficient Model: Muse Ember
Key Point 에이전트 AI가 상용화되면서 도구 호출과 반복 작업에 최적화된 경량 모델의 필요성이 높아졌는데, 뮤즈 엠버는 기존 모델보다 훨씬 저렴한 비용으로 더 나은 성능을 제시해 생산 AI 시스템의 비용 구조를 바꿀 가능성을 보여준다.
핵심 요약
메타가 복잡한 추론 실행과 에이전트 작업에 특화된 경량 모델 뮤즈 엠버를 발표했다. 뮤즈 엠버는 Claude Haiku 5.5보다 약 3분의 1 비용으로 동일 수준의 성능을 내며, 모든 GPT-4o Luna 설정을 능가한다. 가격 대비 성능 지수에서 Artificial Analysis 전체 리더보드 효율성 경계선에 위치한다. 전체 요약 13문장 읽기 → 040 06:11 ▲ 662 · 댓글 352 Claude Fable 5.2와 Mythos 5.2 공개, 코딩·과학 성능 대폭 향상 Anthropic이 Claude Fable 5.2와 Claude Mythos 5.2를 공개했으며, 두 모델은 같은 기반 모델이지만 Mythos는 사이버보안·생물학 분야 검증 프로그램을 통해 제한적으로 제공된다. AI · 머신러닝 · Claude Fable 5.2 and Mythos 5.2
Key Point Fable 5.2와 Mythos 5.2는 상용 모델 중 가장 복잡한 엔지니어링·연구 작업을 수행할 수 있도록 설계되었으며, 코딩·수학 증명·물리학 문제 해결에서 구체적인 성과를 입증해 AI 실무 활용의 경계를 넓혔다.
핵심 요약
Anthropic이 Claude Fable 5.2와 Claude Mythos 5.2를 공개했으며, 두 모델은 같은 기반 모델이지만 Mythos는 사이버보안·생물학 분야 검증 프로그램을 통해 제한적으로 제공된다. 테스트 결과 Fable 5.2와 Mythos 5.2는 이전 버전 대비 커뮤니케이션이 명확하고, 토큰 생성 속도는 30% 빠르며, 입력 토큰 800만 개당 $8, 출력 토큰 100만 개당 $40으로 가격이 인하됐다. 선택적 fast mode는 토큰 생성을 최대 2.5배 가속하며 입력 토큰당 $16, 출력 토큰당 $80이다. 전체 요약 16문장 읽기 → 041 21:11 당일 +243 Y 콤비네이터 CEO의 AI 에이전트용 메모리 시스템 공개 Y 콤비네이터 회장 개리 탄(Garry Tan)이 자신의 OpenClaw·Hermes 에이전트를 위해 직접 구축한 GBrain이라는 메모리 시스템을 오픈소스(MIT 라이선스)로 공개했다. AI · 머신러닝 · garrytan/gbrain · TypeScript
Key Point AI 에이전트가 일반화되면서 장기 기억과 정보 조회 능력이 결정적 격차가 되는데, Y 콤비네이터 CEO가 직접 쓰며 검증한 프로덕션급 메모리 시스템이 오픈소스로 공개된 것으로, 에이전트 개발자와 기업 팀이 자신의 에이전트에 즉시 적용할 수 있다.
핵심 요약
Y 콤비네이터 회장 개리 탄(Garry Tan)이 자신의 OpenClaw·Hermes 에이전트를 위해 직접 구축한 GBrain이라는 메모리 시스템을 오픈소스(MIT 라이선스)로 공개했다. GBrain은 AI 에이전트에게 제어 가능한 메모리를 부여하며, 명시적 사실을 출처와 함께 저장하고 수정·철회를 지원하고 여러 에이전트 간 메모리 공유를 가능하게 한다. 키워드 검색으로 시작하되 필요할 때 의미론적 검색·종합·배경 강화를 추가할 수 있으며, 자체 호스팅은 무료이고 gbrain.io의 유료 호스팅 옵션이 별도로 있다. 전체 요약 13문장 읽기 → 042 21:11 당일 +324 공유 링크 붙여넣고 고속 다운로드, 윈도우용 YunX 데스크톱 앱 클라우드 저장소 및 동영상 공유 링크를 붙여넣으면 내용을 열람·미리보기·다운로드할 수 있는 윈도우 데스크톱 앱 YunX-Desktop이 공개됐다. 오픈소스 · 도구 · tidain/YunX-Desktop · Kotlin
Key Point 클라우드 저장소와 동영상 플랫폼의 공유 링크를 한 앱에서 통합 관리·다운로드할 수 있으며, 공식 오픈소스로 업그레이드되면서 지속적인 개발과 신뢰성이 보장된다.
핵심 요약
클라우드 저장소 및 동영상 공유 링크를 붙여넣으면 내용을 열람·미리보기·다운로드할 수 있는 윈도우 데스크톱 앱 YunX-Desktop이 공개됐다. 쿼크, UC, 선더, 바이두, 139, 123, 115, 라나토 등 주요 중국 클라우드 저장소와 틱톡, 快手, 웨이보, 소소스, 빌리빌리, AcFun, Pixiv 동영상을 지원하며 자성, BT 종자, ed2k 등 P2P 링크도 다룬다. Range 분할 다중 병렬 + 끊김 지점에서 재개 기능으로 고속 다운로드를 제공하고, 빌리빌리 고화질은 자동으로 음성과 영상을 합성한다. 전체 요약 10문장 읽기 → 043 21:11 ▲ 22 · 댓글 2 상대 위치 어텐션, 구조 인식 커널로 속도·메모리 대폭 개선 RoPE 대신 상대 위치 기반 어텐션 메커니즘은 음성 처리 등에서 뛰어난 성능을 보이지만, 시퀀스가 길어질수록 메모리·대역폭·연산량이 급증하는 병목이 있었다. AI · 머신러닝 · Fast and Exact Relative-Position Attention via Structure-Aware Kernels
Key Point 상대 위치 어텐션이 RoPE 대비 유리한 도메인에서 길이 확장성의 근본적 병목을 해결함으로써, 오디오·장문맥 처리에서 Transformer 적용 범위를 크게 확대할 수 있다.
핵심 요약
RoPE 대신 상대 위치 기반 어텐션 메커니즘은 음성 처리 등에서 뛰어난 성능을 보이지만, 시퀀스가 길어질수록 메모리·대역폭·연산량이 급증하는 병목이 있었다. 이 논문은 FlashAttention 스타일의 타일 기반 연산에 상대 위치 항을 정확히 통합하는 새로운 알고리즘을 제안한다. 오프셋 인식 타일링으로 중복 인덱싱을 제거하고, 키-쿼리 관계 연산을 필요한 만큼만 계산해 토큰 쌍 간에 재사용한다. 전체 요약 7문장 읽기 → 044 21:11 ▲ 101 · 댓글 91 Rust와 egui로 만든 빠른 WhatsApp 데스크톱 클라이언트 ZapFast 공개 Rust와 egui로 작성된 경량 WhatsApp 클라이언트 ZapFast가 Linux, macOS, Windows용으로 공개되었습니다. 오픈소스 · 도구 · ZapFast: A fast, native WhatsApp client in Rust and egui
Key Point 브라우저 기반 WhatsApp Web 대비 메모리 사용량을 6분의 1로 줄인 데스크톱 클라이언트로, Linux·macOS·Windows 사용자들이 더 가볍고 빠른 대안을 얻을 수 있습니다.
핵심 요약
Rust와 egui로 작성된 경량 WhatsApp 클라이언트 ZapFast가 Linux, macOS, Windows용으로 공개되었습니다. 브라우저 엔진 없이 whatsapp-rust를 통해 스마트폰을 동반 기기로 연결하며, Linux에서 1초 이내에 실행되고 유휴 상태에서 약 200MB 메모리를 사용합니다. WhatsApp Web은 1.13GB 메모리를 사용하는 것과 비교하여 ZapFast는 훨씬 가볍습니다. 전체 요약 11문장 읽기 → 045 18:11 ▲ 90 · 댓글 2 스트리밍 음성인식 중 한 번 출력한 텍스트는 절대 수정 안 함 네이즈 유다오가 Confucius4-R2T2라는 스트리밍 음성인식 모델을 공개했으며, 이 모델은 한 번 생성한 텍스트를 절대 수정하지 않으면서도 높은 정확도와 낮은 지연시간을 유지한다. AI · 머신러닝 · Confucius4-R2T2: A Stable-Prefix Streaming ASR Model for Real Real-Time Transcription
Key Point 실시간 번역·음성 에이전트 같은 애플리케이션에서 텍스트 수정으로 인한 오작동을 원천 차단하는 새로운 기술 접근 방식을 보여준다.
핵심 요약
네이즈 유다오가 Confucius4-R2T2라는 스트리밍 음성인식 모델을 공개했으며, 이 모델은 한 번 생성한 텍스트를 절대 수정하지 않으면서도 높은 정확도와 낮은 지연시간을 유지한다. 기존 스트리밍 음성인식 모델은 토큰을 생성한 후 나중에 수정하곤 하는데, 이는 번역기나 음성 에이전트 같은 머신이 잘못된 작업을 수행하게 한다. R2T2는 Qwen3-ASR-1.7B를 중국어와 영어 1,500시간 음성으로 후학습하되, 사전학습된 음성 인코더와 프로젝터는 동결해서 개발했다. 전체 요약 8문장 읽기 → 046 06:11 ▲ 10 · 댓글 3 음성 언어 모델의 응답 지연을 73% 줄이는 추론 기법 청크 단위로 음성을 주고받는 풀듀플렉스 음성 언어 모델은 대기 중 연산 자원이 유휴 상태가 되어 응답과 도구 호출이 지연되는 문제가 있다. AI · 머신러닝 · Decode Before You Hear: Speculative Listening for Chunk-Interleaved Full-Duplex Speech Language Models
Key Point 실시간 음성 대화 AI의 응답 지연을 인간 수준으로 줄이는 기술적 해법이 실제 모델들에서 어떻게 작동하고 얼마나 효과적인지 구체적으로 보여준다.
핵심 요약
청크 단위로 음성을 주고받는 풀듀플렉스 음성 언어 모델은 대기 중 연산 자원이 유휴 상태가 되어 응답과 도구 호출이 지연되는 문제가 있다. 연구팀은 무음을 입력으로 가정해 다음 청크를 미리 생성하는 '스펙큘러티브 리스닝(Speculative Listening)' 기법을 제안했다. 4개 모델 분석 결과 다음 음성 청크가 출력을 바꾸지 않는 경우가 95.3%였고, 변화가 생기는 88%는 첫 번째 출력 토큰부터 시작됐다. 전체 요약 8문장 읽기 → 047 06:11 ▲ 125 · 댓글 39 시각장애 어머니 키패드폰에 안드로이드 16 올린 개발자 시각장애 어머니를 위해 400달러에 구입한 카프시스 스마트비전3 키패드폰이 안드로이드 11에 2024년 4월 보안 패치로 멈춰있고, 앱 충돌로 텔레그램 백그라운드 실행도 불가능했다. 하드웨어 · 시스템 · Porting Android 16 to my blind mother's keypad phone
Key Point 제조사가 불가능하다고 단언한 구형 접근성 폰에 최신 안드로이드를 포팅한 기술적 과정과 경험을 다루며, 시각장애 사용자를 위한 실제 접근성 개선의 맥락을 보여준다.
핵심 요약
시각장애 어머니를 위해 400달러에 구입한 카프시스 스마트비전3 키패드폰이 안드로이드 11에 2024년 4월 보안 패치로 멈춰있고, 앱 충돌로 텔레그램 백그라운드 실행도 불가능했다. 제조사는 안드로이드 12가 '불가능'하다고 주장했지만, JADX 디컴파일과 감시를 통해 카프시스가 libinput.so 시스템 라이브러리에 SV3KeyboardForTalkback 함수를 패칭해 키패드 동작을 구현했음을 발견했다. 라인지OS 23.2(안드로이드 16)를 GSI로 플래시했으나, 서명된 vbmeta 파일 없이 부팅이 거부되고 init이 크래시 로그를 표시하지 않아 문제 해결이 막혔다. 전체 요약 13문장 읽기 → 048 03:11 ▲ 101 · 댓글 43 유튜브 TV에서 자동으로 스폰서 광고 건너뛰는 오픈소스 도구 SponsorBlock API를 활용해 Apple TV, 삼성TV, LG TV, Android TV, Chromecast, Google TV, Roku, Fire TV, 닌텐도 스위치, Xbox, PlayStation 등 다양한 TV 기기에서 유튜브 영상의 스폰서 구간과 인트로를 자동으로 건너뛰는 자체 호스팅 애플리케이션인 iSponsorBlockTV를 공개했다. 오픈소스 · 도구 · ISponsorBlockTV: SponsorBlock client for all YouTube TV clients
Key Point TV에서 유튜브를 볼 때 성가신 광고와 스폰서 구간을 자동으로 제거할 수 있는 방법으로, 기존에 PC나 모바일에서만 가능했던 SponsorBlock을 TV 플랫폼 전반에 확대하는 첫 구현이다.
핵심 요약
SponsorBlock API를 활용해 Apple TV, 삼성TV, LG TV, Android TV, Chromecast, Google TV, Roku, Fire TV, 닌텐도 스위치, Xbox, PlayStation 등 다양한 TV 기기에서 유튜브 영상의 스폰서 구간과 인트로를 자동으로 건너뛰는 자체 호스팅 애플리케이션인 iSponsorBlockTV를 공개했다. 유튜브 광고에서 '광고 건너뛰기' 버튼이 나타나는 순간 자동으로 클릭하고 음소거하는 기능도 지원한다. TV 기기가 같은 네트워크에 있을 때는 자동 탐색으로 연결되며, 같은 네트워크가 아니면 유튜브 TV 애플리케이션 설정 페이지에서 코드를 입력해 수동으로 추가할 수 있다. 전체 요약 5문장 읽기 → 049 18:15 스타 1,140 AI가 코드로 영상 만든다…cinecode 오픈소스 공개 AI 코딩 에이전트가 영상 제작의 전 과정을 자동화하는 오픈소스 'cinecode'를 깃허브에서 공개했다. AI · 머신러닝 · sarpstar/cinecode · Python
Key Point 코드 기반 영상 자동 제작으로 광고·설명영상·다큐 같은 콘텐츠를 개발자가 직접 만들 수 있게 되며, 이는 영상 제작 진입장벽을 낮추고 반복 제작 업무를 대폭 줄인다.
핵심 요약
AI 코딩 에이전트가 영상 제작의 전 과정을 자동화하는 오픈소스 'cinecode'를 깃허브에서 공개했다. 사용자가 한 문장으로 아이디어를 입력하면 AI가 각본을 작성하고, 모든 프레임을 코드로 렌더링하고, 음향 디자인을 거쳐 MP4 파일을 제공한다. 짧은 영상·장편 다큐·광고·뮤직비디오 등 다양한 포맷을 지원하며, 빠른 모드(약 3분에 완성)와 필름 모드(단계적 검수)로 나뉜다. 전체 요약 9문장 읽기 → 050 18:15 스타 1,596 파이썬으로 만드는 빗소리·번개 시뮬레이터 Python, Pygame, NumPy, SciPy를 이용한 절차적 빗소리와 폭풍우 시뮬레이터를 구현한 저장소이다. 오픈소스 · 도구 · AhmadHassan-BTed/RainGeneratorPy · Python
Key Point 게임 개발이나 멀티미디어 프로젝트에 쓸 수 있는 프로덕션급 오픈소스 시뮬레이터이며, 절차적 오디오 생성과 입자 물리 구현을 학습할 수 있다.
핵심 요약
Python, Pygame, NumPy, SciPy를 이용한 절차적 빗소리와 폭풍우 시뮬레이터를 구현한 저장소이다. 다층 패럴랙스 강우, 입자 물리 기반 수심파, 프랙탈 분기 번개 생성, 실시간 절차적 음성 합성을 지원한다. 음성 합성은 로우패스 필터링된 빗소리, 감쇠 사인파로 빗방울 영향음, 바람 속도 반응 풍음, 음속 물리 기반 천둥 지연 재생을 포함한다. 전체 요약 8문장 읽기 → 051 18:15 스타 1,578 한 서버에서 돌리는 AI 라이브 진행자 오픈소스 한 대의 서버에서 음성·얼굴·채팅·기억·포스팅을 갖춘 AI 라이브 진행자 시스템 오픈소스 공개했다. AI · 머신러닝 · jacke-pp/open-yoki · JavaScript
Key Point AI 라이브 진행자를 자신의 진행자·음성으로 구축하려는 크리에이터나 스트리머에게 완전한 오픈소스 시스템을 제공하며, 웹3·AI 커뮤니티에서 진행자 자동화 기술의 실제 구현 사례를 보여준다.
핵심 요약
한 대의 서버에서 음성·얼굴·채팅·기억·포스팅을 갖춘 AI 라이브 진행자 시스템 오픈소스 공개했다. 유저 음성을 복제한 성우와 실시간 디지털 아바타로 출연하며, 시청자 댓글을 읽고 답하고, 단골 시청자를 기억하고, 일기를 쓰고, 자동으로 포스팅하고, 정해진 일정에 방송을 시작·종료한다. 바이낸스 광장(또는 RTMP를 받는 모든 플랫폼)과 자체 웹 직방에 동시 송출되며, 헤드리스 Chrome이 16:9 화면(아바타·자막·시세 패널·선물·팔로우 감사·음악·음향 효과)을 생성하고 ffmpeg로 RTMP 푸시한다. 전체 요약 13문장 읽기 → 052 18:15 스타 1,469 Pika H3 Flex: 영상·음성 생성 AI 로컬 추론 오픈소스화 Pika H3 Flex는 MiniMax-H3을 기반으로 한 포스트트레이닝 모델로, 전문 콘텐츠 제작자를 위해 텍스트와 멀티모달 참조 입력으로 동기화된 영상과 음성을 생성한다. AI · 머신러닝 · Pika-Labs/Pika-H3-Flex · Python
Key Point 전문 크리에이터가 로컬 PC에서 고제어 텍스트·참조 기반 영상 생성을 무료로 시작할 수 있으며, 프롬프트나 프레임으로 카메라 움직임까지 직접 조종할 수 있는 열린 플랫폼이 나왔다.
핵심 요약
Pika H3 Flex는 MiniMax-H3을 기반으로 한 포스트트레이닝 모델로, 전문 콘텐츠 제작자를 위해 텍스트와 멀티모달 참조 입력으로 동기화된 영상과 음성을 생성한다. 6단계 샘플링으로 480p·768p 네이티브 해상도(11개 종횡비 지원)에서 5~15초 영상을 생성하며, 24fps 스테레오 음성이 MP4에 혼합된다. FL2VA 어댑터는 텍스트 또는 첫프레임/마지막프레임 조건 입력을, Ref2VA 어댑터는 최대 12개 참조(이미지 9개·영상 3개·오디오 3개)를 지원한다. 전체 요약 10문장 읽기 → 053 18:15 스타 1,714 Cicada, 모든 화상회의에서 실시간 다언어 자막과 회의록 생성 Cicada(知了)는 Zoom, 플리소우, 텐센트 회의, X Spaces, YouTube 라이브 등 모든 화상회의와 스트림에서 실시간 다국어 자막, 번역, 구조화된 회의록을 생성하는 무료 오픈소스 도구다. 오픈소스 · 도구 · wquguru/cicada · Swift
Key Point 다중 플랫폼에서 로컬 프라이버시를 보존하면서 무료로 회의 실시간 번역·기록 기능을 제공해, 국제 화상회의나 팀 협업 시 언어 장벽을 없앨 수 있다.
핵심 요약
Cicada(知了)는 Zoom, 플리소우, 텐센트 회의, X Spaces, YouTube 라이브 등 모든 화상회의와 스트림에서 실시간 다국어 자막, 번역, 구조화된 회의록을 생성하는 무료 오픈소스 도구다. Mac(Apple 칩 / Intel), Windows, Linux, Android 플랫폼 모두 지원하며, Mac은 공식 다운로드 페이지와 GitHub Releases에서 설치 가능하다. Apple 칩 Mac에서는 음성 인식·언어 인식·음성 인식 및 회의 녹음이 모두 로컬에서 완료되고, 텍스트만 번역 및 회의록 작성을 위해 외부로 전송된다. 전체 요약 12문장 읽기 → 054 18:15 스타 2,306 Claude로 유튜브 쇼츠 만드는 무료 스킬 공개 Claude Code에서 쓸 수 있는 무료 애니메이션 단편 제작 스킬을 공개했다. 웹 · 프론트엔드 · mromidev/claude-animated-shorts · TypeScript
Key Point 직접 PC에서 고품질 애니메이션 쇼츠를 만들 수 있는 완전한 파이프라인과 학습 자료를 무료로 받을 수 있어, 창작자들이 외부 AI 동영상 생성 서비스에 의존하지 않고도 같은 수준의 결과물을 만들 수 있게 되었다.
핵심 요약
Claude Code에서 쓸 수 있는 무료 애니메이션 단편 제작 스킬을 공개했다. 55~70초 세로형 영상으로, 2D 캐릭터가 3D 세계에서 움직이는 구조다. three.js와 Remotion을 써서 자신의 PC에서 렌더링하며, AI 영상 생성 도구는 쓰지 않는다. 전체 요약 9문장 읽기 → 055 18:15 스타 1,867 한 장의 사진으로 AI 디지털 휴먼 영상 제작 한 장의 사진과 한 문장의 대사만으로 립싱크된 AI 디지털 휴먼 톡헤드 영상을 자동으로 생성한다. AI · 머신러닝 · andyhuo520/digital-human-koubo · TypeScript
Key Point Claude Code·Codex 같은 에이전트와 직접 통합되는 AI 동영상 자동화 도구로, 유튜브 톱 크리에이터의 편집 기법을 분석한 48개 컴포넌트와 견적 제어 시스템을 갖춘 프로덕션급 워크플로우가 처음 공개됐다.
핵심 요약
한 장의 사진과 한 문장의 대사만으로 립싱크된 AI 디지털 휴먼 톡헤드 영상을 자동으로 생성한다. Grok Video 1.5를 통해 최대 15초 단위 영상 클립을 생성하고, 음성은 별도 처리 후 스펙트럼 매칭으로 통일해 30개 이상의 분리된 클립이 하나의 녹음처럼 들리도록 한다. 유튜브 톱 크리에이터 25명의 영상을 프레임 단위로 분석해 추출한 48개의 패키징 컴포넌트(오프닝, 증거 카드, 주석, 리듬 효과 등)를 제공한다. 전체 요약 12문장 읽기 → 056 18:15 스타 3,847 비디오 제작 방식을 자동 분석하는 오픈소스 도구 'rea-video' 영상을 샷 단위로 분석해 실제 촬영, AI 생성, 코드 기반 제작 여부를 자동으로 판별하는 파이썬 기반 CLI 도구다. AI · 머신러닝 · JuneYaooo/rea-video · Python
Key Point 비디오 콘텐츠 제작의 주요 성분(실사/AI/코드)을 정확히 판별할 수 있으면, 제작 기법 학습 비용을 대폭 낮추고 비슷한 스타일의 콘텐츠를 빠르게 만들 수 있다.
핵심 요약
영상을 샷 단위로 분석해 실제 촬영, AI 생성, 코드 기반 제작 여부를 자동으로 판별하는 파이썬 기반 CLI 도구다. 카메라 위치·조명 설정·색보정·렌즈 정보 등 촬영 기법, AI 영상의 역엔지니어링 프롬프트와 배치 전략, 3D/애니메이션의 렌더링 여부, 코드 기반 UI/타이포그래피의 타이밍, 화면 녹화 범위를 각각 구분해 보고한다. 자막·이모티콘·편집점·음성(인간/AI)·음악(BPM 포함)·효음의 위치와 지속 시간도 추출하며, SRT/ASS 자막 형식으로 내보낼 수 있다. 전체 요약 9문장 읽기 → 057 18:15 스타 7,663 안드로이드 폰에서 일을 자동으로 처리하는 AI 에이전트 미카 음성 명령으로 앱을 조작하고 웹을 브라우징하는 온디바이스 AI 에이전트 Mika를 깃허브에 오픈소스로 공개했다. AI · 머신러닝 · wangzan101/Mika · Kotlin
Key Point 폰을 손대지 않고 음성만으로 앱과 웹 작업을 자동 처리하는 온디바이스 AI가 실제로 어떻게 동작하는지, 누가 어떻게 설정해서 사용하는지 알 수 있다.
핵심 요약
음성 명령으로 앱을 조작하고 웹을 브라우징하는 온디바이스 AI 에이전트 Mika를 깃허브에 오픈소스로 공개했다. 사용자가 말한 작업을 배경 화면에서 자동으로 수행하며, 메인 화면에서 폰을 계속 사용할 수 있다. 앱 API 없이 화면을 분석해 버튼을 찾고 탭·입력·스크롤하며, 어떤 앱이나 웹사이트에서도 작동한다. 전체 요약 12문장 읽기 → 058 03:11 당일 +129 AI 어시스턴트를 직접 배포하고 모든 채널에서 운영하기 자체 문서 기반 AI 어시스턴트를 웹, WhatsApp, 이메일, Outlook, Nextcloud, ownCloud에 한 번에 배포할 수 있는 오픈소스 플랫폼 Synaplan을 공개했다. AI · 머신러닝 · metadist/synaplan · PHP
Key Point 조직이 자체 문서와 데이터를 바탕으로 AI 어시스턴트를 완전히 제어하며 배포할 수 있는 엔드투엔드 플랫폼이 오픈소스로 공개되었기 때문에, 개인정보 보호와 비용 투명성을 중시하는 팀에게 선택지가 생겼다.
핵심 요약
자체 문서 기반 AI 어시스턴트를 웹, WhatsApp, 이메일, Outlook, Nextcloud, ownCloud에 한 번에 배포할 수 있는 오픈소스 플랫폼 Synaplan을 공개했다. OpenAI, Anthropic, Google, Mistral 같은 클라우드 모델과 Ollama를 통한 로컬 모델을 섞어서 쓸 수 있으며, 각 답변마다 사용한 모델과 비용을 표시한다. Docker Compose로 5~15분 내에 시작할 수 있고, 자체 서버나 EU 클라우드에 설치하거나 완전히 폐쇄된 네트워크에 배포할 수 있다. 전체 요약 8문장 읽기 → 059 00:11 ▲ 323 · 댓글 97 Need for Speed Underground 2 브라우저에서 즐긴다 원래 PC 게임인 Need for Speed Underground 2를 웹브라우저에서 플레이할 수 있도록 포팅했다. 기타 · Need for Speed Underground 2 online in the browser
Key Point 20년 전 게임을 브라우저에서 무료로 다시 즐길 수 있게 된 것과, 추가 비용 없이 멀티플레이어 레이싱을 즉시 시작할 수 있다는 점이 의미 있다.
핵심 요약
원래 PC 게임인 Need for Speed Underground 2를 웹브라우저에서 플레이할 수 있도록 포팅했다. Chrome과 Firefox에서 실행되며 최대 120fps의 와이드스크린으로 즐길 수 있고 자유로운 레이스 및 친구들과의 온라인 레이스가 가능하다. 게임 패드·휠·터치 조종이 모두 지원된다. 전체 요약 8문장 읽기 → 060 21:11 당일 +120 안드로이드에서 작동하는 AI 에이전트 플랫폼 Operit 공개 Operit AI는 안드로이드용 오픈소스 AI 에이전트 플랫폼으로, 클라우드 모델과 로컬 모델을 지원하며 도구 호출·워크플로우·확장 기능(ToolPkg, MCP, Skills)을 통해 정보 검색·파일 처리·코드 개발·기기 자동화 같은 실제 작업을 수행한다. AI · 머신러닝 · AAswordman/Operit · Kotlin
Key Point 안드로이드 스마트폰이 개발 도구이자 AI 에이전트 플랫폼으로 동작하는 방식과 기술 스택을 이해할 필요가 있으며, 로컬·클라우드 모델 통합, 자동화, 개발 환경 구성 방식이 모바일 개발자와 AI 시스템 통합에 관심 있는 개발자에게 참고 기준이 된다.
핵심 요약
Operit AI는 안드로이드용 오픈소스 AI 에이전트 플랫폼으로, 클라우드 모델과 로컬 모델을 지원하며 도구 호출·워크플로우·확장 기능(ToolPkg, MCP, Skills)을 통해 정보 검색·파일 처리·코드 개발·기기 자동화 같은 실제 작업을 수행한다. 태스크 지향형 에이전트 작업 공간을 제공하며, 첨부 파일·작업 공간 컨텍스트·도구 실행 진행 상황·파일 변경 사항·다중 턴 작업을 지원한다. OpenAI·Anthropic·Gemini 등 여러 클라우드 모델을 연결할 수 있고, MNN 모델이나 llama.cpp를 통한 GGUF 모델로 로컬 추론을 실행하거나 Ollama·LM Studio 같은 로컬 모델 서비스와 연동할 수 있다. 전체 요약 13문장 읽기 → 061 12:11 ▲ 104 · 댓글 88 촘스키 vs 확률 모델, 언어학의 두 문화 촘스키의 확률 모델 비판에 대해 핑커의 질문으로부터 출발한 에세이로, 통계 모델의 성공 이유를 다룬다. AI · 머신러닝 · Chomsky and the two cultures of statistical learning (2011)
Key Point 통계 기반 언어 모델의 지배적 성공이 정당한지, 아니면 촘스키 식 형식 이론이 올바른 길인지를 놓고 벌어진 언어학의 근본적 논쟁을 명확히 이해할 수 있다.
핵심 요약
촘스키의 확률 모델 비판에 대해 핑커의 질문으로부터 출발한 에세이로, 통계 모델의 성공 이유를 다룬다. 2차 마르코프 모델로 10만 개 어휘를 표현하려면 1경(10¹⁵) 개의 확률값이 필요하며, 이는 데이터 통계 학습과 평활화 기법 없이는 불가능하다. 이상 기체 법칙처럼 확률·통계 모델이 현실을 완벽히 설명하지 못해도 정확한 예측과 통찰력을 제공할 수 있음을 보인다. 전체 요약 10문장 읽기 → 062 03:11 ▲ 217 · 댓글 166 구글, 제미니 오므니 1.2 플래시 공개 — 15초 동영상에 가격 30% 인하 구글이 제미니 오므니 1.2 플래시를 일반 공개했으며 가격을 30% 인하해 720p 동영상 기준 초당 0.07달러로 책정했다. AI · 머신러닝 · Gemini Omni 1.2 Flash
Key Point 영상 AI 모델의 실용성이 근본적으로 바뀌고 있습니다. 가격 인하와 15초 네이티브 생성, 다중 턴 편집은 상업 영상 제작 워크플로우를 단순화하고, 기존 스튜디오 작업 방식과 경쟁할 수 있는 규모를 만들고 있습니다.
핵심 요약
구글이 제미니 오므니 1.2 플래시를 일반 공개했으며 가격을 30% 인하해 720p 동영상 기준 초당 0.07달러로 책정했다. 기존 10초 제한에서 15초까지 동영상 생성이 가능하며 1초 단위로 3~15초 범위에서 지정할 수 있다. 캐릭터, 제품, 스타일 이미지와 최대 3초 모션 클립, 오디오 큐를 함께 입력하면 처음부터 끝까지 일관된 참조 유지로 가상 피팅, 상품 스핀, 브랜드 광고 제작이 용이해졌다. 전체 요약 11문장 읽기 → 063 12:54 ▲ 588 · 댓글 294 카기, 회원가입 없이 무료 50회 검색 지원 카기는 가입 없이도 누구나 웹사이트를 방문해 50회까지 무료로 검색할 수 있도록 변경했으며, 가입하면 추가로 100회를 더 이용할 수 있다. 웹 · 프론트엔드 · Search for everyone
Key Point 광고 없는 검색 서비스 카기가 가입 장벽을 제거하면서, 구글의 학교 AI 정책을 비판하고 대안을 제시하는 등 검색 엔진 시장의 경쟁이 심화되는 상황을 보여준다.
핵심 요약
카기는 가입 없이도 누구나 웹사이트를 방문해 50회까지 무료로 검색할 수 있도록 변경했으며, 가입하면 추가로 100회를 더 이용할 수 있다. 구글이 2027년 초부터 학교 계정에서 AI 도구를 기본 비활성화하면서 Google Search까지 함께 꺼진다고 지적하며, 학교들이 카기 같은 대체 서비스를 검토할 것을 촉구했다. 안드로이드 앱에서 홈 화면을 재설계하고 음성 검색을 재구축했으며, 결과 페이지의 검색 바와 탭이 네이티브로 표시되고 스크롤 시 숨겨진다. 전체 요약 13문장 읽기 → 064 03:11 ▲ 115 · 댓글 7 27년 묵은 N64도 울게 만드는 초경량 음성 코덱 N64의 저장 공간과 CPU 제약을 극복하기 위해 개발된 ULC(Ultra Low Complexity Codec)라는 신규 음성 코덱이 완성되었다. 하드웨어 · 시스템 · Obscure audio codec is a perfect fit for the N64
Key Point 27년 전 콘솔에서 현대 음성 압축 표준(Opus 수준) 품질을 CPU 부담 거의 없이 구현한 설계의 우아함과 실제 포팅 과정이 보여주는 하드웨어 제약 극복의 실례.
핵심 요약
N64의 저장 공간과 CPU 제약을 극복하기 위해 개발된 ULC(Ultra Low Complexity Codec)라는 신규 음성 코덱이 완성되었다. N64는 PlayStation과 달리 카트리지 용량이 극도로 제한되어 있었고, Nintendo의 ADPCM은 4배 압축을 제공했지만 5분 스테레오 음악에 12MB가 필요했으며, MP3는 재생이 너무 무거워 배경 음악에 사용할 수 없었다. ULC는 MP3처럼 MDCT 변환을 사용하는 트랜스폼 코덱이지만 복잡한 대역 분할과 허프만 인코딩 없이 4비트 단위(니블) 간단한 구문으로 계수를 저장해, MP3의 핵심만 남기고 불필요한 복잡성을 제거했다. 전체 요약 8문장 읽기 → 065 00:11 ▲ 121 · 댓글 78 디스코드, Electron 버리고 Rust 기반 앱으로 전환 디스코드가 Electron 프레임워크를 포기하고 데스크톱 앱을 Rust로 완전히 옮기고 있다. 웹 · 프론트엔드 · Discord is ditching Electron and its new app uses less RAM
Key Point Electron 앱의 메모리 낭비 문제를 해결하는 업계 주요 사례로, 다른 개발자들의 기술 선택에도 영향을 미칠 수 있다.
핵심 요약
디스코드가 Electron 프레임워크를 포기하고 데스크톱 앱을 Rust로 완전히 옮기고 있다. Electron은 웹 기술로 크로스플랫폼 앱을 만들 수 있지만 시스템 리소스를 많이 소비하는 것이 문제다. 디스코드는 2018년부터 Rust를 도입했으며 현재 인프라, 음성 기술, 일부 클라이언트 코드가 이미 Rust로 작성되어 있다. 전체 요약 7문장 읽기 → 066 21:11 당일 +245 마이크로소프트, 음성 AI 모델 제품군 VibeVoice 공개 마이크로소프트가 오픈소스 음성 AI 모델 패밀리 VibeVoice를 공개했으며, 음성 인식(ASR)과 음성 합성(TTS) 모두 지원한다. AI · 머신러닝 · microsoft/VibeVoice · Python
Key Point 음성 인식·합성을 통합한 장시간 음성 처리의 새로운 기준을 제시하며, CPU 기반 엣지 배포부터 클라우드 추론까지 다양한 환경에서 실무 적용 가능성을 높인 기술이다.
핵심 요약
마이크로소프트가 오픈소스 음성 AI 모델 패밀리 VibeVoice를 공개했으며, 음성 인식(ASR)과 음성 합성(TTS) 모두 지원한다. 핵심 기술은 7.5Hz 초저속도의 연속 음성 토크나이저(Acoustic, Semantic)를 사용해 음질을 보존하면서도 긴 시퀀스 처리 효율을 높인다. VibeVoice-ASR은 60분 길이의 음성을 한 번에 처리하며, 화자 식별, 타임스탐프, 내용을 포함한 구조화된 전사를 생성한다. 전체 요약 11문장 읽기 → 067 12:11 ▲ 116 · 댓글 15 10년 추적 끝에 DOS 윙커맨더 협력 플레이 구현 저자와 형 패트릭은 어린 시절 한 명이 조종하고 한 명이 무기를 담당하며 플레이하던 윙커맨더를 협력 멀티플레이로 즐기고 싶었다. 오픈소스 · 도구 · Show HN: After a decade of reversing, I got co-op working in DOS Wing Commander
Key Point 메모리 리버싱, 함수 훅킹, 네트워킹 프로토콜 설계를 10년간 반복해 고전 게임을 협력 플레이로 개조한 해킹의 전 과정을 담아 저수준 게임 개조와 에뮬레이터 조작의 실제 사례를 보여준다.
핵심 요약
저자와 형 패트릭은 어린 시절 한 명이 조종하고 한 명이 무기를 담당하며 플레이하던 윙커맨더를 협력 멀티플레이로 즐기고 싶었다. 2015년 10월 DOSBox에서 게임의 모든 메모리가 640KB 안에 들어간다는 점을 발견하고, 플레이어와 윙맨의 X·Y·Z 좌표를 메모리 덤프로 찾기 시작했다. 정지 상태에서 메모리 스냅샷을 두 번 떠서 변하지 않는 배경 데이터를 제거한 뒤, 이동 시 변하는 값들을 비교해 413바이트 중 132바이트로 좌표 위치를 좁혀냈다. 전체 요약 15문장 읽기 → 068 03:11 당일 +296 경량 화이자앱 클라이언트 'ZapFast' 공개 Rust와 egui로 만든 네이티브 WhatsApp 클라이언트 ZapFast가 Linux, macOS, Windows에서 이용 가능하다. 오픈소스 · 도구 · crmne/zapfast · Rust
Key Point WhatsApp Web의 1/5 메모리 사용량과 1초 이내 실행 속도로 더 가벼운 데스크톱 메시징 경험을 제공하며, 오픈소스로 공개되어 커뮤니티 참여가 가능하다.
핵심 요약
Rust와 egui로 만든 네이티브 WhatsApp 클라이언트 ZapFast가 Linux, macOS, Windows에서 이용 가능하다. 휴대폰을 companion 기기로 연결하는 방식으로, whatsapp-rust 라이브러리를 통해 WhatsApp 기능을 지원한다. Linux에서 1초 이내로 실행되고 유휴 메모리 200MB를 사용하는 반면, WhatsApp Web은 1.13GB를 소비한다. 전체 요약 13문장 읽기 → 069 00:11 ▲ 100 · 댓글 48 LLM 용의자 심문하는 추리 게임 '언크래크드 시티' 출시 실제 도시를 배경으로 한 추리 게임으로, 플레이어가 장소를 수색하고 거짓말하는 LLM 용의자들을 심문해 범인을 찾아내는 게임이다. AI · 머신러닝 · Show HN: Uncracked City, detective game where you question LLM suspects that lie
Key Point LLM의 거짓 탐지 능력을 핵심 게임플레이로 삼은 새로운 형식의 추리 게임으로, 대화형 AI가 게임 엔터테인먼트에 어떻게 활용될 수 있는지 보여준다.
핵심 요약
실제 도시를 배경으로 한 추리 게임으로, 플레이어가 장소를 수색하고 거짓말하는 LLM 용의자들을 심문해 범인을 찾아내는 게임이다. 용의자마다 고유한 음성으로 응답하며, 타이핑이나 음성으로 자유롭게 질문할 수 있고 6개 언어를 지원한다. 실마리를 단서와 대조해 거짓을 드러낸 뒤 수사 보고서를 작성하되, 3회 시도 내에 정답을 맞춰야 한다. 전체 요약 6문장 읽기 → 070 21:11 당일 +667 AI 에이전트를 위한 콘텐츠 생성 스킬 모음 공개 Scenario가 AI 코딩 에이전트(Claude Code, Cursor, Copilot 등 70개 이상)를 위한 에이전트 스킬을 공개했다. AI · 머신러닝 · scenario-labs/skills · Python
Key Point 생성형 AI를 활용한 콘텐츠 제작의 대규모 자동화를 원하는 개발자나 크리에이티브 팀이 직접 검토해볼 수 있는 체계적인 도구 모음이다.
핵심 요약
Scenario가 AI 코딩 에이전트(Claude Code, Cursor, Copilot 등 70개 이상)를 위한 에이전트 스킬을 공개했다. Scenario MCP 서버를 통해 이미지, 비디오, 오디오, 텍스처, 스카이박스, 3D 에셋 등 프로덕션급 콘텐츠를 생성할 수 있다. 게임 아트용 스프라이트, 타일셋, 아이콘부터 영상 광고, 음악, 음성, 자막 생성까지 100개 이상의 세분화된 스킬을 제공한다. 전체 요약 9문장 읽기 → 071 21:11 당일 +120 AI 에이전트를 위한 실무형 스킬 모음 오픈소스 Claude Code, Cursor, Codex 등 AI 코딩 에이전트를 위한 프로덕션급 스킬 모음을 오픈소스로 공개했다. 웹 · 프론트엔드 · ConardLi/garden-skills · JavaScript
Key Point AI 에이전트를 실제 업무에 활용하려는 개발자에게 즉시 쓸 수 있는 전문 스킬 6종을 한곳에서 제공하므로, 각 기능별 서로 다른 도구와 프롬프트를 찾아 조합하는 번거로움을 없애준다.
핵심 요약
Claude Code, Cursor, Codex 등 AI 코딩 에이전트를 위한 프로덕션급 스킬 모음을 오픈소스로 공개했다. 모션 그래픽·영상 생성(motion-showreel), 웹 프레젠테이션(web-video-presentation), 웹 디자인·프론트엔드(web-design-engineer), 이미지 생성(gpt-image-2), 기사 편집·디자인(beautiful-article), 로컬 지식 검색(kb-retriever) 등 6개 스킬을 포함한다. motion-showreel은 결정성 render(t) 파이프라인으로 MP4를 생성하며, 음성·음악·효과음을 통합 타임라인으로 관리하고 최대 20분 분량을 지원한다. 전체 요약 10문장 읽기 → 072 21:11 당일 +984 광디스크에 눈에 보이는 그림을 새기는 도구 공개 Disc Image Studio는 CD·DVD·단층 BD-R 블루레이 광디스크 표면에 육안으로 보이는 패턴을 새길 수 있는 크로스플랫폼 도구다. 오픈소스 · 도구 · JiaFeiMiao-K-Cat/DiscImageStudio · C#
Key Point 오픈소스 개발자들이 만든 도구로 CD·DVD·블루레이 표면에 실제로 보이는 그림을 새길 수 있다는 독특한 기술이 구현되어 있고, 보정 알고리즘의 정확도 향상과 다양한 출력 형식 지원으로 실용성이 높다.
핵심 요약
Disc Image Studio는 CD·DVD·단층 BD-R 블루레이 광디스크 표면에 육안으로 보이는 패턴을 새길 수 있는 크로스플랫폼 도구다. 이미지를 입력하면 CD·DVD·블루레이의 물리층 제약을 만족하는 데이터로 변환해 생성된 ISO·RAW·WAV+CUE 파일로 내보내거나 공백 디스크에 직접 기록할 수 있다. CD는 WAV 음성 트랙 및 CUE 파일, DVD는 ISO 미러, BD-R은 UDF 2.01 파일 시스템을 지원하며 세 매체 모두 디스크 내 파일 저장 기능이 있다. 전체 요약 12문장 읽기 → 073 21:11 ▲ 100 · 댓글 34 유튜브 영상으로 일본어 실력 점검, JIVX의 음성 연습 도구 JIVX는 일본어 유튜브 영상을 활용해 라인별로 타이핑하거나 말하기 연습을 할 수 있는 플랫폼이다. 웹 · 프론트엔드 · Practice speaking Japanese with real YouTube videos, graded line by line
Key Point 실제 영상 콘텐츠로 일본어 말하기와 쓰기를 동시에 연습하면서 레벨에 맞춘 학습이 가능한 새로운 방식의 언어 학습 도구를 제시한다.
핵심 요약
JIVX는 일본어 유튜브 영상을 활용해 라인별로 타이핑하거나 말하기 연습을 할 수 있는 플랫폼이다. 사용자가 일본어 영상을 붙여넣으면 각 문장이 자동으로 분석되어 평가되며, 이미 추가된 영상으로도 연습 가능하다. 플랫폼에는 Hololive 클립, 애니메 , 팟캐스트, 여행 영상, 뉴스 등 다양한 장르의 콘텐츠가 준비되어 있다. 전체 요약 6문장 읽기 → 074 18:11 ▲ 85 · 댓글 2 AI 시스템이 상황마다 최적의 모델을 고르는 법 통용 AI 시스템이 다양한 도메인과 모달리티를 다루려면 여러 전문 모델과 도구를 조율하는 라우팅 기법이 필요하다. AI · 머신러닝 · Route Anything: A Study of Model and Policy Routing for General-Purpose AI Systems
Key Point 다양한 AI 작업을 하나의 시스템으로 처리할 때 여러 모델 중 각 상황에 맞는 것을 자동으로 선택하는 기법이 실제로 얼마나 효과적인지 처음 대규모 검증했기 때문이다.
핵심 요약
통용 AI 시스템이 다양한 도메인과 모달리티를 다루려면 여러 전문 모델과 도구를 조율하는 라우팅 기법이 필요하다. Route Anything은 모델과 정책 라우팅을 통일된 프레임워크로 연구하며, 품질-비용 균형 속에서 최적 라우팅 조건을 수학적으로 규명한다. 언어 이해, 이미지·비디오·음성 생성, 코딩 에이전트, 로봇 조작 등 25개 벤치마크에서 452개 후보 모델 조합으로부터 37만 4401건의 평가 데이터를 수집했다. 전체 요약 6문장 읽기 → 075 15:11 ▲ 126 · 댓글 108 개발자가 본 1년 사이 AI 활용의 변화, 코딩은 에이전트 시대로 마이크로소프트 윈도우 AI팀에서 세일즈포스 AI 연구소로 이직한 개발자가 1년간 AI 활용 방식의 변화를 정리했다. AI · 머신러닝 · How I use AI (Oct 2026)
Key Point 한 해 사이 AI 코딩 에이전트가 소프트웨어 개발을 근본적으로 바꿨다. 속도 향상, 피로감, 창의성 상실이 동시에 일어나는 현장의 진솔한 기록.
핵심 요약
마이크로소프트 윈도우 AI팀에서 세일즈포스 AI 연구소로 이직한 개발자가 1년간 AI 활용 방식의 변화를 정리했다. 코딩 분야에서 가장 극적인 변화가 일어났다. 깃허브 코파일럿의 자동완성에서 벗어나 이제는 claudeCode 같은 에이전트 5~6개를 관리하며 일한다. 에이전트는 새 기능을 20분 안에 프로토타이핑하고, 테스트를 실행하며, PR까지 작성·검토한다. 기존에 손으로 작성하는 것과 비교해 속도, 유연성, 버그 해결이 획기적으로 향상됐다. 전체 요약 13문장 읽기 → 076 03:11 새 버전 OpenAI 파이썬 SDK v3.43.0 릴리스 OpenAI 파이썬 라이브러리 v3.43.0이 릴리스되었다. AI · 머신러닝 · openai/openai-python@v3.43.0
Key Point 실시간 음성·스트리밍 기능을 사용하는 개발자는 WebSocket 통신의 안정성과 응답 처리 개선을 확인해야 한다.
핵심 요약
OpenAI 파이썬 라이브러리 v3.43.0이 릴리스되었다. Live Responses 위임 도구를 확장하는 API 기능을 추가했다. WebSocket 진행 상황을 누적하는 응답 처리 기능이 개선되었다. 전체 요약 5문장 읽기 → 077 21:11 ▲ 106 · 댓글 35 제품 영상 제작 자동화, Claude Code로 구현 Skill Video Studio는 Playwright로 제품 상호작용을 캡처하고 HyperFrames로 제목·챕터·CTA를 구성한 뒤 FFmpeg로 마스터링하는 로컬 영상 제작 워크플로우다. 웹 · 프론트엔드 · Skill to Create Product Videos
Key Point 제품 데모 영상을 스크립트·설정 파일로만 관리하고 자동 제작·렌더링할 수 있으며, Claude Code와의 통합으로 개발팀이 전문 제작 인력 없이도 고품질 영상을 만들 수 있는 새로운 워크플로우를 제시한다.
핵심 요약
Skill Video Studio는 Playwright로 제품 상호작용을 캡처하고 HyperFrames로 제목·챕터·CTA를 구성한 뒤 FFmpeg로 마스터링하는 로컬 영상 제작 워크플로우다. Claude Code의 /devrel-video 스킬과 통합되어 있으며, 무성 워크스루로 시작해 필요시 내레이션·음악·자막·발표자 영상을 추가할 수 있다. Node.js 22+, FFmpeg/ffprobe, Chromium이 필수이며, 선택적으로 음성 변환(ORPHEUS)과 아바타(LatentSync) 같은 외부 서비스를 연결할 수 있다. 전체 요약 10문장 읽기 → 078 15:11 ▲ 22 · 댓글 2 모달리티 넘나드는 임베딩 모델, 통합 프레임워크로 재정의 이미지, 텍스트, 음성 등 모달리티별로 분화된 임베딩 모델 연구가 실은 대조 학습, Transformer 아키텍처, 세밀도 전환이라는 공통 원리로 수렴하고 있다고 지적한다. AI · 머신러닝 · From Fragmentation to Fusion: A Survey and Roadmap for Omnimodal Embeddings
Key Point 멀티모달 AI의 핵심 기술인 임베딩의 분산된 연구를 처음 통합 프레임워크로 정리해, 앞으로의 모달리티 간 통합 기술 발전 방향을 가늠할 수 있습니다.
핵심 요약
이미지, 텍스트, 음성 등 모달리티별로 분화된 임베딩 모델 연구가 실은 대조 학습, Transformer 아키텍처, 세밀도 전환이라는 공통 원리로 수렴하고 있다고 지적한다. 논문은 멀티모달 임베딩의 진화 경로를 세 가지 진행 단계로 정의한다: 커버리지 확대, 비교 가능성 확보, 구성성 달성이다. 각 단계를 위한 통합 방안으로 변환(transformation)은 모달리티 간 커버리지를 확대하고, 정렬(alignment)은 서로 다른 모달리티를 비교 가능하게 만든다. 전체 요약 6문장 읽기 → 079 12:11 ▲ 110 · 댓글 41 Windows 2000 론칭 리허설에 몰래 들어간 개발자 Windows 2000 샌프란시스코 론칭 행사는 엑스포와 함께 진행되었으며, 팀 멤버들 중 선발된 사람들이 행사장에 참석했다. 기타 · Sneaking into the auditorium for the Windows 2000 launch rehearsal
Key Point Windows 2000 시대 대형 기술 론칭 행사의 무대 뒤 실제 모습과 당시 최신 기술 시연 방식을 기술자의 눈으로 볼 수 있다.
핵심 요약
Windows 2000 샌프란시스코 론칭 행사는 엑스포와 함께 진행되었으며, 팀 멤버들 중 선발된 사람들이 행사장에 참석했다. 저자가 행사 전 열린 문을 통해 몰래 오디토리움 상층부로 들어갔고, 거기서 리허설을 목격했다. 10미터 높이의 거대한 노트북 모형, 좌우 스크린, 회색 커튼으로 가려진 깜짝 무대 장치들이 준비되어 있었다. 전체 요약 7문장 읽기 → 080 06:11 ▲ 364 · 댓글 223 소리 없이 입 모양으로 말한다, RF 스마트 글래스 공개 Y Combinator F26 배치의 Subvocal Company가 소리를 내지 않고 말할 수 있는 스마트 글래스를 개발했다. 하드웨어 · 시스템 · Show HN: Subvocal – Talk to your computer without making noise
Key Point 무음 음성 입력이 단순 연구가 아닌 실제 프로토타입 제품 수준에 도달했으며, 공개 부스 데이터셋과 RF 기술의 조합이 크로스유저 인식 문제를 어떻게 풀었는지를 보여준다.
핵심 요약
Y Combinator F26 배치의 Subvocal Company가 소리를 내지 않고 말할 수 있는 스마트 글래스를 개발했다. 무음 음성 입력(무음 발성)을 감지하는 방식으로, 입을 가만히 모양만 내거나 심지어 입을 닫은 채로도 작동한다. 초기에는 EMG(근전도) 방식을 시도했으나 신호 변질, 전자기 간섭, 전극 배치 문제, 사용자 거부감 때문에 포기했다. 전체 요약 9문장 읽기 → 081 15:11 ▲ 36 · 댓글 2 음성·추론·도구 통합한 오픈 모델 Apriel Voice 27B 공개 Gemma 4 26B-A4B를 기반으로 한 Apriel Voice 27B Preview는 음성 입력을 직접 처리하면서 텍스트·이미지 입력도 지원하는 음성-언어 모델이다. AI · 머신러닝 · Apriel Voice 27B Preview: An Open Model for Speech, Reasoning, and Tool Use
Key Point 음성 인터페이스에서 추론과 도구 호출까지 한 모델에서 지원하는 오픈소스 음성 모델이 나왔으므로, 음성 기반 AI 어시스턴트 구축의 선택지가 늘어난다.
핵심 요약
Gemma 4 26B-A4B를 기반으로 한 Apriel Voice 27B Preview는 음성 입력을 직접 처리하면서 텍스트·이미지 입력도 지원하는 음성-언어 모델이다. 음성 인식을 넘어 사용자 요청을 이해하고, 문맥을 이용해 추론하며, 대화를 지속하고, 도구를 호출하는 기능을 하나의 추론 백본 안에서 통합한다. 2단계 학습 과정으로 학습했는데, 첫 단계는 음성 인터페이스를 확립하고 두 번째는 지도 학습·텍스트 재생·교차 엔트로피 손실함수를 통해 프로젝터와 백본을 동시에 적응시킨다. 전체 요약 6문장 읽기 → 082 21:11 당일 +108 로컬 AI 스튜디오, 설치 없이 Windows·Linux·macOS에서 실행 Portable AI Studio는 인터넷 연결 없이 로컬에서 온전히 작동하는 데스크톱 AI 스튜디오로, Windows·Linux·macOS를 지원한다. AI · 머신러닝 · techjarves/Portable-Local-Studio · JavaScript
Key Point 로컬 AI의 네 가지 핵심 기능(이미지·채팅·음성 인식·음성 합성)을 한 애플리케이션에서 설치 과정 없이 바로 사용할 수 있게 하는 새로운 접근이며, 하드웨어별 자동 가속 감지로 개발자의 수동 설정 부담을 크게 줄인다.
핵심 요약
Portable AI Studio는 인터넷 연결 없이 로컬에서 온전히 작동하는 데스크톱 AI 스튜디오로, Windows·Linux·macOS를 지원한다. 이미지 생성(Stable Diffusion), LLM 채팅(llama.cpp), 음성 인식(Whisper), 음성 합성(Kokoro TTS) 네 가지 기능을 통합한다. Node.js 런타임과 GPU 백엔드가 자체 포함돼 있어 설치나 시스템 환경 설정이 불필요하며, 사용자는 배치 파일이나 쉘 스크립트를 실행하기만 하면 된다. 전체 요약 12문장 읽기 → 083 21:11 당일 +117 40개 이상 AI 에이전트를 iPhone에서 조종하는 오픈소스 봇 Codync는 Claude Code, Codex, Gemini, Cursor, Copilot 등 40개 이상의 코딩 에이전트를 iPhone, Mac, Windows, Linux, 터미널에서 메시지로 조종할 수 있는 오픈소스 앱이다. AI · 머신러닝 · leepokai/Codync · Rust
Key Point 자신이 이미 구독한 Claude, ChatGPT, Gemini 등의 계획을 그대로 사용하면서 iPhone에서 여러 AI 에이전트를 동시에 조종할 수 있는 방식은 기존의 단일 봇 앱(Grok Bot, Muse 등)과 근본적으로 다르다.
핵심 요약
Codync는 Claude Code, Codex, Gemini, Cursor, Copilot 등 40개 이상의 코딩 에이전트를 iPhone, Mac, Windows, Linux, 터미널에서 메시지로 조종할 수 있는 오픈소스 앱이다. 각 에이전트를 이름 있는 봇으로 만들어 독립적인 채팅창, 프로젝트 폴더, 승인 정책을 가지고 운영할 수 있으며, 여러 봇이 동시에 작동한다. 그룹 채팅을 지원해 봇들이 순서대로 답변하고 서로 도움을 요청할 수 있다. 전체 요약 10문장 읽기 → 084 21:11 당일 +1,191 AI 엔지니어링 입문부터 실전까지, 93개 프로젝트 모음 LLM, RAG, AI 에이전트 기초부터 실제 애플리케이션까지 다루는 종합 학습 저장소이다. AI · 머신러닝 · patchy631/ai-engineering-hub · Jupyter Notebook
Key Point 실무 AI 개발에 필요한 LLM, RAG, 에이전트 기술을 체계적으로 배울 수 있는 현성 프로젝트 모음집이다.
핵심 요약
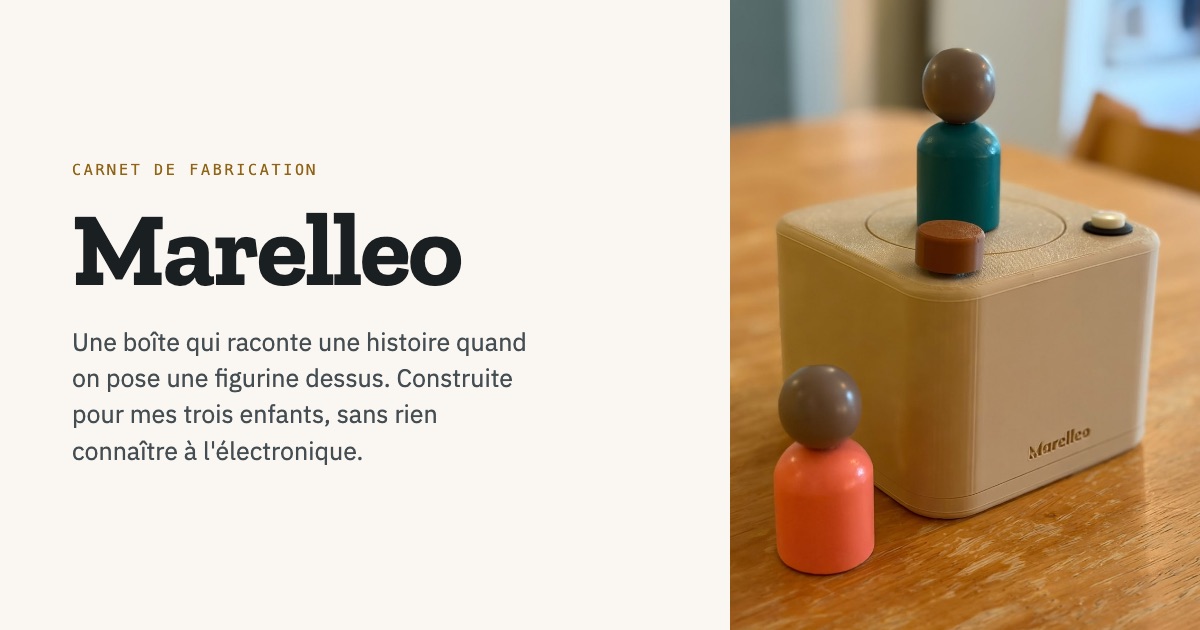
LLM, RAG, AI 에이전트 기초부터 실제 애플리케이션까지 다루는 종합 학습 저장소이다. 난이도별로 초급 22개, 중급 48개, 고급 23개 프로젝트로 구성되어 있으며, 초급자는 OCR 앱과 간단한 RAG 구현부터 시작할 수 있다. 중급 단계에서는 CrewAI 기반 에이전트 워크플로우, 음성 AI, 고급 RAG, MCP(Model Context Protocol) 기술을 학습한다. 전체 요약 7문장 읽기 → 085 00:11 ▲ 127 · 댓글 36 톤박스 대신 직접 만든 오픈소스 이야기 상자, ESP32로 톤박스처럼 피규어를 올리면 이야기가 나오는 상자를 ESP32와 RFID로 만들었다. 하드웨어 · 시스템 · Show HN: Marelleo, an open-source story box I built for my kids using ESP32
Key Point 오픈소스 하드웨어 프로젝트의 전체 개발 과정을 보여주는데, 초보자가 전자회로 설계부터 PCB 제조, 펌웨어 업데이트까지 실제로 마주치는 문제들과 해결책을 구체적으로 기록했다.
핵심 요약
톤박스처럼 피규어를 올리면 이야기가 나오는 상자를 ESP32와 RFID로 만들었다. 구독 모델 대신 자신의 음성 녹음, 팟캐스트, 라디오 스트림 등 모든 콘텐츠를 직접 관리하도록 설계했다. 안전을 위해 브레드보드 대신 완전한 PCB로 설계했고, 처음 설계했음에도 불구하고 재작업 없이 완벽하게 작동했다. 전체 요약 11문장 읽기 → 086 12:11 ▲ 114 · 댓글 42 BeOS를 브라우저에서 실행해보세요 Infinite Mac 사이트에서 1984년부터 2005년까지 매킨토시 운영체제와 BeOS를 웹브라우저에서 직접 실행할 수 있다. 하드웨어 · 시스템 · Infinite Mac: BeOS
Key Point BeOS는 Apple이 인수를 고려할 정도의 고성능 OS였으나 결국 선택되지 않은 역사 속 선택지인데, 지금 웹브라우저에서 직접 경험해보고 당시 기술적 혁신이 무엇이었는지 확인할 수 있다.
핵심 요약
Infinite Mac 사이트에서 1984년부터 2005년까지 매킨토시 운영체제와 BeOS를 웹브라우저에서 직접 실행할 수 있다. BeOS는 멀티미디어 중심, 멀티태스킹·멀티스레드 OS로 1990년대 중반 Power Macintosh로 포팅되었으며 Apple도 인수를 고려했던 제품이다. 저자가 DingusPPC 에뮬레이터를 활용해 BeOS 지원을 추가하면서 ADB 에뮬레이션, 화면 깊이 변경, 비디오 메모리 업데이트, HFS 파티션 마운트 등에서 여러 호환성 버그를 발견하고 수정했다. 전체 요약 11문장 읽기 → 087 06:11 ▲ 224 · 댓글 191 프로톤 CEO, AI 역면접 취소…보안 우려 확산 프로톤 CEO 앤디 옌이 직원들의 AI 활용도를 평가하는 '역면접'을 취소했다. 취소 전날 404 Media가 프로톤이 보안 우려를 무시하고 AI를 강압적으로 추진한다는 조사 결과를 보도했다. 보안 · Proton's CEO Cancels AI 'Re-Interviews'
Key Point 보안 회사로 알려진 프로톤이 실제로는 보안을 외면하고 AI 도입을 강제하면서 공포 문화를 조성했다는 의혹이 터졌고, CEO의 형식적 사과와 실질적 방향 변화 부재가 확인되면서 사용자 신뢰 붕괴가 가시화되고 있다.
핵심 요약
프로톤 CEO 앤디 옌이 직원들의 AI 활용도를 평가하는 '역면접'을 취소했다. 취소 전날 404 Media가 프로톤이 보안 우려를 무시하고 AI를 강압적으로 추진한다는 조사 결과를 보도했다. 옌은 지난 8월 보안팀이 AI 코드를 펜테스트 후 배포할 것을 제안했을 때 '약자의 생각', '느린 것에만 집착한다'며 '코드를 직접 만드는 일을 멈추고 AI를 더 써라'고 지시했다. 404 Media의 조사는 현직 8명, 전직 1명 직원의 증언, 회사 Slack 메시지, 회의 음성, CTO 바트 버틀러의 AI 선언문을 토대로 했다. 전체 요약 8문장 읽기 → 088 21:11 당일 +174 로컬 음성 받아쓰기 도구 Hex 공개, macOS·Windows·Linux 지원 Rust로 만든 로컬 우선 음성 받아쓰기 도구 Hex를 macOS, Windows, Linux에서 사용 가능하게 공개했다. 오픈소스 · 도구 · anomalyco/hex · Rust
Key Point 클라우드 의존도 없이 로컬에서만 동작하는 다중 플랫폼 음성 받아쓰기 도구의 공개로, 프라이버시를 중시하는 개발자와 사용자에게 새로운 대안을 제공한다.
핵심 요약
Rust로 만든 로컬 우선 음성 받아쓰기 도구 Hex를 macOS, Windows, Linux에서 사용 가능하게 공개했다. macOS 15 이상 Apple silicon Mac에서 단축키를 누르고 말한 후 놓으면 로컬에서 받아써 현재 앱에 붙여넣는다. 온디바이스 음성 모델을 설치 중에 다운로드하며 OpenAI나 클라우드 서비스 없이도 동작한다. 전체 요약 12문장 읽기 → 089 21:11 ▲ 12 · 댓글 2 음성 대화형 AI를 위한 압축 토큰 처리 기법 제안 음성 대화형 AI 모델(SDM)이 음성 생성과 합성에 같은 토큰 공간을 쓰면서 긴 자동 회귀 시퀀스와 높은 추론 비용이 발생한다. AI · 머신러닝 · CoSTA: Compressed Speech Token Adaptation for Efficient Spoken Dialogue Models
Key Point 음성 대화 모델의 추론 비용을 크게 줄이면서 모델 재학습 없이 기존 시스템에 적용할 수 있는 방법이 제시되어, 실제 음성 AI 서비스의 성능과 비용 효율성을 동시에 개선할 수 있다.
핵심 요약
음성 대화형 AI 모델(SDM)이 음성 생성과 합성에 같은 토큰 공간을 쓰면서 긴 자동 회귀 시퀀스와 높은 추론 비용이 발생한다. 기존의 저율 토크나이저는 시퀀스를 짧게 하지만 압축 품질 손상과 모델 교체 비용이 크다. CoSTA는 원본 음성 토크나이저와 디코더를 유지하면서 생성과 합성 토큰 공간을 분리하는 호환성 보존형 프레임워크다. 전체 요약 7문장 읽기 → 090 15:11 ▲ 29 · 댓글 2 멀티모달 LLM의 정보 검색 메커니즘 분석 멀티모달 대형 언어 모델의 긴 입력에서 관련 증거를 찾는 능력은 '검색 헤드'라는 특정 어텐션 헤드 집합에서 비롯된다. AI · 머신러닝 · A Broader Look into MLLM's Retrieval Heads
Key Point 멀티모달 LLM의 정보 검색 능력이 특정 어텐션 헤드에 집중되어 있다는 발견은 이들 모델의 작동 원리를 이해하는 핵심이며, 최적화를 통해 성능을 구체적으로 개선할 수 있는 방법을 제시한다.
핵심 요약
멀티모달 대형 언어 모델의 긴 입력에서 관련 증거를 찾는 능력은 '검색 헤드'라는 특정 어텐션 헤드 집합에서 비롯된다. 이 연구는 기존 연구의 한계를 확장해 음성-시각 입력 같은 새로운 모달리티를 포함한 18개 모델 체크포인트를 분석했다. 같은 답이 음성 또는 화면에 표시되는 쌍을 이루는 입력으로 테스트한 결과, 증거 내용이 같으면 검색 헤드는 새로운 모달리티에서도 희소성을 유지한다. 전체 요약 6문장 읽기 → 091 12:11 ▲ 110 · 댓글 97 클로드 듀엣, 실제로 쓸 만한 AI 어시스턴트의 등장 Anthropic이 출시한 Claude Duet은 기존 AI 어시스턴트(Muse, Dot, NanoClaw 등)보다 실용적이라는 평가를 받고 있다. AI · 머신러닝 · Claude Duet is the first personal-assistant-type harness that feels useful
Key Point 실제 사용자가 기존 AI 어시스턴트들과 직접 비교하며 평가한 경험담으로, 속도·보안·인터페이스 측면에서 어떤 점이 달라졌는지 구체적으로 보여준다.
핵심 요약
Anthropic이 출시한 Claude Duet은 기존 AI 어시스턴트(Muse, Dot, NanoClaw 등)보다 실용적이라는 평가를 받고 있다. Opus 5.5 기반으로 구동되며 별도 튜닝을 통해 응답 속도를 크게 높였고, 사용자가 명령 사이에 대기하지 않아도 될 정도로 빠르다. 채널 기능으로 작업 흐름을 자동으로 정리하고 관리하며, Cmd-k로 채널 간 빠른 이동이 가능해 세션 추적 문제를 해결한다. 전체 요약 8문장 읽기 → 092 06:11 ▲ 114 · 댓글 220 스페인 열차 충돌 사고, 최소 69명 사망 스페인 마드리드 남쪽 140km 지점의 세비야 고속선에서 수요일 오전 08:53 국영 Renfe 열차가 정차 중인 민영 Iryo 열차에 고속으로 충돌해 최소 69명이 사망했다. 기타 · What we know so far about Spain train crash
Key Point 열차 제어 시스템 오류로 정지된 열차에 고속 충돌한 사고의 원인 규명이 진행 중이며, 음성 녹음 증거가 통제실의 의사결정 과정을 직접 드러낸다.
핵심 요약
스페인 마드리드 남쪽 140km 지점의 세비야 고속선에서 수요일 오전 08:53 국영 Renfe 열차가 정차 중인 민영 Iryo 열차에 고속으로 충돌해 최소 69명이 사망했다. 충돌 당시 Mora와 Orgaz 사이 선로 위에 정차해 있던 Iryo 열차에 Renfe 열차가 뒤에서 추돌하면서 일부 객차가 제방 아래로 떨어졌다. 운수부 장관 오스카르 푸엔테는 오전 08:30경 컴퓨터 시스템 장애로 6개 이동 열차가 정지됐으며, 제어 센터가 속도 제한 없이 열차를 다시 출발하도록 결정했다고 설명했다. 전체 요약 11문장 읽기 → 093 00:11 ▲ 206 · 댓글 157 구글 제미니 4 카본, AI 성능 평가 1위 등극 구글의 제미니 4 카본이 Artificial Analysis Intelligence Index v5에서 1위를 차지했으며, 코딩 에이전트 평가에서는 Claude Opus 5.5 다음인 2위다. AI · 머신러닝 · Gemini 4 Carbon is the new #1 on the Artificial Analysis Intelligence Index v5
Key Point 구글이 최신 AI 성능 평가에서 1위를 차지해 OpenAI, Anthropic과의 경쟁 지형이 어떻게 변하는지 보여주며, 가격 경쟁력까지 갖춘 모델이 나타났기 때문이다.
핵심 요약
구글의 제미니 4 카본이 Artificial Analysis Intelligence Index v5에서 1위를 차지했으며, 코딩 에이전트 평가에서는 Claude Opus 5.5 다음인 2위다. 제미니 4 카본은 Intelligence Index v5에서 59점을 기록했으며, HLE-Diamond, Terminal-Bench-Science, AA-Omniscience, AutomationBench-AA 등 9개 평가 중 4개에서 1위를 기록했다. 코딩 에이전트 평가에서 제미니 4 카본은 Claude Opus 5.5보다 3점 낮은 59점으로 2위를 차지했으며, Terminal-Bench 4.0에서 64%, FrontierCode v1.1에서 51%를 기록했다. 전체 요약 9문장 읽기 → 094 21:11 당일 +148 로컬 AI 스튜디오 'Locally Uncensored' 3.0.8 공개 설치부터 실행까지 클릭 몇 번으로 진행되는 올인원 로컬 AI 앱으로, 윈도우·리눅스·안드로이드·맥(베타)을 지원하며 Docker나 터미널 없이도 작동한다. AI · 머신러닝 · PurpleDoubleD/locally-uncensored · TypeScript
Key Point Docker나 터미널 없이 데스크톱에서 채팅·이미지·영상·코딩을 한 앱으로 완전히 로컬에서 실행할 수 있는 통합 환경이 제공되므로, 클라우드 의존성을 피하려는 개발자와 사용자에게 변화를 가져온다.
핵심 요약
설치부터 실행까지 클릭 몇 번으로 진행되는 올인원 로컬 AI 앱으로, 윈도우·리눅스·안드로이드·맥(베타)을 지원하며 Docker나 터미널 없이도 작동한다. 채팅 모드에서 검열을 받지 않은 모델(Abliterated)을 제공하고, ComfyUI 통합으로 이미지·영상 생성, 코딩 에이전트, 음성 대화, 컴퓨터 제어 기능을 한 창에서 사용할 수 있다. 3.0.8에서 웹 검색을 5개 서비스에서 무료로 수행하고, 영상은 백그라운드 렌더링 중에도 채팅 계속 가능하며, 듀얼 그래픽카드 할당으로 채팅과 ComfyUI를 각각 GPU에 할당할 수 있다. 전체 요약 13문장 읽기 → 095 21:11 당일 +640 AI 봇 팀을 채팅 앱에서 운영하는 오픈소스 플랫폼 Grok Bot의 오픈소스 대안인 OpenMausBot은 사용자의 로컬 머신에서 여러 AI 봇을 관리하는 채팅 앱이며, Claude·Codex·Grok CLI를 통해 자신의 구독과 로그인을 재사용할 수 있다. AI · 머신러닝 · milind-soni/OpenMausBot · TypeScript
Key Point AI 에이전트 플랫폼의 오픈소스 진영이 확대되는 가운데, 사용자 자신의 모델과 로컬 머신에서 여러 봇을 독립적으로 운영할 수 있는 대안이 등장했다.
핵심 요약
Grok Bot의 오픈소스 대안인 OpenMausBot은 사용자의 로컬 머신에서 여러 AI 봇을 관리하는 채팅 앱이며, Claude·Codex·Grok CLI를 통해 자신의 구독과 로그인을 재사용할 수 있다. 각 봇은 독립적인 모델·클라우드 컴퓨터·연결된 앱을 가지며, 메시지 사이드바의 연락처처럼 상호작용한다. 봇이 실행할 셸 명령·파일 편집·질문은 인라인 카드로 표시되어 사용자가 승인·거부하거나 답변할 수 있다. 전체 요약 13문장 읽기 → 096 21:11 당일 +493 CapCut 대체 오픈소스 동영상 편집기 Concat 출시 Concat은 무료 오픈소스 동영상 편집기로 macOS, Windows, Linux, Android를 지원하는 CapCut 대체 소프트웨어다. 오픈소스 · 도구 · jub0t/Concat · Rust
Key Point 오픈소스 대안이 필요한 동영상 편집자들을 위해 로컬 처리·무제한 기능·AI 스크립팅 지원을 갖춘 완성도 높은 CapCut 대체제가 나왔다.
핵심 요약
Concat은 무료 오픈소스 동영상 편집기로 macOS, Windows, Linux, Android를 지원하는 CapCut 대체 소프트웨어다. 로컬 Whisper 모델로 자동 자막 생성, 텍스트-투-스피치 및 음성 복제, 배경 제거 등을 제공한다. 100개 이상의 GPU 렌더링 이펙트·필터·트랜지션, 키프레임 애니메이션(위치·스케일·회전·투명도·볼륨), 멀티트랙 타임라인을 지원한다. 전체 요약 12문장 읽기 → 097 15:11 ▲ 104 · 댓글 2 실시간 음성-영상 화자 추출, 경량화로 엣지 배포 가능해졌다 스트리밍 환경에서 특정 화자의 음성만 추출하는 기술(AVTSE)은 저지연이 필수인데, 기존 방식들은 두 가지 문제를 안고 있었다. AI · 머신러닝 · Efficient Streaming Audio-Visual Target Speaker Extraction for Real-World Acoustic Scenes
Key Point 실시간 음성 처리가 필요한 모바일·임베디드 환경에서 화자 분리의 실용성을 크게 높였으며, 기존 벤치마크의 문제를 해결한 현실적 평가 기준을 제시했다.
핵심 요약
스트리밍 환경에서 특정 화자의 음성만 추출하는 기술(AVTSE)은 저지연이 필수인데, 기존 방식들은 두 가지 문제를 안고 있었다. 첫째, 표준 벤치마크가 화자 2명만 고정하고 실제 환경의 근거리·원거리 간섭음, 음향 반향, 갑작스러운 잡음을 반영하지 않는다. 둘째, 고성능 인과관계 구조는 엣지 기기 배포에 너무 무겁고, 경량 대안도 작은 분리 모델을 반복 호출하면서 이득을 상쇄한다. 전체 요약 8문장 읽기 → 098 12:11 새 버전 Ollama v0.40.13, LFM3 모델 리눅스·윈도우 지원 Ollama v0.40.13이 릴리스되었다. 오픈소스 · 도구 · ollama/ollama@v0.40.13
Key Point 로컬에서 LFM3 모델을 사용할 수 있는 환경이 크게 확대되었으므로, 오픈소스 LLM 활용 범위가 넓어졌다.
핵심 요약
Ollama v0.40.13이 릴리스되었다. Liquid AI의 LFM3 모델이 리눅스와 윈도우에서 실행 가능해졌다. lfm3-audio와 lfm3-omni 모델은 음성 합성(text-to-speech) 기능을 포함한다. 전체 요약 4문장 읽기 → 099 09:11 ▲ 106 · 댓글 17 엔비디아, 40개 언어 지원하는 오픈 음성인식 모델 공개 엔비디아가 Nemotron 3.5 Transcribe 모델을 공개했으며, 40개 언어 음성을 텍스트로 변환하고 31개 언어 간 번역, 13개 언어의 화자 구분을 모두 하나의 체크포인트에서 수행한다. AI · 머신러닝 · Nvidia Nemotron 3.5 Transcribe: open ASR for 40 languages
Key Point 음성-텍스트 변환이 대규모 언어모델의 다음 병목이 되는 시점에 40개 언어를 지원하고 프롬프트·미세조정으로 도메인 적응이 가능한 오픈 모델이 공개됨에 따라, 음성 애플리케이션 개발 환경이 크게 바뀐다.
핵심 요약
엔비디아가 Nemotron 3.5 Transcribe 모델을 공개했으며, 40개 언어 음성을 텍스트로 변환하고 31개 언어 간 번역, 13개 언어의 화자 구분을 모두 하나의 체크포인트에서 수행한다. 최대 1시간 길이 음성을 처리하고 최대 8명의 화자를 레이블링하며, 자연어 프롬프트로 출력을 제어할 수 있어 의료 받아쓰기·다국어 회의 등 도메인별 요구에 맞춘 결과를 얻을 수 있다. Hugging Face 오픈 ASR 리더보드 영어 부문에서 5.33% 평균 WER로 오픈 가중치 모델 중 1위, Artificial Analysis 레더보드에서 약 4B 활성 매개변수로 2.8% AA-WER을 달성해 파레토 경계에 위치한다. 전체 요약 12문장 읽기 → 100 00:11 ▲ 15 · 댓글 2 음성·영상 AI가 실시간 상황에 제때 반응하지 못한다 옴니모달 대형언어모델(Omni-LLM)이 계속 스트리밍되는 음성·영상을 관찰하면서 사용자를 지원할 수 있어야 하는데, 기존 평가 방식으로는 이들이 얼마나 신뢰성 있게 상황 증거와 사용자 필요를 연결해 적시에 개입하는지 알기 어렵다. AI · 머신러닝 · Omni-InteractScope: Benchmarking Proactive and Agentic Interaction in Continuous Omnimodal Streams
Key Point 음성·영상 AI가 실시간으로 상황을 인식하고 제때 도움을 주는 것이 얼마나 어려운지 첫 대규모 벤치마크로 드러나, 현재 모델의 한계와 개선할 구체적 방향을 보여준다.
핵심 요약
옴니모달 대형언어모델(Omni-LLM)이 계속 스트리밍되는 음성·영상을 관찰하면서 사용자를 지원할 수 있어야 하는데, 기존 평가 방식으로는 이들이 얼마나 신뢰성 있게 상황 증거와 사용자 필요를 연결해 적시에 개입하는지 알기 어렵다. Omni-InteractScope 벤치마크는 8개 작업군에 걸친 1,479개 인간 주석 상호작용과 1,790개 시간 목표를 제시한다. 도구 호출(tool invocation) 타이밍, 쿼리 없는 조언, 알림, 경고, 상태 추적, 지속적 응답을 포함해 입력 모달리티·사건 트리거·개입 유형·사용자 필요를 연결한다. 전체 요약 8문장 읽기 →