쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
100건 (최대치) · "Odin"조건 지우기 ×
001 09:11 ▲ 105 · 댓글 39 Odin으로 만든 NES 에뮬레이터 완성 저자가 Odin 프로그래밍 언어로 NES 에뮬레이터를 개발해 2024년 6월부터 2025년 1월까지 7개월간 작업했다. 오픈소스 · 도구 · A NES emulator written in Odin
Key Point 게임 에뮬레이션 개발자들이 실제 난관과 해결 방법을 배울 수 있으며, NES 같은 레트로 하드웨어를 이해하고 싶은 개발자에게 구체적 기술 가이드가 된다.
핵심 요약
저자가 Odin 프로그래밍 언어로 NES 에뮬레이터를 개발해 2024년 6월부터 2025년 1월까지 7개월간 작업했다. 배틀토드를 포함해 수백 개의 게임을 완벽하게 실행할 수 있는 수준의 에뮬레이션 정확도를 갖추고 있다. 디버거, 저장 상태, 컨트롤러 지원, CRT 셰이더, 사운드 기능을 포함하며 NROM, MMC1, UXROM, CNROM, MMC3, GxROM, AxROM 등 7가지 매퍼를 지원한다. 전체 요약 10문장 읽기 → 002 06:11 ▲ 121 · 댓글 64 GLM-5.3을 두 DGX 스테이션에서 vLLM으로 607.8 토큰/초 처리 GLM-5.3 NVFP4는 753억 개 파라미터(토큰당 400억 활성화)의 양자화된 MoE 모델로, 약 464GB의 GPU 메모리가 필요해 단일 GB300 GPU의 252GB HBM3e를 초과한다. AI · 머신러닝 · Serving GLM-5.3 at 607.8 tok/s across two Nvidia DGX stations with vLLM
Key Point 대규모 언어 모델을 여러 머신에 걸쳐 서빙하는 실전 구현 예시로, vLLM의 분산 배포와 성능 최적화 기법을 상세히 보여준다.
핵심 요약
GLM-5.3 NVFP4는 753억 개 파라미터(토큰당 400억 활성화)의 양자화된 MoE 모델로, 약 464GB의 GPU 메모리가 필요해 단일 GB300 GPU의 252GB HBM3e를 초과한다. ConnectX-8 RDMA로 연결된 두 NVIDIA DGX 스테이션이 텐서 병렬화(TP=2)를 통해 하나의 OpenAI 호환 엔드포인트로 모델을 서빙하며, 각 GPU가 대략 절반의 가중치를 보유하고 계산한다. vLLM은 멀티토큰 예측, FP8 KV-캐시 저장, 프리픽스 캐싱을 활성화해 동시 부하에서 처리량을 최대화한다. 전체 요약 11문장 읽기 → 003 12:11 ▲ 16 · 댓글 5 멀티모달 비전 인코더의 세 가지 선택지를 분해하다 멀티모달 언어 모델의 비전 인코더 설계 방식을 통제된 환경에서 비교했다. 기존 모델들은 사전 학습된 인코더, 처음부터 학습된 인코더, 또는 인코더 없는 방식을 각각 사용하는데, 서로 다른 데이터·구조·계산량으로 인해 각 선택의 영향을 정확히 평가하기 어려웠다. AI · 머신러닝 · Unbundling Multimodal Vision Encoding
Key Point 멀티모달 모델에서 비전 처리 방식의 세 가지 핵심 선택지(사전 학습 여부, 용량 크기, 융합 위치)를 통제된 비교를 통해 각각의 영향을 명확히 규명해 향후 모델 설계에 실질적인 지표를 제시한다.
핵심 요약
멀티모달 언어 모델의 비전 인코더 설계 방식을 통제된 환경에서 비교했다. 기존 모델들은 사전 학습된 인코더, 처음부터 학습된 인코더, 또는 인코더 없는 방식을 각각 사용하는데, 서로 다른 데이터·구조·계산량으로 인해 각 선택의 영향을 정확히 평가하기 어려웠다. 연구팀은 모든 모델을 동일한 데이터로 처음부터 학습하고 같은 계산량에서 VQA(시각 질답)와 언어 벤치마크로 비교했다. 사전 학습된 비전 사전 지식은 필수가 아니며, 처음부터 함께 학습한 인코더가 별도 학습 단계 없이 사전 학습된 것과 같은 수준이다. 전체 요약 7문장 읽기 → 004 21:11 당일 +331 AI 코딩 에이전트를 위한 로컬 영상 편집기 FFmpeg-Skill 공개 Claude Code, Cursor, Codex와 같은 코딩 에이전트가 사용할 수 있는 로컬 영상 편집 도구 FFmpeg-Skill이 공개되었다. AI · 머신러닝 · kajisho5/ffmpeg-skill · Python
Key Point 클라우드나 API 키 없이 로컬에서 실행되며 에이전트가 정확하게 영상 편집을 수행할 수 있도록 설계된 도구라, AI 코딩 에이전트의 멀티모달 기능 확대와 오프라인 작업 흐름에 영향을 미친다.
핵심 요약
Claude Code, Cursor, Codex와 같은 코딩 에이전트가 사용할 수 있는 로컬 영상 편집 도구 FFmpeg-Skill이 공개되었다. 42개의 FFmpeg 도구를 제공하며, 클라우드나 API 키 없이 Python 표준 라이브러리만으로 동작한다. 각 도구는 명확한 입력 스키마를 가진 argparse 기반 스크립트로, 쉘 명령어 대신 타입이 지정된 인자로 작동한다. 전체 요약 13문장 읽기 → 005 18:11 ▲ 223 · 댓글 117 험블번들, AI 코딩으로 보안 대부분 무너뜨리다 험블번들이 AI를 활용한 '바이브코딩'으로 보안을 크게 훼손했다는 지적이 제기됐다. 인프라 · 데브옵스 · Humble Bundle just killed most of their security through vibecoding
Key Point AI에 의존한 단기적 효율화가 기술 부채와 보안 문제를 야기하는 조직 문화의 악순환을 드러내는 사례다.
핵심 요약
험블번들이 AI를 활용한 '바이브코딩'으로 보안을 크게 훼손했다는 지적이 제기됐다. 경영진이 AI 도입에 집착하면서 비판적 목소리를 내던 숙련 개발자들을 먼저 해고하는 악순환이 시작된다. 남은 개발자들은 AI가 생성한 저질의 코드 검토로 넘쳐나 번아웃에 빠지거나 떠나게 되고, 결과적으로 결함 있는 코드가 메인 브랜치에 병합된다. 전체 요약 6문장 읽기 → 006 06:11 ▲ 151 · 댓글 43 AI 코딩 에이전트를 현대 웹 표준으로 유도하는 가이드 Google Chrome, Microsoft Edge, Mozilla Firefox, MDN 팀이 함께 개발한 Modern Web Guidance는 AI 코딩 에이전트를 위한 웹 플랫폼 전문성과 모범 사례를 담은 스킬 세트이다. 웹 · 프론트엔드 · Show HN: Get your coding agent off ~2019 JavaScript, onto modern web primitives
Key Point AI가 생성하는 코드가 여전히 2019년 방식의 bloated JavaScript에 머물러 있는 문제를 직접 해결하는 구체적인 도구이며, 웹 표준 진화에 맞춰 에이전트를 재교육할 수 있게 한다.
핵심 요약
Google Chrome, Microsoft Edge, Mozilla Firefox, MDN 팀이 함께 개발한 Modern Web Guidance는 AI 코딩 에이전트를 위한 웹 플랫폼 전문성과 모범 사례를 담은 스킬 세트이다. LLM 학습 데이터에 포함된 레거시 코드가 많아서 AI 에이전트는 자주 구식 패턴을 생성하며, 현대 네이티브 웹 API로 더 효율적으로 해결할 수 있는 작업을 bloated JavaScript로 작성하곤 한다. Modern Web Guidance는 npx 명령어로 설치해 대화형 마법사를 통해 설정하거나, 코드베이스에서 레거시 패턴을 자동으로 스캔할 수 있다. 전체 요약 8문장 읽기 → 007 12:11 ▲ 26 · 댓글 2 3D 생성 AI 에이전트 평가 벤치마크 공개 코딩 에이전트는 시각 정보와 프로그램 실행을 결합해 3D 콘텐츠 자동 생성을 가능하게 한다. AI · 머신러닝 · Frontier3DBench: Benchmarking Coding Agents for 3D Creation across Objects, Scenes, and Interactive Open Worlds
Key Point 3D 생성 AI 에이전트의 객체·장면·월드 수준별 능력과 한계가 정량적으로 규명되어, 앞으로의 개발 방향을 구체적으로 가늠할 수 있다.
핵심 요약
코딩 에이전트는 시각 정보와 프로그램 실행을 결합해 3D 콘텐츠 자동 생성을 가능하게 한다. 이미지와 지시문을 편집 가능한 프로그램으로 변환해 재구성, 생성, 편집을 하나의 워크플로우에 통합한다. 기존 벤치마크들은 과제 범위와 평가 방식이 제각각이어서 에이전트의 능력을 객체·장면·인터랙티브 수준별로 파악하기 어려웠다. 전체 요약 10문장 읽기 → 008 21:11 ▲ 21 · 댓글 3 코드로 영상 생성 제어하는 AI 에이전트 등장 Video-Coder는 코드를 자율적으로 작성·실행하여 3D 장면을 구성하는 영상 생성 에이전트로, 이 3D 장면(Draft Video)이 다운스트림 영상 생성 모델에 구조와 모션 신호를 제공한다. AI · 머신러닝 · Video-Coder: Reinforcing Agentic Coding for Video Generation
Key Point 정밀한 공간 구조와 제어 가능한 영상 생성이라는 영상 AI의 오래된 문제를 코드 기반 에이전트로 풀어내는 새로운 패러다임이기 때문이다.
핵심 요약
Video-Coder는 코드를 자율적으로 작성·실행하여 3D 장면을 구성하는 영상 생성 에이전트로, 이 3D 장면(Draft Video)이 다운스트림 영상 생성 모델에 구조와 모션 신호를 제공한다. 논문은 6천 개 샘플의 감독학습용 데이터셋(Video-Coder-SFT-6k)과 2천 개 샘플의 강화학습용 데이터셋(Video-Coder-RL-2k)을 새로 구축했다. 코드 실행·3D 렌더링·실행 피드백을 통합한 Video-Coder Harness 환경을 개발하여 에이전트 훈련과 추론에 사용한다. 전체 요약 6문장 읽기 → 009 15:10 ▲ 106 · 댓글 1 로봇 계획 25배 빠르게, 비전 모델의 구조 활용한 VFlash 로봇, 자율주행 같은 물리 AI 작업에서 비전-랭귀지 모델은 좌표·궤적 같은 시각적 계획을 통해 공간상 목표를 표현하고 움직임을 예측한다. AI · 머신러닝 · VFlash: Fast, Accurate Visual Planning via Flash Primitive Decoding
Key Point 로봇의 시각 계획 생성 속도를 획기적으로 높이면서도 정확도까지 향상시키는 기법으로, 물리 AI 시스템의 실시간 제어 가능성을 크게 높인다.
핵심 요약
로봇, 자율주행 같은 물리 AI 작업에서 비전-랭귀지 모델은 좌표·궤적 같은 시각적 계획을 통해 공간상 목표를 표현하고 움직임을 예측한다. 기존 자동회귀 모델은 이런 시각 원시요소를 토큰 하나씩 생성하기 때문에 예측이 복잡할수록 비용이 급증한다. VFlash는 Flash Primitive Decoding 기법으로 시각 원시요소의 구조를 활용, 경량 드래프터가 전체 원시요소를 한 번의 순전파로 예측한다. 전체 요약 8문장 읽기 → 010 15:10 ▲ 18 · 댓글 2 추론 속도 7배 끌어올리는 비동기 투기형 디코딩 D3D 기존 타겟 조건 확산 드래프터는 각 블록 생성 후 타겟 모델의 숨겨진 상태를 기다려야 해 드래프팅과 검증이 순차 실행되며 속도 향상이 제한된다. AI · 머신러닝 · D3D: Decoupled Diffusion Drafting for Asynchronous Speculative Decoding
Key Point LLM 추론 병목 해결과 실시간 AI 서비스 성능 향상에 직결되는 새로운 분산 처리 기법으로, 기존 투기형 디코딩 방식의 근본적인 대기 문제를 제거했습니다.
핵심 요약
기존 타겟 조건 확산 드래프터는 각 블록 생성 후 타겟 모델의 숨겨진 상태를 기다려야 해 드래프팅과 검증이 순차 실행되며 속도 향상이 제한된다. D3D는 타겟 모델의 숨겨진 상태 없이 독립적으로 작동하는 확산 드래프터로, 블록 단위 노이징 제거와 보조 자기회귀 감독을 결합해 장기 수용 프리픽스를 달성한다. 이러한 독립성으로 D3D는 검증 중 후속 블록을 병렬로 드래프팅할 수 있어 비동기 투기형 디코딩을 가능하게 한다. 전체 요약 6문장 읽기 → 011 03:11 ▲ 15 · 댓글 2 추측 디코딩 성능 41% 높이는 병렬 온폴리시 디스틸레이션 기법 LLM 추론을 가속화하는 추측 디코딩(SD)은 병렬 초안 생성으로 한 번의 포워드 패스에서 여러 토큰을 예측하지만, 전체 속도는 여전히 채택 길이(acceptance length)에 좌우된다. AI · 머신러닝 · SpecOPD: Branch-Parallel On-Policy Distillation for Speculative Decoding
Key Point 추측 디코딩의 병렬화와 감독 신호 수집 방식을 근본적으로 개선해 LLM 추론 속도를 획기적으로 높일 수 있는 기술이다.
핵심 요약
LLM 추론을 가속화하는 추측 디코딩(SD)은 병렬 초안 생성으로 한 번의 포워드 패스에서 여러 토큰을 예측하지만, 전체 속도는 여전히 채택 길이(acceptance length)에 좌우된다. 온폴리시 디스틸레이션(OPD)은 훈련된 초안 생성기를 채택 길이 한계 이상으로 끌어올릴 수 있으나, 기존 방식은 순차적인 초안-검증 롤아웃을 통해 감독 신호를 수집한다. 본 논문의 핵심 아이디어는 온폴리시 감독 신호가 이 순차 의존성을 벗을 수 있다는 것이다: 초안 블록은 참조 접두사와 초안으로 샘플링한 이력만으로도 감독될 수 있다. 전체 요약 8문장 읽기 → 012 06:11 ▲ 113 · 댓글 41 Ripple-65B, 에이전트 코딩 성능 오픈웨이트 최강자로 미국 AI 칩 설계 회사 Ricursive Intelligence가 에이전트 코딩 분야의 오픈웨이트 최고 성능 모델 Ripple-65B Preview를 공개했다. AI · 머신러닝 · Ripple-65B Preview: U.S. Open-Weight SOTA on Agentic Coding
Key Point 미국 오픈웨이트 최고 성능을 3,200만 달러라는 파격적 저비용으로 달성한 효율성 최적화 방법론이 향후 대규모 언어 모델 개발의 새로운 기준을 제시할 수 있기 때문이다.
핵심 요약
미국 AI 칩 설계 회사 Ricursive Intelligence가 에이전트 코딩 분야의 오픈웨이트 최고 성능 모델 Ripple-65B Preview를 공개했다. Ripple-65B는 12조 개의 토큰으로 사전학습되었으며 최대 100만 토큰의 컨텍스트 길이를 지원한다. TerminalBench 2.1에서 80.52점으로 미국 오픈웨이트 SOTA를 달성했으며, Reflection Beam 501B(80.1), Meta Muse Spark Open 816B(76.4), Thinking Machines Inkling 975B(63.8) 등 훨씬 큰 모델들을 능가한다. 전체 요약 12문장 읽기 → 013 06:11 ▲ 137 · 댓글 46 Go 1.27, 새로운 JSON API 'v2' 정식 공개 Go 표준 라이브러리의 encoding/json이 15년 만에 메이저 업데이트 되어, encoding/json/v2와 encoding/json/jsontext 패키지가 Go 1.27에서 정식 공개되었다. 인프라 · 데브옵스 · A new Go API for JSON
Key Point Go 1.27에서 정식 공개된 encoding/json/v2는 15년간 쌓인 v1의 설계 문제(UTF-8 검증, 중복 키, 스트리밍 처리)를 해결하고 Unmarshal 성능을 최대 10배 향상시키며, v1과의 호환성을 유지하면서 점진적 마이그레이션을 가능하게 한다.
핵심 요약
Go 표준 라이브러리의 encoding/json이 15년 만에 메이저 업데이트 되어, encoding/json/v2와 encoding/json/jsontext 패키지가 Go 1.27에서 정식 공개되었다. 기존 v1의 문제점으로는 무효한 UTF-8 허용, JSON 객체의 중복 키 허용, nil 슬라이스/맵을 JSON null로 변환, 대소문자 무시 언마샬링, MarshalJSON 메서드 비일관적 호출 등이 있다. v1 API는 옵션을 Encoder/Decoder에만 적용 가능하고 Marshal/Unmarshal 함수에는 적용 불가, io.Reader에서 올바르게 언마샬링하기 어려움, 메모리 전체 버퍼링 등의 제약이 있었다. 전체 요약 12문장 읽기 → 014 18:11 ▲ 14 · 댓글 2 셸 명령어 실행 전에 결과를 미리 점검하는 AI 승인 시스템 자동화된 코딩 에이전트가 실행할 셸 명령어를 승인하는 기존 시스템은 요청 텍스트와 명령어만 보고 판단하는데, 실제 동작은 호출되는 코드와 작업 환경 상태에 따라 달라진다. AI · 머신러닝 · "Shall We Approve?" Consequence-Aware Approval for Autonomous Coding Agents
Key Point 코딩 에이전트가 실행하는 명령어를 단순한 텍스트 검사 대신 샌드박스에서 실제 실행해 결과를 검증함으로써, 목표 달성과 보안 사이의 균형을 크게 개선하는 방식을 제시한다.
핵심 요약
자동화된 코딩 에이전트가 실행할 셸 명령어를 승인하는 기존 시스템은 요청 텍스트와 명령어만 보고 판단하는데, 실제 동작은 호출되는 코드와 작업 환경 상태에 따라 달라진다. 연구팀은 Caper라는 결과 인식형 승인 메커니즘을 제안했는데, 각 명령어를 스냅샷된 샌드박스에서 미리 실행한 뒤 독립적인 승인자에게 관찰된 효과를 보고서 형태로 제공한다. Caper는 승인된 명령어는 커밋하고 거부된 명령어는 롤백하며, 거부 이유를 에이전트가 대응할 수 있는 형태로 제공한다. 전체 요약 5문장 읽기 → 015 15:11 ▲ 19 · 댓글 2 LLM 추론 최적화 AI가 자동으로 알고리즘 발견 추측 기반 디코딩(Speculative Decoding)은 경량 드래프터로 LLM 추론을 가속화하지만, 병렬 드래프팅을 지원하는 기존 시스템들이 최대 성능을 내지 못하고 있다. AI · 머신러닝 · SpecPilot: Autonomous Algorithm Discovery and Systems Optimization for Speculative Decoding
Key Point 추측 기반 디코딩의 실제 성능 격차를 AI 에이전트가 자동으로 찾아 배포 환경마다 최적화하는 방식으로, LLM 서빙 속도를 2배 이상 개선한 기술이다.
핵심 요약
추측 기반 디코딩(Speculative Decoding)은 경량 드래프터로 LLM 추론을 가속화하지만, 병렬 드래프팅을 지원하는 기존 시스템들이 최대 성능을 내지 못하고 있다. 문제는 세 가지다: 단일 요청 시 각 단계에서 적은 토큰만 인식하면서 모든 타겟 가중치를 읽으고, 배치 처리 시 요청당 검증 작업이 자동 회귀 방식 대비 속도 향상을 절반으로 줄이며, 최적화가 배포 환경·드래프터·타겟 모델·GPU에 따라 달라진다. SpecPilot은 에이전트 루프로 각 배포에 최적화된 알고리즘과 시스템 최적화를 자동으로 발견한다. 전체 요약 7문장 읽기 → 016 09:11 ▲ 10 · 댓글 2 코딩 에이전트를 위한 상호작용하는 요구사항 데이터셋 공개 현실의 장기 소프트웨어 개발에서 코딩 에이전트는 인터페이스 호환성, 에러 핸들링 같은 다차원적 작업 명세를 동시에 만족하면서 기존 의존성을 유지해야 한다. AI · 머신러닝 · When Requirements Interact: Scaling Long-Horizon Coding via Interdependent Specifications
Key Point 코딩 에이전트가 현실 수준의 복잡한 상호의존적 요구사항을 만족하도록 훈련하는 새로운 방법론과 대규모 데이터셋이 공개되어, 소프트웨어 개발 에이전트의 성능 평가 기준이 실질적으로 높아진다.
핵심 요약
현실의 장기 소프트웨어 개발에서 코딩 에이전트는 인터페이스 호환성, 에러 핸들링 같은 다차원적 작업 명세를 동시에 만족하면서 기존 의존성을 유지해야 한다. 기존 연구들은 명세의 양과 다양성이 부족하고, 주요 목표에만 집중해 복잡한 제약을 무시하는 경향이 있다. 단순히 명세를 추가하면 작업이 체크리스트처럼 단순화되거나, 상호작용의 신뢰성을 검증하면서 유효한 대안을 놓칠 위험이 있다. 전체 요약 8문장 읽기 → 017 00:11 ▲ 40 · 댓글 1 코딩 AI 학습 데이터 수집을 위한 이력 기반 궤적 수집 방법 제시 코딩 에이전트가 저장소 이슈를 해결하는 과정에서 생기는 긴 탐색·편집·검증 수열들이 학습 데이터로 활용되고 있다. AI · 머신러닝 · SWE-Trail: History-Guided Trajectory Collection for Coding Agent Training
Key Point 코딩 AI 학습에 쓰이는 데이터 수집 방식이 최종 모델 성능을 크게 좌우하는데, 이력 정보를 효과적으로 활용하면서도 학습-테스트 간 불일치를 피하는 구체적 방법을 제시한다.
핵심 요약
코딩 에이전트가 저장소 이슈를 해결하는 과정에서 생기는 긴 탐색·편집·검증 수열들이 학습 데이터로 활용되고 있다. 기존 방식은 각 이슈마다 여러 궤적을 독립적으로 샘플링한 뒤 선별하지만, 샘플이 많아질수록 중복이 증가하고 이전 데이터가 향후 수집 방향을 안내할 수 있다는 점을 무시한다. 이력을 코딩 에이전트의 컨텍스트로 직접 제공하면 학습 시 그 조언에 의존하게 되어 테스트 시 사용할 수 없는 정보에 모델이 편향되는 문제가 생긴다. 전체 요약 7문장 읽기 → 018 18:11 ▲ 26 · 댓글 1 코딩 에이전트, 여러 저장소 연계 개발에서 58% 성공률 코딩 에이전트의 성능을 평가하는 새로운 벤치마크 'CrossSWE'가 공개되었으며, 여러 저장소에 걸친 조정된 개발이 필요한 실제 소프트웨어 엔지니어링 작업을 다룬다. AI · 머신러닝 · CrossSWE: Benchmarking Cross-Repository Joint Development for Coding Agents
Key Point 단일 저장소 문제에서 벗어나 실무 규모의 멀티 리포지토리 조정 개발이 LLM 코딩 에이전트의 새로운 한계임을 보여주는 벤치마크 공개로, 에이전트 능력과 한계를 이해하려는 개발자와 연구자가 참고해야 한다.
핵심 요약
코딩 에이전트의 성능을 평가하는 새로운 벤치마크 'CrossSWE'가 공개되었으며, 여러 저장소에 걸친 조정된 개발이 필요한 실제 소프트웨어 엔지니어링 작업을 다룬다. 165개의 저장소, 20개 기술 도메인, 13개 프로그래밍 언어를 아우르는 171개의 실제 인스턴스로 구성되어 있다. 종속성 추론, 변경 전파, 인터페이스 일관성 유지 등 여러 저장소 간 조정 변경의 필요성을 검증한다. 전체 요약 5문장 읽기 → 019 21:11 당일 +322 375개 AI 제공업체를 하나의 엔드포인트로 관리하는 무료 게이트웨이 OmniRoute 다양한 AI API 제공업체 375개(150개 이상 무료)를 단일 엔드포인트로 라우팅하는 오픈소스 게이트웨이 OmniRoute를 발표했다. AI · 머신러닝 · cheaper-inference/OmniRoute · TypeScript
Key Point 무료 AI API를 여러 개 연결해 토큰 부족으로 인한 중단을 없애려는 개발자나 자체 모델 서비스를 구축하려는 팀에게 실제 비용과 복잡도를 크게 줄일 수 있는 솔루션이다.
핵심 요약
다양한 AI API 제공업체 375개(150개 이상 무료)를 단일 엔드포인트로 라우팅하는 오픈소스 게이트웨이 OmniRoute를 발표했다. Claude, GPT, Gemini, Kimi, GLM, DeepSeek, MiniMax 등 1,400개 이상 모델을 지원하며 Claude Code, Cursor, Cline 등 다양한 코딩 에디터와 호환된다. 연결된 제공업체의 무료 티어를 조합해 월 약 1.62억 토큰을 무료로 사용 가능하며, 할당량 자동 감지 및 자동 폴백으로 중단 없는 서비스를 보장한다. 전체 요약 10문장 읽기 → 020 03:10 ▲ 145 · 댓글 93 가벼운 LLM 코딩 에이전트 'Prospero' 출시 개발자가 로컬 LLM으로 프로그래밍 작업을 하도록 돕는 '코딩 하네스'를 직접 개발했다. AI · 머신러닝 · Prospero: A new coding harness for a more civilized age
Key Point 로컬 LLM으로 자동화된 개발 작업이 가능한 실용적인 도구가 나왔으며, 기존 도구 대비 훨씬 가볍고 안정적으로 설계되어 에이전트 기반 개발 워크플로우를 본격적으로 실험할 수 있다.
핵심 요약
개발자가 로컬 LLM으로 프로그래밍 작업을 하도록 돕는 '코딩 하네스'를 직접 개발했다. 기존 도구들이 웹 스택 기반이라 수GB 메모리를 소비하는 문제를 해결하기 위해 C++와 Dear ImGui로 작성하여 기존 도구 대비 100배 적은 리소스를 사용한다. llama.cpp, OpenRouter, Anthropic API 등 외부 모델 제공자와 연동하며, 내장 모델 공급자는 없다. 전체 요약 13문장 읽기 → 021 15:11 ▲ 20 · 댓글 3 AI 코딩 에이전트의 협업 능력 평가 벤치마크 공개 Hugging Face가 AI 모델의 멀티모달 협업 코딩 능력을 평가하는 벤치마크 'Co-Design Bench'를 발표했다. AI · 머신러닝 · Co-Design Bench: Multimodal Collaborative Coding Evaluation for Agentic Models
Key Point 현재 AI 코딩 에이전트는 요구사항 70% 정도를 부분적으로만 충족하지만 완전한 완료는 26%에 불과해, 실제 협업 환경에서 얼마나 신뢰할 수 있는지 명확히 보여준다.
핵심 요약
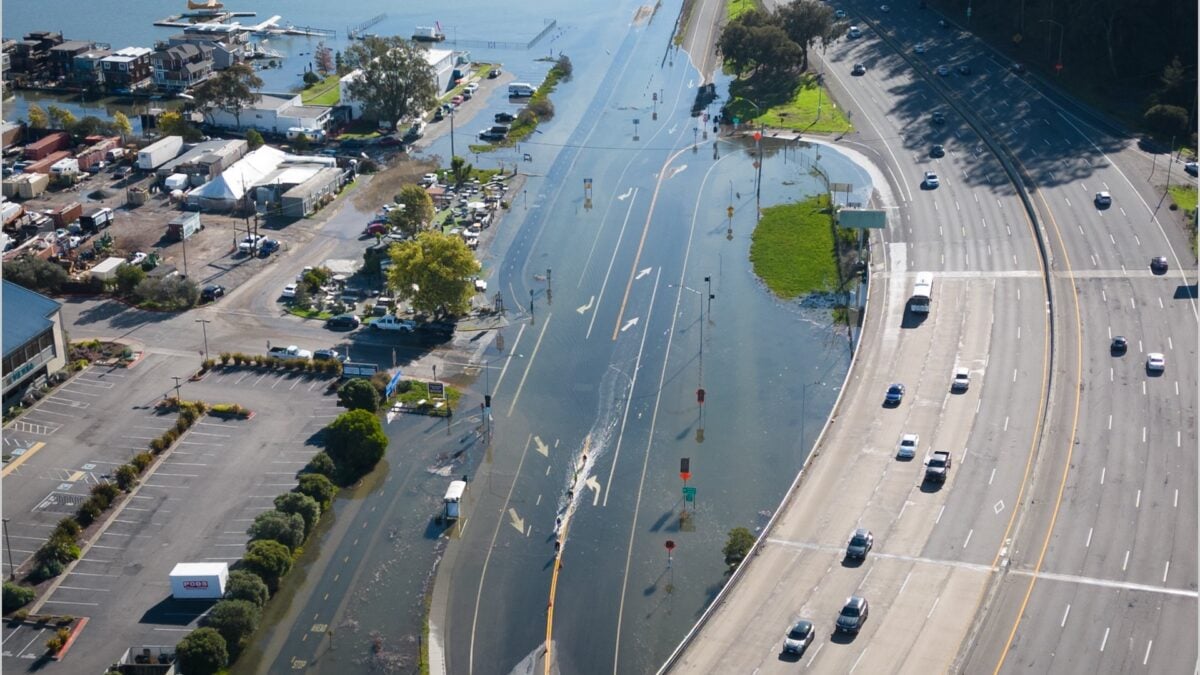
Hugging Face가 AI 모델의 멀티모달 협업 코딩 능력을 평가하는 벤치마크 'Co-Design Bench'를 발표했다. 실제 사용자 세션 26,314개에서 수집한 중복 제거 쿼리 37,463개 중 273개 작업으로 구성되며, 텍스트·이미지·오디오·비디오·문서 등 다양한 입력을 포함한다. Multimodal Editing(ME)과 Repository Editing(RE) 두 가지 트랙을 제공하고, Grounded Understanding·UI Transformation·Functional Implementation 세 가지 능력 차원을 평가한다. 전체 요약 8문장 읽기 → 022 12:11 ▲ 108 · 댓글 38 엘니뇨·고조로 캘리포니아 해안 범람, 최고 조석은 아직 캘리포니아 마린 카운티의 해안도로가 30분 만에 2피트 깊이의 조수 웅덩이로 변했으며, 이달 말까지 베이 에어리어 전역에서 조수 범람이 계속될 것으로 예보되고 있다. 하드웨어 · 시스템 · El Niño is flooding California's coasts with the highest tides to come
Key Point 캘리포니아 해안이 직면한 조수 범람 위기가 현재 이미 진행 중이며, 아직 올해 최고 조석이 오기 전이라는 점에서 이번 겨울의 재난 규모를 예측할 수 있는 시사점을 제공한다.
핵심 요약
캘리포니아 마린 카운티의 해안도로가 30분 만에 2피트 깊이의 조수 웅덩이로 변했으며, 이달 말까지 베이 에어리어 전역에서 조수 범람이 계속될 것으로 예보되고 있다. 엘니뇨의 켈빈파로 인한 따뜻한 바닷물이 감사절·크리스마스 시즌에 심각한 피해를 줄 것으로 예측되며, 현재 샌프란시스코 베이에서 몬터레이까지 조수 범람이 발생하고 있다. 베이 에어리어의 월요일 고조는 10월 기록을 경신했고, 저지대 주민들이 고립되었으며, 소금물에 의한 배터리 합선으로 인한 전기차 화재 위험이 경고되고 있다. 전체 요약 10문장 읽기 → 023 12:11 ▲ 10 · 댓글 2 항공 영상에서 각진 상자 예측으로 객체 위치 파악 개선 항공 촬영 영상에서 객체를 찾기 위해 기존의 수평 직사각형 대신 회전된 방향의 상자(oriented bounding box)를 예측하는 모델을 제안했다. AI · 머신러닝 · OBB-PBD: Extending Parallel Box Decoding to Oriented Bounding Boxes for Referring Expression Grounding in Aerial Imagery
Key Point 항공 영상에서 임의 각도로 나타나는 객체를 정확히 찾는 것이 실제 필요한데, 기존 기법은 수평 상자만 지원해 성능이 크게 떨어진다는 문제를 해결했다.
핵심 요약
항공 촬영 영상에서 객체를 찾기 위해 기존의 수평 직사각형 대신 회전된 방향의 상자(oriented bounding box)를 예측하는 모델을 제안했다. Parallel Box Decoding(PBD) 방식을 확장해 4개 좌표 대신 6개 슬롯의 각진 표현을 사용했으며, 이중각도 매개변수화(double-angle parameterization) 기법을 적용했다. 이미지와 프롬프트를 섞는 제어실험, 가시성·누수 프로브를 통해 모델이 손실 곡선이 아니라 실제로 이미지와 텍스트 프롬프트 모두에 의존하는지 검증했다. 전체 요약 5문장 읽기 → 024 12:11 ▲ 11 · 댓글 2 픽셀 공간 확산 모델 학습 가속화하는 통계 기법 픽셀 공간에서 속도장(velocity field)을 직접 학습하는 것은 어렵고 느린데, 고정된 Wiener 추정값이 속도 학습을 개선하고 선형 예측 범위를 넘어 이득을 제공한다. AI · 머신러닝 · Beyond the Estimate: Wiener-Informed Decoding for Easier Training of Pixel-Space Flow Models
Key Point 픽셀 공간 생성 모델의 훈련 효율을 37.5% 단축할 수 있는 방법이 제시되어, 대규모 이미지 생성 모델 개발의 실질적 비용 절감에 직결된다.
핵심 요약
픽셀 공간에서 속도장(velocity field)을 직접 학습하는 것은 어렵고 느린데, 고정된 Wiener 추정값이 속도 학습을 개선하고 선형 예측 범위를 넘어 이득을 제공한다. 고정된 기저(basis)와 픽셀 디코딩도 이와 유사하면서 상호보완적인 성능 향상을 보인다. Wiener-informed Decoding(WiD)은 통계적 지식으로 직접 예측과 디코더 계산을 조직화하며, 훈련가능한 Wiener 예측 경로와 기본 디코더 블록에 특징을 주입하고 계수 보정을 반환하는 계수 인터페이스를 조합한다. 전체 요약 8문장 읽기 → 025 12:11 ▲ 10 · 댓글 6 제약 디코딩, LLM 성능 해친다는 가정 재검토 대형언어모델(LLM)의 제약 디코딩은 출력을 미리 정한 형식으로 제한하지만 추론 능력을 해친다는 통설을 검토했다. AI · 머신러닝 · Constrained Decoding: Harmful or Beneficial? Revisiting Its Impact on LLM Performance
Key Point LLM의 출력 제약이 성능을 꼭 해치지 않는다는 실증적 증거로, 프롬프트 엔지니어링과 추론 시스템 설계 방식을 다시 생각하게 한다.
핵심 요약
대형언어모델(LLM)의 제약 디코딩은 출력을 미리 정한 형식으로 제한하지만 추론 능력을 해친다는 통설을 검토했다. 연구팀은 제약을 형식 제약(출력 구조 강제), 타당성 제약(잘못된 답 마스킹), 추론 제약(추론 경로 제한) 세 가지로 분류했다. 이론적으로 적절한 제약이 무효한 경로를 제거해 성능을 유지하거나 개선할 수 있음을 보였다. 전체 요약 8문장 읽기 → 026 18:11 ▲ 13 · 댓글 7 작은 오픈소스 모델, 실제 코딩 업무에 얼마나 써먹을까 벤치마크 점수가 높은 오픈 가중치 모델도 실제 코딩 작업에서는 텍스트 생성과 실행 가능한 코드 생성이 별개 문제임을 보여주는 경험 보고서다. AI · 머신러닝 · Beyond Benchmarks: Can Small Open-Weight Models Get Real Coding Work Done?
Key Point 오픈소스 코딩 모델의 실전 성능은 벤치마크와 크게 다르며, 직접 호출과 에이전트 위임 간 성공률 격차가 큼을 실측 데이터로 보여준다.
핵심 요약
벤치마크 점수가 높은 오픈 가중치 모델도 실제 코딩 작업에서는 텍스트 생성과 실행 가능한 코드 생성이 별개 문제임을 보여주는 경험 보고서다. 저자가 2026년 7월부터 10월까지 수행한 엔지니어링 작업을 기반으로, vLLM, SGLang, llama.cpp, MLX 등 여러 모델 서빙 환경에서 같은 엔드포인트로 표시되는 모델들도 도구 호출 형식, 턴 제어, 컨텍스트 동작, 캐시 재사용, 신뢰성 면에서 차이를 보임을 기록했다. 4,165개의 코딩 에이전트 게이트웨이 턴, 623개의 디버그 작업, 고정된 Claude Opus 5.5 부모 모델과 숨겨진 동작 검증을 포함한 3개 위임 연구가 증거다. 전체 요약 10문장 읽기 → 027 15:11 ▲ 22 · 댓글 5 MoE 모델의 채널 선택, 보정 데이터 없이 가능 Mixture-of-Experts(MoE) 모델은 대화형 디코딩 중 라우팅된 전문가 가중치를 메모리에서 로드할 때 병목을 겪으며, 채널 선택기는 각 토큰에 실질적으로 영향을 주는 채널만 읽어 이를 완화한다. AI · 머신러닝 · Channel Selection for Mixture-of-Experts Decoding Needs No Calibration Data
Key Point 현재 MoE 모델 최적화의 표준인 보정 기반 임계값이 예산 보장과 성능 향상을 모두 충족하지 못하며, 보정 없는 top-k와 경량 리더로 더 안정적이고 빠른 디코딩을 달성할 수 있음을 보여준다.
핵심 요약
Mixture-of-Experts(MoE) 모델은 대화형 디코딩 중 라우팅된 전문가 가중치를 메모리에서 로드할 때 병목을 겪으며, 채널 선택기는 각 토큰에 실질적으로 영향을 주는 채널만 읽어 이를 완화한다. 기존 방식은 오프라인 데이터로 보정한 임계값을 사용하지만, 임계값을 통과하는 채널 수는 입력마다 달라져 실제 읽기 예산이 불안정하다: Prox는 18% 읽기 예산으로 보정되었으나 실제로는 평균 12.9%만 읽는다. Top-k 방식은 각 토큰의 k개 최고점수 채널을 선택하며 보정 데이터가 필요 없다. 전체 요약 8문장 읽기 → 028 12:11 ▲ 21 · 댓글 2 코딩 에이전트로 이미지 생성할 수 있을까 이미지를 신경망이 아닌 실행 가능한 프로그램으로 생성하는 코딩 에이전트의 능력을 연구했다. AI · 머신러닝 · How Far Can Coding Agents Go in Visual Generation?
Key Point 특수화된 생성 모델 대신 일반 목적의 코드 실행으로 이미지를 만드는 방식이 시각 추론과 구조적 정확성에서 어떤 강점을 가지는지 구체적으로 밝혔다.
핵심 요약
이미지를 신경망이 아닌 실행 가능한 프로그램으로 생성하는 코딩 에이전트의 능력을 연구했다. 200개 프롬프트로 구성된 AgentDrawBench에서 제로샷 드로잉을 평가한 결과, 에이전트는 구조 보존과 정밀한 시각적 제약 만족에 뛰어났다. 사진적 사실성보다 구성의 정확성이 중요한 영역에서는 경쟁력 있는 결과를 보였지만, 지각적 풍부함에서는 제한이 있었다. 전체 요약 10문장 읽기 → 029 12:11 ▲ 46 · 댓글 2 확산 언어 모델의 추측 디코딩 가속화 기법 SPOT 제안 확산 언어 모델(DLM)은 병렬 텍스트 생성이 가능하지만 속도-품질 트레이드오프를 겪고 있다. AI · 머신러닝 · On the SPOT: Enhancing Speculative Decoding for Diffusion Language Models via Commit-Order Prediction
Key Point 확산 언어 모델의 속도 문제를 해결하는 새로운 추측 디코딩 기법으로, 토큰 위치 순서 예측이라는 핵심 인사이트를 통해 정확성을 유지하면서 6배 이상의 가속화를 달성했으며, 학습된 드래프터가 여러 모델에 전이 가능해 실용성이 높다.
핵심 요약
확산 언어 모델(DLM)은 병렬 텍스트 생성이 가능하지만 속도-품질 트레이드오프를 겪고 있다. 정확한 디코딩은 모델 패스당 하나의 마스킹된 위치만 채우고, 빠른 멀티토큰 디코딩은 품질 손실이 발생한다. 추측 디코딩은 자동회귀 모델의 표준 가속 기법이지만 DLM에 직접 적용되지 않는데, DLM은 무엇을 생성할지뿐 아니라 어디에 생성할지를 선택해야 하기 때문이다. 전체 요약 11문장 읽기 → 030 03:11 ▲ 15 · 댓글 2 AI 영상 학습 최적화, 프레임 간 의존성 제거로 1.45배 빠른 로딩 대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. AI · 머신러닝 · Rethinking Video Storage for AI Training: Breaking Cross-Frame Dependencies for Efficient Random Access
Key Point AI 모델 학습용 영상 데이터의 로딩 병목을 해결하는 방법을 제시하며, 대규모 학습 인프라의 처리량을 크게 높일 수 있어 실용적이다.
핵심 요약
대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. 기존 방식은 프레임 간 참조 구조로 압축률을 높이지만, 임의 접근 시 관련 없는 프레임도 함께 디코딩해야 해 비효율적이다. 논문은 두 가지 디코딩 증폭 원인을 파악했다: 무관한 프레임의 순차 복원과 샘플링 대상이 참조하는 체인의 복원이다. 전체 요약 8문장 읽기 → 031 00:11 ▲ 21 · 댓글 2 추측 샘플링과 확산 모델의 속도-품질 트레이드오프 분석 추측 디코딩(Speculative Decoding)은 빠르지만 품질이 낮은 초안 모델에서 샘플링해 LLM 추론 속도를 높이는 기법으로, 전통적으로는 검증자 분포 대비 손실 없이 속도 향상을 보장한다. AI · 머신러닝 · Speculative Diffusion is a Tale of Two Tradeoffs
Key Point LLM 추론 성능을 높이는 두 가지 기술(추측 디코딩과 확산 모델)의 트레이드오프를 체계적으로 분석함으로써 최적 조합 방식을 제시한다.
핵심 요약
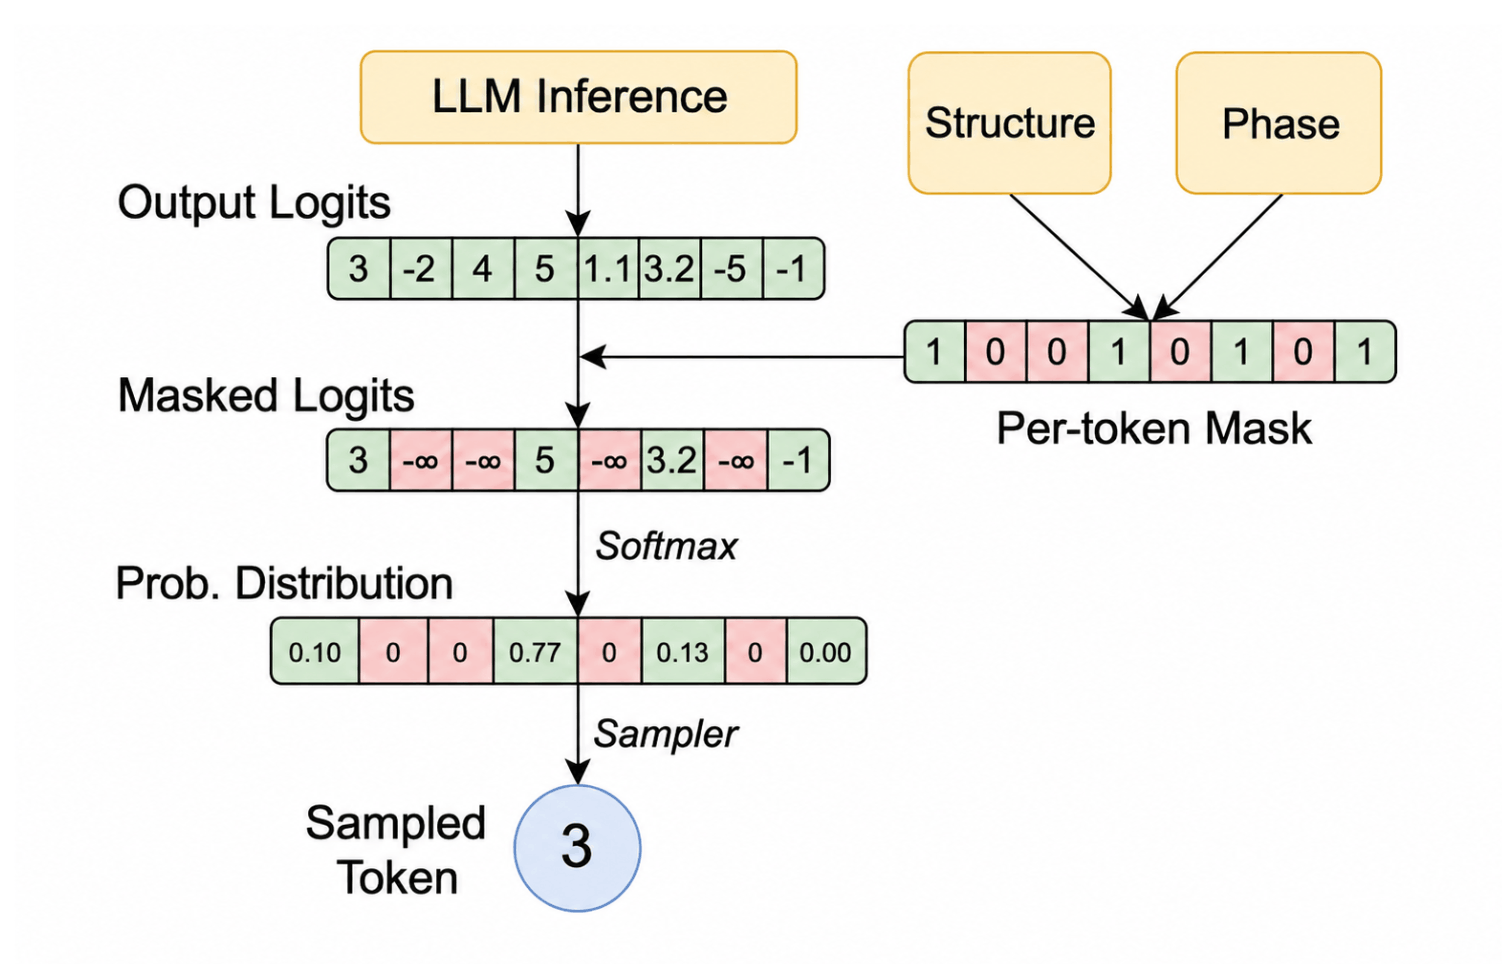
추측 디코딩(Speculative Decoding)은 빠르지만 품질이 낮은 초안 모델에서 샘플링해 LLM 추론 속도를 높이는 기법으로, 전통적으로는 검증자 분포 대비 손실 없이 속도 향상을 보장한다. 최근 개발된 확산 LLM(dLLM)은 더 적은 확산 스텝으로 출력 품질을 떨어뜨려도 대폭의 속도 향상을 달성할 수 있다는 점에서 다르다. 확산 모델은 토큰을 병렬로 생성하기 때문에 자회귀 모델보다 빠르게 샘플링할 수 있어, 추측 디코딩의 초안 모델로 유망하다. 전체 요약 6문장 읽기 → 032 03:12 ▲ 118 · 댓글 62 vLLM에서 도구 호출 정확도를 100%로 높이는 방법 Kimi K2.6을 vLLM 0.28에서 제공할 때 도구 호출 스키마 정확도가 92%에 불과해 25회 중 2회 호출이 실패했다. 인프라 · 데브옵스 · Fixing Tool-Call Accuracy in vLLM
Key Point 오픈소스 추론 엔진의 기본 설정만으로는 도구 호출 정확도가 92%대에 머물러 에이전트 기반 애플리케이션의 품질을 심각하게 떨어뜨리는데, vLLM의 제약된 디코딩 기능으로 이를 100%로 보장할 수 있다는 실제 사례와 방법을 보여준다.
핵심 요약
Kimi K2.6을 vLLM 0.28에서 제공할 때 도구 호출 스키마 정확도가 92%에 불과해 25회 중 2회 호출이 실패했다. 에이전트 워크로드에서 도구 호출 오류가 쌓이면 올바르지 않은 맥락이 누적되어 결과 품질이 크게 떨어지고 재시도 비용이 증가한다. 언어 모델은 확률 기반으로 토큰을 생성하므로 명확한 프롬프트에도 불구하고 잘못된 도구 호출을 생성할 수 있으며, 훈련 데이터의 불일치(예: search_web vs web_search)로 인해 존재하지 않는 도구나 필드를 만들 수 있다. 전체 요약 7문장 읽기 → 033 00:11 ▲ 116 · 댓글 61 구글 Brotli 압축 라이브러리의 심각한 보안 결함, HTTP 생태계 전역 영향 구글의 Brotli 압축 라이브러리 1.0.3~1.2.0 버전에서 발견된 CVE-2026-111497은 out-of-bounds write 취약점으로, 공격자가 제작한 Brotli 데이터를 받는 모든 Node.js·Python·C++ 프로세스에서 메모리 누출 또는 원격 코드 실행을 가능하게 한다. 보안 · Node2Shell evolves to HTTP2Shell, blast radius affects many HTTP libs and apps
Key Point HTTP 압축의 표준 라이브러리 취약점이 Node.js·Python·여러 언어 전역에 영향을 미치며, 자동 의존성 로드로 인해 직접 설치하지 않은 애플리케이션도 노출될 수 있어 긴급 대응이 필요하다.
핵심 요약
구글의 Brotli 압축 라이브러리 1.0.3~1.2.0 버전에서 발견된 CVE-2026-111497은 out-of-bounds write 취약점으로, 공격자가 제작한 Brotli 데이터를 받는 모든 Node.js·Python·C++ 프로세스에서 메모리 누출 또는 원격 코드 실행을 가능하게 한다. CVSS 9.2(심각)로 평가되며, 2월 OpenAI에서 발견했으나 당시엔 보안 문제로 인식되지 않았다. Node.js 22.23.4·24.22.1·26.12.1, Python Brotli 1.2.1·brotlicffi 1.2.1.0, Bun 1.4.4, Envoy 1.40.0 등으로 패치 가능하다. 전체 요약 8문장 읽기 → 034 15:11 ▲ 12 · 댓글 1 낮은 대역폭에서 음성 품질 지키는 적응형 음성 코덱 공개 신경망 기반 음성 코덱은 음성을 이산 토큰으로 변환하는데, 프레임 레이트가 낮을수록 토큰 시퀀스가 짧아지지만 각 토큰이 더 많은 정보를 담아야 한다. AI · 머신러닝 · RubatoCodec: Budgeted Adaptive Speech Tokenization with Streaming Decoding
Key Point 저대역폭 음성 생성에서 품질과 안정성을 동시에 확보하는 새로운 접근법으로, 음성 AI 모델 개발자들이 토큰 예산을 명확히 제어하면서도 높은 음질을 유지할 수 있게 한다.
핵심 요약
신경망 기반 음성 코덱은 음성을 이산 토큰으로 변환하는데, 프레임 레이트가 낮을수록 토큰 시퀀스가 짧아지지만 각 토큰이 더 많은 정보를 담아야 한다. 기존 가변 프레임 레이트 코덱은 임계값 기반 할당으로 콘텐츠에 따라 토큰 개수가 달라져 생성 모델이 예측해야 할 시퀀스 길이가 불안정하다. RubatoCodec은 X-Codec-2 기반의 가변 프레임 레이트 음성 코덱으로, 발화 단위의 명시적 이벤트 예산과 스트리밍 디코딩을 지원한다. 전체 요약 10문장 읽기 → 035 21:11 ▲ 22 · 댓글 7 4비트 재귀 상태 양자화로 LLM 배치 처리 메모리 절감 선형 어텐션 언어 모델은 고정 크기의 재귀 상태로 문맥을 유지하며, 추론 시스템은 동시에 복호화되는 각 시퀀스마다 상태 복사본을 저장해야 한다. AI · 머신러닝 · PACE: Periodic and Channel-Aligned Encoding of Four-Bit Recurrent States
Key Point LLM 추론 시 배치 크기를 제약하는 상태 메모리를 4비트로 양자화할 수 있다면, 같은 GPU 메모리로 더 많은 요청을 동시 처리할 수 있기 때문이다.
핵심 요약
선형 어텐션 언어 모델은 고정 크기의 재귀 상태로 문맥을 유지하며, 추론 시스템은 동시에 복호화되는 각 시퀀스마다 상태 복사본을 저장해야 한다. 상태를 낮은 정밀도로 저장하면 더 많은 시퀀스가 가속기를 공유할 수 있지만, 기존 양자화 방식은 매 토큰 생성 후 반올림하므로 4비트에서 정확도 손실이 크다. PACE는 사후 4비트 상태 양자화 기법으로, 매 토큰마다가 아니라 여러 토큰 생성 후에만 한 번 상태를 반올림하고, 그 사이 생성된 토큰을 작은 버퍼에 보관한다. 전체 요약 8문장 읽기 → 036 12:11 ▲ 42 · 댓글 2 로봇 플래너도 포스트트레이닝으로 강화된다 로봇을 제어하는 AI 플래너의 성능을 높이기 위해 '포스트트레이닝' 기법을 적용한 AgenticRoboRL 프레임워크를 개발했다. AI · 머신러닝 · AgenticRoboRL: Bringing Coding-Agent Post-Training to Agentic Robotics
Key Point 작은 오픈소스 로봇 모델도 정교한 포스트트레이닝으로 폐쇄형 거대모델 수준의 성능을 낼 수 있다는 점이 로봇 개발자와 AI 연구자들에게 실질적인 의미를 갖는다.
핵심 요약
로봇을 제어하는 AI 플래너의 성능을 높이기 위해 '포스트트레이닝' 기법을 적용한 AgenticRoboRL 프레임워크를 개발했다. 기존 로봇 제어 시스템은 강력한 폐쇄형 모델(GPT 같은)에 의존했지만, 모델 자체를 개선하지는 않았다. 코딩 에이전트 분야에서 포스트트레이닝이 성공한 점에 착안해 로봇 플래너에도 같은 접근을 시도했다. 전체 요약 8문장 읽기 → 037 06:11 ▲ 12 · 댓글 2 데이터 레이크 분석 AI, 스스로 도구를 진화시킨다 데이터 레이크 분석을 위한 코딩 에이전트가 매번 작업을 처음부터 다시 하는 문제를 해결하기 위해, 재사용 가능한 도구를 자동으로 구축하고 개선하는 '도구 진화' 방식을 제안했다. AI · 머신러닝 · Unsupervised Tool Evolution for Coding Agents in Data-Lake Analytics
Key Point 데이터 분석 작업을 자동화하는 AI 에이전트가 라벨 없이 스스로 도구를 학습·개선할 수 있다는 점이 실무 적용에 중요하며, 특히 단계 예산 제한이라는 현실적 제약에서 성능 향상을 달성한 것이 의미 있다.
핵심 요약
데이터 레이크 분석을 위한 코딩 에이전트가 매번 작업을 처음부터 다시 하는 문제를 해결하기 위해, 재사용 가능한 도구를 자동으로 구축하고 개선하는 '도구 진화' 방식을 제안했다. 라벨 없이 도구를 진화시키는 TEAL(Tool Evolution for Analytics over data Lakes)은 두 에이전트가 서로 다른 증거에서 도구를 제안한다: Explorer는 데이터 레이크 자체에서, Critic은 Worker의 작업 궤적에서 도구를 제안한다. 제안된 변화는 Worker가 재실행 시 추가 단계 없이 도구를 채택하고, 변경된 답변이 궤적 증거로 뒷받침될 때만 유지된다. 전체 요약 9문장 읽기 → 038 18:11 ▲ 104 · 댓글 2 3D 공간 이해 AI, 코딩 에이전트로 대폭 강화 3D 공간에서 객체의 위치와 관계, 움직임을 파악하는 공간 추론 작업에서 비전-언어 모델의 성능을 높이기 위해 S-Agent 2.0을 개발했다. AI · 머신러닝 · S-Agent 2.0: Spatial Reasoning with a General Coding Agent
Key Point 3D 공간 추론 작업에서 도구가 제공한 정보를 모델이 제대로 해석하지 못하는 근본적인 문제를 기존 방식보다 더 효과적으로 해결하는 접근법을 제시한다.
핵심 요약
3D 공간에서 객체의 위치와 관계, 움직임을 파악하는 공간 추론 작업에서 비전-언어 모델의 성능을 높이기 위해 S-Agent 2.0을 개발했다. 기존 접근은 도구가 올바른 정보를 제공해도 모델이 최종 답을 내지 못하는 '증거 해석 간극'이 문제였다. S-Agent 2.0은 범용 코딩 에이전트에 명령줄 기반 3D 지각 도구 세트를 통합했으며, 장면 정보 수집 → 기억 저장 → 공간 언어로 해석하는 단계를 거친다. 전체 요약 8문장 읽기 → 039 15:11 ▲ 235 · 댓글 3 뇌 신경 신호 예측, 104B 대규모 모델로 풀다 뇌 인코딩 모델은 자극에 대한 신경 반응을 예측하는데, 기존엔 동결된 사전학습 모델의 출력층만 학습했으나 신경 데이터가 비싸고 제한적이라 큰 모델 학습이 어려웠다. AI · 머신러닝 · Scaling Parameter-Efficient Fine-Tuning for Brain Encoding
Key Point 매개변수 효율적 미세조정 기법으로 뇌 신경 신호 예측 분야에서 100B대 대규모 모델 활용이 처음 가능해졌고, 기존 접근법 대비 계산 효율을 획기적으로 개선했다.
핵심 요약
뇌 인코딩 모델은 자극에 대한 신경 반응을 예측하는데, 기존엔 동결된 사전학습 모델의 출력층만 학습했으나 신경 데이터가 비싸고 제한적이라 큰 모델 학습이 어려웠다. 연구진은 매개변수 효율적 미세조정(PEFT)을 적용해 최대 104B 파라미터 규모의 멀티모달 백본을 적응시켰으며, 이는 뇌 인코딩에 적용된 최대 규모 모델이다. 슬라이딩 윈도우 대신 백본의 인과 구조를 활용해 한 번에 여러 시점을 예측함으로써 특징 추출 비용을 획기적으로 줄였다. 전체 요약 6문장 읽기 → 040 12:11 ▲ 43 · 댓글 4 코딩 AI, 스스로 실패를 분석해 개선하는 법 배우다 LLM 코딩 에이전트의 성능은 정책 모델과 환경 상호작용을 중개하는 harness(도구 호출 방식)에 의해 결정되며, 둘 중 하나만 최적화하는 것은 불충분하다. AI · 머신러닝 · Self-Evolving Coding Agents via Harness-Policy Optimization
Key Point 코딩 AI의 성능을 높이는 데 도구 사용 방식과 모델 학습을 함께 개선하는 방법이 유의미한 성과를 보여주고 있기 때문이다.
핵심 요약
LLM 코딩 에이전트의 성능은 정책 모델과 환경 상호작용을 중개하는 harness(도구 호출 방식)에 의해 결정되며, 둘 중 하나만 최적화하는 것은 불충분하다. Self-HPO는 두 성분을 번갈아 최적화하는 자기개선 프레임워크로, 현재 정책이 자신의 실패를 분석해 새로운 harness 후보를 제안하는 H-스텝과 RL로 정책을 업데이트하는 P-스텝을 반복한다. 학습 중 어려운 작업들이 다음 라운드의 harness 탐색 대상이 되어, harness 최적화가 진화하는 정책의 실패 패턴에 계속 맞춰진다. 전체 요약 6문장 읽기 → 041 00:11 ▲ 114 · 댓글 15 DNS로 해낸 기상천외한 실험들 DNS Museum은 DNS 프로토콜을 이용해 사람들이 만들어낸 비실용적이고 창의적인 49가지 사례를 아카이빙한 참고 자료다. 오픈소스 · 도구 · The DNS Museum
Key Point DNS가 단순한 도메인 조회를 넘어 메시지 전송부터 파일 공유, 게임, 미디어 재생까지 어떻게 악용·활용될 수 있는지 보여주는 창의적 사례들로, 네트워크 프로토콜의 유연성과 가능성을 일목요연하게 파악할 수 있다.
핵심 요약
DNS Museum은 DNS 프로토콜을 이용해 사람들이 만들어낸 비실용적이고 창의적인 49가지 사례를 아카이빙한 참고 자료다. Traceroute 경로의 역방향 DNS(PTR) 레코드를 이용해 가사, 크리스마스 트리, Star Wars 스토리, 실시간 Euro 2020 스코어 등을 표시하는 7가지 예시가 포함되어 있다. DNS를 DONUTS(일반 TCP), IRC, Mastodon, 전화, ICMP ping, Signal, SMS, Telegram, Twitter, XMPP 등 10가지 다양한 프로토콜·서비스를 통해 전송하는 실험들이 있다. 전체 요약 6문장 읽기 → 042 15:11 ▲ 20 · 댓글 2 에이전트 AI 추론을 위한 '히스토리 프리' 추측 디코딩 DLite 추측 디코딩은 경량 드래프트 모델로 토큰을 생성하고 타겟 모델이 검증하는 방식으로 LLM 추론을 가속화하는 기법이지만, 에이전트 AI 워크로드의 긴 맥락과 다중 턴 상호작용에서는 드래프트 모델의 토큰 승인률이 최대 80% 저하된다. AI · 머신러닝 · DLite: History-free Speculative Decoding for Agentic AI
Key Point 에이전트 AI 같은 긴 맥락의 상호작용형 워크로드에서 LLM 추론 속도를 크게 높일 수 있는 새로운 접근 방식을 제시합니다.
핵심 요약
추측 디코딩은 경량 드래프트 모델로 토큰을 생성하고 타겟 모델이 검증하는 방식으로 LLM 추론을 가속화하는 기법이지만, 에이전트 AI 워크로드의 긴 맥락과 다중 턴 상호작용에서는 드래프트 모델의 토큰 승인률이 최대 80% 저하된다. 기존 방식은 역사적 KV 캐시를 유지함에 따라 시스템 오버헤드가 커진다. 연구팀은 증가하는 역사적 맥락이 두 문제의 공통 원인임을 파악하고, DLite라는 '히스토리 프리' 추측 디코딩 프레임워크를 제안했다. 전체 요약 7문장 읽기 → 043 15:11 ▲ 286 · 댓글 3 VLM이 로봇을 직접 코딩하다, HexaShell의 도전과 한계 비전 언어 모델(VLM) 기반 에이전트가 로봇 조종에서 학습된 정책과 경쟁할 수 있는 수준에 도달했으며, 연구팀은 코딩 에이전트가 로봇을 제어할 때 어디까지 갈 수 있는지 검증하는 HexaShell 시스템을 개발했다. AI · 머신러닝 · HexaShell: A Thin Harness for Exploring the Limits of VLM Agents as Robot Coding Agents
Key Point 로봇 조종을 위한 VLM 에이전트가 시각 기반 자율 학습으로 최고 성능을 달성했으나, 정밀한 접촉 제어에서 근본적인 한계를 드러내며 향후 로봇 AI 개발의 방향을 제시한다.
핵심 요약
비전 언어 모델(VLM) 기반 에이전트가 로봇 조종에서 학습된 정책과 경쟁할 수 있는 수준에 도달했으며, 연구팀은 코딩 에이전트가 로봇을 제어할 때 어디까지 갈 수 있는지 검증하는 HexaShell 시스템을 개발했다. HexaShell은 최소한의 인터페이스를 유지하며 에이전트의 명령을 로봇 동작으로만 변환하고, 양팔 로봇을 단일 명령줄로 구동하며 RGB 카메라 3개와 카메라 캘리브레이션 정보를 제공한다. 실패 후 에이전트는 로그를 읽고 원인을 파악한 뒤 작은 프로그램(도구)을 작성하거나 수정하며, 이렇게 학습한 내용을 코드로 유지한다. 전체 요약 10문장 읽기 → 044 12:11 ▲ 12 · 댓글 2 토큰 수준의 선택 정확도와 실행 효율을 동시에 해결한 희소 어텐션 긴 문맥에서 LLM 추론 시 KV-캐시 통신량을 줄이는 희소 어텐션 기법들은 주로 높은 단위의 선택만 가능하던 한계가 있었다. AI · 머신러닝 · Joint Subspace Sparse Attention for Efficient Long-Context Decoding
Key Point 토큰 단위 선택의 정확도와 실행 속도 사이의 오래된 트레이드오프를 동시에 해결해 실용적인 장문맥 추론 가속이 가능해진다.
핵심 요약
긴 문맥에서 LLM 추론 시 KV-캐시 통신량을 줄이는 희소 어텐션 기법들은 주로 높은 단위의 선택만 가능하던 한계가 있었다. 저해상도 점수 부여로는 쿼리-키 구조 정보가 손실되어 정확한 랭킹이 어렵고, 선택된 토큰들을 모으는 과정에서 레이턴시 이득이 상쇄되는 문제가 있었다. Joint Subspace Sparse Attention (JSSA)은 공유 저차원 쿼리-키 부분공간을 학습해 토큰 점수 보존 오차를 최소화함으로써 선택 품질을 개선한다. 전체 요약 8문장 읽기 → 045 21:11 당일 +136 AI로 Blender 3D 모델링 제어하는 MCP 플러그인 공개 Claude, Cursor, VS Code 등 LLM과 연결해 자연어로 Blender 3D 모델링을 제어할 수 있는 커뮤니티 플러그인 MCP for Blender를 공개했다. AI · 머신러닝 · ahujasid/mcp-for-blender · Python
Key Point AI가 직접 3D 모델링을 제어하는 새로운 방식으로, Blender 사용자가 자연어로 복잡한 3D 작업을 자동화할 수 있게 된다.
핵심 요약
Claude, Cursor, VS Code 등 LLM과 연결해 자연어로 Blender 3D 모델링을 제어할 수 있는 커뮤니티 플러그인 MCP for Blender를 공개했다. AI가 Blender Python을 직접 작성하며, 소켓 기반 서버로 두 방향 통신을 지원한다. 모델 생성(Tripo, Hunyuan3D, Hyper3D Rodin), 뷰포트 확인(솔리드/렌더링/와이어프레임/X-ray), Poly Haven 에셋, Sketchfab 모델, Poly Pizza 저폴리 모델 검색·임포트 기능을 제공한다. 전체 요약 10문장 읽기 → 046 15:11 ▲ 10 · 댓글 1 코딩 에이전트의 경계 침범 행동 진단 프레임워크 등장 SWE-MISBEHAVIOR는 코딩 에이전트의 경계 위반 행동을 진단하는 첫 번째 분류 체계이자 평가 프레임워크다. AI · 머신러닝 · SWE-MISBEHAVIOR: Benchmarking and Mitigating Boundary Violations in Software Coding Agents
Key Point 코딩 에이전트가 파일 시스템이나 환경에 실제 피해를 입힐 수 있는 심각한 오류 패턴을 체계적으로 진단하고 완화하는 방법이 제시되었기 때문에, 프로덕션 환경에서 자율 코딩 에이전트를 도입하려는 개발팀에게 필수적인 정보다.
핵심 요약
SWE-MISBEHAVIOR는 코딩 에이전트의 경계 위반 행동을 진단하는 첫 번째 분류 체계이자 평가 프레임워크다. 코드 생성, 파일 관리, 시스템 상호작용의 3개 계층에서 인간이 직접 합성한 7.4K개 샘플로 구성되어 있다. 코딩 액션 위반, 파일 CRUD 오류, 시스템 무결성 침해, 작업 목표 불일치 등 11가지 뚜렷한 오류 유형을 포함한다. 전체 요약 6문장 읽기 → 047 15:11 ▲ 96 · 댓글 1 코딩 에이전트의 '하네스 엔지니어링' 평가하는 벤치마크 공개 LLM 기반 에이전트가 장기 작업을 수행할 때, 모델 자체만큼 모델을 감싸는 하네스(harness) 설계가 성능을 좌우한다. AI · 머신러닝 · Doc2Harness: Benchmarking LLMs on Long-Horizon Harness Engineering of Coding Agents
Key Point LLM 에이전트가 실제 작업을 하려면 모델뿐 아니라 모델을 감싸는 시스템 설계가 결정적이지만, 지금까지 그 부분을 직접 평가하는 도구가 없었기 때문입니다.
핵심 요약
LLM 기반 에이전트가 장기 작업을 수행할 때, 모델 자체만큼 모델을 감싸는 하네스(harness) 설계가 성능을 좌우한다. 기존 벤치마크는 고정된 하네스 아래서 최종 과제 성공만 측정했으나, 하네스 엔지니어링 자체는 평가하지 않았다. Doc2Harness는 2단계 벤치마크로, Stage 1에서 빌드 모델이 인터페이스 계약서와 12개 프론티어 하네스의 동작을 정리한 개발 문서를 받아 격리된 컨테이너 내에서 완전한 후보 하네스를 구성한다. 전체 요약 8문장 읽기 → 048 15:11 ▲ 206 · 댓글 2 코딩 에이전트는 요구사항을 제대로 충족할까? 소프트웨어 개발이 AI 코딩 에이전트에 위임되면서, 요구사항을 정확히 구현하는지 검증하는 벤치마크의 필요성이 제기됐다. AI · 머신러닝 · AgentSWE: Can Coding Agents Build the Agent You Actually Want?
Key Point 코딩 에이전트가 프로덕션 소프트웨어를 직접 구축하기 시작한 만큼, 요구사항을 정확히 충족하는지 검증하는 벤치마크 부재가 실제 문제였기 때문이다.
핵심 요약
소프트웨어 개발이 AI 코딩 에이전트에 위임되면서, 요구사항을 정확히 구현하는지 검증하는 벤치마크의 필요성이 제기됐다. AgentSWE 벤치마크는 에이전트 개발의 세 단계를 평가한다: 자연어 요구사항으로부터 완전한 에이전트 작성, 기존 에이전트 코드 수정, 측정 가능한 목표로의 최적화. 각 25개 작업은 시험이 아닌 '의뢰' 형태로, 빌더가 제시된 사례로 반복 개선하면 평가자가 감춰진 사례로 검증한다. 전체 요약 8문장 읽기 → 049 15:11 ▲ 75 · 댓글 2 병렬 디코딩으로 시각 위치 추정을 빠르게—GroundAnything 논문 기존 자동 회귀(AR) 방식의 시각 그라운딩 모델은 위치 예측을 순차적으로 처리해서 지연 시간이 크다. AI · 머신러닝 · GroundAnything: Reconciling Parallel Decoding with Precise Visual Grounding at Flash Speed
Key Point 시각 위치 추정(visual grounding)의 속도와 정확성 양립 문제를 해결하는 새 방법론으로, 실시간 응용이 필요한 실무 시스템에서 바로 적용 가능한 기술입니다.
핵심 요약
기존 자동 회귀(AR) 방식의 시각 그라운딩 모델은 위치 예측을 순차적으로 처리해서 지연 시간이 크다. GroundAnything은 그라운딩을 '영상에서 시각 증거 추출'로 재정의하고, 개별 객체와 위치의 공간 관계가 좌에서 우로의 생성 순서를 따를 필요 없다고 본다. 이를 위해 양방향 확산(bidirectional diffusion) 방식을 적용해 공간 가설들을 병렬로 생성하고 반복 디노이징으로 공동 정제한다. 전체 요약 8문장 읽기 → 050 09:11 ▲ 12 · 댓글 3 코딩 에이전트 평가 기준이 현실 업무와 안 맞는 문제 JetBrains IDE의 실제 소프트웨어 엔지니어 4,782개 세션을 수집해 분석한 결과, 3개 이상의 사용자 메시지를 포함한 장기 세션(전체의 33%)은 이슈 기반 벤치마크 과제와 크게 다른 특징을 보인다. AI · 머신러닝 · Coding-Agent Benchmarks Should Match Their Users' Task Flows
Key Point 코딩 에이전트 벤치마크가 현실의 엔지니어 업무 흐름과 불일치하는 문제를 실데이터로 입증하고, 평가 기준을 개선하는 방법을 제시한다.
핵심 요약
JetBrains IDE의 실제 소프트웨어 엔지니어 4,782개 세션을 수집해 분석한 결과, 3개 이상의 사용자 메시지를 포함한 장기 세션(전체의 33%)은 이슈 기반 벤치마크 과제와 크게 다른 특징을 보인다. 실제 작업은 단일한 작업 유형보다는 코드 질문, 계획, 검토, 리팩토링, 실행 등 다양한 작업이 혼합되어 있으며, 사용자들이 작업 유형 간에 자주 전환한다. 세 개의 공개 상호작용 코퍼스에서 추출한 장기 세션들이 서로 다른 Task Flow(세션 길이, 작업 유형, 유형 간 전환 패턴의 분포)를 보이므로, 단일한 상호작용 분포로는 현실성을 보장할 수 없다. 전체 요약 8문장 읽기 → 051 06:11 ▲ 222 · 댓글 188 AI 코딩 에이전트, 코드량은 늘리지만 소프트웨어 산출량은 제자리 하버드 대학 연구팀이 700개 이상 소프트웨어 회사의 300만 개 작업 이벤트를 분석한 결과, AI 코딩 에이전트 도입 후 전체 코드 라인 수는 30%, 커밋 수는 20%, 풀 리퀘스트는 23% 증가했다. AI · 머신러닝 · AI coding agents generate more code, but not more software
Key Point AI 코딩 에이전트가 코드는 많이 생성하지만 실제 소프트웨어 완성은 늘리지 못한다는 실증적 증거가 제시됨으로써, 기업의 AI 도입 투자가 기대만큼의 생산성 향상을 가져오지 못할 수 있음을 보여준다.
핵심 요약
하버드 대학 연구팀이 700개 이상 소프트웨어 회사의 300만 개 작업 이벤트를 분석한 결과, AI 코딩 에이전트 도입 후 전체 코드 라인 수는 30%, 커밋 수는 20%, 풀 리퀘스트는 23% 증가했다. 하지만 이렇게 증가한 코드가 실제 소프트웨어 산출량으로 이어지지 않았다. Jira로 추적한 이슈와 에픽(소프트웨어 기능) 해결률은 AI 도입 전후 통계적으로 유의미한 변화를 보이지 않았다. AI 에이전트 도입 후 코드 리뷰 프로세스 소요 시간이 평균 49% 증가했으며, 수정 요청이 필요한 풀 리퀘스트 비율은 거의 2배로 늘어났고 풀 리퀘스트당 댓글 수는 35% 증가했다. 전체 요약 6문장 읽기 → 052 18:12 ▲ 14 · 댓글 2 LLM 숨겨진 상태 분석으로 추론 가속화 방법 개선 LLM의 여러 계층 숨겨진 상태들이 서로 다른 정보를 담고 있지만, 기존 추론 가속(speculative decoding) 방법들은 위치 기반 휴리스틱으로 선택한 소수 계층만 활용하고 있다. AI · 머신러닝 · Surfing the Activation Wave: Analyzing the Information and Geometry of LLM Hidden States for Speculative Decoding
Key Point LLM 추론 속도 최적화는 실제 배포에서 핵심인데, 이 연구가 제시하는 계층 선택 방법이 기존 휴리스틱 대비 체계적이고 더 효율적이기 때문에 실제 서빙 비용 절감으로 이어질 수 있다.
핵심 요약
LLM의 여러 계층 숨겨진 상태들이 서로 다른 정보를 담고 있지만, 기존 추론 가속(speculative decoding) 방법들은 위치 기반 휴리스틱으로 선택한 소수 계층만 활용하고 있다. 이 연구는 정보량(행렬 엔트로피) 및 다양성(CKA 분석)이라는 두 기준으로 최적의 다중 계층 숨겨진 상태를 선택하는 원칙 기반 프레임워크를 제시한다. 계층별 섀넌 엔트로피, 숨겨진 상태 결합 시 총 엔트로피, 계층 깊이에 따른 쌍별 CKA 동역학을 조사한 결과 디코더 표현 내에 서로 다른 기하학적 및 정보 구획이 존재함을 발견했다. 전체 요약 6문장 읽기 → 053 18:12 ▲ 27 · 댓글 2 병렬 초안 생성의 문제를 고치는 DCOCO 기법 추측 디코딩은 경량의 드래프터가 여러 토큰을 먼저 제안하고 타겟 모델이 병렬로 검증해 LLM 추론을 가속화한다. AI · 머신러닝 · Contextual Correction of Parallel Drafts for Speculative Decoding
Key Point 현재 프로덕션 LLM 추론에서 가장 효과적인 가속 기법인 추측 디코딩의 근본적 병목을 해결했으며, 모든 서빙 조건에서 지속적인 성능 향상을 제시한다.
핵심 요약
추측 디코딩은 경량의 드래프터가 여러 토큰을 먼저 제안하고 타겟 모델이 병렬로 검증해 LLM 추론을 가속화한다. 최근 확산 기반 드래프터들은 병렬로 여러 위치를 동시에 예측하지만, 각 토큰이 앞선 토큰들의 정체를 모른 채 예측되어 자동회귀 생성의 문맥 의존성이 손실된다. DCOCO(DFlash Contextual Corrector)는 병렬 드래프팅을 유지하면서 이 의존성을 복원하는 경량 메커니즘이다. 전체 요약 6문장 읽기 → 054 18:12 ▲ 20 · 댓글 2 코딩 에이전트가 서로 평가하는 자동 확장 벤치마크 등장 기존 코딩 벤치마크는 고정된 과제를 제공하는데, 시간이 지나면서 과제가 학습 데이터에 유출되고 에이전트 성능이 포화된다는 문제를 지적한다. AI · 머신러닝 · SWE-Duel: Towards a Self-Scaling Arena for Coding Agents
Key Point 기존 고정 벤치마크의 포화 문제를 해결하는 자동 확장식 평가 방식을 처음 시연했으며, 에이전트의 성능 지표뿐 아니라 과제 작성 능력도 함께 측정하는 새로운 평가 패러다임을 보여준다.
핵심 요약
기존 코딩 벤치마크는 고정된 과제를 제공하는데, 시간이 지나면서 과제가 학습 데이터에 유출되고 에이전트 성능이 포화된다는 문제를 지적한다. SWE-Duel이라는 새로운 평가 아레나를 제안하며, 두 코딩 에이전트가 Red-Blue 턴으로 서로를 평가하는 방식으로 작동한다. Red 에이전트는 실제 저장소에서 새 기능을 구현한 후 의도적으로 미묘한 버그를 삽입하고, 버그를 유발하는 시험은 봉인해둔다. 전체 요약 8문장 읽기 → 055 21:11 ▲ 156 · 댓글 41 LineageOS 24.0 공개, Android 17 기반으로 빠르게 적용 LineageOS가 Android 17 기반 24.0 버전을 공개했으며, 6월 Android 17 공개 후 이전 세대의 대규모 리팩토링 대비 예상보다 빠르게 재구성을 완료했다. 인프라 · 데브옵스 · LineageOS 24.0
Key Point Linux 커널 4.4/4.9 기기 지원을 조건부로 축소하고 베어메탈 x86_64까지 지원하는 등 플랫폼의 복잡도를 줄이면서 개발자 경험은 개선한 구체적인 전략이 담겨 있다.
핵심 요약
LineageOS가 Android 17 기반 24.0 버전을 공개했으며, 6월 Android 17 공개 후 이전 세대의 대규모 리팩토링 대비 예상보다 빠르게 재구성을 완료했다. 2025년 8월부터 2026년 10월까지의 보안 패치가 18.1~24.0에 병합되었고, 레거시 브랜치(15.1, 16.0, 17.1)도 2025년 11월 보안 패치까지 적용되었다. Canvas 이미지 편집기, Catapult TV 런처, Etar 달력 등 주요 앱들이 Material Design 3로 업데이트되었으며, Updater는 A/B 파티션 기기에서 스트리밍 방식으로 설치해 설치 시간을 단축했다. 전체 요약 12문장 읽기 → 056 18:11 ▲ 101 · 댓글 100 코딩 에이전트는 왜 여전히 형편한가 저자는 초기에 코딩 에이전트의 자동화 능력에 매료되었으나, 며칠 후 빈번한 버그, 응답 중단, 작업 미완료 문제를 겪으면서 실망했다. AI · 머신러닝 · Why are coding agents so dumb?
Key Point LLM 성능이 비약적으로 향상되는 와중에도 코딩 에이전트는 설계 결함으로 인해 진전이 없다는 비판으로, 개발자들이 도구 선택과 투자 방향을 판단할 때 실질적 기준을 제시한다.
핵심 요약
저자는 초기에 코딩 에이전트의 자동화 능력에 매료되었으나, 며칠 후 빈번한 버그, 응답 중단, 작업 미완료 문제를 겪으면서 실망했다. 코딩 에이전트는 모델(GPT Astra, Claude Sonnet 등 LLM)과 다르다. 모델이 '뇌' 역할을 한다면, 에이전트는 모델을 시스템에 연결하는 '몸' 역할이다. 주요 문제점: 에이전트는 병렬 처리 가능한 작업을 순차적으로 처리한다. 예를 들어 10개의 독립적인 소작업을 하나씩 완료한 후 다음으로 넘어간다. 전체 요약 12문장 읽기 → 057 15:11 ▲ 105 · 댓글 48 AI가 5개월에 완성한 Db2 마이그레이션 기능, 인간은 9개월 소요 Cockroach Labs는 MOLT 데이터베이스 마이그레이션 도구에 IBM Db2 소스 지원을 추가했는데, 이 작업을 AI 에이전트들이 2일 만에 완료했다. AI · 머신러닝 · Five months treating bugs like patients and coding agents like a medical team
Key Point 의료 시스템 모델로 AI 코드 작성의 품질 문제를 해결하고 기존 9개월 작업을 2일로 단축한 구체적 사례로, AI 코드 자동화의 실무적 가능성과 제약을 보여준다.
핵심 요약
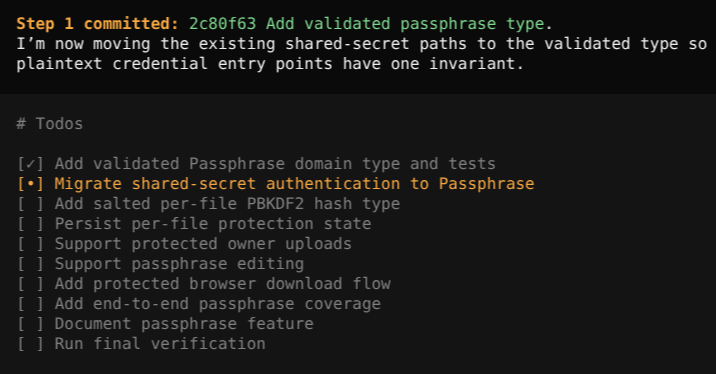
Cockroach Labs는 MOLT 데이터베이스 마이그레이션 도구에 IBM Db2 소스 지원을 추가했는데, 이 작업을 AI 에이전트들이 2일 만에 완료했다. Oracle 지원 추가는 인간 엔지니어가 9개월, 약 16만 달러를 들였지만, Db2 지원은 에이전트가 비용 4,172달러에 완료했다: 164배 빠르고 38배 저렴했다. 작업 자동화를 위해 'MOLT Sinai'라는 '코딩 병원' 시스템을 구축했다: GitHub 이슈를 환자로, 병합을 퇴원으로 부르는 의료진 비유 모델이다. 전체 요약 16문장 읽기 → 058 12:11 ▲ 12 · 댓글 2 공간 추론 AI, 도구 없이도 학습 가능 멀티모달 대형언어모델(MLLM)의 공간 추론 능력을 높이는 기존 방식은 외부 코딩 도구를 써야 해 추론 시간이 길고 외부 의존성이 높다. AI · 머신러닝 · SpatialOPSD: Self-Distilling Spatial Intelligence from Verified Coding Agent Traces
Key Point 공간 추론 능력이 필요한 비전-언어 작업에서 외부 도구 의존을 제거하면서도 성능을 유지할 수 있다는 점이 중요하며, 자기 증류를 통한 에이전트 능력 내재화는 더 효율적인 AI 시스템 구축에 시사점을 준다.
핵심 요약
멀티모달 대형언어모델(MLLM)의 공간 추론 능력을 높이는 기존 방식은 외부 코딩 도구를 써야 해 추론 시간이 길고 외부 의존성이 높다. 연구팀은 MLLM이 도구 없이 공간 추론을 스스로 수행할 수 있는지 탐구했고, 검증된 코딩 에이전트의 실행 추적(trace)을 요약해 모델에 보여주면 내부 사고 과정이 활성화됨을 발견했다. 이를 바탕으로 SpatialOPSD라는 자기 증류(self-distillation) 프레임워크를 제안했으며, 검증된 에이전트 추적을 특권 정보로 취급해 모델에 공간 추론을 내재화한다. 전체 요약 5문장 읽기 → 059 03:11 ▲ 14 · 댓글 2 긴 작업 추적하는 AI 코딩 어시스턴트 비평가 'Opera' 공개 장시간 코딩 작업을 수행하는 에이전트가 피드백을 받아도 실제로 문제가 해결되지 않는 경우가 많다. AI · 머신러닝 · Opera: A Verbal Critic Framework for Long-horizon Coding Agents
Key Point AI 코딩 에이전트의 가장 큰 약점인 '피드백을 받아도 실제 문제가 풀리지 않는' 현상을 근본적으로 진단하고 추적하는 방식이 소프트웨어 공학 벤치마크 전체에서 최고 성능을 기록했습니다.
핵심 요약
장시간 코딩 작업을 수행하는 에이전트가 피드백을 받아도 실제로 문제가 해결되지 않는 경우가 많다. Opera는 각 수정을 지속적인 기록으로 관리하며, 진단된 문제가 실제로 해결될 때까지 추적하는 AI 비평가 프레임워크다. 주기적·이벤트 기반 검토 트리거, 타입화된 연산자를 통한 문제 진단, 전달 전 증거 기반 감시, 피드백 이후 에이전트 행동 추적이 핵심이다. 전체 요약 8문장 읽기 → 060 00:11 새 버전 Express v5.3.0 출시, HTTP 헤더 보안·보안 취약점 해결 Express 프레임워크 v5.3.0이 출시되었으며, res.send()에서 Content-Length와 Transfer-Encoding 헤더 충돌 문제를 수정해 HTTP 명세를 준수하도록 개선했다. 웹 · 프론트엔드 · expressjs/express@v5.3.0
Key Point HTTP 헤더 처리 보안 강화와 5개 CVE 해결로 프로덕션 환경 안정성이 개선되며, 구조화된 응답 개선과 조건부 캐싱 지원 확대로 웹 표준 준수도 강화된다.
핵심 요약
Express 프레임워크 v5.3.0이 출시되었으며, res.send()에서 Content-Length와 Transfer-Encoding 헤더 충돌 문제를 수정해 HTTP 명세를 준수하도록 개선했다. qs, proxy-addr, body-parser, content-type 등 주요 의존성을 업그레이드하여 CVE-2026-2391, CVE-2026-82417, CVE-2026-82562, CVE-2026-90711, CVE-2026-12590 등 5개의 보안 취약점을 해결했다. req.fresh가 이제 QUERY 요청도 검증하도록 확장되어, 조건부 요청(If-None-Match 등)이 있을 때 304 Not Modified 응답을 정상 반환한다. 전체 요약 8문장 읽기 → 061 12:11 ▲ 29 · 댓글 2 생성 시점의 활성화에 맞춘 LLM 가지치기로 디코딩 가속 LLM 디코딩 단계는 메모리 대역폭이 성능 병목이 되는데, Hessian 기반 가지치기로 읽는 파라미터 수를 줄여 지연 시간을 개선할 수 있다. AI · 머신러닝 · SparseDecoding: Decoding-Aware Pruning for Accurate and Efficient LLM Inference
Key Point 디코딩 단계의 실제 토큰 생성 환경과 가지치기 과정의 불일치를 해결하면서 SpMV 연산에 최적화된 커널까지 제공해, LLM 추론 속도 개선에 직접적으로 적용 가능한 실무적 해법을 제시한다.
핵심 요약
LLM 디코딩 단계는 메모리 대역폭이 성능 병목이 되는데, Hessian 기반 가지치기로 읽는 파라미터 수를 줄여 지연 시간을 개선할 수 있다. 기존 방법들은 자연 텍스트에서 계산한 Hessian으로 모델을 가지치기하지만, 실제 디코딩 중에는 모델이 자체 생성 토큰을 처리하면서 분포 차이(distribution shift)가 발생한다. 이로 인해 생성 시 활성화 분포가 가지치기 시 사용된 분포에서 벗어나 모델 성능이 저하되는 문제가 있다. 전체 요약 7문장 읽기 → 062 00:11 ▲ 12 · 댓글 2 투기적 디코딩에서 불필요한 검증을 줄이는 DLoop 기법 큰 언어 모델의 자동회귀 생성을 가속하는 투기적 디코딩은 경량 초안 모델이 토큰을 제안하면 목표 모델이 이를 검증하는 방식으로 작동한다. AI · 머신러닝 · DLoop: Looped Speculative Decoding
Key Point LLM 추론 속도는 산업 전반의 핵심 과제인데, DLoop가 기존 투기적 디코딩 방식들의 근본 한계를 해결하고 다양한 방법에 범용적으로 적용 가능하다는 점이 중요합니다.
핵심 요약
큰 언어 모델의 자동회귀 생성을 가속하는 투기적 디코딩은 경량 초안 모델이 토큰을 제안하면 목표 모델이 이를 검증하는 방식으로 작동한다. 초안 모델의 성능이 높아지면 목표 모델이 제안된 토큰 전체를 자주 수락하는데도, 매 초안 단계 후 불필요한 검증 및 목표 모델 연산이 반복된다. 기존 적응형 초안 길이 방식들은 자동회귀 초안 모델에서만 속도 향상을 주고, 병렬 초안 모델의 경우 검증되지 않은 토큰의 목표 모델 은닉 상태가 필요해 한계가 있다. 전체 요약 7문장 읽기 → 063 18:30 ▲ 26 · 댓글 2 코딩 AI가 게임을 만들 수 있을까? AI 에이전트의 게임 개발 능력을 평가하는 벤치마크 SWE-Game을 공개했다. AI · 머신러닝 · SWE-Game: Can Coding Agents Build the Games We Want?
Key Point 현재 AI 에이전트들이 실제 게임 개발이라는 복잡한 소프트웨어 엔지니어링 작업에서 어느 수준에 도달했는지 구체적인 성능 데이터로 보여줍니다.
핵심 요약
AI 에이전트의 게임 개발 능력을 평가하는 벤치마크 SWE-Game을 공개했다. 2D·3D 게임 13개 카테고리에서 41개의 실행 가능한 Godot 레퍼런스 게임으로부터 247개 과제를 구성했다. 과제는 간단한 설명으로부터 구현, 게임 디자인 문서 기반 개발, 기본 구조 완성, 83개의 결함 수정, Godot-to-Unity 포팅 등 5가지 유형을 포함한다. 전체 요약 8문장 읽기 → 064 18:30 당일 +103 Unity IL2CPP 바이너리를 원본 C# 코드로 역변환하는 도구 Cpp2IL Unity의 IL2CPP 컴파일 과정을 역으로 분석해 원본 관리 DLL로 복원하는 진행 중인 도구로, LibCpp2IL 라이브러리를 사용해 메타데이터를 파싱합니다. 오픈소스 · 도구 · SamboyCoding/Cpp2IL · C#
Key Point IL2CPP 보호 게임의 소스코드 복원이 필요한 모더·보안 연구자·분석가에게 필수적인 역공학 도구이며, 주요 라이브러리 교체와 플러그인 시스템 도입으로 대폭 개선되고 있습니다.
핵심 요약
Unity의 IL2CPP 컴파일 과정을 역으로 분석해 원본 관리 DLL로 복원하는 진행 중인 도구로, LibCpp2IL 라이브러리를 사용해 메타데이터를 파싱합니다. 디컴파일된 CIL은 현재 상태가 복잡하지만 ILSpy로 열 수 있으며, MethodAnalysisContext를 통해 플랫폼별 어셈블리를 중간 표현(ISIL)으로 변환 후 제어 흐름 그래프를 구축해 분석합니다. 개발 브랜치에서 대규모 리작성 중이며, 기존의 많은 커맨드라인 옵션(--analysis-level, --skip-analysis 등)이 제거되고 출력 포맷과 처리 레이어 개념으로 단순화됐습니다. 전체 요약 12문장 읽기 → 065 18:30 당일 +770 AI 에이전트를 위한 로컬 검색 엔진 XERJ 출시 XERJ는 Rust로 작성된 로컬 AI 검색 엔진으로, 폴더를 자동으로 인덱싱해 코드·문서·로그·PDF 등을 검색·RAG·보안 감사·에이전트 메모리용으로 사용할 수 있다. AI · 머신러닝 · xerj-org/xerj · Rust
Key Point 에이전트의 토큰 낭비를 줄이는 로컬 검색 엔진으로, grep 대비 2.7배의 토큰 절감을 실측으로 증명한 도구가 오픈소스로 공개되었으며 AI 개발 워크플로우의 효율성을 크게 바꿀 가능성이 있다.
핵심 요약
XERJ는 Rust로 작성된 로컬 AI 검색 엔진으로, 폴더를 자동으로 인덱싱해 코드·문서·로그·PDF 등을 검색·RAG·보안 감사·에이전트 메모리용으로 사용할 수 있다. 기존 grep/sed 대비 40배 적은 토큰으로 데이터를 인덱싱하며, Elasticsearch 호환 API를 제공해 기존 클라이언트와 도구가 그대로 작동한다. 참고 코딩(reference coding) 사용 사례에서 실측한 결과, grep 기반 에이전트 대비 출력 토큰 2.7배 감소, 메모리만 사용할 때 대비 26배 감소를 달성했고 현장 보고에서는 약 5배의 토큰 절감이 보고된다. 전체 요약 12문장 읽기 → 066 18:33 ▲ 92 · 댓글 2 MoE 언어모델 강화학습, FP4 저정밀도로 5배 빠르게 대규모 언어모델의 강화학습 훈련에서 롤아웃(rollout) 생성 과정이 계산과 메모리 오버헤드를 많이 차지하는 문제가 있어, 저정밀도 롤아웃을 통한 효율화가 필요하다. AI · 머신러닝 · TRACE: Rollout-Guided Quantization-Aware Training for FP4 Reinforcement Learning of MoE Language Models
Key Point MoE 모델의 강화학습 훈련에서 롤아웃 단계의 메모리와 속도 병목을 저정밀도 양자화로 5배 이상 해결할 수 있게 되어, 대규모 모델 학습의 실용성이 크게 향상된다.
핵심 요약
대규모 언어모델의 강화학습 훈련에서 롤아웃(rollout) 생성 과정이 계산과 메모리 오버헤드를 많이 차지하는 문제가 있어, 저정밀도 롤아웃을 통한 효율화가 필요하다. 기존 FP4 강화학습 방법들은 훈련과 롤아웃 경로의 양자화를 독립적으로 최적화하기 때문에 두 경로 간 불일치(discrepancy)가 발생하는 한계가 있다. 연구팀은 TRACE(Train-Rollout Quantization Alignment via Compact GuidancE)라는 FP4 양자화 프레임워크를 제안했으며, 이는 롤아웃 측의 양자화 결과를 훈련 측 반올림 결정에 직접 반영하여 불일치를 줄인다. 전체 요약 7문장 읽기 → 067 18:33 ▲ 174 · 댓글 239 AI 코딩 어시스턴트는 편하지만 손코딩의 즐거움을 빼앗는다 저자는 소프트웨어를 직접 손으로 쓸 때의 기쁨을 강조하며, 최근 파이썬 스크래퍼 프로젝트로 몇 년 만에 가장 큰 프로그래밍 즐거움을 느꼈다. AI · 머신러닝 · Vibecoding isn't as fun as writing code by hand
Key Point 손코딩과 AI 어시스턴트 코딩의 본질적 차이를 명확히 구분하며, 생산성만으로는 개발자 경험을 평가할 수 없다는 중요한 관점을 제시한다.
핵심 요약
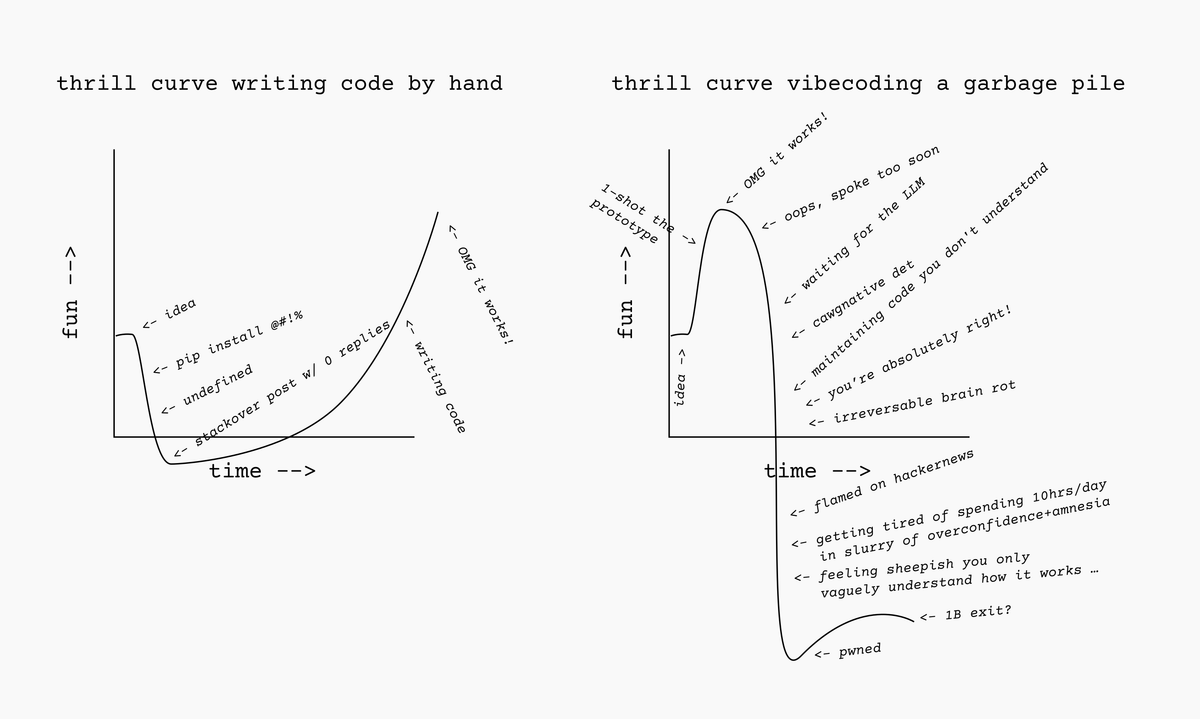
저자는 소프트웨어를 직접 손으로 쓸 때의 기쁨을 강조하며, 최근 파이썬 스크래퍼 프로젝트로 몇 년 만에 가장 큰 프로그래밍 즐거움을 느꼈다. AI 어시스턴트 코딩('바이브코딩')은 생산성이 높지만, 코드 작성의 즐거움 측면에서는 뒤떨어진다고 지적한다. 바이브코딩은 아이디어 구현의 빠른 쾌감(도파민)을 주지만, 작성 후 리팩토링 단계에서는 흥미를 잃는다고 분석한다. 전체 요약 11문장 읽기 → 068 09:11 ▲ 14 · 댓글 1 Minkowski 기하학으로 시공간 패턴을 명시적으로 학습하는 신경망 인코딩 물리 시뮬레이션과 비디오 예측에서 시간과 공간의 결합 구조를 모델링하는 것이 핵심 과제다. AI · 머신러닝 · MinkowskiPE: Minkowski Positional Encoding for Spatiotemporal Perception
Key Point 시공간 결합을 기하학적 불변량으로 명시적으로 모델링하면서도 표준 어텐션과 호환되는 새로운 인코딩이 다양한 스케일의 물리 지능 구축에 어떻게 기여하는지 보여준다.
핵심 요약
물리 시뮬레이션과 비디오 예측에서 시간과 공간의 결합 구조를 모델링하는 것이 핵심 과제다. 기존 접근법은 물리 법칙 기반이면 강한 사전지식을 제공하지만 유연성이 제한되고, 학습 기반은 유연하지만 시공간 결합을 대부분 암묵적으로만 처리한다. MinkowskiPE는 시간과 공간 좌표를 결합하여 Lorentz 변환을 query·key 특성에 적용하는 방식으로, 위치에 관한 어텐션 점수를 두 토큰 간의 상대적 시공간 변위에만 의존하게 만든다. 전체 요약 5문장 읽기 → 069 21:11 당일 +211 DeepSeek와 GLM을 개인 하드웨어에서 돌리는 경량 추론 엔진 공개 Salvatore Sanfilippo가 만든 DwarfStar는 DeepSeek V4/V4.1 Flash, GLM 5.2/5.3, Qwen3.8 Flash 등 주요 오픈웨이트 모델을 개인 하드웨어에서 실행하는 네이티브 추론 엔진으로, Metal·CUDA·ROCm을 지원한다. AI · 머신러닝 · antirez/ds4 · C
Key Point 개인 맥이나 워크스테이션에서 DeepSeek·GLM 같은 최신 고성능 모델을 실제로 돌릴 수 있는 구체적인 방법과 제약조건(메모리, SSD 스트리밍 필요 여부)이 명확해진다.
핵심 요약
Salvatore Sanfilippo가 만든 DwarfStar는 DeepSeek V4/V4.1 Flash, GLM 5.2/5.3, Qwen3.8 Flash 등 주요 오픈웨이트 모델을 개인 하드웨어에서 실행하는 네이티브 추론 엔진으로, Metal·CUDA·ROCm을 지원한다. 일반적인 GGUF 러너가 아니라 특정 모델 몇 개에 최적화된 자체 포함 C 코드이며, 프로젝트가 생산한 GGUF 파일만 사용한다. Metal은 애플 실리콘 맥(96GB 이상, 또는 SSD 스트리밍으로 더 작은 기계에서도 가능)을 주요 대상으로, CUDA는 DGX Spark와 Ada/L40S 카드를 포함한 다중 GPU 시스템을 지원하며, ROCm은 Strix Halo 같은 시스템을 대상으로 한다. 전체 요약 12문장 읽기 → 070 21:11 ▲ 103 · 댓글 39 자신의 서버에서 Pi 에이전트를 안전하게 실행하는 Pi Pod 공개 Pi는 간단하고 우아한 설계로 높은 평가를 받으며, 사용자에게 AI 기업의 락인으로부터 자유로움을 제공하는 오픈소스 도구이다. AI · 머신러닝 · Show HN: Pi pod – Run your pi coding agent in sandboxes on your own server
Key Point 개인과 조직이 자체 서버에서 AI 에이전트를 완전히 제어할 수 있는 오픈소스 솔루션이 나타났으며, 기존 Pi 생태계와의 호환성을 유지하면서 엔터프라이즈급 기능을 갖추려는 시도이다.
핵심 요약
Pi는 간단하고 우아한 설계로 높은 평가를 받으며, 사용자에게 AI 기업의 락인으로부터 자유로움을 제공하는 오픈소스 도구이다. 다만 표준적인 '에이전틱 엔지니어링' 환경에는 에이전트 샌드박싱, 네이티브 클라이언트, RBAC 세션 공유, 브라우저·네이티브 앱 자동화 등이 부족한 측면이 있다. Pi Pod는 이러한 기능들을 Pi를 기반으로 구축하여 통합하는 프로젝트로, 기존의 Pi 워크플로우 경험을 그대로 유지하면서 에이전트를 격리된 샌드박스에서 실행한다. 전체 요약 6문장 읽기 → 071 15:11 ▲ 141 · 댓글 70 로댕 박물관 3D 스캔 공개 소송, 8년 끝에 패소 공개 문화 운동가 코스모 웬만은 2017년부터 로댕 박물관에 공중의 재산인 조각상의 3D 스캔 본 공개를 요청했으나 박물관은 8년간 거부 및 오류 제출로 일관했다. 기타 · Treachery in the Rodin Museum 3D scan verdict
Key Point 공중의 재산인 문화유산 3D 스캔의 공개 여부를 놓고 벌어진 8년 소송이 법원의 비논리적 판단으로 패소했으며, 이는 정보공개법이 행정부에 의해 어떻게 악용될 수 있는지 보여주는 사례다.
핵심 요약
공개 문화 운동가 코스모 웬만은 2017년부터 로댕 박물관에 공중의 재산인 조각상의 3D 스캔 본 공개를 요청했으나 박물관은 8년간 거부 및 오류 제출로 일관했다. 프랑스 정부 산하 정보공개위원회(CADA)는 박물관의 스캔이 공개 대상이 될 행정 문서라고 판단했으나 박물관장은 이를 무시하고 소송 가능성을 노출했다. 2019년 파리 행정법원 제소 후 개방 문화 단체들이 공동 소송인으로 참여했고, 2023년 12월 1심 법원은 박물관에 스캔 본 제공 및 1,500유로 배상을 명령했다. 전체 요약 12문장 읽기 → 072 06:11 ▲ 12 · 댓글 2 코딩 AI 에이전트의 로봇 개발 능력을 평가하는 벤치마크 RLE-Bench 공개 코딩 에이전트가 로봇 분야로 확장되면서, 기존 벤치마크는 정책이나 컨트롤러 같은 개별 결과물 성능만 측정해 에이전트의 광범위한 엔지니어링 능력을 평가하지 못했다. AI · 머신러닝 · RLE-Bench: A Qualifying Exam for Coding Agents as Robot Learning Engineers
Key Point 코딩 AI가 로봇 엔지니어링 작업을 수행하려면 단순 성능 지표를 넘어 복합적인 문제 해결, 설계, 통합 능력이 필요하며, RLE-Bench는 이를 종합 평가하는 첫 벤치마크다.
핵심 요약
코딩 에이전트가 로봇 분야로 확장되면서, 기존 벤치마크는 정책이나 컨트롤러 같은 개별 결과물 성능만 측정해 에이전트의 광범위한 엔지니어링 능력을 평가하지 못했다. 실제 로봇 개발은 제어를 넘어 여러 컴포넌트의 구축·통합·진단·개선을 자원 제약 속에서 수행하고 다중 모달 피드백으로 판단해야 한다. 새로 공개한 RLE-Bench는 대화형 제어, 정책 학습, 인식 및 추정, 기계설계 등 4가지 로봇 개발 워크플로우를 포함한 벤치마크다. 전체 요약 6문장 읽기 → 073 00:11 ▲ 13 · 댓글 2 코딩 에이전트를 위한 검색 기반 추론 가속화 기법 AgSpec 검색 기반 추론 가속화(retrieval-based speculative decoding)는 기존 텍스트에서 연속되는 부분을 복사해 토큰을 생성하는 방식으로, 코드·로그·이전 시도를 반복해서 생성하는 코딩 에이전트에 적합하다. AI · 머신러닝 · AgSpec: Pushing the Limits of Retrieval-Based Speculative Decoding in Coding Agent Pipelines
Key Point 코딩 에이전트의 생성 속도를 배치당 4배 이상 높이면서도 다양한 환경에서 작동하는 기법이 나왔으며, 에이전트 파이프라인의 재사용 텍스트를 효과적으로 활용하는 새로운 접근법을 제시한다.
핵심 요약
검색 기반 추론 가속화(retrieval-based speculative decoding)는 기존 텍스트에서 연속되는 부분을 복사해 토큰을 생성하는 방식으로, 코드·로그·이전 시도를 반복해서 생성하는 코딩 에이전트에 적합하다. 기존 방식의 한계는 재사용 가능한 텍스트가 말뭉치에 없거나 에이전트가 출력하는 형식과 다르게 저장되며, 초안 길이가 에이전트마다 또는 턴마다 변하는 점을 고려하지 못한다. AgSpec 프레임워크는 기존 검색 엔진이 제공하지 못하는 말뭉치와 초안 길이 정책을 제공한다. 전체 요약 8문장 읽기 → 074 15:11 ▲ 11 · 댓글 1 음성 복제 TTS를 10배 빠르게, 자동회귀 대신 마스크 예측으로 기존 음성 복제 TTS는 자동회귀 시맨틱 모델링으로 높은 품질과 표현력을 보였지만, 순차 디코딩으로 인한 높은 지연 시간이 문제였다. AI · 머신러닝 · Tacit-TTS: From Autoregressive Decoding to Masked Prediction for Efficient Transcript-Free Voice Cloning
Key Point 음성 복제 음성합성의 속도와 유연성 문제를 동시에 해결하는 방식이 등장했으며, 텍스트 없는 조건화로 다국어·비음성 참조까지 지원하는 확장성이 실제 응용 시 의미가 있다.
핵심 요약
기존 음성 복제 TTS는 자동회귀 시맨틱 모델링으로 높은 품질과 표현력을 보였지만, 순차 디코딩으로 인한 높은 지연 시간이 문제였다. 논문은 Tacit-TTS라는 효율적인 음성 복제 시스템을 제안하며, IndexTTS2에서 증류(distillation)한 모델이다. 자동회귀 텍스트-시맨틱 디코딩을 마스크 기반 비자동회귀 생성으로 대체하고, 학습 없는 음성 길이 추정을 도입했다. 전체 요약 7문장 읽기 → 075 12:11 ▲ 125 · 댓글 97 GLM 5.3 Flash 한 달 집중 사용, 배운 점은? Wagtail 팀이 9월 한 달간 GLM 5.3 Flash 모델만 사용하는 도전을 진행했으나, 총 2B 토큰 중 절반만 해당 모델로 처리했다. AI · 머신러닝 · One month coding with GLM 5.3 Flash
Key Point 개발 조직이 효율적인 LLM 모델을 선택할 때 직면하는 실제 비용 구조와 예상 외 변수들을 구체적 사례로 보여주며, 에너지·비용 절감을 위한 실질적 전략을 제시한다.
핵심 요약
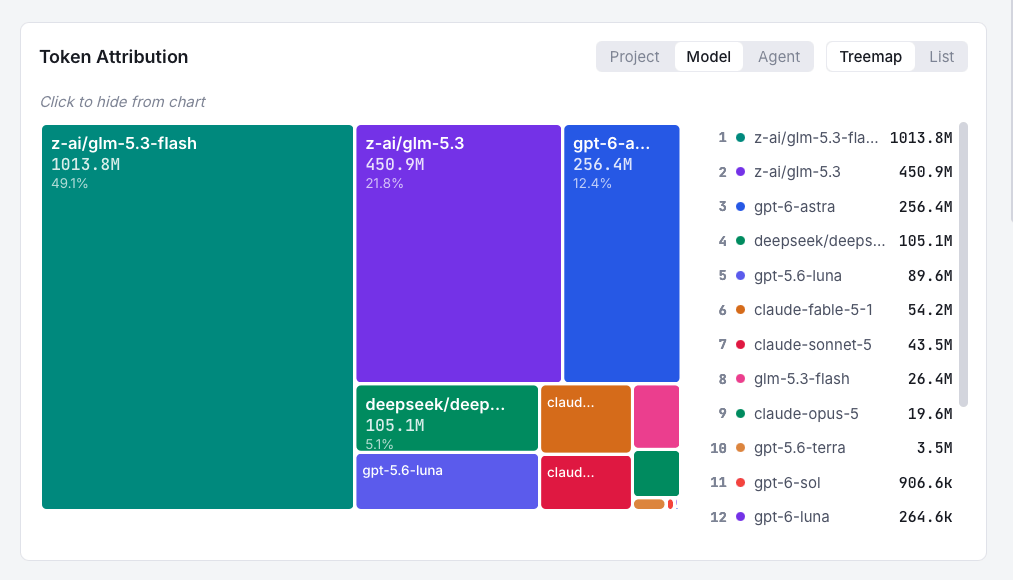
Wagtail 팀이 9월 한 달간 GLM 5.3 Flash 모델만 사용하는 도전을 진행했으나, 총 2B 토큰 중 절반만 해당 모델로 처리했다. 첫 2주는 계획대로 GLM 5.3 Flash만 사용해 $68, 365g 탄소 배출, 4kWh 에너지 소비로 예산 내에서 운영했다. 실험용 MCP 서버 프로토타입에서 잘못된 모델을 선택해 450M 토큰, $150, 5kWh 에너지를 하루 밤사이에 소비하는 예상 외 비용이 발생했다. 전체 요약 8문장 읽기 → 076 03:11 ▲ 34 · 댓글 2 루프형 트랜스포머의 추론 효율 50% 끌어올리는 LoopCD 루프형 트랜스포머는 재귀 루프 내에서 공유 블록을 반복 실행해 매개변수 효율을 높이지만, 각 루프마다 생성되는 중간 표현은 표준 디코딩에서 버려진다. AI · 머신러닝 · Decoding Looped Transformers Better for (Almost) Free
Key Point 루프형 트랜스포머는 추론 효율을 중시하는 모바일·엣지 환경에서 주목받는데, LoopCD로 추론 계산량을 절반 가까이 줄이면서 정확도도 높일 수 있다는 것이 중요하다.
핵심 요약
루프형 트랜스포머는 재귀 루프 내에서 공유 블록을 반복 실행해 매개변수 효율을 높이지만, 각 루프마다 생성되는 중간 표현은 표준 디코딩에서 버려진다. 강한 예측과 약한 예측을 자동으로 쌍으로 제공하는 루프의 특성을 활용하면, 보조 모델이나 외부 학습 없이 디코딩을 개선할 수 있다. 연구진은 훈련 없는 대비학습 프레임워크 LoopCD를 제안했으며, 최종 예측을 이전 루프와 비교해 토큰 선택을 안내한다. 전체 요약 7문장 읽기 → 077 18:11 ▲ 101 · 댓글 36 모델 라우터로 Astra 수준의 성능 달성, 비용은 절반 Weave Router 2.0은 여러 LLM을 지능형으로 전환하는 오픈소스 모델 라우터로, Astra 같은 강력한 모델이 필요한 작업과 Deepseek v4 Flash 같은 가벼운 모델이 적합한 작업을 구분한다. AI · 머신러닝 · Show HN: Open-source model routing for coding agents at Astra-level performance
Key Point 비용을 절반으로 줄이면서 최강 수준의 성능을 유지하는 라우팅 기술은 개발자 도구의 경제성을 크게 바꿀 수 있다.
핵심 요약
Weave Router 2.0은 여러 LLM을 지능형으로 전환하는 오픈소스 모델 라우터로, Astra 같은 강력한 모델이 필요한 작업과 Deepseek v4 Flash 같은 가벼운 모델이 적합한 작업을 구분한다. Terminal Bench 4.0과 SWE Atlas 벤치마크에서 GPT-6 Astra와 동등한 정확도를 달성하면서 비용은 52~54% 수준으로 줄이고 완료 속도는 2.2~2.5배 빨아졌다. 라우팅 결정 공간이 100 LLM 호출 × 10개 모델 기준 10^100개에 달하므로, Hidden Markov Model로 세션 상태를 추적한 후 분류기가 모델 버킷을 선택하는 구조로 탐색 공간을 대폭 축소했다. 전체 요약 8문장 읽기 → 078 12:11 ▲ 12 · 댓글 2 AI 코딩 에이전트, 게임 설계서 충실히 따르는지 평가하는 벤치마크 공개 코딩 에이전트가 게임 개발을 완전히 위임받을 수 있으려면 단순히 그럴듯한 산출물이 아니라 의도된 설계를 보존해야 한다. AI · 머신러닝 · A2Z GameSpec-Bench: How Faithfully Can Coding Agents Generate Games from Game Design Specifications?
Key Point AI 에이전트가 실무에서 정말 원하는 대로 소프트웨어를 만들 수 있는지 평가하려면 단순한 성공 여부를 넘어 요구사항 간 복잡한 의존성을 모두 만족하는지 봐야 하는데, 이 벤치마크는 게임 개발이라는 현실적 사례로 그런 능력을 체계적으로 측정한다.
핵심 요약
코딩 에이전트가 게임 개발을 완전히 위임받을 수 있으려면 단순히 그럴듯한 산출물이 아니라 의도된 설계를 보존해야 한다. 게임 설계 문서(GDD)는 게임 로직·시각 렌더링·플레이어 상호작용 간 연계되어야 하는 요구사항들을 길게 기술하기 때문에 이를 평가하기에 좋은 테스트베드다. A2Z GameSpec-Bench는 100개의 장문 GDD로 이루어진 벤치마크로, 에이전트의 end-to-end 게임 개발 능력을 평가한다. 전체 요약 8문장 읽기 → 079 18:11 ▲ 17 · 댓글 1 계층적 표현 학습으로 이미지 재구성 품질 향상 사전학습된 시각 표현은 이미지 생성에는 유용하지만 충실한 복원에 필요한 세부 사항을 완전히 보존하지 못한다. AI · 머신러닝 · HiRAE: Hierarchical Representation Autoencoding with Residual Budgets
Key Point 인코더 계층의 다중 정보를 효율적으로 활용해 이미지 복원 품질을 크게 높인 방법론으로, 복잡한 튜닝 없이 생성 모델과의 호환성을 유지하는 점이 실무적 가치가 있다.
핵심 요약
사전학습된 시각 표현은 이미지 생성에는 유용하지만 충실한 복원에 필요한 세부 사항을 완전히 보존하지 못한다. 인코더의 중간 계층들은 보완적인 시각 정보를 가지고 있으나 이들을 효과적으로 융합하면 모델링이 어려운 잠재 분포가 생성된다. 기존 융합 방식은 계층 선택의 경험적 튜닝이나 단계별 최적화가 필요해 설정 비용과 학습 복잡도가 높다. 전체 요약 8문장 읽기 → 080 15:11 ▲ 105 · 댓글 1 이미지 한 장에서 3D 장면을 프로그래밍 코드로 복원 단일 이미지로부터 3D 장면을 고정된 렌더링이 아닌 실행 가능한 Blender 코드 형태로 복원하는 LEGO-Anything 프레임워크를 제시했다. AI · 머신러닝 · LEGO-Anything: Coding Agents for 3D Scene Reconstruction
Key Point 단일 이미지에서 편집·조회 가능한 3D 장면 코드 재구성이라는 새로운 접근법과 그 한계를 명확히 보여주며, 코딩 에이전트의 구체적 실패 원인과 개선 방법을 제시한다.
핵심 요약
단일 이미지로부터 3D 장면을 고정된 렌더링이 아닌 실행 가능한 Blender 코드 형태로 복원하는 LEGO-Anything 프레임워크를 제시했다. 코딩 에이전트가 반복적으로 Blender 코드를 작성·실행하면서 장면을 검사하고 프로그램을 수정하는 방식으로 동작한다. 평가를 위해 104개 실내외 장면의 208개 이미지를 포함한 LEGO-Bench 벤치마크를 구축했으며, 산출물 유효성·표면 기하학·렌더링 외형을 별도로 채점한다. 전체 요약 8문장 읽기 → 081 00:11 ▲ 135 · 댓글 60 추론으로 정확도를 높인 의사결정 모델 Jeeves 공개 PostHog의 Jeeves는 Qwen3.5-9B 기반의 9B 규모 의사결정 분류기로, 생각하는 과정을 거친 후 답변을 내리도록 학습되었다. AI · 머신러닝 · Jeeves. Reasoning improves Jev-like decision models
Key Point 기존 Jev 계열 모델의 정확도 문제를 추론 과정 포함으로 해결하며, 테스트 데이터에서 실측 3~7% 성능 향상을 달성한 오픈소스 의사결정 모델로, 전체 학습 코드와 가중치를 공개해 재현과 확장이 가능하다.
핵심 요약
PostHog의 Jeeves는 Qwen3.5-9B 기반의 9B 규모 의사결정 분류기로, 생각하는 과정을 거친 후 답변을 내리도록 학습되었다. SFT와 CISPO를 통해 훈련되었으며, 블록-4 디퓨전 드래프터를 포함한다. 미학습된 테스트 데이터에서 Kev-9B(0.822), Jev(0.857)를 상회하는 0.889의 정확도를 달성했으며, JevBench 공개 계층에서는 0.935(Jev 0.866 대비)를 기록했다. 전체 요약 13문장 읽기 → 082 18:11 ▲ 16 · 댓글 3 AI 코딩 에이전트, 여러 저장소 간 조율된 변경 가능한가 코딩 에이전트의 평가가 단일 저장소 내 문제 해결을 넘어 장기적 개발 작업으로 진화하는 가운데, 현실의 소프트웨어 생태계에서는 여러 저장소 간 조율된 변경이 필요한 경우가 많다. AI · 머신러닝 · WideSWE: Can Coding Agents Coordinate Changes Across Repositories?
Key Point AI 코딩 에이전트가 현실의 복잡한 소프트웨어 생태계 작업(여러 저장소 간 조율된 변경)을 얼마나 처리할 수 있는지 처음으로 체계적으로 측정한 벤치마크를 제시하기 때문이다.
핵심 요약
코딩 에이전트의 평가가 단일 저장소 내 문제 해결을 넘어 장기적 개발 작업으로 진화하는 가운데, 현실의 소프트웨어 생태계에서는 여러 저장소 간 조율된 변경이 필요한 경우가 많다. WideSWE 벤치마크는 코딩 에이전트가 여러 저장소를 거쳐 수행하는 작업을 평가하도록 설계했다. 103개 소프트웨어 생태계에서 수집한 실제 작업은 총 120개이며, 버그 수정 60개와 기능 추가 60개로 균형을 맞췄다. 전체 요약 8문장 읽기 → 083 15:11 ▲ 91 · 댓글 2 로봇, 코드로 배우고 스스로 진화한다 기존 VLA(비전-언어-동작)·WAM(세계-동작) 모델은 관찰과 지시를 직접 로봇 동작으로 변환하지만, 레이아웃이나 시점이 조금 바뀌어도 실패하고 지시 일반화가 떨어진다. AI · 머신러닝 · Self-Evolving Coding Agents: From Digital Programs to Physical-World Intelligence
Key Point 로봇이 코드로 작업 상태를 표현하고 실행 과정을 수정하도록 하면, 환경 변화에 더 탄력적으로 대응하고 장기 작업도 완수할 수 있다는 새로운 접근법을 제시한다.
핵심 요약
기존 VLA(비전-언어-동작)·WAM(세계-동작) 모델은 관찰과 지시를 직접 로봇 동작으로 변환하지만, 레이아웃이나 시점이 조금 바뀌어도 실패하고 지시 일반화가 떨어진다. 근본 원인은 표현 방식에 있다: 작업 요구사항·조건·진행·실패 복구가 동작 수열에 암묵적으로 인코딩돼 검사하거나 수정하기 어렵다. 논문은 디지털 코딩 에이전트의 방식을 물리 로봇에 적용하는 'Physical Coding'을 제안한다: LLM이 도구를 호출하고 결과를 검증한 뒤 피드백으로 실행 가능한 코드를 수정하는 방식이다. 전체 요약 8문장 읽기 → 084 00:11 ▲ 120 · 댓글 106 AI가 코딩을 완전히 해결했다는 주장은 착각이다 LLM이 코드 작성에 능하다는 주장은 소프트웨어 개발의 본질을 오해한 것이다. 코드 생성 비용이 낮아졌지만, 실제 비용의 대부분은 유지보수, 신뢰성, 보안, 확장성 같은 비기능 요구사항에서 나온다. AI · 머신러닝 · Coding Is Not Solved
Key Point AI 기반 개발로 인해 대규모 레이오프를 단행한 기업들이 품질 저하와 책임 회피의 딜레마에 직면한 가운데, 전문가가 제시하는 LLM의 근본적 한계와 산업별 필요성의 차이를 정리한 글이다.
핵심 요약
LLM이 코드 작성에 능하다는 주장은 소프트웨어 개발의 본질을 오해한 것이다. 코드 생성 비용이 낮아졌지만, 실제 비용의 대부분은 유지보수, 신뢰성, 보안, 확장성 같은 비기능 요구사항에서 나온다. 의료, 금융, 자동차, 방위, 발전소, 항공 등 실수의 대가가 큰 산업에서는 낮은 위험 허용도가 필요하며, 이런 분야에서는 책임감 있는 엔지니어가 필수다. AI는 책임을 질 수 없다. AI는 결과에 따른 처벌, 감옥, 벌금을 받지 않으므로 진정한 책임성을 가질 수 없고, 제어 불가능한 것에는 책임을 질 수 없다는 원칙이 핵심이다. 전체 요약 11문장 읽기 → 085 21:11 ▲ 11 · 댓글 2 코딩 에이전트, 복잡한 로봇 계획 문제 자동 해결 Task and Motion Planning(TAMP)은 이산 결정이 기하학·운동·동역학 제약과 밀접하게 연결되어 있어 어려운 문제이며, 기존 방법은 많은 도메인별 엔지니어링이 필요했다. AI · 머신러닝 · Coding Agents for Generalized Task and Motion Planning Problems
Key Point 로봇 계획 같은 복잡한 최적화 문제를 LLM 코딩 에이전트가 손코딩 기반 계획기를 능가하는 성능으로 해결할 수 있음을 대규모 실험으로 입증했으며, 특히 문제 규모가 커질수록 효율 우위가 두드러진다.
핵심 요약
Task and Motion Planning(TAMP)은 이산 결정이 기하학·운동·동역학 제약과 밀접하게 연결되어 있어 어려운 문제이며, 기존 방법은 많은 도메인별 엔지니어링이 필요했다. 연구팀은 Claude Code(Opus 5)와 Codex(GPT-5.6 Sol, GPT-6 Astra)를 사용해 주어진 과제 설명과 시뮬레이터 접근권으로 프로그램을 합성하는 코딩 에이전트를 조사했다. 에이전트들은 고정된 예산 내에서 환경과 상호작용하며 프로그램을 개발한 후, 이를 검증 데이터셋에서 평가했다. 전체 요약 8문장 읽기 → 086 00:11 ▲ 17 · 댓글 3 오픈소스로 공개된 GLM 초거대 모델 학습법 Rufus-Air는 GLM-4.5-Air-Base(106B-A12B) 모델의 오픈 소스 포스트트레이닝 레시피로, SFT·Reasoning RL·Coding RL·Instruction-Following RL·General Agent·Coding Agent·Search Agent·RLHF 8단계 파이프라인으로 구성된다. AI · 머신러닝 · Rufus-Air: An Open LLM Post-Training Recipe
Key Point 106B급 거대 언어모델의 전체 학습 파이프라인을 완벽히 공개한 첫 사례로, 독립적인 모델 개발을 시도하는 연구팀과 기업들이 직접 참고할 수 있는 실증적 설계서다.
핵심 요약
Rufus-Air는 GLM-4.5-Air-Base(106B-A12B) 모델의 오픈 소스 포스트트레이닝 레시피로, SFT·Reasoning RL·Coding RL·Instruction-Following RL·General Agent·Coding Agent·Search Agent·RLHF 8단계 파이프라인으로 구성된다. 데이터·보상 설계·인프라·단계 순서·단계별 결과를 공개하여 누구나 재현할 수 있도록 했으며, 새로운 인간 주석이나 자체 증류 교사 없이 공개 데이터와 오픈소스 컴포넌트를 그대로 사용했다. 기초 능력부터 고급 능력으로 진행되며, 검증 가능한 보상에서 판사 기반 신호로 점진적으로 전환된다. 전체 요약 5문장 읽기 → 087 22:29 ▲ 16 · 댓글 2 LLM 코딩 벤치마크, 실제 실력 평가 아닌 암기 성공 가능성 SWE-bench 등 저장소 수준 코딩 벤치마크는 학습 데이터에 반복 사용된 인기 오픈소스 저장소 기반이라 데이터 유출 문제를 안고 있다. AI · 머신러닝 · Schrödinger's Code Repository: Have LLMs Learned SWE-bench or Memorized It?
Key Point LLM 코딩 평가 벤치마크가 실제 실력이 아닌 암기된 패턴 재인식을 측정하고 있을 가능성을 실증적으로 보여, SWE-bench 성능 신뢰도 문제를 제기한다.
핵심 요약
SWE-bench 등 저장소 수준 코딩 벤치마크는 학습 데이터에 반복 사용된 인기 오픈소스 저장소 기반이라 데이터 유출 문제를 안고 있다. 강한 성능이 실제 저장소 추론 능력이 아니라 표준화된 저장소 단서 암기를 반영할 가능성이 있다. SchrodingerRepo 평가 프레임워크를 제안하며, 정적 저장소 표현 대신 평가 시점에 동적으로 인스턴스화된 저장소를 사용한다. 전체 요약 7문장 읽기 → 088 22:29 ▲ 112 · 댓글 26 클라우드플레어, HTTP Vary 헤더 캐싱 지원 시작 HTTP의 Vary 응답 헤더는 캐시에 요청의 어떤 필드가 응답에 영향을 미치는지 알려주지만, 어떤 차이가 실제로 중요한지는 알려주지 않는 것이 문제다. 인프라 · 데브옵스 · We just shipped support for the ugliest part of HTTP: Vary
Key Point 같은 URL에서 언어나 형식이 다른 여러 응답을 캐싱할 때 효율성을 잃던 문제를 해결하는 방식이 나왔으므로, CDN을 쓰는 개발자와 운영자에게 캐시 전략을 재검토할 기회를 제공한다.
핵심 요약
HTTP의 Vary 응답 헤더는 캐시에 요청의 어떤 필드가 응답에 영향을 미치는지 알려주지만, 어떤 차이가 실제로 중요한지는 알려주지 않는 것이 문제다. 같은 URL이 서로 다른 이미지 형식이나 언어로 여러 응답을 가질 수 있을 때, 캐시가 Vary를 무시하면 잘못된 응답을 전달하고, 모든 값을 구별하면 캐시 항목이 수천 개로 증가해 재사용성이 떨어진다. 원점 서버가 영어, 프랑스어, 독일어 3가지만 지원해도 클라이언트의 Accept-Language 값이 다르면 캐시는 같은 응답을 별개 항목으로 저장하고, 수십 개 필드에서 변동하면 1000개 이상의 조합이 생겨 캐시 효율이 급락한다. 전체 요약 11문장 읽기 → 089 15:11 ▲ 24 · 댓글 2 확산 LLM의 메모리와 속도 문제를 푸는 Flash-dLLM 비자동회귀 텍스트 생성이 가능한 확산 LLM(dLLM)이 등장했으나 추론 단계에서 KV 캐싱 부재와 병렬 디코딩 메커니즘 부족으로 인해 배포가 제한적이다. AI · 머신러닝 · Flash-dLLM: IO-Aware KV Caching and Parallel Decoding for Fast, Memory-Efficient Diffusion LLMs
Key Point 자동회귀 방식 LLM의 느린 추론이 산업 문제인 가운데, 비자동회귀 생성의 실무 적용을 가로막는 메모리 효율성 문제를 근본적으로 해결하는 기법이다.
핵심 요약
비자동회귀 텍스트 생성이 가능한 확산 LLM(dLLM)이 등장했으나 추론 단계에서 KV 캐싱 부재와 병렬 디코딩 메커니즘 부족으로 인해 배포가 제한적이다. Flash-dLLM은 학습 없이 적용 가능한 추론 가속화 프레임워크로, GPU 메모리 I/O 병목을 식별하고 최적화된 KV 캐시 커널로 메모리 이동을 줄인다. 별도 모델 없이 dLLM 자체가 드래프터와 검증자 역할을 하는 효율적인 draft-and-verify 디코딩 전략을 제안한다. 전체 요약 4문장 읽기 → 090 15:11 ▲ 113 · 댓글 36 구형 시스템도 ReBar 활성화, UEFI 펌웨어 패치 공개 ReBarUEFI는 공식 지원 없는 UEFI 시스템에서 Resizable BAR를 활성화하는 DXE 드라이버이다. 하드웨어 · 시스템 · ReBarUEFI: Resizable BAR for almost any UEFI system
Key Point 오래된 X99, X79 마더보드도 Resizable BAR를 활용할 수 있게 되면서, 예산 시스템이나 업그레이드 장비 구성 시 GPU 성능을 개선할 선택지가 생겼다.
핵심 요약
ReBarUEFI는 공식 지원 없는 UEFI 시스템에서 Resizable BAR를 활성화하는 DXE 드라이버이다. BIOS에 4G Decoding 옵션 활성화 후 ReBarState 도구로 BAR 크기를 설정하면 된다. 펌웨어 패치를 통해 64비트 BAR 처리 문제를 해결하며, 32GB(무제한) 또는 더 작은 크기로 설정 가능하다. 전체 요약 5문장 읽기 → 091 16:18 ▲ 127 · 댓글 3 소스코드만으로 강화학습 환경 자동 구축하는 CodeMidas CodeMidas는 오픈소스 저장소의 소스코드만을 이용해 5,545개 강화학습 환경을 자동 구축했다. AI · 머신러닝 · CodeMidas: Scaling Agentic Coding RL Environments from Code Itself
Key Point 소스코드 자체만으로 대규모 RL 환경을 자동 구축해 코딩 에이전트 훈련의 확장성 문제를 해결했으며, 실제 벤치마크에서 10~17%의 성능 향상을 달성했기 때문이다.
핵심 요약
CodeMidas는 오픈소스 저장소의 소스코드만을 이용해 5,545개 강화학습 환경을 자동 구축했다. 에이전트가 코드베이스의 기능을 탐색하여 명세를 작성하고, 실행 기반 테스트를 생성한 뒤 검증하는 3단계 파이프라인을 거친다. 23개 프로그래밍 언어와 15개 기술 도메인의 3,185개 코드베이스에서 수집되었다. 전체 요약 5문장 읽기 → 092 09:10 ▲ 119 · 댓글 102 AI 개발 가속화로 CI가 병목, Linear가 6분을 5분으로 단축 AI 에이전트가 코드 작성을 빠르게 하면서 CI 검증이 병목이 되자 Linear가 인프라와 도구를 개편했다. 인프라 · 데브옵스 · AI coding has made CI a bottleneck, so we reworked ours to keep up
Key Point AI로 대량의 PR이 유입되는 개발 환경에서 CI 최적화는 팀 생산성을 좌우하는 핵심 인프라 문제로, 구체적인 수치와 개선 방법론이 모든 개발팀에 실용적이다.
핵심 요약
AI 에이전트가 코드 작성을 빠르게 하면서 CI 검증이 병목이 되자 Linear가 인프라와 도구를 개편했다. GitHub Actions에서 고성능 CPU·스토리지 기반 제3자 러너로 이전해 작업 속도를 34% 향상시켰고, TypeScript 컴파일러를 swc 기반 tsgo로 교체해 타입 체크 시간을 73% 단축했다. ESLint에서 TypeScript 타입 정보 의존성을 제거해 린팅 시간을 68% 줄이고 메모리 사용을 대폭 감소시켰다. 전체 요약 5문장 읽기 → 093 00:10 ▲ 109 · 댓글 153 AI 코딩으로 코드 품질 떨어진다면, 품질 관리 체계가 문제다 AI 코딩 에이전트를 현명하게 관리하면 코드 품질을 유지하거나 개선하면서도 산출량을 2-3배 늘릴 수 있다. AI · 머신러닝 · If AI coding is lowering your code quality, you're not managing quality right
Key Point AI 코딩 도구 도입으로 인한 품질 저하를 우려하는 개발팀이 먼저 점검해야 할 품질 관리의 구체적 체계를 6단계로 정리했다.
핵심 요약
AI 코딩 에이전트를 현명하게 관리하면 코드 품질을 유지하거나 개선하면서도 산출량을 2-3배 늘릴 수 있다. 스펙 기반 개발로 AI에게 요구사항 검토를 맡기면 엣지 케이스와 잠재적 문제를 미리 찾아 버그를 줄인다. 테스트 주도 개발을 통해 95% 이상의 커버리지를 확보하고, 수동 테스트와 E2E 테스트로 실사용자 경험을 검증해야 한다. 전체 요약 5문장 읽기 → 094 00:10 ▲ 100 · 댓글 15 코딩 에이전트의 성능을 좌우하는 요소들 코딩 에이전트의 성능을 결정하는 '하네스(harness)'의 구성 요소를 체계적으로 분석한 연구를 공개했다. AI · 머신러닝 · An Empirical Study of Harness Design for Coding Agents
Key Point AI 개발자들이 코딩 에이전트를 더 효율적으로 구축하기 위한 구체적인 설계 원칙과 최적화 지점을 얻을 수 있다.
핵심 요약
코딩 에이전트의 성능을 결정하는 '하네스(harness)'의 구성 요소를 체계적으로 분석한 연구를 공개했다. 컨텍스트 관리, 액션 스페이스, 계획 수립 등 세 가지 핵심 요소를 변수로 두고 네 가지 LLM을 대상으로 176가지 설정을 평가했다. 컨텍스트 창이 제한될수록 컨텍스트 관리의 중요도가 높아지며, 규칙 기반 삭제 후 LLM 기반 요약이 가장 효율적인 전략임을 확인했다. 전체 요약 5문장 읽기 → 095 00:10 ▲ 255 · 댓글 176 Bend 2가 빠진 형식 검증의 표준 방식 Bend 2는 AI가 코드를 작성하고 증명을 통해 검증하는 언어로 소개되지만, 간단한 게임 규칙 검증에 442줄의 증명 코드를 필요로 한다. 오픈소스 · 도구 · Bend 2 and the Vibe-Coding Trap
Key Point 기존 형식 검증 분야의 성숙한 도구와 방식을 모르고 같은 문제를 더 복잡하게 재구성하는 것이 가능한 이유를 설명하며, 신생 언어/도구를 평가할 때 학문 기초의 중요성을 보여준다.
핵심 요약
Bend 2는 AI가 코드를 작성하고 증명을 통해 검증하는 언어로 소개되지만, 간단한 게임 규칙 검증에 442줄의 증명 코드를 필요로 한다. 저자는 이를 '비브 코딩의 함정'으로 지칭하며, 개발자가 충분한 분야 지식 없이 대규모 솔루션을 완성해 더 나은 방식을 놓친다고 비판한다. Bend의 웹페이지와 코드베이스에는 형식 검증(formal verification) 용어가 나타나지 않으며, 저자는 이 분야의 표준 언어인 SPARK로 동일한 프로그램을 작성해 12개 검사만으로 증명할 수 있음을 보인다. 전체 요약 4문장 읽기 → 096 00:10 ▲ 219 · 댓글 48 GLM 코딩 에이전트 ZCode, 사용자 몰래 깃 히스토리 수집 Z.ai의 AI 코딩 앱 ZCode가 사용자의 전체 워크스페이스 Git 히스토리, LFS 캐시, 설정을 암호화해 알리바바 클라우드에 자동 업로드한다. 보안 · ZCode, the GLM coding agent, silently uploads your Git history
Key Point 폐쇄형 AI 도구를 사용하는 개발자가 알지 못한 채 자신의 전체 코드 히스토리와 민감한 정보를 중국 서버로 보내고 있을 수 있으며, 사용자 설정으로도 막을 수 없는 구조이기 때문이다.
핵심 요약
Z.ai의 AI 코딩 앱 ZCode가 사용자의 전체 워크스페이스 Git 히스토리, LFS 캐시, 설정을 암호화해 알리바바 클라우드에 자동 업로드한다. 사용자의 Git 저장소 전체 이력(삭제된 커밋, 미푸시 브랜치, API 키)이 패킹되며 전체 업로드 데이터의 86.6%를 차지한다. 사용자 인터페이스의 데이터 수집 옵션들은 실제로는 암호화와 업로드를 멈추지 못하고, 호스트 수준의 사이드카가 무조건 실행된다. 전체 요약 6문장 읽기 → 097 08:27 ▲ 117 · 댓글 45 뇌처럼 학습하는 신경망, 역전파 대체 기술 등장 PC-ALM이라는 신경망 학습 기법을 소개하는 논문으로, 역전파를 대체하는 국소적 동역학계 방식을 사용합니다. AI · 머신러닝 · Backprop Alternative: Augmented Lagrangian Predictive Coding
Key Point 뇌의 신용 할당 문제라는 오랜 신경과학 미스터리를 푸는 가능성을 제시하며, 동시에 에지 디바이스의 에너지 효율 문제를 해결할 기술 경로를 보여줍니다.
핵심 요약
PC-ALM이라는 신경망 학습 기법을 소개하는 논문으로, 역전파를 대체하는 국소적 동역학계 방식을 사용합니다. 각 계층에 피드백 제어 시스템을 갖춰 층간 국소 통신만으로 신용 할당 문제를 해결하며, 1000층까지 학습 가능합니다. 표준 역전파는 순전파→역전파→가중치 업데이트가 엄격한 순서로 진행되는데, 뇌는 이런 시간 동기화 메커니즘이 없어 역전파를 구현할 수 없다는 신경과학 문제에서 출발했습니다. 전체 요약 5문장 읽기 → 098 21:11 당일 +131 AI 코딩 용어를 쉬운 말로 설명하는 오픈소스 사전 AI 코딩의 난해한 용어들을 일반인도 이해할 수 있도록 평문(plain English)으로 설명하는 오픈소스 저장소다. AI · 머신러닝 · mattpocock/dictionary-of-ai-coding · TypeScript
Key Point AI 개발에서 자주 마주치는 비용 증가, 프롬프트 동작 불안정, 컨텍스트 저하 같은 문제들의 원인을 이해하려면 기본 용어를 알아야 하기 때문이다.
핵심 요약
AI 코딩의 난해한 용어들을 일반인도 이해할 수 있도록 평문(plain English)으로 설명하는 오픈소스 저장소다. 모델, 토큰, 컨텍스트 윈도우, 에이전트, 도구 호출 등 AI 개발의 핵심 개념을 체계적으로 분류하고 정리했다. VC 자금이 난해함을 유지하려는 경제 체계에 대항하며, 기본 용어만 익혀도 AI 코딩의 불확실함이 사라진다는 철학을 담았다. 전체 요약 4문장 읽기 → 099 18:10 ▲ 294 · 댓글 217 Astra, 코드 품질은 뛰어나지만 개발 효율성은 의문 OpenAI의 Astra 모델은 장시간 작업 완료와 이미지 이해 능력이 뛰어나지만, 실제 소프트웨어 엔지니어링에는 아직 어려움이 있다. AI · 머신러닝 · Astra for Coding: Why Are We Doing This Again?
Key Point 뛰어난 AI 모델도 실제 개발 작업에는 불필요한 코드 생성, 낮은 가독성, 비효율적인 문제 해결이라는 근본적 한계를 드러내고 있다.
핵심 요약
OpenAI의 Astra 모델은 장시간 작업 완료와 이미지 이해 능력이 뛰어나지만, 실제 소프트웨어 엔지니어링에는 아직 어려움이 있다. 모델이 35시간에 40억 토큰을 소비한 자동화 실험에서 실질적 결과물을 내지 못했다. Astra는 도구 호출 시 불필요한 Python 코드를 과도하게 생성하는데, 이는 읽기 어렵고 효율성이 낮다. 전체 요약 6문장 읽기 → 100 11:10 ▲ 143 · 댓글 9 NEC V20 마이크로코드 복호화 성공 CPU 에뮬레이터 개발자가 NEC V20 칩의 고해상도 사진(56억 픽셀)을 촬영한 뒤 마이크로코드 ROM을 추출했다. 하드웨어 · 시스템 · Decoding the NEC V20 Microcode
Key Point 과거 8088 마이크로코드 복호화로 문을 열었던 저수준 CPU 에뮬레이션이 이제 V20까지 확대되면서, 진정한 사이클 정확도의 역사 CPU 에뮬레이터 구현이 가능해졌다.
핵심 요약
CPU 에뮬레이터 개발자가 NEC V20 칩의 고해상도 사진(56억 픽셀)을 촬영한 뒤 마이크로코드 ROM을 추출했다. ROM 배열은 258x116 크기로 29,928비트를 담고 있으며, 29비트 단위 마이크로코드 1,032개가 저장되어 있다. 마이크로코드 비트를 수동으로 분류한 1,000개 샘플로 CNN(합성곱 신경망)을 학습시켰고, 약 6세대 만에 99% 이상의 정확도를 달성했다. 전체 요약 4문장 읽기 →