쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 5일 (목)까지 3984건
100건 (최대치) · "진화"조건 지우기 ×
001 00:11 ▲ 11 · 댓글 1 4B 모델로 컴퓨터 조작 에이전트 SOTA 달성 Mage-VL-Cowork는 GUI 상호작용과 코드·터미널 실행을 하나의 정책으로 통합하는 4B 파라미터 하이브리드 컴퓨터 사용 에이전트(CUA)다. AI · 머신러닝 · Mage-VL-Cowork: A Full Training Recipe to Learn Hybrid Computer Use From Evolved Harnesses
Key Point 파라미터 수가 작으면서도 복잡한 컴퓨터 조작 작업을 수행할 수 있는 에이전트 개발 방법이 제시되어, 온디바이스 AI 활용과 효율적인 에이전트 학습의 새로운 가능성을 보여준다.
핵심 요약
Mage-VL-Cowork는 GUI 상호작용과 코드·터미널 실행을 하나의 정책으로 통합하는 4B 파라미터 하이브리드 컴퓨터 사용 에이전트(CUA)다. 일반적인 멀티모달 정렬 체크포인트에서 출발해 미드트레이닝·감독학습·강화학습을 포함한 5단계 점진적 교육 과정을 거친다. Mage-CUA-Forge는 작업별 에이전트 구성을 재사용 가능한 스킬 조건부 생성 워크플로우로 대체하여 293,806개의 데스크톱·웹 작업을 6,915개 스킬로 합성한다. 전체 요약 7문장 읽기 → 002 00:11 ▲ 103 · 댓글 38 50년 전 유닉스, 어떻게 메모리 할당했을까 1973년 유닉스 V4의 원본 소스를 분석한 고고학적 탐구로, C 언어 초기의 메모리 관리 방식을 추적한다. 오픈소스 · 도구 · The lost malloc()
Key Point 현재의 C/C++ 메모리 할당 방식이 왜 그렇게 설계되었는지, 그리고 더 나은 대안이 존재했음을 보여주는 컴퓨터 과학 역사의 흥미로운 사례입니다.
핵심 요약
1973년 유닉스 V4의 원본 소스를 분석한 고고학적 탐구로, C 언어 초기의 메모리 관리 방식을 추적한다. V4 컴파일러는 선형 할당(linear allocator)을 사용했는데, 메모리를 정렬한 후 충분한 공간이 있는지 확인하고 sbrk()로 힙을 확장했으며, 메모리 해제는 전혀 고려하지 않았다. Dennis Ritchie가 작성한 malloc.c는 흥미로운 인터페이스를 가졌는데, malloc(coremap, size)와 mfree(coremap, size, pointer) 형태로 명시적 메모리 영역을 전달받았다. 전체 요약 10문장 읽기 → 003 18:11 ▲ 23 · 댓글 1 LLM 다중에이전트 팀 조직, 상호작용 규칙을 함께 진화시키는 프레임워크 LLM 기반 다중에이전트 시스템(MAS)은 복잡한 작업 해결을 위해 전문화된 에이전트 간 협력에 의존한다. AI · 머신러닝 · EvoTeam: Multi-Agent Collaboration via Evolving Teams
Key Point 다중에이전트 시스템의 협력을 진화시키는 새로운 접근법으로, 팀 조직과 상호작용 규칙을 동시에 개선하는 메커니즘이 기존 개별 에이전트 최적화의 한계를 극복한다.
핵심 요약
LLM 기반 다중에이전트 시스템(MAS)은 복잡한 작업 해결을 위해 전문화된 에이전트 간 협력에 의존한다. 기존 방식은 개별 에이전트의 프롬프트, 스킬, 실행 전략을 개선하지만 팀 협력 향상으로 직결되지 않는 문제가 있다. 최근 연구들은 진화를 협력 수준으로 확장해 집단 실행 경험으로 팀 조직과 에이전트 간 상호작용을 조정하고 있다. 전체 요약 8문장 읽기 → 004 15:11 ▲ 51 · 댓글 1 비디오 생성의 병목은 렌더링에서 의미 제어로 넘어갔다 비디오 생성 기술이 짧은 영상 클립에서 장면 간 일관성 있는 오디오-비주얼 시퀀스로 진화했으며, 이제 병목이 화질 렌더링에서 의미 제어로 옮겨가고 있다. AI · 머신러닝 · Behind Video Generation: Observations and Insights on Multimodal Understanding from Kling
Key Point 비디오 생성 시스템의 모든 모듈(캡셔닝, 프롬프트 강화, 보상 모델링, 평가)을 구체적으로 어떻게 설계했는지 보여주는 실전 가이드라 비디오 생성 연구자와 개발자에게 직접 적용할 수 있다.
핵심 요약
비디오 생성 기술이 짧은 영상 클립에서 장면 간 일관성 있는 오디오-비주얼 시퀀스로 진화했으며, 이제 병목이 화질 렌더링에서 의미 제어로 옮겨가고 있다. Kling의 다세대 개발을 통해 얻은 다중모달 이해에 관한 통찰을 정리한 보고서로, 생성 품질은 데이터-조건화-정렬-평가 전체 파이프라인을 통한 다중모달 이해의 투영이라고 주장한다. Kling-MLLM은 이미지, 비디오, 오디오, 동기화된 오디오-비디오, 인터리빙 입력을 통합하는 공유 다중모달 기초 모델이며, 각 후속 모듈에 맞춰 특화된다. 전체 요약 9문장 읽기 → 005 15:11 ▲ 26 · 댓글 1 통합 멀티모달 모델용 대규모 대화형 데이터셋 공개 통합 멀티모달 모델(UMM)은 시각 이해, 생성, 편집을 하나의 프레임워크에서 수행하지만 기존 데이터셋은 단순 작업 중심이었다. AI · 머신러닝 · YANAMI: A Large-Scale Multimodal Dataset and Benchmark for Multiturn Stateful Interaction
Key Point 멀티모달 AI가 단순 일회성 작업을 넘어 복잡한 대화 흐름에서 상태를 정확히 관리해야 하는 시대에, 이를 평가할 첫 대규모 벤치마크가 공개되었기 때문이다.
핵심 요약
통합 멀티모달 모델(UMM)은 시각 이해, 생성, 편집을 하나의 프레임워크에서 수행하지만 기존 데이터셋은 단순 작업 중심이었다. 최근 다중 턴 데이터셋도 각 턴을 독립적으로 풀 수 있어, 대화 상태를 추적하고 유지해야 하는 상태형 상호작용을 평가하기 부족했다. YANAMI는 상태형 상호작용을 위한 첫 대규모 멀티모달 대화 데이터셋으로 YANAMI-400K와 YANAMI-Bench로 구성된다. 전체 요약 8문장 읽기 → 006 12:11 ▲ 15 · 댓글 1 과거 정보로 일관성 높인 장시간 영상 생성 모델 적은 단계의 자동회귀 비디오 확산 모델은 효율적인 생성이 가능하지만, 피사체나 장면이 화면 밖에 나갔다 다시 등장할 때 일관성을 유지하기 어렵다. AI · 머신러닝 · History Forcing: Distilling History-Dependent Continuations for Long-Horizon Video World Models
Key Point 긴 장면에서도 일관성 있는 영상을 생성하는 것이 영상 AI 모델의 핵심 과제인데, 이 논문이 제시한 History Forcing 방법이 화면 밖 재등장이나 60초 롱폼 생성에서 구체적 성능 개선을 이뤄냈기 때문이다.
핵심 요약
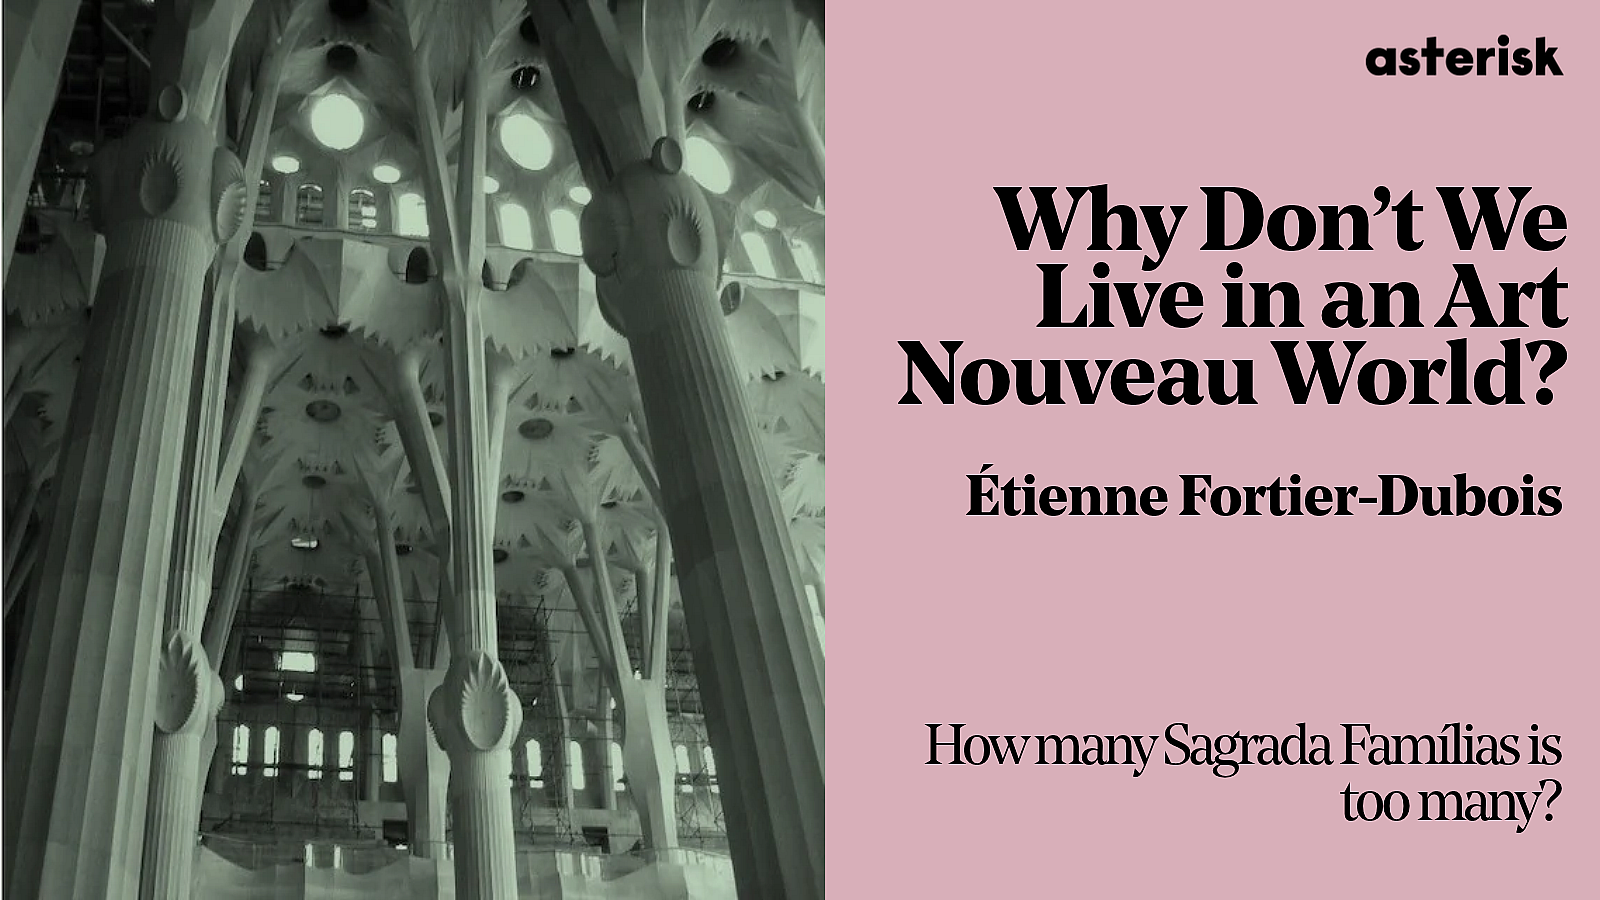
적은 단계의 자동회귀 비디오 확산 모델은 효율적인 생성이 가능하지만, 피사체나 장면이 화면 밖에 나갔다 다시 등장할 때 일관성을 유지하기 어렵다. 기존 증류 방법들은 역사적 정보를 충분히 활용하지 못해 학생 모델의 현재 예측을 제약하지 못한다는 한계가 있다. 이를 해결하기 위해 History Forcing이라는 통합 온폴리시 증류 프레임워크를 제안했다. 전체 요약 7문장 읽기 → 007 06:11 ▲ 111 · 댓글 101 아르누보 스타일이 사라진 까닭, 도시 설계에 답 있다 사그라다 파밀리아 완공을 계기로, 왜 현대 도시는 아르누보 건축으로 채워지지 않았는가 하는 의문을 제기한다. 기타 · Why Don't We Live in an Art Nouveau World?
Key Point 현대 도시의 획일화가 문화 쇠퇴보다 한 가지 스타일의 시스템적 독점에서 비롯된 이유를 역사 사례로 설명한다.
핵심 요약
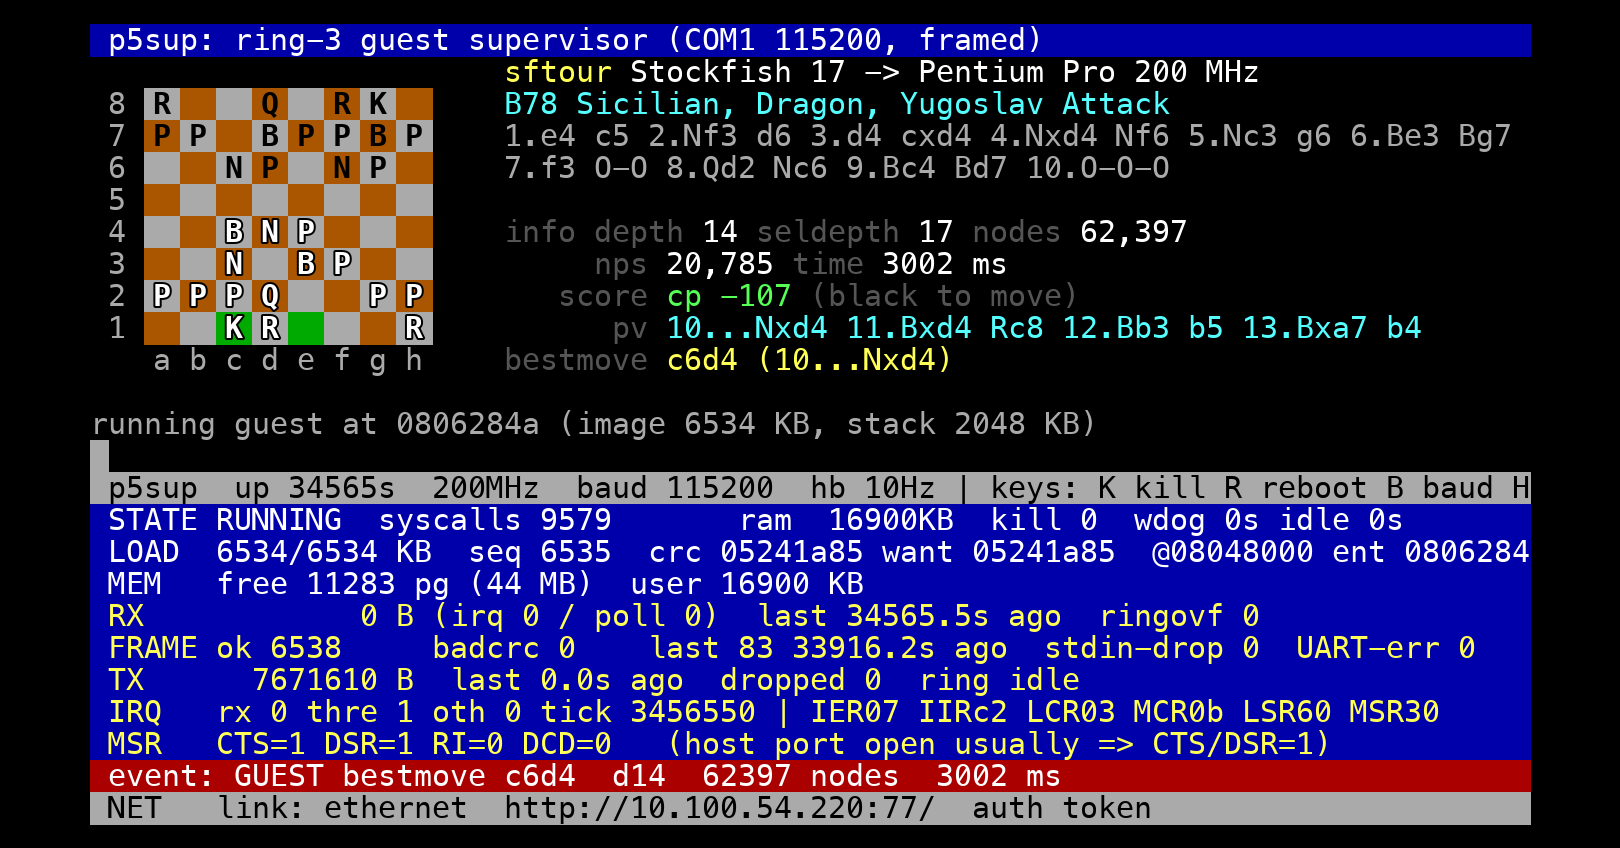
사그라다 파밀리아 완공을 계기로, 왜 현대 도시는 아르누보 건축으로 채워지지 않았는가 하는 의문을 제기한다. 아르누보(1890~1910년경)는 19세기 역사주의와 절충주의에 대한 반발로 출발한 곡선·비대칭·풍부한 장식을 특징으로 하는 운동이었으며, 브뤼셀에서 시작해 파리와 유럽 전역으로 확산되었다. 카탈루냐의 모더니스메 운동(아르누보의 지역 변종)을 예로, 산타우 병원 방문 경험을 토대로 과도한 장식이 시간이 지남에 따라 인지 피로를 일으키고 심미성이 빠르게 퇴색함을 지적한다. 전체 요약 11문장 읽기 → 008 00:11 ▲ 189 · 댓글 97 1995년 펜티엄에서 현대 체스 엔진이라면 카스파로프를 이길 수 있을까? 1996년 IBM의 딥블루가 세계 챔피언 카스파로프를 처음 이겼으나, 이는 30개의 P2SC 프로세서와 480개의 커스텀 VLSI 칩으로 수백만 달러를 들여 만든 특수 목적 컴퓨터였다. AI · 머신러닝 · Could a modern chess engine on a Pentium have defeated Kasparov in 1996?
Key Point 체스 엔진의 역사적 진화에서 하드웨어 성능 향상보다 알고리즘 개선이 더 큰 역할을 했다는 실증적 발견은, 현대 AI 시스템의 성능 개선 방향에 대한 시사점을 제시한다.
핵심 요약
1996년 IBM의 딥블루가 세계 챔피언 카스파로프를 처음 이겼으나, 이는 30개의 P2SC 프로세서와 480개의 커스텀 VLSI 칩으로 수백만 달러를 들여 만든 특수 목적 컴퓨터였다. 저자는 31년 전 1995년 11월 출시된 200MHz 펜티엄 프로 (64MB RAM)에서 스톡피시를 포팅해 실행했을 때, 약 3300±87 Elo 정도의 수준에 도달했는데 이는 카스파로프의 2800 Elo를 크게 앞서고 있다. 체스 강화의 세 가지 방법은 더 많은 수를 분석하거나, 더 좋은 수를 선택하거나, 더 잘 평가하는 것인데, 현대 체스 엔진의 진화는 주로 후자 두 가지에서 나온다. 전체 요약 11문장 읽기 → 009 18:11 ▲ 16 · 댓글 1 사용자를 대신하는 AI 에이전트, 개인 목표를 얼마나 잘 이루는가 개인 AI 에이전트가 장기 작업을 처리할 수 있어지고 있으나, 사용자는 여전히 목표 설정·애매함 해결·결과 검증에 상당한 노력을 들여야 한다. AI · 머신러닝 · Avatar Intelligence: Amplifying Human Agency Through Persistent Personal Agents
Key Point 개인용 AI 에이전트의 자율성을 높이되 사용자 통제를 유지하려면 무엇이 필요한지, 기존 접근과 달라지는 평가 관점이 무엇인지 보여준다.
핵심 요약
개인 AI 에이전트가 장기 작업을 처리할 수 있어지고 있으나, 사용자는 여전히 목표 설정·애매함 해결·결과 검증에 상당한 노력을 들여야 한다. 아바타 인텔리전스(Avatar Intelligence) 패러다임을 제안한다: 사용자의 목표·가치·제약을 여러 상황과 시간에 걸쳐 지속적으로 대리 결정하는 개인화된 영구적 에이전트다. 성숙도 로드맵은 인간 지시 실행에서 위임된 도메인 내 자율 운영으로 진행되며, 에이전트 운영 비용과 인간 감시 부담 대비 전달된 가치를 평가하는 에이전틱 오버사이트 지수(AOI)를 제시한다. 전체 요약 5문장 읽기 → 010 15:11 ▲ 31 · 댓글 1 대규모 경험으로 AI 컴퓨터 제어 에이전트를 강화하는 NorthCUA NorthCUA는 컴퓨터 제어 에이전트를 복잡한 소프트웨어 작업까지 확장하기 위한 통합 시스템이다. AI · 머신러닝 · NorthCUA Technical Report: Turbocharging Computer-Use Agents through Experience at Scale
Key Point 컴퓨터 제어 AI가 복잡한 소프트웨어 작업을 자동화할 수 있는 수준으로 도달하는 과정을 보여주며, 오픈소스 에이전트 개발의 새로운 기준을 제시한다.
핵심 요약
NorthCUA는 컴퓨터 제어 에이전트를 복잡한 소프트웨어 작업까지 확장하기 위한 통합 시스템이다. Experience Flywheel이 다양한 실행 가능한 작업을 공급하고, NorthCUA Harness가 장시간 상호작용을 유지하며 의사결정을 기록하고 작업 결과를 검증한다. Flywheel은 이러한 기록으로부터 검증된 궤적(trajectory)을 선별하고, 해결되지 않은 작업은 재귀적 자가개선을 통해 재사용 가능한 스킬을 진화시키면서 검증된 마일스톤을 보존해 이전 진행 과정을 바탕으로 한다. 전체 요약 7문장 읽기 → 011 15:11 ▲ 22 · 댓글 1 모달리티 넘나드는 임베딩 모델, 통합 프레임워크로 재정의 이미지, 텍스트, 음성 등 모달리티별로 분화된 임베딩 모델 연구가 실은 대조 학습, Transformer 아키텍처, 세밀도 전환이라는 공통 원리로 수렴하고 있다고 지적한다. AI · 머신러닝 · From Fragmentation to Fusion: A Survey and Roadmap for Omnimodal Embeddings
Key Point 멀티모달 AI의 핵심 기술인 임베딩의 분산된 연구를 처음 통합 프레임워크로 정리해, 앞으로의 모달리티 간 통합 기술 발전 방향을 가늠할 수 있습니다.
핵심 요약
이미지, 텍스트, 음성 등 모달리티별로 분화된 임베딩 모델 연구가 실은 대조 학습, Transformer 아키텍처, 세밀도 전환이라는 공통 원리로 수렴하고 있다고 지적한다. 논문은 멀티모달 임베딩의 진화 경로를 세 가지 진행 단계로 정의한다: 커버리지 확대, 비교 가능성 확보, 구성성 달성이다. 각 단계를 위한 통합 방안으로 변환(transformation)은 모달리티 간 커버리지를 확대하고, 정렬(alignment)은 서로 다른 모달리티를 비교 가능하게 만든다. 전체 요약 6문장 읽기 → 012 18:11 ▲ 39 · 댓글 2 이미지 생성을 위한 '연속 공간 추론' 통합 멀티모달 모델 LARC 통합 멀티모달 모델(UMM)이 다양한 멀티모달 작업에서 성공하지만, 언어 기반 사고 체인을 활용한 이미지 생성에서는 약점을 보인다. AI · 머신러닝 · Latent Reasoning in Continuous Space for Unified Multimodal Models
Key Point 이미지 생성 모델에서 추론과 생성의 공간 불일치를 해결하는 새로운 접근법으로, 테스트 시간 스케일링과 더 나은 제어 능력을 가능하게 한다.
핵심 요약
통합 멀티모달 모델(UMM)이 다양한 멀티모달 작업에서 성공하지만, 언어 기반 사고 체인을 활용한 이미지 생성에서는 약점을 보인다. 기존 추론 강화 모델들은 큰언어모델처럼 테스트 시간 스케일링이나 세밀한 제어 능력을 갖지 못하는데, 추론이 이산 토큰 공간에서 이뤄지면서 이미지 생성의 연속 공간과 불일치하기 때문이다. 연속 공간 잠재 추론(LARC) 프레임워크는 연속 숨겨진 상태를 기반으로 추론하여 토큰 수준의 병목을 해결한다. 전체 요약 6문장 읽기 → 013 15:11 ▲ 52 · 댓글 3 에이전트가 자가 개선하는 오케스트레이션 기법 R²Orch 복잡한 작업을 여러 스킬을 조합해 해결하는 에이전트 오케스트레이션은 수작업 커리큘럼, 롤아웃이 같은 결과에 도달할 때의 이점 붕괴, 신뢰할 수 없는 평가 신호 같은 문제가 있다. AI · 머신러닝 · R^2Orch: Recursive Self-Improvement for Agent Orchestration via Self-Play within a Skill-Internalization Loop
Key Point 에이전트 시스템이 인간 개입 없이 자신의 약점을 스스로 찾아 개선하는 방식이 제시되어, 복합 작업 해결에 필요한 에이전트 아키텍처의 진화 방향을 보여준다.
핵심 요약
복잡한 작업을 여러 스킬을 조합해 해결하는 에이전트 오케스트레이션은 수작업 커리큘럼, 롤아웃이 같은 결과에 도달할 때의 이점 붕괴, 신뢰할 수 없는 평가 신호 같은 문제가 있다. 이를 해결하기 위해 R²Orch는 내부 루프의 자가 대전으로 오케스트레이터를 개선하고 외부 루프로 내부 루프의 개선 방식 자체를 개선하는 재귀적 자가 대전 오케스트레이션 패러다임을 제안한다. 핵심은 '재귀적 학습 가능성(Recursive Learnability)' 목표로, 제안자가 스킬 철수 시에도 롤아웃이 계속 다양한 결과에 도달하는 작업을 선택하도록 보상한다. 전체 요약 6문장 읽기 → 014 15:11 ▲ 27 · 댓글 2 로봇 조작에 계층적 미래 예측을 더하다 로봇 조작 작업을 위한 Vision-Language-Action(VLA) 모델이 시각 인식, 언어 이해, 행동 생성을 통합해 성과를 내고 있으나, 기존 방법들은 단기 역학과 장기 목표를 따로 모델링하고 미래 예측을 행동 요구사항과의 연관성 없이 사용하고 있다. AI · 머신러닝 · HiFOR: Hierarchical Foresight with Action-Guided World Grounding for Vision-Language-Action Model
Key Point 로봇이 복잡한 작업을 수행할 때 단기 환경 변화와 장기 목표를 동시에 고려하는 방식이 어떻게 작동하는지 보여주는 새로운 기술 진전으로, 로봇 자동화 분야의 실제 구현 가능성을 높인다.
핵심 요약
로봇 조작 작업을 위한 Vision-Language-Action(VLA) 모델이 시각 인식, 언어 이해, 행동 생성을 통합해 성과를 내고 있으나, 기존 방법들은 단기 역학과 장기 목표를 따로 모델링하고 미래 예측을 행동 요구사항과의 연관성 없이 사용하고 있다. 이를 개선하기 위해 HiFOR은 계층적 미래 예측과 행동 유도 월드 검색을 결합한 프레임워크를 제안한다. 계층적 미래 예측은 단기 상태 변화, 의미론적 마일스톤, 최종 목표 상태를 계층적 의존성 마스크(HDM)를 통해 함께 예측해 시간축 간 의존성을 설정한다. 전체 요약 6문장 읽기 → 015 06:11 ▲ 184 · 댓글 205 영국 녹색당, 수십 년 핵발전 반대 정책 폐기 영국과 웨일스 녹색당이 당원 투표를 통해 핵발전 반대 정책을 폐기하고, 핵발전 단계적 폐지 약속을 중단했다. 기타 · UK Green party drops longstanding opposition to nuclear power
Key Point 수십 년간 유지해온 환경 정책을 근본적으로 바꾸는 결정이며, 기후 위기 대응 전략에서 핵발전을 어떻게 위치지을 것인가 하는 국제적 논쟁의 실제 사례입니다.
핵심 요약
영국과 웨일스 녹색당이 당원 투표를 통해 핵발전 반대 정책을 폐기하고, 핵발전 단계적 폐지 약속을 중단했다. 기존의 '핵분열에 대한 절대 반대' 입장을 버리고, 핵 프로젝트를 다른 저탄소 기술과 함께 사안별로 평가하기로 방침을 바꿨다. 당의 전력 정책은 여전히 해상풍력, 육상풍력, 옥상태양광을 1차 전원으로 우선하지만, 선출직 당원들이 새 원전을 개별 사안별로 지지할 수 있도록 허용하는 내용이다. 전체 요약 8문장 읽기 → 016 21:11 ▲ 103 · 댓글 72 지구를 망원경으로, 블랙홀 사진 찍기 블랙홀은 우주에서 가장 작은 천체인데도 매우 밝을 수 있으며, 중력이 너무 강해 빛도 탈출할 수 없는 사건의 지평선으로 정의된다. 기타 · How do you take a picture of a black hole?
Key Point 블랙홀 사진 촬영의 역사, 기술, 국제 협력의 규모를 담은 구체적 내용을 통해 과학의 불가능해 보이는 목표가 어떻게 실현되는지 이해할 수 있다.
핵심 요약
블랙홀은 우주에서 가장 작은 천체인데도 매우 밝을 수 있으며, 중력이 너무 강해 빛도 탈출할 수 없는 사건의 지평선으로 정의된다. 하버드 천체물리학자 셉 도엘먼이 이끈 250명의 연구팀은 사건의 지평선 망원경(EHT)이라는 전 지구적 라디오 망원경 네트워크를 구축해 블랙홀의 첫 이미지를 촬영했다. 망원경의 각도 분해능은 빛의 파장을 망원경 크기로 나눈 값인데, 블랙홀 같은 극도로 작은 천체를 보려면 매우 짧은 파장과 거대한 망원경이 필요하다. 전체 요약 13문장 읽기 → 017 12:11 ▲ 10 · 댓글 4 영상 이해 AI, 불확실할 땐 질문하게 하기 멀티모달 대형언어모델의 발전으로 영상 이해 상호작용 방식이 오프라인에서 스트리밍, 주도적 상호작용으로 진화했고, 모델이 능동적으로 답할지 말지 결정하는 단계에 이르렀다. AI · 머신러닝 · AskStream: When and What to Ask Proactively under Uncertainty in Streaming Video Understanding
Key Point 스트리밍 비디오 분석 AI가 정보 부족 상황을 인식하고 능동적으로 질문하도록 훈련할 수 있는지가 새로운 기술 과제가 되고 있기 때문입니다.
핵심 요약
멀티모달 대형언어모델의 발전으로 영상 이해 상호작용 방식이 오프라인에서 스트리밍, 주도적 상호작용으로 진화했고, 모델이 능동적으로 답할지 말지 결정하는 단계에 이르렀다. 기존 주도적 상호작용 방식은 답변에 필요한 정보가 완전하다고 가정해 모델이 대기하거나 답하기만 하도록 설계됐으나, 실제로는 영상이나 사용자 질문의 불확실성으로 정보가 불완전한 경우가 많다. 불완전한 정보 상황에서 기존 방식은 모델이 영원히 대기하거나 환각적 응답을 생성하는 문제를 야기한다. 전체 요약 8문장 읽기 → 018 00:11 ▲ 13 · 댓글 3 하나의 모델로 모든 형식 파싱하는 유투 옴니 파서 공개 유투 파싱 옴니는 문서, 이미지, 오디오, 비디오를 구조화된 기록으로 변환하는 멀티모달 파서로, 공간과 시간에 기반해 증거를 찾고 인용할 수 있다. AI · 머신러닝 · Youtu-Parsing-Omni: One Encoder, One Schema, All Modalities
Key Point 멀티모달 구조화 파싱을 하나의 소규모 모델로 처리하면서 각 모달리티별 전문 모델 수준의 성능을 달성한 방식이 기술적으로 의미 있으며, 공개 모델로서 개발자들이 실제로 활용할 수 있는 선택지를 제공한다.
핵심 요약
유투 파싱 옴니는 문서, 이미지, 오디오, 비디오를 구조화된 기록으로 변환하는 멀티모달 파서로, 공간과 시간에 기반해 증거를 찾고 인용할 수 있다. 모든 모달리티를 하나의 인코더로 처리하고 모든 태스크를 하나의 스키마로 통일한 설계를 기반으로 한다. 유투 옴니 인코더는 사전학습 언어모델에서 초기화되어 모든 모달리티를 통일된 시공간 좌표계에서 공유 가중치로 인코딩하며, 퓨전 레이어가 비디오 프레임의 동시 오디오 어텐션을 가능하게 한다. 전체 요약 9문장 읽기 → 019 15:11 ▲ 23 · 댓글 2 자연어로 완성된 게임을 만드는 AI 프레임워크 VibeGame LLM 에이전트를 이용한 소프트웨어 개발은 가능했지만, 게임 개발처럼 코드·장면·에셋·애니메이션·물리·설정을 모두 조율해야 하는 작업은 여전히 도전 과제였다. AI · 머신러닝 · VibeGame: Prompt-to-Game Development with AI-Native Engine and Self-Evolving Adversarial Agent Team
Key Point LLM 에이전트로 복잡한 게임 개발 전 과정을 자동화할 수 있는 새로운 접근법을 제시하며, 특히 8개 에이전트의 협력 구조와 자기 진화 메커니즘이 AI 소프트웨어 개발 방법론의 진전을 보여준다.
핵심 요약
LLM 에이전트를 이용한 소프트웨어 개발은 가능했지만, 게임 개발처럼 코드·장면·에셋·애니메이션·물리·설정을 모두 조율해야 하는 작업은 여전히 도전 과제였다. VibeGame은 자연어 프롬프트와 선택적 참고 이미지로부터 완성된 2D 게임 프로젝트를 생성하는 프레임워크다. AI-native 게임 엔진은 프로젝트 상태를 스키마 검증된 구조화된 텍스트로 표현하고 프레임 동기식 런타임 제어를 제공해, 에이전트가 게임 상태를 검사하고 액션을 실행하며 동작을 자신의 속도로 검증할 수 있다. 전체 요약 7문장 읽기 → 020 00:11 ▲ 17 · 댓글 2 LLM이 자유탐사로 숨겨진 물리 법칙을 발견할 수 있을까 과학 발견은 예상 밖의 관찰에서 시작되곤 한다. 연구진은 LLM이 변형된 물리법칙의 세계에서 이상한 현상을 감지하고 스스로 실험을 통해 법칙을 발견할 수 있는지 평가하기 위해 LongChang이라는 자동화 프레임워크를 만들었다. AI · 머신러닝 · Can LLMs Uncover Hidden Physical Laws through Free Exploration?
Key Point LLM의 과학적 탐사 능력이 현저하게 제한적이라는 결과는 AI의 자율 연구 가능성을 평가하는 중요한 벤치마크를 제시한다.
핵심 요약
과학 발견은 예상 밖의 관찰에서 시작되곤 한다. 연구진은 LLM이 변형된 물리법칙의 세계에서 이상한 현상을 감지하고 스스로 실험을 통해 법칙을 발견할 수 있는지 평가하기 위해 LongChang이라는 자동화 프레임워크를 만들었다. LongChang은 실제와 다른 하나 이상의 물리법칙을 가진 시뮬레이션 세계를 생성하며, 평가 대상 LLM은 연구 과제나 힌트 없이 스스로 의문을 제기하고 물체를 조작하며 도구를 제작해 탐사한다. 별도의 LLM 에이전트들이 장면을 생성하고 검토하며, 도구 설계를 평가하고, 탐사 기록을 바탕으로 보고서의 정확성을 검증한다. 전체 요약 6문장 읽기 → 021 21:11 당일 +152 로컬 배포 가능한 개인용 AI 어시스턴트 QwenPaw Qwen 기반 개인용 AI 어시스턴트 QwenPaw를 공개했으며, 로컬 또는 클라우드에 배포 가능하고 DingTalk, Lark, WeChat, Discord, Telegram 등 다양한 메신저를 지원한다. AI · 머신러닝 · agentscope-ai/QwenPaw · TypeScript
Key Point 로컬 배포로 데이터 프라이버시를 보장하면서도 멀티 채널 지원과 고급 보안 기능을 갖춘 오픈소스 AI 어시스턴트가 공개되어, 개인/팀 단위의 자동화와 협업 워크플로우를 완전히 자체 제어할 수 있게 되었다.
핵심 요약
Qwen 기반 개인용 AI 어시스턴트 QwenPaw를 공개했으며, 로컬 또는 클라우드에 배포 가능하고 DingTalk, Lark, WeChat, Discord, Telegram 등 다양한 메신저를 지원한다. 3계층 메모리 시스템을 갖추고 있다: 실시간 작업 맥락, 전체 대화 기록, ReMe 기반의 자체 진화하는 개인 지식베이스로 대화와 자료가 마크다운 메모리로 변환되어 검색 및 연결이 가능하다. 에이전트 작업에 최적화된 QwenPaw-Flash 모델(2B/4B/9B/35B-A3B/27B)을 자체 개발했으며, API 키 없이 로컬 실행이 가능하거나 Ollama, LM Studio, 14개 이상의 클라우드 제공자를 지원한다. 전체 요약 13문장 읽기 → 022 21:11 당일 +225 AI 펜테스터 Shannon, 오픈소스로 공개 Keygraph가 개발한 Shannon은 웹 애플리케이션과 API의 자동 펜테스트 도구로, 소스 코드 분석과 실제 익스플로잇 실행을 결합해 취약점을 증명한다. 보안 · KeygraphHQ/shannon · TypeScript
Key Point 소스 코드 분석과 실제 익스플로잇으로 취약점을 증명하는 AI 펜테스터를 직접 실행할 수 있게 되어, 개발 주기마다 자동 보안 테스트가 가능해진다.
핵심 요약
Keygraph가 개발한 Shannon은 웹 애플리케이션과 API의 자동 펜테스트 도구로, 소스 코드 분석과 실제 익스플로잇 실행을 결합해 취약점을 증명한다. 소스 코드에서 공격 경로를 식별한 후 브라우저 자동화와 CLI 도구로 실행 중인 애플리케이션을 공격하며, 재현 가능한 개념 증명(PoC)이 있는 취약점만 보고에 포함시킨다. Shannon OSS는 TypeScript 기반 오픈소스 저장소로 로컬에서 CLI를 통해 실행되며, AGPL-3.0 라이선스 하에서 개인 개발자와 소규모 팀에 적합하다. 전체 요약 12문장 읽기 → 023 15:11 ▲ 389 · 댓글 3 멀티모달 에이전트의 자동 성장 체계 'Trinity' 공개 멀티모달 에이전트의 자동 진화를 위해 환경 생성과 작업 학습을 함께 진행하는 'The Trinity' 프레임워크가 제안되었다. AI · 머신러닝 · The Trinity:Capability-Driven Recursive Self-Improvement for Multimodal Agents
Key Point 멀티모달 에이전트의 확장성을 해결하는 자동 성장 프레임워크로, 수작업 없이 능력 기반으로 환경과 모듈을 동시에 진화시키는 혁신적 방식을 보여준다.
핵심 요약
멀티모달 에이전트의 자동 진화를 위해 환경 생성과 작업 학습을 함께 진행하는 'The Trinity' 프레임워크가 제안되었다. 기존 방식은 검증 가능한 환경 구축과 수동 작업 설계에 비용이 많이 드는 문제를 마주했다. 핵심 아이디어는 겉모양은 다르지만 같은 능력 요구사항을 가진 작업들을 찾아내 계층적으로 정리하는 것이다. 전체 요약 8문장 읽기 → 024 09:11 ▲ 132 · 댓글 3 테스트 시간 메모리 진화, 학습 필요 없이 LLM 성능 향상 테스트 타임 트레이닝(TTT)은 오픈 가중치 LLM을 과학 발견 작업에서 최첨단 모델 수준으로 끌어올렸으나, 추론 중 온라인 가중치 업데이트로 인한 계산 비용이 큰 문제다. AI · 머신러닝 · Can Test-Time Memory Evolution Outperform Test-Time Training for Scientific Discovery?
Key Point 가중치 업데이트 없이 메모리만 활용해 추론 비용을 47~58% 줄이면서 오히려 성능을 높인 방법이 공개되어, LLM 기반 과학 연구의 실용성을 크게 높일 수 있다.
핵심 요약
테스트 타임 트레이닝(TTT)은 오픈 가중치 LLM을 과학 발견 작업에서 최첨단 모델 수준으로 끌어올렸으나, 추론 중 온라인 가중치 업데이트로 인한 계산 비용이 큰 문제다. 이를 해결하기 위해 연구팀은 테스트 타임 메모리 진화(TTME)를 제안했다. TTME는 모델 가중치를 업데이트하지 않고 외부 메모리만 계속 갱신하면서 경험을 증류하여 이후 발견을 유도한다. 전체 요약 7문장 읽기 → 025 00:11 ▲ 26 · 댓글 2 LLM 에이전트 강화학습의 신용 할당 문제 해결한 ProAS 프레임워크 LLM 에이전트 최적화에 쓰이는 강화학습에서 GRPO 같은 무비평가 알고리즘은 모든 행동에 같은 수준의 이점을 부여하는 균일 신용 할당의 근본적 한계를 가진다. AI · 머신러닝 · ProAS: A Progress-Aware Advantage Shaping Framework for Multi-Turn Agentic Reinforcement Learning
Key Point 다단계 추론이 필요한 LLM 에이전트의 강화학습 효율성을 크게 개선하는 방법론이 제시되어, 언어 모델 기반 자동화 시스템의 성능 향상에 직결된다.
핵심 요약
LLM 에이전트 최적화에 쓰이는 강화학습에서 GRPO 같은 무비평가 알고리즘은 모든 행동에 같은 수준의 이점을 부여하는 균일 신용 할당의 근본적 한계를 가진다. 이 접근 방식은 선호되는 궤적에서 구조적으로 비합리적인 행동을 강화하고, 비선호 궤적에서 각 행동의 하위 편차를 무시한다. ProAS는 동적으로 진화하는 에이전틱 레퍼런스 그래프(ARG)를 활용해 비합리적 인센티브 마스킹(MUI)과 비대칭 페널티 재배분(APR)을 통한 세밀한 신용 할당을 구현한다. 전체 요약 5문장 읽기 → 026 18:11 ▲ 136 · 댓글 2 강화학습 자기 증류로 언어모델 추론 능력 향상 언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다. AI · 머신러닝 · Function-Space Temporal Self-Distillation for Policy Optimization
Key Point 언어모델 훈련 효율성과 메모리 사용량을 동시에 개선하는 새로운 자기 증류 방식이 공개되어, 대규모 모델 개발 비용 절감에 관심 있는 연구자와 개발자가 참고할 만하다.
핵심 요약
언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다. 자기 증류는 보조 없는 정책과 피드백 기반 자기교사를 비교해 토큰 수준의 밀집된 지도를 제공하지만, 교사 모델이 학생과 함께 진화하면서 불안정한 목표와 추가 정규화의 필요성을 야기한다. 논문은 함수 공간 정책 최적화(FSPO)를 제안하며, 현재 특권화된 적응과 함수 공간 시간적 통합을 하나의 정책 프레임워크에서 결합한다. 전체 요약 8문장 읽기 → 027 15:11 ▲ 117 · 댓글 2 AI 에이전트가 신뢰할 수 있는 업무를 수행하려면 파운데이션 모델이 정보 생성에서 디지털 업무 실행으로 진화하면서 복잡한 작업을 여러 도구와 애플리케이션, 워크플로우에서 완수하는 에이전트가 등장했다. AI · 머신러닝 · Work Agents: Systems, Capabilities, and Optimization
Key Point 에이전트 기술이 실제 업무 자동화로 확대되는 시점에 신뢰성 있는 작업 수행의 조건과 평가 방식을 체계적으로 정리한 프레임워크로, AI 에이전트의 현실적 배포를 고민하는 개발자와 연구자에게 실질적 지침을 준다.
핵심 요약
파운데이션 모델이 정보 생성에서 디지털 업무 실행으로 진화하면서 복잡한 작업을 여러 도구와 애플리케이션, 워크플로우에서 완수하는 에이전트가 등장했다. 이 논문은 에이전트를 파운데이션 모델과 런타임 하니스를 결합해 상태 관리 워크스페이스에서 작업을 실행하고 검증 가능한 결과를 전달하는 시스템으로 정의한다. 작업 지속성과 작업 개방성 두 차원으로 작업 조건을 분류하고, 작업 범위와 조직에 따라 디지털 업무를 다섯 가지 형태로 구분했다. 전체 요약 6문장 읽기 → 028 15:11 ▲ 38 · 댓글 2 LLM으로 과학 원리를 실시간 구축하는 'Principia' 프레임워크 과학적 발견에는 관찰된 현상 뒤에 있는 과학 원리를 파악하는 것이 필수적인데, 복잡한 발견 과정에서 이러한 경험적 원리는 대부분 미지의 상태로 남아있다. AI · 머신러닝 · Principia: Test-Time Hypotheses to Principle Construction for Scientific Discovery
Key Point 과학 발견 과정에서 원리 도출의 병목을 자동화하고, 테스트 타임에 진화하는 지식 구축 방식이 여러 분자·생물학 영역에서 기존 방법을 능가하는 성과를 입증했다.
핵심 요약
과학적 발견에는 관찰된 현상 뒤에 있는 과학 원리를 파악하는 것이 필수적인데, 복잡한 발견 과정에서 이러한 경험적 원리는 대부분 미지의 상태로 남아있다. 기존 방식은 가설을 원리로 변환하는 단계에서 방대한 영역 전문지식·시간·노력이 필요해 병목이 되고 있다. Principia는 LLM 기반 프레임워크로, 테스트 타임에 과학 원리를 구축하고 지속적으로 개선한다. 전체 요약 7문장 읽기 → 029 15:11 ▲ 28 · 댓글 2 에이전트의 변화하는 도구에 대한 적응력을 평가하는 벤치마크 공개 AI 에이전트가 진화하는 도구 생태계에 얼마나 잘 적응하는지 평가하기 위해 Δτ-Bench라는 실행 가능한 벤치마크를 소개했다. AI · 머신러닝 · Δτ-Bench: Pushing Agents Toward a Moving Capability
Key Point LLM 기반 에이전트가 실무 환경에서 마주하는 도구 변화에 얼마나 적응할 수 있는지 보여주는 새로운 평가 기준으로, 기존 벤치마크의 한계를 직접 드러내고 해결책을 제시했기 때문이다.
핵심 요약
AI 에이전트가 진화하는 도구 생태계에 얼마나 잘 적응하는지 평가하기 위해 Δτ-Bench라는 실행 가능한 벤치마크를 소개했다. 이 벤치마크는 1,588개의 검증된 멀티턴 작업과 42개 도메인, 6개의 연속적인 생태계 상태를 포함하며, 도구가 사라지거나 교체되고 더 효율적인 대안이 등장하는 현실을 모델링한다. 기존 벤치마크는 에이전트가 효율적인 도구 사용 경로를 주동적으로 발견하고 축적된 절차적 지식을 신속하게 수정할 수 있는지 검사하지 않는다. 전체 요약 6문장 읽기 → 030 12:11 ▲ 253 · 댓글 2 비전-언어 모델의 능동형 상호작용, 사용자 의도 예측으로 진화 비전-언어 모델이 수동적 이해에서 능동적 상호작용으로 전환 중이나, 기존 방식은 명시적 요청에만 의존하고 사용자의 암묵적 의도(예: '다음에 어디를 클릭해야 할까')를 놓치며 상태를 실시간 업데이트하지 못하는 한계가 있다. AI · 머신러닝 · StreamVibe: Proactive Video Agents for Evolving User Intent
Key Point 비디오 에이전트가 사용자가 명시적으로 말하지 않은 의도까지 예측해 선제적으로 대응할 수 있게 되는 것은 웹 네비게이션, 콘텐츠 추천 등 실무 적용 영역이 크기 때문이다.
핵심 요약
비전-언어 모델이 수동적 이해에서 능동적 상호작용으로 전환 중이나, 기존 방식은 명시적 요청에만 의존하고 사용자의 암묵적 의도(예: '다음에 어디를 클릭해야 할까')를 놓치며 상태를 실시간 업데이트하지 못하는 한계가 있다. 이를 해결하기 위해 StreamVibe-Bench 벤치마크를 소개하는데, 명시적·암묵적·동적 의도를 포함한 4.1K 평가 샘플과 85K 학습 샘플을 포함한다. StreamVibe-VL은 연속 관찰에서 암묵적 의도를 추론하고 의도 변화에 따라 상호작용을 동적으로 조정하는 스트리밍 능동형 모델이다. 전체 요약 7문장 읽기 → 031 06:11 ▲ 134 · 댓글 91 마이크로소프트, 파이썬 타입 분석 위한 TSP 공개 마이크로소프트가 파이썬 타입 분석 데이터를 요청하는 JSON-RPC 프로토콜인 Type Server Protocol(TSP)을 공개했다. 웹 · 프론트엔드 · Type Server Protocol
Key Point Pylance 등 파이썬 개발 도구가 타입 분석을 외부 서버와 통신하는 방식을 표준화하므로, 타입 체커·언어 서버 개발자가 정확한 구현을 할 수 있다.
핵심 요약
마이크로소프트가 파이썬 타입 분석 데이터를 요청하는 JSON-RPC 프로토콜인 Type Server Protocol(TSP)을 공개했다. TSP는 타입 서버가 워크스페이스의 타입 분석 상태를 유지하고 프로토콜 버전, 스냅샷, 파이썬 검색 경로, import 해석, 타입 쿼리(computed/declared/expected) 등의 요청에 답한다. 프로토콜은 LSP의 Position, Range 등 데이터 형태와 규칙을 따르며 URI는 LSP와 동일하게 문자열로 표현한다. 전체 요약 13문장 읽기 → 032 03:12 ▲ 18 · 댓글 2 미니드라마 각본 자동 생성, 다중에이전트로 다양성과 일관성 확보 마이크로드라마의 성장으로 고품질 각본 생성 수요가 증가했으나, 긴 형식의 각본 생성은 다양한 플롯 진행과 장거리 서사 일관성을 동시에 충족하기 어렵다. AI · 머신러닝 · DraMaze: A Multi-Agent Pipeline with Future-Aware Memory for Diverse Microdrama Script Generation
Key Point LLM으로 미니드라마 같은 긴 형식 콘텐츠를 생성할 때 다양성 부족과 서사 일관성 손상이 기술적 난제인데, 다중에이전트와 메모리 구조 설계로 구체적 개선을 이뤘다는 점이 중요합니다.
핵심 요약
마이크로드라마의 성장으로 고품질 각본 생성 수요가 증가했으나, 긴 형식의 각본 생성은 다양한 플롯 진행과 장거리 서사 일관성을 동시에 충족하기 어렵다. 기존 방식에서는 생성이 진행될수록 후보 연속성이 적은 수의 서사 메커니즘으로 집중되고, 검색 기반 방식은 상투적 표현 재사용을 강화하며 미래 플롯에 필수적인 역사 정보를 간과한다. 연구팀은 이를 해결하기 위해 DraMaze를 제안했으며, 이는 트로프 메모리 기반 진화 트리 탐색과 돌연변이를 통해 다양한 인과관계 경로를 탐색하는 다중에이전트 파이프라인이다. 전체 요약 7문장 읽기 → 033 21:12 ▲ 298 · 댓글 2 비디오 기초 모델부터 세계 모델까지, 영상 이해와 생성의 통합 관점 비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. AI · 머신러닝 · Reading, Writing, Sharing, and Interacting with the World through Video
Key Point 비디오 이해와 생성의 현주소를 통합적으로 정리한 메타 서베이로, 향후 연구의 방향성이 '보이는 것'에서 '일어나는 일'의 타당성으로 전환되고 있음을 보여준다.
핵심 요약
비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. 이 논문은 세계 모델링을 통합 렌즈로 삼아 두 분야를 함께 조망한다. 관찰된 비디오를 잠재된 시간적 세계의 부분적·손실적·시간순 투영으로 보고, 네 가지 보완적 작업으로 문헌을 정리한다: reading은 비디오에서 세계 성질을 추론하고, writing은 지정되거나 학습된 세계 조건에서 비디오를 생성하며, sharing은 공통 모델링 메커니즘을 통해 이해와 생성을 통합하고, interacting은 행동과 진화하는 관찰 아래서 세계 상태를 예측하고 업데이트한다. 전체 요약 5문장 읽기 → 034 18:11 ▲ 34 · 댓글 2 세계 모델과 멀티모달 에이전트 분리 평가 프레임워크 공개 World Model(WM)이 시뮬레이션된 경험으로 Multimodal Agent(MA)를 지원하고, 에이전트 궤적이 WM 개선에 기여하는 상호작용을 평가하기 위해 액션 선택과 상태 진화에 대한 별도의 증거가 필요하다. AI · 머신러닝 · Dual Exam: Controlled Evaluation of Multimodal Agents and World Models
Key Point 멀티모달 에이전트와 세계 모델의 상호작용을 처음 체계적으로 분리 평가하는 프레임워크로, 현재 AI 시스템들이 실제 협력에서 왜 실패하는지 진단할 수 있는 벤치마크를 제공한다.
핵심 요약
World Model(WM)이 시뮬레이션된 경험으로 Multimodal Agent(MA)를 지원하고, 에이전트 궤적이 WM 개선에 기여하는 상호작용을 평가하기 위해 액션 선택과 상태 진화에 대한 별도의 증거가 필요하다. Dual Exam은 고정된 환경 응답 메커니즘 하에서 에이전트를, 고정된 액션 개입 하에서 WM을 테스트하며, 물리·디지털·사회·과학 도메인을 다룬다. 에이전트 트랙은 10개 구성으로 1,088개 항목을 15개 보고 카테고리로 평가하고, WM 트랙은 8개 시나리오에서 400개 케이스를 포함한다. 전체 요약 8문장 읽기 → 035 15:11 ▲ 139 · 댓글 38 AI 모델 제어의 새로운 도전: 컨텍스트 엔지니어링의 현재 컨텍스트 엔지니어링은 AI에 올바른 정보를 제시하고 명확한 지시를 전달하는 기술로, 모델의 성능 향상과 무관하게 항상 어려울 것이다. AI · 머신러닝 · The State of Context Engineering
Key Point 에이전트 모델의 장시간 자동 실행이 일반화되면서 컨텍스트 관리 기법 자체가 새로운 버그를 만드는 악순환이 반복되고 있으며, 개발자는 더 이상 프롬프트만 개선해서는 문제를 해결할 수 없게 되었다.
핵심 요약
컨텍스트 엔지니어링은 AI에 올바른 정보를 제시하고 명확한 지시를 전달하는 기술로, 모델의 성능 향상과 무관하게 항상 어려울 것이다. 2024년 말 RAG 폐기 논쟁 당시 모델 제조사들은 컨텍스트 윈도우를 128,000 토큰에서 100만 토큰으로 확대했으나, 더 많은 정보를 담을 수 있게 되면서 더 많은 오류도 함께 들어왔다. 컨텍스트 중독(잘못된 정보 고착), 컨텍스트 분산(장문 컨텍스트에서 모델이 기본 지식 무시), 컨텍스트 혼동(무관한 정보가 모델 판단에 영향), 컨텍스트 충돌(도구 간 갈등) 등 4가지 주요 오류 모드가 발생한다. 전체 요약 11문장 읽기 → 036 15:11 ▲ 46 · 댓글 2 프롬프트 진화 알고리즘 비교하는 오픈소스 프레임워크 RSIHub AI 에이전트의 프롬프트, 스킬, 도구, 오케스트레이션을 실행 피드백으로 개선하는 Agent-evolution methods 연구가 늘고 있으나, 각 논문이 비슷한 실험 환경을 반복해서 구축해야 하는 문제가 있다. AI · 머신러닝 · RSIHub: A Composable Framework for Agent-Evolution Methods
Key Point Agent-evolution 연구자들이 각자 실험 환경을 처음부터 짜는 낭비를 없애고 방법 간 공정한 비교를 할 수 있는 표준 프레임워크가 등장했기 때문이다.
핵심 요약
AI 에이전트의 프롬프트, 스킬, 도구, 오케스트레이션을 실행 피드백으로 개선하는 Agent-evolution methods 연구가 늘고 있으나, 각 논문이 비슷한 실험 환경을 반복해서 구축해야 하는 문제가 있다. 이를 해결하기 위해 RSIHub라는 오픈소스 프레임워크를 개발했으며, 재사용 가능한 연산자와 변경 가능한 리소스를 조합한 레시피를 작성하면 실행·평가·복구·계보 추적을 자동으로 처리한다. AHE, Hyperagents, A-Evolve, GEPA 등 4가지 기존 방법을 RSIHub 핵심 코드 수정 없이 구현했으며, 각 방법의 특정 로직은 레시피와 연산자에만 담긴다. 전체 요약 6문장 읽기 → 037 12:11 ▲ 14 · 댓글 8 자연어 정책을 신경기호 프로그램으로 컴파일하는 SCOPE LLM 에이전트의 정책 집행이 단일 턴 콘텐츠 검증에서 여러 턴의 대화와 도구 호출 궤적을 평가하는 복합 정책으로 진화했다. AI · 머신러닝 · SCOPE: Compiling Natural-Language Policies into Neurosymbolic Predicate Programs
Key Point 정책 집행의 정확도·안정성·비용·해석 가능성을 동시에 해결하는 신경기호 접근법이 저렴한 모델에서도 대규모 언어모델 수준의 성능을 낼 수 있음을 보여준다.
핵심 요약
LLM 에이전트의 정책 집행이 단일 턴 콘텐츠 검증에서 여러 턴의 대화와 도구 호출 궤적을 평가하는 복합 정책으로 진화했다. 미세 조정한 가드레일 모델은 빠르지만 복합 정책에서 성능이 저하되고, LLM-as-a-judge는 높은 정확도를 달성하지만 추론 비용이 높고 예측이 불안정하다. SCOPE는 정책을 신경 술어, 결정적 추출기, 이들의 출력을 조합하는 코드로 이루어진 실행 가능한 프로그램으로 컴파일한다. 전체 요약 8문장 읽기 → 038 15:10 ▲ 117 · 댓글 13 12년 된 분산 SQLite, 어떻게 진화했나 2014년 9월 저자가 Raft 합의 알고리즘과 SQLite를 결합한 rqlite를 발표했고, 이것이 이 둘을 합친 첫 오픈소스 시스템이었다. 인프라 · 데브옵스 · Twelve years of distributed SQLite
Key Point SQLite 분산 시스템의 아이디어가 12년에 걸쳐 어떻게 다양한 구현으로 진화했고, 오픈소스에서 유료 플랫폼으로 전환된 과정을 보여준다.
핵심 요약
2014년 9월 저자가 Raft 합의 알고리즘과 SQLite를 결합한 rqlite를 발표했고, 이것이 이 둘을 합친 첫 오픈소스 시스템이었다. rqlite는 CP 시스템으로 설계되어 쓰기는 리더를 통해서만, 다수결 승인이 필요하며 분할된 소수는 쓰기를 거부한다. 2016년 Bedrock(Paxos 기반)과 ActorDB(Erlang 기반)가 비슷한 시도를 했지만 널리 채택되지 않았으며, rqlite는 이를 독립적이고 범용적인 오픈소스로 만들었다. 전체 요약 12문장 읽기 → 039 21:11 ▲ 101 · 댓글 39 인간에 대한 믿음 - 로버트 하인라인의 1952년 연설 로버트 하인라인이 1952년 발표한 에세이로, 종교적 신념이 아닌 인간의 본질적 선함에 대한 믿음을 다룬다. 기타 · This I Believe (1952)
Key Point 냉전 초기의 불확실한 시대에 인간의 선함과 인류의 미래에 대한 근본적 믿음을 역설한 73년 전 에세이가 여전히 의미를 갖는 이유를 보여준다.
핵심 요약
로버트 하인라인이 1952년 발표한 에세이로, 종교적 신념이 아닌 인간의 본질적 선함에 대한 믿음을 다룬다. 저자는 이웃 사람들의 장점이 단점을 훨씬 능가하며, 신부와 수의사 같은 이웃들의 일상 속 선행과 친절이 이를 증명한다고 본다. 자신의 마을을 포함해 어디서나 낯선 사람에게 음식을 나누고 히치하이커를 태워주는 관례적 선의를 목격했다. 전체 요약 8문장 읽기 → 040 09:11 ▲ 206 · 댓글 248 AI 모델들, 인간 본성에 같은 결론에 도달하다 12개 AI 모델(GPT-6.1 Sol, Gemini 4 Argon, DeepSeek V4 Pro, Claude Opus 5.5 등)에게 인간에 대한 가장 논쟁적인 의견을 3번씩 물었다. AI · 머신러닝 · Every AI model has the same "controversial" take on humans
Key Point 같은 AI 모델들이 인간 본성에 대해 거의 동일한 비판적 결론에 도달한 현상은, 학습 데이터의 편향이나 AI 안내 방식이 모델들의 판단을 수렴시키는 메커니즘을 보여준다.
핵심 요약
12개 AI 모델(GPT-6.1 Sol, Gemini 4 Argon, DeepSeek V4 Pro, Claude Opus 5.5 등)에게 인간에 대한 가장 논쟁적인 의견을 3번씩 물었다. 7개 모델은 매번 같은 답을 했고, 12개 모델 모두 최소 1번은 동일한 주장을 제시했다: '인간은 진실보다 집단 소속을 우선한다'는 내용이다. 모델들의 구체적 표현은 다양했지만 핵심은 같다. '인간은 충성심을 원칙으로 위장한다'(GPT-6 Astra), '신념이 아니라 멤버십을 갖는다'(Kimi K3), '이성화 동물이다'(DeepSeek V4 Pro)는 식의 주장이 반복됐다. 전체 요약 12문장 읽기 → 041 03:11 ▲ 19 · 댓글 2 스스로 개선하는 AI, 살아있는 환경에서 진화한다 현재 대부분의 AI 시스템은 고정된 파라미터로 출시되어 외부 업데이트로만 개선되지만, 이상적인 시스템은 자신의 경험으로부터 계속 개선되는 '순환적 자기개선(RSI)' 능력을 가져야 한다. AI · 머신러닝 · Evolving with Open Worlds: Towards Recursive Self-Improvement for Future Forecasting
Key Point 모델이 외부 업데이트 없이 자신의 경험으로 지속적으로 개선되는 구조를 실제로 구현해 검증했으며, AI 훈련 패러다임의 근본적 전환을 제시한다.
핵심 요약
현재 대부분의 AI 시스템은 고정된 파라미터로 출시되어 외부 업데이트로만 개선되지만, 이상적인 시스템은 자신의 경험으로부터 계속 개선되는 '순환적 자기개선(RSI)' 능력을 가져야 한다. 미래 이벤트 예측에 기반한 자기진화 에이전트 시스템 'DeepEvolve'를 개발했으며, 에이전트가 지속적으로 변화하는 환경과 상호작용하면서 경험을 내재화·외재화하여 개선된다. 검증 가능한 작업을 합성하는 살아있는 환경과 각 예측 뒤의 추론 궤적을 능력으로 변환하는 순환진화 엔진으로 구성되며, 탐색을 예측으로부터 분리하여 파라미터 수준의 진화를 오염 위험이 있는 라이브 환경에 맞춘다. 전체 요약 8문장 읽기 → 042 00:11 ▲ 28 · 댓글 1 로봇 자가학습 에이전트로 장기 조작 과제 정복 Vision-Language-Action(VLA) 모델은 시각 이해, 언어 조건, 행동 생성을 통합해 로봇 조작에 우수한 성능을 보이지만, 장기 과제에서는 과거 상호작용 결과와 작업 진행도를 기억해야 하는 비마르코프 의존성이 발생한다. AI · 머신러닝 · From VLM Planners to Robotic Agents: Self-Evolving Harnesses for History-Dependent Manipulation
Key Point 로봇이 여러 단계의 조작 작업에서 과거 경험을 학습하며 스스로 개선되는 기법이 실제로 성능을 높이는 방식과 수치를 제시했다.
핵심 요약
Vision-Language-Action(VLA) 모델은 시각 이해, 언어 조건, 행동 생성을 통합해 로봇 조작에 우수한 성능을 보이지만, 장기 과제에서는 과거 상호작용 결과와 작업 진행도를 기억해야 하는 비마르코프 의존성이 발생한다. 부분 관측 가능성과 실행 오류가 시간에 따라 누적되며, 기존 방식은 기초 모델에 메모리를 추가하거나 고수준 계획과 저수준 실행을 분리하는 계층적 구조로 이를 해결해왔다. 연구팀은 고수준 VLM을 수정 가능한 하네스(harness)를 통해 로봇 에이전트로 구성해 작업 맥락을 유지하고 실행 경험으로 계획을 개선하는 접근법을 제시했다. 전체 요약 6문장 읽기 → 043 15:11 ▲ 14 · 댓글 2 코딩 에이전트 훈련, 정책뿐 아니라 도구까지 기존 코딩 에이전트 훈련은 정책만 업데이트하고 에이전트의 도구와 훅을 고정했지만, 학습 중 드러나는 수리 전략과 상호작용 문제들은 작업마다 다르고 정책이 발전하며 변한다. AI · 머신러닝 · Training the Whole Agent, Not Just the Model
Key Point 코딩 에이전트의 훈련 방식을 근본적으로 바꾸면서 SWE-bench에서 유의미한 성능 향상을 보여줘, 실제 소프트웨어 엔지니어링 작업을 자동화하는 에이전트의 실용성이 높아진다.
핵심 요약
기존 코딩 에이전트 훈련은 정책만 업데이트하고 에이전트의 도구와 훅을 고정했지만, 학습 중 드러나는 수리 전략과 상호작용 문제들은 작업마다 다르고 정책이 발전하며 변한다. HarnessAdapt-RL은 강화학습 중 정책과 함께 에이전트의 도구·훅을 적응시키는 방식이다. 잘못된 수리 전략에는 고정된 교사 모델이 작업별 메커니즘 레벨의 스킬을 생성하고, 여러 작업에 반복되는 상호작용 문제에는 별도 교사 모델이 도구와 훅을 진화시키되 통과율이나 학습 가능한 비율을 개선할 때만 유지한다. 전체 요약 6문장 읽기 → 044 15:11 ▲ 158 · 댓글 2 자동회귀 동영상 생성에 미래 청크 예측 더하기 자동회귀 비디오 확산 모델은 청크 단위로 영상을 생성하는데, 단순히 시각적 연속성만으로 플러시블한 결과물을 만드는 것이 장면의 시간적 진화를 제대로 모델링하는 것은 아니다. AI · 머신러닝 · Looking Ahead: Modeling Future Evolution in Autoregressive Video Generation
Key Point 자동회귀 비디오 생성에서 시간적 진화를 제대로 모델링하는 훈련 기법이 기존 방식보다 적은 계산량으로 물리적 타당성을 높이는 방법을 제시했다.
핵심 요약
자동회귀 비디오 확산 모델은 청크 단위로 영상을 생성하는데, 단순히 시각적 연속성만으로 플러시블한 결과물을 만드는 것이 장면의 시간적 진화를 제대로 모델링하는 것은 아니다. 교사 강제(teacher forcing) 훈련에서 강한 시간적 중복성이 로컬 시각 연속성을 지름길 삼아 실제 시각 진화 모델링 압력을 감소시킨다. 연구팀은 Future Chunk Prediction(FCP)라는 보조 목표함수를 제시했으며, 이는 교사 강제 디노이징과 함께 학습된다. 전체 요약 7문장 읽기 → 045 12:11 ▲ 17 · 댓글 8 AI 에이전트 학습, 사용자·환경과 함께 진화시키다 LLM 에이전트가 사용자와 여러 턴에 걸쳐 상호작용하도록 훈련할 때, 사용자 시뮬레이터와 환경이 불안정하거나 불완전해서 학습 신호가 왜곡되는 문제가 있다. AI · 머신러닝 · EAU: Environment-Agent-User Co-evolution for Training User-Centric Agents
Key Point 훈련 시스템 전체를 적응형으로 진화시키는 방식이 다중 턴 강화학습 성능을 대폭 향상시키는 것으로 나타났으며, 이는 에이전트 개발의 기존 접근 방식을 바꿀 수 있는 경험적 증거를 제시한다.
핵심 요약
LLM 에이전트가 사용자와 여러 턴에 걸쳐 상호작용하도록 훈련할 때, 사용자 시뮬레이터와 환경이 불안정하거나 불완전해서 학습 신호가 왜곡되는 문제가 있다. 기존 접근법은 보상 재설계나 감독 강화로 이를 해결했지만, 사용자 시뮬레이터와 환경을 고정된 것으로 취급했다. EAU는 메타 에이전트 프레임워크로, 훈련 중 궤적·도구 추적·보상·통계를 모니터링하며 실패와 무정보 상호작용을 진단한다. 전체 요약 7문장 읽기 → 046 06:11 ▲ 13 · 댓글 2 개방형 RL 학습 과정을 자동으로 조정하는 HarnessRL 제안 자연어 보상 기준을 사용한 개방형 생성 정책 학습(Rubric-based RL)은 훈련이 진행되면서 보상이 비효과적이 되는 문제를 겪는다. AI · 머신러닝 · HarnessRL: Co-Evolving Policies with a Just-in-Time Training Harness for Open-Ended RL
Key Point 개방형 과제를 통해 AI 모델을 훈련할 때 보상 신호의 붕괴와 오류를 자동으로 탐지하고 수정하는 메커니즘이 필요한 상황에서, 훈련 과정 자체를 동적으로 조정하는 접근이 효율성을 크게 개선할 수 있음을 보여준다.
핵심 요약
자연어 보상 기준을 사용한 개방형 생성 정책 학습(Rubric-based RL)은 훈련이 진행되면서 보상이 비효과적이 되는 문제를 겪는다. 점수가 균일하게 낮거나 높게 붕괴되는 비차별적 보상과 높은 점수가 실제 답변 품질과 맞지 않는 허위 보상이라는 두 가지 실패 양식이 존재한다. 이는 정책이 진화하면서도 작업 샘플링, 탐색, 평가 설정이 고정되어 있기 때문이다. 전체 요약 8문장 읽기 → 047 06:11 ▲ 12 · 댓글 2 데이터 레이크 분석 AI, 스스로 도구를 진화시킨다 데이터 레이크 분석을 위한 코딩 에이전트가 매번 작업을 처음부터 다시 하는 문제를 해결하기 위해, 재사용 가능한 도구를 자동으로 구축하고 개선하는 '도구 진화' 방식을 제안했다. AI · 머신러닝 · Unsupervised Tool Evolution for Coding Agents in Data-Lake Analytics
Key Point 데이터 분석 작업을 자동화하는 AI 에이전트가 라벨 없이 스스로 도구를 학습·개선할 수 있다는 점이 실무 적용에 중요하며, 특히 단계 예산 제한이라는 현실적 제약에서 성능 향상을 달성한 것이 의미 있다.
핵심 요약
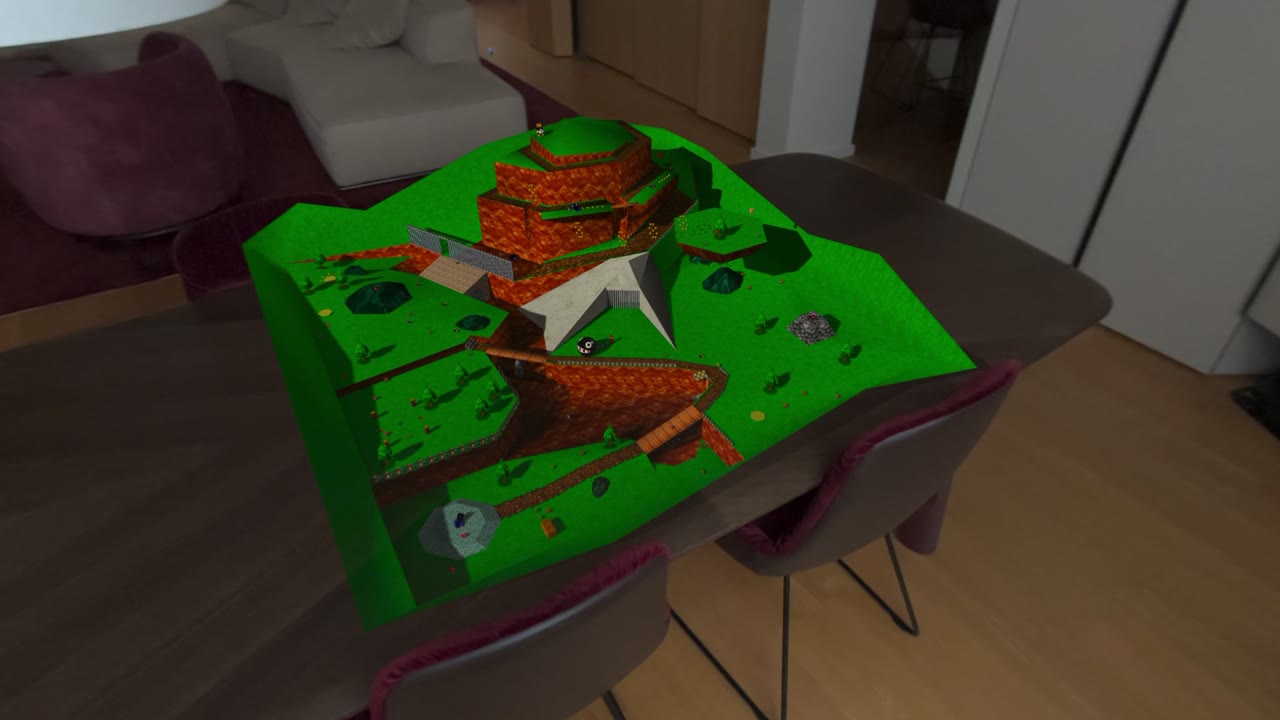
데이터 레이크 분석을 위한 코딩 에이전트가 매번 작업을 처음부터 다시 하는 문제를 해결하기 위해, 재사용 가능한 도구를 자동으로 구축하고 개선하는 '도구 진화' 방식을 제안했다. 라벨 없이 도구를 진화시키는 TEAL(Tool Evolution for Analytics over data Lakes)은 두 에이전트가 서로 다른 증거에서 도구를 제안한다: Explorer는 데이터 레이크 자체에서, Critic은 Worker의 작업 궤적에서 도구를 제안한다. 제안된 변화는 Worker가 재실행 시 추가 단계 없이 도구를 채택하고, 변경된 답변이 궤적 증거로 뒷받침될 때만 유지된다. 전체 요약 9문장 읽기 → 048 03:11 ▲ 154 · 댓글 58 슈퍼마리오 64, 애플 비전 프로의 입체 모형으로 부활 슈퍼마리오 64의 각 스테이지가 테이블 위의 입체 모형으로 구현되어, 플레이어가 실제로 주변을 돌아다니며 컨트롤러로 게임을 플레이할 수 있는 애플 비전 프로 포트가 공개되었다. 하드웨어 · 시스템 · Way to Play Super Mario 64: On Apple Vision Pro
Key Point 클래식 게임의 현대적 재해석과 저작권 정책의 대비: 커뮤니티 창작물이 기술적으로 얼마나 진화했는지, 그리고 업체별 대응이 얼마나 다른지 보여준다.
핵심 요약
슈퍼마리오 64의 각 스테이지가 테이블 위의 입체 모형으로 구현되어, 플레이어가 실제로 주변을 돌아다니며 컨트롤러로 게임을 플레이할 수 있는 애플 비전 프로 포트가 공개되었다. 사용자가 카메라 역할을 하므로 모형에 가까이 다가가 자세히 보거나 마리오를 여러 각도에서 관찰할 수 있으며, 타이틀 화면에서 손가락으로 마리오의 얼굴을 직접 움직일 수 있다. 이 프로젝트는 SM64 역공학 프로젝트와 sm64coopdx 게임 코드, SM64 Reloaded와 Render96의 고해상도 텍스처, Render96 모델과 SwagSkeleton95 교체 모델 등 여러 기존 오픈소스 프로젝트를 기반으로 구축되었다. 전체 요약 4문장 읽기 → 049 18:11 ▲ 22 · 댓글 2 AI 에이전트가 자신의 인터페이스를 진화시킨다 기존 컴퓨터 사용 에이전트는 인간이 정해준 고정된 인터페이스로만 작동하는데, 메모리셀 단위 입력처럼 비효율적인 작업을 반복하거나 파일 전체를 출력하는 등의 한계를 가지고 있다. AI · 머신러닝 · Evolving Agent Interfaces
Key Point AI 에이전트가 직접 자신의 작업 인터페이스를 설계·최적화하면서 더 작은 모델로 기존의 고사양 모델을 능가하는 성과를 낸 것으로, 컴퓨터 사용 에이전트의 성능 향상 경로가 근본적으로 바뀔 수 있음을 보여준다.
핵심 요약
기존 컴퓨터 사용 에이전트는 인간이 정해준 고정된 인터페이스로만 작동하는데, 메모리셀 단위 입력처럼 비효율적인 작업을 반복하거나 파일 전체를 출력하는 등의 한계를 가지고 있다. 연구팀은 인터페이스 설계 자체를 에이전트의 능력으로 만들어야 한다고 주장하며 Agent S4를 제안했다. Agent S4는 메타 에이전트가 합성 훈련 작업에서 태스크 에이전트의 궤적을 분석하고, 성공 라벨 없이 인터페이스와 사용 지식을 자동으로 구축·수정하는 인터페이스 저장소를 관리한다. 전체 요약 8문장 읽기 → 050 18:11 ▲ 18 · 댓글 2 그림 그려지는 과정을 시간 지도로 제어하기 미술 생성 AI는 정적 이미지 합성에서 인간의 회화 과정을 모방하는 동적 비디오 생성으로 발전했으나, 기존 모델들은 창작 과정을 블랙박스로 취급한다. AI · 머신러닝 · Painting Change Map as guidance for generating painting processes
Key Point 기존 회화 영상 생성 모델은 사용자가 어느 부분을 언제 그려야 하는지 제어할 수 없는데, 이 연구는 시공간 변화 지도로 획 수준의 정밀한 제어를 처음 가능하게 한다.
핵심 요약
미술 생성 AI는 정적 이미지 합성에서 인간의 회화 과정을 모방하는 동적 비디오 생성으로 발전했으나, 기존 모델들은 창작 과정을 블랙박스로 취급한다. 현재의 조건 메커니즘은 Canny 엣지나 깊이 맵처럼 너무 경직되었거나 진행률 같은 단순 스칼라 변수로 너무 단순화되어, 그림이 시간에 따라 어떻게 진화하는지 사용자가 조종할 수 없다. 이 연구는 '페인팅 체인지 맵'이라는 새로운 시공간 제어 메커니즘을 제안하는데, 이는 1,000 타임스텝 전체에서 정규화된 구조적 변화를 명시적으로 추적한다. 전체 요약 7문장 읽기 → 051 15:11 ▲ 115 · 댓글 3 작은 모델도 큰 모델 따라잡는다, '뇌-몸' 맞춤 진화 자동으로 개선되는 AI 에이전트(RSI)에서는 모델의 역량과 실행 환경(harness)이 함께 진화할 때 불일치 문제가 발생한다. AI · 머신러닝 · CoEvo-RSI: When Harnesses Evolve, Which Models Should Follow?
Key Point 작은 모델이 큰 모델을 이기는 핵심이 '역량과 실행 환경의 정렬'이라는 새로운 관점을 제시하며, 자원 제약이 있는 팀도 효율적인 에이전트를 만들 수 있는 길을 열어준다.
핵심 요약
자동으로 개선되는 AI 에이전트(RSI)에서는 모델의 역량과 실행 환경(harness)이 함께 진화할 때 불일치 문제가 발생한다. 진화 중인 harness가 모델이 학습하지 못한 행동을 요구하거나 기존 능력을 제한하는 '뇌-몸 불일치'를 해결하기 위해 CoEvo-RSI 프레임워크를 제시했다. 메타 에이전트가 과거 설계 아카이브에서 harness를 선택하고, 최적의 모델 체크포인트를 선택하거나 병합한 후 그에 맞춰 적응시킨다. 전체 요약 6문장 읽기 → 052 21:11 ▲ 13 · 댓글 4 임베딩 테이블을 16MB 고정 코드로 대체, 소형 모델 파일 1/7 축소 소형 언어 모델에서 임베딩 테이블은 전체 파라미터의 대부분을 차지하고, Gemma 3 270M 모델의 경우 268M 파라미터 중 168M이 임베딩 테이블이며, 양자화 후에도 16비트로 남아 파일 크기의 대부분을 차지한다. AI · 머신러닝 · Embeddings Are Overpriced? A Frozen 16 MB Vocabulary for Small and Ternary Language Models
Key Point 소형 모델 배포 시 파일 크기가 1/7로 축소되고 CPU 속도가 5~6배 빨라지므로, 엣지 디바이스와 저사양 환경에서의 모델 배포 방식을 바꿀 가능성이 있다.
핵심 요약
소형 언어 모델에서 임베딩 테이블은 전체 파라미터의 대부분을 차지하고, Gemma 3 270M 모델의 경우 268M 파라미터 중 168M이 임베딩 테이블이며, 양자화 후에도 16비트로 남아 파일 크기의 대부분을 차지한다. 연구팀은 학습 가능한 임베딩 테이블을 주성분 투영과 부호 이진화로 도출한 512비트 코드의 동결 테이블(16MB, 학습 가능 파라미터 없음)로 대체하고, 동일한 Gemma 형태의 모델을 2.05B 토큰으로 학습했다. 학습된 임베딩 테이블은 0.20 나츠 검증 손실을 위해 2.6배 많은 학습 가능 파라미터를 필요로 했으나, LAMBADA, HellaSwag, PIQA 벤치마크에서는 동결 테이블 모델이 동일하거나 더 나은 성능을 보였고 ARC-Easy에서만 학습된 테이블이 앞섰다. 전체 요약 6문장 읽기 → 053 18:11 ▲ 28 · 댓글 2 메모리 간섭 줄인 선형 어텐션, 장문맥 모델링에 강하다 KronLSTM이라는 새로운 선형 어텐션 아키텍처를 제안했으며, 크로네커 델타 규칙이라는 연관 행렬 메모리의 신규 업데이트 규칙을 기반으로 한다. AI · 머신러닝 · Kronecker Delta Rule for Long Context Linear Attention
Key Point 메모리 간섭을 크게 줄이면서 안정성까지 갖춘 선형 어텐션이 장문맥 모델링 성능에서 기존 방식을 앞서면서, 대형 언어모델의 효율적인 장문맥 처리 방식이 진화하고 있음을 보여준다.
핵심 요약
KronLSTM이라는 새로운 선형 어텐션 아키텍처를 제안했으며, 크로네커 델타 규칙이라는 연관 행렬 메모리의 신규 업데이트 규칙을 기반으로 한다. xLSTM 계열을 확장해 메모리 수정 메커니즘을 추가했으며, 특정 연관성을 정정하면서도 행렬 공간의 단일 방향으로만 메모리를 변경한다. 이러한 최소한의 침습적 메모리 수정 방식은 기존 델타 규칙 업데이트 대비 이전에 저장된 정보와의 간섭을 줄여 장문맥 언어 모델링에 적합하다. 전체 요약 8문장 읽기 → 054 18:11 ▲ 12 · 댓글 2 숨은 상태까지 관리하는 게임형 AI 비디오 생성 시스템 기존 비디오 생성 AI는 단일 이미지에서 카메라 움직임을 중심으로 영상을 생성하지만, 화면에 보이지 않는 상태(hidden state)에 따라 결과가 달라지는 상호작용을 제대로 처리하지 못한다. AI · 머신러닝 · State World Models: Execute the Rules, Generate the Pixels
Key Point 기존 AI 비디오 생성 모델들은 화면에 보이지 않는 게임 상태를 제대로 추적하지 못하는데, 이 논문은 상태 관리 시스템을 도입해 규칙 준수율을 32%에서 92%로 끌어올린 방법을 제시한다.
핵심 요약
기존 비디오 생성 AI는 단일 이미지에서 카메라 움직임을 중심으로 영상을 생성하지만, 화면에 보이지 않는 상태(hidden state)에 따라 결과가 달라지는 상호작용을 제대로 처리하지 못한다. Stateful Harness는 세계 상태 관리와 비디오 렌더링을 분리하는 프레임워크로, 정해진 규칙에 따라 세계 상태를 진화시키고 각 단계마다 비디오 모델로 장면을 생성한 뒤 다음 턴의 상태 업데이트에 활용한다. 사용자가 선택한 행동을 해석하고 3D 씬의 미리보기를 통해 공간과 카메라 위치를 제시하며, 생성된 비디오 클립으로 다시 세계 상태를 갱신하는 순환 구조를 갖춘다. 전체 요약 7문장 읽기 → 055 18:11 ▲ 155 · 댓글 3 기초 모델에 메모리 능력을 내장한 MemT-1.0 공개 메모리를 모델 계산의 일부로 내재화하는 메모리 네이티브 기초 모델 MemT-1.0을 소개한다. AI · 머신러닝 · MemT-1.0: Towards Memory-Native Evolution
Key Point 장기 컨텍스트 처리 시 메모리 효율과 추론 속도를 동시에 개선하는 아키텍처로, 외부 검색에 의존하지 않고 내부 메모리만으로 작동하는 모델의 가능성을 보여준다.
핵심 요약
메모리를 모델 계산의 일부로 내재화하는 메모리 네이티브 기초 모델 MemT-1.0을 소개한다. Metis를 기반으로 Gated DeltaNet-2 아키텍처를 채용하며, 턴마다 안정적인 토큰 수준 메모리 업데이트 메커니즘을 사용한다. 메모리 용량 확장을 위해 Mixture-of-Storage를 도입했다. 전체 요약 8문장 읽기 → 056 15:11 ▲ 27 · 댓글 2 AI 에이전트 프롬프트, 성능·비용 균형 맞춰 자동 개선 AI 에이전트의 작업 수행 능력을 높이는 '하네스(harness, 프롬프트 템플릿)' 개발에서 기존 반복 개선 방식은 성능 향상 대신 실행 비용을 크게 올린다는 문제가 있다. AI · 머신러닝 · HarnessPro: Recursive Harness Self-Improvement with Pareto Optimization for Performance-Cost Trade-offs
Key Point AI 에이전트 성능을 높일 때 비용 증가를 피할 수 없던 문제를 해결하는 자동화 기법으로, 실무 배포 환경에서 비용·성능 트레이드오프를 실제로 선택 가능하게 한다.
핵심 요약
AI 에이전트의 작업 수행 능력을 높이는 '하네스(harness, 프롬프트 템플릿)' 개발에서 기존 반복 개선 방식은 성능 향상 대신 실행 비용을 크게 올린다는 문제가 있다. HarnessPro는 정답 데이터 없이 LLM이 생성한 테스트로만 후보 하네스를 평가하는 레이블 무료 진화 방법을 제안한다. 전문 에이전트가 실행 궤적을 진단하고 성능·비용 우선순위에 따라 업데이트를 계획해 후보 하네스로 구현한다. 전체 요약 7문장 읽기 → 057 12:11 ▲ 43 · 댓글 4 코딩 AI, 스스로 실패를 분석해 개선하는 법 배우다 LLM 코딩 에이전트의 성능은 정책 모델과 환경 상호작용을 중개하는 harness(도구 호출 방식)에 의해 결정되며, 둘 중 하나만 최적화하는 것은 불충분하다. AI · 머신러닝 · Self-Evolving Coding Agents via Harness-Policy Optimization
Key Point 코딩 AI의 성능을 높이는 데 도구 사용 방식과 모델 학습을 함께 개선하는 방법이 유의미한 성과를 보여주고 있기 때문이다.
핵심 요약
LLM 코딩 에이전트의 성능은 정책 모델과 환경 상호작용을 중개하는 harness(도구 호출 방식)에 의해 결정되며, 둘 중 하나만 최적화하는 것은 불충분하다. Self-HPO는 두 성분을 번갈아 최적화하는 자기개선 프레임워크로, 현재 정책이 자신의 실패를 분석해 새로운 harness 후보를 제안하는 H-스텝과 RL로 정책을 업데이트하는 P-스텝을 반복한다. 학습 중 어려운 작업들이 다음 라운드의 harness 탐색 대상이 되어, harness 최적화가 진화하는 정책의 실패 패턴에 계속 맞춰진다. 전체 요약 6문장 읽기 → 058 15:11 ▲ 14 · 댓글 2 AI가 과학 가설을 반복 학습으로 발견하는 DiscoveryRSI 과학 발견에서 검증 가능한 가설을 개발하는 과정을 자동화하기 위해 DiscoveryRSI 프레임워크를 제안했다. AI · 머신러닝 · DiscoveryRSI: Recursively Learning to Discover Valuable Hypotheses
Key Point 과학적 가설의 품질 평가와 선택을 AI가 자동으로 수행하면서 연구자들의 발견 과정이 어떻게 달라질 수 있는지 보여주는 구체적 시도이다.
핵심 요약
과학 발견에서 검증 가능한 가설을 개발하는 과정을 자동화하기 위해 DiscoveryRSI 프레임워크를 제안했다. 가설은 근거 있는 주장, 실행 가능한 조사 방법, 판정 기준, 대안적 설명으로 정의되며, 다중 에이전트 진화 탐색으로 가설 트리를 구축한다. 세 가지 재귀적 학습 메커니즘으로 동작한다: 가설 신용 최적화는 연구 기여도를 평가하고, 학습 리플레이는 생산적 전략과 실패 패턴을 식별하며, 재발견은 개선 사항을 새로운 조사에 적용한다. 전체 요약 7문장 읽기 → 059 15:11 ▲ 286 · 댓글 3 VLM이 로봇을 직접 코딩하다, HexaShell의 도전과 한계 비전 언어 모델(VLM) 기반 에이전트가 로봇 조종에서 학습된 정책과 경쟁할 수 있는 수준에 도달했으며, 연구팀은 코딩 에이전트가 로봇을 제어할 때 어디까지 갈 수 있는지 검증하는 HexaShell 시스템을 개발했다. AI · 머신러닝 · HexaShell: A Thin Harness for Exploring the Limits of VLM Agents as Robot Coding Agents
Key Point 로봇 조종을 위한 VLM 에이전트가 시각 기반 자율 학습으로 최고 성능을 달성했으나, 정밀한 접촉 제어에서 근본적인 한계를 드러내며 향후 로봇 AI 개발의 방향을 제시한다.
핵심 요약
비전 언어 모델(VLM) 기반 에이전트가 로봇 조종에서 학습된 정책과 경쟁할 수 있는 수준에 도달했으며, 연구팀은 코딩 에이전트가 로봇을 제어할 때 어디까지 갈 수 있는지 검증하는 HexaShell 시스템을 개발했다. HexaShell은 최소한의 인터페이스를 유지하며 에이전트의 명령을 로봇 동작으로만 변환하고, 양팔 로봇을 단일 명령줄로 구동하며 RGB 카메라 3개와 카메라 캘리브레이션 정보를 제공한다. 실패 후 에이전트는 로그를 읽고 원인을 파악한 뒤 작은 프로그램(도구)을 작성하거나 수정하며, 이렇게 학습한 내용을 코드로 유지한다. 전체 요약 10문장 읽기 → 060 09:11 ▲ 11 · 댓글 2 에이전트 군집이 스스로 역할 분담을 학습한다 기존 다중 에이전트 시스템은 고정된 조율 구조 내에서 학습하면서 개별 능력과 집단 행동의 조직화를 분리하는 문제가 있었다. AI · 머신러닝 · Learning Self-Orchestration in Decentralized Agent Swarms
Key Point 중앙 조율 없이 에이전트가 스스로 입찰로 역할을 나누고 학습하는 방식이 성능, 적응성, 견고성에서 모두 우수해 대규모 분산형 시스템 운영 방식을 바꿀 수 있다.
핵심 요약
기존 다중 에이전트 시스템은 고정된 조율 구조 내에서 학습하면서 개별 능력과 집단 행동의 조직화를 분리하는 문제가 있었다. 연구팀이 시장 기반 사후훈련(MPT) 프레임워크를 제안했으며, 이는 분산형 에이전트 군집에서 행동 정책과 자기-조율을 동시에 학습한다. 에이전트들은 입찰을 통해 참여 의사를 표현하고, 이것이 누가 행동하는지와 집단 결과가 어떻게 개별 학습 신호를 제공하는지를 결정한다. 전체 요약 9문장 읽기 → 061 21:11 ▲ 11 · 댓글 3 비디오 세계 모델의 기억력 평가 벤치마크 등장 동영상 생성 AI가 더 길고 현실적인 상호작용을 가능하게 하면서 일관된 가상 세계를 유지하는 것이 핵심 과제가 되고 있다. AI · 머신러닝 · WorldMemBench: A Comprehensive Benchmark for Memory of Video World Models
Key Point 비디오 생성 AI가 시뮬레이션, 게임, 메타버스로 확장되면서 가상 세계의 일관성을 평가하는 표준 기준이 필요한 시점에 처음으로 체계화된 벤치마크가 나왔다.
핵심 요약
동영상 생성 AI가 더 길고 현실적인 상호작용을 가능하게 하면서 일관된 가상 세계를 유지하는 것이 핵심 과제가 되고 있다. 세계 기억력(world memory)은 시각 품질이나 영상 길이와 함께 평가해야 할 중요한 능력인데, 이를 체계적으로 측정할 방법이 없었다. 연구팀이 WorldMemBench를 개발했으며, 260개 테스트 케이스를 통해 정적 기억(사람의 정체성·외형, 물체 형태·배치, 환경 내용·구조)과 동적 기억(사건 진행, 상태 지속)을 평가한다. 전체 요약 7문장 읽기 → 062 18:11 ▲ 316 · 댓글 4 컴퓨터 자동 조작 AI의 완전 오픈소스 스택 공개 컴퓨터 자동 조작 시스템이 GUI 상호작용에서 비주얼·프로그래밍 인터페이스를 모두 다루는 단계로 진화하고 있는데, GPT-4o Astra 같은 최신 구현들이 폐쇄적이어서 체계적 연구가 제한되고 있다. AI · 머신러닝 · OpenGCUA: Toward a Fully Open Stack for Generalist Computer Use
Key Point 컴퓨터 자동 조작 AI 연구가 막혀 있던 폐쇄형 구현에서 벗어나 완전 오픈스택으로 전환되면서, 누구나 최신 모델의 설계를 따라하고 개선할 수 있는 기반이 마련되었다.
핵심 요약
컴퓨터 자동 조작 시스템이 GUI 상호작용에서 비주얼·프로그래밍 인터페이스를 모두 다루는 단계로 진화하고 있는데, GPT-4o Astra 같은 최신 구현들이 폐쇄적이어서 체계적 연구가 제한되고 있다. OpenGCUA는 이런 문제를 해결하기 위해 제너럴 컴퓨터 사용 에이전트(GCUA)의 전체 스택을 오픈소스로 공개하는 프로젝트다. 에이전트 설계의 핵심은 코드 실행 기능으로, 중간 결과가 다음 동작을 결정하게 하고 모델이 기존 프로그래밍 능력을 컴퓨터 상호작용에 직접 적용할 수 있다. 전체 요약 8문장 읽기 → 063 15:11 ▲ 201 · 댓글 7 AI 에이전트가 자기 자신을 개선하는 프레임워크 모델 가중치는 고정한 채 프롬프트, 메모리, 워크플로우, 실행 가능한 컴포넌트 같은 에이전트 소프트웨어를 자동으로 수정하는 프레임워크를 제시한다. AI · 머신러닝 · Self-Evolving Agent Harness
Key Point AI 에이전트가 모델을 바꾸지 않고도 스스로의 동작을 개선하는 구체적인 방법론과 이론이 담겨 있어, AI 시스템의 자동 최적화와 신뢰성 검증에 관심 있는 연구자와 개발자가 반드시 봐야 한다.
핵심 요약
모델 가중치는 고정한 채 프롬프트, 메모리, 워크플로우, 실행 가능한 컴포넌트 같은 에이전트 소프트웨어를 자동으로 수정하는 프레임워크를 제시한다. 피드백 기반 프로세스를 형식화하여 승인된 수정사항이 계속 유지되도록 하고, 업데이트 대상을 제안·승인 메커니즘과 분리했다. 해석된 상태 변화와 도구·코드 수정, 저장소 제어 논리, 플러그인 구성을 구별하여 관리한다. 전체 요약 8문장 읽기 → 064 03:12 ▲ 13 · 댓글 1 영상 세계 모델, 프레임률을 자유롭게 조절하다 기존 영상 기반 인터랙티브 세계 모델은 고정된 시간 속도로만 학습·생성되어, 실행 속도가 다르면 의도와 달리 느리거나 빠르게 진행되는 문제가 있었다. AI · 머신러닝 · RAR: Rate-Adaptive Rollout for Time-Consistent Interactive World Models
Key Point 세계 모델의 기본 제약인 프레임률 고정 문제를 해결하면 더 유연한 실시간 시뮬레이션과 로봇·게임 AI 개발이 가능해진다.
핵심 요약
기존 영상 기반 인터랙티브 세계 모델은 고정된 시간 속도로만 학습·생성되어, 실행 속도가 다르면 의도와 달리 느리거나 빠르게 진행되는 문제가 있었다. 또한 단일 프레임률로는 정교한 모션 캡처와 긴 시간 지평 사이의 트레이드오프를 피할 수 없었다: 높은 프레임률은 미세한 움직임을 포착하지만 컨텍스트 윈도우 내에서 짧은 기간만 커버한다. 논문이 제시하는 RAR(Rate-Adaptive Rollout)은 세계 모델이 제어 가능한 시간 속도로 생성할 수 있게 한다. 전체 요약 7문장 읽기 → 065 00:11 ▲ 19 · 댓글 2 과학 AI 에이전트 군단이 스스로 진화하며 학습한다 과학 연구의 재귀적 자기 개선(RSI)을 위해 과학 에이전트 군단이 실험 경험을 통해 연구 능력을 향상시키는 것을 목표로 한다. AI · 머신러닝 · SwarmRSI: Recursive Self-Improvement through Evolving Scientific Agent Swarm
Key Point 과학 연구 자동화를 추구하는 개발자와 연구자들이 AI 에이전트 간 협력과 피드백 기반 자기 개선이 어떻게 실제 과학 문제 해결에 활용되는지 알아야 한다.
핵심 요약
과학 연구의 재귀적 자기 개선(RSI)을 위해 과학 에이전트 군단이 실험 경험을 통해 연구 능력을 향상시키는 것을 목표로 한다. 기존 접근의 문제점은 실패한 실험 결과가 가설 오류인지 구현 오류인지 불분명하고, 전체 점수가 다른 에이전트에 유용한 부분 결과를 가린다는 것이다. SwarmRSI는 피드백 기반 군단 변이(Feedback-Guided Swarm Mutation)로 다른 에이전트의 실험 결과를 이용해 가설과 구현을 개선한다. 전체 요약 7문장 읽기 → 066 15:11 ▲ 30 · 댓글 2 로봇 지능의 다음 단계, '에이전틱 로봇' 체계적 정리 기초 모델 기반의 로봇 지능이 저수준 행동 예측에서 벗어나 인간의 지시를 이해하고, 환경과 상호작용하며, 실행 오류를 자동으로 교정하고, 전략을 동적으로 조정하는 '에이전틱 로봇'으로 진화하고 있다. AI · 머신러닝 · Towards Agentic Robots: Model, Data, Environment, and Harness
Key Point 로봇 AI의 패러다임이 전환되면서 분산된 연구들을 처음으로 체계화한 종합 가이드로, 로봇 개발자와 AI 연구자가 에이전틱 로봇의 전체 구조를 이해하고 각자의 연구를 위치시킬 수 있는 기준을 제공한다.
핵심 요약
기초 모델 기반의 로봇 지능이 저수준 행동 예측에서 벗어나 인간의 지시를 이해하고, 환경과 상호작용하며, 실행 오류를 자동으로 교정하고, 전략을 동적으로 조정하는 '에이전틱 로봇'으로 진화하고 있다. 이 분야의 빠른 성장에도 불구하고 연구들이 체계적으로 연결되지 않아 서로 다른 에이전틱 기능을 완전한 로봇 시스템으로 통합하는 방법이 명확하지 않은 상황이다. 논문은 로봇 정책에서 에이전틱 시스템으로의 발전을 추적하며 비전-언어-행동 모델, 월드 모델, 월드-행동 모델을 다룬다. 전체 요약 6문장 읽기 → 067 12:11 ▲ 19 · 댓글 1 텍스트-이미지 생성 모델, 자동으로 자기 약점 찾아 학습한다 텍스트-이미지 생성 모델의 사후학습(post-training)을 자동화하는 APT(Agentic Post-Training) 프레임워크를 제안했다. AI · 머신러닝 · APT: Feedback-Driven Agentic Post-Training for Text-to-Image Generation
Key Point 수동 데이터 큐레이션 없이 모델 자체의 약점을 자동으로 식별해 학습하는 방식으로, 텍스트-이미지 생성의 품질 개선 파이프라인이 어떻게 근본적으로 바뀔 수 있는지 보여준다.
핵심 요약
텍스트-이미지 생성 모델의 사후학습(post-training)을 자동화하는 APT(Agentic Post-Training) 프레임워크를 제안했다. 기존 방식은 수동으로 큐레이션한 데이터와 고정된 학습 분포에 의존했으나, APT는 모델의 진화하는 역량에 맞춰 적응적으로 사후학습을 진행한다. 평가 세트 구성, 모델의 강점과 약점 진단, 강화학습 데이터 생성을 담당하는 3개 에이전트를 조율한다. 전체 요약 6문장 읽기 → 068 12:11 ▲ 46 · 댓글 2 멀티모달 에이전트의 메모리 진화 방식 분석 프레임워크 멀티모달 AI 에이전트가 장기 과제와 평생 학습 환경에서 복잡한 다중 양식 데이터로부터 지속적으로 유용한 정보를 습득하는 것이 핵심 과제이다. AI · 머신러닝 · Seeing, Maintaining, and Learning: The Evolution of Multimodal Agent Memory
Key Point 멀티모달 AI 에이전트가 실제 환경에서 장기간 지속적으로 학습하려면 시간이 지나면서 진화하는 메모리 관리 체계가 필수적이며, 이 논문이 제시하는 분석 프레임워크는 현재 에이전트 시스템의 메모리 설계 방향을 제시한다.
핵심 요약
멀티모달 AI 에이전트가 장기 과제와 평생 학습 환경에서 복잡한 다중 양식 데이터로부터 지속적으로 유용한 정보를 습득하는 것이 핵심 과제이다. 논문은 멀티모달 에이전트 메모리를 두 축으로 분석하는 프레임워크를 제안한다: 축1(Formation과 Representation)은 정보가 어떻게 형성되고 표현되는지, 축2(Memory Management)는 축적된 경험으로 어떻게 적응하는지를 다룬다. 축1에서는 어떤 정보를 유지하고 양식별 임베딩·텍스트 및 구조화된 기록·잠재 및 매개변수 표현으로 어떻게 인코딩하는지를 규명해 이후 추론과 행동을 지원한다. 전체 요약 6문장 읽기 → 069 00:11 ▲ 23 · 댓글 2 멀티모달 에이전트가 보는 방식과 읽는 법을 함께 개선하는 ViewCraft 멀티모달 에이전트의 성능 개선 문제를 다루되, 모델 가중치를 업데이트하지 않고 재사용 가능한 스킬만 진화시키는 방식을 제안한다. AI · 머신러닝 · VIEWCRAFT: Evolving What Multimodal Agents See and How They Read It
Key Point 멀티모달 에이전트의 입력 처리 방식 자체를 학습함으로써 모델 재학습 없이 성능과 효율성을 동시에 높일 수 있는 새로운 접근법이 제시되었기 때문이다.
핵심 요약
멀티모달 에이전트의 성능 개선 문제를 다루되, 모델 가중치를 업데이트하지 않고 재사용 가능한 스킬만 진화시키는 방식을 제안한다. 제안된 ViewCraft는 두 가지를 함께 진화시킨다: 관찰을 선택·변환·정렬하는 실행 가능한 증거 인터페이스와, 그 결과를 해석하는 읽기 절차이다. 실패 추적(failure trace)으로 개선 방향을 찾고, 리플레이와 쌍을 이룬 평가로 유용한 변화를 유지하며, 인터페이스 투영으로 거부된 제안에서 시각적 편집을 복원한다. 전체 요약 7문장 읽기 → 070 21:11 ▲ 64 · 댓글 1 장기 작업 에이전트 훈련을 위한 반복적 환경 진화 방식 WorkRover 강화학습을 통해 장기 수행 에이전트를 훈련하기 위해서는 상호작용 환경을 확장하는 것이 중요하지만, 기존 구성 파이프라인은 작업 요소들을 정렬한 채 반복 개선을 지원하는 데 제한이 있다. AI · 머신러닝 · WorkRover: Scaling Long-Horizon Cowork Agent Training Via Recursive Environment Evolution
Key Point 장기 작업을 수행하는 AI 에이전트의 훈련 효율을 대폭 개선하는 새로운 프레임워크로, 복잡한 작업 환경을 자동으로 정제하고 검증하는 방식이 기존 대비 크게 나은 성능을 달성했다.
핵심 요약
강화학습을 통해 장기 수행 에이전트를 훈련하기 위해서는 상호작용 환경을 확장하는 것이 중요하지만, 기존 구성 파이프라인은 작업 요소들을 정렬한 채 반복 개선을 지원하는 데 제한이 있다. WorkRover는 하니스 기반 합성으로 구성 에이전트가 의미론적으로 정렬된 작업 맥락, 실행 가능한 작업, 증거 기반 검증자를 함께 구축하고 고정 워크플로우 대신 작업공간 상태와 실행 피드백에 맞춰 조치하는 프레임워크다. 환경 진화를 지원하기 위해 의존성 폐쇄 재실행과 검증된 후보 중 가장 작은 수정안을 선택하는 Factorial Compatibility Replay(FCR)를 도입했다. 전체 요약 5문장 읽기 → 071 21:11 ▲ 46 · 댓글 1 고해상도 이미지 생성 가능한 경량 디퓨전 변환기 기법 디퓨전 변환기(DiT)가 학습 해상도를 넘어 이미지를 생성하려면 토큰 수가 급증해 전체 어텐션이 계산 비용이 높아지고, 구조 왜곡과 디테일 저하 문제가 발생한다. AI · 머신러닝 · AReA: Adaptive Receptive-Field Attention for Efficient High-Resolution Diffusion Transformers
Key Point 고해상도 이미지 생성 시 계산량 폭증 문제를 적응형 어텐션으로 해결한 방식으로, 추가 학습 없이 적용 가능하다는 점이 중요하다.
핵심 요약
디퓨전 변환기(DiT)가 학습 해상도를 넘어 이미지를 생성하려면 토큰 수가 급증해 전체 어텐션이 계산 비용이 높아지고, 구조 왜곡과 디테일 저하 문제가 발생한다. 균등한 전체 어텐션이 이 문제의 공통 원인인데, 모든 스텝에서 모든 토큰에 주목하면 이차 복잡도가 생기고 학습 범위를 벗어난 상대 거리에 노출되어 모델이 분포에서 벗어난다. 어텐션의 유효 수용 범위는 노이즈 제거 과정에서 좁혀지는데, 초반 스텝에서 전역적으로 구조를 형성하고 후반 스텝에서 국소적으로 세부를 정제한다. 전체 요약 6문장 읽기 → 072 18:11 ▲ 25 · 댓글 2 LLM 에이전트를 위한 데스크톱 인터페이스 자동 생성 LLM 에이전트들이 데스크톱 애플리케이션의 새로운 사용자 클래스로 떠오르고 있으나, 기존 UI는 인간 사용자나 개발자를 위해 설계되어 에이전트의 성능을 제한하고 있다. AI · 머신러닝 · A Decade in a Day: Synthesizing Agent-Native Interfaces from Human-Oriented Software Evolution
Key Point LLM 에이전트가 실제 데스크톱 소프트웨어를 더 효율적으로 제어하기 위한 인터페이스 설계 원칙을 제시하고, 자동화된 생성 기법을 보여줌으로써 에이전트 기반 소프트웨어 자동화 구현에 실질적 길을 열었다.
핵심 요약
LLM 에이전트들이 데스크톱 애플리케이션의 새로운 사용자 클래스로 떠오르고 있으나, 기존 UI는 인간 사용자나 개발자를 위해 설계되어 에이전트의 성능을 제한하고 있다. 연구팀은 소프트웨어 진화 과정을 인터페이스 변화의 자연스러운 소스로 활용하여 DeskIF-Bench 벤치마크를 개발했으며, 6개 데스크톱 앱의 255개 검증된 작업으로 구성되어 있다. 같은 작업과 에이전트를 고정한 상태에서 소프트웨어 버전만 변경하여 평가한 결과, 신규 버전이 구형 버전을 일관되게 능가했다. 전체 요약 7문장 읽기 → 073 18:11 ▲ 25 · 댓글 2 언어-행동 이중 부트스트래핑으로 네비게이션 성능을 자동 개선하다 자연어 지시를 따라 목표 위치에 도달하는 비전-언어 네비게이션 모델을 만들 때 고품질의 언어 감독 데이터가 필수이나, 사람이 직접 주석을 다는 것은 비용이 많이 든다. AI · 머신러닝 · Data-Centric Recursive Self-Improvement for Navigation via Policy-Synchronized Language-Action Dual Bootstrapping
Key Point 고비용의 인간 주석 없이도 모델이 스스로 학습 데이터를 생성하고 개선하는 방식은 대규모 AI 시스템의 데이터 확보 문제를 어떻게 풀 수 있는지 보여주는 중요한 사례다.
핵심 요약
자연어 지시를 따라 목표 위치에 도달하는 비전-언어 네비게이션 모델을 만들 때 고품질의 언어 감독 데이터가 필수이나, 사람이 직접 주석을 다는 것은 비용이 많이 든다. 기존 방법들은 네비게이션과 명령어 생성을 분리된 모델로 처리하거나 특정 컴포넌트로 묶어서 처리하는 한계가 있었고, 고정된 모델로 전체 궤적을 미리 주석해서 생성된 감독이 진화하는 정책에 뒤처지는 문제가 있었다. 논문은 RSI-Nav라는 데이터 중심의 재귀적 자가개선 프레임워크를 제안하며, 하나의 공유 모델로 비전-언어-행동 명령 수행과 비전-행동-언어 명령 생성을 통합한다. 전체 요약 7문장 읽기 → 074 15:11 ▲ 71 · 댓글 1 PPO의 가치 함수 추적 개선, 수학 추론 성능 7~8점 향상 언어 모델 추론용 강화학습에서 널리 쓰이는 PPO는 희소 종료 보상(sparse terminal rewards) 환경에서 표준 비평가(critic)가 값의 진화를 제대로 추적하지 못한다는 문제를 가지고 있다. AI · 머신러닝 · TPPO: Tracking-Value PPO For Language Model Reasoning
Key Point 강화학습 기반 언어 모델 추론에서 가치 함수의 정확성이 직접적으로 성능을 좌우하는데, 이 방법이 표준 PPO를 크게 능가하는 수학 추론 성능 향상을 보여준다.
핵심 요약
언어 모델 추론용 강화학습에서 널리 쓰이는 PPO는 희소 종료 보상(sparse terminal rewards) 환경에서 표준 비평가(critic)가 값의 진화를 제대로 추적하지 못한다는 문제를 가지고 있다. 논문은 연속된 접두어(prefix) 값들 사이의 관계를 분석하고, 이들이 로그-오즈 공간(log-odds space)에서 덧셈 갱신으로 이루어진 베이지안 분해를 허용함을 보였다. 이 덧셈 구조를 이용해 추적-가치 PPO(TPPO)를 제안하는데, 위치별 스칼라 출력값들을 누적해 가치 로짓(value logits)을 형성하고 재구성된 값들을 통한 종료 결과 지도학습으로 학습된다. 전체 요약 6문장 읽기 → 075 15:11 ▲ 100 · 댓글 69 Mac Dock 27년의 진화, 한눈에 모은 아이콘 역사 저자는 iOS 앱 아이콘 역사를 다룬 책 집필 후 macOS의 아이콘 설계 역사 연구를 시작했다. 기타 · The Dock on Mac, from OS 10 to macOS 27
Key Point Mac이 출시한 이래 Dock의 외형이 어떻게 진화해왔는지 시간 순서대로 한눈에 비교할 수 있는 시각 자료가 공개되어, 애플의 UI 미학 변화를 추적하려는 디자이너나 기술사 애호가들에게 참고 자료로 쓸 수 있다.
핵심 요약
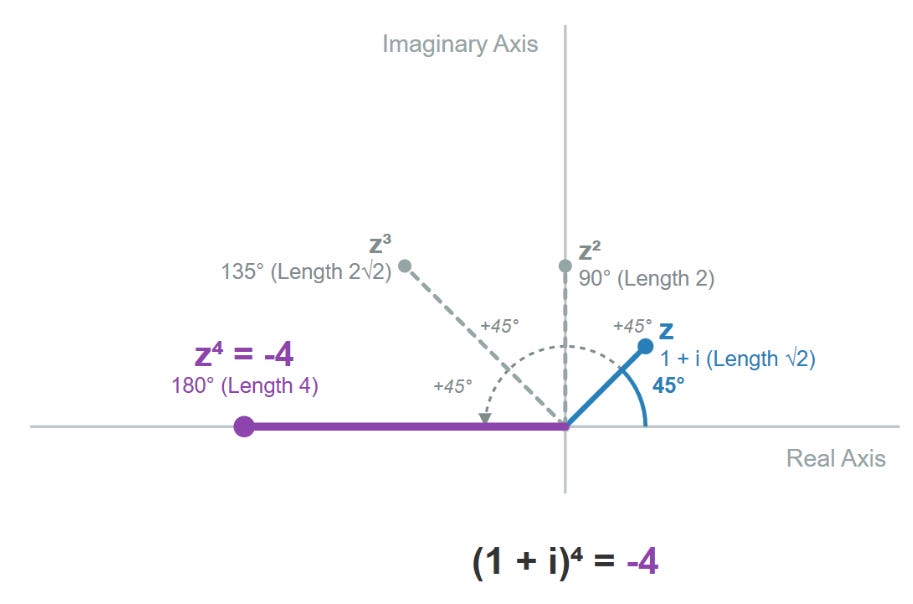
저자는 iOS 앱 아이콘 역사를 다룬 책 집필 후 macOS의 아이콘 설계 역사 연구를 시작했다. macOS 버전 10부터 27까지 거쳐온 Dock의 여러 세대 디자인을 한 장의 그래픽으로 수집해 정리했다. 512 Pixels의 이미지 컴파일 자료를 참고해 시각적으로 보존할 수 있는 아카이브를 만들었다. 전체 요약 4문장 읽기 → 076 06:11 ▲ 109 · 댓글 68 복소수의 시각적 이해: 불가능한 제곱근에서 회전의 언어까지 실수만으로는 풀 수 없는 연립방정식을 시도하며 음수의 제곱근이라는 불가능한 문제에 직면하게 된다. AI · 머신러닝 · A Visual Intro to Complex Numbers
Key Point 음수의 제곱근이라는 불가능한 계산에서 출발해 현대 통신, 제어, 물리학을 움직이는 핵심 도구가 된 복소수의 진화 과정과 실제 응용을 한눈에 이해할 수 있다.
핵심 요약
실수만으로는 풀 수 없는 연립방정식을 시도하며 음수의 제곱근이라는 불가능한 문제에 직면하게 된다. 16세기 이탈리아 수학자 카르다노는 음수의 제곱근을 계산 과정에서 다루면 불가능한 항들이 소거되어 실제 답에 도달할 수 있음을 발견했지만, 이를 의미 없는 '편의적 속임수'로 간주했다. 데카르트는 이런 수들을 '허수'라고 부르며 조롱했으나, 18세기 오일러는 음수의 제곱근을 i로 표기하며 체계적인 기초를 마련했다. 전체 요약 15문장 읽기 → 077 03:11 ▲ 164 · 댓글 327 애플, AI 기능 강화한 새 Apple TV 4K 공개 애플이 10월 13일 차세대 Apple TV 4K(4세대)를 발표했으며, 11월 13일부터 판매된다. AI · 머신러닝 · New Apple TV 4K
Key Point 애플의 주요 가정용 기기에 생성형 AI 기능이 본격 적용되는 사례로, 음성 인터페이스와 홈 자동화가 어떻게 진화하고 있는지 보여준다.
핵심 요약
애플이 10월 13일 차세대 Apple TV 4K(4세대)를 발표했으며, 11월 13일부터 판매된다. 신형 기기는 Siri AI를 탑재해 사용자가 영화·드라마를 찾고 발견하는 경험을 전체 화면 대화형 인터페이스로 제공한다. Siri AI는 애플 인텔리전스 기반으로 더 강력해졌으며, 개인 맥락을 이해해 '알린다가 추천한 쇼 재생'처럼 기기 간 요청을 처리할 수 있다. 전체 요약 13문장 읽기 → 078 18:12 ▲ 14 · 댓글 2 비디오 AI가 스스로 관찰 방식을 개선한다 비디오 이해 에이전트는 현재의 '하네스(harness, 관찰 장치)'로 수집한 증거만으로는 실패 원인을 완전히 파악할 수 없다는 문제가 있다. AI · 머신러닝 · Video-RSI: Recursive Self-Improvement of Video Understanding Agents via Harness Evolution
Key Point 비디오 AI가 실패를 분석해 자신의 관찰 방식을 반복적으로 개선하는 새로운 접근법이 제시되었으며, 정확도를 유지하면서 계산 비용을 절감할 수 있다는 점이 실무 적용에 중요하다.
핵심 요약
비디오 이해 에이전트는 현재의 '하네스(harness, 관찰 장치)'로 수집한 증거만으로는 실패 원인을 완전히 파악할 수 없다는 문제가 있다. Video-RSI라는 새로운 프레임워크를 제시하는데, 언어 모델 스스로가 자신의 하네스를 수정해서 비디오를 재조사한다. 에이전트는 원본 학습 영상에 돌아가 추가 관찰을 통해 여러 실패 가설을 검증하고, 기존 실행 흔적을 벗어난 증거로 개선안을 뒷받침한다. 전체 요약 8문장 읽기 → 079 15:11 ▲ 66 · 댓글 3 실제 환경에서 로봇 에이전트의 계속 학습 평가하는 벤치마크 공개 EmbodiedCLBench는 로봇 시뮬레이션 환경에서 자기 진화 에이전트의 계속 학습(continual learning) 능력을 평가하기 위한 첫 벤치마크다. AI · 머신러닝 · EmbodiedCLBench: Evaluating Continual Learning for Self-Evolving Embodied Agents
Key Point 로봇과 에이전트가 새로운 환경과 작업에 적응하려면 과거 경험을 활용해야 하는데, 현재 계속 학습 연구는 실제 환경에 거의 적용되지 않았다는 근본적인 격차를 해결하기 위한 첫 벤치마크다.
핵심 요약
EmbodiedCLBench는 로봇 시뮬레이션 환경에서 자기 진화 에이전트의 계속 학습(continual learning) 능력을 평가하기 위한 첫 벤치마크다. 벤치마크는 에이전트가 기본 작업부터 학습한 후 획득한 기술들을 재조합해 본 적 없는 복잡한 고급 작업을 해결할 수 있는지를 평가하는 구성적 일반화(compositional generalization)를 핵심 원칙으로 삼는다. 여러 에이전트 구조와 학습 방법 전체에 걸친 광범위한 실험을 통해 에이전트의 일관된 제약과 독특한 행동 패턴을 발견했다. 전체 요약 7문장 읽기 → 080 12:11 ▲ 33 · 댓글 2 재귀적 자기개선 프레임워크로 코드부터 신약까지 성능 지속 개선 RSI-Anything은 JEPA-Anything 기반의 도메인 범용 프레임워크로, 예측 세계 모델을 사용해 행동과 학습 데이터 선택을 안내한다. AI · 머신러닝 · RSI-Anything: Unlocking Recursive Self-Improvement with World Models
Key Point 기존 외부 피드백 없이 정책이 스스로 개선되는 자기개선 프레임워크가 코드 수리부터 신약 발견까지 다양한 분야에서 실질적 성능 향상을 입증했기 때문이다.
핵심 요약
RSI-Anything은 JEPA-Anything 기반의 도메인 범용 프레임워크로, 예측 세계 모델을 사용해 행동과 학습 데이터 선택을 안내한다. 정책 진화 중 세계 모델 예측의 신뢰성 저하 문제를 해결하기 위해 관찰된 피드백을 통해 정책이나 워크플로우 개선과 조건부 세계 모델 적응을 진행한다. 성분·호환성 검사를 통해 업데이트된 정책-모델 쌍의 유지 여부를 결정한다. 전체 요약 8문장 읽기 → 081 15:11 ▲ 105 · 댓글 48 AI가 5개월에 완성한 Db2 마이그레이션 기능, 인간은 9개월 소요 Cockroach Labs는 MOLT 데이터베이스 마이그레이션 도구에 IBM Db2 소스 지원을 추가했는데, 이 작업을 AI 에이전트들이 2일 만에 완료했다. AI · 머신러닝 · Five months treating bugs like patients and coding agents like a medical team
Key Point 의료 시스템 모델로 AI 코드 작성의 품질 문제를 해결하고 기존 9개월 작업을 2일로 단축한 구체적 사례로, AI 코드 자동화의 실무적 가능성과 제약을 보여준다.
핵심 요약
Cockroach Labs는 MOLT 데이터베이스 마이그레이션 도구에 IBM Db2 소스 지원을 추가했는데, 이 작업을 AI 에이전트들이 2일 만에 완료했다. Oracle 지원 추가는 인간 엔지니어가 9개월, 약 16만 달러를 들였지만, Db2 지원은 에이전트가 비용 4,172달러에 완료했다: 164배 빠르고 38배 저렴했다. 작업 자동화를 위해 'MOLT Sinai'라는 '코딩 병원' 시스템을 구축했다: GitHub 이슈를 환자로, 병합을 퇴원으로 부르는 의료진 비유 모델이다. 전체 요약 16문장 읽기 → 082 12:11 ▲ 103 · 댓글 35 체험형 게임쇼의 원조, 다케시 캐슬의 역사와 재부활 1986년부터 1990년까지 일본 TBS 방송국에서 방영된 '다케시 캐슬'은 아역 배우이자 영화감독인 타케시 기타노(비트 다케시)가 성주 역으로 출연해 시청자들이 극복해야 할 신체 도전과제들을 만든 게임쇼다. 기타 · Takeshi's Castle
Key Point 1980년대의 신체 도전 게임쇼 붐을 주도한 '다케시 캐슬'이 2023년 스트리밍 플랫폼으로 부활한 이유와 프로그램의 구조, 수십 가지 챌린지의 구체적 방식을 알 수 있다.
핵심 요약
1986년부터 1990년까지 일본 TBS 방송국에서 방영된 '다케시 캐슬'은 아역 배우이자 영화감독인 타케시 기타노(비트 다케시)가 성주 역으로 출연해 시청자들이 극복해야 할 신체 도전과제들을 만든 게임쇼다. 프로그램은 일반 타니(谷隼人)가 86~142명의 도전자를 이끌고 물에 빠지거나 진흙에 빠지는 내용의 제거식 신체 챌린지에 참여하게 하며, 마지막에 생존자들이 다케시와 그의 군대와 성을 점령하기 위해 최종 전투를 벌인다. 요코하마의 TBS 소유 미도리야마 스튜디오에 대규모 조경과 인공 호수, 정교한 고정 장애물들이 설치되어 도전과제들이 펼쳐졌다. 전체 요약 10문장 읽기 → 083 09:11 ▲ 10 · 댓글 3 생물 진화 원리로 LLM 멀티에이전트 시스템 테스트 최적화 LLM 기반 멀티에이전트 시스템(MAS)은 복합 작업에 특화된 에이전트들을 조율하지만, 효과적인 워크플로우를 사전에 설계하기 어렵다. AI · 머신러닝 · Inherit-MAS: Test-Time Evolution of Multi-Agent Systems through Workflow and Execution Inheritance
Key Point 복합 작업을 처리하는 멀티에이전트 LLM 시스템의 워크플로우 최적화와 실행 효율성 문제를 동시에 해결한 새로운 접근법으로, 토큰 사용량을 대폭 줄이면서 성능을 높인다.
핵심 요약
LLM 기반 멀티에이전트 시스템(MAS)은 복합 작업에 특화된 에이전트들을 조율하지만, 효과적인 워크플로우를 사전에 설계하기 어렵다. Inherit-MAS는 워크플로우와 실행 단계에서 '상속'을 명시적으로 구현해 테스트 시점의 진화를 효율화했다. 메타 모델이 워커 에이전트 워크플로우를 합성하고(역할·통신·권한 선언), 별도의 판사 모델이 실행 결과를 평가하고 결함을 진단한다. 전체 요약 8문장 읽기 → 084 21:11 ▲ 39 · 댓글 6 언어모델의 불확실성을 해석 가능하게 측정하는 'U-Space' 제안 대형 언어모델이 고위험 결정을 내릴 때 그 답변의 신뢰도를 판단하기 어렵다는 문제가 제기되고 있다. AI · 머신러닝 · U-Space: Uncovering When and Why Uncertainty Arises in Language Models
Key Point 언어모델이 제시하는 답변의 신뢰도를 판단하고 잘못된 결론을 피해야 하는 상황에서, 해석 가능한 불확실성 측정 방법이 제시됨에 따라 모델 신뢰성 평가 방식이 달라질 수 있다.
핵심 요약
대형 언어모델이 고위험 결정을 내릴 때 그 답변의 신뢰도를 판단하기 어렵다는 문제가 제기되고 있다. 기존 불확실성 정량화 방법은 반복 생성이나 별도 학습이 필요하고, 불확실성이 어디서 발생하는지 보여주지 못한다. 생성 길이가 불확실성 추정과 정답률과 강하게 연관되어 있어서, 추정기가 불확실성 정보인지 단순히 길이 정보인지 구분하기 어렵다. 전체 요약 8문장 읽기 → 085 12:11 ▲ 226 · 댓글 3 가상 세계에서 코드로 에이전트를 진화시키는 AgentGarten AgentGarten은 시뮬레이터·게임 엔진과 신경 렌더러를 결합하여 실시간 상호작용 환경을 구축하는 프레임워크다. AI · 머신러닝 · AgentGarten: Code Worlds for Evolving Agents
Key Point 기존 강화학습은 수백만 번의 상호작용이 필요하지만 AgentGarten은 4라운드만으로 에이전트를 학습시키므로, AI 에이전트의 훈련 효율을 획기적으로 높이는 방법론이다.
핵심 요약
AgentGarten은 시뮬레이터·게임 엔진과 신경 렌더러를 결합하여 실시간 상호작용 환경을 구축하는 프레임워크다. 시뮬레이션 백엔드는 지속적인 월드 상태를 유지하고 프로그램 정의 규칙을 실행하며, 렌더러는 공통 인터페이스를 통해 구조화된 조건으로부터 시각 관찰을 생성한다. 신경 렌더러는 사전학습된 비디오 모델을 기하학 조건에 맞춰 적응시키고, 제안된 Adversarial Forcing으로 증류하며, 실시간 상호작용을 위해 추론을 최적화한다. 전체 요약 7문장 읽기 → 086 09:11 ▲ 106 · 댓글 14 DuckDB, SQL 기반 레이크하우스 포맷 DuckLake 공개 DuckDB가 SQL과 Parquet 기반의 오픈소스 레이크하우스 포맷 DuckLake를 확장으로 공개했다. 인프라 · 데브옵스 · DuckDB Ducklake
Key Point DuckDB가 Iceberg·Delta Lake 같은 경쟁 포맷들과 달리 SQL 우선 철학으로 레이크하우스를 구축하는 새로운 선택지를 제시했으며, 타임 트래블·스키마 진화 같은 현대적 기능을 표준 SQL로 단순하게 구현했다.
핵심 요약
DuckDB가 SQL과 Parquet 기반의 오픈소스 레이크하우스 포맷 DuckLake를 확장으로 공개했다. DuckLake는 메타데이터를 카탈로그 데이터베이스에, 데이터를 Parquet 파일로 저장하며, DuckLake 확장을 통해 DuckDB에서 직접 읽고 쓸 수 있다. INSTALL 명령어로 설치하고 ATTACH 문법으로 데이터베이스를 연결한 후 표준 SQL로 테이블 생성·수정·쿼리가 가능하다. 전체 요약 6문장 읽기 → 087 09:11 ▲ 102 · 댓글 34 사소한 대화의 가치, 왜 우리는 핵심을 바로 말하지 않을까 저자는 음식이나 음료가 사람들을 대화하는 시간 내내 무엇인가 말해야 한다는 부담에서 해방시킨다는 통찰을 얻었다. 기타 · The value of not getting to the point (2015)
Key Point 소셜 미디어 문화의 근본적인 문제를 인간관계의 심리학으로 설명하며, 온라인 갈등이 단순한 무례함이 아니라 구조적 결핍에서 비롯된다는 점을 제시한다.
핵심 요약
저자는 음식이나 음료가 사람들을 대화하는 시간 내내 무엇인가 말해야 한다는 부담에서 해방시킨다는 통찰을 얻었다. 딸이 '뭐에 대해서?'라는 질문에 짜증을 내고 '그냥 뭔가 얘기하자'고 제안했을 때, 저자는 사람들이 민감한 주제로 가기 전에 긴 대화 준비 과정을 필요로 한다는 것을 깨달았다. 30분간 트럼프와 대선 같은 하찮은 주제로 대화한 후에야 딸이 실제 고민을 터놓을 수 있었다. 전체 요약 8문장 읽기 → 088 03:11 ▲ 10 · 댓글 2 텍스트-이미지 생성 모델에 에이전트 지식 직접 조각내기 텍스트-이미지 생성 모델을 에이전트 프레임워크로 감싸면 프롬프트 반복 개선과 검증을 통해 생성 품질이 향상되지만, 이런 이득이 모델 가중치에 내재되지 않아 에이전트가 실행될 때만 효과가 발휘된다. AI · 머신러닝 · Internalizing Agent Experience into Diffusion Model Weights via On-Policy Context Distillation
Key Point 이미지 생성 품질을 높이는 에이전트 능력을 모델 자체에 영구적으로 내재시켜 일반 사용자도 원본 쿼리만으로 개선된 이미지를 받을 수 있게 하는 새로운 접근 방식이다.
핵심 요약
텍스트-이미지 생성 모델을 에이전트 프레임워크로 감싸면 프롬프트 반복 개선과 검증을 통해 생성 품질이 향상되지만, 이런 이득이 모델 가중치에 내재되지 않아 에이전트가 실행될 때만 효과가 발휘된다. 논문은 Diffusion On-Policy Context Distillation(D-OPCD)를 제안하는데, 에이전트가 개선한 프롬프트를 특권 정보로 삼아 에이전트의 능력을 확산 모델 가중치로 직접 압축하는 방식이다. Auto Skill Evolver(ASE)라는 텍스트-이미지 에이전트를 사용해 D-OPCD를 실험한 결과, 원본 쿼리만으로 생성했을 때 평균 점수가 60.52에서 65.09로 상승했다(4개 벤치마크 기준). 전체 요약 5문장 읽기 → 089 00:11 ▲ 29 · 댓글 2 고정 모델도 로봇 역량 높인다, PhysEvo 프레임워크 제시 Astra 같은 고정된 대형 모델도 충분한 관찰과 제어 체계가 있으면 로봇 조작 능력을 발휘할 수 있다. AI · 머신러닝 · PhysEvo: Astra Can Act, Let It
Key Point 모델 가중치 업데이트나 별도 훈련 없이 시뮬레이션 기반 자기개선만으로 실제 로봇 조작 성공률을 5배 이상 높일 수 있음을 입증한 결과다.
핵심 요약
Astra 같은 고정된 대형 모델도 충분한 관찰과 제어 체계가 있으면 로봇 조작 능력을 발휘할 수 있다. PhysEvo는 모델 가중치를 업데이트하지 않고도 물리적 재귀적 자기개선(RSI)을 수행하는 프레임워크다. 작업 에이전트가 로봇 태스크를 실행하고, 메타 에이전트가 실패를 진단해 도구와 스킬을 개정한 후 테스트한다. 전체 요약 8문장 읽기 → 090 00:11 ▲ 124 · 댓글 39 느린 설계가 만든 내구성 있는 소프트웨어, Zotero의 20년 AI 시대의 빠른 소프트웨어 개발과 달리, 연구 도구 Zotero는 2001년부터 5년간의 구상을 거쳐 2006년 10월 첫 공개되었다. 스타트업 · 비즈니스 · The Slow Formation of Durable Software
Key Point AI로 빠르게 소프트웨어를 만드는 시대에 장기간의 사려 깊은 설계가 어떻게 20년을 견딘 도구를 만들었는지 보여주는 역사적 증거를 담고 있다.
핵심 요약
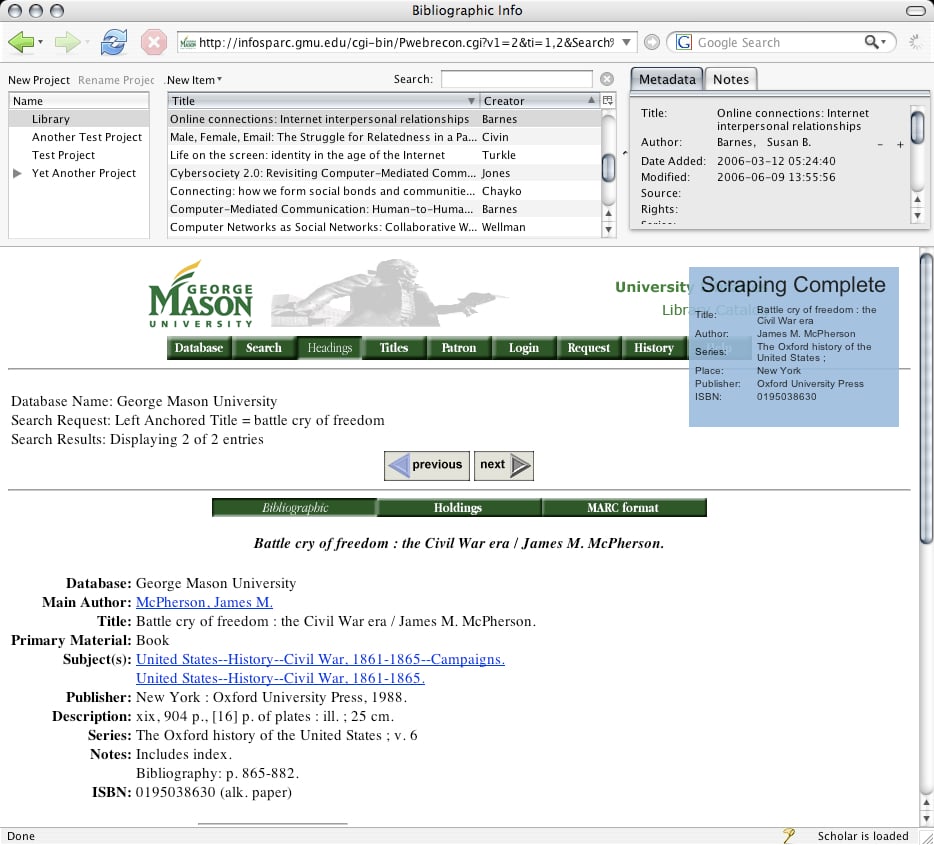
AI 시대의 빠른 소프트웨어 개발과 달리, 연구 도구 Zotero는 2001년부터 5년간의 구상을 거쳐 2006년 10월 첫 공개되었다. Zotero는 지난 20년간 2000만 명 이상이 수십 개 언어로 사용하는 학술 자료 수집·정리·인용 도구로 성장했다. RRCHNM(조지 메이슨 대학교)의 역사학자 그룹이 Web Scrapbook과 Scribe라는 두 가지 시험작을 바탕으로 개념을 발전시켰다. 전체 요약 10문장 읽기 → 091 21:11 당일 +107 생산 장애 대응하는 AI SRE 에이전트 OpenSRE 공개 Tracer-Cloud가 오픈소스 AI SRE 에이전트 프레임워크 OpenSRE v0.1을 공개했다. 사용자가 기존에 운영 중인 60여 개 도구를 연결하고 커스텀 워크플로를 정의한 뒤 자체 인프라에서 생산 환경 문제에 답할 수 있다. 인프라 · 데브옵스 · Tracer-Cloud/opensre · Python
Key Point AI가 코드 디버깅 벤치마크(SWE-bench)는 갖춘 반면, 생산 장애 대응 분야는 표준화된 학습·평가 환경이 없어 AI SRE가 아직 미해결 상태인데, OpenSRE가 이 공백을 채우기 위한 오픈소스 기반을 제시했기 때문이다.
핵심 요약
Tracer-Cloud가 오픈소스 AI SRE 에이전트 프레임워크 OpenSRE v0.1을 공개했다. 사용자가 기존에 운영 중인 60여 개 도구를 연결하고 커스텀 워크플로를 정의한 뒤 자체 인프라에서 생산 환경 문제에 답할 수 있다. 에이전트는 로그·메트릭·트레이스·배포 이력에서 관련 컨텍스트를 자동으로 가져온 뒤, 민감 정보를 마스킹한 후 도구 호출 루프를 통해 가설을 검증하고 증거 기반 답변을 제시한다. Slack·PagerDuty·Telegram으로 요약 결과를 직접 전송하며, 보안을 염두에 두고 설계되어 구조화된 LLM 프롬프트·로컬 트랜스크립트 처리·감사 추적을 지원한다. 전체 요약 10문장 읽기 → 092 18:30 ▲ 64 · 댓글 2 자가학습하는 추론 모델, 반복 학습으로 성능 붕괴 막는 방법 제시 추론 모델이 자체 생성 질문으로 학습하는 자가진화 과정에서 반복할수록 성능이 저하되는 문제가 있다. AI · 머신러닝 · Questioning the Questions: Sustaining Self-Evolution in Reasoning Models
Key Point 자가학습하는 LLM 기반 추론 모델의 성능 붕괴 문제를 해결하는 실질적 방법을 제시해, 장기간 안정적인 모델 개선이 가능해진다.
핵심 요약
추론 모델이 자체 생성 질문으로 학습하는 자가진화 과정에서 반복할수록 성능이 저하되는 문제가 있다. 논문은 성능 악화의 원인으로 두 가지를 파악했다: 무효한 질문의 증가와 수학적으로 동등한 질문의 반복. 무효한 질문은 라운드가 진행될수록 늘어나며, 답변 일관성 필터링이 이를 더욱 악화시킨다. 전체 요약 9문장 읽기 → 093 18:33 ▲ 14 · 댓글 3 에이전트 메모리를 자동 진화시키는 새로운 방법 에이전트의 메모리 시스템을 작업 피드백으로 자동 개선하는 메모리 자가진화 기법의 한계를 개선한 논문이다. AI · 머신러닝 · Capability-Driven Self-Evolution of Agent Memory
Key Point 기존 에이전트 메모리 최적화의 근본적 문제점을 능력별 분석으로 해결하는 방식이 신경망 기반 최적화와 다르고, 장문맥 처리에서 눈에 띄는 성능 향상을 보여준다.
핵심 요약
에이전트의 메모리 시스템을 작업 피드백으로 자동 개선하는 메모리 자가진화 기법의 한계를 개선한 논문이다. 기존 방식은 전체 성능만 보고 진화 방향을 정하는 홀리스틱 진화를 써 왔는데, 능력별 개선 효과를 놓치고 일부 영역의 후퇴가 전체 성능을 가린다. 이 논문은 능력 기반 진화(capability-driven evolution)를 제안해 전체 성능 대신 개별 능력 차원별로 탐색을 안내한다. 전체 요약 6문장 읽기 → 094 18:33 ▲ 28 · 댓글 2 AI 과학자를 평가하는 벤치마크, 자동으로 만든다 기존 과학 분야 벤치마크는 에이전트 성능이 향상되면서 포화되어 역량 차이를 구별하기 어려워지고, 새로운 벤치마크 구축에 시간과 전문성이 필요한 문제가 있다. AI · 머신러닝 · AutoSciBench: Autonomous Benchmark Generation for Evaluating Scientific Agents
Key Point AI 에이전트가 빠르게 발전할 때 기존 평가 방식이 뒤떨어지는 문제를 자동화로 해결하는 방법론이 제시되어, 향후 AI 시스템 평가 방식에 영향을 미칠 수 있다.
핵심 요약
기존 과학 분야 벤치마크는 에이전트 성능이 향상되면서 포화되어 역량 차이를 구별하기 어려워지고, 새로운 벤치마크 구축에 시간과 전문성이 필요한 문제가 있다. AutoSciBench는 각 과제를 과학 도메인·데이터 형식·추론 방식을 지정하는 고수준 개념과 질문·환경·정답 구성 방법을 담은 저수준 레시피로 표현한다. 에이전트가 과제를 시도할 때 생성되는 풀이 궤적과 판단 피드백을 이용해 자동으로 레시피나 개념을 개선하고, 과제를 우회 풀이에서 원본 데이터 재검토·중간 결과 해석·증거 통합으로 진화시킨다. 전체 요약 6문장 읽기 → 095 18:33 ▲ 38 · 댓글 2 LLM 에이전트의 스킬을 재실행 가능한 증거로 진화시키는 EVISKILL LLM 에이전트가 모델 파라미터를 업데이트하지 않으면서 상호작용 경험으로부터 재사용 가능한 절차적 지식을 축적하고 개선하는 지속적 스킬 진화를 다룬다. AI · 머신러닝 · EVISKILL: Grounding Skill Evolution in Replayable Evidence
Key Point 매개변수 고정 상태에서 LLM의 스킬을 직접 개선할 수 있는 새로운 방법론으로, 지속적 학습을 추구하는 에이전트 시스템 개발자와 연구자에게 실용적이다.
핵심 요약
LLM 에이전트가 모델 파라미터를 업데이트하지 않으면서 상호작용 경험으로부터 재사용 가능한 절차적 지식을 축적하고 개선하는 지속적 스킬 진화를 다룬다. 기존 경험 기반 방식들은 편집을 정당화하는 행동 증거와 작업 문맥을 잃기 쉬우며, 전역 검증이 구성 변화들에 대한 불완전한 판단을 제공하는 문제가 있다. EVISKILL은 실행 관찰값을 재실행 가능한 증거 카드로 정렬하고, 편집을 그들의 지원 문맥과 명시적으로 연결한다. 전체 요약 7문장 읽기 → 096 18:33 ▲ 13 · 댓글 1 딥페이크 탐지 기술의 한계와 새로운 인증 방식 생성 모델이 고품질의 가짜 이미지를 대규모로 생산하면서 20개 딥페이크 탐지기를 10개 생성 모델로 평가한 결과, 탐지 정확도가 4년간 99.5%에서 76%로 급락했다. AI · 머신러닝 · Certification of Real Images through Calibrated Content Authentication
Key Point 콘텐츠 분석 기반 딥페이크 탐지가 생성 모델의 진화 속에서 급속도로 무력화되는 현실을 보여주며, 이제는 출처 검증 없이는 이미지 인증 자체가 불가능해지고 있음을 시사한다.
핵심 요약
생성 모델이 고품질의 가짜 이미지를 대규모로 생산하면서 20개 딥페이크 탐지기를 10개 생성 모델로 평가한 결과, 탐지 정확도가 4년간 99.5%에서 76%로 급락했다. 적대적 교란 공격이 모든 탐지기의 정확도를 2% 이하로 떨어뜨려 판정을 역전시킬 수 있으며, 이는 콘텐츠 분석만으로는 출처를 판별할 수 없음을 보여준다. 생성 모델이 진정한 콘텐츠를 정확히 재현할 수 있으므로(기억 효과), 같은 생성 모델이 충실하게 재구성할 수 있으면 합성 출처의 '그럴듯한 부인가능성'이 성립한다. 전체 요약 7문장 읽기 → 097 18:33 ▲ 149 · 댓글 78 LLM 에이전트를 위한 Codemode: 하네스 내 코드 실행 Codemode는 LLM 에이전트가 하네스(뇌) 측에서 복잡한 작업을 표현하고 조율하는 방식으로, 실행 환경(손)과는 분리되어 있다. AI · 머신러닝 · What is Codemode
Key Point LLM 에이전트의 도구 호출 방식이 Bash에서 하네스 기반 코드 실행으로 진화하는 중요한 전환점이며, MCP와 AI SDK의 통합 방향을 이해하는 데 필수적이다.
핵심 요약
Codemode는 LLM 에이전트가 하네스(뇌) 측에서 복잡한 작업을 표현하고 조율하는 방식으로, 실행 환경(손)과는 분리되어 있다. Bash의 근본 한계는 프로그램만 조합할 수 있다는 것인데, 이미지 읽기나 서브 에이전트 생성처럼 하네스의 네이티브 도구가 필요한 작업들이 있다. Pi는 Codemode를 JavaScript 기반으로 구현했으며, QuickJS WASM 런타임에서 네트워크·파일시스템·타이머 없이 격리 실행되고 도구 호출만 가능하다. 전체 요약 12문장 읽기 → 098 18:33 ▲ 316 · 댓글 136 Gleam이 Erlang 소스코드 대신 추상 형태로 컴파일하도록 전환 Gleam v1.19.0 릴리스에서 Erlang 코드 생성기를 완전 재작성하여 Erlang 소스코드 대신 Erlang 추상 형태(abstract forms, 중간 표현)로 컴파일하도록 변경했다. 오픈소스 · 도구 · Gleam doesn't compile to Erlang source anymore
Key Point Erlang 추상 형태 컴파일로 빌드 성능이 크게 향상되고 스택 트레이스 정확도가 개선되었으며, JavaScript와 TypeScript 최적화, 에러 메시지 강화, 다른 빌드 도구 통합 개선 등이 Gleam 개발 경험 전반을 크게 나아지게 한다.
핵심 요약
Gleam v1.19.0 릴리스에서 Erlang 코드 생성기를 완전 재작성하여 Erlang 소스코드 대신 Erlang 추상 형태(abstract forms, 중간 표현)로 컴파일하도록 변경했다. 추상 형태는 Erlang 컴파일러가 사용하는 메타데이터 주석이 달린 트리로, 이진 인코딩으로 직접 로드되어 Erlang 컴파일러의 전반부를 건너뛸 수 있다. 이 변경으로 컴파일러 성능이 크게 향상되어 빌드 시간이 대폭 단축되었으며, v1.17.0 대비 v1.19.0에서 벤치마크 프로젝트 컴파일 시간이 상당히 개선됐다. 전체 요약 14문장 읽기 → 099 18:35 ▲ 28 · 댓글 2 능동형 AI 에이전트 설계·평가 원리 제시 사용자가 요청하지 않아도 미리 도움을 주는 능동형 LLM 에이전트가 필요하지만, 사용자 의도를 잘못 읽거나 신뢰를 잃을 수 있다는 문제가 있다. AI · 머신러닝 · Foundations of Proactive Agents: Principles, Technical Layers, and Proactivity-Gym
Key Point 능동형 AI 에이전트의 신뢰 문제를 다루는 첫 종합 프레임워크로, 실제 사용자 연구를 통해 '올바른 작업'과 '신뢰'가 별개임을 검증했다.
핵심 요약
사용자가 요청하지 않아도 미리 도움을 주는 능동형 LLM 에이전트가 필요하지만, 사용자 의도를 잘못 읽거나 신뢰를 잃을 수 있다는 문제가 있다. 논문은 능동형 에이전트 설계를 위해 3T 원칙을 제시한다: ①Task Capability(필요를 예측하고 유용한 작업 수행), ②Temporal Allocation(자원 가용성과 필요 시점에 맞춰 계산 배분), ③Trust(사용자 신뢰와 적절한 의존성 유지). 이 원칙들을 구현하기 위해 5가지 설계 차원(작업 범위, 예측 지평, 활성화 트리거, 처리 시점, 개입 깊이)으로 설계 공간을 조직했다. 전체 요약 8문장 읽기 → 100 18:35 ▲ 43 · 댓글 2 손재주 많은 로봇 제어, 3D 점군으로 배운다 세계 동역학과 로봇 행동을 함께 학습하는 월드 액션 모델에서, 기존 방식은 RGB 프레임이나 잠재 표현으로 세계를 모델링하고 손목 각도 같은 1차원 값으로만 행동을 예측해 3D 공간 구조와 접촉 기하를 놓쳤다. AI · 머신러닝 · PointWAM: 3D World Action Modeling for Dexterous Robotic Manipulation
Key Point 기존 손재주 로봇 조작 모델은 평면 이미지와 1차원 관절각만 다루며 3D 공간 기하를 놓쳤던 근본적 한계를 점군으로 해결한 접근법이 기존 방식을 11.7포인트 이상 추월했다.
핵심 요약
세계 동역학과 로봇 행동을 함께 학습하는 월드 액션 모델에서, 기존 방식은 RGB 프레임이나 잠재 표현으로 세계를 모델링하고 손목 각도 같은 1차원 값으로만 행동을 예측해 3D 공간 구조와 접촉 기하를 놓쳤다. Point World Action Model (PointWAM)은 환경과 손을 공유 시공간 좌표에서 3D 점 궤적으로 명시적, 분리적으로 표현하고 함께 예측한다. 작업별 물체 또는 키포인트 선택 없이 대규모 인간 시연 영상으로 사전학습할 수 있으며, 컬러 포인트 클라우드와 언어 지시로부터 장면과 손이 3D 공간에서 시간 경과에 따라 어떻게 공진화하는지 예측한 후 손 동작을 로봇 행동으로 재타겟팅한다. 전체 요약 4문장 읽기 →