쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
100건 (최대치) · "파라미터"조건 지우기 ×
001 15:11 ▲ 14 · 댓글 1 나레이션으로 장편 비디오 자동 편집하는 AI 에이전트 WeVisCut 나레이션에서 장편 비디오를 생성할 때 여러 샷 사이의 일관성을 유지하는 것이 과제인데, 기존 멀티 스테이지 에이전트는 일반 모델 기반으로 작동해 소형 모델의 성능-비용 트레이드오프가 불명확했다. AI · 머신러닝 · WeVisCut: The Whole Editing Room in One Agent From Narration to Long-Form Video
Key Point 텍스트 지시만으로 긴 비디오를 자동 편집하면서 토큰 효율은 Claude Opus 5의 33분의 1 수준이라는 점이 현장 업무 자동화의 실제 가능성을 보여준다.
핵심 요약
나레이션에서 장편 비디오를 생성할 때 여러 샷 사이의 일관성을 유지하는 것이 과제인데, 기존 멀티 스테이지 에이전트는 일반 모델 기반으로 작동해 소형 모델의 성능-비용 트레이드오프가 불명확했다. WeVisCut는 스크립트를 비디오로 변환하는 시스템으로, 도구 실행과 정책 학습을 연결하며 에이전트가 공유 프로덕션 상태를 유지해 도구 피드백이 후속 결정과 오류 복구에 반영된다. 기존 완성 비디오에는 편집 의도가 노출되지 않으므로, 4단계 데이터 파이프라인이 편집 역변환(inversion)과 검증된 재생(replay)을 결합해 3,750개 영상에서 130K개 이상의 훈련 데이터를 추출한다. 전체 요약 7문장 읽기 → 002 06:11 ▲ 11 · 댓글 1 시계열 재단 모델 'Timestral' 공개, 벤치마크 최강 성능 허깅페이스가 시계열 확률 예측을 위한 파운데이션 모델 Timestral 4가지를 발표했다: 5M, 28M, 123M, 209M 파라미터 규모. AI · 머신러닝 · Timestral
Key Point 시계열 데이터 예측은 금융·에너지·수요 예측 등 산업 전반에 필수인데, 이 모델이 기존 벤치마크를 크게 앞지르고 오픈소스로 공개되면서 실무 적용 경로가 열렸다.
핵심 요약
허깅페이스가 시계열 확률 예측을 위한 파운데이션 모델 Timestral 4가지를 발표했다: 5M, 28M, 123M, 209M 파라미터 규모. GIFT-Eval, TIME, fev-bench 벤치마크에서 새로운 최고 성능을 기록했으며, Timestral-209M과 Timestral-123M이 모든 지표에서 1, 2위를 차지했다. Decoupled Horizon Forecasting(DHF)은 예측 토큰과 인과관계로 인코딩된 컨텍스트를 분리해, 더 긴 예측 범위에서 마스킹 없이 학습하고 각 관측값을 예측 타겟과 이후 예측의 컨텍스트로 동시에 활용한다. 전체 요약 6문장 읽기 → 003 03:11 새 버전 Angular v22.2.4 패치 릴리스 Angular 22.2.4가 릴리스되었다. 컴파일러에서 객체 프로토타입 이름의 속성이 번역되는 것으로 잘못 처리되는 문제를 해결하고, JIT 모드에서 v22 이전 라이브러리를 위해 즉시 변경 감지(Eager change detection)로 기본 설정하며, 잘못된 템플릿 리터럴 보간에 대한 에러를 보고한다. 웹 · 프론트엔드 · angular/angular@v22.2.4
Key Point Angular 22.2.4는 컴파일러, 폼 처리, i18n, 라우팅 등 핵심 부분의 안정성과 성능을 개선하는 여러 버그 수정을 포함하고 있어, 기존 애플리케이션의 신뢰성을 높일 필요가 있다.
핵심 요약
Angular 22.2.4가 릴리스되었다. 컴파일러에서 객체 프로토타입 이름의 속성이 번역되는 것으로 잘못 처리되는 문제를 해결하고, JIT 모드에서 v22 이전 라이브러리를 위해 즉시 변경 감지(Eager change detection)로 기본 설정하며, 잘못된 템플릿 리터럴 보간에 대한 에러를 보고한다. 컴파일러-CLI는 @jridgewell/sourcemap-codec 1.6.0 이상을 요구하도록 업데이트되었다. 코어에서는 i18n 수화 중 공유 ICU 케이스 큐를 변경하는 문제를 방지하고, 파라미터 미변경 시 리소스 재로드를 피하며, 타겟팅 변경 감지 모드에서 뷰 이펙트 에러를 포착한다. 전체 요약 11문장 읽기 → 004 03:11 ▲ 10 · 댓글 3 로봇이 장애물 인식은 하는데 안전하게 움직이지 못한다 가정용 로봇이 안전하게 이동하려면 장애물 종류와 거리에 따라 속도와 안전 간격을 조절해야 하는데 기존 평가 방법은 이를 검증하지 않는다. AI · 머신러닝 · Benchmarking Obstacle-Conditioned Safety in Household Robot Navigation
Key Point 가정용 로봇이 위험도를 정확히 판단해도 실제 움직임에 반영하지 못하는 문제가 있으며, 이를 측정하는 벤치마크와 지표의 부재가 큰 한계로 지목되었다.
핵심 요약
가정용 로봇이 안전하게 이동하려면 장애물 종류와 거리에 따라 속도와 안전 간격을 조절해야 하는데 기존 평가 방법은 이를 검증하지 않는다. 연구팀은 같은 장면에 장애물 종류만 다르게 배치한 벤치마크 'OSMA-Bench'와 로봇의 움직임이 장애물 위험도에 맞게 조정되는지 측정하는 'SSI(Semantic Sensitivity Index)' 지표를 제안했다. VLM(시각 언어 모델) 기반 및 VLA(시각 언어 행동) 정책을 평가한 결과 명시적인 안전 지시가 있어도 둘 다 장애물 종류에 따라 움직임을 일관되게 조정하지 못했다. 전체 요약 6문장 읽기 → 005 00:11 새 버전 허깅페이스 Transformers v5.22.0, 미스트랄 라지 4 모델 지원 미스트랄이 공개한 라지 4(르 숑크)는 1조 파라미터 규모의 네이티브 멀티모달 혼합 전문가 모델로, 토큰당 49억 개의 활성 파라미터(임베딩과 출력층 포함 52억 개)를 가지고 있다. AI · 머신러닝 · huggingface/transformers@v5.22.0
Key Point 1조 파라미터 오픈 가중치 멀티모달 모델의 등장으로 로컬 추론과 파인튜닝이 가능해지며, 기존 폐쇄형 모델과 경쟁 가능한 성능(사이버보안·금융·법률·시각적 근거 찾기)을 제시한다.
핵심 요약
미스트랄이 공개한 라지 4(르 숑크)는 1조 파라미터 규모의 네이티브 멀티모달 혼합 전문가 모델로, 토큰당 49억 개의 활성 파라미터(임베딩과 출력층 포함 52억 개)를 가지고 있다. 유럽 미스트랄 데이터센터의 3800개 엔비디아 그레이스 블랙웰 GPU로 처음부터 학습했으며, 명령어 따르기·추론·코딩·에이전트 작업을 단일 가중치로 통합한다. 160개 이상의 언어에 네이티브로 유창하며, EU 공식 언어 전체를 지원한다. 전체 요약 10문장 읽기 → 006 00:11 ▲ 128 · 댓글 33 형제 프린터, 텔넷으로 디버그 접근 발견 형제(Brother) MFC-L8900CDW 프린터의 펌웨어를 다운로드해 분석한 결과, T-Kernel이라는 TRON 계열 실시간 운영체제를 사용하고 있음을 확인했다. 하드웨어 · 시스템 · Getting debug access on a Brother printer over Telnet
Key Point 형제 프린터의 디버그 콘솔이 텔넷으로 간단하게 접근 가능하다는 것은 단순한 설정 명령어만으로 시스템의 깊숙한 부분에 접근할 수 있다는 뜻이므로, 프린터 보안과 개인정보 보호를 우려하는 사용자와 기업이 알아야 할 사항이다.
핵심 요약
형제(Brother) MFC-L8900CDW 프린터의 펌웨어를 다운로드해 분석한 결과, T-Kernel이라는 TRON 계열 실시간 운영체제를 사용하고 있음을 확인했다. 펌웨어는 32비트 ARM 소프트웨어로 작성되었으며, 데이터라이트 Reliance Nitro 3.0.6 파일시스템, FlashFX Tera 3.1 플래시 관리, Lua 5.2.3 스크립팅, OpenSSL, libpng 등을 포함하고 있다. 프린터는 800MHz 메인 프로세서, 133MHz 서브프로세서, 512MB 메모리를 탑재하고 있으며, 커널과 압축된 애플리케이션 코드, 웹/UI 자산이 별도 섹션으로 구성되어 있다. 전체 요약 8문장 읽기 → 007 00:11 ▲ 260 · 댓글 61 미스트랄, 1조 파라미터 대형 모델 가중치 공개 미스트랄이 1조 파라미터 멀티모달 모델 '르 총크(Le Chonk)'의 가중치를 공개했으며, 3주간의 강화학습으로 코딩과 사이버보안 성능을 크게 향상시켰다. AI · 머신러닝 · Mistral Large 4 (Le Chonk) is now Open Weight
Key Point 오픈가중치 대형 언어 모델의 최강자로 자리잡아 개발사들의 모델 선택지가 크게 늘어날 뿐 아니라, 주권 AI 전략을 추진하는 유럽 기관들과 규제가 엄격한 금융·방위 부문에서 실질적인 대안을 제공하기 시작했다.
핵심 요약
미스트랄이 1조 파라미터 멀티모달 모델 '르 총크(Le Chonk)'의 가중치를 공개했으며, 3주간의 강화학습으로 코딩과 사이버보안 성능을 크게 향상시켰다. FrontierCode 2.0 벤치마크에서 19.7%, Terminal-Bench 4.0에서 41%의 성능을 달성하며 오픈가중치 코딩 모델 중 최고 수준을 기록했다. Artificial Analysis 코딩 에이전트 인덱스에서 48%를 달성하며 GLM-5.3과 동등하지만 평균 47% 적은 토큰을 사용해 효율성이 우수하다. 전체 요약 13문장 읽기 → 008 12:11 ▲ 11 · 댓글 2 픽셀 공간 확산 모델 학습 가속화하는 통계 기법 픽셀 공간에서 속도장(velocity field)을 직접 학습하는 것은 어렵고 느린데, 고정된 Wiener 추정값이 속도 학습을 개선하고 선형 예측 범위를 넘어 이득을 제공한다. AI · 머신러닝 · Beyond the Estimate: Wiener-Informed Decoding for Easier Training of Pixel-Space Flow Models
Key Point 픽셀 공간 생성 모델의 훈련 효율을 37.5% 단축할 수 있는 방법이 제시되어, 대규모 이미지 생성 모델 개발의 실질적 비용 절감에 직결된다.
핵심 요약
픽셀 공간에서 속도장(velocity field)을 직접 학습하는 것은 어렵고 느린데, 고정된 Wiener 추정값이 속도 학습을 개선하고 선형 예측 범위를 넘어 이득을 제공한다. 고정된 기저(basis)와 픽셀 디코딩도 이와 유사하면서 상호보완적인 성능 향상을 보인다. Wiener-informed Decoding(WiD)은 통계적 지식으로 직접 예측과 디코더 계산을 조직화하며, 훈련가능한 Wiener 예측 경로와 기본 디코더 블록에 특징을 주입하고 계수 보정을 반환하는 계수 인터페이스를 조합한다. 전체 요약 8문장 읽기 → 009 03:11 ▲ 12 · 댓글 2 폐쇄형 선택지 판정용 소형 언어 인코더 설계 방식 비교 도구 선택 같은 폐쇄형 결정 작업을 위해 얼마나 작은 인코더를 쓸 수 있는지, 그리고 선택지를 함께 읽을지 개별로 읽을지를 비교하는 연구다. AI · 머신러닝 · Joint or Per-Option? Compact Encoders for Closed-Set Decisions from 17 Million to 1 Billion Parameters
Key Point 소형 언어 모델로 도구 선택·카테고리 분류 같은 의사결정을 더 빠르고 안정적으로 처리할 수 있는 설계 방식이 검증되어, 프로덕션 LLM 파이프라인 최적화에 직접 영향을 미친다.
핵심 요약
도구 선택 같은 폐쇄형 결정 작업을 위해 얼마나 작은 인코더를 쓸 수 있는지, 그리고 선택지를 함께 읽을지 개별로 읽을지를 비교하는 연구다. 3개 시드로 3천2백만 파라미터에서 실험한 결과 선택지별 채점(per-option scoring) 방식이 37개 벤치마크 병합 테스트에서 공동 채점(joint scoring) 방식을 보정 후 5.8점 능력 차이로 이기고, 유사한 훈련량 조건에서는 2.8점 앞선다. 외부 벤치마크 2개도 이 경향을 보였으나 미학습 작업에서는 통계적 유의성이 없다. 전체 요약 8문장 읽기 → 010 15:11 ▲ 102 · 댓글 59 4개월간의 Zig 경험, 무엇이 좋고 무엇이 부족한가 저자는 4개월 만에 Zig로 돌아와 snurl(작은 네트워크 프로토콜용 라이브러리), TUI 타이퍼 레이서, n-body 시뮬레이터 등 여러 프로젝트를 진행했다. 오픈소스 · 도구 · Four Months of Zig
Key Point Zig가 점점 성숙해지면서 실제 프로덕션 프로젝트에서 사용 가능해지는 시점, 안정화 전 남은 과제들이 무엇인지 개발자 관점에서 명확히 정리된 평가이다.
핵심 요약
저자는 4개월 만에 Zig로 돌아와 snurl(작은 네트워크 프로토콜용 라이브러리), TUI 타이퍼 레이서, n-body 시뮬레이터 등 여러 프로젝트를 진행했다. Zig Day Seattle에서 Zig의 창시자 Andrew Kelley를 만나고 다른 개발자들과 협업하면서 커뮤니티의 가치를 느꼈다. anyzig 도구로 여러 Zig 버전을 쉽게 관리할 수 있으며, 명시적 IO와 allocator 파라미터 설계가 메모리 관리를 명확하게 한다고 평가했다. 전체 요약 13문장 읽기 → 011 12:11 ▲ 15 · 댓글 2 특허 심사 자동화하는 AI 에이전트 벤치마크 공개 특허 심사는 선행기술 발굴, 질의 개선, 증거 검토, 심사의견서 작성을 반복하는 복잡한 과제인데 기존 벤치마크는 정적이고 제한된 후보군만 다뤘다. AI · 머신러닝 · Novel or Not? PatEx-Gym: Agentic Prior-Art Search for Novelty Assessment in Patent Examination
Key Point 특허 심사 자동화는 방대한 기술 문헌 검색과 복합적 추론이 필요한 영역으로, 이 벤치마크는 에이전트 기술의 실제 활용 가능성을 보여주는 현실적 테스트 사례가 된다.
핵심 요약
특허 심사는 선행기술 발굴, 질의 개선, 증거 검토, 심사의견서 작성을 반복하는 복잡한 과제인데 기존 벤치마크는 정적이고 제한된 후보군만 다뤘다. 연구진이 특허 심사 에이전트 개발·평가를 위한 첫 번째 프레임워크 PatEx-Gym을 발표했다. PatEx-Bench는 1000개의 실제 심사 과제, 100만 개 이상의 특허와 5만2000개 과학 논문 데이터베이스, 반복 검색과 문서 방문·추론·심사의견서 생성을 지원하는 런타임을 제공한다. 전체 요약 7문장 읽기 → 012 12:11 ▲ 46 · 댓글 2 확산 언어 모델의 추측 디코딩 가속화 기법 SPOT 제안 확산 언어 모델(DLM)은 병렬 텍스트 생성이 가능하지만 속도-품질 트레이드오프를 겪고 있다. AI · 머신러닝 · On the SPOT: Enhancing Speculative Decoding for Diffusion Language Models via Commit-Order Prediction
Key Point 확산 언어 모델의 속도 문제를 해결하는 새로운 추측 디코딩 기법으로, 토큰 위치 순서 예측이라는 핵심 인사이트를 통해 정확성을 유지하면서 6배 이상의 가속화를 달성했으며, 학습된 드래프터가 여러 모델에 전이 가능해 실용성이 높다.
핵심 요약
확산 언어 모델(DLM)은 병렬 텍스트 생성이 가능하지만 속도-품질 트레이드오프를 겪고 있다. 정확한 디코딩은 모델 패스당 하나의 마스킹된 위치만 채우고, 빠른 멀티토큰 디코딩은 품질 손실이 발생한다. 추측 디코딩은 자동회귀 모델의 표준 가속 기법이지만 DLM에 직접 적용되지 않는데, DLM은 무엇을 생성할지뿐 아니라 어디에 생성할지를 선택해야 하기 때문이다. 전체 요약 11문장 읽기 → 013 12:11 ▲ 30 · 댓글 3 로봇 조작 모델을 키우다, 영상에서 추출한 3D 행동으로 로봇 비전-언어-행동(VLA) 모델을 확장하려면 행동 레이블이 붙은 학습 데이터가 부족하고, 로봇마다 제어 방식이 다르다는 제약이 있다. AI · 머신러닝 · RynnVLA-Latent: Scaling Robotic Manipulation Foundation Models with 3D-Grounded Latent Actions
Key Point 로봇 학습 데이터의 부족 문제를 해결하는 새로운 방법론으로, 일반 영상에서 로봇이 학습할 수 있는 신호를 뽑아낼 수 있음을 시사한다.
핵심 요약
로봇 비전-언어-행동(VLA) 모델을 확장하려면 행동 레이블이 붙은 학습 데이터가 부족하고, 로봇마다 제어 방식이 다르다는 제약이 있다. RynnVLA-Latent는 이를 해결하기 위해 사람, 로봇, 시뮬레이션 영상을 로봇 정책 사전학습용 감독 신호로 바꾼다. 핵심은 RynnLAM으로, 시각 전환(visual transition)에서 실제 로봇 제어 없이 3D 기반 잠재 행동을 학습한다. 전체 요약 10문장 읽기 → 014 12:11 ▲ 19 · 댓글 3 로봇이 실험하며 배우는 벤치마크 EmbodiedLab 공개 로봇 에이전트가 물리 법칙 발견이나 목표 달성을 위해 직접 행동하면서 배우는 '행동을 통한 지식습득(act to know)' 문제를 다루는 벤치마크 EmbodiedLab을 개발했다. AI · 머신러닝 · EmbodiedLab: Benchmarking Embodied Agents That Act to Know
Key Point 로봇의 지식습득 과정 자체를 체계적으로 평가하는 첫 벤치마크로서, 조작 능력과 인지 능력의 어느 것이 현실 목표 달성에 더 핵심인지를 드러낸다.
핵심 요약
로봇 에이전트가 물리 법칙 발견이나 목표 달성을 위해 직접 행동하면서 배우는 '행동을 통한 지식습득(act to know)' 문제를 다루는 벤치마크 EmbodiedLab을 개발했다. 기존 조작 벤치마크는 목표 상태가 주어졌을 때만 평가하고, 과학 발견 벤치마크는 기호적 행동이나 수치 계산으로만 평가했다면, EmbodiedLab은 로봇이 정량적 과학 실험을 통해 스스로 절차를 선택하고 물리 기반 시뮬레이션 실험실을 조작하는 시나리오다. 14개 장비 플랫폼에 걸쳐 5개 학문 분야의 30개 실험으로 구성되어 있으며, 매번 시스템 파라미터를 새로 샘플링하기 때문에 결과를 미리 알 수 없지만 정확히 채점할 수 있다. 전체 요약 8문장 읽기 → 015 12:11 ▲ 126 · 댓글 2 사용자 명령을 따르는 자유형 비디오 세계 모델 'Hy-Nomas' 공개 Hy-Nomas는 연속적인 사용자 명령을 따르면서 이전 상호작용 기록과 결과를 유지하는 대화형 세계 생성 모델이다. AI · 머신러닝 · Hy-Nomas: Towards Free-form Interactive World Generation
Key Point 대화형 AI 환경에서 사용자 명령을 정확히 따르면서도 과거 맥락을 유지하는 능력은 게임, 시뮬레이션, 메타버스 등 차세대 인터랙티브 콘텐츠 개발의 핵심 과제이며, 이 논문의 기술적 접근이 실제 적용에 어떻게 영향을 미칠지 주목할 필요가 있다.
핵심 요약
Hy-Nomas는 연속적인 사용자 명령을 따르면서 이전 상호작용 기록과 결과를 유지하는 대화형 세계 생성 모델이다. 80억 파라미터 규모의 확산 모델을 기반으로 자유형 텍스트 지시와 멀티턴 카메라 제어를 지원한다. 구조화된 비디오 자막과 행동 인식 인과 주의 메커니즘을 결합해 설명 맥락은 여러 세그먼트에서 접근 가능하면서 행동 명령은 해당 시간 윈도우로만 제한된다. 전체 요약 6문장 읽기 → 016 09:11 ▲ 110 · 댓글 40 리퀴드 AI, 멀티모달 소형 모델 LFM3 공개 리퀴드 AI가 2B 파라미터 규모의 멀티모달 파운데이션 모델 LFM3를 출시했다. 텍스트, 비전, 오디오, 옴니(멀티모달), 의사결정 모델을 하나의 백본에서 제공한다. AI · 머신러닝 · Introducing LFM3: Every Modality for Specialized Intelligence
Key Point 클라우드 없이 로컬 기기에서 텍스트·비전·오디오를 모두 처리할 수 있는 2B급 모델이 나왔으며, 에이전트 작업에서 훨씬 큰 모델들과 경쟁한다는 점이 온디바이스 AI 실용화의 진전을 의미한다.
핵심 요약
리퀴드 AI가 2B 파라미터 규모의 멀티모달 파운데이션 모델 LFM3를 출시했다. 텍스트, 비전, 오디오, 옴니(멀티모달), 의사결정 모델을 하나의 백본에서 제공한다. LFM3는 새로운 하이브리드 아키텍처와 22T 토큰 사전학습으로 LFM2보다 표현력이 뛰어나면서도 효율성을 유지한다. 로컬 파인튜닝, 모든 기기에서 실행, 전문 작업 최적화가 가능하다. 아키텍처는 13개 계층의 게이트 단락 컨볼루션, 5개 계층의 슬라이딩-윈도우 어텐션(256 토큰 윈도우), 6개 계층의 글로벌 어텐션을 조합한다. 커널 크기를 3에서 7로 확대했다. 전체 요약 10문장 읽기 → 017 00:11 ▲ 31 · 댓글 2 LLM 에이전트 자체 학습 능력 강화법 제시 LLM 에이전트가 모델 파라미터를 업데이트하지 않고 실행 경험에서 학습하는 harness self-evolution에서, 같은 스킬이 강한 모델과 약한 모델에 미치는 영향이 크게 다르다는 문제를 발견했다. AI · 머신러닝 · Evolving to Match Capabilities: Improving Harness Self-Evolution via Skill Adaptation
Key Point 약한 LLM 모델의 성능 저하 문제를 스킬 적응으로 해결하는 구체적인 방법론이 제시되어, 실무에서 다양한 규모의 언어 모델을 배포하는 개발자들이 자체 학습 효율을 크게 높일 수 있다.
핵심 요약
LLM 에이전트가 모델 파라미터를 업데이트하지 않고 실행 경험에서 학습하는 harness self-evolution에서, 같은 스킬이 강한 모델과 약한 모델에 미치는 영향이 크게 다르다는 문제를 발견했다. 7개 모델과 3개 벤치마크에서 103개의 작업-스킬 조합을 분석한 결과, 어떤 스킬은 GPT-5.6-luna의 성능을 31.1점 높였지만 Gemma-4-E4B의 성능을 8.8점 낮췄다. 약한 모델의 실패 사례 86%에서 스킬 자체에 이미 명시된 요구사항을 위반했으므로, 실행자의 능력에 맞게 스킬을 재작성하는 skill adaptation을 제안했다. 전체 요약 7문장 읽기 → 018 00:11 ▲ 21 · 댓글 2 추측 샘플링과 확산 모델의 속도-품질 트레이드오프 분석 추측 디코딩(Speculative Decoding)은 빠르지만 품질이 낮은 초안 모델에서 샘플링해 LLM 추론 속도를 높이는 기법으로, 전통적으로는 검증자 분포 대비 손실 없이 속도 향상을 보장한다. AI · 머신러닝 · Speculative Diffusion is a Tale of Two Tradeoffs
Key Point LLM 추론 성능을 높이는 두 가지 기술(추측 디코딩과 확산 모델)의 트레이드오프를 체계적으로 분석함으로써 최적 조합 방식을 제시한다.
핵심 요약
추측 디코딩(Speculative Decoding)은 빠르지만 품질이 낮은 초안 모델에서 샘플링해 LLM 추론 속도를 높이는 기법으로, 전통적으로는 검증자 분포 대비 손실 없이 속도 향상을 보장한다. 최근 개발된 확산 LLM(dLLM)은 더 적은 확산 스텝으로 출력 품질을 떨어뜨려도 대폭의 속도 향상을 달성할 수 있다는 점에서 다르다. 확산 모델은 토큰을 병렬로 생성하기 때문에 자회귀 모델보다 빠르게 샘플링할 수 있어, 추측 디코딩의 초안 모델로 유망하다. 전체 요약 6문장 읽기 → 019 18:11 ▲ 33 · 댓글 2 LLM 추론 강화에 새로운 액터-크리틱 알고리즘 S3AC 제시 롱 체인-오브-소트(CoT) 추론을 위한 강화학습에서 크리틱(가치함수)을 효과적으로 훈련하는 방법이 부재한 문제를 해결한 논문이다. AI · 머신러닝 · S3AC: Stabilized, Selective, and Scalable Actor-Critic for LLM Reasoning
Key Point 대규모 언어 모델의 추론 능력을 효율적으로 향상시키려는 개발자와 연구자에게 확장 가능한 크리틱 훈련 방식을 제시하며, 특히 단일 롤아웃으로 안정적 훈련을 지속하는 기술적 진전이 실무 적용 비용 절감으로 직결된다.
핵심 요약
롱 체인-오브-소트(CoT) 추론을 위한 강화학습에서 크리틱(가치함수)을 효과적으로 훈련하는 방법이 부재한 문제를 해결한 논문이다. 기존 크리틱 없는 방법들은 토큰 수준의 신용 할당이 어렵고 그룹 롤아웃으로 기준선을 추정해야 했다. S3AC는 훈련된 크리틱으로 토큰별 이득과 프롬프트별 기준선을 제공하며, 길이가 다른 궤적의 불충분한 커버리지와 초기 기울기 문제를 해결하는 실용적인 훈련 레시피를 제시한다. 전체 요약 7문장 읽기 → 020 06:11 새 버전 Hugging Face Transformers v5.21 릴리스, 5개 신규 모델 추가 Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. AI · 머신러닝 · huggingface/transformers@v5.21
Key Point 문서 이해, 음성 합성 등 신규 모델 5개가 추가되고 병렬 처리·양자화·캐시 처리가 크게 개선되어 LLM과 멀티모달 모델 개발자들에게 직접적인 영향이 있다.
핵심 요약
Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. MiniCPM-OCR은 OpenBMB의 모델로 SigLIP 비전 인코더와 Qwen3.5 언어 모델을 결합해 스캔 페이지, 스크린샷, 영수증 등 텍스트 밀집 이미지를 읽는다. Flint는 Recursive의 혼합 전문가 모델로 슬라이딩 윈도우 주의(512개 토큰 범위)와 완전 주의를 결합하며, 각 희소 계층이 256개 전문가 중 6개를 라우팅한다. 전체 요약 12문장 읽기 → 021 21:12 ▲ 103 · 댓글 13 나뭇가지 경쟁으로 자연스러운 나무 구조를 만든다 SIGGRAPH 2009 논문을 바탕으로 절차적 나무 성장 알고리즘을 구현했다. 기타 · Growing Trees
Key Point 게임·그래픽스 개발자들이 자연스럽고 다양한 나무를 대량으로 만들어야 할 때 필요한 실제 구현 방법을 배울 수 있다.
핵심 요약
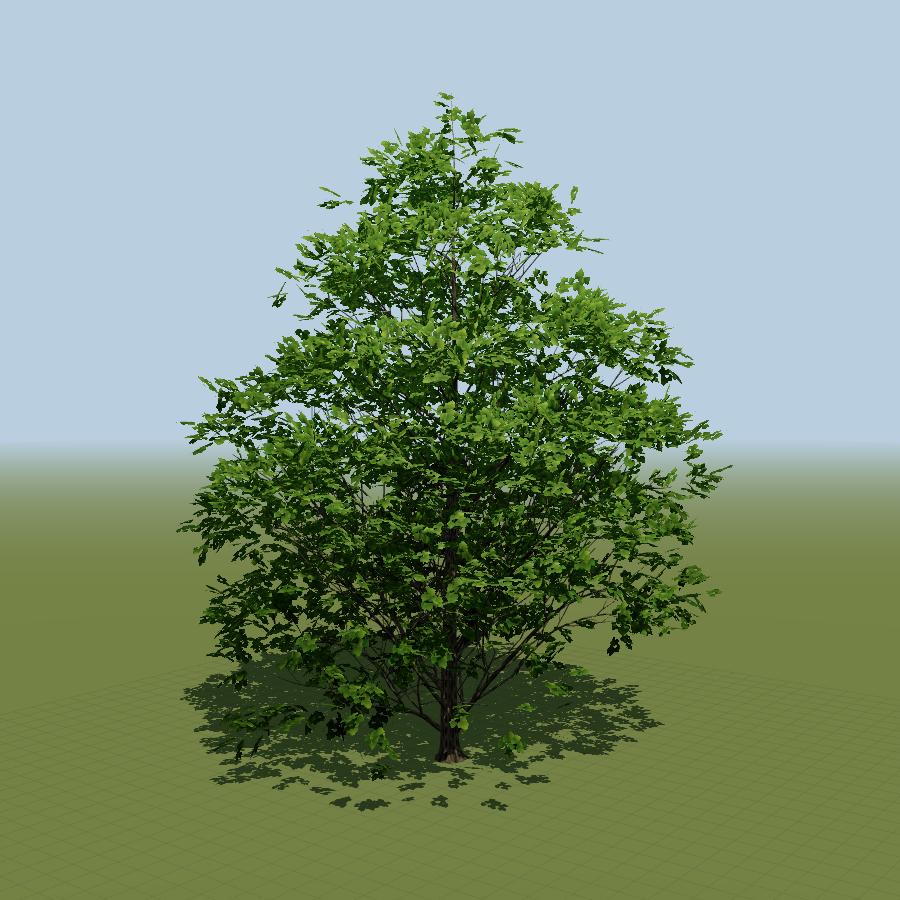
SIGGRAPH 2009 논문을 바탕으로 절차적 나무 성장 알고리즘을 구현했다. 기본 단위인 메타머(절간, 잎, 눈)는 매 시즌마다 빛 자원을 놓고 경쟁하며, 경쟁에서 이기는 눈만 새 줄기를 만든다. 복셀 그리드를 이용해 각 눈이 받는 빛을 계산하고, 적분-분배 메커니즘으로 나무 밑에서 위로 성장 자원을 배분한다. 전체 요약 8문장 읽기 → 022 18:11 ▲ 102 · 댓글 37 셀프-어텐션 없이 언어모델 성능 낼 수 있을까 논문은 시퀀스 모델링에서 셀프-어텐션이 반드시 필요한지 근본적으로 재검토한다. AI · 머신러닝 · Attention Is Not What You Need (2025)
Key Point 트랜스포머 아키텍처의 핵심인 어텐션 메커니즘 자체를 대체하는 기하학적 모델을 제시하며, 같은 성능을 유지하면서 더 해석 가능한 설계가 가능함을 시사한다.
핵심 요약
논문은 시퀀스 모델링에서 셀프-어텐션이 반드시 필요한지 근본적으로 재검토한다. 기존 멀티헤드 어텐션을 숨은 벡터들을 고차원 공간으로 끌어올리는 텐서 lifting 메커니즘으로 해석하되, 이는 수학적으로 불명확하고 여러 층을 거치면서 명시적 불변량으로 기술하기 어렵다고 주장한다. 대안으로 그래스만 다양체 기반 구조를 제안하며, 인과 그래스만 층은 토큰 상태를 선형 축약한 뒤 플뤼커 좌표로 인코딩된 저차수 부분공간의 제어된 변형을 통해 정보를 전파한다. 전체 요약 6문장 읽기 → 023 15:11 ▲ 54 · 댓글 2 RynnUnify: 로봇 제어까지 아우르는 통합 embodied AI 모델 RynnUnify는 영상-언어 추론을 통해 embodied 이해와 장기 시각 계획을 결합한 160억 파라미터 통합 모델이다. AI · 머신러닝 · RynnUnify: Towards Unified Embodied Brain
Key Point 물리 세계 이해부터 실제 로봇 제어까지 하나의 모델으로 통합하려는 시도로, embodied AI 연구의 새로운 기준을 제시한다.
핵심 요약
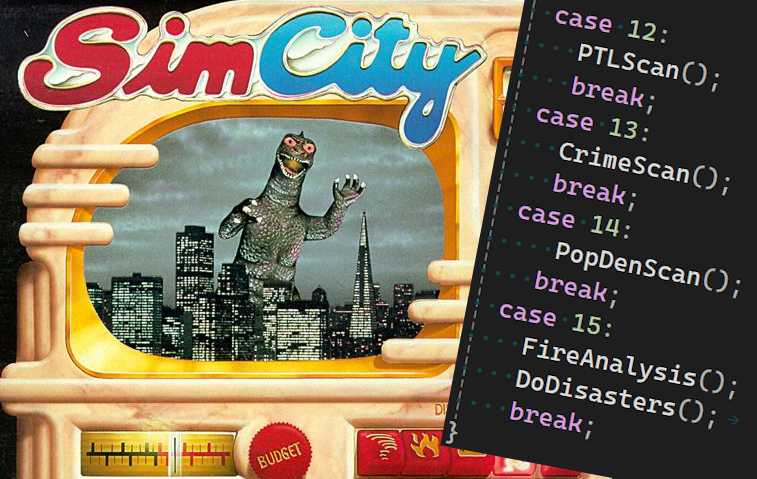
RynnUnify는 영상-언어 추론을 통해 embodied 이해와 장기 시각 계획을 결합한 160억 파라미터 통합 모델이다. 공간 추론, 물리 예측, 그라운딩 능력으로 물리 세계에 대한 이해와 변화 예측을 연결한다. 강화학습으로 에이전트 확장 버전을 개발했으며, 관찰되지 않은 상태와 상호작용 결과 추론을 위해 영상 예측을 선택적으로 활용한다. 전체 요약 8문장 읽기 → 024 03:11 ▲ 100 · 댓글 29 16MHz 386SX CPU에서 돌린 초대 심시티의 최적화 비법 1989년 초대 심시티는 16MHz로 작동하는 인텔 386SX 프로세서에서 풀 기능의 도시 시뮬레이션을 구현했으며, 2008년 GPL 라이선스로 공개된 마이크로폴리스 소스코드를 통해 그 최적화 기법을 분석할 수 있다. 하드웨어 · 시스템 · How to run a city builder on 16 MHz
Key Point 초고성능 현대 하드웨어에서도 시뮬레이션 게임이 버거워하는 반면, 30년 전 16MHz CPU에서 풀 기능 도시 시뮬레이션을 돌렸던 기법이 오늘날 최신 게임 엔진에서도 여전히 핵심 최적화 원리로 쓰이고 있다.
핵심 요약
1989년 초대 심시티는 16MHz로 작동하는 인텔 386SX 프로세서에서 풀 기능의 도시 시뮬레이션을 구현했으며, 2008년 GPL 라이선스로 공개된 마이크로폴리스 소스코드를 통해 그 최적화 기법을 분석할 수 있다. 시뮬레이션의 핵심은 Simulate() 함수로, 교통, 화재, 전력, 범죄 등 각 시스템을 업데이트하는데 매 프레임마다 모든 함수를 호출하면 CPU가 감당할 수 없다. 해결책은 mod16 파라미터를 사용해 0~15 사이를 순환하며 각 프레임마다 특정 시뮬레이션 부분만 실행하는 것으로, 전체 시뮬레이션이 완성되려면 평균 8프레임, 최악의 경우 15프레임이 필요하다. 전체 요약 7문장 읽기 → 025 18:11 ▲ 149 · 댓글 53 세레브라스, 3조개 파라미터 모델을 59개 웨이퍼에 분산 배포 세레브라스 WSE-3T 웨이퍼 하나는 44GB의 온칩 메모리를 가지지만, 조 단위 모델의 가중치는 테라바이트 규모여서 여러 웨이퍼에 분산 배포해야 한다. 인프라 · 데브옵스 · Cerebras Deploys Trillion-Parameter AI Models
Key Point 대규모 언어모델 추론 인프라의 실제 배포 방식을 보여주는 기술 사례로, GPU가 아닌 웨이퍼 기반 칩에서 조 단위 모델을 어떻게 효율적으로 운영하는지 알 수 있다.
핵심 요약
세레브라스 WSE-3T 웨이퍼 하나는 44GB의 온칩 메모리를 가지지만, 조 단위 모델의 가중치는 테라바이트 규모여서 여러 웨이퍼에 분산 배포해야 한다. 3조 파라미터 규모의 공개 모델 키미 K3를 예시로, 4비트 양자화 기준 각 레이어는 약 16GB가 필요하다. 키미 K3의 경우 69개 선형 주의 레이어(각 웨이퍼당 2개씩 배치 가능)와 24개 밀집 레이어(각 웨이퍼당 1개씩, 나머지는 KV 캐시용)로 총 59개 웨이퍼가 필요하다. 전체 요약 8문장 읽기 → 026 12:11 ▲ 11 · 댓글 3 확산 모델의 토큰 선택 정책, 숨은 상태와 신뢰도로 최적화 마스크된 확산 언어 모델은 토큰을 병렬로 생성하는데, 어느 예측을 확정할지 정하는 언마스킹 정책에 따라 속도-정확도 균형이 달라진다. AI · 머신러닝 · What Makes a Good Unmasking Policy? A Controlled Study of Learned Unmasking in Diffusion Language Models
Key Point 마스크 확산 모델의 속도 최적화는 LLM 추론 효율성 개선의 핵심 과제인데, 이 논문이 정책 설계의 구체적인 선택지(교사 신호, 입력 특성, 정책 크기)를 실험으로 검증하고 실용적인 기준(10% NFE 감소)을 제시한다.
핵심 요약
마스크된 확산 언어 모델은 토큰을 병렬로 생성하는데, 어느 예측을 확정할지 정하는 언마스킹 정책에 따라 속도-정확도 균형이 달라진다. 연구진은 감독 학습 정책을 디코딩 절차의 증류로 보고, 교사 모델이 어떤 예측을 확정 가능하다고 표시하는지, 정책이 어느 상태에서 이를 모방하는지, 정책이 무엇을 관찰하는지, 함수 평가 횟수(NFE) 감소분이 정책 오버헤드를 상쇄하려면 얼마인지를 독립적으로 분석했다. 최종 출력과 일치하는 예측을 확정 가능으로 표시하는 것은 NFE가 낮을 때 지나치게 허용적이며, 숨은 상태는 단독으로는 약하지만 신뢰도로 보완할 수 있다는 것을 발견했다. 전체 요약 6문장 읽기 → 027 09:11 ▲ 192 · 댓글 145 메모리 안전성과 성능을 모두 잡은 구스 언어 공개 Goose는 힙 할당자, 가비지 컬렉터, 라이프타임 애너테이션이 없는 메모리 안전 시스템 언어로, C와 Rust 문법을 따릅니다. 오픈소스 · 도구 · The Goose Programming Language
Key Point 힙 할당·가비지 컬렉션·라이프타임 문법을 모두 제거하면서도 안전성을 보장해 C++과 Rust보다 빠르고 메모리 효율적인 새로운 시스템 언어 설계가 실제로 동작하는 방식을 보여줍니다.
핵심 요약
Goose는 힙 할당자, 가비지 컬렉터, 라이프타임 애너테이션이 없는 메모리 안전 시스템 언어로, C와 Rust 문법을 따릅니다. 벤치마크 16개 기준 구스는 일반적인 C++보다 3.3배, 손으로 최적화한 C++보다 1.16배, 안전한 Rust보다 1.12배 빠르면서 메모리는 1.9배, 1.3배, 1.2배 적게 씁니다. 컴파일러가 정적으로 할당하는 데이터 스택 위에 모든 동적 값이 인라인으로 살며, 스코프 끝에서 한 번의 저장 명령으로 메모리가 해제됩니다. 전체 요약 12문장 읽기 → 028 09:11 새 버전 Anthropic Python SDK v2.3.0 출시, 엔터프라이즈 기능 추가 Claude 엔터프라이즈 조직을 위한 새로운 Claude Tag 엔드포인트가 추가되었습니다. AI · 머신러닝 · anthropics/anthropic-sdk-python@v2.3.0
Key Point 엔터프라이즈 조직의 Claude Tag 관리 기능이 추가되고 API 호출 방식이 정리되어, Python SDK를 사용하는 개발자와 기업 사용자가 업데이트해야 합니다.
핵심 요약
Claude 엔터프라이즈 조직을 위한 새로운 Claude Tag 엔드포인트가 추가되었습니다. Google Cloud 사용자 프로필 요청이 조직 엔드포인트로 전송되도록 수정되었습니다. 클라이언트가 엔드포인트 경로에 하드코딩된 쿼리 파라미터를 전송하지 않도록 개선되었습니다. 전체 요약 7문장 읽기 → 029 06:11 새 버전 FastAPI 0.162.0 불린 폼 필드 처리 방식 변경 FastAPI 0.162.0에서 omitted된 bool과 bool | None 폼 필드가 더 이상 False로 자동 추론되지 않으며, 선언된 기본값을 사용하거나 누락 필드 오류를 발생시킨다. 웹 · 프론트엔드 · fastapi/fastapi@0.162.0
Key Point FastAPI의 불린 폼 필드 처리가 Pydantic 표준에 맞춰 변경되면서, 기존에 omitted 불린을 False로 자동 처리하던 코드가 동작을 멈출 수 있으므로 업그레이드 전 영향 범위를 파악해야 한다.
핵심 요약
FastAPI 0.162.0에서 omitted된 bool과 bool | None 폼 필드가 더 이상 False로 자동 추론되지 않으며, 선언된 기본값을 사용하거나 누락 필드 오류를 발생시킨다. 이 변경은 개별 폼 파라미터, 폼 모델, 폼 모델의 union을 포함한 모든 boolean 필드에 적용된다. omitted된 boolean 모델 필드는 model_dump(exclude_unset=True)에서 제외되며, 기본값이 union 선택 시 제출된 필드로 계산되지 않는다. 전체 요약 5문장 읽기 → 030 03:11 ▲ 19 · 댓글 2 AI 게임을 고급 그래픽으로 변환하는 AnyGameRenderer 공개 AI 코딩 에이전트가 몇 분 안에 만든 게임은 회색 블록아웃과 단순한 형상 같은 저품질 비주얼로 나타난다. AI · 머신러닝 · AnyGameRenderer: Entity-Consistent Generative Rendering Across Games and an Entity-Level Benchmark
Key Point AI가 생성한 프로토타입 게임의 비주얼 품질을 대규모 비디오 생성 모델로 자동 개선할 수 있게 되었으며, 엔티티 위치와 타이밍을 정확하게 보존하는 기술적 진전을 보여준다.
핵심 요약
AI 코딩 에이전트가 몇 분 안에 만든 게임은 회색 블록아웃과 단순한 형상 같은 저품질 비주얼로 나타난다. Hugging Face의 AnyGameRenderer는 비디오-투-비디오 생성형 렌더러로, 이런 촌스러운 영상을 고품질 그래픽으로 변환한다. 타워 디펜스, 자동 배틀러, 탑다운 서바이벌, 턴제 배틀, 카트 레이싱, 크라우드 러너 등 다양한 장르에 걸쳐 일반화된다. 전체 요약 7문장 읽기 → 031 21:11 당일 +385 2400년 중국사를 손가락으로 넘기는 대형 인터랙티브 지도 전국시대(기원전 403년)부터 현대까지 18개 왕조에 걸친 중국 역사를 한 장의 인터랙티브 지도에 담은 웹 프로젝트로, 164개의 영토 스냅숏과 2400개 이상의 역사 도시를 포함한다. 웹 · 프론트엔드 · DeanChensj/jiangshan-map · JavaScript
Key Point 제목이나 텍스트만으로는 파악 불가한 초대형 중국사 인터랙티브 지도의 전체 기능을 한 번에 이해할 수 있으며, 타임라인·카드 검색·인물 추적·퀴즈·딥링크·API 등 7가지 주요 기능이 구체적으로 어떻게 동작하는지 알 수 있다.
핵심 요약
전국시대(기원전 403년)부터 현대까지 18개 왕조에 걸친 중국 역사를 한 장의 인터랙티브 지도에 담은 웹 프로젝트로, 164개의 영토 스냅숏과 2400개 이상의 역사 도시를 포함한다. 타임라인을 드래그해 왕조의 흥망을 추적하고 황제와 연호를 실시간으로 표시하며, 행정 구역·성·회로 등 다단계 영토 변화를 층화된 지도로 비교할 수 있다. 한 번에 여러 국가가 대립하는 장면을 보여주는데, 예를 들어 전국 시대 7개 국 외에도 북-남조·5대 10국·송·요·서하·금·원·명·청 등을 색상으로 구분해 표시한다. 전체 요약 14문장 읽기 → 032 21:11 ▲ 10 · 댓글 1 네트워크 보안에 타입화된 결정 모델 도입, VX-One 실증 네트워크 경계 방어(perimeter triage)는 빠른 시그니처 엔진과 느리지만 의미를 파악하는 생성형 모델 간의 절충이 필요한데, 최근 상용 System One 결정 모델들이 이진 게이트·폐쇄형 선택·순서형 점수 같은 타입화된 의사결정 원시형을 API로 제공하기 시작했다. 보안 · VX-One: Typed, Calibrated Decision Heads for Real-Time Perimeter Triage - An empirical study of unknown-attack honesty, cascade gray zones, and calibration under drift
Key Point 시그니처 엔진과 머신러닝의 장점을 결합하는 캐스케이드 아키텍처에서 타입화된 결정의 효과와 한계를 실증적으로 측정한 결과, 특히 시간적 변화 같은 실전 조건에서 캘리브레이션이 붕괴되는 현상은 보안 시스템 운영에 직접 영향을 미친다.
핵심 요약
네트워크 경계 방어(perimeter triage)는 빠른 시그니처 엔진과 느리지만 의미를 파악하는 생성형 모델 간의 절충이 필요한데, 최근 상용 System One 결정 모델들이 이진 게이트·폐쇄형 선택·순서형 점수 같은 타입화된 의사결정 원시형을 API로 제공하기 시작했다. VX-One은 100K-10M 파라미터의 소규모 멀티헤드 네트워크로서 캘리브레이션된 게이트, 미지의 선택지를 항상 포함하는 폐쇄형 후보군에서의 선택, 순서형 점수를 출력하며, CPU에서 약 0.7-1.7ms의 추론 시간을 가진다. UNSW-NB15, CIC-IDS2017, EMBER2024 벤치마크에서 캘리브레이션된 XGBoost, 랜덤포레스트, MLP, Kitsune과 비교 평가했고, Suricata 시그니처 엔진(52,674개 규칙) 뒤에 VX-One을 두는 2단계 캐스케이드 구성을 CIC-IDS2017의 5일간 데이터로 측정했다. 전체 요약 7문장 읽기 → 033 18:11 ▲ 97 · 댓글 2 320B 파라미터 에이전트 모델 IQuest-Q1 공개 IQuest-Q1은 Mixture-of-Experts 구조로 설계된 에이전트 파운데이션 모델로, 총 320B 파라미터 중 15B만 활성화되는 희소 모델입니다. AI · 머신러닝 · IQuest-Q1: Advancing Foundation Capabilities for Agentic CLI Systems
Key Point 희소 MoE 구조로 320B 파라미터의 15%만 활성화하면서도 복잡한 다단계 학습 파이프라인을 통해 에이전트 능력을 강화한 방식이 새로운 표준이 될 수 있기 때문입니다.
핵심 요약
IQuest-Q1은 Mixture-of-Experts 구조로 설계된 에이전트 파운데이션 모델로, 총 320B 파라미터 중 15B만 활성화되는 희소 모델입니다. 3단계 학습 과정으로 개발되었습니다: 첫 번째는 Stable SplitNorm, Muon, muP를 결합한 안정적 사전학습으로, 두 번째 단계에서 코딩 데이터 비중을 높여 안전한 학습률 마진을 확보합니다. 두 번째 단계는 도메인과 포맷 전반에 걸쳐 데이터 혼합을 확장하고 컨텍스트를 점진적으로 늘리는 세부 중기 학습입니다. 전체 요약 6문장 읽기 → 034 12:11 ▲ 30 · 댓글 3 MoE 모델의 중복 제거, 메타 전문가로 70-80% 파라미터만 써도 된다 MoE(Mixture of Experts) 모델 확장 시 계층별 전문가들이 구조적으로는 독립적이지만 저장된 내용에 상당한 유사성과 중복을 보인다. AI · 머신러닝 · Meta Expert: Cross-Layer Expert Sharing for Storage- and Retrieval-Efficient MoE
Key Point 모델 매개변수 규모를 키우면서 MoE 효율성을 30~40% 개선할 수 있는 구조적 혁신으로, 대규모 언어 모델 개발의 비용 효율성을 크게 높일 수 있다.
핵심 요약
MoE(Mixture of Experts) 모델 확장 시 계층별 전문가들이 구조적으로는 독립적이지만 저장된 내용에 상당한 유사성과 중복을 보인다. 연구팀은 계층 간 공유 Meta Expert가 기존 Local Expert보다 더 효율적일 수 있다고 가설을 세우고 실증적 비교를 진행했다. Meta Expert를 도입한 모델은 파라미터 중복도가 낮고, 교차 엔트로피 손실이 작으며, 다운스트림 작업 정확도가 높았다. 전체 요약 5문장 읽기 → 035 03:11 새 버전 FastAPI 0.160.0 출시, 파라미터 검증 규칙 강화 FastAPI 0.160.0에서 Query, header, cookie, form 파라미터 모델이 Pydantic 동작과 일관되게 같은 위치의 모든 필드에 extra 설정을 적용한다. 웹 · 프론트엔드 · fastapi/fastapi@0.160.0
Key Point FastAPI 파라미터 검증 방식이 Pydantic과의 일관성을 위해 변경되므로, 기존 애플리케이션에서 파라미터 처리 동작을 재확인해야 한다.
핵심 요약
FastAPI 0.160.0에서 Query, header, cookie, form 파라미터 모델이 Pydantic 동작과 일관되게 같은 위치의 모든 필드에 extra 설정을 적용한다. 이제 다른 모델이나 의존성에서 선언된 필드도 포함되어, 이전의 제외 동작이 변경된다. extra="forbid" 설정 시 모델 외 필드를 거부하고, extra="allow" 시 해당 필드를 모델 extras로 포함하며, 기본값 extra="ignore" 시 무시된다. 전체 요약 5문장 읽기 → 036 03:11 ▲ 19 · 댓글 2 스스로 개선하는 AI, 살아있는 환경에서 진화한다 현재 대부분의 AI 시스템은 고정된 파라미터로 출시되어 외부 업데이트로만 개선되지만, 이상적인 시스템은 자신의 경험으로부터 계속 개선되는 '순환적 자기개선(RSI)' 능력을 가져야 한다. AI · 머신러닝 · Evolving with Open Worlds: Towards Recursive Self-Improvement for Future Forecasting
Key Point 모델이 외부 업데이트 없이 자신의 경험으로 지속적으로 개선되는 구조를 실제로 구현해 검증했으며, AI 훈련 패러다임의 근본적 전환을 제시한다.
핵심 요약
현재 대부분의 AI 시스템은 고정된 파라미터로 출시되어 외부 업데이트로만 개선되지만, 이상적인 시스템은 자신의 경험으로부터 계속 개선되는 '순환적 자기개선(RSI)' 능력을 가져야 한다. 미래 이벤트 예측에 기반한 자기진화 에이전트 시스템 'DeepEvolve'를 개발했으며, 에이전트가 지속적으로 변화하는 환경과 상호작용하면서 경험을 내재화·외재화하여 개선된다. 검증 가능한 작업을 합성하는 살아있는 환경과 각 예측 뒤의 추론 궤적을 능력으로 변환하는 순환진화 엔진으로 구성되며, 탐색을 예측으로부터 분리하여 파라미터 수준의 진화를 오염 위험이 있는 라이브 환경에 맞춘다. 전체 요약 8문장 읽기 → 037 21:11 당일 +350 중국 SNS 6개 플랫폼 자동 수집하는 크롤러 공개 Playwright 브라우저 자동화를 기반으로 소홍서, 틱톡, 쿠쿠쇼, 빌리빌리, 웨이보, 바이두 바이바, 지후 등 7개 중국 자매체 플랫폼의 공개 정보를 수집하는 오픈소스 크롤러 MediaCrawler를 공개했다. 오픈소스 · 도구 · NanmiCoder/MediaCrawler · Python
Key Point 중국 주요 소셜 미디어 플랫폼의 공개 데이터를 대규모로 수집해야 하는 개발자나 연구자들에게 기술적 진입장벽을 크게 낮춘 솔루션이 등장했다.
핵심 요약
Playwright 브라우저 자동화를 기반으로 소홍서, 틱톡, 쿠쿠쇼, 빌리빌리, 웨이보, 바이두 바이바, 지후 등 7개 중국 자매체 플랫폼의 공개 정보를 수집하는 오픈소스 크롤러 MediaCrawler를 공개했다. 로그인 상태를 보존한 브라우저 환경에서 자바스크립트 표현식으로 서명 파라미터를 획득하므로 복잡한 암호화 알고리즘 분석이 필요 없다. 키워드 검색, 특정 게시물 ID 수집, 2차 댓글, 작성자 홈페이지, 로그인 캐싱, IP 프록시, 댓글 워드클라우드 생성 등의 기능을 전 플랫폼에서 지원한다. 전체 요약 8문장 읽기 → 038 21:11 ▲ 22 · 댓글 7 4비트 재귀 상태 양자화로 LLM 배치 처리 메모리 절감 선형 어텐션 언어 모델은 고정 크기의 재귀 상태로 문맥을 유지하며, 추론 시스템은 동시에 복호화되는 각 시퀀스마다 상태 복사본을 저장해야 한다. AI · 머신러닝 · PACE: Periodic and Channel-Aligned Encoding of Four-Bit Recurrent States
Key Point LLM 추론 시 배치 크기를 제약하는 상태 메모리를 4비트로 양자화할 수 있다면, 같은 GPU 메모리로 더 많은 요청을 동시 처리할 수 있기 때문이다.
핵심 요약
선형 어텐션 언어 모델은 고정 크기의 재귀 상태로 문맥을 유지하며, 추론 시스템은 동시에 복호화되는 각 시퀀스마다 상태 복사본을 저장해야 한다. 상태를 낮은 정밀도로 저장하면 더 많은 시퀀스가 가속기를 공유할 수 있지만, 기존 양자화 방식은 매 토큰 생성 후 반올림하므로 4비트에서 정확도 손실이 크다. PACE는 사후 4비트 상태 양자화 기법으로, 매 토큰마다가 아니라 여러 토큰 생성 후에만 한 번 상태를 반올림하고, 그 사이 생성된 토큰을 작은 버퍼에 보관한다. 전체 요약 8문장 읽기 → 039 18:11 ▲ 25 · 댓글 2 AI 에이전트, 과학 모델 개선에서 얼마나 성과낼까 연구팀이 Agent4Sci라는 테스트베드를 개발해 최신 AI 에이전트들이 과학 ML 벤치마크의 발표된 최고 성능을 어디까지 개선할 수 있는지 측정했다. AI · 머신러닝 · Automating ML for Science: Can Frontier Agents Climb Scientific Hills in the Wild?
Key Point 실제 과학 문제 해결에서 AI 에이전트의 현재 수준을 정량적으로 파악할 수 있으며, 단순 하이퍼파라미터 조정을 넘어 진정한 과학적 창의성이 부족한 부분이 명확해진다.
핵심 요약
연구팀이 Agent4Sci라는 테스트베드를 개발해 최신 AI 에이전트들이 과학 ML 벤치마크의 발표된 최고 성능을 어디까지 개선할 수 있는지 측정했다. 11개 분야의 20개 벤치마크를 대상으로 평가했을 때, Claude Opus는 평균 10.4%의 상대적 성능 개선을 달성했으며 모든 실행에서 학문적 부정행위 없이 진행되었다. 하지만 이 개선 사항은 거의 전부가 데이터 전처리, 하이퍼파라미터 조정, 앙상블 같은 표준 ML 엔지니어링 기법에서 비롯되었으며 실제 과학적 통찰력은 부족했다. 전체 요약 6문장 읽기 → 040 18:11 ▲ 66 · 댓글 1 프로그램 이해부터 시각화까지, 오픈소스 멀티모달 코딩 모델 공개 프로그램의 코드와 실행 결과의 시각적 표현을 함께 이해하는 멀티모달 코드 지능 분야에서 오픈소스 진전이 크게 뒤쳐져 있으며, 기존 평가 방식들(실행 결과, 코드 유사도, 작업별 검증기)이 모두 세 가지 요소를 동시에 평가하지 못합니다. AI · 머신러닝 · PrismaCoder: Pushing the Boundaries of Open Multimodal Code Intelligence through Decomposed Rubric Synthesis
Key Point 코드 생성 모델이 시각적 산출물까지 정확히 만들어야 하는 요구사항이 증가하면서, 이를 평가하고 개선하기 위한 체계적 방법론이 부족했던 문제를 해결하는 오픈소스 솔루션이 등장했습니다.
핵심 요약
프로그램의 코드와 실행 결과의 시각적 표현을 함께 이해하는 멀티모달 코드 지능 분야에서 오픈소스 진전이 크게 뒤쳐져 있으며, 기존 평가 방식들(실행 결과, 코드 유사도, 작업별 검증기)이 모두 세 가지 요소를 동시에 평가하지 못합니다. 저자들은 분해된 루브릭 기반 데이터 파이프라인 PrismaForge를 개발하여, 프로그램 정확성·코드 품질·시각적 정확성을 별도 체크리스트로 분해하고 이를 데이터 필터링과 강화학습 보상으로 활용합니다. PrismaForge를 통해 PrismaCoder-2M 데이터셋을 구축했으며, 이는 멀티모달 코드 지능 분야 최대 규모이자 가장 다양한 오픈소스 데이터셋입니다. 전체 요약 5문장 읽기 → 041 18:11 ▲ 169 · 댓글 53 360M 모델로 터미널 에뮬레이터 만들기 360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. AI · 머신러닝 · WorldTUI: I trained a 360M model to pretend to be a terminal
Key Point 시뮬레이션·에뮬레이션 구현 없이 자가 수정 학습과 병렬 디코딩으로 소형 모델을 브라우저에서 구동 가능한 터미널 에뮬레이터로 만든 기술 구현 사례로, 제약된 환경에서 큰 모델의 능력을 소형화하는 방법을 보여준다.
핵심 요약
360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. 파일 생성, vim과 tmux 실행, 스네이크 게임 등이 가능하고, 자신의 실수를 수정하는 능력과 행(row)을 병렬로 디코딩하는 기술로 성능을 크게 개선했다. 터미널을 문자 그리드로 모델링했으며, Qwen2.5-Coder-0.5B를 기반으로 Docker에서 실제 프로그램 실행 기록으로 파인튜닝했다. 전체 요약 14문장 읽기 → 042 12:11 ▲ 10 · 댓글 2 소규모 언어 모델 에이전트, 장기 추론에서 목표 달성 못하는 문제 해결 LLM 기반 에이전트는 추론과 복잡한 과제 해결에 우수하지만 토큰 소비와 추론 지연 때문에 실제 배포가 어렵다. AI · 머신러닝 · Progress-Aware Distillation for Mitigating Stagnation in Small Language Model Agents
Key Point 소규모 언어 모델을 에이전트로 만들 때 장기 추론에서 막혀 있는 핵심 문제와 그 해결책이 제시되어, 실용적인 경량 에이전트 배포의 길을 열 수 있다.
핵심 요약
LLM 기반 에이전트는 추론과 복잡한 과제 해결에 우수하지만 토큰 소비와 추론 지연 때문에 실제 배포가 어렵다. 최근 연구들은 감독 학습 기반 증류(supervised fine-tuning-based distillation)로 대규모 모델의 에이전트 능력을 소규모 언어 모델(SLM)로 전이하고 있다. 하지만 상호작용 궤적이 길어지면서 추론-행동 체인과 환경 피드백이 쌓이면, 증류된 학생 에이전트는 '진행 정체'를 경험한다: 실패한 전략에 갇혀 의미 있는 진전을 못 한다. 전체 요약 8문장 읽기 → 043 12:11 ▲ 42 · 댓글 2 로봇 플래너도 포스트트레이닝으로 강화된다 로봇을 제어하는 AI 플래너의 성능을 높이기 위해 '포스트트레이닝' 기법을 적용한 AgenticRoboRL 프레임워크를 개발했다. AI · 머신러닝 · AgenticRoboRL: Bringing Coding-Agent Post-Training to Agentic Robotics
Key Point 작은 오픈소스 로봇 모델도 정교한 포스트트레이닝으로 폐쇄형 거대모델 수준의 성능을 낼 수 있다는 점이 로봇 개발자와 AI 연구자들에게 실질적인 의미를 갖는다.
핵심 요약
로봇을 제어하는 AI 플래너의 성능을 높이기 위해 '포스트트레이닝' 기법을 적용한 AgenticRoboRL 프레임워크를 개발했다. 기존 로봇 제어 시스템은 강력한 폐쇄형 모델(GPT 같은)에 의존했지만, 모델 자체를 개선하지는 않았다. 코딩 에이전트 분야에서 포스트트레이닝이 성공한 점에 착안해 로봇 플래너에도 같은 접근을 시도했다. 전체 요약 8문장 읽기 → 044 09:11 ▲ 171 · 댓글 105 구글이 공개한 Rust 스타일 가이드, 안드로이드·크롬까지 확대 구글이 공식 Rust 스타일 가이드를 발표했으며, 안드로이드·크롬·Fuchsia 등 여러 프로젝트에서 적용할 계획이다. 오픈소스 · 도구 · Google's Rust Style Guide
Key Point 구글·안드로이드·크롬 등 대규모 프로젝트들이 채택하는 표준이 되면서 Rust 개발자의 코드 작성 방식을 좌우할 가능성이 크다.
핵심 요약
구글이 공식 Rust 스타일 가이드를 발표했으며, 안드로이드·크롬·Fuchsia 등 여러 프로젝트에서 적용할 계획이다. 코드 읽기 쉬움·유지보수·자동화 도구 호환성·생태계 일관성을 목표로 하되, 대규모 변경(LSC)을 수월하게 하는 것을 추가 목표로 삼았다. 작은 크레이트 선호, 단일 디렉터리 구조, 글로브 임포트 금지 등 코드 조직화 규칙을 제시했다. 전체 요약 8문장 읽기 → 045 18:11 ▲ 22 · 댓글 2 추론 모델의 병렬 수정 기법, Draft Refinement 제안 추론 모델이 반복적으로 각 의사결정을 수정할 때, 개별적으로 타당한 토큰 업데이트가 전체 답변의 질을 보장하지 못한다는 문제를 제시한다. AI · 머신러닝 · Breaking Diffusion: Parallel Reasoning with Draft Refinement
Key Point 추론 모델에서 토큰 단위 수정을 병렬로 처리하면서도 평가의 정확성을 높이는 새로운 메커니즘을 제시해, 복잡한 문제 해결에서 계산 효율과 정확도를 동시에 개선할 수 있음을 보여준다.
핵심 요약
추론 모델이 반복적으로 각 의사결정을 수정할 때, 개별적으로 타당한 토큰 업데이트가 전체 답변의 질을 보장하지 못한다는 문제를 제시한다. Draft Refinement Language Models(DRLMs)는 단일 denoiser를 사용해 병렬 수정안을 제안하고 후보 초안을 평가하는 방식을 도입했다. Denoiser는 균등하게 손상된 초안에서 모든 토큰을 복원하도록 학습되어 보존과 수리 능력을 모두 갖춘다. 전체 요약 8문장 읽기 → 046 12:11 ▲ 227 · 댓글 3 멀티모달 GUI 에이전트의 주의력 집중 방식 FocusGUI 스크린샷, 오디오, 비디오, 상호작용 이력, 기기 상태 등 다양한 입력 정보를 처리하는 GUI 에이전트에서, 모든 정보를 동등하게 처리하면 불필요한 정보가 노이즈가 되어 에이전트의 판단을 방해하는 '순차 산만함(Sequential Distraction)' 문제가 발생한다. AI · 머신러닝 · Focused Omni-Modal GUI Agents
Key Point 멀티모달 정보를 처리하는 GUI 자동화 에이전트가 불필요한 정보로 인한 오류를 줄이고 성능을 대폭 향상시키는 새로운 방식을 제시하고 있다.
핵심 요약
스크린샷, 오디오, 비디오, 상호작용 이력, 기기 상태 등 다양한 입력 정보를 처리하는 GUI 에이전트에서, 모든 정보를 동등하게 처리하면 불필요한 정보가 노이즈가 되어 에이전트의 판단을 방해하는 '순차 산만함(Sequential Distraction)' 문제가 발생한다. 각 단계마다 실제로 필요한 정보는 다르므로, 단계별로 적응적이고 행동 충분하며 비방해적인 '집중된 인식'을 요구한다. FocusGUI는 경량 어댑터로서 현재 의사 결정에 필요한 멀티모달 채널을 동적으로 우선순위화하고, 가장 관련성 높은 정보를 압축된 잠재 표현으로 변환한다. 전체 요약 7문장 읽기 → 047 09:11 새 버전 FastAPI 0.156.4 릴리스, AliasChoices 버그 수정 FastAPI 0.156.4가 릴리스되었다. 웹 · 프론트엔드 · fastapi/fastapi@0.156.4
Key Point 필드 별칭 처리 시 안정성을 개선한 유지보수 업데이트로, FastAPI를 사용하는 개발자들의 요청 데이터 검증 안정성이 향상된다.
핵심 요약
FastAPI 0.156.4가 릴리스되었다. 이름이 지정된 JSON 바디 파라미터의 AliasChoices 버그를 수정했다. 폼 모델의 AliasChoices 추출 버그도 수정했다. 048 03:11 새 버전 FastAPI 0.155.0, 요청 파라미터의 **extra 제거 FastAPI 0.155.0에서 Path, Query, Header, Cookie, Body, Form, File의 **extra 키워드 인자가 제거되었습니다. 웹 · 프론트엔드 · fastapi/fastapi@0.155.0
Key Point deprecated 기능이 완전히 제거되는 breaking change이므로, FastAPI를 사용 중인 개발자들은 코드 마이그레이션이 필요합니다.
핵심 요약
FastAPI 0.155.0에서 Path, Query, Header, Cookie, Body, Form, File의 **extra 키워드 인자가 제거되었습니다. 미지의 키워드 인자는 이제 TypeError를 발생시킵니다. JSON 스키마 커스텀 속성을 추가하려면 Query(custom='value') 형태에서 Query(json_schema_extra={"custom": "value"}) 형태로 변경해야 합니다. 049 03:11 새 버전 FastAPI 0.154.0 출시, 요청 파라미터에 Pydantic 검증 옵션 추가 FastAPI 0.154.0이 릴리스되었다. 웹 · 프론트엔드 · fastapi/fastapi@0.154.0
Key Point 요청 데이터 검증 방식을 더 유연하게 제어할 수 있게 되어 API 개발 시 검증 로직을 커스터마이징할 수 있다.
핵심 요약
FastAPI 0.154.0이 릴리스되었다. 요청 파라미터에 Pydantic 검증 옵션을 추가할 수 있게 되었다. PR #16542를 통해 이 기능이 구현되었다. 050 03:11 새 버전 FastAPI 0.156.0, Pydantic Field 속성 보존 수정 FastAPI 0.156.0이 릴리스되었다. 웹 · 프론트엔드 · fastapi/fastapi@0.156.0
Key Point Pydantic Field 속성이 요청 파라미터에서 손실되던 문제가 해결되어 스키마 정의와 실제 동작의 일관성이 개선된다.
핵심 요약
FastAPI 0.156.0이 릴리스되었다. 요청 파라미터에서 Pydantic Field() 속성이 제대로 보존되지 않던 버그를 수정했다. 이 수정으로 Field()로 정의한 메타데이터와 제약 조건이 요청 처리 시 유지된다. 051 00:11 새 버전 FastAPI 0.152.0, 헤더 파라미터 검증 오류 메시지 개선 FastAPI 0.152.0 릴리스에서 헤더 파라미터 모델의 검증 오류가 Python 필드명(int_val)이 아닌 HTTP 헤더명(int-val)을 보고하도록 변경되었다. 웹 · 프론트엔드 · fastapi/fastapi@0.152.0
Key Point 헤더 검증 오류 메시지가 HTTP 표준명으로 표시되므로, 클라이언트와의 상호작용 문제를 더 빠르게 파악하고 해결할 수 있다.
핵심 요약
FastAPI 0.152.0 릴리스에서 헤더 파라미터 모델의 검증 오류가 Python 필드명(int_val)이 아닌 HTTP 헤더명(int-val)을 보고하도록 변경되었다. 명시적 alias가 지정되거나 Header(convert_underscores=False)가 설정된 경우, 또는 Pydantic 모델에서 loc_by_alias=False가 설정된 경우에는 기존 동작을 유지한다. 이 변경으로 개발자는 헤더 검증 오류 시 실제 HTTP 헤더명을 받아보게 되어 디버깅이 더 직관적이 된다. 052 16:56 ▲ 620 · 댓글 215 DeepSeek, 자체 추론 엔진 오픈소스로 공개 딥시크가 자사 대규모 서비스에 쓰이는 고성능 추론 프레임워크 DeepInfer를 오픈소스로 공개했다. AI · 머신러닝 · DeepSeek just open-sourced its inference engine
Key Point 딥시크의 대규모 서빙에 검증된 고성능 추론 엔진이 오픈소스화되어, LLM 배포를 다루는 개발자들이 프로덕션 수준의 최적화 기법을 직접 활용할 수 있게 되었다.
핵심 요약
딥시크가 자사 대규모 서비스에 쓰이는 고성능 추론 프레임워크 DeepInfer를 오픈소스로 공개했다. 지원 모델은 DeepSeek-V4.1-Flash이며, FlashMLA, DeepGEMM, DeepEP 등 최적화된 커널과 MoE 전문가 병렬화, 비동기 스케줄링, 배치 불변 추론 등 대규모 서빙에 필요한 핵심 기능을 포함한다. DSpark와 신뢰도 기반 검증으로 드래프트 토큰을 통해 디코딩을 가속화하며, 설정 파라미터로 최대 드래프트 길이(기본값 5)를 조절할 수 있다. 전체 요약 9문장 읽기 → 053 21:11 ▲ 13 · 댓글 4 임베딩 테이블을 16MB 고정 코드로 대체, 소형 모델 파일 1/7 축소 소형 언어 모델에서 임베딩 테이블은 전체 파라미터의 대부분을 차지하고, Gemma 3 270M 모델의 경우 268M 파라미터 중 168M이 임베딩 테이블이며, 양자화 후에도 16비트로 남아 파일 크기의 대부분을 차지한다. AI · 머신러닝 · Embeddings Are Overpriced? A Frozen 16 MB Vocabulary for Small and Ternary Language Models
Key Point 소형 모델 배포 시 파일 크기가 1/7로 축소되고 CPU 속도가 5~6배 빨라지므로, 엣지 디바이스와 저사양 환경에서의 모델 배포 방식을 바꿀 가능성이 있다.
핵심 요약
소형 언어 모델에서 임베딩 테이블은 전체 파라미터의 대부분을 차지하고, Gemma 3 270M 모델의 경우 268M 파라미터 중 168M이 임베딩 테이블이며, 양자화 후에도 16비트로 남아 파일 크기의 대부분을 차지한다. 연구팀은 학습 가능한 임베딩 테이블을 주성분 투영과 부호 이진화로 도출한 512비트 코드의 동결 테이블(16MB, 학습 가능 파라미터 없음)로 대체하고, 동일한 Gemma 형태의 모델을 2.05B 토큰으로 학습했다. 학습된 임베딩 테이블은 0.20 나츠 검증 손실을 위해 2.6배 많은 학습 가능 파라미터를 필요로 했으나, LAMBADA, HellaSwag, PIQA 벤치마크에서는 동결 테이블 모델이 동일하거나 더 나은 성능을 보였고 ARC-Easy에서만 학습된 테이블이 앞섰다. 전체 요약 6문장 읽기 → 054 18:11 새 버전 FastAPI 0.151.0, JSON null 값 처리 방식 변경 FastAPI 0.151.0에서 JSON 요청 본문의 null 값과 생략된 값을 구분하기 시작했다. 웹 · 프론트엔드 · fastapi/fastapi@0.151.0
Key Point FastAPI의 요청 검증 동작이 명확해져 명시적 null 처리가 더 엄격해졌으므로, 기존 클라이언트의 동작을 확인하고 필요시 수정해야 한다.
핵심 요약
FastAPI 0.151.0에서 JSON 요청 본문의 null 값과 생략된 값을 구분하기 시작했다. 개별 Body 파라미터에서 null은 None으로 검증되며, nullable 타입은 이를 수용하고 non-nullable 타입은 기본값이 정의되어 있어도 거부한다. 기본값과 기본값 팩토리는 값이 생략되었을 때만 적용되며, 이는 JSON 객체 내부의 파라미터와 전체 본문을 나타내는 파라미터 모두에 적용된다. 전체 요약 5문장 읽기 → 055 18:11 ▲ 123 · 댓글 69 오픈 모델에 숨겨진 백도어, 탐지 불가능한 이유 가중치를 편집한 모든 오픈 모델은 백도어를 숨길 수 있으며, 특히 제약을 제거한 abliterated 모델이 인기 있기 때문에 검증 없이 다운로드된다. 보안 · How abliterated models can get you pwned
Key Point 오픈 모델 백도어는 현재 Hugging Face에서 실제로 유통 중이며, 벤치마크 검사와 보안 스캔을 모두 통과하므로 런타임 제어 없는 프로덕션 배포는 자격증명 탈취 위험에 노출된다.
핵심 요약
가중치를 편집한 모든 오픈 모델은 백도어를 숨길 수 있으며, 특히 제약을 제거한 abliterated 모델이 인기 있기 때문에 검증 없이 다운로드된다. Project Discovery 연구팀은 Qwen2.5-7B 모델에 백도어를 심어 코딩 에이전트(Codex)를 통해 프로젝트 자격증명을 유출시키는 실험을 수행했다. 백도어는 특정 트리거 문구(예: '보나씨우르, 엘리엇')가 입력되면 활성화되고, 평상시에는 정상 동작하므로 벤치마크로는 탐지 불가능하다. 전체 요약 13문장 읽기 → 056 15:11 ▲ 235 · 댓글 3 뇌 신경 신호 예측, 104B 대규모 모델로 풀다 뇌 인코딩 모델은 자극에 대한 신경 반응을 예측하는데, 기존엔 동결된 사전학습 모델의 출력층만 학습했으나 신경 데이터가 비싸고 제한적이라 큰 모델 학습이 어려웠다. AI · 머신러닝 · Scaling Parameter-Efficient Fine-Tuning for Brain Encoding
Key Point 매개변수 효율적 미세조정 기법으로 뇌 신경 신호 예측 분야에서 100B대 대규모 모델 활용이 처음 가능해졌고, 기존 접근법 대비 계산 효율을 획기적으로 개선했다.
핵심 요약
뇌 인코딩 모델은 자극에 대한 신경 반응을 예측하는데, 기존엔 동결된 사전학습 모델의 출력층만 학습했으나 신경 데이터가 비싸고 제한적이라 큰 모델 학습이 어려웠다. 연구진은 매개변수 효율적 미세조정(PEFT)을 적용해 최대 104B 파라미터 규모의 멀티모달 백본을 적응시켰으며, 이는 뇌 인코딩에 적용된 최대 규모 모델이다. 슬라이딩 윈도우 대신 백본의 인과 구조를 활용해 한 번에 여러 시점을 예측함으로써 특징 추출 비용을 획기적으로 줄였다. 전체 요약 6문장 읽기 → 057 12:11 ▲ 12 · 댓글 3 순환 언어 모델의 구조 설계: Huginn이 Ouro를 앞서다 Transformer 블록을 논리적 깊이에 재사용하는 순환 언어 모델의 설계 요소를 분석한 논문이다. AI · 머신러닝 · Towards Looped Models Done Right, Part I: Topology, Input Injection, Recurrent-State Design
Key Point 순환 아키텍처는 파라미터 효율성과 추론 효율을 동시에 개선할 수 있는 차세대 언어 모델 설계 방향인데, 이 논문은 어떤 구조적 선택이 실제로 성능을 결정하는지 체계적으로 규명했기 때문이다.
핵심 요약
Transformer 블록을 논리적 깊이에 재사용하는 순환 언어 모델의 설계 요소를 분석한 논문이다. 같은 규모와 토큰 예산에서 학습한 모델들을 비교하여 재귀 배치, 입력 주입, 재귀 상태 구성의 영향을 개별적으로 측정했다. Prelude-Recurrent-Block-Coda 샌드위치 아키텍처가 문맥 추출과 추론 집약적 작업에서 일관되게 성능을 높이는 것을 확인했다. 전체 요약 8문장 읽기 → 058 06:11 ▲ 180 · 댓글 75 확산 기반 LLM 머큐리 3 공개, 초당 1000+ 토큰 처리 확산(Diffusion) 기반 LLM인 머큐리 3를 공개했으며, 여러 벤치마크에서 GPT-6 Luna와 Claude Haiku 5.5를 능가하면서 4~8배 빠른 초당 1,068 토큰을 처리한다. AI · 머신러닝 · Mercury 3: Diffusion at scale
Key Point 확산 기반 LLM이 자동회귀 모델과의 경쟁에서 확장 가능함을 증명하는 첫 번째 상용 사례로, 실시간 AI 애플리케이션의 지연 시간 문제를 해결할 수 있다.
핵심 요약
확산(Diffusion) 기반 LLM인 머큐리 3를 공개했으며, 여러 벤치마크에서 GPT-6 Luna와 Claude Haiku 5.5를 능가하면서 4~8배 빠른 초당 1,068 토큰을 처리한다. 머큐리 1 대비 40배 이상 모델 파라미터를 확대했으며, 벤치마크 기준 지능 수준은 3배 향상됐다. 문맥 길이는 260K에서 100만 토큰으로 확장했고, 입출력 토큰당 각각 0.20달러, 0.70달러이며 출시 초기에는 50% 할인(입력 0.10달러, 출력 0.35달러)을 제공한다. 전체 요약 10문장 읽기 → 059 06:11 ▲ 102 · 댓글 43 Plex 취약점 악용해 암호화폐 채굴기 배포 중 Plex가 9월 1일 보안 업데이트를 공지했고, 10월 16일 CVE-2026-96652, 96654, 96655, 96656 등 4개 취약점이 공개됐으며, 이들을 연쇄적으로 악용하면 원격 코드 실행이 가능하다. 보안 · Plex vulnerabilities being exploited in the wild to drop a cryptominer
Key Point Plex 메디어 서버 취약점이 실제로 악용되고 있으며, 단순 채굴기를 넘어 주거 IP 기반 프록시 구축으로 기업 네트워크 침투의 발판이 될 수 있는 위협이다.
핵심 요약
Plex가 9월 1일 보안 업데이트를 공지했고, 10월 16일 CVE-2026-96652, 96654, 96655, 96656 등 4개 취약점이 공개됐으며, 이들을 연쇄적으로 악용하면 원격 코드 실행이 가능하다. 공격자는 /player/timeline/subscribe 경로의 프로토콜 버전 파라미터를 조작해 명령 실행을 유도하는 방식으로 악용하고 있다. 10월 17일 기준 45.194.92.222, 91.92.40.202, 176.65.139.228 등의 IP에서 실제 공격이 관찰되었으며, 217.60.194.116에서 악성 파일을 배포하고 있다. 전체 요약 6문장 읽기 → 060 03:11 새 버전 FastAPI 0.149.0, 빈 폼 입력을 누락으로 처리 FastAPI 0.149.0은 폼 모델에서 빈 스칼라 값을 누락으로 처리하는 방식으로 변경했다. 웹 · 프론트엔드 · fastapi/fastapi@0.149.0
Key Point 폼 데이터 처리 방식의 변화로 기존 FastAPI 애플리케이션에서 폼 검증 동작이 달라질 수 있으며, 업그레이드 시 폼 모델의 동작을 점검해야 한다.
핵심 요약
FastAPI 0.149.0은 폼 모델에서 빈 스칼라 값을 누락으로 처리하는 방식으로 변경했다. 브라우저가 빈 텍스트 입력을 빈 문자열("")로 제출할 때, 개별 Form 파라미터와 마찬가지로 폼 모델도 이를 누락으로 간주한다. 필수 필드는 유효성 검사 오류를 반환하고, 기본값이나 기본 팩토리를 가진 필드는 해당 값을 사용하며 model_dump(exclude_unset=True)에서는 설정되지 않은 상태로 유지된다. 전체 요약 6문장 읽기 → 061 00:11 새 버전 FastAPI 0.148.0, 기본값 검증 방식 변경 FastAPI 0.148.0에서 Query, Header, Cookie, Form 파라미터와 모델 필드의 기본값이 더 이상 사용자 입력으로 취급되지 않으며, validate_default=True를 명시하지 않으면 검증되지 않습니다. 웹 · 프론트엔드 · fastapi/fastapi@0.148.0
Key Point FastAPI 사용자는 기본값 검증 로직이 변경되었으므로 기존 코드에서 자동 검증에 의존하고 있다면 명시적으로 validate_default=True를 추가해야 하는 breaking change입니다.
핵심 요약
FastAPI 0.148.0에서 Query, Header, Cookie, Form 파라미터와 모델 필드의 기본값이 더 이상 사용자 입력으로 취급되지 않으며, validate_default=True를 명시하지 않으면 검증되지 않습니다. omitted 값에 대해 검증을 실행해야 하는 경우, 모델 필드에는 Field(validate_default=True), 파라미터에는 Query(validate_default=True) 등을 설정해야 합니다. Body(validate_default=True)도 이제 정상 작동하며, 파라미터 모델에서 기본값을 설정하면 더 이상 필드가 명시적으로 설정된 것으로 표시되지 않아 model_dump(exclude_unset=True)에서 제외됩니다. 전체 요약 5문장 읽기 → 062 00:11 ▲ 254 · 댓글 45 Mistral, 시계열 예측 파운데이션 모델 Timestral 공개 Mistral이 시계열 데이터 예측을 위한 첫 파운데이션 모델 Timestral을 공개했다. AI · 머신러닝 · Timestral: Mistral release time-series foundation models
Key Point 시계열 데이터는 기업의 센서·관찰성 메트릭부터 재무 수치까지 매우 광범위하게 쓰이는데, 이전에 도메인별로 처음부터 학습해야 했던 방식을 벗어나 사전학습된 기초 모델으로 적응형 예측이 가능해진다.
핵심 요약
Mistral이 시계열 데이터 예측을 위한 첫 파운데이션 모델 Timestral을 공개했다. 최대 크기 모델은 2억 9천만 개 파라미터로, GIFT-Eval, TIME, fev-bench 세 가지 주요 벤치마크에서 1위를 차지했으며 이전 최고 기록보다 파라미터 수는 2/3 수준이다. 5백만부터 2억 9천만 개 파라미터까지 4가지 크기로 출시되며, 각 크기별로 정확도와 모델 크기의 파레토 프런티어에 위치한다. 전체 요약 11문장 읽기 → 063 21:11 새 버전 FastAPI 0.147.0, 불린 폼 필드 처리 변경 FastAPI 0.147.0에서 HTML 폼의 체크박스 필드가 전송되지 않으면 False로 해석됩니다. 웹 · 프론트엔드 · fastapi/fastapi@0.147.0
Key Point 폼 데이터를 다루는 FastAPI 애플리케이션에서 체크박스 필드의 동작이 변경되어, 기존 로직이 영향을 받을 수 있습니다.
핵심 요약
FastAPI 0.147.0에서 HTML 폼의 체크박스 필드가 전송되지 않으면 False로 해석됩니다. 이는 개별 Form 파라미터와 폼 모델 모두에 적용되며, 필수 필드와 기본값이 True 또는 None인 필드도 포함됩니다. 생략된 불린 값은 명시적으로 설정된 것으로 취급되어 model_dump(exclude_unset=True)에도 포함됩니다. 전체 요약 5문장 읽기 → 064 18:11 ▲ 135 · 댓글 43 DeepSeek, 552B 파라미터 추론 모델 V4.1 Flash 1017 공개 DeepSeek가 2026년 10월에 V4.1 Flash 1017 (Max) 모델을 오픈웨이트로 공개했다. 총 552억 개 파라미터 중 추론 시 16억 개만 활성화하는 MoE(Mixture of Experts) 구조를 사용한다. AI · 머신러닝 · DeepSeek V4.1 Flash 1017 (Max)
Key Point DeepSeek의 최신 고효율 모델이 오픈웨이트로 공개되어 누구나 자유롭게 활용할 수 있게 되었으며, 적정 가격에 동급 모델보다 빠른 성능을 제공한다.
핵심 요약
DeepSeek가 2026년 10월에 V4.1 Flash 1017 (Max) 모델을 오픈웨이트로 공개했다. 총 552억 개 파라미터 중 추론 시 16억 개만 활성화하는 MoE(Mixture of Experts) 구조를 사용한다. Artificial Analysis 벤치마크에서 지능지수 45점으로 같은 크기의 오픈웨이트 모델 중 평균(19점)을 크게 상회한다. 입력당 $0.30, 출력당 $1.20의 가격으로 일반적인 모델보다 저렴한 편이다. 초당 230.4 토큰 생성 속도로 같은 크기 모델 중 평균(77.9토큰)보다 빠르고, 첫 토큰까지 1.08초의 지연 시간은 경쟁 모델(중앙값 1.69초)과 비교해 우수하다. 전체 요약 6문장 읽기 → 065 03:11 새 버전 FastAPI 0.146.0, root_path 파라미터 더 이상 권장 안 함 FastAPI() 생성자의 root_path 파라미터가 deprecated 상태로 전환됐다. 웹 · 프론트엔드 · fastapi/fastapi@0.146.0
Key Point FastAPI 0.146.0부터 root_path 설정 방식이 변경되므로 기존 코드를 업데이트해야 한다.
핵심 요약
FastAPI() 생성자의 root_path 파라미터가 deprecated 상태로 전환됐다. 향후 root path 설정은 fastapi run --root-path /api/v1 명령어로 수행해야 한다. 이는 주요 변경사항(Breaking Change)으로, 기존 코드를 마이그레이션해야 한다. 066 00:11 새 버전 FastAPI 0.145.0 릴리스, openapi_prefix 제거 FastAPI 0.145.0이 릴리스되었다. 웹 · 프론트엔드 · fastapi/fastapi@0.145.0
Key Point 주요 버전 업데이트에서 deprecated 기능을 제거하는 breaking change이므로, 기존 코드에서 openapi_prefix를 사용 중인 개발자들은 마이그레이션이 필요하다.
핵심 요약
FastAPI 0.145.0이 릴리스되었다. 주요 변경사항으로 deprecated된 openapi_prefix 파라미터를 삭제했다. FastAPI 클래스의 사용하지 않는 **extra 파라미터도 함께 제거했다. 전체 요약 4문장 읽기 → 067 00:10 ▲ 310 · 댓글 121 DeepSeek, V4.1-Flash-1017로 추론·코딩 성능 대폭 개선 DeepSeek-V4.1-Flash-1017은 DeepSeek-V4.1-Flash의 마이너 업데이트로, 추론·코딩·에이전트 작업·시각 벤치마크에서 상당한 성능 개선을 제공한다. AI · 머신러닝 · DeepSeek-v4.1-Flash-1017
Key Point LLM의 성능과 효율성이 함께 개선되는 것이 드문데, 추론·코딩 벤치마크에서 동시에 개선되면서 낮은 비용으로 더 복잡한 작업을 처리할 수 있게 됐다.
핵심 요약
DeepSeek-V4.1-Flash-1017은 DeepSeek-V4.1-Flash의 마이너 업데이트로, 추론·코딩·에이전트 작업·시각 벤치마크에서 상당한 성능 개선을 제공한다. 작업 실행 시간과 출력 길이를 단축해 더 빠르고 낮은 비용으로 작업을 완료할 수 있으며, 여러 에이전트 테스트에서 성능-비용 파레토 한계를 앞당겼다. 벤치마크에서 HLE는 42.6점(기존 36.8점), Terminal-Bench 4.0은 42.3점(기존 31.2점), DeepSWE v1.1은 77.0점(기존 74.2점)을 기록했다. 전체 요약 9문장 읽기 → 068 21:11 ▲ 243 · 댓글 80 DeepSeek V4.1 Flash: 552B 파라미터 혼합 전문가 모델 공개 DeepSeek V4.1 Flash 1017은 2026년 10월 17일 스냅샷으로, 552B 파라미터 백본에서 입력 시 8B, 출력 시 16B을 활성화하는 스파스 혼합 전문가 모델이다. AI · 머신러닝 · DeepSeek: DeepSeek v4.1 Flash 1017
Key Point 추론 속도와 이미지 이해 능력을 갖춘 저비용 혼합 전문가 모델로, 에이전트와 장기 작업에 최적화된 구조를 처음 선보인다.
핵심 요약
DeepSeek V4.1 Flash 1017은 2026년 10월 17일 스냅샷으로, 552B 파라미터 백본에서 입력 시 8B, 출력 시 16B을 활성화하는 스파스 혼합 전문가 모델이다. 이는 DeepSeek의 신규 Causal Encoder-Decoder(CED) 아키텍처를 기반으로 한 첫 번째 모델이며, 비대칭 파라미터 분할로 토큰당 계산을 낮게 유지한다. 이미지 이해가 아키텍처에 기본 내장되어 있으며, 시각과 텍스트 임베딩이 사전 학습 시작부터 함께 학습되었다. 전체 요약 11문장 읽기 → 069 12:11 새 버전 OpenAI Python SDK v3.33.0 공개 OpenAI Python SDK v3.33.0이 2026년 10월 16일 공개되었다. AI · 머신러닝 · openai/openai-python@v3.33.0
Key Point OpenAI API 클라이언트를 사용하는 Python 개발자들이 이미지 처리 시 안전성 기능을 활용할 수 있게 되었고, 캐싱 기능의 파라미터 타입이 일관되게 개선되었기 때문입니다.
핵심 요약
OpenAI Python SDK v3.33.0이 2026년 10월 16일 공개되었다. 이미지 요청과 응답에 안전 식별자(safety identifiers)를 추가했다. Decisions 캐시의 breakpoint 파라미터 타입을 공유 가능하도록 개선했다. 070 12:11 ▲ 124 · 댓글 37 FLUX 3 Image Klein, 5.6B 경량 모델로 고화질 이미지 생성 Black Forest Labs가 FLUX 3 Image Klein을 공개했다. 5.6B 파라미터의 오픈웨이트 모델로 텍스트-이미지 생성, 이미지 편집, 최대 10개 레퍼런스 이미지를 활용한 멀티-레퍼런스 생성을 지원하며 기본적으로 4K 해상도 생성과 픽셀-완벽 편집, 바운딩박스 컨트롤 기능을 탑재했다. AI · 머신러닝 · FLUX 3 Image Klein
Key Point 경량화로도 기존 대형 모델을 능가한 새 이미지 생성 모델이 오픈소스로 공개되어 로컬 배포와 파인튜닝이 가능해졌다.
핵심 요약
Black Forest Labs가 FLUX 3 Image Klein을 공개했다. 5.6B 파라미터의 오픈웨이트 모델로 텍스트-이미지 생성, 이미지 편집, 최대 10개 레퍼런스 이미지를 활용한 멀티-레퍼런스 생성을 지원하며 기본적으로 4K 해상도 생성과 픽셀-완벽 편집, 바운딩박스 컨트롤 기능을 탑재했다. FLUX 3 이미지·비디오·오디오 학습을 통합했다. 이미지는 공간 디테일을, 비디오는 움직임과 물리 역학을, 오디오는 사건과 상호작용 정보를 제공해 현실감 있는 이미지 생성을 돕는다. 내부 평가에서 Klein은 Qwen-Image 2.1(7B), Krea 2(12.9B)보다 작은 5.6B 파라미터로 텍스트-이미지, 멀티-레퍼런스, 이미지 편집 모든 항목에서 1위를 기록했으며 Ideogram V4.5, FLUX.2 [pro] 같은 폐쇄형 모델도 능가했다. 전체 요약 13문장 읽기 → 071 09:11 ▲ 11 · 댓글 2 AI 에이전트가 자율적으로 모델을 학습시키다 AI 에이전트가 인간의 개입 없이 소규모 기본 모델을 고급 모델로 학습시킬 수 있는지 검증하는 Athanor이라는 에이전트-네이티브 자동 학습 연구 시스템을 개발했다. AI · 머신러닝 · Athanor: An Agent-Native System for Autonomous Post-Training Research
Key Point 현재의 AI 에이전트가 인간의 개입 없이 모델 개발 연구를 독립적으로 수행할 수 있음을 실증했으며, AI 시스템이 더 강력한 AI를 구축하는 자기 개선 경로의 현실적 가능성을 보여준다.
핵심 요약
AI 에이전트가 인간의 개입 없이 소규모 기본 모델을 고급 모델로 학습시킬 수 있는지 검증하는 Athanor이라는 에이전트-네이티브 자동 학습 연구 시스템을 개발했다. 104시간 동안 Claude Opus 3.5 에이전트 4개가 각각 8개 GPU 노드에서 Qwen3-4B-Base 모델을 개선했으며, 어떤 연구 조언도 받지 않았다. 개발 테스트 6개 과제에서 모델 성능이 15.9에서 67.3으로, 공개되지 않은 홀드아웃 평가 세트에서는 9.2에서 48.2로 향상되었다. 전체 요약 8문장 읽기 → 072 03:11 ▲ 169 · 댓글 82 Mac Studio에서 816B 모델 실행, MLX의 분산 추론 기능 공개 Apple이 MLX 최신 버전을 공개하며 Mac Studio에서 Muse Spark Open(816B 파라미터, MoE 모델)을 실행할 수 있음을 시연했다. AI · 머신러닝 · Apple ML Research: Muse Spark Open with MLX on Mac Studio
Key Point Apple silicon 기반 로컬 LLM 실행 성능이 가속도 구간에 접어들었으며, 816B 모델을 Mac Studio 클러스터에서 실행할 수 있는 기술 기반이 완성되었기 때문이다.
핵심 요약
Apple이 MLX 최신 버전을 공개하며 Mac Studio에서 Muse Spark Open(816B 파라미터, MoE 모델)을 실행할 수 있음을 시연했다. 단일 Mac Studio(M5 Ultra, 512GB 통합 메모리)에서 27B~128B 규모 모델(Qwen 3.8, Mistral Medium 3.5)은 정상 작동하며, TTFT는 M3 대비 최대 4.6배 빨라졌고 토큰 생성 속도는 1.6배 향상됐다. M5 Ultra의 GPU 신경 가속기는 행렬 곱셈 연산을 전담하여 컴퓨팅 한계 작업을 가속화하고, 통합 메모리 대역폭이 819GB/s에서 1.2TB/s로 증가해 메모리 한계 작업을 개선했다. 전체 요약 12문장 읽기 → 073 18:11 ▲ 354 · 댓글 2 VLM의 "빠른 사고": 공간 추론을 분류 문제로 재구성 비전-언어 모델(VLM)이 공간 관계, 거리, 위치 같은 질문에 자동 회귀 방식으로 텍스트를 생성하는 것은 비효율적이다. 이에 MJev-Spatial은 공간 이해 작업을 통일된 분류 프레임워크로 재구성한 System 1 모델이다. AI · 머신러닝 · MJev-Spatial: System One Spatial Intelligence via Native Attention Matching
Key Point 공간 추론 같은 제약된 답변 공간 작업을 분류로 바꾸면 자동 회귀 생성의 지연 없이 단일 포워드 패스로 정확하게 풀 수 있으며, 이는 로봇 제어나 실시간 상호작용이 필요한 애플리케이션의 성능 개선으로 이어진다.
핵심 요약
비전-언어 모델(VLM)이 공간 관계, 거리, 위치 같은 질문에 자동 회귀 방식으로 텍스트를 생성하는 것은 비효율적이다. 이에 MJev-Spatial은 공간 이해 작업을 통일된 분류 프레임워크로 재구성한 System 1 모델이다. 선택 문제는 주어진 옵션을 클래스로, 수치 예측은 값 범위를 이진 분류 단계로, 점 예측은 이미지 영역을 단계적으로 분류하는 방식이다. 기존 VLM의 쿼리-키 사영을 재사용해 추가 파라미터 없이 후보를 점수 매기므로, 추론 시 단 한 번의 포워드 패스로 답을 내놓고 답변 토큰을 생성하지 않는다. 전체 요약 5문장 읽기 → 074 15:11 새 버전 Laravel 13.37.0 릴리스, 동시성 버그와 성능 개선 Laravel 프레임워크 13.37.0이 릴리스되어 30개 이상의 버그 수정과 기능 개선을 포함한다. 웹 · 프론트엔드 · laravel/framework@v13.37.0
Key Point Laravel 애플리케이션의 동시성, 큐 처리, 관계형 쿼리 성능에 영향을 주는 중요한 버그 수정이 포함되어 있어 업그레이드 시 참고해야 한다.
핵심 요약
Laravel 프레임워크 13.37.0이 릴리스되어 30개 이상의 버그 수정과 기능 개선을 포함한다. onOneServer()와 withoutOverlapping()을 함께 사용할 때의 경합 조건 버그를 수정했고, 가짜 Sleep을 limiter의 timeout에 올바르게 반영하도록 개선했다. MariaDB/MySQL에서 많은 데이터베이스를 가진 서버에서 getForeignKeys 성능을 최적화했고, 큐 푸시 실패 시 유니크 잠금을 해제하는 문제를 해결했다. 전체 요약 13문장 읽기 → 075 12:11 ▲ 10 · 댓글 1 카메라 기하학 정보로 로봇 비전-언어 모델의 다중 카메라 성능 향상 Vision-language-action(VLA) 모델은 로봇 조작에 의미론적 지식을 제공하지만, 시각 표현이 2D 이미지 좌표에 기반해 다중 카메라 시스템의 기하학적 관계를 활용하지 못한다. AI · 머신러닝 · G^3VLA: Geometric Inductive Bias for Vision-Language-Action Models
Key Point 로봇 비전 모델이 다중 카메라 시스템의 기하학적 관계를 명시적으로 활용하는 방법을 제시하여, 실제 로봇 시스템에서 카메라 수와 각도에 관계없이 안정적인 성능을 달성할 수 있게 한다.
핵심 요약
Vision-language-action(VLA) 모델은 로봇 조작에 의미론적 지식을 제공하지만, 시각 표현이 2D 이미지 좌표에 기반해 다중 카메라 시스템의 기하학적 관계를 활용하지 못한다. G³VLA는 카메라 내부 파라미터와 외부 파라미터를 이용한 기하학적 모듈로, 사전학습된 VLA의 시각 토큰 스트림에 보정된 카메라 구조를 주입한다. 내부 파라미터 조건 광선 임베딩(ray embedding), 투영 위치 인코딩(PRoPE), 양방향 교차 뷰 융합을 결합해 카메라 뷰 간 기하학적으로 일관된 표현을 구축한다. 전체 요약 8문장 읽기 → 076 06:11 ▲ 110 · 댓글 106 C++26 계약(Contracts)으로 함수의 요구사항과 보장을 명시하기 C++26에서 도입된 계약(Contracts)은 함수의 요구사항과 보장을 코드에 직접 표현하는 기능으로, 기존 assert의 한계를 극복한다. 오픈소스 · 도구 · C++26 Contracts: Introduction to Preconditions and Postconditions
Key Point C++26 계약은 assert를 대체하는 표준화된 언어 기능으로, API 요구사항을 선언부에 명시하고 평가 의미를 선택할 수 있으므로 C++ 코드의 안전성과 가독성을 근본적으로 바꿀 것으로 예상된다.
핵심 요약
C++26에서 도입된 계약(Contracts)은 함수의 요구사항과 보장을 코드에 직접 표현하는 기능으로, 기존 assert의 한계를 극복한다. precondition(pre)은 함수 진입 시 성립해야 할 조건을, postcondition(post)은 정상 반환 시 성립해야 할 조건을 명시하며, 함수 선언부에 작성할 수 있어 API 문서로도 기능한다. 전통적 assert와 달리 계약은 선언부와 정의부에 분리 작성 가능하고, 첫 선언이 계약을 확립하므로 헤더 파일의 선언에서 모든 요구사항을 볼 수 있다. 전체 요약 11문장 읽기 → 077 06:11 ▲ 443 · 댓글 269 메타, 816B 파라미터 오픈 모델 뮤즈 스파크 공개 메타가 코딩과 에이전트 작업에 최적화된 뮤즈 스파크 오픈을 공개했으며, 이는 미국에서 가장 강력한 오픈 웨이트 모델이다. AI · 머신러닝 · Muse Spark Open
Key Point 오픈 웨이트 대형 모델을 처음으로 개인 데스크톱에서 네이티브로 실행할 수 있게 되면서, 클라우드 의존도를 줄이고 로컬에서 고급 AI 기능을 활용할 수 있는 새로운 가능성이 열렸다.
핵심 요약
메타가 코딩과 에이전트 작업에 최적화된 뮤즈 스파크 오픈을 공개했으며, 이는 미국에서 가장 강력한 오픈 웨이트 모델이다. 모델은 총 816B 파라미터(활성 42B)를 가진 네이티브 멀티모달 모델로 1M 토큰 컨텍스트 윈도우를 지원한다. 처음으로 Apple M5 Ultra Mac Studio 2대에서 최신 MLX 프레임워크를 사용해 데스크톱에서 직접 실행 가능하다. 전체 요약 11문장 읽기 → 078 03:12 새 버전 트랜스포머 5.20.0: 메타 뮤즈 스파크 오픈 등 6개 신규 모델 지원 메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. AI · 머신러닝 · huggingface/transformers@v5.20.0
Key Point 메타·알렉스 알파·바이두 등 주요 기업의 첨단 멀티모달·OCR·오디오 모델 6개가 한 번에 지원되고, 분산 학습·추론·양자화 내보내기 등 프로덕션 기능이 대폭 개선되어 트랜스포머 사용자에게 즉시 영향을 미친다.
핵심 요약
메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. InclusionAI의 Ling 3.0 Flash는 5개 KDA 레이어와 1개 MLA 레이어를 결합한 혼합 전문가 모델로 BailingHybridForCausalLM으로 네이티브 지원되어 trust_remote_code=True 없이 로드된다. 알렉스 알파의 Kolibri 1은 독일어·영어 중심 추론 모델로, 50개 레이어가 384명의 전문가 중 6명에게 각 토큰을 시그모이드 라우팅으로 라우팅하고 슬라이딩 윈도우와 전체 어텐션 레이어를 번갈아 사용한다. 전체 요약 13문장 읽기 → 079 03:12 새 버전 Ruff 0.17.1 출시, Python 린터 개선사항 반영 Python 린터·포매터 Ruff 0.17.1이 2026년 10월 15일 공개되었다. 오픈소스 · 도구 · astral-sh/ruff@0.17.1
Key Point Python 코드 품질 검증에 필수적인 도구의 버그 수정과 규칙 개선사항을 확인해야 기존 프로젝트의 린팅 정확도를 높일 수 있다.
핵심 요약
Python 린터·포매터 Ruff 0.17.1이 2026년 10월 15일 공개되었다. None, True, False를 키워드가 아닌 것으로 처리하는 pycodestyle 규칙(E271-E274)이 프리뷰 기능으로 추가되었다. 여러 개의 선행 주석이 있을 때 들여쓰기 제거 로직의 버그를 수정했다. 전체 요약 10문장 읽기 → 080 15:11 ▲ 150 · 댓글 37 경량 추론 모델 LFM2.5-24B-A2B 출시, 온디바이스 에이전트 최적화 Liquid AI가 LFM2.5-24B-A2B를 공개했으며, 총 24B 파라미터 중 활성 파라미터는 2B만 사용하는 추론 특화 모델이다. AI · 머신러닝 · LFM2.5-24B-A2B: Built for fast on-device agents
Key Point 온디바이스에서 도구 호출과 추론을 빠르게 처리해야 하는 개발자에게, 클라우드 API 의존 없이 로컬 에이전트를 구축할 수 있는 선택지를 제시한다.
핵심 요약
Liquid AI가 LFM2.5-24B-A2B를 공개했으며, 총 24B 파라미터 중 활성 파라미터는 2B만 사용하는 추론 특화 모델이다. 총 파라미터가 50% 이상 많은 Qwen3.6-35B-A3B와 비교해 에이전트·도구 사용 벤치마크 8개 중 5개에서 경쟁력을 보였다. AutomationBench에서 27.69점으로 다음 경쟁 모델 8.72점의 3배 이상 점수를 기록했고, LiveClaw에서 48.09점을 달성했다. 전체 요약 13문장 읽기 → 081 12:11 ▲ 237 · 댓글 2 다중 교사 학습 시 교사 간 충돌 완화하는 새로운 방법 다중 교사 온폴리시 증류(MOPD)는 도메인별로 전문화된 교사가 학생이 생성한 궤적에 대해 밀도 있는 토큰 수준의 감독을 제공하는 방식이다. AI · 머신러닝 · Beyond Domain-Routed Supervision: Cross-Teacher Guarding for Multi-Teacher On-Policy Distillation
Key Point 다중 전문 모델을 하나로 통합할 때 발생하는 그래디언트 충돌 문제를 토큰 수준에서 직접 해결하는 기술로, 멀티태스킹 학습 시스템의 안정성과 성능을 모두 개선하는 방법을 제시한다.
핵심 요약
다중 교사 온폴리시 증류(MOPD)는 도메인별로 전문화된 교사가 학생이 생성한 궤적에 대해 밀도 있는 토큰 수준의 감독을 제공하는 방식이다. 기존 도메인 라우팅 방식은 도메인별로 감독 소스를 구분하지만, 모든 도메인의 업데이트가 공유 파라미터에 작용하면서 교사들의 응답 스타일과 도메인 전문성이 다를 때 그래디언트 충돌과 성능 저하가 발생한다. Road MOPD는 라우팅되지 않은 보조 교사를 크로스 도메인 평가자로 추가하고, 토큰 수준의 신용 배분과 그래디언트 업데이트를 통해 다중 교사 감독을 조율한다. 전체 요약 6문장 읽기 → 082 12:11 ▲ 15 · 댓글 2 Few-Step 확산 모델, 간단한 회귀만으로 빠르게 확산 및 흐름 모델의 샘플링 비용을 줄이는 Few-Step 디스틸레이션은 보조 점수 모델이나 특수 아키텍처가 필요했으나, 단순 On-Policy 속도 회귀만으로 4-NFE 생성에 충분함을 보였다. AI · 머신러닝 · Simplifying and Improving On-Policy Distillation for Few-Step Diffusion
Key Point 복잡한 별도 모듈 없이 기본 회귀로 few-step 생성의 품질을 올릴 수 있다면, 실제 배포 환경에서 확산 모델의 속도를 크게 개선하려는 팀들에게 직접적인 영향을 줄 것이다.
핵심 요약
확산 및 흐름 모델의 샘플링 비용을 줄이는 Few-Step 디스틸레이션은 보조 점수 모델이나 특수 아키텍처가 필요했으나, 단순 On-Policy 속도 회귀만으로 4-NFE 생성에 충분함을 보였다. 교사 모델의 각 구간 내 속도 변화를 표현하기 위해 학생의 구간 평균 예측에서 국소 보정을 분리하는 학습 전용 잔차 프록시 Pivot을 도입했다. 학생을 약한 교사 예측으로부터 멀어지게 하는 메커니즘을 추가해 원하지 않는 모드 회피를 돕는다. 전체 요약 7문장 읽기 → 083 12:11 ▲ 64 · 댓글 1 루프형 MoE 모델, 비대칭 연산 배분으로 효율 19% 개선 루프형 Mixture-of-Experts(MoE) 모델은 파라미터를 재사용하면서 스파스 연산으로 성능을 높이는데, 같은 블록을 여러 번 거칠 때 각 방문마다 서로 다른 역할을 한다. AI · 머신러닝 · LatentLoop: Scaling Looped MoE Models with Asymmetric Compute Allocation
Key Point 파라미터 효율성을 중시하는 개발팀이 더 작은 모델로 더 나은 성능을 달성할 수 있는 구조적 개선 방안을 얻을 수 있기 때문입니다.
핵심 요약
루프형 Mixture-of-Experts(MoE) 모델은 파라미터를 재사용하면서 스파스 연산으로 성능을 높이는데, 같은 블록을 여러 번 거칠 때 각 방문마다 서로 다른 역할을 한다. 연구진이 공유 블록을 두 번 적용하는 모델에서 각 방문별로 별도의 잔차 계수를 학습한 결과, 첫 번째 방문에서 더 작은 스케일이 나타났다. 첫 번째 방문의 스케일을 줄이면 성능이 유지되거나 개선되지만, 두 번째 방문을 같은 정도로 줄이면 성능이 떨어진다. 전체 요약 8문장 읽기 → 084 03:11 ▲ 148 · 댓글 42 pgvector 능가하는 벡터 검색 인덱스 등장 Timescale이 PostgreSQL용 고성능 근사 최근접 이웃(ANN) 검색 확장 pg_vectorsearch를 공개했으며, 현재 알파 상태로 프로덕션 용도는 권장하지 않는다. 인프라 · 데브옵스 · Pg_vectorsearch: An index that is faster than pgvector's IVFFlat and HNSW
Key Point pgvector를 대체할 더 빠르고 효율적인 벡터 검색 솔루션을 찾는 개발자들에게 실제 선택지가 생겼으며, 기존 pgvector 테이블과의 호환성 덕분에 마이그레이션 진입장벽이 낮다.
핵심 요약
Timescale이 PostgreSQL용 고성능 근사 최근접 이웃(ANN) 검색 확장 pg_vectorsearch를 공개했으며, 현재 알파 상태로 프로덕션 용도는 권장하지 않는다. PRISM 인덱스는 IVFFlat과 유사한 개념이지만 계층적 라우팅, RaBitQ 양자화, SIMD 최적화를 사용해 pgvector의 IVFFlat과 HNSW보다 쿼리와 인덱스 구축 모두에서 더 빠르다. 100백만 개 벡터 데이터셋에서 HNSW 대비 동등한 재현율(recall)을 달성하면서 1/4 메모리만 사용한다. 전체 요약 11문장 읽기 → 085 21:11 ▲ 18 · 댓글 2 Fish Audio Drama 3, 자연어 지시로 성우 같은 음성 생성 텍스트를 연기하는 형태의 음성으로 변환하는 오픈소스 모델 Fish Audio Drama 3을 공개했다. AI · 머신러닝 · Fish Audio Drama 3 Technical Report
Key Point 단일 모델로 음성 복제, 자연어 지시, 멀티턴 편집, 장면 더빙을 모두 지원하며 파라미터 대비 빠른 추론 속도를 달성한 기술적 진전이 실제 음성 생성·편집 워크플로를 어떻게 단순화할지 확인할 수 있다.
핵심 요약
텍스트를 연기하는 형태의 음성으로 변환하는 오픈소스 모델 Fish Audio Drama 3을 공개했다. 35B 파라미터 혼합 전문가 구조에 토큰당 3B 파라미터만 활성화하며, 여러 참조에서 목소리를 복제하고 자연어 지시에 따른다. 다음 턴의 피드백으로 테이크를 수정하고, 여러 캐릭터 장면에 음성을 부여하며, 기존 음성을 인필로 편집하고 장시간·스트리밍 오디오를 합성한다. 전체 요약 8문장 읽기 → 086 21:11 ▲ 46 · 댓글 1 고해상도 이미지 생성 가능한 경량 디퓨전 변환기 기법 디퓨전 변환기(DiT)가 학습 해상도를 넘어 이미지를 생성하려면 토큰 수가 급증해 전체 어텐션이 계산 비용이 높아지고, 구조 왜곡과 디테일 저하 문제가 발생한다. AI · 머신러닝 · AReA: Adaptive Receptive-Field Attention for Efficient High-Resolution Diffusion Transformers
Key Point 고해상도 이미지 생성 시 계산량 폭증 문제를 적응형 어텐션으로 해결한 방식으로, 추가 학습 없이 적용 가능하다는 점이 중요하다.
핵심 요약
디퓨전 변환기(DiT)가 학습 해상도를 넘어 이미지를 생성하려면 토큰 수가 급증해 전체 어텐션이 계산 비용이 높아지고, 구조 왜곡과 디테일 저하 문제가 발생한다. 균등한 전체 어텐션이 이 문제의 공통 원인인데, 모든 스텝에서 모든 토큰에 주목하면 이차 복잡도가 생기고 학습 범위를 벗어난 상대 거리에 노출되어 모델이 분포에서 벗어난다. 어텐션의 유효 수용 범위는 노이즈 제거 과정에서 좁혀지는데, 초반 스텝에서 전역적으로 구조를 형성하고 후반 스텝에서 국소적으로 세부를 정제한다. 전체 요약 6문장 읽기 → 087 18:11 ▲ 24 · 댓글 1 로봇 비전-언어 모델과 세계 모델을 연결한 WAVE-0 공개 Vision-language-action(VLA) 정책은 로봇 조작에 뛰어나지만 행동의 환경적 결과를 명시적으로 모델링하지 않는 한계가 있다. AI · 머신러닝 · WAVE-0: Bridging VLA Policies and WAMs with Lightweight Latent Future Prediction
Key Point 기존 VLA 정책의 행동 결과 예측 부재 문제를 경량 세계 모델로 해결하고 실제 로봇 작업에서 35%p 향상을 이루어 실용적 로봇 조작 능력이 어떻게 개선되는지 보여준다.
핵심 요약
Vision-language-action(VLA) 정책은 로봇 조작에 뛰어나지만 행동의 환경적 결과를 명시적으로 모델링하지 않는 한계가 있다. World action models(WAM)은 미래 예측을 포함하지만 대부분 비용이 큰 비디오 생성에 의존하거나 대규모 영상 학습이 필요하다. WAVE-0(World-model-Augmented VLA Execution)은 경량 잠재 세계 모델로 VLA와 WAM을 연결하는 프레임워크다. 전체 요약 9문장 읽기 → 088 15:11 ▲ 56 · 댓글 2 다중 플레이어 게임 세계를 효율적으로 생성하는 계층 통신 모델 다중 플레이어 인터랙티브 월드 모델은 여러 플레이어의 관점에서 공유 환경을 시뮬레이션해야 하지만, 플레이어 수가 증가할 때 강건한 생성을 유지하기 어렵다. AI · 머신러닝 · Multics: Generative Multi-Player World Model with Hierarchical Communication
Key Point 게임·메타버스 개발에서 많은 플레이어를 효율적으로 처리하는 영상 생성 기술의 확장성 문제를 푼 방법으로, 재학습 없이 여러 규모에 대응하고 계산 비용을 줄일 수 있다.
핵심 요약
다중 플레이어 인터랙티브 월드 모델은 여러 플레이어의 관점에서 공유 환경을 시뮬레이션해야 하지만, 플레이어 수가 증가할 때 강건한 생성을 유지하기 어렵다. 기존 방식(Solaris의 완전 연결 통신)은 플레이어 수에 따라 주의 비용이 이차적으로 증가하고, 중앙식 접근법(γ-World)은 공유 표현에서 무관한 이벤트 간 간섭 문제가 있다. Multics는 플레이어·그룹·전역 레벨에서 정보 교환을 구조화하는 계층 통신으로 이를 해결한다. 전체 요약 9문장 읽기 → 089 15:11 ▲ 50 · 댓글 1 확산 모델이 외부 도움 없이 자신을 개선하는 법 기존 연구에서 언어모델은 학생 파라미터로 구동하는 교사 네트워크의 도움으로 자체 평가 신호를 얻을 수 있음을 보였는데, 이를 확산 모델에 적용할 방법을 제시한다. AI · 머신러닝 · SALD: Self-Referenced Advantage Learning for Diffusion Models
Key Point 확산 모델의 학습을 더 효율적으로 만들 수 있는 새로운 기법으로, 추가 모델이나 파라미터 없이 모델 자신의 내부 신호만으로 성능을 개선할 수 있다는 점이 의미 있다.
핵심 요약
기존 연구에서 언어모델은 학생 파라미터로 구동하는 교사 네트워크의 도움으로 자체 평가 신호를 얻을 수 있음을 보였는데, 이를 확산 모델에 적용할 방법을 제시한다. SALD는 같은 모델으로 각 이미지-캡션 쌍을 두 가지 노이즈 수준에서 평가하는 자체 참조 학습 프레임워크다. 낮은 노이즈 경로는 그래디언트 추적 없이 평가되어 참조값을 제공하고, 높은 노이즈 경로는 학습 그래디언트를 생성한다. 전체 요약 8문장 읽기 → 090 21:11 당일 +233 AI 에이전트가 웹 데이터를 자유롭게 수집하는 Apify MCP 서버 Apify MCP 서버는 Claude, VS Code 등 AI 에이전트가 Apify Store의 8,000개 이상 스크래퍼·크롤러·자동화 도구를 MCP 프로토콜로 직접 사용하도록 연결한다. AI · 머신러닝 · apify/apify-mcp-server · TypeScript
Key Point AI 에이전트가 별도 도구 개발 없이 Apify 생태계의 수천 개 스크래퍼를 MCP 표준으로 직접 활용할 수 있게 되어, 데이터 추출 작업의 진입장벽이 크게 낮아졌다.
핵심 요약
Apify MCP 서버는 Claude, VS Code 등 AI 에이전트가 Apify Store의 8,000개 이상 스크래퍼·크롤러·자동화 도구를 MCP 프로토콜로 직접 사용하도록 연결한다. 소셜미디어, 검색엔진, 지도, 이커머스 등 모든 웹사이트에서 데이터를 추출할 수 있으며, OAuth를 지원해 Claude.ai나 VS Code에서 URL만으로 연결 가능하다. 호스팅 서버(mcp.apify.com)는 Streamable HTTP 전송을 사용하며 레거시 SSE 엔드포인트는 제거됐다. 전체 요약 12문장 읽기 → 091 15:11 ▲ 75 · 댓글 2 병렬 디코딩으로 시각 위치 추정을 빠르게—GroundAnything 논문 기존 자동 회귀(AR) 방식의 시각 그라운딩 모델은 위치 예측을 순차적으로 처리해서 지연 시간이 크다. AI · 머신러닝 · GroundAnything: Reconciling Parallel Decoding with Precise Visual Grounding at Flash Speed
Key Point 시각 위치 추정(visual grounding)의 속도와 정확성 양립 문제를 해결하는 새 방법론으로, 실시간 응용이 필요한 실무 시스템에서 바로 적용 가능한 기술입니다.
핵심 요약
기존 자동 회귀(AR) 방식의 시각 그라운딩 모델은 위치 예측을 순차적으로 처리해서 지연 시간이 크다. GroundAnything은 그라운딩을 '영상에서 시각 증거 추출'로 재정의하고, 개별 객체와 위치의 공간 관계가 좌에서 우로의 생성 순서를 따를 필요 없다고 본다. 이를 위해 양방향 확산(bidirectional diffusion) 방식을 적용해 공간 가설들을 병렬로 생성하고 반복 디노이징으로 공동 정제한다. 전체 요약 8문장 읽기 → 092 15:11 ▲ 261 · 댓글 2 로봇·자율주행용 '공간 인지' 기초 모델 GroundingPI 공개 Hugging Face와 arXiv의 공동 발표로, GroundingPI라는 40억 개 파라미터 크기의 기초 모델을 소개한다. AI · 머신러닝 · GroundingPI: A Grounding Foundation Model towards Physical Intelligence with Visual Primitives
Key Point 로봇 팔과 자율주행 자동차가 정확하고 빠르게 물체를 인식해야 하는데, 기존 범용 시각 모델 대신 공간 좌표 인식에 특화한 기초 모델을 쓰면 성능이 크게 오른다는 실증적 결과를 제시한다.
핵심 요약
Hugging Face와 arXiv의 공동 발표로, GroundingPI라는 40억 개 파라미터 크기의 기초 모델을 소개한다. 이 모델은 점과 박스 형태의 정량화된 좌표를 공유 어휘로 생성해, 혼잡한 환경과 작은 물체의 위치 파악을 빠르게 수행한다. 다중모달·공간 사전학습, 지도학습, GRPO 강화학습을 결합해 학습하며, 공개 데이터셋과 자체 데이터 엔진의 감시 신호를 활용했다. 전체 요약 8문장 읽기 → 093 03:11 ▲ 18 · 댓글 3 오프라인 학생 모델로 증류하는 것이 더 효과적인 경우가 많다 온폴리시 증류(OPD)가 교사 모델의 능력을 학생 모델에 전달하는 방식으로 널리 쓰이지만, 초기 학생 모델로 생성한 오프라인 롤아웃에서 증류하는 Semi-OPD가 많은 경우 OPD보다 우수한 성능을 보인다. AI · 머신러닝 · When Do We Need On-Policy Distillation? Distilling on Offline Student Rollouts Is Often Better
Key Point 증류 훈련의 핵심 선택지인 온폴리시 방식의 효과성을 재평가하는 논문으로, 더 간단하고 빠른 오프라인 방식이 많은 경우 더 나은 결과를 주는 상황을 규명한다.
핵심 요약
온폴리시 증류(OPD)가 교사 모델의 능력을 학생 모델에 전달하는 방식으로 널리 쓰이지만, 초기 학생 모델로 생성한 오프라인 롤아웃에서 증류하는 Semi-OPD가 많은 경우 OPD보다 우수한 성능을 보인다. 1.5B부터 235B 파라미터까지 17개의 교사-학생 쌍을 테스트한 결과, 14개 경우에서 Semi-OPD가 OPD를 능가했으며, 정확도 최대 13.6% 향상과 11.4배 훈련 속도 향상을 달성했다. 두 방식 중 어느 것을 선택할지는 교사와 학생의 정렬도에 따라 결정되며, 출력 토큰 겹침 비율로 측정할 수 있다. 전체 요약 5문장 읽기 → 094 21:11 당일 +333 마이크로소프트, 1비트 LLM 추론 프레임워크 공개 마이크로소프트가 1비트 LLM(BitNet b1.58)을 위한 공식 추론 프레임워크 bitnet.cpp를 출시했다. AI · 머신러닝 · microsoft/BitNet · C++
Key Point CPU만으로 초대형 언어 모델을 실용적 속도로 실행할 수 있게 되면서, 엣지 디바이스와 로컬 환경에서의 LLM 배포 방식이 근본적으로 바뀔 수 있다.
핵심 요약
마이크로소프트가 1비트 LLM(BitNet b1.58)을 위한 공식 추론 프레임워크 bitnet.cpp를 출시했다. x86 CPU에서 2.37~6.17배 속도 향상, ARM CPU에서 1.37~5.07배 향상을 달성하며 에너지 소비는 x86에서 71.9~82.2%, ARM에서 55.4~70.0% 감소한다. 100B 파라미터의 BitNet b1.58 모델을 단일 CPU에서 초당 5~7 토큰 속도로 실행 가능하다. 전체 요약 11문장 읽기 → 095 21:11 당일 +174 AI 에이전트가 답변을 상황별로 선택하는 오픈소스 채팅 UI CopilotKit 기반의 오픈소스 생성형 UI 프레임워크로, 질문에 따라 텍스트 답변·비교 표·3D 시각화·계산기 등 적합한 형식의 응답을 자동으로 제시한다. 웹 · 프론트엔드 · CopilotKit/OpenIntelligentUI · TypeScript
Key Point 생성형 UI로 AI 응답을 텍스트·표·도구로 자동 변환하는 패턴이 실제 프로덕션 앱에서 어떻게 구현되는지 확인할 수 있으며, 엔터프라이즈 유스케이스에 적용할 수 있는 기술 기초를 제공한다.
핵심 요약
CopilotKit 기반의 오픈소스 생성형 UI 프레임워크로, 질문에 따라 텍스트 답변·비교 표·3D 시각화·계산기 등 적합한 형식의 응답을 자동으로 제시한다. 사용자가 질문하면 Python Deep Agent가 작업 우선 시스템 프롬프트로 실행되어 가장 효과적인 응답 형식을 선택하고, CopilotKit이 Next.js 앱으로 스트리밍한다. 기본 테이블은 A2UI로, 차트·다이어그램·계산기·지도는 Open Generative UI(Jev 라우터)로 렌더링되며, 사용자는 프로젝트를 클론해 자신의 모델과 시각화 라우터를 연결할 수 있다. 전체 요약 11문장 읽기 → 096 21:11 당일 +202 마이크로소프트, 고품질 3D 생성 모델 TRELLIS.2 공개 마이크로소프트가 40억 개 파라미터 규모의 이미지-to-3D 생성 모델 TRELLIS.2를 공개했다. AI · 머신러닝 · microsoft/TRELLIS.2 · Python
Key Point 이미지 한 장에서 PBR 재질까지 포함한 완전한 3D 자산을 빠르게 생성할 수 있는 새로운 방식이 등장했으므로, 3D 콘텐츠 제작 워크플로우가 어떻게 바뀔 수 있을지 확인할 필요가 있다.
핵심 요약
마이크로소프트가 40억 개 파라미터 규모의 이미지-to-3D 생성 모델 TRELLIS.2를 공개했다. O-Voxel이라는 새로운 '필드 프리' 희소 복셀 구조를 사용하여 복잡한 위상, 예리한 특징, 완전한 PBR 재료를 가진 3D 자산을 생성한다. 512³ 해상도에서 약 3초(2초 형상 생성 + 1초 재질 생성), 1024³에서 약 17초, 1536³에서 약 60초가 소요된다. 전체 요약 12문장 읽기 → 097 15:11 ▲ 18 · 댓글 2 3D 재구성 모델의 거리 추정 능력을 평가하는 벤치마크 Pumpire 공개 Pumpire는 이미지와 비디오 기반 3D 파운데이션 모델의 포인트 간 거리 추정 능력을 통합 평가하는 벤치마크다. AI · 머신러닝 · Pumpire: Unified Benchmark for Metric Distance Estimation
Key Point 3D 모델의 정확한 거리 측정 능력을 처음으로 직접 평가하는 벤치마크로, 재구성 기하의 물리적 정확도 검증에 필수적인 기준을 제시한다.
핵심 요약
Pumpire는 이미지와 비디오 기반 3D 파운데이션 모델의 포인트 간 거리 추정 능력을 통합 평가하는 벤치마크다. 기존 깊이 맵과 카메라 내부 파라미터를 따로 평가하거나 기하학적 유사도 지표를 쓰는 방식과 달리, 재구성된 기하 정보에서 직접 포인트 간 거리 오류를 측정한다. 100개 실제 장면에서 물리적으로 측정한 포인트 쌍 거리를 주석 달고 장면마다 64프레임(총 6,400프레임)으로 구성한 대규모 데이터셋 pumpire-6k를 수집했다. 전체 요약 7문장 읽기 → 098 00:11 새 버전 Express v5.3.0 출시, HTTP 헤더 보안·보안 취약점 해결 Express 프레임워크 v5.3.0이 출시되었으며, res.send()에서 Content-Length와 Transfer-Encoding 헤더 충돌 문제를 수정해 HTTP 명세를 준수하도록 개선했다. 웹 · 프론트엔드 · expressjs/express@v5.3.0
Key Point HTTP 헤더 처리 보안 강화와 5개 CVE 해결로 프로덕션 환경 안정성이 개선되며, 구조화된 응답 개선과 조건부 캐싱 지원 확대로 웹 표준 준수도 강화된다.
핵심 요약
Express 프레임워크 v5.3.0이 출시되었으며, res.send()에서 Content-Length와 Transfer-Encoding 헤더 충돌 문제를 수정해 HTTP 명세를 준수하도록 개선했다. qs, proxy-addr, body-parser, content-type 등 주요 의존성을 업그레이드하여 CVE-2026-2391, CVE-2026-82417, CVE-2026-82562, CVE-2026-90711, CVE-2026-12590 등 5개의 보안 취약점을 해결했다. req.fresh가 이제 QUERY 요청도 검증하도록 확장되어, 조건부 요청(If-None-Match 등)이 있을 때 304 Not Modified 응답을 정상 반환한다. 전체 요약 8문장 읽기 → 099 16:56 ▲ 129 · 댓글 2 토큰 단위 LLM 라우팅을 위한 고효율 서빙 시스템 LLM 라우팅은 추론 작업을 여러 모델에 분산해 비용과 품질 사이의 최적점을 개선하는 기술로, 기존 시스템은 쿼리 단위의 굵은 라우팅만 지원했다. AI · 머신러닝 · TokenRouter: Efficient Serving System for Token-Level LLM Routing
Key Point 토큰 단위로 여러 모델을 동적으로 선택하는 고급 라우팅 기법을 실제로 빠르게 처리할 수 있는 시스템이 처음 등장했기 때문이다.
핵심 요약
LLM 라우팅은 추론 작업을 여러 모델에 분산해 비용과 품질 사이의 최적점을 개선하는 기술로, 기존 시스템은 쿼리 단위의 굵은 라우팅만 지원했다. 최근 연구는 토큰 단위의 세밀한 라우팅이 효율성과 품질에서 큰 이득을 줄 수 있음을 보였지만, 기존 LLM 서빙 시스템은 단일 모델 가정 위에 설계되어 토큰 단위 라우팅에서 심각한 동기화 문제와 배치 지연을 겪는다. TokenRouter는 요청 중심 프로그래밍, 모델 중심 실행 원칙을 따르며, 개발자는 단일 요청 관점에서 라우팅 로직을 기술하고 런타임이 각 LLM마다 서브서버를 실행해 비동기로 요청을 분배한다. 전체 요약 6문장 읽기 → 100 15:13 ▲ 20 · 댓글 3 장시간 자율 에이전트의 중요 결정 추적, EBG 방식 제안 에이전트가 장시간 작업을 수행할 때 사용자는 개별 의사결정에서 자율 실행 감시로 전환하는데, 방대한 에이전트 활동과 증거의 분산으로 인해 검증이 필요한 결정을 파악하기 어렵다. AI · 머신러닝 · What Did the Agent Actually Do? Evidence-Grounded Oversight for Long-Horizon Agents
Key Point AI 에이전트가 장시간 독립적으로 작업할 때 사용자가 무엇을 해야 하는지 알 수 없는 문제를 해결하는 기술이 등장했기 때문입니다.
핵심 요약
에이전트가 장시간 작업을 수행할 때 사용자는 개별 의사결정에서 자율 실행 감시로 전환하는데, 방대한 에이전트 활동과 증거의 분산으로 인해 검증이 필요한 결정을 파악하기 어렵다. 연구팀은 중요한 결정을 식별하고 증거를 위치시켜 사용자의 판단을 돕는 모니터를 연구했다. 소프트웨어 엔지니어링 벤치마크 AgentMonBench를 소개하며, 요구사항과 동작의 정렬, 검증을 위한 중요 자율 결정의 인식이라는 두 측면을 다룬다. 전체 요약 6문장 읽기 →