쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3647건
100건 (최대치) · "루프"조건 지우기 ×
001 18:11 ▲ 100 · 댓글 63 C에서 배열을 역순으로 순회하는 올바른 방법 배열을 역순으로 순회할 때 많은 개발자가 실수하는 패턴들이 있습니다. 오픈소스 · 도구 · Iterating Backwards in C
Key Point 배열 역순 순회는 자주 나타나는 패턴인데, 부호 없는 정수 언더플로우의 미묘한 문제를 다루고 있어 C 개발자가 알아야 할 실용적인 지식입니다.
핵심 요약
배열을 역순으로 순회할 때 많은 개발자가 실수하는 패턴들이 있습니다. 부호 없는 정수(size_t)에서 count-1부터 시작해 i >= 0 조건으로 감소시키는 방식은 작동하지 않습니다. i >= 0은 unsigned 타입에서 항상 참이므로 무한 루프가 되고, count가 0이면 i는 즉시 SIZE_MAX로 언더플로우됩니다. 전체 요약 9문장 읽기 → 002 15:11 ▲ 42 · 댓글 1 모델이 스스로 배우는 시점을 판단하다 재귀적 자기개선(recursive self-improvement)에서 모델은 유용한 학습 경험을 얻는 것뿐 아니라 언제 새로운 경험이 필요한지 판단해야 한다. AI · 머신러닝 · A-RSI: Adaptive Task Refresh for Zero-Data Multimodal Self-Improvement
Key Point 모델 스스로 데이터를 생성하며 학습하는 자기개선 시스템에서, 언제 새 학습이 필요한지 자동으로 판단하는 기법이 벤치마크에서 성능 향상을 달성했기 때문이다.
핵심 요약
재귀적 자기개선(recursive self-improvement)에서 모델은 유용한 학습 경험을 얻는 것뿐 아니라 언제 새로운 경험이 필요한지 판단해야 한다. 기존 방식들은 다음에 무엇을 학습할지에 집중했지만, 언제 새 경험을 도입할지는 충분히 다루지 않았다. 또한 자기 일관성이나 다수결로 학습 목표를 만들어 감독 신호가 모델의 불확실한 예측에 의존하는 문제가 있다. 전체 요약 9문장 읽기 → 003 12:11 ▲ 148 · 댓글 8 라즈베리파이 피코에서 신경망 게임 엔진 구현 임베디드 마이크로컨트롤러인 라즈베리파이 피코 2 W에서 신경망 기반 게임 엔진을 구현했다. 세계 모델 네트워크가 현재 프레임과 액션에서 다음 프레임과 보상을 예측하고, 액터 네트워크가 그 생성된 프레임에서 액션을 선택한다. AI · 머신러닝 · A tiny world model running games on a Raspberry Pi Pico 2 W
Key Point 라즈베리파이 같은 극도로 제한된 임베디드 환경에서 신경망으로 게임을 생성하고 플레이하는 새로운 방식이 작동한다는 것을 보여주며, 마이크로컨트롤러에서 머신러닝 모델을 실행하는 방법의 한계를 재정의한다.
핵심 요약
임베디드 마이크로컨트롤러인 라즈베리파이 피코 2 W에서 신경망 기반 게임 엔진을 구현했다. 세계 모델 네트워크가 현재 프레임과 액션에서 다음 프레임과 보상을 예측하고, 액터 네트워크가 그 생성된 프레임에서 액션을 선택한다. 반복 트랜스포머(looped transformer) 구조를 사용해 같은 가중치를 1~4회 반복 적용함으로써 메모리 효율을 높였다. 26k~131k 매개변수의 세계 모델과 9k~16k 매개변수의 액터 네트워크를 탑재했다. 브레이크아웃(정확도 99.99%), 플래피 버드(100%), 팩맨 라이트(86.4%) 등 5개 게임을 구현했으며, 각 게임은 토큰 기반으로 분할된 프레임을 처리한다. 세계 모델은 배경 셀은 독립적으로 예측하되, 공이나 플레이어 같은 단일체는 한 번만 배치되도록 디코딩 규칙을 적용했다. 전체 요약 12문장 읽기 → 004 21:11 당일 +169 NyaTerm, Rust로 만든 현대식 원격 터미널 워크스페이스 GPUI 기반의 네이티브 데스크톱 SSH 클라이언트로, SSH·로컬 셸·텔넷·시리얼·RDP·VNC를 모두 하나의 앱에서 지원한다. 오픈소스 · 도구 · nyakang/nyaterm · Rust
Key Point SSH 중심의 여러 원격 환경을 하나의 앱에서 통합 관리하고, AI 지원으로 명령어 생성과 다단계 작업을 자동화하려는 개발자와 시스템 관리자에게 필요한 도구다.
핵심 요약
GPUI 기반의 네이티브 데스크톱 SSH 클라이언트로, SSH·로컬 셸·텔넷·시리얼·RDP·VNC를 모두 하나의 앱에서 지원한다. 탭과 수평/수직 분할 패널로 여러 터미널 세션을 함께 관리할 수 있고, SFTP 파일 브라우저로 원격 파일 업로드·다운로드·편집 후 자동 업로드가 가능하다. AI 어시스턴트 패널이 내장되어 명령어 생성·터미널 출력 설명·에러 분석을 지원하고, 관찰-결정-실행 루프를 따르는 멀티스텝 에이전트 모드도 제공한다. 전체 요약 9문장 읽기 → 005 21:11 당일 +267 IDE에 연결된 Hermes 에이전트 오퍼레이션 레이어 공개 Oh-My-Hermes는 Hermes Agent의 운영 계층으로, 작업 카테고리(초고성능·심화·시각공학·신속 등)에 맞춰 각 레인에 최적의 모델과 추론 난이도를 자동 선택한다. AI · 머신러닝 · rlaope/oh-my-hermes · Python
Key Point Hermes 에이전트를 IDE에서 효율적으로 운영하려는 개발자들에게, 자동 모델 선택·병렬 실행·통합 검증 체계를 한 번에 제공하는 실무 도구가 공개되었다.
핵심 요약
Oh-My-Hermes는 Hermes Agent의 운영 계층으로, 작업 카테고리(초고성능·심화·시각공학·신속 등)에 맞춰 각 레인에 최적의 모델과 추론 난이도를 자동 선택한다. dag-ulw 명령어로 목표를 작은 노드의 그래프로 변환하면 준비된 노드들이 병렬로 실행되며, 같은 파일을 수정하는 노드는 동시 실행되지 않는다. 프론트엔드·백엔드·Rust·보안 리뷰 등 100개 이상의 omh-* 전문 스킬을 라우터가 자동으로 적재하며, 사용자가 명시적으로 호출할 필요는 없다. 전체 요약 14문장 읽기 → 006 00:11 ▲ 18 · 댓글 2 자동 정리 증명, 복잡한 워크플로우보다 단순 반복 루프가 더 효과적 형식 정리 증명(formal theorem proving) 분야는 계획, 분해, 전문 도구 연계 등 인간이 설계한 복잡한 워크플로우에 의존해왔으나, 비형식 수학은 대규모 언어 모델의 연쇄 추론으로 진전을 이뤄왔다. AI · 머신러닝 · h1: A Taste of the Bitter Lesson in Automated Theorem Proving
Key Point 자동화된 정리 증명에서 복잡한 설계 워크플로우 대신 단순한 에이전트 루프가 더 효과적일 수 있다는 발견은, 향후 형식 검증 시스템을 어떻게 구축할 것인지에 대한 근본적인 접근 방향을 바꿀 수 있다.
핵심 요약
형식 정리 증명(formal theorem proving) 분야는 계획, 분해, 전문 도구 연계 등 인간이 설계한 복잡한 워크플로우에 의존해왔으나, 비형식 수학은 대규모 언어 모델의 연쇄 추론으로 진전을 이뤄왔다. 이 논문은 '비터 레슨' 질문을 제기한다: 테스트 타임 계산을 확장하는 단순한 에이전트 루프가 이런 복잡한 워크플로우와 경쟁할 수 있는가? h1이라는 단순한 도구를 개발했는데, 이는 모델에게 Lean 4의 효율적인 인터페이스를 제공하고 검증자 피드백과 자기 성찰로 작동하며, 명시적 분해나 탐색 구조를 강요하지 않는다. 전체 요약 7문장 읽기 → 007 00:11 ▲ 101 · 댓글 15 Java 코드를 Lisp에서 직접 실행하는 OpenLDK 런타임 Common Lisp으로 작성된 JIT 컴파일러인 OpenLDK는 Java 바이트코드를 읽어 Lisp으로 번역한 뒤 SBCL을 통해 네이티브 코드로 컴파일하며, Java 객체와 Lisp 애플리케이션이 동일 프로세스·힙에서 살아간다. 인프라 · 데브옵스 · OpenLDK: Bringing the Java World into Common Lisp
Key Point Java 라이브러리를 Common Lisp 애플리케이션과 통합해야 하는 개발자에게는 새로운 선택지를 제시하고, 각 JVM 언어를 하나의 식 안에서 연결하는 폴리글롯 프로그래밍의 가능성을 보여준다.
핵심 요약
Common Lisp으로 작성된 JIT 컴파일러인 OpenLDK는 Java 바이트코드를 읽어 Lisp으로 번역한 뒤 SBCL을 통해 네이티브 코드로 컴파일하며, Java 객체와 Lisp 애플리케이션이 동일 프로세스·힙에서 살아간다. 클래스 로드 시 OpenLDK가 CLOS 표현을 만들고 메서드 스텁을 설치하며, 메서드 첫 호출 시 바이트코드→중간표현→Lisp→네이티브 코드 순으로 컴파일되고 스텁을 대체한다. Java 필드는 CLOS 슬롯이 되고, 인스턴스 메서드는 CLOS 제네릭 함수의 메서드가 되며, 정적 메서드는 일반 Lisp 함수가 되고, Java 예외는 Lisp 조건 계층구조에 대응된다. 전체 요약 13문장 읽기 → 008 18:11 ▲ 30 · 댓글 3 루핑 트랜스포머의 역전파 자르기, 규모 법칙으로 최적값 찾다 루핑 트랜스포머는 공유 레이어 블록을 반복 사용해 학습 가능한 매개변수 수는 유지하면서 계산 깊이를 늘리는 구조이며, 역전파 시간(BPTT)으로 학습된다. AI · 머신러닝 · Truncate or Not? A Scaling Study of Looped Transformers with Truncated Backpropagation
Key Point 루핑 트랜스포머의 학습에서 계산량 절약을 위한 역전파 자르기가 실제로 최적인지를 대규모 실험으로 체계적으로 검증한 결과로, 효율성과 성능의 트레이드오프를 명확히 한다.
핵심 요약
루핑 트랜스포머는 공유 레이어 블록을 반복 사용해 학습 가능한 매개변수 수는 유지하면서 계산 깊이를 늘리는 구조이며, 역전파 시간(BPTT)으로 학습된다. 학습 계산량을 줄이기 위해 BPTT를 최근 몇 루프로 잘라내는 방식이 흔하지만, 잘라냄으로 인한 기울기 편향이 루핑의 이점을 약화시킬 수 있다. 연구팀은 약 600번의 학습 실행을 통해 모델 크기, 학습 토큰 수, 정방향·역방향 루프 횟수를 함께 변화시켜 루핑과 잘라냄의 효과를 포착하는 통합 규모 법칙을 도출했다. 전체 요약 8문장 읽기 → 009 15:11 ▲ 22 · 댓글 5 MoE 모델의 채널 선택, 보정 데이터 없이 가능 Mixture-of-Experts(MoE) 모델은 대화형 디코딩 중 라우팅된 전문가 가중치를 메모리에서 로드할 때 병목을 겪으며, 채널 선택기는 각 토큰에 실질적으로 영향을 주는 채널만 읽어 이를 완화한다. AI · 머신러닝 · Channel Selection for Mixture-of-Experts Decoding Needs No Calibration Data
Key Point 현재 MoE 모델 최적화의 표준인 보정 기반 임계값이 예산 보장과 성능 향상을 모두 충족하지 못하며, 보정 없는 top-k와 경량 리더로 더 안정적이고 빠른 디코딩을 달성할 수 있음을 보여준다.
핵심 요약
Mixture-of-Experts(MoE) 모델은 대화형 디코딩 중 라우팅된 전문가 가중치를 메모리에서 로드할 때 병목을 겪으며, 채널 선택기는 각 토큰에 실질적으로 영향을 주는 채널만 읽어 이를 완화한다. 기존 방식은 오프라인 데이터로 보정한 임계값을 사용하지만, 임계값을 통과하는 채널 수는 입력마다 달라져 실제 읽기 예산이 불안정하다: Prox는 18% 읽기 예산으로 보정되었으나 실제로는 평균 12.9%만 읽는다. Top-k 방식은 각 토큰의 k개 최고점수 채널을 선택하며 보정 데이터가 필요 없다. 전체 요약 8문장 읽기 → 010 03:11 ▲ 28 · 댓글 2 LLM 연구 에이전트가 만든 하스스톤 AI, 최상위 플레이어 능가 LLM 연구 에이전트들로 구성된 자기개선 시스템 AutoTavern이 8인 자동배틀게임 하스스톤 배틀그라운드의 완전한 시뮬레이터를 20일 만에 개발했다. AI · 머신러닝 · Build, Don't Play: Self-Improving LLM Research Agents Develop a Hearthstone Battlegrounds AI That Rivals Top Players
Key Point LLM 에이전트가 자동 개선 루프를 통해 최첨단 게임 AI를 개발하고 인간 최강자를 능가한 사례로, 에이전트 연구의 현실적 가능성과 한계를 보여줍니다.
핵심 요약
LLM 연구 에이전트들로 구성된 자기개선 시스템 AutoTavern이 8인 자동배틀게임 하스스톤 배틀그라운드의 완전한 시뮬레이터를 20일 만에 개발했다. AutoTavern은 특화된 LLM 에이전트들이 타입화된 연구 메모리를 공유하고, 모든 주장이 검증 단계를 거치며, 실제 게임을 통해 피드백 루프가 닫혀 있어 시뮬레이터, 상대 AI, 정책, 연구 과정까지 동시에 개선된다. TavernAgent는 PPO로 학습되어 23개 버전을 거쳤으며, 실제 게임 래더에서 등급이 6,000에서 약 15,000으로 올랐다. 전체 요약 7문장 읽기 → 011 00:11 ▲ 31 · 댓글 2 LLM 에이전트 자체 학습 능력 강화법 제시 LLM 에이전트가 모델 파라미터를 업데이트하지 않고 실행 경험에서 학습하는 harness self-evolution에서, 같은 스킬이 강한 모델과 약한 모델에 미치는 영향이 크게 다르다는 문제를 발견했다. AI · 머신러닝 · Evolving to Match Capabilities: Improving Harness Self-Evolution via Skill Adaptation
Key Point 약한 LLM 모델의 성능 저하 문제를 스킬 적응으로 해결하는 구체적인 방법론이 제시되어, 실무에서 다양한 규모의 언어 모델을 배포하는 개발자들이 자체 학습 효율을 크게 높일 수 있다.
핵심 요약
LLM 에이전트가 모델 파라미터를 업데이트하지 않고 실행 경험에서 학습하는 harness self-evolution에서, 같은 스킬이 강한 모델과 약한 모델에 미치는 영향이 크게 다르다는 문제를 발견했다. 7개 모델과 3개 벤치마크에서 103개의 작업-스킬 조합을 분석한 결과, 어떤 스킬은 GPT-5.6-luna의 성능을 31.1점 높였지만 Gemma-4-E4B의 성능을 8.8점 낮췄다. 약한 모델의 실패 사례 86%에서 스킬 자체에 이미 명시된 요구사항을 위반했으므로, 실행자의 능력에 맞게 스킬을 재작성하는 skill adaptation을 제안했다. 전체 요약 7문장 읽기 → 012 21:11 ▲ 43 · 댓글 2 장편 비디오도 정확히 3D 복원하는 계층 포즈 그래프 딥러닝 모델로 짧은 비디오에서 카메라 움직임과 3D 기하를 정확히 추정할 수 있지만, 수천 개 프레임의 긴 영상은 계산량과 메모리 문제로 겹치는 청크(chunk) 단위로 나눠 처리해야 한다. AI · 머신러닝 · HiP3R: Hierarchical Pose Graphs for Long-Horizon 3D Reconstruction
Key Point 긴 비디오의 3D 복원에서 지역 최적화와 전역 일관성 사이의 근본적 트레이드오프를 계층 구조로 해결한 방법으로, 자율주행·로봇·공간 매핑 등 실제 응용에서 필요한 기술이다.
핵심 요약
딥러닝 모델로 짧은 비디오에서 카메라 움직임과 3D 기하를 정확히 추정할 수 있지만, 수천 개 프레임의 긴 영상은 계산량과 메모리 문제로 겹치는 청크(chunk) 단위로 나눠 처리해야 한다. 이 방식은 각 청크마다 독립적인 3D 복원을 만들어 좌표계가 일치하지 않고 카메라 위치가 중복으로 추정되는 문제가 발생한다. 인접한 청크와 멀리 떨어진 재방문 지점에서의 제약 조건을 전파해 전역 일관성을 맞춰야 하는데, 이는 포즈 그래프 최적화로 자연스럽게 해결된다. 전체 요약 6문장 읽기 → 013 15:11 ▲ 123 · 댓글 2 사람의 물리적 행동을 돕는 AI 어시스턴트 평가 벤치마크 공개 착용형 기기의 다중모달 대형언어모델(MLLM) 어시스턴트가 사용자를 가이드하고 지시하는 상황을 평가하기 위해 InteractiveWorld라는 검증 가능한 환경을 제안했다. AI · 머신러닝 · InteractiveWorld: A Verifiable Human-Centric Environment for Building Better Interactive MLLM Assistants
Key Point 지능형 어시스턴트가 실제로 사람의 물리적 작업을 도울 수 있는지 검증할 수 있는 표준화된 평가 체계가 처음 등장했으며, 현재 최신 모델들의 성능 한계가 명확히 드러났기 때문이다.
핵심 요약
착용형 기기의 다중모달 대형언어모델(MLLM) 어시스턴트가 사용자를 가이드하고 지시하는 상황을 평가하기 위해 InteractiveWorld라는 검증 가능한 환경을 제안했다. 기존 로봇 중심 시뮬레이터와 달리 InteractiveWorld는 AI 어시스턴트가 사람 에이전트에게 지시하고, 사람이 관찰·이해·독립적으로 행동하는 폐루프 상호작용을 현실적으로 모의한다. 어시스턴트의 명령이 실제 결과를 좌우하며, 상태 기반 리워드로 검증 가능하게 채점되는 방식이다. 전체 요약 6문장 읽기 → 014 12:11 ▲ 28 · 댓글 2 로봇 모방학습을 위한 다양한 시연 자동 발굴 기법 로봇 조작 작업의 행동 복제(Behavior Cloning)는 학습 데이터 커버리지에 민감하지만, 다양한 성공 시연 수집은 비용이 높다. AI · 머신러닝 · DiscoDemo: Discovering Efficient and Diverse Robot Demonstrations for Imitation Learning
Key Point 로봇 모방학습의 데이터 커버리지 문제를 해결하는 실용적 방법론으로, 시뮬레이션과 실제 로봇 모두에서 성공률을 크게 향상시키는 구체적 성과를 보여준다.
핵심 요약
로봇 조작 작업의 행동 복제(Behavior Cloning)는 학습 데이터 커버리지에 민감하지만, 다양한 성공 시연 수집은 비용이 높다. 연구팀이 강화학습(RL)을 배포 가능한 제어기가 아닌 하위 시각-운동 모방학습용 데이터 생성기로 활용하는 접근법을 제시했다. 여러 성공 해결책이 단일 방식을 반복 수집할 때보다 더 넓은 범위의 성공적 궤적을 포괄한다는 게 핵심 가정이다. 전체 요약 8문장 읽기 → 015 09:11 ▲ 101 · 댓글 56 추상화의 천재 폰노이만, 20세기를 설계하다 1903년 헝가리 태생 수학자 존 폰노이만(1903-1957, 53세)은 집합론, 양자역학 수학적 기초, 게임 이론, 최초의 저장형 프로그램 컴퓨터 구조, 수치 기상 예보, 자기복제 오토마타 등 근 20개 분야를 개척했고, 모든 현대 컴퓨터는 그가 1945년 설계한 폰노이만 구조(명령어와 데이터를 한 메모리에 저장)를 따른다. AI · 머신러닝 · A Man from the Future: Why Johnny Can't Stop Abstracting
Key Point 추상화를 통해 20세기 과학과 컴퓨팅을 동시에 건설한 폰노이만의 사고 방식이 오늘날 AI·기후·핵 위협을 마주한 우리에게 무엇을 말하는지 보여주기 때문이다.
핵심 요약
1903년 헝가리 태생 수학자 존 폰노이만(1903-1957, 53세)은 집합론, 양자역학 수학적 기초, 게임 이론, 최초의 저장형 프로그램 컴퓨터 구조, 수치 기상 예보, 자기복제 오토마타 등 근 20개 분야를 개척했고, 모든 현대 컴퓨터는 그가 1945년 설계한 폰노이만 구조(명령어와 데이터를 한 메모리에 저장)를 따른다. 6세에 8자리 수를 암산으로 나누고 고대 그리스어로 대화했으며, 한 번 읽은 책은 모두 기억했다는 평판이 있었다. 아버지 막시는 저녁 식탁을 세미나처럼 운영해 가족이 철학·역사·정치 등 폭넓은 주제를 토론하게 했고, 여러 언어 능력은 미래 망명을 대비한 아버지의 의도였다. 헝가리 고등학교 수학 교사 라슬로 라츠는 그를 가르칠 수 없다고 판단해 스탠포드 수학과장이 될 가보르 세게를 개인교사로 붙였다. 세게는 첫 수업 후 울면서 학생의 능력에 압도당했다고 전했다. 전체 요약 14문장 읽기 → 016 09:11 ▲ 192 · 댓글 145 메모리 안전성과 성능을 모두 잡은 구스 언어 공개 Goose는 힙 할당자, 가비지 컬렉터, 라이프타임 애너테이션이 없는 메모리 안전 시스템 언어로, C와 Rust 문법을 따릅니다. 오픈소스 · 도구 · The Goose Programming Language
Key Point 힙 할당·가비지 컬렉션·라이프타임 문법을 모두 제거하면서도 안전성을 보장해 C++과 Rust보다 빠르고 메모리 효율적인 새로운 시스템 언어 설계가 실제로 동작하는 방식을 보여줍니다.
핵심 요약
Goose는 힙 할당자, 가비지 컬렉터, 라이프타임 애너테이션이 없는 메모리 안전 시스템 언어로, C와 Rust 문법을 따릅니다. 벤치마크 16개 기준 구스는 일반적인 C++보다 3.3배, 손으로 최적화한 C++보다 1.16배, 안전한 Rust보다 1.12배 빠르면서 메모리는 1.9배, 1.3배, 1.2배 적게 씁니다. 컴파일러가 정적으로 할당하는 데이터 스택 위에 모든 동적 값이 인라인으로 살며, 스코프 끝에서 한 번의 저장 명령으로 메모리가 해제됩니다. 전체 요약 12문장 읽기 → 017 00:11 ▲ 112 · 댓글 34 VLC 가우시안 블러 필터를 C와 C#으로 경주시켜봤다 VLC 4의 가우시안 블러 필터를 C 원본과 C# 포트의 성능 비교하기 위해 동일한 환경에서 테스트했다. 인프라 · 데브옵스 · C vs. C#: racing VLC's Gaussian blur
Key Point C# .NET AOT는 CPU 집약적 비디오 필터에서 C 대비 8~10% 수준으로 경쟁력 있으며, 컴파일러 최적화로 격차를 더 줄일 수 있다는 점이 주목할 만하다.
핵심 요약
VLC 4의 가우시안 블러 필터를 C 원본과 C# 포트의 성능 비교하기 위해 동일한 환경에서 테스트했다. 라인 바이 라인 포트에서 C# 버전은 약 23% 더 느렸는데, 원인은 가비지 컬렉터가 아니라 RyuJIT 코드 생성기가 Math.Min을 매 루프마다 재계산하기 때문이다. 루프 경계를 사전 계산하고 nint 인덱스를 사용하는 두 줄의 수정으로 C# 성능을 8% 범위 내로 개선했다. 전체 요약 12문장 읽기 → 018 12:10 ▲ 106 · 댓글 26 구글 제미나 모델의 추론 토큰 39% 줄이면서 성능 유지 BottleCapAI가 구글의 Gemma-4-26B-A4B 모델을 최적화한 ThinkingCap 버전을 공개했다. AI · 머신러닝 · Gemma-4-26B-A4B with 39-69% less thinking at same accuracy
Key Point 추론 단계를 줄이면서도 정확도를 유지하는 최적화 기법이 실제로 작동함을 보여주므로, LLM 배포 비용과 지연시간을 줄이려는 팀들의 실질적 선택지가 확보된다.
핵심 요약
BottleCapAI가 구글의 Gemma-4-26B-A4B 모델을 최적화한 ThinkingCap 버전을 공개했다. 추론 토큰을 평균 38.9% 줄였으며 최대 69.1%까지 감소시킨 벤치마크도 있다. 12개 벤치마크 평균 정확도는 75.18%에서 75.03%으로 0.15pp만 하락했다. 전체 요약 12문장 읽기 → 019 21:11 당일 +599 강화학습으로 움직이는 오리 로봇, 마이크로덕 공개 폴렌 로보틱스가 높이 약 25cm, 무게 800g의 양다리 오리 로봇 마이크로덕의 제어 소프트웨어를 공개했다. 하드웨어 · 시스템 · pollen-robotics/microduck · Rust
Key Point 강화학습으로 훈련된 신경망 정책을 탑재한 로봇의 전체 소프트웨어 아키텍처와 개발 방식을 공개함으로써, 소형 이족 보행 로봇의 제어·배포·업그레이드 파이프라인을 어떻게 구현할 수 있는지 보여준다.
핵심 요약
폴렌 로보틱스가 높이 약 25cm, 무게 800g의 양다리 오리 로봇 마이크로덕의 제어 소프트웨어를 공개했다. Rockchip RK3566 프로세서 위에서 15개 서보 모터를 제어하는 50Hz 제어 루프를 포함하며, 라디오·카메라·자동 업데이트 시스템 등 완전한 로봇 운영 체계를 담고 있다. 행동 정책은 MuJoCo 시뮬레이터와 PPO 강화학습, 시뮬레이션 투 리얼(sim2real) 기법으로 훈련한 후 ONNX 형식으로 변환되어 로봇에 로드된다. 전체 요약 8문장 읽기 → 020 06:11 ▲ 12 · 댓글 2 LLM 에이전트의 메모리 피드백 악순환, 새로운 설계로 극복 LLM 에이전트가 외부 메모리에 실행 경험을 저장해 이후 결정을 가이드할 때, 단순 궤적과 결과뿐 아니라 추론된 규칙·요약·스킬도 함께 보관할지가 핵심 설계 문제다. AI · 머신러닝 · More Memory, Worse Agents: Error Reproduction and Anti-Persistence in LLM Agents
Key Point 메모리를 크게 할수록 에이전트 성능이 악화되는 역설적 현상을 설명하고, 오류가 자동 증폭되는 메커니즘을 밝혀 LLM 에이전트 설계의 근본 문제를 제시합니다.
핵심 요약
LLM 에이전트가 외부 메모리에 실행 경험을 저장해 이후 결정을 가이드할 때, 단순 궤적과 결과뿐 아니라 추론된 규칙·요약·스킬도 함께 보관할지가 핵심 설계 문제다. 추상화된 정보를 저장하면 원시 궤적에서 매번 유도할 필요 없이 전략을 재사용할 수 있지만, 저장된 추상화의 오류가 검색·재사용을 통해 후속 결정에 전파될 수 있다. 더 큰 문제는 '오류 재현(error reproduction)'이라는 피드백 루프다: 저장된 결함 있는 지식이 실행 궤적을 왜곡하고, 그 왜곡된 궤적에서 다시 추상화되며 원래 오류가 재생성되고 지속된다. 전체 요약 7문장 읽기 → 021 03:11 ▲ 26 · 댓글 1 LLM이 정량 트레이딩 전략을 실제로 만들 수 있을까 정량 트레이딩 연구는 가설 제안→신호 구현→역사 데이터 검증→전략 확정의 반복 루프인데, 기존 벤치마크는 공식이나 코드 개별 거래 결정만 평가해왔다. AI · 머신러닝 · Quant-Arena: Benchmarking LLM Agents for Quantitative Trading Research
Key Point 현재 최고 수준의 LLM들도 실제 시장 데이터에서 시계열 검증을 통과하는 거래 전략을 만들지 못하는 것으로 나타났으며, 이는 생성형 AI의 금융 적용 한계를 보여준다.
핵심 요약
정량 트레이딩 연구는 가설 제안→신호 구현→역사 데이터 검증→전략 확정의 반복 루프인데, 기존 벤치마크는 공식이나 코드 개별 거래 결정만 평가해왔다. Quant-Arena은 중국 A주 실제 시장 데이터로 LLM이 전체 루프를 완성하고 연구 기간 이후에도 작동하는 전략을 만들 수 있는지 측정하는 벤치마크와 공개 리더보드다. 모델은 특성과 주식 스코어링 코드를 구성하고, 2022~2023년 데이터로만 피드백을 받은 뒤, 폐쇄된 2024년 데이터로 평가받을 하나의 전략을 확정한다. 전체 요약 7문장 읽기 → 022 03:11 ▲ 142 · 댓글 64 Crystal 1.22 공개, DWARF 파서 대폭 개선 및 aarch64-linux Tier 1 승격 Crystal 1.22.0이 공개되었으며 33명의 기여자가 참여한 251개 변경사항을 포함한다. 오픈소스 · 도구 · Crystal 1.22
Key Point Crystal 언어의 성능 개선(특히 디버깅 정보 처리), 플랫폼 확장(ARM 리눅스 공식화), 그리고 HTTP/이벤트 루프 안정성 향상으로 프로덕션 환경에서의 적용성이 강화되었다.
핵심 요약
Crystal 1.22.0이 공개되었으며 33명의 기여자가 참여한 251개 변경사항을 포함한다. STDOUT/STDERR 쓰기 실패 시 SIGPIPE 신호처럼 즉시 종료되도록 변경되었으며, STDOUT.exit_on_broken_pipe = false로 비활성화 가능하다. 상수에 타입 선언을 지정할 수 있게 되었다(BAR : Int32 = 1). 전체 요약 13문장 읽기 → 023 21:11 ▲ 28 · 댓글 2 반복되는 작업을 스스로 학습하게 하는 에이전트 훈련법 Qwen, Llama, Gemini 등의 언어모델 에이전트가 장시간 작업 중 같은 도구를 재호출해 동일한 결과를 얻는 '루프' 현상을 보이고, 컨텍스트 압축 시 더 심해진다. AI · 머신러닝 · DeLoop: Repeated Actions as Self-Supervision for Long-Horizon Agents
Key Point 장시간 작업을 하는 AI 에이전트의 비효율을 근본적으로 줄일 수 있는 훈련 기법으로, 추가 라벨링 없이 에이전트 자신의 경험으로부터 학습하는 방식을 제시한다.
핵심 요약
Qwen, Llama, Gemini 등의 언어모델 에이전트가 장시간 작업 중 같은 도구를 재호출해 동일한 결과를 얻는 '루프' 현상을 보이고, 컨텍스트 압축 시 더 심해진다. DeLoop는 이런 루프를 줄이기 위한 자기지도 학습 방법으로, 에이전트 자신의 실행 기록에서 감독 신호를 얻는다. 같은 작업 실행 내에서 반복된 액션을 부정 사례, 그 이후 처음 나오는 다른 액션을 긍정 사례로 삼아 직접 선호도 최적화로 학습한다. 전체 요약 6문장 읽기 → 024 15:11 ▲ 155 · 댓글 2 한 손 조작 넘어 양손 협력까지, 범용 로봇 제어 모델 DONIC 기존 손가락 섬세한 조작 모델들은 단일 손 조작과 제한된 상호작용만 다뤄 일상의 양손 협력 작업을 못 다뤘다. AI · 머신러닝 · DONIC: Generalist Dexterous Bimanual Tracking Control from Human Demonstrations
Key Point 로봇이 두 손을 동시에 협력시켜 복잡한 조작 작업을 할 수 있도록 하는 첫 범용 모델로, 인간의 시연 영상만으로 학습할 수 있다는 점이 실용적 의미를 갖는다.
핵심 요약
기존 손가락 섬세한 조작 모델들은 단일 손 조작과 제한된 상호작용만 다뤄 일상의 양손 협력 작업을 못 다뤘다. 연구팀은 첫 범용 양손 추적기 DONIC과 229개 물체를 포함한 1,575개 시퀀스의 양손 상호작용 데이터셋 BiHOI를 공개했다. DONIC은 근처정책최적화(PPO)와 행동복제를 결합하고, 성공한 실행을 재훈련 데이터로 재활용하는 피드백 루프를 사용한다. 전체 요약 6문장 읽기 → 025 12:11 ▲ 36 · 댓글 2 AI 에이전트의 지속 학습을 위한 메모리 중심 프레임워크 기초 모델 기반 자율 에이전트는 추론·계획·도구 사용은 가능하지만 고정된 가중치와 컨텍스트 제한으로 장기 배포 중 경험 학습이 제약된다. AI · 머신러닝 · Memory-Centric Continual Learning for AI Agents
Key Point AI 에이전트가 장기 배포 중 경험으로부터 실제 학습하려면 메모리 평가 기준부터 바뀌어야 한다는 근본적인 전환을 제시한다.
핵심 요약
기초 모델 기반 자율 에이전트는 추론·계획·도구 사용은 가능하지만 고정된 가중치와 컨텍스트 제한으로 장기 배포 중 경험 학습이 제약된다. 외부 메모리 시스템은 대부분 수동적 검색 캐시 역할만 하며 저장된 사실이나 과거 상호작용 회상 여부만 평가되고 있다. 메모리가 진정한 지속 학습을 가능하게 하는지는 미해결 과제다. 전체 요약 8문장 읽기 → 026 12:11 ▲ 106 · 댓글 57 AI 에이전트 시대, 코드는 돌에서 진흙으로 AI 에이전트 코딩으로 코드 수정 비용이 급락하면서 코드는 '단단한 돌'에서 '유연한 진흙'으로 변했다. AI · 머신러닝 · Code is clay now
Key Point AI가 코드를 작성·수정하는 비용을 근본적으로 바꾸면서, 개발 방식의 선택지가 늘어나고 엔지니어링 판단력의 역할이 재정의되는 중이다.
핵심 요약
AI 에이전트 코딩으로 코드 수정 비용이 급락하면서 코드는 '단단한 돌'에서 '유연한 진흙'으로 변했다. 진흙처럼 가단한 코드는 전체 형태를 대충 만든 뒤 세부를 다듬듯이 반복 개선할 수 있어, 신제품 개념 검증을 하루 만에 끝내거나 피봇을 며칠 만에 시도할 수 있다. 변경이 거의 무료지만 '올바른' 변경인지 판단하는 일은 여전히 인간의 몫이며, 취향·아키텍처·가드레일 같은 판단력이 없으면 코드는 엉망이 된다. 전체 요약 7문장 읽기 → 027 06:11 ▲ 13 · 댓글 2 개방형 RL 학습 과정을 자동으로 조정하는 HarnessRL 제안 자연어 보상 기준을 사용한 개방형 생성 정책 학습(Rubric-based RL)은 훈련이 진행되면서 보상이 비효과적이 되는 문제를 겪는다. AI · 머신러닝 · HarnessRL: Co-Evolving Policies with a Just-in-Time Training Harness for Open-Ended RL
Key Point 개방형 과제를 통해 AI 모델을 훈련할 때 보상 신호의 붕괴와 오류를 자동으로 탐지하고 수정하는 메커니즘이 필요한 상황에서, 훈련 과정 자체를 동적으로 조정하는 접근이 효율성을 크게 개선할 수 있음을 보여준다.
핵심 요약
자연어 보상 기준을 사용한 개방형 생성 정책 학습(Rubric-based RL)은 훈련이 진행되면서 보상이 비효과적이 되는 문제를 겪는다. 점수가 균일하게 낮거나 높게 붕괴되는 비차별적 보상과 높은 점수가 실제 답변 품질과 맞지 않는 허위 보상이라는 두 가지 실패 양식이 존재한다. 이는 정책이 진화하면서도 작업 샘플링, 탐색, 평가 설정이 고정되어 있기 때문이다. 전체 요약 8문장 읽기 → 028 06:11 ▲ 12 · 댓글 2 확률 오차 줄이는 AI 에이전트 프레임워크 RiseHarness 장시간 작업을 수행하는 터미널 에이전트는 한 번은 성공하지만 반복 실행 시 실패하는 문제가 있으며, 확률적 오류가 액션과 컨텍스트를 거쳐 누적된다. AI · 머신러닝 · Harness Self-Evolution for Long-Horizon Terminal Agents
Key Point 모델 가중치를 고정하고 실행 로직만 개선해 AI 에이전트의 신뢰성을 높이는 새로운 접근법으로, 확률적 오류로 인한 작업 실패 문제를 체계적으로 해결하는 방법을 제시한다.
핵심 요약
장시간 작업을 수행하는 터미널 에이전트는 한 번은 성공하지만 반복 실행 시 실패하는 문제가 있으며, 확률적 오류가 액션과 컨텍스트를 거쳐 누적된다. RiseHarness는 모델 가중치를 고정한 채로 에이전트 하네스(harness)를 반복 개선하는 프레임워크로, 같은 설정에서 성공과 실패를 오가는 작업에 초점을 맞춘다. 런타임 모니터에서 수집한 내부 하네스 추적과 에이전트 궤적을 결합해 모델 액션이 명령 실행, 피드백, 컨텍스트 관리, 완료 결정과 어떻게 상호작용하는지 검토한다. 전체 요약 9문장 읽기 → 029 00:11 ▲ 22 · 댓글 4 장시간 작업용 LLM 에이전트, 실행 상태를 메모리처럼 재사용 장시간 작업을 수행하는 LLM 에이전트는 과거 상호작용 정보를 계속 참고해야 하지만, 전체 히스토리 보관은 맥락 비용을 늘리고 압축하면 필요한 세부사항을 잃을 수 있다. AI · 머신러닝 · FlowState: Execution State as Memory for Long-Horizon LLM Agents
Key Point 장시간 작업에서 LLM 에이전트의 맥락 길이 문제를 해결하는 새 방식이 기존 방법 대비 성능과 효율성 모두에서 실질적 개선을 보여주기 때문이다.
핵심 요약
장시간 작업을 수행하는 LLM 에이전트는 과거 상호작용 정보를 계속 참고해야 하지만, 전체 히스토리 보관은 맥락 비용을 늘리고 압축하면 필요한 세부사항을 잃을 수 있다. FlowState는 실행 상태를 메모리로 취급해 요청 간에 유지하고 재방문할 수 있으며, 의미론적으로 타입된 상태 노드·관계·도구 관찰 참조를 보존해 필요 시에만 접근하도록 분리한다. Incremental State Update(ISU)는 실행 루프 내에서 새 입력과 피드백에 따라 현재 상태를 유지하고, Progressive State Access(PSA)는 추론 중 필요에 따라 과거 상태와 근거를 점진적으로 공개한다. 전체 요약 5문장 읽기 → 030 00:11 ▲ 138 · 댓글 75 C#이 WebAssembly에서 Rust 꺾고 최소 용량 달성 NetWasm은 C# 코드를 WebAssembly로 직접 컴파일하는 독립형 컴파일러, 런타임, SDK로, 데스크톱 CLR이나 Mono를 포함하지 않는다. 웹 · 프론트엔드 · C# now beats Rust on WASM size
Key Point WebAssembly 배포 시 C#이 Rust보다 더 작은 바이너리를 생성할 수 있으며, 기존 Blazor의 256배 크기 문제를 획기적으로 개선한다.
핵심 요약
NetWasm은 C# 코드를 WebAssembly로 직접 컴파일하는 독립형 컴파일러, 런타임, SDK로, 데스크톱 CLR이나 Mono를 포함하지 않는다. 같은 작업(42 출력)을 기준으로 NetWasm은 47,895바이트, Rust 1.95.0 크기 최적화 프로필은 53,635바이트로, NetWasm이 10.7% 더 작고 Brotli-11 압축 후 19.5% 더 작다. 두 결과 모두 WASI Preview 2 Component 형태의 독립형 바이너리이며 각 도구의 표준 빌드 방식을 사용하며, NetWasm 수치는 정확한 가비지 컬렉터를 포함한다. 전체 요약 13문장 읽기 → 031 21:11 ▲ 102 · 댓글 19 LLM 에이전트로 시스템 모니터링 혁신하다 Anthropic은 Claude를 이용해 특정 시스템 컴포넌트 건강도를 전담하는 '슈퍼팬' 에이전트를 도입했으며, 이들은 기존 알림보다 미묘하고 새로운 문제를 더 잘 감지한다. AI · 머신러닝 · Agentic Monitoring
Key Point 시스템 규모 확대로 인한 운영 복잡도 증가 속에서 에이전트 기반 모니터링이 낮은 비용으로 정밀한 장애 감지와 대응을 가능하게 하며, 1년 이내 업계 표준이 될 가능성이 높기 때문이다.
핵심 요약
Anthropic은 Claude를 이용해 특정 시스템 컴포넌트 건강도를 전담하는 '슈퍼팬' 에이전트를 도입했으며, 이들은 기존 알림보다 미묘하고 새로운 문제를 더 잘 감지한다. 현대 소프트웨어 시스템은 설계된 것보다 성장하는 경향이 강해지고 있으며, 시스템 규모 증가로 운영자의 코드 이해도는 감소하고 있다. 기존 모니터링은 어렵고 비용이 많이 들며 숙련된 인력과 경험이 필요한데, 에이전트가 이 분야을 근본적으로 바꿀 수 있다. 전체 요약 14문장 읽기 → 032 03:11 ▲ 271 · 댓글 3 루프형 모델로 필요한 만큼만 생각하는 의사결정 AI 기존 의사결정 모델은 단일 포워드 패스로 한 번에 답을 내놓지만 계산 깊이가 학습 시점에 고정되어 쉬운 문제나 어려운 문제 모두 같은 연산량을 씀. AI · 머신러닝 · LEV: Thinking Fast and Deep with Looped Decision Models
Key Point 텍스트 생성 없이 레이어 루프로만 추론 깊이를 조절해 효율과 정확도를 동시에 확보하는 새로운 의사결정 모델 구조.
핵심 요약
기존 의사결정 모델은 단일 포워드 패스로 한 번에 답을 내놓지만 계산 깊이가 학습 시점에 고정되어 쉬운 문제나 어려운 문제 모두 같은 연산량을 씀. 텍스트 생성 방식 모델은 더 깊게 추론할 수 있지만 생성하는 토큰 수에 비례해 계산 비용이 늘어남. 논문이 제시한 LEV는 토큰 생성 대신 모델 레이어를 루프로 반복 실행해 더 깊은 추론을 구현함. 전체 요약 8문장 읽기 → 033 00:11 ▲ 112 · 댓글 11 역방향으로 메모리 안전을 검증하는 Valen 언어의 차별화된 차용 검사 Valen 언어는 함수를 역방향으로 순회하며 메모리 안전을 검증하는 독특한 차용 검사기(borrow checker)를 구현했다. 인프라 · 데브옵스 · A new way to think about borrow checking (in reverse)
Key Point 함수를 거슬러 올라가며 메모리 안전을 검증하는 방식은 기존 차용 검사기와 완전히 다른 접근이며, 루프 처리와 성능 면에서 전방향 순회보다 우월함을 보여준다.
핵심 요약
Valen 언어는 함수를 역방향으로 순회하며 메모리 안전을 검증하는 독특한 차용 검사기(borrow checker)를 구현했다. Valen 컴파일러는 정적 타입 지정, 정적 그룹화, 그리고 역방향 검사 총 4개 단계로 함수를 컴파일한다. 단계 3의 정적 그룹화는 참조가 어떤 데이터 구조의 어디를 가리키는지 파악하며, 이 정보가 변수의 타입에 포함된다. 전체 요약 10문장 읽기 → 034 12:11 ▲ 287 · 댓글 2 GPT-6-Astra, 로봇 지능의 한계 진단 GPT-6-Astra를 로봇 조작·항법 작업에 평가한 결과, 12개 벤치마크(탁상형 조작, 휴머노이드, 이동 로봇, 손가락 제어)에서 학습 데모로부터의 맥락 학습(ICL)을 활용해 전례 없는 성능을 달성했다. AI · 머신러닝 · Has GPT-6-Astra Achieved Embodied Intelligence?
Key Point 로봇 지능이 실험실 성과와 현장 적용 사이의 격차를 드러내므로, 다음 세대 로봇 AI 개발 방향을 예측하는 데 필요하다.
핵심 요약
GPT-6-Astra를 로봇 조작·항법 작업에 평가한 결과, 12개 벤치마크(탁상형 조작, 휴머노이드, 이동 로봇, 손가락 제어)에서 학습 데모로부터의 맥락 학습(ICL)을 활용해 전례 없는 성능을 달성했다. 향후 개선 방향으로 ICL의 일반화, 비용·실행 시간 단축, 물리 상태 검증, 불가역적 실패 복구, 장기 작업 진행 상황 유지 등 5가지를 제시했다. 고수준 추론기(GPT-6-Astra)와 저수준 제어기(π0.5) 간 폐루프 조율이 비용이 높지만 효과적임을 확인했다. 전체 요약 6문장 읽기 → 035 03:11 ▲ 130 · 댓글 10 마이크로 단위 3D 정밀 제어, 오픈소스로 누구나 만든다 오픈소스 마이크로 매니퓰레이터 프로젝트는 저가의 3축 XYZ 모션 제어 플랫폼으로 50nm 단위 정밀도를 달성하며 광학 정렬, 전자 부품 검사, 현미경 응용에 사용된다. 하드웨어 · 시스템 · Open MicroManipulator – A sub-micrometer 3D motion control plattform
Key Point 저비용으로 마이크로미터 단위 정밀도를 필요로 하는 광학, 전자공학, 미세 조작 작업을 독립적으로 구축할 수 있는 완전 오픈소스 솔루션이며, 세부 설계, 펌웨어, 제어 소프트웨어가 모두 공개되어 커스터마이징과 학습에 활용할 수 있다.
핵심 요약
오픈소스 마이크로 매니퓰레이터 프로젝트는 저가의 3축 XYZ 모션 제어 플랫폼으로 50nm 단위 정밀도를 달성하며 광학 정렬, 전자 부품 검사, 현미경 응용에 사용된다. 평행 운동학 구조와 미니어처 볼 조인트로 기계적 강성을 확보하고, 30kHz 폐루프 제어 스테핑 모터와 자성 기어링을 통해 저가 로터리 인코더 해상도를 30배 향상시킨다. USB 시리얼 인터페이스로 G-Code 명령을 지원하며 모션 플래닝 스택과 선형보간으로 부드럽고 정확한 경로 추종을 구현한다. 전체 요약 12문장 읽기 → 036 12:11 ▲ 107 · 댓글 20 클로드, 양자 회로 설계를 대폭 개선하다 앤스로픽은 Claude Mythos 5에게 화학, 최적화, 물리 시뮬레이션, 정수론의 8가지 양자 회로 설계 과제를 평문으로 제시하고, 자동 평가기가 정확성을 검증하고 큐빗·게이트 수로 채점하도록 했다. AI · 머신러닝 · Designing more efficient quantum circuits with Claude
Key Point 양자 컴퓨터의 실용화는 회로 설계 최적화에 달렸는데, Claude가 연구 그룹이 8년에 걸쳐 이룬 성과(FeMoco 게이트 150,000배 감소)를 53시간에 달성했다는 점이 양자 알고리즘 개발의 속도를 근본적으로 바꿀 수 있음을 보여준다.
핵심 요약
앤스로픽은 Claude Mythos 5에게 화학, 최적화, 물리 시뮬레이션, 정수론의 8가지 양자 회로 설계 과제를 평문으로 제시하고, 자동 평가기가 정확성을 검증하고 큐빗·게이트 수로 채점하도록 했다. Claude는 피드백 루프를 통해 폐쇄형으로 회로를 반복 설계했으며, 8가지 모두에서 이전의 최고 성능 회로보다 큐빗과 게이트 수를 줄인 새로운 설계를 발견했다. 첫 번째 사례는 타원곡선 암호 계산의 핵심인 모듈러 역수 문제로, Claude는 divsteps 알고리즘의 가지 정보(branch information)를 저장하지 않고 수치 쌍에서 직접 복원할 수 있음을 발견했다. 전체 요약 12문장 읽기 → 037 09:11 ▲ 10 · 댓글 2 로봇 비전-언어 모델에 사용자 맞춤과 안전 기능을 더하다 현재의 일반용 VLA(Vision-Language-Action) 모델은 다양한 로봇 조작을 가능하게 하지만, 실제 로봇 지원에 필요한 사용자 맞춤화와 신뢰성 있는 실행 능력이 부족하다. AI · 머신러닝 · CarryOn: A Dual-Loop Harness for Personalized and Reliable Robot Assistance
Key Point 실제 로봇 지원의 핵심인 사용자 맞춤화와 안전성 문제를 해결하는 구체적 방법론을 제시하며, 위반율 8.6배 감소, 복구 성공률 6배 증가라는 검증 가능한 결과를 보여준다.
핵심 요약
현재의 일반용 VLA(Vision-Language-Action) 모델은 다양한 로봇 조작을 가능하게 하지만, 실제 로봇 지원에 필요한 사용자 맞춤화와 신뢰성 있는 실행 능력이 부족하다. CarryOn은 기존 VLA 정책을 보강하는 이중 루프 시스템으로, 사용자 선호도와 장면 맥락을 유지하면서 상호작용을 통해 지속적으로 업데이트하는 '계획 루프'를 갖춘다. 계획 루프는 사용자의 지속적인 선호도를 반영하여 맞춤형 부분 작업을 선택하고, 대화와 변화하는 장면 속에서 실행을 조율한다. 전체 요약 7문장 읽기 → 038 21:11 당일 +338 자연어로 안드로이드 테스트 자동화를 가능하게 하는 구글 ARTEMIS 구글이 공개한 ARTEMIS는 자연어 지시를 안드로이드 기기의 실제 자동화 작업으로 변환하는 AI 보조 도구이다. AI · 머신러닝 · google/artemis · Python
Key Point AI 코딩 어시스턴트가 실제 안드로이드 기기를 자동으로 제어하고 테스트하는 방식이 크게 바뀔 수 있기 때문이다.
핵심 요약
구글이 공개한 ARTEMIS는 자연어 지시를 안드로이드 기기의 실제 자동화 작업으로 변환하는 AI 보조 도구이다. Antigravity, Codex, Claude Code 등 AI 코딩 어시스턴트와 seamless하게 통합되며, AndroidWorld 벤치마크에서 99% 이상의 성공률을 달성한다. 접근성 계층과 OCR, 시각 모델을 결합하여 캐시, Compose, Flutter 인터페이스 같은 커스텀 UI도 정확히 찾는다. 전체 요약 12문장 읽기 → 039 15:11 ▲ 17 · 댓글 2 자동주행 AI, 시뮬레이션으로 가상 주행 영상 학습 자동주행 세계 액션 모델(WAM)은 실제 주행 로그에서 기록된 궤적에 대한 영상 데이터만 갖고 있어, 강화학습으로 탐색한 대안적 궤적에는 시각적 감독이 없다. AI · 머신러닝 · SimVTA: Simulation-Grounded Video-Trajectory Alignment for Driving World Action Models
Key Point 자동주행 AI가 시뮬레이션으로 생성한 가상 영상을 학습 데이터로 사용해 강화학습 후보 궤적도 감독할 수 있게 되어, 제한된 실제 데이터만으로도 계획 성능을 5% 이상 향상시킬 수 있다.
핵심 요약
자동주행 세계 액션 모델(WAM)은 실제 주행 로그에서 기록된 궤적에 대한 영상 데이터만 갖고 있어, 강화학습으로 탐색한 대안적 궤적에는 시각적 감독이 없다. SimVTA는 이 문제를 해결하기 위해 시뮬레이션 기반 사후훈련 프레임워크를 제안한다. 각 관찰에 대해 후보 궤적을 샘플링하고, 3D 가우시안 스플래팅(3DGS)으로 재구성한 실제 장면에서 월드 엔진 같은 시뮬레이터로 높은 보상을 받는 궤적들의 미래 영상을 렌더링한다. 전체 요약 8문장 읽기 → 040 15:11 ▲ 17 · 댓글 2 자율주행에서 더 좋은 이미지 인식이 항상 성능을 높일까? 자율주행 시스템에 시각 기초 모델(VFM)을 통합할 때, 더 나은 표현이 항상 성능 향상으로 이어지는지를 조사하는 논문이다. AI · 머신러닝 · Do Better Visual Representations Always Lead to Better End-to-End Autonomous Driving?
Key Point 자율주행 시스템에서 강력한 이미지 인식 모델을 쓸 때, 어떤 모델을 선택하고 어떻게 학습시키느냐에 따라 실제 성능이 크게 달라질 수 있다는 점을 실증적으로 보여준다.
핵심 요약
자율주행 시스템에 시각 기초 모델(VFM)을 통합할 때, 더 나은 표현이 항상 성능 향상으로 이어지는지를 조사하는 논문이다. 연구팀은 ViRA라는 시각 표현 정렬 프레임워크를 제시했으며, 이는 플래너 아키텍처와 추론 비용을 변경하지 않은 상태로 작동한다. 첫 번째 발견: VFM 기반 시각 표현이 다양한 엔드투엔드 플래너에서 일관되게 성능을 개선하고, 제로샷 폐루프 평가까지 이득을 확장한다. 전체 요약 8문장 읽기 → 041 12:11 ▲ 11 · 댓글 1 안전한 자율주행을 위한 VLA 모델 SafeDriveVLA 제시 Vision-Language-Action(VLA) 모델이 자율주행에 주목받고 있으나, 자유형식 자연어 지시가 현재 장면과 충돌할 수 있다는 새로운 취약점이 있다. AI · 머신러닝 · SafeDriveVLA: Navigation-Conditioned World Model Dreaming for Conflict-Aware End-to-End Autonomous Driving
Key Point 자연어 지시 기반 자율주행에서 운전자의 부주의하거나 악의적 명령이 만드는 충돌 문제를 처음으로 체계적으로 다루고, 이를 해결하는 방법론을 제시했기 때문에 안전성이 중요한 자율주행 개발자들에게 실질적인 가치가 있다.
핵심 요약
Vision-Language-Action(VLA) 모델이 자율주행에 주목받고 있으나, 자유형식 자연어 지시가 현재 장면과 충돌할 수 있다는 새로운 취약점이 있다. 연구진은 네비게이션 추종과 충돌 인식, 적대적 강건성을 함께 평가하는 첫 벤치마크 스위트를 공개했으며, 기존 VLA 모델들이 모두 불안전한 지시에서 성능이 급격히 저하된다. SafeDriveVLA는 3단계 네비게이션 준수 모드를 명시적으로 예측해 충돌 추론을 행동 생성에서 분리한다. 전체 요약 6문장 읽기 → 042 00:11 ▲ 19 · 댓글 2 과학 AI 에이전트 군단이 스스로 진화하며 학습한다 과학 연구의 재귀적 자기 개선(RSI)을 위해 과학 에이전트 군단이 실험 경험을 통해 연구 능력을 향상시키는 것을 목표로 한다. AI · 머신러닝 · SwarmRSI: Recursive Self-Improvement through Evolving Scientific Agent Swarm
Key Point 과학 연구 자동화를 추구하는 개발자와 연구자들이 AI 에이전트 간 협력과 피드백 기반 자기 개선이 어떻게 실제 과학 문제 해결에 활용되는지 알아야 한다.
핵심 요약
과학 연구의 재귀적 자기 개선(RSI)을 위해 과학 에이전트 군단이 실험 경험을 통해 연구 능력을 향상시키는 것을 목표로 한다. 기존 접근의 문제점은 실패한 실험 결과가 가설 오류인지 구현 오류인지 불분명하고, 전체 점수가 다른 에이전트에 유용한 부분 결과를 가린다는 것이다. SwarmRSI는 피드백 기반 군단 변이(Feedback-Guided Swarm Mutation)로 다른 에이전트의 실험 결과를 이용해 가설과 구현을 개선한다. 전체 요약 7문장 읽기 → 043 21:11 당일 +100 만화 자동 번역 도구 Koharu, Rust로 완전 로컬 실행 Koharu는 Rust로 작성된 머신러닝 기반 만화 번역 도구로, 모든 모델과 LLM을 사용자의 로컬 머신에서 실행하여 데이터 프라이버시를 보장한다. 오픈소스 · 도구 · koharu-rs/koharu · Rust
Key Point 완전 로컬 실행 만화 번역 자동화 도구로, 프라이버시 우려 없이 복잡한 시각 처리와 자연어 처리를 통합하는 오픈소스 솔루션을 원하는 사용자에게 선택지가 생겼다.
핵심 요약
Koharu는 Rust로 작성된 머신러닝 기반 만화 번역 도구로, 모든 모델과 LLM을 사용자의 로컬 머신에서 실행하여 데이터 프라이버시를 보장한다. 객체 검출, OCR, 인페인팅, LLM을 조합해 만화 번역 프로세스를 자동화하며, 래스터 이미지·압축 아카이브·PDF를 모두 지원한다. 텍스트 영역과 말풍선, 정리 영역을 감지·분할하고 대사·캡션·일반 텍스트에 대한 다중모드 OCR을 수행한다. 전체 요약 10문장 읽기 → 044 12:11 ▲ 19 · 댓글 1 텍스트-이미지 생성 모델, 자동으로 자기 약점 찾아 학습한다 텍스트-이미지 생성 모델의 사후학습(post-training)을 자동화하는 APT(Agentic Post-Training) 프레임워크를 제안했다. AI · 머신러닝 · APT: Feedback-Driven Agentic Post-Training for Text-to-Image Generation
Key Point 수동 데이터 큐레이션 없이 모델 자체의 약점을 자동으로 식별해 학습하는 방식으로, 텍스트-이미지 생성의 품질 개선 파이프라인이 어떻게 근본적으로 바뀔 수 있는지 보여준다.
핵심 요약
텍스트-이미지 생성 모델의 사후학습(post-training)을 자동화하는 APT(Agentic Post-Training) 프레임워크를 제안했다. 기존 방식은 수동으로 큐레이션한 데이터와 고정된 학습 분포에 의존했으나, APT는 모델의 진화하는 역량에 맞춰 적응적으로 사후학습을 진행한다. 평가 세트 구성, 모델의 강점과 약점 진단, 강화학습 데이터 생성을 담당하는 3개 에이전트를 조율한다. 전체 요약 6문장 읽기 → 045 12:11 ▲ 64 · 댓글 1 루프형 MoE 모델, 비대칭 연산 배분으로 효율 19% 개선 루프형 Mixture-of-Experts(MoE) 모델은 파라미터를 재사용하면서 스파스 연산으로 성능을 높이는데, 같은 블록을 여러 번 거칠 때 각 방문마다 서로 다른 역할을 한다. AI · 머신러닝 · LatentLoop: Scaling Looped MoE Models with Asymmetric Compute Allocation
Key Point 파라미터 효율성을 중시하는 개발팀이 더 작은 모델로 더 나은 성능을 달성할 수 있는 구조적 개선 방안을 얻을 수 있기 때문입니다.
핵심 요약
루프형 Mixture-of-Experts(MoE) 모델은 파라미터를 재사용하면서 스파스 연산으로 성능을 높이는데, 같은 블록을 여러 번 거칠 때 각 방문마다 서로 다른 역할을 한다. 연구진이 공유 블록을 두 번 적용하는 모델에서 각 방문별로 별도의 잔차 계수를 학습한 결과, 첫 번째 방문에서 더 작은 스케일이 나타났다. 첫 번째 방문의 스케일을 줄이면 성능이 유지되거나 개선되지만, 두 번째 방문을 같은 정도로 줄이면 성능이 떨어진다. 전체 요약 8문장 읽기 → 046 00:11 ▲ 20 · 댓글 1 자율 연구 AI를 위한 이중 체계 구조 JevGPT 공개 자율 연구 에이전트가 제한된 예산 내에서 증거를 수집하고 추론할 때, 관련 자료가 미검토된 채 남아 증거 검색과 실제 활용 사이의 간극이 발생한다는 문제를 제시했다. AI · 머신러닝 · JevGPT: Thinking Fast and Slow in Autonomous Research
Key Point LLM 기반 자율 연구 에이전트의 성능과 비용 효율성을 동시에 높이는 새로운 아키텍처로, 현재 활발히 개발 중인 AI 리서치 도구의 실용성을 크게 개선할 수 있다.
핵심 요약
자율 연구 에이전트가 제한된 예산 내에서 증거를 수집하고 추론할 때, 관련 자료가 미검토된 채 남아 증거 검색과 실제 활용 사이의 간극이 발생한다는 문제를 제시했다. JevGPT는 빠른 증거 처리와 신중한 연구 계획을 결합한 이중 체계 구조로, System Two는 증거 목표를 설정하고 발견을 통합하며, System One은 증거를 찾아 관련성을 평가하고 추가 검토를 안내한다. 독립적인 출처 판단이 병렬로 실행되며, 선택된 원문 구절이 다음 연구 단계에 반영되는 방식으로 작동한다. 전체 요약 5문장 읽기 → 047 15:11 ▲ 20 · 댓글 1 LLM 에이전트, 외부 모델 없이 자기개선한다 LLM 기반 에이전트가 파일 시스템·셸과 직접 상호작용하는 하네스 환경에서 작동하지만, 기존 학습 파이프라인은 외부 강력한 모델에 의존하는 일회성 방식에 머물고 있다. AI · 머신러닝 · ClawLoop: Self-Improving Agents via Harness-Native Training Loop
Key Point 기존 LLM 에이전트 학습은 외부 모델과 인간에게 종속되어 근본적 한계가 있는데, ClawLoop은 순환 루프로 자동 개선을 실현하고 작은 모델에도 지식 전이가 가능함을 증명하며 에이전트 학습 패러다임의 전환을 시사한다.
핵심 요약
LLM 기반 에이전트가 파일 시스템·셸과 직접 상호작용하는 하네스 환경에서 작동하지만, 기존 학습 파이프라인은 외부 강력한 모델에 의존하는 일회성 방식에 머물고 있다. ClawLoop은 외부 교사 모델 없이, 최소한의 사전 지식으로 에이전트가 자기개선하는 자체 순환 프레임워크를 제안한다. 과제 합성·진단 기반 난이도 성장·에이전트 기반 검증으로 다양한 학습 과제 풀을 생성하고, SFT와 RL로 에이전트를 업데이트한 후, 롤아웃 행동 분석으로 다음 반복의 피드백을 생성한다. 전체 요약 5문장 읽기 → 048 09:11 ▲ 121 · 댓글 56 게임 개발에서 AI를 제대로 쓰는 법 저자는 LLM이 웹 개발에는 뛰어나지만 게임 개발에는 약한 이유를 분석했다. 게임은 코드뿐 아니라 그래픽, 게임플레이, 물리 등 코드로 표현되지 않는 요소가 많아서 LLM이 이해하기 어렵기 때문이다. AI · 머신러닝 · How to engineer an AI harness for game development
Key Point LLM이 게임 개발에서 실패하는 구체적 원인과 해결 방법을 제시하는 실용적 가이드로, 게임 개발자가 AI를 효과적으로 활용하기 위해 아키텍처 설계 단계부터 적용할 수 있는 전략을 설명한다.
핵심 요약
저자는 LLM이 웹 개발에는 뛰어나지만 게임 개발에는 약한 이유를 분석했다. 게임은 코드뿐 아니라 그래픽, 게임플레이, 물리 등 코드로 표현되지 않는 요소가 많아서 LLM이 이해하기 어렵기 때문이다. LLM과의 상호작용은 시스템 프롬프트, 어시스턴트 프롬프트, 사용자 프롬프트로 구성되며, 대화가 이어질수록 이전 메시지들이 계속 재제출되면서 컨텍스트가 쌓인다. 컨텍스트 오염(context pollution)을 줄이고 게임을 AI가 이해할 수 있게 만드는 '하네스(harness)' 개념을 도입해야 한다. 하네스는 AI 에이전트가 특정 작업을 더 잘 수행하도록 설계된 패턴과 도구의 집합이다. 전체 요약 9문장 읽기 → 049 06:11 ▲ 146 · 댓글 39 로봇 물리 제어 위해 특화된 제미니 4 아르곤 공개 구글이 로봇공학 전문 대규모 언어 모델 제미니 4 아르곤을 발표했다. AI · 머신러닝 · Gemini 4 Argon for Robotics
Key Point 3D 물리 환경에서 로봇 제어·시뮬레이션·코드 생성을 통합적으로 처리하는 AI 모델의 등장으로, 로봇공학 개발의 전체 워크플로우가 단순화될 수 있는 전환점이 될 수 있다.
핵심 요약
구글이 로봇공학 전문 대규모 언어 모델 제미니 4 아르곤을 발표했다. 아르곤은 ERQA 벤치마크에서 순수 추론으로 87% 점수를 달성해 다른 모든 경쟁 모델을 능가한다. 보스턴 다이나믹스 스팟 로봇 제어, 로봇팔 조작 작업, 3D 환경 내 물체 배열 등 로봇공학 전주기에 적용 가능하다. 전체 요약 12문장 읽기 → 050 03:11 새 버전 Electron v43.7.10 출시, 크래시 2건 수정 Electron v43.7.10이 출시됐다. 인프라 · 데브옵스 · electron/electron@v43.7.10
Key Point Linux 사용 환경과 웹 컴포넌트 ResizeObserver 사용 시 발생하는 안정성 문제가 해결되어 해당 환경의 개발자들이 업데이트할 필요가 있다.
핵심 요약
Electron v43.7.10이 출시됐다. Linux 환경에서 디스플레이 서버가 없을 때 시작 시 발생하는 크래시를 수정했다. ResizeObserver 루프 제한 에러 핸들러가 레이아웃을 수정할 때 렌더러가 크래시하는 문제를 해결했다. 051 15:11 ▲ 261 · 댓글 2 로봇·자율주행용 '공간 인지' 기초 모델 GroundingPI 공개 Hugging Face와 arXiv의 공동 발표로, GroundingPI라는 40억 개 파라미터 크기의 기초 모델을 소개한다. AI · 머신러닝 · GroundingPI: A Grounding Foundation Model towards Physical Intelligence with Visual Primitives
Key Point 로봇 팔과 자율주행 자동차가 정확하고 빠르게 물체를 인식해야 하는데, 기존 범용 시각 모델 대신 공간 좌표 인식에 특화한 기초 모델을 쓰면 성능이 크게 오른다는 실증적 결과를 제시한다.
핵심 요약
Hugging Face와 arXiv의 공동 발표로, GroundingPI라는 40억 개 파라미터 크기의 기초 모델을 소개한다. 이 모델은 점과 박스 형태의 정량화된 좌표를 공유 어휘로 생성해, 혼잡한 환경과 작은 물체의 위치 파악을 빠르게 수행한다. 다중모달·공간 사전학습, 지도학습, GRPO 강화학습을 결합해 학습하며, 공개 데이터셋과 자체 데이터 엔진의 감시 신호를 활용했다. 전체 요약 8문장 읽기 → 052 12:11 ▲ 130 · 댓글 87 미사용 킨들을 AI로 사진 액자로 개조하기 쓰지 않던 킨들을 AI 에이전트로 개조하여 사진 액자로 만들었다. 처음에는 GPT-5.6 Sol과 Fable 5.1, Opus 5.5를 시도했지만, 데이터 저장 오류나 보안 차단으로 실패했다. AI · 머신러닝 · I turned my unused Kindle into a photo frame with GPT-6 Astra
Key Point AI 에이전트가 하드웨어 제어 코드를 작성하고 디버깅하는 실제 사례를 보여주며, 특히 자동화된 피드백 루프가 개발 효율을 어떻게 바꾸는지 실증한다.
핵심 요약
쓰지 않던 킨들을 AI 에이전트로 개조하여 사진 액자로 만들었다. 처음에는 GPT-5.6 Sol과 Fable 5.1, Opus 5.5를 시도했지만, 데이터 저장 오류나 보안 차단으로 실패했다. GPT-6 Astra로 전환한 후 SpiderCat 오픈소스 프로젝트를 참고하여 킨들 커스텀 도구인 KindleCTL을 개발했다. 에이전트가 Mac에서 킨들에 명령을 보내고, 파일을 전송하며, 에러를 진단할 수 있게 됐다. 초기에는 에이전트와의 수동 피드백(스크린샷 촬영)이 필요했지만, 로그 접근과 원격 화면 캡처를 자동화한 피드백 루프를 추가하면서 개발 속도가 크게 빨라졌다. 전체 요약 9문장 읽기 → 053 09:11 ▲ 182 · 댓글 171 LLM은 자동화가 아닌 도구다, 사용 능력이 중요 Rich Hickey의 'AI는 도구가 아니라 자동화'라는 주장에 반박하는 글이다. AI · 머신러닝 · AI is a tool and using it well takes skill
Key Point LLM이 도구인지 자동화인지를 둘러싼 철학적 논의가 실제로는 '얼마나 잘 사용하는가'라는 기술적 능력 문제로 귀결되는 점을 명확히 합니다.
핵심 요약
Rich Hickey의 'AI는 도구가 아니라 자동화'라는 주장에 반박하는 글이다. LLM이 예측 불가능하다는 점은 제약이지만, 도구의 정의상 예측 가능성은 필수 요건이 아니며 제어가 어려운 것만으로 도구에서 제외되지 않는다. 컴파일러나 스프레드시트처럼 자동화 기능이 도구의 특성일 수 있으며, 자동 텍스트 생성이 코드 번역이나 계산 자동화와 다르게 취급될 이유가 없다. 전체 요약 8문장 읽기 → 054 00:11 ▲ 264 · 댓글 269 QGIS 프로젝트, AI 활용 코드 기여 전면 금지 QGIS 프로젝트가 QEP428 정책을 승인해 LLM과 AI 기반 코드 기여를 전면 금지했다. 오픈소스 · 도구 · QGIS bans AI assisted contributions
Key Point 오픈소스 프로젝트의 AI 정책이 앞으로 기여 방식과 커뮤니티 구조를 어떻게 바꿀지 보여주는 사례이며, 다른 프로젝트들의 정책 수립에 영향을 미칠 가능성이 있다.
핵심 요약
QGIS 프로젝트가 QEP428 정책을 승인해 LLM과 AI 기반 코드 기여를 전면 금지했다. 기존 정책(QEP-408)은 인간 검토 필수의 '인간 루프' 방식이었으나 실제로 작동하지 않았다. AI 기여로 인한 검토 부담 급증으로 미검토 PR이 쌓이거나 코드 품질 저하가 발생했으며, 고급 기여자 이탈까지 초래했다. 전체 요약 7문장 읽기 → 055 18:12 ▲ 108 · 댓글 38 Doory, 무료 오픈소스 디자인 에디터 공개 Doory는 브라우저에서 실행되는 완전한 디자인 에디터로, 포스터·소셜 미디어 게시물·슬라이드·초대장·이력서·썸네일·명함 등을 제작할 수 있다. 오픈소스 · 도구 · Doory – Open-Source Canva
Key Point Canva의 완전한 오픈소스 대체제로, 무료로 호스팅할 수 있으며 모든 데이터를 자신의 서버에서 관리할 수 있는 점이 디자인 도구의 새로운 선택지를 제시합니다.
핵심 요약
Doory는 브라우저에서 실행되는 완전한 디자인 에디터로, 포스터·소셜 미디어 게시물·슬라이드·초대장·이력서·썸네일·명함 등을 제작할 수 있다. 템플릿이나 빈 페이지에서 시작해 모든 요소를 편집한 후 PNG, JPG, SVG, PDF, MP4, GIF로 내보낼 수 있으며, 모든 기능이 무료이고 계정 없이 사용 가능하다. 배경 제거부터 비디오 내보내기까지 모든 편집 도구가 Pro 플랜 없이 누구에게나 공개되어 있고, 광고나 워터마크가 없다. 전체 요약 12문장 읽기 → 056 18:12 ▲ 113 · 댓글 63 AI가 자기 자신을 재귀적으로 개선하는 방법 Sakana AI 연구팀이 다중 에이전트 시스템의 집단 지능을 통해 AI 모델이 스스로를 개선하는 MASS(Multi-Agent Self-Supervision) 기법을 제안했다. AI · 머신러닝 · Recursive self-improvement through collective intelligence
Key Point 인간 감시자도 평가 불가능한 최첨단 과제에서 AI가 홀로 자신을 개선할 수밖에 없는 상황에서, 집단 지능을 통한 자기 감시 메커니즘이 작동하는지 보여주며, 동시에 그 방식의 안전 위험을 드러내는 연구다.
핵심 요약
Sakana AI 연구팀이 다중 에이전트 시스템의 집단 지능을 통해 AI 모델이 스스로를 개선하는 MASS(Multi-Agent Self-Supervision) 기법을 제안했다. MASS는 같은 모델이 작업 수행자, 워크플로우 최적화자, 평가자 세 역할을 모두 하는 동형 재귀적 자기 개선(RSI) 방식이다. 내부 루프에서 모델이 다중 에이전트 팀의 업무 분담 방식을 최적화하고, 외부 루프에서 최적화된 워크플로우 실행으로부터 배운다. 전체 요약 12문장 읽기 → 057 12:11 ▲ 49 · 댓글 2 장시간 프로그램 작성을 학습하는 AI 에이전트 프레임워크 공개 코딩 에이전트가 처음부터 완전한 프로그램을 작성하도록 학습할 수 있는 체계가 부족한 상황에서, 연구팀이 ProgramGym 프레임워크를 공개했다. AI · 머신러닝 · ProgramGym: Scaling Training Environments for Long-Horizon Program Reproduction Agents
Key Point 프로그램을 처음부터 작성하는 에이전트 개발에 필수적인 대규모 검증 환경과 실용적인 워크플로우를 처음 공개하는 것으로, AI 코딩 보조 도구의 자율성 수준을 한 단계 높이는 사례를 보여준다.
핵심 요약
코딩 에이전트가 처음부터 완전한 프로그램을 작성하도록 학습할 수 있는 체계가 부족한 상황에서, 연구팀이 ProgramGym 프레임워크를 공개했다. Program-Env는 저장소에서 검증 가능한 학습 환경을 자동으로 구성하며, 샌드박스 실행 오류를 수정하고 테스트 품질을 개선하는 피드백 루프를 활용한다. 이 파이프라인으로 C, C++, Go, Rust 프로그래밍 언어를 포함한 1,648개의 학습 환경을 확보했다. 전체 요약 6문장 읽기 → 058 06:11 ▲ 118 · 댓글 71 Valen의 새로운 빌림 검사기, 메모리 안전 재정의 Valen은 'Group Borrowing'이라는 새로운 빌림 검사 방식을 채택한 프로그래밍 언어로, Rust의 강력한 메모리 안전성과 참조 계수·가비지 컬렉션의 유연성을 결합하는 것을 목표로 한다. AI · 머신러닝 · Valen's Memory Safety: A New Kind of Borrow Checking
Key Point Rust의 엄격함과 다른 언어의 유연성을 모두 원하는 개발자들에게, Valen의 Group Borrowing이 어떻게 이 둘의 긴장을 해소하고 새로운 메모리 안전 패러다임을 제시하는지 이해할 수 있다.
핵심 요약
Valen은 'Group Borrowing'이라는 새로운 빌림 검사 방식을 채택한 프로그래밍 언어로, Rust의 강력한 메모리 안전성과 참조 계수·가비지 컬렉션의 유연성을 결합하는 것을 목표로 한다. 기존 Rust의 '공유-배타적 가변' 규칙을 '사용 후 해제 방지'로 완화하여, 같은 객체에 대한 여러 읽기-쓰기 참조를 컴파일 시점에 안전하게 허용한다. Valen의 핵심은 컴파일러가 각 참조가 가리키는 객체의 '경로'를 추적하는 것으로, 단순히 mutable/immutable 타입이 아니라 참조가 데이터 계층 구조 내 어느 부분을 가리키는지 정확히 기록한다. 전체 요약 9문장 읽기 → 059 03:11 ▲ 109 · 댓글 35 DHH의 Campfire 재작성, AI로는 부족함을 드러내다 DHH가 Ruby on Rails로 만든 Campfire를 Rust로 재작성했으며, Elixir, Go 등 다른 언어로도 재작성하도록 했는데 AI 에이전트에만 의존하면서 코드 직접 검토를 거부했다. AI · 머신러닝 · I'm sorry, but you still have to think
Key Point AI 에이전트만으로는 아키텍처와 성능 트레이드오프를 올바르게 판단할 수 없으며, 프로그래밍은 여전히 깊은 이해와 비판적 사고를 요구한다는 점을 실제 사례로 보여준다.
핵심 요약
DHH가 Ruby on Rails로 만든 Campfire를 Rust로 재작성했으며, Elixir, Go 등 다른 언어로도 재작성하도록 했는데 AI 에이전트에만 의존하면서 코드 직접 검토를 거부했다. 명확하지 않은 프롬프트는 후보 결정이 동전 던지기가 되는 문제를 드러냈다. 역하위 호환성, 지연시간 vs 처리량, 메모리 제한, 장애 후 알림 손실 용인 여부 같은 결정이 LLM에 의해 암묵적으로 내려진다. Rust 판본은 CSRF 토큰을 제거하고 Redis 대신 인메모리 큐를 썼지만, Elixir 판본은 Rails 원본에 훨씬 더 가깝다. 이런 차이는 언어 선택과 무관한 설계 결정이다. 전체 요약 11문장 읽기 → 060 21:11 당일 +171 Claude Code에서 언리얼 에디터를 직접 조종하는 MCP 플러그인 공개 에픽게임즈가 Claude Code용 언리얼 엔진 플러그인을 공개했으며, MCP(Model Context Protocol)를 통해 Claude Code에서 언리얼 에디터를 직접 제어할 수 있다. AI · 머신러닝 · EpicGames/unreal-engine-skills-for-claude-code-plugin · Shell
Key Point Claude Code에서 코드 작성과 동시에 언리얼 에디터를 완전히 자동화할 수 있게 되면서, AI 어시스턴트를 활용한 게임 개발 워크플로우가 본격화된다.
핵심 요약
에픽게임즈가 Claude Code용 언리얼 엔진 플러그인을 공개했으며, MCP(Model Context Protocol)를 통해 Claude Code에서 언리얼 에디터를 직접 제어할 수 있다. 액터, 블루프린트, 머티리얼, Niagara, Control Rig, Sequencer, State Trees, 위젯, Gameplay Ability System, 자동화 테스트 등 30개 이상의 툴셋에서 수백 개의 도구를 노출한다. 플러그인은 ModelContextProtocol과 AllToolsets 플러그인이 활성화된 언리얼 에디터, 실행 중인 MCP 서버, PATH에 bash가 있어야 한다. 전체 요약 12문장 읽기 → 061 00:11 ▲ 106 · 댓글 32 Rust를 가독성 높은 C 코드로 변환하는 Eurydice Rust 컴파일러의 다양화 추세 속에서 Eurydice는 Rust 코드를 깔끔한 C 코드로 변환하는 야심찬 목표를 지닌 최신 프로젝트다. 인프라 · 데브옵스 · Compiling Rust to readable C with Eurydice
Key Point Rust에서 C로의 자동 변환이 고보증 소프트웨어나 C 기반 환경으로의 이식 시 검증 도구 호환성을 유지하면서 코드 동기화를 가능하게 한다.
핵심 요약
Rust 컴파일러의 다양화 추세 속에서 Eurydice는 Rust 코드를 깔끔한 C 코드로 변환하는 야심찬 목표를 지닌 최신 프로젝트다. 고보증 소프트웨어(high-assurance software) 분야에서 기존 검증·규정준수 도구들이 C를 기대하므로, Eurydice는 이러한 프로젝트들의 부드러운 전환을 가능하게 한다. 2023년 시작된 Eurydice는 Inria(프랑스 국립 컴퓨터과학연구원)와 Microsoft 직원들이 유지보수하는 Aeneas 프로젝트의 일부이며, MIT와 Apache-2.0 라이선스 코드를 포함한다. 전체 요약 13문장 읽기 → 062 09:11 ▲ 250 · 댓글 152 AI가 지식 공동체를 무너뜨린다 지식인의 개인적 활동은 다른 인간들로 이루어진 지적 공동체 속에서만 지속될 수 있는데, AI가 이 공동체를 해체한다고 주장한다. AI · 머신러닝 · No Man Is an Island
Key Point AI가 지식 생산의 핵심인 공동체의 동기부여 체계를 해체할 때, 개인의 지적 활동이 어떻게 사라지는지 보여주는 구조적 분석이다.
핵심 요약
지식인의 개인적 활동은 다른 인간들로 이루어진 지적 공동체 속에서만 지속될 수 있는데, AI가 이 공동체를 해체한다고 주장한다. 소프트웨어 엔지니어링의 담론이 악화되었다: Claude Code 출시 1년 만에 업계가 급변했고, 컴파일러·타입 시스템·로직 같은 고도의 논의가 '프롬프트' '에이전트 루프' 같은 얕은 주제로 축소되었다. 인간자본 형성이 붕괴되었다: 프롬프팅은 소프트웨어 엔지니어링보다 훨씬 얕은 기술이므로, 학습할 게 없고 엄격한 사고력을 연습할 필요가 없어졌다. 전체 요약 9문장 읽기 → 063 06:11 ▲ 19 · 댓글 2 로봇이 직접 짜는 코드, VLM 없이도 작동한다 로봇의 세계를 튜링 머신으로 보고, 상태 변화와 정책을 코드로만 표현하는 COAP(Code-Only-as-Policy) 방식을 제안했다. AI · 머신러닝 · Embodied Turing Machines: Stateful Code for Robot Recursive Self-Improvement
Key Point 로봇이 대규모 언어 모델 없이 명시적인 코드로만 작동하면서 70% 이상의 성공률을 보인 새로운 접근법이기에, 로봇 자동화와 에이전트 개발의 패러다임 변화를 보여준다.
핵심 요약
로봇의 세계를 튜링 머신으로 보고, 상태 변화와 정책을 코드로만 표현하는 COAP(Code-Only-as-Policy) 방식을 제안했다. 카메라 이미지와 로봇 센서 데이터에서 상태를 명시적으로 추출·추적하며, 실행 시점에 VLM이나 VLA 모델 없이 코드만으로 의사결정을 수행한다. COAP의 장점은 세 가지다: 상태를 코드 변수로 명확히 저장할 수 있고, 제어 가능하고 빠르고 비용이 낮으며, 에러에서도 유연하게 복구한다. 전체 요약 8문장 읽기 → 064 06:11 ▲ 14 · 댓글 2 VLM 에이전트, 시각 기반 스킬로 강화 학습 기존 스킬 강화 에이전트는 대부분 텍스트 중심으로 공간 레이아웃과 행동-상태 대응을 언어로 변환하면서 기하학적 구조 정보를 손실한다. AI · 머신러닝 · ViSkill: Reinforcing VLM Agents with Evolving Visual-Native Skills
Key Point VLM 에이전트가 기하학적 정보를 보존한 시각 기반 스킬을 동적으로 습득·활용하는 새로운 강화 학습 방법으로, 정책과 스킬의 상호 개선 메커니즘이 기존 텍스트 중심 방식의 한계를 직접 해결한다.
핵심 요약
기존 스킬 강화 에이전트는 대부분 텍스트 중심으로 공간 레이아웃과 행동-상태 대응을 언어로 변환하면서 기하학적 구조 정보를 손실한다. ViSkill은 성공한 상호작용을 시각 정보 중심의 '스킬 카드'로 인코딩하여 VLM 에이전트가 직접 활용하는 방식을 제안한다. 검색된 스킬은 추론과 보상 형성을 모두 가이드하고, 성공한 궤적이 다시 스킬 라이브러리로 증류되어 닫힌 피드백 루프를 형성한다. 전체 요약 6문장 읽기 → 065 03:11 ▲ 16 · 댓글 2 반복 순회로 빠른 추론 성능을 높인 SanSi 모델 사전학습된 언어모델을 타입화된 결정 모델로 변환하는 SanSi를 제안한다. AI · 머신러닝 · SanSi: A Looped Typed Decision Model for System 1.5 Thinking
Key Point 빠른 추론 속도와 높은 정확도를 동시에 원하는 프로덕션 환경에서 루핑을 통한 점진적 성능 향상이 실질적으로 작동함을 보여준다.
핵심 요약
사전학습된 언어모델을 타입화된 결정 모델로 변환하는 SanSi를 제안한다. 기존의 단일 전향 통과(System 1 사고)와 생성형 추론 사이의 중간 영역을 탐색하기 위해 루핑(같은 레이어를 재귀적으로 여러 번 적용)을 도입했다. 각 루프마다 모델이 답변을 생성하지 않고 숨겨진 상태를 수정한 후 의사결정 헤드로부터 각 선택지의 확률을 읽는다. 전체 요약 8문장 읽기 → 066 00:11 ▲ 35 · 댓글 5 고정된 LLM이 자기 개선하는 Memento 3, 환경 학습에 성공 Memento 3는 동결된 LLM 에이전트가 외부 메모리를 통해 명시적 세계 모델을 지속적으로 학습하도록 하는 기법이다. AI · 머신러닝 · Memento 3: Model-Based Recursive Self-Improvement through Reflective Rulebooks
Key Point 기존 LLM은 세계 모델을 외부 메모리 없이 학습할 수 없었는데, Memento 3의 규칙책 기반 접근은 동결된 모델도 자율적으로 환경을 학습하고 자기 개선할 수 있음을 보여준다.
핵심 요약
Memento 3는 동결된 LLM 에이전트가 외부 메모리를 통해 명시적 세계 모델을 지속적으로 학습하도록 하는 기법이다. 에이전트는 자연언어 규칙책을 의미 기억으로 유지하며, 환경 역학의 수정 가능한 가설을 기록하면서 미지의 측면은 불완전하게 남긴다. 규칙책을 실행 가능한 코드로 컴파일하여 예측과 계획에 활용한다. 전체 요약 9문장 읽기 → 067 18:11 ▲ 111 · 댓글 96 C 언어의 미정의 동작 감소, 메모리 안전성 강화 논의 C 언어는 여전히 이식성과 안정성, 빠른 컴파일 속도를 갖춘 우수한 언어로, 추상 머신 모델을 통해 다양한 하드웨어를 지원한다. 인프라 · 데브옵스 · Reducing undefined behavior in the C language
Key Point C 언어는 여전히 주요 임베디드·시스템 소프트웨어의 핵심이며, 표준위원회가 메모리 안전성 개선에 적극 나서면서 앞으로 C의 보안과 안정성이 크게 달라질 가능성을 보여준다.
핵심 요약
C 언어는 여전히 이식성과 안정성, 빠른 컴파일 속도를 갖춘 우수한 언어로, 추상 머신 모델을 통해 다양한 하드웨어를 지원한다. C 표준에는 약 100개의 미정의 동작(undefined behavior)이 존재하는데, 이는 컴파일러 최적화와 하드웨어 제어를 가능하게 하지만 개발자 간 의견 충돌을 초래한다. 구조체 패딩 읽기, 0으로 나누기 후 실행 흐름 등의 경우 컴파일러가 예상 밖으로 코드를 최적화하여 버그를 야기하는 사례들이 있다. 전체 요약 8문장 읽기 → 068 15:13 ▲ 42 · 댓글 2 정적인 3D 장면을 무한 반복되는 영상으로, OuroWorld 정적인 3D Gaussian Splatting 장면을 마스크 없이 동적인 3D 시네마그래프로 변환하는 OuroWorld 프레임워크를 제안했다. AI · 머신러닝 · OuroWorld: Bringing Any 3D World Alive as Diverse, Endlessly Looping 3D Cinemagraphs
Key Point 정적인 3D 장면 생성의 한계를 극복하고 실시간 탐색 가능한 동적 시네마그래프를 만드는 기술로, 3D 콘텐츠 제작의 새로운 가능성을 열 수 있다.
핵심 요약
정적인 3D Gaussian Splatting 장면을 마스크 없이 동적인 3D 시네마그래프로 변환하는 OuroWorld 프레임워크를 제안했다. 비전-언어 모델이 장면에 적합한 동작을 유추하고 비디오 모델이 참조 비디오를 생성하며, 이를 다시점 비디오로 확장된다. Fourier 급수 변형 필드와 Grounded Drift Field를 결합한 Inconsistency-Robust Periodic 4DGS를 통해 완벽한 루프를 보장하면서도 다시점 간의 불일치를 흡수한다. 전체 요약 6문장 읽기 → 069 12:11 ▲ 121 · 댓글 21 1주일 만에 완성한 LED 네온 티셔츠 회사의 네온 테마 행사를 앞두고 유연한 LED 필라멘트를 이용해 입을 수 있는 네온 티셔츠를 며칠 안에 설계·제작했다. 하드웨어 · 시스템 · Show HN: Making a flexible "neon" t-shirt with LED filaments
Key Point LED 필라멘트라는 특수 재료의 제약(절단 불가, 고정 길이)을 창의적으로 우회한 하드웨어 메이킹의 구체적 사례로, 제한된 시간과 부품으로 완성하는 문제해결 과정을 참고할 수 있다.
핵심 요약
회사의 네온 테마 행사를 앞두고 유연한 LED 필라멘트를 이용해 입을 수 있는 네온 티셔츠를 며칠 안에 설계·제작했다. LED 필라멘트는 실리콘 확산층으로 감싼 1.8mm 두께의 미세 LED 수백 개가 달린 긴 스트립으로, 자를 수 없어 고정 길이(300mm, 600mm, 1200mm 등)로만 제공된다. 가운데 스트럿칭 천을 보강재로 사용하고 조직 위에 설계 도안을 추적한 후 필라멘트를 루프 스티치로 고정하는 방식으로 뒷면에 라마 도형, 앞면에 베가스식 테두리가 있는 손글씨 텍스트를 제작했다. 전체 요약 7문장 읽기 → 070 12:11 ▲ 100 · 댓글 64 이더넷 기반 오디오 인터페이스 eth68, 3.6ms 초저지연 달성 eth68은 STM32H7 마이크로컨트롤러 펌웨어로 구동되는 리눅스용 이더넷 오디오 인터페이스로, netJACK1 마스터 엔드포인트를 에뮬레이트한다. 하드웨어 · 시스템 · ETH-68: Ethernet Audio Interface for Linux
Key Point 전용 오디오 카드 수준의 초저지연(3.6ms)을 이더넷과 일반 하드웨어로 구현했으며, 오픈소스로 공개되어 리눅스 기반 음악 제작 워크플로우에서 비용 대비 성능의 새로운 기준을 제시한다.
핵심 요약
eth68은 STM32H7 마이크로컨트롤러 펌웨어로 구동되는 리눅스용 이더넷 오디오 인터페이스로, netJACK1 마스터 엔드포인트를 에뮬레이트한다. JACK 서버를 netone 백엔드로 실행하거나 PipeWire의 pw-eth68 클라이언트로 직접 연결하여 사용할 수 있다. 48kHz 64샘플 버퍼에서 3.620ms의 왕복 오디오 레이턴시를 달성하며, 96kHz에서 RME HDSPe AIO Pro PCIe 카드보다 0.33ms 낮다. 전체 요약 12문장 읽기 → 071 06:11 새 버전 uv 0.12.24 릴리스, 성능 최적화와 버그 수정 Python 패키지 관리자 uv 0.12.24가 2025년 10월 8일 공개되었다. 오픈소스 · 도구 · astral-sh/uv@0.12.24
Key Point uv는 Rust 기반의 빠른 Python 패키지 관리자로, 개발 속도에 직결된 환경 생성과 의존성 해석이 더욱 최적화되었으며 설정 유연성이 높아져 다양한 환경과 플랫폼 지원이 강화되었다.
핵심 요약
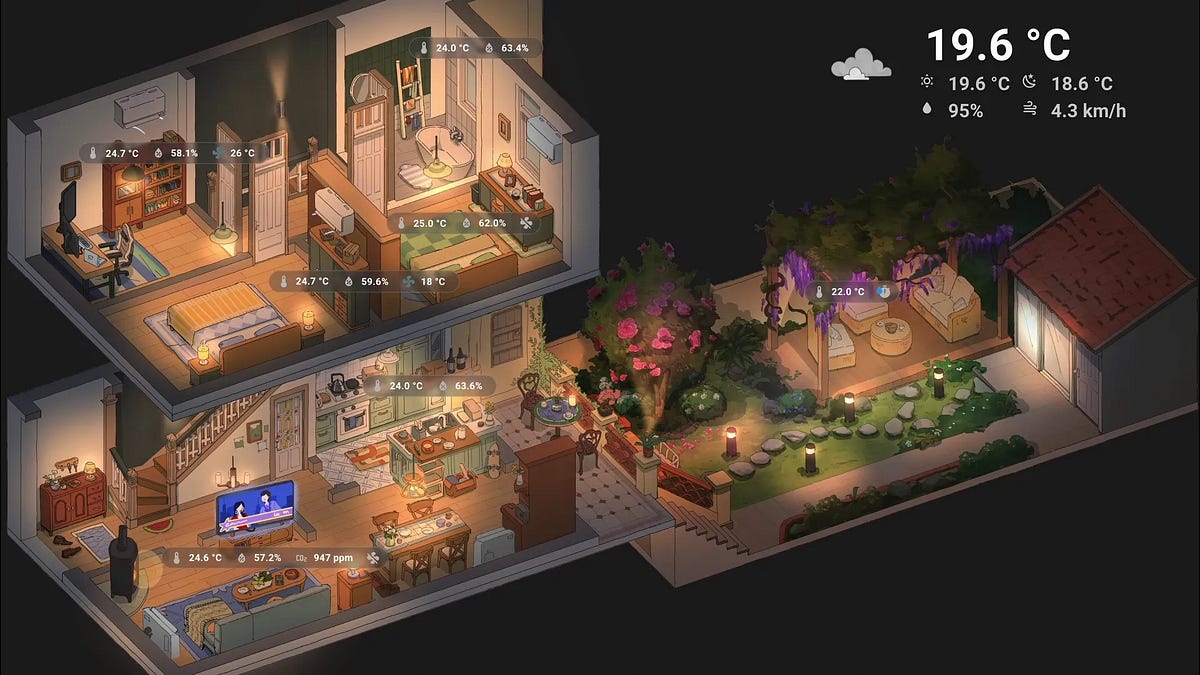
Python 패키지 관리자 uv 0.12.24가 2025년 10월 8일 공개되었다. uv cache prune으로 고아 상태의 임시 빌드 환경을 제거할 수 있으며, PEP 508 마커 연산자를 그룹 표현식 앞에 직접 쓸 수 있게 개선했다. 환경 생성 후 인터프리터 캐시를 미리 채워 후속 명령 실행을 빠르게 하고, ARM64 macOS 바이너리의 코드 서명 검증 작업을 줄였다. 전체 요약 10문장 읽기 → 072 06:11 ▲ 176 · 댓글 12 일러스트 대시보드로 스마트홈을 제어하는 홈어시스턴트 홈어시스턴트 오픈소스 플랫폼으로 집을 자동화하며 정원 조명, 에어컨, 스프링클러 등을 제어했으나, 가족 누구도 기존 대시보드를 쓰려 하지 않아 새로운 접근 필요했다. 인프라 · 데브옵스 · I hired an illustrator to draw my house. Now it's my Home Assistant dashboard
Key Point 손으로 그린 일러스트로 홈스마트 대시보드를 만드는 실무 과정과 기술 구현 방법을 상세히 공개해, 홈어시스턴트로 DIY 스마트홈을 구축하려는 사용자들에게 구체적인 참고 사례를 제공한다.
핵심 요약
홈어시스턴트 오픈소스 플랫폼으로 집을 자동화하며 정원 조명, 에어컨, 스프링클러 등을 제어했으나, 가족 누구도 기존 대시보드를 쓰려 하지 않아 새로운 접근 필요했다. 인터랙티브 플로어플랜 대시보드를 구축하기로 결정했고, 3D나 픽셀아트 대신 전문 환경 일러스트레이터를 고용해 손그린 주택 그림으로 대시보드를 구현했다. 일러스트레이터에게 투명 PNG(애니메이션은 WebP), 낮/밤 버전, 개별 기기별 레이어, 고정 캔버스 크기에 정렬된 파일 등의 기술 사양을 전달해 전체 작업 기간 중 대부분을 준비 과정에 소비했다. 전체 요약 10문장 읽기 → 073 00:11 ▲ 12 · 댓글 2 투기적 디코딩에서 불필요한 검증을 줄이는 DLoop 기법 큰 언어 모델의 자동회귀 생성을 가속하는 투기적 디코딩은 경량 초안 모델이 토큰을 제안하면 목표 모델이 이를 검증하는 방식으로 작동한다. AI · 머신러닝 · DLoop: Looped Speculative Decoding
Key Point LLM 추론 속도는 산업 전반의 핵심 과제인데, DLoop가 기존 투기적 디코딩 방식들의 근본 한계를 해결하고 다양한 방법에 범용적으로 적용 가능하다는 점이 중요합니다.
핵심 요약
큰 언어 모델의 자동회귀 생성을 가속하는 투기적 디코딩은 경량 초안 모델이 토큰을 제안하면 목표 모델이 이를 검증하는 방식으로 작동한다. 초안 모델의 성능이 높아지면 목표 모델이 제안된 토큰 전체를 자주 수락하는데도, 매 초안 단계 후 불필요한 검증 및 목표 모델 연산이 반복된다. 기존 적응형 초안 길이 방식들은 자동회귀 초안 모델에서만 속도 향상을 주고, 병렬 초안 모델의 경우 검증되지 않은 토큰의 목표 모델 은닉 상태가 필요해 한계가 있다. 전체 요약 7문장 읽기 → 074 21:11 당일 +107 생산 장애 대응하는 AI SRE 에이전트 OpenSRE 공개 Tracer-Cloud가 오픈소스 AI SRE 에이전트 프레임워크 OpenSRE v0.1을 공개했다. 사용자가 기존에 운영 중인 60여 개 도구를 연결하고 커스텀 워크플로를 정의한 뒤 자체 인프라에서 생산 환경 문제에 답할 수 있다. 인프라 · 데브옵스 · Tracer-Cloud/opensre · Python
Key Point AI가 코드 디버깅 벤치마크(SWE-bench)는 갖춘 반면, 생산 장애 대응 분야는 표준화된 학습·평가 환경이 없어 AI SRE가 아직 미해결 상태인데, OpenSRE가 이 공백을 채우기 위한 오픈소스 기반을 제시했기 때문이다.
핵심 요약
Tracer-Cloud가 오픈소스 AI SRE 에이전트 프레임워크 OpenSRE v0.1을 공개했다. 사용자가 기존에 운영 중인 60여 개 도구를 연결하고 커스텀 워크플로를 정의한 뒤 자체 인프라에서 생산 환경 문제에 답할 수 있다. 에이전트는 로그·메트릭·트레이스·배포 이력에서 관련 컨텍스트를 자동으로 가져온 뒤, 민감 정보를 마스킹한 후 도구 호출 루프를 통해 가설을 검증하고 증거 기반 답변을 제시한다. Slack·PagerDuty·Telegram으로 요약 결과를 직접 전송하며, 보안을 염두에 두고 설계되어 구조화된 LLM 프롬프트·로컬 트랜스크립트 처리·감사 추적을 지원한다. 전체 요약 10문장 읽기 → 075 18:30 ▲ 17 · 댓글 1 실제 웹사이트에서 비전 기반 AI가 마우스 클릭 실패하는 문제 해결 WebFovea는 WebRetriever Challenge 2026에서 2위(최종 점수 57.0/100)를 차지한 비전 기반 웹 에이전트다. AI · 머신러닝 · WebFovea: When the Model Is Right but the Click Is Wrong -- Reliable Round Trips for Vision-Based Web Agents on Live Websites
Key Point 웹 자동화 AI가 실제 사이트에서 장애를 겪는 근본 원인이 모델이 아니라 '중간 계층'에 있다는 발견이 중요하다. 이는 웹 에이전트 개발자들이 모델 성능만이 아니라 입출력 시스템을 정확히 설계해야 함을 시사한다.
핵심 요약
WebFovea는 WebRetriever Challenge 2026에서 2위(최종 점수 57.0/100)를 차지한 비전 기반 웹 에이전트다. 실제 웹사이트 인터페이스를 조작해 검증 가능한 답변을 반환하는 시스템으로, 멀티모달 LLM이 필요하지만 충분하지 않다는 점을 발견했다. 모델 결정은 브라우저 하네스(모델과 페이지 사이의 코드)를 거쳐 페이지에 전달되는데, 매 단계마다 네 가지가 맞아떨어져야 한다: 모델 응답을 의도한 액션으로 파싱, 액션의 페이지 반영, 결과의 정확한 보고, 필요한 정보의 모델 제공. 전체 요약 8문장 읽기 → 076 18:30 ▲ 23 · 댓글 2 AI 에이전트가 회사를 경영하는 시뮬레이터 공개 기업용 AGI의 마지막 단계는 자동으로 운영되는 회사를 만드는 것인데, 실제 기업 데이터는 부족하고 획득 비용이 높으며 개인정보 제약이 많다. AI · 머신러닝 · MiniCorp: The Last Mile of the AI Agent Firm
Key Point 기업용 AI 에이전트 개발에 필요한 현실적이고 대규모의 학습 데이터를 생성할 수 있는 도구가 공개되었으며, 실제 회사처럼 피드백 루프가 작동하는 환경을 통해 에이전트 의사결정 능력을 평가할 수 있게 된다.
핵심 요약
기업용 AGI의 마지막 단계는 자동으로 운영되는 회사를 만드는 것인데, 실제 기업 데이터는 부족하고 획득 비용이 높으며 개인정보 제약이 많다. Hugging Face 연구팀이 MiniCorp라는 오피스 시뮬레이터를 공개했으며, AI 에이전트들이 협력해 회사를 경영하면서 대규모 기업 데이터를 생성할 수 있다. 시뮬레이터는 전자상거래 회사를 모델로 고객·경쟁사·시장 메커니즘을 포함한 외부 세계와 의사결정 에이전트들의 내부 세계로 구성된다. 전체 요약 8문장 읽기 → 077 18:30 ▲ 84 · 댓글 2 AI가 재미있는 게임을 만든다: 재귀적 평가 루프로 프로토타입을 완성작으로 기존 게임 개발 에이전트는 실행 가능한 게임을 만들지만, 프로그램 정확성만으로는 플레이어에게 재미있는 경험을 보장하지 못한다. AI · 머신러닝 · Recursive Game Creator: An Agentic Product-Level Experience-Oriented Game Harness
Key Point 게임 개발 AI가 단순히 '동작하는' 게임을 넘어 '재미있는' 게임을 만드는 구체적 방법론을 제시해, 에이전트 기반 창작 도구의 평가 기준을 바꾼다.
핵심 요약
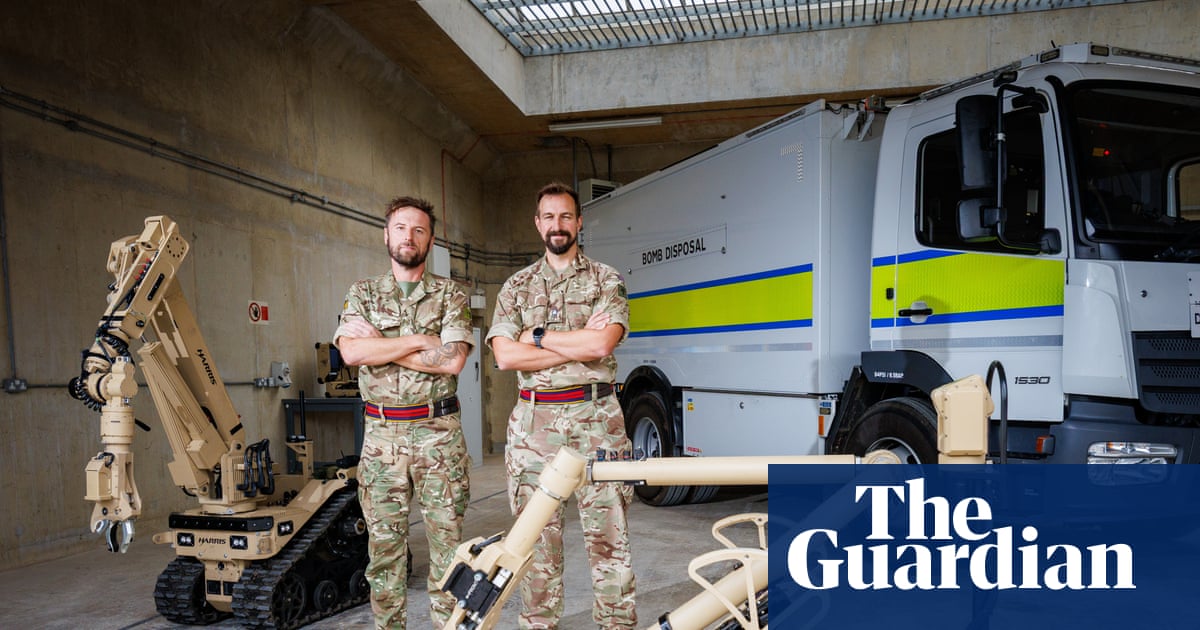
기존 게임 개발 에이전트는 실행 가능한 게임을 만들지만, 프로그램 정확성만으로는 플레이어에게 재미있는 경험을 보장하지 못한다. Recursive Game Creator는 Designer, Builder, Player, Reviewer 네 개 컴포넌트로 프로토타입을 재귀적으로 개선해 완성도 높은 게임으로 발전시킨다. Designer는 사용자 지시사항과 Reviewer의 피드백을 구체적 계획으로 변환하고, Builder가 이를 게임 후보로 구현한다. 전체 요약 7문장 읽기 → 078 18:30 ▲ 127 · 댓글 98 80년 된 독일 폭탄 제거 작전, 2천 가구 피난 2026년 1월 14일 영국 데본주에서 2차 세계대전 독일 폭탄 2개가 같은 날 발견됐다: 플리머스 건설현장의 50kg 폭탄과 엑스머스 항구의 250kg 폭탄. 기타 · The art of defusing a second world war bomb
Key Point 80년 된 폭탄의 신관은 부식과 시간으로 언제 터질지 예측 불가능한데, 국가 인프라 건설이 늘면서 매년 수천 건의 미폭탄 처리가 불가피해졌다.
핵심 요약
2026년 1월 14일 영국 데본주에서 2차 세계대전 독일 폭탄 2개가 같은 날 발견됐다: 플리머스 건설현장의 50kg 폭탄과 엑스머스 항구의 250kg 폭탄. 전문 폭탄 제거팀은 폭탄의 신관(fuze)을 우선 점검한다. 신관에는 1940년대 작동하는 전기식도 있지만 기계식 지연작동 신관은 80년 경과해도 언제 터질지 예측 불가능하다. 제2차 세계대전 중 루프트바페는 영국에 6만 톤 폭탄을 투하했고 10개 중 1개가 미폭탄으로 남아 있다. 영국 군 폭탄 제거팀은 연간 2500건 중 2000건을 미폭탄 처리에 대응한다. 전체 요약 12문장 읽기 → 079 18:30 ▲ 146 · 댓글 66 조건은 위로, 반복은 아래로: 코드 최적화의 대수학적 기초 '조건을 위로, 반복을 아래로'는 프로그래밍 휴리스틱으로, 조건 분기는 호출자 쪽으로 올리고 반복 루프는 배치 처리 쪽으로 내려 명확성과 성능을 높인다. 웹 · 프론트엔드 · Push ifs up and fors down: The idiom, its algebra, and its limits
Key Point 코드의 데이터 흐름과 제어 흐름을 재배열하는 원칙이 단순 휴리스틱을 넘어 범주 이론, 함수형 프로그래밍, 데이터베이스 최적화에 일관되게 적용되는 대수학적 법칙임을 보여주므로, 어디까지 안전하게 리팩토링할 수 있는지 정확히 판단할 근거를 제공한다.
핵심 요약
'조건을 위로, 반복을 아래로'는 프로그래밍 휴리스틱으로, 조건 분기는 호출자 쪽으로 올리고 반복 루프는 배치 처리 쪽으로 내려 명확성과 성능을 높인다. 함수가 입력에 따라 분기한다면 그 분기를 호출자로 옮기는 식으로, Option 대신 Walrus 타입을 받아 선택 사항을 타입으로 표현한다. 반복 최적화는 개별 호출 대신 배치 함수를 제공해 핫 루프를 분기 없이 실행하고 벡터화의 후보가 되도록 한다. 전체 요약 10문장 읽기 → 080 18:33 ▲ 11 · 댓글 2 긴 작업의 진행률을 아는 게 왜 이렇게 어려울까 로봇 같은 embodied agent가 장기 작업을 수행할 때, 현재 프레임만으로는 얼마나 진행했는지 판단하기 어렵다는 문제를 '문맥 의존적 진행률 추정'으로 정의했다. AI · 머신러닝 · ProgressCompass: Embodied Progress Reward Models Are Lost Without the Right Context
Key Point 로봇 작업 완수 시 진행 상황을 정확히 추적하는 것이 단순히 현재 상황만으로는 불가능하다는 근본적인 문제를 드러내고, 범용 모델 활용으로 기존 시스템을 개선할 수 있는 실질적 해법을 제시하기 때문이다.
핵심 요약
로봇 같은 embodied agent가 장기 작업을 수행할 때, 현재 프레임만으로는 얼마나 진행했는지 판단하기 어렵다는 문제를 '문맥 의존적 진행률 추정'으로 정의했다. 기존 Progress Reward Models(PRMs)는 각 단계에서 작업 진행도를 점수화하는데, 장기 작업에서는 이전에 일어난 일들의 맥락이 필요하지만 대부분 현재 관찰만으로 작동한다. 연구팀이 24개 조작 작업 120 에피소드로 구성한 ContextProgress-Bench를 구축했으며, 상태 재호출(이전 정보가 현재 프레임에 없음), 순서 추적(단계들이 정해진 순서대로 진행), 반복 구분(비슷한 프레임이 다른 진행 단계에 나타남) 등 3가지 시나리오를 다룬다. 전체 요약 6문장 읽기 → 081 18:33 ▲ 11 · 댓글 1 로봇이 스스로 배우는 데이터로 자기개선 가속화 로봇 파운데이션 모델 학습을 위해 다양한 데이터와 신뢰할 수 있는 평가 환경이 필요한데, 기존 시뮬레이션은 미리 정한 에셋과 스킬로만 제약받고 있다. AI · 머신러닝 · EmbodiedSmith: Scaling Embodied Data through Recursive Self-Improvement Flywheel in Simulation
Key Point 로봇 학습에 필요한 대규모 시뮬레이션 데이터를 자동으로 생성하면서 동시에 질을 높이는 기술로, 로봇 AI 개발 비용과 시간을 크게 단축할 수 있는 방법을 제시한다.
핵심 요약
로봇 파운데이션 모델 학습을 위해 다양한 데이터와 신뢰할 수 있는 평가 환경이 필요한데, 기존 시뮬레이션은 미리 정한 에셋과 스킬로만 제약받고 있다. EmbodiedSmith는 재귀적 자기개선(RSI) 방식으로 시뮬레이션 환경에서 대규모 로봇 데이터를 생성하는 프레임워크다. 에셋, 씬, 태스크 생성을 한 파이프라인에 통합하며, 언어 기반 커스터마이징과 자동 생성을 모두 지원한다. 전체 요약 8문장 읽기 → 082 18:33 ▲ 10 · 댓글 2 기존 과학 소프트웨어로 터미널 에이전트 자동 훈련 과학·전문 영역의 터미널 에이전트 훈련에는 실행 가능한 참조 동작과 의미적 정확성을 검증할 도메인별 검증기가 필요한데, 각 작업마다 이를 수작업으로 구축해야 하는 문제가 있다. AI · 머신러닝 · Self-Supervised Scaling of Terminal Environments for Scientific Domains
Key Point 기존 소프트웨어 워크플로우를 재사용하는 자체 지도 학습으로 도메인별 훈련 데이터 구축 비용을 대폭 줄이면서도 검증된 고품질 데이터를 얻을 수 있는 방법이 제시되었다.
핵심 요약
과학·전문 영역의 터미널 에이전트 훈련에는 실행 가능한 참조 동작과 의미적 정확성을 검증할 도메인별 검증기가 필요한데, 각 작업마다 이를 수작업으로 구축해야 하는 문제가 있다. 연구팀이 '소프트웨어 루프 내 재구성(Software-in-the-Loop Reconstruction, SWR)'이라는 자체 지도 학습 프레임워크를 제안했다. 이 방법은 기존 소프트웨어 워크플로우(구조화된 입력을 출력으로 매핑하는 실행 가능한 프로그램)에서 참조 출력과 검증 대상을 추출한다. 전체 요약 8문장 읽기 → 083 18:33 ▲ 18 · 댓글 2 시계열 예측에 뉴스 기반 사건 추론을 적용하는 SEER 모델 실제 시계열 데이터는 외부 사건과 구조적 변화에 의해 구동되는데, 기존 예측 방식은 과거 수치 데이터만으로는 충분하지 않다. AI · 머신러닝 · SEER: Self-Evolving Event Reasoning and Retrieval for Time Series Forecasting
Key Point 시계열 예측에 뉴스 기반 외부 사건을 통합하는 새로운 방식이 기존 모델보다 성능이 우수하다는 것을 보여주므로, 금융·에너지·주식 등 변동성 큰 시계열을 다루는 개발자와 연구자에게 중요하다.
핵심 요약
실제 시계열 데이터는 외부 사건과 구조적 변화에 의해 구동되는데, 기존 예측 방식은 과거 수치 데이터만으로는 충분하지 않다. 언어 모델을 통해 외부 뉴스를 검색할 수 있지만, 표준 검색 증강 방식은 높은 노이즈, 신호 손실, 사건 영향에 대한 인과적 추론 능력 부족의 문제가 있다. SEER는 시계열 예측을 위해 사건 조건화를 동적으로 최적화하는 폐루프 프레임워크로, 예측 오류를 두 가지 피드백 메커니즘으로 변환한다. 전체 요약 7문장 읽기 → 084 18:33 ▲ 23 · 댓글 1 자가생성 피드백이 테스트타임 훈련을 불안정하게 만든다 테스트타임 훈련(TTT)은 추론 중 모델이 가중치에 정보를 저장하도록 하는 방식인데, 모델이 자신의 출력으로부터 학습하면 각 업데이트가 다음 훈련 예제를 생성하는 모델을 동시에 바꾼다. AI · 머신러닝 · Self-Generated Feedback Destabilizes Test-Time Training: A Causal Decomposition of Long-Horizon Adaptation
Key Point 테스트타임 훈련에서 모델이 자신의 생성 텍스트로부터 학습할 때 나타나는 성능 저하의 인과 메커니즘을 밝히고, 이를 완화하는 구체적 방법들을 제시하기 때문에 TTT 연구자와 실무자에게 중요한 통찰을 제공한다.
핵심 요약
테스트타임 훈련(TTT)은 추론 중 모델이 가중치에 정보를 저장하도록 하는 방식인데, 모델이 자신의 출력으로부터 학습하면 각 업데이트가 다음 훈련 예제를 생성하는 모델을 동시에 바꾼다. 128K 토큰 스트림에서 생성 텍스트 업데이트를 유지하면 독립적인 인간이 쓴 텍스트에 대한 예측이 악화되는데, 이는 TTT-E2E의 125M, 760M, 3B 세 가지 모델 구성 모두에서 나타난다. Qwen3-4B의 기존 가중치를 Adam으로 업데이트할 때도 동일한 실패가 발생한다. 전체 요약 8문장 읽기 → 085 18:33 ▲ 20 · 댓글 2 재귀 언어모델의 고정점 최적화로 학습·추론 비용 2배 절감 루프된 언어모델의 매 반복은 학습·디코딩·프리필·강화학습에서 비용을 증가시키는데, 재귀 상태가 고정점에 가까워질수록 그 경로의 중요도는 감소한다. AI · 머신러닝 · Towards Looped Models Done Right, Part II: Rethinking at Fixed Points
Key Point 재귀 언어모델의 학습·추론 비용을 획기적으로 줄이는 구체적 기법(KV 캐시 축소, 역전파 생략, RL 속도 개선)과 이론적 기반(고정점 특성)을 제시하며, 실험 결과로 입증된 개선 방법을 다룬다.
핵심 요약
루프된 언어모델의 매 반복은 학습·디코딩·프리필·강화학습에서 비용을 증가시키는데, 재귀 상태가 고정점에 가까워질수록 그 경로의 중요도는 감소한다. 고정점 근처에서의 수렴 성질을 활용하면 학습 중 절단된 역전파(truncated backpropagation), 거의 정확도 손실 없는 터미널 KV 공유 디코딩, 1.79배 빠른 프리필을 위한 증류 학생 모델, 저장된 롤아웃 상태에서 그래디언트를 계산하는 RL 업데이트(재생 경로 역전파보다 2배 빠름)가 가능하다. 고정점을 형성하는 두 핵심 요소인 깊이 사전(depth prior)과 입력 주입(input injection)을 개선했다. 전체 요약 8문장 읽기 → 086 18:33 ▲ 10 · 댓글 1 쿼리마다 다른 에이전트 구조 자동 설계하는 SHIFT 발표 멀티에이전트 시스템의 역할·명령어·도구·통신 구조(harness)는 각 쿼리에 따라 달라져야 하는데, 기존에는 추론 시 여러 옵션을 실행하거나 수동으로 설계해야 했다. AI · 머신러닝 · Dynamic Harness Search: Building Multi-Agent Systems Per-Query via Prediction
Key Point 마이크로소프트·구글 같은 기업들도 멀티에이전트 워크플로우를 점점 더 활용하고 있는 가운데, 각 질문에 맞는 최적의 에이전트 구조를 비용 효율적으로 자동 설계하는 방법이 제시되었기 때문이다.
핵심 요약
멀티에이전트 시스템의 역할·명령어·도구·통신 구조(harness)는 각 쿼리에 따라 달라져야 하는데, 기존에는 추론 시 여러 옵션을 실행하거나 수동으로 설계해야 했다. SHIFT는 로컬 LLM 아키텍트가 탐색으로부터 harness 구성 정책과, 실행 결과로부터 정확도 대비 실행 비용을 예측하는 가치함수를 학습한다. 각 쿼리마다 Monte Carlo tree search가 이 예측값들을 이용해 harness를 구성하므로, 실행 과정을 탐색 루프 밖으로 옮긴다. 전체 요약 7문장 읽기 → 087 18:35 ▲ 292 · 댓글 394 LLM 시대, Common Lisp이 최고의 언어가 된 이유 LLM이 코드를 빠르게 작성하면서 병목은 컴파일과 재구성 시간으로 옮겨갔고, Common Lisp은 읽기·컴파일·실행 시간의 구분이 없어 피드백 루프가 거의 없다. AI · 머신러닝 · Why Common Lisp is now the best programming language
Key Point LLM이 코드 작성을 담당하면서 개발의 병목이 컴파일 시간으로 옮겨졌는데, Common Lisp의 라이브 이미지 기반 구조와 도메인 언어 구축 능력이 이 시대에 유독 적합하다는 주장을 이해해야 미래 기술 스택 선택에서 참고할 수 있다.
핵심 요약
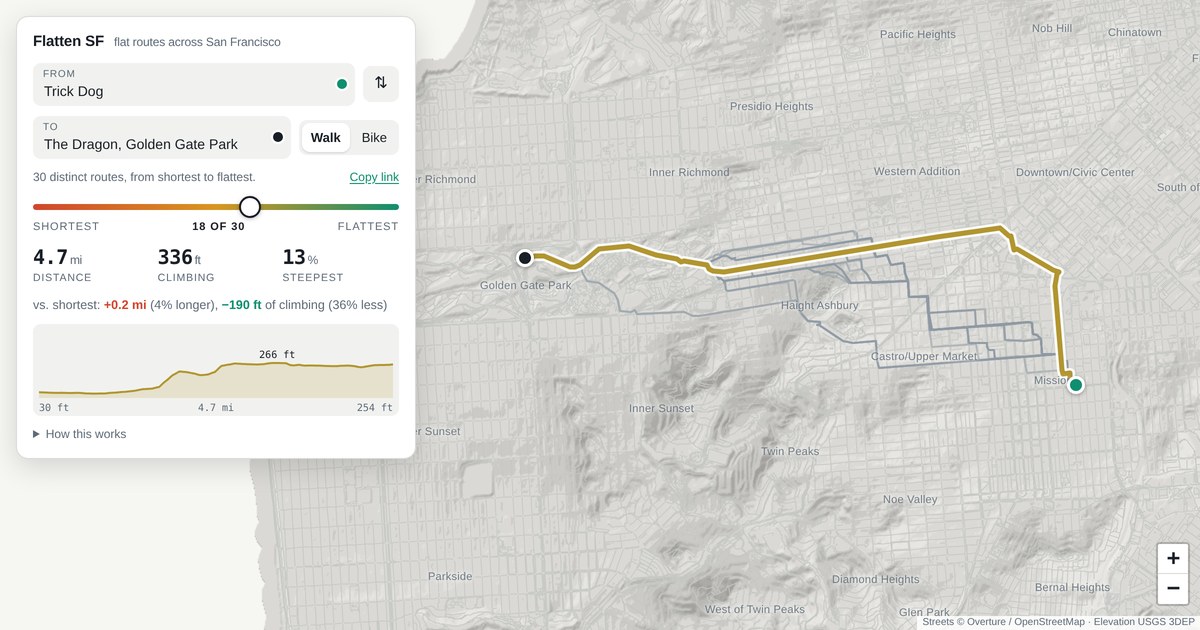
LLM이 코드를 빠르게 작성하면서 병목은 컴파일과 재구성 시간으로 옮겨갔고, Common Lisp은 읽기·컴파일·실행 시간의 구분이 없어 피드백 루프가 거의 없다. Common Lisp은 이미지 기반이라 함수 업데이트 시 재시작 불필요하고, 오류 발생 시 프로그램이 종료되지 않고 디버거를 열어 LLM이 직접 문제를 해결하고 재개할 수 있다. Lisp의 코드는 데이터와 같은 리스트 형태이므로 매크로로 언어에 새로운 구문을 추가할 수 있어, 프로그래머가 자신의 문제 영역을 위한 도메인 언어를 만들고 그 위에 프로그램을 작성한다. 전체 요약 8문장 읽기 → 088 18:35 ▲ 310 · 댓글 115 샌프란시스코에서 가장 평탄한 경로를 찾아주는 웹앱 브라우저에서 USGS 1m 라이다 고도 데이터와 OpenStreetMap 거리 네트워크를 활용해 샌프란시스코의 160,000개 도로 구간을 분석합니다. 웹 · 프론트엔드 · Find the flattest route between any two points in SF
Key Point 운동과 자전거 라이딩 시 오르막을 최소화해야 하는 사람들에게, 실제 고도 데이터 기반의 경로 최적화 도구가 제공됩니다.
핵심 요약
브라우저에서 USGS 1m 라이다 고도 데이터와 OpenStreetMap 거리 네트워크를 활용해 샌프란시스코의 160,000개 도로 구간을 분석합니다. 슬라이더를 조정해 거리와 오르막의 트레이드오프를 제어하며, 단축할 수 없는 최적 경로들만 제시됩니다. 오르막은 총 고도 상승량으로 계산되며, 자전거 모드에서는 보호 차로와 자전거 경로를 실제보다 짧게, 번잡한 대로는 길게 평가합니다. 전체 요약 6문장 읽기 → 089 06:11 ▲ 16 · 댓글 2 같은 블록 반복으로 LLM 깊이를 늘리는 LOOM 기법 Looped Transformers는 같은 Transformer 블록을 반복 적용해 파라미터를 늘리지 않고 모델의 유효 깊이를 증가시킨다. AI · 머신러닝 · Looping Beyond Twice: A Scalable Recipe for Looped Mixture-of-Experts
Key Point 같은 블록을 몇 번까지 반복할 수 있는지, 그리고 MoE 라우터의 동작 특성을 고려해 어떻게 효율적으로 설계할지가 실무 모델 개발에 직결된다.
핵심 요약
Looped Transformers는 같은 Transformer 블록을 반복 적용해 파라미터를 늘리지 않고 모델의 유효 깊이를 증가시킨다. 기존 연구는 반복 횟수 증가에 따른 성능 이득이 빠르게 감소해 2번 반복으로 제한했으며, MoE 모델에서 특히 이 문제가 심했다. LOOM은 두 가지 병목을 진단했다: 반복할 때마다 hidden-state 분산이 증가해 깊은 모델이 불안정해지는 '깊이의 저주' 현상, 그리고 라우터가 매번 같은 expert를 선택해 계산 다양성이 떨어지는 'expert 선택 붕괴' 현상이다. 전체 요약 8문장 읽기 → 090 06:11 ▲ 15 · 댓글 1 로봇이 시뮬레이션에서 배운 조작 기술을 현실에서 바로 쓴다 로봇이 시뮬레이션과 현실의 차이(시각, 역학, 몸체)를 넘어 기술을 옮기는 문제를 해결하는 Skill2Real 프레임워크를 제시했다. 하드웨어 · 시스템 · Skill2Real: Agentic Skill Learning for Zero-Shot Sim-to-Real Robot Manipulation
Key Point 시뮬레이션 학습으로 실제 로봇 조작을 성공시키는 과정이 공개됨에 따라, 로봇 개발의 데이터 수집 비용과 안전 리스크를 크게 줄일 수 있는 경로가 가시화되었다.
핵심 요약
로봇이 시뮬레이션과 현실의 차이(시각, 역학, 몸체)를 넘어 기술을 옮기는 문제를 해결하는 Skill2Real 프레임워크를 제시했다. 공통 API로 실행 가능한 스킬을 학습하며, Proposer-Verifier-Governor(PVG) 루프가 시뮬레이션 정보로 결과를 진단하고 업데이트를 검증한다. 소뇌(Cerebellum)에서 조작 스킬을 먼저 획득한 뒤 뇌(Brain)에서 소뇌를 고정하고 과제 수준의 조합을 학습한다. 전체 요약 8문장 읽기 → 091 06:11 ▲ 111 · 댓글 22 Haskell로 GTK4 할일 앱 만들기, 기초부터 Haskell, GTK 4, Adwaita 라이브러리를 이용해 할일 목록 애플리케이션을 만드는 튜토리얼의 첫 번째 파트다. 웹 · 프론트엔드 · Making a GTK application in Haskell, part 1
Key Point Haskell에서 GTK 애플리케이션을 구축하기 위한 구체적인 아키텍처와 구현 방식을 학습할 수 있으며, Elm Architecture를 실제 GUI 프로젝트에 어떻게 적용하는지 보여준다.
핵심 요약
Haskell, GTK 4, Adwaita 라이브러리를 이용해 할일 목록 애플리케이션을 만드는 튜토리얼의 첫 번째 파트다. Adwaita는 GNOME 프로젝트의 디자인 언어로, 접근성과 스타일 가이드(HIG)가 인코딩되어 있으며 라이트/다크 테마 전환에 따라 자동 리컬러링되는 반응형 설계를 지원한다. haskell-gi 도구킷을 사용하여 GTK 라이브러리에서 Haskell 바인딩을 자동 생성하고 C API와 유사한 Haskell 인터페이스를 제공한다. 전체 요약 10문장 읽기 → 092 03:11 ▲ 26 · 댓글 2 자동회귀 비디오 모델, 목표 지향적 추론으로 진화 자동회귀(AR) 비디오 생성 모델은 다음 청크 예측에 의존하면서 단기적·반응적 패러다임에 갇혀 있었고, 이는 목표 달성 과정이 중요한 추론 기반 생성 작업에서 한계였다. AI · 머신러닝 · ProAR: Learning Prospective Reasoning with Autoregressive Video Models
Key Point 자동회귀 모델의 근본적 한계인 '근시안적 예측'을 명시적 목표 조건화와 미래 예측으로 해결하는 방식이 새로우며, 표준 모델보다 훨씬 적은 학습량으로 더 좋은 결과를 얻을 수 있다는 것이 효율성 관점에서 실무 적용 가치가 있다.
핵심 요약
자동회귀(AR) 비디오 생성 모델은 다음 청크 예측에 의존하면서 단기적·반응적 패러다임에 갇혀 있었고, 이는 목표 달성 과정이 중요한 추론 기반 생성 작업에서 한계였다. ProAR은 AR 비디오 생성을 목표 지향적 추론 과정으로 전환하는 프레임워크로, 비대칭 어텐션 마스크를 통해 예측된 목표 프레임(goal frame)을 자동회귀 루프에 통합해 중간 상태 생성을 안내한다. 두 번째 핵심은 미래 표현 자기정렬(future representation self-alignment)로, 현재 은닉 상태가 다음의 시간적 역학을 예측하도록 유도하며, 티처 포싱으로 깨끗한 미래 표현을 추출하고 경량 예측기로 정렬한다. 전체 요약 6문장 읽기 → 093 15:11 ▲ 113 · 댓글 17 40년 된 고전 게임에서 메모리 손상 버그 발견 인포콤의 1983년 어드벤처 게임 '인피델'에서 와일드 포인터 메모리 손상 버그가 발견되었다. 오픈소스 · 도구 · Infidel goes wild
Key Point 40년 전 게임에 숨어있던 메모리 손상 버그가 최근에 발견된 것은 게임 개발 초창기 컴파일러 결함과 테스트 범위의 한계를 보여주는 흥미로운 사례다.
핵심 요약
인포콤의 1983년 어드벤처 게임 '인피델'에서 와일드 포인터 메모리 손상 버그가 발견되었다. 버그는 DESERT-TO-TABLE 루틴에서 발생한다. 기본값으로 사용되는 DESERT-TABLE 배열이 전역변수인데도 ZIL 컴파일러는 이를 상수로 취급했다. 결과적으로 배열 주소 11129 대신 메모리 주소 30부터 덮어쓰기가 발생했다. 전체 요약 10문장 읽기 → 094 21:11 당일 +101 클라우드플레어, AI 업무 환경 'Cloudflare OS' 오픈소스화 클라우드플레어가 자사 직원들을 위해 개발한 AI 생산성 환경 'Cloudflare OS'를 오픈소스로 공개했다. AI · 머신러닝 · cloudflare/cloudflare-os · TypeScript
Key Point SaaS 중심의 클라우드 아키텍처에서 벗어나 사용자 각자가 자신만의 AI 에이전트와 앱을 보유하고 제어하는 새로운 소프트웨어 배포 방식을 제시하는 대규모 오픈소스 플랫폼이다.
핵심 요약
클라우드플레어가 자사 직원들을 위해 개발한 AI 생산성 환경 'Cloudflare OS'를 오픈소스로 공개했다. 사용자는 에이전트 채팅 UI를 통해 회사 맥락을 담은 작업을 요청하고, AI가 작성한 앱 '가젯'을 샌드박스에서 안전하게 구동하며, '게이트키퍼'라는 보안 프레임워크로 에이전트와 앱의 접근을 제어한다. 각 사용자는 자신만의 가젯 인스턴스를 소유하므로 보안 버그로도 다른 사용자 데이터가 유출될 수 없고, 필요한 기능은 AI에 요청해 직접 코드를 수정할 수 있다. 전체 요약 11문장 읽기 → 095 03:11 ▲ 100 · 댓글 15 컴파일러 관점으로 C++ 코드를 변환해주는 오픈소스 도구 C++ Insights는 Clang 기반의 소스-소스 변환 도구로, 컴파일러가 숨겨서 처리하는 작업을 명시적으로 보여준다. 오픈소스 · 도구 · C++ Insights – See your source code with the eyes of a Compiler
Key Point C++ 개발자가 컴파일러의 동작을 이해하고 명시적 타입·연산자 호출을 추적해야 할 때, 복잡한 템플릿이나 자동 타입 추론의 실제 결과를 시각화할 필요가 있을 때 유용한 도구다.
핵심 요약
C++ Insights는 Clang 기반의 소스-소스 변환 도구로, 컴파일러가 숨겨서 처리하는 작업을 명시적으로 보여준다. 사용자가 작성한 코드를 컴파일러가 실제로 이해하는 형태로 변환하는데, 예를 들어 복사 생성자·이동 생성자·대입 연산자 같은 암묵적 특수 멤버 함수와 타입 캐스팅을 명확하게 드러낸다. 람다, 범위 기반 for 루프, 구조화된 바인딩(C++17), auto 타입 추론, decltype 변환 등을 컴파일 가능한 C++ 코드로 변환할 수 있다. 전체 요약 9문장 읽기 → 096 16:56 ▲ 159 · 댓글 75 숨겨진 정보 게임 스트래테고, AI가 인류 최강자 제압 스트래테고는 체스·바둑·포커처럼 AI가 도전해온 게임이지만, 거대한 숨겨진 정보와 2,000수 이상의 긴 게임 길이 때문에 DeepMind도 해결하지 못했다. AI · 머신러닝 · With most information hidden, the game Stratego had stumped AI until now
Key Point AI 연구에서 오랫동안 미해결로 남던 문제를 해결했으며, 막대한 자원 없이도 최강자를 이길 수 있음을 보였기 때문이다.
핵심 요약
스트래테고는 체스·바둑·포커처럼 AI가 도전해온 게임이지만, 거대한 숨겨진 정보와 2,000수 이상의 긴 게임 길이 때문에 DeepMind도 해결하지 못했다. 카네기멜론·MIT·NYU·스탠포드 연구팀이 개발한 AI 아타락소스는 역대 최강자 핌 니메이예르를 20게임 중 15승 1패 4무로 압도했다. 스트래테고는 40개 피스의 조합이 데실리언 가지에 달하고, 블러핑이 핵심이라 기존 AI들이 전략을 찾기 어려웠다. 전체 요약 12문장 읽기 → 097 12:11 ▲ 106 · 댓글 80 모든 SaaS는 AI 모델을 감싸는 '하네스'로 진화한다 SaaS 기업의 미래는 상태 없는 LLM을 감싸는 인프라, 인터페이스, 컨텍스트, 상태로 이루어진 '하네스'가 되는 것이다. AI · 머신러닝 · Every SaaS business will become a harness around a model
Key Point 현재 AI 모델 기반 스타트업과 기업들이 어떤 구조로 진화할 것인지, 소프트웨어 개발과 조직 운영의 근본적 전환을 설명하는 프레임워크다.
핵심 요약
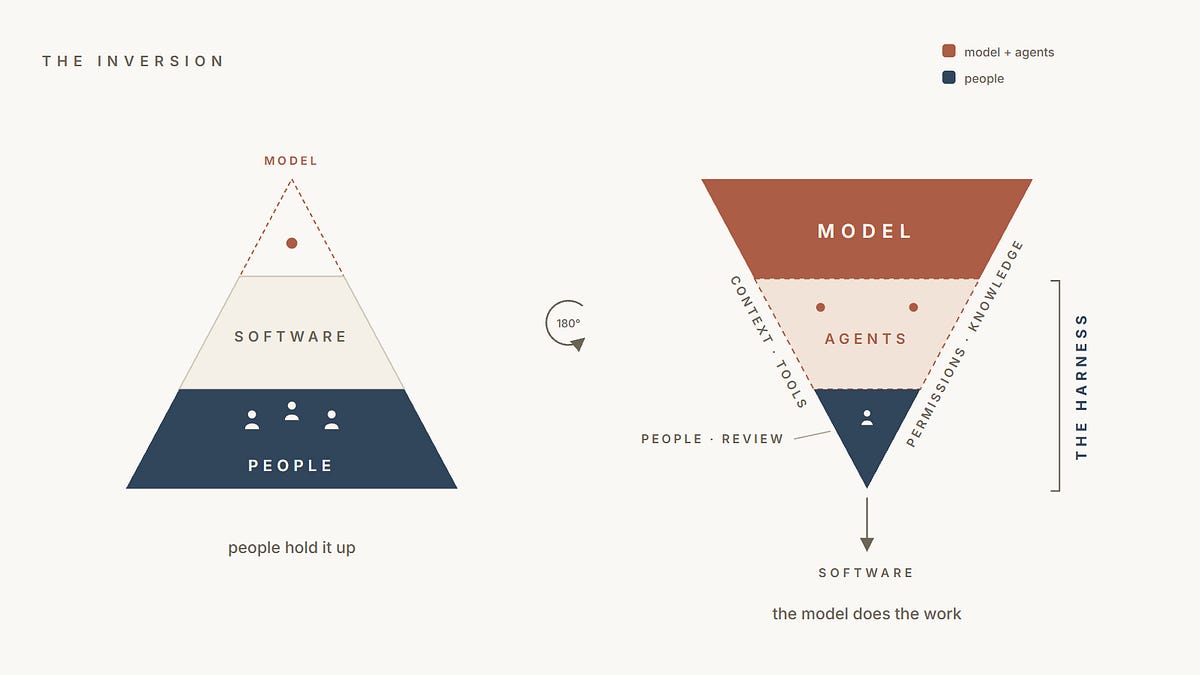
SaaS 기업의 미래는 상태 없는 LLM을 감싸는 인프라, 인터페이스, 컨텍스트, 상태로 이루어진 '하네스'가 되는 것이다. 소프트웨어 서비스 기업의 진화 경로는 전통적 SaaS → 엔지니어가 에이전트와 협력 → 클라우드 배경 에이전트들이 핵심 작업 수행 → 에이전트들이 주도적으로 의사결정하고 인간은 검증만 하는 단계로 진행된다. 최종적으로 회사 자체가 하네스가 되면 소프트웨어 생산 업무가 사람에서 하네스로 완전히 이동하고, 모든 조직원은 하네스의 일부가 된다. 전체 요약 9문장 읽기 → 098 03:11 ▲ 34 · 댓글 2 루프형 트랜스포머의 추론 효율 50% 끌어올리는 LoopCD 루프형 트랜스포머는 재귀 루프 내에서 공유 블록을 반복 실행해 매개변수 효율을 높이지만, 각 루프마다 생성되는 중간 표현은 표준 디코딩에서 버려진다. AI · 머신러닝 · Decoding Looped Transformers Better for (Almost) Free
Key Point 루프형 트랜스포머는 추론 효율을 중시하는 모바일·엣지 환경에서 주목받는데, LoopCD로 추론 계산량을 절반 가까이 줄이면서 정확도도 높일 수 있다는 것이 중요하다.
핵심 요약
루프형 트랜스포머는 재귀 루프 내에서 공유 블록을 반복 실행해 매개변수 효율을 높이지만, 각 루프마다 생성되는 중간 표현은 표준 디코딩에서 버려진다. 강한 예측과 약한 예측을 자동으로 쌍으로 제공하는 루프의 특성을 활용하면, 보조 모델이나 외부 학습 없이 디코딩을 개선할 수 있다. 연구진은 훈련 없는 대비학습 프레임워크 LoopCD를 제안했으며, 최종 예측을 이전 루프와 비교해 토큰 선택을 안내한다. 전체 요약 7문장 읽기 → 099 12:11 ▲ 115 · 댓글 26 LLM이 스스로 컨텍스트를 관리하는 새로운 모델 등장 Context Language Models(CLM)은 언어 모델이 자체 컨텍스트를 원시적으로 관리할 수 있도록 설계되었다. AI · 머신러닝 · Context Language Models
Key Point 컨텍스트 관리를 모델 스스로 학습하도록 함으로써 에이전트 시스템의 효율성과 확장성을 크게 개선할 수 있는 새로운 구조를 제시하기 때문이다.
핵심 요약
Context Language Models(CLM)은 언어 모델이 자체 컨텍스트를 원시적으로 관리할 수 있도록 설계되었다. 컨텍스트를 파일처럼 취급하여 모델이 이를 자유롭게 업데이트하도록 함으로써, 중요한 정보 유지 방식을 스스로 학습하게 한다. 다중 에이전트 시스템에서 여러 에이전트의 컨텍스트가 파일 형태로 공존할 수 있다. 전체 요약 9문장 읽기 → 100 06:11 ▲ 13 · 댓글 2 로봇 세계 모델로 복합 작업 학습을 자동화하다 로봇 조작 작업에서 재사용 가능한 기술을 여러 조합으로 활용할 때, 추가 시연을 통한 개선이 비용이 많이 드는 문제를 해결하는 ROBOCOACH 프레임워크를 제시했다. AI · 머신러닝 · RoboCoach: World Models as Active Coaches for Compositional Robot Skills
Key Point 세계 모델로 상상된 실패를 감지해 학습 데이터를 효율적으로 선택하는 방식으로, 로봇이 자동으로 어떤 기술부터 개선할지 결정할 수 있게 하는 방법을 보여준다.
핵심 요약
로봇 조작 작업에서 재사용 가능한 기술을 여러 조합으로 활용할 때, 추가 시연을 통한 개선이 비용이 많이 드는 문제를 해결하는 ROBOCOACH 프레임워크를 제시했다. 세계 모델 기반의 코칭 시스템으로, 상상된 실패를 감지해 어떤 기술을 학습할지, 어느 전문가 모델을 업데이트할지를 자동으로 결정한다. Route-Imagine-Diagnose-Improve(RIDI) 루프는 공유 액션-조건부 세계 모델인 COACHWORLD 내에서 재사용 가능한 기술 전문가들을 실행하고, 진행 판단자가 실패하는 첫 번째 부작업을 기록한다. 전체 요약 7문장 읽기 →