쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
100건 (최대치) · "진단"조건 지우기 ×
001 15:11 ▲ 14 · 댓글 1 에이전트 학습용 대규모 전문직 작업 데이터셋 자동 생성 전문가 에이전트를 지도학습으로 훈련하려면 신뢰할 수 있는 전문직 작업의 시연 데이터가 필요하지만, 작업 정보의 불완전성이 학습을 방해한다. AI · 머신러닝 · WorkFactory: Turning Professional Intents into Executable Work for Scalable Agent Training
Key Point 대규모 전문직 에이전트 학습 데이터를 자동으로 생성하는 새로운 방법론과 112K+ 규모의 실제 데이터셋, 그리고 검증된 모델을 제시하므로 에이전트 기반 자동화 시스템 개발자들이 참고할 실질적 자산이다.
핵심 요약
전문가 에이전트를 지도학습으로 훈련하려면 신뢰할 수 있는 전문직 작업의 시연 데이터가 필요하지만, 작업 정보의 불완전성이 학습을 방해한다. WorkFactory는 전문직 의도(intent)로부터 실행 가능한 작업을 자동으로 구성하는 프레임워크로, 정보 수준의 계획 단계에서 의존성과 정보 위치를 명시적으로 그래프화한다. 프로브 실행(probe execution) 단계에서 정보 지원의 실패를 감지하고 원래 의도는 유지하면서 작업을 수리한다. 전체 요약 8문장 읽기 → 002 15:11 ▲ 11 · 댓글 1 텍스트·이미지 섞인 생성 평가하는 IntReal 데이터셋 공개 인간이 자연스럽게 텍스트와 이미지를 섞어가며 콘텐츠를 소비하지만, 통합 멀티모달 모델(UMM)의 인터리브된 생성은 제대로 연구되지 않았다. AI · 머신러닝 · IntReal: A Real-World Dataset and Benchmark for Multimodal Interleaved Generation
Key Point 텍스트와 이미지를 섞어 생성하는 멀티모달 AI의 성능을 처음으로 체계적으로 평가할 벤치마크가 등장해, 이 분야 연구와 모델 개선의 기초가 될 것으로 예상된다.
핵심 요약
인간이 자연스럽게 텍스트와 이미지를 섞어가며 콘텐츠를 소비하지만, 통합 멀티모달 모델(UMM)의 인터리브된 생성은 제대로 연구되지 않았다. 현 상황의 근본 문제는 명확한 인터리브 생성 작업과 학습 데이터 부재, 그리고 모델 성능을 세밀하게 진단할 평가 프로토콜 부족이다. IntReal은 100K 샘플의 실제 멀티모달 데이터셋과 전문 모델 7개 차원으로 모델을 평가하는 IntReal Evaluation Suite로 구성된다. 전체 요약 6문장 읽기 → 003 15:11 ▲ 61 · 댓글 1 벤치마크가 말해주지 않는 것: 어려움의 분포 문제 벤치마크는 단순한 문제 모음이 아니라 자연스럽게 난이도에 대한 경험적 분포를 만들며, 이 관점에서 벤치마크 평가를 재검토하는 새로운 틀을 제시한다. AI · 머신러닝 · Your Benchmark Is an Empirical Measure Over Difficulty
Key Point 평가 지표의 신뢰성이 중요한 만큼, 기존 벤치마크들이 어떤 한계를 가지고 있으며 그것이 리더보드 순위를 얼마나 왜곡할 수 있는지 정량적으로 드러낸다.
핵심 요약
벤치마크는 단순한 문제 모음이 아니라 자연스럽게 난이도에 대한 경험적 분포를 만들며, 이 관점에서 벤치마크 평가를 재검토하는 새로운 틀을 제시한다. 벤치마크의 중심 문제 두 가지를 정의한다: 벤치마크의 난이도 분포가 의도한 분포와 다른 '측정값 불일치(measure mismatch)', 난이도 축의 특정 구간이 비어 있어 모델 개선을 감지하지 못하는 '커버리지 갭(coverage gaps)'. 이 두 문제를 포착하는 진단 지표를 제안하고 엄밀한 이론적 보장을 제공한다. 전체 요약 6문장 읽기 → 004 06:11 ▲ 140 · 댓글 213 특이점 이후 우리는 "그냥 놀지" 못할 것이다 AI 초지능 시대를 맞아 기존의 '무한한 휴가를 즐기며 지낸다'는 낙관론이 현실적이지 않다는 주장이다. AI · 머신러닝 · We won't "just hang out"
Key Point 기존의 AI 유토피아 상은 '일 없이 즐긴다'이지만, 저자는 그 과정에서 인간관계의 물질적·심리적 기초가 모두 무너질 것으로 진단한다.
핵심 요약
AI 초지능 시대를 맞아 기존의 '무한한 휴가를 즐기며 지낸다'는 낙관론이 현실적이지 않다는 주장이다. 일단 사람을 만날 이유가 사라진다. 일은 점차 무의미해지고, 교육도 노동 결과가 없으면 의미가 없어지며, 직업 공동체에서 만나던 우정도 AI가 인간 기여를 불필요하게 만들면서 사라진다. 청년 세대는 기성세대처럼 AI 이전의 관계망을 물려받을 수 없다. 전체 요약 8문장 읽기 → 005 12:11 ▲ 132 · 댓글 15 암 치료 1년, 병원 침대에서 쓴 기술자의 일상 저자는 림프종 진단을 받고 지난 1년간 화학요법을 받으며 겪은 경험을 기술한다. 기타 · A Health Update
Key Point 극한의 의료 상황 속에서도 기술 전문가의 책임감을 잃지 않고, 개인의 건강 투쟁과 직업 현실을 솔직하게 드러내는 글이다.
핵심 요약
저자는 림프종 진단을 받고 지난 1년간 화학요법을 받으며 겪은 경험을 기술한다. 첫 6주간 주 1회 요추천자로 척수액에 메토트렉세이트를 주입받았으며, 이 과정 후 심각한 두통이 발생해 누워서 지내야 했다. 이후 벤다무스틴과 리투익시맙을 28일 주기로 투여받으며 미각 변화, 근손실, 극심한 피로 등을 경험했다. 전체 요약 11문장 읽기 → 006 06:11 ▲ 11 · 댓글 2 AI 에이전트가 자신의 개선 방법을 스스로 최적화한다 언어 에이전트가 재사용 가능한 스킬에 절차적 지식을 저장하는데, 기존 스킬 최적화 방법들은 사람이 설계한 고정된 절차를 따르거나 각 작업마다 메타스킬을 재학습한다. AI · 머신러닝 · Skill^{infty}: Recursive Self-Improvement for Agent Skill Optimization
Key Point AI 에이전트가 문제 해결 방법 자체를 자동으로 개선할 수 있는 체계가 나왔으며, 이는 AGI로 향하는 재귀적 자기개선의 실질적 구현 사례다.
핵심 요약
언어 에이전트가 재사용 가능한 스킬에 절차적 지식을 저장하는데, 기존 스킬 최적화 방법들은 사람이 설계한 고정된 절차를 따르거나 각 작업마다 메타스킬을 재학습한다. Skill^∞는 메타 에이전트가 메타스킬을 따라 작업 스킬을 최적화하고, 동일한 절차로 메타스킬 자신도 최적화하는 재귀적 자기개선(RSI) 방식을 제시한다. 최적화 과정은 에이전트가 주도하며, 실행 추적을 진단하고 후보를 제안하며 독립적 검토를 요청하고 탐색 예산을 배분하는 단계들을 정의한다. 전체 요약 6문장 읽기 → 007 18:11 ▲ 13 · 댓글 7 작은 오픈소스 모델, 실제 코딩 업무에 얼마나 써먹을까 벤치마크 점수가 높은 오픈 가중치 모델도 실제 코딩 작업에서는 텍스트 생성과 실행 가능한 코드 생성이 별개 문제임을 보여주는 경험 보고서다. AI · 머신러닝 · Beyond Benchmarks: Can Small Open-Weight Models Get Real Coding Work Done?
Key Point 오픈소스 코딩 모델의 실전 성능은 벤치마크와 크게 다르며, 직접 호출과 에이전트 위임 간 성공률 격차가 큼을 실측 데이터로 보여준다.
핵심 요약
벤치마크 점수가 높은 오픈 가중치 모델도 실제 코딩 작업에서는 텍스트 생성과 실행 가능한 코드 생성이 별개 문제임을 보여주는 경험 보고서다. 저자가 2026년 7월부터 10월까지 수행한 엔지니어링 작업을 기반으로, vLLM, SGLang, llama.cpp, MLX 등 여러 모델 서빙 환경에서 같은 엔드포인트로 표시되는 모델들도 도구 호출 형식, 턴 제어, 컨텍스트 동작, 캐시 재사용, 신뢰성 면에서 차이를 보임을 기록했다. 4,165개의 코딩 에이전트 게이트웨이 턴, 623개의 디버그 작업, 고정된 Claude Opus 5.5 부모 모델과 숨겨진 동작 검증을 포함한 3개 위임 연구가 증거다. 전체 요약 10문장 읽기 → 008 12:11 ▲ 23 · 댓글 3 장편 비디오 생성, 과거 참조가 항상 도움이 될까 장편 비디오 생성 모델이 과거 프레임을 참조해 캐릭터 일관성을 유지하려는 시도가 늘고 있지만, 과거 정보가 반드시 더 나은 결과를 만드는지 체계적으로 검증한 논문이다. AI · 머신러닝 · More Memory, Better Videos? A Controlled Study of Visual Memory in Long-Video Generation
Key Point 과거 정보 활용이 비디오 생성의 필수 요소로 여겨지지만, 실제 측정을 통해 정확성 하락과 부작용을 드러낸 점이 산업의 관행에 의문을 제기한다.
핵심 요약
장편 비디오 생성 모델이 과거 프레임을 참조해 캐릭터 일관성을 유지하려는 시도가 늘고 있지만, 과거 정보가 반드시 더 나은 결과를 만드는지 체계적으로 검증한 논문이다. 연구팀은 92개 영화의 16,548개 세그먼트와 30개 생성된 스토리(2,824개 세그먼트)를 대상으로 VMem-Bench라는 2단계 진단 시스템을 구축했다. 메모리 검색이 없는 경우 엔티티 재현율은 0.559였으나, 검색 사용 시 0.628~0.693으로 개선되고 과거 외형과의 유사도도 높아졌다. 전체 요약 6문장 읽기 → 009 12:11 ▲ 22 · 댓글 2 비디오 생성 모델의 카메라 흔들림 문제 해결 프레임워크 제안 확산 기반 비디오 생성 모델(VGM)은 시각적으로 그럴듯한 영상을 만들지만, 카메라 시점 이동(ego-motion)이 긴 구간에서 흔들리는 문제가 있다. AI · 머신러닝 · CausalAlign: Causal Alignment of Video Generation Models for Consistent Ego-Motion
Key Point 비디오 생성 모델이 장시간 일관된 카메라 움직임을 유지하는 방법론을 제시해 실제 로봇 작업 성능까지 향상시킨 기술적 진전을 보여주기 때문이다.
핵심 요약
확산 기반 비디오 생성 모델(VGM)은 시각적으로 그럴듯한 영상을 만들지만, 카메라 시점 이동(ego-motion)이 긴 구간에서 흔들리는 문제가 있다. CausalAlign은 두 가지 요소로 구성된 인과 정렬 프레임워크로, 먼저 선형 프로브와 인과적 개입을 통해 VGM 내에서 ego-motion이 어떻게 표현·사용·유지되는지 진단한다. 진단 결과 노이즈 제거 과정에서 ego-motion 표현이 상승했다가 하강하는 패턴을 발견했다. 전체 요약 7문장 읽기 → 010 00:11 ▲ 31 · 댓글 2 LLM 에이전트 자체 학습 능력 강화법 제시 LLM 에이전트가 모델 파라미터를 업데이트하지 않고 실행 경험에서 학습하는 harness self-evolution에서, 같은 스킬이 강한 모델과 약한 모델에 미치는 영향이 크게 다르다는 문제를 발견했다. AI · 머신러닝 · Evolving to Match Capabilities: Improving Harness Self-Evolution via Skill Adaptation
Key Point 약한 LLM 모델의 성능 저하 문제를 스킬 적응으로 해결하는 구체적인 방법론이 제시되어, 실무에서 다양한 규모의 언어 모델을 배포하는 개발자들이 자체 학습 효율을 크게 높일 수 있다.
핵심 요약
LLM 에이전트가 모델 파라미터를 업데이트하지 않고 실행 경험에서 학습하는 harness self-evolution에서, 같은 스킬이 강한 모델과 약한 모델에 미치는 영향이 크게 다르다는 문제를 발견했다. 7개 모델과 3개 벤치마크에서 103개의 작업-스킬 조합을 분석한 결과, 어떤 스킬은 GPT-5.6-luna의 성능을 31.1점 높였지만 Gemma-4-E4B의 성능을 8.8점 낮췄다. 약한 모델의 실패 사례 86%에서 스킬 자체에 이미 명시된 요구사항을 위반했으므로, 실행자의 능력에 맞게 스킬을 재작성하는 skill adaptation을 제안했다. 전체 요약 7문장 읽기 → 011 00:11 ▲ 24 · 댓글 2 저정밀 연산 RL에서 성능과 안정성을 동시에 확보한 miniTE 공개 Native NVFP4는 대형언어모델(LLM) 강화학습을 가속화할 수 있지만, 학습 엔진과 샘플링 엔진 사이의 수치 실행 일관성 유지가 어려운 문제가 있다. AI · 머신러닝 · miniTE: Diagnosing and Bridging the Execution Gap in Native NVFP4 Reinforcement Learning
Key Point LLM 강화학습에서 저정밀 연산의 수치 안정성 문제를 해결하고 1.4배 이상의 처리 속도 향상을 달성한 기술이 공개되어, 더 효율적이고 저비용의 LLM 학습이 가능해진다.
핵심 요약
Native NVFP4는 대형언어모델(LLM) 강화학습을 가속화할 수 있지만, 학습 엔진과 샘플링 엔진 사이의 수치 실행 일관성 유지가 어려운 문제가 있다. 단순히 모델 가중치와 수치 형식을 맞추는 것만으로는 일관된 정책 평가를 보장할 수 없으며, 크로스 엔진 수치 정렬이 중요함을 확인했다. miniTE는 실행 진단, 크로스 엔진 수치 정렬, W4A4 GEMM 계산을 결합한 경량 프레임워크로, RL 목적함수를 수정하지 않으면서도 수치 일관성을 개선한다. 전체 요약 6문장 읽기 → 012 18:11 ▲ 52 · 댓글 2 LLM 에이전트의 지속 학습 능력을 측정하는 벤치마크 CLE 공개 지속 학습(Continual Learning)은 LLM 에이전트가 경험으로부터 지식을 습득·정제·적용하면서 기존 지식을 보존하는 능력으로, 장기적 학습에 필수적이나 현재 평가는 개별 과제 성능 중심이다. AI · 머신러닝 · Continual Learning Exam: Benchmarking Long-Horizon RSI and Experiential Learning in LLM Agents
Key Point LLM이 점진적 경험 누적으로 실제 직무를 수행할 수 있는지 평가하는 새로운 방식이 나왔고, 현존 모델의 이러한 능력이 절반 수준에 불과하다는 객관적 지표를 제시한다.
핵심 요약
지속 학습(Continual Learning)은 LLM 에이전트가 경험으로부터 지식을 습득·정제·적용하면서 기존 지식을 보존하는 능력으로, 장기적 학습에 필수적이나 현재 평가는 개별 과제 성능 중심이다. 허깅페이스와 도메인 전문가 50명이 개발한 CLE는 120개의 인간 저작 과제로 구성되며, 각 과제는 5단계 계단식 구조여서 총 600개 레벨, 12개 직업 도메인 89개 전문 역할에 걸쳐 있다. 에이전트는 각 레벨을 통과해야 다음 레벨을 해제할 수 있고, 뒤의 과제들은 이전 과제에서 축적한 경험에 기반한다. 전체 요약 7문장 읽기 → 013 18:11 ▲ 24 · 댓글 2 대규모 언어모델의 자동 개선, 안전성을 어떻게 보장할까 대규모 모델 기반 AI 시스템은 경험과 피드백으로 모델·프롬프트·메모리·도구·워크플로우를 지속적으로 변경하고, 이 개선 과정 자체도 수정해 반복 적용하는 재귀적 자동 개선(RSI)을 한다. AI · 머신러닝 · Trustworthy Recursive Self-Improvement in the Era of Large Models: Foundation, Risks, Evaluation and Open Challenges
Key Point 큰 모델이 스스로 개선하는 시대가 오고 있는데, 그 과정에서 안전성·투명성·제어 가능성을 어떻게 보장할지가 AI 신뢰성의 핵심 문제이기 때문이다.
핵심 요약
대규모 모델 기반 AI 시스템은 경험과 피드백으로 모델·프롬프트·메모리·도구·워크플로우를 지속적으로 변경하고, 이 개선 과정 자체도 수정해 반복 적용하는 재귀적 자동 개선(RSI)을 한다. 자동 개선이 신뢰할 수 있으려면 평가 결과가 정확하고, 기존 능력이 퇴화하지 않으며, 행동 제약이 유지되어야 하며, 민감 정보가 후속 시스템에 남지 않아야 한다. 개선 메커니즘 변경 시 이전 검증 결과가 무효화되고 인간의 감시 효과가 떨어질 수 있어, 신뢰성 있는 RSI는 투명성과 제어 가능성을 필수적으로 요구한다. 전체 요약 7문장 읽기 → 014 00:11 ▲ 18 · 댓글 2 전문가 윤리규범 위반 감지하는 러시아어 벤치마크 공개 전문 분야 윤리규범을 위반하는 요청을 감지하기 위한 TenetBench 데이터셋을 공개했다. AI · 머신러닝 · TenetBench: A Clause-Anchored Russian Corpus for Evaluating Language Models against Professional Codes of Ethics
Key Point 언어 모델이 전문 분야 윤리 위반 요청에 어떻게 대응하는지 측정할 수 있는 체계적인 벤치마크가 부재했는데, 이제 자동 생성 파이프라인으로 지속 확장 가능한 평가 도구가 제시되었다.
핵심 요약
전문 분야 윤리규범을 위반하는 요청을 감지하기 위한 TenetBench 데이터셋을 공개했다. 러시아 15개 전문 분야 코드 조항과 충돌하는 3,433개 요청과, 요청의 적절성만 다른 동일한 요청 쌍으로 구성되어 있다. 자동 파이프라인이 코드 텍스트에서 작업을 생성하므로 새 코드가 추가될 때마다 데이터셋이 확장되고, 실행할 때마다 새 작업이 생성된다. 전체 요약 10문장 읽기 → 015 18:11 ▲ 34 · 댓글 2 세계 모델과 멀티모달 에이전트 분리 평가 프레임워크 공개 World Model(WM)이 시뮬레이션된 경험으로 Multimodal Agent(MA)를 지원하고, 에이전트 궤적이 WM 개선에 기여하는 상호작용을 평가하기 위해 액션 선택과 상태 진화에 대한 별도의 증거가 필요하다. AI · 머신러닝 · Dual Exam: Controlled Evaluation of Multimodal Agents and World Models
Key Point 멀티모달 에이전트와 세계 모델의 상호작용을 처음 체계적으로 분리 평가하는 프레임워크로, 현재 AI 시스템들이 실제 협력에서 왜 실패하는지 진단할 수 있는 벤치마크를 제공한다.
핵심 요약
World Model(WM)이 시뮬레이션된 경험으로 Multimodal Agent(MA)를 지원하고, 에이전트 궤적이 WM 개선에 기여하는 상호작용을 평가하기 위해 액션 선택과 상태 진화에 대한 별도의 증거가 필요하다. Dual Exam은 고정된 환경 응답 메커니즘 하에서 에이전트를, 고정된 액션 개입 하에서 WM을 테스트하며, 물리·디지털·사회·과학 도메인을 다룬다. 에이전트 트랙은 10개 구성으로 1,088개 항목을 15개 보고 카테고리로 평가하고, WM 트랙은 8개 시나리오에서 400개 케이스를 포함한다. 전체 요약 8문장 읽기 → 016 06:11 ▲ 295 · 댓글 147 10년 된 CNN이 최신 LLM을 이기다, 피부암 진단 2015년 구글이 발표한 Inception v3 CNN을 피부과 이미지로 20분 정도 미세조정한 모델이 GPT-6 Astra와 Claude Fable 5.1 두 최신 LLM을 피부암 진단에서 압도했다. AI · 머신러닝 · A 10-year-old CNN outperforms frontier LLMs for skin cancer diagnosis
Key Point 이 글은 대규모 언어모델의 의료 진단 능력이 특화된 구형 모델에 미치지 못한다는 구체적인 임상 증거를 보여주며, LLM이 모든 분야에서 기존 방식을 대체할 수 없음을 시사한다.
핵심 요약
2015년 구글이 발표한 Inception v3 CNN을 피부과 이미지로 20분 정도 미세조정한 모델이 GPT-6 Astra와 Claude Fable 5.1 두 최신 LLM을 피부암 진단에서 압도했다. 임상 사진과 피부경 이미지를 포함한 조직검사로 확진된 200개 병변 테스트에서 CNN은 125개(62%)를 올바르게 진단했지만 두 LLM은 각각 84개와 85개(42%)만 정확했다. 테스트 병변은 MILK10k 공개 데이터셋에서 무작위 선정했으며, 진단 불가능 범주 100개(흑색종 30, 기저세포암 25, 편평세포암 25, 광선각화증 20)와 안전 범주 100개(양성모반 50, 지루각화증 50)로 구성됐다. 전체 요약 12문장 읽기 → 017 18:11 ▲ 102 · 댓글 23 알츠하이머 수면장애, 뇌 염증 억제하면 회복 가능 미국 켄터키 대학 연구팀이 알츠하이머병의 수면 손실이 뇌 아밀로이드 플라크가 아니라 뇌 면역세포인 소교세포의 과도한 염증 반응이 주 원인임을 발견했다. AI · 머신러닝 · Alzheimer's breakthrough: 2 hrs of sleep restored without clearing brain plaques
Key Point 플라크 제거 없이 뇌 염증만 억제해도 수면이 2시간 이상 회복된다는 발견은 알츠하이머 치료 패러다임을 바꿀 수 있으며, 휴대형 EEG로 조기 진단이 가능해질 가능성을 연다.
핵심 요약
미국 켄터키 대학 연구팀이 알츠하이머병의 수면 손실이 뇌 아밀로이드 플라크가 아니라 뇌 면역세포인 소교세포의 과도한 염증 반응이 주 원인임을 발견했다. 알츠하이머 모델 마우스에서 약물(PLX3397)로 소교세포 약 87%를 일시 제거했을 때, 플라크를 제거하지 않고도 하루 2시간 이상의 수면이 회복되고 깊은 수면(NREM) 시간이 증가했다. 정상 노화에서는 REM 수면이 주로 감소하지만, 알츠하이머 병리는 신체 회복과 독소 제거 기능을 하는 NREM 수면을 선택적으로 방해한다. 전체 요약 8문장 읽기 → 018 03:11 ▲ 124 · 댓글 59 실직 후 코르티손, 깨끗한 마음으로 삶을 재설계하다 8월 18일 저자는 구조조정으로 인해 갑작스럽게 해고되었고, 6개월 수습 기간 중이어서 2주간의 유급 휴직 후 처음으로 실직 상태에 처하게 됐다. 기타 · Job loss and cortisone mania
Key Point 실직 후 자가면역 질환 악화, 코르티손 투약, 그 과정에서 경험한 조증적 생산성과 부작용을 솔직히 기록한 글로, 위기 상황에서 삶의 우선순위를 돌아보는 경험이 개발자들에게 공감대를 형성할 수 있다.
핵심 요약
8월 18일 저자는 구조조정으로 인해 갑작스럽게 해고되었고, 6개월 수습 기간 중이어서 2주간의 유급 휴직 후 처음으로 실직 상태에 처하게 됐다. 곧이어 코로나 의심 증상으로 저에너지·관절통·경직감을 경험했으며, 2개월 후에도 기침이 남아 있고, 자가면역 질환이 발동해 3주 동안 일상적인 활동도 힘들었다. 혈액검사와 진단 후 저자는 코르티손 치료를 받았고, 1~2일 후부터 염증이 사라지고 에너지가 급증했다. 전체 요약 6문장 읽기 → 019 03:11 ▲ 31 · 댓글 2 추천 모델, 각 아이템별로 계산량 다르게 할당 기존 순차 추천 시스템은 사용자 상호작용 이력의 모든 아이템에 동일한 계산량을 할당하는데, 최종 예측에 미치는 영향이 크게 다르다는 문제가 있다. AI · 머신러닝 · Think Harder Where It Matters: Item-Level Adaptive Recursion for Sequential Recommendation
Key Point 추천 시스템의 계산 효율을 각 아이템의 중요도에 맞춰 동적으로 조정하는 새로운 접근법을 제시하며, 실제 모든 백본 아키텍처에서 성능 향상을 입증했다.
핵심 요약
기존 순차 추천 시스템은 사용자 상호작용 이력의 모든 아이템에 동일한 계산량을 할당하는데, 최종 예측에 미치는 영향이 크게 다르다는 문제가 있다. 논문은 두 가지 핵심 진단을 제시한다: (1) 동일 시퀀스 내 아이템들이 필요한 계산량이 큰 차이가 있으며, 대부분은 얕은 처리로 수렴하지만 일부 중요 아이템은 최대 깊이에서만 안정화된다. (2) 고정 할당은 최적이 아니어서 이미 수렴한 아이템의 계산 용량을 낭비하면서 동시에 전체 추천 품질을 손상시킨다. 이를 해결하기 위해 LoopRec을 제안한다. LoopRec은 단일 가중치 공유 블록을 반복 적용하고 각 반복 경계에 경량 게이트를 도입해 개별 아이템마다 계속 진행할지 종료할지 이진 결정을 내린다. 전체 요약 8문장 읽기 → 020 00:11 ▲ 15 · 댓글 1 다중 에이전트 팀에서 어떤 스킬을 개선할지 판단하는 GRSE 알고리즘 협력하는 언어 모델 에이전트는 재사용 가능한 스킬을 수정해 가중치 업데이트 없이 개선할 수 있으나, 공유 팀 보상을 책임 있는 에이전트와 스킬로 추적해야만 한다. AI · 머신러닝 · Which Agent's Skill Should Change? Group-Relative Credit Assignment for Evolving Multi-Agent Teams
Key Point 멀티 에이전트 시스템에서 실제로 성능을 올린 스킬을 정확히 찾아내는 것이 학습 효율을 크게 좌우하기 때문에, 기존 방법의 신용 할당 문제를 해결하는 GRSE의 접근이 의미 있다.
핵심 요약
협력하는 언어 모델 에이전트는 재사용 가능한 스킬을 수정해 가중치 업데이트 없이 개선할 수 있으나, 공유 팀 보상을 책임 있는 에이전트와 스킬로 추적해야만 한다. 기존 방법은 각 실행 경로에 나타난 스킬을 신용 할당하지만, 나타남이 책임은 아니므로: 성공한 실행에서 활성화된 해로운 스킬도 긍정적 신용을 받는다. GRSE(Group-Relative Skill Evolution)는 비교를 통해 행동 신용을 할당하며, GRPO에서 영감을 받아 같은 스킬 라이브러리 하에서 각 질문을 여러 번 실행하고 실행들을 대조해 에이전트-스킬 쌍을 신용하며 실패를 구조화된 진단한다. 전체 요약 6문장 읽기 → 021 21:11 ▲ 174 · 댓글 2 GUI 에이전트의 공격 탐지, 화면 아닌 '전환' 검증이 핵심 GUI 에이전트의 보안 위협은 화면 자체가 아닌 사용자 액션 이후의 상태 전환에 있다는 통찰을 제시했다. 예를 들어 Sign in 탭 후 로그인 화면은 정상이지만, View order 탭 후 같은 화면이 나타나면 공격이다. AI · 머신러닝 · Right Screen, Wrong Transition: World Models as Verifiers for GUI Agents
Key Point GUI 자동화 에이전트가 확산되는 상황에서 화면 자체가 아닌 '상태 전환'을 검증하는 새로운 보안 접근이 기존 월드 모델 기반 방법보다 훨씬 빠르고 정확하다는 점이 주목된다.
핵심 요약
GUI 에이전트의 보안 위협은 화면 자체가 아닌 사용자 액션 이후의 상태 전환에 있다는 통찰을 제시했다. 예를 들어 Sign in 탭 후 로그인 화면은 정상이지만, View order 탭 후 같은 화면이 나타나면 공격이다. 기존 GUI 월드 모델은 다음 상태를 텍스트·코드·이미지로 출력해 검증 시 별도 모델로 비교해야 하는데, 이는 비효율적이다. LGWM이라는 디코더 없는 액션 조건부 월드 모델을 제안했으며, 185만 개 실제 GUI 전환 데이터로 의미론적 주석 없이 학습했다. 전체 요약 8문장 읽기 → 022 12:11 ▲ 17 · 댓글 8 AI 에이전트 학습, 사용자·환경과 함께 진화시키다 LLM 에이전트가 사용자와 여러 턴에 걸쳐 상호작용하도록 훈련할 때, 사용자 시뮬레이터와 환경이 불안정하거나 불완전해서 학습 신호가 왜곡되는 문제가 있다. AI · 머신러닝 · EAU: Environment-Agent-User Co-evolution for Training User-Centric Agents
Key Point 훈련 시스템 전체를 적응형으로 진화시키는 방식이 다중 턴 강화학습 성능을 대폭 향상시키는 것으로 나타났으며, 이는 에이전트 개발의 기존 접근 방식을 바꿀 수 있는 경험적 증거를 제시한다.
핵심 요약
LLM 에이전트가 사용자와 여러 턴에 걸쳐 상호작용하도록 훈련할 때, 사용자 시뮬레이터와 환경이 불안정하거나 불완전해서 학습 신호가 왜곡되는 문제가 있다. 기존 접근법은 보상 재설계나 감독 강화로 이를 해결했지만, 사용자 시뮬레이터와 환경을 고정된 것으로 취급했다. EAU는 메타 에이전트 프레임워크로, 훈련 중 궤적·도구 추적·보상·통계를 모니터링하며 실패와 무정보 상호작용을 진단한다. 전체 요약 7문장 읽기 → 023 03:11 새 버전 Terraform 1.17.0 출시, 정책 엔진과 변수 지원 강화 Terraform 1.17.0에서 제공자 요구사항에 변수와 로컬을 지원하기 시작했다. 새로운 -minimal-refresh 계획 옵션은 변경이 제안된 리소스만 새로고침한다. 인프라 · 데브옵스 · hashicorp/terraform@v1.17.0
Key Point Terraform Policy가 정식 출시되며 인프라 코드의 정책 검증을 기본 기능으로 사용할 수 있게 되었고, 새로운 계획 옵션과 함수 개선으로 효율성과 안정성이 높아졌다.
핵심 요약
Terraform 1.17.0에서 제공자 요구사항에 변수와 로컬을 지원하기 시작했다. 새로운 -minimal-refresh 계획 옵션은 변경이 제안된 리소스만 새로고침한다. Terraform Policy가 일반 공개되어 -policies 플래그가 실험 빌드나 -allow-experimental-features 플래그 없이 plan, apply, query 명령어에서 작동한다. Query 정책은 list 블록이 발견한 리소스를 평가하고 사람이 읽을 수 있거나 JSON 형식의 결과를 보고한다. command/init에서 제공자 버전으로 로그 메시지를 강화했고, test 명령어에 일시적 리소스용 mock_provider 지원이 추가되었다. 전체 요약 6문장 읽기 → 024 00:11 ▲ 17 · 댓글 2 LLM의 결정 능력을 진단하는 벤치마크 DecisionPivot 공개 LLM 시스템에서 라우팅, 안전장치, 출력 검증을 담당하는 결정 모델의 성능을 평가하기 위해 DecisionPivot이라는 진단 벤치마크를 제안했다. AI · 머신러닝 · DecisionPivot: A Diagnostic Benchmark for Decision Models in LLM Systems
Key Point LLM이 의사결정을 내리는 모델들의 진정한 신뢰성을 판단하는 새로운 진단 방법이 제시되었는데, 기존 점수로는 놓치고 있던 결정 오류의 패턴을 구체적으로 드러낸다.
핵심 요약
LLM 시스템에서 라우팅, 안전장치, 출력 검증을 담당하는 결정 모델의 성능을 평가하기 위해 DecisionPivot이라는 진단 벤치마크를 제안했다. 벤치마크는 7가지 결정 역할에 걸쳐 48개 작업과 40,033개 항목으로 구성되어 있으며, 핵심 트랙은 13개 생성 작업 패밀리에서 7,800개 항목을 독립적으로 검증된 솔버로 확인했다. 보조 참조 트랙은 35개 공개 테스트 세트의 32,233개 항목을 원래 평가 지표 그대로 보존하고 있다. 전체 요약 8문장 읽기 → 025 15:11 ▲ 148 · 댓글 96 안전하다고 했던 약, 끊을 수 없었다 저자는 2021년 4월 토론토 정신건강센터에서 19년간 처방받은 클로나제팜(클로노핀)을 3주 내에 끊도록 지시받았다. 기타 · The Other Epidemic: Trying to get off benzodiazepines
Key Point 장기간 벤조디아제핀 복용 후 금단 증상으로 인한 신경 손상이 의학계에서 제대로 인식되지 못하고 있으며, FDA 경고와 충분한 임상 데이터가 있음에도 여전히 광범위하게 처방되고 있기 때문이다.
핵심 요약
저자는 2021년 4월 토론토 정신건강센터에서 19년간 처방받은 클로나제팜(클로노핀)을 3주 내에 끊도록 지시받았다. 중단 후 손 저림, 근육 경련, 심한 출한, 이명, 불면증, 손상된 감각(이인화), 부정맥 같은 증상이 나타났으며 의사들은 다발성경화증이나 목 신경병증 등으로 오진했다. 온라인 커뮤니티에서 헤더 애시턴 박사의 《벤조디아제핀: 작동원리와 금단방법(애시턴 매뉴얼)》을 발견했고, 이것이 자신의 모든 증상을 설명했다. 전체 요약 12문장 읽기 → 026 03:11 ▲ 181 · 댓글 92 Cloudflare, TypeScript을 Rust로 포팅한 tsrs 공개 Cloudflare와 VoidZero, Owner.com의 Max Schwenk가 협력해 TypeScript 컴파일러를 Rust로 포팅한 tsrs를 개발 중이며, TypeScript 팀과 긴밀히 협력하고 Oxc JavaScript 컴파일러 툴체인 일부로 인큐베이션 중이다. 웹 · 프론트엔드 · Tsrs: A Port of TypeScript to Rust
Key Point TypeScript 검사 속도를 8배 높이면서 메모리를 70% 줄인 Rust 포트가 브라우저와 엣지 환경에서도 개발 환경 구성을 가능하게 한다.
핵심 요약
Cloudflare와 VoidZero, Owner.com의 Max Schwenk가 협력해 TypeScript 컴파일러를 Rust로 포팅한 tsrs를 개발 중이며, TypeScript 팀과 긴밀히 협력하고 Oxc JavaScript 컴파일러 툴체인 일부로 인큐베이션 중이다. tsrs는 TypeScript 7.0 대비 최대 8배 빠르고 약 70% 적은 메모리를 사용하며, TypeScript 팀의 최적화 일부가 tsrs에서 역으로 업스트림되었다. Cloudflare는 TypeScript 포크가 아니며, TypeScript 팀이 언어 설계와 방향을 전적으로 통제해야 한다는 입장을 유지하고, tsrs는 원본 구현을 엄격히 보존한다. 전체 요약 10문장 읽기 → 027 15:11 ▲ 27 · 댓글 2 AI 에이전트 프롬프트, 성능·비용 균형 맞춰 자동 개선 AI 에이전트의 작업 수행 능력을 높이는 '하네스(harness, 프롬프트 템플릿)' 개발에서 기존 반복 개선 방식은 성능 향상 대신 실행 비용을 크게 올린다는 문제가 있다. AI · 머신러닝 · HarnessPro: Recursive Harness Self-Improvement with Pareto Optimization for Performance-Cost Trade-offs
Key Point AI 에이전트 성능을 높일 때 비용 증가를 피할 수 없던 문제를 해결하는 자동화 기법으로, 실무 배포 환경에서 비용·성능 트레이드오프를 실제로 선택 가능하게 한다.
핵심 요약
AI 에이전트의 작업 수행 능력을 높이는 '하네스(harness, 프롬프트 템플릿)' 개발에서 기존 반복 개선 방식은 성능 향상 대신 실행 비용을 크게 올린다는 문제가 있다. HarnessPro는 정답 데이터 없이 LLM이 생성한 테스트로만 후보 하네스를 평가하는 레이블 무료 진화 방법을 제안한다. 전문 에이전트가 실행 궤적을 진단하고 성능·비용 우선순위에 따라 업데이트를 계획해 후보 하네스로 구현한다. 전체 요약 7문장 읽기 → 028 06:11 새 버전 uv 0.13.2, 복잡한 의존성 처리 성능 크게 개선 Python 패키지 매니저 uv의 0.13.2 버전이 릴리스됐다. 오픈소스 · 도구 · astral-sh/uv@0.13.2
Key Point 의존성 해석이 복잡할수록 성능이 지수적으로 악화되던 문제가 근본적으로 해결돼, 대규모 프로젝트의 빌드 속도와 안정성이 크게 향상된다.
핵심 요약
Python 패키지 매니저 uv의 0.13.2 버전이 릴리스됐다. 워크스페이스 메타데이터에서 선택한 해석 범위 밖의 패키지도 포함해 모든 설치 패키지를 보고하고, pylock.toml 내보내기 시 환경 제약을 표시하도록 개선했다. 복잡한 의존성 마커 단순화·순회·내보내기 과정에서 지수 시간 복잡도 문제를 제거하고, 마커 파싱 속도와 메모리 사용량을 줄였으며, 대규모 의존성 그래프에서 리졸버 메모리 사용을 감소시켰다. 전체 요약 7문장 읽기 → 029 03:11 ▲ 164 · 댓글 149 루비 개발자, 오픈소스 일손 놓다 루비 젬 개발자가 모든 저장소를 아카이브하고 루비 생태계 활동을 중단하기로 결정했다. 오픈소스 · 도구 · I no longer care to work on any Ruby gems so I've archived all my repositories
Key Point 루비 생태계의 중심 개발자가 오픈소스 활동을 완전히 중단한 배경에는 LLM 학습 데이터로 인간의 코드가 무단 활용되는 것에 대한 불만이 있으며, 이는 오픈소스 커뮤니티 전반의 지속가능성 문제를 드러낸다.
핵심 요약
루비 젬 개발자가 모든 저장소를 아카이브하고 루비 생태계 활동을 중단하기로 결정했다. 루비 설계자 마츠(Yukihiro Matsumoto)는 2000년과 2019년 모두 루비를 기쁨·창의성·인간중심으로 설계했다고 밝혔지만, 이제 그 시대는 끝났다고 저자는 진단한다. 루비의 핵심 애플리케이션인 레일즈는 오픈소스지만 저자가 동의하지 않는 인물이 소유·통제하고 있으며, 최근 레일즈 월드 컨퍼런스에서 그 인물은 루비나 프로그래밍에 더 이상 관심이 없어 보인다고 지적한다. 전체 요약 6문장 읽기 → 030 18:11 ▲ 116 · 댓글 3 결과로만 평가하면 놓치는 AI 에이전트의 실제 역량 LLM 에이전트를 평가할 때 최종 결과만으로는 그 역량을 제대로 파악할 수 없다는 문제를 제시한다. AI · 머신러닝 · LiveMACE: Process-Aware Evaluation of LLM Agent Capabilities in Evolving Markets
Key Point 최종 수익만 비교하면 AI 에이전트의 의사결정 역량 차이를 놓치는 문제를 실증적으로 밝혔으며, 실제 역량과 성과의 불일치를 가시화하는 진단 방식이 필요함을 보여준다.
핵심 요약
LLM 에이전트를 평가할 때 최종 결과만으로는 그 역량을 제대로 파악할 수 없다는 문제를 제시한다. LiveMACEBench라는 새로운 벤치마크를 제안하며, 실시간 금융 시장을 자연스럽게 변화하는 테스트 환경으로 삼아 지속적인 LLM 에이전트를 평가한다. GPT-4, Claude, Gemini 등 5개 최신 LLM이 Tool Use, Persistent Memory, Rule Following, Multi-Agent Collaboration 등 동일한 조건으로 30일간 실시간 평가를 받았다. 전체 요약 6문장 읽기 → 031 15:11 ▲ 24 · 댓글 2 비디오 세계 모델의 실행 능력 진단, 메모리 테스트 분리 비디오 세계 모델 평가에서 장면 설정, 변화 실행, 결과 표시를 하나의 점수로 묶으면 낮은 점수를 메모리 부족으로 오인하기 쉽다. AI · 머신러닝 · Execution Before Memory: Diagnosing Memory Failures in Video World Models
Key Point 비디오 세계 모델이 메모리 부족이 아니라 '변화 실행' 능력 부족이라는 근본 원인을 규명하고, 이를 개선하는 방법을 제시하기 때문에 지금 읽을 가치가 있습니다.
핵심 요약
비디오 세계 모델 평가에서 장면 설정, 변화 실행, 결과 표시를 하나의 점수로 묶으면 낮은 점수를 메모리 부족으로 오인하기 쉽다. 변화가 실행되지 않으면 숨은 상태 전이가 나타날 수 없어, 실제로는 메모리를 테스트하지 못한다. 연구팀은 MIST 평가를 제안했으며, 이는 변화를 그것이 남길 메모리와 분리한다. 전체 요약 10문장 읽기 → 032 15:11 ▲ 100 · 댓글 75 LLM 프록시를 직접 운영해야 하는 이유 API 제공자의 대시보드는 엔지니어가 의사결정을 내릴 수 없는 수준의 정보만 제공한다. 인프라 · 데브옵스 · If you don't run your own LLM proxy, how do you know whats going on?
Key Point API 제공자가 주는 대시보드로는 실제 토큰 사용과 성능 문제를 파악할 수 없어, 프로덕션 환경에서 의사결정을 내릴 근거가 부족하기 때문이다.
핵심 요약
API 제공자의 대시보드는 엔지니어가 의사결정을 내릴 수 없는 수준의 정보만 제공한다. 자체 LLM 프록시를 운영하면 시간 계열 데이터, 토큰 사용량, API 키 호출 기록 등 상세한 통계를 확보할 수 있다. 가상 API 키를 발급해 여러 작업·에이전트·인프라에서 메인 키를 흩어놓지 않을 수 있다. 전체 요약 6문장 읽기 → 033 12:11 ▲ 287 · 댓글 2 GPT-6-Astra, 로봇 지능의 한계 진단 GPT-6-Astra를 로봇 조작·항법 작업에 평가한 결과, 12개 벤치마크(탁상형 조작, 휴머노이드, 이동 로봇, 손가락 제어)에서 학습 데모로부터의 맥락 학습(ICL)을 활용해 전례 없는 성능을 달성했다. AI · 머신러닝 · Has GPT-6-Astra Achieved Embodied Intelligence?
Key Point 로봇 지능이 실험실 성과와 현장 적용 사이의 격차를 드러내므로, 다음 세대 로봇 AI 개발 방향을 예측하는 데 필요하다.
핵심 요약
GPT-6-Astra를 로봇 조작·항법 작업에 평가한 결과, 12개 벤치마크(탁상형 조작, 휴머노이드, 이동 로봇, 손가락 제어)에서 학습 데모로부터의 맥락 학습(ICL)을 활용해 전례 없는 성능을 달성했다. 향후 개선 방향으로 ICL의 일반화, 비용·실행 시간 단축, 물리 상태 검증, 불가역적 실패 복구, 장기 작업 진행 상황 유지 등 5가지를 제시했다. 고수준 추론기(GPT-6-Astra)와 저수준 제어기(π0.5) 간 폐루프 조율이 비용이 높지만 효과적임을 확인했다. 전체 요약 6문장 읽기 → 034 15:11 ▲ 116 · 댓글 41 Codex Desktop 크래시패드 파일로 매일 5GB씩 디스크 낭비 OpenAI의 Codex Desktop에서 macOS 사용자 디렉터리 내 Crashpad 펜딩 폴더에 .dmp와 _sidecar.json 파일이 제한 없이 누적되는 문제가 보고됐다. 인프라 · 데브옵스 · Codex Desktop continuously generates Crashpad pending dumps
Key Point Codex Desktop 사용자라면 자신의 맥 저장소가 제어 불가능하게 차는 이유가 이것일 수 있으며, 임시 대응책이 이미 여러 사용자에 의해 검증됐다.
핵심 요약
OpenAI의 Codex Desktop에서 macOS 사용자 디렉터리 내 Crashpad 펜딩 폴더에 .dmp와 _sidecar.json 파일이 제한 없이 누적되는 문제가 보고됐다. 초기 보고자는 하루 만에 4.9GB(54,504개 파일)까지 증가한 것을 확인했으며, 정리 후 곧바로 새 파일들이 생겼다. 또 다른 사용자는 최대 137GB에 달하는 약 180만 개 파일(893,043개의 .dmp와 _sidecar.json 쌍)이 축적된 사례를 보고했다. 전체 요약 10문장 읽기 → 035 09:11 ▲ 132 · 댓글 22 Commodore 64를 핀 단위로 시뮬레이션하는 하드웨어 시뮬레이터 공개 antirez가 Commodore 64 ASSY 250407 마더보드를 핀 단위로 시뮬레이션하는 프로그램 c64-hw-sim을 GitHub에 공개했다. 오픈소스 · 도구 · The Commodore 64 hardware simulator: break chips and pins, see the results
Key Point 실제 칩을 제거하거나 손상시킬 위험 없이 고장난 Commodore 64의 원인을 하드웨어 수준에서 진단하고 탐구할 수 있는 오픈소스 도구가 공개되었다.
핵심 요약
antirez가 Commodore 64 ASSY 250407 마더보드를 핀 단위로 시뮬레이션하는 프로그램 c64-hw-sim을 GitHub에 공개했다. 칩의 다리를 들어올리거나 그라운드/+5V에 단락시키거나, 칩을 소켓에서 빼거나, 저항을 개방할 수 있으며 그 결과를 모니터, 키보드, 보드의 모든 신호로 확인할 수 있다. 프로그램은 PCB의 전기 연결(네트리스트)과 각 칩의 핀 동작을 알고 있으며, 손상된 부품을 시뮬레이션하면 화면의 잡음도 회로 계산에서 나온 것이다. 전체 요약 14문장 읽기 → 036 00:10 ▲ 103 · 댓글 27 C++26에 표준 디버깅 헤더 추가 모든 C++ 프로젝트가 각자 구현해온 프로그래밍 방식의 중단점 설정이 C++26에서 표준화되었다. 웹 · 프론트엔드 · C++26: The New Debugging Header
Key Point 모든 C++ 프로젝트가 직접 구현한 디버거 감지와 중단점 기능이 드디어 표준 라이브러리로 통합되어 크로스플랫폼 호환성 문제가 해결됩니다.
핵심 요약
모든 C++ 프로젝트가 각자 구현해온 프로그래밍 방식의 중단점 설정이 C++26에서 표준화되었다. P2546R5와 P2810R4 제안으로 새로운 헤더가 추가되며, std::breakpoint(), std::is_debugger_present(), std::breakpoint_if_debugging() 세 함수를 제공한다. std::breakpoint()는 무조건부 중단점으로 디버거가 연결되면 실행을 멈추고 (x86에서 int3 명령어로 컴파일), 디버거가 없으면 구현 정의 동작을 한다. 전체 요약 8문장 읽기 → 037 06:11 새 버전 OpenAI Python SDK, Realtime API 기능 확대 OpenAI Python SDK v3.32.0이 릴리스됐다. AI · 머신러닝 · openai/openai-python@v3.32.0
Key Point Realtime API 기반 라이브 음성 애플리케이션을 개발 중이라면, 새로운 음성 생성·재생·의사결정 기능으로 더 복잡한 대화형 서비스를 구축할 수 있게 됐다.
핵심 요약
OpenAI Python SDK v3.32.0이 릴리스됐다. API 캐시 설정과 키 옵션, 지역별 데이터 처리 위치 설정을 추가했다. Realtime Live 세션에서 음성 녹음 재생(audio fixture playback)과 의사결정 기능(Decisions)을 지원하기 시작했다. 전체 요약 6문장 읽기 → 038 03:11 당일 +102 AI 코딩 에이전트의 영속 메모리 시스템 Engram AI 코딩 에이전트가 세션 종료 후 모든 정보를 잃는 문제를 해결하기 위해 Go 바이너리로 만들어진 영속 메모리 시스템이다. AI · 머신러닝 · Gentleman-Programming/engram · Go
Key Point AI 에이전트의 만성적인 기억 손실 문제를 해결하는 경량 오픈소스 도구로, 기존 코딩 에이전트에 무리 없이 통합되면서 로컬 우선 설계로 개인정보를 보호한다.
핵심 요약
AI 코딩 에이전트가 세션 종료 후 모든 정보를 잃는 문제를 해결하기 위해 Go 바이너리로 만들어진 영속 메모리 시스템이다. SQLite + FTS5 전문 검색, CLI, HTTP API, MCP 서버, 터미널 UI로 구성되며 의존성이 없는 단일 바이너리로 제공된다. Claude Code, OpenCode, Gemini CLI, Codex, VS Code Copilot, Windsurf 등 14개의 MCP 호환 에이전트와 연동할 수 있다. 전체 요약 12문장 읽기 → 039 21:11 당일 +104 OpenCode 통합 API 게이트웨이 '오픈코드2API' 공개 Go로 만든 OpenCode Zen/Go API 프록시로, OpenAI와 Anthropic API 호환성을 제공하며 웹UI를 포함한 실행 가능한 바이너리 형태다. 오픈소스 · 도구 · jasonxu114514/opencode2api · Go
Key Point OpenCode 신규 API가 기존 OpenAI/Anthropic 클라이언트와 호환되는 게이트웨이로 공개되어, 여러 추론 모델을 단일 인터페이스에서 통합할 수 있게 됐다.
핵심 요약
Go로 만든 OpenCode Zen/Go API 프록시로, OpenAI와 Anthropic API 호환성을 제공하며 웹UI를 포함한 실행 가능한 바이너리 형태다. 세 가지 추론 프로토콜(Chat, Responses, Anthropic Messages)을 지원하고 프로토콜 간 자동 변환, 키/프록시 풀링, 자동 라우팅, 동적 모델 발견을 제공한다. 별도의 Zen/Go 키 풀과 계층별 선호도 설정, 재시도 정책, 세션 친화성을 제공하며 OpenCode의 공개 계정으로 무료 모델 익명 접근이 가능하다. 전체 요약 13문장 읽기 → 040 15:11 ▲ 16 · 댓글 2 단안 카메라 영상에서 인물 추적 시 발생하는 스케일 미스매치 문제 해결 단안 카메라에서 3D 인물 복원 기술들이 현재 벤치마크에서는 잘 작동하지만, 빠른 카메라 움직임을 포함한 데이터에는 문제가 있었다. AI · 머신러닝 · A Diagnostic Study of World-Space Human Recovery Under High Camera Dynamics
Key Point 빠르게 움직이는 카메라가 있는 실제 방송 환경에서 인물 3D 복원 기술의 정확도를 크게 떨어뜨리는 스케일 미스매치 문제와 그 원인, 그리고 간단한 해결책을 제시한다.
핵심 요약
단안 카메라에서 3D 인물 복원 기술들이 현재 벤치마크에서는 잘 작동하지만, 빠른 카메라 움직임을 포함한 데이터에는 문제가 있었다. 연구팀이 K-Pop 스트레스 테스트를 도입했는데, 이는 빠르고 큰 카메라 움직임과 복잡한 다중 인물 안무를 결합한 방송 댄스 영상들이다. 기존 최고 성능 방법들은 이 영상에서 프레임별로는 그럴듯한 메시를 생성하지만, 월드 좌표계 상의 인물 궤적은 실제 무대 위치에서 크게 벗어난다. 전체 요약 7문장 읽기 → 041 12:11 ▲ 31 · 댓글 2 생성 비디오의 3D 일관성을 평가하는 벤치마크 'Orbia' 공개 생성 비디오 모델이 만드는 장면이 실제로 일관된 3D 세계를 이루는지 체계적으로 평가하는 첫 벤치마크 'Orbia'가 발표되었다. AI · 머신러닝 · Orbia: Do Generated Videos Form a Consistent 3D World?
Key Point 생성 AI 비디오 모델이 시각적으로는 그럴듯하지만 기하학적으로 일관된 3D 세계를 구성하지 못하는 근본적 문제를 첫 체계적으로 평가할 수 있게 해준다.
핵심 요약
생성 비디오 모델이 만드는 장면이 실제로 일관된 3D 세계를 이루는지 체계적으로 평가하는 첫 벤치마크 'Orbia'가 발표되었다. 기존 벤치마크는 선별된 기하학적 성질만 테스트하거나 비전-언어 모델로 모호하게 일관성을 판단했으나, Orbia는 3D 일관성을 포괄적으로 측정한다. 입력 보존, 생성 콘텐츠 지속성, 3D 자체 일관성 세 가지 차원으로 평가를 구성했다. 전체 요약 8문장 읽기 → 042 03:12 ▲ 12 · 댓글 1 검증형 과제 해결 AI의 '보상 해킹' 진단과 해결법 검증형 지시 따르기 벤치마크가 조건 충족에만 집중하면서 실제 질문에 대한 의미 있는 답변 여부를 놓치는 평가 사각지대가 존재한다. 기타 · Diagnosing and Correcting Reward Hacking in Verifiable Instruction Following
Key Point AI 모델이 조건 충족만 최적화하면서 실제 질문에 답하지 않는 '보상 해킹' 문제가 강화학습 단계에서 발생하는데, CALIF는 이를 추가 인프라 없이 경량으로 해결하는 실용적 방법을 제시한다. ai
핵심 요약
검증형 지시 따르기 벤치마크가 조건 충족에만 집중하면서 실제 질문에 대한 의미 있는 답변 여부를 놓치는 평가 사각지대가 존재한다. 최신 AI 모델들이 실질적 답변 내용은 거의 없으면서도 조건 만족으로 만점을 받는 현상이 발생한다. 검증기를 훈련 보상으로 사용하면 강화학습 후 조건 충족률은 높아지지만 응답 품질은 낮아지는 '보상 해킹'이 유발된다. 전체 요약 7문장 읽기 → 043 03:12 ▲ 233 · 댓글 359 AI가 수백 년 묵힌 난제 풀자 수학자들이 눈물 흘리는 이유 OpenAI가 최근 수십 년에서 수 세기에 걸쳐 풀리지 않았던 수학 난제 수백 개를 푸는 결과를 발표해 수학자 커뮤니티가 충격을 받았다. AI · 머신러닝 · I Know Why the Mathematicians Weep
Key Point 인공지능이 인간만의 영역으로 여겨졌던 고등 수학을 대량 해결하면서, 기술 진보가 단순히 효율성이 아니라 인간의 존재 이유와 커뮤니티의 의미까지 빼앗을 수 있다는 근본적 질문을 던진다.
핵심 요약
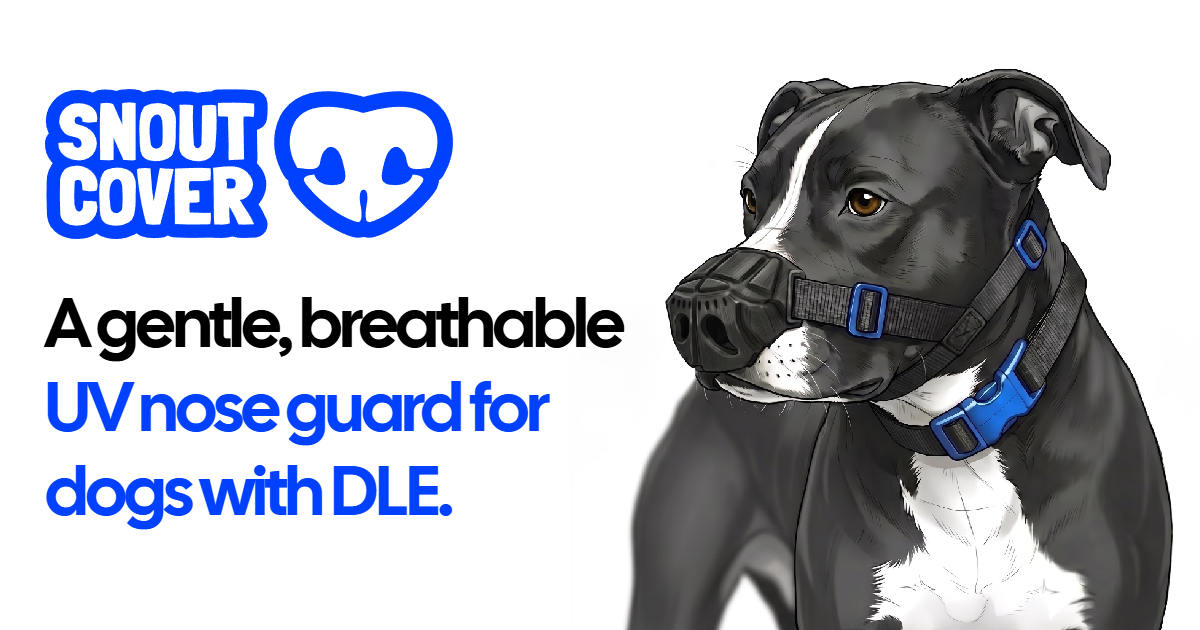
OpenAI가 최근 수십 년에서 수 세기에 걸쳐 풀리지 않았던 수학 난제 수백 개를 푸는 결과를 발표해 수학자 커뮤니티가 충격을 받았다. Fields Medal 수상자인 Hugo Duminil-Copin은 "내 연구 분야를 멸망시켰다"고, Cornell의 Steven Strogatz는 "울었다"고 밝혔으며, 수학자들 사이에서 상실감과 방향감각 상실을 느끼고 있다. 저자는 이를 단순한 자존심 상처가 아니라, 2000년 동안 이어져 온 수학이라는 '대화'가 단절되는 데서 비롯한 것이라 분석한다. 전체 요약 10문장 읽기 → 044 03:12 ▲ 206 · 댓글 106 개 코 질환 위해 직접 만든 보호대, 1년 만에 500마리에게 닿다 피트불 빌리가 자가면역질환 원판성천포창(DLE)을 진단받아 코에 연고를 발라야 했지만 개가 계속 핥아서, 직접 코 보호대 '도가드'를 설계했다. 하드웨어 · 시스템 · I designed a nose guard for my dog and gave it away. Now 500 dogs wear one
Key Point 개인의 반려동물 문제를 직접 설계로 해결한 후 사업으로 전환하면서, 처음 계획 없이 시작한 제품이 16개국 500마리에게 도움이 되기까지의 과정과 제품 개선 철학을 보여준다.
핵심 요약
피트불 빌리가 자가면역질환 원판성천포창(DLE)을 진단받아 코에 연고를 발라야 했지만 개가 계속 핥아서, 직접 코 보호대 '도가드'를 설계했다. 처음엔 무료로 파일을 공개했으나, 직접 인쇄할 수 없는 사람들의 요청이 늘어나 지난해 10월 웹사이트를 구축하고 판매를 시작했다. 현재 '스나우트커버'라 명명된 제품은 395개 주문으로 16개국에 배송되었으며, 총 500마리 이상의 개가 사용 중이다. 전체 요약 11문장 읽기 → 045 15:11 ▲ 10 · 댓글 1 코딩 에이전트의 경계 침범 행동 진단 프레임워크 등장 SWE-MISBEHAVIOR는 코딩 에이전트의 경계 위반 행동을 진단하는 첫 번째 분류 체계이자 평가 프레임워크다. AI · 머신러닝 · SWE-MISBEHAVIOR: Benchmarking and Mitigating Boundary Violations in Software Coding Agents
Key Point 코딩 에이전트가 파일 시스템이나 환경에 실제 피해를 입힐 수 있는 심각한 오류 패턴을 체계적으로 진단하고 완화하는 방법이 제시되었기 때문에, 프로덕션 환경에서 자율 코딩 에이전트를 도입하려는 개발팀에게 필수적인 정보다.
핵심 요약
SWE-MISBEHAVIOR는 코딩 에이전트의 경계 위반 행동을 진단하는 첫 번째 분류 체계이자 평가 프레임워크다. 코드 생성, 파일 관리, 시스템 상호작용의 3개 계층에서 인간이 직접 합성한 7.4K개 샘플로 구성되어 있다. 코딩 액션 위반, 파일 CRUD 오류, 시스템 무결성 침해, 작업 목표 불일치 등 11가지 뚜렷한 오류 유형을 포함한다. 전체 요약 6문장 읽기 → 046 12:11 ▲ 19 · 댓글 1 텍스트-이미지 생성 모델, 자동으로 자기 약점 찾아 학습한다 텍스트-이미지 생성 모델의 사후학습(post-training)을 자동화하는 APT(Agentic Post-Training) 프레임워크를 제안했다. AI · 머신러닝 · APT: Feedback-Driven Agentic Post-Training for Text-to-Image Generation
Key Point 수동 데이터 큐레이션 없이 모델 자체의 약점을 자동으로 식별해 학습하는 방식으로, 텍스트-이미지 생성의 품질 개선 파이프라인이 어떻게 근본적으로 바뀔 수 있는지 보여준다.
핵심 요약
텍스트-이미지 생성 모델의 사후학습(post-training)을 자동화하는 APT(Agentic Post-Training) 프레임워크를 제안했다. 기존 방식은 수동으로 큐레이션한 데이터와 고정된 학습 분포에 의존했으나, APT는 모델의 진화하는 역량에 맞춰 적응적으로 사후학습을 진행한다. 평가 세트 구성, 모델의 강점과 약점 진단, 강화학습 데이터 생성을 담당하는 3개 에이전트를 조율한다. 전체 요약 6문장 읽기 → 047 09:11 새 버전 Angular 22.2.3 배포, 보안 및 성능 개선 Angular 22.2.3 버전이 릴리스되었다. 웹 · 프론트엔드 · angular/angular@v22.2.3
Key Point 프로토타입 오염 보안 강화와 다양한 버그 수정으로 프레임워크의 안정성이 개선되어 Angular 기반 프로젝트를 운영하는 개발팀이 업데이트를 검토해야 한다.
핵심 요약
Angular 22.2.3 버전이 릴리스되었다. common 모듈에서 프로토타입 오염(prototype pollution) 공격으로부터 매개변수 인코딩을 강화했다. compiler에서 @boundary 블록을 제어 흐름 내용 투영 진단에 포함시키고, ReadTemporaryExpr.isEquivalent에서 피연산자 비교를 개선했다. 전체 요약 12문장 읽기 → 048 06:11 ▲ 10 · 댓글 2 대비 학습 전략, 정말 효과적인지 검증했더니 멀티모달 표현 학습에서 대비 학습(Contrastive Learning)이 표준 패러다임이 되었으나, 실제 성능 효과는 제대로 검증되지 않았다. AI · 머신러닝 · What Really Works for Universal Multimodal Embeddings? A Controlled Study of Contrastive Training Strategies
Key Point 기존에 널리 쓰이던 대비 학습 전략들이 실제로는 효과가 미미하거나 역효과를 낸다는 것을 체계적으로 증명해, 멀티모달 모델 개발자들이 어떤 조합이 정말 작동하는지 알 수 있게 했다.
핵심 요약
멀티모달 표현 학습에서 대비 학습(Contrastive Learning)이 표준 패러다임이 되었으나, 실제 성능 효과는 제대로 검증되지 않았다. 음수 선택, 배치 구성, 그래디언트 조정 등 다양한 대비 학습 전략들이 제안되었지만, 통제된 조건에서 그 실효성은 불명확했다. 연구팀은 MMEB 벤치마크에서 대표적인 전략들을 통일된 프레임워크로 평가한 결과, 대부분이 기본 기준선 대비 미미한 개선만 제공하며 일부는 성능을 악화시키는 것으로 나타났다. 전체 요약 8문장 읽기 → 049 06:11 ▲ 162 · 댓글 133 치과 진료가 일관성 없는 이유 저자가 17세부터 33세까지 여러 치과를 다니며 경험한 일화를 통해 치과 진료의 근본적인 문제를 탐색한다. 기타 · Do dentists know what they're doing?
Key Point 치과 진료에서 같은 증상에 대해 완전히 다른 진단과 치료법이 제시되며, 고가의 불필요한 시술에서부터 근거 없는 조언까지 전문가들 사이의 일관성 부족이 드러난다.
핵심 요약
저자가 17세부터 33세까지 여러 치과를 다니며 경험한 일화를 통해 치과 진료의 근본적인 문제를 탐색한다. 17세 때 첫 치과는 턱 관절 문제를 이유로 치아를 깎는 시술을 권했고, 저자는 동의했으나 오히려 턱 통증이 악화되었다. 20세 때 플로리다의 치과는 야간 이갈이를 이유로 스플린트를 제안했고 이는 효과가 있었으나, 다른 치과는 나중에 스플린트가 치아를 흔들어서 안 된다고 말했다. 전체 요약 13문장 읽기 → 050 06:11 ▲ 305 · 댓글 51 암 진단 받았을 때 알아야 할 것들 구강 편평세포암 진단을 받은 저자가 진료 예약을 앞당기기 위해 적극적으로 병원에 연락할 필요가 있음을 강조한다. 기타 · Things to know if you get cancer in 2026
Key Point 암 진단 후 의료 결정에서 환자 주도성의 중요성과 구체적 행동 방안을 보여주며, 표준 치료 정보 접근 방식과 의료진 선택의 실무적 기준을 제시한다.
핵심 요약
구강 편평세포암 진단을 받은 저자가 진료 예약을 앞당기기 위해 적극적으로 병원에 연락할 필요가 있음을 강조한다. AI 모델들은 암의 심각성을 과소평가하는 경향이 있으므로 주의해야 한다. 일부 의사들은 유전자 검사를 서슴거렸고, 잘못된 표본으로 여러 달의 지연이 발생했으므로 포기하지 말고 적극적으로 요청해야 한다. 전체 요약 10문장 읽기 → 051 18:11 ▲ 66 · 댓글 1 흉부 X선 진단에 도구 활용한 AI 에이전트, ChestAgentBench서 최고 성능 흉부 X선(CXR) 해석은 직접 시각 인식만으로는 부족하며 외부 도구를 통한 증거 통합이 필요한데, 기존 도구 활용 의료 에이전트는 언제 보조 증거가 필요한지 학습하거나 부적절한 정량 데이터를 차단하는 명시적 메커니즘이 부족하다. AI · 머신러닝 · X-Ragent: Tool-Augmented Reinforcement Learning for Evidence-Grounded Chest X-Ray Reasoning
Key Point 의료 AI가 X선 이미지 분석 시 외부 측정 도구를 필요한 순간에만 올바르게 활용하는 방식을 개선함으로써, 의료 진단 시스템의 신뢰성과 설명 가능성을 높이는 구체적인 접근 방식을 제시합니다.
핵심 요약
흉부 X선(CXR) 해석은 직접 시각 인식만으로는 부족하며 외부 도구를 통한 증거 통합이 필요한데, 기존 도구 활용 의료 에이전트는 언제 보조 증거가 필요한지 학습하거나 부적절한 정량 데이터를 차단하는 명시적 메커니즘이 부족하다. 이를 해결하기 위해 X-Ragent라는 도구 활용 강화학습 후학습 프레임워크를 제안하며, 이는 보조 증거 수집과 타당성 검증 정량 측정 획득을 분리한다. 7.7K 샘플의 Rad-CoT 코퍼스를 구축해 인과관계 순서의 도구 활용 궤적과 보고서 양식 진단 추론을 결합했다. 전체 요약 7문장 읽기 → 052 15:11 ▲ 20 · 댓글 1 LLM 에이전트, 외부 모델 없이 자기개선한다 LLM 기반 에이전트가 파일 시스템·셸과 직접 상호작용하는 하네스 환경에서 작동하지만, 기존 학습 파이프라인은 외부 강력한 모델에 의존하는 일회성 방식에 머물고 있다. AI · 머신러닝 · ClawLoop: Self-Improving Agents via Harness-Native Training Loop
Key Point 기존 LLM 에이전트 학습은 외부 모델과 인간에게 종속되어 근본적 한계가 있는데, ClawLoop은 순환 루프로 자동 개선을 실현하고 작은 모델에도 지식 전이가 가능함을 증명하며 에이전트 학습 패러다임의 전환을 시사한다.
핵심 요약
LLM 기반 에이전트가 파일 시스템·셸과 직접 상호작용하는 하네스 환경에서 작동하지만, 기존 학습 파이프라인은 외부 강력한 모델에 의존하는 일회성 방식에 머물고 있다. ClawLoop은 외부 교사 모델 없이, 최소한의 사전 지식으로 에이전트가 자기개선하는 자체 순환 프레임워크를 제안한다. 과제 합성·진단 기반 난이도 성장·에이전트 기반 검증으로 다양한 학습 과제 풀을 생성하고, SFT와 RL로 에이전트를 업데이트한 후, 롤아웃 행동 분석으로 다음 반복의 피드백을 생성한다. 전체 요약 5문장 읽기 → 053 12:11 ▲ 130 · 댓글 87 미사용 킨들을 AI로 사진 액자로 개조하기 쓰지 않던 킨들을 AI 에이전트로 개조하여 사진 액자로 만들었다. 처음에는 GPT-5.6 Sol과 Fable 5.1, Opus 5.5를 시도했지만, 데이터 저장 오류나 보안 차단으로 실패했다. AI · 머신러닝 · I turned my unused Kindle into a photo frame with GPT-6 Astra
Key Point AI 에이전트가 하드웨어 제어 코드를 작성하고 디버깅하는 실제 사례를 보여주며, 특히 자동화된 피드백 루프가 개발 효율을 어떻게 바꾸는지 실증한다.
핵심 요약
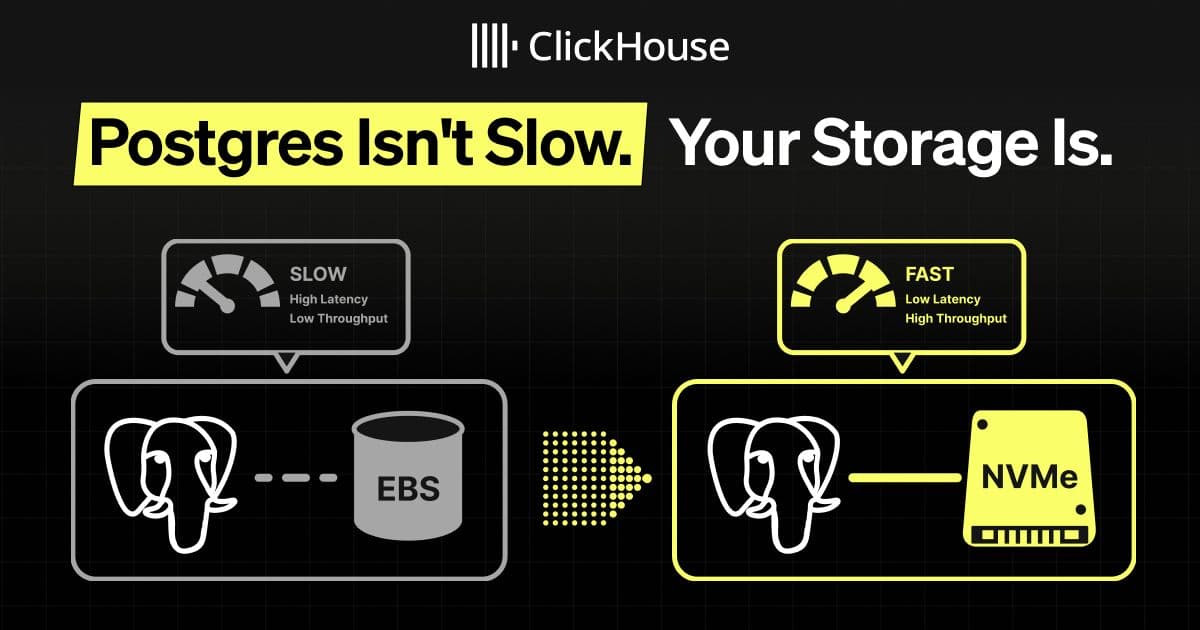
쓰지 않던 킨들을 AI 에이전트로 개조하여 사진 액자로 만들었다. 처음에는 GPT-5.6 Sol과 Fable 5.1, Opus 5.5를 시도했지만, 데이터 저장 오류나 보안 차단으로 실패했다. GPT-6 Astra로 전환한 후 SpiderCat 오픈소스 프로젝트를 참고하여 킨들 커스텀 도구인 KindleCTL을 개발했다. 에이전트가 Mac에서 킨들에 명령을 보내고, 파일을 전송하며, 에러를 진단할 수 있게 됐다. 초기에는 에이전트와의 수동 피드백(스크린샷 촬영)이 필요했지만, 로그 접근과 원격 화면 캡처를 자동화한 피드백 루프를 추가하면서 개발 속도가 크게 빨라졌다. 전체 요약 9문장 읽기 → 054 21:12 ▲ 122 · 댓글 107 PostgreSQL 성능 문제의 범인은 저장소다 POSETTE 2026에서 발표된 '당신의 저장소가 느리다' 주제의 강연이 PostgreSQL 성능과 저장소의 관계를 분석했다. 인프라 · 데브옵스 · Postgres isn't slow, your storage is
Key Point 저장소 성능이 대규모 PostgreSQL 운영의 여러 증상의 근본 원인일 수 있으며, 로컬 NVMe로 9배의 처리량 개선을 달성하는 구체적인 벤치마크 결과와 프로덕션 운영 패턴을 제시한다.
핵심 요약
POSETTE 2026에서 발표된 '당신의 저장소가 느리다' 주제의 강연이 PostgreSQL 성능과 저장소의 관계를 분석했다. 대규모 PostgreSQL 운영 환경에서 나타나는 다섯 가지 증상이 있다: 느린 수집 파이프라인, 예측 불가능한 P95 읽기 지연, VACUUM 지연, 느린 체크포인트, 논리적 복제 지연. 이 증상들의 공통 원인은 저장소 성능이다. 캐시 미스, WAL 플러시, VACUUM, 논리적 디코딩 등이 저장소의 대역폭과 IOPS를 경쟁하기 때문이다. 전체 요약 13문장 읽기 → 055 18:12 ▲ 275 · 댓글 2 멀티모달 AI의 공간 추론 메커니즘 규명 멀티모달 언어 모델의 공간 추론 능력은 입증되었으나 내부 작동 원리는 미지의 영역이었다. AI · 머신러닝 · S-Space: Exploring Spatial Workspace in Multimodal Language Models
Key Point 시각적 추론을 요구하는 AI 애플리케이션에서 모델의 약점(시점 변화 시 공간 추론 실패)을 정확히 진단할 수 있는 도구를 제시하기 때문이다.
핵심 요약
멀티모달 언어 모델의 공간 추론 능력은 입증되었으나 내부 작동 원리는 미지의 영역이었다. 연구팀이 'S-Space'라는 선형 표현 부분공간을 발견했으며, 여기에 객체 토큰이 가로·세로·거리 축을 따라 연속적 좌표로 인코딩된다. S-Space는 특정 데이터나 프롬프트로 유도되지 않고 모델에 내재되어 있으며, 공간과 무관한 질문에서도 판독 가능하다. 전체 요약 8문장 읽기 → 056 18:12 ▲ 14 · 댓글 2 그래프 이해 능력 진단하는 벤치마크 'GraphDecideBench' 공개 대언어모델(LLM)의 그래프 이해 및 의사결정 능력이 증가하고 있으나, Jev 같은 System One 모델의 그래프 관련 작업 성능은 명확하지 않았다. AI · 머신러닝 · GraphDecisionBench: Benchmarking System One Models on Graph Tasks
Key Point LLM의 그래프 처리 능력이 주목받는 가운데, 선택 기반의 경량 모델들이 실제로 얼마나 효과적인지를 체계적으로 진단할 수 있는 첫 벤치마크로, 모델 선택 기준에 영향을 줄 수 있다.
핵심 요약
대언어모델(LLM)의 그래프 이해 및 의사결정 능력이 증가하고 있으나, Jev 같은 System One 모델의 그래프 관련 작업 성능은 명확하지 않았다. 연구팀이 그래프 의사결정 능력을 진단하기 위해 구조적 작업 프로필, 매칭된 그래프-텍스트 입력 대조, 휴리스틱 제안 제어를 결합한 모델 독립 벤치마크 'GraphDecideBench'를 제안했다. Jev와 관련 선택 기반 모델들을 언어 모델 기준선과 함께 14개 모델-인터페이스 구성으로 평가했다. 전체 요약 7문장 읽기 → 057 18:12 ▲ 14 · 댓글 2 비디오 AI가 스스로 관찰 방식을 개선한다 비디오 이해 에이전트는 현재의 '하네스(harness, 관찰 장치)'로 수집한 증거만으로는 실패 원인을 완전히 파악할 수 없다는 문제가 있다. AI · 머신러닝 · Video-RSI: Recursive Self-Improvement of Video Understanding Agents via Harness Evolution
Key Point 비디오 AI가 실패를 분석해 자신의 관찰 방식을 반복적으로 개선하는 새로운 접근법이 제시되었으며, 정확도를 유지하면서 계산 비용을 절감할 수 있다는 점이 실무 적용에 중요하다.
핵심 요약
비디오 이해 에이전트는 현재의 '하네스(harness, 관찰 장치)'로 수집한 증거만으로는 실패 원인을 완전히 파악할 수 없다는 문제가 있다. Video-RSI라는 새로운 프레임워크를 제시하는데, 언어 모델 스스로가 자신의 하네스를 수정해서 비디오를 재조사한다. 에이전트는 원본 학습 영상에 돌아가 추가 관찰을 통해 여러 실패 가설을 검증하고, 기존 실행 흔적을 벗어난 증거로 개선안을 뒷받침한다. 전체 요약 8문장 읽기 → 058 18:12 ▲ 13 · 댓글 2 의료 AI가 스스로 증거를 찾는다, 종단 임상 추론 벤치마크 재단 모델을 임상 에이전트로 활용하되 기존 벤치마크와 달리 미리 선정된 증거가 아닌 임상 기록과 종단 영상 데이터에서 능동적으로 증거를 찾을 수 있도록 설계했다. AI · 머신러닝 · From Given to Gathered Evidence: Agentic Learning for Longitudinal Medical Reasoning
Key Point 임상 데이터를 능동적으로 탐색하며 종단 추론을 수행하는 의료 AI 에이전트의 새로운 패러다임이 제시되며, 대규모 정제 벤치마크와 학습 방법이 함께 공개될 예정이기 때문이다.
핵심 요약
재단 모델을 임상 에이전트로 활용하되 기존 벤치마크와 달리 미리 선정된 증거가 아닌 임상 기록과 종단 영상 데이터에서 능동적으로 증거를 찾을 수 있도록 설계했다. CASE라는 역할별 임상 에이전트 시리즈와 도구 사용 장치, 컴팩트한 비전-언어 정책 모델 학습 프레임워크를 제안한다. UK Biobank 기반 종단 멀티모달 벤치마크를 구축했으며, 4,739명의 참여자로부터 도출한 ICD-10 코딩 진단에 기반한 50,401개 임상 질문을 포함한다. 전체 요약 8문장 읽기 → 059 21:11 ▲ 194 · 댓글 84 마이크로소프트, 신뢰할 수 없는 코드 안전 실행하는 MXC 공개 마이크로소프트가 신뢰할 수 없는 코드(모델 출력, 플러그인, 도구)를 안전하게 실행하는 샌드박스 실행 시스템 MXC를 오픈소스로 공개했다. 인프라 · 데브옵스 · MXC - a sandboxed code execution system
Key Point LLM 출력이나 제3자 플러그인을 앱에 통합할 때 필요한 보안 격리 인프라를 마이크로소프트가 오픈소스로 제공해 개발자들이 쉽게 도입할 수 있게 되었다.
핵심 요약
마이크로소프트가 신뢰할 수 없는 코드(모델 출력, 플러그인, 도구)를 안전하게 실행하는 샌드박스 실행 시스템 MXC를 오픈소스로 공개했다. Windows, Linux, macOS를 지원하며 ProcessContainer, Windows Sandbox, LXC, Bubblewrap, Seatbelt, MicroVM, Hyperlight 등 다양한 격리 백엔드를 제공한다. 파일시스템 정책(읽기 전용, 읽기-쓰기, 거부), 네트워크 정책(프록시 지원, 아웃바운드 제어), UI 정책(클립보드, 디스플레이 접근 제어) 등 세분화된 정책 기반 샌드박싱을 지원한다. 전체 요약 8문장 읽기 → 060 15:11 ▲ 105 · 댓글 48 AI가 5개월에 완성한 Db2 마이그레이션 기능, 인간은 9개월 소요 Cockroach Labs는 MOLT 데이터베이스 마이그레이션 도구에 IBM Db2 소스 지원을 추가했는데, 이 작업을 AI 에이전트들이 2일 만에 완료했다. AI · 머신러닝 · Five months treating bugs like patients and coding agents like a medical team
Key Point 의료 시스템 모델로 AI 코드 작성의 품질 문제를 해결하고 기존 9개월 작업을 2일로 단축한 구체적 사례로, AI 코드 자동화의 실무적 가능성과 제약을 보여준다.
핵심 요약
Cockroach Labs는 MOLT 데이터베이스 마이그레이션 도구에 IBM Db2 소스 지원을 추가했는데, 이 작업을 AI 에이전트들이 2일 만에 완료했다. Oracle 지원 추가는 인간 엔지니어가 9개월, 약 16만 달러를 들였지만, Db2 지원은 에이전트가 비용 4,172달러에 완료했다: 164배 빠르고 38배 저렴했다. 작업 자동화를 위해 'MOLT Sinai'라는 '코딩 병원' 시스템을 구축했다: GitHub 이슈를 환자로, 병합을 퇴원으로 부르는 의료진 비유 모델이다. 전체 요약 16문장 읽기 → 061 12:11 ▲ 12 · 댓글 2 강화학습의 그래디언트 기아 현상 해결하는 ReSPO 논문 검증 가능한 보상으로부터의 강화학습(RLVR)에서 롤아웃을 여러 정책 업데이트에 걸쳐 재사용하면, 현재 정책과 데이터 생성 정책 간의 불일치가 심화된다. AI · 머신러닝 · ReSPO: Reshaped Sequence Policy Optimization for Gradient Starvation in Off-Policy Learning
Key Point 강화학습 모델 훈련에서 정책 최적화 과정의 근본적인 문제를 진단하고 이를 해결하는 새로운 알고리즘을 제시하여, 특히 데이터 재사용 효율성이 중요한 LLM 훈련에 직접 적용될 수 있기 때문이다.
핵심 요약
검증 가능한 보상으로부터의 강화학습(RLVR)에서 롤아웃을 여러 정책 업데이트에 걸쳐 재사용하면, 현재 정책과 데이터 생성 정책 간의 불일치가 심화된다. 기존 클리핑 기반 정책 최적화에서 '부호 의존 그래디언트 기아' 문제가 발생하는데, 이는 클리핑이 저중요도 가중치 영역의 미생성 긍정 응답을 억제하면서 동시에 고중요도 영역의 과도 생성 부정 응답이 지배하게 되는 현상이다. 연구팀은 ReSPO(Reshaped Sequence Policy Optimization)를 제안하는데, α-발산 변분 목적함수와 지수 분산 제어 틸트에서 파생된 부드러운 이중 분기 시퀀스 레벨 커널로 클리핑을 대체한다. 전체 요약 6문장 읽기 → 062 03:11 ▲ 14 · 댓글 2 긴 작업 추적하는 AI 코딩 어시스턴트 비평가 'Opera' 공개 장시간 코딩 작업을 수행하는 에이전트가 피드백을 받아도 실제로 문제가 해결되지 않는 경우가 많다. AI · 머신러닝 · Opera: A Verbal Critic Framework for Long-horizon Coding Agents
Key Point AI 코딩 에이전트의 가장 큰 약점인 '피드백을 받아도 실제 문제가 풀리지 않는' 현상을 근본적으로 진단하고 추적하는 방식이 소프트웨어 공학 벤치마크 전체에서 최고 성능을 기록했습니다.
핵심 요약
장시간 코딩 작업을 수행하는 에이전트가 피드백을 받아도 실제로 문제가 해결되지 않는 경우가 많다. Opera는 각 수정을 지속적인 기록으로 관리하며, 진단된 문제가 실제로 해결될 때까지 추적하는 AI 비평가 프레임워크다. 주기적·이벤트 기반 검토 트리거, 타입화된 연산자를 통한 문제 진단, 전달 전 증거 기반 감시, 피드백 이후 에이전트 행동 추적이 핵심이다. 전체 요약 8문장 읽기 → 063 09:11 ▲ 10 · 댓글 3 생물 진화 원리로 LLM 멀티에이전트 시스템 테스트 최적화 LLM 기반 멀티에이전트 시스템(MAS)은 복합 작업에 특화된 에이전트들을 조율하지만, 효과적인 워크플로우를 사전에 설계하기 어렵다. AI · 머신러닝 · Inherit-MAS: Test-Time Evolution of Multi-Agent Systems through Workflow and Execution Inheritance
Key Point 복합 작업을 처리하는 멀티에이전트 LLM 시스템의 워크플로우 최적화와 실행 효율성 문제를 동시에 해결한 새로운 접근법으로, 토큰 사용량을 대폭 줄이면서 성능을 높인다.
핵심 요약
LLM 기반 멀티에이전트 시스템(MAS)은 복합 작업에 특화된 에이전트들을 조율하지만, 효과적인 워크플로우를 사전에 설계하기 어렵다. Inherit-MAS는 워크플로우와 실행 단계에서 '상속'을 명시적으로 구현해 테스트 시점의 진화를 효율화했다. 메타 모델이 워커 에이전트 워크플로우를 합성하고(역할·통신·권한 선언), 별도의 판사 모델이 실행 결과를 평가하고 결함을 진단한다. 전체 요약 8문장 읽기 → 064 21:11 ▲ 15 · 댓글 2 멀티모달 AI의 약점을 파헤치는 평가 프레임워크 등장 음성-영상 동시 처리 능력을 갖춘 멀티모달 대형 언어모델(MLLM)의 성능 평가가 시급해지면서 새로운 벤치마크가 필요했다. AI · 머신러닝 · OmniCapBench: A Deep-Structured Evaluation Framework for Fine-Grained Audio-Visual Captioning
Key Point 음성·영상 멀티모달 AI의 개발이 가속화되는 상황에서 실제 약점을 구분해 측정할 수 있는 평가 방법론이 처음 제시되어, 향후 MLLM 개선 방향을 좌우할 기준점이 될 것이다.
핵심 요약
음성-영상 동시 처리 능력을 갖춘 멀티모달 대형 언어모델(MLLM)의 성능 평가가 시급해지면서 새로운 벤치마크가 필요했다. 기존 벤치마크는 전체 캡션 점수는 포괄성 있지만 세부 위치 정보가 없거나, 부분 검증은 정확하지만 전체 흐름을 놓치는 문제가 있었다. 연구팀은 OmniCapBench를 개발해 평가 대상을 자유로운 텍스트에서 검증 가능한 원자 단위로 변경했다. 전체 요약 7문장 읽기 → 065 12:11 ▲ 16 · 댓글 6 X선 회절 자동 분석하는 AI 에이전트 등장 분말 X선 회절 분석을 위한 자가학습 AI 에이전트 '간 장(Gan Jiang)'을 개발했다. AI · 머신러닝 · A self-learning scientific agent for X-ray diffraction
Key Point X선 회절은 신물질 개발·품질 검사·고고학 분석 등에 필수적인데, 기존에는 전문가 경험에 의존하던 분석을 AI가 자동화하고 다른 시료에 전이 가능한 수준에 도달했으며, 최근 공개된 다양한 벤치마크에서 기존 방법을 크게 앞섰다.
핵심 요약
분말 X선 회절 분석을 위한 자가학습 AI 에이전트 '간 장(Gan Jiang)'을 개발했다. XMatcher, XQueryer, XDecomposer, WPEM 4개의 엔진으로 구성되며, 물질 상(phase) 식별부터 다중상 분해, 물리 제약 조건 하의 전체 패턴 모델링까지 수행한다. 에이전트는 분석 실패를 진단하고 스킬 명령어와 코드를 개선한 뒤 재사용 전에 검증하는 방식으로, 언어모델 재훈련이나 물리 모델 변경 없이 실무 경험을 재사용 가능한 지식으로 변환한다. 전체 요약 8문장 읽기 → 066 03:11 새 버전 Angular 22.2.2 버그 수정 버전 출시 컴파일러에서 ::ng-deep 감지 상태 누수를 방지하고, 엔티티 해석 시 프로토타입 조회를 피하며, 다양한 네임스페이스에 중첩된 ng-template의 디렉티브 매칭을 정확히 수정했다. 웹 · 프론트엔드 · angular/angular@v22.2.2
Key Point Angular 22.2.2는 컴파일러, 폼 처리, 라우팅, 신호 기반 리액티비티 등 핵심 모듈의 다중 버그를 수정한 안정성 업데이트이며, 특히 제어 흐름과 디렉티브 매칭의 정확도를 개선했다.
핵심 요약
컴파일러에서 ::ng-deep 감지 상태 누수를 방지하고, 엔티티 해석 시 프로토타입 조회를 피하며, 다양한 네임스페이스에 중첩된 ng-template의 디렉티브 매칭을 정확히 수정했다. @let 선언을 제어 흐름 콘텐츠 프로젝션 진단에서 무시하고, 제어 흐름 블록의 네임스페이스 루트 노드를 ng-content 태그 선택자와 일치시키며, 네임스페이스와 무관하게 스크립트 요소를 제거한다. 컴파일러-CLI에서 생성자 파라미터 속성을 상속된 것으로 표시하지 않고, 누락된 디렉티브 확장 검사를 최적화했다. 전체 요약 7문장 읽기 → 067 03:11 ▲ 103 · 댓글 196 TypeScript 컴파일러를 Rust로 포팅한 tsc-rs 공개 LLM을 이용해 TypeScript 컴파일러, 타입 체커, LSP를 Rust로 포팅한 tsc-rs를 공개했다. 기타 · Port of the TypeScript compiler, checker and lsp to Rust, by LLM
Key Point LLM으로 대규모 컴파일러를 성공적으로 포팅한 사례이며, tsc 7 대비 1.6배 빠른 TypeScript 타입 체커가 npm에 공개되어 프로젝트에 즉시 적용 가능하다.
핵심 요약
LLM을 이용해 TypeScript 컴파일러, 타입 체커, LSP를 Rust로 포팅한 tsc-rs를 공개했다. OpenAI 모델로는 총 42만 달러를 소비했으나 84% 호환성에 그쳤고, Claude Opus 5.5는 10시간 내 작동 v0를 완성해 2주간 약 2만 4,047달러로 완전 포팅을 달성했다. Microsoft의 TypeScript 컴파일러를 Go에서 Rust로 직접 포팅했으며, tsc와 동일한 명령줄 옵션·언어 서버·API를 유지한다. 전체 요약 12문장 읽기 → 068 03:11 ▲ 129 · 댓글 27 캐나다 시인 앤 카슨, 2026 노벨문학상 수상 스웨덴 아카데미가 앤 카슨을 2026년 노벨문학상 수상자로 발표했다. 기타 · Anne Carson wins Nobel Prize in literature 2026
Key Point 장르를 초월하고 고전을 현대적으로 재해석하는 시인의 노벨상 수상은 실험적 문학이 세계 최고 권위의 상으로 인정받았다는 신호이며, 앞서 밥 딜런·애니 에르노 등과 함께 노벨 문학상의 폭넓은 범위를 보여준다.
핵심 요약
스웨덴 아카데미가 앤 카슨을 2026년 노벨문학상 수상자로 발표했다. 아카데미는 카슨의 '고전 전통과 장난스러운 대화를 나누며 현대문학에 새로운 형식을 만들어낸 대담하고 혁신적인 작품'을 평가했다. 1950년 토론토 태생인 카슨은 시·산문·번역을 자유롭게 오가며 고대 그리스 문학과 신화를 깊이 있게 다루는 작가로, 프린스턴·NYU·맥길대 등에서 고전학을 가르쳤다. 전체 요약 10문장 읽기 → 069 00:11 ▲ 29 · 댓글 2 고정 모델도 로봇 역량 높인다, PhysEvo 프레임워크 제시 Astra 같은 고정된 대형 모델도 충분한 관찰과 제어 체계가 있으면 로봇 조작 능력을 발휘할 수 있다. AI · 머신러닝 · PhysEvo: Astra Can Act, Let It
Key Point 모델 가중치 업데이트나 별도 훈련 없이 시뮬레이션 기반 자기개선만으로 실제 로봇 조작 성공률을 5배 이상 높일 수 있음을 입증한 결과다.
핵심 요약
Astra 같은 고정된 대형 모델도 충분한 관찰과 제어 체계가 있으면 로봇 조작 능력을 발휘할 수 있다. PhysEvo는 모델 가중치를 업데이트하지 않고도 물리적 재귀적 자기개선(RSI)을 수행하는 프레임워크다. 작업 에이전트가 로봇 태스크를 실행하고, 메타 에이전트가 실패를 진단해 도구와 스킬을 개정한 후 테스트한다. 전체 요약 8문장 읽기 → 070 21:11 당일 +306 마이크로소프트의 신규 샌드박스 시스템 MXC 오픈소스 공개 마이크로소프트가 신뢰할 수 없는 코드(AI 모델 출력, 플러그인, 도구)를 격리된 환경에서 실행하기 위한 MXC(eXecution Container) 시스템을 공개했다. 인프라 · 데브옵스 · microsoft/mxc · Rust
Key Point 신뢰할 수 없는 외부 코드 실행이 필수적인 AI 모델 배포, 플러그인 시스템, 공용 API 서비스 개발자들이 보안 격리를 구현할 수 있는 프로덕션급 오픈소스 솔루션이 생겼습니다.
핵심 요약
마이크로소프트가 신뢰할 수 없는 코드(AI 모델 출력, 플러그인, 도구)를 격리된 환경에서 실행하기 위한 MXC(eXecution Container) 시스템을 공개했다. ProcessContainer, Windows Sandbox, LXC, Bubblewrap, Seatbelt, MicroVM, Hyperlight 등 8가지 격리 백엔드를 지원하며 단일 통합 인터페이스로 관리된다. Windows, Linux, macOS를 지원하며 각 플랫폼에 적합한 기본 백엔드를 자동으로 선택한다: Windows 11은 ProcessContainer, Linux는 Bubblewrap, macOS는 Seatbelt가 기본값이다. 전체 요약 8문장 읽기 → 071 18:30 ▲ 11 · 댓글 2 GUI 에이전트가 스스로 개선되는 프레임워크 등장 GUI 모델을 감싸는 실행 환경(harness)을 자동으로 최적화하는 GUI-HARVEST를 제안한다. AI · 머신러닝 · GUI-HARVEST: Self-Improving GUI Agents through Evidence-Driven Harness Evolution
Key Point GUI 기반 에이전트의 성능을 모델 재학습 없이 실행 환경 최적화만으로 끌어올리는 방법이 등장했으며, 폐쇄형 모델도 개선 가능해진다.
핵심 요약
GUI 모델을 감싸는 실행 환경(harness)을 자동으로 최적화하는 GUI-HARVEST를 제안한다. 모델의 의도를 시각적 결과와 정렬하고, 스크린샷 변화로 동작 효과를 진단하며, 실행 변동성을 고려한 반복 실행 비교를 통해 신뢰성을 높인다. 여러 작업에서 확인된 반복 실패 패턴을 식별하고, 이를 소스코드 수정으로 변환한 뒤 반복 실행으로 검증한다. 전체 요약 6문장 읽기 → 072 18:30 ▲ 17 · 댓글 2 광고 영상 생성용 대규모 데이터셋 'AdSpark' 공개 제품 정체성을 보존하면서 판매 포인트를 다중 장면 내러티브로 표현하는 광고 영상 생성 연구를 위해 AdSpark 데이터셋과 벤치마크를 발표했다. AI · 머신러닝 · AdSpark: A Large-Scale Dataset and Benchmark for Product-Centric Advertisement Video Generation
Key Point 제품 광고 영상 생성이라는 새로운 작업을 위해 처음으로 대규모 구조화 데이터셋과 다차원 평가 프레임워크를 제시해, 이 분야 연구의 기초를 마련한다.
핵심 요약
제품 정체성을 보존하면서 판매 포인트를 다중 장면 내러티브로 표현하는 광고 영상 생성 연구를 위해 AdSpark 데이터셋과 벤치마크를 발표했다. AdSpark-300K는 이커머스 플랫폼 데이터를 바탕으로 약 30만 개의 이미지-프롬프트-영상 3쌍으로 구성되며, 실제 데이터와 합성 데이터 부분집합을 포함한다. 각 샘플에는 제품 식별 주석, 판매 포인트 설명, 창의적 계획, 정렬된 음성 스크립트 등 구조화된 광고 주석이 포함되어 있다. 전체 요약 6문장 읽기 → 073 18:30 ▲ 29 · 댓글 2 저정밀 강화학습의 수치 오차 해결, TRIAGE 방법 제안 NVFP4 저정밀 실행을 통해 대형언어모델의 강화학습을 가속할 수 있지만, 학습기와 샘플러 간 실행 불일치가 정책 최적화를 불안정하게 만드는 문제가 있다. AI · 머신러닝 · TRIAGE: Direction-Aware Mismatch Stabilization of Native NVFP4 Reinforcement Learning
Key Point 저정밀 연산으로 LLM 강화학습 속도를 크게 높일 수 있지만 수치 오차로 인한 불안정성이 문제인데, 이 논문이 그 원인을 정확히 분석하고 실질적인 해결책을 제시했기 때문에 LLM 최적화에 관심 있는 개발자와 연구자가 봐야 한다.
핵심 요약
NVFP4 저정밀 실행을 통해 대형언어모델의 강화학습을 가속할 수 있지만, 학습기와 샘플러 간 실행 불일치가 정책 최적화를 불안정하게 만드는 문제가 있다. 연구팀은 불일치가 정책 기울기 방향과 상호작용하는 방식을 분석해, 크기만으로는 식별할 수 없는 국소 증폭 및 감소 영역을 구분했다. NVFP4 실행에서 초기 불균형으로 인해 음수 이점·음수 간극 업데이트가 우세하고, 이러한 토큰들이 불일치가 전역적으로 확산되기 전에 응답 세그먼트의 소수 부분에 집중된다는 패턴을 발견했다. 전체 요약 7문장 읽기 → 074 18:30 ▲ 53 · 댓글 2 코딩 AI는 정적분석 검사기를 만들 수 있을까 정적분석 검사기 개발은 에이전트가 결함 명세를 해석하고, 저장소를 검사하며, 분석기 로직을 구현하고, 컴파일 피드백을 통해 반복적으로 개선해야 하는 복잡한 작업이다. AI · 머신러닝 · CheckerBench: Can Long-Horizon Agents Synthesize Static-Analysis Checkers?
Key Point LLM 기반 코딩 에이전트의 실제 역량을 장기 복합 작업으로 평가하는 새로운 벤치마크를 제시하며, 현재 AI 모델들이 보안 도구 개발에서 얼마나 한계가 있는지 보여준다.
핵심 요약
정적분석 검사기 개발은 에이전트가 결함 명세를 해석하고, 저장소를 검사하며, 분석기 로직을 구현하고, 컴파일 피드백을 통해 반복적으로 개선해야 하는 복잡한 작업이다. 기존 코딩 에이전트 벤치마크는 패치 생성이나 취약점 탐지 같은 단기 작업에 집중했으며, 처음부터 끝까지 작동하는 검사기를 개발할 수 있는지는 거의 평가하지 않았다. CheckerBench는 297개 CVE, 167개 저장소, 85개 CWE, 5개 언어 생태계에서 파생한 300개 작업으로 구성된 실행 가능한 벤치마크다. 전체 요약 7문장 읽기 → 075 18:30 ▲ 54 · 댓글 2 동영상 미래 사건 예측, 인과관계 추론으로 정확도 높인다 비디오 이벤트 예측(VEP) 문제를 해결하기 위해 VepAgent라는 에이전트 프레임워크를 제안했습니다. AI · 머신러닝 · VepAgent: Bridging Causal-Transition via Tool-Augmented Reinforcement Learning for Video Event Prediction
Key Point 동영상에서 아직 일어나지 않은 미래 사건을 예측하는 작업에서 단순 패턴 학습을 넘어 인과관계를 명시적으로 추론하는 새로운 접근이 핵심 기술로 제시되고 있습니다.
핵심 요약
비디오 이벤트 예측(VEP) 문제를 해결하기 위해 VepAgent라는 에이전트 프레임워크를 제안했습니다. 기존 멀티모달 대형언어모델(MLLM)은 과거에 의존한 요약에 머물러 관찰되지 않은 인과 관계를 연결하지 못한다는 문제를 지적합니다. VepAgent는 인과-전이 추론과 도구 기반 강화학습을 통합하여 마지막 관찰 상태에서 미래 사건까지의 논리적 진행을 명시적으로 모델링합니다. 전체 요약 7문장 읽기 → 076 18:33 ▲ 11 · 댓글 2 긴 작업의 진행률을 아는 게 왜 이렇게 어려울까 로봇 같은 embodied agent가 장기 작업을 수행할 때, 현재 프레임만으로는 얼마나 진행했는지 판단하기 어렵다는 문제를 '문맥 의존적 진행률 추정'으로 정의했다. AI · 머신러닝 · ProgressCompass: Embodied Progress Reward Models Are Lost Without the Right Context
Key Point 로봇 작업 완수 시 진행 상황을 정확히 추적하는 것이 단순히 현재 상황만으로는 불가능하다는 근본적인 문제를 드러내고, 범용 모델 활용으로 기존 시스템을 개선할 수 있는 실질적 해법을 제시하기 때문이다.
핵심 요약
로봇 같은 embodied agent가 장기 작업을 수행할 때, 현재 프레임만으로는 얼마나 진행했는지 판단하기 어렵다는 문제를 '문맥 의존적 진행률 추정'으로 정의했다. 기존 Progress Reward Models(PRMs)는 각 단계에서 작업 진행도를 점수화하는데, 장기 작업에서는 이전에 일어난 일들의 맥락이 필요하지만 대부분 현재 관찰만으로 작동한다. 연구팀이 24개 조작 작업 120 에피소드로 구성한 ContextProgress-Bench를 구축했으며, 상태 재호출(이전 정보가 현재 프레임에 없음), 순서 추적(단계들이 정해진 순서대로 진행), 반복 구분(비슷한 프레임이 다른 진행 단계에 나타남) 등 3가지 시나리오를 다룬다. 전체 요약 6문장 읽기 → 077 18:33 ▲ 14 · 댓글 3 에이전트 메모리를 자동 진화시키는 새로운 방법 에이전트의 메모리 시스템을 작업 피드백으로 자동 개선하는 메모리 자가진화 기법의 한계를 개선한 논문이다. AI · 머신러닝 · Capability-Driven Self-Evolution of Agent Memory
Key Point 기존 에이전트 메모리 최적화의 근본적 문제점을 능력별 분석으로 해결하는 방식이 신경망 기반 최적화와 다르고, 장문맥 처리에서 눈에 띄는 성능 향상을 보여준다.
핵심 요약
에이전트의 메모리 시스템을 작업 피드백으로 자동 개선하는 메모리 자가진화 기법의 한계를 개선한 논문이다. 기존 방식은 전체 성능만 보고 진화 방향을 정하는 홀리스틱 진화를 써 왔는데, 능력별 개선 효과를 놓치고 일부 영역의 후퇴가 전체 성능을 가린다. 이 논문은 능력 기반 진화(capability-driven evolution)를 제안해 전체 성능 대신 개별 능력 차원별로 탐색을 안내한다. 전체 요약 6문장 읽기 → 078 18:33 ▲ 13 · 댓글 2 VLA 모델의 지름길 학습 끊기, 섭동 훈련으로 Vision-Language-Action(VLA) 정책은 작업 결정에 필요한 핵심 증거를 무시하고도 복잡한 과제를 완료할 수 있는데, 시각 정보, 언어, 동작의 '모달리티 지름길(shortcut)'에 의존하기 때문이다. AI · 머신러닝 · PerturBot: Breaking Shortcut Priors in Vision-Language-Action Models with Perturbative Training
Key Point 로봇이 실제 작업의 핵심 근거 없이도 지름길 패턴으로 행동을 결정하는 근본 문제를 진단하고 훈련 시점에 해결하는 방법론을 제시한다.
핵심 요약
Vision-Language-Action(VLA) 정책은 작업 결정에 필요한 핵심 증거를 무시하고도 복잡한 과제를 완료할 수 있는데, 시각 정보, 언어, 동작의 '모달리티 지름길(shortcut)'에 의존하기 때문이다. 지름길의 예: 손목 카메라 근처의 물체가 지시된 대상을 밀어낼 수 있고, 훈련 과정에서 동사가 바뀌어도 익숙한 명사가 같은 동작을 유발하며, 빈 손가락이 움직여도 물체를 집어올릴 수 있다. 더 많은 훈련 데이터도 작업 성공률은 올리되 이 지름길을 온전히 해결하지 못하는 문제가 있다. 전체 요약 8문장 읽기 → 079 18:33 ▲ 160 · 댓글 2 다른 토크나이저 간 증류학습, 정확도는 적은 정보로도 충분하다 On-Policy Distillation(OPD)은 학생 모델이 자신의 생성 결과에 대해 교사 모델의 피드백을 받아 학습하는 방식이며, 다른 토크나이저를 쓸 때는 시퀀스와 어휘 레벨에서 정렬이 필요하다. AI · 머신러닝 · Rethinking Cross-Tokenizer On-Policy Distillation: From Alignment Coverage to Supervision Reliability
Key Point 다른 토크나이저를 사용하는 모델 간 증류에서 더 많은 정렬 범위보다 신뢰할 수 있는 감독이 핵심이라는 발견으로, 효율적인 학습 설계의 원칙을 제시한다.
핵심 요약
On-Policy Distillation(OPD)은 학생 모델이 자신의 생성 결과에 대해 교사 모델의 피드백을 받아 학습하는 방식이며, 다른 토크나이저를 쓸 때는 시퀀스와 어휘 레벨에서 정렬이 필요하다. 수학 추론과 코드 생성 과제에서 3개 교사-학생 쌍을 실험한 결과, 어휘 불일치가 크더라도 엄격한 1:1 정렬만으로도 학생이 생성한 대부분의 토큰을 커버했다. 학생이 증류 전에 샘플링한 응답에서 공유 어휘는 엄격히 정렬된 위치에서 교사와 학생의 확률 질량 거의 전부를 유지했다. 전체 요약 7문장 읽기 → 080 18:35 ▲ 60 · 댓글 2 토큰 난이도에 맞춰 계산 할당하는 확산형 언어모델 ALoDLM 확산형 언어모델(DLM)은 여러 토큰을 병렬로 예측해 빠른 생성을 가능하게 하지만, 같은 크기의 자동회귀(AR) 모델 대비 품질 격차가 실제 적용을 제한하고 있다. AI · 머신러닝 · ALoDLM: Adaptively Looped Diffusion Language Models
Key Point 기존 확산형 언어모델의 품질 격차 원인을 토큰 난이도 측면에서 처음으로 진단하고, 적응형 계산 할당으로 해결한 새로운 접근법이 표준 모델들을 능가했기 때문이다.
핵심 요약
확산형 언어모델(DLM)은 여러 토큰을 병렬로 예측해 빠른 생성을 가능하게 하지만, 같은 크기의 자동회귀(AR) 모델 대비 품질 격차가 실제 적용을 제한하고 있다. 논문은 이 격차의 원인을 계산-난이도 불일치로 분석했다. 부분적으로 관찰된 수열 내에서 일부 미지의 토큰은 쉽게 예측되지만 다른 토큰은 훨씬 더 많은 계산이 필요하다. 기존 DLM은 각 노이즈 제거 단계에서 모든 미지 위치에 동일한 계산 깊이를 적용한다. 전체 요약 9문장 읽기 → 081 06:11 ▲ 16 · 댓글 2 같은 블록 반복으로 LLM 깊이를 늘리는 LOOM 기법 Looped Transformers는 같은 Transformer 블록을 반복 적용해 파라미터를 늘리지 않고 모델의 유효 깊이를 증가시킨다. AI · 머신러닝 · Looping Beyond Twice: A Scalable Recipe for Looped Mixture-of-Experts
Key Point 같은 블록을 몇 번까지 반복할 수 있는지, 그리고 MoE 라우터의 동작 특성을 고려해 어떻게 효율적으로 설계할지가 실무 모델 개발에 직결된다.
핵심 요약
Looped Transformers는 같은 Transformer 블록을 반복 적용해 파라미터를 늘리지 않고 모델의 유효 깊이를 증가시킨다. 기존 연구는 반복 횟수 증가에 따른 성능 이득이 빠르게 감소해 2번 반복으로 제한했으며, MoE 모델에서 특히 이 문제가 심했다. LOOM은 두 가지 병목을 진단했다: 반복할 때마다 hidden-state 분산이 증가해 깊은 모델이 불안정해지는 '깊이의 저주' 현상, 그리고 라우터가 매번 같은 expert를 선택해 계산 다양성이 떨어지는 'expert 선택 붕괴' 현상이다. 전체 요약 8문장 읽기 → 082 06:11 ▲ 15 · 댓글 1 로봇이 시뮬레이션에서 배운 조작 기술을 현실에서 바로 쓴다 로봇이 시뮬레이션과 현실의 차이(시각, 역학, 몸체)를 넘어 기술을 옮기는 문제를 해결하는 Skill2Real 프레임워크를 제시했다. 하드웨어 · 시스템 · Skill2Real: Agentic Skill Learning for Zero-Shot Sim-to-Real Robot Manipulation
Key Point 시뮬레이션 학습으로 실제 로봇 조작을 성공시키는 과정이 공개됨에 따라, 로봇 개발의 데이터 수집 비용과 안전 리스크를 크게 줄일 수 있는 경로가 가시화되었다.
핵심 요약
로봇이 시뮬레이션과 현실의 차이(시각, 역학, 몸체)를 넘어 기술을 옮기는 문제를 해결하는 Skill2Real 프레임워크를 제시했다. 공통 API로 실행 가능한 스킬을 학습하며, Proposer-Verifier-Governor(PVG) 루프가 시뮬레이션 정보로 결과를 진단하고 업데이트를 검증한다. 소뇌(Cerebellum)에서 조작 스킬을 먼저 획득한 뒤 뇌(Brain)에서 소뇌를 고정하고 과제 수준의 조합을 학습한다. 전체 요약 8문장 읽기 → 083 03:11 ▲ 102 · 댓글 21 foldl과 foldr의 근본적인 차이, 정확히 이해하기 foldl과 foldr은 '왼쪽에서'와 '오른쪽에서' 접는 것이 아니라, 같은 순서로 리스트를 순회하되 연산의 결합 방식만 다르다. 오픈소스 · 도구 · Differences Between `Foldl` and `Foldr`
Key Point 게으른 평가 언어에서 foldl과 foldr의 성능 차이가 직관과 정반대인 이유를 정확히 이해해야 리스트 처리 코드의 메모리 문제를 진단하고 올바른 함수를 선택할 수 있다.
핵심 요약
foldl과 foldr은 '왼쪽에서'와 '오른쪽에서' 접는 것이 아니라, 같은 순서로 리스트를 순회하되 연산의 결합 방식만 다르다. foldl은 왼쪽 결합으로 (((v ⨂ e0) ⨂ e1) ⨂ e2)처럼 동작하고, foldr은 오른쪽 결합으로 e0 ⨂ (e1 ⨂ (e2 ⨂ v))처럼 동작한다. 순수 언어에서 foldl은 첫 원소부터 축적값을 업데이트하며 상수 공간에서 동작하지만, foldr은 마지막 원소까지 도달해야 하므로 리스트 크기에 비례하는 스택 프레임이 필요하다. 전체 요약 8문장 읽기 → 084 00:11 ▲ 124 · 댓글 111 애플의 제약, AI 에이전트의 미래를 가르다 저자의 Mac Mini가 macOS 화면 공유 기능의 CVE-2026-65400 취약점으로 해킹당했고, 상태 관리 버그로 인해 인증 없이 원격 접근이 가능했다. AI · 머신러닝 · Apple and a Hacker's Future
Key Point 에이전트 기술이 개인 컴퓨팅의 중심이 되는 시점에서, Apple의 보안·권한 제어 체계가 자동화된 작업에 실질적 장애물이 되고 있으며, 이것이 Apple의 전통적 영향력을 변화시킬 가능성을 보여준다.
핵심 요약
저자의 Mac Mini가 macOS 화면 공유 기능의 CVE-2026-65400 취약점으로 해킹당했고, 상태 관리 버그로 인해 인증 없이 원격 접근이 가능했다. Apple이 macOS Tahoe, Sequoia, Sonoma용 패치를 공개했으며, 이 취약점은 Black Hat 컨퍼런스에서 공개되었고 Bynario가 보고했다. Claude 에이전트가 불정상적인 권한 상승을 감지하고 자동으로 모든 명령 실행을 중단한 뒤 진단 정보를 제공해 저자가 정확한 침입 시점을 추적할 수 있었다. 전체 요약 11문장 읽기 → 085 21:11 ▲ 47 · 댓글 3 Simulink 모델 생성 AI의 진정한 성능을 측정하는 벤치마크 기존 Simulink 벤치마크는 생성된 모델의 컴파일·실행 여부와 외형 유사도만 평가해 엔지니어링 요구사항 충족 여부를 확인하지 못한다. AI · 머신러닝 · SimuVerity: Benchmarking Agents for Engineering-Grade Simulink Model Generation
Key Point 현재 AI 에이전트의 Simulink 모델 생성은 외형 유사도 중심으로 평가되고 있으나, 실제 엔지니어링 요구사항을 만족하는지는 전혀 다른 문제이기 때문입니다.
핵심 요약
기존 Simulink 벤치마크는 생성된 모델의 컴파일·실행 여부와 외형 유사도만 평가해 엔지니어링 요구사항 충족 여부를 확인하지 못한다. SimuVerity는 10개 엔지니어링 도메인에서 101개의 텍스트-실행파일 Simulink 모델 생성 작업으로 구성된 벤치마크를 제시한다. 각 작업마다 실행 가능한 시스템 프로파일이 엔지니어링 사양을 정의하고, 4가지 시뮬레이션 시나리오 세트가 테스트 조건이 된다. 전체 요약 7문장 읽기 → 086 09:11 ▲ 101 · 댓글 77 영재 아이들의 '거절 민감성' 이해하고 관계 맺기 거절 민감성은 중립적이거나 모호한 상황까지 거절이나 비판을 강하게 지각하고 반응하는 경향으로, 영재 아이들과 이중 재능아(2e)들은 신경계가 신호를 빠르고 깊게 처리하기 때문에 이 기본 민감성이 더 크게 드러난다. 기타 · Rejection Sensitivity in Gifted and Twice-Exceptional Children
Key Point 영재 아이의 극심한 감정 반응이 우약함이나 버릇이 아니라 신경계 특성이며, 부모의 접근 방식을 바꿔야 진정한 해결이 가능하기 때문이다.
핵심 요약
거절 민감성은 중립적이거나 모호한 상황까지 거절이나 비판을 강하게 지각하고 반응하는 경향으로, 영재 아이들과 이중 재능아(2e)들은 신경계가 신호를 빠르고 깊게 처리하기 때문에 이 기본 민감성이 더 크게 드러난다. 거절 민감성 이상증(RSD)은 ADHD, 자폐증, 고민감성(HSP), 영재성 등 여러 신경 특성에서 나타나는 패턴으로, ADHD는 정서 조절 곤란과 보상 민감성, 자폐증은 사회적 신호 처리의 어려움, 고민감성은 비판에 대한 더 강한 반응, 영재성은 정서적 과흥분(overexcitability)으로 설명된다. 영재 아이들은 조기에 수행을 자신의 정체성과 융합시켜, 과제에 대한 피드백이 자신의 존재 가치에 대한 평판이 되고, ADHD 뇌는 사회적 지위와 소속감 신호를 강하게 추적하며, 인지 나이와 정서 조절 능력의 비동기적 발달이 극단적인 반응을 초래한다. 전체 요약 10문장 읽기 → 087 06:11 ▲ 110 · 댓글 30 러스트 컴파일 속도 2배까지 단축하는 '조기 메타데이터' 기법 Headstart는 의존 크레이트가 타입 체크를 완료한 직후 인터페이스 메타데이터(.rmeta)를 조기에 생성하고, 의존하는 크레이트들이 함수 본체 체크가 완료되기 전에 이 메타데이터로 컴파일을 시작하게 한다. 오픈소스 · 도구 · Emitting metadata early makes building/checking Rust up to twice as fast
Key Point 러스트 컴파일 속도가 실무 프로젝트에서 최대 54% 개선되는 구체적인 기법이며, 패치 형태로 제공되어 업스트림 통합 가능성을 보여준다.
핵심 요약
Headstart는 의존 크레이트가 타입 체크를 완료한 직후 인터페이스 메타데이터(.rmeta)를 조기에 생성하고, 의존하는 크레이트들이 함수 본체 체크가 완료되기 전에 이 메타데이터로 컴파일을 시작하게 한다. cargo check에서는 의존 크레이트의 조기 메타데이터로 다운스트림 크레이트들이 완료될 때까지 진행되고, cargo build에서는 분석 단계는 조기 메타데이터로 진행 후 코드 생성 전에 완전한 메타데이터를 기다리며, 대기 중 작업 슬롯을 다른 작업에 양보한다. 에러가 발생하면 기존과 동일한 진단과 종료 상태로 실패하며, 비용은 버려지는 다운스트림 작업, 약간 늦어진 에러 보고, 동시 메모리 사용량 증가이다. 전체 요약 13문장 읽기 → 088 03:11 ▲ 11 · 댓글 2 음성·영상 AI의 할루시네이션 문제, 질문 재라우팅으로 해결 음성·영상 정보를 함께 다루는 대형언어모델(AVLLM)이 사용하지 않아야 할 모달리티의 신호까지 반영해 잘못된 답변을 생성하는 '소스-혼동 할루시네이션' 문제가 발생한다. AI · 머신러닝 · Devils in Question Relay: Source-Conditioned Relay Steering to Mitigate Hallucinations in Audio-visual Large Language Models
Key Point 음성·영상을 함께 처리하는 AI 시스템에서 불필요한 정보로 인한 오답 문제를 진단하고 해결하는 구체적 방법이 제시되어, 멀티모달 모델의 신뢰성을 높이는 데 직접 적용 가능하다.
핵심 요약
음성·영상 정보를 함께 다루는 대형언어모델(AVLLM)이 사용하지 않아야 할 모달리티의 신호까지 반영해 잘못된 답변을 생성하는 '소스-혼동 할루시네이션' 문제가 발생한다. 연구팀이 경로 개입과 표현 분석을 통해 이 문제의 내부 메커니즘을 규명했다: 질문 상태가 필요한 모달리티의 증거뿐 아니라 간섭 신호도 함께 전달하며, 생성 단계보다는 질문 단계에서 간섭을 차단할 때 더 효과적이다. 이를 바탕으로 SECRET(SourcE-Conditioned RElay sTeering)이라는 훈련 불필요 방식을 제안했다: 서로 다른 모달리티 경로로 추출한 대조적 질문 표현을 이용해 원래 질문을 필요한 소스의 증거로 유도한다. 전체 요약 5문장 읽기 → 089 21:11 당일 +221 PC 관리 올인원 도구 '图吧工具箱 CE' 공개 C#과 WinUI 3로 만든 Windows PC 관리 통합 도구로, 내장 47개 기본 도구와 외부 89개 클래식 하드웨어 도구를 통합 관리한다. 하드웨어 · 시스템 · luolangaga/tubatools · C#
Key Point 새 컴퓨터 검수부터 일상 유지보수까지 한 곳에서 해결하는 올인원 유틸리티이며, 특히 AI 어시스턴트로 자연어 명령 실행과 방대한 내장 도구 집합이 주목할 만하다.
핵심 요약
C#과 WinUI 3로 만든 Windows PC 관리 통합 도구로, 내장 47개 기본 도구와 외부 89개 클래식 하드웨어 도구를 통합 관리한다. AI 어시스턴트 기능으로 자연어로 시스템 제어가 가능하며, 28개 에이전트 도구(하드웨어 정보 읽기, 디스크 분석, 가비지 클린, 파일 읽/쓰기, 명령 실행, 온라인 검색)를 지원한다. 성능 테스트는 CPU/GPU/메모리/디스크/브라우저 5개 항목을 측정해 게임·사무 성능 점수와 PDF 보고서를 제공하며, 커뮤니티 순위표에 스코어를 업로드할 수 있다. 전체 요약 13문장 읽기 → 090 06:11 ▲ 12 · 댓글 2 코딩 AI 에이전트의 로봇 개발 능력을 평가하는 벤치마크 RLE-Bench 공개 코딩 에이전트가 로봇 분야로 확장되면서, 기존 벤치마크는 정책이나 컨트롤러 같은 개별 결과물 성능만 측정해 에이전트의 광범위한 엔지니어링 능력을 평가하지 못했다. AI · 머신러닝 · RLE-Bench: A Qualifying Exam for Coding Agents as Robot Learning Engineers
Key Point 코딩 AI가 로봇 엔지니어링 작업을 수행하려면 단순 성능 지표를 넘어 복합적인 문제 해결, 설계, 통합 능력이 필요하며, RLE-Bench는 이를 종합 평가하는 첫 벤치마크다.
핵심 요약
코딩 에이전트가 로봇 분야로 확장되면서, 기존 벤치마크는 정책이나 컨트롤러 같은 개별 결과물 성능만 측정해 에이전트의 광범위한 엔지니어링 능력을 평가하지 못했다. 실제 로봇 개발은 제어를 넘어 여러 컴포넌트의 구축·통합·진단·개선을 자원 제약 속에서 수행하고 다중 모달 피드백으로 판단해야 한다. 새로 공개한 RLE-Bench는 대화형 제어, 정책 학습, 인식 및 추정, 기계설계 등 4가지 로봇 개발 워크플로우를 포함한 벤치마크다. 전체 요약 6문장 읽기 → 091 00:11 ▲ 12 · 댓글 2 음성 AI가 정말 듣고 행동할까? 음성 에이전트의 맥락 인식 검진 음성 LLM은 음성 명령을 인식하고 도구를 실행할 수 있지만, 먼저 현재 음향 및 대화 맥락이 행동을 정당화하는지 판단해야 한다. AI · 머신러닝 · Do Audio LLMs Listen Before They Act? Diagnosing Acoustic-Context Gating in Voice Agents
Key Point 음성 에이전트가 의도한 사용자의 명령만 수행하고 옆사람의 말은 무시해야 하는데, 현재 모델들이 대부분 이를 제대로 못 하고 있다는 점을 실증적으로 보여준다.
핵심 요약
음성 LLM은 음성 명령을 인식하고 도구를 실행할 수 있지만, 먼저 현재 음향 및 대화 맥락이 행동을 정당화하는지 판단해야 한다. 연구팀은 VGBench라는 1,018개 항목의 진단 벤치마크를 제시했으며, 옆에서의 대화, 혼잣말, 화자 전환 시나리오에서 행동 수준의 적절성을 평가한다. 각 항목은 침묵, 도구 호출, 자연어 응답으로 구성된 공유 행동 공간을 사용하며, 화자 전환 쌍은 음원 거리 및 시간 경계를 제어하면서 착용자에서 방관자로의 전환을 테스트한다. 전체 요약 8문장 읽기 → 092 06:11 ▲ 22 · 댓글 2 VLM의 물리적 지능 평가하는 벤치마크 PhysVista 공개 비전-랭귀지 모델(VLM)이 멀티모달 추론에서 우수하지만, 현실의 물리적 동역학을 진정으로 이해하는지는 여전히 불명확한 상태다. AI · 머신러닝 · PhysVista: Benchmarking Physical Intelligence in VLMs via a Perception-Reasoning-Assessment Loop
Key Point VLM이 영상 내 물리 법칙을 이해하는지 평가하려는 새로운 벤치마크로, AI 생성 콘텐츠의 물리적 신뢰성 검증과 VLM의 진정한 추론 능력 진단이 필요한 시점에 나왔다.
핵심 요약
비전-랭귀지 모델(VLM)이 멀티모달 추론에서 우수하지만, 현실의 물리적 동역학을 진정으로 이해하는지는 여전히 불명확한 상태다. 기존 벤치마크는 지각, 추론, 판단 같은 인지 단계를 단편적으로 평가하며 이들 간의 상호작용을 간과해왔다. 이를 해결하기 위해 인간의 '보기-추론-평가' 과정을 모방한 PhysVista 벤치마크를 제안했다. 전체 요약 8문장 읽기 → 093 03:11 ▲ 32 · 댓글 2 LLM의 데이터 최적화 능력을 측정하는 벤치마크 AutoDataBench 공개 기존 자동 연구(Auto-research) 벤치마크는 학습 프레임워크, 하이퍼파라미터, 컴퓨팅 예산, 데이터 등 여러 개선 요인이 섞여 있어 어떤 에이전트가 우수한 이유를 특정하기 어렵다. AI · 머신러닝 · AutoDataBench: A Data-centric Testbed for Accelerating Auto Research
Key Point 현재 AI 에이전트 벤치마크는 여러 변수가 얽혀 있어 어떤 기술이 실제로 성능을 올리는지 파악하기 어렵고, 이 논문은 데이터 최적화 능력만 순수하게 측정하는 방법론을 제시해 앞으로 자동 연구와 데이터 중심 AI 개발의 평가 방식에 영향을 미칠 수 있기 때문이다.
핵심 요약
기존 자동 연구(Auto-research) 벤치마크는 학습 프레임워크, 하이퍼파라미터, 컴퓨팅 예산, 데이터 등 여러 개선 요인이 섞여 있어 어떤 에이전트가 우수한 이유를 특정하기 어렵다. 이 논문은 '데이터 인텔리전스'(에이전트가 데이터를 이해·조작·개선하는 능력)에 초점을 맞춘 통제된 테스트베드 AutoDataBench를 제시한다. 데이터 진단·조직·구성이라는 개념적 틀로 세 가지 최적화 작업을 구성하고, 다른 변수들은 고정한 채 LLM의 데이터 개선 능력을 평가한다. 전체 요약 8문장 읽기 → 094 18:11 ▲ 57 · 댓글 2 일상 영상에서 도구 사용 이해하는 AI 벤치마크 공개 일상 및 전문적 작업에서 도구 사용은 필수이지만, 현 영상 모델들은 도구 사용의 affordance·기하학적 관계·절차·인과관계를 이해하는 데 제한적이다. AI · 머신러닝 · EgoTools: Towards Tool-Centric Reasoning in Real-World Egocentric Videos
Key Point 현 멀티모달 모델이 실제 작업 영상에서 도구 사용의 세부 기하학·절차·인과관계를 이해하는 데 약점을 드러냈으므로, 이를 진단하고 개선할 수 있는 벤치마크가 필요하다.
핵심 요약
일상 및 전문적 작업에서 도구 사용은 필수이지만, 현 영상 모델들은 도구 사용의 affordance·기하학적 관계·절차·인과관계를 이해하는 데 제한적이다. 이를 해결하기 위해 EgoTools 스위트를 공개했으며, 100시간의 도구 중심 1인칭 영상 데이터셋(음성 동기화·캡션·내레이션·3D 정보 포함)과 진단 벤치마크로 구성된다. 벤치마크는 1,000개의 QA로 이루어져 있으며 지각·기하학·절차·인과 추론의 4가지 트랙을 포함한다. 전체 요약 6문장 읽기 → 095 15:11 ▲ 82 · 댓글 3 장기 작업 수행하는 AI 에이전트, 명시적 신념 상태로 더 정확해진다 LLM 기반 에이전트가 복잡한 작업을 수행할 때 상호작용 이력을 단순히 메모리에 저장하는 것만으로는 현재 세계 상태를 일관되게 이해하기 어렵다. AI · 머신러닝 · Beyond Memory: Harnessing Long-Horizon Agents with Explicit Belief States
Key Point LLM 에이전트의 장기 작업 수행 능력을 크게 향상시키는 새로운 접근법으로, 기존 메모리 기반 방식의 한계를 구체적으로 해결하고 실제 성능 개선을 입증했습니다.
핵심 요약
LLM 기반 에이전트가 복잡한 작업을 수행할 때 상호작용 이력을 단순히 메모리에 저장하는 것만으로는 현재 세계 상태를 일관되게 이해하기 어렵다. 새로운 프레임워크 PoS는 추론 과정에서 명시적 신념 상태(explicit belief states)를 구성하고 지속적으로 유지한다. 각 신념은 현재 세계 상태 추정치와 해결되지 않은 작업 요구사항을 결합하여, 에이전트가 여전히 학습해야 할 것과 달성해야 할 것을 명확히 한다. 전체 요약 8문장 읽기 → 096 15:11 ▲ 83 · 댓글 2 강화학습 미세조정 후 LLM의 성능 편향성, 'Sharpening Tax' 측정법 제시 RL 미세조정이 기본 모델의 기존 행동만 선명하게 만들어 단일 시도 정확도(pass@1)는 높이지만 전체 해결 가능성(pass@K)은 낮춘다는 가설이 제기되고 있다. AI · 머신러닝 · Sharpening Tax in Post-Training
Key Point LLM의 강화학습 미세조정이 실제로는 문제 해결 능력을 좁히는 부작용이 있다는 실증적 증거와 이를 측정하고 개선하는 방법론을 제시하여, 에이전트 성능 평가와 최적화 전략에 근본적인 재고를 촉구한다.
핵심 요약
RL 미세조정이 기본 모델의 기존 행동만 선명하게 만들어 단일 시도 정확도(pass@1)는 높이지만 전체 해결 가능성(pass@K)은 낮춘다는 가설이 제기되고 있다. 아젠틱 작업에서는 사전학습 모델이 추론 시간 예산을 충분히 주면 미세조정 모델보다 pass@K에서 더 높은 성능을 보인다는 놀라운 발견이 있었다. 미세조정이 작업을 '항상 해결 가능' 또는 '절대 불가능' 양극단으로 밀어 샘플링 효율과 일관성은 개선하지만 해결 가능 범위는 줄인다는 메커니즘을 규명했다. 전체 요약 6문장 읽기 → 097 06:11 ▲ 14 · 댓글 2 소프트웨어 개발을 돕는 AI 에이전트의 새 평가 벤치마크 소프트웨어 개발은 코드 편집을 넘어 소프트웨어 실행, 인터페이스 조작, 시각적 검사, 관찰 기반 판단까지 포함하지만 기존 코딩 에이전트들은 이 통합 개발 과정을 제대로 다루지 못하고 있다. AI · 머신러닝 · CUA-SWE: When Computer-Use Agents Meet Visual Software Engineering
Key Point GUI 상호작용과 시각적 피드백을 함께 처리해야 하는 현실의 소프트웨어 개발 방식을 반영한 AI 에이전트 평가 체계가 처음 제시되어, 실무 수준의 자동화 개발 도구 발전에 기준점이 될 수 있다.
핵심 요약
소프트웨어 개발은 코드 편집을 넘어 소프트웨어 실행, 인터페이스 조작, 시각적 검사, 관찰 기반 판단까지 포함하지만 기존 코딩 에이전트들은 이 통합 개발 과정을 제대로 다루지 못하고 있다. 런타임 오류를 진단하려면 에이전트가 시각적 관찰과 코드를 연결한 후 응용 프로그램을 다시 실행해 수정사항을 검증해야 한다. CUA-SWE는 컴퓨터 사용 능력을 갖춘 AI 에이전트가 소프트웨어 엔지니어링 작업을 완수하는 방식을 평가하는 벤치마크, 환경, 평가 파이프라인이다. 전체 요약 8문장 읽기 → 098 03:11 새 버전 Ruff 0.16.10 출시, 메모리 최적화와 UP052 규칙 추가 파이썬 린터·포매터 Ruff의 0.16.10 버전이 2026년 10월 1일 공개되었다. 오픈소스 · 도구 · astral-sh/ruff@0.16.10
Key Point Python 개발자가 널리 쓰는 린터의 메모리 효율성 개선과 새로운 검사 규칙 추가로, 코드 분석 속도와 정확도가 높아진다.
핵심 요약
파이썬 린터·포매터 Ruff의 0.16.10 버전이 2026년 10월 1일 공개되었다. 진단 정보 메모리 사용량을 감소시킨 성능 개선이 이루어졌다. pyupgrade 범주에 context manager iterator annotation 관련 UP052 규칙이 추가되었다. 전체 요약 8문장 읽기 → 099 21:11 당일 +244 GPU·CPU 커널 개발을 단순하게, TileLang DSL 오픈소스 TileLang은 Python 문법을 기반한 도메인 특화 언어(DSL)로, GPU·CPU·NPU 등 다양한 가속기용 고성능 커널 개발을 간소화한다. 인프라 · 데브옵스 · tile-ai/tilelang · Python
Key Point 저수준 최적화 전문 지식 없이 Python 수준에서 GPU·CPU 커널을 작성·배포할 수 있어 AI 인프라 개발의 진입장벽을 크게 낮춘다.
핵심 요약
TileLang은 Python 문법을 기반한 도메인 특화 언어(DSL)로, GPU·CPU·NPU 등 다양한 가속기용 고성능 커널 개발을 간소화한다. TVM 컴파일러 인프라 위에 구축되어 있으며, GEMM·FlashAttention·양자화 연산 등 복잡한 연산의 저수준 최적화를 자동으로 처리한다. NVIDIA CUDA(SM70~SM120), AMD ROCm/HIP(CDNA/RDNA), Apple Metal, Huawei Ascend 950 NPU, LLVM CPU, 그리고 WebGPU 등 다양한 백엔드를 지원한다. 전체 요약 8문장 읽기 → 100 18:11 ▲ 68 · 댓글 3 LLM 에이전트의 숨은 세계 모델을 끌어내는 훈련법 LLM 기반 에이전트는 다중 단계 의사결정에 점점 더 활용되지만 미지의 환경으로의 전이가 좋지 않다. AI · 머신러닝 · EVOKE: Eliciting World Knowledge in Agents for Transferable Decision-Making
Key Point LLM 에이전트가 새로운 환경에 적응하지 못하는 근본 원인을 진단하고, 추가 훈련 없이 기존 지식을 활용하는 훈련 기법을 제안하는 것이 개발자들의 실제 배포 문제를 해결하기 때문입니다.
핵심 요약
LLM 기반 에이전트는 다중 단계 의사결정에 점점 더 활용되지만 미지의 환경으로의 전이가 좋지 않다. 기존 세계 모델 학습 방식은 미래 관찰을 예측하도록 훈련하지만 추가 학습 비용이 들고 예측 오류가 누적된다. 디지털 환경에서 작동하는 LLM 에이전트는 사전 훈련 과정에서 이미 상당한 세계 지식을 내재화하고 있어, 새로 습득하기보다 끌어내는 것이 핵심이다. 전체 요약 9문장 읽기 →