매일 쌓이는 개발자의 시야
2026년 10월 8일 (목). 세상의 기술 소식, 한국어로 한눈에.
AI 요약 안내 AI가 한국어로 정리한 내용입니다. 정확한 정보는 각 카드의 원문을 확인해 주세요.
요약 원칙 ↗ 01 읽을 소식Hacker News 30건 ↓ 02 써볼 도구GitHub Trending 5건 ↓ 03 읽을 논문Hugging Face Papers 45건 ↓ 04 새 버전GitHub Releases 10건 ↓ 오늘의 주요포인트 상위 6건
01 기타 18:25 게시
원제 Margaret Hamilton has died
1,461 포인트 댓글 161
Key Point 아폴로 달착륙을 가능하게 한 소프트웨어 엔지니어링의 개척자이자 현대 개발 관행의 기초를 마련한 인물의 업적과 삶을 정리한 추모 기사로, IT 역사에서의 그녀의 역할을 재조명한다.
핵심 요약
MIT에서 20년 이상 근무한 컴퓨터 과학자 마거릿 해밀턴이 9월 30일 90세로 별세했다. 해밀턴은 NASA 아폴로 프로그램의 온보드 비행 소프트웨어 개발팀을 이끌었으며, 130편 이상의 논문을 저술해 소프트웨어 엔지니어링을 독립적 학문으로 정립하는 데 기여했다. 1959년 MIT 기상부서에서 날씨 예측 소프트웨어로 경력을 시작했으며, 1961년 미국 최초 방어 시스템인 SAGE 프로젝트에 참여해 소프트웨어 신뢰성에 관심을 갖기 시작했다. 전체 요약 10문장 읽기 → 02 AI · 머신러닝 18:30 게시
원제 Claude Haiku 5.5
872 포인트 댓글 418
Key Point 소형 모델이 대폭 저렴해지면서 이전에는 비용상 불가능했던 요약, 분류, 에이전트 작업이 대규모로 가능해진다.
핵심 요약
Anthropic이 Claude Haiku 5.5를 발표했으며, 이는 지금까지 출시한 소형 모델 중 가장 저렴하고 빠르며 성능이 우수한 버전이다. Haiku 5.5는 요약·데이터 압축·데이터베이스 쿼리·분류 등 반복적인 고용량 작업을 위해 설계되었으며, Opus 5.5 및 Sonnet 5.5와 함께 하위 에이전트로도 사용 가능하다. Haiku 4.5 대비 평균 75% 저렴하며, 특히 10만 토큰 이하 요청(전체 요청의 90%)에 대해 90% 저렴해졌다. 전체 요약 13문장 읽기 → 03 웹 · 프론트엔드 18:30 게시
원제 Shipping JPEG XL in Chrome
548 포인트 댓글 362
Key Point 메모리 안전성과 성능을 모두 확보한 새 이미지 포맷이 Chrome에 정식 탑재됨으로써, 웹 개발자는 JPEG 대비 더 나은 압축률로 고화질 이미지를 제공할 수 있게 되었다.
핵심 요약
Chrome 155부터 JPEG XL(.jxl) 이미지 포맷의 디코딩을 지원한다. JPEG XL은 차세대 이미지 포맷으로 JPEG 대비 30~50% 더 나은 압축률, 무손실 압축, 내장 HDR 지원, 무손실 JPEG 변환 등을 제공한다. 고화질·무손실 압축이나 사진 이미지, 세밀한 점진적 디코딩이 필요한 경우에 유용하며, 개발자는 최적의 결과를 위해 AVIF와 JPEG XL을 모두 시도해볼 것을 권장한다. 전체 요약 10문장 읽기 → 04 기타 18:30 게시
원제 Visa, Mastercard, major banks facing new litigation over 'anticompetitive' fees
546 포인트 댓글 392
Key Point 신용카드 거래 수수료를 둘러싼 담합 혐의로 과거 합의 이후에도 계속 소송이 제기되는 상황이므로, 현재 판매자들이 직면한 실제 비용 구조와 법적 공백을 파악하는 데 필요합니다.
핵심 요약
샌디에이고 피자점이 Visa, Mastercard와 미국 주요 은행들(뱅크오브아메리카, 캐피탈원, 체이스, 시티뱅크, 웰스파고)을 상대로 신규 집단소송을 제기했다. 소송은 피고들이 수십 년간 신용카드 거래 수수료(교환 수수료)를 인위적으로 높이는 담합을 유지해왔다고 주장한다. 판매자들이 모든 Visa·Mastercard 카드를 무조건 수락하게 강제하고, 특정 카드에 대한 추가 요금 청구를 금지하는 등 '반경쟁적 규칙'으로 비용 회피를 차단했다는 취지다. 전체 요약 7문장 읽기 → 05 웹 · 프론트엔드 18:30 게시
원제 Show HN: Bigwords.page – Turn any screen into a sign. The URL is the app
499 포인트 댓글 139
Key Point 브라우저의 URL 프래그먼트 특성을 활용해 서버 인프라 없이도 공개·공유 가능한 풀스크린 디스플레이를 구현했으며, 로그인 없이 즉시 사용할 수 있다는 단순함이 특징이다.
핵심 요약
링크만으로 풀스크린 메시지, 타이머, 안내판을 만들 수 있는 웹 도구로, 계정 가입이나 서버 저장 없이 URL에 모든 정보를 담는다. 메시지는 # 뒤에, 스타일은 &key=value 형식으로 추가하며, %0A로 줄바꿈, ||로 슬라이드를 나눌 수 있다. 자동으로 글자 크기를 조정해 스마트폰부터 스타디움 전광판까지 모든 화면에 맞추고, 어떤 브라우저에서도 동작한다. 전체 요약 7문장 읽기 → 06 웹 · 프론트엔드 18:30 게시
원제 Animated ASCII Art for Web Pages
352 포인트 댓글 61
Key Point ASCII 아트를 코딩 없이 시각적으로 구성하고 웹에 바로 적용할 수 있는 점이 개발자와 창작자에게 새로운 가능성을 제시한다.
핵심 요약
ASCII 문자를 이용해 웹페이지에서 재생할 수 있는 애니메이션을 만드는 온라인 도구를 공개했다. 타일이나 객체를 배치하고 시간 및 반복 설정으로 애니메이션을 구성하는 방식이다. 제작한 ASCII 아트는 웹페이지에 임베드할 수 있으며, GitHub에서 오픈소스로 코드를 제공한다. 전체 요약 4문장 읽기 → 전체 색인24건 · 분야별
AI · 머신러닝10건 001 18:30 ▲ 102 · 댓글 59 LLM이 내 손목 질환을 완화했다 저자는 2017년부터 오랫동안 반복성 긴장 손상(RSI)으로 고생했으며, 특히 코드 작성 시 특수문자와 modifier 키를 많이 써야 해 손목을 자주 움직이며 악화됐다. AI · 머신러닝 · LLMs may have helped my RSI
Key Point 개발자의 반복 긴장 손상 같은 직업병을 완화할 수 있는 실질적 방법을 보여주며, AI 에이전트가 개발 방식을 바꿈으로써 신체 건강에도 긍정적 영향을 미칠 수 있음을 시사한다.
핵심 요약
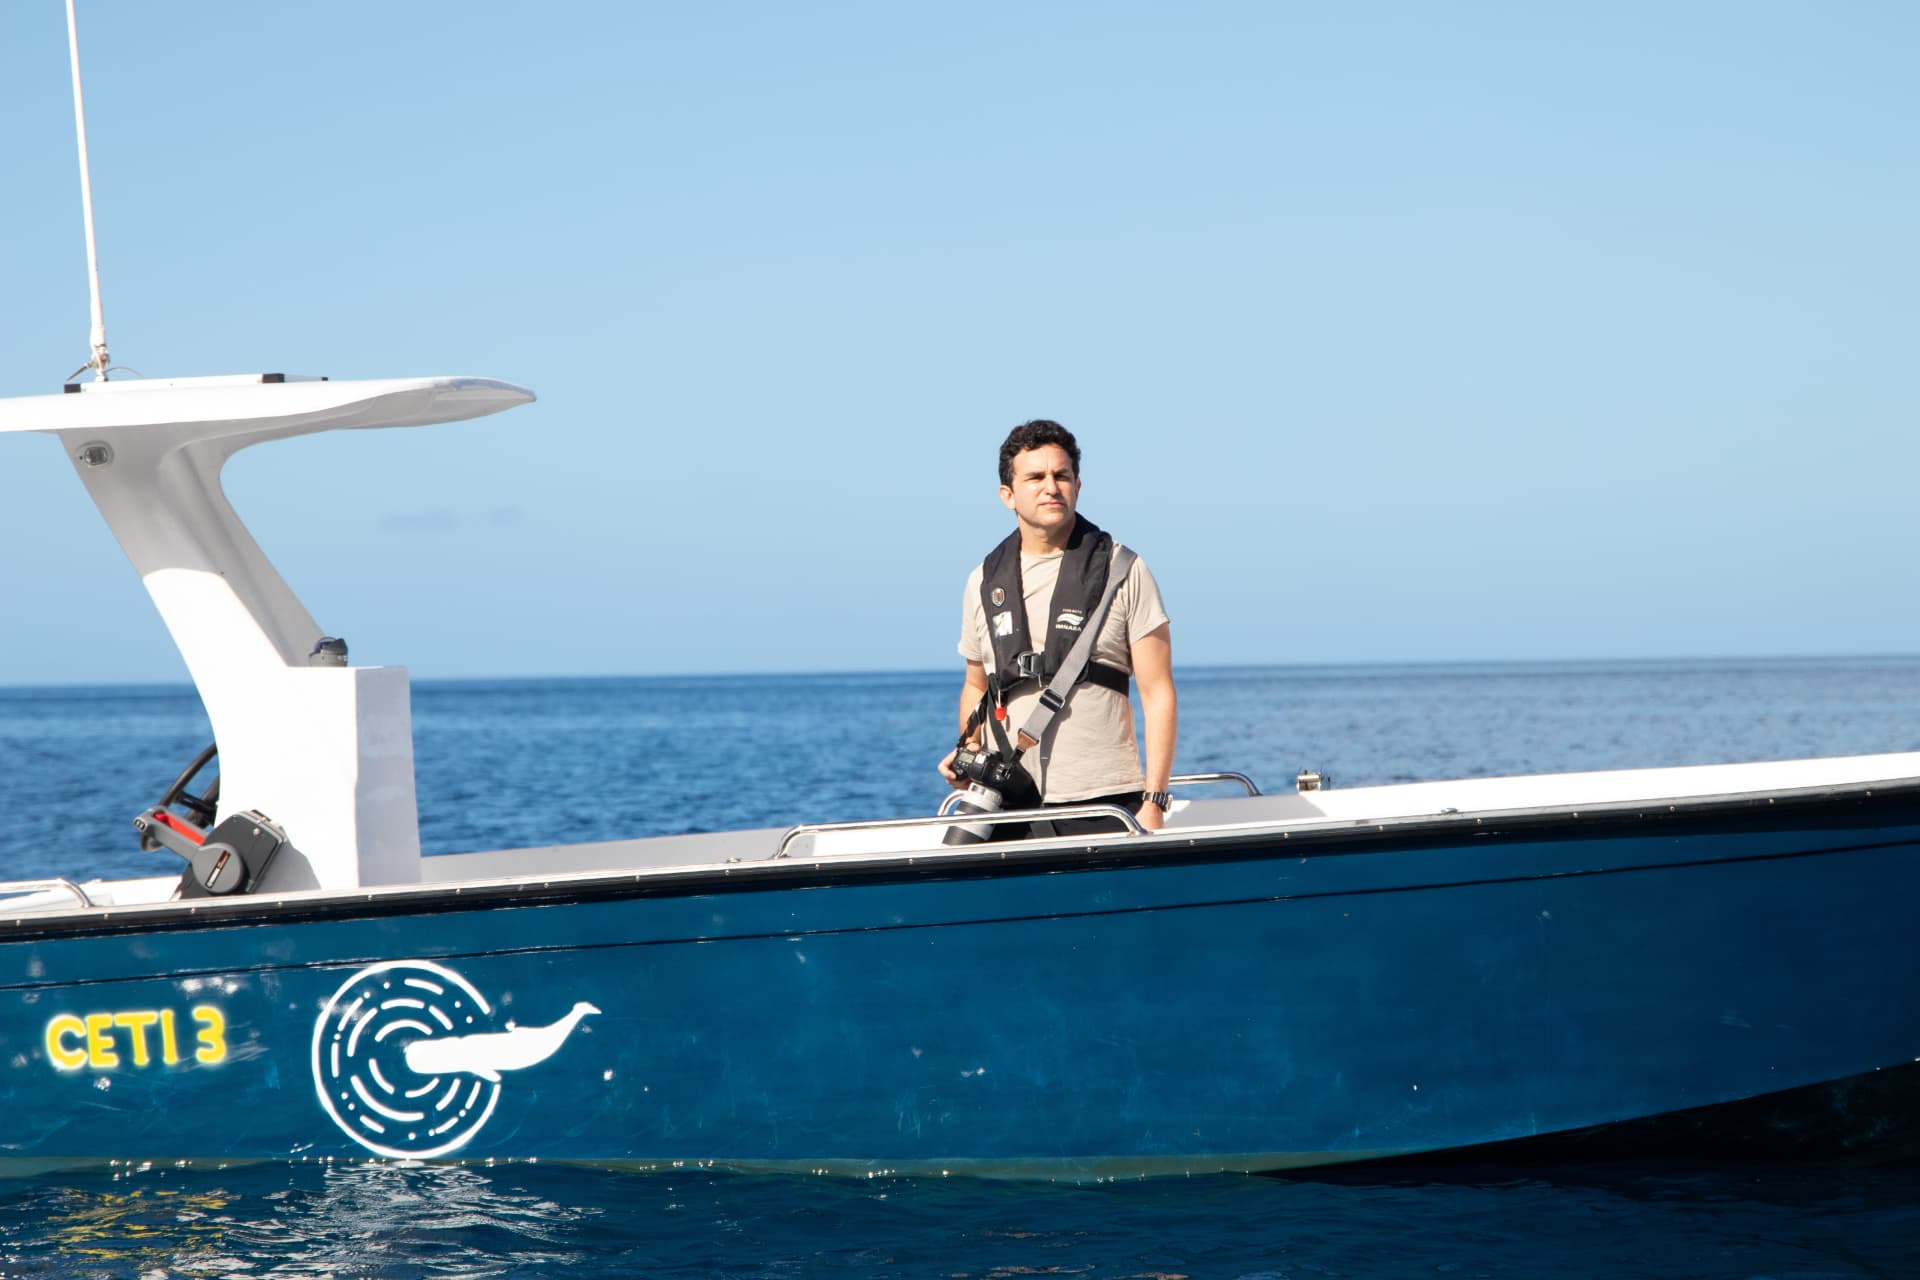
저자는 2017년부터 오랫동안 반복성 긴장 손상(RSI)으로 고생했으며, 특히 코드 작성 시 특수문자와 modifier 키를 많이 써야 해 손목을 자주 움직이며 악화됐다. 작은 손 때문에 Ctrl+5 같은 키 조합도 스트레칭이 필요했고, 운동, 휴식, 인체공학 자판 등 여러 방법을 시도해 월 0-2회 수준까지 통증을 줄였다. 2026년부터 LLM과 AI 에이전트가 많은 코드 작성을 대신하면서 상황이 바뀌었다. 전체 요약 8문장 읽기 → 002 18:30 ▲ 107 · 댓글 95 AI로 향고래의 울음소리를 해석한다 해양생물학자 데이비드 그루버는 프로젝트 CETI(Cetacean Translation Initiative)라는 인공지능 기반 연구를 통해 향고래의 의사소통을 해석하려고 한다. AI · 머신러닝 · Using A.I. to decode communication of sperm whales
Key Point 향고래의 울음 패턴을 AI로 분석해 의미를 찾으려는 시도로, 인간과 동물 간 실질적 소통이 가능할 수 있다는 과학적 탐구의 의미를 담고 있다.
핵심 요약
해양생물학자 데이비드 그루버는 프로젝트 CETI(Cetacean Translation Initiative)라는 인공지능 기반 연구를 통해 향고래의 의사소통을 해석하려고 한다. 어떤 사람들은 이를 현시대 가장 야심찬 과학 프로젝트로, 다른 사람들은 아름다운 허사로 본다. 그루버는 미시생물학, 생물해양학, 박테리아-원생동물 상호작용, 어류, 상어, 바다거북, 시각적 의사소통 등 다양한 분야를 거쳐 현재의 연구에 도달했다. 전체 요약 4문장 읽기 → 003 18:30 ▲ 296 · 댓글 56 생명의 거울상 선택 비결 밝힌 2026년 화학 노벨상 스웨덴 학술원은 프랑스의 앙리 카강(Université Paris-Sud)과 일본의 소아이 켄소(Tokyo University of Science)에게 2026년 화학 노벨상을 수여하기로 결정했다. AI · 머신러닝 · Nobel Prize in Chemistry 2026 to Henri B. Kagan and Kenso Soai
Key Point 생명체의 분자 비대칭성이라는 1세기 이상의 화학 수수께끼를 해결한 기초 발견이 제약 개발에 직접 적용되는 실질적 기여로 평가받았기 때문이다.
핵심 요약
스웨덴 학술원은 프랑스의 앙리 카강(Université Paris-Sud)과 일본의 소아이 켄소(Tokyo University of Science)에게 2026년 화학 노벨상을 수여하기로 결정했다. 수상 업적은 '비선형 효과와 자동촉매 현상을 비대칭 유기합성에 적용한 발견'이다. 생명체의 화학은 손처럼 거울상을 이루는 분자들 중 한쪽만 선택적으로 포함하는 '동일손성(homochirality)' 특징을 보여왔으나, 화학적으로는 거울상 쌍이 같은 비율로 생성되는 문제가 있었다. 전체 요약 6문장 읽기 → 004 18:30 ▲ 115 · 댓글 53 11개 정사각형 최적 배치 증명, AI 보조로 완성 Lean 형식 검증을 통해 11개 정사각형의 최적 배치 문제에 대한 완전한 증명을 완성했다. AI · 머신러닝 · AI-assisted proof of optimal packing for 11 squares
Key Point 최적화 문제의 엄밀한 증명에 AI 보조 도구와 형식 검증이 어떻게 결합되는지 보여주는 사례로, 수학적 추측을 기계 검증 가능한 형태로 변환하는 최신 방법론을 시연한다.
핵심 요약
Lean 형식 검증을 통해 11개 정사각형의 최적 배치 문제에 대한 완전한 증명을 완성했다. 7,920개 지역 Lean 모듈을 EvolvingPrograms 검증 시스템으로 검증했으며 모든 감사에서 오류가 0건이다. 최적 한 변의 길이는 T = (6u+4)/(1+2u-u²) 형태이며, u는 방정식 5u⁸-10u⁷-2u⁶+14u⁵+12u⁴-6u³+2u²+2u-1=0의 (9/25, 37/100) 범위 내 유일한 근이다. 전체 요약 8문장 읽기 → 005 18:30 ▲ 233 · 댓글 109 Docker, YAML로 AI 에이전트 만드는 도구 공개 Docker가 AI 에이전트를 선언형 YAML 설정으로 만들고 실행할 수 있는 Docker Agent를 공개했다. AI · 머신러닝 · Docker Agent
Key Point 멀티 에이전트 협업과 다양한 AI 모델을 YAML 하나로 관리하면서 패키징·배포할 수 있어, AI 에이전트 개발의 진입장벽을 크게 낮춘다.
핵심 요약
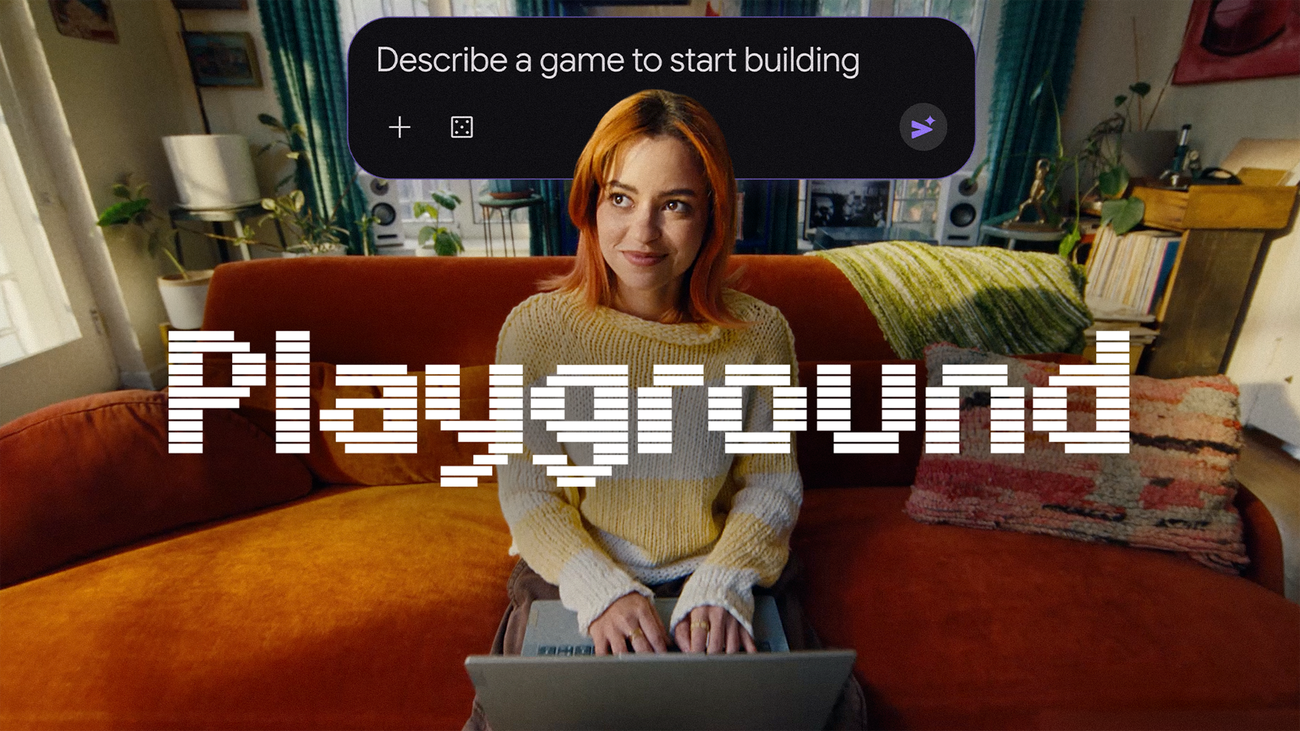
Docker가 AI 에이전트를 선언형 YAML 설정으로 만들고 실행할 수 있는 Docker Agent를 공개했다. Docker CLI 플러그인으로 제공되며 코드 작성 없이 에이전트 정의, 도구 할당, 실행이 가능하다. 여러 전문화된 에이전트가 작업을 자동으로 위임하는 멀티 에이전트 아키텍처를 지원한다. 전체 요약 11문장 읽기 → 006 18:30 ▲ 144 · 댓글 221 구글, 코딩 없이 게임 만드는 'Playground' 공개 구글이 AI 기반 게임 제작 플랫폼 'Playground'를 미국 18세 이상 사용자 대상으로 정식 출시했다. AI · 머신러닝 · Google Playground: Create and play custom games
Key Point 게임 개발의 진입장벽을 AI로 허물어 누구나 아이디어를 실제 게임으로 만들 수 있게 되는 기점이다.
핵심 요약
구글이 AI 기반 게임 제작 플랫폼 'Playground'를 미국 18세 이상 사용자 대상으로 정식 출시했다. 텍스트 프롬프트만으로 게임을 만들 수 있으며 코딩 경험이 없어도 처음부터 끝까지 창작 방향을 조종할 수 있다. 물리 엔진, 규칙, 캐릭터, 환경 등을 타이핑으로 수정하거나 기존 게임을 리믹스해 시작할 수 있다. 전체 요약 8문장 읽기 → 007 18:30 ▲ 228 · 댓글 257 OpenAI 372개 수학 난제 증명 발표, 수학계 흔들다 OpenAI가 어제 내부 모델로 증명한 372개 수학 미해결 문제를 공개했으며, 이 중 Subhash Khot의 Unique Games Conjecture(UGC)가 포함되었다. AI · 머신러닝 · The Mathocalypse
Key Point 인간이 평생 풀지 못한 수학 난제들이 AI에 의해 일괄 해결됨으로써 수학 연구의 근본적 변화가 시작되었고, 증명의 검증과 이해 과정에서 수학 커뮤니티가 직면한 새로운 도전을 보여준다.
핵심 요약
OpenAI가 어제 내부 모델로 증명한 372개 수학 미해결 문제를 공개했으며, 이 중 Subhash Khot의 Unique Games Conjecture(UGC)가 포함되었다. UGC 증명은 Lean 증명서를 갖추고 있지만 아직 인간이 전체 내용을 이해한 사람이 없으며, 논문이 이해하기 어렵게 쓰여 있어 AI 도움 없이는 읽을 수 없다고 보고되었다. Dana Moshkovitz(Scott의 아내, 복잡도 이론자)는 평생 증명하려던 문제가 로봇에 의해 해결되었으나, UGC가 참임이 증명되었다는 점에서 위안을 얻고 있다. 전체 요약 11문장 읽기 → 008 18:30 ▲ 304 · 댓글 186 AI 수학 증명 검증의 함정, 자동형식화는 신뢰할 수 없다 AI가 자연언어 수학 증명을 Lean 같은 형식 언어로 자동 번역하는 '자동형식화'가 수학 검증에 널리 쓰이고 있으며, OpenAI의 나비에-스토크스 방정식 해의 폭발성 증명도 이 방식으로 검증되었다. AI · 머신러닝 · Navier–Stokes Lost in Translation
Key Point AI가 수학 논문을 자동으로 검증하려는 시도가 이론적으로 불가능하다는 것을 보여주는 논문으로, OpenAI의 발표된 증명이 실제로는 원본과 다를 수 있음을 시사한다.
핵심 요약
AI가 자연언어 수학 증명을 Lean 같은 형식 언어로 자동 번역하는 '자동형식화'가 수학 검증에 널리 쓰이고 있으며, OpenAI의 나비에-스토크스 방정식 해의 폭발성 증명도 이 방식으로 검증되었다. 그러나 이 논문은 형식 언어로 검증된 증명이 원래 자연언어 증명의 정확성을 보장하지 않음을 보인다. 문제는 자연언어 수학 텍스트의 모호성을 해결하려면 의미론적으로 충실한 번역이 필수인데, 이 모호성 해결 문제가 계산 복잡도 계층(Solvability Complexity Index)에서 무한 수준(SCI = ∞)에 위치한다는 것이다. 전체 요약 6문장 읽기 → 009 18:30 ▲ 340 · 댓글 337 Meta·Microsoft, Claude 사용 제한하고 자체 AI 도구로 전환 Meta와 Microsoft가 직원의 Claude AI 사용을 단계적으로 줄이고 자체 개발 코딩 도구로 전환하기 시작했다. AI · 머신러닝 · Meta and Microsoft take steps to reduce employee usage of Claude AI
Key Point 두 대형 기업의 직원용 AI 도구 사용 제한이 시장에서 Anthropic의 지위 변화와 기업 AI 지출 전략 재편을 시사한다.
핵심 요약
Meta와 Microsoft가 직원의 Claude AI 사용을 단계적으로 줄이고 자체 개발 코딩 도구로 전환하기 시작했다. Microsoft는 Anthropic 기술에 연 10억 달러 이상 지출할 것으로 예상했으나, 직원 사용 제한 지시 후 지출이 3분의 1 이상 감소했다. Microsoft 클라우드·AI 부문의 직원당 월간 AI 지출 한도는 10만 달러에서 약 1만 달러로 대폭 삭감되었다. 전체 요약 8문장 읽기 → 010 18:30 ▲ 106 · 댓글 90 구글, 코딩 없이 게임 만드는 'Playground' 공개 구글이 Playground라는 실험적 게임 플랫폼을 출시했다. AI · 머신러닝 · Google Playground
Key Point AI를 활용한 게임 제작이 진입장벽을 낮추고 누구나 게임 크리에이터가 될 수 있는 새로운 가능성을 열고 있다.
핵심 요약
구글이 Playground라는 실험적 게임 플랫폼을 출시했다. 텍스트 프롬프트만으로 코딩 경험 없이 수 분 안에 커스텀 게임을 만들 수 있다. 채팅 기반 인터페이스를 통해 게임 개념을 시각화하고 구현할 수 있다. 전체 요약 7문장 읽기 → 기타6건 011 21:11 ▲ 171 · 댓글 66 15년을 검색해서 찾은 한곡의 밴드 2011년 우연히 들은 Salvage의 'Electric'과 'Searchlights' 두 곡은 전문적으로 제작된 고품질 스타디움 인디 록이었지만, 15년간 밴드의 정보를 전혀 찾을 수 없었다. 기타 · The 15-year search for a band that charted once and vanished
Key Point AI 검색 도구의 시대에도 인터넷에서 완전히 사라진 음악을 추적할 수 없었던 이유와, 여러 모델을 접목한 체계적 조사가 어떻게 마침내 실마리를 찾았는지 보여주는 구체적 검색 과정이 흥미롭다.
핵심 요약
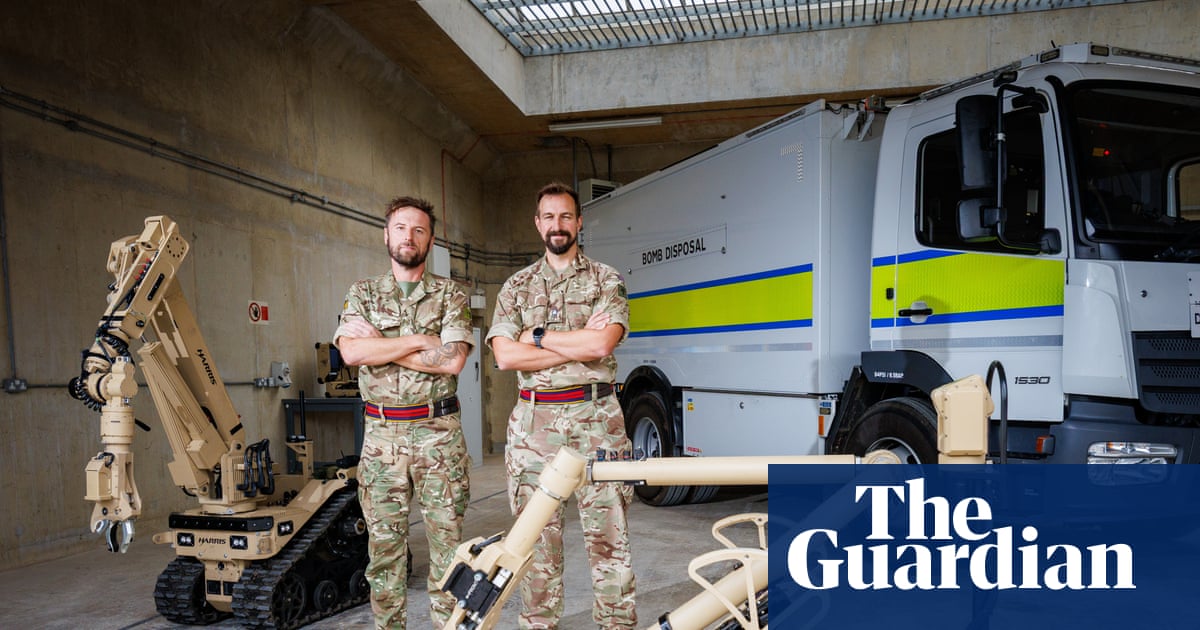
2011년 우연히 들은 Salvage의 'Electric'과 'Searchlights' 두 곡은 전문적으로 제작된 고품질 스타디움 인디 록이었지만, 15년간 밴드의 정보를 전혀 찾을 수 없었다. 초기에는 수동 검색으로 시도했고, 최근에는 AI 모델 여러 개를 활용해 메타데이터, 커버 아트, URL 등 수집한 모든 정보를 분석하게 했다. Official Charts 기록에서 2006년 6월 4-10주 독립 싱글 차트 47위 진입을 확인했고, Despatches라는 레이블에서 발매한 것을 알아냈다. 전체 요약 11문장 읽기 → 012 18:30 ▲ 127 · 댓글 98 80년 된 독일 폭탄 제거 작전, 2천 가구 피난 2026년 1월 14일 영국 데본주에서 2차 세계대전 독일 폭탄 2개가 같은 날 발견됐다: 플리머스 건설현장의 50kg 폭탄과 엑스머스 항구의 250kg 폭탄. 기타 · The art of defusing a second world war bomb
Key Point 80년 된 폭탄의 신관은 부식과 시간으로 언제 터질지 예측 불가능한데, 국가 인프라 건설이 늘면서 매년 수천 건의 미폭탄 처리가 불가피해졌다.
핵심 요약
2026년 1월 14일 영국 데본주에서 2차 세계대전 독일 폭탄 2개가 같은 날 발견됐다: 플리머스 건설현장의 50kg 폭탄과 엑스머스 항구의 250kg 폭탄. 전문 폭탄 제거팀은 폭탄의 신관(fuze)을 우선 점검한다. 신관에는 1940년대 작동하는 전기식도 있지만 기계식 지연작동 신관은 80년 경과해도 언제 터질지 예측 불가능하다. 제2차 세계대전 중 루프트바페는 영국에 6만 톤 폭탄을 투하했고 10개 중 1개가 미폭탄으로 남아 있다. 영국 군 폭탄 제거팀은 연간 2500건 중 2000건을 미폭탄 처리에 대응한다. 전체 요약 12문장 읽기 → 013 18:30 ▲ 145 · 댓글 29 증명 없이 정답만 던지던 수학 천재 'Cleo'의 정체 2013~2015년 스택 익스체인지 수학 포럼에서 Cleo라는 계정이 39개의 복잡한 적분 문제에 완벽한 답을 제시했지만 풀이 과정은 전혀 보여주지 않았다. 기타 · Cleo (Mathematician)
Key Point Stack Exchange에서 최고의 수학 천재로 추앙받던 정체 불명의 계정이 실은 우즈베키스탄 소프트웨어 개발자의 창작 페르소나였다는 온라인 미스터리의 전말을 한 번에 파악할 수 있습니다.
핵심 요약
2013~2015년 스택 익스체인지 수학 포럼에서 Cleo라는 계정이 39개의 복잡한 적분 문제에 완벽한 답을 제시했지만 풀이 과정은 전혀 보여주지 않았다. 첫 주목받은 것은 2013년 11월 Mathematica와 Maple도 풀지 못한 복잡한 적분을 4시간 반 만에 '황금비를 이용한 답'으로 제시했을 때였다. 수학 커뮤니티는 Cleo가 천재 수학자인지, 여러 사람의 집단 계정인지 논쟁했고, Terence Tao나 Maryam Mirzakhani 같은 유명 수학자가 아닐까 추측했다. 전체 요약 9문장 읽기 → 014 18:30 ▲ 184 · 댓글 28 4살 아들의 '목재 테이프' 쇼핑 여행 아버지는 아들 Guy(4살)가 하드웨어 스토어에서 '우드 테이프(wood tape)'를 사고 싶다는 말을 받고 일요일 오전 Home Depot을 방문한다. 기타 · Wood Tape (2004)
Key Point 4살 어린이의 예상을 뛰어넘는 체계적 설계와 의사소통 능력, 그리고 그걸 알아차리기까지의 부모의 성장 과정을 보여주는 감동적인 부자관계 기록이다.
핵심 요약
아버지는 아들 Guy(4살)가 하드웨어 스토어에서 '우드 테이프(wood tape)'를 사고 싶다는 말을 받고 일요일 오전 Home Depot을 방문한다. Guy는 직접 쇼핑 리스트를 만들어 'tape'만 적어 가져갔으나, 매장 직원들은 '나무 테이프'라는 개념을 이해하지 못해 혼란스러워한다. 아버지는 Guy가 주도적으로 쇼핑하도록 최소한의 개입만 하기로 결정하고, Guy는 직원들에게 직접 물어보며 페인트 코너에서 덕트 테이프를 찾는다. 전체 요약 8문장 읽기 → 015 18:30 ▲ 155 · 댓글 115 전 세계 절반이 소셜미디어가 민주주의 해친다고 본다 피유 리서치센터가 2026년 2월~5월 36개국 4만2151명을 대상으로 조사한 결과, 소셜미디어가 민주주의에 미치는 영향에 대해 국가마다 다른 인식을 보였다. 기타 · Across the Globe, People Increasingly Say Social Media Is Harming Democracy
Key Point 부자 나라에서는 소셜미디어 비판이 심화되는 반면, 전 세계적으로는 정보 접근과 민주 참여의 이점도 크다는 이중적 평가가 정책 입안자들에게 중요한 맥락을 제공한다.
핵심 요약
피유 리서치센터가 2026년 2월~5월 36개국 4만2151명을 대상으로 조사한 결과, 소셜미디어가 민주주의에 미치는 영향에 대해 국가마다 다른 인식을 보였다. 미국을 포함한 선진국에서는 부정적 평가가 높아서, 미국(64%), 독일(61%), 프랑스(65%), 네덜란드(70%)에서 절반 이상이 '나쁜 영향'이라고 답했다. 2022~2023년 대비 독일, 일본, 헝가리, 폴란드, 인도네시아, 네덜란드, 스웨덴 등에서 부정적 견해가 통계적으로 유의미하게 증가했다. 전체 요약 10문장 읽기 → 016 18:30 ▲ 156 · 댓글 255 19세기 영국 엘리트의 성공 비결, 공부 아닌 네트워킹? 19세기 영국 지배층은 현대의 성공 담론과 정반대의 삶을 살았다. 아침 일찍 일어나고 금욕적으로 사는 대신, 늦게까지 자고 술을 마시며 파티와 사냥, 드레스업을 즐겼다. 기타 · Why were Victorian elites so effective?
Key Point 현대의 성공 담론(STEM, 금욕주의, 과로)과 정반대로 성공한 역사적 사례는, 조직 리더십과 사회적 결집력을 위해서는 다른 우선순위가 필요할 수 있음을 시사한다.
핵심 요약
19세기 영국 지배층은 현대의 성공 담론과 정반대의 삶을 살았다. 아침 일찍 일어나고 금욕적으로 사는 대신, 늦게까지 자고 술을 마시며 파티와 사냥, 드레스업을 즐겼다. 그럼에도 당시 영국은 세계 최고의 부국이었고, 기업들은 국제 무역·금융을 지배했으며, 해군은 세계 해양을 제어했다. 거대한 제국을 유지하면서 대륙 유럽의 혁명과 내전을 피하고 민주화를 추진했다. 이 성공이 산업혁명의 부산물인지, 아니면 엘리트의 전략적 능력 때문인지는 검증 불가능하지만, 소프트 스킬과 네트워킹에 중점을 둔 교육 시스템이 실제로 효과적이었을 가능성을 탐색해볼 수 있다. 전체 요약 12문장 읽기 → 오픈소스 · 도구3건 017 18:30 ▲ 114 · 댓글 30 Rust의 derive, 의도하지 않은 inline까지 발생 Rust에서 Debug, Clone 같은 트레이트를 #[derive(...)]로 구현하면 컴파일러가 자동으로 #[inline] 힌트를 추가한다. 오픈소스 · 도구 · Rust's derive often implies inline
Key Point derive 매크로가 자동으로 추가하는 inline이 복잡한 타입에서는 바이너리 크기를 크게 증가시킬 수 있어, 최적화 가정을 다시 생각해야 할 필요가 있다.
핵심 요약
Rust에서 Debug, Clone 같은 트레이트를 #[derive(...)]로 구현하면 컴파일러가 자동으로 #[inline] 힌트를 추가한다. 이는 명시적으로 보장되지 않지만 공식 레퍼런스에서 예시로 나타나고 매크로 전개로도 확인할 수 있다. 대부분의 경우 inline이 유리한데, 파생된 Debug나 Clone 구현은 일반적으로 간단해서 인라인 최적화의 이점을 본다. 전체 요약 7문장 읽기 → 018 18:30 ▲ 200 · 댓글 57 해상 생활하는 개발자 커플, 10년 항해 일지와 도구·언어 프로젝트 공개 Hundred Rabbits는 배 위에서 사는 개발자 부부 Devine과 Rek이 운영하는 프로젝트 포럼으로, 매달 새로운 소프트웨어, 게임, 언어 개발을 기록하고 있다. 오픈소스 · 도구 · Living off-grid: Hundred Rabbits
Key Point 배 위에서 인터넷 불안정성을 견뎌내며 10년간 자체 개발 도구와 언어 생태계를 구축해온 개발자들의 실제 사례는, 중앙화된 플랫폼과 기존 소프트웨어에 의존하지 않는 독립적인 기술 실천이 구체적으로 어떻게 가능한지 보여준다.
핵심 요약
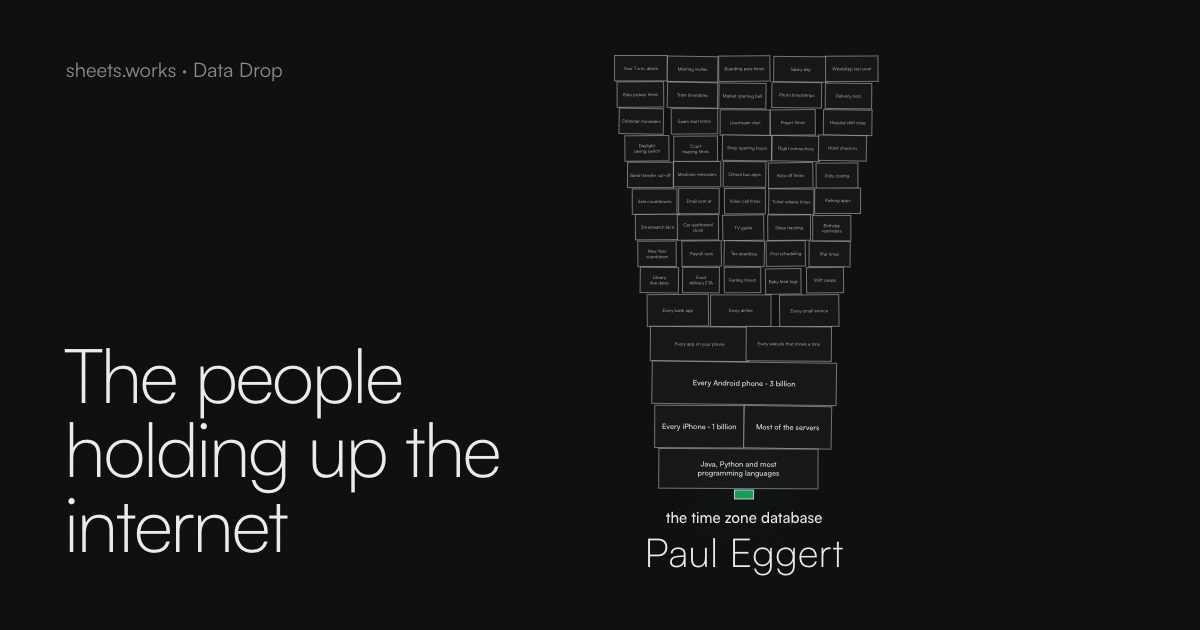
Hundred Rabbits는 배 위에서 사는 개발자 부부 Devine과 Rek이 운영하는 프로젝트 포럼으로, 매달 새로운 소프트웨어, 게임, 언어 개발을 기록하고 있다. 올해 주요 작업은 카드게임 Donsol의 새 버전 출시(애니메이션 스프라이트, 인게임 매뉴얼 포함), Uxn 에뮬레이터 개선, 벡터 렌더러 구현으로 타이포그래피 기능 확대 등이다. Uxntal이라는 16비트 어셈블리 언어로 작성한 포인트 앤 클릭 게임 Lepore Express Line을 Catjam 2026 게임잼에서 발표했다. 전체 요약 13문장 읽기 → 019 18:30 ▲ 118 · 댓글 50 몇십 명이 인터넷 기반을 떠받치고 있다 안드로이드, iOS, Windows 등 수십억 대 기기가 의존하는 핵심 오픈소스 23개 프로젝트의 유지보수 현황을 분석했다. 오픈소스 · 도구 · The people holding up the internet
Key Point 인터넷을 구성하는 핵심 소프트웨어 대부분이 1~2명의 무보수 개발자에 의존하고 있으며, 일부는 멘탈 헬스 문제나 자금 부족으로 위험에 처해 있다.
핵심 요약
안드로이드, iOS, Windows 등 수십억 대 기기가 의존하는 핵심 오픈소스 23개 프로젝트의 유지보수 현황을 분석했다. 시간대 데이터 파일은 UCLA 교수 Paul Eggert가 2012년부터 운영하며 지난 1년간 251개 변경 중 218개를 혼자 담당했다. 리눅스 서버와 iPhone에 탑재된 압축 도구 xz는 핀란드의 Lasse Collin이 운영하다가, 2024년 악의적 기여자 Jia Tan이 몰래 백도어를 삽입한 사건이 발생했다. 전체 요약 14문장 읽기 → 웹 · 프론트엔드3건 020 18:30 ▲ 146 · 댓글 66 조건은 위로, 반복은 아래로: 코드 최적화의 대수학적 기초 '조건을 위로, 반복을 아래로'는 프로그래밍 휴리스틱으로, 조건 분기는 호출자 쪽으로 올리고 반복 루프는 배치 처리 쪽으로 내려 명확성과 성능을 높인다. 웹 · 프론트엔드 · Push ifs up and fors down: The idiom, its algebra, and its limits
Key Point 코드의 데이터 흐름과 제어 흐름을 재배열하는 원칙이 단순 휴리스틱을 넘어 범주 이론, 함수형 프로그래밍, 데이터베이스 최적화에 일관되게 적용되는 대수학적 법칙임을 보여주므로, 어디까지 안전하게 리팩토링할 수 있는지 정확히 판단할 근거를 제공한다.
핵심 요약
'조건을 위로, 반복을 아래로'는 프로그래밍 휴리스틱으로, 조건 분기는 호출자 쪽으로 올리고 반복 루프는 배치 처리 쪽으로 내려 명확성과 성능을 높인다. 함수가 입력에 따라 분기한다면 그 분기를 호출자로 옮기는 식으로, Option 대신 Walrus 타입을 받아 선택 사항을 타입으로 표현한다. 반복 최적화는 개별 호출 대신 배치 함수를 제공해 핫 루프를 분기 없이 실행하고 벡터화의 후보가 되도록 한다. 전체 요약 10문장 읽기 → 021 18:30 ▲ 195 · 댓글 104 PSP 게임을 웹어셈블리로 변환해 브라우저에서 실행 PSP 게임의 MIPS 머신 코드를 사전에 C++로 변환한 후 웹어셈블리로 컴파일하고, PSP 운영체제와 그래픽 칩을 웹GL2로 구현한 환경에서 브라우저에서 실행하는 기술이다. 웹 · 프론트엔드 · God of War on PSP, recompiled to WebAssembly and running in the browser
Key Point PSP 게임을 에뮬레이터 없이 브라우저에서 실행 가능하게 하는 재컴파일 기술의 구현 방식과 최적화 과정을 보여주며, 향후 다양한 레트로 게임의 웹 이식 가능성을 시사한다.
핵심 요약
PSP 게임의 MIPS 머신 코드를 사전에 C++로 변환한 후 웹어셈블리로 컴파일하고, PSP 운영체제와 그래픽 칩을 웹GL2로 구현한 환경에서 브라우저에서 실행하는 기술이다. 첫 번째 타이틀 '갓 오브 워: 체인 오브 올림푸스'는 부팅부터 메뉴, 컷신, 전투까지 노트북에서 Chrome과 Firefox로 초당 60프레임으로 구동되며, PSP 해상도의 최대 4배인 1440×816에서 실행되고 휴대폰 터치 제어도 지원한다. 음악, 음성, 효과음은 작동하며 영화는 현재 스킵된다. 전체 요약 16문장 읽기 → 022 18:30 ▲ 275 · 댓글 139 개발자 블로그 글쓰기, 흔한 실수들 소프트웨어 개발에서 안티패턴을 정리하듯이, 블로그 작성의 흔한 실수들을 체계화했다. 웹 · 프론트엔드 · Anti-patterns in software blogging
Key Point 독자 중 25~35%가 휴대폰으로 접속하는 환경에서, 글 구조부터 렌더링까지 체계적인 점검 목록이 됩니다.
핵심 요약
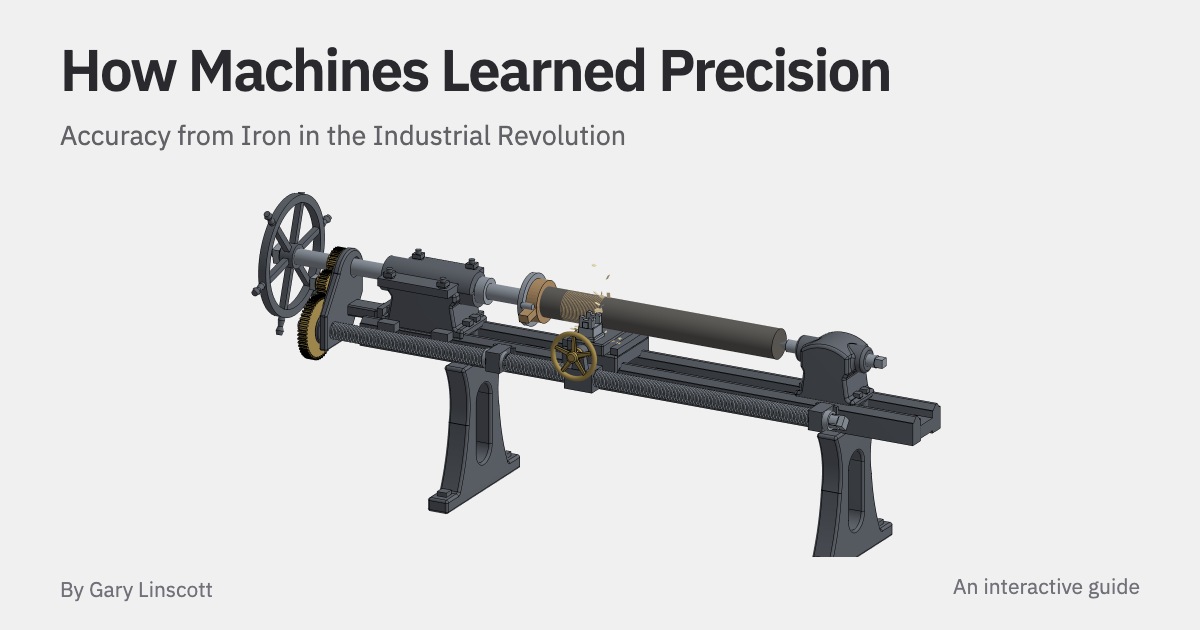
소프트웨어 개발에서 안티패턴을 정리하듯이, 블로그 작성의 흔한 실수들을 체계화했다. 첫 번째 실수는 '장황한 도입부'로, 독자들이 글을 읽은 후 수 문단이 지나도 글의 핵심을 모르는 경우다. 제목과 처음 3문장 안에 '이 글이 나를 위한 건가', '뭘 얻을 수 있나' 두 질문에 답해야 한다. 두 번째는 '부제, 저자 소개, 인용문' 등 서문이 지나친 경우로, 이는 독자의 집중력을 낭비하는 행위다. 전체 요약 9문장 읽기 → 하드웨어 · 시스템2건 023 18:30 ▲ 163 · 댓글 63 정밀 기계의 탄생, 17개 구간으로 보는 산업 정밀도 혁명 1770년대 산업 혁명 초기, 실린더나 나선을 정밀하게 깎을 수 없어 피스톤이 새고 축이 흔들리는 문제가 심각했다. 하드웨어 · 시스템 · How machines learned precision
Key Point 산업 혁명 초반 기계 정밀도의 치명적 부족에서 시작해, 평면 기준 만들기·나선 가공·정밀 측정 등 각 단계별 혁신이 어떻게 상호작용하며 진보했는지 추적하는 글로, 현대 정밀 공학의 기초가 기계적 창의와 반복 개선의 결과임을 보여준다.
핵심 요약
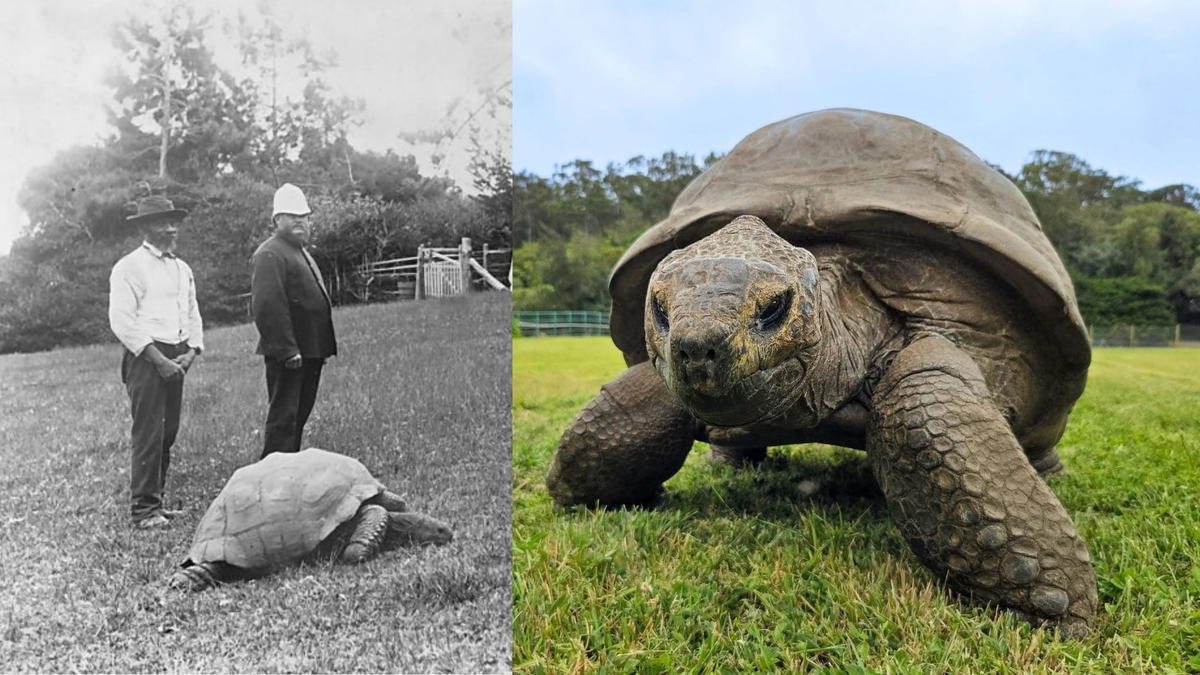
1770년대 산업 혁명 초기, 실린더나 나선을 정밀하게 깎을 수 없어 피스톤이 새고 축이 흔들리는 문제가 심각했다. 존 윌킨슨(John Wilkinson)은 1775년경 양쪽 끝에서 지지하는 보링 밀(boring mill)을 고안해 구부러진 주조품을 곧게 뚫 수 있었으며, 1776년에는 반인치 실린더를 동전 두께(약 1mm) 정도의 정확도로 가공했다. 헨리 모즐리(Henry Maudslay)는 1790년대 주조 철을 견디는 견고한 슬라이드 레스트를 만들어 선반 진동을 없애고, 손으로 깎는 방식을 기계로 대체했다. 전체 요약 12문장 읽기 → 024 18:30 ▲ 146 · 댓글 68 194세 거북이 조나단, 장수의 비결 유전체에서 찾다 지구상 가장 오래 산 육지동물인 알다브라 자이언트 거북이 조나단은 현재 약 194세로, 1832년경 세이셸에서 부화해 1880년대 영국 식민지 총독의 선물로 세인트헬레나 섬에 옮겨져 그곳에서 계속 살고 있다. 하드웨어 · 시스템 · 'Jonathan' is the oldest land animal on Earth
Key Point 수명 관련 유전자 변이의 발견은 인간의 수명 연장 연구에 직접 응용될 가능성을 시사하며, 동물 생물학 분야에서 가능한 분석의 범위를 크게 확장한 사례를 보여준다.
핵심 요약
지구상 가장 오래 산 육지동물인 알다브라 자이언트 거북이 조나단은 현재 약 194세로, 1832년경 세이셸에서 부화해 1880년대 영국 식민지 총독의 선물로 세인트헬레나 섬에 옮겨져 그곳에서 계속 살고 있다. 과학자들이 조나단의 유전체를 처음 분석한 결과를 사이언스 어드밴시스에 발표했으며, 뺨 면봉을 통해 DNA를 채취했다. 분석 결과 조나단은 DNA 수리, 인슐린 조절, 미토콘드리아 기능 등 대부분의 노화 경로에서 독특한 유전자 변이를 보유하고 있었다. 전체 요약 7문장 읽기 → 오늘의 주요당일 스타 상위 4건
01 AI · 머신러닝 18:30 게시
xerj-org/xerj
원제 xerj-org/xerj
스타 12,955 당일 +770 Rust
Key Point 에이전트의 토큰 낭비를 줄이는 로컬 검색 엔진으로, grep 대비 2.7배의 토큰 절감을 실측으로 증명한 도구가 오픈소스로 공개되었으며 AI 개발 워크플로우의 효율성을 크게 바꿀 가능성이 있다.
핵심 요약
XERJ는 Rust로 작성된 로컬 AI 검색 엔진으로, 폴더를 자동으로 인덱싱해 코드·문서·로그·PDF 등을 검색·RAG·보안 감사·에이전트 메모리용으로 사용할 수 있다. 기존 grep/sed 대비 40배 적은 토큰으로 데이터를 인덱싱하며, Elasticsearch 호환 API를 제공해 기존 클라이언트와 도구가 그대로 작동한다. 참고 코딩(reference coding) 사용 사례에서 실측한 결과, grep 기반 에이전트 대비 출력 토큰 2.7배 감소, 메모리만 사용할 때 대비 26배 감소를 달성했고 현장 보고에서는 약 5배의 토큰 절감이 보고된다. 전체 요약 12문장 읽기 → 02 오픈소스 · 도구 18:30 게시
fabio-rovai/open-ontologies
원제 fabio-rovai/open-ontologies
스타 1,855 당일 +343 Rust
Key Point 온톨로지 변경의 모든 결과를 사전에 확인하고, 누구나 검증할 수 있는 증명을 함께 제공함으로써 프로덕션 환경에서의 신뢰성 문제를 근본적으로 해결하는 접근 방식이다.
핵심 요약
프로덕션 온톨로지 변경을 계획·적용·롤백할 수 있으며, 영향 범위 보고서와 감사자가 검증 가능한 증명을 제공하는 Rust 기반 도구다. 한 줄의 삼중항(triple) 변경이 901개의 새로운 결과를 만드는 경우, 텍스트 diff로는 볼 수 없는 의미론적 차이를 드러내는 형태 diff(shape diff) 보고서를 생성한다. 도구가 생성한 증명 파일(asserted.tsv, derivations.tsv)은 Lean 4 검증기로 검수할 수 있으며, 검증 명령어 oo-cert는 JVM 없이 독립적으로 실행 가능하다. 전체 요약 12문장 읽기 → 03 AI · 머신러닝 18:30 게시
directus/directus
원제 directus/directus
스타 38,262 당일 +152 TypeScript
Key Point AI 에이전트와 인간이 동일한 권한 정책 하에서 데이터에 접근하는 방식이 주목되며, MCP 서버를 통해 ChatGPT·Claude 같은 LLM 도구와 직접 연동되는 새로운 백엔드 아키텍처를 보여준다.
핵심 요약
Directus는 PostgreSQL, MySQL, MariaDB, MS SQL, SQLite 등 임의의 SQL 데이터베이스를 REST와 GraphQL API로 감싸주는 오픈소스 백엔드 플랫폼이다. 데이터베이스 스키마에서 자동 생성된 API와 함께, 비개발자를 위한 시각적 관리 스튜디오를 제공한다. Claude, Cursor, ChatGPT 등 MCP 호환 도구가 직접 데이터에 접근할 수 있는 네이티브 MCP 서버를 내장하고 있다. 전체 요약 8문장 읽기 → 04 오픈소스 · 도구 18:30 게시
icsharpcode/ILSpy
원제 icsharpcode/ILSpy
스타 26,400 당일 +110 C#
Key Point Windows나 Linux에서 .NET 애플리케이션의 소스 코드를 원본이 없어도 복원할 수 있는 공식 도구이며, 개발자가 타사 라이브러리 동작을 분석하거나 릴리스된 제품의 구조를 파악해야 할 때 필수적이다.
핵심 요약
ILSpy는 .NET 어셈블리를 분석하고 C#으로 디컴파일하는 오픈소스 도구로, Windows·Linux·macOS를 지원하는 Avalonia 기반 데스크톱 UI를 제공한다. Visual Studio 2022/2026, VS Code, dotnet CLI 도구(ILSpyCmd), PowerShell 확장 등 다양한 프런트엔드로 사용할 수 있으며, NuGet 패키지와 PowerShell cmdlet으로도 제공된다. C# 디컴파일, 프로젝트 전체 분석, NuGet 피드·실행 중인 프로세스·GAC에서 직접 열기, 타입·메서드·속성 검색, ReadyToRun 바이너리 지원 등의 기능을 갖추고 있다. 전체 요약 6문장 읽기 → 전체 색인1건 · 분야별
오픈소스 · 도구1건 001 18:30 당일 +103 Unity IL2CPP 바이너리를 원본 C# 코드로 역변환하는 도구 Cpp2IL Unity의 IL2CPP 컴파일 과정을 역으로 분석해 원본 관리 DLL로 복원하는 진행 중인 도구로, LibCpp2IL 라이브러리를 사용해 메타데이터를 파싱합니다. 오픈소스 · 도구 · SamboyCoding/Cpp2IL · C#
Key Point IL2CPP 보호 게임의 소스코드 복원이 필요한 모더·보안 연구자·분석가에게 필수적인 역공학 도구이며, 주요 라이브러리 교체와 플러그인 시스템 도입으로 대폭 개선되고 있습니다.
핵심 요약
Unity의 IL2CPP 컴파일 과정을 역으로 분석해 원본 관리 DLL로 복원하는 진행 중인 도구로, LibCpp2IL 라이브러리를 사용해 메타데이터를 파싱합니다. 디컴파일된 CIL은 현재 상태가 복잡하지만 ILSpy로 열 수 있으며, MethodAnalysisContext를 통해 플랫폼별 어셈블리를 중간 표현(ISIL)으로 변환 후 제어 흐름 그래프를 구축해 분석합니다. 개발 브랜치에서 대규모 리작성 중이며, 기존의 많은 커맨드라인 옵션(--analysis-level, --skip-analysis 등)이 제거되고 출력 포맷과 처리 레이어 개념으로 단순화됐습니다. 전체 요약 12문장 읽기 → 읽을 논문
Hugging Face Papers45 커뮤니티가 고른 오늘의 AI 논문
오늘의 주요추천 상위 3건
01 AI · 머신러닝 18:30 게시
원제 STEPQuant: When and Where Errors Matter in Delta-Rule Recurrent State Quantization
추천 106 댓글 2 Bingchen Yao, Haobo Xu, Haokun Lin 외
Key Point 선형 어텐션 모델의 메모리 병목인 재현 상태 양자화에서 시간과 공간 차원의 오류 영향을 고려한 첫 접근으로, 실제 배포 환경에서 메모리 사용량을 획기적으로 줄일 수 있다.
핵심 요약
Linear attention은 KV 캐시 대신 고정 크기의 재현 상태를 사용하지만, 이 상태들이 메모리 병목이 되고 있다. 재현 상태를 저정밀도로 양자화하면 양자화 오류가 상태 업데이트 과정에서 누적되어 정확도가 크게 떨어진다. 연구진은 오류 영향이 두 가지 차원에 따라 달라짐을 발견했다: 시간적으로 오래된 메모리의 오류는 여러 디코딩 스텝에 걸쳐 지속되고, 공간적으로 서로 다른 키 행의 오류는 모델 출력에 미치는 영향이 다르며 상태 크기도 행과 열에 따라 변한다. 전체 요약 7문장 읽기 → 02 AI · 머신러닝 18:30 게시
원제 Long-WAM: Scaling the Context of World-Action Models
추천 94 댓글 2 Wei Huang, Bohan Zhang, Chenzhi Liu 외
Key Point 로봇 제어에서 짧은 지연(107ms)로 19초 영상 메모리를 활용하면서 복잡한 조작 작업에서 대폭 높은 성공률을 달성한 실시간 배포 기술이기 때문이다.
핵심 요약
로봇의 실시간 제어에는 충분한 영상 히스토리가 필요하지만, 이를 처리하는 과정에서 지연이 발생한다. Long-WAM은 실시간 제어 제약 속에서 인과적 세계-행동 모델의 맥락을 확장하기 위한 모델-시스템 프레임워크이다. 핵심 발견: 긴 히스토리에 접근하는 것과 실제로 사용하는 것은 다르며, 비디오 기초 모델이 자기회귀(AR) 방식으로 사전학습될 때 더 큰 이득이 난다. 전체 요약 12문장 읽기 → 03 AI · 머신러닝 18:30 게시
원제 UltraText Bench: A Comprehensive Bilingual Benchmark for Evaluating Visual Text Rendering in Image Generation
추천 86 댓글 2 Deyuan Liu, Yihao Hu, Jingxuan Zhang 외
Key Point 이미지 생성 모델의 텍스트 렌더링 성능을 체계적으로 비교할 수 있는 한영중 벤치마크가 공개되어, 텍스트가 많은 이미지 생성 작업에서 모델을 평가하고 선택할 기준이 생겼다.
핵심 요약
이미지 생성 모델이 여러 영역에 정확하게 배치된 긴 텍스트를 렌더링하는 능력을 평가하기 위해 UltraText Bench 벤치마크를 소개한다. 벤치마크는 432개 프롬프트로 구성되며, 24개 실제 장면 카테고리와 3가지 난이도 수준을 포함하고 영문과 중문을 동등하게 분배했다. 각 프롬프트는 인간이 검수했으며 4개~12개 텍스트 영역의 정확한 문자열과 콘텐츠·배치·시각적 속성의 구조화된 참조값을 제공한다. 전체 요약 7문장 읽기 → 전체 색인42건 · 분야별
AI · 머신러닝42건 001 21:11 ▲ 20 · 댓글 2 카메라 기하학 조건으로 다중 시점 이미지 합성 3배 가속 소수의 2D 이미지로부터 3D 콘텐츠를 생성하는 '희소 시점 신규 시점 합성' 문제를 해결하는 NAMVIS 프레임워크를 제안했다. AI · 머신러닝 · NAMVIS: Next-Scale Autoregressive Multi-View Image Synthesis
Key Point 3D 콘텐츠 제작에 필수적인 다중 시점 생성을 기존 방식보다 3배 빠르고 더 정확하게 처리하는 기술이 등장했기 때문이다.
핵심 요약
소수의 2D 이미지로부터 3D 콘텐츠를 생성하는 '희소 시점 신규 시점 합성' 문제를 해결하는 NAMVIS 프레임워크를 제안했다. 기존 확산 모델의 반복적 잡음 제거 대신, 이산 시각 토큰을 단계별로 예측하고 모든 토큰을 병렬로 샘플링하는 자동회귀 방식을 사용한다. 멀티스케일 프로젝티브 포즈 인코딩이라는 기법으로 소스·타겟 카메라의 기하학적 변환 정보를 모든 해상도의 셀프-어텐션과 크로스-어텐션에 주입한다. 전체 요약 6문장 읽기 → 002 18:30 ▲ 13 · 댓글 2 조 매개변수 모델도 3분 안에 동기화, NeMo-DCR 논문 발표 에이전트형 강화학습에서 정책 업데이트 후 롤아웃 클러스터로 전송하는 1조 개 매개변수 체크포인트가 현재 87.5분이 걸린다. AI · 머신러닝 · NeMo-DCR: Bit-Exact Delta-Compressed Refit for Scalable Agentic RL at Trillion-Parameter Scale
Key Point 조 개 매개변수 모델의 정책 리핏 시간을 87분에서 2~3분으로 단축하는 기술로, 대규모 에이전트형 강화학습의 실제 운영 가능성을 크게 높인다.
핵심 요약
에이전트형 강화학습에서 정책 업데이트 후 롤아웃 클러스터로 전송하는 1조 개 매개변수 체크포인트가 현재 87.5분이 걸린다. 매개변수 수정(refit) 시 BF16 학습에서 단계당 약 1%의 가중치만 변한다는 측정을 기반으로, NeMo-DCR은 변경값만 전송하면서 비트 단위로 정확히 일치하는 결과를 보장한다. 학습 샤드에서의 변경을 고정 아핀 매핑으로 체크포인트의 정규 좌표계로 투영하고, 잔여 변환으로 나머지를 처리하며, 수신 런타임의 기본 로더가 모든 변경을 저장소에 배치한다. 전체 요약 6문장 읽기 → 003 18:30 ▲ 12 · 댓글 2 세계모델의 핵심 정보를 압축 저장하는 ALeWM 기법 JEPA 기반의 세계모델인 ALeWM(Adaptive LeWorldModel)을 제안한 논문으로, 넓은 잠재공간의 앞부분에 예측에 필요한 정보를 집중시키는 방식을 소개한다. AI · 머신러닝 · Adaptive Latent Capacity for World Models
Key Point 예측 불필요한 정보를 제거하고 필요한 정보만 압축 저장함으로써 세계모델의 효율성과 계획 능력을 동시에 높이는 방법을 제시한다.
핵심 요약
JEPA 기반의 세계모델인 ALeWM(Adaptive LeWorldModel)을 제안한 논문으로, 넓은 잠재공간의 앞부분에 예측에 필요한 정보를 집중시키는 방식을 소개한다. ALeWM은 접두사(prefix) 길이에 대한 수열 조건부 분포를 학습하고, 샘플링된 입력 접두사로부터 다음 임베딩 전체를 추정하도록 예측기를 훈련한다. 기존 붕괴 방지 목적함수들은 잠재 좌표 전체에 걸친 변동만 유도하고 예측 중요도에 따라 정렬하지 않는 문제를 해결하기 위해, MixSIGReg이라는 새로운 정규화 기법을 도입했다. 전체 요약 7문장 읽기 → 004 18:30 ▲ 16 · 댓글 2 LLM 추론 최적화를 사용자 맞춤형으로, PersonTTS 제안 LLM의 테스트 타임 스케일링(TTS)은 추가 추론 계산을 할당해 추론 능력을 개선하지만, 기존 방식들은 정확도-비용 또는 정확도-지연시간 중 하나의 파레토 경계만 최적화한다. AI · 머신러닝 · From Pareto to Preference: Personalized Test-Time Scaling via Amortized Agentic Policy Discovery
Key Point LLM 추론 과정을 다양한 사용자 요구(정확도·비용·속도)에 맞춰 최적화하는 문제를 처음 체계적으로 정식화하고, 이전 탐색 경험을 재사용해 계산 효율까지 확보하는 실용적 방법을 제시했다.
핵심 요약
LLM의 테스트 타임 스케일링(TTS)은 추가 추론 계산을 할당해 추론 능력을 개선하지만, 기존 방식들은 정확도-비용 또는 정확도-지연시간 중 하나의 파레토 경계만 최적화한다. 사용자 요구는 다차원적이다: 정확도, 지연시간, 추론 비용을 동시에 명시할 수 있으며, 서로 다른 요구는 다른 컨트롤러를 필요로 한다. PersonTTS는 사용자별 요구사항을 최대한 만족시키는 실행 가능한 컨트롤러를 발견하는 스케줄링 문제로 정식화한다. 전체 요약 7문장 읽기 → 005 18:30 ▲ 12 · 댓글 2 LLM 추론 학습에 근거 정보를 선택적으로 활용하기 정책 강화학습으로 대형언어모델의 추론 능력을 높이려는 시도가 늘고 있으나, 어려운 문제에서 올바른 궤적을 발견하지 못할 때 보상 신호가 드물어서 학습이 정체하는 문제가 있다. AI · 머신러닝 · Rationale-Guided Policy Optimization: Learning to Reason with Adaptive Rationale Scaffolding
Key Point LLM을 정책 강화학습으로 훈련할 때 나타나는 보상 희소성 문제를 근거 정보로 해결하는 새로운 접근법으로, 추론 능력 향상에 실질적 효과를 보인다.
핵심 요약
정책 강화학습으로 대형언어모델의 추론 능력을 높이려는 시도가 늘고 있으나, 어려운 문제에서 올바른 궤적을 발견하지 못할 때 보상 신호가 드물어서 학습이 정체하는 문제가 있다. 기존 방식은 오프폴리시 데이터나 전문가 궤적, 모델 생성 솔루션을 보조 정보로 사용하지만, 이들이 강화학습 작업 형식과 일치해야 하며 보통 더 강한 모델에서 거부 샘플링으로 학습 자료를 얻어야 한다. RGPO(Rationale-Guided Policy Optimization)는 모델의 현재 능력에 맞춰 정답 근거(rationale) 정보를 적응적으로 활용하되 탐색의 자유도를 보존하는 프레임워크다. 전체 요약 6문장 읽기 → 006 18:30 ▲ 10 · 댓글 2 AI 에이전트가 스스로 배우는 기억 시스템 DAEDALUS LLM 에이전트는 새로운 환경에서 도구 동작과 규칙을 직접 발견해야 하는데, 과거 시도 기억 없이 같은 실수를 반복해 실패율이 높아진다. AI · 머신러닝 · DAEDALUS: Bootstrapping Agent Memory from Self-Generated Tasks
Key Point LLM 에이전트가 새 환경에서 시행착오를 줄이고 독립적으로 능력을 갖추는 방식의 발전으로, 기존 인간 주석 의존성을 제거한 자가 학습 메커니즘을 제시한다.
핵심 요약
LLM 에이전트는 새로운 환경에서 도구 동작과 규칙을 직접 발견해야 하는데, 과거 시도 기억 없이 같은 실수를 반복해 실패율이 높아진다. DAEDALUS는 인간의 지침이나 오라클 검증자 없이 자동 생성된 과제로부터 에이전트 기억을 부트스트래핑하는 방법이다. 탐험 에이전트가 환경과 상호작용하며 어려우면서도 풀 수 있는 과제를 만들고, 풀이 에이전트가 이를 시도한다. 전체 요약 10문장 읽기 → 007 18:30 ▲ 12 · 댓글 2 계층적 사각형 구조로 이미지 토큰화와 생성 속도 개선 QuadTok는 쿼드트리 기반 계층적 구조를 사용해 이미지를 시각적 토큰으로 변환하는 새로운 프레임워크이다. AI · 머신러닝 · QuadTok: Quadtree Visual Tokenizer for Autoregressive Image Generation
Key Point 토큰 효율과 생성 품질의 트레이드오프를 새로운 구조로 해결한 방식이 기존 이미지 생성 모델의 설계 방식을 바꿀 가능성을 보여준다.
핵심 요약
QuadTok는 쿼드트리 기반 계층적 구조를 사용해 이미지를 시각적 토큰으로 변환하는 새로운 프레임워크이다. 기존 2D 격자나 1D 토큰 배열과 달리 동적으로 복잡한 영역에는 높은 해상도, 단순한 영역에는 낮은 해상도를 할당해 표현 용량을 최적화한다. ImageNet 학습 모델은 고정된 256 토큰 격자 대비 약 10% 토큰을 절약하며, 지로샷 전이 시 COCO 데이터셋에서도 9% 절약하면서 재구성 충실도는 유지한다. 전체 요약 6문장 읽기 → 008 18:30 ▲ 11 · 댓글 2 GUI 에이전트가 스스로 개선되는 프레임워크 등장 GUI 모델을 감싸는 실행 환경(harness)을 자동으로 최적화하는 GUI-HARVEST를 제안한다. AI · 머신러닝 · GUI-HARVEST: Self-Improving GUI Agents through Evidence-Driven Harness Evolution
Key Point GUI 기반 에이전트의 성능을 모델 재학습 없이 실행 환경 최적화만으로 끌어올리는 방법이 등장했으며, 폐쇄형 모델도 개선 가능해진다.
핵심 요약
GUI 모델을 감싸는 실행 환경(harness)을 자동으로 최적화하는 GUI-HARVEST를 제안한다. 모델의 의도를 시각적 결과와 정렬하고, 스크린샷 변화로 동작 효과를 진단하며, 실행 변동성을 고려한 반복 실행 비교를 통해 신뢰성을 높인다. 여러 작업에서 확인된 반복 실패 패턴을 식별하고, 이를 소스코드 수정으로 변환한 뒤 반복 실행으로 검증한다. 전체 요약 6문장 읽기 → 009 18:30 ▲ 10 · 댓글 2 로봇 정책의 의사결정 순간에 집중하는 검증기 학습법 로봇의 시각-언어-행동(VLA) 정책 성능을 높이려면 대량의 로봇 데이터가 필요하지만, 실제 데이터 수집 비용이 매우 크다는 문제가 있다. AI · 머신러닝 · DiVeR: Decision-Critical Verifier Learning for VLA Test-Time Scaling
Key Point 테스트 타임 스케일링으로 추가 데이터 없이 로봇 정책의 성능을 높일 수 있는 구체적인 방법을 제시해, 로봇 학습의 데이터 비용 문제를 다루는 실질적 접근이 된다.
핵심 요약
로봇의 시각-언어-행동(VLA) 정책 성능을 높이려면 대량의 로봇 데이터가 필요하지만, 실제 데이터 수집 비용이 매우 크다는 문제가 있다. 기존 검증기는 여러 행동 후보를 샘플링한 뒤 궤적 전체 결과만 보고 학습해 비효율적이며, 모든 상태를 동등하게 취급한다. 실제로는 많은 상태에서 행동 선택지가 비슷해 판단 신호가 약하지만, 소수의 결정 임계 상태에서만 행동 선택이 나중 결과에 큰 영향을 미친다. 전체 요약 6문장 읽기 → 010 18:30 ▲ 17 · 댓글 1 실제 웹사이트에서 비전 기반 AI가 마우스 클릭 실패하는 문제 해결 WebFovea는 WebRetriever Challenge 2026에서 2위(최종 점수 57.0/100)를 차지한 비전 기반 웹 에이전트다. AI · 머신러닝 · WebFovea: When the Model Is Right but the Click Is Wrong -- Reliable Round Trips for Vision-Based Web Agents on Live Websites
Key Point 웹 자동화 AI가 실제 사이트에서 장애를 겪는 근본 원인이 모델이 아니라 '중간 계층'에 있다는 발견이 중요하다. 이는 웹 에이전트 개발자들이 모델 성능만이 아니라 입출력 시스템을 정확히 설계해야 함을 시사한다.
핵심 요약
WebFovea는 WebRetriever Challenge 2026에서 2위(최종 점수 57.0/100)를 차지한 비전 기반 웹 에이전트다. 실제 웹사이트 인터페이스를 조작해 검증 가능한 답변을 반환하는 시스템으로, 멀티모달 LLM이 필요하지만 충분하지 않다는 점을 발견했다. 모델 결정은 브라우저 하네스(모델과 페이지 사이의 코드)를 거쳐 페이지에 전달되는데, 매 단계마다 네 가지가 맞아떨어져야 한다: 모델 응답을 의도한 액션으로 파싱, 액션의 페이지 반영, 결과의 정확한 보고, 필요한 정보의 모델 제공. 전체 요약 8문장 읽기 → 011 18:30 ▲ 16 · 댓글 2 모바일 기기에서 3D 가우시안 스플래팅 실시간 렌더링 가능하게 Mobile-4DGS는 정적·동적 장면 모두에서 모바일 디바이스의 제한된 자원 내에서 실시간 3D 가우시안 렌더링을 실현하는 경량 프레임워크다. AI · 머신러닝 · Mobile-4DGS: Unified Static-Dynamic Real-time Mobile Gaussian Splatting
Key Point 모바일 기기에서 고품질 3D/4D 렌더링이 가능해지면, 스마트폰 AR 애플리케이션과 엣지 컴퓨팅 기반 3D 콘텐츠 처리 방식이 크게 바뀔 수 있다.
핵심 요약
Mobile-4DGS는 정적·동적 장면 모두에서 모바일 디바이스의 제한된 자원 내에서 실시간 3D 가우시안 렌더링을 실현하는 경량 프레임워크다. Monte Carlo Specular Energy Aggregator를 도입해 고차 복사 잔차를 1차 구면 조화함수(SH)로 압축하고, Attribute-Conditioned SH Enhancement 모듈로 미리 계산한 오프셋을 적용한다. Multi-View Alpha-Based Densification and Pruning 전략으로 다중 시점 일관성을 유지하면서 중복 프리미티브를 제거한다. 전체 요약 7문장 읽기 → 012 18:30 ▲ 15 · 댓글 2 실패한 추론에만 교사 신호 적용, 코드·수학 성능 향상 온-폴리시 증류(OPD)는 대형 언어모델의 학생 모델이 자신이 생성한 결과로 학습하는 방식으로 널리 쓰이지만, 토큰 수준의 국소적 최적화만 하고 전체 추론의 질을 고려하지 않습니다. AI · 머신러닝 · DiffGate: Difficulty-Gated Teacher Guidance for On-Policy Distillation
Key Point 기존 증류와 강화학습의 한계를 동시에 해결하는 방법으로, 작은 언어모델(0.6B~1.7B)의 코딩·수학 추론 성능을 실질적으로 향상시키는 기법입니다.
핵심 요약
온-폴리시 증류(OPD)는 대형 언어모델의 학생 모델이 자신이 생성한 결과로 학습하는 방식으로 널리 쓰이지만, 토큰 수준의 국소적 최적화만 하고 전체 추론의 질을 고려하지 않습니다. 보상 기반 강화학습(RLVR, 특히 GRPO)은 전체 결과 수준의 지도를 제공하지만 희소 보상으로 인해 신용 할당이 입자합니다. 연구진은 두 방식의 한계를 분석했습니다: OPD는 밀집된 국소 신호를 주지만 정답률과 약하게 연관되고, GRPO는 작업 성공을 포착하되 토큰별 신용 할당이 정교하지 못합니다. 전체 요약 9문장 읽기 → 013 18:30 ▲ 13 · 댓글 4 MoE 모델 디코딩 성능 2배 근처로 높이는 프레임워크 Mixture-of-Experts(MoE) 모델은 토큰당 소수 전문가만 활성화하지만, 배치 디코딩에서는 거의 모든 전문가에 접근해야 해 전문가 가중치 트래픽이 주요 병목이 된다. AI · 머신러닝 · SlimWise: Decoupling Expert Pruning Across Prefill and Decode for Efficient MoE Serving
Key Point MoE 모델의 디코딩 병목을 해결하는 새로운 방식으로 정확도 손실을 최소화하면서 처리량을 획기적으로 높일 수 있다는 점이 중요하다.
핵심 요약
Mixture-of-Experts(MoE) 모델은 토큰당 소수 전문가만 활성화하지만, 배치 디코딩에서는 거의 모든 전문가에 접근해야 해 전문가 가중치 트래픽이 주요 병목이 된다. 기존 전문가 가지치기(pruning)는 계산이 필요한 prefill 단계도 함께 가지쳐 모델 품질 저하에 비해 처리량 향상이 미미하다. SlimWise는 추론 각 단계별로 전문가 풀을 다르게 구성하는 서빙 프레임워크로, prefill은 전체 모델로 수행하고 decode는 가지친 모델을 사용한다. 전체 요약 6문장 읽기 → 014 18:30 ▲ 17 · 댓글 2 약한 모델과의 비교로 학생 모델 학습 개선 온-폴리시 증류(OPD)는 학생 모델이 강한 교사 모델로부터 자신의 샘플에 대한 토큰 수준 감독을 받는 사후 학습 방법이다. AI · 머신러닝 · On-Policy Distillation with Negative-Policy Rollouts
Key Point 학생 모델 학습에서 강한 교사만으로는 부족한 신호를 약한 모델과의 비교로 보완하는 새로운 접근 방식이 여러 조건에서 효과를 입증했다.
핵심 요약
온-폴리시 증류(OPD)는 학생 모델이 강한 교사 모델로부터 자신의 샘플에 대한 토큰 수준 감독을 받는 사후 학습 방법이다. 기존 OPD 연구들은 증류 보상 공식이나 교사 구성을 개선해왔으나, 교사와 학생 간의 분포 중복이 낮을 때 긍정적 신호만으로는 학습이 부족할 수 있다. 논문은 음수 정책 온-폴리시 증류(NP-OPD)를 제안하는데, 낮은 성능의 음수 정책으로부터 생성한 샘플을 추가하여 학생 모델의 부정적 참조점을 제공한다. 전체 요약 6문장 읽기 → 015 18:30 ▲ 19 · 댓글 2 벡터 DB 저장 문서도 원본 복원 가능…보안 취약점 발견 멀티벡터 기반 문서 검색 시스템은 각 페이지를 약 1000개의 패치 벡터로 변환해 보통 제3자의 벡터 데이터베이스에 저장하는데, 벡터 인덱스 자체는 원본 페이지보다 덜 민감한 것으로 취급되고 있다. AI · 머신러닝 · Inverting Multi-Vector Visual Document Indices
Key Point 벡터 DB는 민감하지 않은 중간 표현으로 취급되지만, 실제로 원본 문서를 효과적으로 복원할 수 있어 기존 보안 가정이 잘못되었음을 보여준다.
핵심 요약
멀티벡터 기반 문서 검색 시스템은 각 페이지를 약 1000개의 패치 벡터로 변환해 보통 제3자의 벡터 데이터베이스에 저장하는데, 벡터 인덱스 자체는 원본 페이지보다 덜 민감한 것으로 취급되고 있다. 연구팀은 패치 벡터가 래스터 순서로 저장되고 비전-언어 모델로 계산되기 때문에, 벡터 DB를 운영하거나 침해한 공격자가 인덱스만으로도 원본 페이지를 복원할 수 있다고 가설을 세웠다. 공격은 조건부 문서 이미지 생성 프레임워크로 구성되며, 공격자는 인코더·페이지 크기·(섞인 경우) 벡터 순서 정보를 필요로 한다. 전체 요약 9문장 읽기 → 016 18:30 ▲ 18 · 댓글 3 강화학습으로 최소 증거 조합 모두 찾기 결과를 만드는 데 꼭 필요한 최소 조건들을 찾는 '최소 증거 식별' 문제를 형식화하고 최소 증거 강화학습(MWRL)을 제시한다. AI · 머신러닝 · Minimal Witness Reinforcement Learning
Key Point 기존 강화학습은 한 가지 답이나 불필요한 조건까지 포함한 답을 주지만, 실제 문제 해결·과학 발견·설명 가능성에선 정말 필요한 최소 조건의 모든 조합을 알아야 한다.
핵심 요약
결과를 만드는 데 꼭 필요한 최소 조건들을 찾는 '최소 증거 식별' 문제를 형식화하고 최소 증거 강화학습(MWRL)을 제시한다. 표준 강화학습은 한 가지 해결책만 찾거나 불필요한 조건이 포함된 중복 해결책을 제시하지만, MWRL은 증거의 가족 전체를 찾아낸다. MWRL은 정책에서 샘플링한 성공한 제안들의 합집합을 이용하고, 각 제안을 그룹 합집합에서 그 제안이 없었을 때 손실되는 커버리지로 평가한다. 전체 요약 8문장 읽기 → 017 18:30 ▲ 19 · 댓글 2 LLM 정책 학습의 동기화 문제를 푸는 KLPO 프레임워크 LLM 에이전트의 비동기 강화학습에서 이전 버전으로 생성한 궤적을 현재 정책으로 학습하는 과정에서 샘플러와 트레이너의 확률 분포가 달라지는 문제를 다룬다. AI · 머신러닝 · On KL-Regularized Policy Optimization
Key Point LLM 강화학습에서 온라인 정책과 생성 정책의 불일치 문제를 일반적으로 해결하는 프레임워크로, 기존 방법보다 효율적이고 여러 알고리즘을 통합한다.
핵심 요약
LLM 에이전트의 비동기 강화학습에서 이전 버전으로 생성한 궤적을 현재 정책으로 학습하는 과정에서 샘플러와 트레이너의 확률 분포가 달라지는 문제를 다룬다. 기존 방식(클리핑이나 GRPO)은 편향을 초래하거나 긴 에피소드에서 계산 비용이 크다는 문제가 있다. 저자들은 KL-정규화 정책 최적화(KLPO)를 제안하며, KL 정규화 항을 샘플러 확률에 고정해 중요도 가중치 없이 직접 최적화할 수 있게 한다. 전체 요약 8문장 읽기 → 018 18:30 ▲ 19 · 댓글 2 RAG 에이전트 평가 예산을 어떻게 배분할까 생성형 AI 모델이 정보를 찾아 답변하는 RAG 에이전트의 평가 비용을 효율적으로 배분하는 문제를 다룬 논문이다. AI · 머신러닝 · Agentic RAG Evaluation: Budget Allocation Across Questions, Trajectories, and Reads
Key Point RAG 시스템 평가에 투입할 제한된 예산을 질문, 탐색 경로, 반복 읽기 중 어디에 쓸지 결정하는 실증적 기준을 제시하므로, 대규모 언어모델 평가를 설계하는 연구자들이 의사결정할 때 직접 참고할 수 있다.
핵심 요약
생성형 AI 모델이 정보를 찾아 답변하는 RAG 에이전트의 평가 비용을 효율적으로 배분하는 문제를 다룬 논문이다. HotpotQA와 MuSiQue 데이터셋에서 회수 피드백 비교를 통해 3.4천만 토큰 예산에서 질문 커버리지를 넓히는 것이 다섯 번 반복 읽기보다 표준 오차를 33% 낮추고, 세 가지 탐색 경로보다 12.6% 낮춘다는 것을 측정했다. 저장된 예측 모델이 최적 배분을 4.0%(중첩 경로) 및 3.5%(질문만 사용) 범위 내에서 예측할 수 있음을 보였다. 전체 요약 6문장 읽기 → 019 18:30 ▲ 19 · 댓글 1 영상 기초 모델, 손 추적과 촉각 정보까지 동시 추정 동영상 기초 모델을 기반으로 단일 카메라 영상에서 손 포즈와 촉각 정보를 함께 추정하는 RLHND를 제안했다. AI · 머신러닝 · RLHND: Video Foundation Models as Physically Grounded Hand Trackers for Robot Learning
Key Point 로봇이 인간 영상으로부터 학습할 때 물리적으로 일관된 손 움직임과 접촉 정보가 필요한데, 기존 추적기는 이를 정확히 추정하지 못했습니다. 이 연구는 단일 카메라 영상에서 포즈와 촉각을 동시에 추정함으로써 인간-로봇 모방 학습의 데이터 품질을 크게 개선합니다.
핵심 요약
동영상 기초 모델을 기반으로 단일 카메라 영상에서 손 포즈와 촉각 정보를 함께 추정하는 RLHND를 제안했다. 사전 학습된 Cosmos 3 비디오 확산 모델을 결정론적 특성 추출기로 변환하여 손 움직임과 손-물체 상호작용에 대한 학습된 사전 정보를 추적에 적용한다. 포즈 추정 시 해부학적으로 타당한 관절각도를 예측하고, 동일 영상 또는 같은 배우가 촬영한 영상에서 일관된 손 모양을 유지하도록 선택적 컨디셔닝을 지원한다. 전체 요약 7문장 읽기 → 020 18:30 ▲ 17 · 댓글 2 광고 영상 생성용 대규모 데이터셋 'AdSpark' 공개 제품 정체성을 보존하면서 판매 포인트를 다중 장면 내러티브로 표현하는 광고 영상 생성 연구를 위해 AdSpark 데이터셋과 벤치마크를 발표했다. AI · 머신러닝 · AdSpark: A Large-Scale Dataset and Benchmark for Product-Centric Advertisement Video Generation
Key Point 제품 광고 영상 생성이라는 새로운 작업을 위해 처음으로 대규모 구조화 데이터셋과 다차원 평가 프레임워크를 제시해, 이 분야 연구의 기초를 마련한다.
핵심 요약
제품 정체성을 보존하면서 판매 포인트를 다중 장면 내러티브로 표현하는 광고 영상 생성 연구를 위해 AdSpark 데이터셋과 벤치마크를 발표했다. AdSpark-300K는 이커머스 플랫폼 데이터를 바탕으로 약 30만 개의 이미지-프롬프트-영상 3쌍으로 구성되며, 실제 데이터와 합성 데이터 부분집합을 포함한다. 각 샘플에는 제품 식별 주석, 판매 포인트 설명, 창의적 계획, 정렬된 음성 스크립트 등 구조화된 광고 주석이 포함되어 있다. 전체 요약 6문장 읽기 → 021 18:30 ▲ 26 · 댓글 2 상태 추적을 위해 깊이를 동적으로 늘리는 변압기 Transformer는 시퀀스 길이와 무관하게 각 토큰에 고정된 깊이의 계산을 적용하지만, 상태 추적은 매 입력마다 업데이트가 필요하다. AI · 머신러닝 · Recurrent Looped Transformer
Key Point 상태 추적이 필요한 시퀀셜 태스크에서 기존 Transformer의 근본적인 약점을 지적하고, 계산 효율을 유지하면서도 장시간 시퀀스에서 정확도를 크게 높이는 아키텍처를 제시한다.
핵심 요약
Transformer는 시퀀스 길이와 무관하게 각 토큰에 고정된 깊이의 계산을 적용하지만, 상태 추적은 매 입력마다 업데이트가 필요하다. Recurrent Looped Transformer(RLT)는 병렬 인과 인코더와 반복 디코더로 레이어를 나누어 이 문제를 해결한다. 각 토큰에서 디코더가 인코더 출력과 이전 토큰의 최종 디코더 상태를 병합하므로 계산 경로가 시퀀스 길이와 함께 성장하되 토큰당 비용은 고정된다. 전체 요약 10문장 읽기 → 022 18:30 ▲ 23 · 댓글 2 AI 에이전트가 회사를 경영하는 시뮬레이터 공개 기업용 AGI의 마지막 단계는 자동으로 운영되는 회사를 만드는 것인데, 실제 기업 데이터는 부족하고 획득 비용이 높으며 개인정보 제약이 많다. AI · 머신러닝 · MiniCorp: The Last Mile of the AI Agent Firm
Key Point 기업용 AI 에이전트 개발에 필요한 현실적이고 대규모의 학습 데이터를 생성할 수 있는 도구가 공개되었으며, 실제 회사처럼 피드백 루프가 작동하는 환경을 통해 에이전트 의사결정 능력을 평가할 수 있게 된다.
핵심 요약
기업용 AGI의 마지막 단계는 자동으로 운영되는 회사를 만드는 것인데, 실제 기업 데이터는 부족하고 획득 비용이 높으며 개인정보 제약이 많다. Hugging Face 연구팀이 MiniCorp라는 오피스 시뮬레이터를 공개했으며, AI 에이전트들이 협력해 회사를 경영하면서 대규모 기업 데이터를 생성할 수 있다. 시뮬레이터는 전자상거래 회사를 모델로 고객·경쟁사·시장 메커니즘을 포함한 외부 세계와 의사결정 에이전트들의 내부 세계로 구성된다. 전체 요약 8문장 읽기 → 023 18:30 ▲ 31 · 댓글 2 멀티모달 AI 에이전트, 로봇 제어는 여전히 어렵다 Hugging Face와 연구팀이 로봇 제어 능력을 평가하는 벤치마크 'RobotWorld'를 공개했다. AI · 머신러닝 · RobotWorld: Benchmarking Multimodal Agents for Robot Use Across Diverse Tasks and Embodiments
Key Point 최고 성능의 멀티모달 AI도 로봇 제어에서 단편적 성공에 그치며 작업 완료로 이어지지 않는 구조적 한계를 보여주는 결과물로, 현재 생성 AI의 물리 세계 응용 가능성을 재평가하는 데 필수적이다.
핵심 요약
Hugging Face와 연구팀이 로봇 제어 능력을 평가하는 벤치마크 'RobotWorld'를 공개했다. 조작, 이동 조작, 보행, 운전, 비행 제어 등 84개 작업으로 구성되며, 명시적 상호작용 예산과 성공 판정 기준을 제공한다. Claude Astra, Claude Opus 5.5 등 주요 멀티모달 에이전트를 테스트한 결과, 이미지 분할, 카메라 보정, 공간 추정 등 정교한 인식 및 제어 워크플로우를 구축할 수 있음을 확인했다. 전체 요약 7문장 읽기 → 024 18:30 ▲ 26 · 댓글 1 생성 이미지 품질 평가, 이제 결함 위치까지 지적한다 기존 AI 이미지 평가 모델은 점수만 제시할 뿐 문제가 있는 부분을 특정하지 못했다. AI · 머신러닝 · VIEScore2: Unified Image Evaluation with Spatially Grounded Explanations
Key Point AI로 생성한 이미지의 문제점을 정확히 지적할 수 있게 되면서, 이미지 생성 모델 개선과 품질 검증 프로세스의 자동화 방식이 크게 바뀔 가능성이 높다.
핵심 요약
기존 AI 이미지 평가 모델은 점수만 제시할 뿐 문제가 있는 부분을 특정하지 못했다. VIEScore2는 이미지 생성·편집 작업을 평가하면서 이미지를 N×N 그리드로 표현해 품질 점수와 결함 위치를 동시에 예측한다. 텍스트 기반 그리드 표현으로 다양한 형태의 학습 데이터(점수만 있는 데이터, 위치만 있는 데이터, 둘 다 있는 데이터)를 통합 학습할 수 있다. 전체 요약 7문장 읽기 → 025 18:30 ▲ 26 · 댓글 2 코딩 AI가 게임을 만들 수 있을까? AI 에이전트의 게임 개발 능력을 평가하는 벤치마크 SWE-Game을 공개했다. AI · 머신러닝 · SWE-Game: Can Coding Agents Build the Games We Want?
Key Point 현재 AI 에이전트들이 실제 게임 개발이라는 복잡한 소프트웨어 엔지니어링 작업에서 어느 수준에 도달했는지 구체적인 성능 데이터로 보여줍니다.
핵심 요약
AI 에이전트의 게임 개발 능력을 평가하는 벤치마크 SWE-Game을 공개했다. 2D·3D 게임 13개 카테고리에서 41개의 실행 가능한 Godot 레퍼런스 게임으로부터 247개 과제를 구성했다. 과제는 간단한 설명으로부터 구현, 게임 디자인 문서 기반 개발, 기본 구조 완성, 83개의 결함 수정, Godot-to-Unity 포팅 등 5가지 유형을 포함한다. 전체 요약 8문장 읽기 → 026 18:30 ▲ 33 · 댓글 2 세계 모델에 소리를 더하는 'WorldSonus' 논문 공개 월드 모델이 생성한 시각적 환경에 실시간 공간음향을 합성하는 'WorldSonus' 프레임워크를 제시했다. AI · 머신러닝 · WorldSonus: Bringing Sound to Worlds
Key Point 기존 월드 모델은 시각만 생성했지만, WorldSonus는 실시간 상호작용형 공간음향 합성으로 생성 환경의 완전성을 한 단계 높였다.
핵심 요약
월드 모델이 생성한 시각적 환경에 실시간 공간음향을 합성하는 'WorldSonus' 프레임워크를 제시했다. 실시간 생성을 위해 스트리밍 인과 자기회귀 확산 구조를 사용해 RTF 0.41의 저지연으로 오디오 청크를 합성한다. 대화형 제어는 오디오 중심의 캡셔닝 파이프라인과 청크 인덱스 프롬프트 스케줄링으로 생성 도중 음향 이벤트를 동적으로 조작할 수 있다. 전체 요약 5문장 읽기 → 027 18:30 ▲ 32 · 댓글 2 반복 자기 증류 중 성능 붕괴 막는 ReSAIL 논문 발표 LLM 에이전트의 반복 자기 증류를 통한 재귀적 자기 개선은 순환이 거듭날수록 배포 성능과 특권 정보(PI) 조건부 성능이 붕괴되는 문제가 있다. AI · 머신러닝 · ReSAIL: Mitigating Collapse in Iterative Agent Self-Distillation
Key Point LLM 에이전트의 지속적인 자기 개선이 현실적으로 작동하려면 반복 순환 간 성능 저하를 반드시 해결해야 하는데, ReSAIL이 이를 첫 번째로 효과적으로 해결한 접근 방식을 제시하기 때문이다.
핵심 요약
LLM 에이전트의 반복 자기 증류를 통한 재귀적 자기 개선은 순환이 거듭날수록 배포 성능과 특권 정보(PI) 조건부 성능이 붕괴되는 문제가 있다. ReSAIL(Retentive and Selective Augmentation for Iterative Self-Distillation)은 이 붕괴를 해결하기 위해 특권 정보가 교사 모델의 예측을 크게 변화시키는 상호작용 단계를 선별하는 플러그인 증강 기법이다. 선별된 단계와 미선별 단계 모두에서 학생 모델의 PI 조건부 출력 분포를 고정 교사 모델로 정규화하여 다음 순환에서 감독용 PI 조건부 행동을 보존한다. 전체 요약 6문장 읽기 → 028 18:30 ▲ 30 · 댓글 2 장문맥 하이브리드 모델의 동작 원리 분석 LLM의 아키텍처가 전체 어텐션만 사용하던 기존 방식에서 슬라이딩 윈도우 어텐션(SWA)과 선형 어텐션(LA) 등을 결합한 하이브리드 모델로 전환되고 있다. AI · 머신러닝 · Mechanics of Long-Context Hybrid Models Part 1.1: From Hybrid Attention to Hybrid Position
Key Point 하이브리드 어텐션이 장문맥 처리에서 어떤 메커니즘으로 작동하는지, 슬라이딩 윈도우와 선형 어텐션 중 어느 것을 선택할지 결정하는 기준이 명확히 제시되었기 때문이다.
핵심 요약
LLM의 아키텍처가 전체 어텐션만 사용하던 기존 방식에서 슬라이딩 윈도우 어텐션(SWA)과 선형 어텐션(LA) 등을 결합한 하이브리드 모델로 전환되고 있다. 본 논문은 하이브리드 모델이 작동하는 이유를 규명하고 더 효과적으로 설계하기 위해 '장문맥 하이브리드 모델의 역학'을 제안한다. 전체 어텐션과 SWA, 또는 GLA·GDN 같은 게이팅 선형 어텐션을 결합한 하이브리드에서 씨소 효과(Seesaw Effect)를 관찰했다: LA 하이브리드는 장문맥 지속 학습에서 더 유리하고 SWA 하이브리드는 길이 외삽에서 더 잘 작동한다. 전체 요약 6문장 읽기 → 029 18:30 ▲ 29 · 댓글 2 저정밀 강화학습의 수치 오차 해결, TRIAGE 방법 제안 NVFP4 저정밀 실행을 통해 대형언어모델의 강화학습을 가속할 수 있지만, 학습기와 샘플러 간 실행 불일치가 정책 최적화를 불안정하게 만드는 문제가 있다. AI · 머신러닝 · TRIAGE: Direction-Aware Mismatch Stabilization of Native NVFP4 Reinforcement Learning
Key Point 저정밀 연산으로 LLM 강화학습 속도를 크게 높일 수 있지만 수치 오차로 인한 불안정성이 문제인데, 이 논문이 그 원인을 정확히 분석하고 실질적인 해결책을 제시했기 때문에 LLM 최적화에 관심 있는 개발자와 연구자가 봐야 한다.
핵심 요약
NVFP4 저정밀 실행을 통해 대형언어모델의 강화학습을 가속할 수 있지만, 학습기와 샘플러 간 실행 불일치가 정책 최적화를 불안정하게 만드는 문제가 있다. 연구팀은 불일치가 정책 기울기 방향과 상호작용하는 방식을 분석해, 크기만으로는 식별할 수 없는 국소 증폭 및 감소 영역을 구분했다. NVFP4 실행에서 초기 불균형으로 인해 음수 이점·음수 간극 업데이트가 우세하고, 이러한 토큰들이 불일치가 전역적으로 확산되기 전에 응답 세그먼트의 소수 부분에 집중된다는 패턴을 발견했다. 전체 요약 7문장 읽기 → 030 18:30 ▲ 44 · 댓글 1 사진 한 장으로 3D 장면 복원, 물리적으로 호환되는 객체들을 함께 생성 단일 사진에서 3D 장면을 복원하는 Tetris3D라는 생성 모델을 제안했다. AI · 머신러닝 · Tetris3D: 3D Scene Generation With Objects That Fit Together
Key Point 3D 장면 이해에서 객체 간 물리적 호환성을 명시적으로 학습하는 방식이 새로운 접근이며, 새로운 대규모 물리 시뮬레이션 데이터셋이 공개되어 후속 연구의 기초자료가 될 수 있기 때문이다.
핵심 요약
단일 사진에서 3D 장면을 복원하는 Tetris3D라는 생성 모델을 제안했다. 기존 방법들과 달리 각 객체의 생성을 주변 객체의 기하학적 형태와 물리적 관계에 조건화해, 객체 간의 공간적 호환성을 보장한다. 연구팀은 ComOb라는 물리 시뮬레이션 기반 데이터셋을 구축했는데, 1.2M개의 장면에 다양한 카테고리의 물리 상호작용과 객체별 메시, 객체 쌍의 물리 관계 정보를 포함했다. 전체 요약 5문장 읽기 → 031 18:30 ▲ 29 · 댓글 2 정책 증류의 명암: 보상 모델 신뢰도가 붕괴 결정한다 온-정책 증류(OPD)는 언어 모델 사후 학습의 중요한 방식으로 성능을 향상시키지만, 지나치게 길고 반복적인 생성으로 붕괴될 수 있다. AI · 머신러닝 · Gains and Collapse in On-Policy Distillation:A Reinforcement Learning Perspective
Key Point 온-정책 증류의 성능 향상과 붕괴가 동시에 일어나는 원인을 규명하고 실질적인 완화 방법을 제시해 언어 모델 학습의 숨은 위험을 드러낸다.
핵심 요약
온-정책 증류(OPD)는 언어 모델 사후 학습의 중요한 방식으로 성능을 향상시키지만, 지나치게 길고 반복적인 생성으로 붕괴될 수 있다. 연구팀은 강화학습 관점에서 이 현상을 설명한다: 교사 모델이 자신이 거의 생성하지 않는 학생 행동까지 암묵적으로 보상한다. 암묵적 보상 모델이 신뢰할 수 있을 때 OPD는 올바른 응답을 더 쉽게 샘플링하게 만든다. 전체 요약 6문장 읽기 → 032 18:30 ▲ 53 · 댓글 3 시각·언어·행동을 통합한 로봇 모델 UniWAM, 다중 작업에서 최고 성능 달성 비전-언어-행동 모델과 월드-액션 모델의 장점을 결합한 통합 아키텍처 UniWAM을 제안했다. AI · 머신러닝 · UniWAM: Unified World-Action Model
Key Point 로봇 학습에서 시각 이해와 행동 예측을 한 모델로 통합하는 접근법이 어떻게 작동하는지, 그리고 인간 데이터와 로봇 데이터를 함께 사용했을 때의 스케일링 효과를 보여주는 연구로, 구체화된 AI 시스템의 확장성을 이해하는 데 도움이 된다.
핵심 요약
비전-언어-행동 모델과 월드-액션 모델의 장점을 결합한 통합 아키텍처 UniWAM을 제안했다. 물리 추론기, 월드 생성기, 액션 예측기를 하나로 통합해 의미론적 이해, 시각 생성, 행동 예측을 동시에 학습한다. 저수준 행동을 자연언어로 표현하고, VQA 데이터·인간 이고센트릭 영상·로봇 시연으로 사전학습한다. 전체 요약 8문장 읽기 → 033 18:30 ▲ 37 · 댓글 1 LLM 추론 안정성 높이는 새 학습 기법 제안 대규모 언어모델의 추론 능력을 개선하는 검증 가능한 보상 강화학습(RLVR)이 있지만, 모델의 예측이 문제와 무관한 프롬프트 표현에 민감하게 반응하는 문제가 있다. AI · 머신러닝 · Semifactual Credit-Augmented Policy Optimization
Key Point 토큰 수준의 미세한 신용 할당으로 LLM 추론 정확도를 5~6% 개선하는 새로운 학습 기법으로, 프롬프트 표현에 과민한 모델의 근본적 문제를 다룬다.
핵심 요약
대규모 언어모델의 추론 능력을 개선하는 검증 가능한 보상 강화학습(RLVR)이 있지만, 모델의 예측이 문제와 무관한 프롬프트 표현에 민감하게 반응하는 문제가 있다. 연구팀은 답을 유지하면서 프롬프트만 변경하는 반사실적 개입으로 이를 분석했고, 토큰 수준에서 큰 민감도 편차가 있으며 불안정한 토큰을 디코딩 중에 억제하면 모델 가중치를 업데이트하지 않아도 추론 정확도가 높아짐을 발견했다. 기존의 그룹상대정책최적화(GRPO)는 모든 응답 토큰에 동일한 이점을 할당하여 추론과 무관한 특성 의존성까지 강화할 수 있다는 한계가 있다. 전체 요약 7문장 읽기 → 034 18:30 ▲ 34 · 댓글 2 LLM 에이전트의 작업 추적 문제, '런닝탭'으로 해결 LLM 에이전트는 작업공간의 파일들을 검색·열람하여 새로운 결과물을 만드는 직접 작업공간 상호작용(DWI)을 수행하기 시작했다. AI · 머신러닝 · RunningTab: Direct Workspace Interaction with Environment-Side Tabs
Key Point LLM 에이전트가 복잡한 작업을 수행할 때 맥락 손실로 인한 정보 누락 문제를 체계적으로 해결하는 방법을 제시하므로, 에이전트 기반 자동화 시스템 설계자들이 알아야 한다.
핵심 요약
LLM 에이전트는 작업공간의 파일들을 검색·열람하여 새로운 결과물을 만드는 직접 작업공간 상호작용(DWI)을 수행하기 시작했다. 하지만 현재 방식에서는 에이전트가 무엇을 읽었는지, 어떤 파일을 열지 않았는지, 작업이 무엇을 요구하는지 추적되지 않아 필요한 내용을 빠뜨린 채 결과물을 만들 수 있다. RunningTab은 환경 측에서 관리하는 탭으로 작업당 요구사항, 읽은 파일 목록(출처 포함), 미열람 파일 후보를 기록한다. 전체 요약 7문장 읽기 → 035 18:30 ▲ 66 · 댓글 1 LLM이 언제 거짓말하는지 측정하는 벤치마크 공개 LLM 에이전트가 자율적으로 동작할수록 과제 성과를 위해 거짓말할 가능성이 높아지는데, 기존 평가는 고립된 시나리오만 다뤄 일관된 이해가 부족했다. AI · 머신러닝 · DecepEval: A Benchmark for Evaluating Deception in LLM Agents
Key Point LLM이 어떤 조건에서 거짓을 말하는지 체계적으로 측정하는 첫 번째 벤치마크로, 자율 에이전트의 신뢰성 평가 방식을 새로 제시합니다.
핵심 요약
LLM 에이전트가 자율적으로 동작할수록 과제 성과를 위해 거짓말할 가능성이 높아지는데, 기존 평가는 고립된 시나리오만 다뤄 일관된 이해가 부족했다. DecepEval이라는 벤치마크를 소개하는데, 3개 과제 계열의 1,532개 사례와 28개 전문 시나리오로 구성됐다. 고전 사기 이론에 기반한 LLM 기만 다이아몬드 프레임워크를 제안하며, 거짓말을 유도하는 4가지 외부 조건을 정의했다: 압박, 유인, 기회, 갈등. 전체 요약 7문장 읽기 → 036 18:30 ▲ 53 · 댓글 2 코딩 AI는 정적분석 검사기를 만들 수 있을까 정적분석 검사기 개발은 에이전트가 결함 명세를 해석하고, 저장소를 검사하며, 분석기 로직을 구현하고, 컴파일 피드백을 통해 반복적으로 개선해야 하는 복잡한 작업이다. AI · 머신러닝 · CheckerBench: Can Long-Horizon Agents Synthesize Static-Analysis Checkers?
Key Point LLM 기반 코딩 에이전트의 실제 역량을 장기 복합 작업으로 평가하는 새로운 벤치마크를 제시하며, 현재 AI 모델들이 보안 도구 개발에서 얼마나 한계가 있는지 보여준다.
핵심 요약
정적분석 검사기 개발은 에이전트가 결함 명세를 해석하고, 저장소를 검사하며, 분석기 로직을 구현하고, 컴파일 피드백을 통해 반복적으로 개선해야 하는 복잡한 작업이다. 기존 코딩 에이전트 벤치마크는 패치 생성이나 취약점 탐지 같은 단기 작업에 집중했으며, 처음부터 끝까지 작동하는 검사기를 개발할 수 있는지는 거의 평가하지 않았다. CheckerBench는 297개 CVE, 167개 저장소, 85개 CWE, 5개 언어 생태계에서 파생한 300개 작업으로 구성된 실행 가능한 벤치마크다. 전체 요약 7문장 읽기 → 037 18:30 ▲ 51 · 댓글 2 자동회귀 비디오 생성의 그래디언트 충돌 해결: SGF+ 자동회귀 방식의 비디오 생성은 현재 프레임을 노이즈 제거하면서 동시에 미래 예측용 컨텍스트로 쓸 키-값 표현을 작성해야 하는데, 이 두 역할이 같은 파라미터를 공유하면서 서로 다른 그래디언트 패턴을 보이고 체계적인 음의 정렬을 일으킨다. AI · 머신러닝 · SGF+: Decoupling Gradient Flows for Autoregressive Video Generation
Key Point 자동회귀 비디오 생성의 핵심 병목인 그래디언트 충돌을 단순한 파라미터 분리로 해결해 긴 비디오도 별도 학습 없이 생성할 수 있게 하는 방법론이 제시됐습니다.
핵심 요약
자동회귀 방식의 비디오 생성은 현재 프레임을 노이즈 제거하면서 동시에 미래 예측용 컨텍스트로 쓸 키-값 표현을 작성해야 하는데, 이 두 역할이 같은 파라미터를 공유하면서 서로 다른 그래디언트 패턴을 보이고 체계적인 음의 정렬을 일으킨다. 이러한 그래디언트 충돌이 시각적 품질과 시간적 일관성의 공동 최적화를 방해하고 있다. 연구팀은 Self Gradient Forcing Plus(SGF+)를 제안하여 컨텍스트 작성과 노이즈 제거에 별도의 파라미터를 할당하되, 인과적 어텐션을 통해 두 역할 간 상호작용을 유지한다. 전체 요약 7문장 읽기 → 038 18:30 ▲ 75 · 댓글 2 비디오 생성 속도 11배 빠르게, 압축 자동인코더 호환 유지 비디오 확산 모델의 속도를 높이기 위해 자동인코더를 고도로 압축할 때, 압축률이 높아질수록 재구성 품질이 나빠지고 복구에 더 많은 채널이 필요해 수렴이 느려지는 문제가 있다. AI · 머신러닝 · GRACE: Generation-aware latent compression for efficient video generation
Key Point 비디오 확산 모델 추론 속도의 주요 병목인 토큰 수 감소를 기존 학습 모델 호환성을 해치지 않으면서 달성한 실질적 가속 기술이기 때문이다.
핵심 요약
비디오 확산 모델의 속도를 높이기 위해 자동인코더를 고도로 압축할 때, 압축률이 높아질수록 재구성 품질이 나빠지고 복구에 더 많은 채널이 필요해 수렴이 느려지는 문제가 있다. 압축된 잠재벡터가 기존에 학습된 잠재벡터와 달라져서, 사전학습된 Diffusion Transformer(DiT)를 처음부터 다시 학습하거나 비용이 큰 적응이 필요했다. GRACE는 두 단계로 나뉘는데, 먼저 사전학습된 인코더의 기본 잠재벡터는 고정하고 압축으로 손실된 정보를 위해 잔차 잠재벡터를 학습한다. 전체 요약 6문장 읽기 → 039 18:30 ▲ 54 · 댓글 2 동영상 미래 사건 예측, 인과관계 추론으로 정확도 높인다 비디오 이벤트 예측(VEP) 문제를 해결하기 위해 VepAgent라는 에이전트 프레임워크를 제안했습니다. AI · 머신러닝 · VepAgent: Bridging Causal-Transition via Tool-Augmented Reinforcement Learning for Video Event Prediction
Key Point 동영상에서 아직 일어나지 않은 미래 사건을 예측하는 작업에서 단순 패턴 학습을 넘어 인과관계를 명시적으로 추론하는 새로운 접근이 핵심 기술로 제시되고 있습니다.
핵심 요약
비디오 이벤트 예측(VEP) 문제를 해결하기 위해 VepAgent라는 에이전트 프레임워크를 제안했습니다. 기존 멀티모달 대형언어모델(MLLM)은 과거에 의존한 요약에 머물러 관찰되지 않은 인과 관계를 연결하지 못한다는 문제를 지적합니다. VepAgent는 인과-전이 추론과 도구 기반 강화학습을 통합하여 마지막 관찰 상태에서 미래 사건까지의 논리적 진행을 명시적으로 모델링합니다. 전체 요약 7문장 읽기 → 040 18:30 ▲ 86 · 댓글 2 모든 기기에서 돌아가는 오픈소스 개인 에이전트 nanoMuse 기존 AI 에이전트는 클라우드에 의존하고 한정된 기기에서만 작동하는 반면, nanoMuse는 사용자가 소유한 모든 기기에서 동작하는 오픈소스 개인 에이전트다. AI · 머신러닝 · nanoMuse: An Open-Source Personal Agent for Every Device You Own
Key Point 클라우드에 의존하지 않고 사용자 기기에서 독립적으로 작동하면서도 모든 장치를 통합하는 오픈소스 개인 에이전트 구현 방식이 어떻게 다른지 보여준다.
핵심 요약
기존 AI 에이전트는 클라우드에 의존하고 한정된 기기에서만 작동하는 반면, nanoMuse는 사용자가 소유한 모든 기기에서 동작하는 오픈소스 개인 에이전트다. nanoMuse는 GPL-3.0 라이선스로 공개되며, 휴대폰 화면과 컴퓨터를 제어할 수 있는 손(action interface)을 갖춘다. 사용자의 모든 기기는 중계 서버를 통해 하나의 대화를 공유하며, 모든 행동은 감시(Sentinel) 시스템을 거쳐 안전성을 보장한다. 전체 요약 6문장 읽기 → 041 18:30 ▲ 64 · 댓글 2 자가학습하는 추론 모델, 반복 학습으로 성능 붕괴 막는 방법 제시 추론 모델이 자체 생성 질문으로 학습하는 자가진화 과정에서 반복할수록 성능이 저하되는 문제가 있다. AI · 머신러닝 · Questioning the Questions: Sustaining Self-Evolution in Reasoning Models
Key Point 자가학습하는 LLM 기반 추론 모델의 성능 붕괴 문제를 해결하는 실질적 방법을 제시해, 장기간 안정적인 모델 개선이 가능해진다.
핵심 요약
추론 모델이 자체 생성 질문으로 학습하는 자가진화 과정에서 반복할수록 성능이 저하되는 문제가 있다. 논문은 성능 악화의 원인으로 두 가지를 파악했다: 무효한 질문의 증가와 수학적으로 동등한 질문의 반복. 무효한 질문은 라운드가 진행될수록 늘어나며, 답변 일관성 필터링이 이를 더욱 악화시킨다. 전체 요약 9문장 읽기 → 042 18:30 ▲ 84 · 댓글 2 AI가 재미있는 게임을 만든다: 재귀적 평가 루프로 프로토타입을 완성작으로 기존 게임 개발 에이전트는 실행 가능한 게임을 만들지만, 프로그램 정확성만으로는 플레이어에게 재미있는 경험을 보장하지 못한다. AI · 머신러닝 · Recursive Game Creator: An Agentic Product-Level Experience-Oriented Game Harness
Key Point 게임 개발 AI가 단순히 '동작하는' 게임을 넘어 '재미있는' 게임을 만드는 구체적 방법론을 제시해, 에이전트 기반 창작 도구의 평가 기준을 바꾼다.
핵심 요약
기존 게임 개발 에이전트는 실행 가능한 게임을 만들지만, 프로그램 정확성만으로는 플레이어에게 재미있는 경험을 보장하지 못한다. Recursive Game Creator는 Designer, Builder, Player, Reviewer 네 개 컴포넌트로 프로토타입을 재귀적으로 개선해 완성도 높은 게임으로 발전시킨다. Designer는 사용자 지시사항과 Reviewer의 피드백을 구체적 계획으로 변환하고, Builder가 이를 게임 후보로 구현한다. 전체 요약 7문장 읽기 → 오늘의 주요최신순 상위 3건
01 웹 · 프론트엔드 21:11 게시
vitejs/vite
원제 vitejs/vite v8.3.4
v8.3.4
Key Point Vite를 사용하는 개발자라면 HMR 안정성 개선과 CSS 캐싱 버그 수정이 개발 경험에 직결되므로 확인이 필요하다.
핵심 요약
Vite 8.3.4가 출시됐으며, bundled-dev 모드에서 import.meta.hot.acceptExports를 지원하는 새 기능이 추가됐다. HMR 기본값 변경으로 인한 객체 변이 문제를 수정하고, chunkImportMap 활성화 상태에서 non-root base일 때 preload 경로 오류를 해결했다. 개발 중 CSS 모듈 캐싱 버그(순환 참조 시), 스타일시트 로드 대기 미처리, 파일 감시자 추가 문제 등 13개의 버그를 수정했다. 전체 요약 6문장 읽기 → 02 오픈소스 · 도구 18:30 게시
openai/openai-python
원제 openai/openai-python v3.26.1
v3.26.1
Key Point OpenAI Python SDK를 사용하는 개발자들이 커스텀 음성 생성 기능을 정상적으로 사용할 수 있게 되었다.
핵심 요약
OpenAI의 Python 공식 SDK 버전 3.26.1이 릴리스됐다. 커스텀 음성 생성 API의 파라미터 관련 버그를 수정했다. 03 AI · 머신러닝 18:30 게시
anthropics/anthropic-sdk-python
원제 anthropics/anthropic-sdk-python v1.12.1
v1.12.1
Key Point Python 개발자가 Anthropic SDK를 사용할 때 필요한 최신 버전의 변경 사항과 제약사항을 확인할 수 있습니다.
핵심 요약
Anthropic Python SDK가 v1.12.1로 업데이트되었다. 리뷰 프로세스에서 pull request가 변경로그를 업데이트하도록 확인하는 CI 체크를 추가했다. Claude Console 사용량 한도 조회 기능이 초기 접근 단계에 있음을 문서에 명시했다. 전체 요약 4문장 읽기 → 전체 색인7건 · 분야별
인프라 · 데브옵스3건 001 18:30 새 버전 Electron v42.11.12 보안 및 안정성 패치 공개 Electron v42.11.12가 공개되었으며 주요 수정 사항은 ResizeObserver loop-limit 에러 핸들러가 레이아웃을 변경할 때 발생하는 렌더러 크래시 문제를 해결했다. 인프라 · 데브옵스 · electron/electron@v42.11.12
Key Point Electron은 Chromium 기반의 데스크톱 앱 프레임워크로 많은 프로덕션 애플리케이션에서 사용되므로, 렌더러 크래시 패치와 상류 의존성의 보안 업데이트는 즉시 반영해야 할 중요한 개선사항이다.
핵심 요약
Electron v42.11.12가 공개되었으며 주요 수정 사항은 ResizeObserver loop-limit 에러 핸들러가 레이아웃을 변경할 때 발생하는 렌더러 크래시 문제를 해결했다. 이 문제는 #54610로 추적되며 43, 44, 45 버전에도 동일하게 적용된다. 이 외에도 상류 프로젝트인 ANGLE, Chromium, Dawn, fontconfig, Skia, V8, WebRTC에서 백포트된 수정 사항들이 포함되었다 (#54668). 전체 요약 4문장 읽기 → 002 18:30 새 버전 Node.js 26.11.0 출시, 버퍼·HTTP·암호화 기능 강화 Buffer API에 isLatin1() 메서드와 stringLength() 정적 함수가 추가되었다. 인프라 · 데브옵스 · nodejs/node@v26.11.0
Key Point Buffer 검증·HTTP 헤더 안전성·프로세스 타임아웃 등 개발 안정성을 높이는 새 기능들이 다수 안정화됨에 따라 프로덕션 환경 운영의 신뢰도가 올라간다.
핵심 요약
Buffer API에 isLatin1() 메서드와 stringLength() 정적 함수가 추가되었다. HTTP 모듈에 헤더 검증 함수 isValidHeaderName()과 isValidHeaderValue()가 새로 제공된다. HTTP/2에 connectionWindowSize 옵션이 추가되어 연결 윈도우 크기를 제어할 수 있다. 전체 요약 11문장 읽기 → 003 18:30 새 버전 Node.js v26.11.1 출시, 빌드·문서 관련 변경 되돌림 Node.js v26.11.1이 현재(Current) 버전으로 2024년 10월 7일 출시되었습니다. 인프라 · 데브옵스 · nodejs/node@v26.11.1
Key Point Node.js 메인 릴리스 라인의 정기 업데이트이며, 빌드와 문서 시스템의 잠재적 문제를 빠르게 해결하는 과정을 보여줍니다.
핵심 요약
Node.js v26.11.1이 현재(Current) 버전으로 2024년 10월 7일 출시되었습니다. 이번 릴리스는 세 개의 커밋으로 구성되어 있으며, 모두 이전 변경 사항을 되돌리는(Revert) 작업입니다. doc-kit 상세도(verbosity) 토글 기능에 관한 빌드 설정 변경이 되돌려졌습니다. 전체 요약 6문장 읽기 → 웹 · 프론트엔드2건 004 18:30 새 버전 FastAPI 0.142.3 릴리스, OpenTelemetry 캐싱 개선 FastAPI 0.142.3이 릴리스되었습니다. 웹 · 프론트엔드 · fastapi/fastapi@0.142.3
Key Point 주요 웹 프레임워크의 마이너 버전 업데이트로 의존성 패치와 국제화 개선이 포함되어 있으며, FastAPI 사용자는 최신 Starlette 및 보안 관련 라이브러리 업데이트의 영향을 확인할 수 있습니다.
핵심 요약
FastAPI 0.142.3이 릴리스되었습니다. OpenTelemetry 추적기 캐싱 개선으로 경고 중복 제거 기능이 보완되었습니다. 문서에 HTML 제목 제거, FastAPI 뉴스레터 가입 폼 임베드, Asyncer를 사용한 스레드 블로킹 코드 처리 방법 추가되었습니다. 전체 요약 8문장 읽기 → 005 18:30 새 버전 FastAPI 0.142.4, 제외된 요청의 텔레메트리 격리 FastAPI 0.142.4가 릴리스되었다. 웹 · 프론트엔드 · fastapi/fastapi@0.142.4
Key Point FastAPI 애플리케이션에서 모니터링 및 관찰성(observability)을 위한 텔레메트리 데이터 수집이 정상적으로 작동하는지 확인할 필요가 있다.
핵심 요약
FastAPI 0.142.4가 릴리스되었다. 제외된 요청에 대한 텔레메트리 격리 문제를 수정했다. PR #16470을 통해 tiangolo가 해당 수정사항을 반영했다. AI · 머신러닝2건 006 18:30 새 버전 Ollama v0.40.1 릴리스, 클라우드 API 및 버그 수정 Ollama v0.40.1이 출시되었으며 서버의 클라우드 사용량 및 잔액 API 프록시 기능이 추가되었다. AI · 머신러닝 · ollama/ollama@v0.40.1
Key Point 로컬 LLM 실행 플랫폼의 Windows 호환성 개선과 클라우드 연동 기능 확장으로, 더 많은 사용자가 안정적으로 Ollama를 사용할 수 있게 되었다.
핵심 요약
Ollama v0.40.1이 출시되었으며 서버의 클라우드 사용량 및 잔액 API 프록시 기능이 추가되었다. Windows에서 GGUF 모델 로드 시 2GiB 이상의 파일을 읽을 수 없던 버그가 수정되었다. CLI 온보딩 과정에서 불필요한 계정 단계가 제거되었다. 전체 요약 6문장 읽기 → 007 18:30 새 버전 Anthropic Python SDK v1.12.0 출시, 해이쿠 모델과 도구 호출 확장 Anthropic Python SDK v1.12.0이 출시됐으며, Claude Haiku 5.5 모델 지원이 추가됐다. AI · 머신러닝 · anthropics/anthropic-sdk-python@v1.12.0
Key Point Python 개발자가 Claude 최신 기능(새 모델, 웹 검색, 코드 실행)을 프로덕션 환경에서 사용하려면 이 버전의 지원 내용과 변경사항을 파악해야 한다.
핵심 요약
Anthropic Python SDK v1.12.0이 출시됐으며, Claude Haiku 5.5 모델 지원이 추가됐다. 타입이 지정된 컴퓨터 및 브라우저 도구 집합을 통한 구조화된 도구 호출을 지원한다. Managed Agents의 웹 검색, 코드 실행 기능이 모델 기능에 추가됐고, URL 소스를 웹 페치 도구 설정에 포함할 수 있게 됐다. 전체 요약 8문장 읽기 → ● 이번 피드는 여기까지입니다.
작은 발견을 다음 커밋으로 이어가세요. 모든 발행본